
Сценарии отказа, уровни деградации и требования
Информационная система состоит не из железа. Она состоит из цепочек: электричество приходит от генерации через передачу, распределение, преобразование и наконец доходит до потребителя; связь идёт от канала через адресацию, имена, сертификаты и аутентификацию до сервиса. Пока все звенья на месте, цепочки невидимы — их замечают только тогда, когда рвётся одно звено, и оказывается, что зарядка есть, а связи нет, или связь есть, а имя не разрешается, или имя разрешается, а сертификат просрочен, потому что часы ушли.
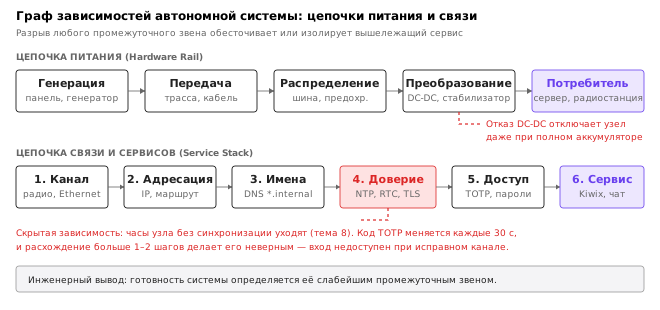
Курс начинается не с технологий, а с рамки, в которой технологии будут оцениваться. Причина практическая: без рамки любая подготовка превращается в закупку — чем больше куплено, тем спокойнее, и это спокойствие ничем не подтверждено. Рамка отвечает на три вопроса. Что именно ломается — то есть какие отказы рассматриваются и какие нет. Что считается сохранённым — то есть до какого уровня работоспособности система обязана дойти в каждом отказе. И как убедиться, что обязательство выполнено, — то есть каким измерением или расчётом подтверждается каждое требование.
Тема задаёт понятийный аппарат и два артефакта: матрицу сценариев и шкалу уровней деградации. Оба артефакта используются во всех последующих темах и в курсовом проекте: тема 3 считает энергию под конкретный сценарий, тема 9 выбирает стратегию копирования под конкретный RPO, тема 13 проверяет всё это учением. Никакие технические решения в курсе не выбираются «потому что хорошие» — они выбираются под сценарий, уровень и допуск.
Надёжность, устойчивость, восстанавливаемость
Три разных свойства
В обиходе слова «надёжный» и «устойчивый» взаимозаменяемы. В инженерии это три разных свойства, и различие между ними определяет, чем вообще имеет смысл заниматься 1.
Надёжность (англ. reliability) — свойство элемента не отказывать за заданное время. Характеризуется интенсивностью отказов, наработкой на отказ, вероятностью безотказной работы. Надёжность повышают качеством компонентов, резервированием, снижением нагрузок. У надёжности есть предел: любая конкретная деталь рано или поздно откажет, и никакая закупка этого не отменяет.
Устойчивость (англ. resilience) — свойство системы сохранять и восстанавливать требуемую функцию при возмущениях, включая те, которые не были предусмотрены проектом. Устойчивость включает четыре способности, которые в литературе по resilience engineering называют не полным перечнем, а рабочей рамкой 12: предвидеть (англ. anticipate) — знать, что может произойти; отслеживать (англ. monitor) — замечать, что происходит; реагировать (англ. respond) — действовать, когда произошло; учиться (англ. learn) — менять систему после того, как произошло.
Восстанавливаемость (англ. recoverability) — свойство вернуться к работоспособному состоянию за приемлемое время после отказа. Измеряется временем восстановления и полнотой восстановления данных.
Три свойства связаны общей шкалой времени. Надёжность говорит, как долго элемент работает до отказа, восстанавливаемость — как долго он стоит после отказа, и обе величины сводятся в одно число — коэффициент готовности, долю времени, когда функция доступна 6. Это число нужно не для отчёта, а для решения: оно показывает, во что выгоднее вкладываться — в более надёжную деталь или в более быстрое восстановление.
Курс занимается второй и третьей способностью и свойством, а не первой. Причина в предмете: надёжность конкретного ноутбука или конкретной батареи — не то, что читатель может существенно изменить. А вот подготовить систему к отказу, заметить отказ, среагировать по записанной процедуре и вернуться к работе — это инженерная задача, которая решается планированием, расчётом и упражнениями.
Практическое следствие для всей дальнейшей работы: вопрос «какое оборудование купить, чтобы ничего не сломалось» заменяется вопросом «какая функция должна сохраниться, при каком отказе, на сколько времени и чем это подтверждается». Второй вопрос имеет ответ, первый — нет.
Готовность: MTBF, MTTR и что из них зависит от читателя
Средняя наработка на отказ (англ. mean time between failures, MTBF) — среднее время работы между отказами. Среднее время восстановления (англ. mean time to repair, MTTR) — среднее время от отказа до возврата функции, включая обнаружение, поиск причины, доставку запчасти и проверку. Стационарный коэффициент готовности (англ. availability) определяется их отношением 9:
A = \frac{\text{MTBF}}{\text{MTBF} + \text{MTTR}}
Разберём пример до последней цифры. Входные данные условные, это не измерение и не паспорт: одноплатный компьютер узла отказывает в среднем раз в год (MTBF = 8760 ч). Вариант 1 — запасной платы нет, замену ждут трое суток (MTTR = 72 ч). Вариант 2 — запасная плата и карта памяти с готовым образом лежат рядом, процедура замены отработана и занимает полчаса (MTTR = 0,5 ч).
mtbf = 8760.0                       # ч, условная наработка: один отказ в год
for mttr in (72.0, 0.5):            # ч: ждать запчасть / заменить из ЗИП
    a = mtbf / (mtbf + mttr)
    print(f"MTTR {mttr:>5} ч: A = {a:.6f}, простой {(1 - a) * 8760:.1f} ч в год")
chain = (8760 / (8760 + 72)) ** 3   # три таких звена последовательно
print(f"три звена подряд: A = {chain:.5f}, простой {(1 - chain) * 8760:.0f} ч в год")
pair = 1 - (72 / (8760 + 72)) ** 2  # два независимых звена параллельно
print(f"два звена параллельно: A = {pair:.7f}, простой {(1 - pair) * 8760 * 60:.1f} мин в год")
MTTR  72.0 ч: A = 0.991848, простой 71.4 ч в год
MTTR   0.5 ч: A = 0.999943, простой 0.5 ч в год
три звена подряд: A = 0.97574, простой 212 ч в год
два звена параллельно: A = 0.9999335, простой 34.9 мин в год
Проверим первую строку вручную: 8760 / (8760 + 72) = 8760 / 8832 = 0,991848; недоступность 1 − 0,991848 = 0,008152; за год 0,008152 × 8760 = 71,4 ч. Вторая строка: 8760 / 8760,5 = 0,999943, простой 0,5 ч. При той же надёжности платы простой сократился в 140 раз — за счёт запасной детали и отработанной процедуры, то есть за счёт восстанавливаемости. Третья строка показывает обратную сторону: цепочка из трёх последовательных звеньев с той же готовностью простаивает втрое дольше одного звена — 212 ч в год, потому что готовность цепочки равна произведению готовностей звеньев. Четвёртая — что даёт дублирование: два независимых параллельных звена простаивают одновременно 34,9 минуты в год.
Вывод для курса: MTBF конкретной платы читатель почти не контролирует, а MTTR — контролирует полностью. Запасная деталь (тема 6), записанная процедура (тема 13) и офлайн-профиль с образом (тема 2) уменьшают знаменатель, и именно это даёт порядки, а не проценты. Модель предполагает независимые отказы и экспоненциальное распределение наработки; общий отказ двух «параллельных» звеньев от одной причины (тот же блок питания, та же гроза) она не видит, и об этом — раздел об анализе видов отказов ниже.
Плавная деградация и единая точка отказа
Два понятия из области устойчивости определяют конструкцию любой автономной системы.
Плавная деградация (англ. graceful degradation) означает, что при потере ресурсов система теряет функции постепенно и в предсказанном порядке, а не обрушивается целиком; в таксономии надёжных вычислений это называют работой в деградированном режиме (англ. degraded mode) 6. Разница видна на примере. Система без плавной деградации: пропал интернет — не работает ничего, включая локальные документы, потому что редактор требует лицензионной проверки онлайн. Система с плавной деградацией: пропал интернет — локальные документы работают, локальная сеть работает, синхронизация между узлами работает, за пределы площадки связи нет. Пользователь замечает потерю только на четвёртом уровне.
Единая точка отказа (англ. single point of failure, SPOF) — элемент, отказ которого выводит из строя всю систему или существенную её часть, при том что замены ему нет. Типичные единые точки отказа в личной системе: один блок питания, один диск с единственной копией данных, одна учётная запись с доступом ко всем ключам, один человек, знающий пароли, одна инструкция, существующая только в голове этого человека. Единая точка отказа — не обязательно деталь: инструкция и пароль тоже элементы системы.
Плавная деградация и устранение единых точек отказа — не абстракции, а проверяемые свойства. Первое проверяется сценарием с последовательным отключением ресурсов: отключили интернет — что осталось; отключили интернет и сеть — что осталось; отключили интернет, сеть и половину заряда — что осталось. Второе проверяется вопросом к каждому элементу: «что произойдёт, если он откажет прямо сейчас, и чем я его заменю». Если ответа на вторую половину вопроса нет, это единая точка отказа, и она заносится в перечень.
RTO и RPO в личном масштабе
Два числа формализуют требования к восстановлению. Они пришли из практики непрерывности деятельности организаций 3, но в личном масштабе работают так же.
Целевое время восстановления (англ. recovery time objective, RTO) — максимально допустимый промежуток от момента отказа до момента, когда функция снова доступна. RTO измеряется не в «когда получится», а в конкретном числе: 15 минут, 1 час, 4 часа, сутки.
Целевая точка восстановления (англ. recovery point objective, RPO) — максимально допустимый объём данных, потерянных при восстановлении, выраженный во времени: RPO 0 означает, что терять нельзя ничего; RPO 1 сутки означает, что допустимо потерять работу за последние сутки.
RTO и RPO задаются до выбора средств, а не после. Это принципиально: если сначала купить резервный диск, а потом подумать, зачем он, получится носитель, который не покрывает ни одного требования. Если сначала задать RPO 1 час, то из этого следует, что копирование раз в сутки не подходит, а из этого следует конкретная конструкция расписания, а из неё — конкретный инструмент (тема 9).
Оба числа имеют цену. Стандарт непрерывности деятельности требует назначать приоритетные сроки возобновления функций в ходе анализа воздействия на деятельность (ISO 22301, разд. 8.2.2) 5, но не говорит, сколько стоит их сократить: это зависит от средства. Пример с готовностью выше показывает, из чего складывается RTO, — из ожидания запчасти, поиска причины и выполнения процедуры, и каждое слагаемое сокращается своим средством: запасным комплектом, записанной процедурой, тренировкой. Уменьшение RPO требует более частого копирования, а частое копирование — это трафик, энергия и износ носителя. Поэтому RTO и RPO назначаются по критичности функции, а не единым значением на всю систему: почта и рабочий документ имеют разные требования, и это нормально.
Требование без метода проверки не является требованием
Формулировка «система должна работать автономно» не является инженерным требованием. Её нельзя проверить: непонятно, что считать работой, при каком отказе, как долго и с каким допуском.
Требование приобретает смысл, когда в нём есть пять частей:
- Условие — при каком сценарии и на каком уровне деградации.
- Объект — какая конкретная функция.
- Величина и допуск — сколько времени, какая доля, какое отклонение.
- Метод проверки — измерение прибором, расчёт программой, прогон процедуры.
- Стенд — на чём проверяется: виртуальная машина, ноутбук, макет.
Пример требования, удовлетворяющего всем пяти частям: «При сценарии Б узел сохраняет уровень 2 (локальная сеть и сервисы) не менее 72 часов; проверка — почасовое моделирование energy.py на профиле нагрузки варианта плюс измерение фактического потребления USB-тестером; допуск — расхождение расчёта и измерения не более 15 %».
Для сравнения, то же намерение в непригодной форме: «узел должен долго работать зимой». Второе нельзя ни подтвердить, ни опровергнуть, а значит нельзя и улучшить: непонятно, что именно исправлять после провала.
Правило распространяется на весь курс и на курсовой проект. В теме 13 при проведении учения каждое требование получает статус «выполнено» или «не выполнено», и «не выполнено» с разбором причины — полноценный результат, тогда как «выполнено» без подтверждения — нет.
Матрица сценариев
Почему сценарий, а не место
Распространённая ошибка — задавать требования через географию или через воображаемое событие: «если случится катастрофа», «если отключат всё». Такая постановка не даёт инженеру ничего: она не указывает, какие именно ресурсы исчезли, а от этого зависит всё.
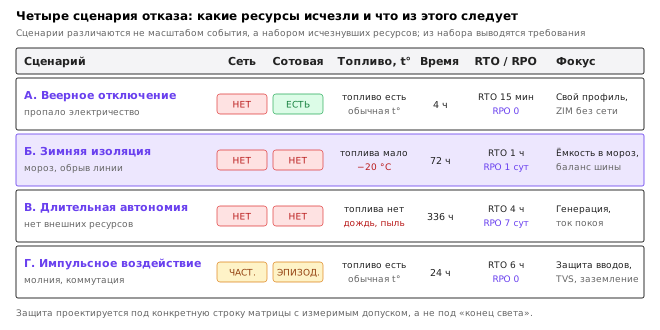
Сценарий в этом курсе задаётся набором отказов и ограничений. Каждое поле матрицы — это ресурс или условие, которое либо есть, либо нет, и от комбинации зависит конструкция системы. Сценариев четыре, и они выбраны так, чтобы покрыть разные классы отказов, а не разные степени драматизма.
Четыре сценария
| Сценарий | Сеть | Интернет | Сотовая | Топливо | Температура | Длительность | RTO | RPO |
|---|---|---|---|---|---|---|---|---|
| А. Веерное отключение | нет | нет | есть | есть | обычная | 4 часа | 15 мин | 0 |
| Б. Зимняя изоляция | нет | нет | нет | ограничено | −20 °C | 3 суток | 1 час | 1 сутки |
| В. Длительная автономия | нет | нет | нет | нет | дождь, пыль | 2 недели | 4 часа | 7 суток |
| Г. Импульсное воздействие | частично | нет | эпизодически | есть | обычная | 1 сутки | 6 часов | 0 |
Сценарий А. Веерное отключение (условие C-01-01: длительность 4 ч). Пропало электричество и вместе с ним проводной интернет и домашняя сеть; сотовая связь работает, потому что базовые станции имеют собственное резервное питание; топливо и отопление есть; температура обычная. Длительность — несколько часов. Это самый частый в жизни и самый недооценённый сценарий: он выглядит как мелочь, но именно в нём обнаруживается, что половина работы остановилась, потому что редактор, справочник и пароли живут в сети.
У допущения «сотовая есть» есть срок. Базовая станция при отключении сети работает от своих аккумуляторов, а их запас операторы не публикуют и он различается от площадки к площадке; при отключении дольше этого запаса связь пропадёт и в сценарии А, причём неравномерно: сначала у станций без резервного генератора, затем перегрузятся оставшиеся. Поэтому курс не задаёт этот срок числом, а в требованиях сценария А сотовый канал считается эпизодическим ресурсом, а не гарантированным: функция, опирающаяся только на него, в перечне требований помечается как риск.
Ключевое свойство сценария А: внешний канал есть, но он мобильный и дорогой. Отсюда требования: работа должна продолжаться на локальных ресурсах, а мобильный канал используется как узкое место для срочного, а не как основной транспорт. RTO здесь мал (15 минут), потому что отказ короткий и застаёт врасплох; RPO равен нулю, потому что данные должны быть на месте к моменту возврата питания.
Сценарий Б. Зимняя изоляция (условие C-01-02: температура −20 °C, длительность 72 часа / 3 суток). Нет сети, нет интернета, нет сотовой связи; топливо ограничено; температура −20 °C; длительность — трое суток. Это сценарий, в котором энергия и тепло становятся главным ограничением, а не связь: при −20 °C свинцовый аккумулятор AGM отдаёт 0,44 паспортной ёмкости — более чем вдвое меньше (C-04-06: 0,44, экстраполяция табл. 1 IEEE 485 в battery.py), литий-железо-фосфатный — 0,70 (C-04-07: 0,70) и к тому же не принимает заряд ниже 0 °C без подогрева, электроника в неотапливаемом помещении требует прогрева. RTO растёт до часа (система может быть физически холодной), RPO — сутки (копии делаются реже, потому что энергия дорога).
Сценарий В. Длительная автономия (условие C-01-03: 2 недели / 336 часов без топлива и связи). Нет ни одного внешнего ресурса: ни сети, ни интернета, ни сотовой, ни топлива. Погода плохая — дождь и пыль, то есть солнечная генерация неполная, а оборудование подвержено влаге. Две недели. Это сценарий, в котором решает не пик возможностей, а расход: систему проектируют не под максимальную нагрузку, а под минимальную достаточную, и всё остальное выключается. RTO здесь наибольший (4 часа), потому что система должна запуститься и стабилизироваться; RPO — неделя, потому что при жёстком ограничении энергии ежедневное копирование становится роскошью.
Сценарий Г. Импульсное воздействие (условие C-01-04: длительность 24 ч). Часть проводной сети физически повреждена, интернета нет, сотовая связь появляется эпизодически, топливо есть, температура обычная, длительность — сутки. Под импульсным воздействием понимается мощный кратковременный электромагнитный импульс в проводах и антеннах: близкий разряд молнии, коммутационный бросок в сети, выброс при восстановлении питания. Его отличие от сценариев А–В в том, что отказывает не внешний ресурс, а собственное оборудование: импульс приходит по кабелю питания, по сетевому кабелю, по антенному фидеру и выводит из строя входные цепи — блок питания, порт коммутатора, приёмник. Отказ может быть скрытым: устройство включается, но порт не поднимает связь или диск отдаёт ошибки чтения.
Главное в сценарии Г — не длительность, а неопределённость восстановления: неизвестно, что уцелело из оборудования и когда появится связь. Поэтому требования сценария Г формулируются иначе, чем в остальных: не «держит уровень N столько-то часов», а «за RTO определяет, что уцелело, и восстанавливает уровень 0 и 1 из того, что уцелело», и ключевыми становятся запасные детали, хранящиеся отключёнными, и копия данных на носителе, не подключённом к узлу в момент импульса. RTO средний (6 часов) — есть время разобраться, что работает; RPO равен нулю, потому что данные должны быть целы, а не потеряны из-за повреждённого носителя. Как устроены пути проникновения импульса и чем их перекрывают — грозозащита, разрядники, экранирование, разнесение кабелей, — разбирается в теме 12; здесь сценарий задаёт только требования.
Как сценарий превращается в требования
Матрица сама по себе — не требования. Требования получаются, когда матрица пересекается со шкалой уровней. Порядок действий такой.
- Для каждого сценария определить, какие уровни деградации должны сохраниться. Сценарий А: уровни 0, 1, 2 обязательны, уровень 3 — при наличии второго узла, уровень 4 доступен эпизодически через сотовую связь. Сценарий Б: уровни 0, 1, 2 обязательны, уровень 3 — при наличии второго узла. Сценарий В: уровни 0, 1 обязательны, уровень 2 — по возможности. Сценарий Г: уровень 0 обязателен, уровень 1 обязателен при уцелевшем носителе.
- Для каждого обязательного уровня сформулировать требование с величиной, допуском, методом и стендом.
- Проверить, что требования не противоречат друг другу. Противоречие выглядит так: требование «не менее 72 часов уровня 2 в сценарии Б» и требование «масса переносимого комплекта не более 8 кг» могут оказаться несовместимыми при данной химии аккумулятора, и тогда одно из них меняется осознанно, а не по факту.
- Определить, какие требования проверяются вычислением, какие измерением, какие прогоном процедуры — и убедиться, что для каждого есть средство проверки в доступной версии полигона.
Шаг 3 — тот, который пропускают чаще всего. Требования, взятые по отдельности, выглядят разумно; вместе они иногда несовместимы, и обнаруживается это только при попытке их одновременно выполнить. Поэтому перечень требований проверяется на совместность до начала работы, а не после.
Уровни деградации
Пять уровней
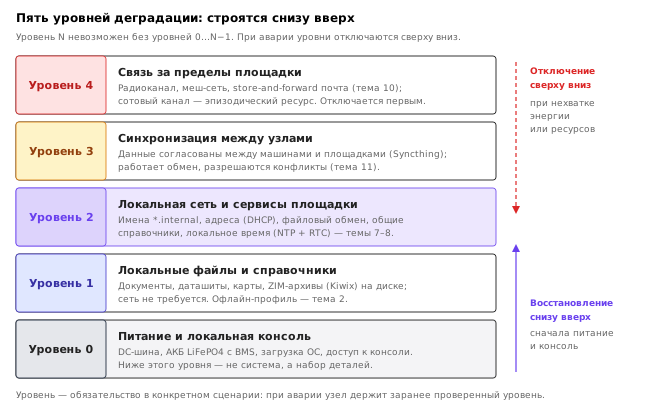
Шкала уровней — способ описать, что именно сохранилось, не вдаваясь в детали реализации. Она устроена так, что каждый следующий уровень включает предыдущий: нельзя иметь локальную сеть, не имея питания и файлов.
Уровень 0 — питание и локальная консоль. Устройство включается, операционная система загружается, есть доступ к командной строке или графическому интерфейсу. Ничего больше не гарантируется. Это минимальный уровень, ниже которого система не система, а набор деталей.
Уровень 1 — локальные файлы и справочники. Доступны документы, книги, документация, даташиты, карты, сохранённые локально. Никакой сети не требуется. Этот уровень — то, ради чего вообще хранят офлайн-профиль (тема 2).
Уровень 2 — локальная сеть и сервисы. Работают имена, адреса, файловый обмен, общие справочники, локальное время — в пределах одной площадки. Требует работающего узла и локальной сети (темы 7–8).
Уровень 3 — синхронизация между узлами. Данные согласованы между несколькими машинами или площадками; работает обмен, разрешаются конфликты (тема 11).
Уровень 4 — связь за пределы площадки. Информация уходит и приходит за пределы узла: радиоканал, меш-сеть, store-and-forward почта (тема 10).
Уровни нумеруются снизу вверх, потому что строятся снизу вверх: невозможно обеспечить уровень 3, не обеспечив уровень 2, а уровень 2 не работает без уровня 1. Это свойство используется при проверке: если при сценарии заявлен уровень 2, а уровень 1 не работает, то заявка ложна независимо от того, что показывает проверка уровня 2.
Почему уровни, а не список сервисов
Список сервисов («почта, календарь, файлы, карты») плох тем, что он привязан к конкретным программам и устаревает вместе с ними. Шкала уровней описывает функцию, а не продукт: «локальные справочники» остаются требованием, даже если конкретная программа чтения ZIM-архивов сменилась трижды.
Второе свойство шкалы: она позволяет формулировать частичные требования. Не «система работает или нет», а «при сценарии Б система держит уровень 2 и теряет уровень 3». Такая формулировка честна — она признаёт, что часть функций будет потеряна, и называет, какая именно.
Третье свойство: шкала задаёт порядок восстановления. Когда система упала и ресурсы ограничены, восстанавливать надо снизу вверх, потому что верхние уровни без нижних не работают. Это же задаёт порядок в чек-листах темы 13: сначала питание и консоль, затем данные, затем сеть, затем синхронизация, затем внешняя связь. Попытка начать сверху — типичная ошибка в момент стресса: человек бросается настраивать радиосвязь, не проверив, что у него работает файловая система.
Уровень как обязательство, а не как описание
Важно, что уровень — это обязательство, которое система берёт на себя в конкретном сценарии, а не оценка её возможностей вообще. Один и тот же узел может держать уровень 4 при сценарии А (сотовая связь работает) и только уровень 2 при сценарии Б (сотовой нет). Это не противоречие и не слабость: это точное описание.
Отсюда следует, что в перечне требований уровень всегда указывается вместе со сценарием. Запись «узел обеспечивает уровень 3» без сценария бессмысленна, потому что не говорит, при каких условиях.
Как строится перечень требований
От карты зависимостей к требованиям
Первый шаг любой подготовки — инвентаризация того, что уже есть, и того, без чего работа останавливается. Это делается не по памяти, а наблюдением: в течение обычного рабочего дня фиксируется, какие сервисы используются и что произойдёт, если каждый из них исчезнет.
Наблюдение нужно потому, что зависимость, которая всегда работала, не воспринимается как зависимость. Вейк и Сатклифф относят к признакам организаций, устойчиво работающих в сложных условиях, нежелание упрощать картину и постоянное внимание к тому, как работа выполняется на деле, а не по схеме 7. Электронная почта осознаётся, потому что она явно «сетевая». Синхронизация часов осознаётся редко, хотя без неё ломаются TLS-соединения, журналы и проверка подписей. Проверка лицензии онлайн осознаётся ещё реже, хотя именно она останавливает работу редактора, который сам по себе полностью локальный.
Карта зависимостей строится по цепочкам, а не по приложениям. Пример для одной функции «работа с документом»:
документ
  файл на диске            → локальный, не зависит от сети
  приложение-редактор       → локальное, но проверяет лицензию онлайн
  шрифты                    → локальные, но часть подгружается из сети
  автосохранение            → локальный диск
  синхронизация с копией    → внешний сервис
  доступ к справочнику      → внешний сервис
Из такой карты видно, что при потере интернета функция не исчезает целиком, а теряет два звена из шести, причём одно из них (лицензия) может остановить всю функцию. Это и есть материал для требований: «при сценарии А редактор запускается и сохраняет файл локально не позже 15 минут после отказа сети» — требование с условием, объектом, допуском и методом проверки.
Скрытые зависимости
Ниже — зависимости, которые чаще всего обнаруживаются только в момент отказа. Каждая из них превращает локальную на вид функцию в сетевую.
- Часы и одноразовые коды. Коды TOTP (приложения-аутентификаторы) вычисляются из общего секрета и текущего времени с шагом 30 секунд (C-01-12: 30 с, RFC 6238, разд. 5.2) 10. Сеть для вычисления кода не нужна, но нужны верные часы и на телефоне, и на сервере: расхождение больше одного-двух шагов делает код неверным. Узел, неделю живущий без синхронизации времени, накапливает уход часов (тема 8), и локальный вход по TOTP может перестать работать без единого сетевого запроса.
- Отзыв сертификатов: OCSP и CRL. Клиент TLS может проверять, не отозван ли сертификат сервера, запросом к ответчику OCSP 11 или по списку отзыва CRL, у которого есть срок следующего обновления
nextUpdate12. Без сети ответчик недоступен, а скачанный список устаревает. Поведение зависит от программы: распространённые браузеры при недоступности OCSP по умолчанию продолжают работу, а строгий клиент (почтовый, корпоративный VPN) отказывает в соединении даже с локальным сервером, если его сертификат выпущен с обязательной проверкой. - Облачные менеджеры паролей. Хранилище паролей синхронизируется с сервером, а локальный кэш у части программ требует периодического входа в сеть или блокируется по таймеру. Это единая точка отказа в самом неудобном месте: без пароля не открыть ни локальный сервис, ни резервную копию.
- Лицензии с онлайн-активацией. Программа, проверяющая лицензию при запуске или раз в N дней, локальна по данным, но сетевая по запуску. Срок офлайн-работы задаёт поставщик, и узнать его можно только из документации или опытом.
- DNS поверх HTTPS по умолчанию. Браузеры умеют отправлять DNS-запросы не системному резолверу, а внешнему серверу по HTTPS (DoH, 13). Когда внешний сервер недоступен, браузер либо возвращается к системному резолверу, либо не разрешает имена вовсе — в зависимости от настройки. Локальное имя
wiki.polygon.internal, которое прекрасно разрешает локальный резолвер (тема 8), браузер в строгом режиме DoH не найдёт.
Общий приём проверки для всех пяти — тот же, что в лабораторной работе 1: выполнить действие в окружении без сети и посмотреть, что сломалось. Без прав администратора такое окружение даёт пространство имён без сетевых интерфейсов (unshare -rn), и программа внутри него видит отказ сети так же, как при настоящем отключении.
Анализ видов и последствий отказов
Карта зависимостей отвечает на вопрос «что сломается без внешнего ресурса». Обратный вопрос — «что будет, если откажет каждый собственный элемент» — систематически задаёт анализ видов и последствий отказов (англ. failure mode and effects analysis, FMEA) 8. Для каждого элемента перечисляются виды отказа, их последствия для уровня деградации, способ обнаружения и мера. Чтобы расставить приоритеты, каждому виду отказа ставят три оценки по шкале 1–10: тяжесть S (англ. severity), вероятность O (англ. occurrence) и трудность обнаружения D (англ. detection); их произведение — приоритетное число риска RPN. Стандарт оговаривает, что RPN — порядковая, а не количественная мера, и сравнивать имеет смысл только строки одной таблицы с одними правилами оценки 8.
Разобранный пример для Полигона. Оценки S, O, D — экспертные оценки автора примера, а не измерения; таблица показывает метод, а не свойства конкретного железа.
| Элемент | Вид отказа | Последствие | Обнаружение | S | O | D | RPN | Мера |
|---|---|---|---|---|---|---|---|---|
| карта памяти SBC | износ, файловая система только для чтения | уровень 0 потерян | ошибки в журнале ядра | 9 | 5 | 6 | 270 | образ на запасной карте, проверка раз в месяц |
| батарейка часов RTC | разряд | неверное время → отказ TLS и TOTP, уровень 2 | расхождение часов при загрузке | 6 | 4 | 8 | 192 | замена по графику, проверка времени в чек-листе |
| DC-DC 12→5 В | пробой после импульса | уровень 0 потерян | узел не включается | 9 | 2 | 2 | 36 | запасной модуль, предохранитель на входе |
| BMS батареи | отключение по низкой температуре | заряд невозможен, сценарий Б | контроллер не показывает ток заряда | 8 | 6 | 7 | 336 | подогрев, контроль тока заряда в журнале |
| локальный резолвер | не запустился | имена *.internal не разрешаются, уровень 2 | проверка dig в чек-листе | 6 | 3 | 3 | 54 | запись в /etc/hosts для ключевых имён |
Наибольшее RPN в примере получила не самая «страшная» по тяжести строка, а та, где отказ плохо заметен: BMS тихо не принимает заряд на морозе, и узнают об этом, когда батарея уже пуста. Это типичный результат FMEA: таблица заставляет оценить обнаружение отдельно, и самыми опасными оказываются тихие отказы. Отсюда прямо следуют требования с методом проверки: «ток заряда при положительной генерации контролируется раз в сутки», «время узла сверяется с эталоном при каждом запуске».
FMEA рассматривает отказы элементов по одному. Отказ общей причины — один импульс, выводящий из строя и основной, и запасной блок питания, подключённые к одной розетке, — она не показывает, и для него строят дерево отказов (англ. fault tree analysis): от нежелательного события сверху вниз через логические «И» и «ИЛИ» к исходным причинам. Для узла Полигона дерево события «уровень 2 потерян» содержит ветвь «ИЛИ»: «нет питания» ИЛИ «нет локальной сети» ИЛИ «нет имён»; ветвь «нет питания» раскрывается через «И»: «батарея пуста» И «генерации нет». Дублирование помогает только там, где в дереве стоит «И», и только если дублирующие элементы не имеют общей причины отказа. Лесон показывает, что значительная часть аварий в сложных системах происходит вообще без отказа элементов — из-за небезопасного взаимодействия исправных частей 4; пример этого курса — исправный браузер, исправный локальный резолвер и строгий режим DoH, которые вместе не дают открыть локальный справочник.
Согласование с ресурсами
Требования, выведенные из сценариев, проверяются на выполнимость по ресурсам: энергия, время, масса, деньги, внимание. Для курса важны первые два, потому что они проверяемы.
Энергетическая проверка делается расчётом: суточная нагрузка на уровне 2 пересчитывается на длительность сценария (суточные ватт-часы × часы / 24) и сравнивается с энергией, которую батарея отдаст нагрузке при температуре сценария. Расчёт выполняет energy.py по конфигурации Полигона (teacher/polygon.json): LiFePO4 100 А·ч × 12,8 В, DoD 0,8, КПД разряда 0,95, суточный профиль уровня 2 — 1042 Вт·ч (C-03-02: 1042 Вт·ч).
python3 teacher/sim/energy.py --scenario Б
Химия lifepo4, -20 °C: ёмкость 1280 Вт·ч × DoD 0.8 × kT 0.700 = полезно 717 Вт·ч; КПД разряда 0.95, заряда 0.95
LiFePO4 ниже 0 °C: заряд заблокирован BMS (подогрева нет)
...
Нагрузка 3126.0 Вт·ч (1042 в сутки), из батареи 716.8 Вт·ч, генерация 0 Вт·ч (0 в сутки)
Дефицит 2445 Вт·ч, сброшено 0 Вт·ч, минимум SOC 0.0 %, в конце 0.0 %
Разряд до LVD: на 16 ч
Требование «уровень 2 на 72 часа в сценарии Б» требует 3126 Вт·ч (C-01-05: 3126 Вт·ч): 1042 × 72 / 24 = 3126. На морозе −20 °C полезная ёмкость Полигона — не 1024, а 716,8 Вт·ч (C-01-06: 716,8 Вт·ч): 1280 × 0,8 × 0,70 = 716,8. Нагрузке достаётся 716,8 × 0,95 = 681 Вт·ч, и разряд до отключения по низкому напряжению (LVD) наступает на 16-м часе (C-01-07: 16 ч). Требование невыполнимо при данной конфигурации, и есть ровно четыре выхода: снизить нагрузку, увеличить ёмкость, добавить генерацию или понизить требование. Все четыре законны, но выбор одного из них — инженерное решение, которое фиксируется, а не обнаруживается потом.
Каждый выход можно довести до числа той же программой. Чтобы продержаться 72 ч на имеющейся батарее, средняя нагрузка не должна превышать 9,46 Вт (C-01-08: 9,46 Вт): 716,8 × 0,95 / 72 = 9,46 — это уровень 0–1 (одноплатный компьютер с локальными файлами), а не уровень 2. Требование вида «уровень 0 при 18 Вт на 72 ч» означает 18 × 72 = 1296 Вт·ч (C-01-11: 1296 Вт·ч) и тоже невыполнимо: батарея разряжается на 38-м часе. Генерация зимой выход не даёт: на 56° с. ш. в декабре панель 100 Вт в среднем приносит десятки ватт-часов в сутки (тема 5), а LiFePO4 без подогрева на морозе их не принимает. Для сценария В с профилем уровня 2 потребность составляет 14 588 Вт·ч за 336 ч (C-01-09: 14 588 Вт·ч) — в пятнадцать раз больше полезной ёмкости, и здесь вопрос не в запасе, а в выборе уровня.
Сценарий А, напротив, выполним с запасом, но его результат зависит от часа начала отказа. Отключение в 17:00 приходится на вечерний пик профиля: за 4 часа нагрузка забирает 210 Вт·ч (C-01-10: 210 Вт·ч; energy.py --scenario А --start-hour 17), и батарея заканчивает сценарий с 78 % полезного заряда. Тот же расчёт с полуночи даёт втрое меньший расход. Требование для сценария А поэтому формулируется для худшего часа начала, а не для среднего.
Временная проверка делается прогоном: требование «RTO 1 час» означает, что процедура восстановления должна укладываться в час, а не что она «в принципе быстрая». Проверяется секундомером на учении (тема 13). Если процедура занимает 2 часа 40 минут, требование не выполнено, и это факт, а не мнение.
Форма перечня
Перечень требований ведётся таблицей и живёт весь курс. Минимальный набор столбцов:
| ID | Требование | Сценарий | Уровень | Метод проверки | Стенд | Допуск | Статус |
|---|---|---|---|---|---|---|---|
| R-01 | Узел держит уровень 2 не менее 4 ч при старте в любой час суток | А | 2 | energy.py --start-hour по худшему часу | П0 | ±15 % | не проверено |
| R-02 | Локальные справочники доступны без сети | А, Б | 1 | прогон поиска по ZIM | П0 | 0 отказов | не проверено |
| R-03 | Узел держит уровень 1 не менее 72 ч при −20 °C | Б | 1 | energy.py --scenario Б + измерение | П0, П1 | ±15 % | не выполнено: нужна нагрузка ≤ 9,46 Вт |
Строка R-03 показывает, как выглядит честный результат расчёта: требование записано, проверено расчётом и получило статус «не выполнено» с причиной. Это не провал перечня, а его работа — до учения стало известно, что именно надо менять. Столбец «Статус» начинается со значения «не проверено» и меняется только после фактической проверки. Значения «в основном», «почти», «должно работать» не используются: статус либо подтверждён, либо нет.
Что эта модель не учитывает
Границы рамки и её расчётов
Рамка сценариев и уровней — модель, и у неё есть явные ограничения с последствиями:
- Вероятности сценариев. Матрица отвечает на вопрос «что делать, если», а не «что вероятнее»; приоритет между сценариями задаётся решением, а не расчётом.
- Зависимость отказов. Формула готовности и FMEA считают отказы независимыми; отказ общей причины (один импульс на два блока питания) делает дублирование бесполезным, и расчёт этого не покажет.
- Энергетический расчёт — потолок.
energy.pyне учитывает старение батареи, саморазряд, серии пасмурных дней, пусковые токи и собственное потребление контроллера; реальная автономия меньше расчётной, поэтому в требованиях стоит допуск, а не точное число. - Человек. Время реакции, ошибки в стрессе и усталость в рамку не входят; они проверяются только учением (тема 13).
Рамка не предсказывает, какой сценарий случится. Она отвечает на вопрос «что делать, если», а не «что вероятнее». Оценка вероятностей — отдельная задача, для неё нужны данные о конкретном месте и они у курса отсутствуют.
Рамка не заменяет проектирование. Матрица и уровни задают, что требуется; как это получить — предмет тем 3–12. Перечень требований без технических решений бесполезен, технические решения без перечня требований бесконтрольны.
Рамка не учитывает стоимость в деньгах. Курс сознательно держит обязательную часть на нулевой стоимости, поэтому денежный столбец в перечне не ведётся; там, где стоимость важна (аппаратные расширения П1 и П2), она указана в тексте темы и в перечне не участвует.
Наконец, рамка не описывает сценарии, в которых метод неприменим. Полное разрушение промышленной базы, длительная потеря инфраструктуры целого региона, климатические изменения необратимого характера — это границы применимости, за которыми инженерные решения уступают место другим дисциплинам. Курс называет эту границу и не пытается её расширить.
Типичные ошибки при построении перечня
Требования без допуска. «Система должна работать быстро» — не требование. Быстро относительно чего, при какой нагрузке, с каким отклонением?
Сценарий как место. «Требование выполнено, если мы в городе N» — не сценарий. Город N не описывает, какие ресурсы исчезли.
Единое требование на всё. «Все данные должны быть доступны всегда» — требование, которое невозможно выполнить и которое поэтому будет проигнорировано. Разные данные имеют разную критичность, и это отражается в разных RTO и RPO.
Проверка задним числом. Перечень пишется после того, как всё куплено и настроено, и подгоняется под то, что получилось. Такой перечень всегда выполнен и поэтому бесполезен: отказы, на которых учатся инженеры, — это как раз несовпадения ожидаемого и фактического, и перечень без возможности несовпадения учиться не даёт 14.
Оптимизм в допуске. Допуск ±50 % превращает проверку в формальность. Допуск выбирается из физики измерения: для расчёта энергии по профилю ±15 % разумно, для проверки наличия файла — ноль отказов.
Отсутствие статуса. Перечень без столбца статуса превращается в список пожеланий. Столбец статуса — то, что отличает инженерный документ от плана намерений.
Итоги темы
Курс занимается устойчивостью и восстанавливаемостью, а не надёжностью: надёжность конкретной детали читатель изменить не может, а подготовку к отказу, обнаружение отказа, реакцию и возврат к работе — может. Коэффициент готовности показывает это числом: при неизменной наработке на отказ сокращение времени восстановления с трёх суток до получаса уменьшает простой в 140 раз.
Сценарий описывается набором исчезнувших ресурсов, а не местом и не масштабом события. Четыре сценария курса — веерное отключение, зимняя изоляция, длительная автономия и импульсное воздействие — различаются не драматизмом, а тем, какие именно звенья цепочек рвутся, и из этого различия выводятся разные требования, включая разные RTO и RPO.
Уровни деградации описывают функцию, а не продукт, и строятся снизу вверх: питание и консоль, локальные файлы, локальная сеть, синхронизация, внешняя связь. Уровень — обязательство в конкретном сценарии, а не свойство системы вообще; поэтому он всегда указывается вместе со сценарием.
Скрытые зависимости — часы, отзыв сертификатов, облачные пароли, онлайн-лицензии, DNS поверх HTTPS — выявляются наблюдением и опытом без сети, а не по памяти; анализ видов отказов дополняет карту взглядом изнутри и выводит наверх тихие отказы, которые плохо обнаруживаются.
Требование имеет смысл только тогда, когда содержит условие, объект, величину с допуском, метод проверки и стенд. Требование без метода проверки нельзя ни подтвердить, ни опровергнуть, а значит нельзя и улучшить. Перечень требований проверяется на совместность и на выполнимость по энергии и времени до начала работы: для Полигона расчёт показывает, что уровень 2 в сценарии Б невыполним, а уровень 0–1 требует средней нагрузки не больше 9,46 Вт.
Следующая тема переходит от рамки к первому практическому слою — офлайн-профилю узла: что именно должно быть под рукой, как убедиться, что это работает, и как поддерживать его в рабочем состоянии годами.
Литература
- Hollnagel E., Woods D. D., Leveson N. (eds.). Resilience Engineering: Concepts and Precepts. — Ashgate, 2006.
- Hollnagel E. Resilience Engineering in Practice: A Guidebook. — Ashgate, 2011.
- NIST Special Publication 800-34 Rev. 1. Contingency Planning Guide for Federal Information Systems. — National Institute of Standards and Technology, 2010. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Leveson N. G. Engineering a Safer World: Systems Thinking Applied to Safety. — MIT Press, 2011.
- ISO 22301:2019. Security and resilience — Business continuity management systems — Requirements. — International Organization for Standardization, 2019.
- Avižienis A., Laprie J.-C., Randell B., Landwehr C. Basic Concepts and Taxonomy of Dependable and Secure Computing // IEEE Transactions on Dependable and Secure Computing. — 2004. — Vol. 1, No. 1. — P. 11–33.
- Weick K. E., Sutcliffe K. M. Managing the Unexpected: Sustained Performance in a Complex World. 3rd ed. — Wiley, 2015.
- IEC 60812:2018. Failure modes and effects analysis (FMEA and FMECA). — International Electrotechnical Commission, 2018.
- IEC 61703:2016. Mathematical expressions for reliability, availability, maintainability and maintenance support terms. — International Electrotechnical Commission, 2016.
- RFC 6238. TOTP: Time-Based One-Time Password Algorithm. — IETF, 2011. https://www.rfc-editor.org/rfc/rfc6238
- RFC 6960. X.509 Internet Public Key Infrastructure Online Certificate Status Protocol — OCSP. — IETF, 2013. https://www.rfc-editor.org/rfc/rfc6960
- RFC 5280. Internet X.509 Public Key Infrastructure Certificate and Certificate Revocation List (CRL) Profile. — IETF, 2008. https://www.rfc-editor.org/rfc/rfc5280
- RFC 8484. DNS Queries over HTTPS (DoH). — IETF, 2018. https://www.rfc-editor.org/rfc/rfc8484
- Petroski H. To Engineer Is Human: The Role of Failure in Successful Design. — Vintage, 1992.