
Сохранность и восстановление данных
В теме 2 был сформирован офлайн-профиль узла и рассмотрены физические типы носителей — от жестких дисков до твердотельных накопителей и оптических дисков M-DISC. В теме 7 развернута автономная операционная система и выстроена цепочка доверенных обновлений, а в теме 8 запущены базовые сервисы: локальный резолвер имен, офлайн-библиотека знаний Kiwix и версионный контроль. До сих пор предполагалось, что накопитель информации исправен, файловая система находится в согласованном состоянии, а файлы, записанные вчера, будут прочитаны сегодня. В условиях автономной эксплуатации это предположение ложно.
Автономный узел функционирует в неблагоприятной физической среде: питание от нестабилизированной шины постоянного тока или генератора (темы 3 и 5) чревато внезапными отключениями под нагрузкой; перепады температур и влажность ускоряют деградацию электронных компонентов; отсутствие запасных деталей исключает оперативную замену вышедшего из строя SSD или жесткого диска. При этом потеря данных в изоляции носит необратимый характер: здесь нет облачного хранилища, из которого можно заново загрузить репозиторий, и нет службы технической поддержки производителя.
В этой теме решаются три взаимосвязанные инженерные задачи. Во-первых, построение модели отказов данных: от механического износа и тихой порчи секторов до повреждения метаданных файловой системы и непреднамеренных ошибок оператора. Во-вторых, организация циклического резервного копирования с дедупликацией, шифрованием и обязательной процедурой инструментальной верификации архивов. В-третьих, освоение процедур низкоуровневого восстановления поврежденных накопителей: посекторное спасение через карту проходов ddrescue, реконструкция разметки диска, задействование резервных суперблоков ext4 и защита криптографических заголовков LUKS2.
Модель угроз и отказов данных
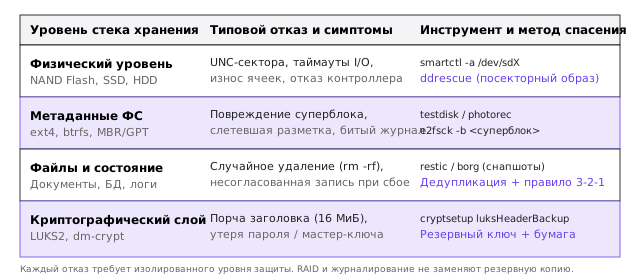
Механические и электронные отказы накопителей
Любой накопитель информации представляет собой совокупность механических узлов, полупроводниковых структур и микроконтроллера, исполняющего внутреннюю микропрограмму (прошивку, англ. firmware) 1. Отказ накопителя может произойти на каждом из этих слоев.
В магнитных жестких дисках (англ. Hard Disk Drive, HDD) механические дефекты вызваны износом подшипников шпинделя или повреждением блока магнитных головок (англ. Head Stack Assembly, HSA). При внезапном падении ноутбука во время записи вращающегося диска головка, летящая над пластиной на высоте в единицы нанометров, соприкасается с магнитной поверхностью. Происходит физический запил пластины (англ. head crash), приводящий к лавинообразному истиранию магнитного слоя и физическому уничтожению данных в зоне соударения 2. Электронная плата HDD (англ. Printed Circuit Board, PCB) уязвима к броскам напряжения: при аварии бортовой шины питания (тема 3) защитные TVS-диоды (англ. Transient Voltage Suppressor) пробиваются накоротко, предотвращая возгорание микросхем, но блокируя запуск накопителя.
В твердотельных накопителях (англ. Solid-State Drive, SSD) и картах microSD отсутствуют подвижные механические части, однако проявляются специфические физические ограничения полупроводниковой структуры NAND Flash 3. Хранение информации основано на удержании электрического заряда в плавающем затворе (англ. floating gate) или нитридной ловушке (англ. charge trap) транзистора. Изолирующий диэлектрический слой туннельного оксида деградирует с каждым циклом программирования и стирания (англ. Program/Erase cycle, P/E cycle). У многоуровневых ячеек TLC и QLC ресурс меньше, чем у SLC и MLC; для конкретного накопителя он задаётся в паспорте как допустимый объём записи (TBW) 3.
Второе фундаментальное ограничение Flash-памяти в условиях изоляции — деградация заряда при хранении в обесточенном состоянии (англ. data retention). Утечка заряда ускоряется с ростом температуры (модель Аррениуса) и с износом ячеек. Нормативная точка отсчёта — стандарт JEDEC JESD218: клиентский SSD, выработавший заявленный ресурс записи, должен сохранять данные без питания 1 год при +30 °C (C-09-07: 1 год) 13. Это требование к изношенному накопителю на границе ресурса; у нового накопителя запас больше, при хранении в тепле — меньше. Для автономного узла вывод прямой: SSD и флеш-карты, лежащие без питания как третья копия, раз в несколько месяцев подключают и полностью перечитывают (restic check --read-data или сверка SHA-256), чтобы контроллер обновил ослабевшие ячейки.
Логическая порча файловых систем и сбои питания
Даже при полностью исправном физическом носителе данные могут быть утрачены вследствие разрушения логической структуры файловой системы (ФС). Основной источник такой порчи в автономных системах — внезапное аварийное отключение электропитания (англ. power-cut event) в момент дисковой активности 4.
Операционная система не сбрасывает данные на носитель мгновенно: в целях оптимизации производительности ядро Linux кэширует операции записи в оперативной памяти (страничный кэш, англ. page cache), сбрасывая их пачками по таймауту фонового демона kworker (параметры dirty_expire_centisecs и dirty_writeback_centisecs). Если питание исчезает в момент, когда изменены таблицы размещения файлов, но сами блоки данных еще не записаны на диск, файловая система оказывается в несогласованном состоянии.
Современные файловые системы (ext4, XFS) используют механизм журналирования (англ. journaling). Перед внесением изменений в основные метаданные ядро записывает атомарную транзакцию в специальную область — журнал (в ext4 за это отвечает подсистема JBD2 — Journaling Block Device) 4. Интервал фиксации транзакций JBD2 в ядре Linux по умолчанию составляет 5 с (опция монтирования commit=5, утверждение C-09-01 [Ц]), что определяет окно уязвимости незафиксированных изменений при внезапном сбросе питания. Если система обесточивается во время транзакции, при следующем монтировании журнал воспроизводится (англ. journal replay), откатывая незавершенные операции. Однако журналирование защищает исключительно целостность метаданных (при стандартном режиме data=ordered), но не защищает содержимое самих файлов: открытый файл, в который производилась запись, может оказаться заполнен нулевыми байтами или содержать фрагменты старых блоков.
Более того, контроллеры потребительских дисков SSD и накопителей USB/microSD в целях поддержания высокой паспортной скорости подтверждают операционной системе выполнение системного вызова flush (fsync) до того, как заряд ячеек Flash физически зафиксирован в энергонезависимых массивах. При пропадании шины 12/5 В суперконденсаторы, обеспечивающие аварийный сброс буфера (англ. Power Loss Protection, PLP), присутствуют только в дорогостоящих серверных SSD; потребительские накопители при резком обесточивании теряют данные из внутренней DRAM контроллера, что приводит к повреждению внутренних таблиц трансляции адресов LBA-в-Flash (Flash Translation Layer, FTL). В результате SSD перестает распознаваться в BIOS либо отображает нулевую емкость 3.
Скрытая деградация секторов и лимиты износа flash-памяти
Коварная форма повреждения информации — так называемая тихая порча данных (англ. silent data corruption или bit rot) 5. Это явление выражается в спонтанном изменении значений отдельных бит в секторе накопителя без генерации ошибки со стороны контроллера в момент чтения или записи.
Причины тихой порчи:
- Фоновая радиация и космические лучи, вызывающие переброс заряда в ячейках DRAM кэша накопителя или ячейках Flash.
- Дефекты чтения соседних дорожек магнитных дисков (англ. track crosstalk) или перетекание заряда между соседними изолированными затворами в ячейках 3D NAND (англ. read disturb).
- Ошибки прошивки контроллера при фоновом уплотнении блоков (англ. garbage collection).
При чтении сектора с битыми битами контроллер задействует алгоритмы помехоустойчивого кодирования (ECC — коды Рида-Соломона или LDPC). Если число ошибочных бит в секторе превышает корректирующую способность кода (у LDPC в современных SSD она зависит от конкретного контроллера и не публикуется в общем виде), контроллер возвращает ошибку ввода-вывода (англ. Uncorrectable ECC error, UNC sector). Если же ошибка попадает в редкую категорию ложного декодирования (англ. miscorrection), контроллер выдает поврежденные данные как валидные. Традиционные файловые системы (ext4, XFS) не хранят контрольных сумм блоков данных и не способны обнаружить факт порчи прикладного файла.
Распространенное заблуждение операторов заключается в убеждении, что аппаратный или программный RAID-массив (например, зеркало RAID-1) гарантирует сохранность данных. Это не так:
- RAID защищает от механического отказа одного из дисков, но не защищает от логической порчи: если ошибка транзакции или вирус стирает файл, команда удаления мгновенно транслируется на оба диска массива.
- RAID не предотвращает распространение поврежденных метаданных.
- При тихом искажении блока на одном из дисков RAID-1 без сквозных контрольных сумм контроллер не знает, какая из двух копий истинна, и может перезаписать валидный блок поврежденным. Следовательно, отказоустойчивые массивы обеспечивают исключительно высокую доступность сервиса (англ. availability), но не заменяют регулярного резервного копирования 6.
Человеческий фактор и ошибки оператора
Ошибка человека — отдельный класс отказа, от которого не защищают ни RAID, ни контрольные суммы: команда удаления выполняется так же надёжно, как любая другая 5. Доля таких потерь в чужой статистике здесь не приводится — на автономном узле она определяется усталостью и составом группы, а не отраслевым средним. В автономном узле оператор совмещает роли системного администратора, инженера по питанию и радиста.
Типовые критические ошибки оператора:
- Выполнение деструктивных команд оболочки с повышенными привилегиями: непреднамеренное удаление рабочего каталога
rm -rf /var/log/ ..вместоrm -rf /var/log/../*, опечатка в пути к целевому блочному устройству в утилитеdd(of=/dev/sdaвместоof=/dev/sdb), форматирование рабочего раздела командойmkfs. - Некорректное извлечение внешних накопителей информации: отсоединение USB-диска или microSD без предварительного размонтирования (
umount) и синхронизации буферов ядра (sync). - Случайная перезапись криптографических заголовков при установке ОС или разметке новых дисков через
parted/fdisk. - Игнорирование предупреждений системного журнала и показателей SMART о деградации носителя до момента полной потери доступа к данным.
Защита от человеческого фактора строится не на призывах к внимательности, а на технических барьерах: монтировании архивных разделов в режиме «только чтение», отказе от постоянной работы под учетной записью root, наличии обязательных паритетных архивов (par2, тема 2) и неизменяемых (англ. append-only) репозиториев резервных копий.
Классификация критичности и приоритизация восстановления
Три категории данных автономного узла
Ресурс накопителей, объем свободной емкости и суточный запас электроэнергии на изолированном узле жестко ограничены (темы 1 и 3). Попытка непрерывно резервировать абсолютно все файлы узла приведет к быстрому исчерпанию дискового пространства и повышенному расходу аккумуляторов на дисковый ввод-вывод. Необходима строгая дифференциация информации по степени критичности.
Все данные автономного узла разделяются на три непересекающиеся категории, образующие пирамиду приоритетов защиты:
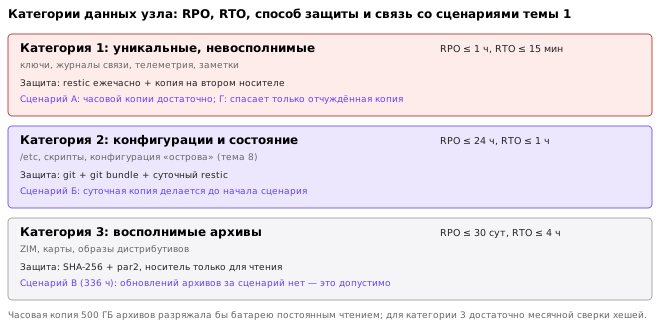
Потеря данных категории 1 необратима: они сгенерированы локально на данном узле и не могут быть восстановлены ни из каких внешних источников. Потеря Категории 2 приводит к значительному увеличению времени восстановления системы (RTO), заставляя оператора вручную перенастраивать сервисы с нуля. Данные Категории 3 имеют максимальный физический объем (десятки и сотни гигабайт), однако при необходимости могут быть запрошены по радиоканалу в виде выжимок (тема 10) либо доставлены на физическом носителе с соседнего узла (тема 2).
Назначение RTO и RPO по классам данных
Как определено в теме 1, целевое время восстановления (RTO) задаёт допустимую длительность простоя сервиса, а целевая точка восстановления (RPO) — предельно допустимый возраст потерянных данных 6. RPO категорий привязаны к сценариям темы 1: в сценарии А (4 ч, связь есть) достаточно RPO категории 1 — часовой копии; в сценарии Б (72 ч, −20 °C) суточная копия категории 2 должна быть сделана до начала сценария; в сценарии В (336 ч автономии) месячный цикл категории 3 означает, что обновления архивов за время сценария не будет вовсе, и это допустимо; в сценарии Г копии на отчуждённом носителе — единственное, что переживает потерю узла.
В таблице представлено сопоставление категорий данных с параметрами непрерывности и требуемыми стратегиями резервирования для условий длительной автономии:
| Категория данных | Типовой объем | Допустимый RPO | Целевой RTO | Механизм резервирования | Периодичность создания |
|---|---|---|---|---|---|
| Категория 1 (Уникальные) | 10–500 МБ | ≤ 1 час | ≤ 15 минут | Инкрементные снапшоты, дублирование на 2 флеш-карты | Ежечасно по таймеру systemd |
| Категория 2 (Конфигурации) | 50–200 МБ | ≤ 24 часа | ≤ 1 час | Git-репозиторий + снапшот restic | При каждом изменении / раз в сутки |
| Категория 3 (Статика/ZIM) | 100–500 ГБ | ≤ 30 суток | ≤ 4 часа | Сверка SHA-256 + паритетные файлы par2 (5 %) | Раз в месяц при ротации носителей |
Для Категории 1 минимизация RPO до 1 часа оправдана: часовой инкремент базы заметок или телеметрии занимает единицы килобайт, не создавая нагрузки на процессор и батарею. Для Категории 3 назначение RPO в 1 час привело бы к непрерывному пересчету хэшей сотен гигабайт данных, что разрядило бы аккумулятор узла за несколько часов.
Изоляция повреждения и перевод в режим «только чтение»
Первое правило инженера при обнаружении признаков порчи данных: немедленно остановить любую запись на подозрительный накопитель 7. Продолжение работы штатной ОС на поврежденном носителе гарантирует усугубление аварии: фоновые процессы ядра, ротация логов systemd-journald и временные файлы каталога /tmp начнут перезаписывать метаданные, разрушая следы удаленных файлов и структуру поврежденных каталогов.
Процедура локализации сбоя:
# 1. Срочный перевод поврежденного раздела в режим read-only
mount -o remount,ro /dev/sdb1

# 2. Если файловая система заблокирована открытыми дескрипторами процессов:
lsof +D /mnt/storage
fuser -mk /mnt/storage
umount /mnt/storage
Если размонтировать раздел стандартным способом невозможно из-за зависания системных вызовов в ядре (состояние процесса D — uninterruptible sleep), прибегают к экстренному сбросу кэша и перемонтированию всех файловых систем через интерфейс Magic SysRq (Documentation/admin-guide/sysrq.rst в исходниках ядра) 7:
# Синхронизация буферов (Sync)
echo s > /proc/sysrq-trigger

# Перевод всех смонтированных ФС в режим read-only (uMount ro)
echo u > /proc/sysrq-trigger
После перевода накопителя в режим ro физический диск отключается от питания. Дальнейшие спасательные операции производятся исключительно на стендовой машине с использованием аппаратного блокиратора записи или монтирования виртуального образа через loop-устройство с флагом -r.
Стратегии резервного копирования на изолированном узле
Полные копии, инкременты и блочные снапшоты
Существуют три классических подхода к формированию резервных копий 6 (рисунок):
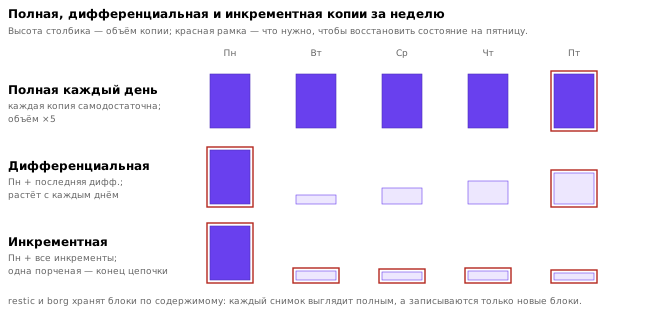
- Полная копия (англ. full backup): создание исчерпывающего слепка всех выбранных файлов. Преимущество — максимальная простота и независимость восстановления: для развертывания требуется единственный архив. Недостатки — экстремальная избыточность, длительное время выполнения и высокий расход энергии на перезапись гигабайтов неизменившихся файлов.
- Дифференциальная копия (англ. differential backup): сохранение только тех файлов, которые были созданы или изменены с момента создания последней полной копии. Объем архива растет линейно со временем, прошедшим с базового бэкапа.
- Инкрементная копия (англ. incremental backup): сохранение только тех блоков или файлов, которые изменились с момента создания предыдущей (любой) резервной копии. Объем каждого инкремента минимален. Недостаток традиционного файлового инкремента — длина цепочки восстановления: при повреждении одного промежуточного инкремента все последующие становятся нечитаемыми.
В современных автономных системах файловый инкремент вытеснен блочными снапшотами с адресацией по содержимому (англ. content-addressable storage, CAS) 8. Каждый файл разбивается на блоки; имя каждого блока вычисляется как криптографический хэш (SHA-256) от его содержимого. Если блок с таким хэшем уже присутствует в репозитории, он не сохраняется повторно. В результате каждая резервная копия логически выглядит для пользователя как полная (доступно полное дерево каталогов на конкретный момент времени), но физически на диске сохраняются только новые уникальные блоки.
Дедупликация с переменным размером блока
Примитивные алгоритмы дедупликации разбивают файлы на блоки фиксированного размера (например, 64 КБ). Этот подход терпит крах при модификации потоковых данных: если в начало файла базы данных SQLite или конфигурационного файла вставить один байт, границы всех последующих 64-килобайтных блоков сдвинутся на 1 байт. Хэш каждого блока изменится, и дедупликация не сработает — весь файл будет сохранен повторно в полном объеме.
Продвинутые утилиты (restic, borgbackup) используют дедупликацию с плавающим окном и переменным размером блока (англ. variable-size chunking) на основе хэширования Рабина или скользящего полиномиального хэша (Buzhash / CDC — Content-Defined Chunking) 8.
Алгоритм перемещает скользящее окно фиксированной ширины (например, 64 байта) по потоку данных байт за байтом, вычисляя контрольное значение полинома:
H = \sum_{i=0}^{W-1} b_i \cdot p^{W-1-i} \pmod M
Граница блока объявляется в тот момент, когда младшие k бит вычисленного хэша H равны нулю (то есть H \pmod{2^k} = 0). Вероятность совпадения составляет 1/2^k, что обеспечивает средний целевой размер блока \bar{S} = 2^k (в restic блоки имеют размер от 512 КиБ до 8 МиБ, в среднем около 1 МиБ, по описанию формата репозитория 14). При вставке байта в начало файла сдвигается граница только первого блока; как только скользящее окно доходит до следующей характерной сигнатуры содержимого, синхронизация границ блоков восстанавливается, и все последующие блоки файла совпадают с уже сохранёнными и повторно не записываются 8.
Сравнение инструментов: restic, borg, rsync
В таблице представлен сравнительный анализ утилит резервного копирования применительно к ограничениям автономного узла (одноплатные компьютеры ARM, медленные накопители USB 2.0, отсутствие сетевого демона на стороне хранилища):
| Характеристика | rsync | BorgBackup (borg) | restic |
|---|---|---|---|
| Архитектура репозитория | зеркало файлов, жёсткие ссылки (--link-dest) | сегменты с индексами | блоки с адресацией по содержимому |
| Дедупликация | нет, только целые неизменённые файлы | да, блоки переменного размера (CDC) | да, блоки переменного размера (CDC) |
| Шифрование | нет (нужен LUKS на носителе копии) | borg 1.4: AES-256-CTR + HMAC-SHA256 или BLAKE2b; borg 2.x: AES-256-OCB или ChaCha20-Poly1305 | AES-256-CTR + Poly1305-AES, всегда включено |
| Сжатие | нет (только при передаче, -z) | lz4, zstd, zlib, lzma | zstd в формате репозитория v2 (restic ≥ 0.14) |
| Работа без сервера | да | да | да; по сети — SFTP или rest-server |
| Неизменяемость на стороне хранилища | нет | borg serve --append-only | rest-server --append-only |
| Зависимости | бинарный файл на C | Python 3 и C-расширения | один статический бинарный файл на Go |
Сведения о шифровании и сжатии — по документации borg (borgbackup.readthedocs.io, раздел «Security») и restic 14. Различие версий borg существенно: репозиторий borg 2.x не читается borg 1.4, и версия инструмента записывается в паспорт копии вместе с паролем. Потребление памяти обоими инструментами растёт с числом блоков в репозитории (индекс блоков держится в памяти); для своего репозитория оно измеряется (/usr/bin/time -v restic backup …, строка «Maximum resident set size»), а не берётся из обзоров.
Вывод для автономного узла: restic удобен тем, что это один статический файл — его можно положить на тот же носитель, что и копию, и восстановить данные с живой системы без установки пакетов. Шифрование в нём не отключается, поэтому незашифрованную копию по ошибке не сделать; обратная сторона — потеря пароля означает потерю копии (раздел о ключах).
Неизменяемые репозитории и правило трёх копий в офлайне
Распространённое эмпирическое правило «3-2-1» требует три копии данных на двух разных типах носителей, одна из них — в другом месте. В автономии его приходится переводить на язык доступного:
- Копия 1 — рабочий накопитель узла.
- Копия 2 — локальный резервный носитель (внешний HDD, вторая карта памяти), подключённый постоянно или по таймеру.
- Копия 3 — отчуждаемый носитель, который после записи физически отключается и хранится в другом помещении (защита от пожара, воды, перенапряжения — тема 12), либо репозиторий на втором узле Полигона.
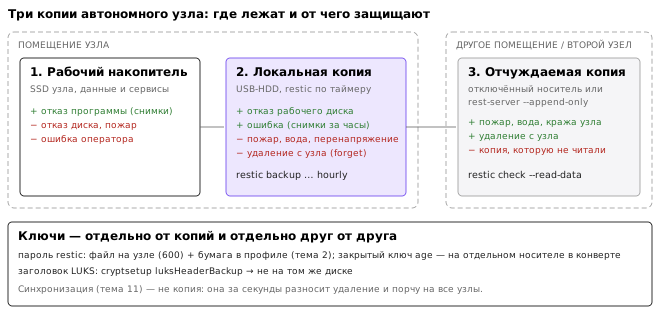
Копия, которую можно стереть с того же узла, не защищает от ошибки оператора и вредоносной программы на узле: удаление restic forget --prune с узла сотрёт и её. Защита — хранилище, которое принимает только добавление. Для restic это rest-server --append-only на другой машине: сервер принимает новые блоки и снимки, но отвергает удаление и перезапись, а очистку старых снимков выполняет администратор хранилища на самом хранилище 14. Флаг chattr +a на каталоге репозитория для этого не годится: он требует root, а restic при каждой операции создаёт и удаляет lock-файлы, поэтому с таким флагом репозиторий перестаёт работать. Опыт ЛР 9 (часть 4) проверяет, что forget --prune через append-only сервер действительно отвергается.
Переключатель защиты от записи на SD-карте — механическая метка, которую читает картридер; карта о ней не знает, и соблюдение зависит от картридера и драйвера. Для отчуждаемой копии надёжнее отключать носитель физически, а при работе с подозрительным носителем — подключать его через аппаратный блокиратор записи или монтировать только для чтения на машине восстановления.
Синхронизация — не резервная копия
Синхронизация (Syncthing, rsync --delete, тема 11) поддерживает одинаковое состояние двух мест — и потому за секунды разносит удаление или порчу файла на все узлы. Резервная копия хранит состояние на моменты времени и позволяет вернуться назад. Механизмы родственные: Syncthing тоже делит файлы на блоки и передаёт только изменённые, но блоки у него фиксированного размера, привязанные к смещению в файле, а не к содержимому, как CDC у restic и borg; вставка байта в начало файла заставляет Syncthing передать файл заново, а restic — сохранить один новый блок. Синхронизация закрывает отказ узла (данные есть на соседнем), резервная копия — ошибку человека и порчу; на автономном Полигоне нужны обе. Резервное копирование баз данных (дампы, журналы транзакций, согласованные снимки) — курс «Базы данных», тема 13; здесь — файлы и носители.
Шифрование копий и хранение ключей
Копия, которая уносится из узла, шифруется: она может быть потеряна или украдена вместе с носителем. restic и borg шифруют сами. Для отдельных файлов и архивов tar используются age (ключи X25519, один короткий файл ключа, age -r <открытый ключ> -o arch.tar.age arch.tar) или GPG (gpg --encrypt -r <ключ>). Открытым ключом шифрует узел; закрытый ключ на узле не хранится, поэтому взлом узла не раскрывает старые копии.
Ключи хранятся отдельно от копий и отдельно друг от друга: пароль restic — в файле на узле и на бумаге в профиле (тема 2), закрытый ключ age — на отдельном носителе в опечатанном конверте. Восстановление ключей — отдельный объект проектирования: при отсутствии всех копий ключа расшифровка не предполагается, и это свойство шифрования, а не недостаток процедуры. Поэтому учебное восстановление (ниже) начинается с вопроса «где ключ» и проверяет, что ключ из профиля действительно открывает копию.
Полный снимок файловой системы: zfs send и tar
Для ZFS и Btrfs резервная копия может быть снимком всей файловой системы: zfs snapshot pool/data@d1, затем zfs send pool/data@d1 > /mnt/backup/data-d1.zfs (полный) или zfs send -i @d1 pool/data@d2 (приращение между снимками); на другой машине поток принимается zfs receive. Аналог в Btrfs — btrfs send/btrfs receive. Преимущество — согласованное состояние на один момент времени и скорость; недостаток — поток читается только той же файловой системой, а повреждение одного байта в файле потока делает его непринимаемым целиком, поэтому такие файлы хранят с par2 (тема 2). Самый переносимый формат — tar (с --xattrs --acls, если нужны права и атрибуты): он читается любой системой десятилетиями, но не дедуплицирует и не шифрует сам.
Процедура верификации и учебное восстановление
Принцип непроверенного бэкапа
Фундаментальная аксиома теории надежности систем хранения формулируется категорично: резервная копия, восстановление из которой не было успешно проверено на чистом стенде, не существует в природе 6.
Попытка опереться на факт успешного завершения команды restic backup без регулярной пробной распаковки данных приводит к катастрофическим последствиям:
- Ключ шифрования может быть утерян или поврежден, делая расшифровку невозможной.
- Файлы баз данных могут быть скопированы в момент незавершенной транзакции (грязное чтение), в результате чего поднятая СУБД откажется открывать поврежденный файл
.db. - Резервный носитель может иметь скрытые повреждения секторов в области хранения свежих снапшотов.
- Конфигурационные файлы могут восстанавливаться с нарушенными правами доступа (
chmod 777или смена владельца сuid 0наuid 1000), из-за чего сервис не запустится.
Контрольные суммы, паритет и аудит репозитория
Верификация резервного хранилища подразделяется на структурную проверку целостности архива и поблочное контрольное чтение данных 8.
В restic регулярный аудит выполняется двухэтапно:
# Этап 1: структурная проверка индексов и деревьев снимков (секунды)
restic check --repo /mnt/backup_drive/repo

# Этап 2: чтение и проверка SHA-256 части блоков данных: n-я десятая часть
restic check --repo /mnt/backup_drive/repo --read-data-subset=3/10
Ключ --read-data-subset=n/10 проверяет n-ю из десяти фиксированных частей репозитория; если таймер при каждом запуске берёт следующую часть, за 10 запусков прочитан весь репозиторий 14. Вариант с процентом (--read-data-subset=10%) выбирает части случайно и полного обхода за 10 запусков не гарантирует. Для репозитория 50 ГБ на носителе со скоростью 80 МБ/с один запуск читает 5 ГБ и занимает 0,017 ч, около минуты (C-09-10: 0,017 ч; расчёт storage.py), — это нагрузка, которую можно планировать по энергобалансу темы 3, а не «пиковая».
Для монолитных файлов (образы ОС, ZIM-архивы) копии дополняются кодами Рида — Соломона утилитой par2 (тема 2). Арифметика par2 (par2cmdline 0.8): файл делится на 2000 исходных блоков, каждый блок восстановления заменяет один любой повреждённый исходный блок. Для файла 10 МБ при избыточности 5 % блок равен 5000 байт, и создаётся 100 блоков восстановления (C-09-08: 100 блоков; расчёт storage.py). Гарантированно исправим непрерывный повреждённый участок длиной до (100 − 1) · 5000 + 1 = 495 001 байт; участок длиннее при неудачном выравнивании задевает 101 блок и уже не исправим. Опыт «повреждение сверх паритета» — ЛР 2.
# Создание 5% паритета для аварийного архива
par2create -r5 -n1 emergency_archive.tar.gz.par2 emergency_archive.tar.gz

# Верификация и восстановление поврежденного файла
par2repair emergency_archive.tar.gz.par2
Регламент учебного восстановления (restore drill)
Учебное восстановление (англ. restore drill) — обязательная регулярная инженерная процедура, проводимая оператором по расписанию (раз в квартал в сценарии длительной автономии, тема 13) 6.
Цель учения — замерить фактический хронометраж полного восстановления узла «на холодную» и подтвердить выполнимость требований RTO.
Регламент проведения тренировки:
- Развертывание в чистой виртуальной машине QEMU или в изолированном сетевом пространстве имен
unshare -rnm(без доступа к рабочей системе). - Монтирование резервного репозитория
restic. - Выполнение команды полного восстановления целевого снапшота:
restic restore latest --repo /mnt/backup_drive/repo --target /tmp/drill_root - Запуск проверочного скрипта валидации контрольных сумм:
sha256sum -c reference.sha256. - Тестовый запуск ключевых демонов (
unbound,dnsmasq, HTTP-сервер Kiwix) внутри изолированного корня черезchrootс проверкой генерации валидных ответов на сетевые запросы. - Фиксация результатов тренировки в журнале обслуживания узла: дата, идентификатор снапшота, затраченное время (минуты), объем восстановленных байт, подпись оператора.
Журнал ведётся и для неуспешных восстановлений, и они в нём важнее успешных. Каждая запись: дата, что восстанавливали, из какой копии, на каком шаге остановились, причина (нет ключа, копия не читается, восстановленный сервис не стартует из-за отсутствующего файла вне копии) и что изменено в процедуре. Неуспешное учебное восстановление — найденная ошибка в схеме копирования, обнаруженная тогда, когда её ещё можно исправить; запись о ней превращается в пункт регламента. Журнал хранится рядом с регламентом в профиле узла (тема 2) и пересматривается на учениях (тема 13).
Низкоуровневая диагностика и восстановление носителей
Диагностика SMART и скрытые дефекты
Технология самоконтроля, анализа и отчетности (англ. Self-Monitoring, Analysis and Reporting Technology, SMART) встроена в контроллеры всех современных жестких дисков и SSD 1. Опрос регистров SMART утилитой smartctl пакета smartmontools позволяет зафиксировать деградацию носителя задолго до того, как он полностью перестанет определяться операционной системой.
Команда полного считывания журнала SMART:
smartctl -a /dev/sdb
В выводе утилиты критическое значение имеют пять нормализованных атрибутов HDD:
ID# ATTRIBUTE_NAME          FLAG     VALUE WORST THRESH TYPE      RAW_VALUE
  5 Reallocated_Sector_Ct   0x0033   100   100   010    Pre-fail  0
187 Reported_Uncorrect      0x0032   100   100   000    Old_age   0
196 Reallocated_Event_Count 0x0032   100   100   000    Old_age   0
197 Current_Pending_Sector  0x0012   100   100   000    Old_age   12
198 Offline_Uncorrectable   0x0010   100   100   000    Old_age   12
Интерпретация критических счетчиков:
5 (Reallocated_Sector_Ct): количество секторов, признанных дефектными и переназначенных во внутреннюю резервную дорожку (англ. spare area). Если RAW_VALUE больше нуля, поверхность пластины начала разрушаться.197 (Current_Pending_Sector): «сектора-кандидаты» — нестабильные блоки, ожидающие переназначения после неудачной попытки чтения. При чтении такого сектора контроллер диска зависает на 5–30 секунд, пытаясь применить многократные повторы чтения с микрошаговым смещением позиционера магнитных головок.198 (Offline_Uncorrectable): число секторов, чтение которых завершилось фатальной нескорректированной ошибкой при фоновом сканировании поверхности.
Для SSD первостепенными метриками являются 05 (Reallocated Flash Blocks), 177 (Wear Range Delta) и 231 (SSD Life Left): если процент оставшегося ресурса приближается к нулю, ячейки теряют способность удерживать заряд, и накопитель подлежит немедленному выводу из эксплуатации.
Посекторное копирование ddrescue и карта mapfile
Когда диск начинает возвращать ошибки чтения (UNC) и зависать по тайм-аутам шины, обычные программы копирования не годятся 9. cp останавливается на первой ошибке. dd conv=noerror,sync продолжает, но читает по порядку и каждый сбойный сектор пробует столько раз, сколько повторит ядро, — накопитель тратит время на зоны, где данных уже не получить, вместо того чтобы сначала забрать исправное.
GNU ddrescue решает эту задачу иначе: читает сначала то, что читается легко, а к сбойным зонам возвращается потом, и ведёт карту (англ. mapfile), где для каждого участка записан его статус. Карта позволяет прервать работу (накопитель отвалился, кончилась энергия) и продолжить с того же места той же командой.
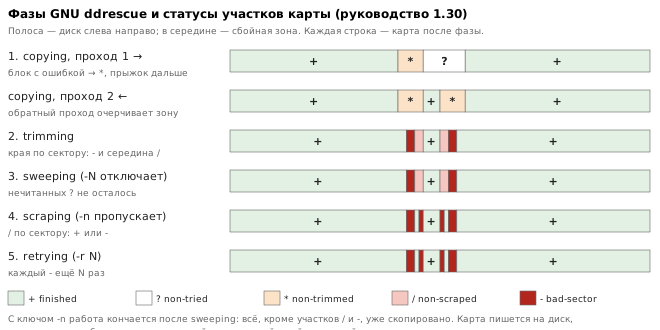
По руководству GNU ddrescue 1.30 (раздел «Algorithm») работа идёт в пять фаз 9:
- Копирование (copying). До четырёх проходов крупными блоками по нечитанным участкам (
?, non-tried). Блок, при чтении которого произошла ошибка, помечается*(non-trimmed, «края не обрезаны»), и ddrescue перескакивает дальше. Второй проход идёт в обратном направлении и очерчивает пропущенные участки с другой стороны. Цель фазы — быстро забрать основную массу исправных данных. - Обрезка (trimming). Для каждого блока
*ddrescue читает по одному сектору от переднего края, пока не встретит сбойный, затем так же от заднего края. Найденные сбойные сектора получают статус-(bad-sector), середина блока —/(non-scraped). - Прочёсывание (sweeping). Нечитанные участки, пропущенные при копировании, читаются без пропусков. Отключается ключом
-N(--no-sweep). - Выскабливание (scraping). Каждый блок
/читается по одному сектору вперёд; несчитанные сектора становятся-. Фаза пропускается ключом-n(--no-scrape) — именно это, а не «копирование без деления блоков», означает-n. - Повторы (retrying). Только если задан
-r N(--retry-passes): каждый сектор-пробуется ещё N раз, направление меняется после каждого прохода.
Прочитанные участки получают статус + (finished). Первая содержательная строка карты — статус всей работы: позиция, текущая фаза (? копирование, * обрезка, % прочёсывание, / выскабливание, - повторы, + готово) и номер прохода. Каждый сектор, по руководству, пробуется не больше двух раз до фазы повторов: в составе крупного блока и затем поодиночке.
Типовой порядок работы с неисправным диском — два запуска с одной картой:
# 1. Забрать исправное быстро: без выскабливания
ddrescue -d -n /dev/sdb rescued.img rescue.map
# 2. Если время и состояние диска позволяют: выскабливание и три прохода повторов
ddrescue -d -r3 /dev/sdb rescued.img rescue.map
Ключ -d (прямой доступ, мимо кэша ядра) нужен на настоящем блочном устройстве; на файле-образе он не применяется. Неисправный диск при этом подключается только для чтения и только к машине восстановления; всё дальнейшее делается с образом.
Числовой пример: время снятия образа
Оценим время снятия образа с диска 500 ГБ при скорости чтения 80 МБ/с и 120 сбойных секторах, собранных в 10 зон по 12 секторов. Каждая неудачная попытка чтения стоит 7 с — столько накопитель с настройкой SCT ERC 70 (так smartctl(8) описывает типичное значение для RAID) пытается прочитать сектор, прежде чем вернуть ошибку; у настольного диска без ERC эта величина больше и задаётся прошивкой.
Исправная поверхность читается за T = V / S = 500 · 10⁹ / 80 · 10⁶ = 6250 с, то есть 1,74 ч (C-09-02: 1,74 ч; расчёт storage.py). Добавку на сбойных зонах storage.py считает по фазам ddrescue:
| Фаза | Неудачных чтений | Добавка, с |
|---|---|---|
| копирование: по одному сбою на зону вперёд и назад | 20 | 140 |
| обрезка: по одному сбою с каждого края зоны | 20 | 140 |
| выскабливание: оставшиеся сектора зон | 100 | 700 |
повторы -r3: 120 секторов × 3 | 360 | 2520 |
С ключом -n работа заканчивается после обрезки: 6250 + 140 + 140 = 6530 с, или 1,81 ч (C-09-03: 1,81 ч), и при этом скопировано всё, кроме 120 · 512 = 61 440 байт сбойных зон. Полный проход с выскабливанием и тремя повторами — 9750 с, 2,71 ч (C-09-04: 2,71 ч): последние 0,9 ч тратятся на эти 60 КБ. Для сравнения, dd bs=512 conv=noerror читает сбойные сектора по порядку, и ядро на каждый делает до пяти повторов (SD_MAX_RETRIES в drivers/scsi/sd.h); добавка — 5040 с (C-09-05: 5040 с), причём исправные данные за сбойной зоной dd получает только после неё.
Вывод для автономного узла: если энергии или ресурса диска хватает на два часа, первый запуск с -n забирает практически всё за 1,81 ч, а решение тратить ли ещё 0,9 ч на 60 КБ принимается отдельно, зная, какие файлы в этих секторах лежат (ЛР 9, часть 2).
Восстановление таблиц разделов и поиск файлов по сигнатурам
После того как образ снят, работа ведётся только с образом, а исходный носитель отключается. Описанные ниже инструменты восстанавливают данные только на своих носителях или с разрешения владельца: для чужого носителя это уже извлечение чужих данных.
Если разрушена таблица разделов (MBR или GPT), ядро не видит границ файловых систем, хотя сами они целы. Порядок действий — от простого к сложному.
- Резервная копия таблицы. Если она сделана заранее (
sfdisk --dump /dev/sdb > table.dump, для GPT —sgdisk --backup=table.gpt /dev/sdb), таблица возвращается одной командой:sfdisk /dev/sdb < table.dumpилиsgdisk --load-backup=table.gpt /dev/sdb. Копия таблиц разделов всех дисков узла — часть профиля (тема 2); она занимает сотни байт. - Вторая копия GPT. GPT хранит копию заголовка и таблицы в последних секторах диска; при порче начала
sgdisk -eиgdisk(команда восстановленияb/c) восстанавливают основную копию из резервной. Таблица MBR такой копии не имеет. - Поиск разделов по сигнатурам.
testdiskсканирует образ и ищет начала файловых систем по характерным признакам: у ext2/3/4 — суперблок с «магическим числом» 0xEF53 по смещению 56 от начала суперблока, то есть 1080 байт от начала раздела; у FAT и NTFS — загрузочный сектор 10. Найдя раздел, он предлагает записать таблицу обратно. В ЛР 9 тот же принцип показан коротким скриптомfind_ext.py: он находит основной и резервные суперблоки и по номеру группы в резервной копии вычисляет начало раздела.
testdisk /log rescued.img          # интерактивно: Analyse → Quick Search → Write
python3 find_ext.py rescued.img    # ЛР 9: суперблоки и вероятное начало раздела
Если файловая система разрушена полностью (затёрты все копии суперблока или таблица инодов), применяется поиск файлов по сигнатурам (англ. file carving) программой photorec 10. Метаданные ФС не используются: в «сыром» образе ищутся заголовки известных форматов — %PDF-, FF D8 FF у JPEG, 89 50 4E 47 0D 0A 1A 0A у PNG, PK\x03\x04 у ZIP — и по структуре формата определяется конец файла. У этого метода два ограничения: имена и каталоги теряются (файлы называются по номеру сектора), а фрагментированный файл восстанавливается только до первого разрыва. В ЛР 9 скрипт carve_png.py делает то же для одного формата и показывает, что PNG извлекается из образа, в котором e2fsck уже ничего не может сделать.
Ремонт файловых систем ext4 и резервные суперблоки
Файловая система ext4 разбивает пространство раздела на группы блоков (англ. block groups) 4. В начале первой группы (Group 0) с фиксированным смещением 1024 байта от старта раздела расположен первичный суперблок (англ. Primary Superblock). Суперблок содержит критические параметры ФС: общее число блоков и inode, размер блока (1024, 2048 или 4096 байт), состояние флагов монтирования и контрольные суммы метаданных.
При повреждении первых секторов раздела монтирование невозможно:
mount: /mnt: wrong fs type, bad option, bad superblock on /dev/loop0, missing codepage or helper program, or other error.
Однако ext4 хранит копии суперблока в начале групп 1 и групп с номерами — степенями 3, 5 и 7 (свойство sparse_super) 4. Номера блоков с копиями показывает mke2fs -n с теми же параметрами, что при создании ФС (ключ -n ничего не записывает), или dumpe2fs, если основной суперблок ещё читается. Для раздела с блоком 1 КиБ, как в ЛР 9, копии лежат в блоках 8193, 24577, 40961, 57345 (C-09-06: 8193; расчёт storage.py); для блока 4 КиБ первая копия — в блоке 32768:
mke2fs -n -b 1024 part.img # ничего не пишет, только печатает разметку
Superblock backups stored on blocks:
	8193, 24577, 40961, 57345
Починка по резервной копии:
e2fsck -fy -b 8193 -B 1024 part.img
Ключ -b задаёт блок с копией суперблока, -B — размер блока (без него e2fsck перебирает размеры сам). Файлы, потерявшие запись в каталоге, переносятся в lost+found с именами по номеру инода. Опыт ЛР 9 показывает и границу метода: если затёрт не только суперблок, а весь первый мегабайт раздела, e2fsck восстанавливает структуру ФС, но иноды группы 0 потеряны вместе с содержимым таблицы инодов, и файлы приходится искать по сигнатурам.
Другие файловые системы и диагностика поверхности
Для других файловых систем порядок тот же — сначала образ, потом инструмент починки, — меняются только команды. XFS чинится xfs_repair (с -n — только проверка; при повреждённом журнале -L обнуляет журнал, теряя последние изменения). Btrfs хранит несколько копий суперблока и контрольные суммы данных: btrfs rescue super-recover восстанавливает суперблок из копии, btrfs restore вытаскивает файлы с несобирающейся ФС на другой носитель, btrfs scrub на живой ФС находит тихую порчу. Пул ZFS, перенесённый на другую машину, подключается zpool import (с -o readonly=on — без записи), а zpool scrub проверяет контрольные суммы всех блоков. Поверхность HDD проверяется badblocks в режиме только чтения (badblocks -sv /dev/sdb, без -w, который стирает данные); на SSD эта проверка мало что даёт, состояние видно в SMART.
Криптографическая защита томов и управление ключами
Архитектура LUKS2 и уязвимость заголовка
Шифрование накопителей на изолированном узле — обязательная мера защиты информации от компрометации в случае кражи или изъятия оборудования 11. Стандартом шифрования блочных устройств в Linux является спецификация LUKS (англ. Linux Unified Key Setup), реализованная в подсистеме dm-crypt.
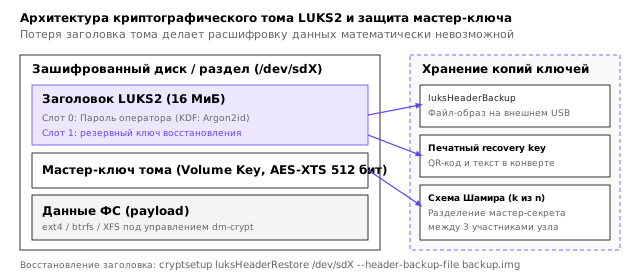
В современной редакции LUKS2 шифрование организовано по двухуровневой схеме:
Пароль оператора (Passphrase) / Ключевой файл (Keyfile)
               │
               ▼ (Криптографическая функция KDF: Argon2id)
       Разблокировка одного из 32 слотов (Keyslot)
               │
               ▼ (Расшифровка метаданных)
       Мастер-ключ тома (Volume Key, 512-бит AES-XTS)
               │
               ▼ (Прозрачное посекторное шифрование dm-crypt)
       Сектора файловой системы (/dev/mapper/cryptroot)
Мастер-ключ тома (англ. Volume Key) генерируется генератором случайных чисел ядра один раз при создании тома и никогда не меняется. Пользовательский пароль не шифрует сам диск: пароль используется исключительно для расшифровки мастер-ключа, хранящегося в одном из 32 доступных слотов заголовка 11. Хэширование пароля выполняется алгоритмом Argon2id, требующим значительных затрат оперативной памяти (до 1 ГБ) и времени ЦП, что предотвращает атаки аппаратного перебора на GPU/ASIC.
У этой архитектуры есть фундаментальная критическая уязвимость: заголовок LUKS2 имеет фиксированный физический размер (стандартно 16 МБ) и расположен в самом начале блочного устройства.
Если в результате сбоя питания, повреждения первых секторов Flash-накопителя или ошибки оператора (dd if=/dev/zero of=/dev/sda bs=1M count=16) первые 16 мегабайт диска затираются — расшифровка данных математически невозможна 11. Оговорка для LUKS2: двоичный заголовок и область метаданных JSON записаны в нём дважды (основная и вторичная копии), поэтому порча первых килобайт исправляется автоматически при открытии тома; но область слотов ключей хранится в одном экземпляре, и её потеря необратима без внешней копии, сделанной cryptsetup luksHeaderBackup 11. Данные полезной нагрузки (англ. payload) остаются зашифрованными на случайном симметричном ключе AES, который более не существует во вселенной. Никакие методы карвинга или низкоуровневого анализа не способны извлечь ни единого байта из такого раздела.
Резервное копирование заголовка LUKS
Из необратимости потери заголовка LUKS2 следует проектное правило: создание резервной копии заголовка тома обязательно сразу после инициализации шифрованного устройства 11.
Создание резервной копии заголовка:
cryptsetup luksHeaderBackup /dev/sdb2 --header-backup-file /mnt/external_safe/luks_header_node09.bin
Восстановление поврежденного заголовка из архивного файла:
cryptsetup luksHeaderRestore /dev/sdb2 --header-backup-file /mnt/external_safe/luks_header_node09.bin
Резервный файл заголовка содержит мастер-ключ тома (зашифрованный паролями активных слотов). Компрометация файла luks_header_node09.bin эквивалентна компрометации самого зашифрованного диска: получив этот файл, злоумышленник может запустить офлайн-перебор пароля на высокопроизводительном кластере. Поэтому резервные копии заголовков LUKS хранятся с тем же уровнем физической изоляции, что и сами мастер-пароли.
Схема разделения секрета и бумажные ключи
Второй критический вектор отказа — человеческая память. В условиях стресса, длительной изоляции или выбывания ключевого оператора знание мастер-пароля может быть утрачено.
Для предотвращения этой единой точки отказа (SPOF, тема 1) применяются два инструмента:
-
Резервные ключи восстановления (Recovery Keys): в один из свободных слотов LUKS2 (например, Keyslot 1) добавляется криптографически стойкий алфавитно-цифровой ключ высокой энтропии (256 бит, 64 символа):
# Генерация случайного ключа восстановления и добавление в свободный слот
openssl rand -hex 32 > recovery_key.txt
cryptsetup luksAddKey /dev/sdb2 recovery_key.txt
Этот ключ распечатывается на бумажном носителе в виде текстовой строки и QR-кода, упаковывается в физически опечатанный свето-влагозащитный конверт и помещается в сейф узла (печатная часть профиля, тема 2). Бумага не подвержена сбоям прошивки контроллеров и сохраняет читаемость десятилетиями.
-
Схема разделения секрета Шамира (англ. Shamir's Secret Sharing, SSS): математический алгоритм, позволяющий разделить секрет (мастер-пароль или файл ключа) на N частей (долей) таким образом, что восстановить исходный секрет можно только при объединении любых K частей (K \le N, так называемая пороговая схема (K, N)) 12. Любые K-1 частей не дают злоумышленнику абсолютно никакой информации о секрете (информационно-теоретическая стойкость).
Пример реализации для автономного коллектива из 3 операторов по схеме (2 из 3) с использованием утилиты ssss-split:
- Оператор А получает Долю 1.
- Оператор Б получает Долю 2.
- Оператор В получает Долю 3. Для расшифровки корневого накопителя узла после аварии достаточно присутствия любых двух операторов из трех. Гибель или предательство одного участника не блокирует доступ к системе и не раскрывает мастер-ключ досрочно.
Что эта модель не учитывает
- Модель не учитывает тяжелые механические повреждения магнитных дисков (заклинивание гидродинамического подшипника шпинделя, обрыв катушки позиционера головок, царапины на магнитных пластинах). Устранение таких неисправностей требует ламинарного бокса чистой зоны (Cleanroom Class 100), донорского накопителя идентичной ревизии и прецизионного съемника магнитных головок, что выходит за рамки возможностей автономного узла.
- Модель не учитывает электрический пробой NAND Flash памяти, при котором высоковольтный импульс разрушает изолирующие оксидные переходы элементарных ячеек кристалла, уничтожая квантовое состояние сохраненного заряда.
- Модель не учитывает аппаратные программные блокировки прошивки SSD («кирпич» контроллера, вход в safe-mode ROM с кодом ошибки Silicon Motion или Phison), требующие перевода микросхемы в тестовый режим (testpoint) и технологических утилит заводской прошивки.
- Модель предполагает добросовестность операционной системы и криптографических библиотек в отношении атак по сторонним каналам (англ. side-channel attacks — анализ потребления тока шины питания процессора при вычислении раундовых ключей AES в ОЗУ).
Итоги темы
Сохранность данных в условиях автономного функционирования не гарантируется надежностью оборудования. Любой накопитель — механический, твердотельный или оптический — неизбежно деградирует во времени под воздействием сбоев электропитания, термических циклических нагрузок и скрытого разрушения полупроводниковых структур. Построение системы хранения без расчета на катастрофический отказ носителя является архитектурной ошибкой проектирования.
Основная защита от потери информации — несколько копий в разных местах по адаптированному правилу трёх копий, из которых хотя бы одна недоступна для удаления с самого узла (rest-server --append-only) и хотя бы одна физически отключена. Разделение данных по трем уровням критичности с минимизацией RPO для уникальных файлов позволяет удержать объем резервных архивов и расход энергии на их генерацию в пределах допустимого баланса автономного узла. Дедупликация на основе плавающего окна в утилите restic обеспечивает компактность репозитория, а сквозное шифрование исключает утечку данных при физической утрате накопителя.
Непроверенная резервная копия — не копия, а предположение; неуспешные учебные восстановления записываются в журнал наравне с успешными. Регулярная процедура учебного развертывания сервисов из архивных снапшотов на чистых стендовых машинах — обязательный технологический регламент узла, подтверждающий фактическую реализуемость параметров целевого времени восстановления (RTO).
При наступлении физической аварии носителя порядок действий начинается с немедленной изоляции устройства, переводе в режим «только чтение» и снятии посекторного образа утилитой ddrescue с картой (mapfile): сначала с -n, чтобы быстро забрать исправное, затем, если позволяют время и энергия, с выскабливанием и повторами. Все последующие восстановительные манипуляции — от починки суперблоков e2fsck до сборки таблиц разделов в testdisk — производятся исключительно над копией образа. При этом наличие заблаговременно сохраненного заголовка LUKS2 и бумажной копии ключа восстановления разделяет безопасность и доступность, не допуская превращения шифрования в причину безвозвратной гибели данных.
Литература
- Schroeder B., Lagisetty R., Merchant A. Flash Reliability in Production: The Expected and the Unexpected // 14th USENIX Conference on File and Storage Technologies (FAST '16). — USENIX Association, 2016.
- Schroeder B., Gibson G. A. Disk failures in the real world: What does an MTTF of 1,000,000 hours mean to you? // 5th USENIX Conference on File and Storage Technologies (FAST '07). — USENIX Association, 2007.
- Cai Y., Haratsch E. F., Mutlu O., Mai K. Error Characterization, Mitigation, and Recovery in Flash-Memory-Based Solid-State Drives // Proceedings of the IEEE. — 2017. — Vol. 105, No. 9. — P. 1666–1704.
- The Linux Kernel documentation: ext4 Data Structures and Algorithms; ext4 General Information (Documentation/filesystems/ext4/, Documentation/admin-guide/ext4.rst). https://docs.kernel.org/filesystems/ext4/
- Keeton K., Santos C., Beyer D., Chase J., Wilkes J. Designing for Disasters // 3rd USENIX Conference on File and Storage Technologies (FAST '04). — USENIX Association, 2004.
- NIST Special Publication 800-34 Rev. 1. Contingency Planning Guide for Federal Information Systems. — National Institute of Standards and Technology, 2010. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Linux Magic System Request Key Hacks. Documentation/admin-guide/sysrq.rst. https://docs.kernel.org/admin-guide/sysrq.html
- Muthitacharoen A., Chen B., Mazières D. A Low-bandwidth Network File System // SOSP '01: Proceedings of the 18th ACM Symposium on Operating Systems Principles. — ACM, 2001.
- Diaz Diaz A. GNU ddrescue Manual. Version 1.30. — Free Software Foundation, 2026. https://www.gnu.org/software/ddrescue/manual/ddrescue_manual.html
- Grenier C. TestDisk & PhotoRec documentation. — CGSecurity. https://www.cgsecurity.org/wiki/TestDisk
- Fruhwirth C., Brož M. LUKS2 On-Disk Format Specification. https://gitlab.com/cryptsetup/LUKS2-docs
- Shamir A. How to share a secret // Communications of the ACM. — 1979. — Vol. 22, No. 11. — P. 612–613.
- JEDEC JESD218. Solid-State Drive (SSD) Requirements and Endurance Test Method. — JEDEC Solid State Technology Association.
- restic Documentation; rest-server README. https://restic.readthedocs.io/ ; https://github.com/restic/rest-server