
Частотный взлом: от Цезаря до Виженера
Криптоанализ начинается не с математики, а с вопроса: что именно знает противник и чего он не знает. В основном курсе шифр рассматривался как механизм, который при правильном ключе скрывает сообщение; здесь тот же механизм рассматривается как источник утечек. Цезарь и Виженер удобны как полигон 1: они полностью ломаются статистикой, и на них видно все приёмы, которые позже, в усложнённом виде, применяются к реальным системам — оценка кандидатов, поиск длины ключа, разделение задачи на независимые подзадачи и проверка гипотезы по избыточности языка.
Тема опирается на тему 1 основного курса (классические шифры и принцип Керкгоффса) и готовит тему 2 (модели атак и вычислительная стойкость): именно здесь появляются количественные критерии «насколько текст похож на язык» и «сколько текста нужно, чтобы ключ определялся однозначно». Все примеры можно воспроизвести на данных из окружения лабораторной работы.
Криптоанализ как инженерная задача
Что известно противнику
Криптоаналитик почти никогда не начинает с пустого места. Ему известен алгоритм, формат сообщения, язык, набор допустимых значений полей, а иногда и фрагмент открытого текста. Эти сведения называются моделью атаки, и от неё зависит трудоёмкость. Различают атаку по шифртексту (известен только шифртекст), по известному открытому тексту (есть пара «открытый текст — шифртекст»), по выбранному открытому тексту (противник может шифровать произвольные сообщения) и по выбранному шифртексту (может получать результат расшифрования). Для классических шифров достаточно первой модели, для реальных протоколов решающей обычно оказывается последняя — возможность задавать вопросы оракулу.
Отдельно стоит утечка формата. Если сообщение — это JSON с полями фиксированной длины, а шифрование детерминированное, противник видит границы полей и повторяющиеся значения, даже не зная ключа. Классический пример — зашифрованная cookie с полем role; в теме 4 апокрифов показано, как из такой утечки получается подделка прав. Здесь важно зафиксировать общий принцип: криптоанализ эксплуатирует не «слабость алгоритма» вообще, а несоответствие между моделью, в которой алгоритм доказан стойким, и условиями, в которых он применён.
Принцип Керкгоффса и утечки формата
Принцип Керкгоффса требует, чтобы стойкость системы зависела только от секретности ключа, а не от секретности алгоритма 8. Для классических шифров это означает: знание того, что используется Виженер, не помогает без ключа, но знание языка, алфавита и статистики — помогает. На практике к этому добавляется знание формата: заголовки файлов, имена полей, постоянные строки протокола. Именно поэтому в теме 2 разбирается атака по известному открытому тексту на заголовках, а в теме 9 — оракул дополнения, где противник узнаёт один бит о расшифровании.
Частоты букв и критерий хи-квадрат
Избыточность языка
Язык избыточен: буквы распределены неравномерно, сочетания букв ограничены, а энтропия на символ заметно ниже log2(|A|). Для английского алфавита из 26 букв энтропия текста оценивается примерно в 1,1–1,5 бита на символ при равномерном пределе 4,7 бита; для русского с 33 буквами — примерно 1,5–2 бита при пределе 5,04 бита 2. Эта избыточность — то, за что цепляется статистический криптоанализ: правильная расшифровка даёт распределение, похожее на языковое, неправильная — почти равномерное.
Частоты для русского и английского, измеренные по обучающим текстам окружения (Пушкин и Остин), приведены в таблице. Значения даны в процентах и округлены; в коде используются точные доли.
| Буква | Русский, % | Буква | Английский, % |
|---|---|---|---|
| о | 10,9 | e | 12,2 |
| е | 8,4 | t | 9,0 |
| а | 8,0 | a | 8,1 |
| и | 7,4 | o | 7,6 |
| н | 6,7 | i | 6,9 |
| т | 6,3 | n | 6,7 |
| с | 5,5 | s | 6,3 |
| р | 4,7 | h | 6,1 |
| в | 4,5 | r | 5,9 |
| л | 4,4 | d | 4,3 |
Редкие буквы — ф, щ, ъ, э в русском; z, q, x, j в английском — встречаются в десятки раз реже, и именно они дают самые надёжные признаки при переборе сдвига.
Статистика хи-квадрат
Пусть O_i — наблюдаемое число вхождений буквы i, E_i = n·p_i — ожидаемое при языковом распределении p_i, где n — общее число букв. Статистика
chi2 = Σ (O_i − E_i)^2 / E_i
мала, когда распределение похоже на языковое 9, и растёт при отклонении. Это не вероятность и не «доказательство»: при малых n критерий шумит, а на коротких текстах лучший по chi2 сдвиг может не совпасть с истинным. Тем не менее для текстов длиной от нескольких сотен букв метод работает устойчиво.
Реализация на Python занимает несколько строк:
from collections import Counter

def chi_squared(text, alphabet, ref):
    letters = [ch for ch in text.lower() if ch in alphabet]
    n = len(letters)
    if n == 0:
        return float("inf")
    counts = Counter(letters)
    total = 0.0
    for ch in alphabet:
        expected = n * ref[ch]
        observed = counts.get(ch, 0)
        total += (observed - expected) ** 2 / expected
    return total
Функция reference_frequencies из окружения возвращает словарь долей, нормированный на единицу; detect_lang различает языки по доле букв, встречающихся только в одном алфавите.
Числовой пример: сдвиг Цезаря
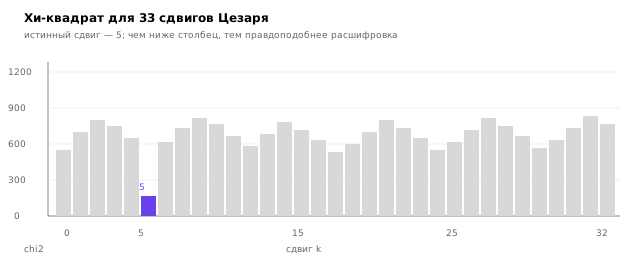
Возьмём сообщение ПРИВЕТМИР и сдвиг k = 5 в русском алфавите из 33 букв. Первая буква П имеет индекс 16 (счёт с нуля), (16 + 5) mod 33 = 21, это Ф; вторая Р (17) даёт Х (22), и так далее. Шифртекст — ФХНЖЙЧСНХ. Перебор всех 33 сдвигов даёт 33 кандидата; для каждого считается chi2, и минимальное значение указывает на k = 5. На короткой строке из девяти букв различия между кандидатами малы, поэтому в лабораторной работе взлом проверяется на текстах в тысячи символов. На рисунке 1 показан профиль статистики для полного перебора сдвигов: минимум приходится на истинный ключ, но соседние значения отличаются всего в разы, а не на порядки.
Индекс совпадений
Определение и смысл
Индекс совпадений (англ. index of coincidence, IC) — вероятность того, что две случайно выбранные буквы текста совпадут:
IC = Σ n_i·(n_i − 1) / (n·(n − 1)),
где n_i — число вхождений буквы i, n — длина текста. Для равномерного случайного текста над алфавитом мощности m ожидание равно 1/m; для английского это 0,0385, для русского — 0,0303. Для осмысленного текста IC выше: у английского около 0,066, у русского около 0,055. Измеренные по обучающим текстам значения — 0,0647 для английского (22 860 букв) и 0,0537 для русского (19 764 буквы); расхождение с «книжными» 0,066 и 0,055 объясняется конкретным автором и объёмом выборки.
Метод введён Уильямом Фридманом в 1920-х годах 35 и до сих пор используется как быстрый тест «это текст или случайность». В отличие от chi2, IC не требует эталонного распределения: он измеряет внутреннюю структуру, а не сходство с языком.
Длина ключа Виженера
Если Виженер использует ключ длины L, то буквы, стоящие в позициях с одинаковым остатком от деления на L, зашифрованы одним и тем же сдвигом. Внутри такого столбца распределение букв сдвинуто, но сохраняет форму языкового, поэтому IC столбца близок к языковому. Если же взять весь шифртекст целиком, позиции перемешаны разными сдвигами, и IC падает к случайному.
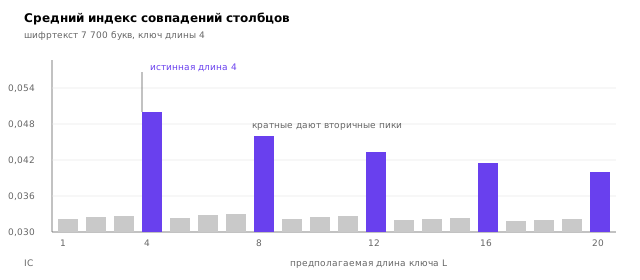
Отсюда процедура: для каждого предполагаемого L разбить текст на L столбцов и усреднить их IC. Правильная длина даёт максимум среднего IC; кратные длины (2L, 3L) тоже дают повышенное значение, потому что столбцы кратны истинным, но максимум обычно у истинной длины. На рисунке ниже показан типичный профиль: пики на 4, 8, 12 при истинной длине 4.
Альтернативная оценка длины — формула Фридмана:
L ≈ 0,027·n / ((n − 1)·IC − 0,038·n + 0,065),
где IC — индекс совпадений всего шифртекста, n — его длина. Формула выведена для английского языка и даёт приблизительное значение; для русского коэффициенты другие, поэтому на практике профиль по L надёжнее.
Метод Касиски и автокорреляция
Повторяющиеся последовательности
Метод Касиски, опубликованный в 1863 году 46, ищет в шифртексте повторяющиеся трёхбуквенные последовательности. Если такая последовательность встретилась дважды, вероятная причина — повтор в открытом тексте, попавший на одинаковую фазу ключа; расстояние между вхождениями кратно длине ключа. НОД всех расстояний даёт кандидата на L. Метод плохо работает на коротких текстах и на текстах с малым алфавитом, зато не требует вычисления IC и хорошо сочетается с ним: Касиски даёт грубого кандидата, IC подтверждает.
Автокорреляция
Более устойчивый вариант — считать число совпадений букв, стоящих на расстоянии d, для d = 1..40. Если d кратно длине ключа, позиции попадают в одну фазу, и доля совпадений выше случайной. Этот критерий эквивалентен IC при разбиении на столбцы, но не требует заранее фиксировать L и удобен для построения графика.
def coincidence_rate(text, d, alphabet):
    a = [ch for ch in text.lower() if ch in alphabet]
    if len(a) <= d:
        return 0.0
    hits = sum(1 for i in range(len(a) - d) if a[i] == a[i + d])
    return hits / (len(a) - d)
На профиле автокорреляции истинная длина ключа видна как локальный максимум, а кратные — как повторяющиеся пики. В лабораторной работе оба метода сравниваются по числу ошибок на коротких текстах.
Взлом Виженера целиком
Разбиение на столбцы
После того как длина L определена, шифртекст делится на L столбцов: в столбец j попадают буквы с индексами j, j+L, j+2L, …. Каждый столбец — это шифр Цезаря с неизвестным сдвигом k_j. Задача сводится к L независимым задачам, каждая из которых решается перебором 33 (или 26) сдвигов с критерием chi2. Суммарная сложность — L·|A| проверок вместо |A|^L полного перебора ключей: для ключа длины 9 это 297 операций против 33^9 ≈ 4,6·10^13.
Восстановление сдвигов
Для каждого столбца выбирается сдвиг с минимальным chi2. Важно, что столбцы короткие: при n/L меньше примерно 100 букв оценки шумят, и один-два столбца могут дать неверный сдвиг. Практические приёмы — проверка согласованности соседних столбцов, перебор двух лучших кандидатов в каждом столбце с оценкой всего текста и использование словаря частых слов. В лабораторной работе базовый вариант ограничивается выбором лучшего кандидата, продвинутый — перебором комбинаций.
Сборка и проверка
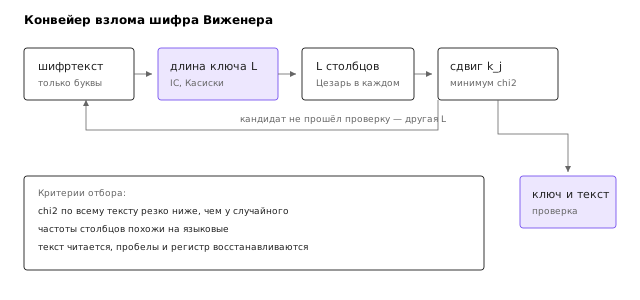
Собранный ключ применяется к шифртексту, и результат оценивается тем же chi2 по всему тексту. Если оценка резко лучше, чем у случайного текста, ключ, скорее всего, верен; окончательная проверка — глазами: осмысленный текст, сохранённые пробелы и регистр. На рисунке ниже показан весь конвейер.
Пределы: расстояние единственности
Формула Шеннона
Сколько шифртекста нужно, чтобы ключ определялся однозначно? Шеннон ввёл расстояние единственности (англ. unicity distance) 2:
N = H(K) / (R_L − R) ,
где H(K) — энтропия ключа в битах, R_L — избыточность открытого текста на символ, R — энтропия шифртекста на символ (для случайного шифртекста R = log2|A|). Для Виженера с ключом длины L энтропия ключа примерно L·log2|A|, а избыточность языка — разница между log2|A| и энтропией текста.
Для английского языка при энтропии текста 1,5 бита на символ и алфавите 26 букв избыточность около 3,2 бита; ключ длины 8 имеет энтропию около 37,6 бита, откуда N ≈ 12 букв. Это оптимистичная оценка: она означает, что в принципе достаточно очень короткого текста, но не говорит, что практически работающий алгоритм его найдёт. Реальные методы требуют сотен букв, потому что оценка chi2 шумная, а перебор ключей длины 8 полным перебором невозможен.
Почему короткие тексты не ломаются
На коротком тексте несколько ключей дают одинаково правдоподобные расшифровки, и различить их нечем: информации физически недостаточно. Это фундаментальное ограничение, а не недостаток конкретного алгоритма. Оно же объясняет, почему в реальных системах важны длина сообщения, структура формата и наличие известных фрагментов: каждое дополнительное ограничение уменьшает пространство кандидатов.
Современные шифры снимают эту проблему иначе 7: ключ 128 бит и хорошее перемешивание делают пространство ключей настолько большим, что перебор невозможен, а статистические свойства шифртекста неотличимы от случайных. Но приёмы, разобранные здесь, — оценка кандидатов по правдоподобию, поиск структуры, сведение задачи к независимым подзадачам — остаются рабочими и в теме 2, и в атаках на реализации в теме 9.
Итоги темы
Классические шифры ломаются потому, что сохраняют статистику открытого текста: сдвиг не меняет форму распределения, а Виженер с коротким ключом оставляет её в столбцах. Индекс совпадений измеряет внутреннюю структуру текста и позволяет найти длину ключа, метод Касиски даёт независимую оценку через повторяющиеся последовательности, а критерий хи-квадрат выбирает сдвиг в каждом столбце. Вместе они образуют конвейер, который на текстах в несколько тысяч букв восстанавливает ключ за доли секунды.
Главный переносимый результат — не конкретные шифры, а способ мышления: противник ищет не «секрет алгоритма», а несоответствие между моделью и реальностью. Избыточность языка, формат сообщения, повторяющиеся поля и предсказуемые заголовки — всё это превращается в критерий, по которому можно отличить правильную гипотезу от неправильной. В следующей теме этот подход формализуется: вводится игра с противником, в которой стойкость означает невозможность отличить шифртексты двух выбранных сообщений.
Литература
- Kahn D. The Codebreakers: The Comprehensive History of Secret Communication from Ancient Times to the Internet. — Scribner, 1996.
- Shannon C. E. Communication Theory of Secrecy Systems. — Bell System Technical Journal, 1949, Т. 28, № 4, С. 656–715. DOI: 10.1002/j.1538-7305.1949.tb00928.x
- Friedman W. F. The Index of Coincidence and Its Applications in Cryptanalysis. — 1922; переиздание Aegean Park Press, 1987.
- Kasiski F. W. Die Geheimschriften und die Dechiffrir-Kunst. — Berlin: Mittler und Sohn, 1863.
- Menezes A., van Oorschot P., Vanstone S. Handbook of Applied Cryptography. — CRC Press, 1996. https://cacr.uwaterloo.ca/hac/
- Singh S. The Code Book: The Science of Secrecy from Ancient Egypt to Quantum Cryptography. — Doubleday, 1999.
- Katz J., Lindell Y. Introduction to Modern Cryptography. — 3-е изд. — CRC Press, 2020.
- Kerckhoffs A. La cryptographie militaire. — Journal des sciences militaires, 1883, Т. 9, С. 5–83.
- Stamp M. Information Security: Principles and Practice. — 2-е изд. — Wiley, 2011.