
Модели атак и вычислительная стойкость
Стойкость — не свойство шифра «само по себе», а утверждение о противнике: что он знает, что может запросить и сколько вычислений готов потратить. Один и тот же AES-256 стоек против перебора ключа и бесполезен, если сервер сообщает, корректно ли дополнение; одна и та же схема RSA безопасна в теории и ломается на практике из-за общего простого множителя. Эта тема вводит язык, на котором такие утверждения формулируются: модели атак, энтропию и избыточность, игры неразличимости и экономику перебора.
Она опирается на тему 2 основного курса (совершенная секретность и вычислительная стойкость) и на апокриф 1 (статистический криптоанализ). Дальше этот язык используется везде: в теме 3 — для оценки ГСЧ, в темах 4–6 — для атак на режимы, в теме 9 — для оракулов RSA.
Противник и модели атак
Что известно противнику
Любая атака начинается с перечня известного. Противник может знать алгоритм, формат сообщения, язык, длины полей, набор допустимых значений и даже фрагмент открытого текста. Модель атаки фиксирует худшее из известного и тем самым задаёт верхнюю границу стойкости: если схема стойка в сильной модели, она стойка и в слабой, но не наоборот.
Стандартная иерархия — от слабой к сильной 28:
| Модель | Что может противник | Типичный пример |
|---|---|---|
| только шифртекст | видеть c | перехват файла |
| известный открытый текст | знать пары (m, c) | заголовки файлов, поля протокола |
| выбранный открытый текст | получать E(m) для своих m | API шифрования, cookie |
| выбранный шифртекст | получать D(c) и признаки ошибки | сервер с оракулом дополнения |
На практике сильнейшая модель почти всегда достижима: сервер, который на неверный шифртекст отвечает разной ошибкой, уже является оракулом расшифрования. Именно так работают атаки на padding oracle (тема 5) и на PKCS#1 v1.5 (тема 9).
Атака по известному открытому тексту на формате
Пусть файл — это BMP, а шифрование блочное с режимом ECB. Первые 54 байта заголовка известны и одинаковы у всех файлов; противник получает пары «заголовок — первый блок шифртекста» и может проверить гипотезу о ключе или режиме. Даже если сам ключ не извлекается, структура файла утекает: одинаковые блоки дают одинаковые шифртексты, и по ним видно, где в документе повторяется текст.
Отсюда практическое правило: криптостойкость начинается с формата. Случайный IV, уникальный nonce и AEAD убирают эту утечку; отсутствие любого из них превращает «известный открытый текст» в рабочий инструмент.
Энтропия, избыточность и расстояние единственности
Энтропия источника
Энтропия дискретного источника X с вероятностями p_i:
H(X) = −Σ p_i·log2 p_i.
Она измеряет неопределённость в битах. Для равномерного выбора из 256 значений H = 8 бит; для пароля из четырёх знаков по 10 вариантов — log2 10^4 ≈ 13,3 бита, если выбор равномерен. Реальные пароли распределены неравномерно, поэтому их энтропия ниже формальной: словарь из миллиона слов даёт около 20 бит, а не 20 «по числу символов».
Для текста на естественном языке энтропия на символ оценивается в 1,1–1,5 бита для английского и 1,5–2 бита для русского при равномерном пределе log2 26 ≈ 4,7 и log2 33 ≈ 5,04 1. Разница между пределом и фактической энтропией — избыточность R_L; именно она позволяет статистическому криптоанализу восстанавливать ключ по небольшому фрагменту.
Расстояние единственности
Шеннон показал, что ключ определяется однозначно, начиная с некоторого объёма шифртекста 1:
N = H(K) / D,
где H(K) — энтропия ключа, а D = log2|A| − H(M) — избыточность открытого текста на символ. Для случайного шифртекста знаменатель равен именно избыточности языка, потому что шифртекст не содержит структуры сверх равномерной.
Пример: ключ Виженера длины 8 над русским алфавитом имеет энтропию 8·log2 33 ≈ 40,4 бита; при избыточности 3,2 бита на букву N ≈ 13 букв. Это теоретический минимум: он говорит, что информации в принципе достаточно, но не гарантирует, что конкретный алгоритм её извлечёт. На практике для надёжного взлома нужны сотни букв, а для коротких сообщений остаётся неоднозначность.
Игры неразличимости
IND-CPA
Стойкость к выбранному открытому тексту формулируется как игра 4. Противник A получает доступ к оракулу шифрования E_k(·) и выбирает два сообщения равной длины m0, m1. Экспериментатор бросает монету b ∈ {0,1}, шифрует m_b и отдаёт c. Противник должен угадать b. Преимущество:
Adv(A) = |2·Pr[A угадал] − 1| — та же конвенция, что и в теме 2.
Схема IND-CPA-стойка, если для любого эффективного A преимущество пренебрежимо мало. На рисунке 1 показаны роли участников игры и то, почему детерминированный шифр проигрывает её с преимуществом 1.
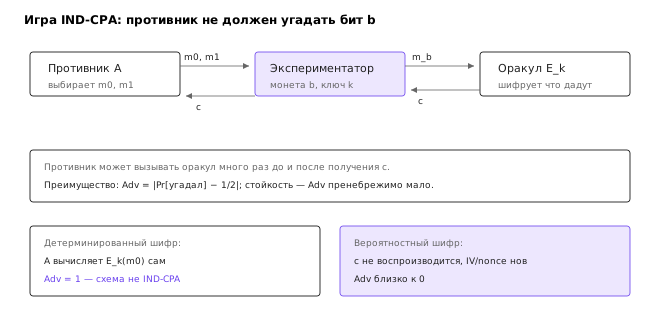 Важно, что противник может шифровать сколько угодно до и после выбора: именно это ловит детерминированные схемы.
IND-CCA
Если дополнительно дать доступ к оракулу расшифрования D_k(·) (с запретом запрашивать сам c), получится IND-CCA — стойкость к выбранному шифртексту. AEAD-схемы проектируются так, чтобы быть IND-CCA: подделка тега должна быть вычислительно неосуществима, иначе оракул ошибки даёт преимущество. Схема, стойкая в IND-CPA, но не в IND-CCA, ломается именно через ошибки расшифрования — это и есть padding oracle.
Почему детерминированное шифрование не IND-CPA
Пусть E_k детерминирована. Противник выбирает m0 ≠ m1, получает c = E_k(m_b) и сам вычисляет E_k(m0) (оракул доступен). Если c = E_k(m0), он отвечает 0, иначе 1. Преимущество равно 1 — максимально возможному. Формально: детерминированная функция от открытого текста не может скрывать равенство сообщений, а IND-CPA требует, чтобы шифртексты разных сообщений были неотличимы.
Отсюда требование вероятностного шифрования 7: случайный IV/nonce в каждом вызове. В схеме с nonce противник видит разные c для одного m и не может воспроизвести шифртекст; в схеме без nonce — может, и игра проиграна.
def adversary(encrypt):
    m0, m1 = b"A" * 16, b"B" * 16
    c0 = encrypt(m0)
    c = encrypt(m0)          # тот же открытый текст ещё раз
    return 0 if c == c0 else 1
Для детерминированного оракула этот противник угадывает всегда; для вероятностного — не лучше монеты.
Экономика перебора
Сколько стоит 2^40, 2^56, 2^64, 2^128
Оценка перебора — это произведение размера пространства ключей на стоимость одной проверки. Измеренная на учебной машине скорость SHA-256 в Python — около 2,9·10^6 операций в секунду на одно ядро (замер в лабораторной работе); специализированная GPU даёт порядка 10^10, ASIC — до 10^13 проверок в секунду для конкретной функции.
| Ключ | Пространство | Python, 2,9·10^6/с | GPU, 10^10/с | ASIC, 10^13/с |
|---|---|---|---|---|
| 40 бит | 1,1·10^12 | 4,4 суток | 110 с | 0,11 с |
| 56 бит | 7,2·10^16 | 790 лет | 83 суток | 2 часа |
| 64 бит | 1,8·10^19 | 200 тыс. лет | 58 лет | 21 сутки |
| 80 бит | 1,2·10^24 | 1,3·10^10 лет | 3,8 млн лет | 3,8 тыс. лет |
| 128 бит | 3,4·10^38 | 3,7·10^24 лет | 1,1·10^21 лет | 1,1·10^18 лет |
На рисунке 2 те же оценки показаны в логарифмическом масштабе: рост на 16 бит добавляет к десятичному логарифму времени примерно 4,8, то есть увеличивает время в 60 тысяч раз.
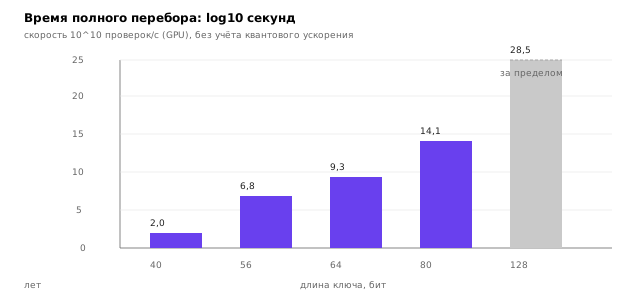
Числа читаются так: 40 бит — это «сегодня», 56 бит — «недели на GPU», 64 бита — «годы на GPU, но дни на ASIC», 80 бит — «недостижимо для перебора», 128 бит — «недостижимо при любых мыслимых технологиях». Отсюда рекомендации NIST: 112–128 бит стойкости для симметричных ключей и 2048–3072 бита для RSA на горизонте до 2030 года 3.
Закон Мура и Гровер
Закон Мура удваивает вычислительную мощность примерно каждые 18–24 месяца. За 30 лет это даёт рост в 2^15–2^20 раз, то есть прибавку 15–20 бит к достижимому перебору. Поэтому ключ 80 бит, казавшийся недостижимым в 1990-х, сегодня находится на грани, а 128 бит остаётся недостижимым: разрыв в 48 бит нельзя закрыть удвоениями.
Квантовый алгоритм Гровера даёт квадратичное ускорение перебора: 2^n превращается в 2^(n/2) 5. Для симметричного ключа это означает, что 128-битный ключ даёт 64-битную стойкость к квантовому перебору, поэтому для долгосрочной защиты рассматривают 256-битные ключи. Для RSA и ECC картина хуже: алгоритм Шора решает факторизацию и дискретный логарифм за полиномиальное время, и это обсуждается в теме 14.
От моделей к практике
Три вопроса перед применением схемы
Первое: какая модель атаки достижима в этой системе? Если сервер возвращает разные ошибки, противник уже имеет IND-CCA-оракул, и схема должна быть стойкой в IND-CCA. Второе: что утекает помимо шифрования — длины, время, коды ошибок, повторяющиеся блоки? Третье: какова цена перебора для конкретного пароля или ключа — не «128 бит», а сколько секунд на доступном оборудовании?
Эти вопросы превращают абстрактную стойкость в инженерное решение 6. AES-256 с уникальным nonce и AEAD — это не «алгоритм», а набор требований: ключ из CSPRNG, nonce не повторяется, тег проверяется до использования открытого текста, ошибки не различаются. Нарушение любого из них ломает систему быстрее, чем любой мыслимый перебор.
Что дальше
Следующая тема — генераторы случайности: откуда берутся ключи и nonce и что происходит, когда генератор предсказуем. Затем темы 4–6 покажут, как ошибки применения (повтор nonce, ECB, отсутствие MAC) превращаются в конкретные атаки. Язык этой темы — модели, энтропия, преимущество, стоимость — будет использоваться в каждой из них.
Итоги темы
Стойкость формулируется как утверждение об игре: противник с определёнными возможностями не может отличить шифртексты с преимуществом лучше случайного. Модели атак упорядочены от «только шифртекст» до «выбранный шифртекст», и практическая система должна выдерживать сильнейшую достижимую модель. Детерминированное шифрование проигрывает IND-CPA с преимуществом 1, поэтому вероятностность и уникальный nonce обязательны.
Энтропия и избыточность объясняют, почему язык помогает криптоанализу и почему короткие сообщения неоднозначны. Экономика перебора переводит биты в годы: 40 бит — сутки, 56 — недели на GPU, 80 — недостижимо, 128 — недостижимо принципиально. Квантовый перебор по Гроверу вдвое сокращает эффективную длину симметричного ключа, а алгоритм Шора обнуляет стойкость RSA и ECC — тема 14 вернётся к этому. Главный вывод: стойкость — это свойство всей системы, а не выбранного алгоритма.
Литература
- Shannon C. E. Communication Theory of Secrecy Systems. — Bell System Technical Journal, 1949, Т. 28, № 4, С. 656–715. DOI: 10.1002/j.1538-7305.1949.tb00928.x
- Katz J., Lindell Y. Introduction to Modern Cryptography. — 3-е изд. — CRC Press, 2020.
- NIST. Recommendation for Key Management, Part 1: General. — SP 800-57 Part 1 Rev. 5, 2020. https://doi.org/10.6028/NIST.SP.800-57pt1r5
- Boneh D., Shoup V. A Graduate Course in Applied Cryptography. — 2023. https://toc.cryptobook.us/
- Grover L. K. A Fast Quantum Mechanical Algorithm for Database Search. — Proceedings of STOC 1996, С. 212–219. DOI: 10.1145/237814.237866
- Aumasson J.-P. Serious Cryptography. — 2-е изд. — No Starch Press, 2024.
- Ferguson N., Schneier B., Kohno T. Cryptography Engineering. — Wiley, 2010.
- Menezes A., van Oorschot P., Vanstone S. Handbook of Applied Cryptography. — CRC Press, 1996. https://cacr.uwaterloo.ca/hac/