
Введение в криптографию: задачи, история, классические шифры
Курс открывается вопросом, который кажется простым только до первого ответа: что именно защищает криптография и от кого. Ответ «шифрует данные» описывает инструмент, но не задачу. Прежде чем выбирать алгоритм, инженер должен назвать свойство, которое нужно обеспечить (конфиденциальность, целостность, аутентичность, неотрекаемость), и противника, от которого это свойство защищается. Дальнейшие шестнадцать тем раскладывают эту задачу на механизмы: симметричные шифры, хеш-функции, коды аутентификации, обмен ключами, подписи, сертификаты, протоколы и постквантовые схемы.
Историческая часть темы нужна не для занимательности. Классические шифры — это уменьшенные модели тех же задач: в них уже видны принцип Керкгоффса, разница между стойкостью к перебору и стойкостью к анализу, роль избыточности языка и цена повторного использования ключа. Частотный анализ, индекс совпадений и метод Касиски, придуманные для ручных шифров, возвращаются в теме 2 при обсуждении расстояния единственности и в теме 3 при оценке энтропии. Поэтому классические шифры разбираются не как курьёз, а как первый полигон.
Изложение движется от задачи к инструменту. Первый раздел вводит четыре свойства защиты и модель противника. Второй разбирает устройство шифров Цезаря, аффинного, простой замены и Виженера. Третий показывает, как они ломаются: перебор, хи-квадрат, частотный анализ, индекс совпадений и метод Касиски с числовыми примерами. Четвёртый связывает роторные машины и Энигму с современной картиной криптографии. Пятый описывает, кто и как стандартизует алгоритмы, — без этого невозможно читать FIPS и RFC, на которые опирается весь курс.
Паспорт темы. Нужно знать: темы 0. Освоите: различать задачи защиты информации и то, что криптография не решает; формулировать модель противника; реализовать и вскрыть классические шифры частотным анализом, методом Касиски и индексом совпадений; объяснять, почему стойкость классических шифров не выдерживает количественной оценки. Проверяет: ЛР 1. Минимум: разделы 1–4. Углубление: раздел 5.
Задачи защиты информации
Четыре свойства и границы криптографии
В защите информации различают четыре свойства, и криптография участвует в каждом, но не заменяет остальные. Конфиденциальность (англ. confidentiality) означает, что данные доступны только тем, кому они предназначены. Целостность (англ. integrity) — что данные не изменены незаметно. Аутентичность (англ. authenticity) — что данные происходят от того, за кого себя выдаёт отправитель. Неотрекаемость (англ. non-repudiation) — что автор сообщения не может впоследствии отрицать факт его создания.
Криптография решает эти задачи математическими средствами, но не решает их целиком. Шифрование не мешает противнику удалить файл, скопировать его или прочитать метаданные: размер, время отправки, адреса. Электронная подпись подтверждает, что документ подписан ключом, но не подтверждает, что человек понимал, что подписывает. Стойкость алгоритма не спасает от ошибки в коде, которая выводит ключ в журнал. Поэтому корректная формулировка звучит так: криптография обеспечивает свойства при условии, что система вокруг неё построена правильно, — и значительная часть курса посвящена именно этому условию.
Полезно сразу разделить примитив и протокол. Примитив (англ. primitive) — базовый алгоритм с точно определённым интерфейсом: блочный шифр, хеш-функция, функция выработки ключа. Протокол — правила, по которым стороны применяют примитивы во времени: кто что отправляет, какие значения проверяет, что делает при ошибке. Примитив может быть безупречен, а протокол — сломан; примеры таких атак разбираются в теме 15.
Принцип Керкгоффса
В 1883 году Огюст Керкгоффс сформулировал правило, которое остаётся основой проектирования: стойкость системы не должна зависеть от сохранения в тайне алгоритма, а только от тайны ключа 8. Алгоритм предполагается известным противнику; секретом является ключ. Обратный подход — «безопасность через неясность» (англ. security through obscurity) 2 — считается ошибкой, потому что алгоритм неизбежно утекает: его реализуют в коде, документируют, реверсируют, наконец, он есть у всех пользователей.
Принцип не запрещает коммерческую тайну вокруг реализации. Он утверждает более слабое и более полезное: даже полное знание устройства системы не должно давать противнику возможности расшифровать данные без ключа. Практическое следствие — открытые стандарты и открытый исходный код криптографических библиотек: тысячи специалистов проверяют то, что иначе проверили бы единицы.
Модель противника
Утверждение «шифр стойкий» бессмысленно без указания, что противник умеет делать 1. В криптографии фиксируют модель противника (англ. adversary model): какие данные у него есть, какие запросы он может делать и какие ресурсы тратит. В учебных схемах действуют Алиса (отправитель), Боб (получатель) и противник. Пассивный противник Ева (англ. eavesdropper) только слушает канал. Активный противник Мэллори (англ. malicious) может подменять, удалять, задерживать и вставлять сообщения, а также инициировать собственные сеансы.
Для шифров различают атаки по доступным данным: только шифртекст (англ. ciphertext-only), известный открытый текст (англ. known-plaintext), выбранный открытый текст (англ. chosen-plaintext), выбранный шифртекст (англ. chosen-ciphertext). Каждая следующая модель сильнее предыдущей: стойкость в слабой модели не гарантирует стойкости в сильной. В теме 2 эти модели формализуются через игры с противником, а в теме 7 выбранный шифртекст превращается в конкретную атаку на оракул дополнения.
Модель противника — не бюрократия, а рабочий инструмент. Если система защищается от пассивного прослушивания, ей достаточно шифрования без аутентификации. Если канал активный, шифрование без целостности позволяет противнику менять данные предсказуемым образом, и это уже другая задача — её решает аутентифицированное шифрование (тема 9).
Классические шифры
Шифр Цезаря и аффинный шифр
Простейший подстановочный шифр — шифр Цезаря: каждая буква алфавита сдвигается на фиксированное число позиций. При сдвиге на 3 буква A переходит в D, X — в A (по модулю 26). Гай Юлий Цезарь, по свидетельству Светония, использовал сдвиг на 3 для переписки 3. Формально для алфавита из N символов шифрование и расшифрование записываются так:
E(x) = (x + k) mod N
D(y) = (y - k) mod N
Ключ — число k от 0 до N-1. Для латинского алфавита пространство ключей равно 26, для русского с «ё» — 33. Уже здесь видна первая проблема: перебор всех ключей занимает доли секунды даже вручную.
Механизм сдвига удобно увидеть на схеме: алфавит записывается по кругу, и ключ задаёт, на сколько позиций поворачивается кольцо сопоставления.
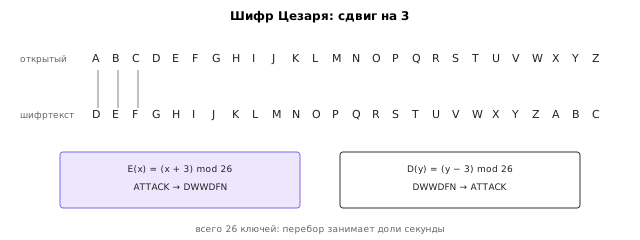
Кольцевая запись объясняет и слабость шифра: при повороте кольца порядок букв сохраняется, меняется только точка отсчёта, поэтому частоты символов переезжают вместе с буквами, не меняя своей формы. Криптоаналитику достаточно заметить эту неизменность.
Аффинный шифр обобщает сдвиг: буква с номером x переходит в (a·x + b) mod N. Параметр b задаёт сдвиг, a — растяжение алфавита. Чтобы преобразование было обратимым, a должно быть взаимно простым с N: тогда существует обратный элемент a⁻¹ по модулю N, и расшифрование имеет вид x = a⁻¹·(y - b) mod N. Для N = 26 подходят a ∈ {1, 3, 5, 7, 9, 11, 15, 17, 19, 21, 23, 25} — двенадцать значений, поскольку φ(26) = 12. Всего ключей 12 · 26 = 312.
N = 26, a = 5, b = 8
E(x) = (5x + 8) mod 26
«AFFINE» → «IHHWVC»
Проверим первую букву: A имеет номер 0, 5·0 + 8 = 8, восьмая буква — I. Вторая F (номер 5): 5·5 + 8 = 33, 33 mod 26 = 7, это H. Обратный элемент к 5 по модулю 26 равен 21, так как 5·21 = 105 = 4·26 + 1. Расшифрование I (номер 8): 21·(8 - 8) = 0, получается A.
Аффинный шифр показывает важную мысль: увеличение пространства ключей с 26 до 312 не делает шифр стойким. Перебор 312 вариантов — мгновенная операция, а частотный анализ работает почти так же, как для Цезаря. Точнее, сохраняется не порядок частот, а их мультимножество: отображение x ↦ a·x + b переставляет буквы, поэтому каждая частота исходного текста переходит в частоту какой-то другой буквы, но набор значений остаётся тем же. При a = 1 (шифр Цезаря) порядок действительно сохраняется, и самая частая буква шифртекста соответствует самой частой букве языка. При a ≠ 1 ранги переставляются, и опознание опирается на сам спектр частот, а не на совпадение мест: набор из двух-трёх пиков по-прежнему узнаваем, а перебор a и b по парам частых букв занимает мгновения.
Простая замена
Шифр простой замены (англ. monoalphabetic substitution) заменяет каждую букву произвольной перестановкой алфавита. Ключ — перестановка из N элементов, число ключей N!: для латинского алфавита около 4·10^26, что соответствует примерно 88 битам энтропии. Перебор такого пространства вручную невозможен, и на этом основании простую замену когда-то считали надёжной.
Стойкость разрушает избыточность языка. В осмысленном тексте буквы распределены неравномерно: в английском e встречается примерно в 12,7 % случаев, t — около 9 %, а z — около 0,07 %. Кроме того, сохраняются структуры: повторяющиеся сочетания, двойные буквы, короткие слова. Криптоаналитик девятого века аль-Кинди описал метод, который сейчас называется частотным анализом: подсчитать частоты символов шифртекста, сопоставить их с частотами языка, затем уточнять соответствия по биграммам и триграммам 4. Для текста длиной в несколько сотен символов замена вскрывается за минуты.
Подробный разбор классических шифров и их криптоанализа приведён в справочнике 9. Число ключей здесь — полезный пример того, что энтропия ключа не равна стойкости. Формально ключей 26! ≈ 4,03·10^26, но эффективное число вариантов, которые нужно проверить с учётом языка, на много порядков меньше. В теме 2 это различие формулируется через расстояние единственности.
Шифр Виженера
Идея полиалфавитного шифра — применять разные сдвиги к разным позициям текста. В шифре Виженера ключевое слово повторяется вдоль сообщения, и буква с номером j сдвигается на номер буквы ключа key[j mod L], где L — длина ключа. Если ключ LEMON, то первая буква сдвигается на 11, вторая на 4, третья на 12, четвёртая на 14, пятая на 13, шестая снова на 11.
Открытый текст:  ATTACKATDAWN
Ключ:            LEMONLEMONLE
Шифртекст:       LXFOPVEFRNHR
Шифр описан в трактате 1586 года, хотя похожая схема встречается у Джована Баттисты Беллазо в 1553 году; название закрепилось за Виженером. Долгое время его называли «неразгадываемым шифром» (фр. le chiffre indéchiffrable), и это заблуждение держалось почти три столетия.
Ключевое свойство Виженера: при известной длине ключа L шифртекст распадается на L независимых столбцов, каждый из которых зашифрован шифром Цезаря со своим сдвигом. Значит, задача сводится к двум: определить L и вскрыть каждый столбец частотным анализом. Оба шага разобраны ниже.
Перестановочные шифры
Подстановка меняет символы, перестановка (англ. transposition) меняет их порядок, оставляя сами символы на месте. Простейший пример — запись текста в таблицу по строкам и чтение по столбцам; ключ задаёт размер таблицы и порядок столбцов. Перестановка сохраняет частоты букв, поэтому частотный анализ по одному символу против неё бесполезен. Зато она сохраняет и частоты биграмм, если перестановка недостаточно перемешивает текст: анализ пар и троек символов восстанавливает структуру.
Исторически перестановки применялись вместе с подстановками: так устроены, например, шифры Второй мировой войны. Для современной криптографии важен вывод: одного перемешивания недостаточно. Шеннон позже сформулировал два требования к стойкому шифру 7 — рассеивание (каждый символ шифртекста зависит от многих символов открытого текста) и перемешивание (статистика открытого текста исчезает в шифртексте). Классические шифры нарушают оба требования по отдельности: подстановка не рассеивает, перестановка не перемешивает.
Сводка по разобранным шифрам — чтобы видеть, чем именно определяется их стойкость.
| Шифр | Размер ключевого пространства | Что сохраняет в шифртексте | Основной метод вскрытия |
|---|---|---|---|
| Цезаря | 26 | все частоты, только сдвинутые | перебор 26 вариантов |
| Аффинный | 312 (12 обратимых a × 26 значений b) | частоты, переставленные нелинейно | перебор или пара частых букв |
| Простая замена | 26! ≈ 4·10²⁶ | полный профиль частот и биграмм | частотный анализ |
| Виженера | 26^L при длине ключа L | частоты в пределах каждого столбца | Касиски, затем частотный анализ столбцов |
| Перестановочный | d! при таблице в d столбцов | частоты одиночных символов целиком | анализ биграмм и троек |
Видно общую закономерность: стойкость растёт не с размером ключа, а с тем, насколько полно шифр уничтожает статистику исходного текста. У простой замены ключевое пространство астрономическое, а вскрывается она вручную за часы — потому что структура сохраняется.
Криптоанализ классических шифров
Перебор и критерий хи-квадрат
Шифр Цезаря вскрывается перебором всех 26 ключей. Человек просматривает 26 строк глазами, программа должна выбрать правильную автоматически. Простой критерий «текст похож на осмысленный» плохо формализуется, поэтому используют статистику: сравнивают частоты букв расшифрованного текста с эталонными частотами языка. Мерой расхождения служит статистика хи-квадрат:
\chi^2 = \sum_{i} \frac{(O_i - E_i)^2}{E_i}, \qquad E_i = n \cdot p_i
Здесь O_i — наблюдаемое число вхождений буквы i, p_i — её эталонная частота, n — общее число букв. Чем меньше χ², тем ближе распределение к языковому. Для правильного ключа значение оказывается на порядки меньше, чем для остальных 25 вариантов.
Метод работает, потому что сдвиг лишь циклически переставляет частоты, не меняя их форму. Тот же критерий применяется к каждому столбцу Виженера. Ограничение тоже важно: на коротких текстах (десятки букв) случайные колебания частот сравнимы с различиями между ключами, и автоматический выбор ошибается. В лабораторной работе это наблюдается на коротких фрагментах.
Частотный анализ
Для простой замены перебор невозможен, но частотный анализ остаётся эффективным. Порядок действий типичен. Сначала считают частоты символов и сопоставляют самые частые с e, t, a, o, i, n для английского языка (для русского порядок иной: о, е, а, и, н, т). Затем смотрят на повторяющиеся шаблоны: двойные буквы, апострофы, короткие слова из одной-двух букв. После этого гипотезы проверяются на биграммах: например, th, he, in, er в английском.
Наглядно это показано на рисунке ниже: гистограмма частот шифртекста повторяет форму гистограммы языка, только подписи столбцов другие.
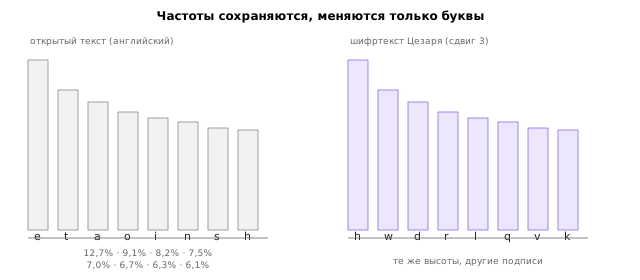
Формально метод опирается на то, что замена — биекция: она сохраняет равенства и неравенства частот, но не их значения. Если в шифртексте символ Q встречается чаще всех, а в языке самая частая буква e, гипотеза Q → e проверяется по окружению. Ошибка исправляется, когда противоречие накапливается: назначив Q → e, криптоаналитик может обнаружить, что тройка QQQ встречается там, где в языке тройных e не бывает.
Для русского языка анализ осложняется буквой «ё» и большой длиной алфавита, но принцип тот же. В лабораторной работе частоты считаются по обучающему тексту, а шифртекст получен из другого произведения, поэтому эталон не подогнан под ответ — это важное методическое условие.
Индекс совпадений
Индекс совпадений (англ. index of coincidence, IC) — вероятность того, что две случайно выбранные позиции строки содержат одинаковый символ. Для строки длиной n с частотами f_i:
\text{IC} = \frac{\sum_{i} f_i (f_i - 1)}{n (n - 1)}
Для случайной строки над алфавитом из N символов ожидаемое значение равно 1/N: 0,0385 для английского и 0,0303 для русского. Для осмысленного текста оно выше: около 0,066 для английского и 0,055–0,060 для русского. Разница возникает из-за неравномерности частот.
Пример: строка HELLOWORLD содержит L трижды, O дважды, остальные буквы по одному разу; n = 10. Сумма f(f-1) равна 3·2 + 2·1 = 8, значит IC = 8/(10·9) = 0,0889. Значение выше языкового, потому что текст короткий; на длинном тексте оно сходится к 0,066.
Индекс совпадений — основной инструмент определения длины ключа Виженера. Если ключ имеет длину L, то буквы, стоящие в шифртексте через L позиций, зашифрованы одним сдвигом. Столбец s[i::L] ведёт себя как текст, зашифрованный Цезарем: его IC близок к языковому. Для неверного L столбцы перемешивают разные сдвиги, и IC падает к случайному. Поэтому строят график среднего IC по столбцам для L = 1..20 и ищут длину, на которой значение выходит на плато.
Метод Касиски
Метод Касиски (1863) использует повторяющиеся фрагменты. Если одна и та же последовательность букв открытого текста встречается дважды на расстоянии, кратном длине ключа, она шифруется одинаково и появляется в шифртексте повторно. Расстояния между повторными вхождениями кратны L, поэтому кандидаты в длину ключа — делители этих расстояний.
Шифртекст:  ABCXXABCYYABC
Повтор «ABC»: позиции 0, 5, 10
Расстояния: 5 и 5
Кандидаты L: делители 5 → 5
На практике повторы возникают и случайно, поэтому метод даёт набор кандидатов, а не единственный ответ. Его комбинируют с индексом совпадений: Касиски подсказывает, какие длины проверять, IC подтверждает. Для коротких текстов и коротких ключей оба метода могут ошибаться, и тогда перебирают несколько ближайших кандидатов.
После определения длины ключа каждый столбец вскрывается как шифр Цезаря: для каждого из N сдвигов считается χ², выбирается минимальный. Сложность взлома Виженера с ключом длины L — примерно L·N операций плюс стоимость определения L; это несопоставимо меньше перебора N^L.
Избыточность языка и расстояние единственности
Почему классические шифры ломаются при достаточной длине текста? Потому что язык избыточен. Если бы буквы были независимы и равновероятны, шифртекст не содержал бы никакой информации о структуре открытого текста, и никакой анализ не помог бы. Реальный язык имеет энтропию около 1–1,5 бит на символ при алфавите в 4,7 бита, то есть избыточность порядка 3,2–3,7 бит на символ.
Шеннон ввёл понятие расстояния единственности 7 (англ. unicity distance): минимальной длины шифртекста, при которой ключ определяется однозначно. Оценка:
N_0 \approx \frac{H(K)}{D}
где H(K) — энтропия ключа в битах, D — избыточность языка на символ. Для простой замены H(K) = \log_2(26!) \approx 88{,}4 бит. При D \approx 3{,}2 бит/символ получаем N_0 \approx 28 символов. Это объясняет, почему замена вскрывается на коротких сообщениях: информации о языке в них уже достаточно, чтобы отсечь почти все ключи. Для Виженера с длиной ключа L энтропия ключа равна L·log₂N, и расстояние единственности растёт линейно с L.
Формула приблизительна: она предполагает, что все ключи равновероятны, а язык стационарен. Но она даёт правильную интуицию и показывает, почему «длинный ключ» не заменяет стойкость: при достаточной длине текста избыточность языка всё равно выдаёт ключ. Современные шифры решают эту проблему иначе — они делают зависимость шифртекста от ключа настолько сложной, что статистические методы не работают, а лучший известный метод — перебор.
От Энигмы к современной криптографии
Роторные машины
Энигма — электромеханическая машина, применявшаяся Германией во Второй мировой войне. Она состоит из клавиатуры, набора роторов, отражателя и ламповой панели. При нажатии клавиши электрический сигнал проходит через роторы, отражается и возвращается, зажигая лампу. После каждого нажатия первый ротор поворачивается, иногда увлекая следующие, — поэтому одна и та же буква шифруется по-разному в зависимости от позиции.
Ключ Энигмы — порядок роторов, их начальные позиции и коммутация на панели. Число возможных настроек огромно: порядка 10^23 для типовой конфигурации, что намного больше, чем у простой замены. Перебор вручную невозможен, и именно поэтому Энигма считалась стойкой. Но у неё было структурное свойство: буква никогда не шифровалась в себя. Это свойство, названное «no self-encryption», давало криптоаналитикам проверяемое ограничение и позволило построить «бомбы» — электромеханические устройства для перебора согласованных настроек.
Взлом Энигмы
В 1932 году польский математик Мариан Реевский восстановил устройство военной Энигмы и построил метод атаки, используя математическую структуру перестановок роторов 104. Польская группа передала результаты британским и французским коллегам в 1939 году, за несколько недель до начала войны. В Блетчли-парке Алан Тьюринг и Гордон Уэлчман развили метод: «бомба» Тьюринга проверяла гипотезы о фрагментах открытого текста (крибах) и находила согласованные положения роторов.
Уроки Энигмы переносятся на современную криптографию. Во-первых, стойкость зависит от модели противника: немцы считали, что процедура выбора ключа и дисциплина связи достаточны, но повторяющиеся шаблоны сообщений (прогнозы погоды) давали крибы. Во-вторых, малейшая структурная аномалия — запрет шифрования буквы в себя — становится точкой входа. В-третьих, атака использует не перебор, а согласованность: проверяется не ключ целиком, а его части, что резко снижает сложность.
Карта современной криптографии
Современная криптография делится на четыре больших области, и курс следует этому делению. Симметричная криптография использует один и тот же ключ для шифрования и расшифрования: поточные шифры (тема 5), блочные шифры (тема 6), режимы (тема 7), хеш-функции (тема 8), MAC и AEAD (тема 9), выработка ключей (тема 10). Асимметричная криптография использует пару ключей: обмен ключами Диффи — Хеллмана (тема 11), RSA (тема 12), эллиптические кривые (тема 13), подписи и PKI (тема 14). Протоколы собирают примитивы в работающие системы (тема 15). Постквантовая криптография отвечает на угрозу квантовых вычислений (тема 16).
Схема на рисунке ниже показывает эту карту и связи между темами: симметричные примитивы решают задачи конфиденциальности и целостности при общем ключе, асимметричные — распределение ключей и неотрекаемость, протоколы объединяют те и другие.
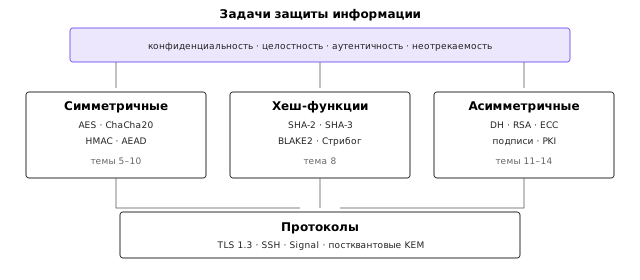
Важно понимать, что асимметричная криптография не заменяет симметричную. Она работает на много порядков медленнее: RSA-2048 выполняет тысячи операций с большими числами, тогда как AES шифрует гигабайты в секунду. Поэтому реальные системы гибридны: асимметричный обмен устанавливает общий ключ, а данные шифруются симметрично. Этот принцип — KEM/DEM — явно описан в темах 11–13 и применяется в TLS (тема 15) и курсовом проекте.
Стандартизация и экосистема
Кто задаёт правила
Криптографические алгоритмы становятся пригодными к применению, когда существует согласованный стандарт: точная спецификация, тестовые векторы и критерии соответствия. Основные организации перечислены ниже.
- NIST (США) выпускает FIPS — обязательные стандарты для федеральных систем — и SP 800 — рекомендации. AES описан в FIPS 197, SHA-2 — в FIPS 180-4, SHA-3 — в FIPS 202, постквантовые схемы — в FIPS 203–205 5.
- IETF публикует RFC; криптографические вопросы курирует рабочая группа CFRG. Здесь описаны ChaCha20-Poly1305 (RFC 8439), HKDF (RFC 5869), X25519 (RFC 7748), Ed25519 (RFC 8032), TLS 1.3 (RFC 8446) 6.
- ISO/IEC выпускает международные стандарты (ISO/IEC 18033 и серия 14888), которые часто дублируют или уточняют национальные.
- ТК 26 (Россия) отвечает за отечественные стандарты: ГОСТ Р 34.12-2015 (блочные шифры «Кузнечик» и «Магма»), ГОСТ Р 34.13-2015 (режимы), ГОСТ Р 34.11-2012 («Стрибог»), ГОСТ Р 34.10-2012 (подпись) 12.
Рекомендации по длинам ключей и срокам их использования собраны в SP 800-57 11. Стандарт не гарантирует отсутствие ошибок. История знает случаи, когда рекомендованный алгоритм оказывался ослабленным: Dual_EC_DRBG, включённый в SP 800-90A, содержал структуру, позволявшую предполагаемому автору предсказывать выход генератора, и был отозван. Поэтому стандарт — необходимая, но не достаточная гарантия; важны независимый анализ и открытость спецификации.
Как читать стандарты
При чтении FIPS и RFC полезно держать в голове три вопроса. Что именно является входом и выходом: длины ключей, блоков, nonce, тегов. Какие требования обязательны, а какие рекомендательны: слова SHALL, MUST, SHOULD, MAY в RFC имеют юридическую силу в рамках протокола. Какие ограничения на использование: максимальное число сообщений на ключ, допустимые длины, требования к генерации случайных чисел.
Тестовые векторы — отдельная ценность. Они позволяют проверить реализацию до того, как она попадёт в систему. В лабораторных работах курса сверка с векторами FIPS и RFC является обязательным шагом: реализация считается верной не тогда, когда «выглядит правильно», а тогда, когда совпала с опубликованным значением. Это дисциплинирует и отучает от привычки проверять шифр на глаз.
Наконец, стандарты задают словарь. В дальнейшем тексте используются термины «открытый текст» (plaintext), «шифртекст» (ciphertext), «ключ» (key), «одноразовое число» (nonce), «тег аутентификации» (authentication tag), «присоединённые данные» (associated data). Термины вводятся при первом употреблении и повторяются в глоссариях тем.
Итоги темы
Криптография отвечает на четыре задачи — конфиденциальность, целостность, аутентичность и неотрекаемость, — но только в связке с корректно построенной системой. Принцип Керкгоффса требует считать алгоритм известным, а секретом — только ключ; модель противника определяет, что именно считается атакой. Без явной модели утверждение о стойкости не имеет смысла.
Классические шифры показывают эволюцию этой мысли. Шифр Цезаря имеет 26 ключей и вскрывается перебором; аффинный шифр — 312 ключей и вскрывается так же; простая замена имеет 26! ключей, но падает от частотного анализа; Виженер с длинным ключом сопротивляется дольше, но рассыпается на столбцы и вскрывается через индекс совпадений и метод Касиски. Во всех случаях решающую роль играет избыточность языка, а не размер ключевого пространства.
Энигма добавляет ещё один урок: структурные свойства схемы, даже при огромном числе настроек, становятся точкой входа для атаки, если противник может их проверить. Современная криптография строится так, чтобы таких проверяемых свойств не оставалось, а лучшим известным методом был перебор — и именно это означает «стойкий» в инженерном смысле.
Следующая тема формализует эти наблюдения. Совершенная секретность Шеннона объясняет, почему одноразовый блокнот не ломается никаким анализом, теорема о длине ключа показывает цену этого свойства, а расстояние единственности и модели IND-CPA/IND-CCA переводят интуицию о «достаточной длине» и «правильной модели» на язык определений.
Литература
- Katz J., Lindell Y. Introduction to Modern Cryptography. 3rd ed. — CRC Press, 2020.
- Aumasson J.-P. Serious Cryptography: A Practical Introduction to Modern Encryption. 2nd ed. — No Starch Press, 2024.
- Singh S. The Code Book: The Science of Secrecy from Ancient Egypt to Quantum Cryptography. — Anchor Books, 1999.
- Kahn D. The Codebreakers: The Comprehensive History of Secret Communication from Ancient Times to the Internet. — Scribner, 1996.
- NIST. Advanced Encryption Standard (AES). — FIPS 197 (updated 2023), 2001. https://doi.org/10.6028/NIST.FIPS.197-upd1
- Rescorla E. The Transport Layer Security (TLS) Protocol Version 1.3. — RFC 8446, IETF, 2018. https://www.rfc-editor.org/rfc/rfc8446
- Shannon C. E. Communication Theory of Secrecy Systems. — Bell System Technical Journal, 1949, Т. 28, № 4, С. 656–715.
- Kerckhoffs A. La cryptographie militaire. — Journal des sciences militaires, 1883, Т. IX, С. 5–83.
- Menezes A. J., van Oorschot P. C., Vanstone S. A. Handbook of Applied Cryptography. — CRC Press, 1996. https://cacr.uwaterloo.ca/hac/
- Kozaczuk W. Enigma: How the German Machine Cipher Was Broken, and How It Was Read by the Allies in World War Two. — University Publications of America, 1984.
- NIST. Recommendation for Key Management, Part 1: General. — SP 800-57 Part 1 Rev. 5, 2020. https://doi.org/10.6028/NIST.SP.800-57pt1r5
- ГОСТ Р 34.12-2015. Информационная технология. Криптографическая защита информации. Блочные шифры. — М.: Стандартинформ, 2015.