
Стойкость шифров: совершенная секретность, модели атак и вычислительная стойкость
В теме 1 стойкость обсуждалась на примерах: шифр Цезаря ломается перебором, простая замена — частотным анализом, Виженер — через индекс совпадений. Каждый раз оставался без ответа вопрос: что значит «шифр стоек» вообще, безотносительно к конкретной атаке? Интуиция подсказывает, что стойкий шифр нельзя вскрыть, но «нельзя» требует уточнения — за какое время, при каких ресурсах противника, в какой модели доступа к данным.
Тема вводит три уровня ответа. Первый — совершенная секретность Шеннона: шифртекст не даёт противнику никакой информации об открытом тексте, даже если противник неограничен в вычислениях. Этот уровень достигается одноразовым блокнотом и только им, а цена — ключ длиной с сообщение. Второй — расстояние единственности: сколько текста нужно, чтобы ключ определялся однозначно; здесь работает избыточность языка. Третий — вычислительная стойкость: противник ограничен ресурсами, и стойкость измеряется числом операций, необходимых для успешной атаки.
Модели атак связывают эти уровни с практикой. Противник может видеть только шифртекст, знать часть открытых текстов, выбирать их или даже выбирать шифртексты и получать результат расшифрования. Для каждой модели существует своё определение стойкости, и путаница между ними — источник реальных ошибок: схема, стойкая в слабой модели, может рушиться в сильной. Тема завершается практическими рекомендациями по длинам ключей и разбором того, почему «перемешивание» и самодельные схемы не заменяют криптографию.
Паспорт темы. Нужно знать: темы 0, 1. Освоите: доказывать необходимость длины ключа для совершенной секретности; оценивать расстояние единственности; переводить оценки сложности в ресурсы; формулировать IND-CPA, IND-CCA и EUF-CMA; различать PRF и PRP; читать редукции и их потери. Проверяет: ЛР 2. Минимум: разделы 1–4. Углубление: разделы 5–6.
Совершенная секретность
Определение Шеннона
Шифр обладает совершенной секретностью (англ. perfect secrecy), если наблюдение шифртекста не меняет вероятностей открытых текстов:
P(M = m | C = c) = P(M = m) для всех m, c с P(C = c) > 0
Иными словами, противник, увидев c, знает об m ровно столько же, сколько знал до перехвата. Определение сформулировано Шенноном в работе 1949 года «Communication Theory of Secrecy Systems» 1, и оно до сих пор остаётся эталоном: из него выводится, что шифртекст и открытый текст статистически независимы.
Из определения немедленно следует необходимое условие: для каждого c и каждого m должен существовать ключ, переводящий m в c. Иначе при некотором c вероятность m стала бы нулевой, а это противоречит определению. Значит, пространство ключей не может быть меньше пространства сообщений: |K| ≥ |M|. Это первая версия теоремы о длине ключа.
Одноразовый блокнот
Одноразовый блокнот (англ. one-time pad, OTP) устроен предельно просто: ключ — случайная строка той же длины, что сообщение, а шифртекст получается побайтовым XOR:
c = m ⊕ k
m = c ⊕ k
Если ключ равномерно распределён и используется ровно один раз, то для любого c и любого m существует ровно один ключ k = m ⊕ c, и все ключи равновероятны. Значит, P(C = c | M = m) = 1/|K| не зависит от m, а по формуле Байеса P(M = m | C = c) = P(M = m). Совершенная секретность доказана.
Проверим на числах. Пусть сообщение — один байт, ключ — один байт. Для шифртекста 0x42 и сообщения 0x00 ключ равен 0x42; для сообщения 0xFF ключ равен 0xBD. Оба ключа равновероятны, поэтому шифртекст не выделяет ни одно сообщение. Противник с неограниченными вычислениями не может предпочесть одну гипотезу другой: все гипотезы согласуются с наблюдением.
Это свойство часто формулируют через «фальшивый ключ»: для любого шифртекста c и любого желаемого открытого текста m' той же длины существует ключ k' = c ⊕ m', при котором c расшифровывается в m'. В лабораторной работе это проверяется функцией fake_key.
Побитово операция выглядит так, как на схеме ниже: каждый бит сообщения складывается по модулю два с соответствующим битом ключа, и ровно та же операция возвращает исходный бит, потому что x ⊕ y ⊕ y = x.
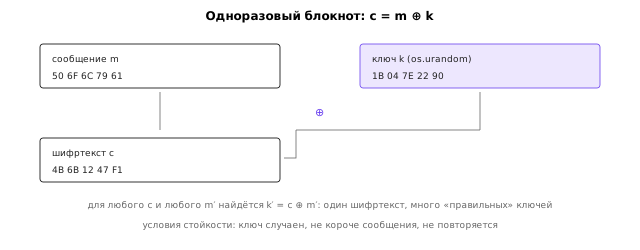
Именно эта простота и порождает главную ошибку применения — повторное использование ключа. Если один и тот же ключ применён к двум сообщениям, то c₁ ⊕ c₂ = m₁ ⊕ m₂: ключ сокращается, и противник получает XOR двух открытых текстов. Для текстов на естественном языке такой результат вскрывается вручную: в ASCII пробел имеет код 0x20 и «обнуляет» регистр буквы, поэтому XOR двух текстов отчётливо показывает границы слов. Дальше угадывается одно слово, и из него восстанавливается фрагмент второго текста, затем наоборот — процедура называется перетаскиванием по предположению (crib dragging) и разобрана в лабораторной работе.
Второе условие теоремы — равномерность и независимость ключа — нарушается не реже. Ключ, выработанный линейным конгруэнтным генератором или Mersenne Twister, формально имеет ту же длину, что сообщение, но не является равномерным на множестве всех строк: противник, знающий устройство генератора, отбрасывает почти все ключи. Совершенная секретность при этом исчезает полностью, хотя длина ключа «правильная». Это первый намёк на то, что в криптографии длина сама по себе ничего не гарантирует, — и прямой мост к теме 3.
Третье ограничение практическое. Ключ должен быть передан заранее по каналу, который не прослушивается, и его запас должен быть не меньше объёма всей переписки. Для разового донесения это выполнимо, для веб-трафика — нет. Поэтому OTP остаётся теоретическим эталоном: он задаёт планку, относительно которой оценивают остальные схемы, и объясняет, зачем нужна вычислительная стойкость вместо информационно-теоретической.
Теорема о длине ключа
Обратное утверждение: если |K| < |M|, совершенная секретность невозможна. Доказательство короткое. Зафиксируем шифртекст c, который может появиться. Множество сообщений, совместимых с c, имеет размер не больше |K|, поскольку каждому ключу соответствует не более одного сообщения. Если |K| < |M|, найдутся сообщения, несовместимые с c; для них P(M = m | C = c) = 0, тогда как априорная вероятность положительна. Определение нарушено.
Отсюда следует практический вывод: совершенная секретность требует ключа не короче сообщения. Для гигабайтного файла нужен гигабайтный ключ, который надо как-то доставить и сохранить. Именно поэтому OTP применяется в особых случаях — дипломатическая связь, «горячая линия», некоторые военные каналы, — но не в массовых протоколах.
Почему OTP непрактичен
Помимо длины ключа, у OTP есть эксплуатационные ограничения. Ключ должен быть истинно случайным: генератор с предсказуемым выходом превращает OTP в поточный шифр с известной структурой. Ключ должен использоваться ровно один раз: повторное использование (two-time pad) немедленно раскрывает XOR открытых текстов, а при знании одного из них — и второй. Ключ должен быть доставлен по независимому каналу: если противник перехватывает и ключ, и шифртекст, схема не даёт ничего.
Исторический пример — проект «Венона»: американские криптоаналитики в 1940-х годах читали советские сообщения, потому что одноразовые блокноты использовались повторно при шифровании разных сообщений 6. XOR двух шифртекстов давал XOR двух открытых текстов, а дальше работал crib-dragging — подбор вероятных фрагментов. Этот пример показывает, что даже совершенная схема ломается при нарушении правил использования, и таких нарушений в реальных системах больше, чем ошибок в алгоритмах.
Избыточность языка и расстояние единственности
Энтропия и избыточность
Энтропия случайной величины X с распределением p(x) измеряет неопределённость:
H(X) = -\sum_{x} p(x) \log_2 p(x)
Для равномерного распределения по N символам энтропия равна \log_2 N: 4,7 бита для 26 букв. Реальный английский текст имеет энтропию около 1–1,5 бита на символ (оценки Шеннона и последующих работ), потому что буквы зависимы: после q почти всегда идёт u, после th вероятно e. Разница между максимальной и реальной энтропией называется избыточностью (англ. redundancy):
D = \log_2 N - H_{\text{языка}} \approx 4{,}7 - 1{,}5 = 3{,}2 \quad \text{бита/символ}
Именно избыточность позволяет вскрывать классические шифры: она оставляет в шифртексте статистические следы, по которым восстанавливается структура. Если бы язык был случаен, частотный анализ не работал бы.
Условная энтропия и взаимная информация
Энтропия одного распределения отвечает на вопрос «сколько неопределённости», но в криптографии важнее вопрос «сколько неопределённости осталось после наблюдения». Условная энтропия H(X \mid Y) — средняя неопределённость X при известном Y:
H(X \mid Y) = H(X, Y) - H(Y), \qquad H(X, Y) \le H(X) + H(Y)
Взаимная информация I(X; Y) измеряет, сколько Y сообщает об X:
I(X; Y) = H(X) - H(X \mid Y) = H(Y) - H(Y \mid X) \ge 0
Равенство I(M; C) = 0 — это и есть совершенная секретность: шифртекст не сообщает об открытом тексте ничего. Из определения Шеннона оно выводится напрямую и объясняет, почему OTP работает: для любого c распределение M при условии C = c совпадает с исходным, значит H(M \mid C) = H(M) и I(M; C) = 0.
Для вычислительной стойкости это соотношение не работает: I(M; C) может быть положительной, но извлечь информацию практически невозможно. Разница принципиальна — информационно-теоретическая стойкость не зависит от ресурсов противника, вычислительная зависит. Курс различает их явно и не переносит выводы одного уровня на другой.
Min-entropy
Средняя энтропия плохо описывает «худший случай». Распределение, в котором один пароль встречается с вероятностью 1/2, а остальные 2^{20} — почти равномерно, имеет энтропию около 20 бит, хотя угадать его можно с первой попытки в половине случаев. Для оценки стойкости к угадыванию используется min-entropy:
H_\infty(X) = -\log_2 \max_x p(x)
Это логарифм вероятности самого вероятного значения, то есть число бит неопределённости в худшем случае. Всегда H_\infty(X) \le H(X), и равенство достигается только на равномерном распределении. Пароли, ключи из парольных фраз и источники энтропии оцениваются именно по min-entropy; стандарты оценки источников (NIST SP 800-90B) работают с ней же. Ошибка «20 бит энтропии, значит 2^{20} попыток» возникает как раз из подмены H на H_\infty.
Сжатие не заменяет шифрование
Сжатие уменьшает избыточность, и это иногда принимают за «перемешивание». Два факта показывают, почему это не так. Во-первых, сжатие обратимо без ключа: любой, кто получил архив, распакует его. Во-вторых, сжатый поток сохраняет структуру — заголовки, длины, блоки, — по которой можно делать выводы. Классический частотный анализ на сжатом тексте не работает, но сама операция не является криптографической: у неё нет секрета.
Более тонкий эффект — утечка через длину. Если сжимать данные вместе с секретом до шифрования, размер шифртекста зависит от содержимого секрета; атаки CRIME и BREACH на TLS используют именно это. Отсюда практическое правило: сжатие и шифрование комбинируются осознанно, а не «для уменьшения объёма перед AES».
Расстояние единственности
Расстояние единственности (англ. unicity distance) — минимальная длина шифртекста, при которой ключ определяется однозначно по всем возможным открытым текстам. Оценка Шеннона:
N_0 \approx \frac{H(K)}{D}
Для простой замены H(K) = log₂(26!) ≈ 88,4 бита, D ≈ 3,2, значит N₀ ≈ 28 символов. Для Виженера с ключом длины L энтропия ключа L·log₂N, и расстояние единственности растёт линейно: ключ длины 10 требует около 280 символов.
Формула приблизительна, но полезна как ориентир. Она объясняет, почему короткие сообщения могут быть неоднозначны: несколько ключей дают осмысленные тексты, и выбор между ними невозможен без дополнительной информации. На длинном тексте осмысленный вариант остаётся один.
Повторное использование ключа
Пусть один и тот же ключ использован для двух сообщений: c₁ = m₁ ⊕ k, c₂ = m₂ ⊕ k. Тогда
c₁ ⊕ c₂ = m₁ ⊕ m₂
Ключ исчез, осталась комбинация открытых текстов. Если один текст известен или угадывается, второй восстанавливается полностью. Если оба неизвестны, работает crib-dragging: предполагаемый фрагмент одного текста подставляется в XOR и проверяется, даёт ли результат осмысленный фрагмент второго. Пробелы особенно полезны: XOR пробела с буквой меняет её регистр, что заметно в тексте.
Для Виженера повторное использование ключа с разными сдвигами — та же ошибка в другой форме. В теме 5 она возвращается как повтор nonce в поточном шифре, в теме 9 — как повтор nonce в AES-GCM, в теме 13 — как повтор nonce в ECDSA. Во всех случаях последствия катастрофические, и во всех случаях причина одна: одно и то же значение, которое должно быть уникальным, использовано дважды.
Вычислительная стойкость
Определение через ресурсы
Совершенная секретность недостижима для массовых систем, поэтому используют вычислительное определение. Схема (t, ε)-стойкая, если любой противник, работающий не более t операций, выигрывает с преимуществом не более ε. Функция ε(t) должна убывать быстрее любой обратной степени t — такое убывание называют пренебрежимо малым (англ. negligible).
На практике t и ε не измеряют для конкретной схемы: доказывают редукцию. Если из эффективной атаки на схему следует эффективное решение трудной задачи (факторизации, дискретного логарифма, задачи на решётках), то схема стойка при условии, что задача трудна. Такие доказательства не абсолютны: они опираются на недоказанные предположения о сложности задач 3.
Уровень стойкости в битах
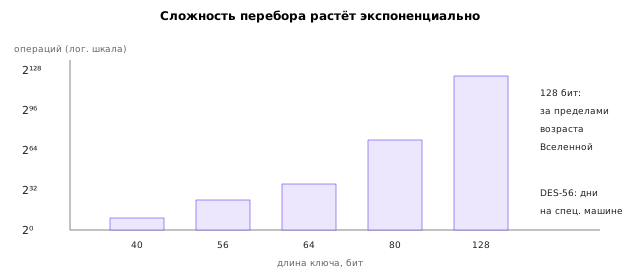
Уровень стойкости (англ. security level) в битах — это log₂ числа операций, необходимых для лучшей известной атаки. Ключ 128 бит даёт уровень около 128, если лучшая атака — перебор. Если известна атака с сложностью 2^100, уровень равен 100, сколько бы бит ни было в ключе.
Полезно помнить порядки. Перебор 56-битного ключа DES стал практически осуществим в 1998 году: машина EFF Deep Crack стоимостью около 250 тысяч долларов находила ключ в среднем за несколько дней. Пространство 2^56 ≈ 7,2·10^16; при миллиарде операций в секунду это около двух лет на одном устройстве, но специализированная машина работает на много порядков быстрее. Пространство 2^128 ≈ 3,4·10^38; при 10^18 операций в секунду перебор занимает около 10^13 лет — больше возраста Вселенной.
Схема ниже показывает соотношение между уровнем стойкости и длиной ключа для трёх семейств алгоритмов: у симметричных шифров они совпадают, у асимметричных длина ключа заметно больше, потому что лучшая атака не является перебором.
Соответствие уровней фиксируется в стандартах, и его удобно держать под рукой в виде таблицы.
| Уровень стойкости | Симметричный ключ | Модуль RSA и DH | Порядок эллиптической кривой |
|---|---|---|---|
| 112 бит | 112 | 2048 | 224 |
| 128 бит | 128 | 3072 | 256 |
| 192 бит | 192 | 7680 | 384 |
| 256 бит | 256 | 15360 | 512 |
Числа в правых столбцах объясняются сложностью задач, а не запасом «на всякий случай». Для факторизации модуля n лучший известный метод — общий решётчатый отбор (GNFS) с субэкспоненциальной сложностью, поэтому модуль 3072 бита соответствует примерно 2^128 операций. Для дискретного логарифма на эллиптической кривой лучший метод — ро Полларда со сложностью порядка √n; значит, уровня 2^128 достаточно достичь на кривой с порядком около 2^256, и длина ключа оказывается вдвое меньше уровня стойкости.
Отсюда практическое следствие, которое часто упускают: «увеличить ключ RSA до 4096 бит» не то же самое, что «повысить стойкость с 128 до 256 бит». Уровень 256 бит для RSA потребовал бы модуля порядка 15 360 бит — такие ключи почти не используются, потому что асимметричная часть протокола и так является самой дорогой. Вместо этого переходят на эллиптические кривые или на постквантовые схемы (тема 16).
Стоимость перебора и закон Мура
Оценка «2^128 лет» верна только при фиксированной скорости. Закон Мура и рост параллельных вычислений увеличивают скорость, поэтому длину ключа выбирают с запасом. Рекомендации NIST SP 800-57 задают уровни стойкости 112, 128, 192 и 256 бит и соответствующие им длины ключей для разных алгоритмов 4. Сводные таблицы разных организаций собраны на keylength.com 5.
Важно, что перебор — не единственная атака. Для блочных шифров существуют дифференциальный и линейный криптоанализ, для RSA — факторизация, для ECDLP — методы Полларда. Уровень стойкости определяется лучшей атакой, а не длиной ключа. Поэтому «ключ 256 бит» у самодельного шифра может означать уровень 40 бит, если структура слабая.
Энергетические и физические ограничения
Иногда приводят аргумент о физических пределах: перебор 2^256 вариантов требует энергии, сравнимой с энергией звезды. Такие оценки полезны как интуиция, но зависят от технологий и не являются доказательством. Для инженера практичнее правило: выбирать длину ключа по рекомендациям стандарта, а не по «сложности взлома», и обновлять параметры при изменении рекомендаций.
Модели атак и неразличимость
Четыре модели
Модели атак различаются тем, что противник знает и что может запрашивать.
- Только шифртекст (ciphertext-only): противник видит
cи не знает ничего обm. - Известный открытый текст (known-plaintext): противник знает пары
(m, c), но не выбирает их. - Выбранный открытый текст (chosen-plaintext, CPA): противник может получать шифртексты для выбранных
m. - Выбранный шифртекст (chosen-ciphertext, CCA): противник может получать расшифрования выбранных
c, кроме целевого.
Каждая модель сильнее предыдущей. Стойкость в модели CPA не влечёт стойкости в CCA: существуют схемы, которые невозможно вскрыть по выбранным открытым текстам, но можно — по выбранным шифртекстам (пример — учебный RSA с дополнением PKCS#1 v1.5 и атака Блейхенбахера, тема 12).
Игра IND-CPA
Неразличимость (англ. indistinguishability) формулируется как игра 2. Противник получает доступ к оракулу шифрования и выбирает два сообщения m₀, m₁ равной длины. Экспериментатор бросает монету b, шифрует m_b и отдаёт шифртекст. Противник должен угадать b. Преимущество (advantage) определяется как
Adv = |2 · P(противник угадал) − 1|
Множитель два выбран намеренно: при таком определении Adv лежит от 0 до 1, а Adv = 1 означает, что противник угадывает всегда. Эквивалентная запись — разность вероятностей ответа в двух экспериментах, |P(A → 1 | b = 1) − P(A → 1 | b = 0)|. Встречающаяся в литературе запись |P(успех) − 1/2| — это та же величина, делённая на два; курс пользуется формой с множителем везде, включая лабораторные работы.
Схема IND-CPA-стойкая, если для любого эффективного противника преимущество пренебрежимо мало. Заметьте: противник может шифровать сколько угодно сообщений, включая m₀ и m₁, — это и есть CPA.
Порядок шагов игры показан на схеме ниже: противник выбирает пару сообщений одинаковой длины, получает шифртекст одного из них и должен угадать, какого именно; оракул шифрования доступен ему в любой момент.
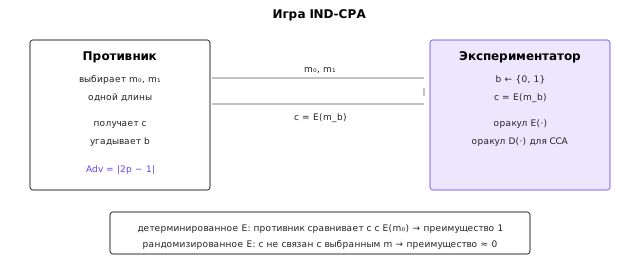
Требование равной длины сообщений существенно: шифртекст не должен выдавать длину сверх той, что известна из контекста. Практически это означает, что схема может утекать длину, но не содержимое, — и это считается допустимым, хотя для некоторых приложений длина сама по себе является секретом, и тогда требуется выравнивание (padding to fixed length).
Определение даётся через эксперимент: для схемы Π, противника A и случайного бита b вычисляется Exp^ind-cpa(Π, A, b), и преимущество противника равно |P(A выводит 1 | b = 1) − P(A выводит 1 | b = 0)|. Стойкость означает, что эта величина пренебрежимо мала как функция от параметра безопасности — длины ключа. Формулировка «пренебрежимо» важна: речь не о том, что противник не может угадать, а о том, что он не может делать это лучше случайного угадывания с существенным перевесом.
Модель имеет варианты. В неадаптивной версии противник выбирает пару сообщений заранее и не обращается к оракулу после получения целевого шифртекста; в адаптивной (её и используют по умолчанию) он может запрашивать шифрование в любой момент, в том числе после. Оракул возвращает шифртексты с честной случайностью, поэтому повторный запрос того же сообщения даёт другой шифртекст — именно это отличает стойкую схему от детерминированной.
Почему детерминированное шифрование не IND-CPA
Если шифрование детерминировано, одинаковые сообщения дают одинаковые шифртексты. Противник в игре запрашивает шифртексты m₀ и m₁ у оракула, получает c₀ и c₁, затем сравнивает с целевым c: совпадение указывает b с преимуществом 1. Никакой перебор не нужен.
Отсюда требование рандомизации: каждый вызов шифрования должен использовать свежее случайное значение (IV или nonce), чтобы одинаковые сообщения давали разные шифртексты. В теме 7 это требование к IV в CBC и к счётчику в CTR, в теме 9 — к nonce в AEAD. Нарушение уникальности nonce возвращает схему к детерминированному поведению и часто ломает её полностью.
Игра IND-CCA
В модели CCA противник дополнительно имеет оракул расшифрования, но не может запрашивать расшифрование целевого шифртекста (иначе игра тривиальна). Стойкость IND-CCA требуется от аутентифицированного шифрования: если схема позволяет отличить корректный шифртекст от испорченного по реакции системы, это уже оракул.
Именно так работает атака padding oracle (тема 7): сервер сообщает, корректен ли padding, и это сообщение превращается в оракул расшифрования. Формально схема может быть стойкой в CPA и полностью ломаться в CCA. Практическое правило: если приложение по-разному реагирует на разные ошибки расшифрования, оно строит оракул.
Формальная рамка стойкости
Свойства безопасности
Свойства формулируются через возможности противника, а не через название механизма. Конфиденциальность означает, что противник не может извлечь информацию о содержимом; целостность — что он не может изменить данные незаметно; аутентичность источника — что он не может выдать свои данные за чужие; неотрекаемость — что автор сообщения не может впоследствии отказаться от авторства; свежесть — что он не может выдать ранее отправленное сообщение за новое; защита метаданных — что скрыт не только текст, но и факт, время и участники обмена.
Свойства независимы. Шифрование даёт конфиденциальность, но не целостность: изменение шифртекста приводит к другому открытому тексту, и получатель об этом не узнает (тема 5, атака bit-flipping). MAC даёт целостность и аутентичность, но не скрывает содержимое. Подпись даёт аутентичность и неотрекаемость, но не конфиденциальность. Свежесть не следует ни из одного из них: её обеспечивает протокол — счётчик, метка времени или одноразовое значение (тема 15).
Неотрекаемость заслуживает отдельного замечания: она требует асимметричной конструкции. Симметричный MAC неотрекаемости не даёт, потому что обе стороны знают один и тот же ключ и любая из них могла бы создать тег. Именно поэтому юридически значимая подпись строится на схеме с открытым ключом и инфраструктуре сертификатов (тема 14).
Пассивный и активный противник
Пассивный противник наблюдает, но не вмешивается: перехватывает трафик, читает файлы, измеряет время. Активный — изменяет, удаляет, вставляет, повторяет сообщения, подменяет стороны. Активность строго сильнее: всё, что ломается пассивным противником, ломается и активным, поэтому модели IND-CPA и IND-CCA различаются именно доступом к оракулам, а не «силой» противника вообще.
Модель должна перечислять не только действия, но и знания: какие ключи у противника есть, сколько сессий он видит, может ли он выбирать данные, имеет ли доступ к устройству. Противник, читающий сеть, и противник, выполняющий код на той же машине, требуют разных механизмов. Формулировка «противник может всё» бесполезна: она не позволяет ничего доказать.
Игры и определения
Определение стойкости в современной криптографии строится как игра между экспериментатором и противником A. Эксперимент Exp(Π, A, λ) возвращает 0 или 1; преимущество — отклонение вероятности успеха от случайного угадывания:
Adv(Π, A, λ) = |2 · P[Exp(Π, A, λ) = 1] − 1|
Схема стойка в данной модели, если для любого противника, работающего за полиномиальное время, Adv пренебрежимо мала по λ. Три части определения обязательны: модель (что разрешено противнику), ограничение ресурсов и асимптотическая малость.
| Игра | Доступ противника | Условие выигрыша | Что обеспечивает |
|---|---|---|---|
| IND-CPA | Оракул шифрования | Угадать b для m₀, m₁ | Стойкость к выбранному открытому тексту |
| IND-CCA | Шифрование и расшифрование (кроме целевого c) | Угадать b | Стойкость к выбранному шифртексту, нужна для AEAD |
| EUF-CMA | Оракул подписи или MAC | Предъявить (m, t) для нового m | Стойкость к подделке |
| INT-CTXT | Шифрование и расшифрование | Предъявить новый c, принятый как корректный | Целостность шифртекста |
Стойкость к подделке формулируется через EUF-CMA (existential unforgeability under chosen-message attack): противник получает теги или подписи для любых сообщений по своему выбору и должен предъявить корректную пару для сообщения, которое не запрашивал. Заметьте, что EUF-CMA не требует, чтобы подделка была «осмысленной», — достаточно любого нового сообщения. В теме 9 это определение применяется к MAC, в темах 12–14 — к подписям.
PRF и PRP
Блочный шифр при фиксированном ключе — перестановка на множестве блоков. Стойкость формулируется как неотличимость от случайной перестановки: противник с оракульным доступом не может сказать, общается он с E_k или с равномерно выбранной перестановкой. Такая модель называется PRP (pseudo-random permutation). Если область значений не обязана быть перестановкой, модель называется PRF (pseudo-random function): неотличимость от случайной функции.
Различие тонкое, но важное для режимов. Режим CBC превращает перестановку в цепочку и требует от блочного шифра именно PRP; режим CTR использует блочный шифр как функцию от счётчика и требует PRF. Лемма о переключении PRP/PRF даёт количественную оценку: преимущества различаются не более чем на q²/2^n, где q — число запросов, n — длина блока. Отсюда и практические ограничения: для 64-битного блока при q = 2^32 поправка достигает порядка единицы, поэтому 64-битные блоки опасны на больших объёмах (Sweet32, тема 6). Для 128-битного блока 2^32 запросов дают поправку 2^-64, что пренебрежимо.
Свойство примитива и свойство протокола
Стойкость не передаётся по наследству. AES-128 в модели PRP стоек, но AES-128 в режиме ECB не является IND-CPA: одинаковые блоки дают одинаковые шифртексты. AES-GCM является AEAD-схемой, но при повторе nonce теряет и конфиденциальность, и целостность. Один и тот же примитив в разных композициях даёт разные свойства, и именно композиция — предмет анализа.
Отсюда два практических следствия. Первое: утверждение «используется AES-256» само по себе ничего не говорит о безопасности системы. Второе: композиции анализируются отдельно, и для типовых из них есть теоремы. Пример — encrypt-then-MAC: если MAC стойк в EUF-CMA, шифр стоек в IND-CPA и ключи независимы, композиция даёт IND-CCA и INT-CTXT (тема 9). Для нестандартной композиции такой теоремы нет, и её стойкость неизвестна, даже если оба примитива хороши.
Редукции и предположения о трудности
Доказательство стойкости схемы Π обычно имеет форму редукции: строится алгоритм B, который, используя противника A как подпрограмму, решает трудную задачу P. Тогда
Adv_Π(A) ≤ Adv_P(B) + ε
Если P считается трудной (факторизация, дискретный логарифм, CDH, DDH, задача обучения с ошибками), а ε мало, схема стойка при этом предположении. Формулировка «стойка, если трудна задача P» честнее, чем «стойка» без оговорок: при появлении эффективного алгоритма для P рушится всё, что на неё опиралось.
У редукций есть цена. Потери в оценке могут быть квадратичными по числу запросов (типичный множитель q²), и тогда «доказанная» стойкость при реальных параметрах ничего не гарантирует. Различают также стандартную модель и модель случайного оракула: вторая удобнее для доказательств, но не описывает реальную хеш-функцию, и схема, стойкая только в ней, требует осторожности.
Наконец, «атака известна» и «атака применима» — разные утверждения. Для 80-битной стойкости известен перебор за 2^80 операций; это не делает систему безопасной, но и не означает, что атака доступна в 2026 году конкретному противнику. При этом атака за 2^40 при тех же допущениях практически применима. Оценка всегда включает модель противника, оборудование и дату — иначе это не оценка, а число.
От теории к практике
Рекомендации по длинам ключей
Стандартная практика на середину 2020-х: симметричные ключи 128 бит для обычных данных и 256 бит для долгосрочных секретов; RSA не короче 2048 бит, лучше 3072; ECC — P-256 или Curve25519; хеш-функции — SHA-256 и сильнее. Эти значения соответствуют уровням стойкости 112–128 бит и согласованы с рекомендациями NIST 4 и CFRG 8.
Длины ключей — не вечная константа. Постквантовые схемы (тема 16) требуют других параметров, а переход на них уже начался в TLS. Инженерная привычка: хранить параметры в конфигурации, а не в коде, и иметь план их обновления.
Чего не делает «перемешивание»
Распространённая ошибка — заменить криптографию самодельной схемой: «сдвинем байты, сложим с паролем, посчитаем CRC». Такая конструкция обычно нестойка, потому что её структура видна аналитику, а не потому, что она «недостаточно сложна». Сложность без обоснования не даёт стойкости 7: современные шифры выглядят простыми, но их стойкость доказана редукциями и проверена десятилетиями атак.
Второе правило: не изобретать протокол. Примитивы можно комбинировать только по известным схемам (encrypt-then-MAC, AEAD, KEM/DEM), и каждая комбинация имеет анализ. Тема 9 показывает, чем отличаются три способа сочетания шифрования и MAC и почему один из них безопасен, а два — нет.
Связь со следующей темой
Вычислительная стойкость предполагает, что ключи и nonce действительно случайны. Если генератор предсказуем, противник может восстановить ключ, не перебирая его, и все оценки сложности становятся неверными. Следующая тема разбирает генераторы случайных чисел: физические источники, криптографически стойкие конструкции, историю Dual_EC_DRBG и реальные провалы — от Debian OpenSSL 2008 до повторного nonce в ECDSA.
Итоги темы
Стойкость имеет три уровня. Совершенная секретность Шеннона требует, чтобы шифртекст не менял вероятностей открытых текстов; она достигается одноразовым блокнотом, требует ключа не короче сообщения и разрушается при повторном использовании ключа. Расстояние единственности показывает, сколько текста нужно для однозначного определения ключа, и объясняет роль избыточности языка. Вычислительная стойкость измеряет стоимость лучшей известной атаки в битах и опирается на недоказанные предположения о сложности задач.
Модели атак задают, что именно считается атакой. IND-CPA требует рандомизации шифрования, IND-CCA — устойчивости к оракулу расшифрования; детерминированная схема не может быть IND-CPA, а схема без аутентификации обычно не бывает IND-CCA. Практические рекомендации по длинам ключей следуют из этих определений, а не из «сложности на глаз».
Следующая тема переносит внимание с алгоритмов на источник случайности. Ключ, nonce и соль должны быть непредсказуемы; если это не так, стойкость схемы не имеет значения. История знает достаточно примеров, чтобы считать это правило инженерным, а не теоретическим.
Литература
- Shannon C. E. Communication Theory of Secrecy Systems. — Bell System Technical Journal, 1949, Т. 28, № 4, С. 656–715.
- Katz J., Lindell Y. Introduction to Modern Cryptography. 3rd ed. — CRC Press, 2020.
- Boneh D., Shoup V. A Graduate Course in Applied Cryptography. — Открытое издание, 2023. https://toc.cryptobook.us/
- NIST. Recommendation for Key Management, Part 1: General. — SP 800-57 Part 1 Rev. 5, 2020. https://doi.org/10.6028/NIST.SP.800-57pt1r5
- BlueKrypt. Cryptographic Key Length Recommendation. — 2025. https://www.keylength.com/
- NSA. Venona: Soviet Espionage and the American Response 1939–1957. — National Security Agency, 1996.
- Aumasson J.-P. Serious Cryptography: A Practical Introduction to Modern Encryption. 2nd ed. — No Starch Press, 2024.
- Menezes A. J., van Oorschot P. C., Vanstone S. A. Handbook of Applied Cryptography. — CRC Press, 1996. https://cacr.uwaterloo.ca/hac/