
Математические основы асимметричной криптографии
Асимметричные схемы — обмен ключами, электронная подпись, шифрование с открытым ключом — опираются на задачи, которые легко сформулировать и трудно решить. Чтобы понимать эти схемы, а не запоминать их как рецепты, нужен небольшой аппарат: арифметика вычетов, алгоритм Евклида, теоремы Ферма и Эйлера, китайская теорема об остатках, быстрое возведение в степень, проверка чисел на простоту и понятие группы. Ничего сверх этого в курсе не понадобится: все дальнейшие темы — RSA (тема 12), обмен Диффи — Хеллмана (тема 11), эллиптические кривые (тема 13) — используют именно этот набор.
Тема устроена как подготовка инструмента, а не как изложение схем. Сначала — арифметика: как делить с остатком, как считать наибольший общий делитель, как находить обратный элемент. Затем — теоремы, которые превращают эту арифметику в вычислительный инструмент: они объясняют, почему a^(p−1) ≡ 1 (mod p) и как это использовать. После — китайская теорема об остатках и быстрое возведение в степень: две техники, без которых не обходится ни одна реализация. Далее — простые числа: как их искать, как отличать от составных и почему тест Ферма обманывается числами Кармайкла. Завершают тему группы и задача дискретного логарифма — та самая трудная задача, на которой держится половина курса, — и конечные поля, включая арифметику в GF(2^8), знакомую по AES.
Все числовые примеры в теме пересчитаны; для каждой нетривиальной формулы указано, откуда она берётся. Это важно, потому что в криптографии ошибка в один бит или в один модуль превращает стойкую конструкцию в учебный пример.
Паспорт темы. Нужно знать: темы 0. Освоите: работать с вычетами, расширенным Евклидом и КТО; возводить в степень за
log nумножений; проверять простоту Миллером — Рабином; различать группу, кольцо и поле; объяснять связь DLP, CDH и DDH. Проверяет: ЛР 4. Минимум: разделы 1–5. Углубление: раздел 6.
Арифметика вычетов
Делимость, НОД и алгоритм Евклида
Целое число a делит b, если существует такое целое k, что b = a·k. Запись: a | b. Отношение делимости транзитивно и сохраняется при сложении: если a | b и a | c, то a | (b + c). Эти два свойства — всё, что нужно для дальнейшего.
Наибольший общий делитель gcd(a, b) — наибольшее число, делящее и a, и b. Он существует для любых целых, кроме пары нулей, и всегда неотрицателен. Ключевое тождество, на котором держится весь алгоритм, записывается как gcd(a, b) = gcd(b, a mod b).
Причина проста: если d делит a и b, то a mod b = a − q·b тоже делится на d, и наоборот. Значит, множество общих делителей пары (a, b) совпадает с множеством общих делителей пары (b, a mod b), а вместе с ним совпадает и наибольший из них.
Отсюда алгоритм Евклида: заменять пару (a, b) парой (b, a mod b), пока второе число не станет нулём. Остаток на каждом шаге меньше предыдущего, поэтому процесс конечен. Число шагов логарифмическое: для чисел не больше n оно не превышает 5·log₁₀ n, то есть для 1024-битного модуля — порядка 310 шагов 1. Это одна из причин, по которой криптография на вычетах вообще практична.
Наименьшее общее кратное связано с НОД простым соотношением lcm(a, b) = |a·b| / gcd(a, b), поэтому отдельный алгоритм для него не нужен.
Если gcd(a, b) = 1, числа называют взаимно простыми. Это условие встретится дальше постоянно: обратный элемент существует только у взаимно простого с модулем числа, а показатель степени в схеме RSA должен быть взаимно прост с функцией Эйлера.
Расширенный алгоритм Евклида
Обычный алгоритм Евклида находит только сам НОД. Расширенный находит ещё и коэффициенты s, t, для которых выполняется тождество Безу: s·a + t·b = gcd(a, b).
Тождество Безу — не абстрактное утверждение: именно оно даёт обратный элемент по модулю. Если gcd(a, m) = 1, то s·a + t·m = 1, а значит s·a ≡ 1 (mod m), то есть s и есть a⁻¹ mod m.
Алгоритм ведёт три последовательности одновременно: остатки r_i, и коэффициенты s_i, t_i при a и b. Начальные значения — (r₀, r₁) = (a, b), (s₀, s₁) = (1, 0), (t₀, t₁) = (0, 1). На каждом шаге вычисляется частное q = r_i / r_{i+1} и все три пары обновляются одним правилом: новое значение равно предыдущее − q · текущее.
Разберём на числах a = 240, b = 46:
| шаг | r | q | s | t |
|---|---|---|---|---|
| 0 | 240 | — | 1 | 0 |
| 1 | 46 | — | 0 | 1 |
| 2 | 10 | 5 | 1 | −5 |
| 3 | 6 | 4 | −4 | 21 |
| 4 | 4 | 1 | 5 | −26 |
| 5 | 2 | 1 | −9 | 47 |
| 6 | 0 | 2 | 23 | −120 |
Работа останавливается, когда остаток стал нулём. Последний ненулевой остаток равен gcd(240, 46) = 2, а коэффициенты предыдущей строки дают −9·240 + 47·46 = 2. Проверка: −2160 + 2162 = 2, верно.
На Python это записывается без рекурсии и без хранения таблицы — достаточно четырёх переменных:
def ext_gcd(a, b):
    old_r, r = abs(a), abs(b)
    old_s, s = 1, 0
    old_t, t = 0, 1
    while r:
        q = old_r // r
        old_r, r = r, old_r - q * r
        old_s, s = s, old_s - q * s
        old_t, t = t, old_t - q * t
    if a < 0:
        old_s = -old_s
    if b < 0:
        old_t = -old_t
    return old_r, old_s, old_t
Функция возвращает тройку (gcd, s, t). Обработка отрицательных входных данных через abs с последующей поправкой знака нужна, чтобы результат удовлетворял тождеству Безу при любых знаках аргументов: усечённое деление в Python ведёт себя не так, как математическое деление с остатком, и без этой поправки знак коэффициента может оказаться неверным.
Сложность расширенного алгоритма та же, что у обычного, — O(log min(a, b)) делений. Никакой факторизации при этом не происходит: алгоритм работает с парой чисел как с целыми, а не раскладывает их на множители.
Обратный элемент и кольцо вычетов
Модульная арифметика — это арифметика остатков от деления на фиксированное число m. Два целых a и b сравнимы по модулю m, если m | (a − b); запись a ≡ b (mod m). Множество остатков {0, 1, …, m−1} с операциями сложения и умножения по модулю образует кольцо вычетов Z/mZ.
Кольцо — не поле: делить можно не всегда. Обратный элемент a⁻¹ существует тогда и только тогда, когда gcd(a, m) = 1. Если модуль простой, обратимы все ненулевые остатки, и кольцо становится полем GF(p). Если модуль составной, обратимы только остатки, взаимно простые с ним, и их число равно φ(m).
Вычислительно обратный элемент находится расширенным алгоритмом Евклида. В Python 3.8 появилась встроенная функция pow(a, -1, m), которая делает то же самое и возбуждает исключение ValueError, если обратного элемента нет:
print(pow(3, -1, 11))          # 4, потому что 3·4 = 12 ≡ 1 (mod 11)
print(pow(7, -1, 26))          # 15, потому что 7·15 = 105 = 4·26 + 1
print(ext_gcd(3, 11))          # (1, 4, -1): 4·3 + (-1)·11 = 1
print(pow(6, -1, 9))           # ValueError: gcd(6, 9) = 3
Сравнение результатов полезно в обе стороны: pow служит эталоном для собственной реализации, а собственная реализация объясняет, что именно происходит внутри. В лабораторной работе обе сверяются на случайных парах, включая отрицательные и большие значения.
Осторожность нужна с модулем-степенью двойки. Для m = 2^k обратимы ровно нечётные числа, и обратный элемент можно вычислить итеративно без Евклида, но главное — помнить: если в схеме модуль составной, а разработчик считает его простым, то обратный элемент существует не для всех значений, и код, который «обычно работает», будет падать на некоторых входах. Отсюда требование проверять параметры, а не полагаться на удачу.
Теоремы Ферма, Эйлера и китайская теорема об остатках
Малая теорема Ферма
Если p — простое, а a не делится на p, то a^(p−1) ≡ 1 (mod p) 1.
Утверждение доказано ещё в XVII веке и имеет короткое комбинаторное обоснование. Рассмотрим последовательность a, 2a, 3a, …, (p−1)a по модулю p. Все её элементы ненулевые и попарно различны: если i·a ≡ j·a (mod p), то (i − j)·a ≡ 0, а поскольку a обратимо, i ≡ j. Значит, эта последовательность — перестановка чисел 1, 2, …, p−1. Перемножив обе последовательности, получаем a^(p−1)·(p−1)! ≡ (p−1)!, и после сокращения на (p−1)! (он не делится на p) остаётся a^(p−1) ≡ 1.
Следствие, которым пользуются чаще: a^p ≡ a (mod p) для любого a, включая кратные p.
Практическая ценность теоремы в том, что она даёт обратный элемент почти даром: a⁻¹ ≡ a^(p−2) (mod p). Это возведение в степень, которое всё равно нужно реализовывать для схем, поэтому отдельный алгоритм Евклида иногда не пишут. Однако для составных модулей формула неверна, а для простых она требует log p умножений против log p делений у Евклида — выигрыша нет, есть только совместимость с уже имеющимся кодом.
Из теоремы Ферма также следует, что порядок элемента в мультипликативной группе по простому модулю делит p − 1. Это утверждение — частный случай теоремы Лагранжа, к которой тема вернётся ниже.
Функция Эйлера
Функция Эйлера φ(m) — количество чисел в диапазоне от 1 до m, взаимно простых с m. Она же — число обратимых элементов кольца Z/mZ.
Свойства, которые нужны на практике:
- для простого
pвыполненоφ(p) = p − 1, потому что все числа меньшеpвзаимно просты с ним; - для произведения взаимно простых
mиnвыполненоφ(m·n) = φ(m)·φ(n)— функция мультипликативна; - для простого
pи натуральногоkвыполненоφ(p^k) = p^k − p^(k−1) = p^k·(1 − 1/p), поскольку из диапазона выпадают только кратныеp.
Из мультипликативности и третьего свойства получается общая формула. Если m = p₁^α₁ · p₂^α₂ · … · p_k^α_k, то φ(m) = m · (1 − 1/p₁) · (1 − 1/p₂) · … · (1 − 1/p_k).
Например, φ(561) = φ(3)·φ(11)·φ(17) = 2·10·16 = 320. Формула требует знать разложение на множители, поэтому вычисление φ(m) для большого составного m — задача той же сложности, что и факторизация. На этом наблюдении держится идея RSA: тот, кто знает разложение модуля, легко вычисляет φ(n), а тот, кто не знает, — нет.
Полезно помнить среднюю величину: φ(m) ведёт себя как m с точностью до множителя порядка log log m, то есть доля обратимых остатков велика. Именно поэтому случайно выбранное число оказывается взаимно простым с модулем с высокой вероятностью, и алгоритмы генерации параметров не застревают надолго.
Теорема Эйлера и её следствия
Теорема Эйлера обобщает теорему Ферма на составные модули: если gcd(a, m) = 1, то a^φ(m) ≡ 1 (mod m).
Доказательство повторяет идею Ферма, только вместо всех ненулевых остатков берётся множество обратимых: умножение на a переставляет его, произведение всех элементов сокращается, остаётся a^φ(m) ≡ 1.
Следствие для вычислений: показатель степени можно приводить по модулю φ(m). Если нужно вычислить a^e mod m при большом e, допустима замена e на e mod φ(m). Это основа всех оптимизаций в схемах с открытым ключом, и это же — источник ошибок, когда приведение делают, забыв о взаимной простоте.
Теорема Эйлера объясняет и обратимость шифрования в RSA. Если n = p·q и e·d ≡ 1 (mod φ(n)), то (m^e)^d = m^(e·d) = m^(1 + k·φ(n)) ≡ m (mod n) для всех m, взаимно простых с n. Отдельная тонкость — случай, когда m не взаимно просто с n; он разбирается в теме 12 и требует китайской теоремы об остатках, потому что сравнение проверяется по модулям p и q независимо.
Наконец, теорема полезна для анализа: если известно, что a^φ(m) ≡ 1, но для некоторого a это не так, то m заведомо составное. Это уже тест на простоту, и он разбирается ниже — вместе с причиной, по которой его недостаточно.
Китайская теорема об остатках
Если модули m₁, m₂, …, m_k попарно взаимно просты, то система сравнений x ≡ a₁ (mod m₁), x ≡ a₂ (mod m₂), …, x ≡ a_k (mod m_k) имеет единственное решение по модулю M = m₁·m₂·…·m_k. Это и есть китайская теорема об остатках (англ. Chinese remainder theorem, CRT). Первые упоминания конструкции встречаются в китайском трактате III века, а современная формулировка — у Гаусса.
Конструктивное доказательство даёт и алгоритм. Обозначим M_i = M / m_i. Поскольку M_i взаимно просто с m_i, существует обратный элемент N_i = M_i⁻¹ mod m_i. Тогда решение собирается как x = Σ a_i · M_i · N_i (mod M) 2.
Каждое слагаемое a_i·M_i·N_i сравнимо с a_i по модулю m_i и сравнимо с нулём по всем остальным модулям, потому что содержит множитель M_j. Сумма, таким образом, имеет ровно нужные остатки.
Существование решения доказано конструкцией, единственность — отдельным рассуждением. Пусть x и y — два решения. Тогда x − y делится на каждый из m_i, а поскольку модули попарно взаимно просты, x − y делится и на их произведение M. Значит, x ≡ y (mod M), то есть решение единственно в кольце Z/MZ.
Полезно посмотреть на это как на отображение φ: Z/MZ → Z/m₁Z × … × Z/m_kZ, φ(x) = (x mod m₁, …, x mod m_k). Оно переводит сложение и умножение в покоординатные операции, то есть является гомоморфизмом колец. Инъективность — это ровно единственность, а мощность области и образа совпадает (M = m₁·…·m_k), поэтому инъективность влечёт биективность. Отсюда и берётся «разбиение» вычислений: арифметика по большому модулю эквивалентна независимой арифметике по маленьким, и обратное отображение задаётся той же формулой с M_i·N_i.
Разберём на малых числах систему x ≡ 2 (mod 3), x ≡ 3 (mod 5), x ≡ 2 (mod 7). Здесь M = 105, а вспомогательные величины таковы: M₁ = 35, 35⁻¹ mod 3 = 2; M₂ = 21, 21⁻¹ mod 5 = 1; M₃ = 15, 15⁻¹ mod 7 = 1. Тогда x = 2·35·2 + 3·21·1 + 2·15·1 = 140 + 63 + 30 = 233, а 233 mod 105 = 23.
Проверка: 23 = 7·3 + 2 (остаток 2), 23 = 4·5 + 3 (остаток 3), 23 = 3·7 + 2 (остаток 2). Решение 23 единственно по модулю 105.
Геометрически теорема означает, что кольцо вычетов по составному модулю распадается в произведение колец по взаимно простым множителям. Схема ниже показывает это разбиение: одно большое сравнение заменяется набором маленьких, независимых друг от друга.
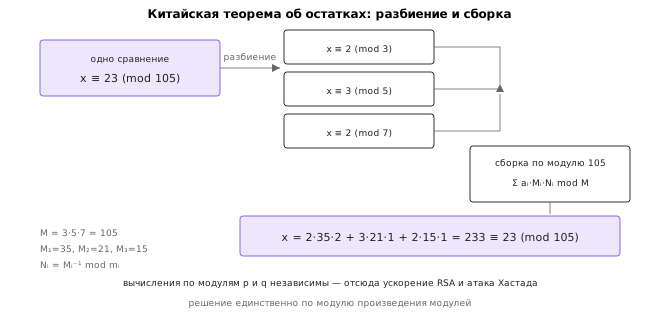
В криптографии КТО применяется в трёх ролях. Первая — ускорение: вычисления по модулю n = p·q выполняются отдельно по p и по q, где числа вдвое короче, а затем собираются; так работает ускорение RSA-расшифрования, дающее выигрыш примерно в четыре раза. Вторая — атака: если одна и та же величина передана с разными модулями, КТО восстанавливает её без всякого ключа — это основа атаки Хастада на RSA с малым показателем (тема 12). Третья — конструирование протоколов с разделением секрета: схемы, где доли секрета выдаются по разным модулям, собирают его ровно по этой формуле.
Отдельно отметим вычислительную сторону: КТО превращает работу с длинными числами в работу с короткими, а на коротких числах умножение квадратично по длине. Именно поэтому в реализациях RSA расшифрование через КТО заметно быстрее, чем «в лоб», и это стандартная оптимизация, а не экзотика.
Быстрое возведение в степень
Бинарный алгоритм
Возводить в степень «в лоб», умножая основание e раз, в криптографии невозможно: показатель содержит сотни или тысячи бит. Бинарный алгоритм (англ. square-and-multiply) сводит работу к log₂ e возведениям в квадрат и примерно столько же умножений.
Идея — в двоичной записи показателя. Если e = Σ b_i·2^i, то a^e = Π (a^(2^i))^b_i.
Величины a^(2^i) получаются последовательным возведением в квадрат: a, a², a⁴, a⁸, …. Остаётся перемножить те из них, которым соответствуют единичные биты. Схема ниже показывает порядок действий для показателя 200 = 11001000₂: семь возведений в квадрат и три умножения.
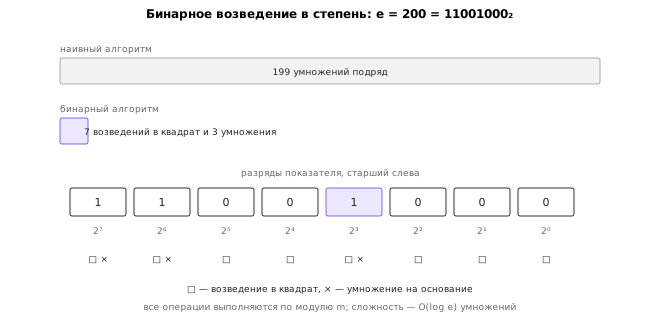
Алгоритм удобно записывать в двух вариантах. Вариант «слева направо» читает биты от старшего к младшему и накапливает результат в одной переменной:
def fast_pow(base, exp, mod):
    result = 1
    base %= mod
    mults = 0
    squares = 0
    while exp:
        if exp & 1:
            result = result * base % mod
            mults += 1
        exp >>= 1
        if exp:
            base = base * base % mod
            squares += 1
    return result, mults, squares


print(fast_pow(3, 200, 1000))   # (1, 3, 7): 3^200 mod 1000 = 1
print(fast_pow(7, 128, 1000))   # (801, 1, 7): 7^128 mod 1000 = 801
Счётчики в возвращаемом значении — не украшение: в лабораторной работе они сверяются с теоретической оценкой ⌊log₂ e⌋ возведений в квадрат и popcount(e) умножений. Для e = 200 двоичная запись 11001000 содержит три единицы, и в точности три умножения видны в выводе.
Вариант «справа налево» обрабатывает биты от младшего к старшему, накапливая степени основания; он удобнее, когда показатель заранее неизвестен, и позволяет распараллелить вычисление по модулям через КТО. В криптографических библиотеках обычно реализован вариант с фиксированным окном (англ. sliding window): показатель разбивается на блоки по w бит, и для каждого блока заранее вычисляются все 2^w степеней основания. При w = 4 число умножений снижается примерно на четверть по сравнению с побитным алгоритмом, а предварительная таблица остаётся маленькой.
Стоимость операции и защита от утечек
Стоимость возведения в степень определяется стоимостью умножения по модулю. Для n-битного модуля школьное умножение требует O(n²) операций над словами, алгоритм Карацубы — O(n^1.585), а умножение на основе быстрого преобразования Фурье — почти линейно по n. На практике для 1024–4096 бит используют комбинацию Карацубы и школьного метода, потому что асимптотически лучшие алгоритмы начинают выигрывать лишь на очень больших числах.
Важна не только скорость, но и постоянство времени выполнения. В схеме с секретным показателем — например, при расшифровании RSA или при вычислении общего секрета Диффи — Хеллмана — ветвления if bit == 1 выполняются за разное время. Противник, измеряющий задержки (атака по времени), может восстановить показатель побитно, а вместе с ним и ключ. Идея атаки принадлежит Паулю Кохеру и опубликована в 1996 году 12; она показывает, что утечка через время выполнения — такая же уязвимость, как ошибка в протоколе.
Защита — делать алгоритм независимым от данных: всегда выполнять и умножение, и возведение в квадрат, выбирая результат маской, либо переходить к схемам с фиксированным числом операций (англ. constant-time). Формально это означает, что последовательность обращений к памяти и число операций не должны зависеть от секретных значений. В cryptography и OpenSSL соответствующие функции спроектированы так; писать собственное возведение в степень для работы с секретами — плохая идея именно из-за этой утечки, а не из-за скорости.
Ещё одна тонкость — модульное умножение. Наивное (a * b) % m в Python безопасно, потому что целые произвольной длины, но в C или Rust произведение двух 64-битных чисел переполняет регистр, и его нужно вычислять либо через 128-битный тип, либо через алгоритм Монтгомери. Ошибка здесь даёт не «приблизительный» результат, а совсем другой, и обнаруживается только тестовым вектором.
Простые числа и проверка на простоту
Распределение простых чисел
Простое число делится только на единицу и на себя. Теорема о распределении простых чисел утверждает, что число простых, не превышающих x, обозначаемое π(x), асимптотически равно x / ln x. Иначе говоря, доля простых среди чисел около x составляет примерно 1 / ln x.
Оценка сразу даёт практическое следствие: около 1024-битного числа доля простых равна 1 / ln(2^1024) ≈ 1 / 710. Значит, перебирая случайные 1024-битные нечётные числа и проверяя каждое, простое удаётся найти в среднем за 355 попыток. Именно так и работают генераторы параметров: случайный кандидат, проверка, отбраковка, следующий кандидат.
Постоянная, уточняющая асимптотику, полезна для оценки: π(x) ≈ x / (ln x − 1). Отсюда доля простых среди нечётных чисел около x составляет 2 / ln x: для 1024 бит это 1 / 355, для 2048 — 1 / 710. Именно эти числа и определяют среднее время генерации.
Плотность простых падает медленно, а вместе с ней медленно растёт время генерации: для 2048 бит нужно в среднем около 710 попыток, для 4096 — около 1420. Это ещё одна причина, по которой в протоколах избегают генерации новых больших простых на каждый запрос: параметры генерируют один раз и переиспользуют.
Важное следствие для криптографии: простые числа распределены достаточно плотно, чтобы случайный поиск работал, но недостаточно плотно, чтобы их можно было перечислять. Поэтому все схемы с открытым ключом либо генерируют простые при инициализации, либо берут их из стандартных групп с фиксированными параметрами, как в RFC 3526 и RFC 7919.
Тест Ферма и числа Кармайкла
Из малой теоремы Ферма немедленно получается тест: выбрать случайное a, взаимно простое с n, вычислить a^(n−1) mod n; если результат не равен единице, число составное. Такое a называют свидетелем составности.
Обратное неверно: если результат равен единице, число может быть составным. Более того, существуют составные n, для которых сравнение выполняется при всех a, взаимно простых с n. Их называют числами Кармайкла. Наименьшее — 561 = 3·11·17; далее идут 1105, 1729, 2465, 2821, 6601.
Проверим 561 вручную. Для a = 2 имеем 2^560 mod 561 = 1, для a = 5 — тоже 1, для a = 7 — тоже 1. Тест Ферма объявляет число простым при каждом из этих оснований, и никакое увеличение числа оснований не помогает: для числа Кармайкла единица получится при любом a, взаимно простом с ним.
Малые числа Кармайкла и псевдопростые по основанию 2 приведены в таблице ниже — они используются в лабораторной работе как проверочный набор.
| Число | Разложение | Тип | Обманывает тест |
|---|---|---|---|
| 341 | 11·31 | псевдопростое по основанию 2 | Ферма, база 2 |
| 561 | 3·11·17 | число Кармайкла | Ферма, все базы |
| 645 | 3·5·43 | псевдопростое по основанию 2 | Ферма, база 2 |
| 1105 | 5·13·17 | число Кармайкла | Ферма, все базы |
| 1729 | 7·13·19 | число Кармайкла | Ферма, все базы |
| 2047 | 23·89 | сильное псевдопростое по основанию 2 | Миллер — Рабин, база 2 |
Последняя строка важна: 2047 обманывает не только тест Ферма, но и более сильный тест Миллера — Рабина при основании 2. Это не означает, что тест бесполезен, — означает, что одного основания недостаточно, и число раундов должно быть выбрано осознанно.
Числа Кармайкла не редкость: до 10^21 их насчитывается порядка двадцати миллионов, и они не кончаются. Критерий Корселта даёт их точное описание: n является числом Кармайкла тогда и только тогда, когда оно свободно от квадратов и для каждого простого p | n выполнено (p − 1) | (n − 1). Конструкция Черника (6k+1)(12k+1)(18k+1) при простых множителях даёт бесконечные семейства таких чисел. Поэтому тест Ферма в чистом виде в криптографии не применяется, хотя его идея лежит в основе всех практических тестов.
Тест Миллера — Рабина
Тест Миллера — Рабина 89 усиливает идею Ферма, используя структуру показателя. Пусть n нечётно и n − 1 = 2^s·d, где d нечётно. Тогда для случайного a вычисляется последовательность a^d, a^(2d), a^(4d), …, a^(2^s·d) (mod n).
Если n простое, то a^(n−1) ≡ 1, а значит, последний элемент равен единице. Кроме того, в последовательности квадратов, начинающейся с a^d, первый элемент, равный единице, должен быть квадратом единицы, то есть либо 1, либо n − 1. Отсюда критерий: число n проходит тест при основании a, если a^d ≡ 1 (mod n) или если в последовательности встречается n − 1.
Схема ниже показывает обе ветви проверки и то, как отбраковывается составное число.
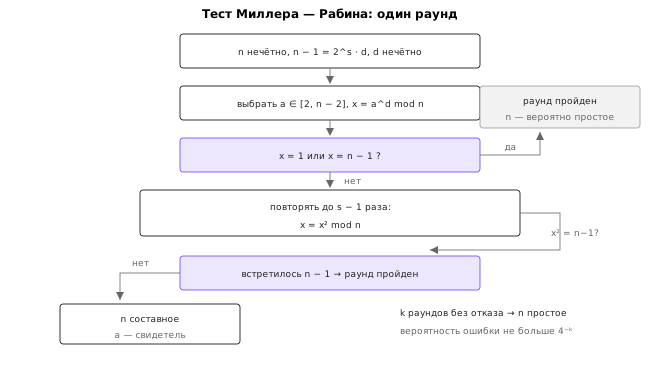
Реализация занимает десяток строк:
def miller_rabin(n, rounds=40):
    if n < 4:
        return n in (2, 3)
    if n % 2 == 0:
        return False

    d = n - 1
    s = 0
    while d % 2 == 0:
        d //= 2
        s += 1

    for _ in range(rounds):
        a = random.randrange(2, n - 1)
        x = pow(a, d, n)
        if x == 1 or x == n - 1:
            continue
        for _ in range(s - 1):
            x = x * x % n
            if x == n - 1:
                break
        else:
            return False
    return True
Вероятностная гарантия формулируется так: для составного n доля оснований, на которых тест ошибается, не превышает 1/4; после k независимых раундов вероятность ошибки не больше 4^(−k). При k = 40 это меньше 2^−80, что для практических целей достаточно.
Оценку можно улучшить. Для 64-битных чисел доказано, что достаточно проверить основания 2, 3, 5, 7, 11, 13, 17, 19, 23, 29, 31, 37 — ошибки не будет вовсе. Для чисел меньше 3·10^24 достаточно первых тринадцати простых оснований. Отсюда практическое правило: для чисел, помещающихся в 64 бита, тест детерминирован; для больших — вероятностный с 40 раундами, и этого достаточно.
Отдельно существует детерминированный полиномиальный тест AKS, доказавший, что проверка простоты лежит в классе P 10. Практического значения он не имеет: константы в оценке сложности огромны, и для 1024-битных чисел Миллер — Рабин быстрее на много порядков. Ценность результата теоретическая — он снял вопрос о принципиальной сложности задачи.
В лабораторной работе тест проверяется на двух наборах: на числах Кармайкла и сильных псевдопростых (должен отбраковать) и на простых из openssl prime (должен принять). Дополнительно измеряется время на 512-, 1024- и 2048-битных числах, чтобы увидеть логарифмический рост числа раундов возведения в степень.
Генерация больших простых
Генерация простого числа состоит из трёх шагов: получить случайный кандидат нужной длины, проверить его на простоту, при отказе — изменить кандидат и повторить. Ключевые решения — в деталях.
Первое: старший бит кандидата устанавливают в единицу, чтобы длина была точной, а младший — в единицу, чтобы число было нечётным. Второе: перед тестом Миллера — Рабина полезно отбросить кандидатов, делящихся на малые простые (2, 3, 5, 7, …, 1000). Это дешёвая операция — одно деление вместо возведения в степень, — и она отбрасывает около 80 % составных кандидатов, ускоряя генерацию в разы.
Третье: кандидата изменяют инкрементом на 2, а не выбирают заново. Так делают и OpenSSL, и cryptography: перебор идёт по арифметической прогрессии, пока не найдётся простое. При этом важно, чтобы стартовое значение было действительно случайным: если оно предсказуемо, предсказуемо и простое.
Четвёртое: для схем, где простое должно обладать дополнительными свойствами (безопасное простое p = 2q + 1, где q тоже простое), генерация становится дороже, потому что вероятность simultaneous выполнения двух условий падает. Именно поэтому стандартные группы Диффи — Хеллмана фиксированы в RFC, а не генерируются на лету.
Проверить результат можно независимо, командой openssl prime:
openssl prime -generate -bits 1024 > p.txt
openssl prime -hex $(cat p.txt)
openssl prime 561
1EEF (7919) is prime
231 (561) is not prime
Вывод openssl prime показывает число в шестнадцатеричном виде и в скобках — в десятичном; для больших чисел вторая часть выводится сокращённо. Сверка собственной реализации с этой командой — обязательный шаг лабораторной работы: она ловит ошибки, которые вероятностный тест пропускает из-за неверной раскладки показателя.
Группы и задача дискретного логарифма
Группы, подгруппы и теорема Лагранжа
Группа — множество G с операцией, которая ассоциативна, имеет нейтральный элемент и для каждого элемента — обратный. Если операция коммутативна, группа абелева. Примеры, которые нужны в курсе: целые по модулю n со сложением; обратимые остатки по модулю n с умножением, обозначаемые (Z/nZ)*; точки эллиптической кривой со сложением (тема 13).
| Структура | Требования к операциям | Пример | Где используется |
|---|---|---|---|
| Полугруппа | замкнутость, ассоциативность | целые по умножению | почти нигде отдельно |
| Группа | + нейтральный элемент и обратные | (Z/nZ, +), (Z/pZ)*, точки кривой | DH, ECDH, ECDSA |
| Абелева группа | + коммутативность | (Z/pZ)*, группа точек кривой | те же схемы |
| Кольцо | абелева группа по +, ассоциативное ·, дистрибутивность | Z/nZ, многочлены | RSA (Z/nZ) |
| Поле | кольцо, где каждый ненулевой элемент обратим | GF(p), GF(2^8), GF(2^n) | AES, ECC над GF(p) |
Различие не академическое. В кольце Z/nZ при составном n есть делители нуля: уравнение a·x ≡ b разрешимо не всегда, а обратный элемент существует только у взаимно простых с n. В поле — разрешимо всегда (при a ≠ 0), и именно поэтому схемы, которым нужна обратимость, работают в поле или в подгруппе простого порядка. Эллиптические кривые дают группу, но не кольцо: складывать точки можно, перемножать — нет, и никакая схема на кривой не требует умножения точки на точку.
Порядок группы |G| — число её элементов. Порядок элемента g — наименьшее k > 0, при котором g^k = e. Теорема Лагранжа утверждает, что порядок элемента всегда делит порядок группы. Доказательство короткое: степени элемента образуют подгруппу, а подгруппы разбивают группу на равномощные классы смежности.
Следствия, которые используются постоянно:
- в группе простого порядка любой элемент, кроме нейтрального, порождает всю группу;
g^|G| = eдля любого элемента — отсюда, в частности, малая теорема Ферма при|G| = p − 1;- если известно разложение
|G|на множители, порядок конкретного элемента проверяется заO(log |G|)операций: достаточно убедиться, чтоg^(|G|/q) ≠ eдля каждого простого делителяq.
Последний пункт важен для протоколов: злоумышленник, подобравший элемент малого порядка, может свести задачу дискретного логарифма к перебору в маленькой подгруппе. Защита — проверять, что порядок элемента равен большому простому числу, и отклонять всё остальное. Именно так устроены безопасные простые и проверка точек на эллиптических кривых.
Циклические группы и порождающий элемент
Группа называется циклической, если существует элемент, степени которого покрывают всю группу. Такой элемент называют порождающим (англ. generator, также первообразный корень). Мультипликативная группа (Z/pZ)* для простого p циклическая, и в ней ровно φ(p − 1) порождающих элементов.
Найти порождающий элемент просто, если известно разложение p − 1 на множители. Кандидат g проверяется по критерию: g^(p−1)/q ≠ 1 (mod p) для каждого простого делителя q числа p − 1. Если условия выполнены, порядок g равен p − 1, и элемент порождает всю группу.
Проблема в том, что разложение p − 1 знать нужно, а для случайного большого простого оно неизвестно. Поэтому на практике либо генерируют «безопасное» простое p = 2q + 1 с простым q (тогда разложение p − 1 известно: это 2·q), либо используют стандартные группы с опубликованными параметрами, где порождающий элемент и разложение порядка зафиксированы спецификацией.
Второй практический момент: в протоколе часто достаточно работать в подгруппе простого порядка q, а не во всей группе. Тогда проверка корректности элемента сводится к двум сравнениям: 1 < y < p − 1 и y^q ≡ 1 (mod p). Именно это требование, а не выбор g, определяет стойкость обмена ключами, и стандарт SP 800-56A предписывает проверять его при каждом получении открытого значения 13.
Задача дискретного логарифма
Пусть G — циклическая группа с порождающим g, и пусть h ∈ G. Задача дискретного логарифма (англ. discrete logarithm problem, DLP) состоит в нахождении такого x, что g^x = h. В аддитивной записи это звучит как «найти коэффициент», но в мультипликативной группе вычетов задача трудна: возведение в степень выполняется за log умножений, а обратная операция известного полиномиального алгоритма не имеет.
Сложность задачи сильно зависит от структуры порядка группы. Если порядок n гладкий (раскладывается на малые множители), работает алгоритм Полига — Хеллмана: задача решается по одному простому множителю, а результаты собираются китайской теоремой об остатках. Именно поэтому в криптографии требуют, чтобы порядок содержал большой простой множитель: при n = 2^40 задача решается за секунды, при n с большим простым множителем — за √q операций.
Отдельно отметим, что сложность задачи не доказана: неизвестно, существует ли полиномиальный алгоритм. Стойкость схем опирается на предположение, что такого алгоритма нет, и доказательства стойкости поэтому строятся как редукции к этой задаче 34. Ситуация та же, что с факторизацией.
CDH и DDH
Задача дискретного логарифма — не единственная трудная задача в этой группе. Для протоколов важны ещё две, и различие между ними определяет, годится ли группа для обмена ключами.
Вычислительная задача Диффи — Хеллмана (англ. computational Diffie–Hellman, CDH): даны g, g^a, g^b; требуется найти g^(ab). Решив DLP, её решить легко: находим a и возводим g^b в степень a. Обратное не известно: CDH может быть трудной, даже если DLP в данной группе решается быстрее.
Решающая задача Диффи — Хеллмана (англ. decisional Diffie–Hellman, DDH): даны g, g^a, g^b и ещё один элемент T; требуется решить, верно ли, что T = g^(ab), или T — случайный элемент группы. Это задача различения, а не вычисления, и она слабее CDH: решив CDH, DDH решается сравнением.
Иерархия такая: DDH ≤ CDH ≤ DLP, где «≤» означает «не труднее». Для протокола Диффи — Хеллмана нужна CDH-трудность: если g^(ab) легко вычислить, общий секрет восстановим. Для некоторых протоколов нужна и DDH-трудность: если противник умеет отличать настоящий общий секрет от случайного, он может отличить и настоящий ключ от случайного в модели, где это имеет значение.
Важно, что DDH-трудность — не универсальное свойство групп. В группах с билинейными спариваниями (pairing-friendly curves) DDH решается эффективно, а CDH по-прежнему считается трудной. Это не делает такие группы непригодными — на них строятся схемы идентификационной криптографии, — но означает, что для обычного DH их брать нельзя: противник отличит ключ от случайного, и доказательство стойкости рушится.
Методы решения и их сложность
Практические методы делятся на две группы: универсальные, работающие в любой группе, и специальные, использующие структуру конкретной группы.
Универсальные методы:
- перебор —
O(n)операций, применим только к маленьким группам; - шаг младенца — шаг великана (англ. baby-step giant-step, BSGS) —
O(√n)операций иO(√n)памяти, детерминированный; - ро-метод Полларда —
O(√n)операций иO(1)памяти, вероятностный 6; - лямбда-метод Полларда — то же, но с возможностью распараллеливания и ускорением в
√mраз приmпроцессорах.
Специальные методы для (Z/pZ)*:
- индексный метод (index calculus) — субэкспоненциальная сложность
exp(O(√(log p · log log p))); - решето числового поля (GNFS) — лучший известный метод для факторизации и, в адаптированной форме, для дискретного логарифма по простому модулю 7; сложность
exp(O(n^(1/3)·(log n)^(2/3))).
| Метод | Сложность | Память | Применимость |
|---|---|---|---|
| Перебор | O(n) | O(1) | учебные примеры |
| BSGS | O(√n) | O(√n) | группы до 2^80 |
| Ро Полларда | O(√n) | O(1) | любые группы |
| Полига — Хеллмана | O(Σ √q_i) | O(1) | гладкий порядок |
| Индексный метод | субэкспоненциальная | велика | (Z/pZ)* |
| GNFS | субэкспоненциальная | велика | (Z/pZ)*, факторизация |
Таблица объясняет, почему для эллиптических кривых достаточны ключи вдвое короче: универсальные методы дают √n, а специальных методов для групп точек кривых над полем простого порядка не известно. Для 256-битной кривой лучшая атака требует около 2^128 операций, тогда как для 3072-битного модуля — тех же 2^128, но при гораздо большей длине ключа.
Шаг младенца — шаг великана, предложенный Шенксом 5, разбирается подробно: он укладывается в несколько строк и показывает саму идею компромисса «время против памяти». Пусть нужно найти x при g^x = h в группе порядка n. Обозначим m = ⌈√n⌉ и представим x = i·m + j, где 0 ≤ i, j < m. Тогда h·(g^(−m))^i = g^j. Левая часть вычисляется для i = 0, 1, …, m−1, правая — таблица значений g^j для j = 0, 1, …, m−1. Совпадение даёт x.
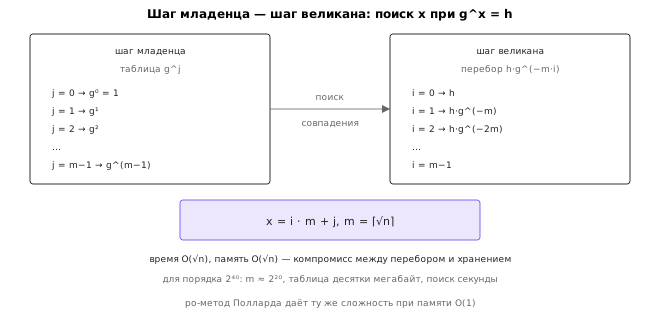
def bsgs(g, h, p, order=None):
    n = order or p - 1
    m = math.isqrt(n) + 1
    table = {}
    e = 1
    for j in range(m):
        table.setdefault(e, j)
        e = e * g % p
    factor = pow(g, n - m % n, p)   # g^(-m) mod p
    y = h
    for i in range(m):
        if y in table:
            return i * m + table[y]
        y = y * factor % p
    return None


print(bsgs(2, 37, 101))   # 56
print(pow(2, 56, 101))    # 37
Для p = 101, g = 2 порядок группы равен 100, поэтому m = 11, и таблица содержит 11 элементов. Ответ x = 56 проверяется прямой подстановкой. В лабораторной работе тот же код применяется к группе с порядком около 2^40, где m ≈ 2^20: таблица занимает десятки мегабайт, а поиск — секунды. Именно этот масштаб показывает, почему 80-битная группа уже небезопасна, хотя формально её порядок огромен.
Конечные поля
Поле GF(p)
Полем называют кольцо, в котором каждый ненулевой элемент обратим. Для простого p кольцо вычетов Z/pZ является полем и обозначается GF(p) (от англ. Galois field). В нём определены все четыре операции, и деление на любой ненулевой элемент корректно.
Характеристика поля — наименьшее k, при котором k·1 = 0. Для GF(p) характеристика равна p. Из этого следует важное тождество: (a + b)^p = a^p + b^p в GF(p), потому что все промежуточные биномиальные коэффициенты делятся на p и обращаются в нуль. Это «первокурсничья мечта» — верная в полях характеристики p и неверная в целых числах; она используется при анализе полиномов над конечными полями.
Конечное поле существует для любого порядка q = p^k, где p простое, и для каждого такого q поле единственно с точностью до изоморфизма. Обозначение — GF(q). Для k = 1 получается поле вычетов; для k > 1 — расширение, элементы которого удобно представлять многочленами степени меньше k с коэффициентами из GF(p).
Криптография использует оба случая. Простые поля — в схемах на дискретном логарифме и в эллиптических кривых над GF(p). Расширения характеристики 2 — в AES (GF(2^8)) и в криптографии на эллиптических кривых над GF(2^m), которая в последние годы выходит из употребления из-за сложностей с безопасной реализацией.
Арифметика в GF(2^8)
Элементы GF(2^8) — байты. Сложение — побитовый XOR: оно же вычитание, поскольку 1 + 1 = 0. Умножение — умножение многочленов с коэффициентами из GF(2) по модулю неприводимого многочлена степени 8. В AES выбран многочлен m(x) = x^8 + x^4 + x^3 + x + 1, что в шестнадцатеричной записи соответствует 0x11B. Неприводимость означает, что многочлен нельзя разложить на множители меньшей степени; именно она делает кольцо многочленов по модулю m(x) полем.
Правило умножения: перемножить многочлены как обычные, привести подобные по модулю 2 (то есть XOR коэффициентов), затем взять остаток по модулю m(x). На практике удобен сдвиговый алгоритм: идти по битам второго множителя, накапливать XOR сдвинутого первого, а при выходе за 8 бит вычитать m(x) — то есть XOR с 0x11B.
def gf256_mul(a, b):
    result = 0
    for _ in range(8):
        if b & 1:
            result ^= a
        high = a & 0x80
        a = (a << 1) & 0xFF
        if high:
            a ^= 0x1B        # младшие 8 бит 0x11B: x^8 заменяется на x^4+x^3+x+1
        b >>= 1
    return result


print(hex(gf256_mul(0x57, 0x13)))   # 0xfe
print(hex(gf256_mul(0x57, 0x83)))   # 0xc1
print(hex(gf256_mul(0x57, 0x01)))   # 0x57
Первый пример — тестовый вектор из FIPS 197: 0x57 · 0x13 = 0xFE 11. Он приведён в стандарте AES именно для проверки реализации умножения. Второй пример (0x57 · 0x83 = 0xC1) взят оттуда же — это промежуточный результат, встречающийся при разборе MixColumns. Обратный элемент проверяется иначе: 0x57⁻¹ = 0xBF, поскольку 0x57 · 0xBF = 0x01; именно это равенство и означает обратимость.
Обратный элемент в GF(2^8) вычисляется возведением в степень 254: a⁻¹ = a^254, поскольку a^255 = 1 для всех ненулевых a. Это следствие теоремы Лагранжа для группы порядка 255. В AES обратные элементы не вычисляются на лету: подстановка SubBytes задана таблицей из 256 байт, и таблица построена как раз из обращения в поле плюс аффинного преобразования.
Практический смысл этого раздела — не в том, чтобы запомнить многочлен, а в том, чтобы понимать: арифметика AES устроена как арифметика поля, а не как «магия таблиц». Любая ошибка в реализации MixColumns или в таблице SBOX обнаруживается тестовым вектором стандарта, и именно так проверяется лабораторная работа по блочным шифрам.
Итоги темы
Асимметричная криптография стоит на очень небольшом наборе математических фактов. Деление с остатком даёт кольцо вычетов; расширенный алгоритм Евклида даёт обратный элемент и тем самым — возможность делить по модулю. Теорема Ферма и теорема Эйлера связывают показатель степени с порядком группы и позволяют приводить показатели; китайская теорема об остатках разбивает вычисления по составному модулю на независимые вычисления по множителям и собирает результат обратно.
Вычислительная часть не менее важна. Бинарное возведение в степень делает возможной работу с показателями в тысячи бит, а требование постоянного времени выполнения превращает наивную реализацию в уязвимость. Проверка простоты устроена как вероятностный тест Миллера — Рабина с малым числом раундов; тест Ферма обманывается числами Кармайкла и в чистом виде непригоден, а генерация простых опирается на плотность распределения и отбраковку малых делителей.
Задача дискретного логарифма и задача факторизации — те две задачи, которые дают асимметричной криптографии её стойкость. Обе не имеют известного полиномиального алгоритма, обе допускают субэкспоненциальные атаки в одних группах и только универсальные — в других. Понимание этой разницы объясняет, почему длины ключей RSA и эллиптических кривых различаются в двенадцать раз при одном уровне стойкости, и почему выбор группы — не деталь реализации, а решение о стойкости.
Конечные поля замыкают тему: GF(p) — рабочая среда для схем на дискретном логарифме, GF(2^8) — среда для AES. Следующая тема переходит к поточным шифрам, где математика проще, но требования к уникальности nonce строже; тема 11 вернётся к группам и построит на них обмен ключами, а тема 12 — к арифметике вычетов и построит RSA.
Литература
- Menezes A., van Oorschot P., Vanstone S. Handbook of Applied Cryptography. — CRC Press, 1996. https://cacr.uwaterloo.ca/hac/
- Paar C., Pelzl J. Understanding Cryptography: A Textbook for Students and Practitioners. — Springer, 2010. DOI: 10.1007/978-3-642-04101-3
- Hoffstein J., Pipher J., Silverman J. H. An Introduction to Mathematical Cryptography. 2nd ed. — Springer, 2014. DOI: 10.1007/978-1-4939-1711-2
- Boneh D., Shoup V. A Graduate Course in Applied Cryptography. — 2023. https://crypto.stanford.edu/~dabo/cryptobook/
- Shanks D. Class Number, a Theory of Factorization, and Genera. — Proceedings of Symposia in Pure Mathematics, 1971, Т. 20, С. 415–440.
- Pollard J. M. Monte Carlo Methods for Index Computation (mod p). — Mathematics of Computation, 1978, Т. 32, № 143, С. 918–924. DOI: 10.1090/S0025-5718-1978-0491431-9
- Lenstra A. K., Lenstra H. W. (eds). The Development of the Number Field Sieve. — Springer, Lecture Notes in Mathematics 1554, 1993. DOI: 10.1007/BFb0091534
- Miller G. L. Riemann's Hypothesis and Tests for Primality. — Journal of Computer and System Sciences, 1976, Т. 13, № 3, С. 300–317. DOI: 10.1016/S0022-0000(76)80043-8
- Rabin M. O. Probabilistic Algorithm for Testing Primality. — Journal of Number Theory, 1980, Т. 12, № 1, С. 128–138. DOI: 10.1016/0022-314X(80)90084-0
- Agrawal M., Kayal N., Saxena N. PRIMES is in P. — Annals of Mathematics, 2004, Т. 160, № 2, С. 781–793. DOI: 10.4007/annals.2004.160.781
- NIST. Advanced Encryption Standard (AES). — FIPS 197 (updated 2023), 2001. https://doi.org/10.6028/NIST.FIPS.197-upd1
- Kocher P. C. Timing Attacks on Implementations of Diffie-Hellman, RSA, DSS, and Other Systems. — Advances in Cryptology — CRYPTO '96, Lecture Notes in Computer Science 1109, Springer, 1996, С. 104–113.
- NIST. Recommendation for Pair-Wise Key-Establishment Schemes Using Discrete Logarithm Cryptography. — SP 800-56A Rev. 3, 2018. https://doi.org/10.6028/NIST.SP.800-56Ar3