
Режимы работы блочных шифров
Блочный шифр умеет ровно одно: превратить 16 байт в 16 байт под управлением ключа. Любое сообщение длиннее блока — а это почти любое сообщение — требует надстройки, которая называется режимом работы (англ. mode of operation). Режим определяет, как блоки связываются между собой, откуда берётся случайность, что происходит с последним неполным блоком и какие свойства получает итоговая схема.
От режима зависит больше, чем от шифра. AES за двадцать лет не получил практических атак, но ошибки в режимах дали почти все громкие провалы: ECB в приложениях выдавал структуру данных, предсказуемый IV в CBC открыл BEAST, некорректная обработка дополнения породила padding oracle и POODLE, повтор счётчика в CTR ломает схему так же, как повтор nonce в поточном шифре. Поэтому тема устроена как разбор четырёх классических режимов и их ошибок, а не как перечисление определений.
Идея, которая объединяет материал: режим превращает детерминированную перестановку в рандомизированную схему. Случайность вносится либо в начало цепочки (IV), либо в счётчик (CTR), либо в сам процесс (CFB). Если эта случайность предсказуема или повторяется, схема теряет свойства, ради которых её строили, — иногда полностью, как в padding oracle, где противник вообще не подбирает ключ, а расшифровывает сообщение через реакцию сервера.
Паспорт темы. Нужно знать: темы 2, 5, 6. Освоите: выбирать режим под задачу; формулировать требования к IV в CBC и к nonce в CTR; проводить padding oracle; объяснять, почему конфиденциальность без целостности недостаточна; прослеживать цепочку «PRP → режим → IND-CPA/CCA → AEAD». Проверяет: ЛР 7. Минимум: разделы 1–5. Углубление: раздел 6.
Зачем нужны режимы
Блоки и сообщения
Обозначим блок шифра E(K, ·) и длину блока n (для AES — 16 байт). Сообщение M имеет произвольную длину, поэтому его нужно разбить на блоки и как-то поступить с последним неполным. Отсюда два элемента любого режима: правило связывания блоков и правило дополнения (англ. padding).
Дополнение — не деталь, а источник уязвимостей. Если режим требует, чтобы длина сообщения была кратна n, то к сообщению добавляются байты, и получатель должен их убрать. Ошибка в проверке дополнения — и сервер начинает сообщать противнику, какое именно дополнение он увидел; это и есть padding oracle. Если режим не требует дополнения (CTR, CFB, OFB), проблема исчезает, но появляются другие требования — к счётчику или к IV.
Режим как схема шифрования
Модель стойкости для режима — IND-CPA из темы 2. Противник выбирает пару сообщений, получает шифртекст одного и должен угадать, какого. Требование: преимущество пренебрежимо. Отдельно рассматривается IND-CCA, где противник имеет ещё и оракул расшифрования: именно в этой модели ломаются режимы без аутентификации, потому что реакция на некорректный шифртекст сама становится оракулом.
Из этого следуют требования к режиму, которые полезно держать в голове при чтении документации:
- шифрование должно быть рандомизированным — либо через случайный IV, либо через уникальный счётчик;
- одинаковые сообщения при разных вызовах должны давать разные шифртексты;
- изменение одного бита шифртекста не должно давать предсказуемого изменения открытого текста (или должно обнаруживаться);
- режим не должен позволять противнику получить информацию из факта ошибки расшифрования.
Последний пункт чаще всего игнорируется при разработке, и именно он стоит за padding oracle.
Требования к IV и счётчику
Вектор инициализации (англ. initialization vector, IV) — открытое значение, которое делает шифрование рандомизированным. Требования к нему различаются по режимам, и путаница между ними — типичная ошибка.
Для CBC IV должен быть непредсказуемым: противник не должен угадать его до шифрования. Случайный IV подходит, счётчик — нет, потому что предсказуемость позволяет атаку BEAST. Уникальность тоже нужна, но она следует из непредсказуемости.
Для CTR и CFB IV — это начальный счётчик, и требование одно: он не должен повторяться при том же ключе. Предсказуемость здесь не опасна: зная счётчик, противник всё равно не может предсказать выход блочного шифра. Зато повтор катастрофичен: два сообщения с одинаковым счётчиком дают одинаковый поток, и XOR шифртекстов выдаёт XOR открытых текстов — ровно как в теме 5.
Для OFB IV должен быть уникальным, и повтор также катастрофичен. Для XTS (шифрование дисков) используется «настройка» (tweak), обычно номер сектора: она не обязана быть случайной, но должна быть уникальной для каждого сектора.
ECB: электронная кодовая книга
Устройство
Режим ECB (англ. electronic codebook) шифрует каждый блок независимо: Cᵢ = E(K, Mᵢ). Никакой связи между блоками нет, дополнение нужно только для последнего неполного блока.
Это самый простой режим и самый плохой. Его свойство — детерминированность: одинаковые блоки открытого текста дают одинаковые блоки шифртекста. Формально это нарушает IND-CPA мгновенно: противник в игре запрашивает шифрование двух сообщений, и одинаковые блоки выдают ответ.
Схема ниже показывает, что происходит с изображением, зашифрованным в ECB: контуры сохраняются, потому что области с одинаковым цветом состоят из одинаковых блоков.
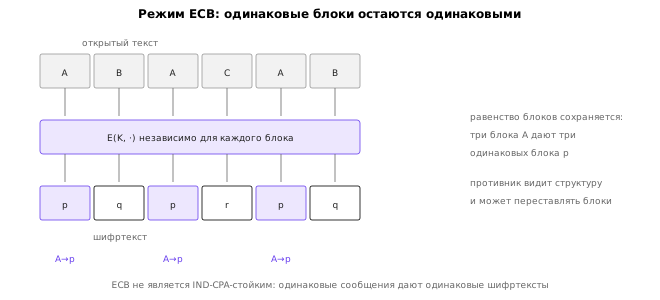
Классическая демонстрация — «ECB-пингвин»: изображение пингвина на белом фоне после шифрования в ECB остаётся узнаваемым, потому что фон состоит из повторяющихся блоков. Это не шутка, а точная иллюстрация утечки: шифр скрывает содержимое блока, но не скрывает равенство блоков.
Почему это опасно на практике
Утечка равенства блоков опасна не только для изображений. Если приложение шифрует в ECB структуру с повторяющимися полями — записи базы данных, JSON с одинаковыми ключами, — противник видит, какие записи совпадают. Если ECB применён к токену аутентификации, противник может переставлять блоки: склеить токен из фрагментов разных токенов и получить валидную структуру с другими полями. Эта атака — «вырезать и вставить» (англ. cut-and-paste) — разбирается в лабораторной работе.
Типичная ошибка проектирования выглядит так: сервис выдаёт токен email=<адрес>&uid=10&role=user, зашифрованный в ECB, и доверяет полю role после расшифрования. Противник регистрирует адрес, подобранный так, чтобы слово admin попало на границу блока, получает токен, вырезает нужный блок и подставляет его в свой токен. Ключ не нужен: ECB позволяет переставлять блоки, потому что каждый блок зашифрован независимо.
Когда ECB всё-таки допустим
Есть узкая область, где ECB уместен: шифрование одного блока, длина которого никогда не превышает длину блока и который не повторяется. Например, обёртка ключа (key wrapping) по схеме, где сам формат гарантирует уникальность. Но и там предпочитают специализированные схемы (AES-KW, RFC 3394), которые добавляют целостность.
Практическое правило: если в документации режим называется ECB, это почти всегда ошибка. Исключение — тестовые векторы и учебные задачи.
CBC: сцепление блоков
Схема и свойства
Режим CBC (англ. cipher block chaining) связывает блоки: каждый блок открытого текста складывается по XOR с предыдущим блоком шифртекста, и только потом шифруется:
C₀ = E(K, M₀ ⊕ IV)
Cᵢ = E(K, Mᵢ ⊕ Cᵢ₋₁)
Mᵢ = D(K, Cᵢ) ⊕ Cᵢ₋₁
M₀ = D(K, C₀) ⊕ IV
Схема ниже показывает цепочку: выход каждого блока влияет на вход следующего, поэтому одинаковые блоки открытого текста дают разные блоки шифртекста.
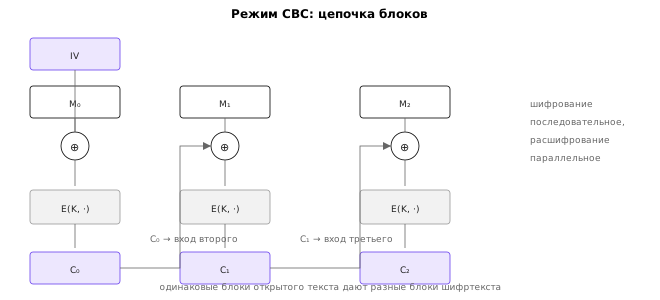
Из устройства следуют три свойства. Первое: шифрование последовательное, распараллелить его нельзя — каждый блок зависит от предыдущего. Расшифрование распараллеливается, потому что для восстановления Mᵢ нужны только Cᵢ и Cᵢ₋₁, оба известны заранее. Второе: изменение одного бита шифртекста портит соответствующий блок открытого текста целиком и ровно один бит в следующем блоке — это свойство иногда используют для обнаружения ошибок, но полагаться на него нельзя. Третье: нужен IV, и он должен быть непредсказуемым.
def cbc_encrypt(key, iv, data):
    data = pkcs7_pad(data)
    out = bytearray()
    prev = iv
    for block in split_blocks(data):
        prev = aes_block_encrypt(key, xor(block, prev))
        out += prev
    return bytes(out)


def cbc_decrypt(key, iv, data):
    out = bytearray()
    prev = iv
    for block in split_blocks(data):
        out += xor(aes_block_decrypt(key, block), prev)
        prev = block
    return pkcs7_unpad(bytes(out))
Тестовый вектор NIST SP 800-38A для AES-128-CBC: ключ 2b7e151628aed2a6abf7158809cf4f3c, IV 000102030405060708090a0b0c0d0e0f, первый блок открытого текста 6bc1bee22e409f96e93d7e117393172a, шифртекст 7649abac8119b246cee98e9b12e9197d 1. Сверка с этим вектором — обязательный шаг перед любой работой с CBC.
Требования к IV и атака BEAST
Требование к IV в CBC — непредсказуемость. Уникальности недостаточно. Если IV выбирается как счётчик (то есть предсказуем), противник может предсказать вход первого блока шифрования: M₀ ⊕ IV. Зная открытый текст M₀ (например, стандартный заголовок), он вычисляет вход блока и получает возможность сравнивать его с входами других блоков.
На этом построена атака BEAST (2011) на TLS 1.0, где IV для CBC генерировался как продолжение цепочки предыдущего записи-сообщения и потому был предсказуем 5. Атака позволяла восстановить cookie аутентификации за несколько тысяч запросов. Исправление в TLS 1.1 — явный случайный IV для каждой записи, что и делает требование «непредсказуемость» практическим.
Отсюда правило: IV в CBC генерируется криптографическим генератором и передаётся вместе с шифртекстом открыто. Попытка «сэкономить» и вывести IV из ключа или из номера сообщения возвращает предсказуемость и открывает атаку.
Дополнение PKCS#7
CBC требует, чтобы длина была кратна длине блока, поэтому сообщение дополняется. Стандартная схема — PKCS#7: добавляется k байт, каждый со значением k, где k от 1 до n. Если длина уже кратна n, добавляется целый блок из n байт со значением n — иначе получатель не смог бы отличить дополнение от данных.
def pkcs7_pad(data, block=16):
    n = block - len(data) % block
    return data + bytes([n]) * n


def pkcs7_unpad(data, block=16):
    if not data or len(data) % block:
        raise ValueError("неверная длина")
    n = data[-1]
    if not 1 <= n <= block or data[-n:] != bytes([n]) * n:
        raise ValueError("неверное дополнение")
    return data[:-n]
Проверим на примере: сообщение hello (5 байт) дополняется 11 байтами 0x0B; сообщение YELLOW SUBMARINE (16 байт) — целым блоком из шестнадцати 0x10, потому что длина уже кратна. Второй случай часто забывают, и реализация, которая «не добавляет дополнение, если длина кратна», ломается на сообщениях ровно блочной длины.
Проверка дополнения должна быть строгой и в постоянном времени: сначала проверить длину, потом значение последнего байта, потом все байты дополнения — и всё это без ранних выходов, если данные пришли извне. Иначе сама проверка становится оракулом.
Атака padding oracle
Padding oracle — атака, при которой противник не подбирает ключ, а использует различие в поведении системы: «дополнение корректно» и «дополнение некорректно». Впервые описана Ваудне в 2002 году 3 и с тех пор воспроизведена в десятках библиотек и протоколов.
Устройство атаки опирается на обратимую структуру CBC. Пусть противник хочет узнать последний байт блока Mᵢ. Он изменяет последний байт предыдущего блока шифртекста Cᵢ₋₁ (или IV для первого блока) и отправляет результат на расшифрование. Сервер расшифровывает, получает «открытый текст» с испорченным последним байтом и проверяет дополнение. Если дополнение корректно — значит, последний байт «открытого текста» равен 0x01; если нет — противник перебирает значения, пока не получит корректное.
Схема ниже показывает шаг атаки.
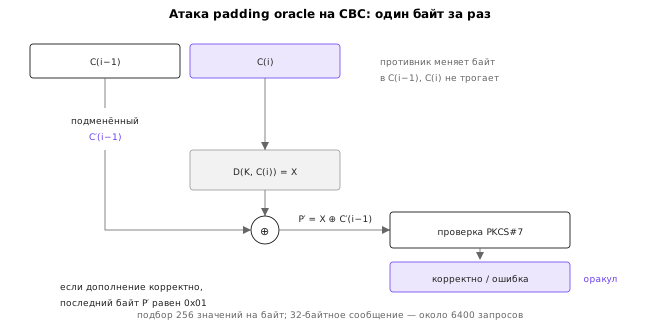
Формально: пусть P' = D(K, Cᵢ) ⊕ C'ᵢ₋₁, где C'ᵢ₋₁ — испорченный предыдущий блок. Противник хочет, чтобы последний байт P' был равен 0x01. Тогда C'ᵢ₋₁[n−1] = D(K, Cᵢ)[n−1] ⊕ 0x01, а искомый байт открытого текста Mᵢ[n−1] = D(K, Cᵢ)[n−1] ⊕ Cᵢ₋₁[n−1]. Сложив, получаем Mᵢ[n−1] = C'ᵢ₋₁[n−1] ⊕ Cᵢ₋₁[n−1] ⊕ 0x01 — всё известно. Затем противник переходит к предыдущему байту, добиваясь дополнения 0x02 0x02, и так далее.
def padding_oracle_attack(oracle, iv, ct, block=16):
    """Восстанавливает открытый текст CBC; oracle(iv || ct) сообщает о корректности дополнения."""
    data = bytearray(iv) + bytearray(ct)
    plain = bytearray(len(data))
    for bi in range(len(data) // block - 1, 0, -1):
        prev_off, cur_off = (bi - 1) * block, bi * block
        inter = bytearray(block)              # D(C) для текущего блока
        for j in range(block - 1, -1, -1):
            pad = block - j
            forged = bytearray(data[:cur_off + block])
            for k in range(j + 1, block):
                forged[prev_off + k] = inter[k] ^ pad
            for g in range(256):
                forged[prev_off + j] = g
                if not oracle(bytes(forged)):
                    continue
                if j == block - 1:            # дополнение из одного байта даёт ложные срабатывания
                    forged[prev_off + j - 1] ^= 0xFF
                    ok = oracle(bytes(forged))
                    forged[prev_off + j - 1] ^= 0xFF
                    if not ok:
                        continue
                inter[j] = g ^ pad
                break
            else:
                raise RuntimeError("оракул не сработал")
        for j in range(block):
            plain[cur_off + j] = inter[j] ^ data[prev_off + j]
    return bytes(plain[block:])
Функция выше — полная реализация: она принимает оракул, IV и шифртекст, а возвращает открытый текст. Тонкость, без которой атака не работает, — обработка первого блока: там вместо предыдущего блока шифртекста используется IV, поэтому атака начинается с приклеивания IV к шифртексту и работает с результирующим массивом как с цепочкой блоков. Вторая тонкость — ложные срабатывания при дополнении из одного байта: значение 0x01 в последней позиции может получиться не только у правильной догадки, поэтому байт перепроверяется с изменением предыдущего. На сохранённых данных из лабораторной работы полная атака 32-байтного сообщения занимает 6443 запроса к оракулу, то есть около 200 запросов на байт.
Число запросов: в среднем 128 на байт, то есть около 2000 запросов на 16-байтный блок. Для 32-байтного токена — порядка 4000 запросов. Это секунды работы скрипта, и именно поэтому padding oracle считается практической атакой, а не теоретической.
Защита формулируется просто: не сообщать противнику, чем именно закончилась проверка. Единый ответ «ошибка расшифрования» на любое некорректное сообщение, одинаковое время ответа, отсутствие разных кодов состояния. Но это лечение симптома: настоящее решение — аутентифицированное шифрование (тема 9), где целостность проверяется до расшифрования и подделка отвергается целиком.
Исторические варианты этой атаки стоит упомянуть отдельно. Lucky13 (2013) использовала разницу во времени проверки MAC в CBC-режиме TLS 4. POODLE (2014) использовала откат на SSL 3.0, где дополнение проверялось только частично, что давало оракул на каждый байт 6. Оба случая показывают: как только протокол даёт противнику различать состояния, атака находится.
CTR: блочный шифр как поточный
Устройство и свойства
Режим CTR (англ. counter) превращает блочный шифр в поточный: шифруется не сообщение, а последовательность значений счётчика, и результат складывается с сообщением:
Sᵢ = E(K, IV + i)
Cᵢ = Mᵢ ⊕ Sᵢ
Схема ниже показывает, что блоки потока вычисляются независимо, поэтому и шифрование, и расшифрование распараллеливаются.
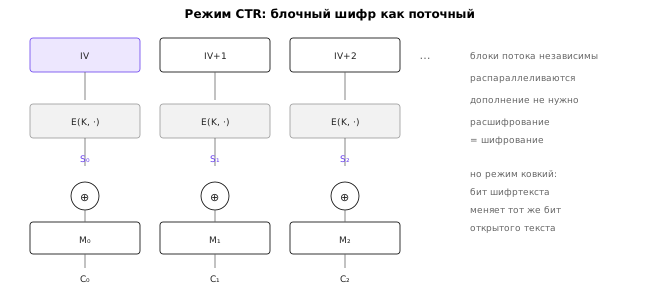
Свойства CTR:
- дополнение не нужно — сообщение любой длины;
- шифрование и расшифрование — одна и та же операция;
- блоки потока независимы, поэтому режим распараллеливается и допускает произвольный доступ (можно расшифровать блок с номером
k, не расшифровывая предыдущие); - изменение бита шифртекста меняет ровно тот же бит открытого текста — режим ковкий, как любой поточный;
- требуется уникальный счётчик в рамках ключа.
Тестовый вектор NIST SP 800-38A для AES-128-CTR: ключ 2b7e151628aed2a6abf7158809cf4f3c, начальный счётчик f0f1f2f3f4f5f6f7f8f9fafbfcfdfeff, первый блок открытого текста 6bc1bee22e409f96e93d7e117393172a, шифртекст 874d6191b620e3261bef6864990db6ce 1.
def ctr_crypt(key, counter_block, data):
    out = bytearray()
    counter = int.from_bytes(counter_block, "big")
    for i, block in enumerate(split_blocks(data, pad=False)):
        ks = aes_block_encrypt(key, ((counter + i) % (1 << 128)).to_bytes(16, "big"))
        out += bytes(a ^ b for a, b in zip(block, ks))
    return bytes(out)
Параллелизм и произвольный доступ
Главное достоинство CTR — независимость блоков. На процессоре с AES-NI режим упирается в пропускную способность памяти, а не в шифр: можно считать четыре, восемь или шестнадцать блоков одновременно. Именно поэтому CTR (и его вариант с аутентификацией, GCM) стал основным режимом для высокоскоростных применений.
Второе достоинство — произвольный доступ. Для шифрования диска или базы данных важно уметь прочитать блок с номером k, не вычисляя поток с начала. В CTR достаточно вычислить E(K, IV + k) — одна операция вместо k. Это причина, по которой CTR и XTS (построенный на той же идее) популярны в системах хранения.
Третье — отсутствие дополнения. Сообщение любой длины шифруется без накладных расходов и без класса ошибок, связанных с дополнением.
Повтор счётчика
Слабое место CTR — уникальность счётчика. Если два сообщения зашифрованы с одним и тем же начальным значением, потоки совпадают, и C₁ ⊕ C₂ = M₁ ⊕ M₂. Последствия те же, что при повторе nonce в ChaCha20: восстановление открытых текстов, а при известном одном из них — полное раскрытие второго.
Есть и вторая, менее очевидная опасность: переполнение счётчика. Если счётчик 32-битный (как в некоторых реализациях GCM), то после 2^32 блоков он вернётся к началу, и поток начнёт повторяться внутри одного сообщения. Реализации должны либо использовать 64-битный счётчик, либо ограничивать длину сообщения.
Третья опасность — «переиспользование» счётчика между разными применениями одного ключа. Если ключ используется и для шифрования данных, и для чего-то ещё, счётчики могут пересечься. Поэтому в протоколах ключ для CTR-режима выводится отдельно, а не берётся напрямую из общего секрета.
CFB, OFB и XTS
CFB и OFB
Режим CFB (англ. cipher feedback) строит поток из предыдущих блоков шифртекста: Sᵢ = E(K, Cᵢ₋₁), Cᵢ = Mᵢ ⊕ Sᵢ. Он самосинхронизирующийся: при потере байт приёмник восстанавливается через один блок. Дополнение не требуется, но требуется уникальный IV.
Режим OFB (англ. output feedback) строит поток из предыдущих выходов блочного шифра: Sᵢ = E(K, Sᵢ₋₁), Cᵢ = Mᵢ ⊕ Sᵢ. Он синхронный, дополнение не нужно, но при повторе IV поток повторяется целиком, и, что хуже, режим теряет синхронизацию при любом сбое.
Оба режима исторически важны — CFB и OFB были в TLS и в прикладных протоколах, — но в новых разработках не используются: CTR проще и параллельнее, а AEAD закрывает целостность. Знать их стоит, потому что они встречаются в унаследованных системах.
XTS и шифрование дисков
Шифрование диска имеет особые требования: произвольный доступ к секторам, отсутствие дополнения (размер сектора фиксирован), устойчивость к «перестановке блоков» (противник может менять местами сектора), и при этом не требуется аутентификация каждого сектора — иначе нельзя было бы менять данные на месте.
Режим XTS (англ. XEX-based tweaked-codebook mode with ciphertext stealing, NIST SP 800-38E) решает эти задачи 2. Идея: каждый блок шифруется с «настройкой» (tweak), в роли которой выступает номер сектора, умноженный на секретный ключ в GF(2^128); затем применяется схема XEX — E(K₁, P ⊕ T) ⊕ T. Настройка уникальна для сектора, поэтому одинаковые данные в разных секторах дают разные шифртексты, а перестановка секторов обнаруживается при расшифровании как мусор.
XTS не аутентифицирует данные: противник может испортить сектор, и это не будет замечено сразу. Для дисков это приемлемый компромисс, потому что аутентификация всей файловой системы потребовала бы пересчёта при каждой записи. Но для сетевых протоколов XTS не применяется.
Режимы ГОСТ
ГОСТ Р 34.13-2015 определяет режимы для «Кузнечика» и «Магмы»: ECB, CBC, CFB, OFB, CTR и выработку имитовставки (MAC) 7. Структурно они совпадают с международными, но с национальными особенностями: например, в ГОСТ CTR счётчик называется «счётчиком» и формируется иначе, а имитовставка — отдельный режим, а не надстройка над шифром.
Знание ГОСТ-режимов нужно для чтения отечественной документации и для совместимости; принципы те же, что разобраны выше, поэтому отдельного разбора они не требуют.
Сравнение режимов и границы применимости
Сводная таблица
| Режим | Параллелизм | Дополнение | Требование к IV | Обработка ошибки | Ковкость |
|---|---|---|---|---|---|
| ECB | да | нужно | не нужен | портит один блок | перестановка блоков |
| CBC | только расшифрование | нужно | непредсказуемость | портит блок и бит в следующем | изменение первого блока |
| CTR | да | не нужно | уникальность | портит ровно один бит | полная |
| CFB | только расшифрование | не нужно | уникальность | портит блок, восстанавливается | полная |
| OFB | нет | не нужно | уникальность | портит бит, теряет синхронизацию | полная |
| XTS | да | не нужно | уникальная настройка на сектор | портит блок | перестановка обнаруживается |
Таблица выше собрана по свойствам, а не по популярности; подробный разбор компромиссов с оценками стойкости и производительности есть в обзоре Рогауэя 8. Из неё видно, что выбор режима — компромисс. ECB прост, но не скрывает структуру. CBC даёт хорошее перемешивание, но требует дополнения и аккуратной обработки ошибок. CTR быстр и параллелен, но ковок. XTS удобен для дисков, но не даёт аутентификации.
Универсального «лучшего» режима нет, но есть практическое правило: для новых приложений используется AEAD (GCM, ChaCha20-Poly1305), а из «чистых» режимов — CTR внутри AEAD-конструкции. CBC и ECB остаются в унаследованных системах и в учебных задачах.
Уникальность и непредсказуемость — разные требования
Два требования легко перепутать, потому что оба формулируются как «IV должен быть хорошим». Уникальность означает, что значение не повторяется в рамках ключа; непредсказуемость — что противник не может угадать его заранее. Уникальное значение вполне может быть предсказуемым: счётчик 0, 1, 2, … уникален, но предсказуем полностью.
CBC требует именно непредсказуемости. Вход первого блока равен M₀ ⊕ IV; если IV известен заранее, противник знает этот вход для любого M₀, который сам выбрал, и может сравнивать его с входами других блоков. BEAST — ровно это: предсказуемый IV в TLS 1.0 позволял адаптивно подбирать открытый текст и восстанавливать cookie. Явный случайный IV в TLS 1.1 снимает предсказуемость, и атака исчезает. Уникальность при этом тоже нужна, но она слабее: повтор IV в CBC даёт одинаковые первые блоки и утечку равенства, а не полный контроль над входом.
CTR и поточные шифры требуют только уникальности. Поток E(K, IV + i) не зависит от открытого текста, поэтому предсказуемость счётчика сама по себе ничего не даёт: зная IV, противник всё равно не знает E(K, ·). Зато повтор IV катастрофичен — поток совпадает, и C₁ ⊕ C₂ = M₁ ⊕ M₂. То же верно для ChaCha20 и для nonce в AEAD.
Практическое следствие: «случайный IV» — правильный ответ для CBC и не обязательный для CTR; «счётчик» — правильный ответ для CTR и недопустимый для CBC. Общее у них одно: значение, которое должно быть уникальным, нельзя использовать дважды, и это требование нарушается чаще, чем любое другое в этой теме.
Цепочка свойств: от перестановки к AEAD
Свойства режимов удобно выстроить в одну линию, которая связывает темы 6, 7 и 9. Блочный шифр при фиксированном ключе — псевдослучайная перестановка (PRP): противник не отличает её от случайной. Режим превращает перестановку в конструкцию над сообщениями: CTR даёт псевдослучайный поток (PRF от счётчика), CBC — цепочку, зависящую от всех предыдущих блоков. Дальше конструкция оценивается в модели IND-CPA: если поток неотличим от случайного, шифрование неразличимо. Наконец, добавление MAC или встроенного тега поднимает свойство до IND-CCA и INT-CTXT — это и есть AEAD.
Оценки на каждом шаге количественные, и именно из них берутся практические лимиты. Для CTR и GCM число блоков на ключ ограничено так, чтобы вероятность повторения счётчика и статистические отклонения потока оставались пренебрежимыми. Для 128-битного блока граница FAR (false acceptance rate) в GCM при q проверках составляет примерно q/2^128; при рекомендованных 2^32 сообщениях это 2^-96, что приемлемо, а при неограниченном числе сообщений — уже нет. Для 64-битного блока та же оценка даёт q²/2^64, и уже 2^32 блоков делают поправку заметной (Sweet32, тема 6). Поэтому «блочный шифр стойкий» не означает «режим можно использовать на любых объёмах»: лимиты — часть спецификации режима, а не деталь реализации.
Misuse resistance
Обычные AEAD-схемы требуют, чтобы nonce был уникален; при повторе GCM теряет и конфиденциальность, и целостность. Схемы с устойчивостью к неправильному использованию (misuse resistance) ослабляют это требование: nonce может повторяться, и схема деградирует до уровня детерминированного шифрования, но не ломается полностью. Пример — AES-GCM-SIV (RFC 8452), где nonce входит в выработку ключа синтеза, а тег вычисляется до шифрования.
Устойчивость к misuse — не замена дисциплине, а страховка на случай ошибки в интеграции. Стоит она дороже: GCM-SIV медленнее GCM примерно вдвое, потому что требует двух проходов. Для новых систем разумный порядок выбора такой: корректно использовать GCM или ChaCha20-Poly1305 с гарантированной уникальностью nonce; если уникальность обеспечить нельзя (например, при шифровании по запросу с сохранённым состоянием), брать misuse-resistant схему.
Конфиденциальность без целостности недостаточна
Все режимы из этой темы обеспечивают только конфиденциальность. Ни один из них не мешает противнику изменить шифртекст так, чтобы открытый текст изменился предсказуемым образом. В ECB это перестановка блоков, в CBC — изменение первого блока и атака через дополнение, в CTR — побитовая подмена.
Именно поэтому в современной практике конфиденциальность и целостность соединяются в одном примитиве — аутентифицированном шифровании. Тема 9 разбирает MAC, GCM и ChaCha20-Poly1305, а также правило «сначала проверить тег, потом расшифровывать», нарушение которого порождает оракулы 9.
Практические рекомендации
Несколько правил, которые стоит запомнить и применять.
Первое: не использовать ECB никогда, кроме тестовых векторов. Если библиотека предлагает ECB по умолчанию, это повод выбрать другую библиотеку.
Второе: для CBC генерировать IV криптографическим генератором и передавать его вместе с шифртекстом; не выводить IV из ключа и не использовать счётчик.
Третье: проверять дополнение строго, в постоянном времени, и не сообщать противнику разницу между «неверное дополнение» и «неверный MAC». Лучше — вообще не использовать режимы с дополнением.
Четвёртое: для CTR следить за уникальностью счётчика и его разрядностью; не допускать переполнения внутри сообщения.
Пятое: для новых систем выбирать AEAD, а не «шифр плюс MAC», собранный вручную. Библиотека лучше знает, в каком порядке проверять тег 10.
Итоги темы
Режим работы превращает блочный шифр в схему шифрования, и именно режим определяет большинство практических свойств: рандомизацию, параллелизм, требования к IV, поведение при ошибках. ECB детерминирован и потому раскрывает структуру данных — от изображений до токенов аутентификации, где перестановка блоков даёт подделку без ключа. CBC связывает блоки и скрывает равенство, но требует непредсказуемого IV, дополнения и аккуратной обработки ошибок; предсказуемый IV открыл BEAST, а небрежная проверка дополнения — padding oracle и POODLE. CTR быстр, параллелен и не требует дополнения, но полностью ковкий и требует уникального счётчика. CFB и OFB остались в унаследованных системах, XTS занял нишу шифрования дисков.
Общий вывод: конфиденциальность без целостности недостаточна. Все атаки этой темы — не против AES, а против того, как режим обрабатывает ошибки и случайность. Padding oracle вообще не подбирает ключ: он читает открытый текст по реакции сервера на некорректное дополнение. Лечение — аутентифицированное шифрование, где подделка отвергается целиком и до расшифрования.
Следующая тема переходит к хеш-функциям: они понадобятся и для MAC, и для подписи, и для хранения паролей. Требования к ним формулируются иначе, чем к шифрам — не неразличимость, а стойкость к коллизиям и к обращению, — и именно на этих требованиях построены атаки, о которых пойдёт речь.
Литература
- NIST. Recommendation for Block Cipher Modes of Operation: Methods and Techniques. — SP 800-38A (with addendum), 2001. https://doi.org/10.6028/NIST.SP.800-38A
- NIST. Recommendation for Block Cipher Modes of Operation: The XTS-AES Mode for Confidentiality on Storage Devices. — SP 800-38E, 2010. https://doi.org/10.6028/NIST.SP.800-38E
- Vaudenay S. Security Flaws Induced by CBC Padding — Applications to SSL, IPSEC, WTLS… — Advances in Cryptology — EUROCRYPT 2002, Springer, 2002, С. 534–545. DOI: 10.1007/3-540-46035-7_36
- AlFardan N. J., Paterson K. G. Lucky Thirteen: Breaking the TLS and DTLS Record Protocols. — IEEE Symposium on Security and Privacy, 2013, С. 526–540. DOI: 10.1109/SP.2013.30
- Duong T., Rizzo J. Here Come The ⊕ Ninjas. — 2011. https://www.benthamsgaze.org/wp-content/uploads/2012/06/beast.pdf
- Möller B., Duong T., Kotowicz A. This POODLE Bites: Exploiting The SSL 3.0 Fallback. — 2014. https://www.openssl.org/~bodo/ssl-poodle.pdf
- ГОСТ Р 34.13-2015. Информационная технология. Криптографическая защита информации. Режимы работы блочных шифров. — Стандартинформ, 2015.
- Rogaway P. Evaluation of Some Blockcipher Modes of Operation. — Technical report for CRYPTREC, 2011. https://web.cs.ucdavis.edu/~rogaway/papers/modes.pdf
- Dworkin M. Recommendation for Block Cipher Modes of Operation: Galois/Counter Mode (GCM) and GMAC. — NIST SP 800-38D, 2007. https://doi.org/10.6028/NIST.SP.800-38D
- Aumasson J.-P. Serious Cryptography: A Practical Introduction to Modern Encryption. 2nd ed. — No Starch Press, 2024.