
Коды аутентификации сообщений и аутентифицированное шифрование
Шифрование защищает конфиденциальность, но ничего не говорит о подлинности: противник, не знающий ключ, всё равно может изменить шифртекст, и получатель либо увидит испорченный открытый текст, либо — в лучшем случае — ошибку дополнения. Тема 7 показала, к чему приводит такая ошибка: padding oracle превращает сообщение об ошибке в оракул расшифрования. Ответ на эту проблему — код аутентификации сообщения (англ. message authentication code, MAC): значение, которое можно вычислить только со знанием ключа и которое проверяется до того, как данные будут использованы.
MAC и хеш-функция решают разные задачи. Хеш проверяет целостность от случайных повреждений и подтверждает, что данные не изменились с момента, когда был вычислен хеш; защитить от целенаправленной подмены он не может, потому что вычислим без ключа. MAC защищает именно от подмены: без ключа тег не вычислить, поэтому изменение данных обнаруживается. Тема 8 показала и подвох: SHA256(key || message) — это не MAC, потому что к нему применима атака удлинения сообщения.
Тема устроена как путь от задачи к готовому инструменту. Сначала — определение стойкости MAC и три семейства конструкций: CBC-MAC и его исправление CMAC, HMAC и его устойчивость к удлинению, полиномиальные MAC (Poly1305, GHASH). Затем — атака по времени на сравнение тегов, которая обходит криптографию целиком и работает на уровне if. Далее — три способа соединить шифрование с MAC и причины, по которым безопасен только один. Завершают тему AEAD: интерфейс, AES-GCM, ChaCha20-Poly1305, катастрофа при повторе nonce и режимы, устойчивые к этому — AES-GCM-SIV, — а также защита от повторного воспроизведения, которую AEAD сам по себе не обеспечивает.
Паспорт темы. Нужно знать: темы 2, 7, 8. Освоите: формулировать EUF-CMA и INT-CTXT; строить HMAC и объяснять его стойкость; измерять утечку при сравнении тегов; различать три способа сочетания шифрования и MAC; применять AEAD и соблюдать лимиты GCM. Проверяет: ЛР 9. Минимум: разделы 1–5. Углубление: раздел 6.
Задача целостности при общем ключе
Что даёт MAC
MAC — функция от ключа K и сообщения M, возвращающая тег T фиксированной длины. Свойства, которые нужны на практике: без ключа тег не вычислить; тег не зависит от длины сообщения в том смысле, что всегда короткий; проверка выполняется быстро; изменение любого бита сообщения меняет тег.
Модель атаки для MAC — подделка при выбранных сообщениях (англ. existential unforgeability under chosen-message attack, EUF-CMA). Противник имеет оракул, выдающий теги для любых сообщений, и должен предъявить пару (M*, T*) с M*, которого он не запрашивал, и корректным тегом. Стойкость означает, что вероятность успеха пренебрежимо мала.
Такая модель сильнее, чем кажется. Она разрешает противнику видеть теги для сообщений на свой выбор — то есть имитирует реальную ситуацию, когда злоумышленник может отправлять данные в систему и наблюдать ответы. Она не разрешает только одно: подделать тег для нового сообщения.
MAC и хеш: в чём разница
Хеш-функция не имеет ключа, поэтому противник может вычислить хеш для любого сообщения. Проверка «хеш совпадает» означает лишь, что данные не изменились по сравнению с моментом вычисления хеша, — и работает только если хеш получен по доверенному каналу. Если противник может подменить и данные, и хеш, проверка бесполезна.
MAC решает эту проблему: без ключа тег не вычислить, поэтому подмена данных без подмены тега обнаруживается. Отсюда практическое следствие: MAC нужен везде, где данные принимаются от недоверенной стороны, — в сетевых протоколах, в токенах, в сообщениях между сервисами, в файлах, скачанных из сети.
Важно не путать MAC с электронной подписью. MAC симметричен: обе стороны знают один ключ, поэтому получатель тоже мог бы создать тег, и MAC не даёт неотрекаемости. Подпись асимметрична и даёт неотрекаемость, но требует другого аппарата (тема 12).
Требования к тегу и длине
Длина тега определяет стойкость к подделке: случайная догадка даёт успех с вероятностью 2^(-t) для тега длиной t бит. Для 128-битного тега это 2^-128, что достаточно. Для 32-битного — 2^-32, что позволяет подобрать тег за миллиарды попыток, а при наличии быстрого оракула — за минуты.
Стандартные длины: HMAC-SHA256 — 256 бит (можно усечь до 128), CMAC-AES — 128 бит, GCM и Poly1305 — 128 бит. Усечение до 64 бит допустимо только там, где число попыток жёстко ограничено протоколом.
Отдельное требование — сравнение тегов должно быть устойчивым к атаке по времени. Об этом ниже, потому что это самая частая ошибка реализаций.
Конструкции MAC
CBC-MAC и проблема переменной длины
Простейший MAC на блочном шифре — CBC-MAC: сообщение шифруется в режиме CBC с нулевым IV, а тегом объявляется последний блок шифртекста. Идея: цепочка CBC связывает все блоки, поэтому изменение любого блока меняет последний.
def cbc_mac(key, msg):
    if not msg or len(msg) % 16:
        raise ValueError("длина должна быть кратна 16 и больше 0")
    enc = Cipher(algorithms.AES(key), modes.CBC(bytes(16))).encryptor()
    return (enc.update(msg) + enc.finalize())[-16:]
Для сообщений фиксированной длины CBC-MAC стоек. Для переменной — нет, и подделка строится в две строки. Пусть известна пара (M₁, T₁), где M₁ — один блок. Тогда сообщение M₂ = M₁ || (M₁ ⊕ T₁) имеет тот же тег T₁: на вход второго блока AES подаётся (M₁ ⊕ T₁) ⊕ T₁ = M₁, то есть ровно то же значение, что и в первом блоке, и цепочка приходит в то же состояние.
m2 = m1 + bytes(a ^ b for a, b in zip(m1, t1)) # тег совпадёт с t1
Причина в том, что CBC-MAC не связывает тег с длиной сообщения. Лечение — либо требовать фиксированную длину, либо включить длину в первое преобразование, либо использовать CMAC.
CMAC
CMAC (NIST SP 800-38B) решает проблему, добавляя к последнему блоку значение, зависящее от ключа и от того, полный ли последний блок 3. Схема: два вспомогательных ключа K₁, K₂ выводятся из основного ключа умножением в GF(2^128); если последний блок полный, к нему добавляется K₁, если неполный — дополняется 10* и к нему добавляется K₂.
Из-за этого два сообщения разной длины, дающие одинаковое состояние цепочки, получают разные теги: добавка зависит от длины. CMAC стоек для сообщений произвольной длины, стандартизован и используется, например, в протоколах с блочными шифрами.
HMAC и устойчивость к удлинению
HMAC (RFC 2104) — конструкция MAC на основе хеш-функции, специально устойчивая к удлинению 1. Формула:
HMAC(K, m) = H((K₀ ⊕ opad) || H((K₀ ⊕ ipad) || m))
где K₀ — ключ, дополненный нулями до длины блока хеш-функции (если ключ длиннее блока, он сначала хешируется), ipad — 64 байта 0x36, opad — 64 байта 0x5c.
Почему удлинение не работает: противник, зная HMAC(K, m), получает выход внешнего хеша, а не состояние внутреннего. Чтобы продолжить вычисление, ему нужно состояние внутренней функции, а оно скрыто внутри внешнего хеша. Формально: H((K₀ ⊕ opad) || X) не даёт возможности вычислить H((K₀ ⊕ opad) || X || pad || Y), потому что X — это выход внутреннего хеша, и его длина известна, но состояние внешней функции после X неизвестно.
def my_hmac_sha256(key, msg):
    if len(key) > 64:
        key = hashlib.sha256(key).digest()
    key = key.ljust(64, b"\x00")
    inner = hashlib.sha256(bytes(a ^ 0x36 for a in key) + msg).digest()
    return hashlib.sha256(bytes(a ^ 0x5c for a in key) + inner).digest()
Проверка по RFC 4231, раздел 4.3: ключ Jefe, сообщение what do ya want for nothing?, ожидаемый тег 5bdcc146bf60754e6a042426089575c75a003f089d2739839dec58b964ec3843 2. Ещё три вектора — из разделов 4.2, 4.4 и 4.7 (ключ длиннее блока) — проверяют граничные случаи: короткий ключ, ключ ровно в блок и ключ длиннее блока.
HMAC — стандарт де-факто для MAC на хеше. Он используется в TLS, IPsec, SSH, JWT (HS256), в API-подписях и в протоколах аутентификации сообщений. Его стойкость доказана в предположении, что функция сжатия хеша ведёт себя как псевдослучайная функция 7, — это более сильное предположение, чем стойкость к коллизиям, но для SHA-2 оно считается выполненным.
Полиномиальные MAC: Poly1305 и GHASH
Для высокоскоростных AEAD нужны MAC, которые считаются быстрее HMAC. Полиномиальные MAC вычисляют значение многочлена от сообщения в конечном поле, используя секретный ключ как коэффициенты или как точку вычисления.
Poly1305 (Бернстайн, 2005) работает в поле по простому модулю 2^130 − 5 8. Ключ — 32 байта: r (для умножения, с «зачищенными» битами) и s (для сложения). Сообщение разбивается на блоки по 16 байт, к каждому добавляется старший бит, и вычисляется (((((m₁·r + m₂)·r + m₃)·r + …) + s) mod 2^128). Стойкость: Poly1305 — одноразовый MAC, ключ используется для одного сообщения; повтор ключа ломает его так же, как повтор nonce ломает поток.
GHASH — аналогичная конструкция в GF(2^128), используемая в AES-GCM. Она вычисляет Σ mᵢ·H^(n−i+1) в поле GF(2^128) с фиксированным многочленом. GHASH тоже одноразовый: ключ H должен быть уникален для каждого nonce.
Одноразовость — главное ограничение полиномиальных MAC, и именно она связывает их с nonce: в AEAD ключ MAC выводится из nonce, поэтому повтор nonce означает повтор ключа MAC.
Сравнение тегов и атака по времени
Ранний выход
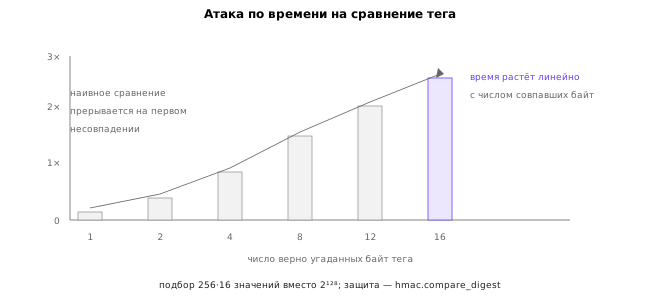
Проверка тега выглядит тривиально: сравнить вычисленный тег с полученным. Наивная реализация сравнивает побайтово и прерывается на первом несовпадении:
def unsafe_compare(a, b):
    if len(a) != len(b):
        return False
    for x, y in zip(a, b):
        if x != y:
            return False
    return True
Время работы зависит от количества совпавших байт. Противник, измеряющий время ответа, может подбирать тег побайтово: сначала найти первый байт, при котором время чуть больше, чем при неверном первом байте, затем второй, и так далее. Число запросов — порядка 256 · 16 = 4096 вместо 2^128.
На практике сигнал тонет в шуме: разница в наносекунды, а сетевые задержки — в миллисекунды. Но в локальных условиях, при усреднении по многим запросам и при искусственно увеличенной задержке сигнал выделяется надёжно. В лабораторной работе задержка на сравнённый байт задаётся переменной окружения, чтобы эффект был измерим; в реальных уязвимостях она меньше, но принцип тот же — и такие уязвимости находили в TLS, в IPsec и в библиотеках проверки подписи.
Сравнение в постоянном времени
Правильная реализация сравнивает за постоянное время, не зависящее от данных:
import hmac

def safe_compare(a, b):
    return hmac.compare_digest(a, b)
hmac.compare_digest accumulates XOR по всем байтам и возвращает результат после полного прохода. Время не зависит от того, где находится первое различие, и от длины совпадающего префикса. Функция работает и для bytes, и для строк ASCII.
Правило простое: любое сравнение секретов — тегов, токенов, хешей паролей, ответов — выполняется через compare_digest или аналогичную функцию платформы. Писать == для сравнения секретов нельзя, даже если «это же быстрый локальный вызов».
Что ещё утекает
Атака по времени — не единственный сторонний канал при проверке MAC. Утечки бывают через код возврата (разные сообщения об ошибке), через время до первого обращения к данным (расшифрование до проверки), через логирование (запись «MAC неверен» с подробностями), через размер ответа. Общий принцип: проверка должна завершаться одинаково для всех видов ошибки, а данные — не использоваться до проверки. Родственная проблема — неполное покрытие: если MAC вычисляется не от всей стенограммы протокола, противник может подобрать коллизию в непокрытой части и перенести аутентификацию на другой сеанс 10.
Сочетание шифрования и MAC
Три способа
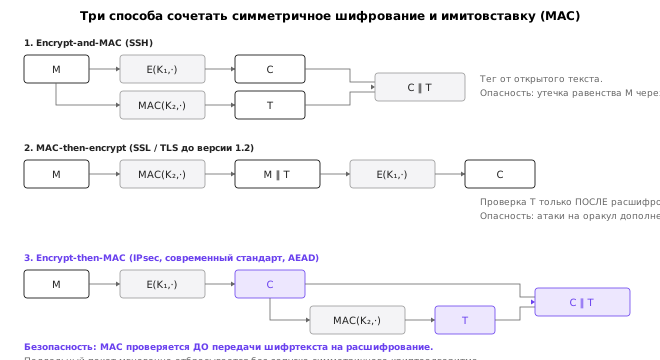
Когда нужны и конфиденциальность, и целостность, возникает вопрос о порядке операций. Возможны три схемы.
Шифрование и MAC (англ. encrypt-and-MAC): C = E(K₁, M), T = MAC(K₂, M). Тег вычисляется от открытого текста и передаётся вместе с шифртекстом.
MAC с последующим шифрованием (англ. MAC-then-encrypt): C = E(K₁, M || MAC(K₂, M)). Тег вычисляется от открытого текста, затем всё вместе шифруется.
Шифрование с последующим MAC (англ. encrypt-then-MAC): C = E(K₁, M), T = MAC(K₂, C). Тег вычисляется от шифртекста и передаётся рядом.
Схема ниже показывает все три варианта.
Какой безопасен
Точная формулировка такая: encrypt-then-MAC — единственная из трёх схем, для которой есть теорема о стойкости в общей модели. Если MAC стоек в EUF-CMA, шифр стоек в IND-CPA, а ключи K₁ и K₂ независимы, то композиция даёт IND-CCA и INT-CTXT 12. Условия существенны: при общем ключе доказательство не работает, а при MAC, который не является псевдослучайной функцией от сообщения, возможны утечки. MAC-then-encrypt и encrypt-and-MAC в общем случае не стойки — контрпримеры строятся, — но это не значит, что любая их реализация ломается: речь о том, что гарантии нет.
Почему encrypt-then-MAC удобнее остальных, видно по порядку операций. При проверке сначала вычисляется тег от полученного шифртекста; если он неверен, расшифрование не выполняется вообще. Противник не может получить никакой информации из поведения расшифрования, потому что расшифрования не было. Это закрывает padding oracle целиком: подделка отвергается до того, как станет известно, корректно ли дополнение.
В encrypt-and-MAC тег вычисляется от открытого текста, но передаётся вместе с шифртекстом, и проверять его можно только после расшифрования. Значит, расшифрование происходит до проверки — а это и есть оракул. Кроме того, encrypt-and-MAC может утекать информацию об открытом тексте через сам тег, если MAC не является псевдослучайной функцией от сообщения.
В MAC-then-encrypt тег тоже проверяется после расшифрования, и вся конструкция уязвима к padding oracle: именно так были устроены CBC-режимы в TLS 1.0–1.2, и именно поэтому появились Lucky13 и POODLE.
Для новых систем практический вывод ещё проще: не собирать композицию вручную, а брать готовый AEAD. Он даёт те же свойства без анализа условий теоремы и без риска перепутать порядок операций или переиспользовать ключ.
Сводка по трём схемам.
| Схема | От чего считается тег | Когда проверяется | Padding oracle | Где встречалась |
|---|---|---|---|---|
| encrypt-and-MAC | открытый текст | после расшифрования | да | SSH (несколько иначе), ранние самодельные протоколы |
| MAC-then-encrypt | открытый текст | после расшифрования | да | TLS 1.0–1.2 с CBC, Lucky13, POODLE |
| encrypt-then-MAC | шифртекст | до расшифрования | нет | IPsec ESP, современные AEAD-конструкции |
Правило, которое стоит запомнить: проверка целостности должна происходить раньше, чем любая обработка шифртекста, — тогда ошибка расшифрования физически не может стать источником утечки.
Ошибки, которые встречаются
Помимо порядка операций, есть несколько типичных ошибок. Использование одного ключа для шифрования и MAC — плохо, потому что свойства примитивов смешиваются; нужны разные ключи, выведенные из общего секрета. Включение метаданных только в шифртекст, но не в MAC, — тогда противник может изменить заголовок, и он не будет обнаружен; метаданные должны входить в тег. Отсутствие привязки к контексту (номер сообщения, идентификатор сеанса) — тогда противник может переставить сообщения местами, и каждое из них будет валидным.
AEAD решает эти проблемы на уровне интерфейса: он принимает присоединённые данные (англ. additional authenticated data, AAD), которые аутентифицируются, но не шифруются, и требует явного nonce.
AEAD
Интерфейс
Аутентифицированное шифрование с присоединёнными данными (англ. authenticated encryption with associated data, AEAD) — примитив с пятью параметрами: ключ, nonce, открытый текст, AAD и (на выходе) шифртекст с тегом.
encrypt(K, N, P, AAD) → (C, T)
decrypt(K, N, C, T, AAD) → P или ошибка
Свойства, которые гарантируются: конфиденциальность P; целостность C и AAD; невозможность подделки без ключа. При неверном теге расшифрование не выдаёт ничего — ни части открытого текста, ни информации о том, что именно не совпало.
Схема ниже показывает интерфейс и место AAD.
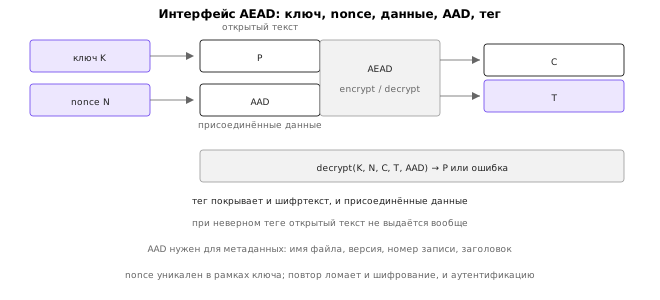
AAD нужен для метаданных: имени файла, версии формата, номера записи, идентификатора сеанса, заголовка пакета. Они не секретны, но менять их нельзя, и AEAD это обеспечивает.
AES-GCM
AES-GCM (NIST SP 800-38D) соединяет CTR-режим для шифрования и GHASH для аутентификации 4. Ключ аутентификации H = E(K, 0^128) вычисляется один раз; затем GHASH считает полиномиальный хеш от AAD и шифртекста, а тег получается как E(K, J₀) ⊕ GHASH, где J₀ — начальное значение счётчика, построенное из nonce.
Схема ниже показывает структуру GCM.
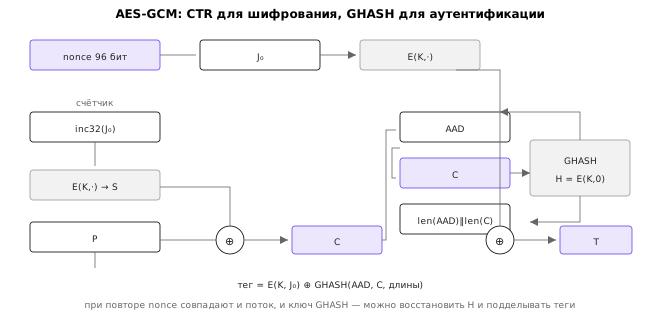
Параметры: nonce 96 бит (рекомендуется), тег 128 бит (можно усечь до 120, 112, 104 или 96 бит, но это ослабляет стойкость и требует отдельного обоснования). Ограничения количественные и обязательные: при 96-битном nonce стандарт допускает не более 2^32 вызовов шифрования на один ключ, а длина открытого текста в одном вызове не превышает 2^39 − 256 бит 4. Ограничение на число вызовов — не перестраховка: вероятность повтора nonce при случайной генерации растёт как q²/2^96, и при q = 2^32 она достигает 2^-32, что уже нельзя считать пренебрежимой величиной для долгоживущего ключа. Поэтому либо nonce ведётся счётчиком с гарантией уникальности, либо ключ меняется раньше, чем исчерпан лимит.
from cryptography.hazmat.primitives.ciphers.aead import AESGCM

key, nonce = os.urandom(16), os.urandom(12)
aad = b"file=doc.txt;version=1"
blob = AESGCM(key).encrypt(nonce, b"secret payload", aad)
pt = AESGCM(key).decrypt(nonce, blob, aad)      # InvalidTag при подмене
Достоинство GCM — скорость: AES-NI ускоряет и CTR, и GHASH (для GHASH есть инструкции PCLMULQDQ). Недостаток — чувствительность к повторам nonce, о которой ниже, и относительно сложная реализация GHASH, где исторически находили ошибки.
ChaCha20-Poly1305
ChaCha20-Poly1305 (RFC 8439) соединяет поточный шифр из темы 5 и полиномиальный MAC 5. Ключ 256 бит, nonce 96 бит. Ключ Poly1305 выводится из первого блока потока ChaCha20, поэтому повтор nonce означает повтор ключа MAC.
Достоинство — скорость на платформах без AES-NI (мобильные, встраиваемые) и простота реализации без таблиц, что снижает риск атак по кэшу. Поэтому ChaCha20-Poly1305 — стандартный выбор для мобильных клиентов и для случаев, когда AES-NI недоступен.
Повтор nonce в GCM
Повтор nonce в GCM — катастрофа, и не только для конфиденциальности. Как и в любом CTR-режиме, совпадение потока даёт C₁ ⊕ C₂ = P₁ ⊕ P₂. Но в GCM последствия хуже: ключ аутентификации H можно восстановить.
Идея атаки (её называют forbidden attack) 9: при повторе nonce два сообщения имеют одинаковые J₀ и одинаковые ключи GHASH. Тег каждого сообщения — линейное уравнение относительно H. Имея два тега, противник получает систему, решает её и находит H. После этого он может подделывать теги для любых сообщений с любым nonce.
Практическая реализация требует нескольких сообщений и знания части открытых текстов, но принципиально это означает: повтор nonce в GCM ломает не только конфиденциальность, но и всю аутентификацию сеанса.
Защита — дисциплина nonce: счётчик с проверкой переполнения или случайный 96-битный nonce с ограничением на число сообщений. Второй вариант при 2^32 сообщениях даёт вероятность коллизии около 2^-33, что приемлемо.
Устойчивые к повтору nonce режимы
Если дисциплину nonce обеспечить нельзя (например, при перезапусках и сбоях), используют режимы, которые не ломаются при повторе. AES-GCM-SIV (RFC 8452) — один из них 6: nonce входит в выработку ключа, поэтому повтор nonce приводит лишь к тому, что два одинаковых сообщения дают одинаковый шифртекст (что и так очевидно), а разные сообщения — разные, и секретность сохраняется.
Название SIV означает «синтетический IV»: сначала вычисляется тег от открытого текста, и уже он используется как часть nonce для шифрования. Это делает схему детерминированной при фиксированном входе, но защищает от катастрофы при повторе. Плата — скорость: два прохода вместо одного.
Аналогично устроены AEGIS и другие «misuse-resistant» схемы. Практическое правило: если есть риск повтора nonce, выбирайте SIV-режим; если дисциплина гарантирована, GCM или ChaCha20-Poly1305 проще и быстрее.
Повтор воспроизведения и рекомендации
Защита от replay
AEAD защищает от подмены, но не от повторного воспроизведения: противник может переслать валидный шифртекст повторно, и он будет принят. Именно так работают атаки повторного воспроизведения в протоколах аутентификации.
Защита строится на уровне протокола: счётчик сообщений (номер записи), проверяемый получателем; метка времени с окном допустимости; одноразовые значения в запросе и ответе. Сам AEAD тут не помогает, потому что повторно пересылаемые данные криптографически корректны.
Важно понимать границу: AEAD отвечает на вопрос «данные подлинные и целые?», но не на вопрос «это первая передача?». Второй вопрос решается состоянием протокола, и именно поэтому в TLS есть счётчик записей, а в протоколах аутентификации — nonce и метки времени.
Что выбирать
Для новых систем выбор прост: AES-GCM, если процессор поддерживает AES-NI, или ChaCha20-Poly1305 в остальных случаях. Оба стандартизованы, оба имеют проверенные реализации в cryptography и OpenSSL, оба поддерживают AAD.
Не следует собирать AEAD вручную из шифра и MAC: вероятность ошибиться в порядке операций, в разделении ключей или в обработке ошибок слишком высока 11. Библиотека, которая предоставляет AESGCM, уже решила эти вопросы и, что важнее, скрыла их от прикладного кода.
Не следует использовать усечённые теги без понимания: 32-битный тег означает 2^-32 на попытку, что при наличии сетевого доступа может быть недостаточно. Если протокол требует короткого тега, это должно быть обосновано ограничением числа попыток.
Итоги темы
MAC решает задачу подлинности при общем ключе: без ключа тег не вычислить, поэтому подмена данных обнаруживается. Стойкость формулируется как EUF-CMA — невозможность подделать тег для нового сообщения, даже имея оракул тегов. CBC-MAC стоек только для фиксированной длины; CMAC исправляет это добавкой, зависящей от длины; HMAC решает задачу на основе хеша и устойчив к удлинению; Poly1305 и GHASH быстры, но одноразовы.
Сравнение тегов должно быть постоянным по времени. Атака по времени не подбирает ключ: она читает тег побайтово по времени ответа, и защита от неё — compare_digest, а не внимательность.
Из трёх способов соединить шифрование с MAC безопасен только encrypt-then-MAC, потому что только он позволяет проверить целостность до расшифрования. AEAD делает этот выбор за разработчика: интерфейс требует nonce и AAD, а при неверном теге просто не выдаёт открытый текст. AES-GCM и ChaCha20-Poly1305 — стандартные варианты; повтор nonce в GCM ломает не только конфиденциальность, но и ключ аутентификации, поэтому при риске повтора выбирают SIV-режимы.
И главное: AEAD не защищает от повторного воспроизведения. Это задача протокола, и следующая тема переходит к другой задаче того же уровня — выработке ключей из паролей и управлению ключами, где ошибки тоже лежат не в примитивах, а в их соединении.
Литература
- Krawczyk H., Bellare M., Canetti R. HMAC: Keyed-Hashing for Message Authentication. — RFC 2104, IETF, 1997. https://www.rfc-editor.org/rfc/rfc2104
- Nystrom M. Identifiers and Test Vectors for HMAC-SHA-224, HMAC-SHA-256, HMAC-SHA-384, and HMAC-SHA-512. — RFC 4231, IETF, 2005. https://www.rfc-editor.org/rfc/rfc4231
- NIST. Recommendation for Block Cipher Modes of Operation: The CMAC Mode for Authentication. — SP 800-38B, 2016. https://doi.org/10.6028/NIST.SP.800-38B
- NIST. Recommendation for Block Cipher Modes of Operation: Galois/Counter Mode (GCM) and GMAC. — SP 800-38D, 2007. https://doi.org/10.6028/NIST.SP.800-38D
- Nir Y., Langley A. ChaCha20 and Poly1305 for IETF Protocols. — RFC 8439, IETF, 2018. https://www.rfc-editor.org/rfc/rfc8439
- Gueron S., Langley A., Lindell Y. AES-GCM-SIV: Nonce Misuse-Resistant Authenticated Encryption. — RFC 8452, IETF, 2019. https://www.rfc-editor.org/rfc/rfc8452
- Bellare M., Canetti R., Krawczyk H. Keying Hash Functions for Message Authentication. — Advances in Cryptology — CRYPTO '96, Springer, 1996, С. 1–15. DOI: 10.1007/3-540-68697-5_1
- Bernstein D. J. The Poly1305-AES Message-Authentication Code. — Fast Software Encryption (FSE 2005), Springer, 2005, С. 32–49. DOI: 10.1007/11502760_3
- Joux A. Authentication Failures in NIST Version of GCM. — Comment to NIST, 2006. https://csrc.nist.gov/csrc/media/projects/block-cipher-techniques/documents/bcm/comments/800-38-series-drafts/gcm/joux_comments.pdf
- Bhargavan K., Leurent G. Transcript Collision Attacks: Breaking Authentication in TLS, IKE and SSH. — Network and Distributed System Security Symposium (NDSS), 2016. DOI: 10.14722/ndss.2016.23418
- Aumasson J.-P. Serious Cryptography: A Practical Introduction to Modern Encryption. 2nd ed. — No Starch Press, 2024.
- Bellare M., Namprempre C. Authenticated Encryption: Relations among Notions and Analysis of the Generic Composition Paradigm. — Advances in Cryptology — ASIACRYPT 2000, Springer, 2000, С. 531–545. DOI: 10.1007/3-540-44448-3_41