
Пароли, выработка и управление ключами
Пароль — самый распространённый и самый слабый секрет в любой системе. Он выбирается человеком, а значит имеет низкую энтропию, повторяется на разных сайтах и попадает в утечки. Задача криптографии здесь не «зашифровать пароль», а сделать так, чтобы украденная база не превратилась в список открытых паролей: проверка должна быть достаточно дорогой, чтобы массовый перебор стал невыгодным, и достаточно быстрой, чтобы вход занимал десятые доли секунды.
Отсюда два разных класса функций. Быстрые хеш-функции (SHA-256) хороши для целостности, но непригодны для паролей: современная видеокарта считает миллиарды SHA-256 в секунду, и база из миллиона хешей вскрывается за минуты. Медленные функции (PBKDF2, bcrypt, scrypt, Argon2) специально спроектированы так, чтобы каждая попытка стоила дорого — по времени или по памяти. Именно память оказалась решающим ресурсом: видеокарта имеет тысячи параллельных потоков, но ограниченный объём быстрой памяти, поэтому функция, требующая мегабайт на вычисление, снижает преимущество GPU на порядки.
Вторая половина темы — выработка ключей из уже готового секрета. Здесь задача обратная: нужно из одного случайного секрета получить несколько независимых ключей для разных целей, не потеряв стойкости. Для этого служит HKDF с его двумя шагами — извлечением и расширением, — и разделение по назначению (доменная сепарация), без которого ключ шифрования и ключ MAC могут случайно совпасть.
Третья часть — управление ключами: иерархия, шифрование конвертом, обёртывание ключей, ротация, уничтожение, HSM. Это наименее «математическая» и наиболее часто проваливаемая часть: большинство инцидентов с ключами происходит не из-за взлома алгоритма, а из-за того, что ключ лежал в конфигурации, репозитории или логе.
Паспорт темы. Нужно знать: темы 0, 3, 9. Освоите: объяснять, почему пароли — особая задача; подбирать параметры PBKDF2, scrypt и Argon2id; оценивать энтропию пароля; строить HKDF с разделением ключей; описывать обёртывание ключей, конверт и иерархию KMS. Проверяет: ЛР 10. Минимум: разделы 1–4. Углубление: разделы 5–6.
Почему пароли — особая задача
Утечки и их последствия
Крупные утечки паролей происходят регулярно, и их последствия выходят далеко за пределы одного сайта. RockYou (2009) — 32 миллиона паролей в открытом виде, ставших учебным набором для всех, кто занимается подбором. LinkedIn (2012) — около 6,5 миллиона хешей SHA-1 без соли, значительная часть которых была восстановлена за дни. Adobe (2013) — десятки миллионов записей с обратимым «шифрованием» и подсказками к паролям.
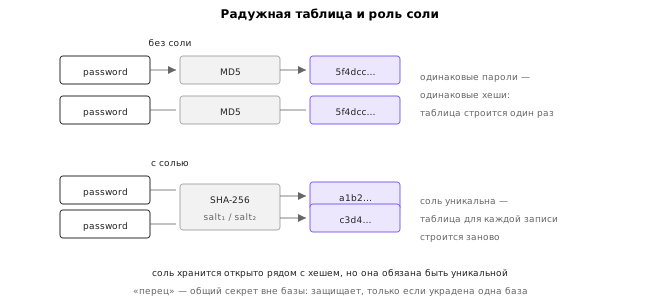
Общее в этих историях: пароли хранились способом, который не выдерживает массового анализа. SHA-1 без соли означает, что одинаковые пароли дают одинаковые хеши, а значит один раз восстановленный пароль открывает все аккаунты с ним. Отсутствие соли позволяет применять заранее вычисленные таблицы. Отсутствие медленности позволяет перебирать миллиарды вариантов в секунду.
Практическое следствие для разработчика: хранение паролей — не «ещё одно поле в базе», а отдельная задача с собственными требованиями, и ошибка здесь не компенсируется ничем: ни HTTPS, ни двухфакторной аутентификацией, ни политикой сложности.
Перебор, словари и правила
Атака на пароль начинается не с полного перебора, а со словаря. Люди выбирают пароли из ограниченного набора: имена, слова, названия команд, даты. Словарь из миллиона реальных паролей покрывает значительную долю всех аккаунтов.
К словарю применяются правила мутаций (англ. mutation rules): заглавная первая буква, замена a → @, o → 0, добавление 1, !, 2024 в конец. Правила увеличивают словарь в десятки раз, но всё равно остаются на много порядков меньше полного пространства. Именно поэтому пароль P@ssw0rd2024 не лучше password: он входит в стандартный набор мутаций.
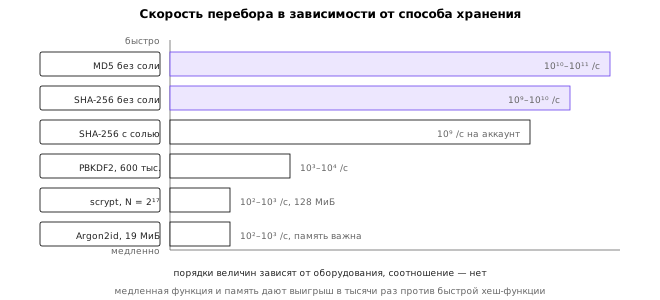
Скорость перебора зависит от функции хранения:
| Функция | Порядок скорости на GPU | Что это значит |
|---|---|---|
| MD5 без соли | 10^10–10^11 в секунду | вся база вскрывается за минуты |
| SHA-256 без соли | 10^9–10^10 в секунду | то же, чуть медленнее |
| SHA-256 с солью | 10^9 в секунду на аккаунт | радужные таблицы не работают, но перебор быстрый |
| PBKDF2-SHA256, 600 000 итераций | 10^3–10^4 в секунду | перебор словаря занимает часы-дни |
| bcrypt, cost 12 | 10^3 в секунду | сравнимо с PBKDF2 |
| scrypt, N = 2^17 | 10^2–10^3 в секунду | память ограничивает параллелизм |
| Argon2id, 19 МиБ, t=2 | 10^2–10^3 в секунду | то же, с настройкой памяти |
Числа зависят от оборудования и меняются каждый год, но соотношение устойчиво: медленная функция с памятью даёт выигрыш в тысячи раз против быстрой хеш-функции.
Радужные таблицы и почему нужна соль
Радужная таблица (англ. rainbow table) — компромисс между временем и памятью для обращения хешей. Идея восходит к Хеллману (1980) 9: вместо хранения всех пар «пароль — хеш» строятся цепочки, где чередуются функция редукции и хеш, и хранятся только начала и концы цепочек. Ойшлин (2003) усовершенствовал метод, добавив разные функции редукции на разных позициях, что уменьшило число коллизий внутри цепочек 10.
Для защиты достаточно соли — случайного значения, уникального для каждой записи. Хеш вычисляется от salt || password, поэтому:
- одинаковые пароли дают разные хеши;
- заранее вычисленная таблица бесполезна, потому что для каждой соли нужна своя;
- атака на конкретный аккаунт требует пересчёта таблицы, что сопоставимо с прямым перебором.
Соль не обязана быть секретной — она хранится рядом с хешем. Её длина: 16 байт и больше, генерируется криптографическим генератором.
«Перец» (англ. pepper) — дополнительный секрет, общий для всех записей, который хранится не в базе, а в конфигурации или в HSM. Он защищает от сценария, когда украдена только база: без перца перебор невозможен. Ограничение: перец нельзя менять без пересчёта всех хешей, и он не помогает, если украден и код.
Медленные функции хеширования паролей
PBKDF2
PBKDF2 (RFC 8018) — простейшая медленная функция: HMAC применяется к паролю и соли заданное число раз 1.
DK = T₁ || T₂ || …
Tᵢ = F(P, S, c, i)
F = U₁ ⊕ U₂ ⊕ … ⊕ U_c
U₁ = HMAC(P, S || INT(i)),  U_j = HMAC(P, U_{j−1})
Достоинства: простота, стандартизованность, поддержка везде (в том числе в ФСТЭК-сертифицированных средствах). Недостаток: только время, никакой памяти. GPU легко распараллеливает PBKDF2, потому что каждое вычисление требует лишь несколько десятков байт состояния.
Параметры: число итераций и длина производного ключа. OWASP рекомендует 600 000 итераций для PBKDF2-HMAC-SHA256 (и 210 000 для SHA-512) 7. NIST SP 800-63B требует, чтобы число итераций было «как можно большим», и приводит 10 000 как абсолютный минимум для устаревших систем 6.
import hashlib

dk = hashlib.pbkdf2_hmac("sha256", password, salt, 600_000, dklen=32)
bcrypt
bcrypt (1999) — адаптивная функция на основе шифра Blowfish с модифицированным расписанием ключей 8. Параметр cost задаёт число итераций как 2^cost; при cost = 12 это 4096 раундов расширения ключа. Достоинство — адаптивность: при росте вычислительных мощностей увеличивают cost, не меняя формат.
Особенность: bcrypt использует только первые 72 байта пароля, остальное игнорируется. Это не уязвимость при разумных паролях, но при длинных парольных фразах часть энтропии теряется, и это нужно знать. Вторая особенность — внутреннее состояние 4 КБ, что ограничивает параллелизм на GPU, но не так сильно, как у scrypt и Argon2.
scrypt
scrypt (RFC 7914) — функция, затратная по памяти 2. Параметры N (число блоков), r (размер блока), p (параллелизм). Память оценивается как 128 · N · r байт; при N = 2^17, r = 8 это 128 МиБ.
Алгоритм сначала заполняет большой массив псевдослучайными блоками, затем обращается к нему в псевдослучайном порядке. Именно это делает атаку дорогой: для каждого параллельного вычисления нужна своя память, а её количество на видеокарте ограничено. Кроме того, случайные обращения к большой памяти плохо ложатся на архитектуру GPU.
import hashlib

dk = hashlib.scrypt(password, salt=salt, n=2**17, r=8, p=1, dklen=32, maxmem=256 * 1024 * 1024)
Тестовый вектор RFC 7914: scrypt("", "", N=16, r=1, p=1, dklen=64) даёт 77d65762…d18906. Он нужен для проверки реализации и показывает, что параметры входят в результат.
Argon2 и выбор параметров
Argon2 (RFC 9106) — победитель конкурса Password Hashing Competition (2015) 312. Три варианта: Argon2d (устойчив к GPU, но уязвим к атакам по сторонним каналам), Argon2i (устойчив к сторонним каналам, но слабее против GPU), Argon2id (гибрид, рекомендуемый по умолчанию).
Параметры: память m, число проходов t, параллелизм p, длина соли и тега. Редакции рекомендаций различаются, и их стоит называть явно. OWASP (редакция 2023 года и новее) приводит несколько профилей: m = 19 МиБ, t = 2, p = 1; m = 46 МиБ, t = 1, p = 1; m = 12 МиБ, t = 3, p = 1. RFC 9106 рекомендует более дорогие профили: m = 64 МиБ, t = 3, p = 4 как второй вариант и m = 2 ГиБ, t = 1, p = 4 как первый, для систем, где память действительно есть.
from argon2.low_level import hash_secret_raw, Type

tag = hash_secret_raw(
    secret=password, salt=salt, time_cost=2, memory_cost=19 * 1024,
    parallelism=1, hash_len=32, type=Type.ID,
)
Пакет argon2-cffi (в Ubuntu — python3-argon2) может отсутствовать; в этом случае продвинутая часть работы выполняется на scrypt, а Argon2 разбирается по спецификации. В cryptography Argon2 появился начиная с версии 44, поэтому в среде с 3.4.8 он недоступен.
Выбор параметров — компромисс между стоимостью проверки и стоимостью перебора. Ориентир — время проверки порядка десятых долей секунды на той машине, где она выполняется (это порядок величины, а не норматив: конкретное число зависит от оборудования и нагрузки). Меньше — перебор становится дешевле; больше — сервер не справляется и появляется соблазн кэшировать результаты. Параметры фиксируются в формате хранения вместе с солью и версией алгоритма, иначе обновление профиля потребует пересчёта всех хешей.
Сравнение
| Функция | Ресурс | Параметры | Особенность |
|---|---|---|---|
| PBKDF2 | время | итерации | поддержка везде, слаб против GPU |
| bcrypt | время, 4 КБ | cost | обрезает пароль до 72 байт |
| scrypt | память | N, r, p | требует много памяти, плохо на GPU |
| Argon2id | память и время | m, t, p | современный стандарт, гибрид |
Практическое правило: для нового кода — Argon2id, если библиотека доступна; scrypt как замена; PBKDF2 как минимально допустимый вариант для совместимости.
Энтропия паролей и политика
Энтропия и парольные фразы
Энтропия пароля оценивается как log₂ числа вариантов, из которых он выбран. Для случайной строки из 12 символов алфавита 62 это log₂(62^12) ≈ 71 бит. Для пароля Tr0ub4dor&3 энтропия гораздо ниже, чем кажется: он состоит из слова с заменами и суффикса, то есть входит в пространство, которое покрывается правилами мутаций.
Парольная фраза (англ. passphrase) из четырёх случайных слов, выбранных из словаря в 7776 слов (как в схеме Diceware), даёт log₂(7776^4) ≈ 51,7 бита. Пять слов — около 64,6 бита, шесть — около 77,5. Такая фраза длиннее и легче запоминается, чем случайная строка той же энтропии.
Важно: энтропия считается относительно модели выбора. Если слова выбираются не случайно, а «придумываются», энтропия падает до уровня словаря с мутациями, и оценка в 51 бит превращается в 30–35.
Рекомендации NIST SP 800-63B
NIST SP 800-63B (2017, обновления 2020-х) изменил подход к паролям 6. Основные положения:
- минимальная длина — 8 символов, рекомендуется 15 и больше для паролей без второго фактора;
- максимальная длина — не менее 64 символов, чтобы не мешать парольным фразам и менеджерам;
- проверка по списку распространённых и скомпрометированных паролей обязательна;
- правила сложности (заглавные, цифры, спецсимволы) и принудительная ротация — не рекомендуются, потому что дают предсказуемые мутации;
- подсказки к паролю не должны раскрывать сам пароль;
- ограничение числа попыток входа обязательно;
- при проверке допускаются пробелы и любые символы Unicode.
Логика изменений: правила сложности заставляют людей выбирать Password1!, что хуже длинной фразы; принудительная ротация заставляет менять Password1! на Password2!. Проверка по списку утечек и ограничение попыток дают больше, чем формальные требования.
Что не работает
Несколько мер, которые кажутся полезными, но не работают. Ограничение длины пароля до 16 символов — мешает менеджерам и фразам. Запрет спецсимволов — снижает пространство. Секретные вопросы — часто угадываются по открытым данным. Хранение пароля в логах или в параметрах URL — утечка. Отправка пароля по электронной почте «для восстановления» — компрометация.
Отдельно стоит упомянуть проверку на скомпрометированные пароли: сервисы вроде Have I Been Pwned позволяют проверить хеш пароля по префиксу, не передавая сам пароль (k-anonymity). Это хорошая практика, и она встроена во многие менеджеры паролей.
Функции выработки ключей
KDF из секрета и KDF из пароля
Важно различать два класса функций, которые по-русски называются одинаково. Полезно держать перед глазами всю таблицу «похожих» примитивов: у них разные входы, разные цели и разные атаки.
| Примитив | Ключ | Вход | Основная цель | Главная атака |
|---|---|---|---|---|
| Хеш-функция | нет | данные | целостность, идентификатор | коллизия, прообраз |
| MAC | да | данные | аутентичность при общем ключе | подделка (EUF-CMA) |
| KDF из секрета | нет (секрет на входе) | высокоэнтропийный секрет | выработка нескольких ключей | компрометация входа, ошибка разделения |
| Парольный KDF | нет (пароль на входе) | низкоэнтропийный пароль | замедление перебора | словарь, GPU/ASIC |
| AEAD | да | данные и AAD | конфиденциальность + целостность | повтор nonce |
| Обёртывание ключа | да | ключ | хранение ключа с целостностью | подмена обёртки |
Строчки «KDF из секрета» и «парольный KDF» различаются не устройством, а предположением о входе: если вход равномерен, замедлять нечего, а если это пароль, замедление обязательно. Ошибка «применим HKDF к паролю» не даёт ошибки в коде — она даёт незаметно слабую систему.
Функция выработки ключа из пароля (англ. password-based key derivation function) — медленная, с солью, предназначена для низкоэнтропийного входа. Это PBKDF2, scrypt, Argon2. Её цель — сделать перебор дорогим.
Функция выработки ключа из секрета (англ. key derivation function) — быстрая, предназначена для высокоэнтропийного входа. Её цель — из одного хорошего секрета получить несколько ключей для разных целей. Это HKDF.
Путать их опасно: HKDF от пароля не даёт защиты от перебора (он быстрый), а PBKDF2 от случайного ключа — лишняя трата ресурсов.
HKDF: extract и expand
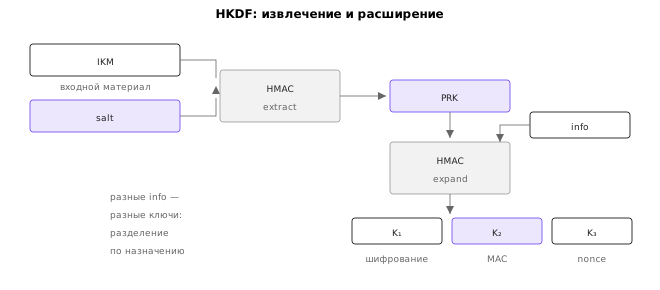
HKDF (RFC 5869) состоит из двух шагов 4.
Шаг извлечения (англ. extract) превращает входной материал в псевдослучайный ключ фиксированной длины:
PRK = HMAC(salt, IKM)
Шаг расширения (англ. expand) разворачивает PRK в ключи нужной длины и для нужных назначений:
OKM = T₁ || T₂ || …
T₁ = HMAC(PRK, info || 0x01)
Tᵢ = HMAC(PRK, T_{i−1} || info || i)
Параметр info — это и есть разделение по назначению: разные строки дают независимые ключи. Например, info = b"encryption" и info = b"authentication" дают два ключа, которые нельзя перепутать.
import hashlib, hmac

def hkdf_extract(salt, ikm):
    return hmac.new(salt, ikm, hashlib.sha256).digest()


def hkdf_expand(prk, info, length):
    out, t, i = b"", b"", 1
    while len(out) < length:
        t = hmac.new(prk, t + info + bytes([i]), hashlib.sha256).digest()
        out += t
        i += 1
    return out[:length]
Тестовый вектор RFC 5869, случай 1: IKM = 0b·22, salt = 000102030405060708090a0b0c, info = f0f1f2f3f4f5f6f7f8f9, длина 42. Ожидаемый PRK = 077709362c2e32df0ddc3f0dc47bba6390b6c73bb50f9c3122ec844ad7c2b3e5, OKM = 3cb25f25faacd57a90434f64d0362f2a2d2d0a90cf1a5a4c5db02d56ecc4c5bf34007208d5b887185865.
Схема ниже показывает оба шага.
Разделение по назначению
Доменная сепарация (англ. domain separation) — требование, чтобы каждый ключ использовался ровно для одной цели. Причина проста: если один и тот же ключ применяется и для шифрования, и для MAC, свойства примитивов смешиваются, и появляются атаки, которых не было бы при разделении.
Практика: из общего секрета выводятся отдельные ключи для каждого направления и каждой цели. В TLS 1.3, например, из общего секрета выводятся ключи для рукопожатия, для данных клиента, для данных сервера, для обновления ключей и для экспорта — все с разными метками.
Разделение реализуется через info в HKDF, через префиксы в KDF или через разные соли. Главное — чтобы разные цели никогда не получали один и тот же ключ.
Управление ключами
Иерархия и шифрование конвертом
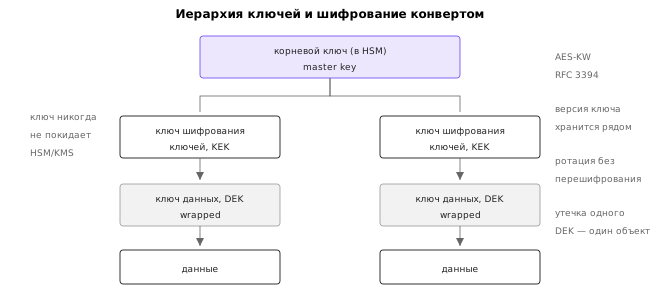
Ключей в системе много, и они образуют иерархию. Верхний уровень — корневой ключ (англ. root key или master key), который хранится в защищённом месте (HSM, KMS) и используется редко. Следующий уровень — ключи шифрования ключей (англ. key encryption key, KEK). Нижний уровень — ключи шифрования данных (англ. data encryption key, DEK), которые используются для конкретных объектов.
Шифрование конвертом (англ. envelope encryption): данные шифруются DEK, а DEK шифруется KEK. Получается «конверт»: зашифрованные данные и зашифрованный ключ рядом. Достоинства: DEK можно менять часто, не перешифровывая данные; KEK остаётся в HSM; при утечке одного DEK скомпрометирован только один объект.
Схема ниже показывает иерархию.
Обёртывание ключей
Для шифрования ключей используют не произвольный режим, а специализированный — обёртывание ключей (англ. key wrapping). AES-KW (RFC 3394) определён именно для этого 5: он шифрует ключ с целостностью, без nonce, и результат на 8 байт длиннее входа.
Свойства AES-KW: детерминированность (одинаковый ключ и KEK дают одинаковый результат), встроенная проверка целостности (при подмене расшифрование отклоняется), поддержка в HSM и стандартных библиотеках. Детерминированность здесь достоинство, а не недостаток: обёрнутый ключ хранится в базе, и повторное обёртывание того же ключа не должно давать новый результат.
from cryptography.hazmat.primitives.keywrap import aes_key_wrap, aes_key_unwrap

wrapped = aes_key_wrap(kek, dek)          # длина кратна 8, результат +8 байт
dek = aes_key_unwrap(kek, wrapped)        # InvalidUnwrap при подмене
Ротация, уничтожение и HSM
Ротация ключей (англ. key rotation) — регулярная смена ключей с сохранением возможности читать старые данные. Реализуется через версионирование: в контейнере хранится идентификатор версии ключа, и при чтении используется соответствующая версия. Сроки ротации зависят от чувствительности данных и от требований стандарта (NIST SP 800-57 рекомендует конкретные периоды для разных типов ключей).
Уничтожение ключа (англ. key destruction) — не удаление файла, а гарантированное затирание всех копий, включая резервные и кэшированные. В HSM это делается командой, которая физически уничтожает материал; в программной среде — перезаписью, но гарантий меньше, потому что копии могут остаться в снапшотах и бэкапах.
HSM (англ. hardware security module) — устройство, которое хранит ключи и выполняет операции с ними, не выдавая материал наружу. Программный интерфейс — PKCS#11, а также KMIP и проприетарные API. KMS — облачный аналог: управляемый сервис, который выполняет шифрование и хранит ключи, а клиент получает только результат.
Практическое правило: если ключ можно прочитать в коде или в конфигурации, это не «управление ключами», а хранение секрета в открытом виде. Настоящее управление начинается там, где ключ никогда не покидает границу, в которой он используется.
Аутентификация без передачи пароля
SCRAM
SCRAM (RFC 5802) — схема аутентификации, при которой пароль не передаётся по сети даже в защищённом виде 11. Клиент доказывает знание пароля, используя соль, число итераций и серверный nonce, а сервер проверяет доказательство. Схема устойчива к перехвату и к компрометации базы: украденные верификаторы не позволяют войти без перебора.
SCRAM используется как механизм SASL в PostgreSQL, MongoDB, Kafka, XMPP. Он требует, чтобы сервер хранил не хеш пароля, а верификатор, из которого нельзя вывести ключ клиента.
PAKE и OPAQUE
PAKE (англ. password-authenticated key exchange) — класс протоколов, которые одновременно аутентифицируют стороны по паролю и вырабатывают общий ключ, причём пароль не передаётся и не может быть проверен офлайн по перехвату. Классический пример — SPAKE2 (RFC 9382); другой — OPAQUE, где сервер хранит не пароль, а «конверт», который нельзя использовать для офлайн-перебора без взаимодействия с сервером.
Практическая ценность: PAKE защищает от офлайн-перебора по перехваченному рукопожатию и от компрометации базы (в случае OPAQUE). Стоимость — сложность реализации и отсутствие поддержки в большинстве библиотек, поэтому в массовых продуктах чаще встречается SCRAM или TLS с паролем внутри защищённого канала.
Итоги темы
Пароли нельзя хранить открыто и нельзя хранить «просто хешем». Правильная схема включает соль (уникальную для каждой записи), медленную функцию (PBKDF2, bcrypt, scrypt или Argon2id) и параметры, подобранные под целевую задержку в 100–300 мс. Память — ключевой ресурс: функции, требующие мегабайт на вычисление, снижают преимущество GPU на порядки.
Политика паролей сместилась от формальных правил к содержательным мерам: длине, проверке по списку утечек, ограничению попыток и отказу от принудительной ротации. Парольные фразы дают больше энтропии при меньшей нагрузке на память человека.
Выработка ключей — отдельная задача: HKDF с шагами extract и expand позволяет из одного секрета получить несколько независимых ключей, а параметр info обеспечивает разделение по назначению. Смешивать KDF из пароля и KDF из секрета нельзя: у них разные цели и разные требования к скорости.
Управление ключами — самая проваливаемая часть. Иерархия, шифрование конвертом, обёртывание ключей (AES-KW), ротация с версионированием, уничтожение и HSM — не бюрократия, а способ сделать так, чтобы утечка одного ключа не означала утечку всех. Правило простое: ключ не должен появляться там, где его можно прочитать.
Следующая тема переходит к асимметричной криптографии — обмену ключами Диффи — Хеллмана, — где задача распределения ключей решается принципиально иначе, а требования к случайности и к проверке параметров становятся ещё строже.
Литература
- Moriarty K. (ed.). PKCS #5: Password-Based Cryptography Specification Version 2.1. — RFC 8018, IETF, 2017. https://www.rfc-editor.org/rfc/rfc8018
- Percival C., Josefsson S. The scrypt Password-Based Key Derivation Function. — RFC 7914, IETF, 2016. https://www.rfc-editor.org/rfc/rfc7914
- Biryukov A., Dinu D., Khovratovich D., Josefsson S. Argon2 Memory-Hard Function for Password Hashing and Proof-of-Work Applications. — RFC 9106, IETF, 2021. https://www.rfc-editor.org/rfc/rfc9106
- Krawczyk H., Eronen P. HMAC-based Extract-and-Expand Key Derivation Function (HKDF). — RFC 5869, IETF, 2010. https://www.rfc-editor.org/rfc/rfc5869
- Schaad J., Housley R. Advanced Encryption Standard (AES) Key Wrap Algorithm. — RFC 3394, IETF, 2002. https://www.rfc-editor.org/rfc/rfc3394
- NIST. Digital Identity Guidelines: Authentication and Lifecycle Management. — SP 800-63B, 2017 (with updates). https://doi.org/10.6028/NIST.SP.800-63b
- OWASP. Password Storage Cheat Sheet. — OWASP Cheat Sheet Series, 2024. https://cheatsheetseries.owasp.org/cheatsheets/Password_Storage_Cheat_Sheet.html
- Provos N., Mazières D. A Future-Adaptable Password Scheme. — Proceedings of the USENIX Annual Technical Conference, 1999. https://www.usenix.org/legacy/events/usenix99/provos.html
- Hellman M. E. A Cryptanalytic Time-Memory Trade-Off. — IEEE Transactions on Information Theory, 1980, Т. 26, № 4, С. 401–406. DOI: 10.1109/TIT.1980.1056220
- Oechslin P. Making a Faster Cryptanalytic Time-Memory Trade-Off. — Advances in Cryptology — CRYPTO 2003, Springer, 2003, С. 617–630. DOI: 10.1007/978-3-540-45146-4_36
- Newman C., Menon-Sen A., Melnikov A., Williams N. Salted Challenge Response Authentication Mechanism (SCRAM-SHA-1). — RFC 5802, IETF, 2010. https://www.rfc-editor.org/rfc/rfc5802
- Biryukov A., Dinu D., Khovratovich D. Argon2: New Generation of Memory-Hard Functions for Password Hashing and Other Applications. — IEEE European Symposium on Security and Privacy (EuroS&P), 2016, С. 292–302. DOI: 10.1109/EuroSP.2016.38