
Введение в базы данных и СУБД
Почти любая информационная система — интернет-магазин, банк, система учёта успеваемости, журнал событий веб-сервера — в конечном счёте решает одну задачу: хранить данные долго, надёжно и так, чтобы ими могли одновременно пользоваться многие программы и люди. На первом курсе данные программы на Python жили в переменных и, в лучшем случае, сохранялись в файл CSV или JSON. Для учебной задачи этого достаточно, но стоит представить, что с тем же файлом одновременно работают сотни пользователей, что питание пропадает в середине записи, что формат файла нужно изменить, не переписывая десяток программ, — и становится ясно, почему возникла отдельная область информатики и отдельный класс программ: системы управления базами данных.
Настоящая тема открывает курс и выполняет две задачи. Во-первых, она вводит основные понятия — данные, база данных, модель данных, схема, система управления базой данных — и объясняет, какие именно проблемы СУБД снимает с прикладного программиста. Во-вторых, она даёт общую картину: как развивались модели данных от иерархической до реляционной и далее, как устроена СУБД изнутри и как конкретно устроен PostgreSQL — СУБД, на которой построен весь курс. Подробности каждого механизма излагаются в последующих темах, а здесь важно понять, какие механизмы вообще существуют и зачем они нужны.
Курс состоит из четырёх разделов. Раздел I «Реляционная модель и язык SQL» (темы 1–6) вводит реляционную модель и ограничения целостности, реляционную алгебру и язык запросов SQL — от запросов к одной таблице до соединений, подзапросов, агрегирования, оконных функций, изменения данных, рекурсивных запросов и представлений. Раздел II «Проектирование баз данных» (темы 7–9) учит строить схему: концептуальная модель «сущность — связь», функциональные зависимости и нормализация, физическое проектирование — типы данных, хранение, полуструктурированные данные. Раздел III «Внутреннее устройство и производительность» (темы 10–13) раскрывает то, что скрыто за декларативным SQL: индексы, выполнение и оптимизацию запросов, транзакции и управление параллельным доступом, журнал, восстановление и резервное копирование. Раздел IV «Базы данных в приложениях» (темы 14–16) посвящён серверному программированию, работе с базой из приложения на Python и безопасности, а также масштабированию, NoSQL и аналитическим системам. Все примеры и лабораторные работы строятся на одной учебной базе — книжном интернет-магазине «Книжный узел», которая устанавливается в лабораторной работе 1.
Изложение темы построено так. Первый раздел определяет базовые понятия и перечисляет свойства, отличающие базу данных от набора файлов. Второй прослеживает историю моделей данных и языка SQL. Третий описывает трёхуровневую архитектуру ANSI/SPARC и понятие независимости данных — с демонстрацией на учебной базе. Четвёртый разбирает компоненты СУБД и путь запроса через них. Пятый посвящён архитектуре PostgreSQL: процессам сервера, кластеру, базам, схемам и ролям, а также встраиваемым СУБД. Шестой кратко характеризует профессиональные роли и рынок СУБД.
Данные, базы данных и системы управления ими
Данные, информация и база данных
Под данными (англ. data) понимают зарегистрированные факты, представленные в форме, пригодной для хранения, передачи и обработки: строка «Пикник на обочине», число 520.00, дата 2021-06-24. Информация (англ. information) — это данные вместе с их смыслом, то есть с интерпретацией: «книга „Пикник на обочине“ стоит 520 рублей». Одни и те же данные без описания смысла бесполезны: число 520 может быть ценой, числом страниц или кодом склада. Поэтому база данных хранит не только сами значения, но и их описание — какие бывают объекты, из каких свойств они состоят, какие правила должны выполняться.
База данных (англ. database) — это совместно используемый набор логически связанных данных и их описания, предназначенный для удовлетворения информационных потребностей организации 2. В этом определении важно каждое слово. «Совместно используемый» — с базой работают многие программы и пользователи, а не одна программа. «Логически связанных» — данные отражают одну предметную область (англ. universe of discourse): книги, авторы, покупатели и заказы магазина связаны между собой. «И их описания» — база данных самоописательна: описание структуры, называемое схемой (англ. schema) или метаданными, хранится в самой базе, в системном каталоге (англ. system catalog), и доступно для запросов наравне с данными.
Система управления базами данных, СУБД (англ. Database Management System, DBMS), — программная система, которая позволяет определять структуру базы, создавать, читать и изменять данные и при этом контролирует доступ к ним, обеспечивает целостность, параллельную работу и восстановление после сбоев 23. Совокупность базы данных, СУБД и прикладных программ, работающих с ними, называют системой баз данных (англ. database system). В обиходе слова «база данных» нередко употребляют и в смысле «СУБД» («поставим базу данных PostgreSQL»); в курсе эти понятия различаются: PostgreSQL — СУБД, а bookstore — база данных, которой он управляет.
Каждая СУБД реализует определённую модель данных (англ. data model) — набор понятий для описания структуры данных, операций над ними и ограничений целостности. Реляционная модель описывает данные как отношения (таблицы) и операции над ними; иерархическая — как деревья записей; документная — как вложенные документы. Описание конкретной базы в терминах модели — это её схема, а сами данные в определённый момент времени — состояние, или экземпляр (англ. instance), базы. Схема меняется редко и осознанно, состояние — при каждой операции записи. Разница между ними принципиальна: утверждение «каждая книга относится к одной рубрике» — свойство схемы, а «сейчас в базе 2010 книг» — свойство состояния. К этому различию курс будет возвращаться постоянно, начиная с темы 2, где выяснится, что ключ — свойство схемы, а не случайно уникальных данных.
Почему не набор файлов
Простейший способ хранить данные магазина — файлы: books.csv, customers.csv, orders.csv и программа на Python, которая их читает и пишет. Именно так работали информационные системы 1960-х годов, и недостатки такого подхода хорошо известны 23. Рассмотрим их на примере.
Первая проблема — зависимость программ от формата данных. Программа, которая читает books.csv, знает, что цена — пятый столбец, разделитель — запятая, кодировка — UTF-8. Если добавить в файл столбец «год издания» перед ценой, все программы, читающие файл, придётся исправить. В СУБД программы обращаются к данным по именам, а не по положению байтов в файле, и изменение структуры хранения скрыто от них. Это свойство называется независимостью данных и подробно разбирается в третьем разделе.
Вторая проблема — дублирование и противоречивость. Если имя покупателя хранится и в файле покупателей, и в каждой строке файла заказов, то при смене фамилии одни копии исправят, а другие забудут. Избыточность (англ. redundancy) порождает несогласованность (англ. inconsistency). Устранение избыточности — предмет нормализации (тема 8).
Третья проблема — целостность. Правила «цена не может быть отрицательной», «электронный адрес покупателя уникален», «заказ ссылается на существующего покупателя» в файловой системе проверяются (или не проверяются) каждой программой отдельно. Достаточно одной программы с ошибкой — и в файле появится заказ несуществующего покупателя. СУБД хранит ограничения целостности (англ. integrity constraints) в схеме и проверяет их при каждом изменении, кто бы его ни выполнял. В учебной базе это выглядит так:
INSERT INTO order_item (order_id, book_id, quantity, price) VALUES (1, 999999, 1, 100.00);
INSERT INTO customer (email, full_name) VALUES ('user1@example.com', 'Двойник');
UPDATE stock SET quantity = quantity - 100 WHERE warehouse_id = 1 AND book_id = 1;
ERROR:  insert or update on table "order_item" violates foreign key constraint "order_item_book_id_fkey"
DETAIL:  Key (book_id)=(999999) is not present in table "book".
ERROR:  duplicate key value violates unique constraint "customer_email_key"
DETAIL:  Key (email)=(user1@example.com) already exists.
ERROR:  new row for relation "stock" violates check constraint "stock_quantity_check"
DETAIL:  Failing row contains (1, 1, -89).
Все три изменения отвергнуты сервером: позиция заказа ссылается на несуществующую книгу, адрес user1@example.com уже занят, остаток книги 1 на складе 1 (он равен 11) стал бы отрицательным. Ни одна прикладная программа не обязана помнить об этих правилах — их соблюдение гарантирует СУБД. Ограничения целостности — тема 2.
Четвёртая проблема — параллельный доступ. Две программы одновременно читают остаток книги (11 экземпляров), каждая продаёт один экземпляр и записывает 10. Продано два экземпляра, а остаток уменьшился на один — классическое потерянное обновление (англ. lost update). В файловой системе от этого защищает только ручная блокировка файла целиком, что сводит параллельную работу на нет. СУБД предоставляет транзакции (англ. transactions) — группы операций, которые выполняются как единое целое и изолированы от других транзакций; механизмы изоляции — тема 12.
Пятая проблема — сбои. Если программа записала половину файла и процесс был прерван, файл повреждён. Если в заказе успели записать позиции, но не успели записать оплату, данные противоречивы. СУБД гарантирует, что зафиксированная транзакция сохранится и после сбоя, а незафиксированная не оставит следов; для этого служит журнал упреждающей записи (тема 13). Совокупность гарантий атомарности, согласованности, изоляции и долговечности транзакций называют ACID (англ. Atomicity, Consistency, Isolation, Durability) 2.
Шестая проблема — безопасность. Файл либо доступен процессу целиком, либо недоступен. СУБД разграничивает права на уровне таблиц, столбцов и даже строк: аналитик видит обезличенную статистику продаж, но не адреса покупателей (тема 15).
Наконец, седьмая проблема — доступ к данным. Чтобы ответить на вопрос «какие книги рубрики „Базы данных“ дороже 2500 рублей», с файлами нужно написать программу: открыть файл, разобрать строки, отфильтровать, отсортировать. В СУБД достаточно сформулировать вопрос на декларативном языке запросов (англ. query language) — описать, что нужно получить, а не как:
SELECT title, price
FROM book
WHERE category_id = 13 AND price > 2500
ORDER BY price DESC, title
LIMIT 3;
        title        |  price
---------------------+---------
 Практика чисел 962  | 2979.99
 Путь Python 1363    | 2979.99
 Теория Python 291   | 2959.99
(3 rows)
Как именно найти эти строки — прочитать таблицу целиком или воспользоваться индексом, отсортировать все строки или только три лучших, — решает сама СУБД. Второй ключ сортировки title добавлен не случайно: у двух книг одинаковая цена 2979.99, и без него порядок этих строк, а при меньшем LIMIT и сам состав результата, не определён — СУБД вправе вернуть их в любом порядке (тема 3). Это разделение ответственности — центральная идея реляционного подхода 1.
Когда СУБД не нужна
Перечисленные достоинства не бесплатны. СУБД — сложная программа, её нужно установить, настроить, администрировать; доступ к данным через сервер медленнее, чем чтение локального файла. Если данные пишет одна программа, читают редко, а их потеря не страшна (конфигурационный файл, журнал отладки, результаты одного научного расчёта), обычного файла может быть достаточно. Промежуточный вариант — встраиваемая СУБД вроде SQLite, которая работает внутри процесса программы и хранит базу в одном файле, но даёт язык SQL, транзакции и ограничения целостности; к ней вернёмся в пятом разделе. Выбор хранилища — инженерное решение, и умение обосновать его — одна из целей курса.
История моделей данных и языка SQL
Файловые системы и навигационные модели
Первые коммерческие системы обработки данных 1950–1960-х годов строились на файлах с последовательным доступом на магнитных лентах: каждая программа сама определяла формат записей, а обработка выполнялась пакетами. Появление дисков с прямым доступом позволило хранить связи между записями явно — указателями. Так возникли навигационные модели данных: программа получает запись и «перемещается» по указателям к связанным записям, то есть сама прокладывает путь доступа.
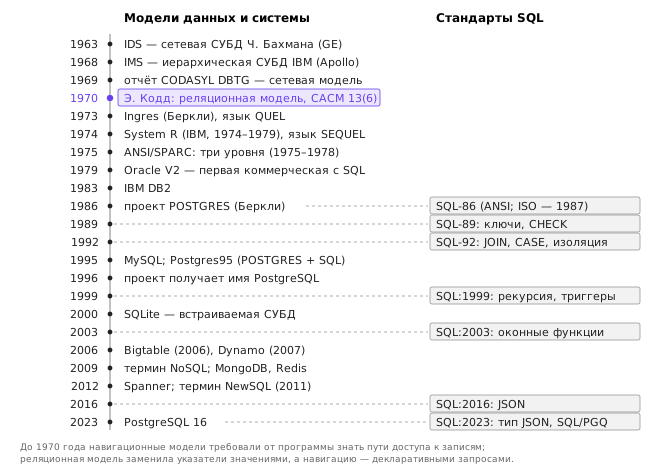
Иерархическая модель представляет данные как лес деревьев: у каждой записи, кроме корневой, ровно один родитель. Её классическая реализация — IMS (англ. Information Management System) компании IBM, созданная в 1966–1968 годах совместно с North American Rockwell для учёта деталей в программе Apollo и выпущенная как коммерческий продукт в 1969 году 23. Иерархия хорошо описывает естественно древовидные данные (изделие — узлы — детали), но плохо — связи «многие ко многим»: книга с двумя авторами должна либо дублироваться под каждым автором, либо связываться искусственными «логическими» указателями.
Сетевая модель снимает ограничение на одного родителя: записи объединяются в наборы (англ. sets) «владелец — члены», и запись может быть членом нескольких наборов. Её прообраз — система IDS (англ. Integrated Data Store), созданная Чарльзом Бахманом в General Electric в начале 1960-х годов, а стандарт сформулирован рабочей группой по базам данных DBTG (англ. Data Base Task Group) комитета CODASYL в отчётах 1969 и 1971 годов 2. В 1973 году Бахман получил премию Тьюринга; его тьюринговская лекция называлась «Программист как навигатор» и описывала программиста, путешествующего по базе данных от записи к записи 11.
Навигационные системы были быстрыми, но у них был фундаментальный недостаток: путь доступа зашит в программу. Запрос «все заказы покупателя» пишется как цикл по набору «покупатель — заказы»; если для нового запроса нужного набора нет, его приходится добавлять в схему и перестраивать базу, а изменение структуры ломает существующие программы. Программисты, по выражению Кодда, должны были знать физическую организацию данных, чтобы получить к ним доступ.
Реляционная модель Кодда и первые реляционные СУБД
В июне 1970 года сотрудник исследовательской лаборатории IBM в Сан-Хосе Эдгар Кодд опубликовал в журнале Communications of the ACM (т. 13, № 6) статью «A Relational Model of Data for Large Shared Data Banks» 1. Кодд предложил представлять все данные единообразно — как отношения в математическом смысле, то есть множества кортежей, — а связи между ними выражать не указателями, а значениями: заказ хранит номер покупателя, и связь «заказ — покупатель» восстанавливается сравнением значений. Первая же фраза статьи формулирует цель: пользователи больших банков данных должны быть защищены от знания того, как данные организованы в машине 1. Над отношениями определялись операции, позднее оформленные как реляционная алгебра (тема 3), результат которых — снова отношения; запрос описывает искомый результат, а способ его получения выбирает система.
Идея встретила скепсис: казалось, что система, сама выбирающая путь доступа, не может быть столь же эффективной, как ручная навигация. Ответом стали два исследовательских проекта середины 1970-х годов. Проект System R в той же лаборатории IBM (1974–1979) построил полноценную реляционную СУБД с языком SEQUEL, позднее переименованным в SQL, оптимизатором на основе стоимости, транзакциями и восстановлением 5. Язык SEQUEL (англ. Structured English Query Language) был описан Дональдом Чемберлином и Рэймондом Бойсом в 1974 году 7; оптимизатор System R, описанный Патрисией Селинджер с соавторами в 1979 году, до сих пор служит образцом для оптимизаторов реляционных СУБД (тема 11) 4. Параллельно в Калифорнийском университете в Беркли Майкл Стоунбрейкер и Юджин Вонг с 1973 года разрабатывали СУБД Ingres с языком QUEL 6. Оба проекта доказали, что реляционная СУБД может быть практичной.
Коммерческие системы последовали быстро. В 1979 году компания Relational Software (впоследствии Oracle) выпустила Oracle V2 — первую коммерчески доступную СУБД с языком SQL; IBM выпустила SQL/DS в 1981 году и DB2 в 1983 году; на основе проекта Ingres была создана одноимённая коммерческая СУБД, а выходцы из него участвовали в создании Sybase, от которой ведёт происхождение Microsoft SQL Server 2. В 1981 году Кодд получил премию Тьюринга. В 1986 году Стоунбрейкер начал в Беркли проект POSTGRES («после Ingres»), нацеленный на расширяемость системы типов и правил; в 1994–1995 годах Эндрю Ю и Джолли Чен заменили язык запросов POSTQUEL на SQL (система Postgres95), а в 1996 году проект получил имя PostgreSQL и стал развиваться сообществом 9.
SQL и его стандарты
SQL (произносится «эс-кью-эль» или, по старому имени, «сиквел») стал общим языком реляционных СУБД благодаря стандартизации. Стандарт ведётся сначала ANSI, затем совместно ISO и IEC под номером ISO/IEC 9075 и состоит из нескольких частей: Framework, Foundation, Call-Level Interface, Persistent Stored Modules и др. 13. Основные редакции перечислены в таблице.
| Редакция | Основные нововведения |
|---|---|
| SQL-86 (ANSI X3.135-1986, ISO 9075:1987) | первый стандарт: SELECT, INSERT, UPDATE, DELETE, CREATE TABLE, представления, привилегии |
| SQL-89 | средства целостности: PRIMARY KEY, FOREIGN KEY, CHECK, DEFAULT |
| SQL-92 (SQL2) | JOIN в предложении FROM, внешние соединения, CASE, типы даты и времени, уровни изоляции транзакций, information_schema |
| SQL:1999 (SQL3) | рекурсивные запросы WITH RECURSIVE, триггеры, тип BOOLEAN, пользовательские и структурные типы (объектно-реляционные расширения), хранимые процедуры (PSM) |
| SQL:2003 | оконные функции, MERGE, столбцы-идентификаторы и последовательности, SQL/XML |
| SQL:2006, SQL:2008 | развитие SQL/XML; TRUNCATE, триггеры INSTEAD OF, FETCH FIRST |
| SQL:2011 | темпоральные таблицы (периоды, системное версионирование) |
| SQL:2016 | работа с JSON, распознавание шаблонов в последовательностях строк (MATCH_RECOGNIZE) |
| SQL:2023 | тип данных JSON, запросы к графам свойств (SQL/PGQ, часть 16) |
Стандарт велик, и ни одна СУБД не реализует его полностью; кроме того, у каждой СУБД есть собственные расширения. PostgreSQL стремится следовать стандарту и в документации указывает, какие возможности соответствуют ему, а какие являются расширениями; в курсе отклонения от стандарта оговариваются явно.
Объектно-реляционные расширения, NoSQL и NewSQL
В 1980–1990-х годах популярность объектно-ориентированного программирования породила объектные СУБД, хранившие объекты языка программирования непосредственно. Широкого распространения они не получили; вместо этого реляционные СУБД вобрали часть их идей — пользовательские типы, наследование таблиц, массивы, расширяемые индексы. Такие системы называют объектно-реляционными; PostgreSQL с его расширяемой системой типов, восходящей к проекту POSTGRES, — характерный пример 9.
В 2000-х годах крупные интернет-компании столкнулись с объёмами данных и нагрузкой, для которых один сервер был недостаточен. Распределённые хранилища Google Bigtable (2006) и Amazon Dynamo (2007) отказались от части реляционных гарантий — соединений, транзакций над несколькими записями, строгой согласованности — ради горизонтального масштабирования и доступности. С 2009 года подобные системы объединяют под условным названием NoSQL: хранилища «ключ — значение» (Redis), документные (MongoDB), с широкими столбцами (Cassandra), графовые (Neo4j) 12. Позднее появились системы, которые называют NewSQL или распределёнными SQL-СУБД (Google Spanner, CockroachDB, YugabyteDB): они сохраняют SQL и транзакции, но распределяют данные по многим узлам. Эти модели и компромиссы между ними — тема 16. Примечательно, что реляционные СУБД, в свою очередь, переняли сильные стороны NoSQL: в PostgreSQL есть тип jsonb для документов (тема 9), а реляционная модель остаётся основной для систем учёта, где важны целостность и транзакции.
Временную шкалу ключевых событий показывает рисунок ниже.
Трёхуровневая архитектура и независимость данных
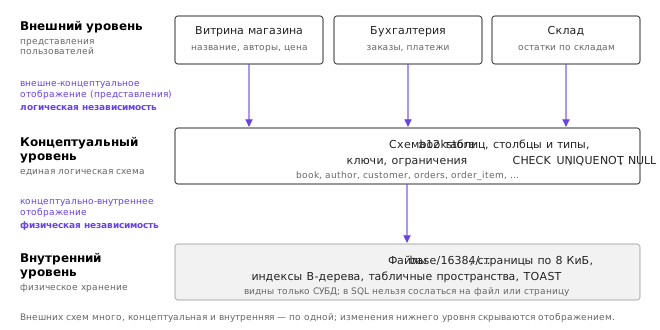
Уровни ANSI/SPARC
В 1975 году исследовательская группа по СУБД комитета ANSI/X3/SPARC опубликовала промежуточный отчёт, а в 1977–1978 годах — итоговый, в котором предложила разделять описание базы данных на три уровня 8. Эта архитектура не стала стандартом в строгом смысле, но её понятия — уровни и независимость данных — общеприняты 23.
Внешний уровень (англ. external level) — то, как данные видит конкретный пользователь или приложение. Каждое внешнее представление, или подсхема, включает только нужные данные в удобной форме: витрина магазина видит название, автора и цену книги, бухгалтерия — суммы платежей, служба доставки — адреса и статусы заказов. Внешних представлений много.
Концептуальный уровень (англ. conceptual level) — единое логическое описание всей базы: какие есть сущности, их атрибуты, связи и ограничения целостности, без подробностей хранения. Для реляционной СУБД это набор таблиц со столбцами, типами, ключами и ограничениями — то, что записано в schema.sql учебной базы. Концептуальная схема одна. В современной терминологии её чаще называют логической схемой.
Внутренний уровень (англ. internal level) — физическое представление данных: в каких файлах и страницах хранятся строки, в каком формате, какие построены индексы, как данные сжаты и размещены на дисках. Внутренняя схема тоже одна.
Между уровнями существуют отображения (англ. mappings): внешне-концептуальное определяет, как строки внешнего представления получаются из таблиц концептуальной схемы, концептуально-внутреннее — как таблицы хранятся физически. Именно эти отображения СУБД берёт на себя. Схема на рисунке ниже показывает уровни и отображения на примере «Книжного узла».
Физическая независимость данных
Физическая независимость данных (англ. physical data independence) — возможность изменять внутреннюю схему, не изменяя концептуальную схему и прикладные программы. Покажем её на учебной базе. Найдём книгу по названию и посмотрим план выполнения — способ, которым СУБД собирается выполнять запрос (команда EXPLAIN подробно разбирается в теме 11):
EXPLAIN SELECT book_id, title, price FROM book WHERE title = 'Пикник на обочине';
                      QUERY PLAN
------------------------------------------------------
 Seq Scan on book  (cost=0.00..88.12 rows=1 width=46)
   Filter: (title = 'Пикник на обочине'::text)
(2 rows)
План Seq Scan означает последовательное чтение всей таблицы с проверкой условия для каждой строки. Создадим индекс — вспомогательную структуру для быстрого поиска (тема 10) — и повторим тот же запрос:
CREATE INDEX book_title_idx ON book (title);
EXPLAIN SELECT book_id, title, price FROM book WHERE title = 'Пикник на обочине';
                                 QUERY PLAN
----------------------------------------------------------------------------
 Index Scan using book_title_idx on book  (cost=0.28..8.29 rows=1 width=46)
   Index Cond: (title = 'Пикник на обочине'::text)
(2 rows)
Текст запроса не изменился, результат (книга 4, цена 520.00) тот же, но способ выполнения другой: теперь СУБД ищет строку по индексу, и оценка стоимости уменьшилась примерно в десять раз. Приложение, выполняющее этот запрос, ничего не нужно менять — оно даже не знает о существовании индекса. Точно так же без изменения программ можно перенести таблицу в другое табличное пространство на другом диске, изменить параметры хранения или сжатия. Индекс в эксперименте удаляется командой DROP INDEX book_title_idx;, поскольку вторичные индексы в учебной базе намеренно отсутствуют до темы 10.
Логическая независимость данных
Логическая независимость данных (англ. logical data independence) — возможность изменять концептуальную схему, не изменяя внешних схем и программ, которые через них работают. Её добиться труднее, и реализуется она в основном механизмом представлений (англ. views) — именованных запросов, которые ведут себя как таблицы (тема 6). Пусть программа прайс-листа работает не с таблицей book непосредственно, а с представлением:
BEGIN;
CREATE VIEW price_list AS
    SELECT isbn, title, price FROM book WHERE price > 0;
SELECT * FROM price_list WHERE isbn = '9785170878239';
     isbn      |       title       | price
---------------+-------------------+--------
 9785170878239 | Пикник на обочине | 520.00
(1 row)
Теперь изменим концептуальную схему: переименуем столбец цены и добавим новый столбец скидки. Запрос через представление продолжает работать и возвращает тот же результат, а СУБД сама перестроила отображение — это видно по тексту представления, который возвращает функция pg_get_viewdef:
ALTER TABLE book RENAME COLUMN price TO list_price;
ALTER TABLE book ADD COLUMN discount numeric(4, 2) NOT NULL DEFAULT 0;
SELECT * FROM price_list WHERE isbn = '9785170878239';
SELECT pg_get_viewdef('price_list');
ROLLBACK;
     isbn      |       title       | price
---------------+-------------------+--------
 9785170878239 | Пикник на обочине | 520.00
(1 row)

            pg_get_viewdef
--------------------------------------
  SELECT isbn,                       +
     title,                          +
     list_price AS price             +
    FROM book                        +
   WHERE (list_price > (0)::numeric);
(1 row)
Внешняя схема (представление price_list со столбцом price) осталась прежней, изменилось лишь отображение. Весь эксперимент выполнен внутри транзакции и отменён командой ROLLBACK — в PostgreSQL изменения схемы транзакционны, и это позволяет безопасно экспериментировать с учебной базой. Логическая независимость не абсолютна: если удалить столбец, используемый представлением, или разделить таблицу на две, представление придётся переписать, а для изменения данных через сложное представление нужны дополнительные механизмы (тема 6 и тема 14). Тем не менее разделение «что хранится» и «что видит приложение» — основной инструмент эволюции схемы.
Где проходят границы на практике
Трёхуровневая архитектура — идеализация. В реальных системах приложения часто обращаются прямо к таблицам концептуальной схемы, а не к представлениям, и тогда логическая независимость отсутствует: переименование столбца ломает приложение. С другой стороны, физическая независимость в реляционных СУБД выполняется очень полно: SQL вообще не содержит средств сослаться на файл, страницу или указатель. Это прямое следствие реляционной модели, где доступ к данным выполняется только по значениям 1. Цена такой независимости — необходимость оптимизатора: раз программа не указывает путь доступа, его должна выбирать СУБД, и выбирать хорошо. Устройство оптимизатора — тема 11.
Компоненты СУБД и путь запроса
Обзор архитектуры
Внутреннее устройство СУБД традиционно описывают как набор взаимодействующих компонентов 42. Рисунок ниже показывает их на пути одного запроса от клиента до диска.
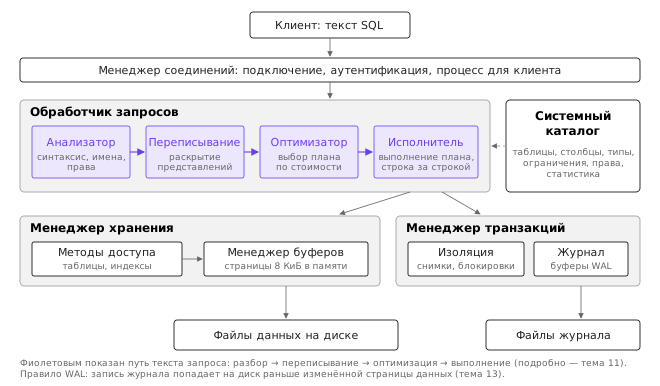
Менеджер соединений (англ. connection manager) принимает подключения клиентов, проверяет их подлинность и создаёт для каждого клиента контекст выполнения — в PostgreSQL отдельный процесс (следующий раздел).
Обработчик запросов (англ. query processor) превращает текст SQL в результат. Анализатор (англ. parser) проверяет синтаксис и строит дерево разбора; на этом этапе по системному каталогу проверяется, что таблицы и столбцы существуют и что у пользователя есть права. Модуль переписывания (англ. rewriter) раскрывает представления, подставляя их определения. Оптимизатор, или планировщик (англ. optimizer, planner), перебирает возможные способы выполнения — порядок соединений, методы доступа к таблицам, алгоритмы соединения и сортировки — оценивает стоимость каждого по статистике о данных и выбирает самый дешёвый план (англ. execution plan). Исполнитель (англ. executor) выполняет план, обычно по конвейерной схеме: каждый узел плана по запросу выдаёт следующую строку своему родителю.
Менеджер хранения (англ. storage manager) включает методы доступа (англ. access methods) — способы читать и изменять таблицы и индексы — и менеджер буферов (англ. buffer manager), который держит в оперативной памяти копии страниц с диска. Данные на диске разбиты на страницы фиксированного размера (в PostgreSQL 8 КиБ); любое чтение или изменение строки выполняется над страницей в буферном кеше, а запись изменённых страниц на диск откладывается.
Менеджер транзакций (англ. transaction manager) обеспечивает изоляцию параллельных транзакций — блокировками, многоверсионностью или их сочетанием — и вместе с менеджером журнала (англ. log manager) гарантирует атомарность и долговечность: прежде чем изменённая страница попадёт на диск, на диск должна попасть запись журнала, описывающая изменение. Это правило упреждающей записи (англ. write-ahead logging, WAL) позволяет после сбоя восстановить зафиксированные изменения (тема 13).
Наконец, системный каталог (англ. catalog) хранит метаданные — описания таблиц, столбцов, типов, ограничений, индексов, прав, а также статистику для оптимизатора. В реляционной СУБД каталог сам состоит из таблиц, и к нему можно обращаться обычными запросами — это одно из правил Кодда, о которых пойдёт речь в теме 2.
План выполнения: что выбрал оптимизатор
Увидеть результат работы оптимизатора позволяет команда EXPLAIN. Запрос о трёх самых дорогих книгах рубрики «Базы данных» (рубрика 13) выполняется таким планом:
EXPLAIN SELECT title, price FROM book WHERE category_id = 13 ORDER BY price DESC LIMIT 3;
                             QUERY PLAN
--------------------------------------------------------------------
 Limit  (cost=89.60..89.61 rows=3 width=42)
   ->  Sort  (cost=89.60..89.88 rows=114 width=42)
         Sort Key: price DESC
         ->  Seq Scan on book  (cost=0.00..88.12 rows=114 width=42)
               Filter: (category_id = 13)
(5 rows)
План читается снизу вверх, от листьев к корню. Узел Seq Scan последовательно читает таблицу book и пропускает дальше только строки рубрики 13; оптимизатор ожидает около 114 таких строк, исходя из статистики (в рубрике 13 на самом деле 114 книг, оценка точна). Узел Sort сортирует их по убыванию цены, узел Limit отдаёт три первые. Числа cost — оценка стоимости в условных единицах (первое — до выдачи первой строки, второе — до выдачи всех), rows — ожидаемое число строк, width — средняя ширина строки в байтах. Детальное чтение планов — тема 11; сейчас важно, что план — это программа, которую СУБД построила по декларативному запросу сама.
Менеджер буферов в действии
Работу менеджера буферов можно наблюдать с помощью EXPLAIN (ANALYZE, BUFFERS): запрос действительно выполняется, а в плане показывается, сколько страниц было найдено в буферном кеше (hit) и сколько пришлось прочитать с диска или из кеша операционной системы (read). Выполним запрос сразу после перезапуска сервера, когда буферный кеш пуст, а затем повторим его:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*) FROM book WHERE price > 2500;
                             QUERY PLAN
--------------------------------------------------------------------
 Aggregate (actual time=1.219..1.220 rows=1 loops=1)
   Buffers: shared read=63
   ->  Seq Scan on book (actual time=0.039..1.196 rows=344 loops=1)
         Filter: (price > '2500'::numeric)
         Rows Removed by Filter: 1666
         Buffers: shared read=63
 Planning:
   Buffers: shared hit=6 read=2
 Planning Time: 0.189 ms
 Execution Time: 1.243 ms
(10 rows)
При повторном выполнении того же запроса:
                             QUERY PLAN
--------------------------------------------------------------------
 Aggregate (actual time=0.382..0.382 rows=1 loops=1)
   Buffers: shared hit=63
   ->  Seq Scan on book (actual time=0.012..0.364 rows=344 loops=1)
         Filter: (price > '2500'::numeric)
         Rows Removed by Filter: 1666
         Buffers: shared hit=63
 Planning Time: 0.098 ms
 Execution Time: 0.401 ms
(8 rows)
Таблица book занимает 63 страницы по 8 КиБ. В первый раз все 63 страницы были прочитаны (read=63), во второй — найдены в общем буферном кеше (hit=63), и запрос выполнился втрое быстрее. Абсолютные времена у каждого читателя будут своими; важно соотношение. Размер буферного кеша задаётся параметром shared_buffers (по умолчанию 128 МиБ) 10. Буферный кеш — причина, по которой СУБД не может просто записывать каждое изменение сразу на диск и нуждается в журнале; связь кеша и журнала разбирается в теме 13.
Транзакции и журнал: обещание долговечности
Компоненты, обеспечивающие транзакции, — самые сложные в СУБД, и им посвящены темы 12 и 13. Здесь достаточно сформулировать, что они обещают. Транзакция начинается командой BEGIN и завершается COMMIT (зафиксировать) или ROLLBACK (отменить); выполненный выше эксперимент с представлением был отменён именно ROLLBACK, и в базе не осталось ни представления, ни переименованного столбца. Если сервер аварийно остановится после COMMIT, изменения сохранятся; если до — не останется ни одного из них. Если две транзакции работают с одними данными одновременно, каждая видит согласованное состояние базы. Все эти гарантии СУБД даёт любой программе без единой строчки кода с её стороны — в этом и состоит смысл выделения управления данными в отдельную систему.
Архитектура PostgreSQL
Клиент-серверная модель и процессы сервера
PostgreSQL построен по клиент-серверной архитектуре (англ. client-server architecture): сервер — отдельная программа, управляющая файлами базы, а клиенты (psql, приложение на Python с драйвером psycopg, графическая среда pgAdmin) подключаются к нему по сети или через локальный сокет и обмениваются сообщениями по протоколу PostgreSQL 10. Клиент никогда не читает файлы базы сам; все данные проходят через сервер, и это позволяет серверу контролировать целостность, права и параллельный доступ.
Сервер PostgreSQL использует модель «процесс на соединение» (англ. process-per-connection). Главный процесс, исторически называемый postmaster, при запуске выделяет общую память (буферный кеш, таблицы блокировок, буферы журнала), запускает фоновые процессы и ждёт подключений. Для каждого нового клиента он порождает отдельный обслуживающий процесс (англ. backend), который аутентифицирует клиента и затем выполняет все его запросы 109. Обслуживающие процессы взаимодействуют друг с другом только через общую память. Схема на рисунке ниже показывает эту архитектуру.
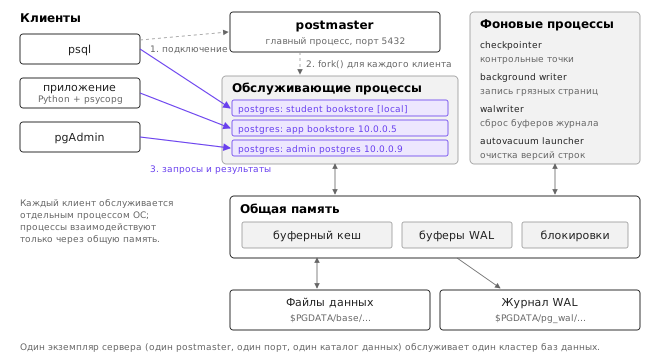
Процессы сервера видны средствами операционной системы. Пока один клиент выполняет долгий запрос, команда ps показывает потомков главного процесса:
ps -o pid,ppid,cmd --ppid $(head -1 $PGDATA/postmaster.pid)
  PID  PPID CMD
 5404  5264 postgres: checkpointer
 5405  5264 postgres: background writer
 5601  5264 postgres: walwriter
 5602  5264 postgres: autovacuum launcher
 5603  5264 postgres: logical replication launcher
16801  5264 postgres: postgres bookstore [local] SELECT
Первая строка файла postmaster.pid в каталоге данных содержит номер главного процесса (здесь 5264). Фоновые процессы выполняют служебную работу: checkpointer выполняет контрольные точки, background writer заблаговременно записывает «грязные» страницы буферного кеша на диск, walwriter сбрасывает буферы журнала, autovacuum launcher запускает очистку старых версий строк (тема 12), logical replication launcher обслуживает логическую репликацию (тема 13). Последняя строка — обслуживающий процесс клиента: пользователь postgres, база bookstore, подключение через локальный сокет ([local]), выполняется SELECT. В Ubuntu заголовки процессов дополнительно содержат имя кластера, например postgres: 16/main: checkpointer.
Ту же картину изнутри показывает системное представление pg_stat_activity:
SELECT pid, backend_type, datname, usename, state, left(query, 30) AS query
FROM pg_stat_activity ORDER BY pid;
  pid  |         backend_type         |  datname  | usename  | state  |             query
-------+------------------------------+-----------+----------+--------+--------------------------------
  5404 | checkpointer                 |           |          |        |
  5405 | background writer            |           |          |        |
  5601 | walwriter                    |           |          |        |
  5602 | autovacuum launcher          |           |          |        |
  5603 | logical replication launcher |           | postgres |        |
 16801 | client backend               | bookstore | postgres | active | select pg_sleep(8)
 16805 | client backend               | bookstore | postgres | active | SELECT pid, backend_type, datn
(7 rows)
Видны оба клиента: один выполняет pg_sleep(8), другой — сам этот запрос (его номер процесса возвращает функция pg_backend_pid()). Номера процессов у читателя будут другими. Модель «процесс на соединение» проста и надёжна — ошибка в одном обслуживающем процессе не портит память другого, — но каждое соединение стоит несколько мегабайт памяти и время на порождение процесса. Поэтому приложения с тысячами клиентов используют пулы соединений (тема 15). Другие СУБД используют потоки вместо процессов (MySQL, Microsoft SQL Server) — это различие реализации, а не модели.
Кластер, базы данных, схемы и роли
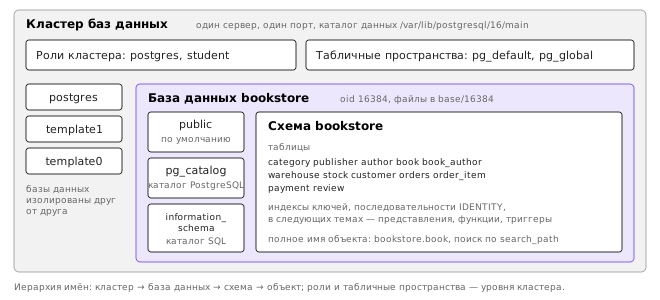
Один экземпляр сервера PostgreSQL управляет кластером баз данных (англ. database cluster) — набором баз, хранящихся в одном каталоге данных и обслуживаемых одним главным процессом на одном сетевом порту (по умолчанию 5432) 10. Слово «кластер» здесь не означает группу серверов; это терминология PostgreSQL. Каталог данных можно узнать командой SHOW data_directory; в Ubuntu это /var/lib/postgresql/16/main, а конфигурационные файлы вынесены в /etc/postgresql/16/main/. Внутри каталога данных — подкаталог base с файлами баз, global с общими для кластера таблицами, pg_wal с журналом и др. Устройство файлов — тема 9.
Иерархию объектов кластера показывает рисунок ниже. Кластер содержит несколько баз данных (англ. databases). Сразу после инициализации их три: postgres (база по умолчанию для подключения служебных программ) и шаблоны template0 и template1, копированием которых создаются новые базы. Базы изолированы друг от друга: запрос, выполняемый в одной базе, не может обратиться к таблицам другой.
SELECT oid, datname, pg_size_pretty(pg_database_size(oid)) AS size
FROM pg_database ORDER BY oid;
  oid  |  datname  |  size
-------+-----------+---------
     1 | template1 | 7551 kB
     4 | template0 | 7329 kB
     5 | postgres  | 7487 kB
 16384 | bookstore | 19 MB
(4 rows)
Каждый объект каталога PostgreSQL имеет внутренний идентификатор oid; подкаталог base/16384 каталога данных содержит файлы базы bookstore. Учебная база при масштабе 1 занимает около 19 МиБ.
База данных делится на схемы (англ. schemas) — пространства имён для таблиц, представлений, функций и других объектов. Схемы позволяют держать в одной базе объекты разных подсистем или пользователей с одинаковыми именами и разграничивать к ним права. В каждой новой базе есть схема public; учебная база создаёт схему bookstore, и все её таблицы называются полностью bookstore.book, bookstore.orders и т. д. Чтобы не писать имя схемы каждый раз, задают путь поиска (англ. search path) — параметр search_path, список схем, в которых ищутся неквалифицированные имена:
SHOW search_path;
SET search_path = bookstore;
   search_path
-----------------
 "$user", public
(1 row)
По умолчанию поиск ведётся в схеме с именем текущего пользователя (если она есть) и в public. Все запросы темы выполнены после SET search_path = bookstore. Слово «схема» оказывается многозначным: в общем смысле это описание структуры базы (концептуальная схема), а в PostgreSQL и стандарте SQL — ещё и именованное пространство имён внутри базы. Из контекста почти всегда ясно, о чём идёт речь. Схемы и search_path подробнее рассматриваются в теме 9, а их роль в безопасности — в теме 15.
Над всем кластером стоят роли (англ. roles) — учётные записи, от имени которых выполняются подключения и которым выдаются права. Роли общие для всего кластера, а не для отдельной базы. Роль с атрибутом LOGIN может подключаться (её называют пользователем), роль-суперпользователь (SUPERUSER) обходит все проверки прав. При установке создаётся суперпользователь postgres; в лабораторной работе 1 создаётся собственная роль-суперпользователь, что удобно в учебной среде, но недопустимо в промышленной. Роли, привилегии и аутентификация — тема 15.
Системный каталог
Описание всех объектов кластера хранится в системном каталоге — наборе таблиц схемы pg_catalog: pg_class (таблицы, индексы, представления, последовательности), pg_attribute (столбцы), pg_constraint (ограничения), pg_namespace (схемы), pg_database, pg_roles и др. 10. Помимо собственного каталога PostgreSQL предоставляет стандартную схему information_schema — набор представлений, определённых стандартом SQL и одинаковых (в идеале) во всех СУБД. Например, сколько в учебной базе таблиц, столбцов и ограничений каждого типа:
SELECT count(*) AS tables FROM information_schema.tables WHERE table_schema = 'bookstore';
SELECT count(*) AS columns FROM information_schema.columns WHERE table_schema = 'bookstore';
SELECT constraint_type, count(*)
FROM information_schema.table_constraints
WHERE table_schema = 'bookstore'
GROUP BY constraint_type ORDER BY constraint_type;
 tables
--------
     12
(1 row)

 columns
---------
      53
(1 row)

 constraint_type | count
-----------------+-------
 CHECK           |    53
 FOREIGN KEY     |    14
 PRIMARY KEY     |    12
 UNIQUE          |     6
(4 rows)
Число ограничений CHECK (53) кажется неожиданно большим: в schema.sql их записано гораздо меньше. Объяснение — в различии двух каталогов. По стандарту ограничение NOT NULL — частный случай ограничения CHECK (столбец IS NOT NULL), и information_schema показывает каждое из 41 таких ограничений учебной базы как отдельный CHECK со служебным именем; в собственном каталоге PostgreSQL 16 признак NOT NULL хранится как свойство столбца (pg_attribute.attnotnull), а pg_constraint содержит только 12 «настоящих» проверок. Этот пример показывает, что стандартный каталог удобен для переносимых запросов, а собственный — точнее отражает устройство конкретной СУБД. К каталогу курс обращается в каждой теме; в лабораторной работе 1 с ним предстоит поработать самостоятельно.
Встраиваемые СУБД: SQLite
Клиент-серверная архитектура — не единственная возможная. Встраиваемая СУБД (англ. embedded database) — библиотека, которая работает внутри процесса прикладной программы и хранит базу в обычном файле; отдельного сервера, сетевого протокола и учётных записей нет. Самый распространённый пример — SQLite, созданная Ричардом Хиппом в 2000 году: она встроена в Android и iOS, браузеры, многие настольные программы и входит в стандартную библиотеку Python 14.
import sqlite3

con = sqlite3.connect("shop.db")          # база — один файл; сервера нет
con.execute("CREATE TABLE IF NOT EXISTS book (id INTEGER PRIMARY KEY, title TEXT NOT NULL, price NUMERIC)")
con.execute("INSERT INTO book (title, price) VALUES (?, ?)", ("Пикник на обочине", 520))
con.commit()
print(con.execute("SELECT id, title, price FROM book").fetchall())
con.close()
[(1, 'Пикник на обочине', 520)]
После выполнения в текущем каталоге появляется файл shop.db размером 8192 байта — вся база целиком. SQLite поддерживает SQL, транзакции, ограничения целостности, но рассчитана на одного пишущего клиента в каждый момент времени и не управляет правами доступа: кто может открыть файл, тот может всё. Разработчики SQLite формулируют её назначение так: она конкурирует не с клиент-серверными СУБД, а с функцией fopen() — то есть с хранением данных в собственных файлах приложения 14. Сравнение двух архитектур сведено в таблицу.
| Свойство | PostgreSQL (клиент-сервер) | SQLite (встраиваемая) |
|---|---|---|
| Где работает | отдельные процессы сервера | внутри процесса приложения |
| Хранение | каталог данных кластера, много файлов | один файл базы |
| Доступ по сети | да, протокол PostgreSQL | нет (только через файловую систему) |
| Параллельная запись | много пишущих транзакций одновременно | один пишущий в каждый момент |
| Права доступа | роли, привилегии, политики строк | права файловой системы |
| Администрирование | установка, настройка, резервное копирование | практически не требуется |
| Типичное применение | многопользовательские системы, веб-приложения | мобильные и настольные приложения, локальные кеши, тесты |
Люди и системы: роли специалистов и рынок СУБД
Кто работает с базой данных
С базой данных работают специалисты разных ролей, и курс затрагивает задачи каждой из них 2. Администратор базы данных (англ. database administrator, DBA) отвечает за работу СУБД как системы: установку и обновление, настройку параметров, резервное копирование и восстановление, мониторинг производительности, управление ролями и правами, репликацию. Его инструменты рассматриваются в темах 10–13 и 15. Разработчик (англ. developer) проектирует схему базы для своей задачи, пишет запросы и серверный код, встраивает работу с базой в приложение; ему адресованы прежде всего разделы I, II и IV. Аналитик данных (англ. data analyst) извлекает из базы ответы на вопросы бизнеса — запросами с группировкой и оконными функциями (тема 5), часто над отдельной аналитической копией данных (тема 16). Конечные пользователи работают с базой через приложения, не зная SQL. Границы ролей условны: в небольшой команде разработчик сам администрирует базу.
Обзор рынка СУБД
Рынок СУБД разнообразен, но в сегменте реляционных систем его основу много лет составляют несколько продуктов 212.
Oracle Database — коммерческая СУБД компании Oracle, исторически лидер в крупных корпоративных системах; отличается богатством функций для высокой доступности и масштабирования. Microsoft SQL Server — коммерческая СУБД Microsoft, тесно интегрированная с её платформой; с 2017 года работает и под Linux. IBM Db2 — наследница System R, распространена в банковских системах на мейнфреймах. MySQL — свободная СУБД, появившаяся в 1995 году и ставшая основой веб-приложений 2000-х годов (связка LAMP); сейчас принадлежит Oracle, а её ответвление MariaDB развивается независимо. SQLite — встраиваемая СУБД, рассмотренная выше; по числу установленных копий она, вероятно, самая распространённая СУБД в мире 14.
PostgreSQL — свободная объектно-реляционная СУБД с открытым исходным кодом под либеральной лицензией PostgreSQL License, развиваемая международным сообществом 9. Она известна строгим следованием стандарту SQL, надёжностью, развитой системой типов (массивы, диапазоны, jsonb, геометрия) и расширяемостью: собственные типы, функции, методы доступа и целые подсистемы подключаются как расширения (PostGIS для геоданных, TimescaleDB для временных рядов, pgvector для векторного поиска). Основные версии выходят ежегодно и поддерживаются пять лет; курс использует версию 16, вышедшую в 2023 году и входящую в Ubuntu 24.04.
Либеральная лицензия позволяет создавать на основе PostgreSQL собственные продукты, и многие СУБД, включая облачные сервисы крупных провайдеров, построены на его коде. В России на основе PostgreSQL развивается ряд отечественных СУБД, наиболее известная из которых — Postgres Pro компании Postgres Professional (основана в 2015 году); её редакции добавляют к PostgreSQL возможности для крупных систем и включены в реестр российского программного обеспечения. Существуют и другие отечественные дистрибутивы и продукты на основе PostgreSQL. Знания, полученные в курсе на «чистом» PostgreSQL, переносятся на них непосредственно, а знание реляционной модели и SQL — на любую реляционную СУБД.
Почему курс построен на PostgreSQL
Для учебного курса PostgreSQL удобен по нескольким причинам. Он свободен, устанавливается одной командой и близок к стандарту. Его внутреннее устройство хорошо документировано и доступно для наблюдения: планы выполнения, статистика, версии строк, содержимое страниц, журнал — всё это можно увидеть штатными средствами и расширениями, что позволяет не просто прочитать о механизме, а наблюдать его работу. Наконец, на русском языке есть подробная литература о его устройстве, в первую очередь книга Е. В. Рогова «PostgreSQL 16 изнутри» 10. Принципы же — реляционная модель, нормализация, B-деревья, оптимизация на основе стоимости, протоколы изоляции и восстановления — общие для всех реляционных СУБД.
Итоги темы
База данных — совместно используемый набор логически связанных данных вместе с их описанием, а СУБД — программная система, которая берёт на себя управление этими данными: хранит схему в каталоге, проверяет ограничения целостности при каждом изменении, изолирует параллельные транзакции, гарантирует сохранность зафиксированных изменений после сбоя, разграничивает права и выполняет декларативные запросы. Всё это прикладной программе пришлось бы делать самой, если бы данные хранились в файлах, — и делать заведомо хуже.
История баз данных — это история отделения программ от устройства данных. Навигационные модели IMS и CODASYL требовали от программиста знать пути доступа; реляционная модель Кодда (1970) заменила указатели значениями, а навигацию — декларативными запросами. Проекты System R и Ingres доказали практичность идеи, SQL стал стандартом (от SQL-86 до SQL:2023), а последующие волны — объектно-реляционные расширения, NoSQL, NewSQL — дополнили, но не отменили реляционную модель.
Архитектура ANSI/SPARC разделяет внешний, концептуальный и внутренний уровни описания данных; отображения между ними обеспечивают физическую независимость (индекс ускорил запрос, не изменив его текст) и логическую независимость (представление скрыло переименование столбца). Платой за независимость служит необходимость оптимизатора, который сам строит план выполнения. Внутри СУБД запрос проходит разбор, переписывание, оптимизацию и выполнение; исполнитель работает со страницами через менеджер буферов, а менеджер транзакций и журнал обеспечивают изоляцию и долговечность.
PostgreSQL — клиент-серверная СУБД с моделью «процесс на соединение»: главный процесс порождает обслуживающий процесс для каждого клиента и фоновые процессы для служебной работы; все они разделяют общую память. Кластер содержит базы данных, база — схемы, схема — таблицы и другие объекты; роли общие для кластера; описание всего этого хранится в системном каталоге, доступном обычным запросам. Встраиваемые СУБД вроде SQLite занимают другую нишу — замену собственным файлам приложения.
Следующая тема переходит от общей картины к фундаменту — реляционной модели данных: что такое отношение и чем оно отличается от таблицы SQL, какие бывают ключи, как ограничения целостности защищают данные «Книжного узла» и как неопределённое значение NULL порождает трёхзначную логику.
Литература
- Codd E. F. A Relational Model of Data for Large Shared Data Banks. — Communications of the ACM, 1970, Т. 13, № 6, С. 377–387, DOI: 10.1145/362384.362685.
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Дейт К. Дж. Введение в системы баз данных. 8-е изд. — М.: Вильямс, 2005. (Date C. J. An Introduction to Database Systems. 8th ed. — Addison-Wesley, 2004.)
- Hellerstein J. M., Stonebraker M., Hamilton J. Architecture of a Database System. — Foundations and Trends in Databases, 2007, Т. 1, № 2, С. 141–259, DOI: 10.1561/1900000002.
- Astrahan M. M. et al. System R: Relational Approach to Database Management. — ACM Transactions on Database Systems, 1976, Т. 1, № 2, С. 97–137, DOI: 10.1145/320455.320457.
- Stonebraker M., Wong E., Kreps P., Held G. The Design and Implementation of INGRES. — ACM Transactions on Database Systems, 1976, Т. 1, № 3, С. 189–222, DOI: 10.1145/320473.320476.
- Chamberlin D. D., Boyce R. F. SEQUEL: A Structured English Query Language. — Proceedings of the 1974 ACM SIGFIDET Workshop on Data Description, Access and Control, 1974, С. 249–264, DOI: 10.1145/800296.811515.
- Tsichritzis D., Klug A. (eds.) The ANSI/X3/SPARC DBMS Framework: Report of the Study Group on Database Management Systems. — Information Systems, 1978, Т. 3, № 3, С. 173–191.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Preface, 2. A Brief History of PostgreSQL; 1.2. Architectural Fundamentals. — 2023. https://www.postgresql.org/docs/16/history.html
- Рогов Е. В. PostgreSQL 16 изнутри. — М.: ДМК Пресс, 2024. https://postgrespro.ru/education/books/internals
- Bachman C. W. The Programmer as Navigator. — Communications of the ACM, 1973, Т. 16, № 11, С. 653–658, DOI: 10.1145/355611.362534.
- Клеппман М. Высоконагруженные приложения. Программирование, масштабирование, поддержка. — СПб.: Питер, 2018. (Kleppmann M. Designing Data-Intensive Applications. — O'Reilly, 2017.)
- ISO/IEC 9075-1:2023. Information technology — Database languages SQL — Part 1: Framework (SQL/Framework). — ISO, 2023.
- SQLite Documentation. Appropriate Uses For SQLite; About SQLite. — https://www.sqlite.org/whentouse.html