
Реляционная алгебра и основы запросов SQL
В теме 2 отношение было определено как множество кортежей над схемой, а таблица SQL — как его практическое воплощение со своими отступлениями: строки могут повторяться, столбцы упорядочены, значение может отсутствовать (NULL). Там же были введены ключи и ограничения целостности, которые не дают занести в базу заведомо неверные данные. Однако база данных создаётся не ради хранения, а ради ответов на вопросы: какие книги дороже тысячи рублей, какие покупатели живут в городах без склада, какие книги написаны обоими Стругацкими. Остаётся открытым вопрос, на каком языке такие вопросы задавать и как СУБД понимает, что именно у неё спрашивают.
Ответ, предложенный Коддом одновременно с самой реляционной моделью, — реляционная алгебра: небольшой набор операций, каждая из которых получает одно или два отношения и возвращает новое отношение 1. Алгебра важна по двум причинам. Во-первых, она задаёт точный смысл запроса: любое предложение SQL, о котором пойдёт речь в этой и следующих темах, можно перевести в выражение алгебры, и тогда спор «что вернёт запрос» решается вычислением. Во-вторых, выражения алгебры можно преобразовывать, сохраняя результат, и именно этим занимается оптимизатор СУБД, выбирая из множества эквивалентных выражений самое дешёвое.
Изложение построено так. Первые три раздела посвящены алгебре: основным операциям, соединениям и делению, эквивалентным преобразованиям и связи с реляционным исчислением. Все операции показаны на маленьких отношениях из первых строк учебной базы «Книжный узел», а результаты проверены запросами SQL. Вторая половина темы переходит к языку SQL: логическому порядку выполнения запроса SELECT и его следствиям, условиям и выражениям, сортировке, ограничению выборки и операциям над множествами. Рассматриваются запросы к одной таблице; соединения в SQL изучаются в теме 4, группировка и агрегатные функции — в теме 5.
Реляционная алгебра: основные операции
Операнды, операции и замкнутость
Реляционная алгебра (англ. relational algebra) — совокупность операций над отношениями, результат каждой из которых снова является отношением 135. Последнее свойство называется замкнутостью (англ. closure) и составляет главное достоинство алгебры: раз результат операции — отношение, к нему можно применить следующую операцию, и из простых операций строятся выражения любой сложности, как в школьной алгебре из сложения и умножения строятся многочлены. Выражение реляционной алгебры (англ. relational algebra expression) — это либо имя отношения, либо операция, применённая к выражениям.
Операции делятся на унарные, с одним операндом (выборка, проекция, переименование), и бинарные, с двумя (объединение, разность, пересечение, декартово произведение, соединения, деление). Кодд в исходной статье и последующих работах выделил набор, через который выражаются все остальные: выборка, проекция, переименование, объединение, разность и декартово произведение 23. Пересечение, соединения и деление — производные операции, введённые ради удобства и потому, что для них существуют эффективные алгоритмы выполнения.
Важно помнить, что алгебра работает с отношениями в строгом смысле темы 2: отношение — множество, поэтому в нём нет повторяющихся кортежей и нет порядка ни строк, ни атрибутов; атрибуты различаются по именам. Каждая операция, результат которой мог бы содержать одинаковые кортежи (проекция, объединение), по определению их устраняет. Отсутствующих значений в классической алгебре тоже нет; Дейт последовательно отстаивает именно такую, «чистую» модель и критикует SQL за отступления от неё 5. Как SQL отступает от этих правил и к каким последствиям это приводит, обсуждается в разделе о запросе SELECT.
В печатных учебниках условие и список атрибутов операции записываются нижним индексом. В тексте темы принята линейная запись, понятная без набора формул: параметр операции пишется в квадратных скобках сразу после её знака, например σ[цена > 1000](Книга). Выражения алгебры даются моноширинным шрифтом.
Учебные отношения
Для ручных вычислений возьмём из учебной базы шесть книг и их авторов, оставив только нужные атрибуты. Отношения Книга, Автор и Авторство показаны в таблице ниже; их можно создать в схеме ra скриптом ra.sql из окружения лабораторной работы 3 и проверять любое выражение запросом. В SQL имена этих таблиц пишутся строчными буквами: ra.книга, ra.автор, ra.авторство.
| Отношение | Кортежи |
|---|---|
| Книга(книга, название, рубрика, цена) | (1, Война и мир, 5, 1290), (2, Преступление и наказание, 5, 450), (4, Пикник на обочине, 6, 520), (5, Трудно быть богом, 6, 540), (7, Искусство программирования, 12, 3990), (10, Основание, 23, 610) |
| Автор(автор, имя, страна) | (1, Лев Толстой, Россия), (2, Фёдор Достоевский, Россия), (4, Аркадий Стругацкий, СССР), (5, Борис Стругацкий, СССР), (7, Дональд Кнут, США), (10, Айзек Азимов, США) |
| Авторство(книга, автор) | (1, 1), (2, 2), (4, 4), (4, 5), (5, 4), (5, 5), (7, 7), (10, 10) |
| Класс(класс, от, до) | (дешёвая, 0, 500), (средняя, 500, 1500), (дорогая, 1500, 100000) |
Отношение Авторство реализует связь «многие ко многим» между книгами и авторами: у «Пикника на обочине» два автора, и каждый из Стругацких написал две книги. Отношение Класс понадобится для примера соединения по неравенству: нижняя граница класса включается, верхняя нет.
Выборка, проекция и переименование
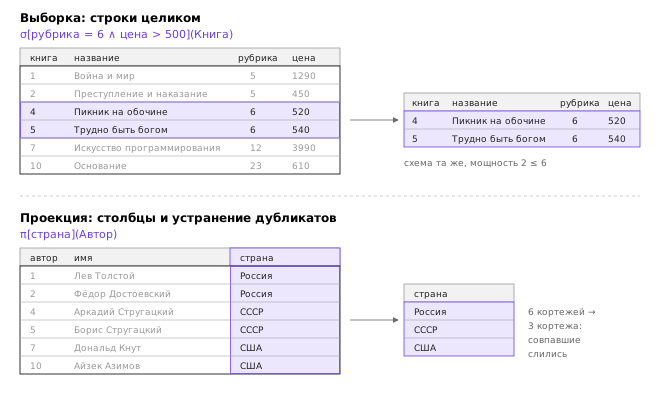
Выборка (англ. selection, также restriction) σ[F](R) возвращает те кортежи отношения R, для которых истинно условие F. Условие строится из сравнений атрибутов с константами или друг с другом операторами =, ≠, <, ≤, >, ≥ и связок ∧, ∨, ¬. Схема результата совпадает со схемой R, а мощность не больше мощности R. Выборка «вырезает» строки таблицы:
σ[рубрика = 6 ∧ цена > 500](Книга)
  = { (4, Пикник на обочине, 6, 520), (5, Трудно быть богом, 6, 540) }
Проекция (англ. projection) π[A1, …, Ak](R) оставляет в каждом кортеже только перечисленные атрибуты и удаляет получившиеся дубликаты. Проекция «вырезает» столбцы, и именно устранение дубликатов отличает её от простого вычёркивания столбцов таблицы. Из шести кортежей Автор проекция на страну даёт три:
π[страна](Автор) = { (Россия), (СССР), (США) }
Рисунок ниже показывает обе операции на одной и той же таблице: выборка оставляет часть строк целиком, проекция — часть столбцов всех строк, после чего совпавшие строки сливаются.
Переименование (англ. rename) ρ[S(B1, …, Bn)](R) возвращает то же отношение под именем S с атрибутами B1, …, Bn. Операция ничего не вычисляет, но без неё нельзя обойтись в двух случаях: когда отношение участвует в выражении дважды (например, чтобы найти пары соавторов, Авторство соединяется само с собой, и атрибуты двух копий надо различить) и когда атрибуты нужно согласовать по именам для объединения или естественного соединения. В SQL переименованию соответствуют псевдонимы таблиц и столбцов (FROM book AS b, price * 1.2 AS new_price).
Операции комбинируются. Названия и цены книг рубрики 6 записываются выражением π[название, цена](σ[рубрика = 6](Книга)), а в SQL — запросом, в котором проекции соответствует список SELECT, а выборке — предложение WHERE:
SELECT DISTINCT название, цена
FROM ra.книга
WHERE рубрика = 6;
     название      |  цена
-------------------+--------
 Пикник на обочине | 520.00
 Трудно быть богом | 540.00
(2 rows)
Слово DISTINCT здесь не случайно: без него SQL не устраняет дубликаты, и запрос соответствует проекции алгебры только тогда, когда дубликатов заведомо нет.
Объединение, разность и пересечение
Теоретико-множественные операции применимы только к совместимым отношениям (англ. union-compatible): с одинаковым числом атрибутов и одинаковыми доменами соответствующих атрибутов 3. Если имена атрибутов различаются, их предварительно согласуют переименованием. Для совместимых R и S:
- объединение (англ. union)
R ∪ Sсодержит кортежи, входящие хотя бы в одно из отношений; - разность (англ. difference)
R − S— кортежи R, не входящие в S; - пересечение (англ. intersection)
R ∩ S— кортежи, входящие в оба отношения.
Пересечение не является базовой операцией: R ∩ S = R − (R − S). Объединение и пересечение коммутативны и ассоциативны, разность — нет. Типичное применение разности — вопросы с отрицанием «которые не…»: номера книг, у которых нет ни одного автора из США, — это все номера книг минус номера книг американских авторов:
π[книга](Книга) − π[книга](Авторство ⋈ σ[страна = 'США'](Автор))
  = {1, 2, 4, 5, 7, 10} − {7, 10} = {1, 2, 4, 5}
Знак ⋈ обозначает естественное соединение, о котором речь пойдёт в следующем разделе. Заметим характерную ошибку: выражение π[книга](σ[страна ≠ 'США'](Авторство ⋈ Автор)) отвечает на другой вопрос — «у каких книг есть хотя бы один автор не из США» — и для книги, написанной совместно американцем и россиянином, дало бы противоположный ответ. Отрицание «ни одного» выражается разностью, а не условием «не равно» внутри выборки.
На реальных данных учебной базы теоретико-множественные операции хорошо видны на городах. Города, где есть покупатели, но нет склада, дают разность проекций двух таблиц; в SQL ей соответствует оператор EXCEPT, подробно рассмотренный в конце темы:
SELECT city FROM customer
EXCEPT
SELECT city FROM warehouse
ORDER BY city;
     city
--------------
 Екатеринбург
 Самара
 Томск

(4 rows)
Четвёртая, пустая на вид строка — это NULL: у 471 покупателя город не указан. В классической алгебре такого значения нет, а SQL при выполнении EXCEPT считает два NULL «одинаковыми» и потому оставляет NULL в результате. К этой особенности вернёмся в разделе о логическом порядке выполнения.
Соединения и деление
Декартово произведение и тета-соединение
Декартово произведение (англ. Cartesian product, cross product) R × S состоит из всех кортежей, полученных приписыванием к каждому кортежу R каждого кортежа S. Схема результата — объединение схем (одноимённые атрибуты предварительно переименовываются), мощность — произведение мощностей: |Книга × Класс| = 6 · 3 = 18. Само по себе произведение редко бывает ответом на вопрос: в нём каждая книга сочетается с каждым ценовым классом, и большинство сочетаний бессмысленны. Но за ним почти всегда следует выборка, отбирающая осмысленные сочетания.
Пара «произведение, затем выборка» настолько частая, что для неё введена отдельная операция — тета-соединение (англ. theta join): R ⋈[θ] S = σ[θ](R × S), где θ — условие, связывающее атрибуты обоих операндов. Название происходит от греческой буквы, которой традиционно обозначают произвольный оператор сравнения. Если условие состоит только из равенств, соединение называют эквисоединением (англ. equijoin). Отнесём каждую книгу к ценовому классу — это соединение по неравенству:
Книга ⋈[от ≤ цена ∧ цена < до] Класс
Из 18 кортежей произведения условию удовлетворяют шесть: каждая книга попадает ровно в один класс, потому что интервалы классов не пересекаются и покрывают все цены. Проверка в SQL на малых отношениях (синтаксис соединения подробно разбирается в теме 4):
SELECT к.книга, к.название, к.цена, л.класс
FROM ra.книга AS к
JOIN ra.класс AS л ON л.от <= к.цена AND к.цена < л.до
ORDER BY к.книга;
 книга |          название          |  цена   |  класс
-------+----------------------------+---------+---------
     1 | Война и мир                | 1290.00 | средняя
     2 | Преступление и наказание   |  450.00 | дешёвая
     4 | Пикник на обочине          |  520.00 | средняя
     5 | Трудно быть богом          |  540.00 | средняя
     7 | Искусство программирования | 3990.00 | дорогая
    10 | Основание                  |  610.00 | средняя
(6 rows)
Определение через произведение задаёт смысл операции, но не способ её выполнения: СУБД не строит произведение, а применяет специальные алгоритмы соединения — вложенные циклы, хеширование, слияние, — которые изучаются в теме 11.
Естественное соединение
Естественное соединение (англ. natural join) R ⋈ S — эквисоединение по всем одноимённым атрибутам, после которого из каждой пары одинаковых атрибутов оставлен один. Учебные отношения специально построены так, что общие атрибуты имеют общие имена: у Книга и Авторство общий атрибут «книга», у Авторство и Автор — «автор». Поэтому выражение Книга ⋈ Авторство ⋈ Автор соединяет книги с авторами «по смыслу» и даёт восемь кортежей — по одному на каждый кортеж Авторства, со всеми атрибутами книги и автора. Естественное соединение ассоциативно, и скобки в такой цепочке можно не ставить.
Удобство естественного соединения оборачивается хрупкостью: условие соединения не записано явно, а выводится из имён. Если бы у отношений Книга и Автор оказался общий атрибут с одинаковым именем, но разным смыслом (скажем, «страна» как страна издания и страна автора), соединение молча добавило бы бессмысленное условие равенства и потеряло бы кортежи. Если общих атрибутов нет вовсе, естественное соединение вырождается в декартово произведение. По этой причине в SQL естественным соединением пользуются редко — подробно в теме 4.
Переименование позволяет соединить отношение с самим собой. Найдём пары соавторов, то есть авторов, написавших общую книгу. Переименуем копию Авторства, чтобы второй автор назывался иначе, соединим по книге и оставим пары, где первый номер меньше второго, — иначе каждая пара войдёт дважды, а каждый автор окажется соавтором самого себя:
π[автор, соавтор](σ[автор < соавтор](Авторство ⋈ ρ[А2(книга, соавтор)](Авторство)))
Соединение даёт двенадцать кортежей (книга 4 и книга 5 — по четыре сочетания двух авторов, остальные шесть книг — по одному), выборка оставляет два: (4, 4, 5) и (5, 4, 5). Проекция сливает их в единственный кортеж (4, 5): Аркадий и Борис Стругацкие. Здесь хорошо видно, что устранение дубликатов в проекции — не формальность, а часть смысла ответа.
Полусоединение и антисоединение
Часто соединение нужно не для того, чтобы получить атрибуты второго отношения, а лишь чтобы проверить, есть ли для кортежа пара. Для этого служат две производные операции 4:
- левое полусоединение (англ. semijoin)
R ⋉ S— кортежи R, для которых в S найдётся хотя бы один кортеж с совпадающими общими атрибутами; по определениюR ⋉ S = π[атрибуты R](R ⋈ S); - антисоединение (англ. antijoin, anti-semijoin)
R ▷ S— кортежи R, для которых такого кортежа нет:R ▷ S = R − (R ⋉ S).
Схема результата обеих операций совпадает со схемой R, а мощность не превосходит мощности R: полусоединение не размножает кортежи, даже если пара находится многократно. Книги американских авторов — полусоединение, книги, у которых нет авторов из СССР, — антисоединение:
Книга ⋉ (Авторство ⋈ σ[страна = 'США'](Автор))   = книги 7, 10
Книга ▷ (Авторство ⋈ σ[страна = 'СССР'](Автор))  = книги 1, 2, 7, 10
В SQL полусоединению и антисоединению соответствуют подзапросы с EXISTS и NOT EXISTS. Хотя подзапросы — предмет темы 4, полезно уже сейчас увидеть, как близко SQL следует алгебре:
SELECT к.книга, к.название
FROM ra.книга AS к
WHERE NOT EXISTS (SELECT 1
                  FROM ra.авторство AS w
                  JOIN ra.автор AS а ON а.автор = w.автор
                  WHERE w.книга = к.книга AND а.страна = 'СССР')
ORDER BY к.книга;
 книга |          название
-------+----------------------------
     1 | Война и мир
     2 | Преступление и наказание
     7 | Искусство программирования
    10 | Основание
(4 rows)
Полусоединение и антисоединение важны и для реализации: планировщик PostgreSQL распознаёт в запросах эти операции и выполняет их специальными узлами плана Semi Join и Anti Join (тема 11).
Деление
Деление (англ. division) отвечает на вопросы с квантором всеобщности: «книги, написанные всеми Стругацкими», «покупатели, купившие все книги серии», «книги, которые есть на всех складах». Пусть R имеет атрибуты X ∪ Y, а S — атрибуты Y. Частное R ÷ S — это множество тех значений x атрибутов X, для которых в R присутствуют сочетания x со всеми кортежами S 13:
R ÷ S = { x | для каждого y ∈ S кортеж (x, y) ∈ R }
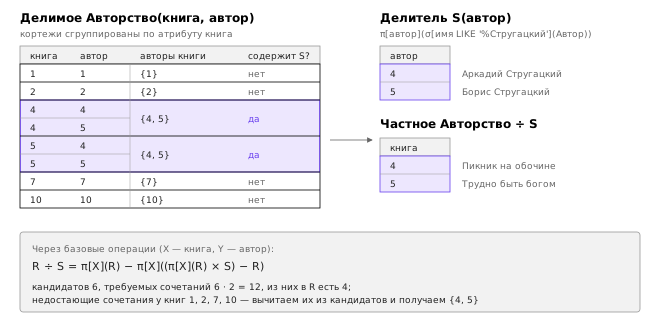
Название операции оправдано тождеством (R × S) ÷ S = R для непустого S: деление обращает декартово произведение, как деление чисел обращает умножение. Вычислим вручную, какие книги написаны обоими Стругацкими. Делимое — Авторство(книга, автор), делитель — номера авторов-Стругацких:
S = π[автор](σ[имя LIKE '%Стругацкий'](Автор)) = { (4), (5) }
Авторство ÷ S
Сгруппируем кортежи делимого по книге и для каждой книги выпишем множество её авторов: книга 1 — {1}, книга 2 — {2}, книга 4 — {4, 5}, книга 5 — {4, 5}, книга 7 — {7}, книга 10 — {10}. Книга входит в частное, если её множество авторов содержит весь делитель {4, 5}. Ответ — книги 4 и 5. Рисунок показывает эту проверку.
Деление не базовая операция; через базовые она выражается так 3:
R ÷ S = π[X](R) − π[X]((π[X](R) × S) − R)
Смысл формулы прочитывается справа налево. π[X](R) × S — все сочетания «кандидат, требуемый элемент», которые должны были бы присутствовать, если бы каждый кандидат подходил. Вычитая R, получаем недостающие сочетания. Их проекция на X — кандидаты, которым чего-то не хватает, и, вычитая их из всех кандидатов, получаем ответ. Для нашего примера: кандидатов шесть, требуемых сочетаний 6 · 2 = 12, из них в Авторстве есть четыре, недостающих восемь — у книг 1, 2, 7 и 10; остаются книги 4 и 5.
Две тонкости деления встречаются в задачах постоянно. Первая — пустой делитель: если S пуст, условие «для каждого y ∈ S» истинно для любого x, и частное равно π[X](R). Например, «покупатели, купившие все книги несуществующей серии» — это все покупатели, у которых есть хоть одна покупка; на практике такой ответ часто неожидан, и его стоит оговаривать. Вторая — лишние атрибуты делимого: если в R кроме X и Y есть ещё атрибут (например, количество экземпляров на складе), его надо отбросить проекцией до деления, иначе он попадёт в X и разобьёт группы. В SQL деление записывается двойным NOT EXISTS — «нет такого требуемого элемента, для которого нет пары»; эта форма разбирается в теме 4.
Алгебраические выражения, исчисление и оптимизация
Реляционное исчисление и декларативность SQL
Алгебра процедурна в том смысле, что выражение предписывает последовательность операций: сначала выборка, потом соединение, потом проекция. Кодд предложил и другой, непроцедурный язык — реляционное исчисление (англ. relational calculus), основанное на логике предикатов первого порядка 2. Запрос исчисления кортежей (англ. tuple relational calculus) описывает свойства искомых кортежей, ничего не говоря о том, как их найти:
{ t | t ∈ Книга ∧ t.цена > 1000 }

{ k.книга | k ∈ Книга ∧
            ∀a ∈ Автор ( a.имя LIKE '%Стругацкий' →
                         ∃w ∈ Авторство ( w.книга = k.книга ∧ w.автор = a.автор ) ) }
Первое выражение читается: «все кортежи t из Книга, у которых цена больше 1000». Второе — запрос с делением: «номера книг k, такие что для любого автора a с фамилией Стругацкий существует кортеж Авторства, связывающий k и a». Квантор всеобщности ∀, который в алгебре приходится выражать хитрой формулой с разностями, здесь записывается прямо. Существует и исчисление доменов (англ. domain relational calculus), в котором переменные пробегают значения атрибутов, а не кортежи; на нём основан язык Query-by-Example.
Кодд доказал, что алгебра и исчисление (в его безопасной форме, исключающей бесконечные ответы вроде «все кортежи, не входящие в Книга») равны по выразительной силе: всякий запрос исчисления выражается в алгебре, и наоборот 2. Язык, способный выразить любой запрос реляционной алгебры, называют реляционно полным (англ. relationally complete). SQL реляционно полон и выходит за рамки алгебры: в нём есть агрегирование, сортировка, рекурсия, арифметика.
Синтаксис SQL ближе к исчислению: запрос описывает, что нужно получить (из каких таблиц, при каком условии, какие столбцы), а не как. Это свойство называют декларативностью (англ. declarative language). Задача перевести декларативный запрос в эффективную процедуру ложится на СУБД: запрос разбирается, переводится во внутреннее представление, близкое к дереву операций алгебры, и оптимизатор ищет эквивалентное дерево с наименьшей стоимостью. Так был устроен уже первый оптимизатор System R 6, и так устроены оптимизаторы современных СУБД, включая PostgreSQL (тема 11).
Дерево операций
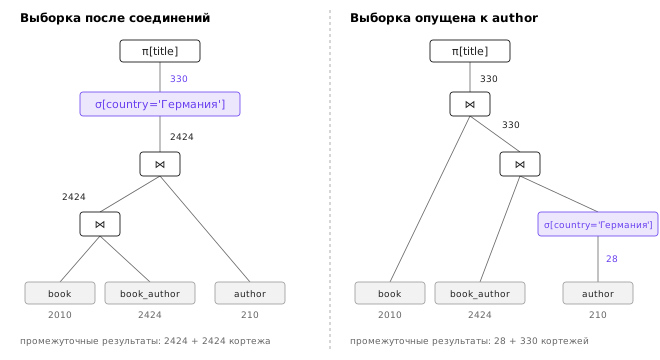
Выражение алгебры удобно изображать деревом операций (англ. expression tree, query tree): листья — исходные отношения, внутренние узлы — операции, корень — последняя операция, дающая ответ. Данные текут снизу вверх: каждый узел получает результаты дочерних узлов и передаёт свой результат родителю. Дерево наглядно показывает, какие промежуточные отношения возникают при вычислении и каков их размер, а размер промежуточных результатов и определяет стоимость запроса.
Возьмём вопрос «названия книг авторов из Германии» над полными таблицами учебной базы. Прямой перевод формулировки даёт выражение
π[title](σ[country = 'Германия'](book ⋈ book_author ⋈ author))
и дерево с выборкой над результатом двух соединений. Это дерево изображено на рисунке ниже слева.
Правила эквивалентности
Два выражения алгебры эквивалентны, если на любых допустимых отношениях дают одинаковый результат. Учебники приводят десятки правил эквивалентности 34; основные из них таковы (R, S — выражения, F, G — условия):
- каскад выборок:
σ[F ∧ G](R) ≡ σ[F](σ[G](R)), и выборки перестановочны:σ[F](σ[G](R)) ≡ σ[G](σ[F](R)); - каскад проекций: если список A содержится в B, то
π[A](π[B](R)) ≡ π[A](R); - коммутативность и ассоциативность соединения и произведения:
R ⋈ S ≡ S ⋈ R,(R ⋈ S) ⋈ T ≡ R ⋈ (S ⋈ T); - проталкивание выборки через соединение: если условие F использует только атрибуты R, то
σ[F](R ⋈ S) ≡ σ[F](R) ⋈ S; - проталкивание выборки через объединение, разность и пересечение:
σ[F](R − S) ≡ σ[F](R) − σ[F](S); - проталкивание проекции: до соединения можно отбросить атрибуты, не нужные ни в результате, ни в условии соединения;
- превращение произведения в соединение:
σ[F](R × S) ≡ R ⋈[F] S.
Правила обоснованы определениями операций. Например, проталкивание выборки через соединение верно потому, что кортеж соединения удовлетворяет условию на атрибуты R тогда и только тогда, когда ему удовлетворяет образующий его кортеж R. Но правила имеют условия применимости, и их нарушение — источник ошибок: условие, затрагивающее атрибуты обоих операндов, нельзя опустить к одному из них, а проекцию нельзя протолкнуть через разность (π[A](R − S) в общем случае не равно π[A](R) − π[A](S), в чём легко убедиться на двух кортежах, совпадающих по A).
Проталкивание выборки на данных «Книжного узла»
Оценим, что даёт проталкивание выборки в примере с немецкими авторами, по реальным мощностям таблиц учебной базы: в book 2010 строк, в book_author 2424, в author 210, из них 28 авторов из Германии.
Если вычислять выражение буквально по определению, через декартово произведение, промежуточное отношение book × book_author × author содержало бы 2010 · 2424 · 210 = 1 023 170 400 кортежей — миллиард с лишним. Именно поэтому никакая СУБД не выполняет соединение через произведение. Если соединения выполняются как соединения, но выборка стоит над ними (левое дерево на рисунке), оба соединения дают по 2424 кортежа (у каждой строки book_author ровно одна книга и один автор), и лишь затем выборка оставляет 330 кортежей. Если же выборку опустить к author (правое дерево), то первое соединение получает на вход 28 авторов вместо 210, его результат — 330 кортежей, и второе соединение работает уже с ними. Промежуточные результаты сократились в семь с лишним раз, а ответ не изменился: 330 строк, относящихся к 322 различным книгам (несколько книг написаны двумя немецкими авторами, и проекция π[title] в алгебре слила бы такие строки).
Эвристика «выполнять выборки как можно раньше» — одна из первых, которые применяет оптимизатор. Однако окончательный выбор порядка соединений и алгоритмов делается не по эвристикам, а по оценке стоимости с использованием статистики о данных 6; об этом — в теме 11. Для автора запросов отсюда следует важный вывод: порядок, в котором записаны таблицы и условия в запросе SQL, не определяет порядок их обработки. Запрос описывает результат, а не план.
Запрос SELECT: структура и логический порядок выполнения
Предложения запроса SELECT
Запрос SELECT состоит из предложений (англ. clauses), каждое из которых отвечает за свой шаг преобразования данных 89:
| Предложение | Назначение | Соответствие в алгебре |
|---|---|---|
FROM | источники строк: таблицы, соединения, подзапросы | операнды, ×, ⋈ |
WHERE | условие отбора строк | σ |
GROUP BY | разбиение строк на группы | расширение алгебры (тема 5) |
HAVING | условие отбора групп | σ над группами (тема 5) |
SELECT | список вычисляемых столбцов и их псевдонимы | π с вычислениями, ρ |
DISTINCT | устранение повторяющихся строк | устранение дубликатов в π |
ORDER BY | порядок строк результата | нет: отношение не упорядочено |
LIMIT/OFFSET, FETCH FIRST | выдача части строк | нет |
Обязательно только само слово SELECT со списком выражений: SELECT 2 + 2 — корректный запрос PostgreSQL. Предложения записываются в строго определённом порядке, который совпадает с порядком в таблице, за исключением того, что SELECT и DISTINCT пишутся первыми. Простейший запрос к одной таблице выбирает строки по условию:
SELECT book_id, title, price
FROM book
WHERE category_id = 6 AND price < 300;
 book_id |         title          | price
---------+------------------------+--------
     148 | Секреты вычислений 148 | 239.99
     248 | Практика звёзд 248     | 279.99
     385 | Введение в Python 385  | 189.99
     858 | Практика времени 858   | 229.99
(4 rows)
Здесь и далее запросы выполняются в базе bookstore с путём поиска search_path = bookstore, поэтому имена таблиц пишутся без схемы. Порядок строк в выводе этого запроса никак не гарантирован: в нём нет ORDER BY.
Логический порядок выполнения
Порядок, в котором предложения записываются, не совпадает с порядком, в котором они логически применяются. Логический порядок выполнения (англ. logical query processing order) определяет, какие имена и значения доступны на каждом шаге 89:
FROM— формируется исходный набор строк; если таблиц несколько, они соединяются (тема 4).WHERE— отбрасываются строки, для которых условие не истинно (ложно или неизвестно).GROUP BY— оставшиеся строки разбиваются на группы.HAVING— отбрасываются группы, не удовлетворяющие условию.SELECT— вычисляются выражения списка выборки, им присваиваются псевдонимы (здесь же вычисляются оконные функции, тема 5).DISTINCT— устраняются повторяющиеся строки.- Операции над множествами
UNION,INTERSECT,EXCEPT, если запрос из них состоит. ORDER BY— строки упорядочиваются.LIMIT/OFFSETилиFETCH FIRST— выдаётся нужная часть строк.
Схема на рисунке показывает этот конвейер и отмечает, начиная с какого шага видны псевдонимы столбцов.
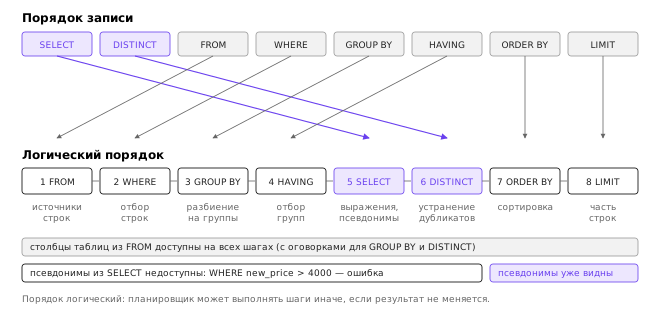
Слово «логический» существенно. Порядок описывает смысл запроса, а не действия исполнителя: планировщик вправе переставлять операции, применять условие WHERE прямо при чтении таблицы, останавливаться после получения нужного числа строк при LIMIT — лишь бы результат совпадал с тем, что дал бы буквальный конвейер. Это прямое продолжение идеи эквивалентных преобразований из предыдущего раздела.
Следствия логического порядка: псевдонимы, ORDER BY и DISTINCT
Из логического порядка вытекает правило, на котором спотыкаются почти все начинающие: псевдоним столбца, введённый в списке SELECT, нельзя использовать в WHERE, потому что WHERE применяется раньше, чем вычисляется список выборки.
SELECT title, price * 1.2 AS new_price
FROM book
WHERE new_price > 4000;
ERROR:  column "new_price" does not exist
LINE 3: WHERE new_price > 4000;
              ^
Правильно повторить выражение в условии; в ORDER BY, который выполняется после SELECT, псевдоним уже доступен:
SELECT title, price * 1.2 AS new_price
FROM book
WHERE price * 1.2 > 4000
ORDER BY new_price DESC;
               title               | new_price
-----------------------------------+-----------
 Искусство программирования. Том 1 |  4788.000
(1 row)
По той же причине псевдоним нельзя использовать в GROUP BY и HAVING — так требует стандарт. PostgreSQL в виде расширения разрешает в GROUP BY ссылаться на псевдоним или номер столбца результата, но в WHERE и HAVING — нет 9. Когда выражение длинное и повторять его не хочется, его выносят в подзапрос в FROM или в общее табличное выражение WITH (темы 4 и 6).
Второе следствие касается ORDER BY. Сортировка выполняется после SELECT, но в PostgreSQL ей доступны и столбцы исходной таблицы, не вошедшие в список выборки: SELECT title FROM book ORDER BY price корректен. Исключение — запрос с DISTINCT: после устранения дубликатов одной строке результата может соответствовать много исходных строк с разными значениями, и сортировать по ним невозможно.
SELECT DISTINCT city FROM customer ORDER BY registered_at;
ERROR:  for SELECT DISTINCT, ORDER BY expressions must appear in select list
LINE 1: SELECT DISTINCT city FROM customer ORDER BY registered_at;
                                                    ^
Третье следствие — порядок вычисления условий внутри WHERE не определён. Условие price > 0 AND 1000 / price > 2 не защищено от деления на ноль: СУБД вправе вычислить вторую часть первой, и документация PostgreSQL прямо предупреждает, что на порядок вычисления операндов AND и OR полагаться нельзя; если порядок важен, используется выражение CASE 10.
Мультимножества и NULL: где SQL отступает от алгебры
Таблица SQL — мультимножество (англ. multiset, bag): одинаковые строки допустимы, и запрос не устраняет их, пока его не попросят 38. Так сделано ради скорости — устранение дубликатов требует сортировки или хеширования всего результата — и потому, что иногда дубликаты несут смысл (две одинаковые позиции чека). Поэтому SELECT city FROM customer возвращает 5000 строк, по одной на покупателя, а проекции алгебры π[city](customer) соответствует только запрос с DISTINCT:
SELECT DISTINCT city FROM customer ORDER BY city;
      city
-----------------
 Екатеринбург
 Казань
 Москва
 Новосибирск
 Самара
 Санкт-Петербург
 Томск

(8 rows)
Восьмая строка — NULL. Здесь проявляется второе отступление SQL от алгебры: при устранении дубликатов, группировке и операциях над множествами два NULL считаются неразличимыми (англ. not distinct), хотя в условиях WHERE сравнение NULL = NULL даёт не истину, а неизвестность (тема 2). Стандарт формулирует это различие через два отношения: равенство значений в условиях и «неразличимость» (англ. distinctness) при сравнении строк в DISTINCT, GROUP BY, UNION 7.
PostgreSQL дополнительно поддерживает нестандартную форму DISTINCT ON (выражения), которая оставляет из каждой группы строк с одинаковыми значениями выражений первую по порядку ORDER BY 9. Это удобный, но непереносимый приём; в стандартном SQL та же задача решается оконными функциями (тема 5).
Условия, выражения и функции
Сравнения, BETWEEN, IN и NULL в условиях
Условие в WHERE — логическое выражение, построенное из сравнений =, <> (или !=), <, <=, >, >= и связок AND, OR, NOT. Приоритет связок обычный: NOT сильнее AND, AND сильнее OR, и условие a OR b AND c означает a OR (b AND c). При смешении связок скобки лучше ставить явно.
Для частых форм условий есть сокращения 11. Предикат x BETWEEN a AND b означает x >= a AND x <= b — обе границы включаются. Предикат x IN (v1, v2, v3) означает x = v1 OR x = v2 OR x = v3. Книг, изданных в 2000–2009 годах, и книг из трёх подрубрик программирования (Python, C и C++, Java — рубрики 18, 19, 20) в учебной базе соответственно:
SELECT count(*) FROM book WHERE pub_year BETWEEN 2000 AND 2009;   -- 575
SELECT count(*) FROM book WHERE category_id IN (18, 19, 20);      -- 315
Функция count(*) подсчитывает строки результата; агрегатные функции подробно рассматриваются в теме 5, здесь она используется лишь как способ узнать число строк. Включение обеих границ в BETWEEN — частый источник ошибок с датами и временем: условие created_at BETWEEN '2024-01-01' AND '2024-01-31' для столбца типа timestamptz не захватит заказы, сделанные 31 января после полуночи. Для интервалов надёжнее полуоткрытая форма created_at >= '2024-01-01' AND created_at < '2024-02-01'.
Главная ловушка условий — NULL. По правилам трёхзначной логики (тема 2) любое сравнение с NULL даёт неизвестность, а WHERE оставляет только строки, где условие истинно. Поэтому условие и его отрицание вместе не покрывают таблицу:
SELECT count(*) FROM book WHERE publisher_id = 4;      -- 186
SELECT count(*) FROM book WHERE publisher_id <> 4;     -- 1729
SELECT count(*) FROM book WHERE publisher_id IS NULL;  -- 95
186 + 1729 = 1915, а книг 2010: 95 книг без издательства (среди них «Искусство программирования» Кнута) не входят ни в первый, ни во второй результат. Вопрос «книги не издательства АСТ» на естественном языке обычно подразумевает и книги без издательства, и тогда условие пишется как publisher_id IS DISTINCT FROM 4 или publisher_id <> 4 OR publisher_id IS NULL. Та же природа у ловушки NOT IN со списком, содержащим NULL, — она подробно разбирается в теме 4.
Поиск по шаблону: LIKE, ILIKE и регулярные выражения
Предикат LIKE сравнивает строку с шаблоном, в котором % обозначает любую последовательность символов (в том числе пустую), а _ — ровно один символ 11. Сравнение учитывает регистр; в PostgreSQL есть нестандартный вариант ILIKE, не учитывающий регистр:
SELECT count(*) FROM book WHERE title LIKE 'Искусство%';   -- 208
SELECT count(*) FROM book WHERE title LIKE '%python%';     -- 0
SELECT count(*) FROM book WHERE title ILIKE '%python%';    -- 167
В названиях книг слово Python пишется с прописной буквы, поэтому LIKE '%python%' не находит ничего. Если сами символы % или _ нужно искать буквально, их экранируют обратной косой чертой: LIKE '%10\%%'. Шаблон, начинающийся с %, требует просмотра каждой строки; когда поиск по шаблону может использовать индекс, а когда нет, — вопрос темы 10.
Для более сложных шаблонов PostgreSQL поддерживает регулярные выражения POSIX операторами ~ (с учётом регистра), ~* (без учёта), !~ и !~* (отрицания). Стандартный предикат SIMILAR TO использует гибрид синтаксисов LIKE и регулярных выражений и на практике применяется редко 11. Найдём книги, название которых начинается со слова «Тайна» или «Хроники» и заканчивается двузначным номером от 10 до 19:
SELECT book_id, title
FROM book
WHERE title ~ '^(Тайна|Хроники) .* 1[0-9]$';
 book_id |        title
---------+---------------------
      13 | Тайна времени 13
      17 | Тайна звёзд 17
      18 | Тайна баз данных 18
(3 rows)
В отличие от LIKE, регулярное выражение ищет совпадение в любом месте строки, если не привязано якорями ^ (начало) и $ (конец). Без якоря $ под шаблон подошли бы и названия с номерами 100–199 и 1000–1999.
Выражение CASE и обзор функций
Выражение CASE — условное выражение SQL: проверяет условия по порядку и возвращает значение первой истинной ветви, а если ни одна не подошла, — значение ветви ELSE или NULL при её отсутствии 1011. CASE — выражение, а не оператор управления, поэтому его можно использовать всюду, где допустимо значение: в списке SELECT, в WHERE, в ORDER BY. Классифицируем книги по цене:
SELECT book_id, title, price,
       CASE WHEN price = 0    THEN 'бесплатно'
            WHEN price < 500  THEN 'дешёвая'
            WHEN price < 1500 THEN 'средняя'
            ELSE 'дорогая'
       END AS price_class
FROM book
WHERE book_id <= 10
ORDER BY book_id;
 book_id |               title               |  price  | price_class
---------+-----------------------------------+---------+-------------
       1 | Война и мир                       | 1290.00 | средняя
       2 | Преступление и наказание          |  450.00 | дешёвая
       3 | Евгений Онегин                    |  390.00 | дешёвая
       4 | Пикник на обочине                 |  520.00 | средняя
       5 | Трудно быть богом                 |  540.00 | средняя
       6 | Убийство в «Восточном экспрессе»  |  480.00 | дешёвая
       7 | Искусство программирования. Том 1 | 3990.00 | дорогая
       8 | Высоконагруженные приложения      | 2390.00 | дорогая
       9 | PostgreSQL 16 изнутри             |    0.00 | бесплатно
      10 | Основание                         |  610.00 | средняя
(10 rows)
Порядок ветвей важен: бесплатная книга удовлетворяет и условию price < 500, но попадает в первую подходящую ветвь. Вторая форма, CASE выражение WHEN значение THEN …, сравнивает одно выражение с несколькими значениями на равенство. Родственные функции COALESCE(a, b, …) (первое не-NULL значение) и NULLIF(a, b) (NULL, если a = b) — сокращения частых выражений CASE, введённые в теме 2.
Функций в PostgreSQL сотни, и их полный перечень — глава 9 документации 11. Для запросов к одной таблице чаще всего нужны функции, сведённые в таблицу.
| Группа | Функции и операторы | Пример и результат |
|---|---|---|
| строки | length, lower, upper, left, right, substr, position, replace, trim, split_part, ` | |
| числа | + - * /, %, round, trunc, ceil, floor, abs, power | 7 / 2 → 3, 7 / 2.0 → 3.5000000000000000 |
| даты и время | now(), current_date, extract, date_trunc, age, + interval, to_char | date_trunc('month', created_at) |
| приведение типов | CAST(x AS тип), x::тип | created_at::date |
Две особенности этих функций заслуживают отдельного внимания. Деление целых чисел в PostgreSQL целочисленное (7 / 2 = 3), как в Python оператор //; чтобы получить дробный результат, один из операндов делают типа numeric. Оператор конкатенации || возвращает NULL, если хотя бы один операнд NULL, а функция concat пропускает NULL-аргументы:
SELECT 'Книга: ' || title || ', издательство ' || publisher_id AS s1,
       concat('Книга: ', title, ', издательство ', publisher_id) AS s2
FROM book
WHERE book_id IN (6, 7);
                           s1                            |                           s2
---------------------------------------------------------+---------------------------------------------------------
 Книга: Убийство в «Восточном экспрессе», издательство 3 | Книга: Убийство в «Восточном экспрессе», издательство 3
                                                         | Книга: Искусство программирования. Том 1, издательство
(2 rows)
У книги Кнута издательство не указано, и выражение с || целиком превратилось в NULL. Функции дат работают с типами date, timestamp, timestamptz и interval. Например, для первого заказа учебной базы:
SELECT created_at,
       created_at::date                 AS d,
       extract(year FROM created_at)    AS y,
       date_trunc('month', created_at)  AS m,
       created_at + interval '14 days'  AS deadline
FROM orders
WHERE order_id = 1;
          created_at           |     d      |  y   |           m            |           deadline
-------------------------------+------------+------+------------------------+-------------------------------
 2023-09-27 13:27:48.308747+03 | 2023-09-27 | 2023 | 2023-09-01 00:00:00+03 | 2023-10-11 13:27:48.308747+03
(1 row)
Значения типа timestamptz выводятся в часовом поясе сеанса (параметр TimeZone, здесь Europe/Moscow), поэтому при другом поясе у вас время и, возле полуночи, даже дата будут другими. Типы даты и времени и работа с часовыми поясами — предмет темы 9.
Сортировка, ограничение выборки и операции над множествами
ORDER BY: ключи сортировки, NULL и правила сравнения строк
Отношение не упорядочено, и таблица SQL тоже: без ORDER BY СУБД возвращает строки в том порядке, в котором ей удобно, и этот порядок может измениться после обновления данных, создания индекса или смены плана 8. Если порядок важен — для отчёта, для постраничного вывода, для сравнения результатов, — он задаётся явно. ORDER BY принимает список ключей сортировки: строки упорядочиваются по первому ключу, при равенстве — по второму и так далее; у каждого ключа своё направление ASC (по возрастанию, по умолчанию) или DESC.
Место NULL при сортировке стандарт оставляет на усмотрение реализации; PostgreSQL считает NULL больше любого значения, поэтому при ASC NULL оказываются в конце, а при DESC — в начале 8. Это даёт неожиданный результат в запросе «пять самых молодых авторов»:
SELECT full_name, birth_year FROM author ORDER BY birth_year DESC LIMIT 5;
    full_name     | birth_year
------------------+------------
 Татьяна Попов    |
 Мартин Клеппман  |
 Анна Кузнецов    |
 Егор Рогов       |
 Мария Виноградов |
(5 rows)
У 27 авторов год рождения неизвестен, и все пять мест заняли они (в каком порядке между собой — не определено). Явное указание NULLS LAST и второй ключ сортировки дают осмысленный и воспроизводимый ответ:
SELECT full_name, birth_year
FROM author
ORDER BY birth_year DESC NULLS LAST, full_name
LIMIT 5;
   full_name   | birth_year
---------------+------------
 Андрей Попов  |       2004
 Ирина Волков  |       2004
 Ирина Орлов   |       2004
 Мария Иванов  |       2004
 Ольга Соколов |       2004
(5 rows)
Сортировка строк зависит от правила сравнения (англ. collation) — набора правил, определяющих порядок символов с учётом языка, регистра и диакритики 12. Правило задаётся при создании базы (обычно по локали операционной системы), может быть указано для столбца и для отдельного выражения конструкцией COLLATE. Разница хорошо видна на кириллице:
SELECT x FROM (VALUES ('ёж'), ('еж'), ('Ель'), ('яблоко'), ('Яма'), ('Эра')) AS v(x)
ORDER BY x COLLATE "C";
-- Ель, Эра, Яма, еж, яблоко, ёж

SELECT x FROM (VALUES ('ёж'), ('еж'), ('Ель'), ('яблоко'), ('Яма'), ('Эра')) AS v(x)
ORDER BY x COLLATE "ru-x-icu";
-- еж, ёж, Ель, Эра, яблоко, Яма
Правило "C" сравнивает коды символов Unicode: все прописные буквы идут раньше строчных, а «ё» (код U+0451) оказывается после «я». Правило "ru-x-icu" из библиотеки ICU сортирует по правилам русского языка. Следствие для практики: результат ORDER BY title на разных серверах может различаться, если базы созданы с разными правилами сравнения. Учебная база в окружении проверки создана с правилом C.UTF-8; на вашем сервере порядок строк в запросах с сортировкой по тексту может отличаться. Подробнее о правилах сравнения и их влиянии на индексы — в темах 9 и 10.
LIMIT, OFFSET и FETCH FIRST
Предложение LIMIT n ограничивает результат первыми n строками, OFFSET m пропускает первые m строк. Стандарт SQL с 2008 года определяет эквивалентную форму OFFSET m ROWS FETCH FIRST n ROWS ONLY; LIMIT — распространённое, но нестандартное расширение, которое PostgreSQL поддерживает наряду со стандартной формой 89. Без ORDER BY ограничение выборки бессмысленно: «первые n строк» неупорядоченного множества — это n каких-то строк.
Даже с ORDER BY результат может оказаться неоднозначным, если у строк на границе одинаковые ключи сортировки:
SELECT title, price FROM book ORDER BY price DESC LIMIT 3;
               title               |  price
-----------------------------------+---------
 Искусство программирования. Том 1 | 3990.00
 Теория Python 905                 | 2999.99
 Теория моря 1202                  | 2999.99
(3 rows)
Книг ценой 2999.99 четыре, и какие две из них попадут в ответ, не определено. Есть два честных решения. Первое — добавить ключ, делающий порядок однозначным (ORDER BY price DESC, book_id). Второе — стандартная форма WITH TIES, появившаяся в PostgreSQL 13: она выдаёт вместе с последней строкой все строки с теми же значениями ключей сортировки 9:
SELECT title, price FROM book ORDER BY price DESC FETCH FIRST 3 ROWS WITH TIES;
               title               |  price
-----------------------------------+---------
 Искусство программирования. Том 1 | 3990.00
 Теория Python 905                 | 2999.99
 Теория моря 1202                  | 2999.99
 Теория времени 1491               | 2999.99
 Секреты забытого города 1454      | 2999.99
(5 rows)
Пара LIMIT/OFFSET — простейший способ постраничного вывода: страница k по 20 строк — это ORDER BY … LIMIT 20 OFFSET 20 * (k − 1). Способ прост, но плохо масштабируется: чтобы выдать строки с 100 001 по 100 020, СУБД должна получить и отбросить первые 100 000, так что каждая следующая страница дороже предыдущей. Кроме того, если между запросами страниц в таблицу добавлены строки, они сдвигают границы, и пользователь видит повторы или пропуски. Альтернатива — пагинация по ключу (англ. keyset pagination): следующая страница запрашивается условием «ключ больше последнего показанного» (WHERE (price, book_id) > (169.99, 1987)), и при наличии индекса стоимость не зависит от номера страницы 13. Этот приём и его связь с индексами подробно рассматриваются в теме 10.
UNION, INTERSECT и EXCEPT
Операции над множествами SQL соответствуют операциям алгебры ∪, ∩ и −: UNION, INTERSECT, EXCEPT 8. Операнды должны иметь одинаковое число столбцов совместимых типов; имена столбцов результата берутся из первого запроса, а сопоставление столбцов идёт по позиции, а не по имени. По умолчанию операции устраняют дубликаты, как в алгебре; с ключевым словом ALL они работают с мультимножествами: UNION ALL просто дописывает строки второго запроса к первому, INTERSECT ALL оставляет строку столько раз, сколько минимум её вхождений в операнды, EXCEPT ALL — разность кратностей.
Города, где есть склады или издательства, — объединение (14 строк при UNION ALL, 5 при UNION):
SELECT city FROM warehouse
UNION
SELECT city FROM publisher
ORDER BY city;
      city
-----------------
 Казань
 Москва
 Новосибирск
 Санкт-Петербург

(5 rows)
Пятая строка — снова NULL: у издательства «Северный узел» город не указан. Города, где есть и покупатели, и склады, — пересечение; результат — все четыре города складов. Предложение ORDER BY в составном запросе относится ко всему результату, а не к последнему операнду, и потому пишется один раз в конце; там же пишутся LIMIT и OFFSET. Чтобы отсортировать или ограничить отдельный операнд, его заключают в скобки. Если в одном запросе встречаются несколько операций, INTERSECT связывает сильнее, чем UNION и EXCEPT, а операции одного уровня выполняются слева направо 8.
Выбор между UNION и UNION ALL — не стилистический. UNION устраняет дубликаты, для чего СУБД вынуждена сортировать или хешировать весь результат; если операнды заведомо не пересекаются (например, выбирают строки разных статусов), UNION ALL даёт тот же ответ дешевле. Если же дубликаты возможны и важны (подсчёт всех строк), UNION молча исказит результат. Оператор EXCEPT удобен для сравнения двух наборов строк: два запроса возвращают одно и то же множество строк, если обе разности, A EXCEPT B и B EXCEPT A, пусты. Этим приёмом пользуются при проверке переписанных запросов и миграций данных (темы 4 и 8).
Итоги темы
Реляционная алгебра — замкнутый набор операций над отношениями: выборка и проекция вырезают строки и столбцы, переименование согласует имена, объединение, разность и пересечение работают с совместимыми отношениями, декартово произведение и соединения сочетают кортежи разных отношений, полусоединение и антисоединение проверяют наличие пары, деление отвечает на вопросы «для всех». Базовых операций шесть, остальные выражаются через них, но имеют собственные эффективные алгоритмы. Отрицание в вопросах выражается разностью или антисоединением, квантор всеобщности — делением, и умение распознать в формулировке вопроса эти конструкции — главный навык, который даёт алгебра.
Выражение алгебры можно изображать деревом операций и преобразовывать по правилам эквивалентности. Проталкивание выборки к листьям дерева на данных учебной базы уменьшает промежуточные результаты в семь раз, не меняя ответа; такими преобразованиями и оценками стоимости занимается оптимизатор. Реляционное исчисление описывает результат логической формулой, равносильно алгебре по выразительной силе и показывает, откуда в SQL декларативность: запрос задаёт, что нужно получить, а план выполнения выбирает СУБД.
Запрос SELECT записывается в одном порядке, а логически выполняется в другом: FROM, WHERE, GROUP BY, HAVING, SELECT, DISTINCT, ORDER BY, LIMIT. Из этого порядка следуют правила видимости псевдонимов и ограничения на ORDER BY при DISTINCT. SQL отступает от алгебры в двух отношениях — таблицы являются мультимножествами, и в них есть NULL, — и большинство ошибок в простых запросах связано именно с этими отступлениями: забытый DISTINCT, потерянные строки с NULL в условии «не равно», NULL в начале сортировки по убыванию, неоднозначный LIMIT без уникального ключа сортировки.
Все запросы этой темы обращались к одной таблице. В теме 4 алгебраические соединения, полусоединения, антисоединения и деление получат полноценное воплощение в SQL — соединения JOIN, внешние соединения и подзапросы, — и появятся новые ловушки, связанные с NULL и с размножением строк при соединении.
Литература
- Codd E. F. A Relational Model of Data for Large Shared Data Banks. — Communications of the ACM, 1970, Т. 13, № 6, С. 377–387, DOI: 10.1145/362384.362685.
- Codd E. F. Relational Completeness of Data Base Sublanguages. — In: Rustin R. (ed.) Data Base Systems. Courant Computer Science Symposia Series, Vol. 6. — Prentice-Hall, 1972, С. 65–98.
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Garcia-Molina H., Ullman J. D., Widom J. Database Systems: The Complete Book. 2nd ed. — Pearson Prentice Hall, 2008.
- Дейт К. Дж. Введение в системы баз данных. 8-е изд. — М.: Вильямс, 2005.
- Selinger P. G., Astrahan M. M., Chamberlin D. D., Lorie R. A., Price T. G. Access Path Selection in a Relational Database Management System. — Proceedings of the 1979 ACM SIGMOD International Conference on Management of Data, 1979, С. 23–34, DOI: 10.1145/582095.582099.
- ISO/IEC 9075-2:2023. Information technology — Database languages SQL — Part 2: Foundation (SQL/Foundation). — ISO, 2023.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 7. Queries. — 2024. https://www.postgresql.org/docs/16/queries.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. SELECT. — 2024. https://www.postgresql.org/docs/16/sql-select.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 4.2. Value Expressions. — 2024. https://www.postgresql.org/docs/16/sql-expressions.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 9. Functions and Operators. — 2024. https://www.postgresql.org/docs/16/functions.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 24.2. Collation Support. — 2024. https://www.postgresql.org/docs/16/collation.html
- Winand M. Paging Through Results. — Use The Index, Luke! https://use-the-index-luke.com/sql/partial-results/fetch-next-page