
Соединения и подзапросы
В теме 3 были введены операции реляционной алгебры — соединения, полусоединение, антисоединение, деление — и запрос SELECT к одной таблице. Но данные «Книжного узла», как и любой нормализованной базы, разнесены по многим таблицам: название книги хранится в book, имя автора — в author, связь между ними — в book_author, а покупатель, заказ, позиции заказа и оплата — в четырёх разных таблицах. Почти любой практический вопрос — «какие книги купил покупатель», «какие издательства не выпустили ни одной книги по Python», «сколько заплатили за заказ» — требует собрать данные из нескольких таблиц. Остаётся открытым вопрос, как алгебраические соединения и подзапросы записываются в SQL и чем SQL с его NULL и мультимножествами отличается здесь от алгебры.
Тема отвечает на этот вопрос в два шага. Первый — соединения: внутренние, внешние, самосоединения и соединения многих таблиц по пути внешних ключей. Здесь возникают две ловушки, на которых ошибаются и опытные разработчики: условие в WHERE, незаметно превращающее внешнее соединение во внутреннее, и размножение строк при соединении с двумя независимыми таблицами «многих». Второй шаг — подзапросы: скалярные, в FROM, в условиях с IN, EXISTS, ANY/ALL, коррелированные и LATERAL. Подзапросы дают в SQL прямые аналоги полусоединения, антисоединения и деления; рядом с ними — третья ловушка, NOT IN при наличии NULL.
Все примеры выполнены на учебной базе bookstore масштаба scale=1, числа строк приведены из реального вывода. Группировка и агрегатные функции рассматриваются в теме 5; здесь функции count, sum и avg используются только в простейшем виде — для подсчёта строк и суммы по всем строкам результата или подзапроса. Как СУБД выполняет соединения (вложенные циклы, хеширование, слияние), разбирается в теме 11.
Внутреннее соединение
От декартова произведения к JOIN
Если в предложении FROM перечислить две таблицы через запятую или соединить их ключевыми словами CROSS JOIN, результатом будет декартово произведение: каждая строка первой таблицы в паре с каждой строкой второй 5. В учебной базе 2010 книг и 4 склада, поэтому SELECT count(*) FROM book CROSS JOIN warehouse возвращает 8040. Произведение бывает нужно само по себе — например, чтобы получить все сочетания «книга — склад» и затем найти отсутствующие остатки, — но чаще за ним следует отбор осмысленных пар, то есть тета-соединение темы 3.
Исторически соединение записывали именно так: произведение в FROM и условие соединения в WHERE. Стандарт SQL-92 ввёл явный синтаксис соединения (англ. explicit join syntax), в котором условие соединения записывается рядом с таблицей в предложении ON 41:
-- старый стиль: произведение и условие в WHERE
SELECT b.title, p.name
FROM book b, publisher p
WHERE p.publisher_id = b.publisher_id AND b.book_id <= 3;

-- явное соединение
SELECT b.title, p.name
FROM book b
JOIN publisher p ON p.publisher_id = b.publisher_id
WHERE b.book_id <= 3;
          title           |  name
--------------------------+--------
 Война и мир              | АСТ
 Преступление и наказание | Эксмо
 Евгений Онегин           | Азбука
(3 rows)
Для внутреннего соединения обе формы эквивалентны, и PostgreSQL строит для них одинаковый план. Явная форма предпочтительнее по двум причинам. Условия соединения отделены от условий отбора, и запрос легче читать. И главное — пропущенное условие соединения в явной форме вызывает синтаксическую ошибку (JOIN требует ON или USING), а в старой форме молча превращает запрос в декартово произведение. Слово JOIN означает INNER JOIN — внутреннее соединение (англ. inner join): в результат попадают только пары строк, для которых условие истинно. Строка без пары исчезает: книг 2010, а book JOIN publisher возвращает 1915 строк, потому что у 95 книг publisher_id равен NULL, а сравнение NULL = значение не истинно.
Буквы b и p — псевдонимы таблиц (англ. table alias), реализация переименования ρ. Когда в запросе несколько таблиц, имена столбцов принято уточнять псевдонимом (b.title), даже если имя уникально: запрос становится понятнее и не ломается, если в другую таблицу позже добавят столбец с тем же именем. Если же имя столбца встречается в двух таблицах, уточнение обязательно, иначе PostgreSQL сообщает об ошибке column reference "…" is ambiguous.
USING и NATURAL JOIN
Когда соединение идёт по равенству одноимённых столбцов, вместо ON можно написать USING: book JOIN book_author USING (book_id) означает ON book.book_id = book_author.book_id, но в результате остаётся один столбец book_id, а не два 5. Это удобно и безопасно: столбцы соединения перечислены явно.
NATURAL JOIN идёт дальше: он соединяет по всем одноимённым столбцам, не перечисляя их, — это естественное соединение алгебры, введённое ещё Коддом 12. Именно поэтому им почти не пользуются в рабочем коде. Условие соединения зависит от схемы, а не от запроса, и меняется вместе с ней. В учебной базе у order_item и book два общих имени: book_id и price. Пока цена книги в каталоге совпадает с ценой в заказах, естественное соединение возвращает все 59 910 позиций заказов. Изменим в транзакции цену «Войны и мира» и посмотрим ещё раз:
BEGIN;
UPDATE book SET price = 1390 WHERE book_id = 1;
SELECT count(*) FROM order_item NATURAL JOIN book;           -- 58702
SELECT count(*) FROM order_item JOIN book USING (book_id);   -- 59910
ROLLBACK;
1208 позиций с «Войной и миром» исчезли из естественного соединения без всякого предупреждения: столбец order_item.price хранит цену на момент заказа, book.price — текущую, и условие order_item.price = book.price для них стало ложным. Такие ошибки трудно заметить, потому что запрос продолжает работать и возвращает правдоподобные данные. Обратный случай тоже возможен: warehouse NATURAL JOIN publisher соединяет склады с издательствами по городу — случайному общему имени, о котором автор запроса мог и не думать. Если же общих имён нет совсем, NATURAL JOIN становится декартовым произведением.
Соединение нескольких таблиц: путь по внешним ключам
Вопрос, затрагивающий несколько таблиц, решается соединением по цепочке внешних ключей (англ. join path): от таблицы к таблице, на каждом шаге — по паре «внешний ключ — первичный ключ». Чтобы найти этот путь, удобно держать перед глазами схему базы. Например, для вопроса «из каких рубрик книги в заказе 1» путь такой: orders → order_item (по order_id) → book (по book_id) → category (по category_id).
SELECT o.order_id, o.created_at::date AS d, b.title,
       cat.name AS category, oi.quantity, oi.price
FROM orders o
JOIN order_item oi ON oi.order_id = o.order_id
JOIN book b        ON b.book_id = oi.book_id
JOIN category cat  ON cat.category_id = b.category_id
WHERE o.order_id = 1
ORDER BY b.book_id;
 order_id |     d      |          title           |  category  | quantity |  price
----------+------------+--------------------------+------------+----------+---------
        1 | 2023-09-27 | Хроники баз данных 286   | Фантастика |        1 | 1489.99
        1 | 2023-09-27 | Практика времени 345     | Математика |        1 | 1479.99
        1 | 2023-09-27 | История старого дома 756 | Фантастика |        1 | 2559.99
(3 rows)
Синтаксически соединения в FROM выполняются слева направо: a JOIN b ON … JOIN c ON … означает (a JOIN b ON …) JOIN c ON …, и в условии ON можно ссылаться только на таблицы, уже появившиеся левее 7. Для внутренних соединений порядок записи не влияет ни на результат (соединение коммутативно и ассоциативно), ни на скорость: планировщик сам выбирает порядок выполнения (тема 11). Для внешних соединений порядок важен, к этому вернёмся ниже.
Полезно уметь оценивать мощность результата до выполнения. Соединение «многие к одному» по внешнему ключу, обязательному (NOT NULL) и ссылочно целостному, сохраняет число строк левой таблицы: каждая позиция заказа находит ровно одну книгу, каждая книга — ровно одну рубрику, поэтому три позиции заказа дают три строки. Соединение «один ко многим» может увеличить число строк — об этом отдельный раздел.
Самосоединение: рубрики и их родители
Таблица category хранит дерево рубрик: столбец parent_id ссылается на ту же таблицу. Чтобы рядом с рубрикой вывести название родителя, таблицу соединяют саму с собой — это самосоединение (англ. self-join). Псевдонимы здесь обязательны: две копии одной таблицы играют разные роли, и их надо различать, как при переименовании ρ в алгебре. Добавив третью копию, получим «дедушку» — рубрику верхнего уровня:
SELECT c.name AS category, p.name AS parent, g.name AS grandparent
FROM category c
JOIN category p ON p.category_id = c.parent_id
JOIN category g ON g.category_id = p.parent_id
ORDER BY c.category_id;
        category        |      parent      |        grandparent
------------------------+------------------+---------------------------
 Python                 | Программирование | Компьютерная литература
 C и C++                | Программирование | Компьютерная литература
 Java                   | Программирование | Компьютерная литература
 PostgreSQL             | Базы данных      | Компьютерная литература
 NoSQL                  | Базы данных      | Компьютерная литература
 Космическая фантастика | Фантастика       | Художественная литература
(6 rows)
В рубрикаторе 23 рубрики, но в ответе шесть: внутреннее соединение отбросило рубрики, у которых нет родителя или «дедушки», — четыре рубрики верхнего уровня и тринадцать рубрик второго уровня. Каждое следующее самосоединение спускается на один уровень дерева, поэтому дерево произвольной глубины самосоединениями не обойти; для этого служат рекурсивные запросы (тема 6).
Другой типичный пример самосоединения — пары строк одной таблицы, связанных общим значением. Соавторы — это две строки book_author с одной книгой и разными авторами; условие ba2.author_id > ba1.author_id оставляет каждую пару один раз и исключает пары автора с самим собой. Для первых десяти книг такой запрос возвращает две строки — Аркадий и Борис Стругацкие для «Пикника на обочине» и «Трудно быть богом».
Соединение по неравенству
Условие соединения не обязано быть равенством. Соединение по произвольному условию — тета-соединение алгебры; когда условие отлично от равенства, его называют неэквисоединением (англ. non-equi join). Типичный случай — соединение с таблицей интервалов: тарифной сеткой, шкалой скидок, ценовыми классами. Справочник интервалов не обязательно хранить в базе: конструктор VALUES с псевдонимом и именами столбцов создаёт маленькую таблицу прямо в запросе 5.
SELECT b.book_id, b.title, b.price, band.label
FROM book b
JOIN (VALUES ('дешёвая', 0, 500),
             ('средняя', 500, 1500),
             ('дорогая', 1500, 100000)) AS band (label, lo, hi)
  ON b.price >= band.lo AND b.price < band.hi
WHERE b.book_id <= 6
ORDER BY b.book_id;
 book_id |              title               |  price  |  label
---------+----------------------------------+---------+---------
       1 | Война и мир                      | 1290.00 | средняя
       2 | Преступление и наказание         |  450.00 | дешёвая
       3 | Евгений Онегин                   |  390.00 | дешёвая
       4 | Пикник на обочине                |  520.00 | средняя
       5 | Трудно быть богом                |  540.00 | средняя
       6 | Убийство в «Восточном экспрессе» |  480.00 | дешёвая
(6 rows)
Рассуждение о мощности здесь то же, что и для соединения по ключу, но гарантий меньше: ни первичный, ни внешний ключ не обещают, что каждой книге найдётся ровно один интервал. Если интервалы пересекаются, книга на границе попадёт в два класса и строка размножится; если между интервалами есть разрыв, книга в разрыве исчезнет из внутреннего соединения. По всей таблице запрос возвращает 2010 строк — ровно по одной на книгу. Сдвиг нижней границы первого класса с 0 на 1 оставляет 2009 строк: бесплатная книга выпадает в разрыв. А замена < на <= делает интервалы пересекающимися, но на учебных данных по-прежнему даёт 2010 строк, потому что ни одна книга не стоит ровно 500 или 1500 рублей. Ошибка в запросе есть, а на данных она не видна — к этому наблюдению мы вернёмся в конце темы. Поэтому интервалы принято задавать полуоткрытыми (нижняя граница включается, верхняя нет) и примыкающими друг к другу. Для неэквисоединения PostgreSQL не может применить ни соединение хешированием, ни соединение слиянием — обоим методам нужно условие равенства — и выполняет его вложенными циклами (тема 11).
Внешние соединения
LEFT, RIGHT и FULL: дополнение значениями NULL
Внутреннее соединение теряет строки без пары, а вопрос часто требует их сохранить: «все книги с издательствами, в том числе книги без издательства». Для этого служат внешние соединения (англ. outer join) 125:
- левое внешнее соединение
A LEFT JOIN B ON …возвращает все строки внутреннего соединения и, кроме того, каждую строку A, не нашедшую пары, дополненную значениями NULL в столбцах B; - правое
A RIGHT JOIN B— то же для строк B; оно равносильноB LEFT JOIN A, и на практике обычно пишут левые соединения; - полное
A FULL JOIN Bсохраняет строки без пары с обеих сторон.
SELECT b.book_id, b.title, p.name AS publisher
FROM book b
LEFT JOIN publisher p ON p.publisher_id = b.publisher_id
WHERE b.book_id <= 8
ORDER BY b.book_id;
 book_id |               title               | publisher
---------+-----------------------------------+-----------
       1 | Война и мир                       | АСТ
       2 | Преступление и наказание          | Эксмо
       3 | Евгений Онегин                    | Азбука
       4 | Пикник на обочине                 | АСТ
       5 | Трудно быть богом                 | АСТ
       6 | Убийство в «Восточном экспрессе»  | Эксмо
       7 | Искусство программирования. Том 1 |
       8 | Высоконагруженные приложения      | ДМК Пресс
(8 rows)
Книга Кнута сохранилась, а на месте издательства — NULL. По всей таблице book LEFT JOIN publisher даёт 2010 строк против 1915 у внутреннего соединения. Рисунок ниже сравнивает три вида соединений на двух маленьких таблицах.
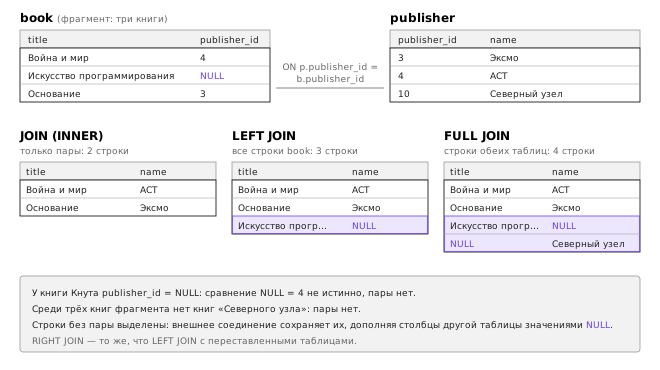
Полное соединение удобно для сверки двух наборов: какие города есть только у складов, какие только у издательств, какие у обоих.
SELECT w.city AS warehouse_city, p.name AS publisher
FROM warehouse w
FULL JOIN publisher p ON p.city = w.city
ORDER BY w.warehouse_id, p.publisher_id;
 warehouse_city  |   publisher
-----------------+---------------
 Москва          | ДМК Пресс
 Москва          | Эксмо
 Москва          | АСТ
 Москва          | Наука
 Москва          | МЦНМО
 Москва          | Самокат
 Санкт-Петербург | Питер
 Санкт-Петербург | БХВ
 Санкт-Петербург | Азбука
 Новосибирск     |
 Казань          |
                 | Северный узел
(12 rows)
Склады в Новосибирске и Казани не нашли издательств, а издательство «Северный узел» с неизвестным городом не нашло склада — и все три строки сохранены. Заметим, что NULL в результате внешнего соединения неоднозначен: в последней строке пустой warehouse_city означает «пары нет», но такой же NULL мог бы прийти из самой таблицы. Чтобы отличать эти случаи, проверяют на NULL столбец, который в таблице заведомо не пуст, — первичный ключ.
Условие в ON и условие в WHERE
Для внутреннего соединения безразлично, записано условие в ON или в WHERE: в обоих случаях оно отбирает пары. Для внешнего соединения это различие принципиально, и оно следует из логического порядка выполнения запроса (тема 3). Условие ON — часть соединения: оно определяет, какие строки считаются парой, а строки левой таблицы без пары сохраняются в любом случае. Условие WHERE применяется после соединения к уже построенным строкам, включая дополненные NULL 57.
Рассмотрим вопрос «покупатели из Томска и их заказы за декабрь 2024 года — включая покупателей, которые в декабре ничего не заказывали». Покупателей из Томска 576.
-- условие на дату в ON: 584 строки
SELECT c.customer_id, o.order_id
FROM customer c
LEFT JOIN orders o ON o.customer_id = c.customer_id
                  AND o.created_at >= '2024-12-01'
WHERE c.city = 'Томск';

-- условие на дату в WHERE: 72 строки
SELECT c.customer_id, o.order_id
FROM customer c
LEFT JOIN orders o ON o.customer_id = c.customer_id
WHERE c.city = 'Томск' AND o.created_at >= '2024-12-01';
Первый запрос отвечает на поставленный вопрос: 72 строки — декабрьские заказы томичей, ещё 512 строк — томичи без декабрьских заказов, с NULL в order_id; 72 + 512 = 584. Во втором запросе левое соединение сначала строит все заказы томичей за всё время и строки для томичей без заказов вообще, а затем WHERE отбрасывает каждую строку, где created_at не больше границы, — в том числе все строки, дополненные NULL, потому что сравнение NULL >= '2024-12-01' не истинно. Остаются 72 строки, ровно как у внутреннего соединения: условие в WHERE «превратило» внешнее соединение во внутреннее. Схема на рисунке показывает, на каком шаге теряются строки.
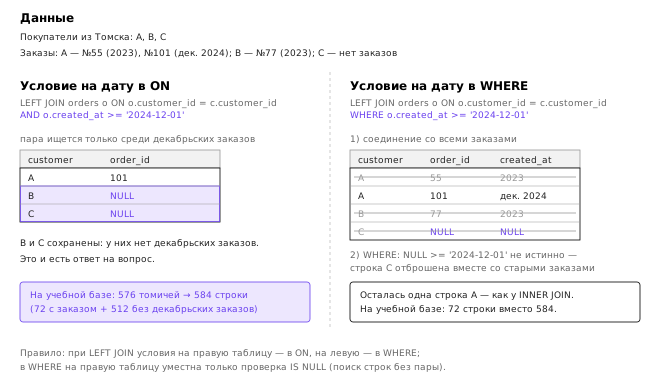
Правило, которое из этого следует: при LEFT JOIN условия на правую таблицу пишутся в ON, условия на левую — в WHERE. Условие WHERE на столбец правой таблицы допустимо только в одном случае — когда оно проверяет IS NULL и намеренно оставляет строки без пары. PostgreSQL сам замечает, что WHERE с таким условием отбрасывает дополненные строки, и выполняет соединение как внутреннее; в плане выполнения это видно по узлу Join без слова Left (тема 11).
Тот же эффект возникает в цепочке соединений: a LEFT JOIN b ON … JOIN c ON c.id = b.c_id — внутреннее соединение с c отбрасывает строки, где b дополнено NULL, и внешнее соединение с b теряет смысл. Если строки a должны сохраниться, вся цепочка после первого внешнего соединения тоже должна быть внешней, либо b JOIN c заключается в скобки как единое целое: a LEFT JOIN (b JOIN c ON …) ON ….
Строки без пары: антисоединение через LEFT JOIN
Внешнее соединение даёт и способ найти строки без пары — антисоединение темы 3. Левое соединение сохраняет строки левой таблицы без пары, дополняя их NULL; остаётся оставить только их, проверив на NULL первичный ключ правой таблицы. Покупатели, не сделавшие ни одного заказа:
SELECT count(*)
FROM customer c
LEFT JOIN orders o ON o.customer_id = c.customer_id
WHERE o.customer_id IS NULL;   -- 621
Проверять на NULL нужно именно столбец, который в правой таблице не может быть NULL, — столбец условия соединения или первичный ключ: проверка необязательного столбца, например o.warehouse_id IS NULL, смешала бы строки без пары с настоящими заказами без склада. Другие формулировки антисоединения — NOT EXISTS, NOT IN, EXCEPT — рассмотрены в разделе о подзапросах.
Размножение строк при соединении
Мощность соединения «один ко многим»
Соединение по внешнему ключу «один ко многим» с точки зрения стороны «один» размножает строки: заказ 1 соединяется с тремя своими позициями и превращается в три строки, и все атрибуты заказа — дата, покупатель, статус — повторяются трижды. Это не ошибка: каждая строка результата описывает одну позицию, и соединение отвечает на вопрос о позициях. Ошибка возникает, когда результат такого соединения используют для вопроса о заказах — например, считают заказы или складывают атрибуты заказа. Размножение строк (англ. row multiplication, также fan-out) — самая частая причина неверных отчётов, потому что запрос выполняется без ошибок и даёт число правдоподобного масштаба.
Мощность соединения можно оценить заранее. Если каждая строка A соединяется в среднем с k строками B, то |A ⋈ B| ≈ k · |A|. В учебной базе 20 000 заказов и 59 910 позиций, в среднем три позиции на заказ, поэтому orders JOIN order_item даёт 59 910 строк. Любая сумма по атрибуту orders, посчитанная после такого соединения, окажется примерно втрое больше правильной.
Две независимые связи «один ко многим»
Опаснее всего случай, когда к одной строке присоединяются две независимые таблицы «многих». У заказа есть позиции (order_item) и платежи (payment); позиции и платежи между собой не связаны, связь у каждого — только с заказом. Соединение orders JOIN order_item JOIN payment сочетает каждую позицию заказа с каждым его платежом, то есть строит декартово произведение внутри каждого заказа: при трёх позициях и одном платеже платёж повторяется трижды, при трёх позициях и двух платежах получилось бы шесть строк. Родственную ситуацию в ER-моделировании называют ловушкой «веер» (англ. fan trap, тема 7); рисунок ниже показывает её на заказе 1.
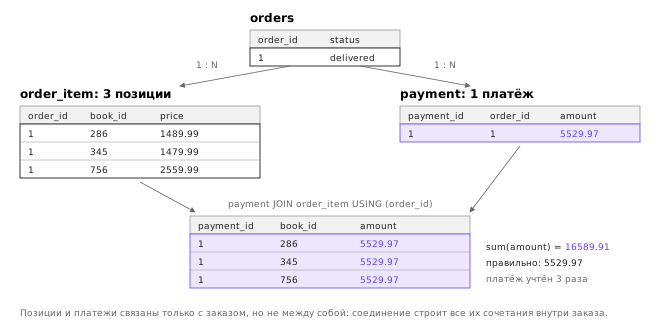
Посчитаем сумму платежей за ноябрь 2024 года правильно и «с соединением», которое понадобилось бы, например, чтобы заодно вывести названия купленных книг:
-- платежи без соединения
SELECT count(*), sum(amount)
FROM payment
WHERE paid_at >= '2024-11-01' AND paid_at < '2024-12-01';

-- те же платежи, соединённые с позициями заказов
SELECT count(*), sum(p.amount)
FROM payment p
JOIN order_item oi ON oi.order_id = p.order_id
WHERE p.paid_at >= '2024-11-01' AND p.paid_at < '2024-12-01';
 count |    sum
-------+------------
   553 | 3456109.22
(1 row)

 count |     sum
-------+-------------
  1658 | 10361057.69
(1 row)
553 платежа превратились в 1658 строк, а выручка выросла втрое: каждый платёж сложен столько раз, сколько позиций в его заказе. Ошибку выдаёт именно число строк: если запрос отвечает на вопрос о платежах, строк должно быть столько же, сколько платежей. Отсюда простое правило самопроверки — перед суммированием посчитать строки и сравнить с числом объектов, о которых задан вопрос.
Как избежать размножения
Способов три, и все они сводятся к тому, чтобы не соединять независимые таблицы «многих» напрямую.
Первый — не соединять, если атрибуты второй таблицы не нужны в результате. Если таблица в запросе нужна только для условия («платежи по заказам, в которых есть книги Кнута»), её место не в JOIN, а в полусоединении EXISTS (раздел о подзапросах): полусоединение по определению не размножает строки.
Второй — свести каждую таблицу «многих» к одной строке на ключ до соединения: вычислить сумму позиций заказа коррелированным подзапросом или подзапросом в FROM и только потом соединить с платежами. Предварительная агрегация (англ. pre-aggregation) подзапросом с GROUP BY — основной приём построения отчётов, он подробно разбирается в теме 5.
Третий способ, который часто применяют и который не следует применять, — DISTINCT или count(DISTINCT …) поверх размноженного результата. Он маскирует симптом: два разных платежа на одинаковую сумму по одному заказу DISTINCT склеит в один, и сумма станет меньше правильной. Правильный запрос не порождает лишних строк, а не убирает их после.
Подзапросы
Скалярные подзапросы
Подзапрос (англ. subquery) — запрос SELECT, вложенный в другой запрос и заключённый в скобки. Место подзапроса определяет, что от него требуется. Скалярный подзапрос (англ. scalar subquery) стоит там, где ожидается одно значение, и должен вернуть не более одной строки с одним столбцом; если строк нет, значение подзапроса — NULL, если строк больше одной — возникает ошибка выполнения 8. Средняя цена книги — 1567.74 рубля; книги дороже средней:
SELECT count(*) FROM book WHERE price > (SELECT avg(price) FROM book); -- 991
Скалярный подзапрос можно использовать и в списке SELECT, например чтобы вывести отклонение цены от средней:
SELECT book_id, title, price,
       round(price - (SELECT avg(price) FROM book), 2) AS diff
FROM book
WHERE book_id <= 5
ORDER BY book_id;
 book_id |          title           |  price  |   diff
---------+--------------------------+---------+----------
       1 | Война и мир              | 1290.00 |  -277.74
       2 | Преступление и наказание |  450.00 | -1117.74
       3 | Евгений Онегин           |  390.00 | -1177.74
       4 | Пикник на обочине        |  520.00 | -1047.74
       5 | Трудно быть богом        |  540.00 | -1027.74
(5 rows)
Этот подзапрос не зависит от внешнего запроса — такой подзапрос называют некоррелированным (англ. uncorrelated), и СУБД вычисляет его один раз. В плане выполнения PostgreSQL он виден как узел InitPlan.
Подзапросы в FROM: производные таблицы
Подзапрос в предложении FROM называется производной таблицей (англ. derived table): его результат участвует в запросе как обычная таблица 5. Стандарт и PostgreSQL до версии 15 включительно требуют дать ему псевдоним; в PostgreSQL 16 псевдоним можно опустить, но давать его по-прежнему принято — по нему ссылаются на столбцы подзапроса. Производные таблицы решают две задачи. Первая — дать имя вычисленному столбцу, чтобы использовать его в WHERE внешнего запроса, обойдя ограничение логического порядка выполнения из темы 3:
SELECT title, new_price
FROM (SELECT title, price * 1.2 AS new_price FROM book) AS t
WHERE new_price > 4000;
               title               | new_price
-----------------------------------+-----------
 Искусство программирования. Том 1 |  4788.000
(1 row)
Вторая — подготовить данные до соединения: свести таблицу «многих» к одной строке на ключ и избежать размножения строк (подробно — в теме 5). Производная таблица — это то же, что подвыражение в дереве алгебры; планировщик PostgreSQL, как правило, «раскрывает» простые подзапросы в FROM, встраивая их в основной запрос, так что вынос выражения в подзапрос не делает запрос медленнее. Для длинных запросов ту же роль удобнее играет общее табличное выражение WITH (тема 6).
IN, ANY и ALL
Подзапрос, возвращающий один столбец и сколько угодно строк, используется в условиях со специальными предикатами 6:
x IN (подзапрос)— истинно, если x равно хотя бы одному значению подзапроса;x оп ANY (подзапрос)(синонимSOME) — истинно, если сравнениеx оп vистинно хотя бы для одного значения v;x = ANY (…)равносильноIN;x оп ALL (подзапрос)— истинно, если сравнение истинно для всех значений;x <> ALL (…)равносильноNOT IN.
Книги дороже всех книг рубрики «Базы данных» (рубрика 13, самая дорогая — 2979.99):
SELECT count(*) FROM book
WHERE price > ALL (SELECT price FROM book WHERE category_id = 13);   -- 13
Предикат ALL скрывает неочевидный случай: для пустого подзапроса он истинен. В рубрике 1 «Художественная литература» книг нет (книги лежат в её подрубриках), поэтому price > ALL (SELECT price FROM book WHERE category_id = 1) истинно для всех 2010 книг — точно так же, как деление на пустой делитель в теме 3 возвращает всех кандидатов. Формулировка через max (price > (SELECT max(price) …)) в этом случае вернула бы пустой результат, потому что максимум пустого множества — NULL. Две формулировки, кажущиеся равносильными, расходятся именно на граничном случае. Ещё одна тонкость — NULL в подзапросе: если среди значений есть NULL, а для остальных сравнение истинно, ALL даёт неизвестность, и строка не проходит. Это та же ловушка, что и у NOT IN, рассмотренная ниже.
Коррелированные подзапросы
Подзапрос, ссылающийся на столбцы внешнего запроса, называется коррелированным (англ. correlated subquery). Логически он вычисляется заново для каждой строки внешнего запроса — как функция от этой строки. Сумма каждого заказа покупателя 4003:
SELECT o.order_id, o.status,
       (SELECT sum(oi.quantity * oi.price)
        FROM order_item oi
        WHERE oi.order_id = o.order_id) AS total
FROM orders o
WHERE o.customer_id = 4003
ORDER BY o.order_id;
 order_id |  status   |  total
----------+-----------+---------
     5939 | delivered | 3949.97
     8889 | delivered | 5449.97
    10737 | delivered | 4079.97
    19913 | delivered | 3059.96
(4 rows)
Ссылка o.order_id внутри подзапроса связывает его с текущей строкой внешнего запроса. Здесь коррелированный подзапрос сразу решает проблему размножения: для каждого заказа он возвращает ровно одно число, и соединять заказ с позициями не нужно. В условиях WHERE коррелированный подзапрос выражает зависимость «для этой строки существует / не существует / сравнивается с …», на чём построены полусоединение и антисоединение.
«Вычисляется для каждой строки» описывает смысл, а не способ выполнения. Ещё в 1982 году Ким показал, как преобразовывать вложенные запросы в соединения 9, и современные оптимизаторы, включая PostgreSQL, превращают многие коррелированные подзапросы в EXISTS/IN в полусоединения и антисоединения. Скалярный коррелированный подзапрос в списке SELECT PostgreSQL 16 выполняет как SubPlan — действительно по разу на строку, что на больших таблицах бывает медленно (тема 11).
LATERAL, полусоединение, антисоединение и деление
LATERAL: топ-3 в каждой рубрике
Подзапрос в FROM по стандарту не может ссылаться на другие таблицы того же FROM: производная таблица вычисляется независимо. Ключевое слово LATERAL (стандарт SQL:1999, PostgreSQL 9.3) снимает это ограничение: подзапрос, помеченный LATERAL, может ссылаться на столбцы таблиц, стоящих в FROM левее, и вычисляется логически для каждой их строки 57. По сути это коррелированный подзапрос, который возвращает не одно значение, а целую таблицу — несколько строк и столбцов.
Классическая задача для LATERAL — «первые N в каждой группе». Три самые дорогие книги в каждой подрубрике раздела «Базы данных» (рубрика 13):
SELECT c.category_id, c.name, t.book_id, t.title, t.price
FROM category c
CROSS JOIN LATERAL (
        SELECT b.book_id, b.title, b.price
        FROM book b
        WHERE b.category_id = c.category_id
        ORDER BY b.price DESC, b.book_id
        LIMIT 3) AS t
WHERE c.parent_id = 13
ORDER BY c.category_id, t.price DESC, t.book_id;
 category_id |    name    | book_id |            title             |  price
-------------+------------+---------+------------------------------+---------
          21 | PostgreSQL |    1477 | Тайна чисел 1477             | 2969.99
          21 | PostgreSQL |    1849 | Основы северного ветра 1849  | 2959.99
          21 | PostgreSQL |     616 | Основы вычислений 616        | 2919.99
          22 | NoSQL      |      21 | Искусство забытого города 21 | 2949.99
          22 | NoSQL      |    1651 | Хроники северного ветра 1651 | 2949.99
          22 | NoSQL      |    1533 | Введение в алгоритмов 1533   | 2919.99
(6 rows)
Для каждой строки category подзапрос получает её category_id, сортирует книги этой рубрики и оставляет три. Рисунок поясняет, как строится результат. Сделать то же обычным подзапросом в FROM нельзя — у него нет доступа к текущей рубрике, а ORDER BY … LIMIT 3 без LATERAL дал бы три книги на всю таблицу.
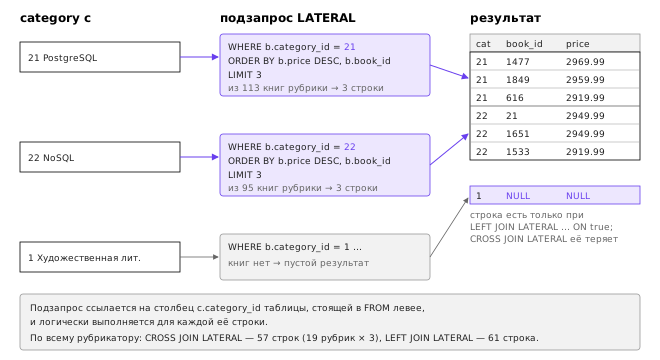
Как и обычное соединение, CROSS JOIN LATERAL отбрасывает строки, для которых подзапрос пуст. По всему рубрикатору он возвращает 57 строк — по три для каждой из 19 рубрик с книгами; четыре рубрики верхнего уровня, в которых нет книг, исчезают. Чтобы их сохранить, используется внешний вариант LEFT JOIN LATERAL (…) AS t ON true — он даёт 61 строку, из них четыре с NULL вместо книги. Та же задача решается оконными функциями (row_number() OVER (PARTITION BY …), тема 5); LATERAL выгоден, когда групп мало, строк в группах много и есть индекс по ключу группы и сортировки — тогда для каждой группы читается лишь несколько строк.
EXISTS и NOT EXISTS: полусоединение и антисоединение
Предикат EXISTS (подзапрос) истинен, если подзапрос возвращает хотя бы одну строку; что именно он возвращает, не важно, поэтому принято писать SELECT 1 6. Коррелированный EXISTS — прямая запись полусоединения R ⋉ S, NOT EXISTS — антисоединения R ▷ S. В отличие от соединения, EXISTS не размножает строки: покупатель, оставивший десять отзывов, войдёт в ответ один раз.
Покупатели без заказов — антисоединение — записываются по меньшей мере четырьмя способами, и на учебной базе все дают 621 строку:
-- 1. NOT EXISTS
SELECT c.customer_id FROM customer c
WHERE NOT EXISTS (SELECT 1 FROM orders o WHERE o.customer_id = c.customer_id);

-- 2. LEFT JOIN ... IS NULL
SELECT c.customer_id FROM customer c
LEFT JOIN orders o ON o.customer_id = c.customer_id
WHERE o.customer_id IS NULL;

-- 3. NOT IN
SELECT c.customer_id FROM customer c
WHERE c.customer_id NOT IN (SELECT o.customer_id FROM orders o);

-- 4. EXCEPT
SELECT customer_id FROM customer
EXCEPT
SELECT customer_id FROM orders;
Формы 1 и 2 PostgreSQL выполняет одинаково — узлом Anti Join (форму 2 — только если на NULL проверяется столбец из условия соединения; при проверке o.order_id IS NULL строится внешнее соединение с последующим фильтром, результат тот же). Самосоединение и внешние соединения в задачах «найти строки без пары» подробно разобраны в учебнике 11. Форма 4 возвращает только столбцы, участвующие в разности; чтобы получить имя и город покупателя, её результат пришлось бы снова соединить с customer. Форма 3 работает здесь правильно лишь потому, что orders.customer_id объявлен NOT NULL; в общем случае она опасна.
NOT IN и NULL
Ловушка NOT IN упоминалась в теме 2; здесь она проявляется в полную силу. Условие x NOT IN (v1, v2, v3) означает x <> v1 AND x <> v2 AND x <> v3. Если хотя бы одно vi — NULL, соответствующее сравнение даёт неизвестность, и вся конъюнкция может быть только ложной или неизвестной, но не истинной. Поэтому NOT IN с подзапросом, вернувшим хотя бы один NULL, не возвращает ни одной строки 63.
Найдём склады в городах, где нет издательств:
SELECT city FROM warehouse
WHERE city NOT IN (SELECT city FROM publisher);
 city
------
(0 rows)
SELECT city FROM warehouse w
WHERE NOT EXISTS (SELECT 1 FROM publisher p WHERE p.city = w.city);
    city
-------------
 Казань
 Новосибирск
(2 rows)
Правильный ответ — Казань и Новосибирск, но NOT IN вернул пустой результат: у издательства «Северный узел» город не указан, и для Казани условие превратилось в «Казань ≠ Москва И … И Казань ≠ NULL», то есть в неизвестность. NOT EXISTS такой ловушки не имеет: внутреннее условие p.city = w.city для строки с NULL просто не истинно, и строка-кандидат не находится. Практическое правило: для антисоединения использовать NOT EXISTS (или LEFT JOIN … IS NULL); NOT IN допустим только с подзапросом по столбцу NOT NULL или со списком констант. Кроме корректности, у NOT EXISTS есть и преимущество в скорости: PostgreSQL превращает его в антисоединение, а NOT IN с подзапросом — нет, потому что их семантика при NULL различается (тема 11).
Симметричная, но менее опасная особенность есть и у NOT EXISTS: строка внешнего запроса с NULL в столбце сравнения попадает в ответ антисоединения, так как пары для неё не находится. Покупатели с неизвестным городом войдут в ответ на вопрос «покупатели из городов без издательств» через NOT EXISTS и не войдут через NOT IN даже со списком без NULL. Какой ответ правилен — решает постановка задачи, и это стоит оговаривать явно.
Деление в SQL: покупатели, купившие все книги серии
В SQL нет оператора деления, и вопрос «для всех» переформулируется через двойное отрицание: «покупатель купил все книги серии» равносильно «нет такой книги серии, которую покупатель не купил» 101. Каждое «нет такого» записывается NOT EXISTS. Книги серии «Миры Стругацких» отмечены в attrs (оператор ->> извлекает значение из JSONB, тема 9):
SELECT c.customer_id, c.full_name
FROM customer c
WHERE NOT EXISTS (
        SELECT 1
        FROM book b
        WHERE b.attrs ->> 'series' = 'Миры Стругацких'
          AND NOT EXISTS (
                SELECT 1
                FROM orders o
                JOIN order_item oi ON oi.order_id = o.order_id
                WHERE o.customer_id = c.customer_id
                  AND oi.book_id = b.book_id))
ORDER BY c.customer_id;
Запрос возвращает 17 покупателей (первые — 1 Анна Фролов, 11 Пётр Жуков, 13 Анна Титов). Читается он изнутри наружу: самый внутренний подзапрос проверяет, купил ли покупатель c книгу b; средний ищет книгу серии, для которой такой покупки нет; внешний оставляет покупателей, для которых такой книги не нашлось.
Ту же мысль можно записать через разность: «множество книг серии минус множество книг покупателя пусто».
SELECT count(*)
FROM customer c
WHERE NOT EXISTS (
        SELECT book_id FROM book WHERE attrs ->> 'series' = 'Миры Стругацких'
        EXCEPT
        SELECT oi.book_id
        FROM orders o JOIN order_item oi ON oi.order_id = o.order_id
        WHERE o.customer_id = c.customer_id);      -- 17
Есть и третья формулировка — через подсчёт: покупатель подходит, если число различных купленных им книг серии равно числу книг серии; она требует группировки и рассматривается в теме 5. Все формулировки наследуют особенность алгебраического деления при пустом делителе: если в серии нет книг (например, серия названа с опечаткой), условие «нет такой книги, которую покупатель не купил» истинно для всех, и запрос возвращает всех 5000 покупателей, включая тех, кто не сделал ни одного заказа. Если такой ответ нежелателен, к условию добавляют проверку, что делитель не пуст, или ограничивают кандидатов покупателями, у которых есть заказы.
Эквивалентные формулировки и чтение запросов
Один вопрос — несколько запросов
SQL позволяет записать один и тот же вопрос многими способами, и умение переходить между формулировками полезно и для понимания, и для оптимизации. Возьмём вопрос «покупатели из Казани, оставившие хотя бы один отзыв с оценкой 2» и сравним пять формулировок:
| Формулировка | Строк |
|---|---|
customer JOIN review … WHERE city = 'Казань' AND rating = 2 | 157 |
то же с SELECT DISTINCT c.customer_id, c.full_name | 122 |
WHERE city = 'Казань' AND customer_id IN (SELECT customer_id FROM review WHERE rating = 2) | 122 |
WHERE city = 'Казань' AND EXISTS (SELECT 1 FROM review r WHERE r.customer_id = c.customer_id AND r.rating = 2) | 122 |
SELECT customer_id FROM customer WHERE city = 'Казань' INTERSECT SELECT customer_id FROM review WHERE rating = 2 | 122 |
Соединение отвечает на другой вопрос — «отзывы с оценкой 2, оставленные покупателями из Казани»: покупатель с тремя такими отзывами даёт три строки, отсюда 157 вместо 122. DISTINCT исправляет число строк, но, как было показано выше, только если в списке выборки есть уникальный ключ покупателя: без customer_id два разных покупателя с одинаковым именем слились бы в одну строку. IN и EXISTS — полусоединения, они выражают вопрос точнее всего, и PostgreSQL выполняет их одинаково. INTERSECT даёт верное множество номеров, но других столбцов не вернёт.
Выбор формулировки определяется смыслом вопроса. Если результату нужны столбцы обеих таблиц — соединение. Если вторая таблица служит только условием «есть / нет» — EXISTS или NOT EXISTS. Если вопрос содержит «все» — двойное NOT EXISTS. Если нужны «первые N в каждой группе» — LATERAL или оконные функции. Проверить, что две формулировки эквивалентны на данных, можно приёмом из темы 3: обе разности EXCEPT должны быть пусты. Но совпадение на одних данных не доказывает эквивалентности: формулировки с NOT IN и NOT EXISTS совпадают, пока в данных нет NULL, и расходятся, как только NULL появляется. Доказательство эквивалентности — рассуждение на уровне алгебры и трёхзначной логики, а не тест.
Как читать сложный запрос
Запрос из нескольких соединений и вложенных подзапросов удобно читать в логическом порядке выполнения, а не сверху вниз:
- Начать с
FROM: какие таблицы соединяются, по каким условиям, какие соединения внешние; построить мысленно путь по внешним ключам и оценить, не размножаются ли строки. - Прочитать
WHERE: какие условия относятся к левой таблице, какие к правой; нет ли условия на правую таблицу внешнего соединения, превращающего его во внутреннее. - Каждый подзапрос прочитать как отдельный вопрос: коррелирован ли он (есть ли ссылки на внешние таблицы), что он возвращает — одно значение, столбец, таблицу; какой операции алгебры соответствует (полусоединение, антисоединение, деление).
- Проверить граничные случаи: пустой подзапрос (
ALL, деление), NULL в подзапросе (NOT IN,ALL), строки без пары (внутреннее соединение их теряет). - Только после этого прочитать список
SELECT,DISTINCTиORDER BY.
Полезно также переписывать запрос в выражение алгебры: если в нём есть отрицание, оно должно стоять на месте разности или антисоединения, если есть «все» — на месте деления. Расхождение формулировки вопроса и структуры запроса обычно и указывает на ошибку.
Итоги темы
Соединения в SQL — прямое воплощение операций алгебры. CROSS JOIN — декартово произведение, JOIN … ON — тета-соединение, USING — эквисоединение по перечисленным одноимённым столбцам, NATURAL JOIN — естественное соединение, которое из-за неявного условия ломается при изменении схемы или данных и поэтому почти не используется. Соединение нескольких таблиц идёт по цепочке внешних ключей, самосоединение с псевдонимами позволяет сравнивать строки одной таблицы и спускаться по уровням дерева рубрик.
Внешние соединения сохраняют строки без пары, дополняя их NULL. Условие на правую таблицу внешнего соединения должно стоять в ON: в WHERE оно отбрасывает дополненные строки и превращает соединение во внутреннее — на учебной базе 584 строки вместо 72. Внешнее соединение с проверкой IS NULL первичного ключа — одна из формулировок антисоединения.
Соединение с таблицей «многих» размножает строки, а соединение с двумя независимыми таблицами «многих» строит произведение внутри каждой группы: сумма платежей за месяц выросла втрое. Защита — не соединять таблицу, нужную только для условия (использовать EXISTS), сводить таблицы «многих» к одной строке на ключ до соединения и сверять число строк с числом объектов вопроса, а не прятать размножение за DISTINCT.
Подзапросы бывают скалярными, табличными в FROM, коррелированными и LATERAL. EXISTS и NOT EXISTS выражают полусоединение и антисоединение, двойное NOT EXISTS — деление. Граничные случаи требуют внимания: ALL и деление истинны на пустом множестве, NOT IN с NULL в подзапросе не возвращает строк. В теме 5 к соединениям и подзапросам добавятся группировка и агрегатные функции, которые позволят строить отчёты без размножения строк, а оконные функции дадут ещё один способ решения задачи «первые N в группе».
Литература
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Garcia-Molina H., Ullman J. D., Widom J. Database Systems: The Complete Book. 2nd ed. — Pearson Prentice Hall, 2008.
- Дейт К. Дж. Введение в системы баз данных. 8-е изд. — М.: Вильямс, 2005.
- ISO/IEC 9075-2:2023. Information technology — Database languages SQL — Part 2: Foundation (SQL/Foundation). — ISO, 2023.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 7.2. Table Expressions. — 2024. https://www.postgresql.org/docs/16/queries-table-expressions.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 9.23. Subquery Expressions. — 2024. https://www.postgresql.org/docs/16/functions-subquery.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. SELECT. — 2024. https://www.postgresql.org/docs/16/sql-select.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 4.2. Value Expressions. — 2024. https://www.postgresql.org/docs/16/sql-expressions.html
- Kim W. On Optimizing an SQL-like Nested Query. — ACM Transactions on Database Systems, 1982, Т. 7, № 3, С. 443–469, DOI: 10.1145/319732.319745.
- Celko J. Joe Celko's SQL for Smarties: Advanced SQL Programming. 5th ed. — Morgan Kaufmann, 2014.
- Новиков Б. А., Горшкова Е. А., Графеева Н. Г. Основы технологий баз данных. 2-е изд. — М.: ДМК Пресс, 2020.
- Codd E. F. A Relational Model of Data for Large Shared Data Banks. — Communications of the ACM, 1970, Т. 13, № 6, С. 377–387, DOI: 10.1145/362384.362685.