
Агрегирование, группировка и оконные функции
В темах 3 и 4 каждая строка результата запроса соответствовала одной строке или одной комбинации строк исходных таблиц: выборка отбрасывает строки, проекция — столбцы, соединение склеивает строки разных таблиц. Но большинство вопросов, которые задают базе данных руководитель магазина и аналитик, устроены иначе: «сколько заказов было в марте», «какая рубрика приносит больше выручки», «какой средний рейтинг у книги», «как изменилась выручка по сравнению с прошлым месяцем». Ответ на такой вопрос — сводка по многим строкам, а не сами строки.
Тема посвящена трём механизмам SQL, которые порождают такие сводки. Агрегатные функции сворачивают множество значений в одно. Группировка разбивает строки на группы и применяет агрегат к каждой группе отдельно; её расширения — наборы группирования, ROLLUP и CUBE — строят в одном запросе итоги на нескольких уровнях детализации. Оконные функции вычисляют сводку по «окну» соседних строк, не схлопывая сами строки, и тем самым позволяют в одном запросе сравнить строку с её группой, с предыдущей строкой или с накопленным итогом. Вместе эти механизмы составляют основу аналитических запросов, и понимать их нужно не на уровне синтаксиса, а на уровне модели: какое множество строк видит агрегат в каждой точке запроса.
Первый раздел вводит агрегатные функции, второй — группировку и фильтры WHERE, HAVING и FILTER, третий — многоуровневые итоги, четвёртый — оконные функции и рамку окна, пятый — типовые аналитические задачи. Все запросы выполнены на учебной базе «Книжный узел» (scale=1) в PostgreSQL 16 с search_path = bookstore; генератор данных детерминирован, поэтому у вас получатся те же числа (оговорка о часовом поясе — в лабораторной работе).
Агрегатные функции
От множества значений к одному значению
Агрегатная функция (англ. aggregate function) принимает на вход мультимножество значений — по одному от каждой строки, участвующей в вычислении, — и возвращает одно значение 1. Классический набор, закреплённый ещё в первых версиях стандарта SQL, — count, sum, avg, min и max; современный стандарт и PostgreSQL добавляют к нему десятки функций, в том числе статистические (stddev, var_samp, corr), логические (bool_and, bool_or), функции сборки (string_agg, array_agg, json_agg) и упорядоченные агрегаты (percentile_cont, mode) 25.
Если в запросе есть агрегат, но нет GROUP BY, вся таблица (точнее, всё, что осталось после FROM и WHERE) считается одной группой, и результат состоит ровно из одной строки:
SELECT count(*), count(publisher_id), count(DISTINCT publisher_id),
       sum(price), avg(price), min(price), max(price)
FROM book;
 count | count | count |    sum     |          avg          | min  |   max
-------+-------+-------+------------+-----------------------+------+---------
  2010 |  1915 |    10 | 3151150.00 | 1567.7363184079601990 | 0.00 | 3990.00
(1 row)
Уже в этом коротком примере видны три разных значения count. Форма count(*) считает строки — любые, независимо от содержимого. Форма count(выражение) считает строки, в которых выражение не равно NULL: у 95 книг издательство не указано, поэтому count(publisher_id) на 95 меньше. Форма count(DISTINCT выражение) считает различные значения, отличные от NULL: книги выпущены десятью издательствами. Функция avg над столбцом типа numeric возвращает numeric с большим числом знаков после запятой; в отчётах её результат округляют функцией round(значение, 2).
Агрегат удобно представлять как свёртку: начальное состояние, функция перехода, поглощающая очередное значение, и финальная функция, превращающая состояние в результат; так агрегаты и описываются в PostgreSQL 1. У sum состояние — текущая сумма, у avg — пара «сумма и количество». Отсюда следует, что агрегат вычисляется за один проход и допускает вычисление по частям с последующим объединением (на этом основано параллельное агрегирование — тема 11).
NULL и пустое множество
Все агрегатные функции, кроме count(*), пропускают NULL: значение NULL просто не поступает в функцию перехода 12. Следствие, о котором часто забывают: avg(x) — это sum(x) / count(x), а не sum(x) / count(*). Если у трёх из десяти покупателей неизвестен возраст, средний возраст вычисляется по семи известным значениям, и это обычно именно то, что нужно. Но если NULL в столбце означает «ноль» (например, скидка не предоставлялась), среднее окажется завышенным, и NULL нужно явно заменить: avg(coalesce(discount, 0)).
Второй особый случай — пустое множество строк. Стандарт SQL требует, чтобы count от пустого множества возвращал 0, а остальные агрегаты — NULL 5:
SELECT count(*), sum(price), avg(price), max(price)
FROM book
WHERE price > 100000;
 count | sum | avg | max
-------+-----+-----+-----
     0 |     |     |
(1 row)
С точки зрения математики сумма пустого множества равна нулю, и NULL здесь выглядит странно; К. Дейт неоднократно критиковал это решение стандарта 8. Практическое правило: если сумма пустого множества должна печататься как 0, это делается явно — coalesce(sum(price), 0). Обратите внимание и на то, что запрос без GROUP BY возвращает одну строку даже тогда, когда ни одна строка не прошла фильтр; запрос с GROUP BY в той же ситуации вернёт ноль строк, потому что групп нет.
Различие count(*) и count(столбец) становится принципиальным во внешних соединениях. Корневые рубрики учебной базы («Художественная литература», «Компьютерная литература» и т. д.) книг не содержат: книги привязаны к подрубрикам. Попробуем посчитать книги в рубриках левым соединением:
SELECT c.category_id, c.name,
       count(*)         AS cnt_star,
       count(b.book_id) AS cnt_books
FROM category c
LEFT JOIN book b ON b.category_id = c.category_id
WHERE c.category_id IN (1, 3, 12, 13, 21)
GROUP BY c.category_id, c.name
ORDER BY c.category_id;
 category_id |           name            | cnt_star | cnt_books
-------------+---------------------------+----------+-----------
           1 | Художественная литература |        1 |         0
           3 | Компьютерная литература   |        1 |         0
          12 | Программирование          |      119 |       119
          13 | Базы данных               |      114 |       114
          21 | PostgreSQL                |      113 |       113
(5 rows)
Для рубрики без книг левое соединение порождает одну строку, в которой столбцы книги заполнены NULL (тема 4). Выражение count(*) считает эту строку и выдаёт ложную единицу, а count(b.book_id) — правильный ноль. Правило: в запросах с внешним соединением считают значения столбца внутренней таблицы, причём такого, который не может быть NULL в настоящих строках (лучше всего — первичного ключа).
Сборка значений: string_agg, array_agg, bool_and
Не все агрегаты возвращают число. Функция string_agg(выражение, разделитель) склеивает строки через разделитель, array_agg(выражение) собирает значения в массив, bool_and и bool_or вычисляют логические «и» и «или» по всем значениям (в стандарте SQL они называются EVERY и ANY/SOME) 2. Для функций сборки важен порядок, а мультимножество строк порядка не имеет; поэтому порядок указывается внутри вызова агрегата — ORDER BY в скобках после аргументов. Там же допустим DISTINCT:
SELECT b.book_id, b.title, count(*) AS authors,
       string_agg(a.full_name, ', ' ORDER BY ba.author_order) AS names
FROM book b
JOIN book_author ba USING (book_id)
JOIN author a USING (author_id)
WHERE b.book_id <= 10
GROUP BY b.book_id
HAVING count(*) > 1
ORDER BY b.book_id;
 book_id |       title       | authors |                names
---------+-------------------+---------+--------------------------------------
       4 | Пикник на обочине |       2 | Аркадий Стругацкий, Борис Стругацкий
       5 | Трудно быть богом |       2 | Аркадий Стругацкий, Борис Стругацкий
(2 rows)
Логические агрегаты удобны для вопросов вида «у всех ли…» и «есть ли хотя бы один…»: например, bool_and(status = 'delivered') в группе по покупателю отвечает, все ли его заказы доставлены, а bool_or(status = 'cancelled') — был ли хотя бы один отменённый. Отдельный класс составляют упорядоченные агрегаты (англ. ordered-set aggregates) — медиана и процентили, для которых нужен не порядок сборки, а порядок значений: percentile_cont(0.5) WITHIN GROUP (ORDER BY x) 2. Медиана числа отзывов на книгу в учебной базе равна 5 при среднем 6,9: распределение скошено, несколько популярных книг собирают сотни отзывов.
Точность сумм: numeric и float
Денежные суммы в учебной базе хранятся в типе numeric(10,2) — десятичном числе с фиксированной точностью. Сумма значений numeric вычисляется точно, тогда как суммирование двоичных чисел с плавающей точкой (real, double precision) накапливает ошибки округления, потому что большинство десятичных дробей (0,1, 0,01) в двоичной системе непредставимы точно:
SELECT sum(oi.quantity * oi.price)           AS exact,
       sum((oi.quantity * oi.price)::float8) AS approx,
       sum((oi.quantity * oi.price)::real)   AS r
FROM order_item oi;
    exact     |       approx       |       r
--------------+--------------------+----------------
 122692201.56 | 122692201.55991654 | 1.22649424e+08
(1 row)
Сумма в double precision отличается от точной на доли копейки, а в real (около 7 значащих цифр) — на десятки тысяч рублей. Для денег используется numeric; выбор типов и устройство чисел с плавающей точкой подробно рассматриваются в теме 9.
Группировка строк
GROUP BY: разбиение на группы
Предложение GROUP BY разбивает строки, оставшиеся после FROM и WHERE, на группы: в одну группу попадают строки с одинаковыми значениями выражений группировки 3. Каждая группа порождает ровно одну строку результата, а агрегатные функции вычисляются по строкам своей группы. В терминах реляционной алгебры это отдельная операция группировки с агрегированием, которую обычно обозначают γ (гамма): γ с атрибутами группировки G и списком агрегатов F отображает отношение в отношение, где каждому различному значению G соответствует один кортеж 6.
Разберём группировку вручную на маленьком отношении — первых десяти книгах учебной базы. Сгруппируем их по издательству:
SELECT publisher_id, count(*) AS books, sum(price) AS total,
       round(avg(price), 2) AS avg_price,
       string_agg(book_id::text, ',' ORDER BY book_id) AS ids
FROM book
WHERE book_id <= 10
GROUP BY publisher_id
ORDER BY publisher_id NULLS LAST;
 publisher_id | books |  total  | avg_price |  ids
--------------+-------+---------+-----------+--------
            2 |     2 | 2390.00 |   1195.00 | 8,9
            3 |     3 | 1540.00 |    513.33 | 2,6,10
            4 |     3 | 2350.00 |    783.33 | 1,4,5
            7 |     1 |  390.00 |    390.00 | 3
              |     1 | 3990.00 |   3990.00 | 7
(5 rows)
Проверим результат вручную. Издательство 3 («Эксмо») выпустило книги 2, 6 и 10 по ценам 450, 480 и 610 рублей; их сумма 1540, среднее 1540 / 3 = 513,33. Издательство 2 («ДМК Пресс») — книги 8 и 9 по 2390 и 0 рублей (бесплатная электронная книга); среднее 1195, и ноль честно участвует в нём, потому что ноль — это значение, а не NULL. Наконец, у книги 7 («Искусство программирования» Кнута) издательство не указано, и она образовала собственную группу с ключом NULL. Это важная особенность: при сравнении значений NULL = NULL даёт «неизвестно» (тема 2), но для группировки, как и для DISTINCT, все NULL считаются одинаковыми и попадают в одну группу 35. Схема на рисунке ниже показывает, как десять строк превращаются в пять.
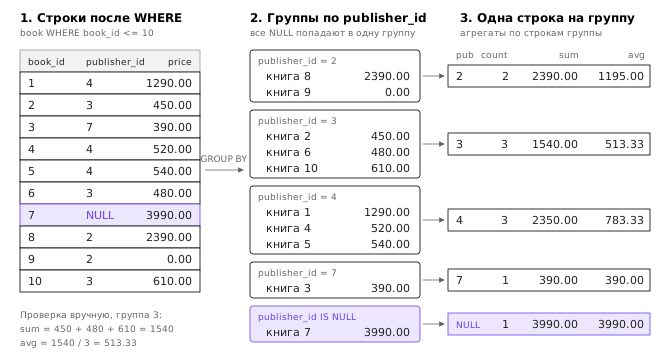
Физически группировка выполняется сортировкой или хеш-таблицей (алгоритмы и их стоимость — в теме 11), но на семантику это не влияет: результат группировки, как любой результат SQL без ORDER BY, не упорядочен.
Какие столбцы можно выбирать: правило функциональной зависимости
После группировки каждая строка результата представляет целую группу. Поэтому в списке SELECT, в HAVING и ORDER BY можно использовать только то, что имеет одно значение на группу: выражения группировки, агрегатные функции и константы. Попытка вывести столбец, который внутри группы может принимать разные значения, — ошибка:
SELECT b.category_id, c.name, count(*)
FROM book b JOIN category c ON c.category_id = b.category_id
GROUP BY b.category_id;
ERROR:  column "c.name" must appear in the GROUP BY clause or be used in an aggregate function
LINE 1: SELECT b.category_id, c.name, count(*)
                              ^
С точки зрения человека запрос корректен: по идентификатору рубрики её название определено однозначно. Но СУБД должна доказать это формально. Стандарт SQL начиная с SQL:1999 разрешает выводить столбец, функционально зависящий от столбцов группировки (A → B означает, что значение A однозначно определяет значение B; подробно — в теме 8) 5. PostgreSQL реализует частный случай: если в GROUP BY перечислены все столбцы первичного ключа таблицы, выводить можно любые её столбцы 3. Здесь группировка идёт по внешнему ключу книги b.category_id, а равенство из условия соединения PostgreSQL для вывода зависимости не использует. Достаточно группировать по первичному ключу той таблицы, чьи столбцы выводятся:
SELECT c.category_id, c.name, count(*) AS books
FROM book b JOIN category c ON c.category_id = b.category_id
GROUP BY c.category_id
ORDER BY books DESC
LIMIT 3;
 category_id |       name       | books
-------------+------------------+-------
           6 | Фантастика       |   124
          12 | Программирование |   119
          13 | Базы данных      |   114
(3 rows)
Правило защищает от бессмысленных результатов: MySQL до версии 5.7 по умолчанию выполнял такие запросы и возвращал значение произвольной строки группы, теперь по умолчанию включён близкий к стандарту режим ONLY_FULL_GROUP_BY. Если зависимости нет, а одно значение на группу всё же нужно, его выбирают явно: min(c.name) или DISTINCT ON (тема 3).
WHERE, HAVING и FILTER
Условие можно поставить в трёх местах запроса с группировкой, и смысл у них разный. WHERE фильтрует строки до группировки и не может содержать агрегатов: в момент его вычисления групп ещё нет. HAVING фильтрует группы после вычисления агрегатов и обычно содержит именно агрегатные условия. Это прямо следует из логического порядка выполнения запроса, введённого в теме 3: FROM → WHERE → GROUP BY → HAVING → SELECT → DISTINCT → ORDER BY → LIMIT:
SELECT book_id, count(*) FROM review WHERE count(*) > 50 GROUP BY book_id;
ERROR:  aggregate functions are not allowed in WHERE
LINE 1: SELECT book_id, count(*) FROM review WHERE count(*) > 50 GRO...
                                                   ^
Типичная задача на HAVING — рейтинг с порогом надёжности. Если отсортировать книги по среднему рейтингу без ограничений, наверху окажутся книги с одним-двумя отзывами по пять баллов, и такой «рейтинг» ничего не говорит. Ограничим выборку книгами, у которых не меньше 50 отзывов (таких 11):
SELECT book_id, count(*) AS reviews, round(avg(rating), 2) AS avg_rating
FROM review
GROUP BY book_id
HAVING count(*) >= 50
ORDER BY avg_rating DESC, book_id
LIMIT 5;
 book_id | reviews | avg_rating
---------+---------+------------
      11 |      59 |       3.88
       8 |      51 |       3.80
       5 |      75 |       3.73
       6 |      64 |       3.69
       1 |     282 |       3.68
(5 rows)
Условие без агрегатов формально можно написать и в HAVING, но правильнее — в WHERE: строки отбрасываются до группировки.
Третье место для условия — предложение FILTER (WHERE …) у отдельного агрегата (SQL:2003, в PostgreSQL с версии 9.4) 111. Оно ограничивает строки, которые поступают в конкретный агрегат, не затрагивая остальные агрегаты и саму группировку. Так строятся сводные таблицы (англ. pivot tables), где значения одного столбца становятся отдельными столбцами отчёта:
SELECT extract(year FROM created_at)::int AS year,
       count(*) AS total,
       count(*) FILTER (WHERE status = 'delivered') AS delivered,
       count(*) FILTER (WHERE status = 'cancelled') AS cancelled,
       count(*) FILTER (WHERE status IN ('new', 'paid', 'shipped')) AS in_progress,
       round(100.0 * count(*) FILTER (WHERE status = 'cancelled') / count(*), 2) AS cancel_pct
FROM orders
GROUP BY year
ORDER BY year;
 year | total | delivered | cancelled | in_progress | cancel_pct
------+-------+-----------+-----------+-------------+------------
 2022 |  6559 |      6071 |       488 |           0 |       7.44
 2023 |  6766 |      6303 |       463 |           0 |       6.84
 2024 |  6675 |      6002 |       474 |         199 |       7.10
(3 rows)
В GROUP BY здесь указан псевдоним year из списка SELECT — расширение PostgreSQL; стандарт требует повторить выражение 3. До появления FILTER сводку писали через count(CASE WHEN status = 'delivered' THEN 1 END): CASE без ELSE даёт NULL, который count пропускает. Множитель 100.0 нужен потому, что деление целых чисел целочисленное (488 * 100 / 6559 даёт 7).
Многоуровневые итоги
Наборы группирования
Отчёт часто требует итогов сразу на нескольких уровнях: выручка по каждому складу и году, итог по каждому складу и общий итог. Обычным GROUP BY это три разных запроса, объединённых UNION ALL, — три прохода по данным и громоздкий текст. Расширение GROUPING SETS (SQL:1999, в PostgreSQL с версии 9.5) позволяет перечислить несколько наборов группирования в одном запросе; результат равен объединению результатов группировки по каждому набору, а столбцы, не входящие в текущий набор, заполняются NULL 35:
SELECT extract(year FROM created_at)::int AS year, status, count(*)
FROM orders
GROUP BY GROUPING SETS ((year), (status), ())
ORDER BY year, status;
 year |  status   | count
------+-----------+-------
 2022 |           |  6559
 2023 |           |  6766
 2024 |           |  6675
      | cancelled |  1425
      | delivered | 18376
      | new       |    69
      | paid      |    63
      | shipped   |    67
      |           | 20000
(9 rows)
Три первые строки получены группировкой по году, следующие пять — по статусу, последняя — по пустому набору (), то есть по всей таблице. Идея обобщённого оператора группировки, порождающего итоги на всех уровнях, была сформулирована в статье Грея и соавторов о «кубе данных» 7 и затем вошла в стандарт.
ROLLUP и CUBE
Две часто встречающиеся комбинации наборов имеют сокращённую запись. ROLLUP (a, b, c) означает иерархию итогов — наборы (a, b, c), (a, b), (a), (); он соответствует отчёту с промежуточными итогами, где a — старший уровень. CUBE (a, b, c) означает все 2³ = 8 подмножеств списка — итоги по всем сочетаниям измерений 37. Число наборов в ROLLUP растёт линейно (n + 1), в CUBE — экспоненциально (2ⁿ), поэтому CUBE применяют к небольшому числу измерений.
Построим отчёт о выручке по складам и годам с итогом по складу и общим итогом. Выручкой будем считать сумму quantity * price по позициям всех заказов, кроме отменённых:
SELECT w.warehouse_id AS wh, w.city,
       extract(year FROM o.created_at)::int AS year,
       sum(oi.quantity * oi.price) AS revenue
FROM orders o
JOIN order_item oi USING (order_id)
JOIN warehouse w USING (warehouse_id)
WHERE o.status <> 'cancelled'
GROUP BY ROLLUP ((w.warehouse_id, w.city), year)
ORDER BY w.warehouse_id, year;
 wh |      city       | year |   revenue
----+-----------------+------+--------------
  1 | Москва          | 2022 |   9550842.18
  1 | Москва          | 2023 |   9615121.20
  1 | Москва          | 2024 |   9290503.09
  1 | Москва          |      |  28456466.47
...
  4 | Казань          | 2022 |   9426751.52
  4 | Казань          | 2023 |   9951079.79
  4 | Казань          | 2024 |   9665281.42
  4 | Казань          |      |  29043112.73
    |                 |      | 113644946.68
(17 rows)
В выводе опущены строки складов 2 и 3. Внутренние скобки (w.warehouse_id, w.city) объединяют два столбца в один элемент свёртки: идентификатор и город склада всегда отбрасываются вместе, и строк вида «склад 1 без города» не появляется. Без скобок ROLLUP (w.warehouse_id, w.city, year) дал бы лишний уровень итогов «по идентификатору склада без города», совпадающий по смыслу с итогом по складу. Сортировка ORDER BY w.warehouse_id, year ставит итоговые строки после детальных, потому что NULL при сортировке по возрастанию в PostgreSQL идёт последним.
Тот же отчёт с CUBE ((w.warehouse_id, w.city), year) содержал бы ещё три строки — итоги по годам без разбивки по складам. Для трёх измерений рост заметнее: GROUP BY CUBE (warehouse_id, extract(year FROM created_at), status) по таблице заказов даёт 90 строк — 36 реально встречающихся комбинаций «склад, год, статус» (в 2022 и 2023 годах есть только статусы delivered и cancelled), 12 + 20 + 9 строк для пар измерений, 4 + 3 + 5 строк для одиночных и общий итог.
Функция GROUPING и два смысла NULL
В отчётах с наборами группирования NULL приобретает второй смысл: он означает не «значение неизвестно», а «по этому столбцу просуммировано». Если в самих данных столбец может быть NULL, строки становятся неразличимы. Книги без издательства дают ровно такой случай (строки десяти издательств в выводе сокращены):
SELECT p.name, GROUPING(p.name) AS g, count(*) AS books
FROM book b
LEFT JOIN publisher p USING (publisher_id)
GROUP BY ROLLUP (p.name)
ORDER BY g, books DESC;
     name      | g | books
---------------+---+-------
 Северный узел | 0 |   215
 ...
               | 0 |    95
               | 1 |  2010
(12 rows)
В результате две строки с пустым названием: 95 книг без издательства и общий итог 2010. Различить их позволяет функция GROUPING(выражение): она возвращает 1, если выражение в данной строке «свёрнуто» (не входит в текущий набор группирования), и 0, если это обычное значение группы 35. При нескольких аргументах GROUPING(a, b) возвращает битовую маску. В отчёте для людей её используют, чтобы подписать итоговые строки: CASE WHEN GROUPING(p.name) = 1 THEN 'Итого' ELSE coalesce(p.name, 'без издательства') END.
Оконные функции
Окно: сводка без схлопывания строк
Группировка отвечает на вопрос о группе, но теряет строки: после GROUP BY category_id отдельных книг в результате уже нет. Между тем многие вопросы требуют одновременно строки и сводки по её окружению: «цена книги и средняя цена в её рубрике», «доля склада в общей выручке», «номер книги в рейтинге рубрики», «выручка месяца и выручка предыдущего месяца». Средствами тем 3–4 их можно решить соединением таблицы с результатом группировки или коррелированным подзапросом, но это громоздко и требует нескольких проходов по данным.
Оконная функция (англ. window function) вычисляет значение для каждой строки по множеству связанных с ней строк — окну (англ. window), — и при этом строки не схлопываются: сколько строк поступило на вход, столько и выходит 41. Синтаксически это агрегатная или специальная функция с предложением OVER, описывающим окно. В стандарт SQL оконные функции вошли в поправке OLAP к SQL:1999 и в SQL:2003, в PostgreSQL — с версии 8.4, полный набор режимов рамки из SQL:2011 — с версии 11 5.
Описание окна состоит из трёх частей, и схема на рисунке ниже показывает их на данных учебной базы:
- раздел (англ. partition),
PARTITION BY выражения, — строки делятся на непересекающиеся разделы, и окно строки никогда не выходит за пределы её раздела; безPARTITION BYвся таблица — один раздел; - порядок,
ORDER BY выражения, — строки внутри раздела упорядочиваются; от порядка зависят ранжирующие функции, функции смещения и рамка; - рамка (англ. frame),
ROWS/RANGE/GROUPS BETWEEN … AND …, — подмножество раздела, по которому агрегат вычисляется для текущей строки.
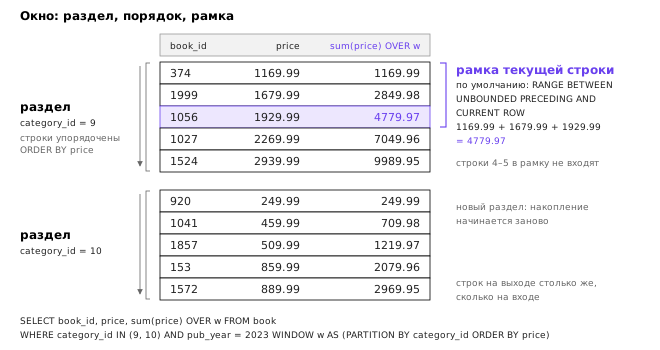
Сравним группировку и окно на первых книгах учебной базы. Посчитаем для каждой книги число книг и среднюю цену в её рубрике и общую сумму цен:
SELECT book_id, category_id, price,
       count(*)   OVER (PARTITION BY category_id) AS cat_books,
       round(avg(price) OVER (PARTITION BY category_id), 2) AS cat_avg,
       sum(price) OVER () AS total
FROM book
WHERE book_id <= 5
ORDER BY category_id, book_id;
 book_id | category_id |  price  | cat_books | cat_avg |  total
---------+-------------+---------+-----------+---------+---------
       1 |           5 | 1290.00 |         2 |  870.00 | 3190.00
       2 |           5 |  450.00 |         2 |  870.00 | 3190.00
       4 |           6 |  520.00 |         2 |  530.00 | 3190.00
       5 |           6 |  540.00 |         2 |  530.00 | 3190.00
       3 |           8 |  390.00 |         1 |  390.00 | 3190.00
(5 rows)
Все пять строк сохранились, а рядом с каждой стоит сводка по её разделу. Окно OVER () — вся выборка, поэтому total одинаков во всех строках. И здесь же видна важнейшая особенность: в рубрике 5 на самом деле 108 книг, а не 2. Оконные функции вычисляются после WHERE, GROUP BY и HAVING, но до DISTINCT, ORDER BY и LIMIT 3; окно видит только строки, прошедшие фильтр. Если нужна сводка по всей рубрике, а вывести требуется лишь несколько книг, окно вычисляют в подзапросе, а фильтруют снаружи:
SELECT *
FROM (SELECT book_id, category_id, price,
             count(*) OVER (PARTITION BY category_id) AS cat_books,
             round(avg(price) OVER (PARTITION BY category_id), 2) AS cat_avg,
             round(100 * price / sum(price) OVER (PARTITION BY category_id), 2) AS pct_of_cat
      FROM book) s
WHERE book_id <= 3
ORDER BY category_id, book_id;
 book_id | category_id |  price  | cat_books | cat_avg | pct_of_cat
---------+-------------+---------+-----------+---------+------------
       1 |           5 | 1290.00 |       108 | 1551.75 |       0.77
       2 |           5 |  450.00 |       108 | 1551.75 |       0.27
       3 |           8 |  390.00 |       105 | 1626.75 |       0.23
(3 rows)
Из того же порядка выполнения следует, что оконную функцию нельзя использовать в WHERE и HAVING (сообщение window functions are not allowed in WHERE), а псевдоним оконного столбца нельзя использовать в WHERE того же уровня. Фильтр по результату окна всегда ставится во внешнем запросе — этот приём понадобится для задачи «топ-N в группе». Зато оконную функцию можно применить к результату агрегата, потому что окна вычисляются после группировки: выражение sum(sum(x)) OVER () — это сумма групповых сумм по всем группам.
Ранжирование: row_number, rank, dense_rank, ntile
Ранжирующие функции (англ. ranking functions) не имеют аргумента и зависят только от положения строки в упорядоченном разделе 2. Функция row_number() нумерует строки подряд: 1, 2, 3, … rank() присваивает строкам с равными значениями ключа сортировки — они называются равноправными, или пирами (англ. peers), — одинаковый ранг, а следующий ранг пропускает занятые номера: 1, 2, 2, 4. dense_rank() тоже присваивает пирам одинаковый ранг, но без пропусков: 1, 2, 2, 3. ntile(n) делит раздел на n корзин как можно более равного размера и возвращает номер корзины. Цены в учебной базе округлены до десятков рублей, поэтому совпадения встречаются часто:
SELECT book_id, price,
       row_number() OVER w, rank() OVER w, dense_rank() OVER w, ntile(4) OVER w
FROM book
WHERE category_id = 21
WINDOW w AS (ORDER BY price DESC)
ORDER BY price DESC, book_id
LIMIT 10;
 book_id |  price  | row_number | rank | dense_rank | ntile
---------+---------+------------+------+------------+-------
    1477 | 2969.99 |          1 |    1 |          1 |     1
    1849 | 2959.99 |          2 |    2 |          2 |     1
     616 | 2919.99 |          3 |    3 |          3 |     1
    1185 | 2919.99 |          4 |    3 |          3 |     1
    1584 | 2899.99 |          5 |    5 |          4 |     1
     598 | 2869.99 |          6 |    6 |          5 |     1
    1194 | 2849.99 |          7 |    7 |          6 |     1
     518 | 2789.99 |          9 |    8 |          7 |     1
    1702 | 2789.99 |          8 |    8 |          7 |     1
    1973 | 2789.99 |         10 |    8 |          7 |     1
(10 rows)
Предложение WINDOW w AS (…) задаёт имя окна, которое затем используется в нескольких функциях; это сокращает текст и гарантирует, что все функции считаются по одному окну. В рубрике PostgreSQL 113 книг, поэтому в каждую из четырёх корзин ntile(4) попадает 28 или 29 книг, и все показанные строки лежат в первой.
Обратим внимание на книги стоимостью 2789,99: row_number выдал им номера 9, 8 и 10 — не в порядке book_id. Это не ошибка. Для пиров порядок внутри окна не определён, и row_number нумерует их в том порядке, в котором строки случайно оказались после сортировки; внешний ORDER BY … book_id переупорядочил результат уже после вычисления окна. Такой результат недетерминирован: при другом плане выполнения или другой версии СУБД номера могут распределиться иначе. Если номер строки должен быть воспроизводимым, в ORDER BY окна добавляют уникальный ключ: ORDER BY price DESC, book_id.
Функции смещения: lag, lead, first_value, last_value
Функции смещения (англ. offset functions, value functions) возвращают значение выражения из другой строки окна 2. lag(x, k, по_умолчанию) берёт значение из строки, отстоящей на k строк назад в порядке раздела (по умолчанию k = 1), lead — на k строк вперёд; если такой строки нет, возвращается NULL или значение по умолчанию. first_value, last_value и nth_value(x, n) возвращают значение из первой, последней и n-й строки рамки. Функции lag и lead не зависят от рамки — только от порядка, а first_value, last_value и nth_value вычисляются по рамке, и здесь кроется первая ловушка:
SELECT book_id, price,
       first_value(price) OVER w AS cheapest,
       last_value(price)  OVER w AS last_default,
       last_value(price)  OVER (w ROWS BETWEEN UNBOUNDED PRECEDING
                                    AND UNBOUNDED FOLLOWING) AS dearest
FROM book
WHERE category_id = 9 AND pub_year = 2023
WINDOW w AS (ORDER BY price)
ORDER BY price, book_id;
 book_id |  price  | cheapest | last_default | dearest
---------+---------+----------+--------------+---------
     374 | 1169.99 |  1169.99 |      1169.99 | 2939.99
    1999 | 1679.99 |  1169.99 |      1679.99 | 2939.99
    1056 | 1929.99 |  1169.99 |      1929.99 | 2939.99
    1027 | 2269.99 |  1169.99 |      2269.99 | 2939.99
    1524 | 2939.99 |  1169.99 |      2939.99 | 2939.99
(5 rows)
first_value даёт ожидаемую минимальную цену, а last_value с рамкой по умолчанию просто повторяет цену текущей строки. Причина — рамка по умолчанию заканчивается на текущей строке (точнее, на последнем её пире), и последняя строка рамки — это сама текущая строка. Чтобы получить последнюю строку раздела, рамку расширяют до UNBOUNDED FOLLOWING. Конструкция OVER (w ROWS …) дополняет именованное окно рамкой; изменить в нём раздел или порядок таким способом нельзя.
Рамка окна: ROWS, RANGE, GROUPS и рамка по умолчанию
Рамка задаётся границами начала и конца относительно текущей строки: UNBOUNDED PRECEDING (начало раздела), n PRECEDING, CURRENT ROW, n FOLLOWING, UNBOUNDED FOLLOWING (конец раздела). Смысл слов «n строк назад» и «текущая строка» определяет режим рамки 14:
ROWS— смещения считаются в физических строках:ROWS BETWEEN 2 PRECEDING AND CURRENT ROW— текущая строка и две предыдущие, независимо от значений;RANGE— смещения считаются в значениях ключа сортировки:RANGE BETWEEN INTERVAL '2 days' PRECEDING AND CURRENT ROW— все строки, у которых дата не более чем на два дня меньше даты текущей строки;CURRENT ROWв этом режиме означает «текущая строка вместе со всеми её пирами»; режим с числовым смещением требует ровно одного выражения вORDER BY;GROUPS— смещения считаются в группах пиров:GROUPS BETWEEN 1 PRECEDING AND CURRENT ROW— группа пиров текущей строки и одна предыдущая группа.
Дополнительно предложение EXCLUDE (CURRENT ROW, GROUP, TIES) позволяет исключить из рамки текущую строку или её пиров. Если рамка не указана, действует рамка по умолчанию: RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW 1. При наличии ORDER BY это все строки от начала раздела до текущей и всех её пиров; без ORDER BY все строки раздела — пиры друг друга, и рамка совпадает со всем разделом. Именно поэтому sum(x) OVER (PARTITION BY g) даёт сумму по группе, а sum(x) OVER (PARTITION BY g ORDER BY t) — накопительную сумму.
Слова «и всех её пиров» — источник распространённой ошибки. Рассмотрим продажи «Войны и мира» (книга 1) в первые дни января 2022 года: в некоторые дни было по два заказа. Посчитаем накопительный итог проданных экземпляров тремя способами:
SELECT o.created_at::date AS day, o.order_id, oi.quantity,
       sum(oi.quantity) OVER (ORDER BY o.created_at::date) AS by_default,
       sum(oi.quantity) OVER (ORDER BY o.created_at::date, o.order_id) AS by_day_and_id,
       sum(oi.quantity) OVER (ORDER BY o.created_at::date
                              GROUPS BETWEEN 1 PRECEDING AND CURRENT ROW) AS groups_2
FROM orders o
JOIN order_item oi USING (order_id)
WHERE oi.book_id = 1 AND o.status <> 'cancelled' AND o.created_at < '2022-01-11'
ORDER BY day, o.order_id;
    day     | order_id | quantity | by_default | by_day_and_id | groups_2
------------+----------+----------+------------+---------------+----------
 2022-01-02 |    11239 |        1 |          2 |             1 |        2
 2022-01-02 |    18890 |        1 |          2 |             2 |        2
 2022-01-03 |      564 |        2 |          5 |             4 |        5
 2022-01-03 |     6352 |        1 |          5 |             5 |        5
 2022-01-05 |    12331 |        3 |          8 |             8 |        6
 2022-01-06 |     1215 |        1 |         10 |             9 |        5
 2022-01-06 |    16195 |        1 |         10 |            10 |        5
 2022-01-07 |     1586 |        1 |         12 |            11 |        4
 2022-01-07 |    16528 |        1 |         12 |            12 |        4
 2022-01-08 |     4295 |        1 |         13 |            13 |        3
 2022-01-10 |     6438 |        1 |         15 |            14 |        3
 2022-01-10 |    14018 |        1 |         15 |            15 |        3
(12 rows)
Столбец by_default построен с рамкой по умолчанию. Второго января было два заказа по одному экземпляру, и обе строки получили итог 2: рамка первой из них включила её пира — второй заказ того же дня. Если нужен итог на конец дня, это правильно, но в построчном отчёте («продано с учётом этого заказа») значения в строках-пирах неверны, и ошибка незаметна, пока в данных нет совпадений ключа. Столбец by_day_and_id исправляет её уникальным ключом order_id в ORDER BY: пиров больше нет, и RANGE … CURRENT ROW совпадает с ROWS … CURRENT ROW. Одного ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW без уникального ключа недостаточно: порядок строк внутри дня останется неопределённым, и при проверке на учебной базе строка заказа 11239 получила итог 2, а выведенная после неё строка заказа 18890 — итог 1. Столбец groups_2 показывает режим GROUPS: сумма за текущий и предыдущий день продаж (6 января — 2 экземпляра 6-го и 3 экземпляра 5-го).
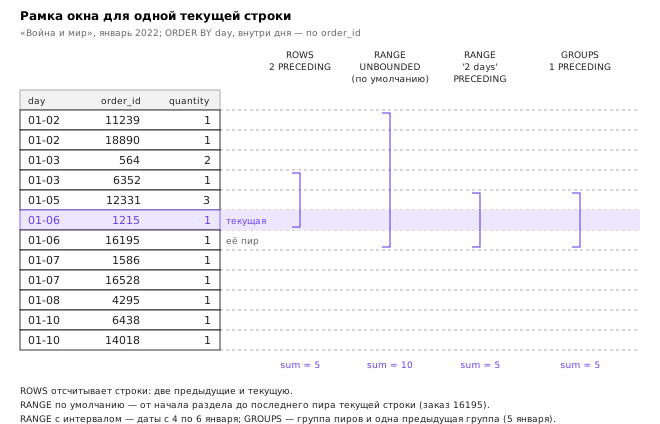
Режимы ROWS и RANGE с числовым смещением различаются, когда значения ключа идут с пропусками. Скользящая сумма за три дня, посчитанная по дневным итогам продаж той же книги:
SELECT day, copies,
       sum(copies) OVER (ORDER BY day ROWS BETWEEN 2 PRECEDING AND CURRENT ROW) AS rows_3,
       sum(copies) OVER (ORDER BY day RANGE BETWEEN INTERVAL '2 days' PRECEDING
                                                AND CURRENT ROW) AS range_3d
FROM (SELECT o.created_at::date AS day, sum(oi.quantity) AS copies
      FROM orders o JOIN order_item oi USING (order_id)
      WHERE oi.book_id = 1 AND o.status <> 'cancelled' AND o.created_at < '2022-01-16'
      GROUP BY day) d
ORDER BY day;
    day     | copies | rows_3 | range_3d
------------+--------+--------+----------
 2022-01-02 |      2 |      2 |        2
 2022-01-03 |      3 |      5 |        5
 2022-01-05 |      3 |      8 |        6
 2022-01-06 |      2 |      8 |        5
 2022-01-07 |      2 |      7 |        7
 2022-01-08 |      1 |      5 |        5
 2022-01-10 |      2 |      5 |        3
 ...
(11 rows)
Всего в выводе 11 строк, последние четыре опущены. Для 5 января ROWS взял три последние строки — 2, 3 и 5 января — и получил 8, хотя 2 января лежит за пределами трёхдневного интервала (3–5 января). RANGE с интервалом взял только строки с датами от 3 по 5 января и получил 6. В днях без продаж строк нет совсем, поэтому «три строки» и «три дня» — разные окна. Если ряд содержит пропуски, есть два правильных решения: окно RANGE с интервалом или предварительное дополнение ряда нулевыми днями, например соединением с generate_series (тема 6).
Место окон в запросе и стоимость
Из логического порядка выполнения следуют четыре правила. Окна вычисляются после группировки и HAVING, поэтому видят только прошедшие фильтры строки и могут принимать агрегаты в качестве аргументов. Окна вычисляются до DISTINCT, ORDER BY и LIMIT, поэтому LIMIT не уменьшает работу окна. Порядок вывода задаётся только внешним ORDER BY, а порядок внутри OVER определяет лишь вычисление функции. Оконные функции разрешены только в списке SELECT и в ORDER BY.
В PostgreSQL окно выполняется узлом WindowAgg: строки сортируются по ключам PARTITION BY и ORDER BY, после чего узел проходит по ним, поддерживая состояние рамки. Если начало рамки неподвижно (UNBOUNDED PRECEDING), состояние агрегата просто наращивается; для скользящих рамок используется обратная функция перехода (англ. inverse transition function), «вычитающая» уходящую из рамки строку, если она определена для агрегата (sum, count, avg по точным типам), иначе рамка пересчитывается целиком 1. Окна с одинаковыми PARTITION BY и ORDER BY обходятся одной сортировкой. Алгоритмы эффективного вычисления окон разобраны в работе Лайса и соавторов 9, планы выполнения — в теме 11.
Аналитические задачи
Доля в итоге и накопительный итог
Доля строки или группы в итоге — классическое применение окна по всей выборке. Поскольку окна вычисляются после группировки, сумму групповых сумм можно взять одним выражением:
SELECT w.warehouse_id AS wh, w.city,
       sum(oi.quantity * oi.price) AS revenue,
       round(100 * sum(oi.quantity * oi.price)
                 / sum(sum(oi.quantity * oi.price)) OVER (), 2) AS pct
FROM orders o
JOIN order_item oi USING (order_id)
JOIN warehouse w USING (warehouse_id)
WHERE o.status <> 'cancelled'
GROUP BY w.warehouse_id
ORDER BY w.warehouse_id;
 wh |      city       |   revenue   |  pct
----+-----------------+-------------+-------
  1 | Москва          | 28456466.47 | 25.04
  2 | Санкт-Петербург | 28421557.87 | 25.01
  3 | Новосибирск     | 27723809.61 | 24.40
  4 | Казань          | 29043112.73 | 25.56
(4 rows)
Внутренний sum — агрегат группы, внешний sum(…) OVER () — оконная функция, суммирующая групповые суммы по всем четырём строкам. Склады в генераторе выбираются равновероятно, поэтому доли близки к 25 %. Здесь же работает правило функциональной зависимости: w.city выводится без включения в GROUP BY, потому что группировка идёт по первичному ключу склада.
Накопительный итог (англ. running total) — сумма с рамкой «от начала до текущей строки». В следующем запросе по месячной выручке первого полугодия 2024 года вычислены сразу четыре показателя: выручка предыдущего месяца (lag), прирост к предыдущему месяцу в процентах, накопительная выручка с начала года и скользящее среднее за три месяца:
SELECT month, revenue,
       lag(revenue) OVER w AS prev,
       round(100 * (revenue / lag(revenue) OVER w - 1), 1) AS growth_pct,
       sum(revenue) OVER w AS running,
       round(avg(revenue) OVER (w ROWS BETWEEN 2 PRECEDING AND CURRENT ROW), 2) AS ma3
FROM (SELECT date_trunc('month', o.created_at)::date AS month,
             sum(oi.quantity * oi.price) AS revenue
      FROM orders o JOIN order_item oi USING (order_id)
      WHERE o.status <> 'cancelled'
        AND o.created_at >= '2024-01-01' AND o.created_at < '2024-07-01'
      GROUP BY month) m
WINDOW w AS (ORDER BY month)
ORDER BY month;
   month    |  revenue   |    prev    | growth_pct |   running   |    ma3
------------+------------+------------+------------+-------------+------------
 2024-01-01 | 3289200.33 |            |            |  3289200.33 | 3289200.33
 2024-02-01 | 3078061.77 | 3289200.33 |       -6.4 |  6367262.10 | 3183631.05
 2024-03-01 | 3265760.20 | 3078061.77 |        6.1 |  9633022.30 | 3211007.43
 2024-04-01 | 3026671.42 | 3265760.20 |       -7.3 | 12659693.72 | 3123497.80
 2024-05-01 | 3188579.88 | 3026671.42 |        5.3 | 15848273.60 | 3160337.17
 2024-06-01 | 3051971.56 | 3188579.88 |       -4.3 | 18900245.16 | 3089074.29
(6 rows)
Проверим март вручную: прирост 3265760,20 / 3078061,77 − 1 ≈ 0,061, то есть 6,1 %; скользящее среднее (3289200,33 + 3078061,77 + 3265760,20) / 3 = 3211007,43. Для января lag возвращает NULL — честный ответ «не с чем сравнивать», а скользящее среднее первых двух месяцев посчитано по одному и двум значениям, потому что рамка у начала раздела короче. Накопительная сумма корректна и с рамкой по умолчанию, потому что месяцы уникальны. Наконец, lag берёт предыдущую строку, а не предыдущий месяц: для рядов с пропусками календарь сначала дополняют.
Топ-N в каждой группе
Задача «три самых продаваемые книги в каждой рубрике» — один из самых частых вопросов к аналитическим базам. В теме 4 она решалась через LATERAL; оконное решение — пронумеровать книги внутри рубрики и отфильтровать номера во внешнем запросе:
SELECT category_id, book_id, sold, rnk
FROM (SELECT b.category_id, b.book_id, sum(oi.quantity) AS sold,
             rank() OVER (PARTITION BY b.category_id
                          ORDER BY sum(oi.quantity) DESC) AS rnk
      FROM book b JOIN order_item oi USING (book_id)
      WHERE b.category_id IN (18, 19, 20)
      GROUP BY b.category_id, b.book_id) t
WHERE rnk <= 3
ORDER BY category_id, rnk, book_id;
 category_id | book_id | sold | rnk
-------------+---------+------+-----
          18 |       84 |  118 |   1
          18 |       74 |   96 |   2
          18 |      168 |   88 |   3
          19 |       42 |  148 |   1
          19 |       48 |  146 |   2
          19 |       40 |  143 |   3
          20 |       18 |  217 |   1
          20 |       23 |  172 |   2
          20 |       31 |  150 |   3
(9 rows)
Выбор ранжирующей функции — это выбор семантики при совпадениях. row_number() <= 3 всегда даёт ровно три строки на группу, но при равенстве третьего и четвёртого мест выбирает одну из книг произвольно. rank() <= 3 включает все книги, разделившие третье место, и строк может быть больше трёх; при равенстве первых трёх мест rank даст 1, 1, 1, 4, и четвёртая книга уже не попадёт в «топ-3». dense_rank() <= 3 отбирает три различных значения показателя — «книги с тремя лучшими результатами продаж», — и строк может быть много больше. Ни один вариант не «правильнее» другого: формулировка бизнес-вопроса должна однозначно указывать, что делать с совпадениями.
Когорты и повторные покупки
Когортный анализ (англ. cohort analysis) делит клиентов на когорты по моменту начала отношений — месяцу регистрации или первой покупки — и прослеживает поведение каждой когорты во времени. Если смешать всех покупателей, рост числа «старых» клиентов маскирует ухудшение удержания новых; когорты делают такие эффекты видимыми. В «Книжном узле» дата регистрации покупателя и даты его заказов сгенерированы независимо, поэтому естественная когорта здесь — квартал первого неотменённого заказа. Вычислим её оконным min по разделу покупателя, а затем посчитаем, сколько покупателей каждой когорты делали заказы через один, два и четыре квартала:
SELECT cohort,
       count(DISTINCT customer_id) AS customers,
       count(DISTINCT customer_id) FILTER (WHERE q = 1) AS q1,
       count(DISTINCT customer_id) FILTER (WHERE q = 2) AS q2,
       count(DISTINCT customer_id) FILTER (WHERE q = 4) AS q4
FROM (SELECT customer_id,
             date_trunc('quarter', min(created_at) OVER c)::date AS cohort,
             qn - min(qn) OVER c AS q
      FROM (SELECT customer_id, created_at,
                   (extract(year FROM created_at) * 4
                    + extract(quarter FROM created_at))::int AS qn
            FROM orders
            WHERE status <> 'cancelled') o
      WINDOW c AS (PARTITION BY customer_id)) s
GROUP BY cohort
ORDER BY cohort;
   cohort   | customers | q1  | q2  | q4
------------+-----------+-----+-----+-----
 2022-01-01 |      1181 | 387 | 371 | 388
 2022-04-01 |       843 | 245 | 238 | 262
 2022-07-01 |       650 | 205 | 196 | 195
 2022-10-01 |       457 | 114 | 127 | 107
 2023-01-01 |       352 | 104 | 107 |  85
 2023-04-01 |       244 |  54 |  63 |  75
 2023-07-01 |       189 |  50 |  53 |  47
 2023-10-01 |       139 |  36 |  27 |  42
 2024-01-01 |        97 |  25 |  23 |   0
 2024-04-01 |        86 |  27 |  24 |   0
 2024-07-01 |        53 |  10 |   0 |   0
 2024-10-01 |        51 |   0 |   0 |   0
(12 rows)
Номер квартала qn = год × 4 + квартал превращает кварталы в последовательные целые числа, и qn − min(qn) — число кварталов от первого заказа. Таблица иллюстрирует два методических эффекта. Цензурирование справа: нули в правом нижнем углу означают не потерю клиентов, а отсутствие данных о будущем, и честный отчёт выводит там NULL. Цензурирование слева: первая когорта самая большая потому, что данные начинаются с января 2022 года и все прежние покупатели «впервые» появляются в этом квартале. Удержание обычно выражают в процентах: из когорты второго квартала 2022 года во втором следующем квартале заказы сделали 238 из 843 покупателей, около 28 %.
Пробелы и острова
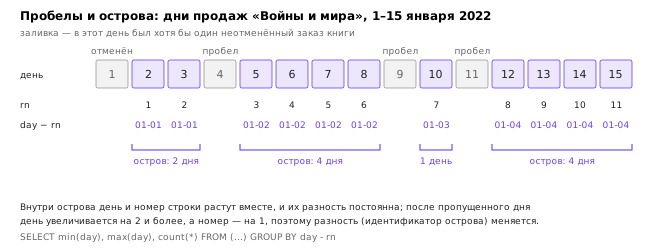
Задача «пробелов и островов» (англ. gaps and islands) — найти в упорядоченной последовательности максимальные непрерывные участки (острова) и разрывы между ними (пробелы) 10. Примеры: периоды непрерывной работы сервиса, серии дней подряд с продажами, диапазоны занятых номеров. Классическое решение основано на простом наблюдении. Пронумеруем элементы последовательности подряд функцией row_number(). Внутри острова и значение, и номер растут на единицу на каждом шаге, поэтому их разность постоянна; при переходе через пробел значение прыгает больше чем на единицу, а номер — ровно на единицу, и разность меняется. Значит, разность «значение минус номер» — идентификатор острова.
Найдём серии дней подряд, в каждый из которых продавался хотя бы один экземпляр «Войны и мира». Для дат разность «дата − целое число» — снова дата, и она одинакова для всех дней острова:
SELECT day, row_number() OVER (ORDER BY day) AS rn,
       day - (row_number() OVER (ORDER BY day))::int AS island
FROM (SELECT DISTINCT o.created_at::date AS day
      FROM orders o JOIN order_item oi USING (order_id)
      WHERE oi.book_id = 1 AND o.status <> 'cancelled') d
WHERE day < '2022-01-16'
ORDER BY day;
    day     | rn |   island
------------+----+------------
 2022-01-02 |  1 | 2022-01-01
 2022-01-03 |  2 | 2022-01-01
 2022-01-05 |  3 | 2022-01-02
 2022-01-06 |  4 | 2022-01-02
 2022-01-07 |  5 | 2022-01-02
 2022-01-08 |  6 | 2022-01-02
 2022-01-10 |  7 | 2022-01-03
 2022-01-12 |  8 | 2022-01-04
 2022-01-13 |  9 | 2022-01-04
 2022-01-14 | 10 | 2022-01-04
 2022-01-15 | 11 | 2022-01-04
(11 rows)
Здесь фильтр day < '2022-01-16' стоит после вычисления окна (во внешнем запросе по отношению к DISTINCT), но поскольку отбрасываются только поздние даты, нумерация первых строк от этого не меняется. Первый январский заказ книги (1 января) был отменён и в выборку не попал. Схема на рисунке ниже показывает тот же расчёт: при каждом пропущенном дне (4, 9, 11 января) идентификатор острова увеличивается.
Остаётся сгруппировать по идентификатору острова и найти самые длинные серии за весь период:
SELECT min(day) AS first_day, max(day) AS last_day, count(*) AS days
FROM (SELECT day, day - (row_number() OVER (ORDER BY day))::int AS island
      FROM (SELECT DISTINCT o.created_at::date AS day
            FROM orders o JOIN order_item oi USING (order_id)
            WHERE oi.book_id = 1 AND o.status <> 'cancelled') d) g
GROUP BY island
ORDER BY days DESC, first_day
LIMIT 5;
 first_day  |  last_day  | days
------------+------------+------
 2022-10-25 | 2022-11-13 |   20
 2022-08-03 | 2022-08-13 |   11
 2022-11-22 | 2022-12-02 |   11
 2023-09-07 | 2023-09-17 |   11
 2024-01-23 | 2024-02-01 |   10
(5 rows)
Самая длинная серия — 20 дней подряд, с 25 октября по 13 ноября 2022 года. Существенное условие метода — уникальность значений: DISTINCT убирает повторы дней, иначе два заказа одного дня получили бы разные номера и разные идентификаторы. Есть и второй способ, полезный, когда «непрерывность» определяется сложнее, чем шагом в единицу (например, «перерыв не больше трёх дней»): функцией lag сравнить каждый элемент с предыдущим, отметить начало нового острова флагом CASE WHEN day - lag(day) OVER (ORDER BY day) > 1 THEN 1 ELSE 0 END, а затем накопительной суммой флагов получить номер острова. Пробелы же — это промежутки между соседними островами: от last_day + 1 одного острова до first_day − 1 следующего, их также удобно получать функцией lead по результату группировки.
Итоги темы
Агрегатная функция сворачивает мультимножество значений в одно. Она пропускает NULL (кроме count(*)), от пустого множества возвращает NULL (кроме count, дающего 0) и может собирать значения в строку или массив в порядке, заданном внутри вызова. Эти правила — источник большинства ошибок в отчётах: count(*) во внешнем соединении считает несуществующую строку, avg по столбцу с NULL делит не на число строк, сумма пустой выборки печатается пустой.
Группировка порождает одну строку на группу, поэтому выводить можно только то, что однозначно определено группой: выражения группировки, агрегаты и, в PostgreSQL, столбцы таблицы, первичный ключ которой входит в группировку. Условие на строки ставится в WHERE, на группы — в HAVING, на строки отдельного агрегата — в FILTER. GROUPING SETS, ROLLUP и CUBE вычисляют итоги нескольких уровней одним запросом, а GROUPING отличает итоговый NULL от NULL в данных.
Оконная функция вычисляет сводку по окну строки, не схлопывая строки. Окно задаётся разделом, порядком и рамкой; ранжирующие функции и lag/lead зависят только от порядка, агрегаты и first_value/last_value — от рамки. Рамка по умолчанию при наличии ORDER BY — RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW, она включает всех пиров текущей строки, и при неуникальном ключе сортировки строки-пиры получают одинаковые накопительные итоги; ROWS без уникального ключа даёт недетерминированный результат. Окна вычисляются после группировки и до ORDER BY и LIMIT, поэтому фильтр по результату окна ставится во внешнем запросе.
На этих механизмах строятся типовые аналитические запросы: доля в итоге, топ-N в группе с осознанным выбором поведения при совпадениях, рост к предыдущему периоду, скользящие средние, когорты и «пробелы и острова». Такие запросы получаются многоуровневыми; в теме 6 будет показано, как общие табличные выражения WITH делают их читаемыми, как сохранить отчёт в представлении или материализованном представлении и как изменять данные операторами INSERT, UPDATE, DELETE и MERGE.
Литература
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Section 4.2. Value Expressions (4.2.7. Aggregate Expressions, 4.2.8. Window Function Calls). — 2023. https://www.postgresql.org/docs/16/sql-expressions.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Sections 9.21. Aggregate Functions; 9.22. Window Functions. — 2023. https://www.postgresql.org/docs/16/functions-aggregate.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Section 7.2. Table Expressions (7.2.3. The GROUP BY and HAVING Clauses, 7.2.4. GROUPING SETS, CUBE, and ROLLUP, 7.2.5. Window Function Processing). — 2023. https://www.postgresql.org/docs/16/queries-table-expressions.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Section 3.5. Window Functions. — 2023. https://www.postgresql.org/docs/16/tutorial-window.html
- ISO/IEC 9075-2:2023. Information technology — Database languages SQL — Part 2: Foundation (SQL/Foundation). — ISO, 2023.
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Gray J., Chaudhuri S., Bosworth A., Layman A., Reichart D., Venkatrao M., Pellow F., Pirahesh H. Data Cube: A Relational Aggregation Operator Generalizing Group-By, Cross-Tab, and Sub-Totals. — Data Mining and Knowledge Discovery, 1997, Т. 1, № 1, С. 29–53, DOI: 10.1023/A:1009726021843.
- Дейт К. Дж. Введение в системы баз данных. 8-е изд. — М.: Вильямс, 2005.
- Leis V., Kundhikanjana K., Kemper A., Neumann T. Efficient Processing of Window Functions in Analytical SQL Queries. — Proceedings of the VLDB Endowment, 2015, Т. 8, № 10, С. 1058–1069, DOI: 10.14778/2794367.2794375.
- Ben-Gan I. T-SQL Window Functions: For Data Analysis and Beyond. 2nd ed. — Microsoft Press, 2020.
- Winand M. Modern SQL: The FILTER Clause. — 2015. https://modern-sql.com/feature/filter