
Изменение данных, общие табличные выражения и представления
В темах 3–5 база данных только читалась: запрос SELECT с соединениями, подзапросами, группировкой и оконными функциями вычислял новое отношение из хранимых, ничего в них не меняя. Но база «Книжного узла» живёт: покупатели оформляют заказы, склады получают поставки, издательства присылают прайсы, цены меняются. Операторы, которые добавляют, изменяют и удаляют строки, образуют язык манипулирования данными (англ. Data Manipulation Language, DML). Остаётся открытым вопрос, как эти операторы связаны с уже изученным SELECT, какие строки они затрагивают и как не испортить данные одной неосторожной командой.
Тема отвечает на этот вопрос и добавляет три средства, которые делают сложные запросы и изменения управляемыми. Общие табличные выражения WITH дают имена промежуточным результатам и позволяют записать многошаговый запрос сверху вниз, как последовательность определений; рекурсивная форма WITH RECURSIVE решает задачи, недоступные обычному SELECT, — обход дерева рубрик произвольной глубины. Представления сохраняют запрос в базе под именем и служат внешним уровнем архитектуры ANSI/SPARC из темы 1; материализованные представления, кроме того, сохраняют и результат запроса.
Сначала разбираются операторы INSERT, UPDATE, DELETE и TRUNCATE, затем — вставка с обработкой конфликта, MERGE и загрузка COPY, далее — общие табличные выражения, рекурсивные запросы и представления. Все примеры выполнены на учебной базе bookstore масштаба scale=1. Примеры, изменяющие данные, выполнены внутри транзакции, которая завершается командой ROLLBACK и отменяет все изменения; в этой теме транзакция используется только как такая страховка, а её свойства и параллельная работа нескольких транзакций — предмет темы 12. Триггеры, позволяющие выполнять собственный код при изменении данных, рассматриваются в теме 14.
Добавление, изменение и удаление строк
Изменение данных как операция над множеством строк
Каждый оператор изменения данных, как и SELECT, работает с множеством строк, а не с одной строкой. UPDATE и DELETE содержат условие WHERE, которое отбирает изменяемые строки ровно по тем же правилам, что и в SELECT: строка затрагивается, если условие истинно, и не затрагивается, если оно ложно или неизвестно 1. Отсюда следует главное правило безопасной работы: прежде чем изменять, выполнить SELECT с тем же условием и посмотреть, какие и сколько строк будут затронуты. Отсюда же — главная опасность: пропущенное или неверное условие затрагивает не одну строку, а все.
BEGIN;
UPDATE book SET price = price * 1.1;     -- забыто условие WHERE
ROLLBACK;
BEGIN
UPDATE 2010
ROLLBACK
Ответ сервера UPDATE 2010 — тег команды (англ. command tag) с числом затронутых строк — сразу показывает ошибку: вместо цен одной книги изменились цены всего каталога. Команда BEGIN открывает транзакцию, и пока она не зафиксирована командой COMMIT, изменения видны только в этом сеансе и могут быть отменены командой ROLLBACK 1. Поэтому разумный порядок ручного изменения данных таков: BEGIN, изменение, проверка тега команды и результата запросом SELECT, затем COMMIT или ROLLBACK. Клиент psql по умолчанию работает в режиме автофиксации: каждая команда вне явного BEGIN фиксируется сразу, и отменить её уже нельзя (подробно о транзакциях — в теме 12).
INSERT: VALUES, значения по умолчанию и INSERT … SELECT
Оператор INSERT добавляет строки в таблицу. Список столбцов после имени таблицы указывает, каким столбцам присваиваются значения; остальные получают значение по умолчанию (англ. default value) из определения таблицы, а если его нет — NULL 2. Явный список столбцов следует писать всегда: запрос без него зависит от порядка столбцов в таблице и сломается, если столбец добавят или переставят.
BEGIN;
INSERT INTO book (isbn, title, publisher_id, category_id, pub_year, pages, price)
VALUES ('9785970612345', 'Грокаем базы данных', 2, 13, 2024, 312, 1490.00)
RETURNING book_id, title, attrs;
ROLLBACK;
 book_id |        title        | attrs
---------+---------------------+-------
    2011 | Грокаем базы данных | {}
(1 row)

INSERT 0 1
Столбец book_id объявлен как GENERATED ALWAYS AS IDENTITY: его значение выдаёт генератор последовательности, и в только что загруженной базе новая книга получает номер 2011. Столбец attrs получил значение по умолчанию '{}'. Предложение RETURNING возвращает строки в том виде, в каком они записаны в таблицу, и позволяет узнать сгенерированный ключ без отдельного запроса; о нём — ниже. Тег INSERT 0 1 означает, что вставлена одна строка (первое число — устаревшее поле, сейчас всегда 0).
Попытка задать значение столбцу GENERATED ALWAYS явно отвергается:
ERROR:  cannot insert a non-DEFAULT value into column "book_id"
DETAIL:  Column "book_id" is an identity column defined as GENERATED ALWAYS.
HINT:  Use OVERRIDING SYSTEM VALUE to override.
Это защищает от рассогласования ключей и генератора; OVERRIDING SYSTEM VALUE нужен только при переносе данных с сохранением ключей. Заметим также, что генератор последовательности не транзакционен: после ROLLBACK номер 2011 не возвращается, и следующая вставка получит 2012. Пропуски в номерах — нормальное явление, и полагаться на сплошную нумерацию нельзя (подробно о генерации ключей — в теме 9).
Одной командой можно вставить несколько строк, перечислив их в VALUES через запятую; ключевое слово DEFAULT вместо значения явно запрашивает значение по умолчанию. Если хотя бы одна строка нарушает ограничение, не вставляется ни одна — команда атомарна:
BEGIN;
INSERT INTO book (isbn, title, category_id, price)
VALUES ('97859706', 'Плохой ISBN', 13, 100);
ROLLBACK;
ERROR:  new row for relation "book" violates check constraint "book_isbn_check"
DETAIL:  Failing row contains (2012, 97859706     , Плохой ISBN, null, 13, null, null, 100.00, {}, null).
Вместо VALUES источником строк может быть любой запрос — это INSERT … SELECT. Так копируют данные между таблицами, заполняют вспомогательные таблицы, переносят данные при изменении схемы (в теме 8 этим способом выполняется нормализация). Например, отменённые заказы 2022 года копируются во временную таблицу той же структуры, созданную конструкцией LIKE:
BEGIN;
CREATE TEMP TABLE cancelled_2022 (LIKE orders);
INSERT INTO cancelled_2022
SELECT * FROM orders
WHERE status = 'cancelled' AND created_at < '2023-01-01';
ROLLBACK;
CREATE TABLE
INSERT 0 488
Здесь SELECT * уместен: таблица-приёмник создана по образцу источника, и порядок столбцов в них совпадает по построению.
UPDATE и DELETE: отбор строк, FROM и USING
Оператор UPDATE присваивает столбцам отобранных строк новые значения; в выражениях справа можно использовать старые значения столбцов этой же строки (price = price * 1.1). Все присваивания одной команды вычисляются по старым значениям строки, поэтому SET a = b, b = a меняет значения местами 3. Оператор DELETE удаляет отобранные строки.
Условие изменения часто зависит от других таблиц. Стандарт SQL позволяет выразить это подзапросом в WHERE, и такая запись работает в любой СУБД: UPDATE book SET … WHERE category_id IN (SELECT …). PostgreSQL, кроме того, допускает предложение FROM в UPDATE и USING в DELETE — расширения стандарта, позволяющие соединить изменяемую таблицу с другими и ссылаться на их столбцы и в условии, и в новых значениях 3. Повысим на 10 % цены платных книг раздела «Базы данных» (рубрика 13) и его подрубрик, округлив до цены вида «…9,99». Сначала — проверочный SELECT с тем же условием:
SELECT count(*)
FROM book b
JOIN category c ON c.category_id = b.category_id
WHERE (c.category_id = 13 OR c.parent_id = 13)
  AND b.price > 0;                                   -- 321

BEGIN;
UPDATE book b
SET price = round(b.price * 1.10, -1) - 0.01
FROM category c
WHERE c.category_id = b.category_id
  AND (c.category_id = 13 OR c.parent_id = 13)
  AND b.price > 0;
ROLLBACK;
UPDATE 321
Число строк совпало с предсказанием: 114 книг рубрики 13, 113 — «PostgreSQL», 95 — «NoSQL», без одной бесплатной. Функция round(x, -1) округляет до десятков: цена 2919.99 становится 3209.99.
У UPDATE … FROM есть ловушка, родственная размножению строк при соединении (тема 4). Если строка изменяемой таблицы соединяется с несколькими строками из FROM, PostgreSQL изменит её один раз, использовав одну из них, причём какую — заранее не определено 3:
BEGIN;
UPDATE book b SET price = v.price
FROM (VALUES (1, 1300.00), (1, 1400.00)) AS v (book_id, price)
WHERE b.book_id = v.book_id;
SELECT price FROM book WHERE book_id = 1;
ROLLBACK;
UPDATE 1
  price
---------
 1300.00
(1 row)
Ни ошибки, ни предупреждения: команда сообщила об одной изменённой строке, а какая из двух цен победила, зависит от плана выполнения. Поэтому источник в FROM должен давать не более одной строки на каждую изменяемую строку — это проверяется заранее запросом к источнику. Как будет показано ниже, MERGE в той же ситуации сообщает об ошибке.
DELETE … USING устроен так же. Удалим из таблицы остатков записи с нулевым количеством по книгам, изданным до 2010 года:
BEGIN;
DELETE FROM stock s
USING book b
WHERE b.book_id = s.book_id
  AND s.quantity = 0
  AND b.pub_year < 2010;
ROLLBACK;
DELETE 76
Удаление и изменение ключа проверяются ограничениями внешнего ключа (тема 2). Удалить книгу, на которую ссылаются остатки, нельзя:
ERROR:  update or delete on table "book" violates foreign key constraint "stock_book_id_fkey" on table "stock"
DETAIL:  Key (book_id)=(7) is still referenced from table "stock".
А удаление заказа, наоборот, каскадно удалит его позиции (order_item объявлена с ON DELETE CASCADE), но будет отвергнуто, если у заказа есть платежи: ссылка из payment объявлена без каскада. Поведение DELETE определяется не самим оператором, а ограничениями схемы, и прежде чем удалять, полезно посмотреть раздел «Referenced by» в выводе \d таблица.
RETURNING и TRUNCATE
Предложение RETURNING — расширение PostgreSQL — есть у INSERT, UPDATE и DELETE 1. Оно превращает оператор изменения в источник строк: команда возвращает затронутые строки, как SELECT. Для INSERT и UPDATE возвращаются новые значения строк, для DELETE — удалённые. Это избавляет от второго запроса «что же изменилось» и, главное, от гонки между изменением и чтением. Отметим отгруженными оплаченные заказы, сделанные до 21 декабря 2024 года:
BEGIN;
UPDATE orders
SET status = 'shipped'
WHERE status = 'paid' AND created_at < '2024-12-21'
RETURNING order_id, customer_id, created_at::date AS day, status;
ROLLBACK;
 order_id | customer_id |    day     | status
----------+-------------+------------+---------
     2935 |         112 | 2024-12-20 | shipped
     8534 |        2258 | 2024-12-20 | shipped
     9405 |         227 | 2024-12-20 | shipped
    10772 |        3970 | 2024-12-20 | shipped
    13004 |        1962 | 2024-12-20 | shipped
    18093 |         555 | 2024-12-20 | shipped
(6 rows)

UPDATE 6
В PostgreSQL 16 RETURNING в UPDATE возвращает только новые значения; чтобы получить и старые, приходится соединять результат с исходной таблицей или использовать общее табличное выражение. Возможность ссылаться в RETURNING на старые значения (OLD) появилась лишь в PostgreSQL 18.
Оператор TRUNCATE удаляет все строки таблицы, но устроен иначе, чем DELETE без условия 1. DELETE просматривает таблицу и помечает удалённой каждую строку, поэтому его время пропорционально размеру таблицы, а место освобождается только после очистки (тема 12). TRUNCATE заменяет файлы таблицы пустыми и выполняется почти мгновенно при любом размере. Цена скорости — ограничения: TRUNCATE не принимает условия, не вызывает построчных триггеров и не может очистить таблицу, на которую ссылается внешний ключ другой таблицы, если та не очищается в той же команде:
ERROR:  cannot truncate a table referenced in a foreign key constraint
DETAIL:  Table "book_author" references "book".
HINT:  Truncate table "book_author" at the same time, or use TRUNCATE ... CASCADE.
Особенность PostgreSQL: TRUNCATE транзакционен, его можно отменить командой ROLLBACK. В Oracle и MySQL эта команда относится к языку определения данных и неявно фиксирует транзакцию, поэтому отменить её нельзя. Параметр RESTART IDENTITY заодно сбрасывает генераторы столбцов идентичности очищаемой таблицы.
Вставка с конфликтом, MERGE и массовая загрузка
INSERT … ON CONFLICT: «вставить или обновить»
Частая задача — записать строку, если её ещё нет, а если есть — обновить. Склад получил поставку: для пары «склад — книга», уже присутствующей в stock, количество надо увеличить, а для новой пары — вставить строку. Наивное решение «проверить запросом, затем вставить или обновить» требует двух команд и ненадёжно: между проверкой и вставкой другой сеанс может вставить ту же строку, и вставка упадёт на ограничении уникальности (почему так происходит — в теме 12). PostgreSQL с версии 9.5 решает задачу одной командой INSERT … ON CONFLICT, которую называют операцией «upsert» (от update и insert) 2.
Предложение ON CONFLICT указывает конфликтную цель — столбцы уникального индекса или ограничения, — и действие при нарушении уникальности: DO NOTHING (пропустить строку) или DO UPDATE SET … (обновить существующую). В выражениях DO UPDATE псевдоним таблицы обозначает существующую строку, а специальная таблица EXCLUDED — строку, которую пытались вставить. Остатки книг 7 и 8 до поставки:
 warehouse_id | book_id | quantity
--------------+---------+----------
            2 |       7 |        0
            3 |       7 |        9
            4 |       7 |       30
            2 |       8 |       13
            4 |       8 |       33
BEGIN;
INSERT INTO stock AS s (warehouse_id, book_id, quantity)
VALUES (1, 7, 5), (2, 7, 10), (2, 8, 4)
ON CONFLICT (warehouse_id, book_id)
DO UPDATE SET quantity = s.quantity + EXCLUDED.quantity
RETURNING *;
ROLLBACK;
 warehouse_id | book_id | quantity
--------------+---------+----------
            1 |       7 |        5
            2 |       7 |       10
            2 |       8 |       17
(3 rows)

INSERT 0 3
Пары (1, 7) не было — строка вставлена; пары (2, 7) и (2, 8) были — количество увеличено на 10 и на 4. С DO NOTHING та же команда вставила бы одну строку (1, 7) и вернула бы только её. К DO UPDATE можно добавить условие WHERE, и тогда строка обновляется лишь при его истинности, иначе конфликтная строка пропускается.
Два ограничения ON CONFLICT полезно знать заранее. Конфликтная цель должна совпадать с уникальным индексом или ограничением; если такого нет, команда не выполняется:
ERROR: there is no unique or exclusion constraint matching the ON CONFLICT specification
И одна команда не может обновить одну и ту же строку дважды. Если в поставке пара (2, 7) встречается в двух накладных, команда завершится ошибкой:
ERROR:  ON CONFLICT DO UPDATE command cannot affect row a second time
HINT:  Ensure that no rows proposed for insertion within the same command have duplicate constrained values.
Исправление — свести источник к одной строке на ключ до вставки, например группировкой с суммой количеств: это тот же принцип предварительной агрегации, что и в теме 4.
MERGE: сведение таблицы с источником
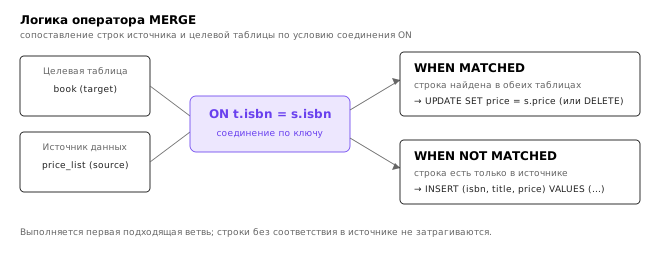
Оператор MERGE появился в стандарте SQL:2003, а в PostgreSQL — только в версии 15 412. Он сводит целевую таблицу (англ. target) с источником (англ. source): соединяет их по условию и для каждой строки источника выполняет действие в зависимости от того, нашлась ли пара 4. Логика работы такова:
- Источник соединяется с целевой таблицей по условию
ON. - Каждая строка источника получает статус:
MATCHED— пара в целевой таблице есть,NOT MATCHED— пары нет. - Предложения
WHENпроверяются по порядку, и выполняется первое, чей статус совпал и чьё дополнительное условиеAND …истинно: дляMATCHED—UPDATE,DELETEилиDO NOTHING, дляNOT MATCHED—INSERTилиDO NOTHING. - Строка, для которой не подошло ни одно предложение, пропускается.
Схема на рисунке показывает, как строки прайса распределяются по ветвям.
Пусть издательство прислало прайс, загруженный во временную таблицу price_list (о загрузке — в следующем подразделе): новая цена «Войны и мира», неизменная цена «Евгения Онегина» и новая книга. Сопоставление идёт по ISBN — естественному ключу, общему для магазина и издательства; внутренний book_id издательству неизвестен.
MERGE INTO book AS b
USING price_list AS s ON b.isbn = s.isbn
WHEN MATCHED AND b.price <> s.price THEN
    UPDATE SET price = s.price
WHEN NOT MATCHED THEN
    INSERT (isbn, title, category_id, price)
    VALUES (s.isbn, s.title, s.category_id, s.price);
MERGE 2
 book_id |        title        |  price
---------+---------------------+---------
       1 | Война и мир         | 1390.00
       3 | Евгений Онегин      |  390.00
    2016 | Грокаем базы данных | 1490.00
(3 rows)
Тег MERGE 2 — число строк, к которым применено действие: одна обновлена, одна вставлена, «Евгений Онегин» не подошёл ни под одно предложение, поскольку его цена не изменилась, и был пропущен. Дополнительное условие AND b.price <> s.price избавляет от бессмысленных записей: строка, «обновлённая» тем же значением, всё равно переписывается (в PostgreSQL это новая версия строки, тема 12). Номер новой книги 2016, а не 2011: предыдущие примеры, отменённые ROLLBACK, уже израсходовали несколько значений генератора.
В отличие от UPDATE … FROM, MERGE по стандарту требует, чтобы каждой строке целевой таблицы соответствовало не более одной строки источника. Если в прайсе две строки с одним ISBN, команда завершается ошибкой, а не выбирает одну из них произвольно 4:
ERROR:  MERGE command cannot affect row a second time
HINT:  Ensure that not more than one source row matches any one target row.
Чем MERGE отличается от INSERT … ON CONFLICT? MERGE универсальнее: источником служит любая таблица или запрос, условие сопоставления произвольно (не обязательно уникальный индекс), доступны удаление и несколько ветвей с условиями. Зато ON CONFLICT надёжнее при одновременной работе нескольких сеансов: он опирается на уникальный индекс и гарантированно либо вставит строку, либо обновит существующую, тогда как MERGE при одновременной вставке той же строки другим сеансом может завершиться ошибкой уникальности; документация рекомендует для таких случаев ON CONFLICT 4. Практическое правило: ON CONFLICT — для вставки отдельных строк в рабочую таблицу приложением, MERGE — для пакетной сверки таблицы с внешним источником (прайсом, выгрузкой, справочником).
В PostgreSQL 16 у MERGE нет предложения RETURNING и ветви WHEN NOT MATCHED BY SOURCE для строк цели, отсутствующих в источнике; обе добавлены в PostgreSQL 17, а в PostgreSQL 16 дают синтаксическую ошибку. Книги, исчезнувшие из прайса, здесь удаляют отдельной командой DELETE … WHERE NOT EXISTS (…).
COPY, \copy и временные таблицы
Загружать тысячи строк отдельными командами INSERT неэффективно: каждая разбирается, планируется и пересылается по сети отдельно. Для массовой загрузки и выгрузки служит команда COPY, передающая поток строк в текстовом, CSV или двоичном формате между таблицей и файлом или потоком клиента 5; она многократно быстрее построчной вставки (сравнение — в теме 15).
Важно различать, где находится файл. Серверная команда COPY таблица FROM 'путь' читает файл в файловой системе сервера от имени пользователя ОС, под которым работает PostgreSQL, и поэтому разрешена только суперпользователю или членам роли pg_read_server_files (для записи — pg_write_server_files) 5. Метакоманда psql \copy выглядит так же, но работает иначе: файл читает или пишет клиент psql на своей машине с правами пользователя, запустившего psql, и передаёт данные серверу командой COPY … FROM STDIN (или получает COPY … TO STDOUT). Для загрузки файлов с рабочей машины нужна именно \copy.
\copy (SELECT book_id, isbn, price FROM book WHERE category_id = 21 ORDER BY book_id) TO 'pg_books.csv' WITH (FORMAT csv, HEADER)
COPY 113
book_id,isbn,price
9,9785937001351,0.00
28,9780000000028,639.99
33,9780000000033,179.99
Метакоманда \copy, как и любая метакоманда psql, записывается в одну строку. В формате CSV пустое поле без кавычек читается как NULL, а пустая строка в кавычках "" — как пустая строка 5.
Загружать внешний файл сразу в рабочую таблицу рискованно: в файле могут оказаться дубликаты, ошибки формата, строки, нарушающие ограничения. COPY атомарна: при первой же ошибке вся команда отменяется, и в таблице не остаётся ни одной строки из файла, а сообщение указывает номер ошибочной строки:
ERROR:  new row for relation "t2" violates check constraint "t2_price_check"
DETAIL:  Failing row contains (616, 9780000000616, 2919.99).
CONTEXT:  COPY t2, line 33: "616,9780000000616,2919.99"
Поэтому принят двухшаговый приём: загрузить файл в промежуточную (англ. staging) таблицу без строгих ограничений, проверить и очистить данные запросами и только затем перенести их в рабочие таблицы командой INSERT … SELECT, INSERT … ON CONFLICT или MERGE. Промежуточную таблицу удобно делать временной.
Временная таблица (англ. temporary table) создаётся командой CREATE TEMP TABLE и существует только до конца сеанса, а с параметром ON COMMIT DROP — до конца транзакции; ON COMMIT DELETE ROWS очищает её при каждой фиксации 1. Она видна только создавшему её сеансу: два пользователя могут одновременно иметь временные таблицы с одним именем, не мешая друг другу. В PostgreSQL временные таблицы размещаются в особой схеме сеанса pg_temp_N, которая просматривается первой при поиске имён, поэтому временная таблица «заслоняет» постоянную с тем же именем; изменения временных таблиц не записываются в журнал WAL (тема 13), что делает их быстрее обычных.
CREATE TEMP TABLE pg_prices (book_id integer, isbn char(13), price numeric(10,2));
\copy pg_prices FROM 'pg_books.csv' WITH (FORMAT csv, HEADER)
Метакоманда \copy сообщает COPY 113, а \d pg_prices показывает таблицу в схеме вида pg_temp_3; номер схемы у каждого сеанса свой.
Общие табличные выражения
WITH: именованные подзапросы
Запрос из нескольких уровней вложенных подзапросов читается изнутри наружу и плохо поддаётся проверке. Общее табличное выражение (англ. common table expression, CTE) — подзапрос, которому в начале запроса в предложении WITH дано имя; дальше на это имя ссылаются как на таблицу 6. Конструкция введена в стандарте SQL:1999 и позволяет записать многошаговый запрос сверху вниз, как последовательность определений, каждое из которых можно выполнить и проверить отдельно.
Найдём рубрики, в которых средняя цена книги выше средней по всему каталогу:
WITH cat_avg AS (
    SELECT category_id, avg(price) AS avg_price, count(*) AS books
    FROM book
    GROUP BY category_id
),
total AS (
    SELECT avg(price) AS avg_price FROM book
)
SELECT c.name, ca.books, round(ca.avg_price, 2) AS avg_price
FROM cat_avg ca
JOIN category c ON c.category_id = ca.category_id
CROSS JOIN total t
WHERE ca.avg_price > t.avg_price
ORDER BY ca.avg_price DESC;
      name      | books | avg_price
----------------+-------+-----------
 Математика     |   107 |   1737.84
 Физика         |    99 |   1635.34
 Базы данных    |   114 |   1634.38
...
 Сети           |   101 |   1572.56
(10 rows)
Каждое выражение отвечает на свой вопрос: cat_avg — средняя цена и число книг по рубрикам, total — средняя цена по каталогу (1567.74, тема 4). Последующие выражения могут ссылаться на предыдущие, а основной запрос — на любые из них. Многоуровневый аналитический запрос темы 5 превращается в цепочку именованных шагов, и промежуточный результат любого шага можно вывести, заменив основной запрос на SELECT * FROM имя_шага.
Общее табличное выражение, на которое ссылаются несколько раз, вычисляется один раз; производная таблица, повторённая в запросе дважды, — дважды. По смыслу же WITH эквивалентно подзапросам в FROM: имя существует только в пределах одного оператора и, в отличие от представления, в базе не сохраняется.
Материализация общих табличных выражений
Как выполняется общее табличное выражение? Возможны две стратегии. При материализации (англ. materialization) выражение вычисляется один раз отдельно от основного запроса, результат сохраняется во временном хранилище, и основной запрос читает уже его. При встраивании (англ. inlining) выражение подставляется в основной запрос как подзапрос, и планировщик оптимизирует их вместе: может протолкнуть условие внутрь, использовать индекс, выбрать порядок соединений.
До PostgreSQL 12 общие табличные выражения всегда материализовались. Это служило «барьером оптимизации» (англ. optimization fence): условие основного запроса не проникало внутрь WITH, и разработчики даже намеренно пользовались этим, чтобы управлять планом. В PostgreSQL 12 правило изменилось: выражение по умолчанию встраивается, если оно не рекурсивное, не имеет побочных эффектов (это SELECT без изменчивых функций) и используется в основном запросе ровно один раз; иначе оно материализуется 614. Решение можно переопределить: AS MATERIALIZED принудительно материализует выражение, AS NOT MATERIALIZED принудительно встраивает его даже при нескольких ссылках. Рисунок сравнивает планы двух вариантов.
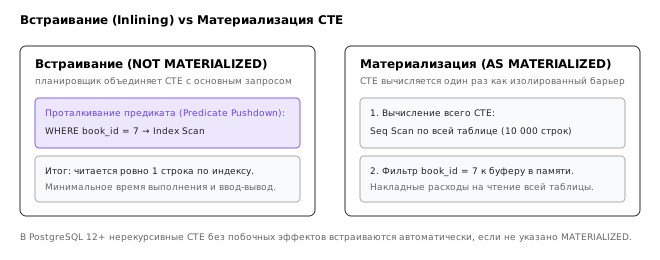
Разница видна в планах (подробно о чтении планов — в теме 11):
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
WITH b AS (SELECT * FROM book)
SELECT title FROM b WHERE book_id = 7;

EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
WITH b AS MATERIALIZED (SELECT * FROM book)
SELECT title FROM b WHERE book_id = 7;
                         QUERY PLAN
------------------------------------------------------------
 Index Scan using book_pkey on book (actual rows=1 loops=1)
   Index Cond: (book_id = 7)
(2 rows)

                     QUERY PLAN
-----------------------------------------------------
 CTE Scan on b (actual rows=1 loops=1)
   Filter: (book_id = 7)
   Rows Removed by Filter: 2009
   CTE b
     ->  Seq Scan on book (actual rows=2010 loops=1)
(5 rows)
В первом плане выражения b как отдельного шага нет вовсе: планировщик подставил его и нашёл книгу по первичному ключу. Во втором выражение вычислено целиком (прочитаны все 2010 строк), сохранено, и лишь затем к результату применён фильтр, отбросивший 2009 строк. Если на выражение сослаться дважды (например, соединить b с самим собой), оно по умолчанию материализуется, а с NOT MATERIALIZED — встраивается в обе ссылки, и каждая читает книгу по индексу.
Отсюда практические выводы. Материализация выгодна, когда выражение дорогое, используется несколько раз и его результат невелик, или когда нужно гарантировать однократное вычисление. Встраивание выгодно, когда основной запрос отбирает из выражения малую часть строк. Совет «не использовать CTE ради производительности» из старых статей к PostgreSQL 12 и новее уже не относится.
Общие табличные выражения с изменением данных
В PostgreSQL выражение в WITH может быть не только SELECT, но и INSERT, UPDATE или DELETE с предложением RETURNING; его результатом становятся возвращённые строки 6. Это позволяет выполнить несколько связанных изменений одной командой. Оформим заказ покупателя 1 со склада 2 на две книги Стругацких:
BEGIN;
WITH new_order AS (
    INSERT INTO orders (customer_id, warehouse_id)
    VALUES (1, 2)
    RETURNING order_id
)
INSERT INTO order_item (order_id, book_id, quantity, price)
SELECT o.order_id, b.book_id, 1, b.price
FROM new_order o
CROSS JOIN book b
WHERE b.book_id IN (4, 5)
RETURNING *;
ROLLBACK;
 order_id | book_id | quantity | price
----------+---------+----------+--------
    20001 |       4 |        1 | 520.00
    20001 |       5 |        1 | 540.00
(2 rows)

INSERT 0 2
Номер заказа, выданный генератором, передаётся во вставку позиций через RETURNING, без промежуточного запроса и без переменных в приложении. Столбцы created_at и status получили значения по умолчанию — текущее время и 'new'.
Второй классический пример — перенос строк в архив: DELETE … RETURNING в WITH и INSERT … SELECT из него в основном запросе. Перенесём во временную таблицу-архив отзывы, оставленные до июля 2022 года: Удаление и вставка выполняются одной командой и потому вместе либо выполняются, либо нет:
CREATE TEMP TABLE review_archive (LIKE review);

WITH moved AS (
    DELETE FROM review
    WHERE created_at < '2022-07-01'
    RETURNING *
)
INSERT INTO review_archive
SELECT * FROM moved;
INSERT 0 1783
У таких команд есть важное правило видимости. Все части оператора — выражения WITH и основной запрос — выполняются с одним и тем же снимком данных, то есть видят базу в состоянии на начало оператора, и не видят изменений, сделанных друг другом 6. Единственный способ передать изменённые строки дальше — RETURNING. Это легко проверить:
BEGIN;
WITH removed AS (
    DELETE FROM stock WHERE book_id = 7 RETURNING *
)
SELECT (SELECT count(*) FROM removed) AS removed,
       (SELECT count(*) FROM stock WHERE book_id = 7) AS still_visible;
ROLLBACK;
 removed | still_visible
---------+---------------
       3 |             3
(1 row)
Основной запрос всё ещё видит три удаляемые строки stock, хотя к концу команды их уже нет. Поэтому не следует строить команду, в которой две части изменяют одну и ту же строку: порядок их выполнения не определён. Выражение WITH с изменением данных выполняется ровно один раз и полностью, даже если основной запрос не читает его результат 6.
Рекурсивные запросы
WITH RECURSIVE: как вычисляется рекурсивный запрос
В теме 4 было показано, что самосоединение спускается по дереву рубрик на один уровень, и дерево произвольной глубины так не обойти: число самосоединений пришлось бы знать заранее. Реляционная алгебра Кодда не выражает транзитивного замыкания — множества всех пар «предок — потомок» — никаким фиксированным выражением. Стандарт SQL:1999 добавил для этого рекурсивные запросы WITH RECURSIVE 69.
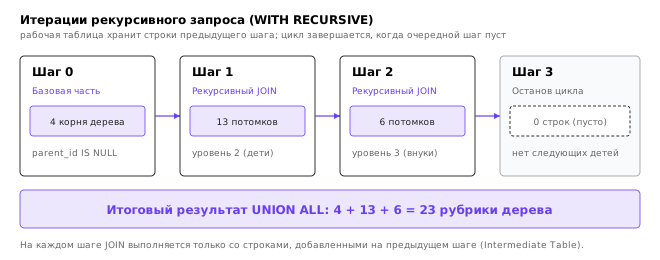
Рекурсивное общее табличное выражение состоит из двух частей, соединённых UNION ALL (или UNION): нерекурсивной (англ. non-recursive term), задающей начальные строки, и рекурсивной (англ. recursive term), которая ссылается на само выражение. Название «рекурсия» не должно вводить в заблуждение: вычисление итеративно 6:
- Вычислить нерекурсивную часть; её строки поместить в результат и в рабочую таблицу (англ. working table).
- Пока рабочая таблица не пуста: вычислить рекурсивную часть, подставив вместо ссылки на выражение текущее содержимое рабочей таблицы (а не весь накопленный результат); полученные строки добавить в результат и сделать новым содержимым рабочей таблицы.
- Когда рекурсивная часть вернёт пустое множество, вычисление закончено.
Простейший пример — генерация ряда чисел:
WITH RECURSIVE n (i) AS (
    SELECT 1
    UNION ALL
    SELECT i + 1 FROM n WHERE i < 5
)
SELECT i FROM n;
На первом шаге рабочая таблица содержит строку 1, на втором — 2, и так далее; на пятом шаге условие i < 5 ложно для единственной строки 5, рекурсивная часть пуста, и вычисление останавливается. Результат — пять строк от 1 до 5. Для рядов чисел и дат в PostgreSQL удобнее функция generate_series, но рекурсивная форма переносима и позволяет генерировать последовательности по любому правилу. Например, календарь последних восьми дней 2024 года с числом заказов (внешнее соединение сохраняет дни без заказов):
WITH RECURSIVE d (day) AS (
    SELECT date '2024-12-24'
    UNION ALL
    SELECT day + 1 FROM d WHERE day < date '2024-12-31'
)
SELECT d.day, count(o.order_id) AS orders
FROM d
LEFT JOIN orders o ON o.created_at >= d.day AND o.created_at < d.day + 1
GROUP BY d.day
ORDER BY d.day;
    day     | orders
------------+--------
 2024-12-24 |     16
 2024-12-25 |     22
...
 2024-12-30 |     25
 2024-12-31 |      0
(8 rows)
Последний день данных — 30 декабря, поэтому 31 декабря заказов нет; без сгенерированного календаря этот день просто отсутствовал бы в отчёте.
Обход дерева рубрик: путь, глубина, поддерево
Нерекурсивная часть обхода дерева выбирает корни, рекурсивная — соединяет таблицу рубрик с уже найденными рубриками по parent_id, то есть находит их детей. Попутно можно вычислять глубину (на единицу больше, чем у родителя) и путь от корня (путь родителя плюс своё имя). Рисунок показывает содержимое рабочей таблицы на каждой итерации.
WITH RECURSIVE tree AS (
    SELECT category_id, parent_id, name, 1 AS depth,
           name AS path, ARRAY[category_id] AS sort_key
    FROM category
    WHERE parent_id IS NULL
    UNION ALL
    SELECT c.category_id, c.parent_id, c.name, t.depth + 1,
           t.path || ' / ' || c.name, t.sort_key || c.category_id
    FROM category c
    JOIN tree t ON c.parent_id = t.category_id
)
SELECT category_id, depth, path
FROM tree
ORDER BY sort_key;
 category_id | depth |                              path
-------------+-------+-----------------------------------------------------------------
           1 |     1 | Художественная литература
           5 |     2 | Художественная литература / Классическая проза
           6 |     2 | Художественная литература / Фантастика
          23 |     3 | Художественная литература / Фантастика / Космическая фантастика
...
           3 |     1 | Компьютерная литература
          12 |     2 | Компьютерная литература / Программирование
          18 |     3 | Компьютерная литература / Программирование / Python
          19 |     3 | Компьютерная литература / Программирование / C и C++
          20 |     3 | Компьютерная литература / Программирование / Java
          13 |     2 | Компьютерная литература / Базы данных
          21 |     3 | Компьютерная литература / Базы данных / PostgreSQL
          22 |     3 | Компьютерная литература / Базы данных / NoSQL
...
(23 rows)
Из 23 строк результата показана часть. Порядок строк, в котором вычисляется рекурсивный запрос, — по уровням: сначала все корни, затем все рубрики второго уровня и так далее. Чтобы вывести дерево «как в оглавлении», каждую ветвь целиком, нужен ключ сортировки, отражающий путь. Здесь это массив номеров рубрик от корня: массивы сравниваются поэлементно, поэтому потомки оказываются сразу за предком. Типы столбцов задаёт нерекурсивная часть, и рекурсивная должна возвращать те же типы: если путь в нерекурсивной части приведён к varchar(50), запрос будет отвергнут с сообщением recursive query "tree" column 5 has type character varying(50) in non-recursive term but type character varying overall.
Стандарт SQL и PostgreSQL с версии 14 предлагают для этой задачи готовое предложение SEARCH DEPTH FIRST BY столбец SET имя (обход в глубину) или SEARCH BREADTH FIRST BY … (в ширину): оно само добавляет столбец с ключом сортировки, по которому строки упорядочиваются в нужном порядке 613.
Обход можно вести и вверх — от рубрики к корню, соединяя по c.category_id = u.parent_id; так строится «хлебная крошка» для страницы рубрики «Python»: Python, Программирование, Компьютерная литература.
Самая полезная форма — транзитивное замыкание: все пары «рубрика — рубрика её поддерева», включая саму рубрику. Нерекурсивная часть даёт пары (x, x) для каждой рубрики, рекурсивная — добавляет детей последнего найденного потомка. Соединив замыкание с книгами и сгруппировав по корню поддерева, получим число книг в поддереве каждой рубрики:
WITH RECURSIVE sub (root_id, category_id) AS (
    SELECT category_id, category_id FROM category
    UNION ALL
    SELECT s.root_id, c.category_id
    FROM sub s
    JOIN category c ON c.parent_id = s.category_id
)
SELECT r.category_id, r.name, count(b.book_id) AS books
FROM sub s
JOIN category r ON r.category_id = s.root_id
LEFT JOIN book b ON b.category_id = s.category_id
WHERE r.parent_id IS NULL OR r.parent_id = 3
GROUP BY r.category_id, r.name
ORDER BY r.category_id;
 category_id |           name            | books
-------------+---------------------------+-------
           1 | Художественная литература |   549
           2 | Научная литература        |   312
           3 | Компьютерная литература   |   950
           4 | Детская литература        |   199
          12 | Программирование          |   434
          13 | Базы данных               |   322
          14 | Сети                      |   101
          15 | Безопасность              |    93
(8 rows)
Строки показаны для корней и для подрубрик «Компьютерной литературы». Сумма по четырём корням равна 2010 — всем книгам каталога, хотя ни в одном корне книг нет: они лежат во вложенных рубриках. В «Базах данных» 322 книги — 114 в самой рубрике и 208 в двух её подрубриках; именно эти книги затронул UPDATE … FROM в начале темы, где поддерево было перечислено вручную условием c.category_id = 13 OR c.parent_id = 13, справедливым лишь при глубине не больше двух уровней ниже. Замыкание содержит 48 пар: 23 пары «рубрика — она сама», 19 пар «родитель — ребёнок» и 6 пар «дедушка — внук». count(b.book_id) вместо count(*) нужен потому, что рубрика без книг даёт во внешнем соединении строку с NULL (тема 5).
Циклы и их обнаружение
Дерево рубрик по смыслу не содержит циклов, но схема этого не гарантирует: ничто не мешает сделать «Художественную литературу» дочерней рубрикой «Космической фантастики», которая сама вложена в «Фантастику», а та — в «Художественную литературу». Рекурсивный запрос по графу с циклом при UNION ALL никогда не закончится: рабочая таблица не опустеет. Проверим на копии рубрикатора во временной таблице:
CREATE TEMP TABLE cat AS SELECT * FROM category;
UPDATE cat SET parent_id = 23 WHERE category_id = 1;    -- цикл 1 → 6 → 23 → 1

SET statement_timeout = '2s';
WITH RECURSIVE tree AS (
    SELECT category_id, parent_id, 1 AS depth FROM cat WHERE category_id = 6
    UNION ALL
    SELECT c.category_id, c.parent_id, t.depth + 1
    FROM cat c JOIN tree t ON c.parent_id = t.category_id
)
SELECT count(*) FROM tree;
RESET statement_timeout;
ERROR: canceling statement due to statement timeout
Без ограничения времени запрос не завершился бы: обход снова и снова проходит по циклу 1 → 6 → 23 → 1, и каждая новая итерация порождает строки. Защитных приёмов три. Первый — UNION вместо UNION ALL: строка, уже присутствующая в результате, не добавляется повторно, и вычисление останавливается. Но он работает, только если строки при повторном проходе цикла полностью совпадают; глубина или путь в строке делают каждую строку новой, и UNION не помогает 6. Второй — хранить в строке путь (массив пройденных ключей) и не продолжать ветвь, если очередной ключ уже есть в пути: условие c.category_id = ANY (t.path). Третий, появившийся в PostgreSQL 14, — стандартное предложение CYCLE, которое делает то же автоматически 613:
WITH RECURSIVE tree AS (
    SELECT category_id, name FROM cat WHERE category_id = 6
    UNION ALL
    SELECT c.category_id, c.name
    FROM cat c JOIN tree t ON c.parent_id = t.category_id
) CYCLE category_id SET is_cycle USING path
SELECT category_id, name, is_cycle, path FROM tree;
 category_id |           name            | is_cycle |        path
-------------+---------------------------+----------+--------------------
           6 | Фантастика                | f        | {(6)}
          23 | Космическая фантастика    | f        | {(6),(23)}
           1 | Художественная литература | f        | {(6),(23),(1)}
           5 | Классическая проза        | f        | {(6),(23),(1),(5)}
           6 | Фантастика                | t        | {(6),(23),(1),(6)}
           7 | Детектив                  | f        | {(6),(23),(1),(7)}
           8 | Поэзия                    | f        | {(6),(23),(1),(8)}
(7 rows)
CYCLE category_id объявляет, по какому столбцу распознавать повтор; SET is_cycle задаёт имя столбца-признака, USING path — имя столбца, где накапливается путь. Строка, замкнувшая цикл, попадает в результат с is_cycle = t и дальше не развивается. Найти циклы в данных можно запросом … WHERE is_cycle: здесь это строка «Фантастика», к которой обход вернулся по пути 6 → 23 → 1 → 6.
Рекурсивные запросы обходят не только деревья, но и произвольные графы: маршруты, зависимости, связи «покупатели, купившие эту книгу, купили также» (тема 16). Для деревьев, которые читаются гораздо чаще, чем меняются, применяют и другие способы хранения — материализованный путь, вложенные множества, таблицу замыкания, — позволяющие обойтись без рекурсии ценой усложнения изменений; они подробно разобраны в книге Селко 11. Для графов размер результата может расти экспоненциально с глубиной, поэтому глубину обхода на практике ограничивают условием.
Представления
Представление как именованный запрос
Представление (англ. view) — запрос, сохранённый в базе под именем; к нему обращаются как к таблице 710. В отличие от общего табличного выражения, представление существует в базе постоянно и доступно всем запросам и всем пользователям с правами на него. Данные представление не хранит: при каждом обращении PostgreSQL на этапе переписывания подставляет текст представления в запрос как подзапрос, после чего планировщик оптимизирует их вместе (путь запроса через переписывание — тема 11).
CREATE VIEW catalog AS
SELECT b.book_id, b.title, c.name AS category, p.name AS publisher, b.price
FROM book b
JOIN category c ON c.category_id = b.category_id
LEFT JOIN publisher p ON p.publisher_id = b.publisher_id;

SELECT * FROM catalog WHERE book_id <= 3;
 book_id |          title           |      category      | publisher |  price
---------+--------------------------+--------------------+-----------+---------
       1 | Война и мир              | Классическая проза | АСТ       | 1290.00
       2 | Преступление и наказание | Классическая проза | Эксмо     |  450.00
       3 | Евгений Онегин           | Поэзия             | Азбука    |  390.00
(3 rows)
Представления решают три задачи. Первая — абстракция: сложное соединение записано и проверено один раз, а приложение работает с простой «витриной». Это внешний уровень архитектуры ANSI/SPARC (тема 1): при изменении хранимых таблиц достаточно переписать представление, сохранив его столбцы, — логическая независимость данных. Вторая — безопасность: права можно выдать на представление, не выдавая их на таблицы (тема 15). Третья — единообразие: определение «выручки» записано в одном месте, а не повторяется с вариациями в десятках отчётов.
Определение представления фиксируется в момент создания. Звёздочка в CREATE VIEW v AS SELECT * FROM book раскрывается в список столбцов, существующих сейчас, и столбец, добавленный в таблицу позже, в представлении не появится. Таблица, в свою очередь, не может потерять столбец, от которого зависит представление: команда ALTER TABLE book DROP COLUMN price отвергается с сообщением cannot drop column price of table book because other objects depend on it. Команда CREATE OR REPLACE VIEW позволяет изменить запрос, но только добавив столбцы в конец списка с сохранением имён и типов существующих; удалить столбец так нельзя (cannot drop columns from view), и представление приходится удалить и создать заново 7. Текст представления показывает метакоманда \d+ имя или \sv имя.
Обновляемые представления и WITH CHECK OPTION
Можно ли изменять данные через представление? В общем случае нет: если представление соединяет таблицы, группирует строки или вычисляет выражения, неясно, какие строки каких таблиц должна изменить команда. Но для простых представлений ответ однозначен, и PostgreSQL (начиная с версии 9.3) делает их автоматически обновляемыми (англ. automatically updatable): команда INSERT, UPDATE или DELETE к представлению переписывается в команду к его базовой таблице 7. Представление обновляемо, если:
- в его
FROMровно одна таблица или обновляемое представление; - на верхнем уровне нет
WITH,DISTINCT,GROUP BY,HAVING,LIMIT,OFFSETи операций над множествами; - в списке выборки нет агрегатных, оконных функций и функций, возвращающих множества.
Представление catalog соединяет три таблицы и поэтому не обновляемо:
UPDATE catalog SET price = 1390 WHERE book_id = 1;
ERROR:  cannot update view "catalog"
DETAIL:  Views that do not select from a single table or view are not automatically updatable.
HINT:  To enable updating the view, provide an INSTEAD OF UPDATE trigger or an unconditional ON UPDATE DO INSTEAD rule.
Подсказка указывает на триггер INSTEAD OF, который выполняет вместо изменения представления произвольный код; это средство рассматривается в теме 14. Представление над одной таблицей с отбором строк, напротив, обновляемо. В нём могут быть и вычисляемые столбцы, но они только читаются:
CREATE VIEW pg_books AS
SELECT book_id, title, category_id, price, price * 0.9 AS member_price
FROM book
WHERE category_id = 21;

UPDATE pg_books SET member_price = 100 WHERE book_id = 9;
ERROR:  cannot update column "member_price" of view "pg_books"
DETAIL:  View columns that are not columns of their base relation are not updatable.
Узнать, какие представления и столбцы обновляемы, можно в information_schema.views (is_updatable, is_insertable_into) и information_schema.columns (is_updatable).
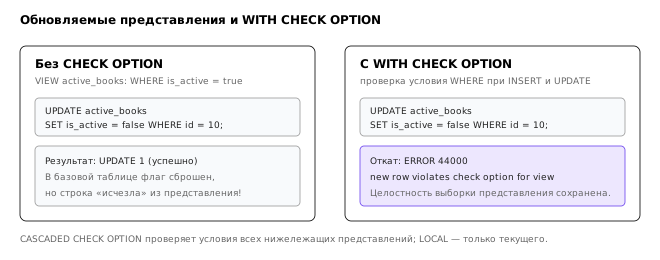
Условие WHERE обновляемого представления ограничивает, какие строки можно изменить или удалить через него, но не проверяет новые значения. Через представление «книги рубрики PostgreSQL» можно перенести книгу в другую рубрику — и она исчезнет из представления, через которое её изменили; можно вставить книгу рубрики «Классическая проза», которую представление никогда не покажет 7:
BEGIN;
UPDATE pg_books SET category_id = 22 WHERE book_id = 9;          -- UPDATE 1
SELECT count(*) FROM pg_books WHERE book_id = 9;                  -- 0
INSERT INTO pg_books (title, category_id, price)
VALUES ('Не про PostgreSQL', 5, 100);                             -- INSERT 0 1
ROLLBACK;
Такие «исчезающие строки» нарушают ожидание пользователя и смысл представления как ограниченного окна в данные. Предложение WITH CHECK OPTION требует, чтобы каждая строка, вставленная или изменённая через представление, оставалась видимой через него, и отвергает команду иначе 7. Рисунок поясняет разницу.
CREATE VIEW pg_books AS
SELECT book_id, title, category_id, price
FROM book
WHERE category_id = 21
WITH CHECK OPTION;

UPDATE pg_books SET category_id = 22 WHERE book_id = 9;
ERROR:  new row violates check option for view "pg_books"
DETAIL:  Failing row contains (9, 9785937001351, PostgreSQL 16 изнутри, 2, 22, 2024, 664, 0.00, {"free": true, "binding": "pdf"}, null).
Сообщение показывает строку базовой таблицы целиком — со всеми столбцами book, а не только со столбцами представления. Если представление построено над другим представлением, WITH CASCADED CHECK OPTION (вариант по умолчанию) проверяет условия всей цепочки, а WITH LOCAL CHECK OPTION — только условие самого представления. Например, для представления «дешёвые книги по PostgreSQL» SELECT * FROM pg_books WHERE price < 1000, построенного над pg_books без проверки, перенос книги в рубрику 22 с LOCAL будет разрешён (условие price < 1000 выполнено), а с CASCADED — отвергнут.
Материализованные представления
Обычное представление при каждом обращении выполняет свой запрос заново. Для тяжёлых отчётов, которые читаются часто, а меняются редко, это расточительно. Материализованное представление (англ. materialized view) сохраняет результат запроса как таблицу; обращение к нему читает готовые строки 8. В PostgreSQL материализованные представления появились в версии 9.3. Сохраним отчёт о выручке по месяцам и разделам каталога верхнего уровня (тема 5):
CREATE MATERIALIZED VIEW revenue_by_month AS
SELECT date_trunc('month', o.created_at)::date AS month,
       coalesce(p.parent_id, c.parent_id, c.category_id) AS root_id,
       sum(oi.quantity * oi.price) AS revenue
FROM orders o
JOIN order_item oi ON oi.order_id = o.order_id
JOIN book b ON b.book_id = oi.book_id
JOIN category c ON c.category_id = b.category_id
LEFT JOIN category p ON p.category_id = c.parent_id
WHERE o.status <> 'cancelled'
GROUP BY 1, 2;
SELECT 144
Корень дерева здесь найден без рекурсии, потому что глубина рубрикатора известна: у рубрики третьего уровня корень — родитель родителя, у второго — родитель. Результат — 144 строки (36 месяцев на 4 раздела), занимающие одну страницу 8 КиБ. Запрос к материализованному представлению за декабрь 2024 года выполнился за 0,4 мс, тот же отчёт, вычисляемый по исходным таблицам, — за 23 мс (времена приведены как пример; на другой машине они будут иными, но соотношение сохранится и с ростом базы будет расти).
Цена скорости — устаревание. Материализованное представление не следит за изменениями таблиц: если отменить заказ 20000 от 28 декабря, сумма в представлении останется прежней. Данные обновляются только командой REFRESH MATERIALIZED VIEW, которая заново выполняет запрос и заменяет содержимое 8. Обычный REFRESH на время работы блокирует чтение представления. Вариант REFRESH MATERIALIZED VIEW CONCURRENTLY вычисляет новый результат во временной таблице, сравнивает его со старым и применяет только разницу, не мешая читателям; для сопоставления строк ему нужен уникальный индекс по столбцам представления без условия WHERE 8:
ERROR:  cannot refresh materialized view "bookstore.revenue_by_month" concurrently
HINT:  Create a unique index with no WHERE clause on one or more columns of the materialized view.
После CREATE UNIQUE INDEX ON revenue_by_month (month, root_id) обновление CONCURRENTLY выполняется. Оно обычно медленнее простого, но не блокирует отчёты на время обновления. Материализованное представление — управляемая денормализация (тема 8): данные хранятся дважды, а согласованность обеспечивает не СУБД, а процедура обновления — по расписанию или после загрузки данных. Автоматического инкрементального поддержания при каждом изменении таблиц в PostgreSQL 16 нет; его строят триггерами (тема 14).
Итоги темы
Операторы INSERT, UPDATE и DELETE работают с множествами строк, отбираемыми теми же условиями, что и в SELECT. Отсюда правило безопасной работы — проверить условие запросом и выполнить изменение в транзакции, сверив тег команды с ожидаемым числом строк, — и главные ловушки: пропущенное WHERE и неоднозначный источник в UPDATE … FROM.
Для «вставить или обновить» служат INSERT … ON CONFLICT, опирающийся на уникальный индекс, и стандартный MERGE (PostgreSQL 15 и новее), сводящий таблицу с произвольным источником. Внешние данные загружаются командой COPY или \copy в промежуточную временную таблицу и проверяются перед переносом.
Общие табличные выражения WITH дают имена шагам запроса. С PostgreSQL 12 они по умолчанию встраиваются в основной запрос, если используются один раз, и материализуются, если несколько. Выражения с изменением данных передают строки через RETURNING и видят один снимок данных. WITH RECURSIVE вычисляется итеративно через рабочую таблицу и выражает транзитивное замыкание — путь, глубину, поддерево рубрики; от зацикливания защищают путь в строке и предложение CYCLE (PostgreSQL 14).
Представление сохраняет запрос под именем и служит инструментом абстракции и безопасности; простые представления над одной таблицей автоматически обновляемы, а WITH CHECK OPTION не даёт изменению увести строку за пределы представления. Материализованное представление хранит результат и ускоряет чтение ценой устаревания до REFRESH. В разделе II курса изученный язык применяется к проектированию: в теме 7 строится концептуальная модель, в теме 8 — нормализация, где переносы данных выполняются уже знакомыми INSERT … SELECT, а материализованные представления выступают как средство осознанной денормализации.
Литература
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 6. Data Manipulation. — 2023. https://www.postgresql.org/docs/16/dml.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. INSERT. — 2023. https://www.postgresql.org/docs/16/sql-insert.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. UPDATE. — 2023. https://www.postgresql.org/docs/16/sql-update.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. MERGE. — 2023. https://www.postgresql.org/docs/16/sql-merge.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. COPY. — 2023. https://www.postgresql.org/docs/16/sql-copy.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 7.8. WITH Queries (Common Table Expressions). — 2023. https://www.postgresql.org/docs/16/queries-with.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. CREATE VIEW. — 2023. https://www.postgresql.org/docs/16/sql-createview.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 41.3. Materialized Views. — 2023. https://www.postgresql.org/docs/16/rules-materializedviews.html
- ISO/IEC 9075-2:2023. Information technology — Database languages SQL — Part 2: Foundation (SQL/Foundation). — ISO, 2023.
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Celko J. Joe Celko's Trees and Hierarchies in SQL for Smarties. 2nd ed. — Morgan Kaufmann, 2012.
- PostgreSQL Global Development Group. PostgreSQL 15 Release Notes. — 2022. https://www.postgresql.org/docs/release/15.0/
- PostgreSQL Global Development Group. PostgreSQL 14 Release Notes. — 2021. https://www.postgresql.org/docs/release/14.0/
- PostgreSQL Global Development Group. PostgreSQL 12 Release Notes. — 2019. https://www.postgresql.org/docs/release/12.0/