
Функциональные зависимости и нормализация
В теме 7 схема базы данных получалась из модели «сущность — связь» по почти механическим правилам. Они гарантируют корректную структуру, но только если сама модель составлена удачно: если в сущность «Книга» по недосмотру попал город издательства, правила честно перенесут ошибку в схему, и один и тот же факт будет записан многократно. Нужен инструмент, позволяющий судить о качестве схемы строго, а не по интуиции.
Таким инструментом служат функциональные зависимости — ограничения вида «значение одних атрибутов однозначно определяет значение других» — и построенная на них теория нормализации. Её основы заложил Э. Кодд в начале 1970-х годов: в статье 1970 года он ввёл нормализованные отношения 1, а в 1972 году — вторую и третью нормальные формы 2. Затем У. Армстронг дал полную систему правил вывода зависимостей 3, Ф. Бернстайн — алгоритм синтеза схемы в третьей нормальной форме 5, Р. Фейгин — многозначные зависимости и четвёртую нормальную форму 6. Сегодня это классический раздел теории баз данных, одинаково изложенный во всех учебниках 91011.
Первый раздел показывает на учебной базе «Книжный узел» аномалии вставки, обновления и удаления. Второй вводит функциональные зависимости, правила их вывода и три базовых алгоритма: замыкание множества атрибутов, поиск потенциальных ключей и минимальное покрытие. Третий определяет нормальные формы от первой до нормальной формы Бойса — Кодда, четвёртый посвящён декомпозиции и алгоритмам нормализации, пятый — многозначным зависимостям, 4НФ и 5НФ и денормализации. Физические решения, в том числе выбор типов данных, относятся к теме 9.
Все примеры выполнены в PostgreSQL 16 на учебной базе (scale=1, база bookstore). Собственные таблицы создаются в отдельной схеме t08, исходная схема bookstore не изменяется. Алгоритмы разбираются вручную, а их реализация на Python (файл fd.py) пишется в лабораторной работе 8.
Об обозначениях. Отношение с именем R и атрибутами A, B, C записывается как R(A, B, C). Множества атрибутов записываются в фигурных скобках: {A, B}. В функциональной зависимости одиночный атрибут пишется без скобок: {A, B} → C, A → {B, C}. Во многих учебниках вместо {A, B} пишут просто AB; смысл тот же, но в этом курсе множества записываются явно.
Избыточность и аномалии
Широкая таблица заказов
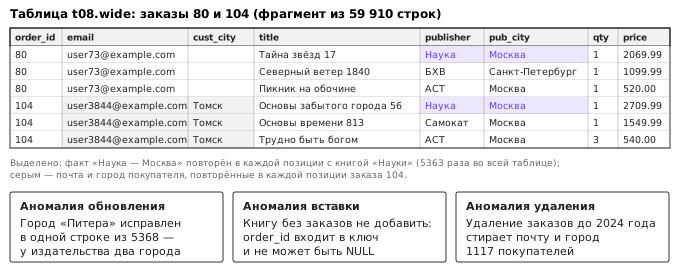
Представим, что заказы «Книжного узла» хранятся в одной таблице: строка — позиция заказа, а рядом всё, что может понадобиться в отчёте, — дата, почта и город покупателя, ISBN, название и издательство книги, город издательства, количество и цена. Такие таблицы постоянно встречаются на практике: выгрузки из учётных систем, электронные таблицы, «быстрые прототипы». Построим её из учебной базы:
CREATE SCHEMA t08;
CREATE TABLE t08.wide AS
SELECT o.order_id, o.created_at, c.customer_id, c.email, c.city AS cust_city,
       b.isbn, b.title, p.name AS publisher, p.city AS pub_city,
       oi.quantity, oi.price
FROM bookstore.orders o
JOIN bookstore.customer c USING (customer_id)
JOIN bookstore.order_item oi USING (order_id)
JOIN bookstore.book b USING (book_id)
LEFT JOIN bookstore.publisher p USING (publisher_id);
SELECT 59910
Посмотрим на два заказа:
SELECT order_id, email, cust_city, isbn, title, publisher, pub_city, quantity, price
FROM t08.wide
WHERE order_id IN (80, 104)
ORDER BY order_id, isbn;
 order_id |        email         | cust_city |     isbn      |            title            | publisher |    pub_city     | quantity |  price
----------+----------------------+-----------+---------------+-----------------------------+-----------+-----------------+----------+---------
       80 | user73@example.com   |           | 9780000000017 | Тайна звёзд 17              | Наука     | Москва          |        1 | 2069.99
       80 | user73@example.com   |           | 9780000001840 | Основы северного ветра 1840 | БХВ       | Санкт-Петербург |        1 | 1099.99
       80 | user73@example.com   |           | 9785170878239 | Пикник на обочине           | АСТ       | Москва          |        1 |  520.00
      104 | user3844@example.com | Томск     | 9780000000056 | Основы забытого города 56   | Наука     | Москва          |        1 | 2709.99
      104 | user3844@example.com | Томск     | 9780000000813 | Основы времени 813          | Самокат   | Москва          |        1 | 1549.99
      104 | user3844@example.com | Томск     | 9785170878246 | Трудно быть богом           | АСТ       | Москва          |        3 |  540.00
(6 rows)
Почта и город покупателя повторяются в каждой позиции заказа, а город издательства — в каждой позиции каждого заказа, где встречается книга этого издательства. Сколько раз записан один и тот же факт «АСТ находится в Москве», показывает группировка:
SELECT publisher, pub_city, count(*) AS rows
FROM t08.wide
GROUP BY publisher, pub_city
ORDER BY publisher NULLS LAST;
   publisher   |    pub_city     | rows
---------------+-----------------+------
 АСТ           | Москва          | 7075
 Азбука        | Санкт-Петербург | 5347
 БХВ           | Санкт-Петербург | 5286
 ДМК Пресс     | Москва          | 6450
 МЦНМО         | Москва          | 4546
 Наука         | Москва          | 5363
 Питер         | Санкт-Петербург | 5368
 Самокат       | Москва          | 5641
 Северный узел |                 | 5814
 Эксмо         | Москва          | 6152
               |                 | 2868
(11 rows)
Десять фактов о городах издательств записаны 57 042 раза; в схеме учебной базы они хранятся в десяти строках таблицы publisher. Избыточность (англ. redundancy) — хранение одного факта в нескольких местах — означает не только лишний расход памяти: копии факта могут разойтись, и тогда база данных противоречит сама себе.
Аномалии обновления, вставки и удаления
Неприятности, которые порождает избыточность, традиционно делят на три вида и называют аномалиями (англ. anomalies) 911.
Аномалия обновления (англ. update anomaly) возникает, когда изменение одного факта требует изменения многих строк, а изменены не все. Допустим, оператор исправил город издательства «Питер» в одном заказе, записав его сокращённо:
BEGIN;
UPDATE t08.wide SET pub_city = 'СПб'
WHERE publisher = 'Питер' AND order_id = 4;
SELECT publisher, count(DISTINCT pub_city) AS cities, count(*) AS rows
FROM t08.wide
GROUP BY publisher
HAVING count(DISTINCT pub_city) > 1;
ROLLBACK;
 publisher | cities | rows
-----------+--------+------
 Питер     |      2 | 5368
(1 row)
Теперь на вопрос «где находится издательство „Питер“» база отвечает двумя способами, и какой из них верен, по данным не понять. Чтобы обновить факт корректно, нужно изменить 5368 строк, а запрос, затрагивающий их все, легко написать неправильно. В схеме bookstore тот же факт хранится в одной строке publisher, и аномалия невозможна.
Аномалия вставки (англ. insertion anomaly) — невозможность записать факт, пока не известен другой, не связанный с ним факт. Позиция заказа однозначно определяется парой «заказ — книга», поэтому естественный первичный ключ таблицы wide — (order_id, isbn). Новую книгу, которую ещё никто не заказал, в такую таблицу не добавить:
ALTER TABLE t08.wide ADD PRIMARY KEY (order_id, isbn);
INSERT INTO t08.wide (isbn, title, publisher, pub_city)
VALUES ('9785446100000', 'Новая книга', 'Питер', 'Санкт-Петербург');
ERROR:  null value in column "order_id" of relation "wide" violates not-null constraint
DETAIL:  Failing row contains (null, null, null, null, null, 9785446100000, Новая книга, Питер, Санкт-Петербург, null, null).
Заказа ещё нет, а первичный ключ не допускает пустого order_id. Так же нельзя записать нового покупателя без заказов или издательство без книг, а «фиктивный заказ» исказил бы отчёты.
Аномалия удаления (англ. deletion anomaly) симметрична: удаление одного факта уничтожает другие. Пусть заказы до 2024 года решили перенести в архив и удалить из рабочей таблицы. Вместе с ними исчезнут сведения о покупателях, которые с тех пор ничего не заказывали, и о книгах, которые не продавались в 2024 году:
SELECT count(DISTINCT customer_id) AS lost_customers,
       count(DISTINCT isbn) FILTER (WHERE NOT EXISTS (
           SELECT 1 FROM t08.wide v
           WHERE v.isbn = w.isbn AND v.created_at >= '2024-01-01')) AS lost_books
FROM t08.wide w
WHERE NOT EXISTS (SELECT 1 FROM t08.wide v
                  WHERE v.customer_id = w.customer_id AND v.created_at >= '2024-01-01');
 lost_customers | lost_books
----------------+------------
           1117 |          2
Почта и город 1117 покупателей и две книги пропадут из базы, хотя удалять их никто не собирался.
Рисунок ниже показывает фрагмент широкой таблицы и место каждой аномалии.
Декомпозиция как лекарство и её риски
Все три аномалии устраняются одним приёмом — декомпозицией (англ. decomposition): широкое отношение заменяется несколькими более узкими, каждое из которых хранит факты одного вида. Сведения об издательстве переносятся в отношение Издательство(издательство, город), о книге — в Книга(isbn, название, издательство), о заказе — в Заказ(заказ, дата, покупатель) и так далее. Именно так устроена схема bookstore.
Но неудачная декомпозиция вредит: соединение частей может породить строки, которых не было (в теме 7 так было с тернарной связью «поставщик — книга — склад»), а ограничение, проверявшееся внутри одной таблицы, может «размазаться» по нескольким. Какие декомпозиции устраняют избыточность, не теряя ни информации, ни ограничений, позволяют строго решить функциональные зависимости.
Функциональные зависимости
Определение и смысл зависимости
Пусть R — схема отношения, X и Y — подмножества её атрибутов. Говорят, что в R выполняется функциональная зависимость (ФЗ, англ. functional dependency) X → Y, если в любом допустимом экземпляре отношения любые два кортежа, совпадающие по всем атрибутам X, совпадают и по всем атрибутам Y 910. Множество X называют левой частью, или детерминантом (англ. determinant), Y — правой частью. Читается запись так: «X функционально определяет Y» или «Y функционально зависит от X».
В широкой таблице заказов выполняются, например, зависимости isbn → {title, publisher} (ISBN однозначно определяет название и издательство книги), publisher → pub_city, order_id → {created_at, customer_id} и {order_id, isbn} → {quantity, price}. Зависимость order_id → isbn не выполняется: в заказе может быть несколько книг.
Ключевое слово определения — «в любом допустимом экземпляре». Функциональная зависимость — утверждение о предметной области, ограничение целостности; данные могут её опровергнуть, но не доказать. Гипотезу X → Y удобно проверять запросом: сгруппировать строки по X и найти группы, где больше одного различного значения Y.
SELECT 'isbn -> title' AS fd, count(*) AS violations
FROM (SELECT isbn FROM t08.wide GROUP BY isbn
      HAVING count(DISTINCT title) > 1) t
UNION ALL
SELECT 'isbn -> price', count(*)
FROM (SELECT isbn FROM t08.wide GROUP BY isbn
      HAVING count(DISTINCT price) > 1) t
UNION ALL
SELECT 'customer_id -> cust_city', count(*)
FROM (SELECT customer_id FROM t08.wide GROUP BY customer_id
      HAVING count(DISTINCT ROW(cust_city)) > 1) t
UNION ALL
SELECT 'cust_city -> customer_id', count(*)
FROM (SELECT cust_city FROM t08.wide GROUP BY cust_city
      HAVING count(DISTINCT customer_id) > 1) t
UNION ALL
SELECT 'order_id -> isbn', count(*)
FROM (SELECT order_id FROM t08.wide GROUP BY order_id
      HAVING count(DISTINCT isbn) > 1) t
ORDER BY violations, fd;
            fd            | violations
--------------------------+------------
 customer_id -> cust_city |          0
 isbn -> price            |          0
 isbn -> title            |          0
 cust_city -> customer_id |          8
 order_id -> isbn         |      19999
(5 rows)
Две последние гипотезы опровергнуты. Три первые данными не опровергнуты, но статус у них разный. Зависимости isbn → title и customer_id → cust_city отражают правила предметной области. Зависимость isbn → price выполняется лишь потому, что цены в учебной базе не менялись; по смыслу в позиции хранится цена на момент заказа, и правильная зависимость — {order_id, isbn} → price. Какие зависимости считать заданными, решает проектировщик по бизнес-правилам (тема 7), а запросы лишь помогают найти кандидатов и ошибки.
Обратим внимание на count(DISTINCT ROW(cust_city)) в третьем подзапросе. Агрегат count(DISTINCT x) пропускает NULL, поэтому группа со значениями «Москва» и NULL выглядела бы согласованной. Запись ROW(x) превращает значение в одноэлементную строку, которая сама NULL не является, и пустое значение считается отдельным:
SELECT count(DISTINCT x) AS distinct_values, count(DISTINCT ROW(x)) AS distinct_rows
FROM (VALUES ('Москва'), (NULL), ('Москва')) AS v(x);
 distinct_values | distinct_rows
-----------------+---------------
               1 |             2
(1 row)
Зависимость X → Y называется тривиальной (англ. trivial), если Y ⊆ X, например {order_id, isbn} → isbn; такие зависимости выполняются в любом отношении. Через зависимости выражаются и ключи (тема 2): K — суперключ (англ. superkey) отношения R, если K → R, а потенциальный ключ (англ. candidate key) — минимальный по включению суперключ. Ограничения PRIMARY KEY и UNIQUE объявляют именно такие зависимости, и СУБД проверяет их сама. Зависимость с несуперключевой левой частью, например publisher → pub_city в таблице wide, средствами объявления схемы не выражается. Это главный практический довод в пользу нормализации: в хорошей схеме все зависимости следуют из ключей.
Правила вывода: аксиомы Армстронга
Из одних зависимостей следуют другие. Если isbn → publisher и publisher → pub_city, то, очевидно, и isbn → pub_city: две книги с одинаковым ISBN имеют одно издательство, а значит, и один город издательства. Говорят, что множество зависимостей F логически влечёт зависимость f (записывается F ⊨ f), если f выполняется в любом отношении, в котором выполняются все зависимости из F. Множество всех зависимостей, следующих из F, называют замыканием F и обозначают F⁺.
У. Армстронг в 1974 году предложил три правила вывода 3. Пусть X, Y, Z — множества атрибутов, а XY обозначает объединение X ∪ Y.
- Рефлексивность (англ. reflexivity): если Y ⊆ X, то X → Y. Правило порождает тривиальные зависимости.
- Пополнение (англ. augmentation): если X → Y, то X ∪ Z → Y ∪ Z для любого Z.
- Транзитивность (англ. transitivity): если X → Y и Y → Z, то X → Z.
Правила корректны (англ. sound): всё выводимое действительно следует из F. Важнее, что они полны (англ. complete): любая зависимость, логически следующая из F, выводится из F тремя правилами 310.
Из аксиом получают удобные производные правила:
- объединение: если X → Y и X → Z, то X → Y ∪ Z;
- декомпозиция (расщепление правой части): если X → Y ∪ Z, то X → Y и X → Z;
- псевдотранзитивность: если X → Y и Y ∪ W → Z, то X ∪ W → Z.
Выведем для примера правило объединения. Пополним X → Y множеством X: получим X → X ∪ Y (объединение X с самим собой есть X). Пополним X → Z множеством Y: получим X ∪ Y → Y ∪ Z. По транзитивности из двух полученных зависимостей X → Y ∪ Z. Декомпозиция выводится ещё проще: Y ⊆ Y ∪ Z, по рефлексивности Y ∪ Z → Y, затем транзитивность.
Из правила декомпозиции следует, что любое множество зависимостей можно переписать так, чтобы правые части состояли из одного атрибута, — это понадобится при построении минимального покрытия. Обратного правила для левых частей нет: из {A, B} → C не следует ни A → C, ни B → C. Цена позиции зависит от пары «заказ — книга», но не от заказа и не от книги в отдельности.
Замыкание множества атрибутов
Перебирать вывод по аксиомам неудобно: замыкание F⁺ содержит экспоненциально много зависимостей (одних тривиальных зависимостей для n атрибутов 3ⁿ). Практически все задачи решает более узкое понятие. Замыканием множества атрибутов X относительно F (англ. attribute closure) называется множество X⁺ всех атрибутов A, для которых F ⊨ X → A 910. Зависимость X → Y следует из F тогда и только тогда, когда Y ⊆ X⁺.
Алгоритм вычисления замыкания прост.
- Положить результат равным X.
- Перебирать зависимости V → W из F. Если V целиком содержится в результате, а W — ещё нет, добавить W к результату.
- Повторять шаг 2, пока результат меняется. Итоговое множество и есть X⁺.
Каждый проход либо добавляет атрибут, либо завершает работу, поэтому проходов не больше числа атрибутов. Корректность доказывается в две стороны: всё добавленное выводится по аксиомам, а если алгоритм остановился, то отношение из двух строк, совпадающих ровно на атрибутах результата, удовлетворяет F и нарушает X → A для любого A вне результата. Существует и алгоритм, линейный относительно длины записи F 8.
Пример. Пусть R(A, B, C, D, E, G) и F = { {A, B} → C, C → A, {B, C} → D, {A, C, D} → B, D → {E, G}, {B, E} → C, {C, G} → {B, D}, {C, E} → {A, G} } — известный пример из учебной литературы 9. Вычислим {B, D}⁺:
| Шаг | Применённая зависимость | Результат |
|---|---|---|
| 0 | — | {B, D} |
| 1 | D → {E, G}: D входит в результат | {B, D, E, G} |
| 2 | {B, E} → C: B и E входят в результат | {B, C, D, E, G} |
| 3 | {C, E} → {A, G}: C и E входят в результат | {A, B, C, D, E, G} |
Результат содержит все атрибуты R, следовательно, {B, D} — суперключ. Проверим, нет ли в нём лишнего: {B}⁺ = {B} (ни одна левая часть не содержится в {B}), {D}⁺ = {D, E, G}. Значит, {B, D} — потенциальный ключ.
Тот же алгоритм на широкой таблице заказов. Зададим зависимости, отражающие правила магазина:
- order_id → {created_at, customer_id};
- customer_id → {email, cust_city};
- email → customer_id;
- isbn → {title, publisher};
- publisher → pub_city;
- {order_id, isbn} → {quantity, price}.
Тогда {order_id}⁺ вычисляется в два шага: первая зависимость добавляет created_at и customer_id, вторая — email и cust_city; получаем {order_id, created_at, customer_id, email, cust_city}. Это ровно атрибуты, описывающие заказ и его покупателя, — будущая таблица заказов вместе с таблицей покупателей. Аналогично {isbn}⁺ = {isbn, title, publisher, pub_city}. Наконец, {order_id, isbn}⁺ объединяет оба замыкания и добавляет quantity и price — это все одиннадцать атрибутов, так что {order_id, isbn} — суперключ. Рисунок ниже показывает, как растёт замыкание.
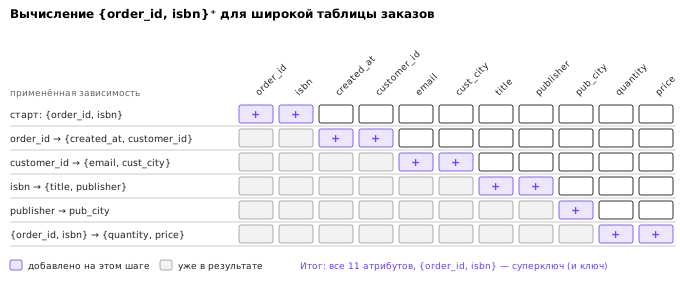
Замыкание отвечает на основные вопросы проектирования: следует ли зависимость из F, является ли множество суперключом, лишний ли атрибут в левой части, эквивалентны ли два множества зависимостей.
Потенциальные ключи и минимальное покрытие
Найти все потенциальные ключи отношения — первая задача анализа схемы, потому что от ключей зависят определения нормальных форм. В общем случае ключей может быть экспоненциально много, а задача «входит ли данный атрибут хотя бы в один ключ» NP-полна 14; но для схем реального размера помогает простое наблюдение. Разделим атрибуты R на группы по тому, где они встречаются в нетривиальных частях зависимостей из F:
- атрибут, который не встречается ни в одной правой части, ничем не определяется и потому входит в каждый ключ — назовём такие атрибуты ядром;
- атрибут, который встречается только в правых частях, не входит ни в один ключ: он выводится из остальных атрибутов любого суперключа;
- остальные атрибуты (встречающиеся и слева, и справа) могут входить в ключи, а могут и не входить.
Алгоритм: вычислить замыкание ядра; если оно содержит все атрибуты, ядро — единственный ключ. Иначе перебирать добавки к ядру из атрибутов третьей группы по возрастанию размера, пропуская надмножества уже найденных ключей; каждое множество, замыкание которого содержит все атрибуты, — ключ.
Пример. R(A, B, C, D, E), F = {A → B, {B, C} → E, {E, D} → A}.
- Правые части: B, E, A. Атрибуты C и D не встречаются справа — ядро {C, D}. Атрибутов, встречающихся только справа, нет: B стоит слева в {B, C} → E, E — в {E, D} → A, A — в A → B. Третья группа — {A, B, E}.
- {C, D}⁺ = {C, D}: ни одна левая часть не содержится в ядре, ядро — не ключ.
- Добавки из одного атрибута. {A, C, D}⁺: A → B даёт B, затем {B, C} → E даёт E — все пять атрибутов, ключ. {B, C, D}⁺: {B, C} → E, затем {E, D} → A — ключ. {C, D, E}⁺: {E, D} → A, затем A → B — ключ.
- Добавки из двух атрибутов содержат один из найденных ключей и пропускаются.
Ответ: три ключа {A, C, D}, {B, C, D} и {C, D, E}. Атрибуты, входящие хотя бы в один потенциальный ключ, называют ключевыми, или первичными (англ. prime attributes); здесь ключевые все пять. Для широкой таблицы заказов ядро — {order_id, isbn}: эти атрибуты не встречаются в правых частях, а замыкание ядра, как показано выше, содержит всё. Единственный ключ — {order_id, isbn}.
Второй инструмент — минимальное покрытие. Множества зависимостей F и G эквивалентны (G — покрытие F), если F⁺ = G⁺, то есть каждая зависимость одного множества выводится из другого. Минимальным, или каноническим, покрытием (англ. minimal cover, canonical cover) называют эквивалентное F множество G, в котором правая часть каждой зависимости — один атрибут, ни из одной левой части нельзя удалить атрибут без потери эквивалентности и ни одну зависимость нельзя удалить без потери эквивалентности 910. Минимальное покрытие — «очищенная» запись правил предметной области без повторов и лишних условий; оно служит входом алгоритма синтеза третьей нормальной формы. Строится оно в три шага, и порядок шагов важен.
- Расщепить правые части: X → {A, B} заменить на X → A и X → B.
- Удалить лишние атрибуты левых частей. Атрибут B в зависимости X → A, где B ∈ X, лишний, если A ∈ (X − {B})⁺, причём замыкание вычисляется относительно текущего множества зависимостей.
- Удалить избыточные зависимости. Зависимость f избыточна, если она следует из остальных: A ∈ X⁺ относительно множества без f.
Небольшой пример: F = {A → {B, C}, B → C, A → B, {A, B} → C}. Шаг 1 даёт A → B, A → C, B → C, {A, B} → C. На шаге 2 в {A, B} → C атрибут A лишний: {B}⁺ = {B, C} содержит C; зависимость превращается в B → C и совпадает с уже имеющейся. На шаге 3 зависимость A → C избыточна: без неё {A}⁺ = {A, B, C}. Минимальное покрытие — {A → B, B → C}.
Минимальное покрытие не единственно. Для F = {A → B, B → A, A → C, B → C} каждая из двух последних зависимостей избыточна при наличии другой, и в зависимости от порядка проверки получаются покрытия {A → B, B → A, B → C} или {A → B, B → A, A → C}; все минимальные покрытия эквивалентны. Шаги 2 и 3 нельзя менять местами: после сокращения левой части какая-то зависимость может стать избыточной, а проверка на избыточность уже пройдена.
Нормальные формы
Первая нормальная форма и споры об атомарности
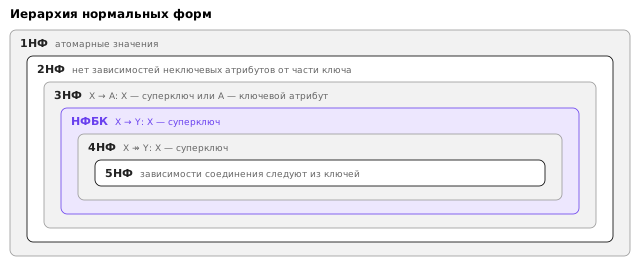
Нормальная форма (англ. normal form) — условие на схему отношения и множество зависимостей, исключающее определённый вид избыточности. Нормальные формы вложены друг в друга (иерархия показана на рисунке в конце раздела). Нормализация (англ. normalization) — замена отношения, не удовлетворяющего нужной форме, набором отношений, которые ей удовлетворяют.
Отношение находится в первой нормальной форме (1НФ, англ. first normal form), если значения всех его атрибутов атомарны, то есть не являются множествами, списками или отношениями 19. Поле «авторы» со значением «Аркадий Стругацкий, Борис Стругацкий» нарушает 1НФ: чтобы найти книги Бориса Стругацкого, придётся разбирать строку, ничто не мешает записать автора с опечаткой или лишним пробелом, а внешний ключ на таблицу авторов поставить нельзя. Нарушение устраняется выносом повторяющейся группы в отдельное отношение — так устроена таблица book_author.
Понятие атомарности относительно: дата состоит из года, месяца и дня, строка — из символов, и СУБД умеет извлекать их части. К. Дейт поэтому определяет 1НФ как требование, чтобы каждый кортеж содержал ровно одно значение каждого атрибута из его домена, сколь угодно сложного 11. Практическое правило: если по части значения нужно искать, на неё нужно ссылаться внешним ключом или на неё распространяется ограничение, эта часть должна быть отдельным атрибутом или отдельной строкой.
Массивы и тип jsonb в PostgreSQL позволяют хранить в одном поле список или документ. Массив тегов книги формально нарушает 1НФ, но может быть разумным решением, если элементы не являются сущностями, на которые ссылаются, и не требуют ограничений целостности; подробно — в теме 9. Кроме того, в теории нормализации предполагается, что строки отношения различны, а пустых значений нет (отличия таблицы SQL от отношения — в теме 2).
Вторая и третья нормальные формы
Определения второй и третьей нормальных форм опираются на различие ключевых и неключевых атрибутов. Напомним: атрибут ключевой (первичный), если входит хотя бы в один потенциальный ключ, и неключевой — в противном случае.
Отношение находится во второй нормальной форме (2НФ), если оно в 1НФ и ни один неключевой атрибут не зависит функционально от собственного подмножества какого-либо потенциального ключа 29. Иначе говоря, каждый неключевой атрибут зависит от ключа целиком, а не от его части. Нарушение 2НФ называют частичной зависимостью (англ. partial dependency). В широкой таблице с ключом {order_id, isbn} неключевой атрибут title зависит от части ключа — isbn, а email — от другой части, order_id (через customer_id). Таблица wide не находится во 2НФ. Если ключ состоит из одного атрибута, частичных зависимостей не бывает, и отношение в 1НФ автоматически находится во 2НФ.
Отношение находится в третьей нормальной форме (3НФ), если для каждой нетривиальной зависимости X → A, выполняющейся в нём, либо X — суперключ, либо A — ключевой атрибут 29. Эквивалентная формулировка Кодда: отношение во 2НФ, и ни один неключевой атрибут не зависит транзитивно от ключа, то есть через другой неключевой атрибут. Нарушение 3НФ называют транзитивной зависимостью (англ. transitive dependency). Отношение Книга(isbn, title, publisher, pub_city) находится во 2НФ (ключ из одного атрибута), но не в 3НФ: publisher → pub_city, а publisher не суперключ и pub_city не ключевой атрибут. Город издательства зависит от ISBN транзитивно: isbn → publisher → pub_city. Именно эта зависимость породила 5368 копий города «Питера».
Обе формы устраняют один вид избыточности: факт, определяемый не ключом, хранится в каждом кортеже с данным значением детерминанта. 2НФ запрещает лишь зависимости от части ключа, 3НФ — от любого множества, не являющегося суперключом, поэтому на практике проверяют сразу 3НФ.
Нормальная форма Бойса — Кодда и пример, где она отличается от 3НФ
В определении 3НФ есть оговорка: зависимость X → A с несуперключевой левой частью допустима, если A — ключевой атрибут. Если её убрать, получится более строгая форма. Отношение находится в нормальной форме Бойса — Кодда (НФБК, англ. Boyce — Codd normal form, BCNF), если для каждой нетривиальной зависимости X → Y, выполняющейся в нём, X — суперключ 910. Форма предложена Р. Бойсом и Э. Коддом в 1974 году. Определение НФБК короче и яснее: в отношении нет других нетривиальных зависимостей, кроме тех, что следуют из ключей, а значит, все ограничения такого рода СУБД проверяет через PRIMARY KEY и UNIQUE.
Любое отношение в НФБК находится в 3НФ. Обратное неверно, и классический пример — почтовый адрес 910. Рассмотрим отношение Адрес(улица, город, индекс) со следующими правилами: улица в городе однозначно определяет почтовый индекс — {улица, город} → индекс (для простоты считаем, что вся улица обслуживается одним отделением), а индекс однозначно определяет город — индекс → город.
Найдём ключи. Атрибут «улица» не встречается в правых частях и входит в любой ключ. {улица}⁺ = {улица}. Добавки: {улица, город}⁺ = {улица, город, индекс} и {улица, индекс}⁺ = {улица, индекс, город} — оба множества ключи. Ключевые все три атрибута.
Проверим 3НФ. Зависимость {улица, город} → индекс — левая часть суперключ. Зависимость индекс → город — левая часть не суперключ, но «город» — ключевой атрибут, и 3НФ допускает такую зависимость. Отношение в 3НФ, но не в НФБК.
Избыточность при этом есть: факт «индекс 630090 относится к Новосибирску» записан в каждой строке с этим индексом, и ограничения ключа не помешают ввести для двух таких строк разные города. Декомпозиция по нарушающей зависимости даёт Индекс(индекс, город) с ключом {индекс} и Улица(улица, индекс) с ключом {улица, индекс}. Оба отношения в НФБК, соединение восстанавливает исходное без потерь (см. следующий раздел), но зависимость {улица, город} → индекс потеряна: улица и город больше не встречаются в одном отношении. Ничто не помешает записать в Улица строки (Ленина, 630090) и (Ленина, 630091) с двумя новосибирскими индексами, и проверить правило можно будет только запросом с соединением или триггером (тема 14).
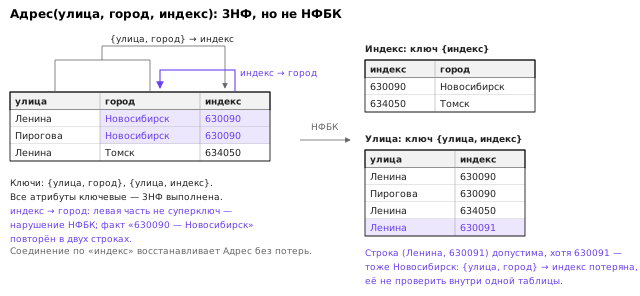
Пример показывает принципиальный компромисс: для некоторых отношений нет декомпозиции, которая одновременно приводит все части в НФБК и сохраняет все зависимости. 3НФ — это форма, для которой такая декомпозиция существует всегда; НФБК — форма без избыточности, обусловленной функциональными зависимостями, но иногда ценой потери проверяемости ограничения. Абстрактный пример той же ситуации — отношение R(A, B, C, D, E) с F = {A → B, {B, C} → E, {E, D} → A} из предыдущего раздела: все атрибуты ключевые, поэтому отношение в 3НФ, но A → B нарушает НФБК, так как {A}⁺ = {A, B} — не суперключ.
Сводка определений приведена в таблице.
| Форма | Условие (для нетривиальных X → A) | Что запрещено |
|---|---|---|
| 1НФ | значения атрибутов атомарны | повторяющиеся группы, списки в поле |
| 2НФ | 1НФ; неключевой A не зависит от части потенциального ключа | частичные зависимости |
| 3НФ | X — суперключ или A — ключевой атрибут | транзитивные зависимости неключевых атрибутов |
| НФБК | X — суперключ | любые зависимости с несуперключевой левой частью |
| 4НФ | для нетривиальных многозначных X ↠ Y: X — суперключ | независимые многозначные факты в одном отношении |
| 5НФ | каждая зависимость соединения следует из ключей | избыточность, устранимая лишь разбиением на три и более части |
Определение нормальной формы проверяется не только на исходных зависимостях, но и на всех, которые следуют из F и относятся к атрибутам отношения. Это существенно после декомпозиции: зависимости на атрибутах части отношения — это проекция F⁺ на эти атрибуты, и в ней могут оказаться зависимости, которых в исходной записи F не было. Например, если R(A, B, C) с F = {A → B, B → C} разбить на R1(A, C) и R2(A, B), то в R1 выполняется A → C, хотя такой зависимости в F нет. Для проверки НФБК отношения Ri достаточно для каждого подмножества X ⊆ Ri вычислить X⁺ относительно F: если X⁺ ∩ Ri содержит что-то кроме X, но не все атрибуты Ri, найдено нарушение.
Декомпозиция отношений
Соединение без потерь и теорема Хита
Декомпозицией схемы R называется набор схем R1, …, Rk, объединение атрибутов которых равно R; экземпляр r заменяется проекциями r1 = π(R1)(r), …, rk = π(Rk)(r). Декомпозиция обладает свойством соединения без потерь (англ. lossless join), если для любого допустимого экземпляра r естественное соединение проекций совпадает с r. Соединение проекций всегда содержит r: каждый исходный кортеж собирается из своих же кусков. Опасность в обратном — соединение может породить лишние, ложные кортежи (англ. spurious tuples). Название «с потерями» парадоксально, но точно: теряется не строка, а информация о том, какие сочетания значений были на самом деле.
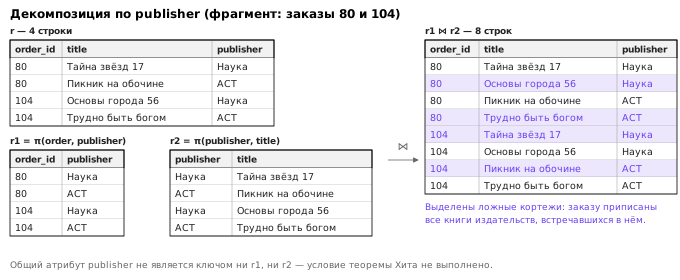
Проверим это на данных. Возьмём три заказа и только три атрибута — заказ, ISBN и издательство — и разобьём их двумя способами. Сначала неудачно: на (order_id, publisher) и (publisher, isbn), то есть «в каком заказе были книги каких издательств» и «какие книги выпускает издательство».
CREATE TABLE t08.r AS
SELECT order_id, isbn, publisher FROM t08.wide WHERE order_id IN (80, 104, 122);
CREATE TABLE t08.r1 AS SELECT DISTINCT order_id, publisher FROM t08.r;
CREATE TABLE t08.r2 AS SELECT DISTINCT publisher, isbn FROM t08.r;
SELECT (SELECT count(*) FROM t08.r) AS r,
       (SELECT count(*) FROM t08.r1 JOIN t08.r2 USING (publisher)) AS r1_join_r2;
 r | r1_join_r2
---+------------
 9 |         20
(1 row)
Из девяти исходных строк получилось двадцать. Какие из них ложные, показывает разность:
SELECT order_id, isbn, publisher FROM t08.r1 JOIN t08.r2 USING (publisher)
EXCEPT
SELECT order_id, isbn, publisher FROM t08.r
ORDER BY publisher, order_id, isbn;
 order_id |     isbn      | publisher
----------+---------------+-----------
       80 | 9785170878246 | АСТ
      104 | 9785170878239 | АСТ
      122 | 9785170878239 | АСТ
       80 | 9780000000056 | Наука
       80 | 9780000000092 | Наука
      104 | 9780000000017 | Наука
      104 | 9780000000092 | Наука
      122 | 9780000000017 | Наука
      122 | 9780000000056 | Наука
      104 | 9780000000085 | Самокат
      122 | 9780000000813 | Самокат
(11 rows)
Соединение «приписало» каждому заказу все книги тех издательств, книги которых в нём были: в заказе 80 был «Пикник на обочине» издательства АСТ, и соединение добавило в него «Трудно быть богом» того же издательства. Общий атрибут publisher не определяет ни заказ, ни книгу, и по проекциям восстановить, какие книги были в каком заказе, невозможно. Рисунок иллюстрирует механизм.
Теперь удачная декомпозиция: (order_id, isbn) и (isbn, publisher). Проверка соединения без потерь в SQL — разность в обе стороны: обе должны быть пустыми.
CREATE TABLE t08.s1 AS SELECT DISTINCT order_id, isbn FROM t08.r;
CREATE TABLE t08.s2 AS SELECT DISTINCT isbn, publisher FROM t08.r;
SELECT 'r EXCEPT s1⋈s2' AS direction, count(*) FROM (
    SELECT order_id, isbn, publisher FROM t08.r
    EXCEPT
    SELECT order_id, isbn, publisher FROM t08.s1 JOIN t08.s2 USING (isbn)) d
UNION ALL
SELECT 's1⋈s2 EXCEPT r', count(*) FROM (
    SELECT order_id, isbn, publisher FROM t08.s1 JOIN t08.s2 USING (isbn)
    EXCEPT
    SELECT order_id, isbn, publisher FROM t08.r) d
ORDER BY direction;
   direction    | count
----------------+-------
 r EXCEPT s1⋈s2 |     0
 s1⋈s2 EXCEPT r |     0
(2 rows)
Разность в обе стороны пуста. Заметим, что такая проверка на конкретных данных, как и проверка гипотезы о зависимости, лишь не находит контрпример; гарантию для любых допустимых данных даёт теорема.
Теорема Хита (1971) 4: если в отношении R(X, Y, Z) выполняется X → Y, то декомпозиция на R1(X, Y) и R2(X, Z) обладает свойством соединения без потерь. Доказательство короткое. Пусть в соединении есть кортеж (x, y, z). Он получен из кортежа (x, y) проекции R1, который происходит от некоторого (x, y, z′) из r, и из кортежа (x, z) проекции R2, который происходит от некоторого (x, y′, z) из r. Оба исходных кортежа совпадают по X, значит, по зависимости X → Y совпадают и по Y: y′ = y. Следовательно, (x, y, z) = (x, y′, z) ∈ r, и ложных кортежей нет.
Отсюда критерий для декомпозиции на две части 910: декомпозиция R на R1 и R2 без потерь тогда и только тогда, когда R1 ⊆ (R1 ∩ R2)⁺ или R2 ⊆ (R1 ∩ R2)⁺, то есть общие атрибуты — суперключ хотя бы одной из частей. В удачном варианте {isbn}⁺ содержит publisher, в неудачном {publisher}⁺ = {publisher, pub_city} не содержит ни order_id, ни isbn. Слова «тогда и только тогда» верны, если ограничения исчерпываются функциональными зависимостями (см. раздел о многозначных зависимостях).
Для декомпозиции на большее число частей применяется алгоритм погони (англ. chase) 10. Строится таблица: строка i соответствует части Ri, столбцы — атрибутам R; на местах атрибутов Ri стоит символ a, на остальных — символ b с индексом строки. Пока возможно, строки, совпадающие по левой части какой-либо зависимости из F, уравниваются по её правой части (символ a побеждает b). Декомпозиция без потерь тогда и только тогда, когда появляется строка из одних a. Для R(A, B, C, D), F = {A → B, B → C} и частей {A, B}, {B, C}, {A, D} третья строка (a, b, b, a) по A → B получает a в столбце B, затем по B → C — в столбце C: декомпозиция без потерь. Для частей {A, B}, {B, C}, {C, D} строка из одних a не появляется.
Сохранение зависимостей
Второе желательное свойство декомпозиции касается ограничений. Проекцией множества F на схему Ri называют множество всех зависимостей из F⁺, обе части которых состоят из атрибутов Ri. Декомпозиция сохраняет зависимости (англ. dependency preserving), если объединение проекций F на R1, …, Rk эквивалентно F 9. Практический смысл: каждое ограничение можно проверить внутри одной таблицы — при вставке строки в Ri достаточно проверить зависимости, относящиеся к Ri, и не нужно соединять таблицы.
Вычислять проекции дорого: в общем случае приходится перебирать все подмножества атрибутов Ri. Проверить, сохраняется ли конкретная зависимость X → Y, можно без них 9. Положим Z = X и будем, пока Z растёт, для каждой части Ri добавлять к Z множество ((Z ∩ Ri)⁺ ∩ Ri), где замыкание вычисляется относительно F. Зависимость сохраняется, если в конце Y ⊆ Z. Смысл процедуры: Z — всё, что можно вывести, «переходя» из таблицы в таблицу только по зависимостям, проверяемым внутри каждой таблицы.
Для адреса: зависимость {улица, город} → индекс и части Индекс(индекс, город), Улица(улица, индекс). Начинаем с Z = {улица, город}. Для части Индекс: Z ∩ {индекс, город} = {город}, {город}⁺ = {город}, ничего нового. Для части Улица: Z ∩ {улица, индекс} = {улица}, {улица}⁺ = {улица}, ничего нового. Z не изменилось и не содержит «индекс» — зависимость потеряна, что и было показано в разделе о НФБК.
Свойства соединения без потерь и сохранения зависимостей независимы. Соединение без потерь обязательно: без него декомпозиция искажает данные. Сохранение зависимостей желательно: без него часть ограничений придётся проверять запросами или триггерами.
Алгоритм синтеза третьей нормальной формы
Ф. Бернстайн в 1976 году предложил строить схему в 3НФ не разбиением исходного отношения, а синтезом — непосредственно из зависимостей 5. В современной формулировке 910 алгоритм таков.
- Построить минимальное покрытие G множества F.
- Сгруппировать зависимости G по левым частям; для каждой группы X → A1, …, X → Am создать отношение со схемой X ∪ {A1, …, Am}.
- Если ни одно из созданных отношений не содержит потенциального ключа R, добавить отношение, схема которого — какой-нибудь ключ R.
- Удалить отношения, схема которых содержится в схеме другого отношения.
Результат всегда находится в 3НФ, сохраняет зависимости (каждая зависимость G целиком лежит в одном отношении) и обладает свойством соединения без потерь (это обеспечивает отношение с ключом, добавленное на шаге 3).
Применим алгоритм к широкой таблице заказов с одиннадцатью атрибутами и шестью зависимостями, приведёнными выше.
Шаг 1. После расщепления правых частей получаем десять зависимостей: order_id → created_at, order_id → customer_id, customer_id → email, customer_id → cust_city, email → customer_id, isbn → title, isbn → publisher, publisher → pub_city, {order_id, isbn} → quantity, {order_id, isbn} → price. Лишних атрибутов в левых частях нет: единственные составные левые части — {order_id, isbn}, а {order_id}⁺ и {isbn}⁺ не содержат ни quantity, ни price. Избыточных зависимостей тоже нет: например, без customer_id → email множество {customer_id}⁺ = {customer_id, cust_city}, и email не выводится. Покрытие уже минимально.
Шаг 2. Группы по левым частям дают шесть отношений:
| Левая часть | Отношение |
|---|---|
| order_id | {order_id, created_at, customer_id} |
| customer_id | {customer_id, email, cust_city} |
| {email, customer_id} | |
| isbn | {isbn, title, publisher} |
| publisher | {publisher, pub_city} |
| {order_id, isbn} | {order_id, isbn, quantity, price} |
Шаг 3. Ключ R — {order_id, isbn} — содержится в последнем отношении, добавлять ничего не нужно.
Шаг 4. Отношение {email, customer_id} содержится в {customer_id, email, cust_city} и удаляется.
Получено пять отношений — заказ, покупатель, книга, издательство, позиция заказа. Это та самая схема, по которой построена учебная база (с суррогатными ключами вместо названия издательства). Проверим соединение без потерь на всех 59 910 строках: создадим пять таблиц запросами SELECT DISTINCT по атрибутам каждого отношения (таблицы t08.customer_n, orders_n, book_n, publisher_n, item_n), соберём их обратно представлением t08.joined и сравним с исходной таблицей:
CREATE VIEW t08.joined AS
SELECT i.order_id, o.created_at, c.customer_id, c.email, c.cust_city,
       i.isbn, b.title, b.publisher, p.pub_city, i.quantity, i.price
FROM t08.item_n i
JOIN t08.orders_n o USING (order_id)
JOIN t08.customer_n c USING (customer_id)
JOIN t08.book_n b USING (isbn)
LEFT JOIN t08.publisher_n p USING (publisher);
SELECT (SELECT count(*) FROM (SELECT * FROM t08.wide
                              EXCEPT SELECT * FROM t08.joined) d) AS wide_minus_joined,
       (SELECT count(*) FROM (SELECT * FROM t08.joined
                              EXCEPT SELECT * FROM t08.wide) d) AS joined_minus_wide;
 wide_minus_joined | joined_minus_wide
-------------------+-------------------
                 0 |                 0
(1 row)
У 2868 строк издательство не указано, и внутреннее соединение по publisher потеряло бы их, поскольку NULL не равен NULL; поэтому последнее соединение внешнее. Операция EXCEPT, напротив, считает два NULL одинаковыми, и сравнение корректно.
Для отношения Адрес(улица, город, индекс) синтез даёт отношения {улица, город, индекс} и {индекс, город}; второе содержится в первом и удаляется — исходное отношение уже в 3НФ, и алгоритм его не меняет.
Алгоритм декомпозиции в НФБК
Схему в НФБК получают разбиением 910.
- Начать с набора из одного отношения R.
- Пока в наборе есть отношение Ri не в НФБК: найти нарушающую зависимость X → Y (X ⊆ Ri, X не суперключ Ri, Y ⊆ Ri, Y ⊄ X) и заменить Ri двумя отношениями: Ri1 = X⁺ ∩ Ri и Ri2 = X ∪ (Ri − X⁺).
Каждый шаг — декомпозиция по теореме Хита: общая часть новых отношений — X, и X определяет все атрибуты Ri1, поэтому результат обладает свойством соединения без потерь. Отношения уменьшаются, и алгоритм заканчивается (отношение из двух атрибутов всегда в НФБК). Сохранение зависимостей не гарантируется, а результат зависит от порядка выбора нарушений.
Для широкой таблицы заказов алгоритм работает так (на каждом шаге выбрано первое найденное нарушение):
- R — все 11 атрибутов. Нарушение customer_id → email: {customer_id}⁺ = {customer_id, email, cust_city}. Отделяем R1 = {customer_id, email, cust_city}; остаётся {order_id, created_at, customer_id, isbn, title, publisher, pub_city, quantity, price}.
- В остатке нарушение isbn → publisher: {isbn}⁺ ∩ остаток = {isbn, title, publisher, pub_city}. Отделяем это отношение; остаётся {order_id, created_at, customer_id, isbn, quantity, price}.
- В {isbn, title, publisher, pub_city} нарушение publisher → pub_city (транзитивная зависимость): получаем {publisher, pub_city} и {isbn, title, publisher}.
- В {order_id, created_at, customer_id, isbn, quantity, price} нарушение order_id → created_at: получаем {order_id, created_at, customer_id} и {order_id, isbn, quantity, price}.
Все пять отношений в НФБК и совпадают с результатом синтеза. Для адреса же синтез оставляет отношение как есть (3НФ), а декомпозиция в НФБК разбивает его и теряет зависимость.
Как выбирать между ними? Обычно рекомендуют стремиться к НФБК, а если это ведёт к потере важной зависимости, остановиться на 3НФ 910. В реальных схемах ситуация «3НФ, но не НФБК» встречается нечасто: она требует перекрывающихся составных потенциальных ключей, как {улица, город} и {улица, индекс}.
За пределами НФБК и денормализация
Многозначные зависимости и четвёртая нормальная форма
НФБК устраняет избыточность, порождаемую функциональными зависимостями, но не всякую. Пусть в одной таблице хранятся авторы книги и склады, на которых она есть: (book_id, author, warehouse). Посмотрим на «Пикник на обочине»:
SELECT ba.book_id, a.full_name AS author, w.city AS warehouse
FROM bookstore.book_author ba
JOIN bookstore.author a USING (author_id)
JOIN bookstore.stock s USING (book_id)
JOIN bookstore.warehouse w USING (warehouse_id)
WHERE ba.book_id = 4
ORDER BY author, warehouse;
 book_id |       author       | warehouse
---------+--------------------+-----------
       4 | Аркадий Стругацкий | Казань
       4 | Аркадий Стругацкий | Москва
       4 | Борис Стругацкий   | Казань
       4 | Борис Стругацкий   | Москва
(4 rows)
Нетривиальных функциональных зависимостей здесь нет, ключ — все три атрибута, отношение в НФБК. Тем не менее факт «книга есть в Казани» записан дважды, по разу для каждого автора, а добавление склада потребует двух строк. Множества авторов и складов книги независимы, и таблица хранит их декартово произведение; для всей учебной базы соединение book_author (2424 строки) и stock (4804 строки) по книге даёт 5778 строк.
Такое ограничение называется многозначной зависимостью (англ. multivalued dependency, MVD) и записывается X ↠ Y. В отношении R(X, Y, Z) выполняется X ↠ Y, если для любых двух кортежей, совпадающих по X, в отношении есть и кортеж, взявший X и Y из первого, а Z — из второго 6. Здесь book_id ↠ author: для каждой книги множество авторов не зависит от склада. Многозначные зависимости появляются парами: из X ↠ Y следует X ↠ Z, поэтому пишут book_id ↠ author | warehouse. Любая функциональная зависимость является и многозначной (множество значений Y состоит из одного элемента). Для многозначных зависимостей справедлив аналог теоремы Хита, причём в форме «тогда и только тогда»: декомпозиция R(X, Y, Z) на (X, Y) и (X, Z) без потерь в точности тогда, когда X ↠ Y 6.
Отношение находится в четвёртой нормальной форме (4НФ), если для каждой нетривиальной многозначной зависимости X ↠ Y левая часть X — суперключ 6. Таблица (book_id, author, warehouse) не в 4НФ и раскладывается на (book_id, author) и (book_id, warehouse) — ровно book_author и stock. Обычно нарушение 4НФ — результат объединения двух независимых связей «многие ко многим» в одну таблицу; правильно построенная ER-модель (тема 7) его не допускает.
Зависимости соединения и пятая нормальная форма
Обобщение многозначной зависимости на произвольное число частей — зависимость соединения (англ. join dependency) ⋈(R1, …, Rk): отношение всегда равно соединению своих проекций на R1, …, Rk. Многозначная зависимость — это зависимость соединения с двумя частями. Отношение находится в пятой нормальной форме (5НФ, она же нормальная форма проекции — соединения, англ. project-join normal form), если каждая выполняющаяся в нём зависимость соединения следует из потенциальных ключей 712.
В теме 7 три бинарные проекции тернарной связи «поставщик поставляет книгу на склад», соединённые обратно, давали ложную тройку: зависимости соединения там не было, и тернарная таблица — единственно верное представление. Но если действует правило «если поставщик поставляет книгу, книга поступает на склад и поставщик работает со складом, то он поставляет эту книгу на этот склад», выполняется зависимость соединения ⋈({поставщик, книга}, {книга, склад}, {поставщик, склад}); тернарная таблица становится избыточной и раскладывается на три бинарные, но не на две. Такие правила редки, и 5НФ имеет в основном теоретическое значение 12.
Денормализация: когда и какой ценой
Нормализованная схема устраняет избыточность, но платит соединениями: чтобы показать позицию заказа с названием книги и городом покупателя, нужно соединить пять таблиц. Денормализация (англ. denormalization) — сознательное введение избыточности ради скорости чтения или простоты запросов. Важно слово «сознательное»: денормализуют уже нормализованную схему, точно зная, какая зависимость нарушается и кто отвечает за согласованность копий.
Типичные приёмы:
- кеширующий (производный) столбец: сумма заказа в таблице заказов, число отзывов и средний рейтинг в таблице книг;
- копирование атрибута по внешнему ключу: город покупателя в заказе, чтобы фильтровать заказы без соединения;
- материализованное представление (тема 6): результат запроса с соединениями и агрегатами хранится как таблица и обновляется командой
REFRESH MATERIALIZED VIEW13;
Не всякое повторение данных — денормализация. Цена в позиции заказа (order_item.price) только похожа на копию цены книги: она фиксирует цену на момент заказа, это самостоятельный факт с зависимостью {order_id, book_id} → price, а не нарушение нормальной формы.
Цена денормализации — поддержание согласованности. Кеширующий столбец вводит зависимость, которую СУБД не проверяет, и любой код, меняющий исходные данные в обход правил, порождает расхождение. Смоделируем это: сохраним суммы заказов в копии таблицы заказов, а затем изменим количество в одной позиции, забыв пересчитать сумму.
CREATE TABLE t08.orders_d AS
SELECT o.order_id, o.customer_id, o.status,
       (SELECT sum(oi.quantity * oi.price) FROM bookstore.order_item oi
        WHERE oi.order_id = o.order_id) AS total
FROM bookstore.orders o;
CREATE TABLE t08.order_item_d AS SELECT * FROM bookstore.order_item;
UPDATE t08.order_item_d SET quantity = quantity + 1
WHERE order_id = 104 AND book_id = 5;
SELECT d.order_id, d.total AS cached, sum(i.quantity * i.price) AS actual
FROM t08.orders_d d JOIN t08.order_item_d i USING (order_id)
GROUP BY d.order_id, d.total
HAVING d.total IS DISTINCT FROM sum(i.quantity * i.price);
 order_id | cached  | actual
----------+---------+---------
      104 | 5879.98 | 6419.98
(1 row)
Это та же аномалия обновления, с которой начиналась тема, только введённая намеренно. Поэтому у каждого денормализованного элемента должен быть механизм поддержания: триггер, пересчитывающий сумму в той же транзакции (тема 14), регулярное обновление материализованного представления, контрольный запрос вроде приведённого выше. Денормализуют по результатам измерений, когда индексы и анализ планов (темы 10 и 11) не помогли.
Итоги темы
Избыточность — хранение одного факта в нескольких строках — порождает аномалии обновления, вставки и удаления: копии факта расходятся, независимый факт нельзя записать без другого, удаление одного уничтожает другой. Строгим языком для описания того, какие факты от чего зависят, служат функциональные зависимости. Это ограничения предметной области: данные могут опровергнуть гипотезу о зависимости, но не доказать её, и решение принимает проектировщик.
Аксиомы Армстронга корректны и полны, а практически все вопросы о зависимостях решает вычисление замыкания множества атрибутов: с его помощью проверяется вывод зависимости, находятся потенциальные ключи и строится минимальное покрытие.
Нормальные формы описывают отсутствие определённой избыточности. 2НФ и 3НФ запрещают зависимости неключевых атрибутов от части ключа и от неключевых атрибутов, НФБК — любые нетривиальные зависимости, левая часть которых не суперключ. НФБК строже 3НФ, и пример с адресом показывает, что приведение к НФБК может потребовать потери зависимости, тогда как 3НФ всегда достижима с её сохранением.
Декомпозиция обязана быть соединением без потерь (для двух частей — общие атрибуты являются суперключом одной из них, по теореме Хита) и желательно должна сохранять зависимости. Алгоритм синтеза Бернстайна даёт схему в 3НФ с обоими свойствами, алгоритм декомпозиции — схему в НФБК без потерь. На учебной базе оба алгоритма получают из широкой таблицы те же пять отношений, по которым устроена схема bookstore. Многозначные зависимости и зависимости соединения продолжают ряд до 4НФ и 5НФ, а денормализация — осознанный обратный шаг, требующий механизма согласования копий.
Логическая схема в нормальной форме определяет, какие отношения и ключи нужны, но ничего не говорит о том, в каких типах хранить значения и как строки лежат на диске. Этим вопросам посвящена следующая тема — физическое проектирование.
Литература
- Codd E. F. A Relational Model of Data for Large Shared Data Banks. — Communications of the ACM, 1970, Т. 13, № 6, С. 377–387, DOI: 10.1145/362384.362685.
- Codd E. F. Further Normalization of the Data Base Relational Model. — In: Rustin R. (ed.) Data Base Systems. Courant Computer Science Symposia Series, Vol. 6. — Prentice-Hall, 1972, С. 33–64.
- Armstrong W. W. Dependency Structures of Data Base Relationships. — Information Processing 74: Proceedings of IFIP Congress 74. — North-Holland, 1974, С. 580–583.
- Heath I. J. Unacceptable File Operations in a Relational Data Base. — Proceedings of the 1971 ACM SIGFIDET Workshop on Data Description, Access and Control. — ACM, 1971, С. 19–33.
- Bernstein P. A. Synthesizing Third Normal Form Relations from Functional Dependencies. — ACM Transactions on Database Systems, 1976, Т. 1, № 4, С. 277–298, DOI: 10.1145/320493.320489.
- Fagin R. Multivalued Dependencies and a New Normal Form for Relational Databases. — ACM Transactions on Database Systems, 1977, Т. 2, № 3, С. 262–278, DOI: 10.1145/320557.320571.
- Fagin R. Normal Forms and Relational Database Operators. — Proceedings of the 1979 ACM SIGMOD International Conference on Management of Data. — ACM, 1979, С. 153–160.
- Beeri C., Bernstein P. A. Computational Problems Related to the Design of Normal Form Relational Schemas. — ACM Transactions on Database Systems, 1979, Т. 4, № 1, С. 30–59.
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Garcia-Molina H., Ullman J. D., Widom J. Database Systems: The Complete Book. 2nd ed. — Pearson Prentice Hall, 2008.
- Date C. J. Database Design and Relational Theory: Normal Forms and All That Jazz. — O'Reilly Media, 2012.
- Kent W. A Simple Guide to Five Normal Forms in Relational Database Theory. — Communications of the ACM, 1983, Т. 26, № 2, С. 120–125, DOI: 10.1145/358024.358054.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Section 41.3. Materialized Views. — 2024. https://www.postgresql.org/docs/16/rules-materializedviews.html
- Lucchesi C. L., Osborn S. L. Candidate Keys for Relations. — Journal of Computer and System Sciences, 1978, Т. 17, № 2, С. 270–279.