
Физическое проектирование: типы данных, хранение и полуструктурированные данные
В темах 7 и 8 схема базы данных строилась на логическом уровне: сущности и связи превращались в отношения, функциональные зависимости подсказывали, как разбить широкую таблицу на несколько узких без потери информации. Логическая схема отвечает на вопрос «какие отношения и с какими ключами нужны», но молчит о том, как эти отношения будут жить на диске. Между тем от решений этого уровня зависят и корректность (сумма платежей, посчитанная в числах с плавающей точкой, может не сойтись с банковской выпиской на копейку), и объём (одна и та же таблица при неудачном порядке столбцов занимает на пятую часть больше места), и скорость (таблица, которую можно отсечь целиком, не нужно читать).
Физическое проектирование (англ. physical design) — этап, на котором логическая схема превращается в объекты конкретной СУБД: выбираются типы данных столбцов, способы генерации ключей, размещение таблиц по схемам и табличным пространствам, разбиение больших таблиц на секции, а также индексы 14. Индексам посвящена отдельная тема 10, а здесь рассматривается всё остальное. В трёхуровневой архитектуре ANSI/SPARC, о которой шла речь в теме 1, это внутренний уровень, и благодаря физической независимости данных его можно менять, не переписывая запросы приложения.
Изложение построено так. Первый раздел посвящён выбору типов данных: числам, строкам, датам, перечислениям, массивам и диапазонам, доменам. Второй — генерации ключей: последовательностям, столбцам идентичности и UUID. Третий раздел спускается на уровень файлов и страниц и объясняет, как PostgreSQL хранит строку таблицы, почему порядок столбцов влияет на размер и что происходит с длинными значениями. Четвёртый посвящён полуструктурированным данным в форматах json и jsonb. Пятый рассматривает схемы, табличные пространства и секционирование таблиц. Все примеры выполнены в PostgreSQL 16 на учебной базе «Книжный узел» (scale=1, база bookstore); эксперименты, создающие собственные таблицы, выполняются в отдельной схеме lab09.
Выбор типов данных
Целые числа, numeric и числа с плавающей точкой
Тип данных столбца — это одновременно ограничение целостности (в столбец integer нельзя записать строку), способ представления значения в памяти и на диске и набор операций над ним. Стандарт SQL определяет несколько семейств числовых типов, и PostgreSQL реализует их все 1.
Целые типы smallint, integer и bigint занимают 2, 4 и 8 байт и хранят числа в диапазонах примерно ±32 тысячи, ±2,1 миллиарда и ±9,2·10¹⁸ соответственно. Арифметика над ними точная, а переполнение — ошибка, а не «заворачивание» значения, как в языке C:
SELECT 2147483647::integer + 1;
ERROR: integer out of range
Тип numeric(p, s) (синоним decimal) хранит десятичные числа с заданной точностью p — общим числом значащих цифр — и масштабом s — числом цифр после запятой. Без указания p и s он хранит числа практически любой длины: до 131 072 цифр до запятой и до 16 383 после 1. Внутри значение записывается в системе счисления с основанием 10 000 (каждые четыре десятичные цифры — двухбайтовое «слово»), поэтому длина представления переменная: цена 1290.00 из таблицы book занимает на диске 5 байт, а 0.00 — 3 байта. Операции над numeric выполняются программно и медленнее целочисленных, но результат точен в пределах заданного масштаба.
Типы real и double precision — это двоичные числа с плавающей точкой стандарта IEEE 754, 4 и 8 байт, с точностью около 6 и 15 десятичных знаков 15. Главное их свойство, которое нужно понимать при проектировании, состоит в том, что большинство десятичных дробей в двоичной системе непредставимы точно. Число 0,1 в двоичной записи — бесконечная периодическая дробь, и хранится лишь её приближение 6:
SELECT 0.1::float8 + 0.2::float8 AS f,
       0.1::float8 + 0.2::float8 = 0.3::float8 AS f_eq,
       0.1 + 0.2 AS n,
       0.1 + 0.2 = 0.3 AS n_eq;
          f          | f_eq |  n  | n_eq
---------------------+------+-----+------
 0.30000000000000004 | f    | 0.3 | t
Литерал 0.1 без приведения в PostgreSQL имеет тип numeric, поэтому вторая пара столбцов вычислена точно. Ошибка в одном сложении ничтожна, но она накапливается. Сумма миллиона слагаемых 0,1 должна равняться ровно 100 000:
SELECT sum(0.1::float8) AS f8, sum(0.1::float4) AS f4, sum(0.1::numeric) AS n
FROM generate_series(1, 1000000);
         f8         |    f4     |    n
--------------------+-----------+----------
 100000.00000133288 | 100958.34 | 100000.0
В double precision ошибка составила тысячные доли копейки, в real — почти тысячу рублей. Отсюда правило физического проектирования: денежные суммы, количества и всё, что должно сходиться при сложении и сравниваться на равенство, хранится в целых числах или в numeric с фиксированным масштабом; именно поэтому столбцы price и amount в «Книжном узле» объявлены как numeric(10, 2). Числа с плавающей точкой уместны для результатов измерений и научных расчётов, где значения изначально приближённые, а скорость и компактность важнее точного равенства. Сравнивать их на равенство не следует вовсе — только с допуском.
Тип money хранит сумму как 8-байтовое целое число минимальных единиц валюты и поэтому точен, но число знаков после запятой и формат вывода зависят от параметра lc_monetary: в учебном кластере с локалью C.UTF-8 запрос SELECT '1290.00'::money выводит $1,290.00, а резервная копия, восстановленная в базу с другой локалью, может быть прочитана неверно 1. Поэтому для денег обычно предпочитают numeric.
Строки, кодировки и правила сортировки
Стандарт SQL определяет строковые типы character(n) (сокращённо char(n)) — строку фиксированной длины, дополняемую пробелами, и character varying(n) (varchar(n)) — строку переменной длины не длиннее n символов. PostgreSQL добавляет к ним тип text — строку произвольной длины, не входящую в стандарт, но поддерживаемую большинством СУБД под тем или иным именем.
В некоторых СУБД выбор между этими типами влияет на производительность: строка фиксированной длины позволяет вычислять смещение следующего столбца без чтения длины. В PostgreSQL все три типа хранятся одинаково — как значение переменной длины с заголовком, — и документация формулирует вывод однозначно: разницы в производительности между ними нет, кроме лишнего места у дополняемого пробелами char(n) и нескольких тактов процессора на проверку длины у varchar(n); char(n) обычно самый медленный из трёх, и в большинстве случаев следует использовать text или varchar 1. Ограничение длины в varchar(n) — это ограничение целостности, а не способ сэкономить место. Если правило предметной области звучит сложнее, чем «не длиннее n», его лучше выразить через CHECK, как сделано для ISBN в учебной базе: столбец isbn проверяется регулярным выражением «ровно 13 цифр».
У char(n) есть и семантическая особенность: хвостовые пробелы считаются незначимыми при сравнении. Это легко приводит к неожиданностям:
SELECT 'abc'::char(5) = 'abc  '::char(5)       AS char_eq,
       'abc'::varchar(5) = 'abc  '::varchar(5) AS varchar_eq,
       length('abc'::char(5))                  AS len,
       'abc'::char(5) || '|'                   AS concat;
 char_eq | varchar_eq | len | concat
---------+------------+-----+--------
 t       | f          |   3 | abc|
Значение типа char(5) хранится с дополняющими пробелами, но функция length их не считает, а при приведении к text для конкатенации они отбрасываются.
Длина строки в символах и в байтах различается. Сервер учебной базы использует кодировку UTF-8 (SHOW server_encoding), в которой латинская буква занимает один байт, а кириллическая — два:
SELECT title, length(title) AS chars, octet_length(title) AS bytes,
       pg_column_size(title) AS stored
FROM bookstore.book WHERE book_id IN (1, 9);
         title         | chars | bytes | stored
-----------------------+-------+-------+--------
 Война и мир           |    11 |    20 |     21
 PostgreSQL 16 изнутри |    21 |    28 |     29
Функция pg_column_size показывает размер значения в том виде, в каком оно хранится: 20 байт текста плюс однобайтовый заголовок длины (подробнее о заголовках — в разделе о хранении). Кодировка задаётся при создании базы и в дальнейшем не меняется; для новых баз фактически безальтернативна UTF-8.
С кодировкой тесно связано правило сортировки (англ. collation) — функция, определяющая порядок строк и их равенство при сравнении. Порядок «по кодам символов» (правило C) прост и быстр, но для человека неестествен: все прописные буквы идут раньше строчных, а «ё» оказывается после «я». Лингвистически правильный порядок для русского языка дают правила сортировки библиотеки ICU (англ. International Components for Unicode), реализующей алгоритм сортировки Unicode 11:
-- правило сортировки базы: C.UTF-8
SELECT name FROM (VALUES ('ёж'), ('Ель'), ('ель'), ('яблоко'),
                         ('Яма'), ('арбуз'), ('Банан')) AS v(name)
ORDER BY name;
-- то же с лингвистическим правилом ICU для русского языка
SELECT name FROM (VALUES ('ёж'), ('Ель'), ('ель'), ('яблоко'),
                         ('Яма'), ('арбуз'), ('Банан')) AS v(name)
ORDER BY name COLLATE "ru-RU-x-icu";
 по C.UTF-8 | по ru-RU-x-icu
------------+---------------
 Банан      | арбуз
 Ель        | Банан
 Яма        | ёж
 арбуз      | ель
 ель        | Ель
 яблоко     | яблоко
 ёж         | Яма
(Результаты двух запросов сведены в одну таблицу.) Правило сортировки задаётся для базы при создании (в PostgreSQL 15 и новее базу можно создать сразу с правилом ICU), а также для отдельного столбца или выражения ключевым словом COLLATE 1. Выбор правила — тоже решение физического проектирования: от него зависят результат ORDER BY, работа ограничений уникальности и, как будет показано в теме 10, возможность использовать индекс для поиска по префиксу LIKE 'abc%'. Смена правила сортировки у существующих данных требует перестроения индексов, потому что индекс хранит строки упорядоченными по старому правилу.
Дата и время
Тип date хранит календарную дату (4 байта), time — время суток, timestamp и timestamp with time zone (timestamptz) — момент времени с точностью до микросекунды (8 байт), interval — промежуток времени (16 байт) 1. Самая частая ошибка проектирования в этом семействе — выбор timestamp (полное имя timestamp without time zone) для хранения моментов событий.
Различие между двумя типами не в том, что один «хранит часовой пояс», а другой нет. Ни один из них пояс не хранит. Значение timestamptz при вводе переводится в UTC с учётом указанного или текущего (параметр сеанса TimeZone) часового пояса и хранится как момент в UTC, а при выводе переводится в пояс текущего сеанса 1. Значение timestamp хранится как есть — это «показания настенных часов» без привязки к месту. Эксперимент:
CREATE TEMP TABLE tz_demo (ts timestamp, tstz timestamptz);
SET TimeZone = 'Europe/Moscow';
INSERT INTO tz_demo VALUES ('2024-03-01 12:00', '2024-03-01 12:00');
SET TimeZone = 'Asia/Novosibirsk';
SELECT * FROM tz_demo;
         ts          |          tstz
---------------------+------------------------
 2024-03-01 12:00:00 | 2024-03-01 16:00:00+07
Заказ, оформленный в полдень по Москве, для сеанса в Новосибирске произошёл в 16:00 местного времени, и столбец timestamptz показывает это верно. Столбец timestamp утверждает, что заказ был в 12:00, — но по каким часам, уже не восстановить. Поэтому моменты событий (создание заказа, платёж, вход пользователя) хранятся в timestamptz, как это сделано в учебной базе для orders.created_at и payment.paid_at. Тип timestamp уместен лишь для «плановых» значений, привязанных к местному времени по смыслу: «открытие магазина в 9:00 по местному времени» должно оставаться 9:00 и после перехода на летнее время.
Арифметика с интервалами тоже учитывает часовые пояса. Интервал хранит отдельно месяцы, дни и микросекунды, поэтому interval '1 day' и interval '24 hours' — разные величины. В поясе с переходом на летнее время они дают разный результат:
SET TimeZone = 'Europe/Berlin';
SELECT timestamptz '2024-03-30 12:00' + interval '1 day'    AS plus_day,
       timestamptz '2024-03-30 12:00' + interval '24 hours' AS plus_24h;
        plus_day        |        plus_24h
------------------------+------------------------
 2024-03-31 12:00:00+02 | 2024-03-31 13:00:00+02
В ночь на 31 марта 2024 года в Германии часы перевели вперёд, сутки длились 23 часа, и «через день в то же время» не совпадает с «через 24 часа». Аналогично date '2024-01-31' + interval '1 month' даёт 29 февраля: при прибавлении месяцев день обрезается до последнего дня месяца.
Перечисления, массивы, диапазоны и домены
Столбец orders.status может принимать пять значений. Ограничить его можно тремя способами, и выбор между ними — классическое решение физического проектирования.
Первый способ, принятый в учебной базе, — text с ограничением CHECK (status IN ('new', 'paid', ...)). Он прост, значения читаемы, а изменить список можно командой ALTER TABLE, заменив ограничение. Второй — тип-перечисление (англ. enumerated type), CREATE TYPE order_status AS ENUM ('new', 'paid', 'shipped', 'delivered', 'cancelled'). Значение перечисления занимает 4 байта (строка 'delivered' — 10 байт), сравнение идёт в порядке объявления ('paid' < 'shipped' истинно), а добавлять значения можно командой ALTER TYPE ... ADD VALUE; удалить значение из перечисления нельзя 1. Третий — таблица-справочник статусов и внешний ключ на неё. Справочник позволяет хранить при каждом значении дополнительные атрибуты (название для интерфейса, признак «заказ завершён»), менять список обычными командами DML и управлять им без изменения схемы, но требует соединения для получения названия. Если список значений — часть логики приложения и меняется вместе с кодом, подходят CHECK или перечисление; если им управляют пользователи — справочник.
PostgreSQL поддерживает массивы любого встроенного или пользовательского типа (по стандарту SQL тип записывается как text ARRAY, integer ARRAY) с операторами включения @> и пересечения && 1. Массив нарушает первую нормальную форму в её строгом понимании (тема 8), и для сущностей, на которые нужно ссылаться внешними ключами, он не годится: нельзя объявить, что каждый элемент массива авторов ссылается на author. Уместен массив для коротких списков значений, которые читаются и записываются целиком, — например, набора меток книги «хит» и «новинка».
Диапазонные типы (int4range, numrange, daterange, tstzrange и др.) представляют интервал значений с включёнными или исключёнными границами. Они удобны для периодов действия цен и акций: оператор @> проверяет попадание точки в диапазон, && — пересечение двух диапазонов, * вычисляет пересечение. В сочетании с ограничением исключения EXCLUDE (тема 2) диапазон позволяет декларативно запретить пересекающиеся периоды акций для одной книги; для этого нужен индекс GiST, о котором пойдёт речь в теме 10.
Тип bytea хранит двоичные данные (обложки, файлы); альтернатива — хранить файл во внешнем хранилище, а в базе только путь и контрольную сумму.
Наконец, домен (англ. domain) — именованный тип на основе существующего с дополнительными ограничениями. Домен позволяет один раз описать правило и использовать его во многих таблицах:
CREATE DOMAIN isbn13 AS char(13) CHECK (VALUE ~ '^[0-9]{13}$');
SELECT '978516'::isbn13;
ERROR: value for domain isbn13 violates check constraint "isbn13_check"
Сводка размеров основных типов приведена в таблице. Значения получены функцией pg_column_size в PostgreSQL 16 на 64-разрядной платформе.
| Тип | Размер | Замечание |
|---|---|---|
boolean | 1 байт | |
smallint, integer, bigint | 2, 4, 8 байт | точная арифметика, ошибка при переполнении |
real, double precision | 4, 8 байт | приближённые, IEEE 754 |
numeric | переменный | точный; 1290.00 — 5 байт на диске |
date | 4 байта | |
timestamp, timestamptz | 8 байт | микросекунды; timestamptz хранится в UTC |
interval | 16 байт | месяцы, дни, микросекунды отдельно |
uuid | 16 байт | |
text, varchar(n), char(n), bytea, jsonb | переменный | заголовок 1 или 4 байта, далее данные |
| перечисление | 4 байта |
Генерация ключей
Последовательности и столбцы идентичности
Суррогатный ключ (тема 2) нужно откуда-то брать. Классический источник в PostgreSQL — последовательность (англ. sequence), отдельный объект базы, выдающий возрастающие числа функцией nextval. Стандарт SQL:2003 ввёл столбцы идентичности (англ. identity columns), и в PostgreSQL 10 появился синтаксис GENERATED ALWAYS AS IDENTITY, который используется во всех таблицах учебной базы. За столбцом идентичности стоит та же последовательность, но она принадлежит столбцу, удаляется вместе с ним и не позволяет случайно вставить значение вручную 1:
CREATE TABLE lab09.seq_demo (
    id   integer GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name text
);
INSERT INTO lab09.seq_demo (name) VALUES ('первая');
BEGIN;
INSERT INTO lab09.seq_demo (name) VALUES ('откатится');
ROLLBACK;
INSERT INTO lab09.seq_demo (name) VALUES ('третья');
SELECT * FROM lab09.seq_demo;
 id |  name
----+--------
  1 | первая
  3 | третья
Значение 2 потеряно: последовательность нетранзакционна, и выданное nextval число не возвращается при откате. Это сделано сознательно — иначе параллельные транзакции ждали бы друг друга при каждой вставке. Следствие для проектирования: суррогатный ключ гарантирует уникальность, но не отсутствие пропусков, и строить на нём «сквозную нумерацию счетов без пропусков» нельзя. Попытка вставить явное значение в столбец GENERATED ALWAYS завершается ошибкой с подсказкой OVERRIDING SYSTEM VALUE; вариант GENERATED BY DEFAULT разрешает явные значения, но тогда легко получить конфликт с будущими значениями последовательности.
Предел integer — около 2,1 миллиарда — кажется недостижимым, но таблица событий, получающая тысячу строк в секунду, исчерпает его за 25 дней, а смена типа ключа большой таблицы с внешними ссылками требует перезаписи таблиц и индексов. Для таблиц, рост которых трудно предсказать, разумно сразу выбирать bigint.
UUID: случайные и упорядоченные по времени
Последовательность выдаёт уникальные значения только в пределах одной базы. Когда идентификатор должен создаваться в приложении до обращения к базе, в нескольких независимых базах или на клиенте, используют универсальный уникальный идентификатор (англ. Universally Unique Identifier, UUID) — 128-битное число, вероятность совпадения которого пренебрежимо мала. Современная спецификация UUID — RFC 9562 (2024) — описывает несколько версий 7. Версия 4 состоит из 122 случайных бит. Версия 7 начинается с 48-битной метки времени в миллисекундах от начала эпохи Unix, за которой идут случайные биты, поэтому идентификаторы версии 7, созданные позже, больше созданных раньше.
В PostgreSQL 16 тип uuid занимает 16 байт, а встроенная функция gen_random_uuid() (в ядре с версии 13) генерирует UUID версии 4. Функции для версии 7 в PostgreSQL 16 нет:
SELECT uuidv7();
ERROR: function uuidv7() does not exist
Встроенная функция uuidv7() появилась только в PostgreSQL 18 3; в более ранних версиях UUID версии 7 генерирует приложение или функция на SQL (в окружении лабораторной работы есть учебная функция uuid_v7_like(), собирающая такое значение из метки времени и gen_random_uuid()).
Почему версия имеет значение? Первичный ключ поддерживается индексом-B-деревом (тема 10), в котором ключи хранятся упорядоченно. Возрастающие ключи (последовательность или UUIDv7) всегда вставляются в самый правый лист дерева, страницы заполняются плотно, а «горячей» остаётся лишь небольшая правая часть индекса. Случайные ключи UUIDv4 попадают в произвольные листья: при каждой вставке нужна новая страница индекса, листья делятся пополам и в среднем оказываются заполнены примерно на 70 %. Эксперимент: в три таблицы с первичным ключом разного вида вставлено по 2 миллиона строк, после чего измерены размер индекса первичного ключа и средняя плотность его листьев (функция pgstatindex из расширения pgstattuple).
| Ключ | Размер индекса | Плотность листьев |
|---|---|---|
bigint из последовательности | 43 МиБ | 90,1 % |
uuid версии 4 (gen_random_uuid()) | 77 МиБ | 70,7 % |
uuid версии 7 (учебная функция) | 60 МиБ | 90,0 % |
Индекс по UUID больше индекса по bigint уже потому, что ключ вдвое длиннее, но случайный порядок добавляет к этому ещё почти треть. Пока индекс помещается в оперативную память, разница сказывается в основном на размере; когда индекс многократно больше буферного кеша, случайная вставка означает чтение случайной страницы с диска на каждую строку, и скорость вставки падает в разы. Время вставки в нашем опыте составило около 5 с для bigint и около 21 с для UUIDv4 (из них около 4 с — сама генерация двух миллионов случайных UUID); на другой машине числа будут другими, но соотношение сохраняется. Отсюда рекомендация: если UUID нужен, предпочтительна версия 7; если не нужен — достаточно bigint с идентичностью. У UUIDv7 есть и обратная сторона: метка времени в ключе раскрывает момент создания записи, что не всегда допустимо для идентификаторов, видимых пользователю.
Как PostgreSQL хранит таблицу
Файлы, слои и страницы
На внутреннем уровне PostgreSQL хранит каждое отношение — таблицу, индекс, последовательность, материализованное представление — в отдельном наборе файлов в каталоге данных кластера 2. Путь к основному файлу относительно каталога данных возвращает функция pg_relation_filepath:
SELECT pg_relation_filepath('bookstore.orders');
 pg_relation_filepath
----------------------
 base/16384/16605
Здесь 16384 — идентификатор (OID) базы данных, 16605 — номер файла таблицы (relfilenode); у вас числа будут другими. Файл делится на сегменты по 1 ГиБ (16605, 16605.1, ...), чтобы не упираться в ограничения файловых систем. Кроме основного слоя (англ. main fork) с данными у таблицы есть служебные слои: карта свободного пространства (англ. free space map, файл с суффиксом _fsm), где для каждой страницы записано, сколько места на ней свободно, и карта видимости (англ. visibility map, _vm) — по два бита на страницу, отмечающие, что все строки страницы видимы всем транзакциям и что все они «заморожены» 2. Карта видимости создаётся очисткой (VACUUM); она понадобится в теме 10 для сканирования только индекса, а её смысл подробно раскрывается в теме 12.
Размеры слоёв и отношения в целом показывают функции pg_relation_size(rel, fork), pg_table_size (таблица со всеми слоями и TOAST), pg_indexes_size и pg_total_relation_size (всё вместе):
SELECT pg_relation_size('bookstore.orders')         AS main,
       pg_relation_size('bookstore.orders', 'fsm')  AS fsm,
       pg_size_pretty(pg_table_size('bookstore.orders'))          AS tbl,
       pg_size_pretty(pg_indexes_size('bookstore.orders'))        AS idx,
       pg_size_pretty(pg_total_relation_size('bookstore.orders')) AS total;
  main   |  fsm  |   tbl   |  idx   |  total
---------+-------+---------+--------+---------
 1212416 | 24576 | 1216 kB | 456 kB | 1672 kB
Основной слой занимает 1 212 416 байт — ровно 148 страниц по 8192 байта (в выводе pg_size_pretty единицы kB и MB двоичные, то есть это КиБ и МиБ).
Файл отношения — последовательность страниц (англ. page, также block) фиксированного размера. В PostgreSQL размер страницы задаётся при компиляции и по умолчанию равен 8 КиБ (SHOW block_size выводит 8192); все операции ввода-вывода и весь буферный кеш работают страницами 2. Устройство страницы таблицы (англ. heap page) показано на рисунке ниже.
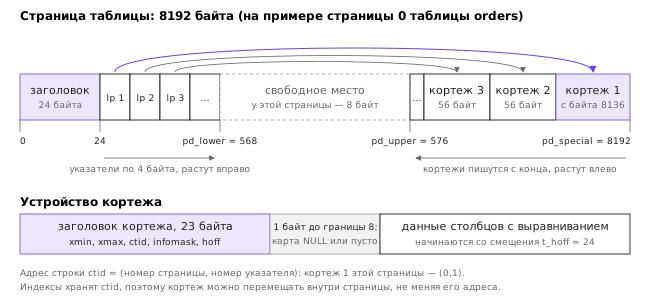
Страница начинается с заголовка (PageHeaderData) длиной 24 байта: в нём LSN — номер последней записи журнала, изменившей страницу (тема 13), контрольная сумма, флаги и три смещения: pd_lower — конец массива указателей, pd_upper — начало области данных, pd_special — начало специальной области (у таблиц она пуста, у индексов в ней хранятся служебные данные). За заголовком идёт массив указателей строк (англ. line pointers, ItemIdData) по 4 байта: каждый содержит смещение и длину кортежа на странице. Сами кортежи записываются с конца страницы к началу, так что свободное место всегда находится посередине, между pd_lower и pd_upper 2.
Адрес строки в таблице — пара «номер страницы, номер указателя», которая называется ctid. Ссылка идёт на указатель, а не на байтовое смещение кортежа, поэтому кортеж можно перемещать внутри страницы при уплотнении, не меняя его адрес; индексы хранят именно такие адреса.
Заглянуть внутрь страницы позволяет расширение pageinspect 4. Оно устанавливается командой CREATE EXTENSION pageinspect и доступно суперпользователю. Функция get_raw_page читает страницу как массив байтов, page_header разбирает заголовок, heap_page_items — указатели и заголовки кортежей:
SELECT lower, upper, special, pagesize
FROM page_header(get_raw_page('bookstore.orders', 0));
 lower | upper | special | pagesize
-------+-------+---------+----------
   568 |   576 |    8192 |     8192
SELECT lp, lp_off, lp_len, t_hoff, t_ctid
FROM heap_page_items(get_raw_page('bookstore.orders', 0)) LIMIT 3;
 lp | lp_off | lp_len | t_hoff | t_ctid
----+--------+--------+--------+--------
  1 |   8136 |     56 |     24 | (0,1)
  2 |   8080 |     56 |     24 | (0,2)
  3 |   8024 |     56 |     24 | (0,3)
Первый кортеж занимает последние 56 байт страницы (смещение 8136), второй — предыдущие 56 и так далее. Всего на странице 136 кортежей: массив указателей заканчивается на байте 24 + 136 · 4 = 568, а данные начинаются с байта 8192 − 136 · 56 = 576. Свободными остались 8 байт — меньше, чем нужно для ещё одного кортежа с указателем.
Заголовок кортежа и выравнивание
Каждая версия строки на странице начинается с заголовка кортежа (HeapTupleHeaderData), занимающего 23 байта 2. В нём хранятся номера транзакций t_xmin и t_xmax, создавшей и удалившей версию, номер команды, адрес t_ctid (у последней версии он указывает на саму строку, у устаревшей — на более новую версию), число столбцов и флаги (t_infomask), а также смещение начала данных t_hoff. Назначение этих полей — многоверсионное управление параллельным доступом, которое подробно рассматривается в теме 12; для физического проектирования важно, что каждая строка таблицы несёт около 24 байт служебной информации плюс 4 байта указателя. Для узких таблиц это больше, чем сами данные 13.
За заголовком может следовать битовая карта NULL (англ. null bitmap) — по одному биту на столбец, — если в строке есть хотя бы одно неопределённое значение. Данные начинаются со смещения t_hoff, кратного 8 байтам (величине MAXALIGN на 64-разрядных платформах). Поэтому 23-байтовый заголовок фактически занимает 24 байта, и в этот лишний байт помещается битовая карта таблицы, в которой не больше 8 столбцов. Если столбцов 9 и в строке есть NULL, карта занимает 2 байта, и t_hoff становится 32: в эксперименте с таблицей из девяти столбцов integer строка без NULL занимает 60 байт, а строка с одним NULL — 64, хотя данных в ней на 4 байта меньше.
Внутри области данных каждое значение выравнивается по границе, которую требует его тип (столбец attalign каталога pg_attribute): smallint — по 2 байтам, integer — по 4, bigint, timestamptz и double precision — по 8; boolean и короткие строки выравнивания не требуют. Между значениями вставляются байты-заполнители (англ. padding). Разберём строку таблицы orders длиной 56 байт:
| Смещение | Длина | Содержимое |
|---|---|---|
| 0 | 23 + 1 | заголовок кортежа и выравнивание до 24 |
| 24 | 4 | order_id integer |
| 28 | 4 | customer_id integer |
| 32 | 8 | created_at timestamptz (выровнен по 8 — смещение 32 подходит) |
| 40 | 10 | status text: однобайтовый заголовок и 9 байт 'delivered' |
| 50 | 2 | заполнитель до границы 4 байт |
| 52 | 4 | warehouse_id integer |
Порядок столбцов в таблице влияет на число заполнителей. Сравним две таблицы с одинаковым набором столбцов — трёх boolean, двух bigint, integer, smallint и timestamptz, — объявленных в «неудачном» порядке (чередование однобайтовых и восьмибайтовых) и в «удачном» (от больших к меньшим), по 100 тысяч строк в каждой. Раскладка одной строки показана на рисунке.
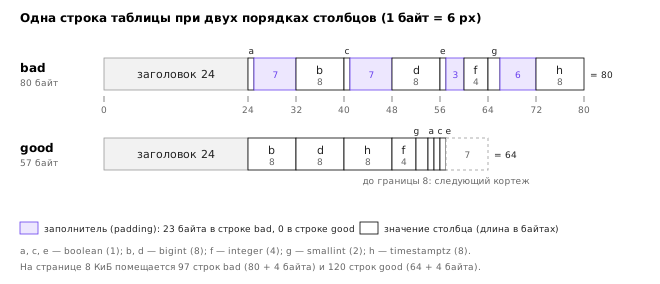
CREATE TABLE lab09.bad  (a boolean, b bigint, c boolean, d bigint,
                         e boolean, f integer, g smallint, h timestamptz);
CREATE TABLE lab09.good (b bigint, d bigint, h timestamptz, f integer,
                         g smallint, a boolean, c boolean, e boolean);
-- вставка 100 000 строк в каждую
  t   | row_bytes |  size   | pages
------+-----------+---------+-------
 bad  |        80 | 8248 kB |  1031
 good |        57 | 6672 kB |   834
Строка «неудачной» таблицы занимает 80 байт, «удачной» — 57, а вся таблица уменьшилась на 19 %. Заметим, что выигрыш в размере таблицы меньше выигрыша в длине строки: следующий кортеж на странице тоже начинается с границы 8 байт, поэтому 57-байтовая строка фактически занимает 64 байта, и на странице помещается 120 строк вместо 97. Правило, вытекающее из эксперимента: в широких таблицах с большим числом строк полезно объявлять сначала столбцы фиксированной длины с выравниванием 8, затем 4 и 2, затем однобайтовые и столбцы переменной длины. Для маленьких справочников экономия несущественна, и порядок лучше выбирать из соображений читаемости. Переставить столбцы существующей таблицы в PostgreSQL можно только пересоздав её.
TOAST: хранение длинных значений
Кортеж должен целиком помещаться на одной странице: PostgreSQL не разрывает строки между страницами. Как же тогда хранится text длиной в мегабайт? Ответ — механизм TOAST (англ. The Oversized-Attribute Storage Technique) 2.
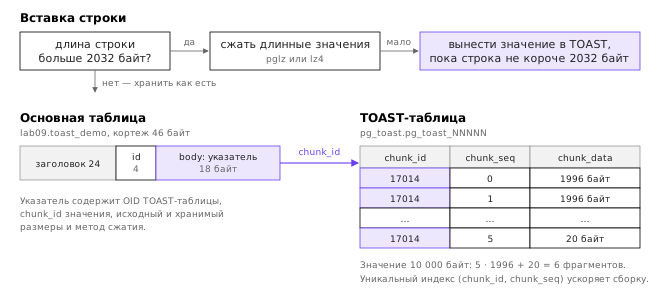
Все типы переменной длины («varlena») начинаются с заголовка длины. Значения короче 127 байт хранятся на диске с однобайтовым заголовком и без выравнивания, более длинные — с четырёхбайтовым. Два бита заголовка TOAST резервирует для своих целей, поэтому максимальная длина одного значения — 1 ГиБ 2. Когда вставляемая строка таблицы длиннее порога TOAST_TUPLE_THRESHOLD, механизм TOAST начинает её «ужимать»: сжимает длинные значения и, если этого мало, выносит их в отдельную TOAST-таблицу, пока строка не станет короче TOAST_TUPLE_TARGET. Оба значения по документации «обычно 2 кБ» 2; точнее, порог вычисляется так, чтобы на странице помещалось четыре кортежа, и для страницы 8 КиБ составляет 2032 байта. Вынесенное значение режется на фрагменты (англ. chunks) примерно по 2000 байт, каждый хранится отдельной строкой TOAST-таблицы, а в основной строке остаётся указатель длиной 18 байт. Схема показана на рисунке.
Проверим порог экспериментом. В таблицу lab09.toast_demo (id integer, body text) вставлены строки со случайным (несжимаемым) текстом длиной от 1000 до 10 000 символов и строки из повторяющейся буквы a. Для каждой строки выведены длина текста, размер хранимого значения и длина кортежа на странице:
 текст              | length | stored | lp_len
--------------------+--------+--------+--------
 случайный          |   1000 |   1004 |   1032
 случайный          |   1990 |   1994 |   2022
 случайный          |   2000 |   2004 |   2032
 случайный          |   2010 |   2010 |     46
 случайный          |   3000 |   3000 |     46
 случайный          |  10000 |  10000 |     46
 повтор 'a'         |   3000 |     44 |     72
 повтор 'a'         |  10000 |    125 |    153
 повтор 'a'         | 100000 |   1156 |   1184
Кортеж длиной ровно 2032 байта (24 байта заголовка, 4 байта id, 4 байта заголовка значения и 2000 байт текста) ещё хранится целиком. При 2010 символах кортеж превысил бы порог, текст сжать не удалось, и он вынесен в TOAST: на странице остался кортеж длиной 46 байт = 24 + 4 + 18. Текст из повторяющихся символов, напротив, прекрасно сжимается (алгоритмом pglz, заданным параметром default_toast_compression; с PostgreSQL 14 доступен и lz4, если сервер собран с его поддержкой) и остаётся в строке: сто тысяч букв a заняли 1156 байт. TOAST-таблица — обычная таблица в схеме pg_toast со столбцами chunk_id, chunk_seq и chunk_data; значение длиной 10 000 байт хранится в ней шестью фрагментами, максимальный из которых — 1996 байт.
Для каждого столбца задаётся стратегия хранения (столбец attstorage каталога): plain — без сжатия и выноса (для типов фиксированной длины), extended — сжатие, затем вынос (по умолчанию для text, jsonb, bytea), external — вынос без сжатия (ускоряет substring над длинными значениями), main — сжатие, а вынос только в крайнем случае (по умолчанию у numeric) 2. Меняется она командой ALTER TABLE ... ALTER COLUMN ... SET STORAGE.
Благодаря TOAST длинные описания не мешают запросам, которые их не читают: основная таблица остаётся компактной. Обратная сторона — SELECT * по таблице с длинными значениями заметно дороже выборки нужных столбцов, потому что каждое вынесенное значение собирается из фрагментов. Обновление строки без изменения вынесенных значений их не копирует.
Fillfactor и оценка размера таблицы
Параметр хранения fillfactor (от 10 до 100, по умолчанию 100) задаёт, до какой доли страницы заполнять её при вставке; остаток резервируется для будущих обновлений строк этой страницы 10. Когда обновлённая версия строки помещается на ту же страницу, а изменённые столбцы не входят ни в один индекс, PostgreSQL выполняет HOT-обновление (англ. Heap-Only Tuple), не трогая индексы; об этом — в теме 10. Таблица orders, скопированная с fillfactor = 70, занимает 211 страниц вместо 148: на странице 95 строк вместо 136. Уменьшать fillfactor имеет смысл для таблиц с частыми обновлениями (остатки на складе, счётчики), а не для таблиц, в которые только добавляют строки.
Знание устройства страницы позволяет оценить размер таблицы до её создания — это и есть подробно разобранный пример раздела. Оценим таблицу orders при scale=50, где в ней миллион строк.
- Длина кортежа: 24 байта заголовка и 32 байта данных (по таблице выше) — 56 байт; с указателем — 60 байт. Длина 56 кратна 8, поэтому дополнительного выравнивания между кортежами нет.
- Полезное место страницы: 8192 − 24 = 8168 байт. Строк на странице: ⌊8168 / 60⌋ = 136 — ровно столько, сколько показал
heap_page_items. - Страниц: ⌈1 000 000 / 136⌉ = 7353, размер: 7353 · 8192 байт ≈ 57,4 МиБ.
Проверка на базе bookstore50 (таблица после загрузки и автоматической очистки):
SELECT relpages, pg_size_pretty(pg_relation_size('bookstore.orders'))
FROM pg_class WHERE oid = 'bookstore.orders'::regclass;
 relpages | pg_size_pretty
----------+----------------
     7353 | 57 MB
Расчёт совпал со страницей. Если бы status был перечислением (4 байта с выравниванием по 4) вместо text, строка заняла бы 24 + 4 + 4 + 8 + 4 + 4 = 48 байт, на страницу поместилось бы 157 строк, и таблица уменьшилась бы примерно на 13 %. Для проектировщика такая оценка — быстрый способ сравнить варианты схемы до загрузки данных. При этом надо помнить, что в реальной таблице есть и «мёртвые» версии строк, оставшиеся после обновлений и удалений (тема 12), поэтому фактический размер со временем превышает расчётный.
Полуструктурированные данные: JSON и JSONB
json и jsonb
Не все атрибуты сущности известны заранее. У бумажной книги есть переплёт, у электронной — формат файла, у детской — возрастная маркировка, у многотомника — число томов. Можно завести по столбцу на каждый возможный атрибут (большинство будут NULL), можно вынести атрибуты в таблицу «сущность — атрибут — значение» (англ. entity-attribute-value, EAV), а можно хранить их в столбце полуструктурированного формата. В «Книжном узле» выбран третий путь: столбец book.attrs типа jsonb.
PostgreSQL предлагает два типа для данных в формате JSON 8. Тип json хранит исходный текст документа без изменений и при каждом обращении разбирает его заново. Тип jsonb (появился в PostgreSQL 9.4) хранит документ в разобранном двоичном виде: ключи объектов отсортированы, повторяющиеся ключи схлопнуты (остаётся последний), пробелы не сохраняются. Различие видно сразу:
SELECT '{"b": 1, "a": 2, "a": 3}'::json  AS j,
       '{"b": 1, "a": 2, "a": 3}'::jsonb AS jb;
            j             |        jb
--------------------------+------------------
 {"b": 1, "a": 2, "a": 3} | {"a": 3, "b": 1}
Ввод в jsonb чуть медленнее, но обработка намного быстрее, и только jsonb поддерживает операторы включения и индексы GIN (тема 10). Документация рекомендует jsonb для большинства приложений; json оправдан, если нужно сохранить документ байт в байт, например подписанный ответ внешней системы 8. По размеру типы близки: документ {"binding": "soft", "series": "Миры Стругацких"} занимает 66 байт как json и 70 байт как jsonb.
Операторы и язык путей SQL/JSON
Основные операторы над jsonb 9:
| Оператор | Смысл | Пример |
|---|---|---|
-> | элемент по ключу (или индексу массива) как jsonb | attrs -> 'binding' → "hard" |
->> | элемент по ключу как text | attrs ->> 'binding' → hard |
#>, #>> | элемент по пути | attrs #>> '{dims,height}' |
@> | левый документ содержит правый | attrs @> '{"binding": "soft"}' |
? | есть ли ключ верхнего уровня | attrs ? 'age' |
||, - | слияние документов, удаление ключа | attrs || '{"bestseller": true}' |
@?, @@ | проверка выражения пути SQL/JSON | attrs @? '$.age ? (@ == "18+")' |
Различие между -> и ->> существенно: первый возвращает jsonb (строка в кавычках), второй — text, который можно сравнивать с обычной строкой и приводить к числу:
SELECT book_id, attrs -> 'binding' AS j, attrs ->> 'binding' AS t,
       attrs -> 'volumes' AS volumes
FROM bookstore.book WHERE book_id IN (1, 4, 9);
 book_id |   j    |  t   | volumes
---------+--------+------+---------
       1 | "hard" | hard | 2
       4 | "soft" | soft |
       9 | "pdf"  | pdf  |
Отсутствующий ключ даёт NULL. Оператор включения @> проверяет, что документ содержит указанную структуру, и именно его поддерживают индексы GIN:
SELECT book_id, title FROM bookstore.book
WHERE attrs @> '{"series": "Миры Стругацких"}';
 book_id |       title
---------+-------------------
       4 | Пикник на обочине
       5 | Трудно быть богом
Стандарт SQL:2016 ввёл язык путей SQL/JSON (англ. SQL/JSON path language) для навигации по документам, и PostgreSQL поддерживает его с версии 12 9. Выражение пути начинается с $ (весь документ), спускается по ключам через точку, по массивам — через индексы и *, а фильтр записывается после ? в скобках, где @ обозначает текущий элемент. Функция jsonb_path_query возвращает найденные элементы, jsonb_path_exists и оператор @? проверяют, что что-то найдено:
SELECT count(*) FROM bookstore.book
WHERE attrs @? '$.age ? (@ == "18+" || @ == "16+")';

SELECT jsonb_path_query(
    '{"formats": [{"type": "pdf", "size": 12}, {"type": "epub", "size": 5}]}',
    '$.formats[*] ? (@.size > 10).type');
 count
-------
   295

 jsonb_path_query
------------------
 "pdf"
Документ можно изменять функциями jsonb_set (заменить значение по пути), операторами || и -. Изменение даже одного ключа записывает новую версию всего документа (а если он вынесен в TOAST — и всех его фрагментов), поэтому для больших документов с частыми точечными изменениями jsonb — дорогой выбор.
Когда JSONB уместен, а когда это скрытая денормализация
JSONB даёт гибкость, но платой за неё служат гарантии, которые реляционная модель предоставляет бесплатно. У ключа в документе нет типа (в одной книге "volumes": 2, в другой — "volumes": "два"), нет ограничения NOT NULL, нет внешнего ключа, нет статистики распределения отдельных ключей для планировщика (тема 11), а опечатка в имени ключа в запросе не вызывает ошибки — просто ничего не находится. Документ, в который встроены данные других сущностей (например, имена авторов книги), — это денормализация в чистом виде со всеми аномалиями обновления из темы 8: переименование автора потребует обойти все документы.
Разумное правило таково. Атрибуты, по которым есть бизнес-логика, связи, частые фильтры и агрегаты, — столбцы со своими типами и ограничениями. В JSONB уместно хранить действительно разнородные и редко используемые в условиях атрибуты (характеристики товаров разных категорий), данные внешних систем, которые сохраняются как есть, и настройки. Если атрибут из JSONB со временем «повзрослел» и стал использоваться повсеместно, его выносят в столбец; в лабораторной работе это делается командами ALTER TABLE ... ADD COLUMN и UPDATE. Промежуточный вариант — генерируемый столбец, вычисляемый из документа:
ALTER TABLE lab09.book_j
    ADD COLUMN binding text GENERATED ALWAYS AS (attrs ->> 'binding') STORED;
Часть гарантий можно вернуть и для документа — ограничением CHECK над выражениями jsonb:
ALTER TABLE lab09.book_j ADD CONSTRAINT attrs_shape
    CHECK (jsonb_typeof(attrs) = 'object'
           AND attrs ->> 'binding' IN ('soft', 'hard', 'pdf'));
UPDATE lab09.book_j SET attrs = attrs || '{"binding": "spiral"}' WHERE book_id = 1;
ERROR:  new row for relation "book_j" violates check constraint "attrs_shape"
DETAIL:  Failing row contains (1, Война и мир, {"binding": "spiral", "volumes": 2}).
Сравнение документной модели с реляционной на более широком материале — с документными СУБД вроде MongoDB — проводится в теме 16 12.
Схемы, табличные пространства и секционирование
Схемы и путь поиска
Схема (англ. schema) — пространство имён внутри базы данных: в разных схемах могут быть таблицы с одинаковыми именами 1. Все таблицы учебной базы находятся в схеме bookstore, системные — в pg_catalog, временные — в отдельной схеме сеанса, а схема public создаётся в каждой базе по умолчанию. Имя без указания схемы разрешается по пути поиска — параметру search_path:
SHOW search_path;
SELECT count(*) FROM book;
SET search_path = bookstore, public;
SELECT count(*) FROM book;
   search_path
-----------------
 "$user", public

ERROR:  relation "book" does not exist

 count
-------
  2010
По умолчанию путь включает схему с именем текущего пользователя и public; каталог pg_catalog неявно просматривается первым. Схемы используются для разделения модулей в одной базе, для экспериментов, не затрагивающих основные данные (lab09), и для разграничения прав (тема 15). Путь поиска — источник известной уязвимости: объект с «чужим» именем в схеме, стоящей раньше в пути, перехватит обращение без указания схемы, поэтому в функциях с повышенными правами путь задают явно (темы 14 и 15).
Табличные пространства
Табличное пространство (англ. tablespace) — каталог файловой системы, в котором PostgreSQL размещает файлы отношений 1. По умолчанию их два: pg_default (каталог base кластера) и pg_global (общие для кластера каталоги). Команда CREATE TABLESPACE fast LOCATION '/mnt/nvme/pg' позволяет вынести, например, горячие индексы на быстрый накопитель. Табличное пространство — не самостоятельная единица хранения: без каталога кластера и журнала его файлы бесполезны, и резервное копирование должно охватывать их все (тема 13).
Декларативное секционирование
Когда таблица вырастает до сотен миллионов строк, дорогими становятся очистка всей таблицы, удаление старых данных командой DELETE и работа с индексами, не помещающимися в память. Секционирование (англ. partitioning) делит одну логическую таблицу на несколько физических — секций (англ. partitions) — по значению ключа секционирования 10. Запросы обращаются к родительской таблице, а СУБД направляет строки в нужные секции и пропускает секции, которые заведомо не содержат подходящих строк.
PostgreSQL с версии 10 поддерживает декларативное секционирование трёх видов 10:
- по диапазону (
PARTITION BY RANGE) — секция получает интервал значений ключа, типично по дате: заказы по годам или месяцам; - по списку (
PARTITION BY LIST) — секция получает перечень значений: заказы по регионам; - по хешу (
PARTITION BY HASH, с версии 11) — строка попадает в секцию по остатку от деления хеша ключа на число секций (MODULUS,REMAINDER); это способ равномерно разделить данные без естественного диапазона.
Создадим копию таблицы заказов, секционированную по годам:
CREATE TABLE lab09.orders_p (
    order_id     integer NOT NULL,
    customer_id  integer NOT NULL,
    created_at   timestamptz NOT NULL,
    status       text NOT NULL,
    warehouse_id integer,
    PRIMARY KEY (order_id, created_at)
) PARTITION BY RANGE (created_at);
CREATE TABLE lab09.orders_2022 PARTITION OF lab09.orders_p
    FOR VALUES FROM ('2022-01-01') TO ('2023-01-01');
CREATE TABLE lab09.orders_2023 PARTITION OF lab09.orders_p
    FOR VALUES FROM ('2023-01-01') TO ('2024-01-01');
CREATE TABLE lab09.orders_2024 PARTITION OF lab09.orders_p
    FOR VALUES FROM ('2024-01-01') TO ('2025-01-01');
INSERT INTO lab09.orders_p SELECT * FROM bookstore.orders;
SELECT tableoid::regclass AS partition, count(*) FROM lab09.orders_p GROUP BY 1 ORDER BY 1;
     partition     | count
-------------------+-------
 lab09.orders_2022 |  6559
 lab09.orders_2023 |  6766
 lab09.orders_2024 |  6675
Нижняя граница диапазона включается, верхняя — нет, поэтому полночь 1 января 2023 года попадает во вторую секцию. Первичный ключ секционированной таблицы обязан включать ключ секционирования: уникальность проверяется индексами каждой секции по отдельности, и только так СУБД может гарантировать её для всей таблицы. Строка, для которой нет подходящей секции, вызывает ошибку no partition of relation "orders_p" found for row; чтобы её избежать, создают секцию по умолчанию (PARTITION OF ... DEFAULT) или заранее — секции на будущие периоды. Структура секционированной таблицы и отсечение секций показаны на рисунке.
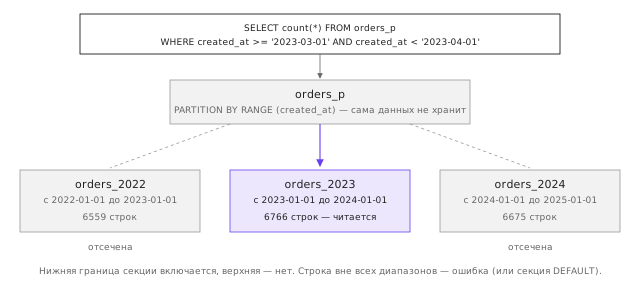
Главная выгода для запросов — отсечение секций (англ. partition pruning): если условие запроса ограничивает ключ секционирования, планировщик исключает из плана секции, которые не могут содержать нужных строк 10. Как именно читается план выполнения, подробно разбирается в теме 11; здесь достаточно увидеть, какие секции в нём остались:
EXPLAIN SELECT count(*) FROM lab09.orders_p
WHERE created_at >= '2023-03-01' AND created_at < '2023-04-01';
                                QUERY PLAN
--------------------------------------------------------------------------
 Aggregate  (cost=152.99..153.00 rows=1 width=8)
   ->  Seq Scan on orders_2023 orders_p  (cost=0.00..151.49 rows=600 width=0)
         Filter: ((created_at >= '2023-03-01 00:00:00+03'::timestamp with time zone)
                   AND (created_at < '2023-04-01 00:00:00+03'::timestamp with time zone))
В плане одна секция — orders_2023 (длинная строка условия перенесена для читаемости). Если же условие не касается ключа секционирования, читаются все секции:
EXPLAIN SELECT count(*) FROM lab09.orders_p WHERE status = 'cancelled';
 Aggregate  (cost=409.69..409.70 rows=1 width=8)
   ->  Append  (cost=0.00..406.12 rows=1425 width=0)
         ->  Seq Scan on orders_2022 orders_p_1  (cost=0.00..130.99 rows=488 width=0)
               Filter: (status = 'cancelled'::text)
         ->  Seq Scan on orders_2023 orders_p_2  (cost=0.00..134.57 rows=463 width=0)
               Filter: (status = 'cancelled'::text)
         ->  Seq Scan on orders_2024 orders_p_3  (cost=0.00..133.44 rows=474 width=0)
               Filter: (status = 'cancelled'::text)
Узел Append объединяет результаты сканирования трёх секций. Отсечение возможно и во время выполнения, если граница известна только тогда — например, задана функцией now() или параметром подготовленного оператора; в плане это видно как строка Subplans Removed: N.
Не менее важна выгода для обслуживания. Удалить данные за 2022 год можно командой DROP TABLE lab09.orders_2022 или отсоединить секцию ALTER TABLE ... DETACH PARTITION — это мгновенная операция над метаданными вместо DELETE миллионов строк. Очистка и построение индексов выполняются по секциям, и старые, неизменяемые секции не нужно обрабатывать повторно.
Секционирование — не бесплатное ускорение: запрос без условия по ключу обходит все секции, при сотнях секций растут затраты на планирование, а уникальность по столбцам вне ключа секционирования обеспечить нельзя. Документация рекомендует выбирать ключ секционирования по самым частым условиям запросов и операциям удаления данных и избегать чрезмерного числа секций 10. Для таблицы в десятки тысяч строк, как orders при scale=1, секционирование ничего не даёт; оно оправдано, когда таблица измеряется десятками гигабайт или когда данные регулярно удаляются целыми периодами. Распределение секций по разным серверам — шардирование — рассматривается в теме 16.
Итоги темы
Физическое проектирование превращает логическую схему в объекты конкретной СУБД, и почти каждое его решение — компромисс между корректностью, объёмом и скоростью. Тип данных — это одновременно ограничение и способ хранения. Денежные суммы требуют точной арифметики numeric или целых чисел, потому что двоичная плавающая точка не представляет десятичные дроби и накапливает ошибку. Моменты событий хранятся в timestamptz, который переводит время в UTC и обратно, а не в timestamp, теряющем привязку к часовому поясу. В PostgreSQL char(n) и varchar(n) не быстрее text, а ограничение длины — это правило целостности, не оптимизация. Выбор между перечислением, CHECK и справочником определяется тем, кто и как меняет список значений.
Суррогатные ключи из последовательностей уникальны, но допускают пропуски. Случайные UUID версии 4 рассыпают вставки по всему индексу, отчего индекс становится больше и медленнее; UUID версии 7, упорядоченные по времени, ведут себя почти как последовательность. В PostgreSQL 16 встроенной функции для них нет — она появилась в версии 18.
На внутреннем уровне таблица — набор файлов из страниц по 8 КиБ. Каждая строка несёт 23-байтовый заголовок, выровненный до 24 байт, и 4-байтовый указатель; столбцы выравниваются по границам своих типов, поэтому порядок столбцов влияет на размер таблицы. Длинные значения сжимаются и выносятся в TOAST-таблицу, когда строка превышает порог около 2 КиБ. Зная эти числа, можно с точностью до страницы рассчитать размер таблицы до её создания.
Тип jsonb даёт гибкость для разнородных атрибутов и поддерживает операторы включения и язык путей SQL/JSON, но лишает данные типов, ограничений и связей; атрибуты, по которым есть логика и связи, должны быть столбцами. Секционирование делит большую таблицу на части по ключу, позволяя пропускать ненужные секции при запросах и удалять старые данные целыми секциями.
Остался главный инструмент физического проектирования, без которого ни одна большая таблица не обходится, — индекс. Как устроено B-дерево, почему его высота почти не растёт с ростом таблицы, какие ещё типы индексов есть в PostgreSQL и чего стоит каждый индекс при изменении данных, рассматривается в теме 10.
Литература
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 8. Data Types; 5.9. Schemas; 23.6. Tablespaces; 24.2. Collation Support. — 2024. https://www.postgresql.org/docs/16/datatype.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 73. Database Physical Storage. — 2024. https://www.postgresql.org/docs/16/storage.html
- PostgreSQL Global Development Group. PostgreSQL 18 Documentation. 9.14. UUID Functions. — 2025. https://www.postgresql.org/docs/18/functions-uuid.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. F.25. pageinspect — low-level inspection of database pages. — 2024. https://www.postgresql.org/docs/16/pageinspect.html
- IEEE 754-2019. IEEE Standard for Floating-Point Arithmetic. — IEEE, 2019, DOI: 10.1109/IEEESTD.2019.8766229.
- Goldberg D. What Every Computer Scientist Should Know About Floating-Point Arithmetic. — ACM Computing Surveys, 1991, Т. 23, № 1, С. 5–48, DOI: 10.1145/103162.103163.
- Davis K., Peabody B., Leach P. Universally Unique IDentifiers (UUIDs). — RFC 9562, IETF, 2024. https://www.rfc-editor.org/rfc/rfc9562
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 8.14. JSON Types. — 2024. https://www.postgresql.org/docs/16/datatype-json.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 9.16. JSON Functions and Operators. — 2024. https://www.postgresql.org/docs/16/functions-json.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 5.11. Table Partitioning; CREATE TABLE (Storage Parameters). — 2024. https://www.postgresql.org/docs/16/ddl-partitioning.html
- Davis M., Whistler K., Scherer M. Unicode Technical Standard #10: Unicode Collation Algorithm. — Unicode Consortium. https://www.unicode.org/reports/tr10/
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017. (Рус. пер.: Клеппман М. Высоконагруженные приложения. Программирование, масштабирование, поддержка. — СПб.: Питер, 2018.)
- Рогов Е. В. PostgreSQL 16 изнутри. — М.: ДМК Пресс, 2024. https://postgrespro.ru/education/books/internals
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.