
Индексы
В предыдущих темах мы изучали реляционную модель, логическое и физическое проектирование таблиц. Но до сих пор данные читались последовательным перебором: чтобы найти одну книгу по названию или один заказ по номеру, СУБД была вынуждена прочитать всю таблицу с диска страницу за страницей. В учебной базе с двумя тысячами строк это занимает миллисекунды, но в промышленной базе с миллионами записей последовательное сканирование превращает запрос в секундное ожидание и блокирует дисковую подсистему.
Эта тема посвящена индексам — вспомогательным структурам данных, которые связывают значения столбцов с физическими адресами строк таблицы (TID — Tuple Identifier). Мы разберём, как устроено классическое B-дерево, почему оно одинаково быстро находит единичные строки и диапазоны, как работают составные, частичные и покрывающие индексы, а также изучим специализированные типы индексов в PostgreSQL: GIN, GiST, BRIN и Hash.
Зачем нужны индексы
Последовательное чтение против прямого доступа
Пусть таблица заказов orders масштаба scale=50 содержит 1 000 000 строк и занимает около 450 МБ (примерно 25 000 страниц по 8 КиБ). Если мы выполняем простой запрос:
SELECT * FROM bookstore.orders WHERE customer_id = 12345;
Без индекса сервер выполняет последовательное сканирование (Seq Scan) 5: процесс чтения считывает с диска в буферный кэш все 25 000 страниц, проверяя каждую запись на соответствие предикату customer_id = 12345. Если искомых заказов всего три штуки, 99,99 % прочитанных данных оказываются бесполезными.
Индекс представляет собой упорядоченный список пар (ключ, TID). Зная customer_id = 12345, сервер за 3–4 операции чтения переходит по ветвям дерева к нужной листовой странице индекса, находит три указателя на строки (номер страницы и смещение внутри страницы) и считывает ровно те страницы таблицы, где эти строки физически находятся. Число дисковых обращений сокращается с 25 000 до 6–7.
Понятие селективности
Всегда ли индекс выгоднее последовательного сканирования? Нет. Эффективность индекса зависит от селективности предиката (англ. selectivity) — доли строк таблицы, удовлетворяющих условию 23.
- Если предикат выбирает 0,01 % строк (высокая селективность), индекс даёт колоссальный выигрыш.
- Если же предикат выбирает 40 % строк (низкая селективность), обращение по индексу порождает 400 000 случайных чтений страниц таблицы. Каждое случайное чтение страницы (
random_page_cost) на шпиндельных дисках и даже на SSD обходится планировщику дороже последовательного чтения (seq_page_cost), при котором ядро ОС использует упреждающее чтение (readahead). В этом случае планировщик PostgreSQL сознательно отказывается от индекса и выбирает последовательное чтение всей таблицы 1.
B-дерево: фундаментальная структура хранения
По умолчанию в PostgreSQL команда CREATE INDEX создаёт B-дерево (точнее, его модификацию B^+-дерево с алгоритмом Lehman & Yao 46).
Устройство B-дерева в PostgreSQL
B-дерево состоит из страниц размером 8 КиБ, организованных в сбалансированную иерархию 16:
- Метастраница (Meta Page): блок 0, содержащий версию реализации, указатель на текущий корневой блок и статистику дерева.
- Корневой узел (Root Page): вершина дерева, содержащая пары «ключ — номер дочернего блока».
- Внутренние узлы (Internal Pages): промежуточные уровни маршрутизации поиска.
- Листовые узлы (Leaf Pages): нижний уровень дерева, хранящий пары
(ключ, TID). Все листовые страницы связаны между собой двусвязным списком через указателиbtpo_prevиbtpo_next.
Благодаря двусвязному списку листьев B-дерево одинаково эффективно обслуживает операторы равенства =, неравенства <, <=, >, >=, проверку принадлежности диапазону BETWEEN и упорядочивание ORDER BY.
Расчёт высоты дерева
Ключевое достоинство B-дерева — огромный коэффициент ветвления (англ. fanout). На одной странице 8 КиБ помещается от 200 до 400 ключей с указателями 1.
- При коэффициенте ветвления B = 300:
- Уровень 1 (корень): 300 записей.
- Уровень 2: 300^2 = 90\,000 записей.
- Уровень 3: 300^3 = 27\,000\,000 записей.
- Уровень 4: 300^4 = 8\,100\,000\,000 записей (8 миллиардов!).
Для таблицы в 1 миллион строк глубина дерева составляет всего 2–3 уровня (tree_level). Это означает, что доступ к любой строке гарантированно требует не более 3–4 чтений страниц.
Внутреннюю структуру B-дерева можно исследовать через стандартное расширение pageinspect:
SELECT tree_level, internal_pages, leaf_pages
FROM pgstatindex('bookstore.orders_pkey');
 tree_level | internal_pages | leaf_pages
------------+----------------+------------
          2 |             15 |       2740
Префиксный поиск и классы операторов
B-дерево по текстовому столбцу с типовой локалью использует сортировку по правилам национального алфавита (collation). В условиях вида WHERE email LIKE 'ivan%' планировщик часто не может использовать стандартный индекс, так как порядок символов в ICU-локали может отличаться от строгого побайтового сравнения.
Для поддержки быстрого поиска по префиксу шаблонных строк LIKE 'abc%' индекс создаётся со специальным классом операторов text_pattern_ops 5:
CREATE INDEX customer_email_prefix_idx ON bookstore.customer (email text_pattern_ops);
С этим классом операторов B-дерево упорядочивает байты по кодам ASCII/UTF-8, трансформируя условие LIKE 'ivan%' в диапазонное сканирование email >= 'ivan' AND email < 'ivao'.
Составные и покрывающие индексы
Правило левого префикса в составных индексах
Индекс может быть построен по нескольким столбцам:
CREATE INDEX orders_cust_created_idx ON bookstore.orders (customer_id, created_at);
В таком индексе записи отсортированы строго лексикографически: сначала по первому столбцу customer_id, а строки с одинаковым customer_id — по второму столбцу created_at.
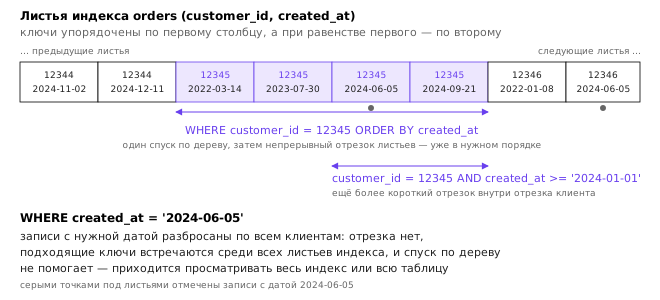
Отсюда следует фундаментальное правило левого префикса 2:
- Запрос
WHERE customer_id = 10 AND created_at >= '2024-01-01'использует индекс целиком; - Запрос
WHERE customer_id = 10использует дерево для поиска диапазона покупателя; - Запрос
WHERE created_at >= '2024-01-01'не может использовать индекс эффективно, так как даты распределены по всем покупателям и не образуют непрерывного диапазона.
Покрывающие индексы (INCLUDE) и Index Only Scan
Обычное индексное сканирование (Index Scan) сначала находит TID в индексе, а затем обращается к таблице («куче» — heap), чтобы извлечь остальные столбцы запроса. Каждое обращение к куче требует чтения страницы.
Если все столбцы, запрошенные клиентом, уже содержатся в самом индексе, сервер может выполнить сканирование только индекса (Index Only Scan) 15. Но если добавить столбец в индекс обычным образом (CREATE INDEX ON orders (customer_id, status)), дерево будет сортировать данные и по status, тратя процессорное время на сравнение строк и расщепление страниц.
Конструкция INCLUDE добавляет неключевые столбцы только в листовые страницы дерева без участия в сортировке:
CREATE INDEX orders_cust_status_inc_idx ON bookstore.orders (customer_id) INCLUDE (status);
Запрос SELECT status FROM bookstore.orders WHERE customer_id = 42 считывает только индекс.
Тонкость: из-за механизма MVCC (многоверсионности, тема 12) индекс не хранит номера транзакций xmin/xmax. Чтобы убедиться, что найденная строка видна текущему снимку, PostgreSQL обращается к карте видимости (Visibility Map, VM) таблицы. Если бит страницы в карте видимости равен 1 (все строки страницы зафиксированы и видны всем), обращение к куче исключается полностью (Heap Fetches: 0) 1.
Специализированные индексы
Частичные индексы (Partial Indexes)
Если запрос фильтрует строки по редкому значению флага, нет смысла индексировать миллионы неинтересных строк. Частичный индекс содержит предикат WHERE:
CREATE INDEX orders_unprocessed_idx ON bookstore.orders (created_at)
WHERE status IN ('pending', 'processing');
Если незавершённых заказов в интернет-магазине 0,5 %, частичный индекс займёт в 200 раз меньше места в оперативной памяти и не будет замедлять вставки завершённых заказов.
Индексы по выражениям
Если приложение часто ищет данные без учёта регистра, условие WHERE lower(email) = 'test@example.com' при обычном индексе по email приведёт к Seq Scan, так как функция lower() скрывает значение ключа от планировщика. Решение — индекс по выражению:
CREATE INDEX customer_lower_email_idx ON bookstore.customer (lower(email));
Другие методы доступа: GIN, GiST, BRIN, Hash
PostgreSQL поддерживает подключаемую архитектуру методов доступа к индексам 15:
| Тип | Архитектура | Основное применение |
|---|---|---|
| B-tree | Сбалансированное дерево | Равенство, диапазоны, сортировка чисел, дат, строк |
| Hash | Хеш-таблица с бакетами | Быстрый поиск только по равенству =, компактнее B-tree |
| GIN | Обобщённый инвертированный индекс | Полнотекстовый поиск, массивы, документы JSONB (@>), поиск подстрок с pg_trgm |
| GiST | Дерево сбалансированных предикатов | Геометрия PostGIS, временные интервалы (tsrange), ограничения исключения EXCLUDE |
| BRIN | Индекс диапазонов блоков | Огромные таблицы (>100 ГБ), где данные упорядочены физически (даты логов, автоинкремент) |
Инвертированный индекс GIN
В B-дереве строка индекса содержит (значение, TID). В GIN (Generalized Inverted Index) 7 индексируются элементы, входящие в состав составных значений (слова текста, элементы массива или ключи/значения JSONB). GIN строит список TID для каждого отдельного элемента:
CREATE INDEX book_attrs_gin_idx ON bookstore.book USING gin (attrs);
Запрос SELECT * FROM bookstore.book WHERE attrs @> '{"binding": "hard"}'; мгновенно находит книги по инвертированному списку ключа binding. А расширение pg_trgm позволяет с помощью GIN ускорять поиск произвольных подстрок LIKE '%слово%' за счёт индексирования 3-буквенных сочетаний (триграмм).
Блочный индекс BRIN
В аналитических таблицах и журналах событий строки вставляются монотонно по времени. Значит, на страницах в начале диска лежат старые даты, а в конце — свежие. BRIN (Block Range Index) хранит только минимальное и максимальное значение столбца для диапазона страниц (по умолчанию 128 блоков = 1 МБ).
- Размер BRIN-индекса для таблицы на 100 млн строк составляет считанные сотни килобайт!
- При поиске
WHERE created_at >= '2024-06-01'BRIN позволяет мгновенно отбросить 95 % страниц диска, читая только блоки с подходящими экстремумами.
Эксплуатация индексов и пагинация
Цена индексов и HOT-обновления
Каждый созданный индекс ускоряет чтение, но замедляет INSERT, UPDATE и DELETE, так как СУБД обязана синхронно обновить все деревья индексов.
Для смягчения этой проблемы в PostgreSQL реализован механизм HOT (Heap-Only Tuples) 1: если при операции UPDATE значения индексируемых столбцов не изменились, а на текущей странице таблицы есть свободное место, новая версия строки создаётся на той же странице без добавления записей в индексы. Старая и новая версии связываются цепочкой прямо внутри страницы.
Обслуживание: CONCURRENTLY и разрастание
Команда CREATE INDEX требует эксклюзивной блокировки SHARE, разрешающей чтение, но блокирующей любые операции записи INSERT/UPDATE/DELETE. На рабочей базе с миллионами строк создание индекса может длиться минуты, парализуя сервис.
Для изменения структуры без простоя применяется конкурентное создание 5:
CREATE INDEX CONCURRENTLY idx_orders_date ON bookstore.orders (created_at);
В режиме CONCURRENTLY сервер сканирует таблицу в два прохода, не блокируя пишущие транзакции. Если при построении произошёл сбой, индекс помечается как INVALID и требует удаления либо перестроения утилитой REINDEX CONCURRENTLY.
Пагинация по ключу (Keyset) против OFFSET
При отображении каталогов в веб-приложениях традиционно используется смещение LIMIT 20 OFFSET 100000.
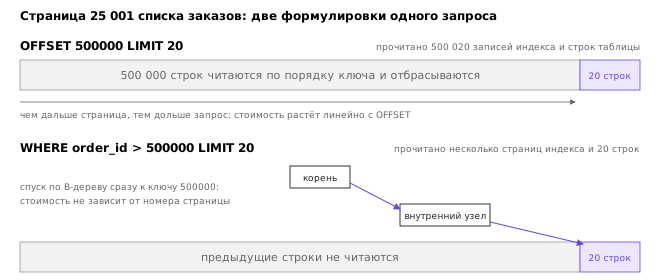
Конструкция OFFSET 100000 вынуждает сервер прочитать по индексу 100 000 строк, отбросить их и вернуть только следующие 20. На 5000-й странице сайта запрос начинает зависать на секунды.
Промышленный стандарт решения этой проблемы — пагинация по ключу (keyset pagination / seek method) 2:
-- Быстрый переход к следующей странице:
SELECT order_id, created_at, status
FROM bookstore.orders
WHERE (created_at, order_id) < ('2024-05-15 14:30:00+03', 451200)
ORDER BY created_at DESC, order_id DESC
LIMIT 20;
Благодаря составному индексу (created_at, order_id) планировщик не перебирает 100 000 строк, а делает точечный спуск по дереву прямо к первому элементу следующей страницы, гарантируя одинаковое время отклика (1–2 мс) как на первой, так и на миллионной странице.
Итоги темы
Индексы — главный инструмент обеспечения производительности реляционных баз данных. Классическое B-дерево обеспечивает логарифмическую сложность O(\log N) операций поиска, вставки и диапазонного чтения. Составные индексы подчиняются правилу левого префикса, а конструкция INCLUDE реализует Index Only Scan, исключая обращения к страницам кучи при актуальной карте видимости. Для специализированных сценариев PostgreSQL предоставляет инвертированные индексы GIN для JSONB и текстового поиска, а также компактные зонные индексы BRIN для упорядоченных во времени журналов.
В следующей теме мы изучим, как планировщик запросов на основе стоимостной модели решает, когда именно использовать эти индексы, как читать планы EXPLAIN (ANALYZE, BUFFERS) и оптимизировать сложные соединения.
Литература
- Рогов Е. В. PostgreSQL 16 изнутри. — М.: ДМК Пресс, 2024.
- Winand M. SQL Performance Explained. — 2012. https://use-the-index-luke.com/
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Lehman P. L., Yao S. B. Efficient Locking for Concurrent Operations on B-Trees. — ACM Transactions on Database Systems, 1981, Vol. 6, No. 4, С. 650–670.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 11. Indexes. — 2024. https://www.postgresql.org/docs/16/indexes.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 64. B-Tree Indexes. — 2024. https://www.postgresql.org/docs/16/btree.html
- Bartunov O., Sigaev T. Generalized Inverted Index for PostgreSQL. — 2006.