
Выполнение и оптимизация запросов
Язык SQL декларативен: разработчик описывает, какие данные ему нужны, но не указывает алгоритм их извлечения. Задача превращения декларативного SQL-запроса в эффективный императивный план выполнения возложена на ядро СУБД — планировщик (оптимизатор) и исполнитель (executor).
В этой теме мы проследим весь путь запроса от получения сетевого пакета до выдачи результирующего набора строк. Мы разберём классическую модель итераторов Volcano, алгоритмы соединений (Nested Loop, Hash Join, Merge Join), стоимостную модель планировщика PostgreSQL, чтение планов EXPLAIN (ANALYZE, BUFFERS) и методы устранения типичных узких мест в промышленных запросах.
Путь запроса в СУБД
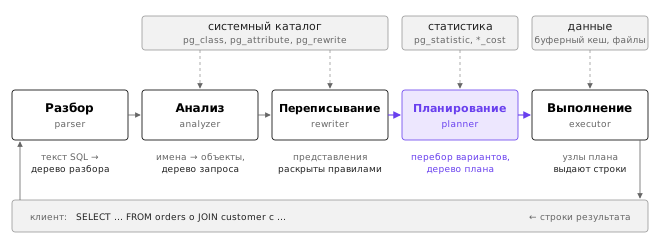
Прежде чем запрос начнёт выполняться, он проходит через четыре стадии обработки 14:
- Разбор (Parser): лексический и синтаксический анализ строки SQL. Парсер проверяет грамматику и строит дерево разбора (parse tree), где каждый узел представляет ключевое слово или выражение.
- Переписывание (Rewriter): семантический анализ и трансформация дерева. На этом этапе проверяется существование таблиц и столбцов в системном каталоге
pg_classиpg_attribute, вызовы представлений (VIEW) заменяются их телами, а правила (RULE) встраиваются в дерево запроса. - Планирование (Planner / Optimizer): поиск оптимального плана выполнения на основе стоимостной модели. Планировщик перебирает возможные порядки соединений, выбирает методы доступа к таблицам и оценивает затраты каждого варианта в условных единицах стоимости (cost units).
- Выполнение (Executor): физическое исполнение выбранного плана и передача строк клиенту.
Модель итераторов (модель Volcano)
Исполнитель запросов в PostgreSQL построен по конвейерной итераторной модели Volcano Гоетца Грэфе 3. План выполнения представляет собой дерево узлов (Nodes). Каждый узел реализует стандартизированный интерфейс с тремя базовыми функциями:
ExecInit(): инициализация узла, выделение структур памяти;ExecProcNode(): запрос следующей строки (Next);ExecEnd(): освобождение занятых ресурсов.
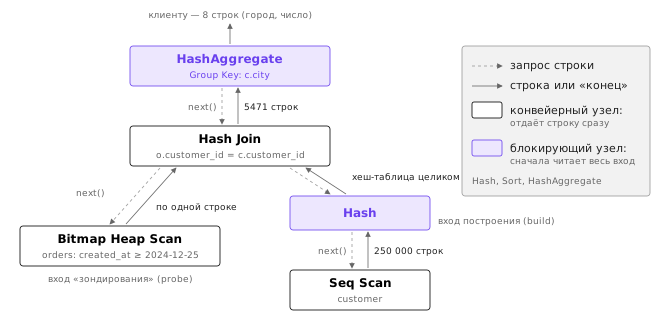
Главное достоинство модели итераторов — конвейерная обработка (pipelining): СУБД не материализует промежуточные результаты в памяти целиком. Корневой узел вызывает Next() у дочернего, тот передаёт запрос ещё ниже, и первая строка возвращается клиенту немедленно. Это обеспечивает мгновенное время отклика для запросов с LIMIT.
Исключение составляют блокирующие операции (англ. pipeline breakers): сортировка (Sort) и построение хеш-таблицы (Hash). Чтобы отсортировать данные или построить хеш, узел обязан сначала вычитать и накопить в памяти все входящие строки.
Методы доступа к таблицам
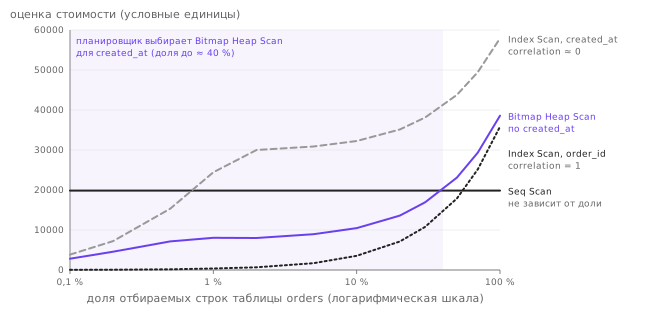
При обращении к отдельной таблице планировщик выбирает один из четырёх методов доступа 14:
- Последовательное сканирование (Seq Scan): считывание всех страниц таблицы подряд. Оптимально при низкой селективности (выборке более 15–20 % строк), а также для таблиц, целиком помещающихся в несколько блоков памяти.
- Индексное сканирование (Index Scan): точечный спуск по B-дереву и немедленное чтение соответствующей страницы кучи (heap). Идеально для уникальных выборок (
WHERE id = 42) и диапазонного чтения с сортировкой. - Сканирование только индекса (Index Only Scan): извлечение данных напрямую из индекса без чтения страниц таблицы, если все запрошенные столбцы есть в индексе и подтверждены картой видимости (Visibility Map).
- Сканирование по битовой карте (Bitmap Index Scan + Bitmap Heap Scan): двухфазный метод. Первая фаза сканирует индекс и строит в оперативной памяти битовую карту: в ней битами помечаются страницы таблицы, содержащие искомые строки. Вторая фаза сортирует номера страниц по физическому порядку на диске и последовательно считывает только нужные блоки. Это превращает хаотичные случайные чтения (random I/O) в эффективное последовательное чтение и позволяет комбинировать несколько индексов по условиям
AND/ORлогическими операциямиBitmapAndиBitmapOr.
Методы соединения отношений (Joins)
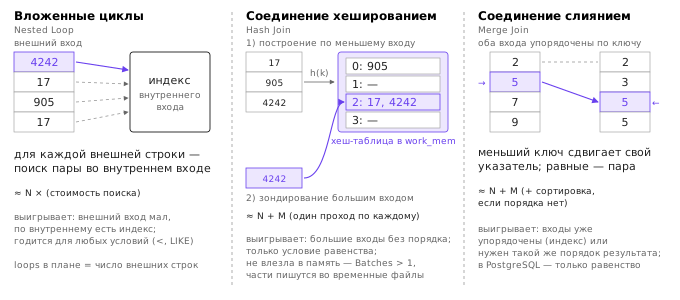
В реляционной алгебре соединение R \bowtie S требует сопоставления кортежей. В PostgreSQL реализованы три фундаментальных алгоритма соединения 12:
1. Соединение вложенными циклами (Nested Loop)
Внешний цикл перебирает строки отношения R, и для каждой строки во внутреннем цикле ищутся совпадения в S:
\text{Сложность без индекса: } O(|R| \cdot |S|), \quad \text{с индексом по } S: O(|R| \cdot \log |S|)
- Когда выигрывает: внешнее отношение R очень мало (1–100 строк), а по внутреннему отношению S доступен эффективный индекс.
- Особенность: не требует предварительного чтения всего набора данных и начинает отдавать строки немедленно.
2. Соединение хешированием (Hash Join)
Алгоритм выполняется в две фазы:
- Фаза сборки (Build): меньшее отношение считывается целиком, и по ключу соединения в памяти строится хеш-таблица.
- Фаза зондирования (Probe): большее отношение последовательно сканируется, и для каждой строки вычисляется хеш ключа, по которому в хеш-таблице мгновенно находятся совпадения.
- Сложность: линейная O(|R| + |S|).
- Когда выигрывает: соединение больших неотсортированных таблиц по предикату равенства (
R.id = S.r_id). - Ограничение: требует достаточного объёма памяти
work_mem. Если хеш-таблица не помещается вwork_mem, PostgreSQL разбивает соединение на несколько пакетов (batches) со сбросом временных файлов на диск, что резко замедляет запрос.
3. Соединение слиянием (Merge Join)
Оба отношения предварительно упорядочиваются по ключу соединения, после чего два курсора синхронно двигаются по потокам данных, как в алгоритме сортировки слиянием:
- Сложность: O(|R| \log |R| + |S| \log |S|) при необходимости сортировки, либо O(|R| + |S|), если данные уже упорядочены индексами.
- Когда выигрывает: обе таблицы уже отсортированы нужным образом (например, читаются по B-дереву), либо результат запроса сам требует
ORDER BYпо ключам соединения.
Стоимостная модель и статистика
Параметры стоимости
Оптимизатор PostgreSQL — стоимостной (Cost-Based Optimizer, CBO) 12. Каждому элементарному действию приписан весовой коэффициент в условных единицах:
seq_page_cost = 1.0— базовый эталон: последовательное чтение одной страницы с диска;random_page_cost = 4.0— случайное чтение страницы (для современных NVMe SSD администраторы снижают этот параметр до1.1–1.5, чтобы планировщик охотнее выбирал индексный доступ);cpu_tuple_cost = 0.01— обработка одной строки процессором;cpu_index_tuple_cost = 0.005— обработка одной индексной записи;cpu_operator_cost = 0.0025— вычисление одного оператора или функции в условииWHERE.
Итоговая оценка стоимости запроса складывается из затрат на ввод-вывод (I/O) и процессорную обработку:
\text{Total Cost} = (\text{Pages}_{\text{seq}} \cdot 1.0) + (\text{Pages}_{\text{rnd}} \cdot 4.0) + (\text{Tuples} \cdot 0.01) + (\text{Operators} \cdot 0.0025)
Системная статистика pg_stats
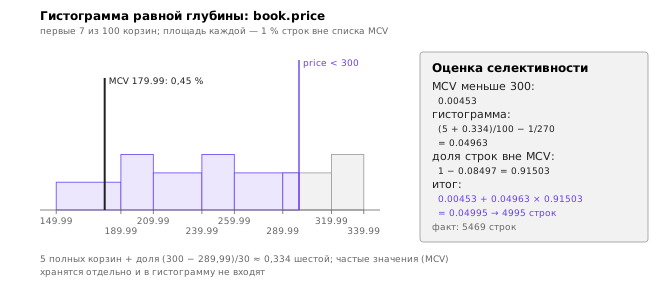
Чтобы оценить число строк, попадающих под условие, планировщик опирается на статистику, собираемую фоновым процессом ANALYZE в представлении pg_stats 14:
n_distinct: оценка числа уникальных значений (положительное число — абсолютное количество; отрицательное — доля от общего числа строк);most_common_vals(MCV) иmost_common_freqs(MCF): списки самых частых значений и их вероятностей (для условий видаWHERE status = 'delivered');histogram_bounds: гистограмма равных глубин (Equi-depth Histogram), делящая диапазон значений на интервалы с одинаковым числом строк (для условийWHERE price BETWEEN 500 AND 1500);correlation: мера физической корреляции порядка строк на диске с их логическим порядком (1.0 — строки идеально упорядочены; 0.0 — хаотичный разброс).
Коррелированные столбцы и CREATE STATISTICS
Стандартный планировщик предполагает, что условия по разным столбцам независимы:
P(A \land B) = P(A) \cdot P(B)
Если столбцы логически связаны (например, city = 'Москва' и region = 'Московская область'), перемножение селективностей занижает число ожидаемых строк в сотни раз. Планировщик ошибочно ожидает 1 строку вместо 10 000 и выбирает губительный Nested Loop.
Решение проблемы — сбор расширенной многостолбцовой статистики 4:
CREATE STATISTICS stat_city_region (dependencies, ndistinct, mcv)
ON city, region FROM bookstore.customer;
ANALYZE bookstore.customer;
Чтение планов EXPLAIN
Команда EXPLAIN показывает расчетный план планировщика, а EXPLAIN (ANALYZE, BUFFERS) физически выполняет запрос и сравнивает прогноз с реальностью 1:
EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)
SELECT * FROM bookstore.orders WHERE customer_id = 12345;
Пример разбора строки плана:
Bitmap Heap Scan on orders (cost=12.45..450.20 rows=110 width=48) (actual rows=115 loops=1)
cost=12.45..450.20:- Первое число (
12.45) — startup cost: затраты до выдачи первой строки клиенту (например, время на построение битовой карты); - Второе число (
450.20) — total cost: полная расчетная стоимость извлечения всех строк.
- Первое число (
rows=110: расчетная кардинальность (сколько строк ожидает планировщик).width=48: средний размер результирующей строки в байтах.actual rows=115 loops=1: фактические результаты. Еслиloops > 1(узел вызывался многократно, например, во внутреннем цикле Nested Loop), общее число строк равноactual rows * loops.Buffers: shared hit=42 read=5:hit: страницы, прочитанные из оперативной памяти (Shared Buffers);read: физические чтения страниц с диска.
Золотое правило оптимизации: главное внимание при чтении планов обращается на расхождение между расчетными rows и фактическими actual rows. Если они расходятся на порядки — статистика устарела, столбцы коррелированы либо в условии использована функция, лишающая оптимизатор математической модели.
Типичные проблемы и профилирование
Ошибки в коде запросов
Разбор типичных ошибок индексирования и написания запросов подробно систематизирован М. Винандом 5:
- Неявное приведение типов (Implicit Casting):
Если столбец
phoneимеет типvarchar, а в запросе написаноWHERE phone = 79991234567(числовой литерал), PostgreSQL неявно оборачивает столбец в приведение:WHERE phone::numeric = 79991234567. Индекс поphoneотключается, вызывая полныйSeq Scan. - Ловушка
NOT INс NULL: ЗапросWHERE id NOT IN (SELECT parent_id FROM t)при наличии хотя бы одногоNULLв подзапросе возвращает пустой результат для всей таблицы из-за трёхзначной логики SQL (NULL = xдаетUNKNOWN). Планировщик вынужден использовать тяжелыйSubPlan. Решение — операторNOT EXISTS.
Профилирование с pg_stat_statements
Для поиска проблемных запросов на промышленном сервере нельзя опираться на ручной запуск EXPLAIN. Стандартом мониторинга является расширение pg_stat_statements 1, аккумулирующее статистику всех выполняемых запросов с нормализацией параметров:
SELECT query, calls,
       round(total_exec_time::numeric, 2) AS total_ms,
       round(mean_exec_time::numeric, 2) AS avg_ms,
       shared_blks_read
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 5;
Этот отчет мгновенно показывает запросы, потребляющие 80 % ресурсов процессора и диска, позволяя точечно создавать недостающие индексы и оптимизировать соединения.
Итоги темы
Оптимизация запросов — это математически выверенный процесс сопоставления структуры запроса, индексов и статистических распределений данных. Планировщик транслирует SQL через конвейер Volcano, выбирая между последовательным чтением, индексами и битовыми картами. При соединениях Nested Loop оптимален для точечных индексных выборок, Hash Join масштабируется на большие несортированные объемы, а Merge Join эффективен для предварительно упорядоченных потоков. Анализ EXPLAIN (ANALYZE, BUFFERS) и контроль расхождения rows с actual rows — фундаментальный навык разработчика и администратора баз данных.
В следующей теме 12 мы перейдем к механизмам изоляции транзакций, блокировкам и многоверсионному управлению параллельным доступом (MVCC).
Литература
- Рогов Е. В. PostgreSQL 16 изнутри. — М.: ДМК Пресс, 2024.
- Selinger P. G., Astrahan M. M., Chamberlin D. D., Lorie R. A., Price T. G. Access Path Selection in a Relational Database Management System. — Proceedings of the 1979 ACM SIGMOD International Conference on Management of Data, 1979, С. 23–34.
- Graefe G. Volcano — An Extensible and Efficient Query Evaluation System. — IEEE Transactions on Knowledge and Data Engineering, 1994, Vol. 6, No. 1, С. 120–135.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 14. Performance Tips (Using EXPLAIN; Statistics Used by the Planner; Controlling the Planner with Guiding Options). — 2024. https://www.postgresql.org/docs/16/performance-tips.html
- Winand M. SQL Performance Explained. — 2012. https://use-the-index-luke.com/