
Транзакции и управление параллельным доступом
В предыдущих темах база данных рассматривалась так, будто с ней работает один пользователь: запрос читает таблицы, оператор UPDATE изменяет строки, и никто не вмешивается между двумя действиями. В действительности сервер «Книжного узла» одновременно обслуживает сотни сеансов: покупатели оформляют заказы, склад списывает остатки, аналитик строит отчёт за год. В теме 1 был приведён пример: две программы читают остаток книги (11), каждая продаёт экземпляр и записывает 10 — продано два экземпляра, а остаток уменьшился на один. От таких ошибок защищают транзакции; в этой теме разбирается, как именно.
Транзакция объединяет несколько операций в логическую единицу, и СУБД обещает, что единица выполнится целиком или не выполнится вовсе и что параллельные единицы не помешают друг другу. Второе обещание гораздо тоньше первого: полная изоляция стоит дорого, поэтому стандарт SQL предлагает несколько уровней изоляции, и на каждом возможны свои аномалии.
Первый раздел вводит транзакцию и свойства ACID, второй описывает аномалии параллельного выполнения, воспроизводя каждую двумя сеансами. Третий раздел даёт теорию — расписания, сериализуемость, граф конфликтов, двухфазные блокировки и многоверсионность, четвёртый — уровни изоляции стандарта и их реализацию в PostgreSQL. Пятый раздел посвящён версиям строк, снимкам, очистке и заморозке, шестой — блокировкам и практическим шаблонам. Журнал и восстановление после сбоя — предмет темы 13.
Опыты выполнены в PostgreSQL 16 на базе bookstore (scale=1) в схеме lab12 из окружения лабораторной работы: копии остатков (stock) и цен (book_price), таблица shelf для наблюдения версий строк и очередь заданий job; в сеансах установлен search_path = lab12, bookstore, public. Сеанс, выполняющий оператор, указан комментарием -- сессия 1. Номера транзакций и процессов у читателя будут другими.
Транзакция и её свойства
Свойства ACID
Транзакция (англ. transaction) — последовательность операций чтения и записи, которую СУБД рассматривает как неделимую единицу работы. Понятие сложилось в работах Дж. Грея 1970-х годов 4, а аббревиатуру ACID для четырёх её свойств предложили Т. Хердер и А. Ройтер в 1983 году 9:
- атомарность (англ. atomicity) — либо все изменения транзакции становятся частью базы, либо ни одно; транзакция, прерванная на середине, не оставляет следов;
- согласованность (англ. consistency) — транзакция переводит базу из одного согласованного состояния в другое: все ограничения целостности (темы 2 и 6) выполняются после её завершения, если они выполнялись до начала;
- изоляция (англ. isolation) — параллельно выполняемые транзакции не влияют друг на друга: результат такой же, как если бы они выполнялись в каком-то последовательном порядке;
- долговечность (англ. durability) — после подтверждения фиксации изменения не теряются ни при каком сбое, предусмотренном моделью отказов.
Согласованность в значительной мере обязанность приложения: СУБД проверяет объявленные ограничения (CHECK, внешние ключи), но правило «в двух городах вместе должен оставаться хотя бы один экземпляр книги» ей неизвестно. Атомарность и изоляция — обязанность СУБД, в PostgreSQL обе опираются на многоверсионность; долговечность обеспечивает журнал (тема 13). Определение изоляции через «какой-то последовательный порядок» — это и есть сериализуемость, центральное понятие темы 10.
Границы транзакции: BEGIN, COMMIT, ROLLBACK и автофиксация
Транзакция начинается командой BEGIN (синоним START TRANSACTION) и завершается COMMIT — фиксацией (англ. commit), после которой изменения видимы другим и долговечны, — или ROLLBACK — откатом (англ. rollback, abort). Оператор вне блока BEGIN … COMMIT выполняется как отдельная транзакция; этот режим называется автофиксацией (англ. autocommit) и в psql включён по умолчанию (\echo :AUTOCOMMIT выводит on, а вне блока SELECT now() = statement_timestamp() даёт t: время начала транзакции совпадает с временем начала оператора). Клиентские библиотеки ведут себя иначе: psycopg 3 по требованию спецификации Python DB-API неявно открывает транзакцию первым оператором и держит её до commit() или rollback() (подробно — в теме 15). Забытая открытая транзакция удерживает блокировки и снимок данных, что, как будет показано ниже, мешает и другим сеансам, и очистке таблиц.
Уровень изоляции задаётся в BEGIN ISOLATION LEVEL … или первой командой транзакции SET TRANSACTION ISOLATION LEVEL …; по умолчанию действует default_transaction_isolation = 'read committed' 5.
Точки сохранения и прерванная транзакция
Отменить часть транзакции позволяют точки сохранения (англ. savepoint): SAVEPOINT имя отмечает момент внутри транзакции, ROLLBACK TO SAVEPOINT имя отменяет сделанное после него, и транзакция продолжается. Пусть второе из двух списаний «Преступления и наказания» нарушает ограничение CHECK (quantity >= 0):
BEGIN;
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 2;
SAVEPOINT before_spb;
UPDATE stock SET quantity = quantity - 5 WHERE warehouse_id = 2 AND book_id = 2;
SELECT warehouse_id, quantity FROM stock WHERE book_id = 2 ORDER BY 1;
ROLLBACK TO SAVEPOINT before_spb;
SELECT warehouse_id, quantity FROM stock WHERE book_id = 2 ORDER BY 1;
COMMIT;
BEGIN
UPDATE 1
SAVEPOINT
ERROR:  new row for relation "stock" violates check constraint "stock_quantity_check"
DETAIL:  Failing row contains (2, 2, -3).
ERROR:  current transaction is aborted, commands ignored until end of transaction block
ROLLBACK
 warehouse_id | quantity
--------------+----------
            1 |       30
            2 |        2
            3 |       23
(3 rows)

COMMIT
После ошибки транзакция PostgreSQL переходит в состояние «прервана» (англ. aborted): любой оператор, кроме ROLLBACK и ROLLBACK TO SAVEPOINT, отвергается сообщением current transaction is aborted. Откат к точке сохранения вернул транзакцию в рабочее состояние, и первое списание (31 → 30) было зафиксировано. Без точки сохранения выход один — полный откат; COMMIT в прерванной транзакции ничего не фиксирует и отвечает ROLLBACK. Расставлять точки сохранения перед каждым оператором psql умеет сам (переменная ON_ERROR_ROLLBACK).
Аномалии параллельного выполнения
Потерянное обновление
Аномалия (англ. anomaly), или феномен (англ. phenomenon), — эффект параллельного выполнения транзакций, невозможный ни при каком последовательном их выполнении. В Москве (склад 1) 11 экземпляров «Войны и мира»; две транзакции на уровне по умолчанию Read Committed продают по экземпляру: читают остаток, вычисляют новое значение в приложении и записывают его:
-- сессия 1
BEGIN;
SELECT quantity FROM stock WHERE warehouse_id = 1 AND book_id = 1;   -- 11
-- сессия 2
BEGIN;
SELECT quantity FROM stock WHERE warehouse_id = 1 AND book_id = 1;   -- 11
-- сессия 1
UPDATE stock SET quantity = 10 WHERE warehouse_id = 1 AND book_id = 1;
-- сессия 2
UPDATE stock SET quantity = 10 WHERE warehouse_id = 1 AND book_id = 1;   -- ждёт
-- сессия 1
COMMIT;
-- сессия 2: UPDATE 1 выполнен сразу после фиксации сессии 1
COMMIT;
UPDATE второй сессии ждал, пока первая, уже изменившая строку, не завершится, а затем записал 10: остаток 10 при двух проданных экземплярах, изменение первой транзакции потеряно. Это потерянное обновление (англ. lost update): транзакция перезаписывает значение, изменённое другой транзакцией после того, как первая его прочитала, и тем самым уничтожает чужое изменение 1. Временная диаграмма на рисунке ниже показывает чередование операций двух транзакций.
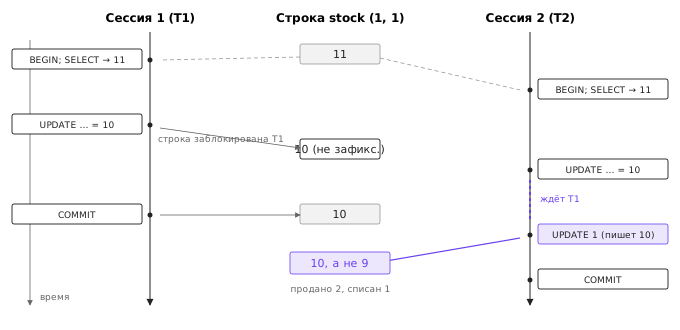
Блокировка строки упорядочила две записи, но вторая основана на устаревшем чтении. При нагрузке эффект велик: когда в скрипте race.py из окружения лабораторной работы восемь потоков продают по 50 экземпляров тем же способом «прочитать — подумать 2 мс — записать», из 400 продаж остаток отражает лишь 57 (таблица в разделе «Повтор транзакции»).
Грязное чтение, неповторяющееся чтение и фантом
Стандарт SQL-92 определяет уровни изоляции через три феномена 1.
Грязное чтение (англ. dirty read) — транзакция читает данные другой, ещё не зафиксированной транзакции; если та откатится, прочитанного значения никогда не существовало. Попробуем воспроизвести его на уровне Read Uncommitted:
-- сессия 1
BEGIN;
UPDATE book_price SET price = 990 WHERE book_id = 1;
-- сессия 2
BEGIN TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
SELECT price FROM book_price WHERE book_id = 1;     -- 1290.00
Вторая сессия видит старую цену, а не незафиксированные 990. В PostgreSQL грязное чтение невозможно ни на каком уровне: Read Uncommitted реализован как Read Committed 5. Причина в многоверсионности: читатель получает последнюю зафиксированную версию строки.
Неповторяющееся, или нечёткое, чтение (англ. non-repeatable read, fuzzy read) — транзакция дважды читает одну и ту же строку и получает разные значения, потому что между чтениями другая транзакция изменила строку и зафиксировалась:
-- сессия 1
BEGIN;
SELECT price FROM book_price WHERE book_id = 1;     -- 1290.00
-- сессия 2 (автофиксация)
UPDATE book_price SET price = 1390 WHERE book_id = 1;
-- сессия 1
SELECT price FROM book_price WHERE book_id = 1;     -- 1390.00
COMMIT;
На уровне Read Committed это допустимо: каждый оператор видит данные, зафиксированные к его началу.
Фантом (англ. phantom) — транзакция дважды выполняет запрос с одним и тем же условием и получает разные множества строк, потому что другая транзакция вставила (или удалила) строки, удовлетворяющие условию. В отличие от неповторяющегося чтения, «виновата» строка, которой при первом чтении не существовало:
-- сессия 1
BEGIN;
SELECT count(*), sum(quantity) FROM stock WHERE book_id = 7;   -- 3 | 39
-- сессия 2
INSERT INTO stock VALUES (1, 7, 5);
-- сессия 1
SELECT count(*), sum(quantity) FROM stock WHERE book_id = 7;   -- 4 | 44
COMMIT;
Фантомы опасны для проверок «если таких строк ещё нет, вставить»: заблокировать отсутствующую строку невозможно.
Родственная аномалия — асимметрия чтения (англ. read skew): транзакция читает связанные строки в разные моменты и видит несогласованное состояние. Если первая сессия прочитала остаток «Войны и мира» в Москве (11), затем вторая перенесла 5 экземпляров в Казань и зафиксировалась, а потом первая прочитала остаток в Казани (13), то по двум чтениям у магазина 24 экземпляра, хотя в любой момент их было 19. Запрос SELECT sum(quantity) FROM stock WHERE book_id = 1 в той же транзакции вернул верные 19: на уровне Read Committed согласованность гарантирована внутри оператора, но не между операторами.
Асимметрия записи
Самая коварная аномалия возникает, когда транзакции читают пересекающиеся данные, а изменяют разные строки. Правило магазина: «Пикник на обочине», который есть в Москве и Казани (в окружении — по одному экземпляру), нельзя распродать полностью. Два продавца одновременно проверяют правило и продают книгу каждый со своего склада, работая на уровне Repeatable Read, чтобы исключить неповторяющееся чтение и фантомы:
-- сессия 1
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT sum(quantity) FROM stock WHERE book_id = 4 AND warehouse_id IN (1, 4);   -- 2
-- сессия 2
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT sum(quantity) FROM stock WHERE book_id = 4 AND warehouse_id IN (1, 4);   -- 2
-- сессия 1: 2 > 1, значит, можно продать
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 4;
-- сессия 2: 2 > 1, значит, можно продать
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 4 AND book_id = 4;
-- сессия 1
COMMIT;
-- сессия 2
COMMIT;
SELECT warehouse_id, quantity FROM stock WHERE book_id = 4 ORDER BY warehouse_id;
 warehouse_id | quantity
--------------+----------
            1 |        0
            4 |        0
(2 rows)
Обе транзакции зафиксированы, правило нарушено: книги нет нигде. Выполненные последовательно в любом порядке, они дали бы правильный результат: вторая увидела бы сумму 1 и отказала покупателю. Ни одна из трёх аномалий стандарта не возникла, и ни одна запись не перезаписала другую. Аномалия называется асимметрией записи (англ. write skew) 1: решение о записи принято на основании данных, которые изменила другая транзакция, причём записи затрагивают разные строки. Классический пример — дежурство врачей: «хотя бы один должен остаться на дежурстве», и двое одновременно снимают себя с дежурства 12. Та же аномалия возникает со вставками, например при правиле «не больше одного задания на заказ»: две транзакции проверяют count(*) = 0 и обе вставляют по строке.
Почему асимметрия записи возникает и как её обнаружить, объясняет теория сериализуемости.
Сериализуемость и способы её обеспечения
Расписания и сериализуемость по конфликтам
Формально транзакцию представляют последовательностью операций чтения r(X) и записи w(X) элементов данных и фиксации c. Расписание (англ. schedule, history) — чередование операций нескольких транзакций, в котором сохранён порядок операций внутри каждой транзакции 104. Последовательное расписание (англ. serial schedule) выполняет транзакции целиком одну за другой. Расписание называется сериализуемым (англ. serializable), если его результат эквивалентен результату некоторого последовательного расписания тех же транзакций.
На практике используют достаточное условие, проверяемое по структуре расписания. Две операции разных транзакций конфликтуют (англ. conflict), если они обращаются к одному элементу и хотя бы одна из них — запись. Различают три вида конфликтов: чтение — запись (r1(X) … w2(X)), запись — чтение (w1(X) … r2(X)) и запись — запись (w1(X) … w2(X)). Переставлять соседние неконфликтующие операции можно без изменения результата, а конфликтующие — нельзя. Расписание сериализуемо по конфликтам (англ. conflict serializable), если перестановками неконфликтующих операций его можно превратить в последовательное.
Критерий проверки — граф предшествования, или граф конфликтов (англ. precedence graph, conflict graph): вершины — транзакции, а дуга Ti → Tj проводится, если операция Ti конфликтует с более поздней операцией Tj. Расписание сериализуемо по конфликтам тогда и только тогда, когда граф не содержит циклов; топологическая сортировка графа даёт эквивалентный последовательный порядок 10.
Разберём вручную расписание потерянного обновления. Обозначим строку остатка через A:
S1: r1(A) r2(A) w1(A) c1 w2(A) c2
Пары конфликтующих операций: r1(A) и w2(A) — чтение T1 раньше записи T2, дуга T1 → T2; r2(A) и w1(A) — чтение T2 раньше записи T1, дуга T2 → T1; w1(A) и w2(A) — дуга T1 → T2. В графе есть цикл T1 → T2 → T1, расписание несериализуемо. При любом последовательном порядке остаток стал бы 9, а не 10.
Теперь асимметрия записи. Пусть A — остаток в Москве, B — в Казани; каждая транзакция читает оба (сумма), а пишет свой:
S2: r1(A) r1(B) r2(A) r2(B) w1(A) w2(B) c1 c2
Конфликты: r2(A) раньше w1(A) — дуга T2 → T1; r1(B) раньше w2(B) — дуга T1 → T2. Записи в разные строки не конфликтуют между собой, но цикл T1 → T2 → T1 образован двумя конфликтами «чтение — запись». Графы обоих расписаний показаны на рисунке ниже.
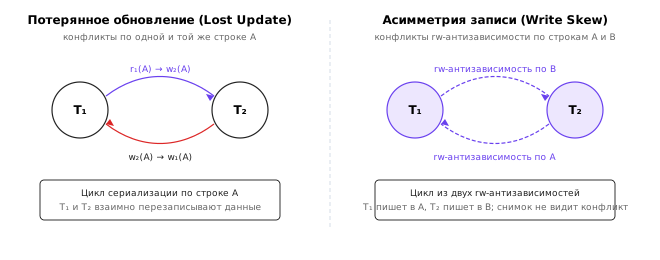
Конфликт «чтение — запись», при котором одна транзакция читает версию, а другая затем записывает новую версию того же элемента, называют антизависимостью (англ. rw-antidependency). Это понятие понадобится при обсуждении уровня Serializable.
Двухфазные блокировки
Классический способ гарантировать сериализуемость — блокировки. Перед чтением элемента транзакция получает разделяемую блокировку (англ. shared lock, S), перед записью — исключительную (англ. exclusive lock, X); S совместима с S, а X несовместима ни с чем. Сами по себе блокировки сериализуемости не обеспечивают: если отпустить блокировку сразу после чтения, другая транзакция успеет изменить элемент.
Протокол двухфазной блокировки (англ. two-phase locking, 2PL) требует, чтобы транзакция не получала ни одной новой блокировки после того, как отпустила хотя бы одну. У транзакции есть фаза роста, когда она только захватывает блокировки, и фаза сжатия, когда только отпускает. К. Эсваран, Дж. Грей и соавторы в 1976 году доказали, что любое расписание, порождённое транзакциями, соблюдающими 2PL, сериализуемо по конфликтам 8. На практике применяют строгую двухфазную блокировку (англ. strict 2PL): все блокировки удерживаются до фиксации или отката, что дополнительно исключает чтение незафиксированных данных и каскадные откаты 10.
В расписании S1 под строгой 2PL обе транзакции получают S-блокировки на A, затем каждая пытается получить X-блокировку и ждёт другую. Возникает взаимоблокировка (англ. deadlock): СУБД откатывает одну транзакцию, и при повторе та читает уже 10. Сериализуемость достигнута ценой ожиданий и откатов.
У 2PL две известные трудности. Первая — фантомы: блокировки строк не мешают вставить новую строку, удовлетворяющую условию запроса; нужны блокировки предикатов (англ. predicate locks), введённые в той же работе 1976 года 8, или их приближение — блокировки диапазонов ключей индекса (англ. next-key locking), как в InnoDB (MySQL). Вторая — производительность: читатели блокируют писателей и наоборот, поэтому длинный отчёт по таблице заказов останавливает оформление новых заказов.
Многоверсионность и изоляция снимков
Многоверсионное управление параллельным доступом (англ. Multiversion Concurrency Control, MVCC) устраняет конфликт читателей и писателей: при изменении строки старая версия не уничтожается, а рядом создаётся новая. Транзакция читает данные из снимка (англ. snapshot) — согласованного состояния базы, в котором видны изменения транзакций, зафиксированных до определённого момента, и не видны остальные. Читатель не ждёт писателя, а берёт предыдущую версию; писатель не ждёт читателя.
На многоверсионности построена изоляция снимков (англ. Snapshot Isolation, SI), описанная Х. Беренсоном и соавторами в 1995 году 1. Транзакция все чтения выполняет из снимка, взятого при её начале, а при фиксации действует правило «первый фиксирующий выигрывает» (англ. first-committer-wins): если элемент, который транзакция изменила, был изменён и зафиксирован другой транзакцией после взятия снимка, транзакция откатывается. Изоляция снимков исключает грязное чтение, неповторяющееся чтение, фантомы при чтении (снимок не меняется) и потерянное обновление (правило первого фиксирующего). Но она допускает асимметрию записи: в расписании S2 транзакции изменяют разные строки, правило первого фиксирующего не срабатывает, и обе фиксируются 1.
Oracle до сих пор называет изоляцию снимков уровнем Serializable. А. Фекете и соавторы в 2005 году доказали, что в графе зависимостей любого несериализуемого расписания под изоляцией снимков есть две подряд идущие антизависимости между параллельными транзакциями 13; этот результат лёг в основу сериализуемой изоляции снимков.
Уровни изоляции в стандарте и в PostgreSQL
Стандарт SQL и его критика
Стандарт SQL определяет четыре уровня изоляции — Read Uncommitted, Read Committed, Repeatable Read и Serializable — через запрещённые феномены; Serializable дополнительно обязан давать результат некоторого последовательного выполнения. Таблица сопоставляет стандарт с PostgreSQL по документации 5 и опытам темы; две последние строки добавлены по классификации Беренсона и соавторов 1.
| Аномалия | Read Uncommitted | Read Committed | Repeatable Read | Serializable |
|---|---|---|---|---|
| Грязное чтение | стандарт допускает, в PostgreSQL нет | нет | нет | нет |
| Неповторяющееся чтение | возможно | возможно | нет | нет |
| Фантом | возможно | возможно | стандарт допускает, в PostgreSQL нет | нет |
| Потерянное обновление | возможно | возможно | нет (ошибка сериализации) | нет |
| Асимметрия записи | возможна | возможна | возможна | нет |
Определение уровней через феномены подверг критике Беренсон с соавторами 1. Формулировки стандарта допускают узкое и широкое толкование («прочитано значение, которое потом откатили» или «прочитано незафиксированное значение»), перечень неполон — нет грязной записи (англ. dirty write, P0), перезаписи чужого незафиксированного значения, — а изоляция снимков запрещает все три феномена и формально проходит как Serializable, хотя допускает асимметрию записи. Авторы дали строгие формулировки (P0–P3, P4 — потерянное обновление, A5A — асимметрия чтения, A5B — асимметрия записи) и поместили изоляцию снимков между Repeatable Read и Serializable.
Read Committed: снимок на каждый оператор
На уровне Read Committed каждый оператор получает новый снимок в момент своего начала 5: он видит только зафиксированные данные и всегда согласованное состояние (сумма 19 в примере с асимметрией чтения), но два оператора одной транзакции могут видеть разное.
Особо ведут себя UPDATE, DELETE и SELECT … FOR UPDATE. Если найденная по снимку строка изменена параллельной незафиксированной транзакцией, оператор ждёт её завершения. Если та откатилась, оператор продолжает со своей версией; если зафиксировалась — берёт новейшую версию строки, заново проверяет для неё условие WHERE и при его выполнении изменяет новейшую версию 5. На этом основан простейший способ избавиться от потерянного обновления — атомарный UPDATE, вычисляющий новое значение из текущего:
-- сессия 1
BEGIN;
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 1;
-- сессия 2
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 1;   -- ждёт
-- сессия 1
COMMIT;
-- сессия 2: UPDATE 1
SELECT quantity FROM stock WHERE warehouse_id = 1 AND book_id = 1;
 quantity
----------
        9
(1 row)
Вторая сессия дождалась фиксации первой, перечитала строку (10) и записала 9. С условием AND quantity > 0 перепроверка делает безопасной и продажу последнего экземпляра: вторая из двух конкурирующих продаж после ожидания увидит нулевой остаток и вернёт UPDATE 0. Шаблон UPDATE … SET qty = qty - 1 WHERE … AND qty > 0 не требует ни повторов, ни явных блокировок, но вся логика проверки должна уместиться в один оператор. Документация предупреждает и об оборотной стороне перепроверки: оператор, затрагивающий много строк, может увидеть одни строки в одном состоянии, а другие — в другом 5.
Repeatable Read: изоляция снимков
На уровне Repeatable Read PostgreSQL реализует изоляцию снимков: снимок берётся при первом операторе транзакции (не в момент BEGIN) и используется до её конца 5. Поэтому повторное чтение цены в опыте выше дало бы прежние 1290, а запрос по book_id = 7 — те же три строки после вставки четвёртой: фантомов при чтении нет, хотя стандарт их здесь допускает.
Когда транзакция уровня Repeatable Read пытается изменить строку, которую после взятия её снимка изменила и зафиксировала другая транзакция, PostgreSQL не перечитывает строку, как на Read Committed, а прерывает транзакцию — так реализовано правило первого фиксирующего:
-- сессия 1
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT quantity FROM stock WHERE warehouse_id = 1 AND book_id = 1;   -- 11
-- сессия 2
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT quantity FROM stock WHERE warehouse_id = 1 AND book_id = 1;   -- 11
-- сессия 1
UPDATE stock SET quantity = 10 WHERE warehouse_id = 1 AND book_id = 1;
-- сессия 2
UPDATE stock SET quantity = 10 WHERE warehouse_id = 1 AND book_id = 1;   -- ждёт
-- сессия 1
COMMIT;
ERROR: could not serialize access due to concurrent update
Ошибка в сессии 2 появилась сразу после фиксации сессии 1 (если бы та откатилась, сессия 2 продолжила бы работу). Потерянное обновление предотвращено ценой отката: продажу нужно повторить, и повтор возьмёт новый снимок и прочитает 10. Асимметрию записи этот механизм не обнаруживает: транзакции изменили разные строки.
Serializable: сериализуемая изоляция снимков
До версии 9.1 уровень Serializable в PostgreSQL совпадал с нынешним Repeatable Read. С версии 9.1 он реализован как сериализуемая изоляция снимков (англ. Serializable Snapshot Isolation, SSI) — алгоритм М. Кэхилла, У. Рёма и А. Фекете 2008 года 2, доработанный для PostgreSQL Д. Портсом и К. Гриттнером 3. Сервер сохраняет изоляцию снимков и дополнительно отслеживает антизависимости между параллельными транзакциями. По теореме Фекете и соавторов несериализуемое расписание содержит «опасную структуру» (англ. dangerous structure): транзакцию-стержень (англ. pivot) T2 с входящей антизависимостью от параллельной T1 (T1 прочитала то, что T2 затем изменила) и исходящей антизависимостью к параллельной T3 (T2 прочитала то, что изменила T3) 132. T1 и T3 могут совпадать — так выглядит асимметрия записи двух транзакций. SSI находит такие структуры и откатывает одну из транзакций, не дожидаясь замыкания цикла (рисунок ниже).
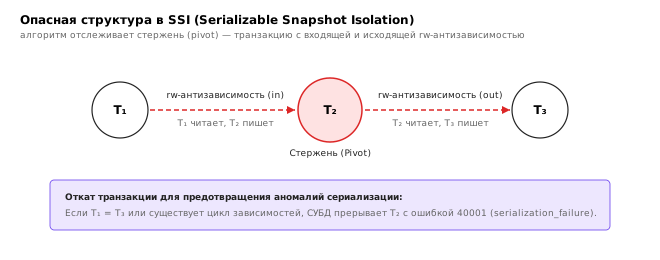
Чтобы обнаружить антизависимость, нужно знать, что читала транзакция. Для этого SSI ставит предикатные блокировки SIReadLock: они никого не заставляют ждать, а лишь отмечают прочитанные данные — версии строк, страницы, страницы индекса или отношение целиком. Повторим опыт с асимметрией записи на уровне Serializable:
-- сессия 1
BEGIN ISOLATION LEVEL SERIALIZABLE;
SELECT sum(quantity) FROM stock WHERE book_id = 4 AND warehouse_id IN (1, 4);   -- 2
-- сессия 2
BEGIN ISOLATION LEVEL SERIALIZABLE;
SELECT sum(quantity) FROM stock WHERE book_id = 4 AND warehouse_id IN (1, 4);   -- 2
-- сессия 1
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 4;
-- сессия 2
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 4 AND book_id = 4;
-- сессия 1
COMMIT;
-- сессия 2
COMMIT;
ERROR:  could not serialize access due to read/write dependencies among transactions
DETAIL:  Reason code: Canceled on identification as a pivot, during commit attempt.
HINT:  The transaction might succeed if retried.
Оба UPDATE прошли без ожидания, а вторая транзакция получила ошибку при фиксации как стержень опасной структуры; в Казани остался один экземпляр. Предикатные блокировки открытой транзакции видны в pg_locks (mode = 'SIReadLock'); здесь это одна блокировка всей таблицы stock, читаемой последовательным сканированием. При доступе по индексу блокируются лишь прочитанные страницы индекса и версии строк, и ложных конфликтов меньше; многочисленные блокировки укрупняются (параметр max_pred_locks_per_transaction) 35. Так же ловится и «вставочная» асимметрия: две транзакции, проверившие SELECT count(*) FROM job WHERE order_id = 140 и вставившие по заданию, на Repeatable Read обе фиксируются, а на Serializable вторая получает ту же ошибку.
SSI допускает ложные срабатывания (англ. false positives) — откаты транзакций, не нарушивших бы сериализуемость, — зато, по измерениям Портса и Гриттнера, на нагрузках с преобладанием чтения близка по производительности к изоляции снимков и заметно быстрее строгой 2PL 3. Для длинных отчётов есть режим SERIALIZABLE READ ONLY DEFERRABLE: транзакция ждёт «безопасного» снимка и затем выполняется без предикатных блокировок и без риска отката.
Повтор транзакции
На уровнях Repeatable Read и Serializable ошибки сериализации (SQLSTATE 40001) — нормальная часть работы. Такую транзакцию, как и прерванную взаимоблокировкой (40P01), приложение повторяет целиком: заново читает, решает и записывает 5; повторять последний оператор бессмысленно. Скрипт race.py реализует повтор; сравним пять способов продать 300 экземпляров восемью потоками (время — для учебного стенда):
Режим race.py | Уровень | Продаж | Остаток уменьшился на | Повторов | Время, с |
|---|---|---|---|---|---|
naive — чтение, пауза, запись | Read Committed | 400 | 57 | 0 | 0,63 |
atomic — quantity = quantity - 1 | Read Committed | 300 | 300 | 0 | 0,29 |
forupdate — SELECT … FOR UPDATE | Read Committed | 300 | 300 | 0 | 1,05 |
repeatable — как naive + повтор | Repeatable Read | 300 | 300 | 1459 | 6,47 |
serializable — как naive + повтор | Serializable | 300 | 300 | 1377 | 5,97 |
Корректны все варианты, кроме первого, но на «горячей» строке оптимистические уровни изоляции дают около пяти откатов на продажу; FOR UPDATE выстраивает потоки в очередь, а атомарный UPDATE держит блокировку строки минимальное время. Уровень Serializable делает корректность свойством СУБД, а не каждой транзакции, — главный аргумент в его пользу; для «горячих» мест полезны шаблоны из последнего раздела. Повтор в коде на Python разбирается в теме 15.
Многоверсионность в PostgreSQL
Версии строк: xmin, xmax и ctid
Заголовок версии строки (тема 9) содержит поля t_xmin, t_xmax и t_ctid. Каждой изменяющей транзакции PostgreSQL присваивает номер транзакции (англ. transaction ID, XID) — 32-битное число из возрастающего счётчика. Поле xmin — номер транзакции, создавшей версию (INSERT или UPDATE), xmax — номер транзакции, удалившей (DELETE или UPDATE) или заблокировавшей её, 0 — версия не удалялась; ctid — адрес версии: номер страницы и номер указателя. Эти поля доступны в запросах как системные столбцы 511.
Проследим строки таблицы shelf (три книги, без индексов, с выключенной автоочисткой). Функция heap_page_items расширения pageinspect показывает все версии на странице, включая невидимые 7. Сначала на странице 0 три версии под указателями 1–3 со смещениями 8136, 8056, 7992, все с t_xmin = 6037, t_xmax = 0. Сессия 1 в незафиксированной транзакции 6045 снижает цену второй книги, после чего обе сессии читают таблицу:
-- сессия 1
BEGIN;
UPDATE shelf SET price = 420 WHERE book_id = 2;
-- сессия 1 и сессия 2
SELECT ctid, xmin, xmax, book_id, price FROM shelf;
-- сессия 1
 ctid  | xmin | xmax | book_id |  price
-------+------+------+---------+---------
 (0,1) | 6037 |    0 |       1 | 1290.00
 (0,3) | 6037 |    0 |       3 |  390.00
 (0,4) | 6045 |    0 |       2 |  420.00
(3 rows)

-- сессия 2
 ctid  | xmin | xmax | book_id |  price
-------+------+------+---------+---------
 (0,1) | 6037 |    0 |       1 | 1290.00
 (0,2) | 6037 | 6045 |       2 |  450.00
 (0,3) | 6037 |    0 |       3 |  390.00
(3 rows)
Сессия 1 видит свою новую версию (0,4), сессия 2 — прежнюю (0,2) с xmax = 6045: транзакция 6045 пометила её удалённой, но не зафиксировалась. На странице лежат обе:
SELECT lp, lp_off, lp_flags, t_xmin, t_xmax, t_ctid
FROM heap_page_items(get_raw_page('lab12.shelf', 0));
 lp | lp_off | lp_flags | t_xmin | t_xmax | t_ctid
----+--------+----------+--------+--------+--------
  1 |   8136 |        1 |   6037 |      0 | (0,1)
  2 |   8056 |        1 |   6037 |   6045 | (0,4)
  3 |   7992 |        1 |   6037 |      0 | (0,3)
  4 |   7912 |        1 |   6045 |      0 | (0,4)
(4 rows)
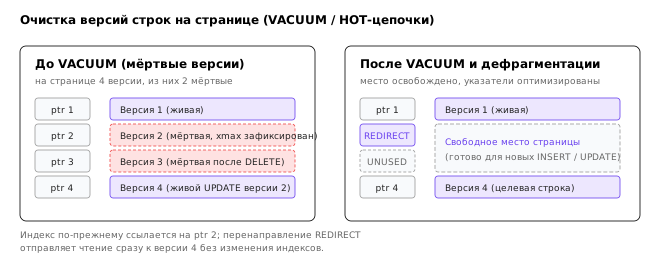
UPDATE в PostgreSQL — это вставка новой версии и пометка старой удалённой; t_ctid старой версии указывает на новую, и версии строки образуют цепочку. Откат транзакции 6045 не потребовал бы никаких действий со страницей: достаточно отметить в журнале состояний транзакций, что 6045 откатилась, и версия (0,4) станет невидимой, а xmax версии (0,2) — недействительным. Поэтому откат в PostgreSQL мгновенный при любом объёме изменений, а при восстановлении после сбоя не нужна фаза отмены (тема 13). После COMMIT сессия 1 удаляет третью книгу: DELETE ничего не стирает, версия (0,3) лишь получает t_xmax = 6046. Состояние страницы показано на рисунке ниже.
Снимки и правила видимости
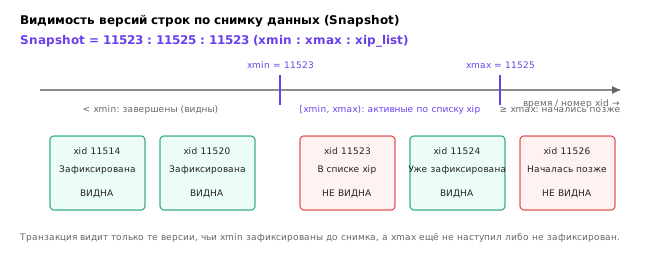
Снимок описывается тремя значениями, которые возвращает pg_current_snapshot() в виде xmin:xmax:xip_list 5: xmin — наименьший номер ещё активной транзакции (все меньшие завершены); xmax — граница, начиная с которой номера считаются не завершёнными (на единицу больше номера последней завершённой транзакции); xip_list — активные транзакции между ними. Изменения транзакции видны в снимке, если она зафиксирована, её номер меньше xmax и не входит в xip_list.
Пусть сессия 1 начала транзакцию 11523 и изменила цену первой книги, сессия 2 в транзакции 11524 изменила цену третьей и зафиксировалась (таблица перед опытом пересоздана). Сессия 3 берёт снимок и читает таблицу:
-- сессия 3
SELECT pg_current_snapshot();
SELECT ctid, xmin, xmax, book_id, price FROM shelf;
 pg_current_snapshot
---------------------
 11523:11525:11523
(1 row)

 ctid  | xmin  | xmax  | book_id |  price
-------+-------+-------+---------+---------
 (0,1) | 11514 | 11523 |       1 | 1290.00
 (0,2) | 11514 |     0 |       2 |  450.00
 (0,5) | 11524 |     0 |       3 |  380.00
(3 rows)
На странице пять версий: три исходные (xmin = 11514), из них первая удалена 11523, третья — 11524; версия 4 создана 11523, версия 5 — 11524. Применим правило к каждой:
- версия 1: создана 11514 (завершена до снимка), удалена 11523, активной в снимке, — удаление не видно, версия видна;
- версия 2: создана 11514, не удалялась — видна;
- версия 3: удалена 11524, которая зафиксирована и меньше
xmaxснимка, — не видна; - версия 4: создана активной 11523 — не видна;
- версия 5: создана 11524 — видна, цена 380.
Видно по одной версии каждой книги (рисунок ниже). Полные правила учитывают ещё собственные изменения транзакции (номера команд cmin/cmax) и откаченные транзакции 11.
Состояние транзакций хранится в каталоге pg_xact, по два бита на транзакцию; чтобы не обращаться к нему при каждом чтении, первый узнавший статус читатель ставит в заголовке версии биты-подсказки (англ. hint bits) HEAP_XMIN_COMMITTED и подобные, которые показывает функция heap_tuple_infomask_flags 7.
Уровни изоляции различаются моментом взятия снимка: перед каждым оператором (Read Committed) или перед первым оператором транзакции. Пока жив снимок, которому может понадобиться старая версия, её нельзя удалить; версии, не видимые ни одному снимку, называют мёртвыми (англ. dead tuples).
Очистка: VACUUM, autovacuum и раздувание
Очистка (англ. vacuum) находит мёртвые версии, удаляет ссылающиеся на них записи индексов и освобождает место на страницах. Выполним её для shelf после UPDATE и DELETE:
VACUUM (VERBOSE) shelf;
INFO:  vacuuming "bookstore.lab12.shelf"
INFO:  finished vacuuming "bookstore.lab12.shelf": index scans: 0
pages: 0 removed, 1 remain, 1 scanned (100.00% of total)
tuples: 2 removed, 2 remain, 0 are dead but not yet removable
removable cutoff: 6047, which was 0 XIDs old when operation ended
...
 lp | lp_off | lp_flags | t_xmin | t_xmax | t_ctid
----+--------+----------+--------+--------+--------
  1 |   8136 |        1 |   6037 |      0 | (0,1)
  2 |      4 |        2 |        |        |
  3 |      0 |        0 |        |        |
  4 |   8056 |        1 |   6045 |      0 | (0,4)
(4 rows)
Удалены две мёртвые версии: удалённые зафиксированными транзакциями с номером меньше removable cutoff не нужны ни одному снимку. Указатель 3 стал свободным (lp_flags = 0, LP_UNUSED), и следующая вставка заняла его. Указатель 2 стал перенаправлением (LP_REDIRECT) на указатель 4: так устроено HOT-обновление (англ. Heap-Only Tuple) — если новая версия поместилась на ту же страницу и индексируемые столбцы не менялись, индексы не получают новой записи и ведут к исходному указателю (подробнее — в теме 10). Версия 4 сдвинулась со смещения 7912 на 8056: страница уплотнена.
Обычная очистка не возвращает место операционной системе (кроме пустых страниц в конце файла): оно отмечается в карте свободного пространства (англ. free space map) и используется под новые версии. Покажем это на копии таблицы заказов (20 000 строк), измеряя её расширением pgstattuple:
CREATE TABLE orders_copy WITH (autovacuum_enabled = off) AS SELECT * FROM bookstore.orders;
SELECT pg_size_pretty(table_len) AS size, tuple_count, dead_tuple_count,
       pg_size_pretty(free_space) AS free
FROM pgstattuple('lab12.orders_copy');
| Шаг | Размер | Живых версий | Мёртвых версий | Свободно |
|---|---|---|---|---|
после создания и VACUUM | 1184 kB | 20 000 | 0 | 8824 bytes |
UPDATE orders_copy SET status = status | 2360 kB | 20 000 | 20 000 | 9484 bytes |
VACUUM | 2360 kB | 20 000 | 0 | 1180 kB |
ещё один такой же UPDATE | 2360 kB | 20 000 | 20 000 | 9484 bytes |
VACUUM FULL | 1184 kB | 20 000 | 0 | 8824 bytes |
Обновление всех строк удвоило таблицу; очистка размер не уменьшила, но освободила почти половину файла, и второе обновление уложилось в это место. Сократить файл может VACUUM FULL, переписывающий таблицу под исключительной блокировкой. Разрастание таблицы из-за мёртвых версий и пустот называют раздуванием (англ. bloat); опасно оно, когда очистка не успевает или не может работать.
Главная причина «не может» — долгий снимок. Повторим UPDATE и VACUUM (VERBOSE), пока сессия 2 держит открытой транзакцию Repeatable Read, уже прочитавшую таблицу:
tuples: 0 removed, 40000 remain, 20000 are dead but not yet removable
Двадцать тысяч версий мертвы для всех, кроме сессии 2, и пока она не завершит транзакцию, очистка их не уберёт. Такие сеансы находят в pg_stat_activity по столбцу backend_xmin (горизонт снимка); у сессии 2 там состояние idle in transaction — транзакция открыта, сеанс бездействует, типичный результат забытого COMMIT. Горизонт очистки держат также слоты репликации и запросы на реплике с hot_standby_feedback (тема 13).
Обычно очистку выполняет автоочистка (англ. autovacuum): раз в autovacuum_naptime (60 с) она обрабатывает таблицы, где мёртвых версий больше autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor × reltuples, по умолчанию 50 + 0,2 × число строк 6; для orders это 4050 версий. Попутно очистка ведёт карту видимости (англ. visibility map) — по два бита на страницу: «все версии видны всем» и «все заморожены»; первый бит позволяет очистке пропускать страницы, а сканированию только индекса (тема 10) — не читать таблицу.
Заморозка и переполнение счётчика транзакций
32-битный счётчик транзакций доходит примерно до 4,3 миллиарда и начинается заново. Номера сравниваются «по кругу»: для каждого номера около 2,1 миллиарда (2³¹) предшествующих считаются прошлым, остальные — будущим. Если версия доживёт до момента, когда счётчик уйдёт вперёд больше чем на 2³¹, её xmin окажется «в будущем», и строка исчезнет. Это переполнение счётчика транзакций (англ. transaction ID wraparound) 6. Защита — заморозка (англ. freezing): очистка помечает старые версии как видимые в любом снимке. С версии 9.4 для этого в заголовке одновременно ставятся биты HEAP_XMIN_COMMITTED и HEAP_XMIN_INVALID, а номер xmin сохраняется:
VACUUM (FREEZE) shelf;
SELECT lp, t_xmin, combined_flags
FROM heap_page_items(get_raw_page('lab12.shelf', 0)),
     heap_tuple_infomask_flags(t_infomask, t_infomask2);
 lp | t_xmin |   combined_flags
----+--------+--------------------
  1 |  11514 | {HEAP_XMIN_FROZEN}
  2 |  11514 | {HEAP_XMIN_FROZEN}
  3 |        |
  4 |        |
  5 |  11524 | {HEAP_XMIN_FROZEN}
(5 rows)
Очистка замораживает версии старше vacuum_freeze_min_age (50 миллионов транзакций). Номер, старше которого в таблице нет незамороженных версий, хранится в pg_class.relfrozenxid, для базы — в pg_database.datfrozenxid; функция age() показывает их возраст. Когда возраст relfrozenxid превышает autovacuum_freeze_max_age (200 миллионов), автоочистка выполняет агрессивную очистку таблицы, даже если для неё автоочистка выключена 6. Если и это не помогает, сервер при 40 миллионах оставшихся номеров начинает предупреждать, а при 3 миллионах перестаёт выделять номера. Возраст datfrozenxid — обязательный показатель мониторинга.
Блокировки и практические шаблоны
Блокировки таблиц
Многоверсионность не отменяет блокировок: писатели одной строки должны упорядочиться, а изменение структуры таблицы несовместимо с работой с ней. Блокировки уровня таблицы (англ. table-level locks) берутся неявно каждой командой; режимов восемь, и названия у них исторические (ROW EXCLUSIVE — блокировка таблицы). Основные режимы по документации 5:
| Режим | Какие команды его берут | С какими режимами конфликтует |
|---|---|---|
ACCESS SHARE | SELECT | ACCESS EXCLUSIVE |
ROW SHARE | SELECT … FOR UPDATE/SHARE | EXCLUSIVE, ACCESS EXCLUSIVE |
ROW EXCLUSIVE | INSERT, UPDATE, DELETE, MERGE | SHARE и все более сильные |
SHARE UPDATE EXCLUSIVE | VACUUM (без FULL), ANALYZE, CREATE INDEX CONCURRENTLY | сам с собой и все более сильные |
SHARE | CREATE INDEX (без CONCURRENTLY) | ROW EXCLUSIVE, SHARE UPDATE EXCLUSIVE и все сильнее SHARE |
ACCESS EXCLUSIVE | DROP TABLE, TRUNCATE, VACUUM FULL, большинство форм ALTER TABLE, LOCK TABLE | со всеми режимами |
Ещё два режима, SHARE ROW EXCLUSIVE и EXCLUSIVE, встречаются редко. Обычные SELECT, INSERT, UPDATE и DELETE на уровне таблицы не конфликтуют, CREATE INDEX останавливает запись, а большинство ALTER TABLE — всё.
Неочевидное следствие связано с очередью. Сессия 1 в открытой транзакции прочитала book_price (ACCESS SHARE). Сессия 2 выполняет мгновенный ALTER TABLE book_price ADD COLUMN discount numeric и ждёт ACCESS EXCLUSIVE. Сессия 3 выполняет обычный SELECT count(*) FROM book_price и тоже ждёт: её режим совместим с сессией 1, но запрос встаёт в очередь за сессией 2. Оба ожидающих оператора завершились сразу после COMMIT в сессии 1.
Так одна забытая транзакция и одна миграция схемы останавливают все запросы к таблице. Защита — SET lock_timeout = '2s' перед изменением схемы: команда, не дождавшаяся блокировки, прерывается сообщением ERROR: canceling statement due to lock timeout и повторяется позже (безопасные миграции — в теме 15).
Блокировки строк и их наблюдение
Блокировки строк (англ. row-level locks) хранятся не в общей памяти сервера, а в заголовке версии строки — в поле xmax и битах t_infomask, поэтому заблокировать можно сколько угодно строк. Изменение строки неявно блокирует её до конца транзакции, явно строку блокируют предложением SELECT … FOR … 5:
| Режим | Когда берётся | Конфликтует с |
|---|---|---|
FOR KEY SHARE | проверка внешнего ключа | FOR UPDATE |
FOR SHARE | запрет изменять строку | FOR NO KEY UPDATE, FOR UPDATE |
FOR NO KEY UPDATE | UPDATE, не меняющий уникальных ключей | FOR SHARE, FOR NO KEY UPDATE, FOR UPDATE |
FOR UPDATE | DELETE, UPDATE ключа, явный SELECT … FOR UPDATE | со всеми |
Ослабленные режимы нужны для внешних ключей. Вставка остатка INSERT INTO bookstore.stock VALUES (2, 1, 5) проверяет ссылку на книгу и блокирует её строку в режиме FOR KEY SHARE, а параллельное изменение цены этой книги берёт FOR NO KEY UPDATE — режимы совместимы, и в опыте вставка прошла без ожидания. Расширение pgrowlocks показало на строке книги обе блокировки с признаком multi = t: если строку блокируют несколько транзакций, в xmax пишется номер мультитранзакции (англ. MultiXact) со списком участников. А после SELECT … FOR UPDATE на книгу вставка остатка ждёт.
Кто кого ждёт, показывают pg_stat_activity (столбцы wait_event_type, wait_event), функция pg_blocking_pids(pid) и pg_locks. Пусть сессия 1 (процесс 32568) в открытой транзакции изменила цену книги, а сессия 2 (процесс 32567) пытается изменить её же. В pg_stat_activity у процесса 32567 видно ожидание Lock/transactionid и pg_blocking_pids = {32568}, а у 32568 — состояние idle in transaction. Подробности — в pg_locks:
SELECT l.pid, l.locktype, l.relation::regclass AS rel, l.transactionid AS xid,
       l.tuple, l.mode, l.granted
FROM pg_locks l JOIN pg_stat_activity a USING (pid)
WHERE a.datname = 'bookstore' AND l.pid <> pg_backend_pid() AND l.locktype <> 'virtualxid'
ORDER BY l.pid, l.locktype, rel;
  pid  |   locktype    |       rel       | xid  | tuple |       mode       | granted
-------+---------------+-----------------+------+-------+------------------+---------
 32567 | relation      | book_price      |      |       | RowExclusiveLock | t
 32567 | relation      | book_price_pkey |      |       | RowExclusiveLock | t
 32567 | transactionid |                 | 6048 |       | ShareLock        | f
 32567 | transactionid |                 | 6049 |       | ExclusiveLock    | t
 32567 | tuple         | book_price      |      |     1 | ExclusiveLock    | t
 32568 | relation      | book_price      |      |       | RowExclusiveLock | t
 32568 | relation      | book_price_pkey |      |       | RowExclusiveLock | t
 32568 | transactionid |                 | 6048 |       | ExclusiveLock    | t
(8 rows)
Каждая транзакция держит исключительную блокировку собственного номера. Сессия 2 нашла в xmax строки номер 6048 активной транзакции и, чтобы дождаться её конца, запросила блокировку этого номера в режиме ShareLock — она не выдана (granted = f) и будет выдана, когда транзакция 6048 завершится. Блокировка вида tuple закрепляет за сессией 2 место в очереди к строке. Снять зависание можно, завершив блокирующий сеанс функцией pg_terminate_backend(32568).
Взаимоблокировки
Пусть две транзакции списывают по экземпляру двух книг в разном порядке:
-- сессия 1
BEGIN;
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 1;
-- сессия 2
BEGIN;
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 2;
-- сессия 1
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 2;   -- ждёт
-- сессия 2
UPDATE stock SET quantity = quantity - 1 WHERE warehouse_id = 1 AND book_id = 1;   -- ждёт
Через секунду сессия 1 получила ошибку, а сессия 2 — UPDATE 1:
ERROR:  deadlock detected
DETAIL:  Process 30926 waits for ShareLock on transaction 5975; blocked by process 30925.
Process 30925 waits for ShareLock on transaction 5974; blocked by process 30926.
HINT:  See server log for query details.
CONTEXT:  while updating tuple (0,3) in relation "stock"
Граф ожиданий не проверяется при каждой блокировке: процесс, прождавший дольше deadlock_timeout (по умолчанию 1 с), строит граф ожиданий (англ. wait-for graph) и, найдя цикл, откатывает свою транзакцию 5; сообщение перечисляет цикл. Взаимоблокировка — следствие порядка действий приложения, и лучшее средство — единый порядок захвата ресурсов: если все транзакции списывают книги по возрастанию book_id, цикл невозможен. Помогает и блокировка всех нужных строк одним оператором (SELECT … ORDER BY book_id FOR UPDATE).
Практические шаблоны
Атомарный UPDATE — самый дешёвый способ избежать потерянного обновления на Read Committed. Пессимистическая блокировка (англ. pessimistic locking) — SELECT … FOR UPDATE в начале транзакции — нужна, когда решение требует логики, не выразимой одним оператором. Если блокировать все строки, от которых зависит решение, она исправляет и асимметрию записи: когда обе сессии выполняют SELECT … WHERE book_id = 4 AND warehouse_id IN (1, 4) FOR UPDATE, вторая ждёт первую, после чего на Read Committed видит остатки 0 и 1 и отказывает покупателю, а на Repeatable Read получает could not serialize access due to concurrent update. Этот приём называют материализацией конфликта: скрытый конфликт по чтению становится явным конфликтом по записи.
Оптимистическая блокировка (англ. optimistic locking) подходит, когда между чтением и записью проходят минуты (менеджер открыл карточку книги и через пять минут сохраняет цену): держать транзакцию так долго нельзя, поэтому в строке хранят номер версии и проверяют его при записи:
-- обе сессии прочитали price = 450.00, version = 1
-- сессия 2
UPDATE book_price SET price = 470, version = version + 1 WHERE book_id = 2 AND version = 1;   -- UPDATE 1
-- сессия 1
UPDATE book_price SET price = 460, version = version + 1 WHERE book_id = 2 AND version = 1;   -- UPDATE 0
UPDATE 0 сообщает, что строку уже изменили и её нужно перечитать.
Для очереди заданий, из которой берут задания несколько исполнителей, служит SKIP LOCKED — пропуск строк, заблокированных другими:
BEGIN;
SELECT job_id, order_id FROM job WHERE status = 'new'
ORDER BY job_id LIMIT 1 FOR UPDATE SKIP LOCKED;
-- сессия 1 получила job_id = 1, сессия 2 — job_id = 2, обе без ожидания
Вариант NOWAIT сразу выдаёт ERROR: could not obtain lock on row in relation "job". Без блокировки исполнители возьмут одно задание вдвоём, а с FOR UPDATE без SKIP LOCKED выстроятся в очередь; скрипт queue_worker.py в лабораторной работе сравнивает три варианта.
Рекомендательные блокировки (англ. advisory locks) — блокировки произвольных чисел, смысл которых определяет приложение: pg_advisory_lock(ключ) (до конца сеанса или pg_advisory_unlock), pg_advisory_xact_lock(ключ) (до конца транзакции), pg_try_advisory_lock(ключ) (без ожидания, возвращает true или false) 5. Так гарантируют, что ночной пересчёт рейтингов выполняет один экземпляр программы: пока сессия 1 держит pg_advisory_lock(12), pg_try_advisory_lock(12) в сессии 2 возвращает f.
Общее правило — короткие транзакции: длинная держит блокировки и старый снимок и повышает вероятность ошибок сериализации. Параметры statement_timeout, lock_timeout и idle_in_transaction_session_timeout (по умолчанию выключены) ограничивают оператор, ожидание блокировки и бездействие в транзакции; их разумно задавать для ролей приложений.
Итоги темы
Транзакция объединяет операции в единицу со свойствами ACID. Идеал изоляции — сериализуемость: результат параллельного выполнения совпадает с некоторым последовательным. Её проверяют по ацикличности графа конфликтов, а обеспечивают строгой двухфазной блокировкой, при которой читатели и писатели ждут друг друга, или многоверсионностью с дополнительным контролем.
Стандарт SQL определяет уровни изоляции через грязное чтение, неповторяющееся чтение и фантом, но, как показали Беренсон и соавторы, эта шкала неполна: в ней нет потерянного обновления и асимметрии записи, и в неё не укладывается изоляция снимков. В PostgreSQL Read Uncommitted совпадает с Read Committed (снимок на каждый оператор); Repeatable Read — изоляция снимков, где конфликт записи даёт ошибку could not serialize access due to concurrent update, но асимметрия записи возможна; Serializable — сериализуемая изоляция снимков, которая по предикатным блокировкам находит опасные структуры антизависимостей. На двух последних уровнях приложение обязано повторять транзакции.
Многоверсионность в PostgreSQL хранит все версии строки в самой таблице: xmin, xmax и снимок xmin:xmax:xip_list определяют, какая версия кому видна; откат мгновенный, читатели не ждут писателей. Цена — мёртвые версии, которые убирает очистка, раздувание, если очистка не успевает или ей мешает старый снимок, и заморозка, без которой 32-битный счётчик транзакций не может безопасно пойти на новый круг.
Блокировки таблиц защищают структуру, блокировки строк упорядочивают писателей; ожидания видны в pg_locks и pg_stat_activity, взаимоблокировки сервер находит по графу ожиданий. Атомарный UPDATE, FOR UPDATE, оптимистическая блокировка, SKIP LOCKED и короткие транзакции позволяют избежать и аномалий, и лишних ожиданий. Следующая тема отвечает на отложенный вопрос: как зафиксированная транзакция переживает сбой сервера.
Литература
- Berenson H., Bernstein P., Gray J., Melton J., O'Neil E., O'Neil P. A Critique of ANSI SQL Isolation Levels. — Proceedings of the 1995 ACM SIGMOD International Conference on Management of Data, 1995, С. 1–10, DOI: 10.1145/223784.223785.
- Cahill M. J., Röhm U., Fekete A. D. Serializable Isolation for Snapshot Databases. — Proceedings of the 2008 ACM SIGMOD International Conference on Management of Data, 2008, С. 729–738, DOI: 10.1145/1376616.1376690.
- Ports D. R. K., Grittner K. Serializable Snapshot Isolation in PostgreSQL. — Proceedings of the VLDB Endowment, 2012, Т. 5, № 12, С. 1850–1861, DOI: 10.14778/2367502.2367523.
- Gray J., Reuter A. Transaction Processing: Concepts and Techniques. — Morgan Kaufmann, 1993.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 13. Concurrency Control. — 2024. https://www.postgresql.org/docs/16/mvcc.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Section 25.1. Routine Vacuuming. — 2024. https://www.postgresql.org/docs/16/routine-vacuuming.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Appendix F. pageinspect — low-level inspection of database pages. — 2024. https://www.postgresql.org/docs/16/pageinspect.html
- Eswaran K. P., Gray J. N., Lorie R. A., Traiger I. L. The Notions of Consistency and Predicate Locks in a Database System. — Communications of the ACM, 1976, Т. 19, № 11, С. 624–633, DOI: 10.1145/360363.360369.
- Härder T., Reuter A. Principles of Transaction-Oriented Database Recovery. — ACM Computing Surveys, 1983, Т. 15, № 4, С. 287–317, DOI: 10.1145/289.291.
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019.
- Рогов Е. В. PostgreSQL 16 изнутри. — М.: ДМК Пресс, 2024. https://postgrespro.ru/education/books/internals
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017.
- Fekete A., Liarokapis D., O'Neil E., O'Neil P., Shasha D. Making Snapshot Isolation Serializable. — ACM Transactions on Database Systems, 2005, Т. 30, № 2, С. 492–528, DOI: 10.1145/1071610.1071615.