
Журнал, восстановление и резервное копирование
В теме 12 транзакция была описана через свойства ACID, и атомарность, согласованность и изоляция получили подробное объяснение. Четвёртое свойство, долговечность (англ. durability), было принято на веру: если сервер ответил на COMMIT успехом, изменения сохранятся, что бы ни случилось потом. Между тем данные таблиц живут в буферном кеше в оперативной памяти и попадают на диск с задержкой, а питание может пропасть в любую миллисекунду. Остаётся открытым вопрос: каким образом СУБД выполняет обещание долговечности, не записывая на диск каждую изменённую страницу в момент фиксации.
Ответ — журнал упреждающей записи (англ. Write-Ahead Log, WAL), центральный механизм любой промышленной СУБД. Журнал позволяет восстановить базу после сбоя сервера, а его архивирование даёт восстановление на произвольный момент времени и репликацию — копию базы на другом сервере, поддерживаемую проигрыванием того же журнала.
Изложение идёт от классификации отказов к журналу упреждающей записи, затем к восстановлению после сбоя (алгоритм ARIES и подход PostgreSQL), резервному копированию и, обзорно, репликации. Все эксперименты выполнены на PostgreSQL 16 в отдельном учебном кластере с параметром fsync = on (значения по умолчанию); сообщения сервера приведены на английском языке, как их выводит сервер с lc_messages = C.
Отказы и требования к долговечности
Классификация отказов
Механизмы восстановления принято классифицировать по тому, от какого отказа они защищают 76. Различают три класса.
Отказ транзакции (англ. transaction failure) — транзакция не может завершиться: нарушено ограничение, обнаружена взаимоблокировка, приложение выполнило ROLLBACK. Сервер работает, память и диски исправны; результаты транзакции должны исчезнуть так, как будто её не было. Этот случай разобран в теме 12.
Отказ системы (англ. system failure, crash) — потеря содержимого оперативной памяти: выключение питания, аварийное завершение сервера или операционной системы; диски сохраняются. После перезапуска база должна содержать результаты всех зафиксированных транзакций и не содержать результатов незафиксированных. От него защищает журнал (разделы 2–3).
Отказ носителя (англ. media failure) — потеря данных на диске: выход диска из строя, повреждение файловой системы, а также ошибки людей — удалённый каталог данных или ошибочный DELETE, который для СУБД является корректной зафиксированной транзакцией. Здесь нужны копии данных в другом месте — резервные копии и реплики (разделы 4–5).
Буферный кеш и почему изменения не пишутся сразу на диск
Данные таблиц и индексов хранятся в файлах страницами по 8 КиБ (тема 9). Чтобы прочитать или изменить строку, сервер загружает страницу в буферный кеш — область общей памяти (в PostgreSQL её размер задаёт параметр shared_buffers), изменяет её там и помечает буфер как «грязный» (англ. dirty). Записывает грязную страницу на диск позже другой процесс — фоновый процесс записи или процесс контрольной точки.
Почему бы не записывать страницы при каждой фиксации? Потому что это медленно и избыточно: транзакция, изменившая строки в десяти таблицах и пяти индексах, означала бы пятнадцать случайных записей по 8 КиБ, а страница, изменённая сто раз за секунду разными транзакциями, писалась бы сто раз. Кроме того, запись страницы не атомарна: страница 8 КиБ записывается на диск, атомарная единица записи которого — сектор 512 байт или 4 КиБ, и при отключении питания посреди записи на диске может оказаться «разорванная» страница (англ. torn page), половина которой новая, а половина старая.
Хердер и Ройтер ввели для политик буферного менеджера две пары терминов 6. Политика force требует при фиксации записать все изменённые транзакцией страницы, no-force — не требует. Политика steal разрешает записать на диск («украсть» буфер) страницу с изменениями ещё не зафиксированной транзакции, no-steal — запрещает. Сочетание no-steal и force делает восстановление тривиальным, но непригодно на практике: force медленна, а no-steal требует держать в памяти все страницы длинной транзакции. Практически все промышленные СУБД, включая PostgreSQL, используют сочетание steal и no-force, самое быстрое и самое трудное для восстановления. После сбоя на диске могут оказаться изменения незафиксированных транзакций (следствие steal) и могут отсутствовать изменения зафиксированных (следствие no-force). Исправить и то и другое позволяет журнал.
Целевые показатели: RPO и RTO
Требования к восстановлению в эксплуатации формулируют двумя числами. Целевая точка восстановления (англ. Recovery Point Objective, RPO) — какой объём последних изменений допустимо потерять при отказе, выраженный во времени: «не более 5 минут работы магазина». Целевое время восстановления (англ. Recovery Time Objective, RTO) — за какое время сервис должен снова заработать: «не более часа».
Эти два числа определяют выбор механизмов: еженощная логическая выгрузка даёт RPO до суток, архивирование журнала — минуты или секунды, синхронная реплика — ноль; переключение на горячую реплику сокращает RTO до секунд.
Журнал упреждающей записи
Принцип WAL и номер позиции в журнале
Журнал упреждающей записи — это файл (точнее, последовательность файлов), в который сервер дописывает записи о каждом изменении данных. Запись журнала (англ. WAL record) описывает изменение настолько, чтобы его можно было повторить: «на странице 25 файла 16598 в позицию 180 вставлена такая-то версия строки», «транзакция 819 зафиксирована». Журнал пишется строго последовательно, поэтому запись в него дешёвая — дописывание в конец, без поиска по диску.
Протокол WAL состоит из двух правил 17.
- Запись журнала, описывающая изменение страницы, должна попасть на диск раньше, чем сама изменённая страница. Отсюда название: журнал пишется «упреждающе».
- Транзакция считается зафиксированной, когда на диск записаны все записи журнала этой транзакции, включая запись о фиксации. Только после этого клиент получает ответ на
COMMIT.
Первое правило делает безопасной политику steal: если на диск попала страница с незафиксированным изменением, в журнале обязательно есть описание этого изменения, и при восстановлении известно, что с ним делать. Второе правило делает безопасной политику no-force: если страница зафиксированной транзакции не успела попасть на диск, её изменения можно повторить по журналу. Вместо случайной записи многих страниц при фиксации выполняется последовательная запись небольшого объёма журнала и одна операция fsync.
Каждая позиция в журнале имеет номер — LSN (англ. Log Sequence Number). В PostgreSQL LSN — это 64-битное смещение в байтах от начала журнала, которое печатается как две шестнадцатеричные половины через косую черту: 0/3119950. LSN только растёт, поэтому разность двух LSN равна объёму журнала, записанному между ними. В заголовке каждой страницы данных хранится LSN последней записи журнала, изменившей эту страницу (поле pd_lsn); буферный менеджер не записывает страницу на диск, пока журнал не сброшен по крайней мере до этого LSN, — так реализуется первое правило.
Журнал хранится в каталоге pg_wal кластера файлами-сегментами по 16 МиБ (размер задаётся при initdb). Имя сегмента — 24 шестнадцатеричные цифры: 8 цифр номера линии времени (англ. timeline, о ней — в разделе 4), затем старшие 32 бита LSN и номер сегмента внутри них:
SELECT pg_current_wal_lsn(), pg_walfile_name(pg_current_wal_lsn());
 pg_current_wal_lsn |     pg_walfile_name
--------------------+--------------------------
 0/3119950          | 000000010000000000000003
(1 row)
LSN 0/3119950 лежит в сегменте номер 3 (0x3119950 / 16 МиБ = 3) по смещению 0x119950 от его начала. Старые сегменты, ставшие ненужными для восстановления, сервер удаляет или переименовывает для повторного использования.
Сколько журнала порождает изменение
Объём журнала, порождаемого операцией, измеряется разностью LSN до и после неё. Повысим цену всех 119 книг рубрики «Программирование» (category_id = 12) на 10 рублей, а затем вернём её обратно; перед первым изменением выполним контрольную точку (её смысл объяснён ниже). Метакоманда \gset сохраняет результат запроса в переменной psql:
CHECKPOINT;
SELECT pg_current_wal_lsn() AS lsn0 \gset
UPDATE bookstore.book SET price = price + 10 WHERE category_id = 12;
SELECT pg_current_wal_lsn() AS lsn1 \gset
UPDATE bookstore.book SET price = price - 10 WHERE category_id = 12;
SELECT pg_current_wal_lsn() AS lsn2 \gset
SELECT pg_wal_lsn_diff(:'lsn1', :'lsn0') AS first_update,
       pg_wal_lsn_diff(:'lsn2', :'lsn1') AS second_update;
 first_update | second_update
--------------+---------------
       573984 |         61280
(1 row)
Два одинаковых по смыслу оператора, изменивших одни и те же 119 строк, породили 561 КиБ и 60 КиБ журнала — почти в десять раз меньше. Причину показывает утилита pg_waldump, которая читает файлы журнала и печатает их записи в текстовом виде 11. С ключом --stats=record она выдаёт сводку по типам записей в заданном диапазоне LSN (столбцы с процентами ниже опущены):
pg_waldump -p ~/pglab/main/pg_wal -s 0/3119950 -e 0/31A5B70 --stats=record
Type                          N    Record size    FPI size    Combined size
----                          -    -----------    --------    -------------
Transaction/COMMIT            1             34           0               34
Heap/UPDATE                 114          33529       19444            52973
Heap/HOT_UPDATE               2            144        8192             8336
Heap/LOCK                   117           6558      389196           395754
Heap/UPDATE+INIT              3           1018           0             1018
Btree/INSERT_LEAF           234          15694       97680           113374
                       --------       --------    --------         --------
Total                       471          56977      514512           571489
Собственно записи об изменениях заняли 57 КиБ, а 90 % объёма приходится на столбец FPI size — полные образы страниц (англ. Full Page Image, FPI), о которых речь пойдёт ниже. Таблица также показывает, из чего складывается обновление строки в PostgreSQL. Новая версия строки (тема 12) не поместилась на заполненную страницу, поэтому старая версия сначала помечается блокированной (Heap/LOCK), а новая записывается на другую страницу (Heap/UPDATE; UPDATE+INIT — на новую, только что инициализированную страницу). Раз версия переехала на другую страницу, в оба индекса таблицы — по первичному ключу и по isbn — добавляются ссылки на неё: 234 записи Btree/INSERT_LEAF (по две на строку). Лишь две строки удалось обновить на той же странице без изменения индексов (HOT_UPDATE, тема 10).
Отдельные записи можно увидеть, изменив одну строку остатков на складе (здесь показано второе из двух одинаковых обновлений):
UPDATE bookstore.stock SET quantity = quantity + 1
WHERE warehouse_id = 1 AND book_id = 1;
rmgr: Heap2  len (rec/tot): 57/57, tx: 0,   lsn: 0/031BA7D8, prev 0/031BA7B0, desc: PRUNE ... dead: [1] ... blkref #0: rel 1663/16384/16598 blk 0
rmgr: Heap   len (rec/tot): 71/71, tx: 818, lsn: 0/031BA818, prev 0/031BA7D8, desc: HOT_UPDATE old_xmax: 818, old_off: 180, ..., new_off: 181, blkref #0: rel 1663/16384/16598 blk 25
rmgr: Transaction len (rec/tot): 34/34, tx: 818, lsn: 0/031BA860, prev 0/031BA818, desc: COMMIT 2026-10-17 20:27:39.244612 MSK
Каждая строка — одна запись: менеджер ресурсов (англ. resource manager, rmgr), отвечающий за её применение, длина, номер транзакции, LSN записи и предыдущей записи, описание и ссылки на блоки (rel 1663/16384/16598 blk 25 — табличное пространство, база, файл, страница). Обновление строки заняло 71 байт, фиксация — 34 байта; перед ними внутристраничная очистка (PRUNE, тема 12) пометила мёртвой исходную версию на странице 0, которую первое обновление перенесло на страницу 25. Начиная с PostgreSQL 15 те же сведения можно получить запросом SQL с помощью расширения pg_walinspect.
Фиксация: fsync, групповая фиксация и synchronous_commit
Записи журнала сначала формируются в кольцевом буфере в общей памяти (wal_buffers), а на диск попадают тремя путями: при фиксации транзакции, когда буфер заполнен, и периодически — процессом записи журнала (англ. WAL writer) каждые wal_writer_delay = 200 мс. При фиксации обслуживающий процесс пишет буфер в файл и вызывает fsync (или аналог по параметру wal_sync_method), который возвращает управление, когда данные на энергонезависимом носителе. Схема на рисунке ниже показывает оба потока записи: последовательный поток журнала, ожидаемый при фиксации, и отложенный поток страниц данных.
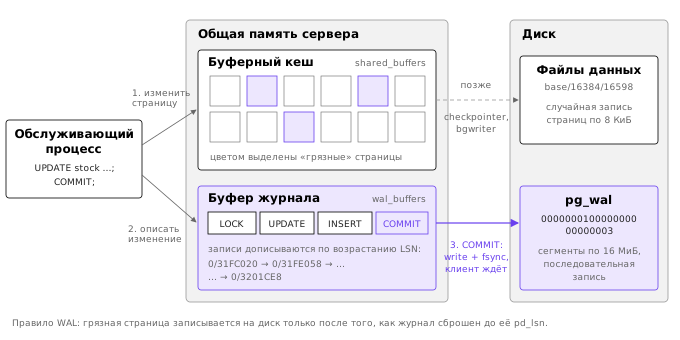
Время fsync — от десятков микросекунд на серверном SSD до десятков миллисекунд на жёстком или медленном виртуальном диске — ограничивает число фиксаций в секунду одного клиента. Два механизма ослабляют это ограничение.
Групповая фиксация (англ. group commit). Если несколько транзакций фиксируются почти одновременно, один вызов fsync сбрасывает записи их всех: процесс, пришедший к журналу вторым, обнаруживает, что его запись уже сброшена чужим fsync. Поэтому при многих параллельных клиентах суммарная пропускная способность растёт почти пропорционально числу клиентов, хотя задержка каждой фиксации остаётся прежней. Идея групповой фиксации описана ещё в классической монографии Грея и Ройтера 12. Параметры commit_delay и commit_siblings позволяют намеренно подождать попутчиков, но по умолчанию выключены 10.
Асинхронная фиксация. Параметр synchronous_commit задаёт, чего ждёт COMMIT. При значении on (по умолчанию) — сброса журнала на диск. При off сервер отвечает клиенту сразу после формирования записи о фиксации, а на диск её запишет процесс записи журнала. Согласованность не страдает — после сбоя база окажется в состоянии на момент чуть раньше сбоя, — но транзакции, о фиксации которых клиент уже знает, могут быть потеряны; окно риска не превышает трёх интервалов wal_writer_delay, то есть 600 мс 1. Параметр задают для отдельных транзакций: запись журнала посещений сайта не стоит ожидания fsync, а оплата заказа — стоит. Остальные значения (local, remote_write, remote_apply) относятся к репликации и описаны в разделе 5.
Порядок величин показывает опыт с утилитой нагрузочного тестирования pgbench: один клиент 10 секунд вставлял по строке в отдельной транзакции (pgbench -n -c 1 -T 10 -f ins.sql). При synchronous_commit = on получилось 9,5 транзакции в секунду, при off — 5877; восемь клиентов при on дали 57 транзакций в секунду — работает групповая фиксация. Машина имела медленный сброс на диск (pg_test_fsync показал десятки миллисекунд на вызов fdatasync), поэтому разница почти тысячекратная; на ноутбуке с SSD она обычно составляет один-два порядка. Вывод не зависит от величины: при синхронной фиксации пропускная способность одного клиента ограничена временем fsync, а не процессором. Отключать сам fsync (параметр fsync = off) допустимо только для данных, которые не жалко потерять целиком: после сбоя такой кластер может оказаться повреждённым, а не просто «отставшим».
Контрольные точки и полностраничные записи
Журнал позволяет повторить изменения, но с какого места? Если начинать с самого начала, журнал придётся хранить вечно, а восстановление будет длиться часами. Контрольная точка (англ. checkpoint) ограничивает этот путь: процесс контрольной точки (англ. checkpointer) записывает на диск все грязные страницы буферного кеша и сохраняет в управляющем файле global/pg_control позицию, с которой следует начинать восстановление, — точку повтора (англ. REDO point). Всё, что изменено до точки повтора, гарантированно находится в файлах данных; сегменты журнала до неё больше не нужны для восстановления после сбоя.
Контрольная точка «нечёткая» (англ. fuzzy): работа не останавливается. Запоминается точка повтора — текущий LSN, затем грязные страницы постепенно записываются параллельно с работой транзакций, и в конце в журнал добавляется запись CHECKPOINT, а в pg_control — её позиция. Страницы, изменённые после точки повтора, могут и не попасть на диск: их изменения есть в журнале.
Контрольная точка запускается по времени (checkpoint_timeout, по умолчанию 5 минут), по объёму журнала (max_wal_size, по умолчанию 1 ГиБ), командой CHECKPOINT и при остановке сервера; запись страниц растягивается на долю интервала checkpoint_completion_target (0,9) 10. Редкие контрольные точки уменьшают объём записи, но увеличивают время восстановления. Журнал сервера (log_checkpoints = on по умолчанию с PostgreSQL 15) сообщает о каждой контрольной точке:
LOG:  checkpoint starting: immediate force wait
LOG:  checkpoint complete: wrote 2421 buffers (14.8%); 0 WAL file(s) added, 0 removed,
      2 recycled; write=0.731 s, sync=5.300 s, total=6.833 s; ...;
      distance=28874 kB, estimate=28874 kB; lsn=0/31198D8, redo lsn=0/31198A0
Осталась проблема разорванных страниц: к наполовину записанной странице нельзя применить запись «в позицию 180 вставлена строка». Решение — полностраничные записи (full_page_writes, по умолчанию включён): при первом изменении страницы после контрольной точки в журнал включается её полный образ, и при восстановлении страница берётся из журнала, а не с диска. Именно эти образы — около 500 КиБ (образ бывает меньше 8 КиБ: пустое место в середине страницы не включается) — составили 90 % журнала в опыте выше: первое обновление после контрольной точки касалось каждой страницы впервые, второе образов уже не содержало. Поэтому частые контрольные точки увеличивают объём журнала, иногда в разы. Образы можно сжимать (wal_compression), их число показывает pg_stat_wal.wal_fpi.
Восстановление после сбоя
Алгоритм ARIES: анализ, повтор и отмена
Классический алгоритм восстановления для политики steal/no-force — ARIES (англ. Algorithm for Recovery and Isolation Exploiting Semantics), разработанный в IBM Моханом и соавторами и опубликованный в 1992 году 5. Его идеи используются в DB2, SQL Server и многих других СУБД и излагаются во всех учебниках 7. ARIES опирается на три принципа: упреждающую запись журнала, повтор истории при восстановлении (англ. repeating history) и журналирование изменений, выполняемых при отмене.
Восстановление в ARIES состоит из трёх проходов по журналу.
- Анализ (англ. analysis). Журнал читается от последней контрольной точки до конца, и восстанавливаются таблица активных транзакций (какие не успели зафиксироваться) и таблица грязных страниц (какие страницы могли не попасть на диск и с какого LSN их повторять).
- Повтор (англ. redo). Повторяются все изменения — и зафиксированных, и незафиксированных транзакций, — для которых LSN в заголовке страницы меньше LSN записи. Сравнение LSN делает повтор идемпотентным. После повтора база находится точно в состоянии момента сбоя — «история повторена».
- Отмена (англ. undo). Изменения незавершённых транзакций откатываются в обратном порядке, и каждое отменённое действие записывается в журнал компенсирующей записью (англ. Compensation Log Record, CLR) со ссылкой на следующую запись, подлежащую отмене. CLR повторяются, но никогда не отменяются, поэтому сбой во время восстановления не заставит отменять отменённое повторно.
Записи ARIES физиологические (англ. physiological): страница адресуется физически, а изменение внутри неё описывается логически («вставить запись с ключом K»). Вместе с повтором истории это позволяет отменять действия при блокировках отдельных записей и откатываться к точкам сохранения — отсюда «Fine-Granularity Locking and Partial Rollbacks» в названии статьи.
Восстановление в PostgreSQL: повтор без отмены
PostgreSQL реализует ту же идею повтора истории, но без фаз анализа и отмены в смысле ARIES. Это возможно благодаря многоверсионности (тема 12). Операция UPDATE или DELETE не перезаписывает строку на месте, а создаёт новую версию или помечает старую номером удалившей транзакции в поле xmax. Видна ли версия, решается по статусу транзакций xmin и xmax, который хранится в отдельной структуре — журнале статусов транзакций pg_xact (исторически CLOG, англ. commit log). Изменения прерванной транзакции не нужно «отменять» на страницах: если она не зафиксирована, её версии невидимы для всех.
Поэтому восстановление после сбоя в PostgreSQL сводится к одному проходу 18:
- из
pg_controlчитается позиция последней контрольной точки и её точка повтора; - записи журнала от точки повтора до конца повторяются по порядку; для записей с полным образом страница восстанавливается из образа, для остальных запись применяется, только если LSN страницы меньше LSN записи; повторяются и записи о фиксации, обновляющие
pg_xact; - конец журнала обнаруживается по первой некорректной записи (нулевая длина, неверная контрольная сумма CRC-32C — у каждой записи она есть);
- транзакции, не имеющие записи о фиксации, считаются прерванными; выполняется контрольная точка, и сервер начинает принимать подключения.
Схема на рисунке ниже показывает это на оси журнала. Транзакция T1 зафиксирована до сбоя — её запись COMMIT повторяется, и изменения становятся видимыми. Транзакция T2 не успела зафиксироваться — её изменения тоже повторяются на страницах, но остаются невидимыми.
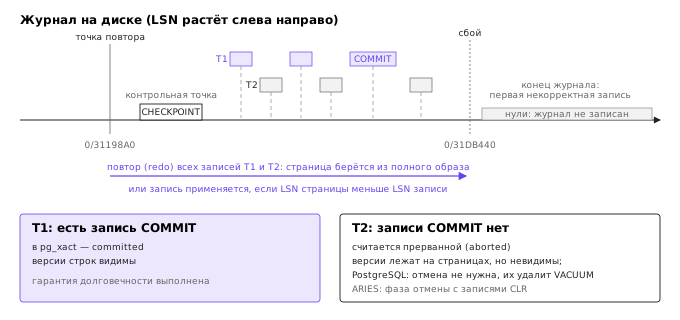
Цена подхода — мёртвые версии прерванных транзакций остаются в таблицах до очистки VACUUM. Выигрыш — простота и скорость: откат транзакции, изменившей миллион строк, мгновенен (меняются два бита в pg_xact), тогда как в СУБД с отменой на месте (Oracle, MySQL/InnoDB) он может длиться столько же, сколько сама транзакция.
Опыт: аварийная остановка
Вставим в таблицу три строки: первую — обычной транзакцией, вторую — в транзакции, которая не будет зафиксирована (отдельная сессия выполняет BEGIN; INSERT ...; и ждёт), третью — с synchronous_commit = off. Сразу после этого остановим сервер в режиме immediate: процессы завершаются немедленно, без контрольной точки и без записи грязных страниц — для базы это неотличимо от отключения питания (за исключением того, что операционная система успевает дописать уже переданные ей данные).
CREATE TABLE lab13.crash_test (id integer, note text);
INSERT INTO lab13.crash_test VALUES (1, 'зафиксирована, synchronous_commit = on');
-- в другой сессии: BEGIN; INSERT INTO lab13.crash_test VALUES (2, 'не зафиксирована'); ...
SET synchronous_commit = off;
INSERT INTO lab13.crash_test VALUES (3, 'зафиксирована, synchronous_commit = off');
pg_ctl -D ~/pglab/main stop -m immediate
pg_ctl -D ~/pglab/main -l ~/pglab/main.log start
Журнал сервера при запуске описывает восстановление:
LOG:  database system was interrupted; last known up at 2026-10-17 20:27:38 MSK
LOG:  database system was not properly shut down; automatic recovery in progress
LOG:  redo starts at 0/31198A0
LOG:  invalid record length at 0/31DB440: expected at least 24, got 0
LOG:  redo done at 0/31DB418 system usage: CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
LOG:  checkpoint starting: end-of-recovery immediate wait
LOG:  checkpoint complete: wrote 112 buffers (0.7%); ...
LOG:  database system is ready to accept connections
Повтор начался с точки повтора последней контрольной точки — 0/31198A0, той самой, что была выведена в сообщении о контрольной точке выше, — и закончился на первой записи с нулевой длиной: дальше журнал ещё не был записан. Минимальная длина 24 байта — размер заголовка записи журнала. Было повторено около 775 КиБ журнала, на что ушло меньше 0,01 с; затем выполнена контрольная точка конца восстановления.
TABLE lab13.crash_test;
 id |                  note
----+-----------------------------------------
  1 | зафиксирована, synchronous_commit = on
  3 | зафиксирована, synchronous_commit = off
(2 rows)
Строка 3 уцелела: запись о её фиксации успела попасть на диск до остановки (её сбрасывает процесс записи журнала не позже чем через несколько интервалов wal_writer_delay), но гарантии этого нет, и при неудачном моменте сбоя она была бы потеряна. Строки 2 нет, однако физически она в таблице есть — её вставка повторена по журналу. Это показывают расширение pageinspect (тема 9) и функция pg_xact_status:
SELECT lp, t_xmin, pg_xact_status(t_xmin::text::xid8) AS status
FROM heap_page_items(get_raw_page('lab13.crash_test', 0));
 lp | t_xmin |  status
----+--------+-----------
  1 |    821 | committed
  2 |    823 | aborted
  3 |    824 | committed
(3 rows)
Версия строки 2 лежит на странице, но создавшая её транзакция 823 считается прерванной, поэтому версия невидима. Отмены не потребовалось.
Положение последней контрольной точки и состояние кластера (in production, shut down, in crash recovery) показывает утилита pg_controldata, читающая файл pg_control без запуска сервера. Время восстановления после сбоя (RTO для отказа системы) пропорционально объёму журнала после последней контрольной точки: при max_wal_size = 1GB и интенсивной записи — минуты проигрывания.
Резервное копирование
Логическое копирование: pg_dump и pg_restore
Журнал защищает от отказа системы, но не от отказа носителя и не от ошибок людей: если удалён каталог данных или выполнен ошибочный DELETE, журнал на том же диске не поможет. Нужна копия данных в другом месте. Различают два вида резервного копирования: логическое — выгрузка содержимого базы в виде команд и данных, независимая от физического представления, — и физическое — копия файлов кластера 2.
Логическую копию одной базы создаёт утилита pg_dump 2. Она подключается к серверу как обычный клиент, открывает транзакцию уровня REPEATABLE READ и выгружает определения объектов и данные таблиц из одного снимка (тема 12), поэтому копия согласована, даже если база в это время изменяется. Работе других сеансов выгрузка не мешает, за одним исключением: на выгружаемые таблицы берутся блокировки ACCESS SHARE, поэтому ALTER TABLE или DROP TABLE будут ждать её окончания.
pg_dump поддерживает четыре формата (ключ -F), их сравнение приведено в таблице.
| Формат | Ключ | Что получается | Восстановление | Выборочное восстановление | Параллельность |
|---|---|---|---|---|---|
| простой (plain) | -Fp | SQL-скрипт | psql -f | только правкой текста | нет |
| специальный (custom) | -Fc | один сжатый файл с оглавлением | pg_restore | да | восстановление -j |
| каталог (directory) | -Fd | каталог: оглавление и сжатый файл на таблицу | pg_restore | да | выгрузка и восстановление -j |
| tar | -Ft | tar-архив каталога, без сжатия | pg_restore | да | нет |
Выгрузим учебную базу в трёх форматах:
pg_dump -d bookstore -Fp -f bookstore.sql
pg_dump -d bookstore -Fc -f bookstore.dump
pg_dump -d bookstore -Fd -j 4 -f bookstore.dir
ls -l bookstore.sql bookstore.dump; du -sh bookstore.dir
-rw-r--r-- 1 student student 5022156 Oct 16 13:37 bookstore.sql
-rw-r--r-- 1 student student 1460726 Oct 16 13:37 bookstore.dump
1.5M	bookstore.dir
База занимает на диске 19 МиБ, а её логическая копия — 4,8 МиБ в виде SQL и 1,4 МиБ в сжатом виде: выгрузка не содержит индексов (только команды их создания), свободного места на страницах и служебных полей версий строк. Обратная сторона — восстановление дольше выгрузки: индексы и ограничения при загрузке строятся заново, для большой базы это часы.
Выгрузка в специальном формате содержит оглавление (англ. table of contents, TOC), которое печатает pg_restore -l:
pg_restore -l bookstore.dump | grep review # 8 строк, показаны 6
236; 1259 16552 TABLE bookstore review student
235; 1259 16551 SEQUENCE bookstore review_review_id_seq student
3465; 0 16552 TABLE DATA bookstore review student
3479; 0 0 SEQUENCE SET bookstore review_review_id_seq student
3287; 2606 16559 CONSTRAINT bookstore review review_pkey student
3300; 2606 16562 FK CONSTRAINT bookstore review review_book_id_fkey student
Каждая строка — отдельный элемент: определение таблицы, её данные, значение последовательности, ограничения. pg_restore умеет восстанавливать базу целиком (pg_restore -d новая_база -j 4 bookstore.dump — в четыре параллельных потока), выбранные схемы (-n) и таблицы (-t), только определения (--schema-only) или только данные (--data-only), а также произвольный набор элементов по списку (-l записывает оглавление в файл, его можно отредактировать и передать ключом -L).
Выборочное восстановление требует аккуратности. Пусть по ошибке удалены отзывы с низкой оценкой: DELETE FROM bookstore.review WHERE rating <= 2 (1299 строк). Наивная попытка загрузить данные таблицы из копии в рабочую базу терпит неудачу:
pg_restore -d bookstore --data-only -t review bookstore.dump
pg_restore: error: COPY failed for table "review": ERROR:  duplicate key value violates unique constraint "review_pkey"
DETAIL:  Key (review_id)=(1) already exists.
CONTEXT:  COPY review, line 1
pg_restore: warning: errors ignored on restore: 1
Копия содержит все 13 744 отзыва, а в таблице остались 12 445 из них. Правильный путь — восстановить копию в отдельную базу и перенести только недостающие строки, например конвейером из двух команд \copy:
createdb bookstore_copy
pg_restore -d bookstore_copy -j 4 bookstore.dump
psql -d bookstore_copy -c "\copy (SELECT * FROM bookstore.review WHERE rating <= 2) TO STDOUT" \
  | psql -d bookstore -c "\copy bookstore.review FROM STDIN"
COPY 1299
Утилита pg_dump выгружает одну базу и не выгружает объекты уровня кластера — роли и табличные пространства. Их выгружает pg_dumpall --globals-only, а pg_dumpall без ключей выгружает весь кластер одним SQL-скриптом. Полная логическая копия кластера — это выгрузка глобальных объектов плюс pg_dump каждой базы. Логические копии переносимы между версиями PostgreSQL и архитектурами. Начиная с PostgreSQL 16.10 простой формат начинается с метакоманды \restrict — защиты от выполнения посторонних метакоманд psql, — поэтому такую выгрузку следует загружать клиентом psql той же или более новой версии.
Физическое копирование: pg_basebackup
Физическая копия — это копия файлов кластера. Просто скопировать каталог работающего сервера нельзя: файлы изменяются во время копирования, и страницы окажутся сняты в разные моменты. Однако журнал «склеивает» такую копию: если известна точка повтора контрольной точки, выполненной в начале копирования, и сохранён журнал за время копирования, его повтор приведёт копию в согласованное состояние, как при восстановлении после сбоя, а полностраничные записи исправят разорванные страницы.
Утилита pg_basebackup делает это автоматически 2. Она подключается к серверу по протоколу репликации, запрашивает контрольную точку (ключ -c fast — немедленную), копирует все файлы кластера и одновременно получает журнал (ключ -X stream, по умолчанию), а в конце записывает в копию файл backup_label с точкой начала восстановления и манифест backup_manifest с контрольными суммами файлов:
pg_basebackup -D ~/pglab/backup -c fast -X stream -P
cat ~/pglab/backup/backup_label
START WAL LOCATION: 0/4000028 (file 000000010000000000000004)
CHECKPOINT LOCATION: 0/4000060
BACKUP METHOD: streamed
BACKUP FROM: primary
START TIME: 2026-10-16 13:39:00 MSK
LABEL: pg_basebackup base backup
START TIMELINE: 1
Целостность копии по манифесту проверяет pg_verifybackup (выводит backup successfully verified). Чтобы подключиться по протоколу репликации, роль должна иметь атрибут REPLICATION, а файл pg_hba.conf — разрешать подключения к псевдобазе replication; кластер, созданный initdb, разрешает их локально.
Физическая копия восстанавливается быстро — это запуск сервера на скопированном каталоге, — но привязана к основной версии PostgreSQL, копирует кластер целиком (одну таблицу восстановить нельзя) и сама по себе даёт RPO, равное интервалу между копиями. Её сила проявляется в сочетании с архивом журнала.
Непрерывное архивирование и восстановление на момент времени
Если сохранять каждый заполненный сегмент журнала в архив, то базовая копия плюс архив журнала позволяют восстановить кластер на любой момент после окончания базовой копии: достаточно проиграть журнал до нужной точки и остановиться. Это называется непрерывным архивированием и восстановлением на момент времени (англ. Point-In-Time Recovery, PITR) 2. Именно так исправляются ошибки, которые журнал считает корректными транзакциями, — ошибочный DELETE или DROP TABLE.
Архивирование включается параметрами (изменение archive_mode требует перезапуска сервера):
wal_level = replica          # по умолчанию; minimal не годится для архива
archive_mode = on
archive_command = 'test ! -f /home/student/pglab/archive/%f && cp %p /home/student/pglab/archive/%f'
Сервер вызывает archive_command для каждого заполненного сегмента, подставляя вместо %p путь к файлу, а вместо %f — его имя, и считает сегмент заархивированным, только если команда вернула код 0; иначе повторяет попытку, не удаляя сегмент из pg_wal. Поэтому команда не должна возвращать 0 при неудаче и не должна перезаписывать существующий файл (test ! -f). Учебная команда cp не вызывает fsync и годится только для опытов; с PostgreSQL 15 вместо команды можно подключить модуль архивирования (archive_library). Поскольку архивируются только заполненные сегменты, при малой нагрузке последний сегмент может долго оставаться незаархивированным; параметр archive_timeout принудительно переключает сегмент через заданное время, а функция pg_switch_wal() — немедленно. Ход архивирования показывает представление pg_stat_archiver.
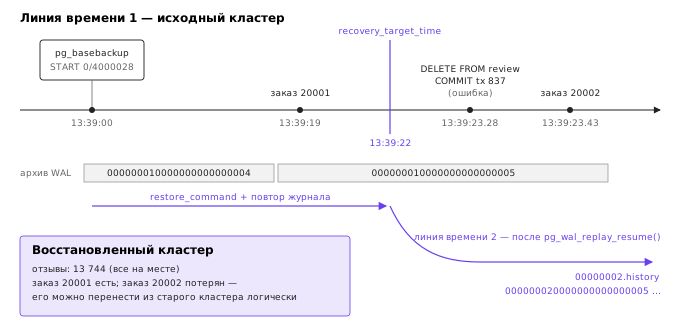
Разберём сценарий, изображённый на рисунке ниже. После базовой копии в магазине оформлен заказ 20001; через несколько секунд кто-то выполнил DELETE FROM bookstore.review без условия, удалив все 13 744 отзыва; затем был оформлен заказ 20002.
 order_id |          created_at
----------+-------------------------------
    20001 | 2026-10-16 13:39:19.216563+03
DELETE 13744
          delete_time          | txid_current
-------------------------------+--------------
 2026-10-16 13:39:23.273126+03 |          837
 order_id |          created_at
----------+-------------------------------
    20002 | 2026-10-16 13:39:23.425203+03
Точный момент ошибки можно найти в архиве той же утилитой pg_waldump, отыскав записи о фиксации:
pg_waldump -p ~/pglab/archive 000000010000000000000005 | grep COMMIT
rmgr: Transaction len (rec/tot): 34/34, tx: 837, lsn: 0/051AE398, ..., desc: COMMIT 2026-10-16 13:39:23.282438 MSK
rmgr: Transaction len (rec/tot): 34/34, tx: 838, lsn: 0/051AE4C0, ..., desc: COMMIT 2026-10-16 13:39:23.425584 MSK
Восстанавливать будем в новый каталог, оставив повреждённый кластер нетронутым, — это общее правило: никогда не уничтожать последнюю версию данных, пока восстановление не проверено. Копируем базовую копию, задаём в её конфигурации другой порт, команду извлечения сегментов из архива и цель восстановления, создаём файл-сигнал recovery.signal и запускаем сервер:
cp -a ~/pglab/backup ~/pglab/pitr
cat >> ~/pglab/pitr/postgresql.conf <<'EOF'
port = 5434
archive_mode = off
restore_command = 'cp /home/student/pglab/archive/%f %p'
recovery_target_time = '2026-10-16 13:39:22+03'
EOF
touch ~/pglab/pitr/recovery.signal
pg_ctl -D ~/pglab/pitr -l ~/pglab/pitr.log start
LOG:  starting point-in-time recovery to 2026-10-16 13:39:22+03
LOG:  starting backup recovery with redo LSN 0/4000028, checkpoint LSN 0/4000060, on timeline ID 1
LOG:  restored log file "000000010000000000000004" from archive
LOG:  redo starts at 0/4000028
LOG:  restored log file "000000010000000000000005" from archive
LOG:  consistent recovery state reached at 0/4000100
LOG:  database system is ready to accept read-only connections
LOG:  recovery stopping before commit of transaction 837, time 2026-10-16 13:39:23.282438+03
LOG:  pausing at the end of recovery
HINT:  Execute pg_wal_replay_resume() to promote.
Файл recovery.signal (с PostgreSQL 12 он заменил прежний recovery.conf) сообщает серверу, что нужно не просто восстановиться после сбоя, а выполнить восстановление из архива: извлекать сегменты командой restore_command и проигрывать их до цели. Обратим внимание на строку recovery stopping before commit of transaction 837: цель по времени проверяется только на записях о фиксации и прерывании транзакций. Транзакция 837 зафиксирована в 13:39:23,28, позже цели, поэтому её фиксация не применяется и её изменения невидимы, хотя записи об удалении строк уже проиграны: решает время записи COMMIT, а не время выполнения DELETE.
По умолчанию (recovery_target_action = 'pause') сервер останавливается на цели в режиме только для чтения, чтобы администратор проверил результат:
SELECT count(*) FROM bookstore.review;
SELECT order_id, customer_id, created_at FROM bookstore.orders WHERE order_id > 20000;
 count
-------
 13744
(1 row)

 order_id | customer_id |          created_at
----------+-------------+-------------------------------
    20001 |          42 | 2026-10-16 13:39:19.216563+03
(1 row)
Отзывы на месте, заказ 20001, оформленный до ошибки, тоже; заказа 20002, оформленного после ошибки, нет — это и есть плата за PITR. Если цель выбрана неудачно, сервер можно остановить, изменить recovery_target_time и запустить снова (вперёд по журналу; назад — только начав заново с базовой копии). Если результат верен, функция pg_wal_replay_resume() завершает восстановление:
LOG:  redo done at 0/51AE398 ...
LOG:  last completed transaction was at log time 2026-10-16 13:39:19.219762+03
LOG:  selected new timeline ID: 2
LOG:  archive recovery complete
LOG:  database system is ready to accept connections
Сервер начинает новую линию времени (англ. timeline) с номером 2: новые сегменты журнала получают имена 00000002..., а в файл 00000002.history записывается точка ветвления — 1 0/51AE398 before 2026-10-16 13:39:23.282438+03. Линии времени не дают перепутать в архиве журнал «старой» истории, где отзывы удалены, с журналом новой. Кроме времени, целью могут быть номер транзакции (recovery_target_xid), LSN (recovery_target_lsn), именованная точка, созданная заранее функцией pg_create_restore_point() (recovery_target_name), или момент достижения согласованности (recovery_target = 'immediate').
Заказ 20002 можно перенести логически из нетронутого старого кластера. RPO схемы «базовая копия плюс архив журнала» — один незаархивированный сегмент или archive_timeout; RTO — время копирования базовой копии плюс время проигрывания журнала от неё, поэтому базовые копии делают регулярно (ежедневно или еженедельно), а старые копии и сегменты архива удаляют по политике хранения. PostgreSQL 17 добавил инкрементные базовые копии (pg_basebackup --incremental и pg_combinebackup), сокращающие объём регулярных копий.
Стратегия резервного копирования и проверка копий
Резервная копия, из которой никогда не пробовали восстановиться, — это не резервная копия, а надежда. Типичные причины бесполезности копии: команда архивирования давно завершается с ошибкой, которую никто не видел; копия лежит на том же диске, что и сервер; в выгрузку не попали роли; нужный сегмент журнала удалён. Поэтому стратегия включает регулярное пробное восстановление с проверкой содержимого и мониторинг (pg_stat_archiver.failed_count, возраст последней копии).
Эмпирическое правило 3-2-1 требует не менее трёх копий данных (рабочие и две резервные) на двух разных типах носителей, причём одна копия — вне площадки. Логические и физические копии дополняют друг друга: физические с архивом журнала дают малые RPO и RTO, логические переносимы, позволяют восстановить отдельную таблицу и попутно проверяют, что все данные читаются. Сводка механизмов приведена в таблице.
| Механизм | От чего защищает | RPO | RTO |
|---|---|---|---|
| журнал и восстановление после сбоя | отказ системы | 0 (synchronous_commit = on) | время повтора журнала от контрольной точки |
pg_dump по расписанию | носитель, ошибки, перенос между версиями | интервал между выгрузками | время загрузки и построения индексов |
pg_basebackup и архив журнала | носитель, ошибки (PITR) | сегмент или archive_timeout | копирование и повтор журнала |
| асинхронная реплика | носитель, отказ сервера | отставание реплики (обычно доли секунды) | секунды или минуты на переключение |
| синхронная реплика | то же | 0 | то же |
Две последние строки таблицы показывают, что реплика защищает от отказа оборудования, но не от ошибок: ошибочный DELETE реплицируется за доли секунды. Реплика не заменяет резервную копию.
Репликация
Потоковая физическая репликация и горячий резерв
Сервер, способный проиграть журнал из архива, может проигрывать и журнал, поступающий от работающего сервера в реальном времени. Это физическая потоковая репликация (англ. streaming replication) 3. Основной сервер (англ. primary) запускает для каждой реплики процесс-отправитель журнала (англ. WAL sender), а реплика (англ. standby) — процесс-получатель (англ. WAL receiver), записывающий журнал в свой pg_wal, и процесс восстановления (англ. startup process), непрерывно его проигрывающий. Реплика — побайтная копия основного сервера. Режим горячего резерва (англ. hot standby, параметр hot_standby, по умолчанию включён) разрешает выполнять на реплике запросы только на чтение. Устройство показано на рисунке ниже.
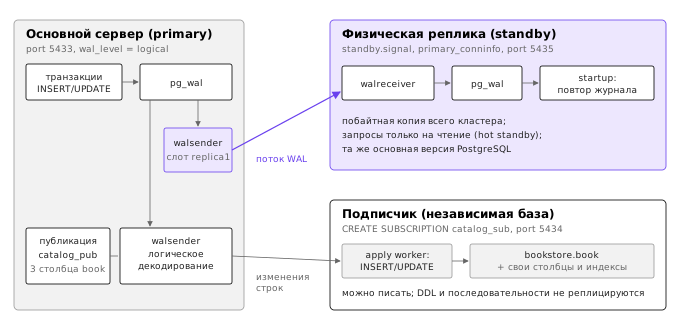
Реплику создают из базовой копии. Ключ -R утилиты pg_basebackup записывает в копию параметры подключения к основному серверу и файл-сигнал standby.signal, а ключи -C -S replica1 создают слот репликации (англ. replication slot) — объект на основном сервере, запоминающий, до какой позиции реплика получила журнал:
pg_basebackup -D ~/pglab/replica -c fast -X stream -R -C -S replica1
echo "port = 5435" >> ~/pglab/replica/postgresql.conf
pg_ctl -D ~/pglab/replica -l ~/pglab/replica.log start
В файл postgresql.auto.conf реплики записываются параметры primary_conninfo (строка подключения к основному серверу) и primary_slot_name = 'replica1'. Файл standby.signal отличается от recovery.signal тем, что восстановление никогда не заканчивается: дойдя до конца доступного журнала, сервер ждёт новых записей. Журнал реплики сообщает: started streaming WAL from primary at 0/8000000 on timeline 1. На основном сервере состояние реплик показывает представление pg_stat_replication:
SELECT application_name, state, sent_lsn, replay_lsn, replay_lag, sync_state
FROM pg_stat_replication;
-[ RECORD 1 ]----+----------------
application_name | walreceiver
state            | streaming
sent_lsn         | 0/8000060
replay_lsn       | 0/8000060
replay_lag       | 00:00:00.216532
sync_state       | async
Столбцы sent_lsn, write_lsn, flush_lsn, replay_lsn отражают этапы движения журнала: отправлен, записан репликой, сброшен ею на диск, проигран. Отставание в байтах вычисляется как pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn), отставание во времени показывают столбцы *_lag. Попытка изменить данные на реплике завершается ошибкой cannot execute INSERT in a read-only transaction.
Слот репликации гарантирует, что основной сервер не удалит сегменты журнала, ещё не полученные репликой, даже если она долго недоступна. У этой гарантии есть оборотная сторона: забытый слот отключённой реплики удерживает журнал бесконечно, и pg_wal растёт до заполнения диска, после чего основной сервер останавливается. Защита — мониторинг pg_replication_slots и ограничение max_slot_wal_keep_size. Долгие запросы на реплике могут конфликтовать с проигрыванием очистки, выполненной на основном сервере; тогда проигрывание ждёт не дольше max_standby_streaming_delay (30 с), после чего запрос отменяется.
Синхронная и асинхронная репликация
По умолчанию репликация асинхронная: основной сервер подтверждает фиксацию, как только запись о ней сброшена на его собственный диск, не дожидаясь реплики. Если основной сервер выйдет из строя, последние транзакции, не успевшие дойти до реплики, будут потеряны при переключении. RPO равно отставанию реплики. Этот компромисс между задержкой и надёжностью присущ любой репликации с выделенным ведущим узлом, не только PostgreSQL 9.
Синхронная репликация устраняет эту потерю: основной сервер ждёт подтверждения от реплики, перечисленной в параметре synchronous_standby_names. Насколько далеко должна продвинуться запись на реплике, задаёт уже знакомый synchronous_commit 10:
| Значение | COMMIT ждёт | Что гарантировано при отказе основного сервера |
|---|---|---|
off | ничего | возможна потеря последних транзакций даже на основном сервере |
local | сброса на локальный диск | транзакция не потеряна при сбое основного сервера, но может отсутствовать на реплике |
remote_write | записи журнала репликой в файл (без fsync) | переживёт сбой процесса PostgreSQL на реплике, но не её операционной системы |
on | сброса журнала на диск реплики | транзакция есть на диске реплики |
remote_apply | проигрывания записи на реплике | транзакция видна запросам на реплике |
Цена синхронной репликации — задержка каждой фиксации на время сетевого обмена и, что важнее, зависимость доступности основного сервера от реплики. Проверим это: добавим в primary_conninfo реплики параметр application_name=replica1, назначим её синхронной (ALTER SYSTEM SET synchronous_standby_names = 'replica1' и SELECT pg_reload_conf()), после чего pg_stat_replication покажет sync_state = sync. Пока реплика работает, вставка выполняется как обычно. После остановки реплики COMMIT повисает; прерванный через 5 секунд клавишами Ctrl+C, он выводит:
Cancel request sent
WARNING:  canceling wait for synchronous replication due to user request
DETAIL:  The transaction has already committed locally, but might not have been replicated to the standby.
INSERT 0 1
Предупреждение точно описывает ситуацию: транзакция уже зафиксирована на основном сервере (запись COMMIT в его журнале), и отменить её нельзя; не выполнено лишь ожидание реплики. Поэтому в эксплуатации одну синхронную реплику не используют: задают кворум из нескольких, например ANY 1 (replica1, replica2) — дождаться любой одной из двух.
Логическая репликация
Физическая реплика копирует кластер целиком, доступна только для чтения и требует той же версии PostgreSQL. Логическая репликация снимает эти ограничения 4. При wal_level = logical журнал содержит достаточно сведений, чтобы логическое декодирование (англ. logical decoding) восстановило из него изменения строк («у строки с ключом 9 изменена цена»); они передаются подписчику и применяются как обычные INSERT, UPDATE, DELETE.
На источнике создаётся публикация (англ. publication) — набор таблиц, с PostgreSQL 15 — с перечнем столбцов и условием отбора строк; на получателе — подписка (англ. subscription). Опубликуем для витрины магазина на другом сервере идентификатор, название и цену книг:
-- на источнике (wal_level = logical; изменение требует перезапуска)
CREATE PUBLICATION catalog_pub FOR TABLE bookstore.book (book_id, title, price);
-- на получателе: таблица создаётся вручную, DDL не реплицируется
CREATE SCHEMA bookstore;
CREATE TABLE bookstore.book (
    book_id         integer PRIMARY KEY,
    title           text NOT NULL,
    price           numeric(10, 2) NOT NULL,
    updated_locally timestamptz DEFAULT now()
);
CREATE SUBSCRIPTION catalog_sub
    CONNECTION 'host=/tmp port=5433 dbname=bookstore'
    PUBLICATION catalog_pub;
NOTICE:  created replication slot "catalog_sub" on publisher
CREATE SUBSCRIPTION
Подписка сначала копирует текущее содержимое таблицы (2010 строк), а затем применяет поток изменений: после UPDATE bookstore.book SET price = 199.00 WHERE book_id = 9 на источнике через доли секунды та же цена видна на получателе. В отличие от физической реплики получатель — самостоятельная база: у таблицы свой столбец updated_locally, в неё можно писать, на ней можно строить свои индексы. Ограничения логической репликации в PostgreSQL 16: не реплицируются изменения схемы (DDL), значения последовательностей и большие объекты; для репликации UPDATE и DELETE у таблицы должен быть идентификатор реплики (по умолчанию первичный ключ); конфликт — например, вставка строки с ключом, уже существующим у получателя, — останавливает применение изменений до вмешательства администратора 4. Применения — передача части данных в другую систему, консолидация баз, обновление версии с минимальным простоем.
Переключение при отказе и инструменты
Повышение реплики до основного сервера (англ. promotion) выполняется командой pg_ctl promote или функцией pg_promote(): сервер завершает восстановление, выбирает новую линию времени и принимает запись. Трудность — в решении, когда его выполнять. Если основной сервер не упал, а лишь временно недоступен по сети, после повышения реплики окажется два сервера, принимающих запись, и их данные разойдутся — ситуация «разделённого мозга» (англ. split brain) 9. Бывший основной сервер после этого нельзя просто подключить репликой к новому: его журнал ушёл вперёд по старой линии времени. Его пересоздают из новой базовой копии или «перематывают» утилитой pg_rewind, которая копирует только изменившиеся блоки 3.
Автоматическое переключение без разделённого мозга требует согласованного решения узлов о том, кто сейчас основной, — задачи консенсуса (тема 16). Для PostgreSQL её обычно решает Patroni: агент на каждом узле управляет сервером, а сведения о лидере хранит в распределённом хранилище (etcd, Consul, ZooKeeper). Резервное копирование в эксплуатации выполняют pgBackRest, Barman или WAL-G — с параллельными и инкрементными копиями, сжатием, шифрованием и политикой хранения.
Итоги темы
Долговечность транзакций обеспечивается не немедленной записью изменённых страниц, а журналом упреждающей записи. Буферный менеджер следует быстрой политике steal/no-force, а протокол WAL делает её безопасной: запись журнала попадает на диск раньше страницы, а транзакция зафиксирована, когда на диск сброшена её запись COMMIT. Цена фиксации — одна последовательная запись и fsync, разделяемый групповой фиксацией; synchronous_commit = off меняет небольшое окно возможной потери последних транзакций на многократный рост скорости.
Восстановление после сбоя повторяет журнал с точки повтора последней контрольной точки. Контрольные точки ограничивают время восстановления, а полностраничные записи защищают от разорванных страниц ценой роста журнала. Алгоритм ARIES повторяет историю и затем отменяет незавершённые транзакции с компенсирующими записями; PostgreSQL благодаря многоверсионности обходится без отмены — изменения незафиксированных транзакций остаются на страницах, но невидимы.
От отказа носителя и ошибок людей защищают только копии в другом месте. Логическая выгрузка pg_dump переносима и позволяет восстанавливать отдельные объекты; физическая копия pg_basebackup с архивом журнала позволяет восстановить кластер на любой момент — например, на мгновение перед ошибочным DELETE. Стратегия формулируется через RPO и RTO и обязательно включает пробное восстановление.
Тот же журнал, передаваемый по сети, даёт физическую потоковую репликацию — синхронную или асинхронную, а его логическое декодирование — репликацию отдельных таблиц между независимыми базами. Реплика защищает от отказа оборудования, но не от ошибок, и не заменяет резервную копию. Следующая тема переходит к программированию на стороне сервера — функциям, процедурам и триггерам; распределённые системы рассматриваются в теме 16.
Литература
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 30. Reliability and the Write-Ahead Log. — 2024. https://www.postgresql.org/docs/16/wal.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 26. Backup and Restore. — 2024. https://www.postgresql.org/docs/16/backup.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 27. High Availability, Load Balancing, and Replication. — 2024. https://www.postgresql.org/docs/16/high-availability.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 31. Logical Replication. — 2024. https://www.postgresql.org/docs/16/logical-replication.html
- Mohan C., Haderle D., Lindsay B., Pirahesh H., Schwarz P. ARIES: A Transaction Recovery Method Supporting Fine-Granularity Locking and Partial Rollbacks Using Write-Ahead Logging. — ACM Transactions on Database Systems, 1992, Т. 17, № 1, С. 94–162, DOI: 10.1145/128765.128770.
- Haerder T., Reuter A. Principles of Transaction-Oriented Database Recovery. — ACM Computing Surveys, 1983, Т. 15, № 4, С. 287–317, DOI: 10.1145/289.291.
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019. Chapter 19. Recovery System.
- Рогов Е. В. PostgreSQL 16 изнутри. — М.: ДМК Пресс, 2024. Часть II. Буферный кеш и журнал. https://postgrespro.ru/education/books/internals
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017. Chapter 5. Replication.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 20.5. Write Ahead Log; 20.6. Replication. — 2024. https://www.postgresql.org/docs/16/runtime-config-wal.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. pg_waldump. — 2024. https://www.postgresql.org/docs/16/pgwaldump.html
- Gray J., Reuter A. Transaction Processing: Concepts and Techniques. — Morgan Kaufmann, 1993.