
Программирование на стороне сервера: функции, процедуры, триггеры
До сих пор сервер базы данных выступал исполнителем отдельных операторов SQL: клиент присылал запрос, сервер выполнял его и возвращал результат. Вся логика — какие проверки выполнить перед оформлением заказа, что записать в журнал изменений, как пересчитать сводные данные — оставалась на стороне клиента. Между тем у сервера есть собственные языки программирования, и значительную часть логики можно выполнить рядом с данными: в виде функций, процедур и триггеров, которые хранятся в базе так же, как таблицы и представления.
Хранимые процедуры описаны в части стандарта SQL/PSM (англ. Persistent Stored Modules), триггеры вошли в SQL:1999 11; реализации различаются — PL/SQL в Oracle, Transact-SQL в SQL Server, PL/pgSQL в PostgreSQL, — а идеи общие 912.
Сначала обсуждается, когда логику стоит переносить в базу, и вводятся функции на SQL. Затем рассматривается язык PL/pgSQL, включая исключения и динамический SQL, далее — свойства функций, влияющие на оптимизатор и безопасность, процедуры с управлением транзакциями, триггеры и, в завершение, событийные триггеры, уведомления LISTEN/NOTIFY и другие языки. Примеры выполнены на PostgreSQL 16 на учебной базе «Книжный узел»; собственные объекты примеров создаются в схеме srv. Работа с базой из программ, роли и права доступа рассматриваются в теме 15.
Логика в базе данных и функции на SQL
Зачем выполнять код на сервере и когда этого не делать
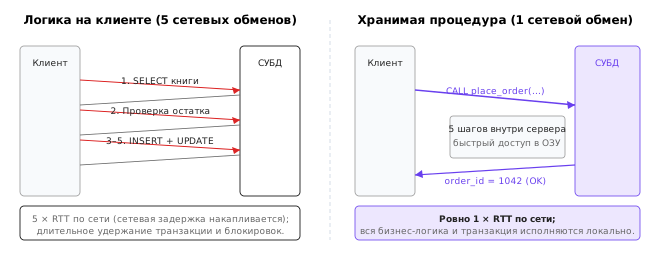
Перенос логики на сервер даёт три выигрыша. Первый — меньше обменов по сети. Оформление заказа — это чтение остатков, вставка заказа и позиций, списание остатков; если каждый шаг — отдельный запрос, приложение ждёт ответа сервера столько раз, сколько шагов (стоимость обмена обсуждается в теме 15), а процедура выполняет все шаги за один обмен, как показано на рисунке ниже. Второй — правила, общие для всех клиентов: если остатки списываются триггером, ни веб-приложение, ни скрипт загрузки, ни администратор в psql не смогут «забыть» это сделать. Третий — близость к данным: функция, обрабатывающая миллион строк, не передаёт их по сети.
Цена переноса — код в базе труднее тестировать и версионировать, а его изменение становится изменением схемы, согласуемым с миграциями (тема 15). Сервер базы данных сложнее масштабировать, чем серверы приложений, поэтому вычисления, не связанные с данными, и обращения к внешним сервисам разумнее выполнять в приложении. Наконец, логика в триггерах «невидима»: разработчик, выполняющий UPDATE, может не знать, что вместе с ним изменяются ещё три таблицы. Практическое правило: в базу переносят то, что относится к целостности данных и должно выполняться всегда (сложные ограничения, аудит, согласованность производных данных), и то, что выигрывает от близости к данным (массовая обработка, многошаговые операции); часто меняющиеся бизнес-правила обычно остаются в приложении.
Функции на языке SQL
Простейшая функция пишется на самом SQL. Она состоит из заголовка — имени, параметров, типа результата — и тела, записанного строковой константой, обычно в «долларовых» кавычках $$ ... $$, чтобы внутри не удваивать апострофы 4:
CREATE SCHEMA srv;

CREATE FUNCTION srv.order_total(p_order_id integer)
RETURNS numeric
LANGUAGE sql
STABLE
AS $$
    SELECT coalesce(sum(quantity * price), 0)
    FROM bookstore.order_item
    WHERE order_id = p_order_id
$$;

SELECT order_id, status, srv.order_total(order_id) AS total
FROM bookstore.orders
WHERE order_id BETWEEN 1 AND 3;
 order_id |  status   |  total
----------+-----------+---------
        1 | delivered | 5529.97
        2 | delivered | 9259.95
        3 | delivered | 3369.97
(3 rows)
Функция на SQL возвращает результат последнего оператора тела; слово STABLE — категория изменчивости (третий раздел). Префикс p_ у параметра — соглашение, отличающее параметры от столбцов: при параметре order_id условие WHERE order_id = order_id было бы неоднозначным. Функция может возвращать и множество строк — RETURNS SETOF тип или RETURNS TABLE (столбцы); такую табличную функцию (англ. set-returning function) используют во FROM, как таблицу (пример — функция srv.customers_by_city в третьем разделе). Параметры могут иметь значения по умолчанию и передаваться по имени (имя => значение). С PostgreSQL 14 тело функции на SQL можно записать в стиле стандарта — RETURN выражение или BEGIN ATOMIC ... END; такое тело разбирается при создании, и сервер запоминает зависимости от таблиц и функций 4:
CREATE FUNCTION srv.with_vat(p_price numeric, p_rate numeric DEFAULT 0.2)
RETURNS numeric
LANGUAGE sql
IMMUTABLE
RETURN round(p_price * (1 + p_rate), 2);

EXPLAIN (COSTS OFF)
SELECT title FROM bookstore.book WHERE srv.with_vat(price) > 5000;
                      QUERY PLAN
-------------------------------------------------------
 Seq Scan on book
   Filter: (round((price * 1.2), 2) > '5000'::numeric)
(2 rows)
Функцию можно вызвать как srv.with_vat(1290) (результат 1548.00) или srv.with_vat(p_rate => 0.1, p_price => 1290) (1419.00). План показывает важное свойство простых функций на SQL: планировщик подставляет (англ. inline) их тело в запрос, как макрос, — функции в плане нет, есть её выражение. Подстановка возможна, если тело — одно выражение или один SELECT без побочных эффектов и у функции нет мешающих атрибутов (например, SECURITY DEFINER) 2. Подставленная функция ничего не стоит, а оптимизатор видит её содержимое и может, например, использовать индекс. Функции на процедурных языках не подставляются никогда: для планировщика это «чёрный ящик».
Функции хранятся в каталоге pg_proc (\df srv.* перечисляет их, \sf имя печатает текст); допускается перегрузка (англ. overloading) — функции с одним именем и разными типами параметров.
Язык PL/pgSQL
Блоки, переменные и управляющие конструкции
SQL декларативен: в нём нет переменных, условных операторов и циклов. Когда логика требует последовательности шагов с проверками, используют процедурный язык. PL/pgSQL (англ. Procedural Language/PostgreSQL) установлен в каждой базе по умолчанию; по синтаксису он восходит к Ada и близок к PL/SQL СУБД Oracle 1. Тело функции — блок из необязательного раздела объявлений DECLARE, раздела операторов BEGIN ... END и необязательного раздела обработки исключений EXCEPTION; блоки могут быть вложенными. Функция ниже относит покупателя к сегменту по сумме покупок:
CREATE FUNCTION srv.customer_segment(p_customer_id integer)
RETURNS text
LANGUAGE plpgsql
STABLE
AS $$
DECLARE
    v_name   bookstore.customer.full_name%TYPE;
    v_spent  numeric;
BEGIN
    SELECT full_name INTO STRICT v_name
    FROM bookstore.customer
    WHERE customer_id = p_customer_id;

    SELECT coalesce(sum(oi.quantity * oi.price), 0) INTO v_spent
    FROM bookstore.orders o
    JOIN bookstore.order_item oi USING (order_id)
    WHERE o.customer_id = p_customer_id AND o.status <> 'cancelled';

    IF v_spent >= 150000 THEN
        RETURN v_name || ': постоянный (' || v_spent || ' руб.)';
    ELSIF v_spent > 0 THEN
        RETURN v_name || ': обычный (' || v_spent || ' руб.)';
    ELSE
        RETURN v_name || ': без покупок';
    END IF;
EXCEPTION
    WHEN no_data_found THEN
        RAISE EXCEPTION 'покупатель % не найден', p_customer_id
            USING ERRCODE = 'P0002', HINT = 'проверьте идентификатор';
END;
$$;

SELECT c, srv.customer_segment(c) FROM unnest(ARRAY[1, 42, 464]) AS c;
SELECT srv.customer_segment(100000);
  c  |             customer_segment
-----+------------------------------------------
   1 | Анна Фролов: постоянный (632586.36 руб.)
  42 | Иван Тихонов: обычный (120209.33 руб.)
 464 | ...
(3 rows)

ERROR:  покупатель 100000 не найден
HINT:  проверьте идентификатор
CONTEXT:  PL/pgSQL function srv.customer_segment(integer) line 23 at RAISE
Разберём конструкции.
- Переменная объявляется с типом;
%TYPEозначает «тот же тип, что у столбца»,%ROWTYPE— тип строки таблицы; без начального значения переменная равна NULL. SELECT ... INTO переменныезаписывает в переменные первую строку результата; если строк нет, переменные получают NULL, если их несколько — молча берётся первая. СловоSTRICTтребует ровно одной строки: иначе возникает исключениеno_data_foundилиtoo_many_rows. ПослеSELECT INTO,INSERT,UPDATE,DELETEпеременнаяFOUNDпоказывает, была ли затронута хотя бы одна строка.IF ... ELSIF ... ELSE ... END IFиCASEустроены как в обычных языках; условие, равное NULL, трактуется как ложь (трёхзначная логика, тема 3).- Циклы:
LOOP ... END LOOPс выходомEXIT WHEN условие,WHILE условие LOOP,FOR i IN 1..10 LOOP,FOR запись IN запрос LOOP(перебор строк результата),FOREACH x IN ARRAY массив LOOP.
Функция, возвращающая множество строк, формирует результат постепенно: RETURN NEXT добавляет текущие значения выходных параметров, RETURN QUERY запрос — все строки запроса. Результат накапливается в памяти и отдаётся после завершения функции, поэтому LIMIT во внешнем запросе не сокращает её работу. Цикл по строкам на процедурном языке оправдан, когда шаги действительно зависят друг от друга; задачу «рост выручки к предыдущему месяцу» один запрос с оконной функцией lag (тема 5) решит быстрее любого цикла. Код на PL/pgSQL можно выполнить и однократно, без создания функции, — анонимным блоком DO $$ ... $$.
Как PL/pgSQL выполняет запросы
Интерпретатор PL/pgSQL сам не вычисляет ни запросов, ни выражений: каждое выражение и каждый оператор SQL передаются исполнителю SQL. При первом выполнении в сеансе оператор готовится как подготовленный оператор (англ. prepared statement): переменные PL/pgSQL заменяются параметрами $1, $2, а план затем используется повторно (после пяти выполнений возможен переход к общему плану, тема 11) 1. Поэтому переменная в запросе — всегда значение, а не часть текста: вместо неё нельзя «подставить» имя столбца или условие — для этого служит динамический SQL.
Второе следствие касается видимости данных. Функция VOLATILE получает новый снимок данных (тема 12) для каждого своего оператора, как операторы транзакции на уровне Read Committed, и видит изменения, зафиксированные параллельными транзакциями; функции STABLE и IMMUTABLE используют снимок вызвавшего их запроса 2. Различие существенно для триггеров, проверяющих ограничения (пример ниже).
Ошибки и исключения
Оператор RAISE выдаёт сообщение с уровнем важности: DEBUG, LOG, INFO, NOTICE, WARNING — просто сообщения; EXCEPTION (по умолчанию) — ошибка, прерывающая выполнение. Символ % в строке формата заменяется очередным аргументом, а предложение USING задаёт код ошибки ERRCODE и поля DETAIL, HINT, которые клиент получает отдельно от текста и может обработать программно (в psycopg — через e.diag, тема 15). Код ошибки — пятисимвольный SQLSTATE стандарта SQL (23505 — unique_violation, 23514 — check_violation, P0001 — код RAISE EXCEPTION по умолчанию); у каждого кода есть символическое имя 1.
Раздел EXCEPTION перехватывает ошибки блока: WHEN имя_условия THEN операторы. В обработчике доступны SQLSTATE и SQLERRM, а GET STACKED DIAGNOSTICS возвращает подробности: имя нарушенного ограничения, таблицу, контекст. Условие WHEN others перехватывает любые ошибки, кроме отмены запроса.
Ключевое свойство: при ошибке все изменения базы, выполненные в блоке, откатываются, а значения переменных сохраняются. Реализовано это вложенной транзакцией (англ. subtransaction) — неявной точкой сохранения (тема 12), которая устанавливается при каждом входе в блок с разделом EXCEPTION. Блок либо выполняется целиком, либо не оставляет следов, но вход в него дороже входа в обычный блок: на учебной машине анонимный блок DO с циклом из 200 000 итераций x := x + 1 выполнялся 15 мс, а тот же цикл, где присваивание обёрнуто во вложенный блок BEGIN ... EXCEPTION WHEN others THEN NULL; END, — 98 мс. Поэтому раздел EXCEPTION не ставят в тело цикла «на всякий случай». И перехват ошибки — не её устранение: обработчик WHEN others THEN NULL или RAISE NOTICE без повторного возбуждения ошибки приводит к тому, что функция «успешно» завершается, не выполнив часть работы, и вызывающий об этом не узнаёт. Правильный обработчик либо исправляет ситуацию, либо дополняет сообщение подробностями и возбуждает ошибку заново (RAISE без параметров повторно возбуждает текущее исключение).
Динамический SQL: EXECUTE, format() и USING
Иногда текст запроса неизвестен заранее: имя таблицы, столбца или вид условия определяются во время работы. Оператор EXECUTE строка выполняет запрос, текст которого вычислен; он каждый раз разбирается и планируется заново. Пусть нужна функция «сколько строк таблицы имеют заданное значение столбца». Наивная реализация склеивает текст из параметров:
CREATE FUNCTION srv.count_by_bad(p_table text, p_column text, p_value text)
RETURNS bigint
LANGUAGE plpgsql
STABLE
AS $$
DECLARE
    n bigint;
BEGIN
    EXECUTE 'SELECT count(*) FROM bookstore.' || p_table
         || ' WHERE ' || p_column || ' = ''' || p_value || ''''
    INTO n;
    RETURN n;
END;
$$;

SELECT srv.count_by_bad('customer', 'city', 'Казань');
SELECT srv.count_by_bad('publisher', 'name', 'Изд-во «Д''Артаньян»');
SELECT srv.count_by_bad('customer', 'city', 'Казань'' OR ''1'' = ''1');
 count_by_bad
--------------
          562
(1 row)

ERROR:  syntax error at or near "Артаньян»"
QUERY:  SELECT count(*) FROM bookstore.publisher WHERE name = 'Изд-во «Д'Артаньян»'
 count_by_bad
--------------
         5000
(1 row)
Первый вызов работает. Второй — с законным значением, содержащим апостроф, — завершается синтаксической ошибкой: апостроф из данных закрыл строковую константу. Третий показывает, что данные изменили смысл запроса: часть значения стала условием OR '1' = '1', истинным для всех 5000 покупателей. Это та же SQL-инъекция (англ. SQL injection), что и при склейке строк в приложении (тема 15), только внутри сервера: граница между кодом и данными стёрта. Правильная реализация разделяет две задачи — подстановку идентификаторов в текст запроса и передачу значений:
CREATE FUNCTION srv.count_by(p_table text, p_column text, p_value text)
RETURNS bigint
LANGUAGE plpgsql
STABLE
AS $$
DECLARE
    n bigint;
BEGIN
    EXECUTE format('SELECT count(*) FROM %I.%I WHERE %I = $1',
                   'bookstore', p_table, p_column)
    INTO n
    USING p_value;
    RETURN n;
END;
$$;

SELECT srv.count_by('customer', 'city', 'Казань') AS kazan,
       srv.count_by('customer', 'city', 'Казань'' OR ''1'' = ''1') AS odd_city;
SELECT srv.count_by('customer', 'city; DROP TABLE x', 'Казань');
 kazan | odd_city
-------+----------
   562 |        0
(1 row)

ERROR:  column "city; DROP TABLE x" does not exist
QUERY:  SELECT count(*) FROM bookstore.customer WHERE "city; DROP TABLE x" = $1
Функция format() строит строку по шаблону, подобно printf 1:
| Спецификатор | Действие | Аргумент | Результат |
|---|---|---|---|
%s | вставляет текст как есть | city | city |
%I | идентификатор: при необходимости заключает в двойные кавычки и удваивает кавычки внутри (как quote_ident) | Order Items, select, a"b | "Order Items", "select", "a""b" |
%L | литерал: заключает в апострофы, удваивает апострофы, NULL выводит как NULL (как quote_nullable) | Д'Артаньян, NULL | 'Д''Артаньян', NULL |
Почему так безопасно? Строка, подставленная через %I, всегда становится ровно одним идентификатором: что бы она ни содержала — пробелы, точку с запятой, кавычки, — она окажется внутри двойных кавычек с удвоенными внутренними кавычками, и анализатор прочитает её как имя, а не как продолжение запроса; так city; DROP TABLE x стала именем несуществующего столбца. Значение же вообще не попадает в текст: в запросе стоит параметр $1, а значение передаётся через USING отдельно, уже после разбора, как параметр подготовленного оператора. Анализатор его не видит, и никакое содержимое значения не меняет структуру запроса: строка с апострофами — просто необычное название города. Попутно USING сохраняет тип значения.
Спецификатор %L тоже экранирует корректно и нужен там, где параметры недопустимы, например в командах DDL (format('ALTER ROLE %I SET search_path = %L', ...)), но для значений в запросах предпочтительнее USING. Спецификатор %s для данных извне не годится никогда. Наконец, %I защищает структуру запроса, но не проверяет, какую таблицу запросили: если допустимы лишь некоторые таблицы, их проверяют по списку разрешённых или по каталогу (to_regclass).
Свойства функций: изменчивость и права
Категории изменчивости
Каждая функция относится к одной из трёх категорий изменчивости (англ. volatility) — это обещание автора функции оптимизатору 24.
IMMUTABLE(неизменяемая): при одних и тех же аргументах всегда возвращает один результат, не обращается к базе и не зависит от параметров сеанса. Примеры:lower(text),abs,date_truncдля типаtimestamp,srv.with_vat.STABLE(стабильная): в пределах одного оператора SQL при одних и тех же аргументах возвращает один результат; может читать базу и зависеть от параметров сеанса, но не изменяет данные. Примеры:now()(начало транзакции),to_char(зависит от настроек локализации),date_truncдляtimestamptz(зависит от часового пояса сеанса), функции, выполняющиеSELECT.VOLATILE(изменчивая, по умолчанию): результат может меняться при каждом вызове, возможны побочные эффекты. Примеры:random(),clock_timestamp(),nextval(), любые функции, изменяющие данные.
Категория хранится в столбце pg_proc.provolatile (i, s, v). Обещание не проверяется: PostgreSQL позволит объявить IMMUTABLE функцию, читающую таблицу. Неправильная категория приводит либо к упущенной оптимизации (функция объявлена изменчивой, хотя могла быть стабильной), либо к неверным результатам (объявлена более «строгой», чем есть). Обе ситуации показаны ниже.
Как изменчивость влияет на план и число вызовов
Неизменяемую функцию с константными аргументами оптимизатор вправе вычислить один раз при планировании и заменить результатом. Стабильную — один раз в начале выполнения, используя значение как константу, в том числе для поиска по индексу. Изменчивую нужно вызывать для каждой строки, и сравнивать её результат с индексом нельзя: значение могло бы измениться по ходу просмотра. Проверим. Создадим индекс по моменту заказа и три функции, возвращающие одно и то же начало отчётного периода, но с разными категориями:
CREATE INDEX orders_created_at_idx ON bookstore.orders (created_at);
ANALYZE bookstore.orders;

CREATE FUNCTION srv.report_start_v() RETURNS timestamptz
LANGUAGE plpgsql VOLATILE  AS $$ BEGIN RETURN '2024-12-25'; END $$;
CREATE FUNCTION srv.report_start_s() RETURNS timestamptz
LANGUAGE plpgsql STABLE    AS $$ BEGIN RETURN '2024-12-25'; END $$;
CREATE FUNCTION srv.report_start_i() RETURNS timestamptz
LANGUAGE plpgsql IMMUTABLE AS $$ BEGIN RETURN '2024-12-25'; END $$;

EXPLAIN (COSTS OFF)
SELECT count(*) FROM bookstore.orders WHERE created_at >= srv.report_start_v();
EXPLAIN (COSTS OFF)
SELECT count(*) FROM bookstore.orders WHERE created_at >= srv.report_start_s();
                      QUERY PLAN
------------------------------------------------------
 Aggregate
   ->  Seq Scan on orders
         Filter: (created_at >= srv.report_start_v())
(3 rows)

                         QUERY PLAN
-------------------------------------------------------------
 Aggregate
   ->  Index Only Scan using orders_created_at_idx on orders
         Index Cond: (created_at >= srv.report_start_s())
(3 rows)
Изменчивая функция превратила запрос в последовательный просмотр с фильтром, стабильная позволила использовать индекс. План с неизменяемой функцией тот же, что со стабильной, но вместо вызова в условии стоит константа '2024-12-25 00:00:00+03'::timestamp with time zone: функция вычислена при планировании. Число вызовов показывает статистика функций: параметр track_functions = 'all' включает её сбор, представление pg_stat_xact_user_functions показывает вызовы в текущей транзакции. Все три запроса возвращают по 118 строк:
SET track_functions = 'all';
BEGIN;
SELECT count(*) FROM bookstore.orders WHERE created_at >= srv.report_start_v();
SELECT count(*) FROM bookstore.orders WHERE created_at >= srv.report_start_s();
SELECT count(*) FROM bookstore.orders WHERE created_at >= srv.report_start_i();
SELECT funcname, calls FROM pg_stat_xact_user_functions ORDER BY funcname;
COMMIT;
    funcname    | calls
----------------+-------
 report_start_i |     1
 report_start_s |     2
 report_start_v | 20000
(3 rows)
Изменчивая функция вызвана для каждой из 20 000 строк, неизменяемая — один раз при планировании, стабильная — дважды: планировщик вычислил её для оценки селективности условия, исполнитель — перед поиском по индексу. На учебной машине запрос с изменчивой функцией выполнялся около 10 мс, со стабильной — около 0,2 мс. Вывод: функции, только читающие данные, следует объявлять STABLE, а не оставлять категорию по умолчанию.
Индексы по выражениям требуют IMMUTABLE
Индекс по выражению (тема 10) хранит вычисленные значения. Если функция может вернуть для той же строки другое значение — завтра или в сеансе с другими настройками, — индекс перестанет соответствовать таблице. Поэтому в выражениях индекса допустимы только неизменяемые функции:
CREATE INDEX ON bookstore.orders (to_char(created_at, 'YYYY-MM'));
CREATE INDEX ON bookstore.orders ((created_at::date));
CREATE INDEX ON bookstore.orders (date_trunc('month', created_at));
ERROR:  functions in index expression must be marked IMMUTABLE
ERROR:  functions in index expression must be marked IMMUTABLE
ERROR:  functions in index expression must be marked IMMUTABLE
Все три выражения зависят от часового пояса сеанса: timestamptz — момент времени, а какой у этого момента месяц, зависит от того, где наблюдатель. Заказ, сделанный 1 января 2023 года в 02:00 по Москве, в Нью-Йорке ещё относится к 31 декабря. Соблазнительный «обходной путь» — обернуть выражение в свою функцию и объявить её IMMUTABLE. Сервер не возражает, но:
CREATE FUNCTION srv.month_of(ts timestamptz) RETURNS text
LANGUAGE sql IMMUTABLE
AS $$ SELECT to_char(ts, 'YYYY-MM') $$;
CREATE INDEX orders_month_idx ON bookstore.orders (srv.month_of(created_at));
ANALYZE bookstore.orders;

SET TimeZone = 'America/New_York';
SELECT count(*) FROM bookstore.orders WHERE srv.month_of(created_at) = '2023-01';
SET enable_indexscan = off;
SET enable_bitmapscan = off;
SELECT count(*) FROM bookstore.orders WHERE srv.month_of(created_at) = '2023-01';
RESET ALL;
 count
-------
   575
(1 row)

 count
-------
   570
(1 row)
Один и тот же запрос дал два ответа, и ни один не сопровождается предупреждением. Индекс построен в сеансе с поясом Europe/Moscow и вернул 575 заказов «московского» января; последовательный просмотр (индекс запрещён для эксперимента) вычислил функцию в поясе Нью-Йорка и нашёл 570. Корректное решение — сделать выражение действительно неизменяемым, явно указав пояс: created_at AT TIME ZONE 'Europe/Moscow' даёт «местное» время типа timestamp, а date_trunc для timestamp неизменяема:
DROP INDEX bookstore.orders_month_idx;
DROP FUNCTION srv.month_of;
CREATE INDEX orders_month_msk_idx
    ON bookstore.orders (date_trunc('month', created_at AT TIME ZONE 'Europe/Moscow'));
Такой индекс используется запросами с тем же выражением и даёт одинаковый ответ в любом сеансе. Похожая ловушка — зависимость от данных: функция, читающая таблицу курсов валют, не может быть IMMUTABLE, даже если курсы меняются редко.
SECURITY DEFINER и search_path
По умолчанию функция выполняется с правами вызывающего (SECURITY INVOKER). Функция с атрибутом SECURITY DEFINER выполняется с правами владельца — как программа с битом setuid в Unix. Это способ дать роли строго ограниченный доступ: аналитик не может читать таблицу покупателей (роли и привилегии — тема 15), но может вызвать функцию, возвращающую только агрегаты:
CREATE ROLE srv_analyst NOLOGIN;  -- роль аналитика без доступа к схеме bookstore

CREATE FUNCTION srv.customers_by_city()
RETURNS TABLE (city text, customers bigint)
LANGUAGE sql
STABLE
SECURITY DEFINER
SET search_path = pg_catalog, pg_temp
AS $$
    SELECT city, count(*) FROM bookstore.customer
    GROUP BY city ORDER BY 2 DESC LIMIT 3
$$;
REVOKE EXECUTE ON FUNCTION srv.customers_by_city() FROM PUBLIC;
GRANT USAGE ON SCHEMA srv TO srv_analyst;
GRANT EXECUTE ON FUNCTION srv.customers_by_city() TO srv_analyst;
После SET ROLE srv_analyst запрос SELECT count(*) FROM bookstore.customer завершается ошибкой permission denied for schema bookstore, а SELECT * FROM srv.customers_by_city() возвращает три строки: Москва — 1125 покупателей, Самара — 593, Томск — 576. К такому привилегированному коду предъявляются три требования 4. Во-первых, право EXECUTE на новую функцию по умолчанию получает PUBLIC, то есть все, — его отзывают и выдают только адресатам. Во-вторых, путь поиска (search_path, тема 9) задаёт вызывающий сеанс: если функция обращается к объектам по неполным именам, вызывающий может создать в схеме, просматриваемой раньше, одноимённый объект, и подменённый код выполнится с правами владельца. Особенно важна схема pg_temp: при поиске таблиц она по умолчанию просматривается первой, а создавать в ней может любой. Защита — SET search_path в определении функции с доверенными схемами и pg_temp последней, плюс полные имена в теле. В-третьих, динамический SQL в такой функции строится только через %I и USING.
Предложение SET параметр = значение применимо к любому параметру сервера на время вызова (work_mem, statement_timeout). Другие атрибуты функций — STRICT (при NULL-аргументе функция не вызывается и возвращает NULL), PARALLEL SAFE (допускает параллельное выполнение, тема 11), COST и ROWS (оценки для планировщика) — описаны в документации CREATE FUNCTION 4.
Процедуры и управление транзакциями
Процедуры и оператор CALL
Функция вызывается внутри запроса и возвращает значение. Процедура (англ. procedure, PostgreSQL 11) вызывается отдельным оператором CALL и возвращает результаты только через параметры INOUT и OUT 1. Главное отличие — отношение к транзакциям: функция всегда выполняется внутри транзакции вызвавшего её оператора, а процедура, вызванная на верхнем уровне, может сама фиксировать и откатывать транзакции.
Процедура перемещения экземпляров книги между складами объединяет несколько шагов. Достаточность остатка проверяет само ограничение CHECK (quantity >= 0) таблицы stock, а его нарушение перехватывается и заменяется понятным сообщением:
CREATE PROCEDURE srv.transfer_stock(
    p_book integer, p_from integer, p_to integer, p_qty integer,
    INOUT p_left integer DEFAULT NULL)
LANGUAGE plpgsql
AS $$
DECLARE
    v_constraint text;
BEGIN
    UPDATE bookstore.stock SET quantity = quantity - p_qty
    WHERE warehouse_id = p_from AND book_id = p_book
    RETURNING quantity INTO p_left;
    IF NOT FOUND THEN
        RAISE EXCEPTION 'книги % нет на складе %', p_book, p_from
            USING ERRCODE = 'no_data_found';
    END IF;

    INSERT INTO bookstore.stock AS s (warehouse_id, book_id, quantity)
    VALUES (p_to, p_book, p_qty)
    ON CONFLICT (warehouse_id, book_id)
        DO UPDATE SET quantity = s.quantity + EXCLUDED.quantity;
EXCEPTION
    WHEN check_violation THEN
        GET STACKED DIAGNOSTICS v_constraint = CONSTRAINT_NAME;
        RAISE EXCEPTION 'на складе % недостаточно экземпляров книги % (нарушено %)',
            p_from, p_book, v_constraint
            USING ERRCODE = 'check_violation';
END;
$$;

CALL srv.transfer_stock(1, 1, 2, 5);
CALL srv.transfer_stock(1, 1, 2, 50);
CALL srv.transfer_stock(1, 3, 2, 1);
 p_left
--------
      6
(1 row)

ERROR:  на складе 1 недостаточно экземпляров книги 1 (нарушено stock_quantity_check)
CONTEXT:  PL/pgSQL function srv.transfer_stock(integer,integer,integer,integer,integer) line 20 at RAISE
ERROR:  книги 1 нет на складе 3
CONTEXT:  PL/pgSQL function srv.transfer_stock(integer,integer,integer,integer,integer) line 9 at RAISE
Первый вызов переместил 5 экземпляров «Войны и мира» из Москвы в Санкт-Петербург и вернул в p_left остаток на исходном складе. Второй пытался списать 50 из оставшихся 6: UPDATE нарушил ограничение, и обработчик заменил системное сообщение предметным. Ошибки не оставили следов: запрос к stock показывает 6 экземпляров в Москве и 5 в Санкт-Петербурге, как после первого вызова (затем экземпляры возвращены обратно). Заметим, что остаток проверяется не отдельным SELECT перед UPDATE, а самим атомарным UPDATE с ограничением: шаблон «прочитать, проверить, записать» отдельными операторами подвержен потерянному обновлению (тема 12), а SET quantity = quantity - p_qty вычисляет значение по актуальной версии заблокированной строки.
COMMIT и ROLLBACK внутри процедуры
Фиксация внутри процедуры нужна для длительной пакетной обработки. Обработать миллион строк одной транзакцией плохо: она долго удерживает блокировки, мешает очистке старых версий строк (тема 12), а ошибка на последней строке отменяет всю работу. Процедура может разбить работу на пакеты и фиксировать каждый 1. Заполним витрину сумм заказов:
CREATE TABLE srv.order_totals (
    order_id integer PRIMARY KEY,
    total    numeric(12, 2) NOT NULL
);

CREATE PROCEDURE srv.fill_order_totals(p_batch integer DEFAULT 5000)
LANGUAGE plpgsql
AS $$
DECLARE
    v_from integer := 0;
    v_max  integer;
    v_rows integer;
BEGIN
    SELECT max(order_id) INTO v_max FROM bookstore.orders;
    WHILE v_from < v_max LOOP
        INSERT INTO srv.order_totals (order_id, total)
        SELECT order_id, sum(quantity * price)
        FROM bookstore.order_item
        WHERE order_id > v_from AND order_id <= v_from + p_batch
        GROUP BY order_id
        ON CONFLICT (order_id) DO UPDATE SET total = EXCLUDED.total;
        GET DIAGNOSTICS v_rows = ROW_COUNT;
        RAISE NOTICE 'заказы % – %: % строк, транзакция %',
            v_from + 1, v_from + p_batch, v_rows, txid_current();
        COMMIT;
        v_from := v_from + p_batch;
    END LOOP;
END;
$$;

CALL srv.fill_order_totals();
NOTICE:  заказы 1 – 5000: 5000 строк, транзакция 1362
NOTICE:  заказы 5001 – 10000: 5000 строк, транзакция 1363
NOTICE:  заказы 10001 – 15000: 5000 строк, транзакция 1364
NOTICE:  заказы 15001 – 20000: 5000 строк, транзакция 1365
CALL
Каждый пакет выполнен в своей транзакции (номера различаются); после COMMIT новая транзакция начинается автоматически. Если процедура прервётся на третьем пакете, первые два останутся зафиксированными, а повторный вызов благодаря ON CONFLICT безопасно перезапишет обработанные строки — такая идемпотентность (тема 15) обязательна для обработки с промежуточными фиксациями. У управления транзакциями есть ограничения, проверяемые при выполнении. Если выполнить BEGIN; CALL srv.fill_order_totals();, первый пакет будет обработан, а на COMMIT возникнет ошибка invalid transaction termination: процедура, вызванная внутри открытой клиентом транзакции, не может её завершить, так как транзакцией владеет клиент. То же верно при вызове из функции или из SELECT: управлять транзакциями можно только в цепочке вызовов CALL (или блоков DO), идущей с верхнего уровня без промежуточных запросов. Второе ограничение: внутри блока с разделом EXCEPTION фиксировать нельзя, так как блок — вложенная транзакция; попытка завершается ошибкой cannot commit while a subtransaction is active. Поэтому обработку ошибок пакета выносят во вложенный блок, а COMMIT ставят вне его.
Триггеры
Устройство триггера и порядок срабатывания
Триггер (англ. trigger) — правило «при событии выполнить функцию»: при вставке, изменении, удалении строк таблицы или её очистке TRUNCATE сервер автоматически вызывает заданную функцию 35. Идея активных баз данных, реагирующих на события, развивалась в исследованиях 1980–1990-х годов 10. Триггер в PostgreSQL — это два объекта: триггерная функция без параметров, возвращающая тип trigger, и сам триггер, связывающий её с таблицей и событием.
Триггеры различаются моментом срабатывания — BEFORE (до действия), AFTER (после), INSTEAD OF (вместо него, только для представлений) — и уровнем: построчный (FOR EACH ROW) вызывается для каждой затронутой строки, операторный (FOR EACH STATEMENT) — один раз на оператор, даже если тот не затронул ни одной строки. Чтобы увидеть порядок срабатывания, создадим на маленькой таблице четыре триггера, печатающих сообщения:
CREATE TABLE srv.t (id integer PRIMARY KEY, v integer);
INSERT INTO srv.t VALUES (1, 10), (2, 20), (3, 30);

CREATE FUNCTION srv.trace() RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
    IF TG_LEVEL = 'ROW' THEN
        RAISE NOTICE '% ROW: OLD = %, NEW = %', TG_WHEN, OLD, NEW;
    ELSE
        RAISE NOTICE '% STATEMENT', TG_WHEN;
    END IF;
    RETURN NEW;
END;
$$;

CREATE TRIGGER t_bs BEFORE UPDATE ON srv.t FOR EACH STATEMENT EXECUTE FUNCTION srv.trace();
CREATE TRIGGER t_br BEFORE UPDATE ON srv.t FOR EACH ROW EXECUTE FUNCTION srv.trace();
CREATE TRIGGER t_ar AFTER UPDATE ON srv.t FOR EACH ROW EXECUTE FUNCTION srv.trace();
CREATE TRIGGER t_as AFTER UPDATE ON srv.t FOR EACH STATEMENT EXECUTE FUNCTION srv.trace();

UPDATE srv.t SET v = v + 1 WHERE id <= 2;
NOTICE:  BEFORE STATEMENT
NOTICE:  BEFORE ROW: OLD = (1,10), NEW = (1,11)
NOTICE:  BEFORE ROW: OLD = (2,20), NEW = (2,21)
NOTICE:  AFTER ROW: OLD = (1,10), NEW = (1,11)
NOTICE:  AFTER ROW: OLD = (2,20), NEW = (2,21)
NOTICE:  AFTER STATEMENT
UPDATE 2
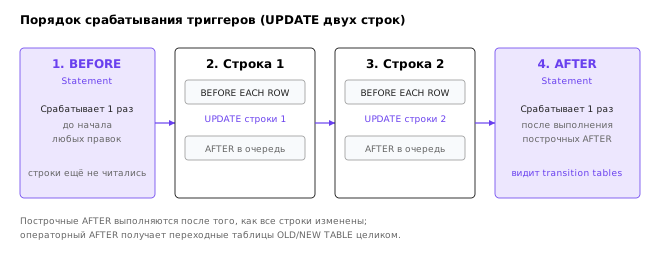
Порядок, показанный на рисунке ниже: операторный BEFORE; для каждой строки — построчный BEFORE и само изменение; затем, после обработки всех строк, построчные AFTER в порядке изменения; в конце — операторный AFTER. События построчных AFTER-триггеров ставятся в очередь и обрабатываются в конце оператора, когда все изменения выполнены. Оператор, не затронувший ни одной строки (WHERE id > 100), вызывает только два операторных триггера. Несколько триггеров одного вида на одно событие срабатывают в алфавитном порядке имён 5.
В функции триггера доступны переменные 1: NEW и OLD — новая и старая версии строки (OLD не определена при INSERT, NEW — при DELETE), TG_OP — операция, TG_WHEN, TG_LEVEL, TG_TABLE_SCHEMA, TG_TABLE_NAME, TG_ARGV — аргументы из CREATE TRIGGER. Возвращаемое значение важно только для построчных BEFORE и INSTEAD OF: возврат NEW (возможно, изменённой) означает «выполнить действие с этой версией строки», возврат NULL — «пропустить строку»; у AFTER-триггеров и операторных результат игнорируется. Отсюда разделение ролей: BEFORE-триггеры проверяют и изменяют строку до записи (нормализовать e-mail, заполнить changed_at, отклонить недопустимое значение), AFTER-триггеры реагируют на выполненное изменение — меняют другие таблицы, пишут журнал, отправляют уведомления. Предложение WHEN (условие) проверяется без вызова функции, а UPDATE OF столбец ограничивает срабатывание операторами, изменяющими этот столбец.
Аудит изменений: построчный триггер и переходные таблицы
Классическое применение — аудит (англ. audit trail): запись того, кто, когда и как изменил данные. Тип jsonb (тема 9) позволяет хранить старую и новую версии строки любой таблицы в одном журнале:
CREATE TABLE srv.audit_log (
    audit_id   bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    table_name text        NOT NULL,
    op         text        NOT NULL,
    old_row    jsonb,
    new_row    jsonb,
    changed_by text        NOT NULL DEFAULT current_user,
    changed_at timestamptz NOT NULL DEFAULT now()
);

CREATE FUNCTION srv.audit_row() RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
    INSERT INTO srv.audit_log (table_name, op, old_row, new_row)
    VALUES (TG_TABLE_SCHEMA || '.' || TG_TABLE_NAME, TG_OP,
            CASE WHEN TG_OP <> 'INSERT' THEN to_jsonb(OLD) END,
            CASE WHEN TG_OP <> 'DELETE' THEN to_jsonb(NEW) END);
    RETURN NULL;
END;
$$;

CREATE TRIGGER orders_audit_row
    AFTER INSERT OR UPDATE OR DELETE ON bookstore.orders
    FOR EACH ROW EXECUTE FUNCTION srv.audit_row();

UPDATE bookstore.orders SET status = 'paid' WHERE order_id = 673;
SELECT op, old_row ->> 'status' AS old_status, new_row ->> 'status' AS new_status,
       new_row ->> 'customer_id' AS customer, changed_by
FROM srv.audit_log;
   op   | old_status | new_status | customer | changed_by
--------+------------+------------+----------+------------
 UPDATE | new        | paid       | ...      | postgres
(1 row)
Функция to_jsonb(OLD) преобразует строку целиком, поэтому одна триггерная функция подходит для любой таблицы, а новый столбец таблицы не требует её изменения. Запись журнала делается в той же транзакции, что и изменение: при откате исчезнет и она. Столбец changed_by заполняется current_user; если приложение подключается под одной общей ролью, имя конечного пользователя передают иначе, например параметром сеанса (SET app.user = ... и current_setting('app.user')).
Построчный триггер вызывается для каждой строки, и при массовых изменениях это заметно. Альтернатива — операторный триггер с переходными таблицами (англ. transition tables, PostgreSQL 10): предложение REFERENCING OLD TABLE AS ... NEW TABLE AS ... даёт функции все старые и новые версии строк, изменённых оператором, как таблицы, к которым можно обращаться запросами 5. Журнал заполняется одним INSERT ... SELECT. Сравним стоимость на изменении всех 20 000 заказов (оператор не меняет значений, но для сервера это обычное обновление; транзакция откатывается):
BEGIN;
EXPLAIN (ANALYZE, COSTS OFF) UPDATE bookstore.orders SET warehouse_id = warehouse_id;
ROLLBACK;

CREATE FUNCTION srv.audit_stmt() RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
    INSERT INTO srv.audit_log (table_name, op, old_row, new_row)
    SELECT TG_TABLE_SCHEMA || '.' || TG_TABLE_NAME, TG_OP, to_jsonb(o), to_jsonb(n)
    FROM old_rows o JOIN new_rows n USING (order_id);
    RETURN NULL;
END;
$$;
DROP TRIGGER orders_audit_row ON bookstore.orders;
CREATE TRIGGER orders_audit_upd
    AFTER UPDATE ON bookstore.orders
    REFERENCING OLD TABLE AS old_rows NEW TABLE AS new_rows
    FOR EACH STATEMENT EXECUTE FUNCTION srv.audit_stmt();

BEGIN;
EXPLAIN (ANALYZE, COSTS OFF) UPDATE bookstore.orders SET warehouse_id = warehouse_id;
ROLLBACK;
...
EXPLAIN ANALYZE показывает время каждого триггера и число вызовов: 20 000 вызовов построчного против одного операторного. Времена на другой машине будут иными, но соотношение устойчиво: операторный триггер выполняет один запрос вместо двадцати тысяч. Ограничения: переходные таблицы доступны только в триггерах AFTER, и такой триггер определяется для одного события — попытка объявить его AFTER INSERT OR DELETE завершается ошибкой transition tables cannot be specified for triggers with more than one event; поэтому для вставки, изменения и удаления создают три триггера с одной функцией, различающей случаи по TG_OP. Аудит триггерами не заменяет журнал сервера и расширение pgaudit (тема 15): триггеры не видят чтения и могут быть отключены владельцем таблицы. Их сила — в записи содержания изменений в виде, удобном для запросов: вопрос «какой была цена книги месяц назад» решается запросом к журналу.
Денормализованные данные и сложные ограничения
Второе применение — поддержание денормализованных данных (тема 8): сумм, счётчиков, средних, хранимых отдельно, чтобы не вычислять их при каждом чтении. Пусть общее число экземпляров книги на всех складах хранится в таблице srv.book_stock_total (book_id, quantity). Построчный AFTER-триггер на stock обрабатывает любое изменение как «вычесть OLD.quantity, прибавить NEW.quantity» (при INSERT — только прибавить, при DELETE — только вычесть); это корректно и тогда, когда UPDATE меняет сам book_id. Согласованность проверяется запросом, сравнивающим хранимые итоги с вычисленными заново; его включают в регулярные проверки, потому что итоги расходятся с данными не только из-за ошибок в триггере, но и при отключении триггеров во время загрузки и при TRUNCATE, для которого построчные триггеры не срабатывают.
Параллельную корректность обеспечивает атомарность UPDATE ... SET quantity = quantity - ...: две транзакции, меняющие остатки одной книги, выстраиваются в очередь на блокировке строки итога. Обратная сторона — «горячая» строка: если книгу одновременно покупают сотни клиентов, все они ждут друг друга на одной строке итога, даже списывая с разных складов. Денормализация переносит стоимость с чтения на запись.
Третье применение — ограничения целостности, не выражаемые декларативно (CHECK видит только одну строку, тема 2). Пусть у книги может быть не более трёх авторов. Триггер считает авторов перед вставкой; строка с PERFORM, выделенная комментарием, в первом варианте отсутствовала:
CREATE FUNCTION srv.check_author_limit() RETURNS trigger
LANGUAGE plpgsql
AS $$
DECLARE
    v_cnt integer;
BEGIN
    PERFORM 1 FROM bookstore.book WHERE book_id = NEW.book_id FOR UPDATE;  -- исправление
    SELECT count(*) INTO v_cnt
    FROM bookstore.book_author WHERE book_id = NEW.book_id;
    IF v_cnt >= 3 THEN
        RAISE EXCEPTION 'у книги % уже % автора', NEW.book_id, v_cnt
            USING ERRCODE = 'check_violation';
    END IF;
    RETURN NEW;
END;
$$;

CREATE TRIGGER book_author_limit
    BEFORE INSERT OR UPDATE OF book_id ON bookstore.book_author
    FOR EACH ROW EXECUTE FUNCTION srv.check_author_limit();
У «Пикника на обочине» (книга 4) два автора. Две параллельные транзакции добавляют по третьему: опыт проведён программой на Python с двумя соединениями psycopg (тема 15) — первая сессия вставляет автора и не фиксирует транзакцию, вторая в отдельном потоке вставляет другого автора, через секунду первая фиксирует. Без строки PERFORM обе сессии зафиксировались без ожидания, и у книги оказалось четыре автора. Каждая транзакция видела двух зафиксированных авторов и не видела незафиксированную вставку соседа — это асимметрия записи (англ. write skew, тема 12). Ограничение, проверяемое запросом к другим строкам, требует сериализации конкурирующих проверок; простой способ — заблокировать строку «родителя», общую для всех конкурентов. С исправлением:
2 автора до опыта
сессия 1: вставила автора 1, транзакция открыта
сессия 1: COMMIT
сессия 2: ошибка: у книги 4 уже 3 автора (ждала 1.0 с)
3 автора после опыта
Вторая сессия ждала блокировки строки книги, пока первая не зафиксировалась, затем подсчитала авторов заново и увидела трёх. Здесь важна категория функции: триггерная функция изменчива, поэтому запрос после PERFORM ... FOR UPDATE выполняется с новым снимком и видит только что зафиксированную строку. Другие решения — уровень изоляции Serializable для всех транзакций, меняющих связь (тема 12), или счётчик авторов в строке книги с ограничением CHECK, поддерживаемый триггером.
Триггеры INSTEAD OF и опасности триггеров
Представление на соединении не является автоматически обновляемым (тема 6), и триггер INSTEAD OF определяет, что делать вместо его изменения. Представление «карточка книги» показывает название издательства вместо номера:
CREATE VIEW srv.book_card AS
SELECT b.book_id, b.title, b.price, p.name AS publisher
FROM bookstore.book b
LEFT JOIN bookstore.publisher p USING (publisher_id);

UPDATE srv.book_card SET publisher = 'Питер' WHERE book_id = 7;
ERROR:  cannot update view "book_card"
DETAIL:  Views that do not select from a single table or view are not automatically updatable.
HINT:  To enable updating the view, provide an INSTEAD OF UPDATE trigger or an unconditional ON UPDATE DO INSTEAD rule.
Подсказка сервера указывает решение:
CREATE FUNCTION srv.book_card_update() RETURNS trigger
LANGUAGE plpgsql
AS $$
DECLARE
    v_publisher_id integer;
BEGIN
    IF NEW.publisher IS NOT NULL THEN
        SELECT publisher_id INTO v_publisher_id
        FROM bookstore.publisher WHERE name = NEW.publisher;
        IF NOT FOUND THEN
            RAISE EXCEPTION 'издательство «%» не найдено', NEW.publisher;
        END IF;
    END IF;
    UPDATE bookstore.book
    SET title = NEW.title, price = NEW.price, publisher_id = v_publisher_id
    WHERE book_id = OLD.book_id;
    RETURN NEW;
END;
$$;

CREATE TRIGGER book_card_update
    INSTEAD OF UPDATE ON srv.book_card
    FOR EACH ROW EXECUTE FUNCTION srv.book_card_update();

BEGIN;
UPDATE srv.book_card SET publisher = 'Питер', price = price * 0.9
WHERE book_id = 7 RETURNING *;
SELECT book_id, publisher_id, price FROM bookstore.book WHERE book_id = 7;
ROLLBACK;
UPDATE 1
 book_id | publisher_id |  price
---------+--------------+---------
       7 |            1 | 3591.00
(1 row)
Книга Кнута, не имевшая издательства, получила издательство 1 («Питер») и цену на 10 % ниже (RETURNING * вернул строку представления с новыми значениями). Строка, возвращённая функцией, служит результатом RETURNING и учитывается в счётчике UPDATE 1; возврат NULL означал бы «строка не изменена». Через триггеры INSTEAD OF можно предоставить приложению упрощённый интерфейс, устойчивый к изменениям схемы, — например, вставку в несколько таблиц через одно представление.
Опасности триггеров. Первая — каскады и рекурсия: триггер, изменяющий таблицу, вызывает её триггеры, в том числе себя. Типичная ошибка — заполнять столбец «время изменения» в AFTER-триггере отдельным UPDATE той же строки:
ALTER TABLE srv.t ADD COLUMN changed_at timestamptz;
CREATE FUNCTION srv.t_touch() RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
    UPDATE srv.t SET changed_at = now() WHERE id = NEW.id;  -- ошибка
    RETURN NULL;
END;
$$;
CREATE TRIGGER t_touch AFTER UPDATE ON srv.t
    FOR EACH ROW EXECUTE FUNCTION srv.t_touch();

UPDATE srv.t SET v = 0 WHERE id = 1;
ERROR: stack depth limit exceeded
Каждый UPDATE в триггере вызывал тот же триггер; после сотен уровней вложенности исчерпан стек, и оператор отменён целиком. Правильно изменять строку до записи — в BEFORE-триггере присваиванием NEW.changed_at := now(); RETURN NEW;. Если вложенный вызов действительно нужен, его глубину возвращает pg_trigger_depth(), пригодная для условия WHEN.
Вторая опасность — скрытая логика: триггер невидим в тексте запроса, и UPDATE одной строки может длиться секунды из-за пересчёта итогов. Поэтому триггеры документируют, держат простыми и не используют для бизнес-логики, которую естественнее вызвать явно; список триггеров таблицы показывает \d таблица, время каждого — EXPLAIN ANALYZE. Третья — производительность: построчный триггер замедляет массовые операции в разы, поэтому при больших загрузках триггеры иногда отключают и затем пересчитывают производные данные одним запросом.
Событийные триггеры, уведомления и другие языки
Событийные триггеры
Событийный триггер (англ. event trigger) связан не с таблицей, а с базой целиком и реагирует на команды DDL: события ddl_command_start, ddl_command_end, sql_drop (удаление объектов), table_rewrite (перезапись таблицы) 6. Создаёт их только суперпользователь. Функция возвращает тип event_trigger и получает сведения о событии через специальные функции:
CREATE FUNCTION srv.log_ddl() RETURNS event_trigger
LANGUAGE plpgsql
AS $$
DECLARE
    r record;
BEGIN
    FOR r IN SELECT * FROM pg_event_trigger_ddl_commands() LOOP
        RAISE NOTICE 'DDL: % %', r.command_tag, r.object_identity;
    END LOOP;
END;
$$;
CREATE EVENT TRIGGER log_ddl ON ddl_command_end EXECUTE FUNCTION srv.log_ddl();

CREATE TABLE srv.tmp_demo (id integer PRIMARY KEY);
DROP TABLE srv.tmp_demo;
DROP EVENT TRIGGER log_ddl;
Команда CREATE TABLE выводит два сообщения — DDL: CREATE TABLE srv.tmp_demo и DDL: CREATE INDEX srv.tmp_demo_pkey: таблица с первичным ключом — две команды. Удаление функция pg_event_trigger_ddl_commands() не показывает: удалённые объекты перечисляет pg_event_trigger_dropped_objects() в триггере на sql_drop. Применения — журнал изменений схемы, запрет опасных команд на рабочей базе, автоматическая выдача привилегий на новые объекты; ошибка в такой функции блокирует весь DDL в базе.
LISTEN и NOTIFY
Приложению часто нужно узнавать об изменениях: служба доставки ждёт оплаченные заказы, витрина — изменения цен. Опрос таблицы раз в секунду расточителен и даёт задержку. PostgreSQL предоставляет асинхронные уведомления (англ. asynchronous notifications) 7: сеанс выполняет LISTEN канал, любой сеанс — NOTIFY канал, 'данные' или pg_notify(канал, данные), и все подписчики получают уведомление с именем канала, строкой данных (англ. payload) и номером процесса отправителя.
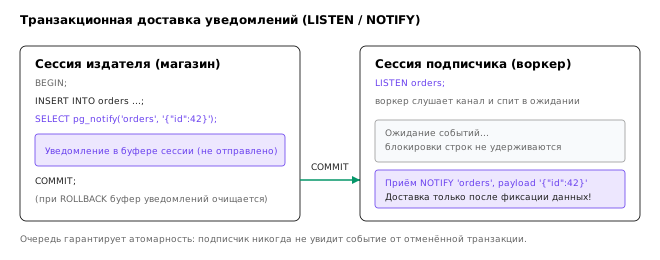
Уведомления транзакционны: отправленное в транзакции доставляется только при её фиксации и исчезает при откате, так что подписчик не узнает об изменении, которого «не было». Одинаковые уведомления (тот же канал и та же строка) в одной транзакции сливаются в одно; уведомления одной транзакции доставляются в порядке отправки, разных — в порядке фиксации. Строка данных по умолчанию должна быть короче 8000 байт, поэтому передают ключ, а данные подписчик читает запросом 7. Связь уведомления с изменением удобно выразить триггером:
CREATE FUNCTION srv.notify_order_status() RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
    PERFORM pg_notify('order_status',
        json_build_object('order_id', NEW.order_id,
                          'old', OLD.status, 'new', NEW.status)::text);
    RETURN NULL;
END;
$$;

CREATE TRIGGER orders_notify_status
    AFTER UPDATE OF status ON bookstore.orders
    FOR EACH ROW
    WHEN (OLD.status IS DISTINCT FROM NEW.status)
    EXECUTE FUNCTION srv.notify_order_status();
Подписчика и магазин изобразим двумя соединениями psycopg в одной программе; метод notifies() с параметрами timeout и stop_after есть в psycopg 3.2 и новее:
import time, psycopg

listener = psycopg.connect("dbname=bookstore", autocommit=True)
listener.execute("LISTEN order_status")

shop = psycopg.connect("dbname=bookstore")      # транзакция начнётся неявно
shop.execute("UPDATE bookstore.orders SET status = 'paid' WHERE order_id = 140")
shop.execute("UPDATE bookstore.orders SET status = 'paid' WHERE order_id = 140")
print("до COMMIT получено:", list(listener.notifies(timeout=1)))
t0 = time.monotonic()
shop.commit()
for n in listener.notifies(timeout=1, stop_after=1):
    print(f"после COMMIT через {1000 * (time.monotonic() - t0):.1f} мс:",
          n.channel, n.payload)
до COMMIT получено: []
после COMMIT через 0.5 мс: order_status {"order_id" : 140, "old" : "new", "new" : "paid"}
Пока транзакция магазина не зафиксирована, подписчик за секунду ожидания не получил ничего; после COMMIT уведомление пришло за доли миллисекунды. Второй UPDATE не изменил статус, и триггер не сработал. Схема на рисунке ниже показывает этот обмен во времени.
Механизм прост и не заменяет очередь сообщений: уведомления не хранятся для отключённых подписчиков, и переподключившийся сеанс пропущенного не получит. Надёжная схема сочетает таблицу-очередь (событие записывается в той же транзакции, обработчик выбирает строки с FOR UPDATE SKIP LOCKED, тема 12) с NOTIFY как сигналом «загляни в очередь». Подписчик не должен держать открытую транзакцию: пока она открыта, очередь уведомлений (8 ГиБ в стандартной сборке) не может очищаться 7.
PL/Python и другие процедурные языки
В стандартную поставку PostgreSQL кроме PL/pgSQL входят PL/Tcl, PL/Perl и PL/Python 8; сторонние проекты добавляют PL/v8 (JavaScript), PL/Java, PL/R. Язык подключается командой CREATE EXTENSION (для PL/Python в Ubuntu нужен пакет postgresql-plpython3-16, затем CREATE EXTENSION plpython3u); тело функции — код на Python, к базе он обращается через модуль plpy. В учебной среде проверки этого курса PL/Python не установлен, поэтому примеры не приводятся. Различают доверенные (англ. trusted) языки — PL/pgSQL, plperl, — не дающие коду доступа к файлам и сети сервера, и недоверенные (untrusted) — plpython3u, plperlu, — дающие все возможности процесса сервера; функции на недоверенных языках создаёт только суперпользователь, а PL/Python существует только в недоверенном варианте 8. Самый быстрый серверный код — функции на C; так устроены расширения (англ. extensions) — пакеты функций, типов, операторов и методов доступа, устанавливаемые CREATE EXTENSION: pgcrypto, pg_trgm, pageinspect, PostGIS, pgvector 2.
Итоги темы
Серверное программирование переносит часть логики к данным. Функции на SQL — самый простой и часто самый эффективный вид серверного кода: планировщик подставляет их тело в запрос. PL/pgSQL добавляет переменные, условия, циклы и исключения; каждый оператор SQL в нём выполняется как подготовленный оператор с параметрами, а блок с разделом EXCEPTION — как вложенная транзакция, которая при ошибке откатывает свои изменения, но стоит дороже обычного блока. Динамический SQL безопасен при строгом разделении кода и данных: идентификаторы подставляются через format() с %I, значения передаются через USING и не попадают в текст запроса.
Категория изменчивости — обещание оптимизатору: стабильные и неизменяемые функции вычисляются один раз и допускают поиск по индексу, изменчивые вызываются для каждой строки, а ложное IMMUTABLE в индексе по выражению приводит к молча неверным результатам. Функции SECURITY DEFINER требуют фиксированного search_path, отзыва EXECUTE у PUBLIC и безопасного динамического SQL. Процедуры могут фиксировать транзакции, что нужно для пакетной обработки, — но только при вызове с верхнего уровня и вне блоков с обработкой исключений.
Триггеры выполняют код при изменении данных: построчные BEFORE проверяют и изменяют строку, AFTER реагируют на изменение, операторные с переходными таблицами обрабатывают все строки одним запросом, INSTEAD OF делают обновляемыми сложные представления. На них строятся аудит, денормализованные итоги и сложные ограничения, но ограничения, проверяющие другие строки, требуют явной сериализации, а рекурсия, скрытая логика и стоимость построчных вызовов — дисциплины. Событийные триггеры реагируют на DDL, LISTEN/NOTIFY уведомляет приложения о зафиксированных изменениях. Следующая тема рассматривает ту же границу между приложением и СУБД со стороны приложения: подключение, транзакции в коде, параметризованные запросы, роли и защиту данных.
Литература
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 43. PL/pgSQL — SQL Procedural Language. — 2024. https://www.postgresql.org/docs/16/plpgsql.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 38. Extending SQL (38.5. Query Language (SQL) Functions; 38.7. Function Volatility Categories). — 2024. https://www.postgresql.org/docs/16/extend.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 39. Triggers. — 2024. https://www.postgresql.org/docs/16/triggers.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. CREATE FUNCTION. — 2024. https://www.postgresql.org/docs/16/sql-createfunction.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. CREATE TRIGGER. — 2024. https://www.postgresql.org/docs/16/sql-createtrigger.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 40. Event Triggers. — 2024. https://www.postgresql.org/docs/16/event-triggers.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. NOTIFY. — 2024. https://www.postgresql.org/docs/16/sql-notify.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 46. PL/Python — Python Procedural Language. — 2024. https://www.postgresql.org/docs/16/plpython.html
- Silberschatz A., Korth H. F., Sudarshan S. Database System Concepts. 7th ed. — McGraw-Hill, 2019. Chapter 5. Advanced SQL.
- Widom J., Ceri S. (eds.) Active Database Systems: Triggers and Rules for Advanced Database Processing. — Morgan Kaufmann, 1996.
- ISO/IEC 9075-4:2023. Information technology — Database languages SQL — Part 4: Persistent stored modules (SQL/PSM). — ISO, 2023.
- Garcia-Molina H., Ullman J. D., Widom J. Database Systems: The Complete Book. 2nd ed. — Pearson Prentice Hall, 2009. Chapter 7. Constraints and Triggers; Chapter 9. SQL in a Server Environment.