
Базы данных в приложениях и безопасность
В предыдущих темах база данных рассматривалась «изнутри»: как формулировать запросы, проектировать схему, как СУБД хранит данные, выполняет запросы, изолирует транзакции и восстанавливается после сбоя, как переносить часть логики на сторону сервера (тема 14). Опыты выполнялись в psql от имени суперпользователя, но в реальной системе с базой работает программа — веб-приложение, сценарий загрузки, — которая формирует запросы из пользовательского ввода, а к базе одновременно обращаются сотни программ и людей с разными полномочиями.
На стыке приложения и базы возникают проблемы, которых не видно в psql: производительности (дорогое открытие соединения, сотни мелких запросов вместо одного), корректности (неверные границы транзакции, отсутствие повтора при ошибке сериализации, миграция, останавливающая магазин) и безопасности (запрос, собранный склейкой строк, приложение с правами суперпользователя, покупатель, читающий чужие заказы).
Первый раздел описывает подключение к серверу и пулы соединений, второй — транзакции в коде приложения и их повтор, третий — передачу данных в запрос: параметризацию, причины SQL-инъекции, проблему N+1 и пакетную загрузку. Четвёртый кратко рассматривает ORM и миграции схемы, пятый и шестой — роли, привилегии, защиту на уровне строк, аутентификацию и шифрование. Примеры написаны на Python с драйвером psycopg 3 и выполнены на учебной базе «Книжный узел».
Как приложение работает с СУБД
Протокол клиент — сервер и драйверы
PostgreSQL построен по клиент-серверной архитектуре (тема 1): клиент и сервер — разные процессы, обменивающиеся сообщениями по протоколу (англ. frontend/backend protocol, версия 3.0 используется с PostgreSQL 7.4) 1. Клиент открывает соединение TCP или сокет Unix и отправляет стартовое сообщение с именем пользователя и базы; сервер проводит аутентификацию, сообщает параметры сеанса и сообщением ReadyForQuery показывает готовность принимать команды.
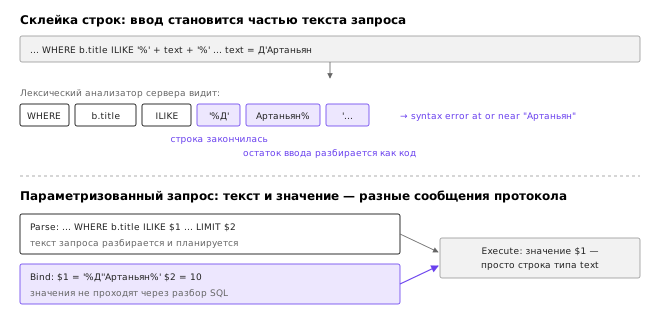
Для выполнения команд есть два режима. В простом (англ. simple query) клиент отправляет сообщение Query с текстом SQL, возможно из нескольких операторов. В расширенном (англ. extended query) выполнение разбито на шаги: Parse передаёт текст с позиционными заполнителями $1, $2, …, Bind связывает разобранный оператор со значениями параметров, Execute выполняет его, Sync завершает цикл 1. Принципиальное свойство расширенного режима: текст запроса и значения параметров передаются разными сообщениями, и значения никогда не проходят через лексический анализатор SQL. На этом свойстве основана защита от SQL-инъекций (третий раздел). Разобранный оператор можно сохранить под именем и выполнять многократно — так устроены подготовленные операторы (тема 11).
Драйвер (англ. driver) — библиотека, реализующая протокол для конкретного языка программирования. Эталонная реализация — библиотека libpq на языке C из поставки PostgreSQL 2; ею пользуется и psql. Одни драйверы построены поверх libpq (psycopg для Python), другие реализуют протокол самостоятельно (PgJDBC для Java, asyncpg, node-postgres). Универсальные интерфейсы ODBC и JDBC позволяют работать с разными СУБД через единый API; в Python эту роль играет спецификация DB-API 2.0 (PEP 249), которой следует и psycopg.
В курсе используется psycopg 3 — современный драйвер PostgreSQL для Python 3. Минимальная программа выглядит так:
import psycopg

with psycopg.connect("dbname=bookstore") as conn:
    row = conn.execute(
        "SELECT title, price FROM bookstore.book WHERE book_id = %s", (4,)
    ).fetchone()
    print(row)
('Пикник на обочине', Decimal('520.00'))
Столбец price типа numeric(10,2) пришёл в программу как точное decimal.Decimal: драйвер отображает типы PostgreSQL на типы языка (timestamptz → datetime, jsonb → словари и списки) и обратно. Заполнитель %s — синтаксис psycopg: перед отправкой драйвер заменяет его на $1 и передаёт значение отдельно.
Строка подключения и секреты
Параметры подключения задаются строкой подключения (англ. connection string) в одной из двух форм: последовательность пар «ключ=значение» (host=db.example.ru port=5432 dbname=bookstore user=shop_web sslmode=verify-full) или URI (postgresql://shop_web@db.example.ru:5432/bookstore?sslmode=verify-full) 2. Не указанные в строке параметры libpq берёт из переменных окружения (PGHOST, PGPORT, PGDATABASE, PGUSER) или значений по умолчанию.
Пароль записывать в исходный код нельзя: код хранится в системе контроля версий и копируется на машины разработчиков, и пароль, однажды попавший в историю коммитов, следует считать раскрытым. Libpq предлагает файл паролей ~/.pgpass: каждая строка имеет вид хост:порт:база:пользователь:пароль, а сам файл должен быть доступен только владельцу (права 0600), иначе libpq его игнорирует 2. На серверах пароль передают через переменные окружения или хранилища секретов (HashiCorp Vault, секреты Kubernetes). Модуль подключения учебного приложения не содержит ни хоста, ни пароля — всё приходит из окружения:
import os
import psycopg

DSN = os.environ.get("BOOKSTORE_DSN", "dbname=bookstore")

def connect(**kwargs):
    return psycopg.connect(DSN, **kwargs)
Стоимость соединения и пулы
PostgreSQL обслуживает каждое соединение отдельным процессом операционной системы: главный процесс postmaster при подключении клиента порождает (fork) обслуживающий процесс (англ. backend), и тот живёт до отключения клиента (тема 1). Установление соединения поэтому дорого: нужно создать процесс, выполнить аутентификацию, прочитать системный каталог в локальные кеши процесса. Каждый процесс потребляет память, а их число ограничено параметром max_connections (по умолчанию 100).
Измерим стоимость соединения скриптом pool_bench.py из окружения лабораторной работы. Скрипт выполняет 200 одинаковых запросов поиска книги по ключу тремя способами: открывая новое соединение на каждый запрос, через одно долгоживущее соединение и через пул из четырёх соединений (сервер и клиент на одной машине, соединение через сокет Unix):
новое соединение на запрос:   5.85 мс на запрос, разных серверных процессов: 200
одно соединение:              0.20 мс на запрос, разных серверных процессов: 1
пул (4 соединения):           0.26 мс на запрос, разных серверных процессов: 4
Абсолютные значения зависят от машины, но порядок разницы устойчив: открытие соединения в десятки раз дороже простого запроса, а по сети с TLS — ещё дороже.
Решение — пул соединений (англ. connection pool): набор заранее открытых соединений, которые приложение берёт на время работы и возвращает, не закрывая. В psycopg пул реализован пакетом psycopg_pool 3: объект ConnectionPool(dsn, min_size=4, max_size=10) держит соединения, а блок with pool.connection() as conn: берёт соединение и по выходе возвращает его в пул, не закрывая.
Когда веб-сервис запущен в двадцати копиях с пулом из двадцати соединений в каждой, сервер получает 400 соединений, большей частью простаивающих. Эту задачу решает внешний пул — процесс-посредник; самый распространённый — PgBouncer: клиенты подключаются к нему как к серверу PostgreSQL, а он распределяет их запросы по небольшому числу настоящих серверных соединений 4. Схема на рисунке ниже показывает оба уровня.
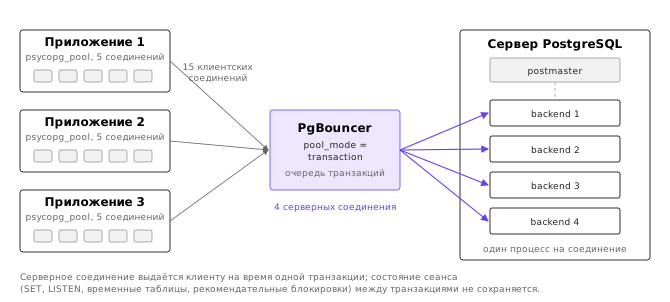
PgBouncer поддерживает три режима, различающиеся тем, когда серверное соединение возвращается в пул 4:
| Режим | Серверное соединение закреплено за клиентом | Что перестаёт работать |
|---|---|---|
сеансовый (session) | на всё время подключения клиента | ничего; экономится только время открытия соединения |
транзакционный (transaction) | на время одной транзакции | состояние сеанса между транзакциями: SET/RESET, LISTEN, рекомендательные блокировки уровня сеанса, PREPARE на уровне SQL, временные таблицы с ON COMMIT PRESERVE ROWS |
операторный (statement) | на время одного оператора | дополнительно — транзакции из нескольких операторов |
Транзакционный режим даёт наибольшую экономию, но требует дисциплины: параметр, установленный командой SET, «утечёт» к другому клиенту, которому достанется то же серверное соединение, тогда как SET LOCAL или set_config(…, true) действуют до конца транзакции и безопасны. Подготовленные операторы протокольного уровня, которыми пользуются драйверы, в транзакционном режиме поддерживаются начиная с PgBouncer 1.21 при ненулевом параметре max_prepared_statements 4.
Размер пула выбирают по возможностям сервера, а не по числу пользователей: с пользой одновременно выполняется порядка стольких запросов, сколько процессорных ядер. Пул из 20 соединений на 2000 пользователей работает лучше 2000 соединений: лишние запросы ждут в очереди пула, а не конкурируют за ресурсы сервера.
Транзакции в коде приложения
Границы транзакции и автофиксация
Транзакция, как было показано в теме 12, — единица работы, которая выполняется целиком или не выполняется вовсе. В psql её границы задаются явно командами BEGIN и COMMIT, а без них действует режим автофиксации (англ. autocommit): каждый оператор — отдельная транзакция. Драйверы ведут себя по-разному, и непонимание этого — частый источник ошибок.
Спецификация DB-API требует, чтобы по умолчанию автофиксация была выключена, и psycopg ей следует 3: первый же оператор неявно открывает транзакцию, и она остаётся открытой, пока программа не вызовет commit() или rollback(). Проследим состояние соединения (conn.info.transaction_status) в коротком опыте:
conn = psycopg.connect("dbname=bookstore")      # autocommit=False по умолчанию
print(conn.info.transaction_status.name)         # IDLE
conn.execute("SELECT 1")
print(conn.info.transaction_status.name)         # INTRANS — транзакция открыта
try:
    conn.execute("SELECT 1/0")
except psycopg.errors.DivisionByZero:
    pass
print(conn.info.transaction_status.name)         # INERROR
conn.execute("SELECT 1")
IDLE
INTRANS
INERROR
psycopg.errors.InFailedSqlTransaction: current transaction is aborted, commands ignored until end of transaction block
Во-первых, даже чтение открывает транзакцию, и если программа затем надолго задумается, сервер увидит сеанс в состоянии idle in transaction, который удерживает снимок и блокировки и мешает очистке версий строк (тема 12). Во-вторых, после ошибки все операторы отвергаются до rollback().
Надёжный приём — включить автофиксацию и задавать границы транзакций явно блоком with conn.transaction(): при нормальном выходе из блока psycopg выполняет COMMIT, при исключении — ROLLBACK и пробрасывает исключение дальше 3:
conn = psycopg.connect("dbname=bookstore", autocommit=True)
try:
    with conn.transaction():
        conn.execute("UPDATE bookstore.book SET price = price + 1 WHERE book_id = 1")
        raise ValueError("ошибка в коде приложения")
except ValueError:
    pass
print(conn.execute("SELECT price FROM bookstore.book WHERE book_id = 1").fetchone())
(Decimal('1290.00'),)
Цена не изменилась: исключение откатило транзакцию. Вложенный блок conn.transaction() создаёт точку сохранения (SAVEPOINT). Контекстный менеджер with psycopg.connect(...) as conn: по выходе фиксирует незавершённую транзакцию (или откатывает её при исключении) и закрывает соединение.
Границу транзакции определяет смысл операции: она охватывает все изменения, вместе переводящие базу в согласованное состояние (списание остатка, заказ и его позиции), и ничего лишнего — ни ожидания пользователя, ни вызова платёжного шлюза, ведь всё это время удерживаются блокировки.
Повтор при ошибке сериализации и взаимоблокировке
На уровнях изоляции Repeatable Read и Serializable PostgreSQL не блокирует конфликтующие транзакции до конца, а позволяет им выполняться и прерывает одну из них ошибкой сериализации (тема 12). Это нормальное поведение, а не сбой: документация прямо требует, чтобы приложение было готово повторить транзакцию, завершившуюся ошибкой с кодом SQLSTATE 40001 (serialization_failure); разумно повторять и транзакции, прерванные при обнаружении взаимоблокировки, код 40P01 (deadlock_detected) 5. В psycopg этим кодам соответствуют классы исключений psycopg.errors.SerializationFailure и psycopg.errors.DeadlockDetected.
Рассмотрим оформление заказа в учебном приложении. Функция выполняет одну попытку в транзакции уровня Serializable: читает остаток, проверяет его, уменьшает и создаёт заказ.
def place_order_once(conn, customer_id, warehouse_id, items):
    with conn.transaction():
        conn.execute("SET TRANSACTION ISOLATION LEVEL SERIALIZABLE")
        for book_id, qty in items:
            row = conn.execute(
                "SELECT quantity FROM bookstore.stock "
                "WHERE warehouse_id = %s AND book_id = %s",
                (warehouse_id, book_id)).fetchone()
            if row is None or row[0] < qty:
                raise OutOfStock(f"книга {book_id}: на складе {row[0] if row else 0}")
            conn.execute(
                "UPDATE bookstore.stock SET quantity = quantity - %s "
                "WHERE warehouse_id = %s AND book_id = %s",
                (qty, warehouse_id, book_id))
        # ... INSERT INTO bookstore.orders ... RETURNING order_id; вставка позиций
    return order_id
Скрипт stress_orders.py устанавливает на складе остаток 10 экземпляров одной книги и запускает 8 потоков, каждый из которых трижды пытается купить один экземпляр. Без повтора результат таков:
поток 1: SerializationFailure: could not serialize access due to concurrent update
попыток покупки: 24
успешно: 3, нет в наличии: 0, ошибок конфликта: 21, повторов: 0
остаток на складе: 7; продано + остаток = 10 (было 10)
Целостность сохранена, но магазин отказал 21 покупателю при наличии товара. Временная диаграмма ниже показывает, что произошло: две транзакции прочитали один остаток, первая изменила его и зафиксировалась, а вторая при изменении той же строки получила ошибку, потому что её снимок устарел.
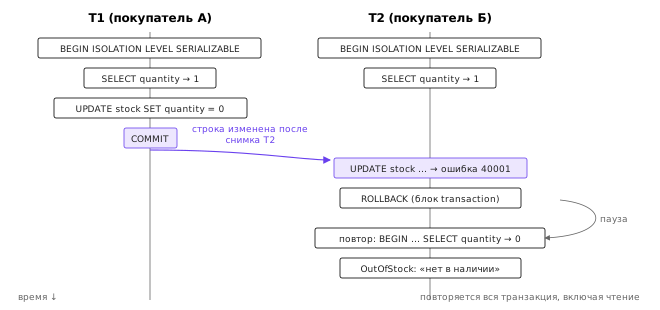
Правильная обработка — повторить всю транзакцию, включая чтения и решения, принятые на их основе: при повторе транзакция получит новый снимок, увидит актуальный остаток и, возможно, примет другое решение (например, сообщит, что товара нет) 5. Повторять только упавший оператор бессмысленно — транзакция уже прервана.
def place_order(conn, customer_id, warehouse_id, items, max_attempts=5):
    for attempt in range(1, max_attempts + 1):
        try:
            return place_order_once(conn, customer_id, warehouse_id, items)
        except (errors.SerializationFailure, errors.DeadlockDetected):
            if attempt == max_attempts:
                raise
            time.sleep(random.uniform(0, 0.005 * 2 ** attempt))
Пауза перед повтором случайна и растёт с номером попытки (англ. exponential backoff with jitter), чтобы конфликтующие транзакции не столкнулись снова; число попыток ограничено. Тот же опыт с повтором:
попыток покупки: 24
успешно: 10, нет в наличии: 14, ошибок конфликта: 0, повторов: 21
остаток на складе: 0; продано + остаток = 10 (было 10)
Продано ровно 10 экземпляров, остальные покупатели получили корректный ответ «нет в наличии». При 16 потоках пяти попыток не хватило части транзакций: повтор лечит редкие конфликты, а для «горячей» строки нужна иная схема. Для этой задачи она известна из темы 12: атомарный UPDATE … SET quantity = quantity - 1 WHERE … AND quantity >= 1 на уровне Read Committed, который ждёт блокировки строки вместо прерывания и не требует повторов.
Повторять можно не всякую ошибку: нарушение CHECK, синтаксическая ошибка или отсутствие прав при повторе возникнут снова. Пограничный случай — нарушение уникальности (23505), иногда тоже вызванное гонкой двух транзакций, выбравших один ключ; его повторяют осторожно 5.
Идемпотентность и внешние эффекты
Повтор безопасен, пока у транзакции нет эффектов вне базы: письмо, отправленное изнутри повторённой транзакции, уйдёт дважды. Поэтому внешние действия выполняют после фиксации, а надёжную доставку обеспечивает приём «исходящей таблицы» (англ. transactional outbox): транзакция записывает задание («отправить письмо о заказе 20031») в таблицу базы, а отдельный процесс выбирает задания (например, с SKIP LOCKED, тема 12) и выполняет их 10.
Тоньше ситуация, когда сервер зафиксировал транзакцию, но ответ на COMMIT потерялся из-за обрыва сети: приложение не знает, была ли фиксация, и повтор создаст второй заказ. Решение — сделать операцию идемпотентной (англ. idempotent), то есть такой, что повторное выполнение не меняет результат. Клиент генерирует для каждой логической операции уникальный ключ (англ. idempotency key), например UUID, и передаёт его с запросом; в таблице заказов этот ключ защищён ограничением уникальности. Повторная вставка с тем же ключом либо отвергается ошибкой уникальности, либо при INSERT … ON CONFLICT (request_key) DO NOTHING молча не выполняется, и приложение находит по ключу уже созданный заказ и возвращает его клиенту 10. Тот же приём используют платёжные API.
Передача данных в запрос
Склейка строк и как возникает SQL-инъекция
В окружении лабораторной работы есть модуль поиска по каталогу, написанный «как в старом проекте». Функция получает от пользователя фрагмент названия и выбранный в интерфейсе столбец сортировки и собирает запрос склейкой строк:
def search_books(conn, text, order_by="title", limit=10):
    query = (
        "SELECT b.book_id, b.title, b.price, b.pub_year "
        "FROM bookstore.book AS b "
        "WHERE b.title ILIKE '%" + text + "%' "
        "ORDER BY b." + order_by + ", b.book_id "
        "LIMIT " + str(limit)
    )
    return conn.execute(query).fetchall()
На обычных запросах функция работает. Но покупатель ищет роман о мушкетёрах и вводит «Д'Артаньян»:
python3 shop.py search "Д'Артаньян"
ошибка базы данных: SyntaxError: syntax error at or near "Артаньян"
LINE 1: ... FROM bookstore.book AS b WHERE b.title ILIKE '%Д'Артаньян%'...
                                                             ^
Причина видна в выводе сервера. Апостроф во вводе пользователя совпал с символом, которым в SQL ограничивается строковая константа. Лексический анализатор сервера прочитал '%Д' как законченную строку, а Артаньян%'… — как продолжение текста запроса, то есть как код, и не смог его разобрать. Данные пользователя стали частью программы на SQL. Здесь это привело к синтаксической ошибке, но суть шире: если ввод может завершить строковую константу, то следующий за апострофом текст сервер интерпретирует как часть запроса, и его содержание определяет не программист, а тот, кто ввёл данные. Это и есть SQL-инъекция (англ. SQL injection) — внедрение постороннего кода в запрос через данные 9. Ровно та же проблема у параметра order_by: его значение вставляется в текст после ORDER BY без всяких кавычек, и функция без возражений принимает любой фрагмент SQL, например price DESC, — значит, примет и всё, что угодно другое.
Через инъекцию можно прочитать, изменить или удалить данные, недоступные через интерфейс приложения, а при избыточных правах приложения — выполнить и административные действия; инъекции десятилетиями остаются среди самых распространённых уязвимостей веб-приложений 9. Ручное «экранирование опасных символов» ненадёжно: легко забыть одно место или неверно учесть правила конкретной СУБД. Правильное решение устраняет саму причину — смешение кода и данных в одной строке.
Параметризованные запросы
Параметризованный запрос (англ. parameterized query) содержит в тексте только заполнители, а значения передаются отдельно. Исправленная функция поиска:
def search_books(conn, text, order_by="title", limit=10):
    ...
    query = sql.SQL(
        "SELECT b.book_id, b.title, b.price, b.pub_year "
        "FROM bookstore.book AS b "
        "WHERE b.title ILIKE %s "
        "ORDER BY {}, b.book_id "
        "LIMIT %s"
    ).format(sql.Identifier("b", order_by))
    return conn.execute(query, ("%" + like_escape(text) + "%", limit)).fetchall()
Что получает сервер? Включим для сеанса журналирование всех операторов (SET log_statement = 'all') и выполним упрощённый параметризованный запрос поиска; в журнале сервера появятся две строки:
LOG:  execute <unnamed>: SELECT book_id, title FROM bookstore.book WHERE title ILIKE $1 LIMIT $2
DETAIL:  parameters: $1 = '%Д''Артаньян%', $2 = '10'
Текст запроса, переданный в сообщении Parse, содержит только $1 и $2; значения пришли в сообщении Bind и в разборе текста не участвовали (апостроф удвоен лишь при печати в журнал) 1. Каким бы ни было значение, оно остаётся значением типа text: защита не в «более тщательном экранировании», а в том, что данные и код идут разными каналами. Такая передача называется привязкой параметров на стороне сервера (англ. server-side binding), и psycopg 3 использует её по умолчанию 3.
Для команд, не принимающих параметров в расширенном протоколе, есть привязка на стороне клиента — класс ClientCursor: драйвер сам оформляет значения как литералы по правилам сервера ('Д''Артаньян').
Принципиальное ограничение параметров: они заменяют только значения — константы в выражениях. Имя таблицы или столбца, ключевое слово ASC/DESC, фрагмент условия параметром передать нельзя: сервер должен знать их на этапе разбора и планирования. Для этих случаев нужен другой инструмент.
Заметим, что исправленная функция экранирует во вводе символы шаблона LIKE — это вопрос корректности, а не безопасности: внутри значения LIKE по-прежнему считает % любой последовательностью символов, а _ — любым символом, и без экранирования поиск «_» находит все книги. Функция like_escape предваряет %, _ и \ обратной косой чертой — символом экранирования LIKE по умолчанию.
Динамические идентификаторы: модуль psycopg.sql
Пользователь выбирает столбец сортировки, и имя столбца приходится вставлять в текст запроса. Безопасный способ — модуль psycopg.sql, который строит запрос из частей разного рода 3: sql.SQL — фрагмент кода, написанный программистом; sql.Identifier — идентификатор, который будет заключён в двойные кавычки с удвоением внутренних кавычек; sql.Literal — значение, оформленное как литерал; sql.Placeholder — заполнитель. Метод as_string показывает итоговый текст:
print(sql.SQL("ORDER BY {}").format(sql.Identifier("b", "price")).as_string(conn))
print(sql.Identifier("price DESC").as_string(conn))
ORDER BY "b"."price"
"price DESC"
Строка price DESC, переданная как идентификатор, превращается в имя столбца "price DESC", которого не существует, — запрос завершится ошибкой, но ни одного постороннего ключевого слова в нём не появится. Это тот же принцип, что у функции format() с %I в PL/pgSQL (тема 14). Но пользователь не должен сортировать по любому столбцу, поэтому исправленная функция сначала сверяет имя со списком разрешённых (англ. allow list) и при несовпадении выбрасывает ValueError, не обращаясь к серверу:
ORDER_COLUMNS = {"title", "price", "pub_year"}

if order_by not in ORDER_COLUMNS:
    raise ValueError(f"недопустимый столбец сортировки: {order_by!r}")
Итоговое правило: значения — только параметрами; идентификаторы — только через sql.Identifier и только из списка разрешённых; ключевые слова (направление сортировки и т. п.) — выбором из фиксированных фрагментов sql.SQL в коде программы. Склеивать запрос с внешними данными нельзя ни в каком виде, включая f-строки. Параметризация не отменяет принципа наименьших привилегий (пятый раздел): он ограничивает ущерб, если ошибка всё же проникнет в код.
Число обращений к серверу: проблема N+1 и пакетная загрузка
Каждый запрос — это обмен по сети, и его задержка (сотни микросекунд в пределах центра обработки данных, миллисекунды между зданиями) складывается с каждым обращением. Типичная ошибка, умножающая эту задержку, — проблема N+1 запросов (англ. N+1 query problem): программа одним запросом получает список из N объектов, а затем для каждого делает ещё один или несколько запросов за связанными данными.
Скрипт report_orders.py строит отчёт по последним заказам: номер, имя покупателя, число позиций и сумма. Наивная версия получает 200 заказов, а затем для каждого запрашивает имя покупателя и позиции — это 1 + 2 · 200 = 401 запрос. Версия с одним запросом соединяет таблицы и группирует на сервере (тема 5):
SELECT o.order_id, c.full_name, count(oi.book_id)::int,
       coalesce(sum(oi.quantity * oi.price), 0)
FROM (SELECT order_id, customer_id, created_at
      FROM bookstore.orders
      ORDER BY created_at DESC, order_id DESC
      LIMIT 200) AS o
JOIN bookstore.customer AS c USING (customer_id)
LEFT JOIN bookstore.order_item AS oi USING (order_id)
GROUP BY o.order_id, o.created_at, c.full_name
ORDER BY o.created_at DESC, o.order_id DESC;
report_n_plus_1: запросов 401, время 91.6 мс
report_one_query: запросов 1, время 11.5 мс
результаты совпадают
На 2000 заказах — 4001 запрос и 967 мс против одного запроса и 26 мс; при сетевой задержке 1 мс наивная версия потратила бы ещё около 4 с только на ожидание ответов. На машине разработчика с десятком тестовых строк проблема незаметна.
Та же логика относится к записи. Загрузка 100 тыс. строк построчными INSERT означает 100 тыс. обменов по сети. Psycopg предлагает два средства. Метод executemany выполняет один оператор со многими наборами параметров, начиная с версии 3.1 — в конвейерном режиме протокола (англ. pipeline mode), когда клиент отправляет следующие команды, не дожидаясь ответов на предыдущие 3. Команда COPY … FROM STDIN передаёт поток строк одной командой в компактном формате, минуя разбор и планирование отдельного оператора для каждой строки (тема 6):
with conn.cursor() as cur:
    with cur.copy("COPY lab15.price_import (isbn, price, quantity) FROM STDIN") as copy:
        for row in rows:
            copy.write_row(row)
Результаты скрипта bulk_load.py для 100 тыс. строк (каждый способ — в одной транзакции; учебный сервер работает с fsync=off, поэтому стоимость фиксации здесь не видна):
| Способ | Время, с | Строк в секунду |
|---|---|---|
цикл с execute | 19,19 | 5 211 |
executemany | 1,75 | 57 103 |
COPY | 0,10 | около 1 млн |
Разница между крайними вариантами — два порядка. Отметим, что если бы построчные вставки выполнялись в режиме автофиксации, каждая из них была бы отдельной транзакцией с ожиданием записи журнала на диск (тема 13), и на обычном сервере с fsync=on разница стала бы ещё больше.
ORM и миграции схемы
Отображение объектов на таблицы
В объектно-ориентированной программе данные представлены объектами со ссылками друг на друга, в базе — строками таблиц, связанными значениями ключей. Преобразование между двумя представлениями называют объектно-реляционным отображением (англ. Object-Relational Mapping, ORM), а библиотеки, выполняющие его автоматически, — ORM-библиотеками. Классификация шаблонов дана в книге М. Фаулера 11: в шаблоне «активная запись» (англ. Active Record) объект сам умеет сохранять себя в базу (Django ORM, Ruby on Rails); в шаблоне «преобразователь данных» (англ. Data Mapper) объекты ничего не знают о базе, а отображение выполняет отдельный слой (SQLAlchemy, Hibernate). Шаблон «ленивая загрузка» (англ. Lazy Load) означает, что связанные объекты читаются из базы при первом обращении к ним.
Самая распространённая ORM для Python — SQLAlchemy 12. В ней таблицам customer и orders соответствуют классы Customer и Order, а связь «один ко многим» описывается атрибутом Customer.orders = relationship(...), через который программа получает список заказов покупателя как обычный список объектов.
Достоинства ORM — меньше однообразного кода и всегда параметризованные запросы. Но ORM скрывает число и вид запросов, и именно здесь рождается проблема N+1. Цикл по 50 покупателям с обращением к c.orders при ленивой загрузке (поведение по умолчанию) порождает 51 запрос. Явное указание стратегии загрузки selectinload(Customer.orders) сводит их к двум: второй запрос получает заказы всех покупателей сразу условием customer_id IN (…). Журнал SQLAlchemy при этом показывает и неявные транзакции:
BEGIN (implicit)
SELECT bookstore.customer.customer_id, ... FROM bookstore.customer WHERE ...
SELECT bookstore.orders.customer_id AS bookstore_orders_customer_id, ...
FROM bookstore.orders
WHERE bookstore.orders.customer_id IN (%(primary_keys_1)s::INTEGER, %(primary_keys_2)s::INTEGER)
ROLLBACK
Сеанс ORM открыл транзакцию при первом запросе и откатил её при закрытии; долгоживущий сеанс держит транзакцию открытой. Практическое правило: включать журнал запросов при разработке, явно задавать стратегии загрузки и переходить к SQL для отчётов и массовых операций.
Миграции и версионирование схемы
Схема меняется вместе с приложением, и изменения должны одинаково воспроизводиться на машинах разработчиков, тестовом и рабочем серверах. Эту задачу решают миграции (англ. schema migrations) — пронумерованные скрипты изменения схемы, хранящиеся в системе контроля версий вместе с кодом 13. В базе ведётся служебная таблица с номерами применённых миграций; инструмент сравнивает её со списком файлов и применяет недостающие по порядку.
В лабораторной работе используется самописный инструмент из нескольких десятков строк. Его служебная таблица:
CREATE TABLE IF NOT EXISTS lab15.schema_migrations (
    version    text PRIMARY KEY,
    checksum   text NOT NULL,
    applied_at timestamptz NOT NULL DEFAULT now()
);
Каждая миграция применяется в одной транзакции вместе с записью о ней. Благодаря транзакционному DDL PostgreSQL (в MySQL большинство команд DDL неявно фиксируют транзакцию) упавшая миграция откатывается полностью. Контрольная сумма обнаруживает правку уже применённой миграции, которая иначе привела бы к расхождению схем.
Промышленные инструменты устроены так же: Alembic для SQLAlchemy генерирует черновик миграции по разнице между моделями и схемой; Flyway и Liquibase распространены в мире Java; sqitch упорядочивает изменения по явным зависимостям и хранит для каждого сценарии применения, отката и проверки. Применённую миграцию не редактируют, а исправляют новой.
Изменение схемы на работающей базе
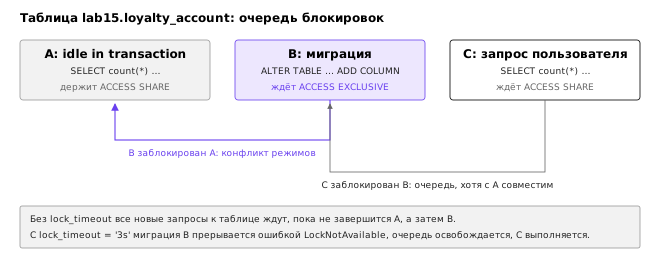
Миграция, мгновенная на пустой базе разработчика, может остановить рабочую базу: большинство вариантов ALTER TABLE требуют блокировки ACCESS EXCLUSIVE, несовместимой даже с чтением (тема 12) 14, и опасна не только длительность команды, но и очередь блокировок. Опыт: сеанс A открыл транзакцию и прочитал таблицу, сеанс B начал миграцию ALTER TABLE … ADD COLUMN, а сеанс C — обычный запрос пользователя — пытается читать ту же таблицу. Представление pg_stat_activity в этот момент:
SELECT pid, wait_event_type, wait_event, left(query, 60) AS query,
       pg_blocking_pids(pid) AS blocked_by
FROM pg_stat_activity
WHERE datname = 'bookstore' AND state <> 'idle' AND pid <> pg_backend_pid()
ORDER BY backend_start;
 pid | wait_event_type | wait_event |                         query                          | blocked_by
-----+-----------------+------------+--------------------------------------------------------+------------
 826 | Client          | ClientRead | SELECT count(*) FROM lab15.loyalty_account             | {}
 829 | Lock            | relation   | ALTER TABLE lab15.loyalty_account ADD COLUMN note text | {826}
 832 | Lock            | relation   | SELECT count(*) FROM lab15.loyalty_account             | {829}
Сеанс C заблокирован не транзакцией A (её ACCESS SHARE с чтением совместима), а ожидающей миграцией B: запрос на ACCESS EXCLUSIVE стоит в очереди, и все последующие запросы выстраиваются за ним (рисунок ниже). Пока A не завершится, таблица недоступна. Защита — параметр lock_timeout: в опыте с lock_timeout = '3s' сеанс B получил LockNotAvailable: canceling statement due to lock timeout, после чего запрос C выполнился. Миграцию затем повторяют.
Кроме ограничения ожидания, существуют приёмы, сокращающие саму блокировку 14:
- добавление столбца с постоянным значением по умолчанию начиная с PostgreSQL 11 не переписывает таблицу и выполняется мгновенно (значение хранится в каталоге), тогда как значение по умолчанию с изменчивой функцией вроде
random()требует перезаписи всей таблицы; - новое ограничение
CHECKили внешний ключ добавляют сNOT VALID(проверяются только новые строки, блокировка короткая), а затем выполняютVALIDATE CONSTRAINT, который проверяет старые строки, не блокируя запись; - индекс создают командой
CREATE INDEX CONCURRENTLY, которая не блокирует запись, но работает дольше и не может выполняться внутри блока транзакции (тема 10) — инструмент миграций должен уметь выполнять такие шаги вне транзакции; - несовместимые изменения (переименование столбца, смена типа) выполняют в несколько выпусков по схеме «расширить — перенести — сузить» (англ. expand and contract): добавить новый столбец, научить приложение писать в оба, перенести данные порциями, переключить чтение, и лишь затем удалить старый столбец 13.
Роли и привилегии
Роли, членство и принцип наименьших привилегий
Все полномочия в PostgreSQL связаны с ролями (англ. role), существующими на уровне кластера. Роль с атрибутом LOGIN может подключаться к серверу, роль без него служит группой для других ролей 7. Атрибуты задают особые полномочия: SUPERUSER снимает все проверки прав, CREATEDB и CREATEROLE разрешают создавать базы и роли, BYPASSRLS позволяет обходить защиту на уровне строк, REPLICATION — подключаться для репликации.
Член групповой роли пользуется её привилегиями; в PostgreSQL 16 у членства три признака: INHERIT (привилегии действуют автоматически), SET (можно переключиться на роль командой SET ROLE), ADMIN (можно управлять членством) 7. Предопределённые роли дают типовые наборы полномочий: pg_read_all_data, pg_write_all_data (с версии 14), pg_monitor.
Главный принцип распределения полномочий — принцип наименьших привилегий (англ. principle of least privilege): каждый участник получает ровно те права, которые нужны для его задачи. Приложение не подключается как суперпользователь или владелец таблиц, права выдаются групповым ролям по функциям, а учётные записи компонентов разделены. Для «Книжного узла» спроектируем три групповые роли и учётные записи для входа:
CREATE ROLE bs_customer NOLOGIN;   -- витрина магазина (действует от имени покупателя)
CREATE ROLE bs_manager  NOLOGIN;   -- менеджер каталога и заказов
CREATE ROLE bs_analyst  NOLOGIN;   -- аналитик: только чтение, без персональных данных

CREATE ROLE shop_web     LOGIN IN ROLE bs_customer;
CREATE ROLE anna_manager LOGIN IN ROLE bs_manager;
CREATE ROLE oleg_analyst LOGIN IN ROLE bs_analyst;
GRANT, REVOKE и привилегии по умолчанию
Владелец объекта (роль, создавшая его) имеет на него все права; остальные получают привилегии командой GRANT и лишаются их командой REVOKE 6. Для таблиц определены привилегии SELECT, INSERT, UPDATE, DELETE, TRUNCATE, REFERENCES и TRIGGER, причём SELECT, INSERT, UPDATE и REFERENCES можно выдавать на отдельные столбцы. Для схемы — USAGE (обращаться к объектам схемы) и CREATE (создавать в ней объекты); без USAGE на схему не помогут никакие права на таблицы. Особая псевдороль PUBLIC означает «все роли».
Выдадим права в соответствии с функциями ролей:
GRANT USAGE ON SCHEMA bookstore TO bs_customer, bs_manager, bs_analyst;

-- Покупатель: каталог, свои заказы, списание остатка.
GRANT SELECT ON bookstore.book, bookstore.author, bookstore.book_author,
                bookstore.category, bookstore.publisher, bookstore.warehouse,
                bookstore.stock TO bs_customer;
GRANT SELECT, INSERT ON bookstore.orders, bookstore.order_item TO bs_customer;
GRANT UPDATE (quantity) ON bookstore.stock TO bs_customer;

-- Менеджер: читает всё, ведёт каталог, меняет только статус заказа.
GRANT SELECT ON ALL TABLES IN SCHEMA bookstore TO bs_manager;
GRANT INSERT, UPDATE ON bookstore.book, bookstore.book_author, bookstore.author,
                        bookstore.stock TO bs_manager;
GRANT UPDATE (status) ON bookstore.orders TO bs_manager;

-- Аналитик: (права на остальные таблицы опущены) без персональных данных покупателей.
GRANT SELECT (customer_id, city, registered_at) ON bookstore.customer TO bs_analyst;
Права хранятся в каталоге в виде списков управления доступом (англ. Access Control List, ACL) и показываются метакомандой \dp:
                                       Access privileges
  Schema   |   Name   | Type  |     Access privileges     |    Column privileges    | Policies
-----------+----------+-------+---------------------------+-------------------------+----------
 bookstore | customer | table | postgres=arwdDxt/postgres+| customer_id:           +|
           |          |       | bs_manager=r/postgres     |   bs_analyst=r/postgres+|
           |          |       |                           | city:                  +|
           |          |       |                           |   bs_analyst=r/postgres+|
           |          |       |                           | registered_at:         +|
           |          |       |                           |   bs_analyst=r/postgres |
Запись bs_manager=r/postgres читается так: роль bs_manager имеет привилегию r (SELECT), выданную ролью postgres; буквы a, w, d, D, x, t означают INSERT, UPDATE, DELETE, TRUNCATE, REFERENCES, TRIGGER 6. Права можно проверить функциями has_table_privilege и has_column_privilege или прямо — переключившись на роль аналитика:
SET ROLE bs_analyst;
SELECT email FROM bookstore.customer LIMIT 1;
SELECT city, count(*) FROM bookstore.customer GROUP BY city ORDER BY 2 DESC LIMIT 2;
RESET ROLE;
ERROR:  permission denied for table customer
  city  | count
--------+-------
 Москва |  1125
 Самара |   593
Права на столбцы — простой способ скрыть персональные данные. Тонкость: GRANT … ON ALL TABLES IN SCHEMA действует только на уже существующие таблицы. Для будущих объектов задают привилегии по умолчанию:
ALTER DEFAULT PRIVILEGES IN SCHEMA bookstore GRANT SELECT ON TABLES TO bs_analyst;
Привилегии по умолчанию применяются к объектам, которые создаст роль, выполнившая команду (или роль, указанная в FOR ROLE), и показываются метакомандой \ddp 6. Ещё одна тонкость касается UPDATE и DELETE с условием: для чтения столбцов в WHERE нужна привилегия SELECT на эти столбцы, поэтому одного UPDATE для типичного изменения недостаточно.
Схемы и search_path
Имя объекта без указания схемы разрешается по пути поиска search_path, по умолчанию "$user", public (тема 9). Это и вопрос безопасности: роль, способная создавать объекты в схеме, стоящей в пути раньше нужной, может подменить таблицу или функцию одноимённой. До PostgreSQL 15 все роли по умолчанию имели право CREATE в схеме public; начиная с версии 15 это право у PUBLIC отозвано (осталось только USAGE), а схема принадлежит роли pg_database_owner — владельцу базы 6. Для приложений рекомендуются две меры: обращаться к объектам по полным именам (bookstore.book) или задавать роли приложения фиксированный путь (ALTER ROLE shop_web SET search_path = bookstore), а функциям с SECURITY DEFINER — всегда явный SET search_path (тема 14).
Защита на уровне строк
Привилегии отвечают на вопрос «к каким таблицам и столбцам есть доступ», но не «к каким строкам». Покупатель должен видеть только свои заказы; если эта проверка написана в приложении, одна забытая WHERE customer_id = … открывает чужие данные. Защита на уровне строк (англ. Row-Level Security, RLS), появившаяся в PostgreSQL 9.5, переносит её в базу: таблице назначаются политики (англ. policies) — условия, которые сервер сам добавляет к каждому запросу 6.
Политика задаётся командой CREATE POLICY с двумя выражениями: USING фильтрует существующие строки, которые запрос может видеть, изменять или удалять; WITH CHECK проверяет новые и изменённые строки при INSERT и UPDATE. У тысяч покупателей нет своих ролей, поэтому приложение сообщает базе идентификатор покупателя через пользовательский параметр конфигурации:
ALTER TABLE bookstore.orders ENABLE ROW LEVEL SECURITY;

CREATE POLICY orders_customer ON bookstore.orders
    FOR ALL TO bs_customer
    USING (customer_id = NULLIF(current_setting('app.customer_id', true), '')::int)
    WITH CHECK (customer_id = NULLIF(current_setting('app.customer_id', true), '')::int);
Второй аргумент true функции current_setting означает «вернуть NULL, если параметр не задан» вместо ошибки, а NULLIF защищает от пустой строки, которую параметр сохраняет после RESET. В обоих случаях условие даёт NULL и покупатель не видит ничего. Приложение задаёт идентификатор на время транзакции:
BEGIN;
SET LOCAL ROLE bs_customer;
SELECT set_config('app.customer_id', '42', true);
SELECT order_id, created_at::date, status FROM bookstore.orders ORDER BY created_at LIMIT 5;
SELECT count(*) FROM bookstore.orders;
INSERT INTO bookstore.orders (customer_id, warehouse_id) VALUES (43, 1);
 order_id | created_at |  status
----------+------------+-----------
     6903 | 2022-03-31 | delivered
     8195 | 2022-04-04 | delivered
    13414 | 2022-05-07 | delivered
     3240 | 2022-07-02 | delivered
    10664 | 2022-08-14 | delivered
(5 rows)

 count
-------
    22
(1 row)

ERROR:  new row violates row-level security policy for table "orders"
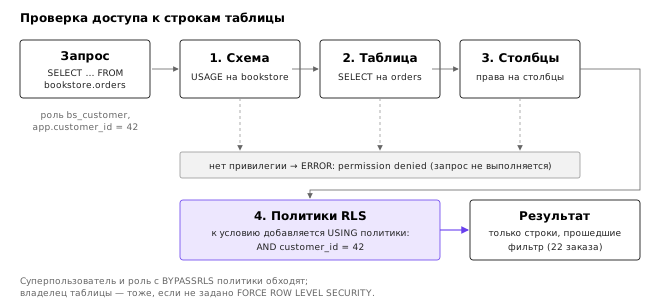
Запрос без всякого WHERE вернул только 22 заказа покупателя 42, а попытка создать заказ от имени покупателя 43 отвергнута предложением WITH CHECK. Третий аргумент true в set_config делает установку локальной для транзакции, и при пуле соединений идентификатор не «перейдёт» к следующему клиенту. План запроса показывает, что условие политики просто добавлено к условию запроса:
EXPLAIN (COSTS OFF) SELECT count(*) FROM bookstore.orders WHERE status = 'delivered';
 Aggregate
   ->  Seq Scan on orders
         Filter: ((status = 'delivered'::text) AND (customer_id = (NULLIF(current_setting('app.customer_id'::text, true), ''::text))::integer))
Поэтому для таблиц с RLS индекс по столбцу из политики так же важен, как индекс по столбцу из обычного условия (тема 10).
Правила работы RLS 6. После ENABLE ROW LEVEL SECURITY действует запрет по умолчанию: роль без применимой политики не видит ни одной строки, и, включив RLS только с политикой для покупателей, легко «сломать» отчёты — аналитик получит count = 0 вместо 20 000. Для персонала нужны собственные политики (например, USING (true)). Несколько разрешающих политик (PERMISSIVE, по умолчанию) объединяются через OR, ограничивающие (AS RESTRICTIVE) — через AND. Суперпользователи и роли с атрибутом BYPASSRLS всегда обходят политики; владелец таблицы обходит их, пока для таблицы не задано ALTER TABLE … FORCE ROW LEVEL SECURITY. Отсюда практическое следствие: приложение должно работать под ролью, которая не является ни суперпользователем, ни владельцем таблиц и не имеет BYPASSRLS, — иначе политики не действуют. Наконец, подзапрос внутри политики к другой таблице с RLS сам проходит через её политики; так удобно защитить позиции заказов: USING (EXISTS (SELECT 1 FROM bookstore.orders o WHERE o.order_id = order_item.order_id)).
Схема на рисунке ниже сводит проверки, через которые проходит запрос: сначала привилегии на схему, таблицу и столбцы, затем фильтр политик.
Аутентификация, защита канала и персональные данные
pg_hba.conf: кто, откуда и каким методом
Аутентификация (англ. authentication) — проверка того, что клиент действительно является той ролью, под именем которой подключается; авторизация (англ. authorization) — проверка полномочий этой роли, рассмотренная выше. Правила аутентификации PostgreSQL задаются в файле pg_hba.conf (от англ. host-based authentication) 7. Каждая строка файла содержит тип подключения (local — сокет Unix, host — TCP с TLS или без, hostssl — только TLS, hostnossl — только без TLS), базу, роль, адрес клиента (для TCP) и метод аутентификации. Сервер просматривает строки сверху вниз и применяет первую подходящую; если ни одна не подошла, подключение отвергается. Изменения вступают в силу после SELECT pg_reload_conf().
Пример правил для учебного магазина:
# TYPE   DATABASE   USER          ADDRESS          METHOD
local    all        postgres                       peer
hostssl  bookstore  shop_web      10.0.1.0/24      scram-sha-256
hostssl  bookstore  +bs_analyst   10.0.5.0/24      scram-sha-256
host     all        all           0.0.0.0/0        reject
Администратор postgres входит только локально по методу peer: сервер узнаёт у операционной системы имя пользователя процесса на другом конце сокета. Веб-приложение подключается только из своей подсети и только по TLS; +bs_analyst означает «любая роль из группы bs_analyst»; последняя строка запрещает всё остальное. Метод trust впускает без проверки и допустим только на изолированной учебной машине — так настроен кластер, на котором проверялись примеры темы:
SELECT type, database, user_name, address, auth_method FROM pg_hba_file_rules;
 type  |   database    | user_name |  address  | auth_method
-------+---------------+-----------+-----------+-------------
 local | {all}         | {all}     |           | trust
 host  | {all}         | {all}     | 127.0.0.1 | trust
 host  | {all}         | {all}     | ::1       | trust
...
(6 rows)
Представление показывает, как сервер разобрал текущий файл, и в столбце error сообщает об ошибках ещё до перечитывания конфигурации 7.
SCRAM-SHA-256 и хранение паролей
Парольный метод не должен ни передавать пароль по сети в открытом виде, ни хранить на сервере то, чем можно воспользоваться для входа. Метод password передаёт пароль открытым текстом и допустим лишь внутри TLS. Устаревший метод md5 хранит хеш MD5 от пароля и имени роли; украденного хеша достаточно для входа, а сам алгоритм MD5 давно не считается стойким 7.
Рекомендуемый метод — scram-sha-256, реализация механизма SCRAM (англ. Salted Challenge Response Authentication Mechanism) с функцией SHA-256 8. Сервер хранит не пароль, а производные ключи: из пароля, случайной соли и числа итераций вычисляется SaltedPassword, из него — StoredKey и ServerKey. При входе стороны обмениваются случайными числами (англ. nonce), клиент доказывает знание пароля подписью от параметров обмена, сервер в ответ доказывает знание ключа — проверка взаимная. По сети не передаётся ничего пригодного для повторного входа, а украденные StoredKey и ServerKey не позволяют выдать себя за клиента 8.
Формат хранения можно увидеть в каталоге pg_authid (доступен только суперпользователю):
ALTER ROLE shop_web PASSWORD 'учебный-пароль';
SELECT rolname, left(rolpassword, 40) || '…' AS rolpassword
FROM pg_authid WHERE rolname = 'shop_web';
 rolname  |                rolpassword
----------+-------------------------------------------
 shop_web | SCRAM-SHA-256$4096:FJ3+3nt7RLeSxJe0vFZ0I…
Строка содержит название механизма, число итераций (4096; параметр scram_iterations появился в PostgreSQL 16), соль и ключи. С версии 14 password_encryption по умолчанию равен scram-sha-256; если в pg_hba.conf указан md5, а пароль хранится в формате SCRAM, сервер использует SCRAM 7. Пароль лучше менять метакомандой \password в psql: она вычисляет ключи на клиенте, и пароль не попадает в журнал сервера.
Шифрование соединения, аудит и персональные данные
SCRAM защищает пароль, но не данные запросов и результатов. Шифрование канала обеспечивает протокол TLS (англ. Transport Layer Security): на сервере включается ssl = on с сертификатом и ключом, а тип hostssl в pg_hba.conf запрещает подключения без шифрования. Параметр клиента sslmode по умолчанию равен prefer — TLS, если сервер его поддерживает, но без проверки сертификата. Защиту от подмены сервера даёт только режим verify-full, при котором клиент проверяет, что сертификат подписан доверенным центром и выдан на имя сервера, к которому выполняется подключение 2. Параметр channel_binding=require дополнительно связывает аутентификацию SCRAM с конкретным каналом TLS.
Классификация защищаемых данных и нормативные требования
В современных базах данных хранятся разнородные активы, требующие дифференцированного уровня защиты в соответствии с отраслевыми стандартами и законодательством:
- Персональные данные (Personally Identifiable Information, PII): ФИО, паспортные данные, номера телефонов, адреса электронной почты и доставки, история заказов. В России обработка регулируется Федеральным законом № 152-ФЗ «О персональных данных», в Евросоюзе — регламентом GDPR. Нарушение требований влечёт крупные штрафы и блокировку сервиса.
- Данные платежных карт (Cardholder Data / PCI DSS): первичный номер банковской карты (PAN), срок действия, имя держателя карты 15. Международный стандарт PCI DSS категорически запрещает хранение чувствительных данных аутентификации (CVV2/CVC2-кодов и PIN-блоков) в базе данных после проведения авторизации транзакции. Номера карт в базе должны быть зашифрованы сильными криптографическими алгоритмами (AES-256) либо усечены (отображение только первых 6 и последних 4 цифр).
- Защищаемая медицинская тайна (Protected Health Information, PHI): сведения о диагнозах, рецептах, посещениях врачей (в США регулируется актом HIPAA, в РФ — 323-ФЗ).
Управление доступом к таким данным строится на трёх классических моделях:
- Дискреционный контроль (DAC): права
GRANTиREVOKEна уровне таблиц и столбцов; - Ролевой контроль (RBAC): объединение прав в роли аналитиков, операторов склада, биллинга;
- Атрибутивный контроль (ABAC): динамическое вычисление прав на основе атрибутов субъекта и объекта через политики
Row-Level Security(RLS), где условие доступа зависит от текущего пользователя, времени суток или статуса заказа 6.
Маскирование данных: статическое и динамическое
Для предотвращения утечек конфиденциальной информации применяется маскирование данных (Data Masking):
- Статическое маскирование (Static Data Masking): необратимая подмена реальных персональных данных синтетическими или зашумлёнными при создании дампа рабочей базы для разработчиков, тестировщиков и аналитиков. Имена заменяются генератором случайных имён, телефоны и email обнуляются или хешируются с солью. Это исключает компрометацию данных при взломе тестового контура.
- Динамическое маскирование (Dynamic Data Masking): преобразование чувствительных полей «на лету» в момент выполнения запроса в зависимости от роли клиента. Например, администратор базы или финансовый сервис видит полный номер телефона клиента, а стажёр службы поддержки — маскированное значение:
-- Представление с динамическим маскированием email и телефона
CREATE OR REPLACE VIEW bookstore.v_customer_masked AS
SELECT
    customer_id,
    name,
    CASE
        WHEN pg_has_role(current_user, 'bs_manager', 'MEMBER') THEN email
        ELSE regexp_replace(email, '(?<=.).(?=.*@)', '*', 'g')
    END AS email,
    CASE
        WHEN pg_has_role(current_user, 'bs_manager', 'MEMBER') THEN phone
        ELSE overlay(phone placing '******' from 5 for 6)
    END AS phone
FROM bookstore.customer;
Аудит безопасности и модуль pgaudit
Штатные параметры сервера log_statement = 'all' непригодны для промышленного аудита: они перегружают дисковую подсистему мусорным трафиком, журналируют внутренние системные запросы и, что хуже всего, записывают открытые пароли и персональные данные прямо в системный лог.
Для выполнения требований регуляторов (PCI DSS, 152-ФЗ, СТО БР ИББС) в PostgreSQL используется специализированное открытое расширение pgAudit (PostgreSQL Audit Extension) 16. pgAudit перехватывает команды на этапе планирования и формирует структурированные записи аудита с детализацией по классам:
READ: выборкиSELECTиз таблиц;WRITE: модификацииINSERT,UPDATE,DELETE,TRUNCATE;ROLE: команды управления ролями и привилегиями (GRANT,REVOKE,CREATE ROLE);DDL: изменение схемы данных (CREATE TABLE,ALTER TABLE,DROP);FUNCTION: вызовы хранимых процедур и расширений.
Пример настройки аудита в postgresql.conf:
shared_preload_libraries = 'pgaudit'
pgaudit.log = 'write, role, ddl'
pgaudit.log_catalog = off
pgaudit.log_relation = on
pgaudit.log_parameter = on
Директива pgaudit.log_relation = on гарантирует, что в журнале аудита будет зафиксировано точное имя затронутой таблицы и перечень прочитанных столбцов, что обеспечивает доказательную базу при расследовании утечек информации службой безопасности.
Итоги темы
Приложение работает с PostgreSQL по протоколу клиент — сервер, в расширенном режиме которого текст запроса и значения параметров передаются разными сообщениями. Соединение обслуживается отдельным процессом сервера и стоит дорого, поэтому используются пулы соединений, а при многих экземплярах приложения — PgBouncer, транзакционный режим которого требует не хранить состояние в сеансе. Параметры подключения и пароли приходят из окружения, ~/.pgpass или хранилища секретов, но не из исходного кода.
Границы транзакции определяются смыслом операции и задаются явно; на уровнях Repeatable Read и Serializable приложение обязано повторять транзакцию целиком при ошибках 40001 и 40P01, ограничивая число попыток. Внешние эффекты выносятся за пределы повторяемой транзакции, а неопределённость фиксации снимается ключами идемпотентности.
Данные передаются в запрос только параметрами: склейка строк смешивает код и данные, и апостроф в «Д'Артаньян» ломает запрос по той же причине, по которой возможна SQL-инъекция. Идентификаторы оформляются через sql.Identifier и сверяются со списком разрешённых. Число обращений к серверу — самостоятельный ресурс: N+1 и построчная загрузка лечатся соединениями на сервере, executemany и COPY. ORM ускоряет разработку, но скрывает запросы и транзакции; миграции делают изменения схемы воспроизводимыми, а lock_timeout, NOT VALID и CREATE INDEX CONCURRENTLY позволяют менять схему работающей базы.
Безопасность строится слоями — pg_hba.conf и SCRAM-SHA-256, TLS с проверкой сертификата, роли и привилегии по принципу наименьших привилегий, защита на уровне строк, аудит, — и ни один слой не достаточен в одиночку. Заключительная тема 16 выходит за пределы одного сервера: масштабирование, распределённые транзакции, NoSQL и аналитические системы.
Литература
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 55. Frontend/Backend Protocol. — 2024. https://www.postgresql.org/docs/16/protocol.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 34. libpq — C Library (34.1. Database Connection Control Functions; 34.16. The Password File; 34.19. SSL Support). — 2024. https://www.postgresql.org/docs/16/libpq-connect.html
- Psycopg 3 Documentation (Basic module usage; Transactions management; Server-side binding; Connection pools; psycopg.sql — SQL string composition). — 2025. https://www.psycopg.org/psycopg3/docs/
- PgBouncer Documentation. Features; Configuration. — 2025. https://www.pgbouncer.org/features.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 13.5. Serialization Failure Handling. — 2024. https://www.postgresql.org/docs/16/mvcc-serialization-failure-handling.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 5.7. Privileges; 5.8. Row Security Policies; 5.9. Schemas. — 2024. https://www.postgresql.org/docs/16/ddl-priv.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 21. Client Authentication; Chapter 22. Database Roles. — 2024. https://www.postgresql.org/docs/16/client-authentication.html
- Hansen T. SCRAM-SHA-256 and SCRAM-SHA-256-PLUS Simple Authentication and Security Layer (SASL) Mechanisms. — RFC 7677, IETF, 2015. https://www.rfc-editor.org/rfc/rfc7677
- OWASP Foundation. SQL Injection Prevention Cheat Sheet. — OWASP Cheat Sheet Series. https://cheatsheetseries.owasp.org/cheatsheets/SQL_Injection_Prevention_Cheat_Sheet.html
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017. (Рус. пер.: Клеппман М. Высоконагруженные приложения. Программирование, масштабирование, поддержка. — СПб.: Питер, 2018.)
- Fowler M. Patterns of Enterprise Application Architecture. — Addison-Wesley, 2002.
- SQLAlchemy 2.0 Documentation. ORM Querying Guide: Relationship Loading Techniques. — 2025. https://docs.sqlalchemy.org/en/20/orm/queryguide/relationships.html
- Ambler S. W., Sadalage P. J. Refactoring Databases: Evolutionary Database Design. — Addison-Wesley, 2006.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. 13.3. Explicit Locking; ALTER TABLE. — 2024. https://www.postgresql.org/docs/16/explicit-locking.html
- PCI Security Standards Council. Payment Card Industry (PCI) Data Security Standard, v4.0. — 2022.
- pgAudit Project. pgAudit: Open Source PostgreSQL Audit Logging. — 2025. https://www.pgaudit.org/