
За пределами одного сервера: масштабирование, NoSQL и аналитические системы
Все предыдущие темы курса рассматривали одну базу данных на одном сервере: модель и язык, проектирование, индексы и планы, транзакции, журнал и восстановление, серверную логику и работу из приложения. Даже реплика из темы 13 была лишь копией того же сервера, проигрывающей его журнал. Для большинства информационных систем этого достаточно: один хорошо настроенный сервер PostgreSQL обслуживает базы в сотни гигабайт и тысячи транзакций в секунду.
Когда одного сервера не хватает — данные не помещаются на диски, поток записи превышает возможности одного журнала, пользователи на разных континентах, простой недопустим, — строят распределённую систему, данные которой хранятся на нескольких узлах. Гарантии, которые одна СУБД давала «даром» (атомарность транзакции, видимость зафиксированных изменений, единая точка истины), становятся предметом отдельных протоколов, а сеть добавляет новый вид отказа: узлы живы, но не могут связаться. Параллельно возникли системы с другими моделями данных — ключ-значение, документы, широкие колонки, графы — и аналитические СУБД, иначе хранящие те же таблицы.
Первый раздел темы описывает масштабирование и шардирование, второй — распределённые транзакции, теорему CAP, модели согласованности и консенсус, третий — модели NoSQL в сравнении с реляционной на «Книжном узле», четвёртый — полнотекстовый поиск как специализированную модель внутри PostgreSQL, пятый — аналитические системы и колоночное хранение. Примеры выполнены в PostgreSQL 16 на учебной базе (scale=1); для опытов с шардами использованы базы shard0 и shard1 на двух серверах PostgreSQL, которые создают скрипты лабораторной работы.
Масштабирование: от одного сервера к шардам
Вертикальное масштабирование и реплики для чтения
Масштабируемость (англ. scalability) — способность системы справляться с ростом нагрузки добавлением ресурсов; нагрузку описывают объёмом данных, числом операций чтения и записи в секунду, числом соединений, требуемым временем ответа 1.
Вертикальное масштабирование (англ. scale up) — более мощный сервер. Приложение не меняется, все гарантии одной СУБД сохраняются; ограничения — предел одной машины, стоимость, растущая быстрее производительности, и единая точка отказа. Это первый и часто достаточный шаг, особенно если сначала убедиться, что запросы используют индексы (тема 10), планы разумны (тема 11), а соединения идут через пул (тема 15).
Горизонтальное масштабирование (англ. scale out) добавляет машины. Если узкое место — чтение, используются реплики для чтения: физические реплики из темы 13 в режиме горячего резерва принимают отчёты и выборки каталога. Запись по-прежнему идёт на один сервер, а каждая реплика хранит полную копию, так что ни запись, ни объём данных реплики не масштабируют.
Реплики привносят первую проблему распределённой системы — отставание (replay_lag в pg_stat_replication, тема 13). Покупатель, оставивший отзыв и обновивший страницу, может не увидеть его, если чтение попало на отстающую реплику: нарушено свойство «чтение своих записей» (англ. read-your-writes) 1. Решения: читать только что изменённые данные с основного сервера; запоминать позицию журнала после записи (pg_current_wal_lsn()) и читать с реплики, лишь когда она её достигла (pg_last_wal_replay_lsn()); синхронная репликация с synchronous_commit = remote_apply ценой задержки каждой фиксации.
Шардирование и выбор ключа
Когда не хватает места или пропускной способности записи, данные делят между серверами. Шардирование (англ. sharding, в литературе также horizontal partitioning) — разбиение строк таблицы на непересекающиеся части, шарды (англ. shards), хранящиеся на разных узлах 1. Это секционирование из темы 9, секции которого живут на разных машинах.
Принадлежность строки шарду определяет ключ шардирования (англ. shard key, distribution column). Способов сопоставить значению ключа шард три:
- по диапазону (англ. range sharding): шард получает интервал значений ключа. Запросы по диапазону затрагивают немного шардов, но монотонно растущий ключ (время заказа, последовательный идентификатор) направляет всю новую запись на последний шард — образуется «горячая точка» (англ. hot spot);
- по хешу (англ. hash sharding): шард определяется хеш-функцией от ключа. Нагрузка распределяется равномерно, но запрос по диапазону ключа приходится отправлять на все шарды;
- по справочнику (англ. directory-based): отдельная таблица соответствия «ключ — шард», которую можно менять произвольно, но которая сама становится критическим компонентом.
Выбор ключа — главное и труднообратимое решение. Хороший ключ имеет много значений с равномерной нагрузкой и совпадает с условием большинства запросов, чтобы запрос обслуживался одним шардом. Для «Книжного узла» это customer_id: заказы, позиции, платежи и бонусный счёт относятся к покупателю, и на его шарде обслуживаются история заказов, оформление заказа и личный кабинет. Такое размещение связанных строк разных таблиц на одном шарде называется совместным размещением (англ. co-location) 14. Небольшие и редко изменяемые таблицы, нужные везде, — книги, рубрики, склады — копируются на все шарды целиком как справочные (англ. reference tables).
Скрипт лабораторной работы раскладывает покупателей по двум шардам по правилу «CRC32 от customer_id по модулю числа шардов» и переносит вместе с покупателем его заказы и позиции:
Шардов: 2
  шард 0: dbname=shard0
  шард 1: dbname=shard1 port=5418
book        строк по шардам: 2010, 2010
customer    строк по шардам: 2500, 2500
orders      строк по шардам: 10133, 9867
order_item  строк по шардам: 30353, 29557
account     строк по шардам: 2500, 2500
Хеш распределил покупателей поровну, заказы — почти поровну. Внешние ключи orders → customer, order_item → orders и order_item → book проверяются локально: связанные строки лежат на одном шарде, а справочная book есть на обоих. Уникальность email же гарантирована теперь только в пределах шарда; глобальная уникальность требует отдельной глобальной таблицы или распределённой транзакции.
Хеширование распределяет ключи, но не нагрузку внутри одного ключа — от перекоса (англ. skew) оно не спасает. «Войну и мир» купили 982 из 4342 покупателей с неотменёнными заказами; при шардировании по book_id все её продажи пришлись бы на один шард. «Горячие» ключи дополнительно дробят (ключ плюс случайный суффикс) ценой усложнения чтения 1.
Перебалансировка
При добавлении узлов правило «хеш по модулю N» коварно: при переходе от N к N + 1 шардам остаток меняется у большинства ключей. Скрипт rebalance.py лабораторной работы подсчитывает долю переехавших покупателей из 5000 для трёх схем распределения:
$ python3 rebalance.py 2 3
mod N    переехало  3344 из 5000 ( 66.9 %); ключей по шардам после: 1675 1603 1722
кольцо   переехало  1942 из 5000 ( 38.8 %); ключей по шардам после: 1517 1541 1942
слоты    переехало  1640 из 5000 ( 32.8 %); ключей по шардам после: 1680 1680 1640
Идеал: переезжает 1/3 ключей = 33.3 %
При «mod N» переезжают две трети ключей, а при переходе от 4 к 5 шардам — 80,2 %, хотя достаточно перевезти пятую часть. Две другие схемы приближаются к этому идеалу. Согласованное хеширование (англ. consistent hashing) размещает на «кольце» значений хеш-функции и ключи, и узлы; ключ принадлежит ближайшему по ходу кольца узлу, поэтому новый узел забирает ключи только у своих соседей 12. Чтобы нагрузка была равномерной, каждый узел представлен на кольце многими виртуальными узлами; при 64 виртуальных узлах на шард разброс в опыте всё ещё заметен. Этот приём использует Amazon Dynamo и наследующие ему системы, например Cassandra 5.
Третья схема — фиксированное число логических секций (слотов), значительно большее числа узлов. Ключ всегда попадает в один и тот же слот (хеш по модулю числа слотов, которое не меняется), а узлам назначаются целые слоты; при добавлении узла ему передаются несколько слотов вместе с данными. Так устроены Redis Cluster (16 384 слота) и Citus, в котором распределённая таблица по умолчанию делится на 32 шарда, распределяемых по рабочим узлам 14. Сама перевозка идёт при продолжающейся записи: шард копируется, изменения догоняются (например, логической репликацией из темы 13), затем переключается маршрутизация.
Запросы, затрагивающие несколько шардов
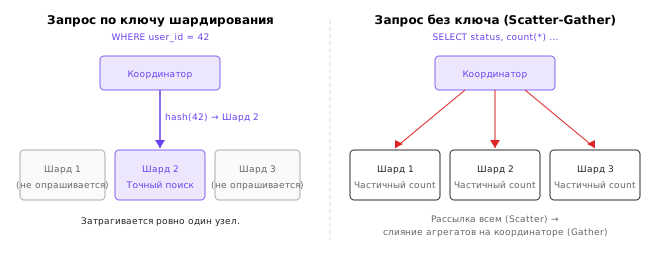
Запрос с условием на ключ шардирования маршрутизатор отправляет на один шард. Запрос без такого условия — «сколько экземпляров книги 4 продано» — приходится разослать всем шардам и объединить ответы. Эта схема называется «разослать и собрать» (англ. scatter-gather); время ответа определяется самым медленным шардом, а нагрузку несут все узлы. Схема показана на рисунке.
Объединение частичных результатов — источник тонких ошибок. Сумма и количество разложимы: итог равен сумме частичных итогов. Среднее напрямую не разложимо: среднее средних неверно, если в шардах разное число строк, поэтому шарды возвращают пару (сумма, количество), а деление выполняется после объединения. Медиана, число различных значений и «первые k» не разложимы вовсе: город может быть четвёртым по выручке на обоих шардах и первым в сумме. В лабораторной работе предлагается найти обе ошибки в готовом отчёте. Соединение совместно размещённых таблиц и соединение со справочной таблицей выполняются на каждом шарде локально, а соединение таблиц, распределённых по разным ключам, требует пересылки строк между узлами (англ. shuffle) — самой дорогой операции распределённой СУБД.
Часть этой механики есть в самом PostgreSQL. Секционированная по хешу таблица (тема 9) может иметь секции — сторонние таблицы (англ. foreign tables) расширения postgres_fdw, расположенные на другом сервере. Создадим таблицу покупателей из двух секций, вторая из которых находится на втором сервере PostgreSQL (в опыте — на той же машине, порт 5418, каталог сокета /tmp/aidt-pg; в его базе shard1 заранее создана таблица customer_p1 той же структуры). Сторонний сервер описывается командой CREATE SERVER, а учётные данные для подключения — командой CREATE USER MAPPING:
CREATE EXTENSION postgres_fdw;
CREATE SERVER shard1_srv FOREIGN DATA WRAPPER postgres_fdw
    OPTIONS (host '/tmp/aidt-pg', port '5418', dbname 'shard1');
CREATE USER MAPPING FOR CURRENT_USER SERVER shard1_srv OPTIONS (user 'postgres');
CREATE TABLE lab16.customer_sh (
    customer_id integer NOT NULL, email text NOT NULL,
    full_name text NOT NULL, city text
) PARTITION BY HASH (customer_id);
CREATE TABLE lab16.customer_sh0 PARTITION OF lab16.customer_sh
    FOR VALUES WITH (MODULUS 2, REMAINDER 0);
CREATE FOREIGN TABLE lab16.customer_sh1 PARTITION OF lab16.customer_sh
    FOR VALUES WITH (MODULUS 2, REMAINDER 1)
    SERVER shard1_srv OPTIONS (schema_name 'public', table_name 'customer_p1');
INSERT INTO lab16.customer_sh SELECT customer_id, email, full_name, city FROM bookstore.customer;
Вставка распределила 2499 покупателей в локальную секцию и 2501 — на второй сервер. Запрос по ключу отсекает лишние секции, и если нужная секция удалённая, условие передаётся на другой сервер:
EXPLAIN (VERBOSE, COSTS OFF)
SELECT full_name, city FROM lab16.customer_sh WHERE customer_id = 3;
                                       QUERY PLAN
----------------------------------------------------------------------------------------
 Foreign Scan on lab16.customer_sh1 customer_sh
   Output: customer_sh.full_name, customer_sh.city
   Remote SQL: SELECT full_name, city FROM public.customer_p1 WHERE ((customer_id = 3))
Группировка без условия на ключ читает обе секции. С параметром enable_partitionwise_aggregate = on планировщик строит для неё план «разослать и собрать»: узлы Partial HashAggregate над каждой секцией и общий Finalize HashAggregate. Однако в PostgreSQL 16 частичный агрегат по сторонней секции вычисляется на локальном сервере: в строке Remote SQL плана стоит SELECT city FROM public.customer_p1, то есть удалённый сервер передаёт все значения. Полноценные распределённые СУБД выполняют агрегацию на узлах. Расширение Citus превращает PostgreSQL в такую систему: координатор хранит метаданные и планирует запросы, рабочие узлы хранят шарды, таблица распределяется вызовом create_distributed_table('orders', 'customer_id'), справочная — create_reference_table('book'), а фрагменты запросов выполняются на рабочих узлах параллельно 14. В учебной среде Citus не установлен, поэтому он описан по документации.
Распределённые транзакции и согласованность
Двухфазная фиксация
Пусть покупатель 42 (шард 0) переводит 100 бонусных рублей покупателю 4 (шард 1). На двух серверах это две независимые транзакции, которые могут завершиться по-разному: списание зафиксировано, зачисление отвергнуто — и 100 рублей исчезли.
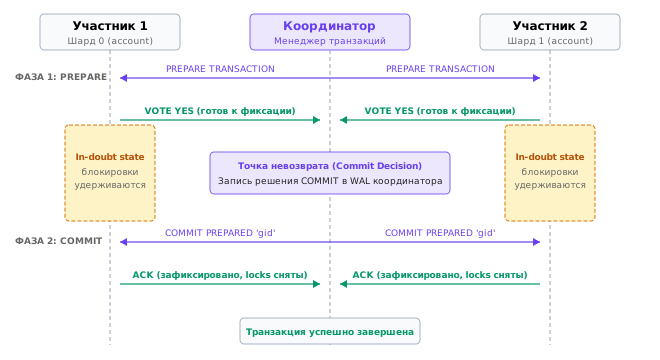
Классическое решение — протокол двухфазной фиксации (англ. two-phase commit, 2PC) 19. Координатор (англ. coordinator) — приложение или узел, начавший транзакцию; участники (англ. participants) — серверы, выполняющие её части. Когда участники выполнили работу:
- Фаза подготовки. Координатор посылает каждому участнику запрос «подготовиться». Участник проверяет, что может зафиксировать транзакцию, сбрасывает на диск всё необходимое и отвечает «да», после чего уже не вправе отменить её сам: он обещает зафиксировать её по требованию даже после перезапуска.
- Фаза фиксации. Если все ответили «да», координатор записывает решение «фиксировать» в свой журнал и рассылает команду фиксации; если хоть один ответил «нет» или не ответил — рассылает отмену.
Запись решения в журнал координатора — точка невозврата, после которой координатор обязан довести фиксацию до всех участников даже после своего сбоя (рисунок).
PostgreSQL выступает участником 2PC с помощью команд PREPARE TRANSACTION 'gid', COMMIT PREPARED 'gid' и ROLLBACK PREPARED 'gid', где gid — глобальный идентификатор, выбираемый координатором 9. Координатор PostgreSQL не реализует: им служит менеджер транзакций приложения, расширение (Citus) или скрипт. По умолчанию возможность выключена: параметр max_prepared_transactions равен 0, и PREPARE TRANSACTION завершается ошибкой prepared transactions are disabled; параметр меняется только с перезапуском сервера.
После ALTER SYSTEM SET max_prepared_transactions = 10 и перезапуска подготовим списание на шарде 0 (баланс покупателя 42 до операции — 5660.47):
BEGIN;
UPDATE shop.account SET balance = balance - 100 WHERE customer_id = 42;
PREPARE TRANSACTION 'xfer-42-4';
SELECT gid, transaction, prepared, owner, database FROM pg_prepared_xacts;
    gid    | transaction |           prepared            |  owner   | database
-----------+-------------+-------------------------------+----------+----------
 xfer-42-4 |       21585 | 2026-10-17 20:37:38.868537+03 | postgres | shard0
Команда PREPARE TRANSACTION отсоединяет транзакцию от сеанса: её состояние записано на диск, и она переживает даже аварийный перезапуск сервера. Её изменения не видны другим (баланс по-прежнему 5660.47), а блокировки она удерживает — в pg_locks они числятся с пустым pid, и попытка изменить ту же строку ждёт:
SET lock_timeout = '3s';
UPDATE shop.account SET balance = balance + 1 WHERE customer_id = 42;
ERROR:  canceling statement due to lock timeout
CONTEXT:  while updating tuple (13,44) in relation "account"
Только COMMIT PREPARED 'xfer-42-4' из любого сеанса завершает транзакцию; баланс становится 5560.47.
Главный недостаток 2PC — блокирующий характер. Участник, ответивший «да», находится в состоянии неопределённости (англ. in doubt): он не может ни зафиксировать транзакцию (вдруг другой ответил «нет»), ни отменить (вдруг решение «фиксировать» уже принято). Если координатор выходит из строя, участники ждут его, удерживая блокировки. В лабораторной работе скрипт перевода «падает» после подготовки, и транзакции остаются на шардах, пока восстановление не прочитает журнал координатора: решения нет — транзакция отменяется (правило «предполагаемой отмены», англ. presumed abort). Забытые подготовленные транзакции к тому же мешают очистке удалять старые версии строк (тема 12), поэтому pg_prepared_xacts нужно отслеживать 9. Наконец, 2PC добавляет сетевые обмены и синхронные записи на диск. Поэтому распределённых транзакций избегают выбором ключа шардирования, а где они нужны, каждого участника делают отказоустойчивым через консенсус, как в Spanner 6.
Теорема CAP и PACELC
В 2000 году Э. Брюер сформулировал гипотезу: распределённая система с общими данными обладает не более чем двумя из трёх свойств — согласованностью (англ. Consistency), доступностью (англ. Availability) и устойчивостью к разделению сети (англ. Partition tolerance) 2. В 2002 году С. Гилберт и Н. Линч уточнили формулировку и доказали её как теорему 3. В доказательстве согласованность означает линеаризуемость (о ней ниже): система ведёт себя как единственная копия данных; доступность — каждый запрос к работающему узлу получает ответ (не ошибку); разделение — сеть может терять любые сообщения между группами узлов.
Смысл теоремы показывает рисунок. Реплики оказались по разные стороны разрыва сети, и клиент хочет изменить значение. Реплика может отказать или ждать связи — согласованность сохранена ценой доступности (выбор CP), — либо принять запись — система доступна, но на другой стороне читают старое значение, и копии расходятся (выбор AP).
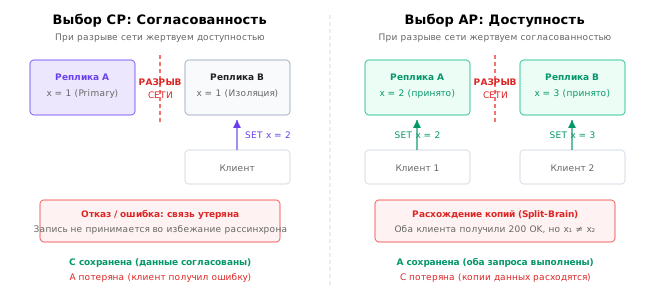
Разделения сети не выбирают — они случаются, поэтому формулировка «выберите два из трёх» вводит в заблуждение: реальный выбор — между C и A во время разделения 1. Синхронная реплика PostgreSQL из темы 13 — выбор CP: без связи с ней фиксация ждёт. Dynamo и Cassandra в типичной настройке выбирают AP: запись принимается любыми доступными репликами, а расхождения разрешаются позже 5.
Д. Абади заметил, что CAP описывает лишь редкий режим работы, и предложил формулировку PACELC: если есть разделение (P), система выбирает между доступностью (A) и согласованностью (C), иначе (E, else) — между задержкой (L, latency) и согласованностью (C) 4. Даже без отказов строгая согласованность требует ждать подтверждения других реплик. Системы в духе Dynamo относятся к классу PA/EL — жертвуют согласованностью ради доступности и малой задержки; полностью транзакционные распределённые СУБД — к классу PC/EC.
Модели согласованности
«Согласованность» здесь означает иное, чем буква C в ACID (тема 12): не соблюдение ограничений, а то, какие значения могут вернуть чтения, когда у данных несколько копий. Неформально, от сильной модели к слабой 1:
- линеаризуемость (англ. linearizability): каждая операция выглядит выполненной мгновенно в некоторый момент между её началом и концом; если запись завершилась, любое начатое после этого чтение вернёт новое значение. Это формализация «единственной копии» 11;
- последовательная согласованность (англ. sequential consistency): все клиенты видят операции в одном порядке, сохраняющем порядок операций каждого клиента, но не обязательно реальное время;
- причинная согласованность (англ. causal consistency): общий порядок гарантирован лишь для причинно связанных операций: никто не увидит ответ на отзыв без самого отзыва;
- итоговая согласованность (англ. eventual consistency): если записи прекратятся, копии со временем станут одинаковыми; о промежуточных чтениях ничего не обещается.
Между ними — сеансовые гарантии: чтение своих записей, монотонное чтение. Асинхронные реплики PostgreSQL дают итоговую согласованность. Линеаризуемость относится к отдельным операциям, а сериализуемость из темы 12 — к транзакциям; их сочетание называют строгой сериализуемостью (англ. strict serializability).
В системах без ведущего узла (Dynamo, Cassandra) согласованность настраивается кворумами 5. Значение хранится на N репликах, запись подтверждают W реплик, чтение опрашивает R и берёт самое свежее. При R + W > N множества пересекаются, и чтение увидит последнюю успешную запись; типичная настройка Dynamo — N = 3, R = 2, W = 2. Линеаризуемости кворумы сами по себе не дают, но позволяют выбирать компромисс для каждого запроса 1.
Консенсус и распределённые SQL-СУБД
Переключение на реплику в теме 13 упиралось в вопрос «кто сейчас основной?»: два узла, считающие себя ведущими, — это «разделённый мозг». Задача, в которой узлы должны прийти к одному решению несмотря на отказы части из них, называется консенсусом (англ. consensus); на ней строятся выбор ведущего и согласованный журнал команд.
Алгоритм Raft, предложенный Д. Онгаро и Дж. Аустерхаутом, создавался как более понятная альтернатива алгоритму Paxos 7. Узлы находятся в одной из трёх ролей: ведущий (англ. leader), последователь (англ. follower) или кандидат (англ. candidate). Время делится на сроки (англ. terms) с возрастающими номерами. Последователь, не получавший сообщений от ведущего дольше случайного тайм-аута, становится кандидатом, увеличивает номер срока и просит голоса; ведущим становится кандидат, получивший голоса большинства. Ведущий принимает команды клиентов, дописывает их в свой журнал и рассылает последователям; запись считается зафиксированной, когда она сохранена на большинстве узлов. Поскольку два большинства всегда пересекаются, в одном сроке не может быть двух ведущих, а зафиксированная запись не теряется при смене ведущего. Кластер из 2f + 1 узлов переживает отказ f узлов: три узла — один отказ, пять — два. Это потоковая репликация журнала из темы 13, в которой фиксацию решает большинство, а не один сервер. Raft используют etcd (хранилище, на которое опирается Patroni из темы 13), Consul, CockroachDB, YugabyteDB.
Распределённые SQL-СУБД (англ. distributed SQL, NewSQL) соединяют консенсус, шардирование и 2PC. Прародитель класса — Google Spanner 6. Данные в нём делятся на диапазоны ключей, каждый диапазон реплицируется группой Paxos, а транзакции, затрагивающие несколько групп, фиксируются двухфазной фиксацией, участники которой — сами отказоустойчивые группы; тем самым снимается главная проблема 2PC — отказ участника. Для упорядочения транзакций Spanner использует API TrueTime, возвращающий время как интервал с ограниченной погрешностью (GPS-приёмники и атомные часы); перед подтверждением фиксации транзакция выжидает эту погрешность (англ. commit wait), и порядок транзакций совпадает с реальным временем. CockroachDB и YugabyteDB воспроизводят эту архитектуру на обычном оборудовании, используя Raft; обе совместимы с протоколом PostgreSQL, а YugabyteDB использует в качестве слоя запросов код самого PostgreSQL. Плата за масштабируемость — задержка: каждая фиксация требует обмена с большинством реплик, возможно, в других регионах.
Модели данных NoSQL
Откуда взялся NoSQL и модель «ключ — значение»
Термин NoSQL (обычно расшифровывают как Not only SQL) объединяет разнородные СУБД, появившиеся в 2000-х годах у интернет-компаний, которым требовалось масштабирование записи на сотни узлов, гибкая схема и высокая доступность 1. Общих черт у них немного: отказ от реляционной модели в пользу модели, удобной для конкретного класса запросов, горизонтальное масштабирование «из коробки» и, как правило, ослабленные гарантии транзакций и согласованности. За прошедшие годы границы размылись: документные СУБД получили многодокументные транзакции, а реляционные — JSON, полнотекстовый и векторный поиск.
Простейшая модель — «ключ — значение» (англ. key-value): СУБД хранит соответствие уникального ключа и значения, о структуре которого почти ничего не знает, и умеет получать, записывать и удалять значение по ключу. Это хеш-таблица, распределённая по узлам. Её достоинства — предсказуемо малое время операций и простота шардирования (ключ — он же ключ шардирования); недостаток — запросы возможны только по ключу. Типичный представитель — Redis: хранилище в оперативной памяти, значениями которого могут быть строки, списки, хеши, множества и упорядоченные множества, с временем жизни ключей, атомарными операциями над структурами, сохранением на диск снимками и журналом команд, репликацией и кластерным режимом на 16 384 слотах. Корзина покупателя «Книжного узла» и счётчик просмотров книги в Redis выглядели бы так (команды приведены для иллюстрации: Redis в учебной среде не установлен):
HSET cart:42 book:4 1 book:9 2        # корзина покупателя 42: книга -> количество
EXPIRE cart:42 604800                 # корзина живёт неделю
INCR views:book:4                     # атомарный счётчик просмотров
ZINCRBY top:books:2024-10 1 book:4    # рейтинг продаж месяца
Хранилища «ключ — значение» служат кешами перед реляционной базой, хранилищами сеансов, очередями, счётчиками — там, где нужна скорость, а данные либо восстановимы из основной базы, либо допускают потерю последних изменений. Модель Amazon Dynamo тоже относится к этому классу, но отличается распределённостью и упором на доступность записи: согласованное хеширование, кворумы, версионирование значений векторными часами и разрешение конфликтов приложением 5.
Документная модель и её сравнение с реляционной
Документная СУБД хранит документы — самоописывающие древовидные структуры (JSON, в MongoDB — его двоичный вариант BSON), сгруппированные в коллекции. Схема не объявляется заранее: каждый документ несёт имена своих полей. В MongoDB документ имеет обязательный ключ _id, размер документа ограничен 16 МиБ, поддерживаются индексы по полям, в том числе вложенным, конвейер агрегации, шардирование по ключу и наборы реплик с автоматическим выбором ведущего.
Главная идея документной модели — хранить вместе то, что вместе читается. Карточка книги «Книжного узла» в реляционной схеме собирается из шести таблиц: book, publisher, category, book_author, author, review. В документной модели это один документ с вложенными массивами авторов и отзывов. Скрипт setup.sql лабораторной работы строит такие документы в таблице lab16.book_doc типа jsonb (тип и операторы описаны в теме 9); фрагмент документа книги «Пикник на обочине»:
{"isbn": "9785170878239", "year": 2021, "price": 520.00, "title": "Пикник на обочине",
 "attrs": {"series": "Миры Стругацких", "binding": "soft"},
 "authors": [{"name": "Аркадий Стругацкий", "author_id": 4},
             {"name": "Борис Стругацкий", "author_id": 5}],
 "reviews": [{"body": "Полезно для работы", "rating": 4,
              "created_at": "2022-02-04T13:11:39.57374+03:00", "customer_id": ...}, ...],
 "category": "Фантастика", "publisher": "АСТ"}
Сравним две модели на одних и тех же данных. Чтение карточки по ключу из документа — одно обращение к индексу первичного ключа и одна строка:
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT doc FROM lab16.book_doc WHERE book_id = 4;
 Index Scan using book_doc_pkey on book_doc (actual time=0.021..0.022 rows=1 loops=1)
   Index Cond: (book_id = 4)
   Buffers: shared hit=3
Сборка того же документа соединением шести таблиц (запрос из файла card_join.sql окружения, с индексом по review.book_id) обращается к 21 странице буферного кеша и включает две сортировки и построение JSON. Измерение утилитой pgbench (по 10 секунд, случайные книги, подготовленные операторы) дало на учебной машине около 6800 чтений документа в секунду против 3650 сборок соединением — разница меньше, чем можно было ожидать, потому что все страницы в памяти, а значительная часть времени уходит на разбор запроса и пересылку результата. Времена у каждого свои; важно соотношение и число страниц.
Расплата за быстрое чтение — избыточность. Имя автора повторяется в каждом документе его книг. Переименуем автора 142 (генератор данных ошибся в форме фамилии: «Елена Смирнов»): в реляционной схеме меняется одна строка таблицы author, в документной — 22 документа, и журнал упреждающей записи (тема 13), измеренный функцией pg_current_wal_insert_lsn() до и после каждого обновления, вырастает на 240 байт и на 25 448 байт соответственно. Хуже того, обновить документы легко неправильно: условие doc -> 'authors' -> 0 ->> 'author_id' = '142' находит только 19 документов, в которых автор стоит первым, и три документа, где он соавтор, остаются со старым именем. Это аномалия обновления из теории нормализации (тема 8), перенесённая в документную модель. Корректное обновление пересобирает массив:
UPDATE lab16.book_doc d
SET doc = jsonb_set(d.doc, '{authors}',
        (SELECT jsonb_agg(CASE WHEN a ->> 'author_id' = '142'
                               THEN a || '{"name": "Елена Смирнова"}'
                               ELSE a END ORDER BY ord)
         FROM jsonb_array_elements(d.doc -> 'authors') WITH ORDINALITY AS t(a, ord)))
WHERE d.doc @> '{"authors": [{"author_id": 142}]}';
UPDATE 22
Сопоставление по размеру тоже не в пользу документов: таблица book_doc занимает 2328 КиБ, тогда как шесть нормализованных таблиц — 1752 КиБ, хотя в них есть ещё и описания книг (214 КиБ), которых в документах нет. Причина — имена полей "customer_id", "rating", "body", "created_at", повторённые в каждом из 13 744 отзывов. Сжатие TOAST (тема 9) частично спасает: документ «Пикника на обочине» с 104 отзывами занимает 12 164 байта в текстовом виде и 3569 байт в хранимом. Наконец, массив отзывов неограничен: у самой популярной книги их 282, а у реального магазина могут быть десятки тысяч, и каждое добавление отзыва переписывает весь документ.
Отсюда правило проектирования документной модели: вкладывать то, что принадлежит документу, читается вместе с ним и ограничено по размеру (атрибуты книги, позиции заказа), и хранить ссылками то, что разделяется между документами или растёт без ограничения (авторы, отзывы). Это и есть проектирование «от запросов» — схема определяется не структурой предметной области, а тем, какие запросы должны выполняться быстро 1.
Широкие колонки и проектирование от запросов
СУБД с широкими колонками (англ. wide-column stores) — Google Bigtable, Apache HBase, Apache Cassandra — организуют данные в таблицы со строками, но строка в них — это ключ раздела и упорядоченный набор столбцов, число и состав которых может различаться от строки к строке. Cassandra соединяет модель данных Bigtable с распределённой архитектурой Dynamo: кольцо узлов с согласованным хешированием, репликация без ведущего узла, настраиваемая для каждого запроса согласованность (ONE, QUORUM, ALL), хранение на LSM-деревьях — журнал фиксации, таблица в памяти и неизменяемые отсортированные файлы на диске, что делает запись очень дешёвой 15.
Первичный ключ таблицы Cassandra состоит из ключа раздела (англ. partition key), определяющего узел, и ключей кластеризации (англ. clustering columns), задающих порядок строк внутри раздела. Соединений и произвольных условий нет: эффективен только запрос, указывающий ключ раздела. Поэтому схема проектируется от запросов: для каждого запроса приложения — своя таблица, а одни и те же данные записываются в несколько таблиц. Для «Книжного узла» на языке CQL (пример по документации, в учебной среде Cassandra нет):
CREATE TABLE orders_by_customer (
    customer_id int, created_at timestamp, order_id int, status text, total decimal,
    PRIMARY KEY ((customer_id), created_at, order_id)
) WITH CLUSTERING ORDER BY (created_at DESC, order_id ASC);

CREATE TABLE sales_by_book_month (
    book_id int, month text, order_id int, quantity int,
    PRIMARY KEY ((book_id, month), order_id)
);
Первая таблица отвечает на вопрос «последние заказы покупателя» чтением одного раздела, вторая — «продажи книги за месяц». Приложение при оформлении заказа пишет в обе таблицы, а согласованность между ними — его забота. В реляционной базе те же два запроса обслуживались бы одной парой таблиц orders и order_item и двумя индексами (тема 10).
Графовая модель и рекурсивные запросы
Графовая СУБД хранит вершины и рёбра с атрибутами (модель графа свойств, англ. property graph) и предлагает язык запросов к путям; в Neo4j это Cypher. Связи между вершинами хранятся непосредственно при вершинах, так что переход по ребру не требует поиска по индексу. Запрос «соавторы соавторов автора» в Cypher записывается образцом пути (иллюстрация, Neo4j в учебной среде нет):
MATCH (a:Author {author_id: 142})-[:WROTE]->(:Book)<-[:WROTE]-(co:Author)
      -[:WROTE]->(:Book)<-[:WROTE]-(co2:Author)
RETURN DISTINCT co2.full_name;
В SQL граф — это таблица рёбер, а обход — рекурсивный запрос (тема 6). Граф соавторства «Книжного узла» строится из book_author: ребро соединяет двух авторов одной книги (968 направленных рёбер). Наивный обход перечисляет пути, отсекая циклы проверкой «вершины ещё нет в пути»:
WITH RECURSIVE coauthor AS (
    SELECT DISTINCT x.author_id AS a, y.author_id AS b
    FROM bookstore.book_author x
    JOIN bookstore.book_author y ON y.book_id = x.book_id AND y.author_id <> x.author_id),
walk (author_id, distance, path) AS (
    SELECT 142, 0, ARRAY[142]
    UNION ALL
    SELECT c.b, w.distance + 1, w.path || c.b
    FROM walk w JOIN coauthor c ON c.a = w.author_id
    WHERE c.b <> ALL (w.path) AND w.distance < 7)
SELECT distance, count(*) AS paths, count(DISTINCT author_id) AS authors
FROM walk GROUP BY distance ORDER BY distance;
 distance | paths | authors
----------+-------+---------
        0 |     1 |       1
        1 |     7 |       7
        2 |    35 |      32
        3 |   152 |     100
        4 |   713 |     179
        5 |  3391 |     192
        6 | 16239 |     194
        7 | 77008 |     194
Число различных достижимых авторов насыщается на 194, а число простых путей растёт примерно в 4,7 раза с каждым шагом; с ограничением глубины 9 запрос перебирает 2 153 648 путей (в опыте около 4 с). Без ограничения глубины и без проверки пути такой запрос на графе с циклами не завершается вовсе. Правильный алгоритм для кратчайших расстояний — поиск в ширину с множеством посещённых вершин; в SQL его можно выразить рекурсией по уровням, где строка рабочей таблицы хранит весь фронт и множество посещённых вершин (решение — в лабораторной работе), и такой запрос находит те же 194 автора за доли секунды. Графовые СУБД реализуют обходы и поиск путей встроенными алгоритмами, и для задач, где основная операция — многошаговый обход (социальные связи, маршруты, выявление мошеннических цепочек), это их преимущество. Для одного-двух шагов, как в рекомендации «покупатели этой книги купили также», достаточно обычных соединений и индексов.
Подведём итог раздела. NoSQL-модель оправдана, когда её сильная сторона совпадает с основным профилем нагрузки: экстремальный поток простых операций по ключу, требование доступности записи при разделениях сети, данные с действительно произвольной структурой, глубокие обходы графа. Когда же данные связаны, важны транзакции и ограничения целостности, а запросы заранее неизвестны, реляционная СУБД остаётся лучшим выбором — тем более что PostgreSQL сам поддерживает документы (jsonb с индексами GIN), полнотекстовый и векторный поиск, а масштабируется репликами и расширениями. Многие системы используют несколько хранилищ одновременно (англ. polyglot persistence): реляционную базу как источник истины, кеш «ключ — значение» и поисковый индекс, наполняемые из неё.
Полнотекстовый поиск: специализированная модель внутри PostgreSQL
Документ, лексемы и словари
Поиск книги по словам названия и описания — пример задачи, для которой и оператор LIKE, и B-дерево не подходят. Условие title ILIKE '%ветер%' не находит ни одной книги «Хроники северного ветра», потому что в названии стоит форма «ветра»; оно не учитывает морфологию, не ранжирует результаты и требует полного просмотра таблицы. Полнотекстовый поиск (англ. full-text search) решает задачу иначе: документ заранее превращается в набор нормализованных слов, и поиск идёт по ним 10.
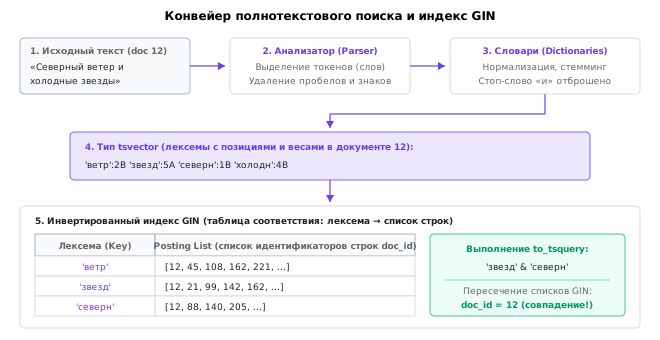
В PostgreSQL обработанный документ имеет тип tsvector — отсортированный список лексем (англ. lexemes) с позициями, а запрос — тип tsquery, логическое выражение над лексемами. Превращение текста в лексемы управляется конфигурацией текстового поиска: анализатор (англ. parser) разбивает текст на фрагменты разных типов (слово кириллицей, слово латиницей, число), а цепочка словарей (англ. dictionaries) для каждого типа фрагмента выдаёт лексему или отбрасывает слово как стоп-слово:
SELECT alias, token, dictionaries, lexemes
FROM ts_debug('russian', 'О книгах Кнута и PostgreSQL 16');
   alias   |   token    |  dictionaries  |   lexemes
-----------+------------+----------------+--------------
 word      | О          | {russian_stem} | {}
 blank     |            | {}             |
 word      | книгах     | {russian_stem} | {книг}
 blank     |            | {}             |
 word      | Кнута      | {russian_stem} | {кнут}
 blank     |            | {}             |
 word      | и          | {russian_stem} | {}
 blank     |            | {}             |
 asciiword | PostgreSQL | {english_stem} | {postgresql}
 blank     |            | {}             |
 uint      | 16         | {simple}       | {16}
Конфигурация russian обрабатывает кириллические слова стеммером Snowball (russian_stem), латинские — английским стеммером, числа — словарём simple, который только приводит к нижнему регистру. Предлоги «о» и «и» — стоп-слова, их лексемы пусты. Стеммер (англ. stemmer) отсекает окончания по правилам, не зная словаря: «книгах» → «книг». Различие конфигураций видно на названии книги Кнута:
SELECT to_tsvector('russian', 'Искусство программирования. Том 1') AS ru,
       to_tsvector('simple', 'Искусство программирования. Том 1') AS simple;
                  ru                   |                      simple
---------------------------------------+--------------------------------------------------
 '1':4 'искусств':1 'программирован':2 | '1':4 'искусство':1 'программирования':2 'том':3
Слово «Том» в русской конфигурации — стоп-слово, а цифры после двоеточия — позиции слов в тексте. Конфигурация по умолчанию задаётся параметром default_text_search_config, который initdb выбирает по локали кластера; в учебной среде он равен pg_catalog.english, поэтому конфигурацию разумно указывать явно.
Стеммер — не лемматизатор: он не приводит слово к словарной форме, и формы с беглой гласной расходятся. Так возникает классическая ошибка поиска:
SELECT ts_lexize('russian_stem', 'ветер') AS a, ts_lexize('russian_stem', 'ветра') AS b;
    a    |   b
---------+--------
 {ветер} | {ветр}
Поэтому запрос plainto_tsquery('russian', 'северный ветер') превращается в 'северн' & 'ветер', а в документах с названием «Хроники северного ветра» хранится лексема 'ветр':
SELECT count(*) FROM lab16.book_fts WHERE tsv @@ plainto_tsquery('russian', 'северный ветер');
 count
-------
     0
Запрос «северный ветер» не находит ни одной из 163 книг с «северного ветра» в названии. Исправить это можно префиксным поиском (to_tsquery('russian', 'северн:* & ветр:*')), словарём синонимов или подключением словаря Ispell/Hunspell, который выполняет настоящую морфологическую нормализацию по словарю 10. В лабораторной работе эта ошибка разбирается подробно.
Запросы и ранжирование
Запрос tsquery строится несколькими функциями: to_tsquery принимает выражение с операторами & (и), | (или), ! (не), <-> (следующее слово) и префиксами :*; plainto_tsquery соединяет все слова через &; phraseto_tsquery — через <->; websearch_to_tsquery (с PostgreSQL 11) понимает синтаксис поисковых систем — кавычки для фраз, or, минус для исключения:
SELECT to_tsquery('russian', 'книги & (кнут | postgres:*)'),
       plainto_tsquery('russian', 'книги Кнута'),
       phraseto_tsquery('russian', 'книги Кнута'),
       websearch_to_tsquery('russian', '"северного ветра" -тайна');
            to_tsquery            | plainto_tsquery | phraseto_tsquery  |     websearch_to_tsquery
----------------------------------+-----------------+-------------------+-------------------------------
 'книг' & ( 'кнут' | 'postgr':* ) | 'книг' & 'кнут' | 'книг' <-> 'кнут' | 'северн' <-> 'ветр' & !'тайн'
Оператор @@ проверяет, соответствует ли документ запросу. Документ для поиска удобно хранить в генерируемом столбце, присваивая лексемам веса от A до D в зависимости от того, из какой части текста они взяты:
ALTER TABLE lab16.book_fts ADD COLUMN tsv tsvector GENERATED ALWAYS AS (
    setweight(to_tsvector('russian', title), 'A') ||
    setweight(to_tsvector('russian', coalesce(description, '')), 'B')) STORED;
Функции ранжирования ts_rank (по частоте лексем запроса) и ts_rank_cd (с учётом близости лексем) оценивают релевантность с учётом весов; по умолчанию вес A равен 1,0, B — 0,4, C — 0,2, D — 0,1 10. Слово «история» встречается и в названиях книг («История звёзд»), и в описаниях («Книга о истории…»), и ранжирование это различает:
SELECT round(ts_rank(tsv, q)::numeric, 4) AS rank, count(*)
FROM lab16.book_fts, to_tsquery('russian', 'история') AS q
WHERE tsv @@ q GROUP BY 1 ORDER BY 1 DESC;
  rank  | count
--------+-------
 0.6687 |    24
 0.6079 |   162
 0.2432 |   221
Выше всех 24 книги, где слово есть и в названии, и в описании, затем 162 книги с ним только в названии, ниже — 221 книга, где оно только в описании. Функция ts_headline выделяет найденные слова во фрагменте текста для показа пользователю: ts_headline('russian', title, q, 'StartSel=«, StopSel=»') для книги 12 возвращает «Практика «северного» «ветра» 12». Вес можно использовать и в самом условии: запрос 'звезда:A & космос' требует, чтобы «звезда» встретилась в названии (21 книга).
Инвертированный индекс GIN
Без индекса проверка tsv @@ q выполняется для каждой строки. Индекс GIN (англ. Generalized Inverted Index) — инвертированный индекс: для каждой лексемы он хранит упорядоченный список строк, в которых она встречается (англ. posting list), а для частых лексем — B-дерево таких ссылок 10. Запрос с & пересекает списки, с | — объединяет. Путь от текста до индекса показан на рисунке.
CREATE INDEX book_fts_tsv_idx ON lab16.book_fts USING gin (tsv);
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF)
SELECT book_id, title FROM lab16.book_fts WHERE tsv @@ to_tsquery('russian', 'звезда:A & космос');
 Bitmap Heap Scan on book_fts (actual rows=21 loops=1)
   Recheck Cond: (tsv @@ '''звезд'':A & ''космос'''::tsquery)
   Heap Blocks: exact=19
   ->  Bitmap Index Scan on book_fts_tsv_idx (actual rows=21 loops=1)
         Index Cond: (tsv @@ '''звезд'':A & ''космос'''::tsquery)
Индекс по 2010 книгам занимает 160 КиБ. Он возвращает битовую карту строк (тема 11), а повторная проверка Recheck Cond нужна, потому что индекс не хранит веса, и условие :A проверяется по самому документу. Для запроса по лексеме «книга», которая есть во всех 1374 описаниях, планировщик предпочитает последовательное чтение — индекс полезен для избирательных запросов. Цена GIN — медленное обновление: добавление документа вставляет в индекс по записи на каждую лексему. Чтобы смягчить это, новые записи сначала копятся в списке ожидания (параметр индекса fastupdate, по умолчанию включён) и переносятся в основную структуру при очистке или при переполнении списка (gin_pending_list_limit).
Полнотекстовый поиск PostgreSQL достаточен для каталога магазина или базы документов организации. Специализированные поисковые системы (Elasticsearch, OpenSearch на основе библиотеки Lucene) предлагают более развитое ранжирование, морфологию, фасетный поиск и горизонтальное масштабирование, но требуют отдельной инфраструктуры и синхронизации с основной базой. Похожий выбор возникает и с векторным поиском: расширение pgvector добавляет тип vector для векторных представлений текстов и изображений, операторы расстояния (<-> — евклидово, <=> — косинусное) и приближённые индексы HNSW и IVFFlat, позволяя искать «похожие по смыслу» книги в той же базе, где хранятся заказы.
Аналитические системы и колоночное хранение
OLTP и OLAP
Все предыдущие темы курса, по существу, описывали обработку транзакций в реальном времени (англ. Online Transaction Processing, OLTP): много коротких транзакций, каждая читает и меняет несколько строк по ключу. Аналитическая обработка (англ. Online Analytical Processing, OLAP) устроена иначе 113:
| Свойство | OLTP | OLAP |
|---|---|---|
| Типичный запрос | карточка книги, оформление заказа | выручка по рубрикам и месяцам за три года |
| Строк на запрос | единицы, доступ по ключу | миллионы и миллиарды, полный просмотр |
| Столбцов на запрос | все столбцы строки | несколько из десятков |
| Запись | частые мелкие изменения | пакетная загрузка |
| Пользователи | покупатели, приложение | аналитики, отчёты |
| Узкое место | задержка, параллельные транзакции | пропускная способность чтения |
Совмещать обе нагрузки в одной базе можно до определённого объёма: тяжёлый отчёт конкурирует с оформлением заказов за диск и процессор и, держа старый снимок, мешает очистке (тема 12). Поэтому аналитику выносят в хранилище данных (англ. data warehouse) — отдельную базу, куда данные из операционных систем периодически загружаются. Классический процесс загрузки называется ETL (англ. Extract, Transform, Load): данные извлекаются из источников, очищаются и преобразуются, затем загружаются. В современных облачных хранилищах распространён ELT: сырые данные загружаются как есть, а преобразования выполняются уже внутри хранилища средствами SQL.
Схема хранилища строится вокруг фактов и измерений 13. Таблица фактов (англ. fact table) содержит события с числовыми мерами — для «Книжного узла» это строка продажи: количество, сумма, — и ссылки на таблицы измерений (англ. dimension tables): дата, книга, покупатель, склад. Измерения денормализованы и содержат все атрибуты для группировки: у даты — год, квартал, месяц, день недели; у книги — название, рубрика, издательство. Такая схема называется «звездой» (англ. star schema): таблица фактов в центре, измерения вокруг. Если измерения нормализованы (рубрика книги вынесена в свою таблицу, а та ссылается на родительскую рубрику), схема становится «снежинкой» (англ. snowflake schema). Звезда сознательно нарушает третью нормальную форму (тема 8) ради простоты и скорости запросов: данные в хранилище не изменяются точечно, и аномалии обновления не возникают.
Строчное и колоночное хранение
В PostgreSQL, как и в других OLTP-СУБД, таблица хранится построчно: все столбцы строки лежат рядом на одной странице (тема 9). Для запроса по ключу это идеально — одна страница содержит всю строку. Для аналитического запроса, которому нужны три столбца из двадцати, это расточительно: читаются страницы целиком, со всеми столбцами.
Колоночное хранение (англ. column-oriented storage) кладёт рядом значения одного столбца: каждый столбец — отдельный файл или отдельная область, а строка восстанавливается по позиции значения. Запрос читает только нужные столбцы. Эту архитектуру систематизировала исследовательская СУБД C-Store 8, ставшая основой коммерческой Vertica; на тех же принципах построены ClickHouse, DuckDB, Amazon Redshift, Google BigQuery и формат файлов Parquet. Различие двух способов хранения показано на рисунке.
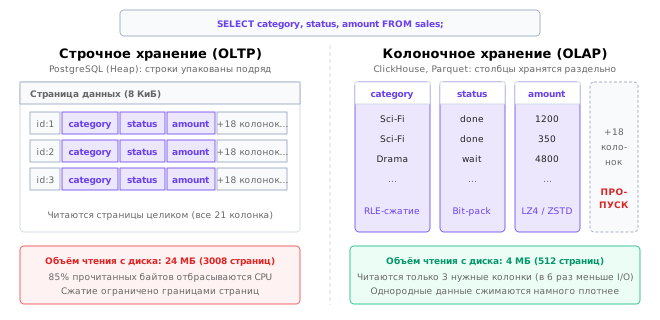
Проверим идею на «Книжном узле». Скрипт лабораторной работы создаёт широкую таблицу продаж lab16.sales_wide — 59 910 позиций заказов с 21 столбцом (сведения о заказе, книге, покупателе, складе), как в выгрузке для хранилища. Отчёт «три рубрики с наибольшей выручкой» использует три столбца: category, status и amount. Сравним чтение широкой таблицы с её узкой проекцией — копией только из этих трёх столбцов, которая имитирует колоночное хранение средствами строчной СУБД (параллельные процессы отключены параметром max_parallel_workers_per_gather = 0, чтобы сравнение было честным):
CREATE TABLE lab16.sales_narrow AS SELECT category, status, amount FROM lab16.sales_wide;
SELECT relname, relpages, pg_size_pretty(pg_table_size(oid)) FROM pg_class
WHERE oid IN ('lab16.sales_wide'::regclass, 'lab16.sales_narrow'::regclass);
   relname    | relpages | pg_size_pretty
--------------+----------+----------------
 sales_narrow |      512 | 4136 kB
 sales_wide   |     3008 | 24 MB
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT category, sum(amount) AS revenue FROM lab16.sales_wide
WHERE status <> 'cancelled' GROUP BY category ORDER BY revenue DESC LIMIT 3;
 Limit (actual time=31.221..31.223 rows=3 loops=1)
   Buffers: shared hit=3008
   ->  Sort (actual time=31.219..31.220 rows=3 loops=1)
         Sort Key: (sum(amount)) DESC
         Sort Method: top-N heapsort  Memory: 25kB
         Buffers: shared hit=3008
         ->  HashAggregate (actual time=31.201..31.207 rows=19 loops=1)
               Group Key: category
               Batches: 1  Memory Usage: 24kB
               Buffers: shared hit=3008
               ->  Seq Scan on sales_wide (actual time=0.004..13.284 rows=55642 loops=1)
                     Filter: (status <> 'cancelled'::text)
                     Rows Removed by Filter: 4268
                     Buffers: shared hit=3008
 Planning:
   Buffers: shared hit=27
 Planning Time: 0.106 ms
 Execution Time: 31.258 ms
Тот же запрос к узкой таблице читает 512 страниц вместо 3008 и выполняется за 24 мс вместо 31 мс. Различие во времени невелико, потому что все страницы уже в буферном кеше, а основное время уходит на вычисление хеш-агрегата по текстовому ключу. Когда таблица в сотни гигабайт читается с диска, время определяется числом прочитанных страниц, и выигрыш становится почти шестикратным, как и отношение размеров. При этом строка узкой таблицы всё ещё занимает в среднем 60 байт против 386 у широкой: 24 байта из них — заголовок версии строки, нужный для многоверсионности (тема 12), а рубрика хранится полным текстом в каждой строке.
Сжатие и векторное выполнение
Колоночное хранение открывает второй источник выигрыша — сжатие. Значения одного столбца однотипны и часто повторяются, а значит, хорошо сжимаются специальными кодировками 8:
- словарное кодирование (англ. dictionary encoding): 19 различных рубрик заменяются номерами в словаре, и на значение достаточно 5 бит вместо десятков байт текста;
- кодирование длин серий (англ. run-length encoding, RLE): последовательность одинаковых значений хранится как пара «значение, число повторов». В таблице
sales_wide, упорядоченной по номеру заказа, столбецstatusиз 59 910 значений состоит всего из 3018 серий, потому что 92 % заказов доставлены; - упаковка битов и разностное кодирование для чисел и дат: хранятся разности соседних значений, занимающие немного бит.
Сжатие особенно эффективно, если данные отсортированы по столбцам, используемым в группировке; поэтому C-Store хранит столбцы в порядке сортировки, а ClickHouse требует указать ключ сортировки таблицы. Как это выглядит на практике, показывает DuckDB — встраиваемая аналитическая СУБД, работающая внутри процесса приложения подобно SQLite. Скрипт columns_duckdb.py лабораторной работы выгружает sales_wide из PostgreSQL, сохраняет в формате Parquet и выполняет тот же отчёт (в учебной среде DuckDB 1.5.6, один поток выполнения):
PostgreSQL (heap):   23.54 МиБ
CSV:                 21.54 МиБ
Parquet:              1.37 МиБ

Столбцы в Parquet (байт): сжатый / несжатый размер, кодировки
  created_at        220818   479311  PLAIN
  customer_email    120808   202036  PLAIN_DICTIONARY
  ...
  amount             79783    82571  PLAIN_DICTIONARY
  category           38229    38288  PLAIN_DICTIONARY
  ...
  status              5100    20502  PLAIN_DICTIONARY

Время (лучшее из 5): PostgreSQL 30.3 мс, DuckDB по Parquet 2.5 мс
Те же данные в Parquet занимают в 17 раз меньше места, чем таблица PostgreSQL, а отчёту нужны лишь столбцы category, status и amount — 123 112 байт, около 120 КиБ. Столбец status занимает 5100 байт, менее 0,1 байта на значение. Результаты обоих запросов совпали до копейки. Различие во времени объясняется не только объёмом: колоночные СУБД используют векторное выполнение (англ. vectorized execution), обрабатывая не по одной строке, как узлы плана PostgreSQL (тема 11), а пакетами из тысяч значений одного столбца в плотных массивах, что эффективно использует кеш процессора и его векторные инструкции. Времена здесь, как всегда, — пример с учебной машины.
У колоночного хранения есть и обратная сторона: вставка одной строки затрагивает все столбцы, а точечное обновление в сжатом столбце дорого. Поэтому колоночные СУБД копят новые строки в небольшой строчной области и периодически сливают их в колоночную (в C-Store это пара хранилищ для записи и для чтения 8, в ClickHouse — фоновое слияние частей таблиц семейства MergeTree), а для OLTP-нагрузки непригодны.
Обзор аналитических систем можно свести к нескольким ориентирам. ClickHouse — колоночная СУБД с открытым кодом, разработанная в «Яндексе» для веб-аналитики: распределённые таблицы, векторное выполнение, приближённые агрегаты, загрузка миллионов строк в секунду. DuckDB — встраиваемая аналитическая СУБД для анализа данных на одной машине, читающая напрямую Parquet и CSV. Облачные хранилища (BigQuery, Redshift, Snowflake) разделяют хранение и вычисления. Внутри экосистемы PostgreSQL колоночное хранение предлагают расширения, например метод доступа columnar в Citus 14. Выбор, как всегда, определяется нагрузкой: PostgreSQL с индексами и материализованными представлениями справляется с аналитикой на десятках гигабайт, а на сотнях гигабайт и терабайтах колоночная СУБД выигрывает на порядки.
Итоги темы
Один сервер PostgreSQL масштабируется вертикально и репликами для чтения, но реплики не увеличивают ни объём данных, ни поток записи и добавляют отставание, нарушающее чтение своих записей. Дальнейший рост требует шардирования — разбиения строк по ключу между серверами. Ключ шардирования должен совпадать с условием большинства запросов, чтобы они обслуживались одним шардом, и позволять совместно размещать связанные строки; справочные таблицы копируются на все шарды. Хеширование «по модулю N» при добавлении узла перевозит большую часть данных, а согласованное хеширование и фиксированные слоты — лишь необходимую долю. Межшардовые запросы собирают частичные результаты, и только разложимые агрегаты можно объединять простым сложением.
Транзакция, затрагивающая несколько шардов, требует двухфазной фиксации. PostgreSQL поддерживает роль участника командами PREPARE TRANSACTION и COMMIT PREPARED при ненулевом max_prepared_transactions; подготовленная транзакция переживает перезапуск и держит блокировки, пока координатор не сообщит решение, поэтому отказ координатора блокирует участников. Теорема CAP утверждает, что при разделении сети нельзя сохранить одновременно линеаризуемость и доступность, а PACELC добавляет, что и без отказов строгая согласованность стоит задержки. Модели согласованности — от линеаризуемости до итоговой — описывают, что может вернуть чтение; кворумы позволяют настраивать компромисс. Консенсус (Raft, Paxos) позволяет узлам надёжно выбрать ведущего и согласовать журнал, и на нём построены распределённые SQL-СУБД — Spanner, CockroachDB, YugabyteDB.
NoSQL-системы предлагают модели, оптимизированные под конкретные запросы: «ключ — значение» для простейших операций, документы для данных, читаемых целиком, широкие колонки для огромных потоков записи с заранее известными запросами, графы для многошаговых обходов. Опыт с карточками книг показал, чем оплачивается документная модель: быстрое чтение документа сопровождается избыточностью, аномалиями обновления и ростом размера. PostgreSQL же сам вмещает специализированные модели: документы jsonb, полнотекстовый поиск с морфологией, ранжированием и индексом GIN, векторный поиск расширением pgvector. Аналитическая нагрузка выигрывает от колоночного хранения, сжатия и векторного выполнения, и для неё строят хранилища данных со схемой «звезда».
Этой темой курс завершается. Его главный урок в том, что за каждой гарантией СУБД стоит конкретный механизм с конкретной ценой. Ограничения целостности и нормализация защищают от противоречий, индекс ускоряет чтение за счёт записи, многоверсионность разводит читателей и писателей ценой очистки, журнал обеспечивает долговечность ценой синхронной записи. В распределённой системе цены растут: согласованность оплачивается задержкой и доступностью, атомарность — блокирующим протоколом, масштабируемость — ограничениями на запросы. Инженер, понимающий эти механизмы, выбирает систему по требованиям задачи, а не по моде, и в большинстве случаев начинает с одного хорошо спроектированного реляционного сервера.
Литература
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017. (Рус. пер.: Клеппман М. Высоконагруженные приложения. Программирование, масштабирование, поддержка. — СПб.: Питер, 2018.)
- Brewer E. A. Towards Robust Distributed Systems. — Keynote at the 19th ACM Symposium on Principles of Distributed Computing (PODC), 2000.
- Gilbert S., Lynch N. Brewer's Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services. — ACM SIGACT News, 2002, Т. 33, № 2, С. 51–59, DOI: 10.1145/564585.564601.
- Abadi D. Consistency Tradeoffs in Modern Distributed Database System Design: CAP is Only Part of the Story. — IEEE Computer, 2012, Т. 45, № 2, С. 37–42, DOI: 10.1109/MC.2012.33.
- DeCandia G., Hastorun D., Jampani M., Kakulapati G., Lakshman A., Pilchin A., Sivasubramanian S., Vosshall P., Vogels W. Dynamo: Amazon's Highly Available Key-value Store. — Proceedings of the 21st ACM Symposium on Operating Systems Principles (SOSP), 2007, С. 205–220, DOI: 10.1145/1294261.1294281.
- Corbett J. C., Dean J., Epstein M. et al. Spanner: Google's Globally-Distributed Database. — Proceedings of the 10th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 2012.
- Ongaro D., Ousterhout J. In Search of an Understandable Consensus Algorithm. — Proceedings of the USENIX Annual Technical Conference (USENIX ATC), 2014, С. 305–319.
- Stonebraker M., Abadi D. J., Batkin A. et al. C-Store: A Column-oriented DBMS. — Proceedings of the 31st International Conference on Very Large Data Bases (VLDB), 2005, С. 553–564.
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. PREPARE TRANSACTION; COMMIT PREPARED; ROLLBACK PREPARED; pg_prepared_xacts; 20.4. Resource Consumption (max_prepared_transactions). — 2024. https://www.postgresql.org/docs/16/sql-prepare-transaction.html
- PostgreSQL Global Development Group. PostgreSQL 16 Documentation. Chapter 12. Full Text Search; Chapter 70. GIN Indexes. — 2024. https://www.postgresql.org/docs/16/textsearch.html
- Herlihy M. P., Wing J. M. Linearizability: A Correctness Condition for Concurrent Objects. — ACM Transactions on Programming Languages and Systems, 1990, Т. 12, № 3, С. 463–492, DOI: 10.1145/78969.78972.
- Karger D., Lehman E., Leighton T., Panigrahy R., Levine M., Lewin D. Consistent Hashing and Random Trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web. — Proceedings of the 29th ACM Symposium on Theory of Computing (STOC), 1997, С. 654–663, DOI: 10.1145/258533.258660.
- Kimball R., Ross M. The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling. 3rd ed. — Wiley, 2013.
- Citus Data. Citus Documentation: Concepts (Nodes, Distributed Data, Co-location); Table Management. — 2024. https://docs.citusdata.com/