
Обработка текста: регулярные выражения, grep, sed, awk
В предыдущих темах текст появлялся постоянно, но почти всегда в роли содержимого: файлы открывались в less, конфигурации правились в редакторе, вывод команд перенаправлялся в файлы. Тема 6 переводит текст в роль рабочего инструмента. Журналы веб-сервера, таблицы, выводы команд ls и ps, конфигурационные файлы — всё это строки, а строка с разделителями — это запись с полями. Умение быстро находить нужные строки, отбирать поля, считать и заменять значения отличает работу в терминале от простого запуска программ.
Изложение построено от общего к частному. Сначала текст рассматривается как интерфейс между программами, и на примере журнала веб-сервера в формате combined вводится набор полей, на котором показываются все инструменты темы. Затем вводятся регулярные выражения — язык шаблонов, общий для grep, sed и awk, — с различием диалектов BRE и ERE. Далее идут grep и инструменты обработки таблиц: sort, uniq, cut, tr. Потоковый редактор sed и язык обработки полей awk рассматриваются в двух отдельных разделах, а последний раздел собирает все инструменты в отчёт по журналу, сравнивает решение конвейером с решением одной программой awk и показывает, как те же приёмы переносятся на JSON с помощью jq.
Все примеры выполнены в оболочке Bash в Ubuntu. Журнал, на котором показаны результаты, создаётся учебным скриптом make_logs.py из лабораторной работы 6. Скрипт использует фиксированное начальное значение случайных чисел, поэтому числа в выводах одинаковы у всех читателей, выполнивших те же шаги. Инструменты проверены в версиях GNU grep 3.7 и gawk 5.1, которые поставляются с Ubuntu 22.04; в Ubuntu 24.04 версии отличаются незначительно, и все приведённые приёмы работают в них одинаково. Тема опирается на умения из тем 2, 3 и 5: пути, просмотр файлов, перенаправления и конвейеры.
Текст как интерфейс между программами
Строка, запись и поле
Большинство программ UNIX обмениваются данными через текст, и это решение было принято сознательно: текст читается человеком, сохраняется в файл без специального формата и передаётся по конвейеру без дополнительной обработки 1. Философия UNIX предполагает, что каждая программа делает одно дело, а сложные задачи решаются соединением таких программ. Чтобы соединение работало, все программы должны понимать один и тот же формат — строки текста.
Строка (англ. line) — единица текста, ограниченная символом перевода строки. Поле (англ. field) — значение внутри строки, отделённое от соседних значений разделителем: пробелом, табуляцией, двоеточием, запятой или другим символом. Запись (англ. record) в большинстве случаев совпадает со строкой. Инструменты этой темы читают поток записей и в каждой записи выделяют поля: grep работает со строкой целиком, cut и awk — с полями, sed — со строкой как с текстом, в котором можно заменять любые фрагменты.
Удобный пример поля с разделителем — файл учётных записей /etc/passwd, где поля разделены двоеточиями. Для иллюстрации создадим небольшой файл с тремя строками, похожими на записи этого файла:
printf '%s\n' 'bob:x:1002:1002::/home/bob:/bin/bash' 'alice:x:1001:1001::/home/alice:/bin/bash' 'root:x:0:0:root:/root:/bin/bash' > passwd.demo
cut -d: -f1,3 passwd.demo
bob:1002
alice:1001
root:0
Опция -d: задаёт разделитель полей, а -f1,3 — номера полей, которые нужно вывести. Номера полей отсчитываются с единицы. Так же устроены многие другие инструменты: поле — это то, что стоит между разделителями, а не «слово» в смысле естественного языка.
Журнал веб-сервера и формат combined
Основным примером темы служит журнал доступа веб-сервера. Каждый запрос к сайту записывается в журнал одной строкой. Во многих веб-серверах используется формат, который называется combined; он содержит адрес клиента, время, запрос, код ответа, размер ответа, адрес страницы, с которой пришёл посетитель (referer), и строку идентификации программы клиента (User-Agent). Ниже приведена первая строка журнала, созданного генератором лабораторной работы; здесь и далее примеры выполняются в каталоге ~/lab-06/lr-env, где генератор создал каталог data:
head -n 1 data/access.log
198.51.100.88 - - [11/Oct/2026:00:00:36 +0000] "GET /about HTTP/1.1" 200 46932 "-" "Mozilla/5.0 (iPhone; CPU iPhone OS 17_5 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.5 Mobile/15E148 Safari/604.1"
Строка делится на поля не так очевидно, как кажется на глаз. Разделителем по умолчанию для awk служит любой пробел, поэтому дата и время записываются в два поля, запрос — в три, а строка User-Agent занимает столько полей, сколько в ней слов. Таблица 1 показывает разбиение по пробелам. Поля 1–10 имеют одинаковый смысл во всех строках журнала; поля, начиная с 11-го, зависят от строки.
Таблица 1. Поля строки журнала combined при разбиении по пробелам
| Номер поля | Содержимое в примере | Смысл |
|---|---|---|
| 1 | 198.51.100.88 | адрес клиента |
| 2 | - | идентификатор клиента (ident), обычно - |
| 3 | - | имя пользователя (authuser), - если аутентификации нет |
| 4 и 5 | [11/Oct/2026:00:00:36 и +0000] | дата, время и часовой пояс; при пробельном разбиении занимают два поля |
| 6, 7 и 8 | "GET, /about, HTTP/1.1" | метод, путь и версия протокола; запрос занимает три поля |
| 9 | 200 | код ответа |
| 10 | 46932 | размер тела ответа в байтах, - если тела нет |
| 11 | "-" | referer, адрес предыдущей страницы |
| 12 и далее | слова User-Agent | строка программы клиента, содержит пробелы и скобки |
Для проверки разбиения выведем первые десять полей строки с помощью awk. Подробно этот инструмент разбирается в разделе об awk, пока достаточно увидеть, что номера полей соответствуют таблице:
head -n 1 data/access.log | awk '{for (i = 1; i <= 10; i++) printf "$%d = [%s]\n", i, $i}'
$1 = [198.51.100.88]
$2 = [-]
$3 = [-]
$4 = [[11/Oct/2026:00:00:36]
$5 = [+0000]]
$6 = ["GET]
$7 = [/about]
$8 = [HTTP/1.1"]
$9 = [200]
$10 = [46932]
Если в качестве разделителя указать двойную кавычку, строка делится на части, соответствующие логическим частям записи: адрес и дата — в первом поле, запрос — во втором, размер ответа и код — в третьем, referer — в четвёртом, User-Agent — в шестом:
head -n 1 data/access.log | awk -F'"' '{for (i = 1; i <= 6; i++) printf "$%d = [%s]\n", i, $i}'
$1 = [198.51.100.88 - - [11/Oct/2026:00:00:36 +0000] ]
$2 = [GET /about HTTP/1.1]
$3 = [ 200 46932 ]
$4 = [-]
$5 = [ ]
$6 = [Mozilla/5.0 (iPhone; CPU iPhone OS 17_5 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.5 Mobile/15E148 Safari/604.1]
Именно это разбиение обычно удобнее для анализа: поле $6 содержит User-Agent целиком, а поле $2 — запрос целиком. Если же нужен код ответа, удобнее разбиение по пробелам, где код находится в поле 9. Выбор разделителя — первое решение, которое принимается при обработке любого журнала. Ошибка в нём даёт результат, который выглядит правдоподобно, но неверен, — поэтому полезно каждый раз проверять разбиение на одной строке.
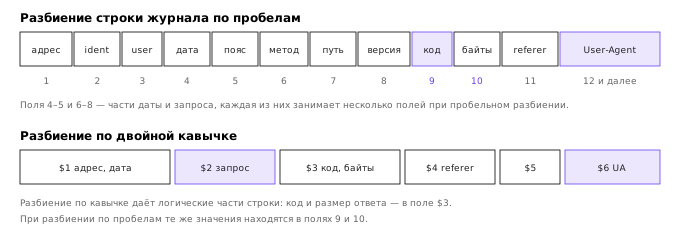
Рисунок показывает то же разбиение наглядно: над строкой отмечены номера полей при разбиении по пробелам, под строкой — части, которые получаются при разбиении по кавычкам.
Конвейер как поток текста
Программы этой темы читают текст со стандартного входа и пишут результат на стандартный выход, поэтому их можно соединять конвейером | — тем же механизмом, который рассматривался в теме 5. Каждая программа получает поток записей от предыдущей, преобразует его и передаёт следующей. Ни одна из программ не знает, откуда пришли данные: это может быть файл, вывод другой команды или клавиатура.
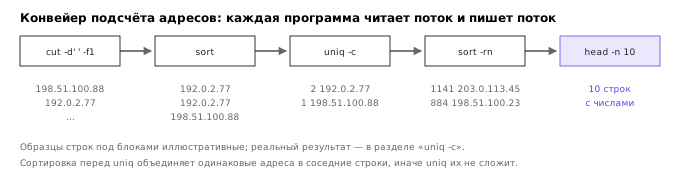
Типичная цепочка обработки журнала выглядит так: из строки выделяется адрес клиента, адреса сортируются, одинаковые адреса подсчитываются, результаты сортируются по количеству, и выводятся первые строки. Команда для такой цепочки будет разобрана в разделе про инструменты таблиц, здесь достаточно увидеть её структуру:
cut -d' ' -f1 data/access.log | sort | uniq -c | sort -rn | head -n 10
Каждый элемент конвейера решает одну задачу. Именно такая декомпозиция делает обработку текста понятной и проверяемой: можно остановиться на любом этапе, посмотреть промежуточный результат и убедиться, что он правильный. Этот приём — основной способ отладки обработки текста — и его стоит применять всегда. Схема этого конвейера приведена на рисунке ниже.
Регулярные выражения
Литералы и метасимволы
Регулярное выражение (англ. regular expression, сокращённо regex) — это шаблон, который описывает множество строк. Простейший шаблон состоит из обычных символов, которые совпадают сами с собой: шаблон GET находит слово GET в любом месте строки. Для описания более широкого множества строк используются метасимволы — символы со специальным значением. Чтобы метасимвол был воспринят как обычный символ, его экранируют обратной косой чертой: \. означает точку, а не «любой символ».
Таблица 2 содержит метасимволы, которые встречаются почти во всех диалектах регулярных выражений. Здесь показаны формы, которые одинаковы для BRE и ERE; различия будут разобраны в следующем подразделе.
Таблица 2. Основные метасимволы регулярных выражений
| Конструкция | Значение | Пример |
|---|---|---|
. | любой одиночный символ, кроме перевода строки | a.c совпадает с abc и a7c |
^ | начало строки | ^GET — строка, начинающаяся с GET |
$ | конец строки | HTTP/1\.1"$ — строка, заканчивающаяся на HTTP/1.1" |
* | ноль или более повторений предыдущего элемента | ab*c совпадает с ac, abc, abbc |
[abc] | один символ из перечисленных | [0-9] — одна цифра |
[^abc] | один символ, кроме перечисленных | [^0-9] — любой символ, не являющийся цифрой |
[[:digit:]] | класс POSIX: цифра | то же, что [0-9] в локали C |
\. | точка как обычный символ | 203\.0\.113\.45 — точный адрес |
\ с символом | экранирование метасимвола | \[ — открывающая квадратная скобка |
Подробное изложение регулярных выражений, включая поведение движков и типичные ошибки, есть в книге Фридла 2. Регулярные выражения в различных инструментах одинаковы по смыслу, но не по синтаксису. Шаблон, который работает в grep, почти наверняка будет работать и в sed, и в awk, однако экранирование служебных символов в них может отличаться. Поэтому при переходе от одного инструмента к другому полезно сверяться с руководством 3 4 5.
BRE и ERE: один шаблон в двух диалектах
Стандарт POSIX определяет два диалекта регулярных выражений. Базовые регулярные выражения (англ. basic regular expressions, BRE) — диалект по умолчанию в grep и sed. Расширенные регулярные выражения (англ. extended regular expressions, ERE) включаются ключом -E в grep и sed и используются в awk. Главное различие связано со служебными символами: в ERE символы ( ) { } | + ? имеют специальный смысл без экранирования, а в BRE для получения того же смысла их нужно экранировать обратной косой чертой, а без экранирования они считаются обычными символами.
Таблица 3. Различия диалектов BRE и ERE
| Конструкция | BRE | ERE |
|---|---|---|
| группа | \( и \) | ( и ) |
| альтернатива | | (расширение GNU) | | (в ERE — без обратной черты, то есть ` |
| одно и более | \+ (расширение GNU) | + |
| ноль или одно | \? (расширение GNU) | ? |
| интервал | \{m,n\} | {m,n} |
символ + без обратной черты | обычный символ | оператор повтора |
Различие лучше всего видно на примерах. Создадим небольшой файл, в котором есть строки с символами +, слова color и colour, адрес и дата:
printf '%s\n' 'a+b' 'aab' 'ab' 'abab' 'color' 'colour' '192.0.2.77' '2026-10-11' > re.txt
grep 'a+b' re.txt
a+b
В BRE символ + обычный, поэтому шаблон находит только строку, в которой есть буквально a+b. Теперь тот же шаблон в ERE:
grep -E 'a+b' re.txt
aab
ab
abab
В ERE a+ означает «одна или более букв a», поэтому шаблон находит строки, где перед b стоит хотя бы одна буква a. Строка a+b не попадает в вывод, потому что перед её b стоит символ +, а не a. Заметим, что такое поведение противоположно интуиции: первый пример ищет текст, второй — множество строк.
Аналогичная ситуация с группировкой и необязательными символами. Шаблон для слов color и colour удобно записать как colou?r:
grep 'colou\?r' re.txt
grep -E 'colou?r' re.txt
color
colour
color
colour
Здесь BRE потребовала экранирования \?. В GNU-реализации оно поддерживается как расширение, однако в строгом POSIX-режиме такой синтаксис не гарантирован. Поэтому при переносе шаблонов между системами полезно использовать ERE.
Интервал повторений записывается в BRE с экранированием фигурных скобок. Если его забыть, шаблон станет поиском буквального текста:
echo 'x5{2}' | grep '5{2}'
echo 'xx' | grep 'x\{2\}'
grep -E '^[0-9]{4}-[0-9]{2}-[0-9]{2}$' re.txt
x5{2}
xx
2026-10-11
Первый шаблон в BRE ищет буквальный текст 5{2}, второй — две буквы x через интервал, третий в ERE проверяет, что вся строка имеет вид даты. Он использует сразу три метасимвола — якоря ^ и $ и интервалы {4}, {2}. Такой шаблон полезен для проверки формата: строка подходит целиком, а не просто содержит дату.
Альтернатива позволяет искать одно из нескольких слов. Для журнала это удобно, например, для поиска редиректов и отказов:
grep -c '" \(301\|404\) ' data/access.log
grep -c -E '" (301|404) ' data/access.log
1629
1629
Обе формы дают одинаковый результат, но запись в ERE короче и легче читается. В этой теме все примеры для grep будут использовать ERE, кроме случаев, когда нужно показать различие диалектов.
Шаблоны для журнала
Регулярные выражения становятся полезными, когда их применяют к реальным данным. В журнале есть несколько мест, где простой шаблон даёт ложные совпадения. Рассмотрим поиск ответов с кодом 5xx. Первая попытка — искать три цифры, начинающиеся с 5, между пробелами:
grep -c ' 5[0-9][0-9] ' data/access.log
268
Результат 268 больше, чем число ответов с кодом 5xx, которое равно 212. Причина в том, что между пробелами может стоять и размер ответа: например, 512 или 598 байт. Чтобы шаблон искал именно код ответа, нужно учесть, что он стоит сразу после закрывающей кавычки запроса:
grep -c '" 5[0-9][0-9] ' data/access.log
212
Одна кавычка в шаблоне отличает код ответа от размера ответа. Это типичный приём: шаблон должен учитывать структуру строки, а не только её содержимое. Тот же принцип позволяет искать адреса в начале строки с помощью якоря:
grep -c '^203\.0\.113\.' data/access.log
6847
Якорь ^ привязывает шаблон к началу строки, а экранированные точки означают точки в адресе, а не произвольные символы. Без экранирования шаблон 203.0.113. нашёл бы и строки вида 203a0b113c, хотя в журнале таких адресов нет. Такая ошибка встречается часто, и её трудно заметить, потому что число совпадений выглядит правдоподобно.
Поиск без учёта регистра и поиск целых слов делаются ключами -i и -w. Для журнала полезно искать программы-роботы по подстроке bot, которая встречается в User-Agent поисковых роботов:
grep -c 'googlebot' data/access.log
grep -ci 'googlebot' data/access.log
grep -ci 'bot' data/access.log
0
912
1790
Робот Google записывает себя как Googlebot с заглавной буквы, поэтому поиск с учётом регистра не нашёл ни одной строки, а ключ -i нашёл 912. Подстрока bot в нижнем регистре есть и в Googlebot, и в bingbot, поэтому третья команда находит запросы обоих роботов. Такой поиск даёт приблизительный ответ: подстрока bot может встретиться и в других строках. Точность результата зависит от того, насколько хорошо шаблон описывает искомое, поэтому для ответа на вопрос о роботах всегда полезно посмотреть несколько найденных строк.
Регулярные выражения иногда совпадают с частью строки, а нужна только эта часть. Ключ -o выводит только совпавший фрагмент. Пример — извлечение IPv4-адресов из текста:
echo 'ip 203.0.113.45 and 10.0.0.1' | grep -o -E '([0-9]{1,3}\.){3}[0-9]{1,3}'
203.0.113.45
10.0.0.1
Шаблон проверяет форму адреса, но не значения октетов: адрес 999.1.1.1 он тоже примет. Для строгой проверки потребовался бы более сложный шаблон или отдельная проверка чисел. Такая оговорка важна: регулярные выражения описывают форму текста, а не его смысл.
Инструменты поиска и таблиц
grep: поиск строк
Команда grep выводит строки, которые соответствуют шаблону. Её имя происходит от команды редактора ed, которая выполняла поиск «g/re/p» — глобальный поиск регулярного выражения с выводом строк 3. Таблица 4 содержит опции, которые используются чаще всего.
Таблица 4. Основные опции grep
| Опция | Назначение |
|---|---|
-E | расширенные регулярные выражения (ERE) |
-i | поиск без учёта регистра |
-v | вывод строк, которые не соответствуют шаблону |
-n | вывод номеров строк |
-c | вывод только числа совпавших строк |
-o | вывод только совпавших фрагментов, каждый в своей строке |
-w | совпадение только с целым словом |
-m N | остановиться после N найденных строк |
-l | вывод только имён файлов, в которых есть совпадения |
-r | рекурсивный поиск по каталогам |
-q | без вывода, только код возврата |
Опция -n полезна для того, чтобы найти строку в журнале и вернуться к ней командой sed или less. Первые три строки с кодом 503 выглядят так:
grep -n -m 3 ' 503 ' data/access.log | cut -c1-120
9568:203.0.113.45 - - [11/Oct/2026:14:00:25 +0000] "GET /api/items HTTP/1.1" 503 197 "-" "Mozilla/5.0 (iPhone; CPU iPhon
9569:198.51.100.150 - - [11/Oct/2026:14:00:28 +0000] "POST /api/items HTTP/1.1" 503 197 "https://yandex.ru/" "Mozilla/5.
9588:192.0.2.205 - - [11/Oct/2026:14:00:54 +0000] "POST /api/items HTTP/1.1" 503 197 "https://nsu.example/" "Mozilla/5.0
Все три строки относятся к интервалу 14:00–14:20, в котором в генераторе моделируется всплеск отказов приложения. Номер строки показывает место записи в файле, а время — когда она произошла. Эта связь будет использована в разделе, где строится отчёт по часам.
Код возврата grep важен для сценариев. Команда возвращает 0, если найдено хотя бы одно совпадение, 1 — если совпадений нет, и 2 — при ошибке. Проверка с ключом -q позволяет использовать grep в условиях:
grep -q 'zzz' data/access.log; echo "код возврата: $?"
grep -q 'GET' data/access.log; echo "код возврата: $?"
код возврата: 1
код возврата: 0
Такой код возврата используется в ветвлениях скриптов, которые рассматриваются в темах 13 и 14. Здесь важно понять, что grep сообщает о результате поиска только через код возврата, а не через текст.
sort: сортировка и ключи
Команды sort, uniq, cut и tr входят в набор GNU Coreutils, их опции подробно описаны в руководстве 7. Команда sort переставляет строки в порядке возрастания. По умолчанию сравнение строковое: символы сравниваются по кодам, и число 10 стоит раньше 9, потому что первый символ 1 меньше 9. Для числового сравнения используется ключ -n, для обратного порядка — -r. Ключ -u оставляет только уникальные строки.
Когда строка состоит из полей, сортировка по полю задаётся ключом -k. Формат -k N,M означает: сортировать по полям от N до M. Без указания конца сортировка идёт до конца строки, что часто приводит к неожиданным результатам. Разделитель полей задаётся ключом -t. Вот файл с размерами файлов:
cat sizes.txt
report.pdf 2048
notes.txt 512
logo.png 18342
index.html 9000
todo 512
Сортировка по всей строке и по второму полю строковым сравнением даёт разные результаты:
sort -k2,2 sizes.txt
logo.png 18342
report.pdf 2048
notes.txt 512
todo 512
index.html 9000
Строковое сравнение ставит 18342 раньше 2048, потому что первый символ 1 меньше 2. Для чисел нужен ключ -n:
sort -k2,2n sizes.txt
notes.txt 512
todo 512
report.pdf 2048
index.html 9000
logo.png 18342
Чтобы сортировать по убыванию, добавляется r: sort -k2,2nr sizes.txt выводит logo.png первым. Порядок одинаковых значений (notes.txt и todo с размером 512) определяется исходным порядком строк только при устойчивой сортировке; sort в GNU по умолчанию сравнивает всю строку при равенстве ключей, поэтому здесь notes.txt стоит раньше todo по алфавиту.
Для файла с разделителем двоеточием ключ -t: обязателен:
sort -t: -k3,3n passwd.demo
root:x:0:0:root:/root:/bin/bash
alice:x:1001:1001::/home/alice:/bin/bash
bob:x:1002:1002::/home/bob:/bin/bash
Здесь сортировка идёт по третьему полю — идентификатору пользователя. Ключ -n нужен, иначе 1001 стояло бы раньше 2. Следует помнить, что порядок сортировки зависит от локали, которая задаётся переменными LANG и LC_ALL и рассматривается в теме 8. Для отчётов, которые должны совпадать у разных людей, полезно указывать локаль явно.
uniq -c и обязательная сортировка
Команда uniq удаляет повторяющиеся строки, но сравнивает только соседние строки. Поэтому одинаковые строки, разделённые другими, она не объединяет. С ключом -c команда выводит число повторений каждой группы. Демонстрация на небольшом файле:
printf '%s\n' b a b a a > u.txt
uniq -c u.txt
sort u.txt | uniq -c
      1 b
      1 a
      1 b
      2 a
      3 a
      2 b
Первый вызов uniq -c выдал шесть строк вместо двух, потому что группы одинаковых соседних строк короткие. Второй вызов сначала сгруппировал одинаковые строки сортировкой и только потом подсчитал их. Правило, которое нужно запомнить: перед uniq всегда стоит sort, если нужно подсчитать все вхождения, а не только соседние.
cut -d' ' -f1 data/access.log | uniq -c | sort -rn | head -n 3
      3 203.0.113.9
      3 203.0.113.9
      3 203.0.113.9
Результат выглядит как подсчёт, но это подсчёт серий соседних одинаковых адресов. Самый частый адрес 203.0.113.45 с 1141 запросом в этом выводе не появился вовсе. Правильная цепочка добавляет сортировку, а затем сортирует результат по числу запросов:
cut -d' ' -f1 data/access.log | sort | uniq -c | sort -rn | head -n 10
   1141 203.0.113.45
    884 198.51.100.23
    785 192.0.2.77
    664 203.0.113.9
    604 198.51.100.150
    518 192.0.2.130
    494 203.0.113.201
    398 198.51.100.7
    375 203.0.113.66
    355 192.0.2.14
Эта цепочка — основа большинства отчётов по журналу. Первый sort группирует одинаковые адреса, uniq -c подсчитывает их, второй sort -rn ставит самые частые адреса первыми, а head оставляет десять строк. Заметим, что поля выводятся в порядке «число, адрес»: так устроен вывод uniq -c, и это удобно для дальнейшей сортировки.
cut -d' ' -f1 data/access.log | sort -u | wc -l
406
cut, tr и другие инструменты таблиц
Команда cut вырезает фрагменты строк по полям (ключ -f, разделитель -d) или по позициям символов (ключ -c). Она работает быстро, но не умеет учитывать кавычки и пробелы внутри полей, поэтому для журнала с User-Agent её применяют только к полям без пробелов. Пример выбора трёх полей — адреса, пути и кода:
cut -d' ' -f1,7,9 data/access.log | head -n 2
198.51.100.88 /about 200
192.0.2.77 /static/app.js 304
Ключ -c выбирает символы по позициям: cut -c1-15 даёт первые 15 символов строки. Это удобно для коротких заголовков, но для журнала с переменной длиной полей почти бесполезно.
Команда tr работает на уровне отдельных символов: она заменяет одни символы другими, удаляет их или сжимает повторяющиеся. Замена регистра — типичный пример:
echo 'Hello World' | tr 'a-z' 'A-Z'
HELLO WORLD
printf 'a  b   c\n' | tr -s ' '
printf 'x\r\ny\r\n' | tr -d '\r' | od -c | head -n 2
a b c
0000000   x  \n   y  \n
0000004
Для работы с таблицами есть ещё четыре небольших инструмента, которые полезно знать хотя бы в обзоре. Команда paste склеивает строки нескольких файлов «бок о бок», а column -t выравнивает поля в столбцы для чтения человеком (в Ubuntu column входит в пакет bsdextrautils):
printf '%s\n' alice bob carol > names.txt
printf '%s\n' 1001 1002 1003 > uids.txt
paste -d: names.txt uids.txt
printf '%s\n' 'name uid shell' 'alice 1001 /bin/bash' 'bob 1002 /bin/zsh' | column -t
alice:1001
bob:1002
carol:1003
name   uid   shell
alice  1001  /bin/bash
bob    1002  /bin/zsh
Команда comm сравнивает два отсортированных файла и выводит три столбца: строки только первого файла, только второго и общие. Ключи -1, -2, -3 скрывают соответствующие столбцы, поэтому comm -12 выводит только общие строки. Команда join объединяет строки двух отсортированных файлов по общему полю, как соединение таблиц в базе данных:
printf '%s\n' alice bob carol > a.txt
printf '%s\n' bob carol dave > b.txt
comm -12 a.txt b.txt
printf '%s\n' 'alice 1001' 'bob 1002' 'carol 1003' > u.txt
printf '%s\n' 'alice admin' 'carol dev' > g.txt
join u.txt g.txt
bob
carol
alice 1001 admin
carol 1003 dev
Обе команды требуют, чтобы входные файлы были отсортированы по ключу сравнения; на несортированных данных они выдают неполный результат и предупреждение. Это то же правило, что и для uniq: сначала sort, затем сравнение.
sed: потоковый редактор
Построчная модель и подстановка
Команда sed (англ. stream editor, потоковый редактор) читает вход построчно, применяет к каждой строке набор команд и выводит результат. Исходный файл при этом не меняется, если не указан ключ -i. Наиболее частая команда — подстановка s/шаблон/замена/флаги. По умолчанию заменяется только первое совпадение в строке, флаг g заменяет все совпадения 4.
echo 'GET /a GET /b' | sed 's/GET/get/'
echo 'GET /a GET /b' | sed 's/GET/get/g'
get /a GET /b
get /a get /b
Первая команда заменила только первое слово, вторая — оба. Ошибка выбора флага часто остаётся незамеченной, потому что результат похож на правильный. В шаблоне sed используется BRE по умолчанию; ключ -E включает ERE, и тогда группы записываются без обратной косой черты, а в замене ссылки на группы имеют вид \1, \2 и т. д.:
echo '2026-10-11' | sed -E 's/([0-9]{4})-([0-9]{2})-([0-9]{2})/\3.\2.\1/'
11.10.2026
Шаблон запоминает три группы — год, месяц и день, — а замена выводит их в обратном порядке. Такая перестановка полей встречается при приведении дат к нужному формату.
Адреса строк
Адрес определяет, к каким строкам применяется команда. Адрес может быть номером строки, диапазоном номеров, регулярным выражением или символом $, обозначающим последнюю строку. Команда p печатает строку, а d удаляет её. Ключ -n подавляет автоматический вывод, и тогда печатаются только строки, для которых явно вызвана команда p.
sed -n '2,3p' sizes.txt
sed '/notes/d' sizes.txt
sed -n '$p' sizes.txt
notes.txt 512
logo.png 18342
report.pdf 2048
logo.png 18342
index.html 9000
todo 512
todo 512
Первая команда вывела строки со второй по третью, вторая удалила строку, содержащую notes, третья вывела последнюю строку. В журнале адреса с регулярными выражениями позволяют выбрать строки за определённый интервал или по определённому признаку. Например, строки с кодом 503 можно выбрать адресом / 503 / — это проверяется на примере лабораторной работы.
Команды sed можно записывать с другим разделителем, если в шаблоне есть косые черты. Путь файла в конфигурации удобнее записывать как s|/old/path|/new/path|, чтобы не экранировать каждый слеш. Разделитель может быть любым символом, кроме буквы и обратной косой черты.
Правка на месте и резервная копия
Ключ -i меняет файл на месте: sed записывает результат в файл, а не на экран. Опасность состоит в том, что исходный текст теряется, если команда написана неверно. Поэтому правка на месте должна выполняться с резервной копией. Ключ -i.bak сохраняет исходный файл под именем с суффиксом .bak, а новый файл получает изменения. В GNU sed суффикс записывается сразу после -i; в BSD и macOS синтаксис другой (-i ''), и команда, написанная для Linux, там не сработает.
Рассмотрим учебный файл конфигурации server.conf, в котором нужно изменить параметр upstream_timeout с 30 на 60. Сначала проверим, какие строки подходят под шаблон:
grep -n 'upstream' server.conf
11:upstream_timeout = 30
Теперь выполним правку с резервной копией и сравним файлы:
sed -i.bak 's/^upstream_timeout = 30/upstream_timeout = 60/' server.conf
ls server.conf server.conf.bak
diff server.conf.bak server.conf
server.conf
server.conf.bak
11c11
< upstream_timeout = 30
---
> upstream_timeout = 60
Команда diff показала единственное отличие. Обозначение 11c11 означает «строка 11 первого файла заменена строкой 11 второго файла». Строки, начинающиеся с <, принадлежат первому файлу, строки с > — второму. Якорь ^ в шаблоне защищает от случайной замены текста в комментарии, где та же строка могла бы встретиться в середине.
Перед правкой на месте полезно сделать пробный запуск без -i: команда выводит результат на экран, и её можно проверить. Если результат правильный, добавляется ключ -i. Такой порядок действий предотвращает большинство ошибок, связанных с необратимой заменой.
Опасности sed
Самая частая ошибка — регулярное выражение, которое совпадает с большим фрагментом текста. Жадный шаблон .* захватывает всё, что может, и замена затрагивает больше, чем предполагалось. Например, в строке журнала шаблон ".*" захватит всё от первой кавычки до последней, включая запрос и User-Agent. Более точный шаблон "[^"]*" ищет одну пару кавычек и не выходит за неё. Этот пример показывает, что точность шаблона важнее его краткости.
awk: поля, шаблоны и действия
Модель «шаблон и действие»
Язык awk назван по первым буквам авторов — Aho, Weinberger и Kernighan 6. Программа на awk состоит из правил вида шаблон { действие }. Программа читает записи (по умолчанию строки) и для каждой записи проверяет каждое правило: если шаблон совпал, выполняется действие. Если шаблон опущен, действие выполняется для каждой записи. Если действие опущено, выводится вся запись.
Во время обработки awk разделяет запись на поля и хранит их в переменных $1, $2 и т. д. Переменная $0 содержит всю запись, NF — число полей в записи, NR — номер текущей записи. Значение $NF — последнее поле записи. Эти переменные используются почти во всех программах awk 5.
awk '{print $1, $9}' data/access.log | head -n 2
198.51.100.88 200
192.0.2.77 304
Правило без шаблона выводит адрес и код ответа для каждой строки. Правило с шаблоном выбирает строки, отвечающие условию. Для подсчёта ошибок 5xx подходит шаблон, проверяющий начало кода ответа:
awk '$9 ~ /^5/' data/access.log | wc -l
awk '$9 >= 500' data/access.log | wc -l
212
212
Оператор ~ проверяет соответствие регулярному выражению, которое записывается между косыми чертами. Оператор >= сравнивает числа. Оба варианта дают одинаковый результат для кодов 5xx, потому что в журнале нет кодов, начинающихся с 5, которые были бы меньше 500.
Правило END выполняется один раз после обработки всех записей. Оно удобно для итогов. Например, число записей в файле:
awk 'END {print NR}' data/access.log
20000
Разбиение по пробелам при работе с журналом дает опасный результат для $NF. Последнее поле строки — последнее слово User-Agent, а не сам User-Agent:
head -n 1 data/access.log | awk '{print NF; print $NF}'
28
Safari/604.1"
Именно поэтому в журнале с User-Agent разделитель обычно задаётся кавычкой. Ключ -F задаёт разделитель полей, и его значение может быть строкой или регулярным выражением. Для журнала удобнее всего -F'"'.
Переменные и ассоциативные массивы
Переменные awk не требуют объявления и бывают числовыми или строковыми. Пустая переменная в числовом контексте равна нулю, а строка «-» при сложении превращается в ноль. Особенность awk, которая отличает его от большинства языков, — массивы ассоциативные: индексом может быть строка. Массив создаётся при первом обращении к элементу, поэтому подсчёт вхождений записывается одной строкой: n[$9]++ увеличивает счётчик для кода ответа, стоящего в $9.
awk '{n[$9]++} END {for (s in n) printf "%s %d\n", s, n[s]}' data/access.log | sort
200 15449
301 464
302 538
304 2010
401 162
404 1165
500 125
502 49
503 38
Обход массива в цикле for (ключ in массив) выполняется в порядке, который не задан стандартом. Вывод может быть в другом порядке в разных версиях awk, поэтому результат принято сортировать внешней командой sort. Этот приём используется во всех отчётах темы.
Ассоциативные массивы позволяют суммировать значения по группам. Размер переданных данных по кодам ответа вычисляется так:
awk '{b[$9] += $10} END {for (s in b) printf "%-4s %12d\n", s, b[s]}' data/access.log | sort | head -n 4
200     374046988
301         78416
302             0
304             0
Для кодов 302 и 304 тело ответа отсутствует, и поле содержит «-». При сложении в числовом контексте оно превращается в ноль, поэтому суммы корректны. Такое поведение удобно, но оно скрывает отсутствие данных: если нужно различать «ноль» и «нет тела», это приходится проверять отдельно.
Подсчёт уникальных значений удобно делать массивом, в котором проверяется, встречался ли ключ раньше. Выражение !seen[$6]++ истинно только при первом появлении значения. Число уникальных User-Agent можно получить так:
awk -F'"' '!seen[$6]++ {c++} END {print c}' data/access.log
13
В журнале всего 13 различных строк User-Agent, включая строки роботов. Поле $6 при разделении по кавычкам содержит строку User-Agent целиком, поэтому такой подсчёт корректен, а при разделении по пробелам он дал бы неверный результат.
printf и форматированный вывод
Команда print выводит значения через пробел и добавляет перевод строки. Для выравнивания столбцов и управления числом знаков используется printf, который работает так же, как одноимённая функция языка C. Формат задаётся строкой со спецификаторами: %s для строки, %d для целого числа, %.2f для числа с двумя знаками после запятой, %-8s для строки с выравниванием влево в восьми позициях, %% для знака процента. Перевод строки в printf не добавляется и записывается явно как \n.
awk 'BEGIN { printf "%-8s %6d\n", "ok", 42 }'
ok 42
Спецификатор %-8s дополнил слово ok пробелами до восьми позиций, а %6d выровнял число по правому краю в шести позициях. Такой вывод удобен для таблиц, которые читаются глазами.
Сквозной разбор журнала
Отчёт по журналу
Задача отчёта — ответить на несколько вопросов по журналу: сколько было запросов, сколько ошибок, какие адреса наиболее активны, в какие часы нагрузка максимальна. Сначала ответим на вопрос о часах. Час записан в дате и времени, и в строке журнала он отделён двоеточием от даты:
cut -d: -f2 data/access.log | sort | uniq -c | head -n 4
    132 00
    157 01
    142 02
    163 03
Таблица полностью показывает суточный ход нагрузки, но её удобнее смотреть по сумме за каждый час. Для вопроса о пиках важнее другое: число ошибок по часам. Оно позволяет увидеть интервал, в котором отказы сгруппированы:
awk '$9 == 503 {split($4, t, ":"); h[t[2]]++} END {for (x in h) print x, h[x]}' data/access.log | sort -n
14 38
Все 38 ответов 503 приходятся на час с 14:00. Внутри этого часа они сгруппированы в первых двадцати минутах, что видно по номерам строк предыдущего примера. Такой вывод не доказывает причину, но указывает, где её нужно искать — в журнале ошибок error.log, в котором есть записи с той же датой и адресами клиентов.
Поиск адресов с ошибками и сравнение с общим числом запросов тоже делаются по журналу. Чтобы понять, какие страницы дают отказы, удобно извлечь путь без строки запроса. Для этого используется разбиение по кавычкам и обрезка параметров:
awk -F'"' '$3 ~ /^ 5[0-9][0-9] / {split($2, r, " "); p = r[2]; sub(/\?.*/, "", p); print p}' data/access.log | sort | uniq -c | sort -rn
    161 /api/items
     51 /api/items/42
Все отказы сосредоточены на двух адресах приложения: /api/items и /api/items/42. Для администратора сайта это указание на конкретный компонент, а не на весь сервер. Такой вывод получен без чтения журнала глазами, но проверить его можно, выбрав несколько строк командой grep.
Сравнение конвейера и одной программы awk
Для отчёта можно использовать конвейер из нескольких программ или одну программу awk. Сравним два решения на одной задаче — подсчёт запросов по кодам ответа с долей в процентах. Конвейер выглядит так:
awk '{print $9}' data/access.log | sort | uniq -c | awk '{printf "%s %d %.2f\n", $2, $1, 100 * $1 / 20000}' | sort -n | head -n 4
200 15449 77.25
301 464 2.32
302 538 2.69
304 2010 10.05
Здесь число 20000 записано вручную, что нарушает универсальность: при другом размере журнала результат станет неверным. Программа awk может получить общее число запросов сама и вывести всю таблицу за один проход:
awk '
{ total++; bytes += $10; code[$9]++ }
$9 ~ /^5/ { errors++ }
END {
    printf "Запросов всего:   %d\n", total
    printf "Ответов 5xx:      %d (%.2f %%)\n", errors, 100 * errors / total
    printf "Передано, байт:   %d\n", bytes
    printf "Код  Запросов  Доля\n"
    fflush()
    for (c in code) printf "%s %d %.2f\n", c, code[c], 100 * code[c] / total | "sort -n"
}' data/access.log
Запросов всего:   20000
Ответов 5xx:      212 (1.06 %)
Передано, байт:   374372975
Код  Запросов  Доля
200 15449 77.25
301 464 2.32
302 538 2.69
304 2010 10.05
401 162 0.81
404 1165 5.83
500 125 0.62
502 49 0.24
503 38 0.19
Вызов fflush() перед выводом таблицы в канал гарантирует, что заголовок выведен раньше строк, которые сортирует внешняя программа sort. Без него порядок строк может нарушиться, потому что вывод awk буферизуется. Конвейер и программа дают одинаковые значения долей. Конвейер удобен при исследовании: каждый его шаг можно проверить отдельно. Одна программа awk удобнее для итогового отчёта, потому что все показатели считаются за один проход по файлу, а общее число запросов вычисляется, а не задаётся вручную.
JSON: данные, у которых есть структура
До сих пор запись была плоской: строка, а в ней поля, отделённые пробелом или кавычкой. Многие современные программы выдают данные в другом формате — JSON (англ. JavaScript Object Notation). Его используют ответы веб-интерфейсов (API), журналы современных серверов и контейнеров, конфигурации. JSON строится из нескольких конструкций. Объект — набор пар «ключ: значение» в фигурных скобках, ключ всегда строка в двойных кавычках. Массив — упорядоченный список значений в квадратных скобках. Значением может быть строка, число, true, false, null, а также другой объект или массив, поэтому объекты и массивы вкладываются друг в друга на любую глубину.
Для примеров используем небольшой файл data/items.json из архива окружения: ответ учебного интерфейса магазина /api/items, сохранённый в файл. Он содержит массив товаров, у каждого есть вложенный объект stock (остатки) и массив tags. Журнал доступа в этом же формате тоже есть: генератор make_json.py превращает access.log в файл data/access.jsonl, где каждая строка — отдельный объект. Такой вариант называют JSON Lines: один объект на строку, поэтому файл по-прежнему можно читать построчно. Подготовка данных описана в лабораторной работе 6.
Почему для JSON плохо подходят приёмы предыдущих разделов? Потому что смысл JSON задаётся структурой, а не расположением символов в строке. Одни и те же данные могут быть записаны с отступами на нескольких строках или в одной строке без пробелов, и для программы, читающей JSON, это один и тот же документ. Покажем, что получается у grep. Сначала найдём цены в файле, отформатированном с отступами:
grep -o '"price": [0-9]*' data/items.json | head -n 2
"price": 120
"price": 2400
Теперь сожмём тот же документ в одну строку (jq -c, подробности ниже) и повторим поиск:
jq -c . data/items.json > compact.json
grep -c '"price": ' compact.json
0
Шаблон не нашёл ничего: в сжатой записи после двоеточия нет пробела, хотя данные те же. Есть и более принципиальные причины. Одинаковые ключи могут встречаться на разных уровнях вложенности, и построчный поиск не отличит, к какому объекту относится найденное значение; строка может содержать экранированные кавычки и запятые; значение может занимать несколько строк. Построчный awk с разделителем «двойная кавычка» работал для combined, потому что формат фиксирован; для JSON, где порядок и форматирование ключей не гарантированы, такой подход ломается при первом изменении программы-источника. Поэтому для JSON применяют инструмент, который разбирает документ по правилам формата.
jq: фильтр, поле, элемент массива
Программа jq — это «sed для JSON»: она читает JSON со стандартного ввода или из файла, применяет к нему фильтр (небольшую программу на собственном языке) и печатает результат. Как и остальные инструменты темы, она работает в конвейере, а потому легко комбинируется с sort и uniq. Пакет называется jq; установка — sudo apt install jq. Простейший фильтр . означает «документ целиком», и jq печатает его отформатированным и, если терминал поддерживает цвет, подсвеченным. Это самый быстрый способ прочитать неотформатированный ответ:
jq . data/items.json | head -n 12
{
  "status": "ok",
  "total": 5,
  "items": [
    {
      "id": 1,
      "name": "Кабель UTP 5e, 3 м",
      "price": 120,
      "tags": [
        "сеть",
        "кабель"
      ],
Выбор поля записывается через точку: .total, а вложенное поле — цепочкой .items и далее. Элемент массива выбирается индексом в квадратных скобках (индексы с нуля), а все элементы сразу — пустыми скобками .items[]; фильтры соединяются знаком |, как команды в конвейере, и результат левого передаётся правому. Запятая вычисляет несколько фильтров над одним входом:
jq '.total, .items[0].name' data/items.json
5
"Кабель UTP 5e, 3 м"
Строки выводятся в кавычках, как значения JSON. Для передачи в sort, cut или while read кавычки мешают, поэтому используется ключ -r (англ. raw): строки печатаются как есть. Чтобы получить имена всех товаров по одному в строке:
jq -r '.items[].name' data/items.json
Кабель UTP 5e, 3 м
Коммутатор 8 портов
Патч-панель 24 порта
Монитор 24 дюйма
Разъём RJ-45 (100 шт.)
Выражение .items[].name читается слева направо: взять поле items, развернуть массив в отдельные элементы, из каждого взять name. Для самого массива и объектов есть функции length (число элементов массива или ключей объекта) и keys (отсортированный список ключей):
jq '.items | length' data/items.json
jq -c '.items[0] | keys' data/items.json
5
["id","name","price","stock","tags"]
Ключ -c (англ. compact) печатает каждый результат в одной строке без отступов. Он нужен, когда результатом служат объекты или массивы, а читать их будет следующая программа конвейера, и когда нужно получить именно JSON Lines.
Отбор, преобразование и построение новых объектов
Аналог grep для JSON — функция select(условие): она пропускает элемент дальше, если условие истинно, и ничего не возвращает в противном случае. В условии можно сравнивать числа и строки (==, !=, <, >), соединять условия словами and, or, not, обращаться к вложенным полям. Выберем товары, которых нет на основном складе:
jq -c '.items[] | select(.stock.main == 0) | {id, name}' data/items.json
{"id":2,"name":"Коммутатор 8 портов"}
Фрагмент {id, name} — построение нового объекта: запись сокращает {id: .id, name: .name}. Значение можно вычислять: {id, total: (.stock.main + .stock.reserve)} создаст объект с суммарным остатком. Функция map(фильтр) применяет фильтр к каждому элементу массива и собирает результаты в новый массив, а add складывает элементы массива. Сумма цен всех товаров вычисляется так:
jq '.items | map(.price) | add' data/items.json
14630
Для табличного вывода у jq есть форматы @csv и @tsv. Они применяются к массиву и превращают его в строку CSV (с кавычками вокруг строк и экранированием) или в строку с табуляциями. Обязательно использовать их вместе с -r, иначе результат будет ещё раз закодирован как JSON-строка:
jq -r '.items[] | [.id, .name, .price] | @csv' data/items.json
1,"Кабель UTP 5e, 3 м",120
2,"Коммутатор 8 портов",2400
3,"Патч-панель 24 порта",1850
4,"Монитор 24 дюйма",9700
5,"Разъём RJ-45 (100 шт.)",560
Формат @csv всегда берёт строки в кавычки, а числа оставляет как есть, поэтому запятая внутри названия «Кабель UTP 5e, 3 м» безопасна: программа, читающая CSV, не примет её за разделитель столбцов. Попытка собрать такую строку вручную через echo "$id,$name,$price" дала бы лишний столбец. Для обычного текстового конвейера удобнее @tsv: табуляция в названиях встречается редко, а cut и awk -F'\t' разбирают её без хлопот.
Значение из оболочки передают в фильтр ключом --arg имя значение, а не подстановкой в текст фильтра: тогда кавычки и спецсимволы в значении не сломают программу. Внутри фильтра переменная пишется как $имя. Чтобы фильтр не раскрывала оболочка, его заключают в одинарные кавычки:
jq --arg tag сеть -c '.items[] | select(.tags | index($tag)) | .id' data/items.json
1
2
3
Таблица 5 собирает основные элементы языка jq, использованные выше.
Таблица 5. Основные элементы jq
| Запись | Смысл |
|---|---|
. | документ целиком |
.a.b | поле b вложенного объекта в поле a |
.a[0], .a[] | первый элемент массива; все элементы по очереди |
ф1 | ф2 | результат первого фильтра подаётся второму |
select(условие) | пропустить элемент, если условие истинно |
map(ф), add, length, keys | преобразовать элементы массива, сложить, посчитать, перечислить ключи |
{id, name} | построить новый объект |
ф // значение | значение по умолчанию, если результат пуст или null |
-r, -c, -s | сырые строки без кавычек; компактный вывод; прочитать все входные объекты в один массив |
@csv, @tsv | оформить массив как строку CSV или TSV (использовать с -r) |
--arg имя значение | передать значение из оболочки в переменную $имя |
jq в конвейере: журнал в формате JSON Lines
Соединим jq с инструментами темы на журнале data/access.jsonl. Он содержит те же 20 000 запросов, что и access.log, но в виде объектов: поля ip, time, method, path, status, bytes, а также ms (время обработки в миллисекундах) и вложенный объект client с полями ua и referer. Поле ms в формате combined отсутствует, и в учебном файле его значения сгенерированы, поэтому смысл имеет только их сопоставление, а не абсолютные цифры. Первая проверка — число ответов 5xx. Оно должно совпасть с уже известным значением 212 из access.log:
jq -c 'select(.status >= 500)' data/access.jsonl | wc -l
212
Здесь сравнение выполняется над числом, а не над текстом, поэтому не нужно думать о пробелах вокруг кода. Типичная задача «топ адресов» строится как конвейер: jq -r выделяет поле (по одному значению в строке), а дальше работает уже известная связка sort | uniq -c | sort -rn:
jq -r '.ip' data/access.jsonl | sort | uniq -c | sort -rn | head -n 3
   1141 203.0.113.45
    884 198.51.100.23
    785 192.0.2.77
Так же считаются пути с ошибкой 503. Вложенные поля (например, .client.referer) выбираются цепочкой, а оператор // подставляет запасное значение вместо null:
jq -r 'select(.status == 503) | .path' data/access.jsonl | sort | uniq -c
jq -r '.client.referer // "-"' data/access.jsonl | sort | uniq -c | sort -rn | head -n 3
     25 /api/items
     10 /api/items/42
      1 /api/items?page=6
      1 /api/items?page=8
      1 /api/items?page=9
  11942 -
   2036 https://nsu.example/news/
   2035 https://www.google.com/
Ключ -s (англ. slurp) собирает все входные объекты в один массив, после чего доступны агрегаты над всем журналом: jq -s 'map(.ms) | add / length | floor' вычисляет среднее время, а group_by(.status) группирует записи. Платой за это служит память: весь файл загружается целиком, поэтому для больших журналов предпочитают потоковую обработку без -s с последующим sort/awk. Среднее время обработки по учебному журналу равно 49 мс. Список медленных запросов в виде таблицы с табуляциями (вывод ограничен тремя строками) получается так:
jq -r 'select(.ms > 3000) | [.time, .path, .status, .ms] | @tsv' data/access.jsonl | head -n 3
11/Oct/2026:09:29:47 +0000	/api/items	502	3665
11/Oct/2026:10:49:27 +0000	/api/items	500	3442
11/Oct/2026:12:26:09 +0000	/api/items?page=2	500	3762
Вывод показывает то, что невозможно получить из combined: время обработки каждого запроса. В учебном журнале дольше трёх секунд обрабатывались 11 запросов, и все они закончились ответами 5xx; так устроен генератор, в настоящих журналах такой связи может не быть, но проверить её теперь можно одной командой. Если документ повреждён, jq сообщает об этом, не печатает частичный результат и завершается с ненулевым кодом возврата (в версии 1.6 из Ubuntu 22.04 это код 4, в более новых версиях — 2). В скриптах этот код нужно проверять; в конвейере код jq доступен через массив PIPESTATUS:
echo '{"a": ' | jq . ; echo "код возврата: ${PIPESTATUS[1]}"
parse error: Unfinished JSON term at EOF at line 2, column 0
код возврата: 4
Этот вывод получен в jq 1.6 (Ubuntu 22.04). В Ubuntu 24.04 установлен jq 1.7.1: там код возврата равен 2, а сообщение начинается с префикса jq: parse error:, остальной текст тот же.
Получение JSON по сети — работа программы curl: curl -s адрес | jq ... является обычной связкой, подробно — в теме 11. Здесь важно, что ответ приходит в виде текста, и дальше действуют те же правила конвейера: перед тяжёлой обработкой его удобно сохранить в файл и разобрать на копии.
Итоги темы
Обработка текста опирается на три идеи, которые связывают инструменты этой темы. Первая — текст как интерфейс: строка журнала или таблица полей становятся данными, если известно, как они разделены. Выбор разделителя — первое решение, от которого зависит весь результат, и проверка разбиения на одной строке — обязательный шаг. Вторая идея — регулярное выражение описывает форму текста, а не его смысл. Шаблон " 5[0-9]{2} отделяет код ответа от размера, потому что учитывает структуру строки, а не только набор символов. Третья идея — конвейер строится из программ, каждая из которых решает одну задачу, и промежуточный результат всегда можно проверить.
Инструменты дополняют друг друга. grep отбирает строки, cut и awk выделяют поля, sort и uniq -c считают вхождения, а sed правит текст построчно. Важнейшие ошибки связаны с порядком действий: uniq работает только с отсортированными соседними строками, а правка sed -i без резервной копии необратима. Поэтому при работе с журналом полезно сохранять промежуточные результаты и сверяться с ними. Для JSON построчные инструменты не годятся: его разбирает jq, который выбирает поля и элементы массивов, фильтрует записи через select, передаёт значения из оболочки через --arg и превращает результат в строки для конвейера (-r, @csv, @tsv).
Тема подготовила почву для программирования на Bash. Скрипты берут на себя повторяющиеся действия: поиск по журналу, отчёт за день, правку конфигурации с проверкой. Условия и циклы, которые позволяют обрабатывать файлы в цикле, рассматриваются в теме 14, а в теме 13 появляется первый скрипт. Процессы, которые отвечают за работу сервера, и их завершение будут рассмотрены в теме 7, а конфигурация сервиса и журналы systemd — в теме 9.
Литература
- Shotts W. The Linux Command Line: A Complete Introduction. 2nd ed. — No Starch Press, 2019. Открытая версия: https://linuxcommand.org/tlcl.php
- Friedl J. E. F. Mastering Regular Expressions. 3rd ed. — O'Reilly Media, 2006.
- Free Software Foundation. GNU Grep Manual. — https://www.gnu.org/software/grep/manual/
- Free Software Foundation. GNU sed Manual. — https://www.gnu.org/software/sed/manual/
- Robbins A. Gawk: Effective AWK Programming. — Free Software Foundation. https://www.gnu.org/software/gawk/manual/
- Aho A. V., Kernighan B. W., Weinberger P. J. The AWK Programming Language. 2nd ed. — Addison-Wesley, 2023.
- Free Software Foundation. GNU Coreutils Manual. — https://www.gnu.org/software/coreutils/manual/