
Изоляция процессов: пространства имён, cgroups, ограничения
В предыдущих разделах система рассматривалась как единое общее пространство. В теме 4 изучались пользователи и классические права доступа, в теме 7 — процессы и сигналы, в теме 9 — службы systemd, в теме 10 — дисковые разделы и точки монтирования, а в теме 11 — сетевые интерфейсы и доступ по SSH. До сих пор любая запущенная программа видела все процессы в таблице ps, разделяла общее дерево каталогов / и использовала общие сетевые адреса машины. Однако на серверах часто требуется запустить недоверенный код или изолировать независимые службы друг от друга так, чтобы сбой или компрометация одного сервиса не затронули остальные части операционной системы 1.
В современной индустрии для этого повсеместно применяются контейнеры (Docker, Podman, containerd). Начинающие специалисты нередко воспринимают контейнер как облегчённую виртуальную машину или особую «магию». В действительности в ядре Linux нет системного вызова «создать контейнер». Контейнер — это обычный процесс пользовательского пространства, для которого ядро применило четыре стандартных механизма изоляции: пространства имён (англ. namespaces), контрольные группы (англ. control groups, cgroups), многослойную файловую систему (англ. OverlayFS) и привилегии ядра (англ. capabilities) 2.
В этой теме подробно разбирается, как устроены эти фундаментальные механизмы ядра Linux. Изложение строится последовательно: от исторического корня изоляции — системного вызова chroot — к семи современным типам пространств имён, далее к многослойным файловым системам, ограничению аппаратных ресурсов в cgroups v2 и тонкой настройке безопасности служб через директивы песочницы systemd. Все команды выполнены в среде Ubuntu; примеры вывода отражают реальное поведение ядра.
От chroot к современным контейнерам
Зачем изолировать процессы
При эксплуатации серверов возникают три главные задачи, требующие изоляции: безопасность, воспроизводимость и управление ресурсами.
С точки зрения безопасности программа не должна видеть и изменять чужие данные. Если веб-сервер скомпрометирован злоумышленником, атакующий не должен иметь возможности прочитать конфигурационные файлы соседней базы данных, перехватить трафик на сетевом интерфейсе или отправить сигнал завершения критически важным службам.
С точки зрения воспроизводимости и зависимостей разным приложениям требуются разные версии системных библиотек, интерпретаторов и конфигураций. Изоляция файловой системы позволяет запустить приложение со всеми его зависимостями в виде отдельного изолированного дерева каталогов (англ. rootfs), не конфликтуя с пакетами хостовой системы 1.
С точки зрения управления ресурсами один процесс не должен монополизировать центральный процессор или исчерпать всю оперативную память машины, приводя к аварийной остановке всей операционной системы.
Исторический предшественник: chroot и его пределы
Первым механизмом изоляции в UNIX стал системный вызов chroot (англ. change root), появившийся ещё в Version 7 UNIX в 1979 году. Он изменяет корневой каталог для вызывающего процесса и всех его будущих потомков.
Если процесс выполнил смену корня в каталог /opt/jail, то путь / внутри процесса начинает указывать именно на /opt/jail. Процесс теряет возможность адресовать файлы выше этого каталога через стандартные относительные пути вроде ../../. Однако chroot решает только задачу изоляции путей файловой системы и обладает принципиальными ограничениями:
- Процесс с правами суперпользователя (
root) может легко покинуть пределы chroot-окружения, например создав новое устройство или открыв файловый дескриптор за пределами корня до вызоваchroot2. - Таблица процессов остаётся глобальной: процесс видит все программы хоста и может отправлять им сигналы.
- Сеть, имя узла, межпроцессное взаимодействие (IPC) и пользователи остаются общими.
- Потребление памяти и процессора никак не ограничивается.
Из-за этого chroot называют «песочницей», но не средством полной изоляции. Для полноценного контейнера потребовались более глубокие изменения в архитектуре ядра.
Из чего на самом деле собран контейнер
Современный Linux-контейнер собирается ядром из четырёх независимых компонентов, показанных на рисунке 1.
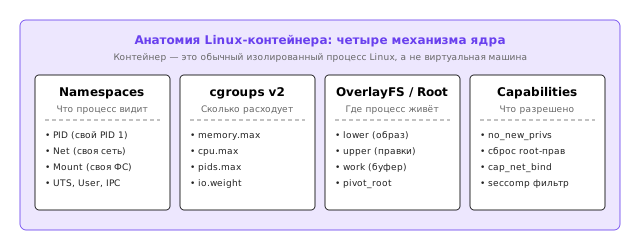
Как видно из рисунка, каждый компонент отвечает за свою грань изоляции:
- Пространства имён (Namespaces) определяют, что процесс видит в системе (свой список процессов, свои сетевые интерфейсы, свои точки монтирования).
- Контрольные группы (cgroups v2) задают, сколько ресурсов процесс может потребить (лимиты оперативной памяти, долей процессорного времени, числа процессов и дискового ввода-вывода).
- Корневая файловая система и OverlayFS определяют, где процесс находится и какие файлы ему доступны.
- Возможности (Capabilities) и фильтры системных вызовов определяют, какие привилегированные операции ядро разрешает выполнять процессу.
Движки контейнеризации вроде Docker или Podman являются лишь удобными консольными утилитами, автоматизирующими вызовы этих встроенных механизмов ядра 3.
Пространства имён (Namespaces)
Семь видов пространств имён Linux
Пространство имён (англ. namespace) — это абстракция ядра Linux, изолирующая определённый системный ресурс так, чтобы процессы внутри пространства имён видели только собственный изолированный экземпляр этого ресурса 2. Ядро поддерживает восемь типов пространств имён, семь из которых являются основными при контейнеризации. Они перечислены в таблице.
| Пространство имён | Флаг clone / unshare | Изолируемый ресурс | Назначение |
|---|---|---|---|
mnt (Mount) | CLONE_NEWNS | Точки монтирования файловых систем | Своё независимое дерево каталогов и монтирований |
pid (Process ID) | CLONE_NEWPID | Идентификаторы процессов | Своя нумерация процессов, собственный процесс с PID 1 |
net (Network) | CLONE_NEWNET | Сетевой стек, интерфейсы, маршруты | Свои IP-адреса, порты, таблицы маршрутизации, iptables |
uts (UNIX Timesharing) | CLONE_NEWUTS | Имя узла и доменное имя | Свой hostname и domainname |
ipc (Inter-Process) | CLONE_NEWIPC | Очереди сообщений, семафоры, память System V | Изоляция разделяемой памяти между приложениями |
user (User ID) | CLONE_NEWUSER | Идентификаторы пользователей и групп | Отображение UID/GID; непривилегированный root |
cgroup (Control Group) | CLONE_NEWCGROUP | Корень иерархии контрольных групп | Скрывает структуру cgroup хоста |
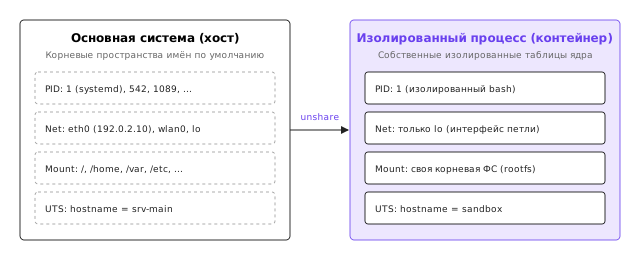
Различие между глобальной таблицей хоста и изолированными таблицами процессов проиллюстрировано на рисунке 2.
Исследование пространств: /proc/PID/ns и lsns
Для каждого запущенного процесса ядро экспортирует ссылки на связанные с ним пространства имён в виртуальной файловой системе procfs по пути /proc/<PID>/ns/. Посмотрим на пространства имён текущей командной оболочки:
ls -l /proc/$$/ns
итого 0
lrwxrwxrwx 1 student student 0 окт 19 16:40 cgroup -> 'cgroup:[4026531835]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 ipc -> 'ipc:[4026531839]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 mnt -> 'mnt:[4026531832]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 net -> 'net:[4026531833]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 pid -> 'pid:[4026531836]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 pid_for_children -> 'pid:[4026531836]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 time -> 'time:[4026531834]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 time_for_children -> 'time:[4026531834]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 user -> 'user:[4026531837]'
lrwxrwxrwx 1 student student 0 окт 19 16:40 uts -> 'uts:[4026531838]'
Каждая запись представляет собой символическую ссылку специального вида: имя типа и идентификатор в квадратных скобках (номер inode в служебной псевдо-ФС nsfs). Если два процесса ссылаются на одинаковый номер, например net:[4026531833], значит, они делят один и тот же сетевой стек. Если номера различаются — их сети полностью изолированы.
Для сводного анализа всех активных пространств имён в системе используется утилита lsns из пакета util-linux 3:
lsns -t pid
        NS TYPE NPROCS   PID USER   COMMAND
4026531836 pid      90  1481 student /usr/bin/dbus-broker-launch --scope user
4026532895 pid       1 19399 student /usr/lib/chromium/chromium --type=renderer
Утилита выводит тип пространства, число ассоциированных процессов, PID процесса-лидера и имя пользователя.
Утилиты unshare и nsenter
Для создания новых пространств имён и запуска программ в них из командной строки применяется утилита unshare. Она вызывает системный вызов unshare(2) или clone(2) и передаёт управление целевой программе 3.
Основные опции утилиты unshare:
-m,--mount— создать новое пространство монтирования;-u,--uts— создать новое пространство имён UTS (для смены hostname);-p,--pid— создать новое пространство идентификаторов процессов (требует опции--fork);-n,--net— создать изолированный сетевой стек;-U,--user— создать изолированное пространство пользователей;-r,--map-root-user— создать User Namespace и отобразить текущего непривилегированного пользователя на UID 0 (root);--mount-proc— автоматически смонтировать изолированную файловую систему procfs в/proc.
Обратной операцией является подключение к уже существующим пространствам имён работающего процесса с помощью утилиты nsenter. Например, команда nsenter -t <PID> -n ip addr позволяет заглянуть в сетевой стек процесса с указанным PID, что активно применяется при отладке контейнеров.
Изоляция пользователей: User Namespace и непривилегированный root
Пространство имён пользователей (англ. User Namespace) появилось в ядре Linux 3.8 и стало революцией в безопасности. Оно позволяет отображать диапазоны UID и GID внутри пространства на совершенно другие UID и GID на хосте 2.
Главное преимущество состоит в том, что процесс может быть полноценным root (UID 0) внутри своего пространства имён, обладая правом создавать точки монтирования и настраивать интерфейсы, оставаясь при этом абсолютно непривилегированным пользователем (например, UID 1000) для остальной операционной системы.
Проверим это с помощью опции -r:
unshare -r bash -c 'id; whoami'
uid=0(root) gid=0(root) groups=0(root),65534(nobody)
root
Внутри запущенной подоболочки команда id сообщает, что процесс выполняется от имени суперпользователя root. Однако снаружи этот процесс исполняется обычным пользователем student. Если этот процесс попытается прочитать защищённый файл /etc/shadow хостовой системы, ядро Linux откажет в доступе, поскольку реальный UID процесса не равен нулю.
Отображение идентификаторов задаётся в псевдофайлах /proc/<PID>/uid_map и /proc/<PID>/gid_map. В простейшем случае строка 0 1000 1 означает: «UID 0 внутри пространства соответствует UID 1000 снаружи на протяжении 1 идентификатора».
Изоляция имён, процессов и сети: UTS, PID, Net
Объединим изоляцию имени хоста (UTS) и таблицы процессов (PID):
unshare -r -u -p --fork bash -c 'hostname sandbox; echo "Имя хоста: $(hostname), PID: $$"'
Имя хоста: sandbox, PID: 1
Обратите внимание: внутри нового пространства имён PID процесс получил идентификатор 1. В любой UNIX-подобной системе процесс с PID 1 является инициализирующим процессом (init). Если этот процесс завершится, ядро автоматически завершит всех остальных потомков в данном PID namespace.
Теперь проверим изоляцию сетевого стека:
unshare -r -n ip addr
1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
В новом сетевом пространстве полностью отсутствуют физические сетевые интерфейсы (eth0, wlan0), нет маршрутов и чужих слушающих сокетов. Доступен лишь выключенный интерфейс локальной петли lo. Чтобы связать такое изолированное пространство с внешней сетью, создаётся виртуальная пара сетевых адаптеров (англ. veth pair), один конец которой помещается в пространство имён контейнера, а второй подключается к виртуальному мосту (англ. bridge) на хосте. Детально работа сетевых мостов и протоколов маршрутизации изучается в курсе «Компьютерные сети и сетевые технологии».
Файловая система изолированного процесса
Пространство монтирования и pivot_root
Изолированный процесс нуждается в собственном дереве каталогов. Пространство монтирования (Mount Namespace) изолирует список точек монтирования. Если процесс в новом Mount Namespace смонтирует диск или каталог, это монтирование не появится в основной системе 2.
Для полноценной смены корневого каталога системы используется системный вызов pivot_root(new_root, put_old). В отличие от старого chroot, который просто смещает указатель корня, pivot_root делает указанную точку монтирования настоящим новым корнем всей файловой системы, а старый корень переносит во временный подкаталог put_old, после чего старый корень можно полностью размонтировать командой umount -l. Именно pivot_root используют Docker и Podman при запуске контейнеров, исключая возможность выхода наружу.
Многослойные файловые системы: OverlayFS
Если каждый контейнер требовал бы полной копии операционной системы размером в несколько гигабайт, дисковое пространство сервера быстро бы исчерпалось. Решением стала технология объединённых файловых систем (англ. union mount), стандартом которой в ядре Linux является OverlayFS 2.
Механизм OverlayFS объединяет содержимое нескольких каталогов в единую точку монтирования, как показано на рисунке 3.
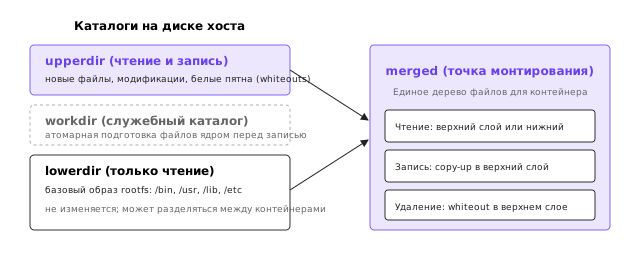
В OverlayFS выделяются четыре роли каталогов:
lowerdir— один или несколько базовых каталогов только для чтения (англ. read-only). В них размещается неизменяемый образ операционной системы. Этот каталог может одновременно и безопасно разделяться сотнями контейнеров.upperdir— каталог чтения и записи (англ. read-write), уникальный для каждого контейнера. Все создаваемые, изменяемые или удаляемые файлы физически сохраняются здесь.workdir— служебный каталог на том же дисковом разделе, необходимый ядру для атомарной подготовки файлов перед их перемещением вupperdir.merged— итоговая точка монтирования. Именно этот каталог видит контейнер в качестве своего дерева файлов.
Работа со слоями строится по двум принципам:
- Копирование при записи (Copy-up): когда процесс пытается изменить файл, существующий только в нижнем слое
lowerdir, ядро незаметно для приложения копирует файл целиком в верхний слойupperdir, и модификация применяется уже к этой копии. Оригинальный файл вlowerdirостаётся нетронутым. - Белые пятна (Whiteouts): если процесс удаляет файл из нижнего слоя, ядро создаёт в верхнем слое специальный символьный файл-заглушку с номером устройства 0/0. При обращении к
mergedэтот файл скрывается от чтения, создавая видимость удаления.
Проверим работу OverlayFS на практике без прав root, воспользовавшись пользовательским пространством имён:
unshare -r -m bash -c '
TMPDIR=$(mktemp -d)
mkdir -p "$TMPDIR"/{lower,upper,work,merged}
echo "Исходный файл" > "$TMPDIR/lower/app.conf"
mount -t overlay overlay -o lowerdir="$TMPDIR/lower",upperdir="$TMPDIR/upper",workdir="$TMPDIR/work" "$TMPDIR/merged"
echo "Изменение в контейнере" >> "$TMPDIR/merged/app.conf"
echo "=== Содержимое merged ==="
cat "$TMPDIR/merged/app.conf"
echo "=== Содержимое lower (не изменился) ==="
cat "$TMPDIR/lower/app.conf"
echo "=== Содержимое upper ==="
cat "$TMPDIR/upper/app.conf"
umount "$TMPDIR/merged"
rm -rf "$TMPDIR"
'
=== Содержимое merged ===
Исходный файл
Изменение в контейнере
=== Содержимое lower (не изменился) ===
Исходный файл
=== Содержимое upper ===
Исходный файл
Изменение в контейнере
Как видно из вывода, нижний каталог lower не был модифицирован. Все изменения изолированно осели в каталоге upper. При удалении контейнера достаточно просто стереть каталог upper, вернувшись к исходному состоянию.
Управление ресурсами: контрольные группы cgroups v2
Модель cgroups v2 и иерархия /sys/fs/cgroup
Пространства имён изолируют видимость процессов, но не защищают аппаратные ресурсы машины. Если изолированный процесс запустит бесконечный цикл выделения памяти или начнёт непрерывно создавать дочерние процессы (fork-бомба), система быстро исчерпает ресурсы.
Для распределения и ограничения аппаратных ресурсов ядро Linux предоставляет механизм контрольных групп (cgroups) 2. В современных дистрибутивах (Ubuntu 22.04 и новее) по умолчанию используется вторая версия механизма — cgroups v2 (единая иерархия).
В cgroups v2 контрольные группы представлены каталогами в виртуальной файловой системе /sys/fs/cgroup. Иерархия строится в виде дерева: свойства родительской группы наследуются дочерними группами. Иерархия групп управления показана на рисунке 4.
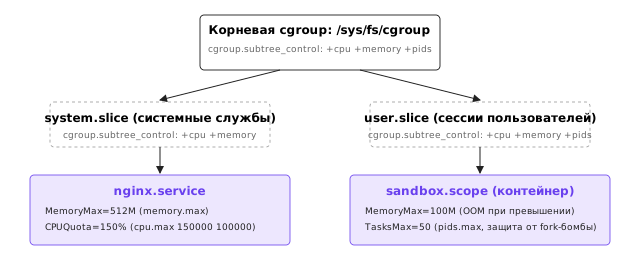
Посмотрим на список доступных контроллеров в корневой группе:
cat /sys/fs/cgroup/cgroup.controllers
cpuset cpu io memory hugetlb pids rdma misc dmem
Для включения контроллера в дочерней группе родительская группа должна записать его имя со знаком плюс в служебный файл cgroup.subtree_control.
Контроллеры: memory, cpu, pids, io
Каждый контроллер отвечает за отдельный аппаратный ресурс и управляется псевдофайлами внутри каталога группы:
-
Память (
memory):memory.max— жёсткий предел оперативной памяти (в байтах или суффиксах K, M, G). При попытке превысить этот порог ядро запускает механизм OOM-killer и завершает процесс внутри группы.memory.high— мягкий предел. При его достижении процессы группы замедляются ядром для снижения давления на оперативную память, но не завершаются аварийно.memory.current— текущий объём потребляемой памяти группой.
-
Процессор (
cpu):cpu.max— квота процессорного времени. Задаётся двумя числами: квота и период в микросекундах. Например, значение50000 100000означает, что процессам группы разрешено использовать процессор не более 50 мс из каждых 100 мс (то есть ровно 50 % одного ядра). Значение200000 100000соответствует двум ядрам CPU.
-
Число процессов (
pids):pids.max— максимальное суммарное число потоков и процессов, которое разрешено создать внутри данной группы. Это надёжная защита от fork-бомб: при попытке вызватьfork()сверх лимита вызов возвращает ошибку-EAGAIN.pids.current— текущее количество процессов в группе.
-
Ввод-вывод (
io):io.weight— относительный вес очереди дискового ввода-вывода (от 1 до 10000).io.max— жёсткие лимиты операций ввода-вывода (IOPS) или пропускной способности (байт в секунду) для конкретных блочных устройств.
Мониторинг и управление: systemd-cgls, systemd-cgtop, systemd-run
В Linux с системой инициализации systemd именно systemd является главным менеджером cgroups v2 4. Службам соответствуют cgroups внутри system.slice, пользовательским сессиям — внутри user.slice.
Для просмотра дерева контрольных групп предназначена утилита systemd-cgls:
systemd-cgls --no-pager -u user-1000.slice
Unit user-1000.slice (/user.slice/user-1000.slice):
├─user@1000.service …
│ ├─session.slice
│ │ ├─dbus-broker.service
│ │ │ └─1481 /usr/bin/dbus-broker-launch --scope user
│ └─app.slice
│   └─app-org.kde.konsole.service
│     └─12480 /usr/bin/konsole
Для интерактивного наблюдения за ресурсами в реальном времени используется утилита systemd-cgtop, аналогичная top, но группирующая нагрузку по слайсам и сервисам.
Для запуска разовых команд с контролем ресурсов без создания постоянного сервиса используется команда systemd-run с параметром --scope 4:
systemd-run --user --scope -p MemoryMax=50M -p TasksMax=10 echo "Запуск в ограниченной cgroup"
Running as unit: run-p36096-i26603.scope; invocation ID: cad62eb557d241cc86ef2ab1c428def0
Запуск в ограниченной cgroup
Команда создала временную контрольную группу со строгим ограничением памяти в 50 МБ и максимальным числом потоков 10, выполнила команду и удалила группу после завершения.
Поведение при исчерпании ресурсов: OOM-killer внутри cgroup
Что происходит, когда процесс пытается потребить больше памяти, чем задано в memory.max?
Ядро сначала пытается освободить память внутри cgroup (сбросить дисковый кэш). Если свободной памяти не появилось, ядро активирует механизм OOM-killer (англ. Out Of Memory Killer), но применяет его локально: завершается процесс внутри превысившей лимит группы, а не случайный критически важный процесс хоста.
Счётчик аварийных завершений памяти фиксируется ядром в служебном файле memory.events: значение oom_kill увеличивается на единицу при каждом срабатывании.
Ограничение привилегий: Capabilities и песочницы systemd
Привилегии ядра: Linux Capabilities
Традиционная модель прав UNIX бинарна: пользователь либо обычный (UID != 0) и не может почти ничего привилегированного, либо суперпользователь (UID == 0) и может абсолютно всё. Это противоречит принципу наименьших привилегий: если веб-серверу всего лишь нужно занять порт 80, давать ему полные права root опасно, так как при уязвимости в коде атакующий получает полный контроль над ядром 2.
Для решения этой проблемы в Linux были введены возможности (англ. capabilities). Все полномочия суперпользователя были разделены примерно на 40 дискретных прав. Основные из них приведены в таблице.
| Возможность (Capability) | Что разрешает делать |
|---|---|
CAP_NET_BIND_SERVICE | Привязывать сокеты к привилегированным портам (номера ниже 1024) |
CAP_NET_ADMIN | Настраивать сетевые интерфейсы, таблицы маршрутизации и брандмауэр |
CAP_SYS_ADMIN | Широкий набор операций администрирования (монтирование, настройка квот и др.) |
CAP_SYS_PTRACE | Трассировать и отлаживать чужие процессы через ptrace |
CAP_SETUID / CAP_SETGID | Менять произвольный UID / GID процесса |
CAP_DAC_OVERRIDE | Игнорировать проверку прав доступа rwx к файлам |
CAP_CHOWN | Изменять владельца любых файлов |
Посмотреть возможности текущего процесса можно утилитой capsh из пакета libcap2-bin 3:
capsh --print
Current: =
Bounding set =cap_chown,cap_dac_override,cap_dac_read_search,cap_fowner,cap_fsetid,cap_kill,cap_setgid,cap_setuid,cap_setpcap,cap_linux_immutable,cap_net_bind_service,cap_net_broadcast,cap_net_admin,cap_net_raw,cap_ipc_lock,cap_ipc_owner,cap_sys_module,cap_sys_rawio,cap_sys_chroot,cap_sys_ptrace,cap_sys_pacct,cap_sys_admin,cap_sys_boot,cap_sys_nice,cap_sys_resource,cap_sys_time,cap_sys_tty_config,cap_mknod,cap_lease,cap_audit_write,cap_audit_control,cap_setfcap,cap_mac_override,cap_mac_admin,cap_syslog,cap_wake_alarm,cap_block_suspend,cap_audit_read,cap_perfmon,cap_bpf,cap_checkpoint_restore
Ambient set =
Securebits: 00/0x0/1'b0 (no-new-privs=0)
uid=1000(student) euid=1000(student)
Строка Current: = означает, что у обычного пользователя активных привилегий нет. Чтобы наделить отдельный исполняемый файл конкретным правом без установки бита setuid root, администратор использует утилиту setcap:
sudo setcap 'cap_net_bind_service=+ep' /usr/local/bin/mywebserver
После этого программа сможет открывать 80 порт без прав root. Проверить установленные файловые права можно командой getcap.
Флаг no_new_privs и переход в непривилегированный режим
Критически важным барьером безопасности является бит no_new_privs. Если процесс установил этот флаг через системный вызов prctl(PR_SET_NO_NEW_PRIVS, 1, ...), ядро гарантирует, что ни этот процесс, ни любые его потомки никогда не смогут повысить свои привилегии, даже если запустят программу с битом setuid (например, /usr/bin/sudo или /usr/bin/passwd) 2. Этот флаг обязательно выставляется всеми контейнерными средами при создании непривилегированных контейнеров.
Изоляция служб: директивы песочницы systemd
Как было показано в теме 9, службы управляются юнитами systemd. Начиная с версии 230, в systemd встроен мощный декларативный инструментарий песочницы (англ. service sandboxing), позволяющий изолировать любой сервис с помощью нескольких строк в секции [Service] без использования сторонних движков контейнеризации 4.
Наиболее важные директивы песочницы:
ProtectSystem=strict— монтирует всю файловую систему хоста (каталоги/usr,/boot,/etc) только для чтения.ProtectHome=yes— полностью скрывает каталоги/home,/rootи/run/userот службы (они выглядят пустыми).PrivateTmp=yes— создаёт для службы изолированный каталог/tmp, недоступный другим процессам.PrivateDevices=yes— скрывает реальные физические устройства в/dev, оставляя только псевдоустройства (/dev/null,/dev/zero,/dev/urandom).NoNewPrivileges=yes— активирует флаг ядраno_new_privs.ProtectKernelTunables=yes— запрещает изменение параметров ядра через/proc/sysи/sys.ProtectControlGroups=yes— монтирует/sys/fs/cgroupтолько для чтения.ReadWritePaths=/var/log/myapp— точечно разрешает запись только в указанный каталог при включённомProtectSystem=strict.
Оценка защищённости службы: systemd-analyze security
Для проверки качества настройки изоляции служб в systemd входит встроенный анализатор безопасности systemd-analyze security 4. Он проверяет более 70 параметров изоляции и выставляет числовой рейтинг уязвимости (exposure score) от 0.0 (максимально изолированный) до 10.0 (полный доступ к хосту).
Проверим оценку защищённости для системной службы разрешения имён:
systemd-analyze security systemd-resolved.service
  NAME                               DESCRIPTION                        EXPOSURE
✓ SystemCallFilter=~@swap            System call allow list defined fo…
✓ SystemCallFilter=~@reboot          System call allow list defined fo…
✓ SystemCallFilter=~@raw-io          System call allow list defined fo…
✓ SystemCallFilter=~@mount           System call allow list defined fo…
✓ SystemCallFilter=~@module          System call allow list defined fo…
✓ User=/DynamicUser=                 Service runs under a static non-r…
✓ NoNewPrivileges=                   Service processes cannot acquire …
✓ PrivateDevices=                    Service has no access to hardware…
✓ MemoryDenyWriteExecute=            Service cannot create writable ex…
✓ RestrictNamespaces=~user           Service cannot create user namesp…
✓ RestrictNamespaces=~pid            Service cannot create process nam…
✓ RestrictNamespaces=~net            Service cannot create network nam…

→ Overall exposure level for systemd-resolved.service: 2.2 OK :-)
Служба получила рейтинг 2.2 («OK»), поскольку использует ограничения системных вызовов, работу от непривилегированного пользователя, защиту от смены пространств имён и флаг NoNewPrivileges. Если служба не использует изоляцию, анализатор выводит рейтинг выше 9.0 («UNSAFE»).
Контейнерные движки: собирая всё воедино
Роль движков: Docker, Podman, containerd
Теперь, когда механизмы ядра изучены, становится понятна роль контейнерных движков:
- Низкоуровневые среды выполнения (runc, crun): вызывают
unshare, настраивают cgroups в/sys/fs/cgroup, монтируют OverlayFS и выполняютpivot_root. - Высокоуровневые демоны (containerd, CRI-O): загружают образы из удалённых реестров, распаковывают tar-архивы слоёв в каталоги
lowerdirи отслеживают жизненный цикл процессов. - Интерфейсы пользователя (Docker CLI, Podman): предоставляют удобные команды
run,build,ps, транслируя параметры командной строки в конфигурации ядра.
Подробное изучение спецификаций образов OCI и архитектуры контейнерных платформ выходит за рамки базового курса по командной строке и рассматривается в специализированных курсах по контейнеризации и оркестрации.
Итоги темы
Изоляция процессов в Linux — это не монолитная технология, а гармоничное сочетание фундаментальных примитивов ядра. Пространства имён разделяют глобальные таблицы ресурсов, предоставляя изолированному процессу собственный PID 1, независимый сетевой стек, уникальное имя узла и локальные точки монтирования. Механизм User Namespace делает возможным безопасный запуск контейнеров от непривилегированного пользователя, снимая риски компрометации хоста.
Файловая система OverlayFS обеспечивает эффективное разделение базовых неизменяемых образов и индивидуальных слоёв записи с помощью прозрачного копирования при модификации. Контрольные группы cgroups v2 выстраивают строгую иерархию лимитов процессора, памяти и процессов, предотвращая исчерпание системных ресурсов и локализуя действия OOM-killer. Наконец, разделение прав суперпользователя на capabilities и директивы изоляции systemd позволяют надёжно защитить системные службы без избыточных накладных расходов.
В следующей теме 13 начинается третий раздел курса — программирование на командной оболочке Bash. Знание процессов, дескрипторов, потоков ввода-вывода и окружения послужит фундаментом для написания первого надёжного скрипта автоматизации 5.
Литература
- Nemeth E., Snyder G., Hein T. R., Whaley B., Mackin D. UNIX and Linux System Administration Handbook. 5th ed. — Addison-Wesley, 2017.
- Kerrisk M. The Linux Programming Interface. — No Starch Press, 2010.
- The Linux man-pages project. — https://man7.org/linux/man-pages/
- systemd. Документация systemd.unit, systemd.service, systemd.timer, journalctl. — https://www.freedesktop.org/software/systemd/man/
- Shotts W. The Linux Command Line: A Complete Introduction. 2nd ed. — No Starch Press, 2019. Открытая версия: https://linuxcommand.org/tlcl.php