
Как работать с апокрифами
Апокрифы — это вторая половина курса. Основная программа отвечает на вопрос «как сеть устроена и как ею управлять»; апокрифы смотрят на ту же сеть с другой стороны: что происходит, когда в неё приходит чужой пакет, где заканчивается доверие между протоколами, как обойти контроль доступа и как каждый приём выглядит в глазах защитника. Одиннадцать тем идут от разведки до промышленных сетей, и каждая заканчивается не «атака удалась», а разбором следа, который она оставила.
Этот модуль ничего не атакует. Он объясняет, как устроены остальные: в каких границах ставятся эксперименты, чем отличаются утверждения разных уровней достоверности, как ведётся журнал и в каком порядке темы опираются друг на друга. Без него первые же расхождения между текстом и выводом команды выглядят как ошибка курса, хотя чаще это разница между требованием стандарта и поведением конкретного ядра.
Зачем отдельный нулевой модуль
Апокриф устроен иначе, чем тема основной программы. Там материал шёл от механизма к практике: как работает протокол, как его настроить, как проверить. Здесь на первом месте стоит вопрос «чему протокол верит», и ответ на него не всегда совпадает с тем, что написано в документации: стандарт описывает, как должно быть, ядро реализует подмножество, а учебная лаборатория упрощает ещё и это подмножество.
Разрыв между тремя уровнями — не дефект, а предмет изучения. Если в лаборатории ARP-спуфинг не сработал, это может означать три разных вещи: атака написана неверно, ядро ведёт себя иначе, чем ожидалось, или защита действительно включена. Различить их можно только заранее зная, какой уровень вы проверяете. Поэтому нулевой модуль фиксирует три вещи: модель нарушителя, уровни воспроизводимости и правила чтения утверждений 1.
Чем апокриф отличается от темы основной программы
Каждая тема апокрифов отвечает на три вопроса, и третий — не приложение, а половина темы:
- Как устроено. Механизм до структуры и функции: таблица соседей и
struct neighbour, хук netfilter и кортеж conntrack, конечный автомат BGP, сообщение DNS. - Как воспроизвести. Рабочая команда, скрипт или конфигурация в среде, которую можно собрать на одной машине.
- Как ловится. Что видно в захвате, в NetFlow, в журнале IDS; какое конкретное правило, настройка или счётчик останавливает приём.
Тема открывается разделом «Тень базового курса»: короткой отсылкой к легитимному механизму и сразу — к его извращению. Это не повторение. Читатель уже видел, как протокол должен работать, поэтому апокриф не пересказывает базу, а показывает, чего протоколу не хватает: аутентификации, привязки к контексту, проверки состояния.
Отсюда следствие для чтения: если в теме встретилось незнакомое понятие из основной программы, возвращаться нужно к ней, а не искать обходное объяснение здесь. Апокрифы предполагают, что стек TCP/IP, маршрутизация, DNS и TLS уже разобраны.
Приёмы курса не привязаны к конкретному инструменту и легко сопоставляются с внешними классификациями: разведка, первоначальный доступ, боковое перемещение и эксфильтрация в матрице ATT&CK 2 покрывают те же шаги, что и темы 01–11, но с другой точки зрения — по действиям, а не по протоколам. Это сопоставление полезно при чтении отчётов и при построении детекторов.
Модель нарушителя
Любая оценка «атака работает» имеет смысл только вместе с возможностями атакующего. Один и тот же приём может быть тривиальным для того, кто стоит на пути, и вычислительно невозможным для того, кто видит только ответы сервера. Поэтому в каждой теме модель нарушителя названа явно, а вместе с ней — бюджет: сколько пакетов, попыток и времени требует приём.
| Параметр | Варианты | Что меняет |
|---|---|---|
| Позиция | в сегменте, на пути, вне пути | на пути доступны подмена и вставка; вне пути — только угадывание |
| Доступ | без учётных данных, с низкопривилегированной учётной записью, с правами администратора | определяет, какие протоколы вообще доступны |
| Инструменты | только сетевой стек, raw-сокеты, специализированные утилиты | влияет на скорость и на след в журналах |
| Бюджет | единицы пакетов, тысячи, часы перебора | превращает «теоретически возможно» в «практически нет» |
| Обнаружение | скрытность не требуется, требуется | определяет, какие приёмы вообще рассматриваются |
Модель нарушителя — это рамка для расчётов, а не разрешение. Она нужна, чтобы отличить «приём невозможен» от «приём дорог»: подделка DNS-ответа вне пути при достаточной энтропии идентификатора и порта требует миллионов попыток, а на пути — одного пакета. Числа в таких оценках всегда указываются с источником: энтропия TXID и порта, размер окна TCP, таймеры BGP.
Границы модели одинаковы для всех тем: не рассматриваются физическое разрушение оборудования, атаки на цепочку поставок, социальная инженерия против конкретных людей и отказ в обслуживании реальной инфраструктуры. Всё, что делается в лаборатории, делается в пространствах имён, контейнерах или виртуальных машинах, которые можно удалить одной командой.
Своя лаборатория и документированные адреса
Курс исходит из простого правила: эксперимент ставится только в собственной изолированной среде. Это не формальность, а условие воспроизводимости. Чужая сеть меняется между запусками, её нельзя сбросить, а её реакция на подделку пакетов непредсказуема.
Технические следствия этого правила:
- Адреса — только документационные. IPv4 —
192.0.2.0/24,198.51.100.0/24,203.0.113.0/243, IPv6 —2001:db8::/324, номера AS — из диапазона для документации, 64496–64511 7 (в курсе используются 64500–64502). Такие адреса не маршрутизируются в интернете, поэтому случайная утечка пакета не достигает чужой системы. - Домены — только
example.comи производные (nsu.example,lab.example). Это домены, зарезервированные для примеров. - Изоляция — на уровне ядра. Сетевые пространства имён (
unshare -rnm) дают собственный стек, свои таблицы маршрутизации и свои правилаnftables, не затрагивая хост 5. - Радио — только собственное оборудование. Передача в эфир регулируется: мощность, канал и разрешённые диапазоны зависят от страны. Эксперименты с 802.11 выполняются на собственном оборудовании или на виртуальном радиомодуле; чужие точки доступа и чужие клиенты не являются частью стенда.
- Никаких внешних целей. Ни сканирования, ни подделки пакетов, ни перебора за пределами стенда. Если в задании нужен «внешний» узел, он эмулируется.
Уборка — часть эксперимента, а не уборка после него. Каждая работа заканчивается возвратом стенда в исходное состояние: остановленные процессы, удалённые пространства имён, снятые правила, удалённые временные файлы. Процессы останавливаются по PID-файлу, а не по pkill -f: шаблон по имени убивает чужие процессы и скрывает ошибку в сценарии.
Уровни воспроизводимости
Не всякая часть темы воспроизводится одинаково. Один и тот же приём может быть показан на готовом захвате, в пространствах имён, в контейнерах или только на оборудовании. Уровень указывается в начале лабораторной, и от него зависит, что именно проверяется.
| Уровень | Среда | Что даёт | Чего не даёт |
|---|---|---|---|
| 0 | готовый pcap и журналы | точный разбор полей, повторяемость, ноль зависимостей | нельзя изменить поведение и увидеть реакцию |
| 1 | сетевые пространства имён на одном ядре | реальный стек, свои таблицы, nftables, tc | нет отдельных версий ядра и драйверов |
| 2 | контейнеры, FRRouting, Containerlab | реальные демоны маршрутизации и протоколы | нет GPU, радио и части оборудования |
| 3 | виртуальные машины, SDR, коммутатор | поведение конкретной протокольной реализации | дороже, медленнее, хуже воспроизводится |
Уровень 0 — не «упрощённая версия» и не замена: это единственный способ гарантировать, что все увидят одни и те же байты. Уровни 1 и 2 — основные: они дают живую реакцию стека и при этом остаются воспроизводимыми. Уровень 3 используется там, где без него не обойтись: 802.11, АСУ ТП с реальным контроллером, поведение античит-защиты.
Если в среде нет инструмента, лабораторная не отменяется: у неё есть минимальный сценарий на уровне 0 и запасной вариант, названный в задании. В журнале при этом фиксируется, какой уровень использован, — иначе вывод «правило не сработало» может относиться к отсутствующей зависимости, а не к защите.
Как читать утверждения
В тексте встречаются утверждения разной природы, и путать их — самая частая причина ложных выводов. Пять пометок покрывают почти всё:
| Пометка | Что означает | Пример |
|---|---|---|
| [RFC] | требование или рекомендация стандарта | «BGP-сосед шлёт KEEPALIVE каждые 60 секунд» |
| [Linux] | поведение конкретного ядра или дистрибутива | «кеш ARP держит запись в состоянии REACHABLE около 30 секунд» |
| [инструмент] | поведение версии утилиты | «Suricata 7 в режиме -i копирует пакеты, а не стоит в разрыве» |
| [упрощение] | сознательное учебное допущение | «в лаборатории мост не умеет DAI» |
| [историческое] | приём или поведение, которого в современной сети уже нет | «RH0 отброшен RFC 5095» |
Правило простое: любое число — таймер, размер, энтропия, доля потерь — имеет пометку или ссылку на источник. Если пометки нет, это ошибка текста, а не свойство протокола. Особенно это касается мест, где легко запомнить неверное: таймауты соседства, размеры окна, скорость перебора, число попыток.
Разница между уровнями видна на простом примере. Стандарт требует, чтобы узел не принимал ICMP redirect от не-шлюза 6; Linux принимает их только при определённых настройках маршрута; в лаборатории redirect приходит от узла, который шлюзом не является, и всё равно срабатывает — потому что маршрут уже указывает на этот адрес. Три утверждения верны одновременно, и каждое отвечает на свой вопрос.
Формат темы
Все темы апокрифов собраны по одной схеме. Это не бюрократия: одинаковая последовательность позволяет сравнивать темы между собой и быстро находить пропущенный раздел.
- Легитимный механизм из основной программы — коротко, только то, что нужно для атаки.
- Граница доверия — кому и чему протокол верит и почему.
- Состояния и обмен сообщениями — что и в каком порядке отправляется.
- Формат пакета или записи — поля, флаги, таймеры.
- Предпосылки приёма — что должно совпасть, чтобы атака сработала.
- Атакующий приём — команда, скрипт, конфигурация.
- Что видит получатель, сеть и защитный инструмент — три разных картины одного события.
- Обнаружение — конкретное правило, счётчик или настройка.
- Защита и её ограничения — что именно она закрывает и чего не закрывает.
- Лабораторное наблюдение и контрольный вывод — что должно получиться и как понять, что получилось не то.
Если раздел отсутствует, тема считается неполной — независимо от объёма. Если раздел есть, но в нём нет конкретики (породы правила, номера поля, названия счётчика), он тоже неполный.
Формат лабораторной
Лабораторная строится вокруг предсказания. Сначала формулируется гипотеза: что должно произойти и почему. Потом ставится эксперимент. Потом наблюдение сравнивается с гипотезой, и расхождение объясняется — а не замалчивается.
Журнал ведётся по пяти колонкам:
| Предсказание | Наблюдение | Расхождение | Причина | Доказательство |
|---|---|---|---|---|
| что ожидалось | что реально видно | в чём несовпадение | почему | вывод команды, файл, номер пакета |
Такая форма отличается от «команда — результат» тем, что фиксирует расхождение как результат, а не как неудачу. В апокрифах расхождение — самый ценный фрагмент: именно оно показывает, где заканчивается стандарт и начинается реализация.
Каждая работа содержит часть «найти и исправить ошибку»: правило, скрипт или конфигурация с дефектом, который нужно обнаружить по симптому. Это проверяет не память, а понимание — умение отличить ошибку в своём коде от поведения стека.
Маршрут, ветви и зависимости
Темы идут не алфавитом и не по номерам протоколов. Порядок задан зависимостями: каждая следующая тема использует наблюдения и инструменты предыдущих. Восьмая тема — первый интеграционный модуль: она опирается на фрагментацию из четвёртой, DNS-каналы пятой, туннели шестой и требует настроенного сенсора.
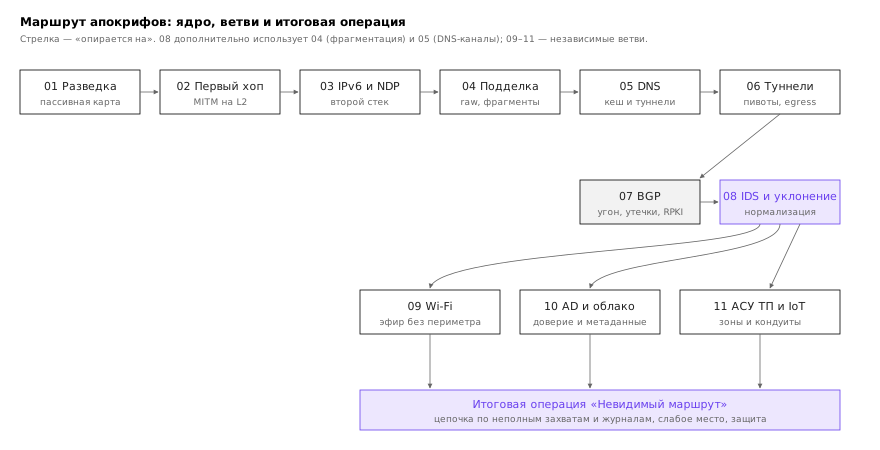
| Тема | Опирается на | Даёт |
|---|---|---|
| 01 Разведка | основная программа: мониторинг, ARP, сканирование | пассивная карта, активная проверка, след сканера |
| 02 Первый хоп | 01 | MITM на L2, захват учётных данных, DAI и snooping |
| 03 IPv6 и NDP | 02 | второй стек, RA, обход IPv4-фильтра |
| 04 Подделка пакетов | 02, 03 | raw-сокеты, фрагментация, ICMP, TCP-инъекции |
| 05 DNS | 04 | отравление кеша, rebinding, туннели и C2 |
| 06 Туннели и пивоты | 05 | обход egress, TLS-перехват, отпечатки |
| 07 BGP | 01, 04 | угон префикса, утечки, RPKI и ROV |
| 08 IDS и уклонение | 04, 05, 06, 07 | нормализация, обход правил, инженерия обнаружения |
| 09 Wi-Fi | 02, 08 | эфир без периметра, WPA2/WPA3, WIDS |
| 10 AD и облако | 05, 06, 08 | Kerberos и NTLM, LDAP, DCSync, метаданные |
| 11 АСУ ТП и IoT | 02, 08, 10 | Modbus и MQTT, зоны и кондуиты, пассивный мониторинг |
После одиннадцатой темы идёт итоговая операция: по неполному набору захватов и журналов восстановить цепочку, определить слабое место и предложить защиту. Она не добавляет новых приёмов — она проверяет, что все предыдущие собраны в одну картину.
Ветви после восьмой темы можно проходить в любом порядке: 09 (альтернативные среды), 10 (идентичность и облако), 11 (специализированные сети). Они не зависят друг от друга, но все опираются на ядро 01–08.
Уровни вопросов
Вопросы в конце темы проверяют разное, и это видно по формулировке. Пять уровней:
- Понимание: объяснить механизм своими словами. «Почему ARP-ответ принимается без запроса?»
- Применение: предсказать результат команды или настройки. «Что покажет
ip neighпосле поддельного ответа?» - Анализ: найти причину расхождения. «Правило не сработало — какие три проверки нужно сделать?»
- Проектирование: выбрать защиту под ограничения. «Что дешевле в сети с неуправляемыми коммутаторами: DAI или 802.1X?»
- Синтез: восстановить событие по нескольким источникам. «По pcap и журналу сенсора определите, был ли это скан или штатная работа.»
Вопрос уровня «понимание» не проверяет, умеет ли читатель применять; вопрос «синтез» не проверяет память на поля. Если на вопрос можно ответить одним словом из текста — это не вопрос курса.
Если инструмента нет
Апокрифы рассчитаны на Linux и набор утилит, но не требуют всего сразу. У каждой части есть замена, и она названа в задании: tshark вместо Suricata для разбора, готовый захват вместо генерации кадров, скрипт на scapy вместо hping3. Замена фиксируется в журнале: результат, полученный другим инструментом, — это другой уровень воспроизводимости, и путать его с исходным нельзя.
Чего замена не меняет: механизм. Если нет iodine, DNS-туннель собирается вручную на TXT-записях; если нет SDR, разбирается записанный захват. Приём остаётся тем же, меняется только способ получить байты.
Отдельный случай — живой захват. tshark -i и tcpdump работают через dumpcap, которому права выданы файловыми возможностями; в пользовательском пространстве имён они не действуют, и захват падает с Permission denied. Поэтому в лабораториях встречаются три варианта: захват от root вне пространства имён, готовый pcap из окружения и короткий скрипт на AF_PACKET, который пишет pcap сам. Разбор во всех трёх случаях одинаковый.
Литература
- NIST. Technical Guide to Information Security Testing and Assessment. — SP 800-115, 2008. https://csrc.nist.gov/pubs/sp/800/115/final
- MITRE. ATT&CK: Adversarial Tactics, Techniques, and Common Knowledge. https://attack.mitre.org
- Cotton M., Vegoda L., Bonica R. Special-Purpose IP Address Registries. — RFC 6890, IETF, 2013. https://www.rfc-editor.org/rfc/rfc6890
- Huston G. IPv6 Address Prefix Reserved for Documentation. — RFC 3849, IETF, 2004. https://www.rfc-editor.org/rfc/rfc3849
- network_namespaces(7). — Linux man-pages. https://man7.org/linux/man-pages/man7/network_namespaces.7.html
- Braden R. Requirements for IP Version 4 Routers. — RFC 1812, IETF, 1995. https://www.rfc-editor.org/rfc/rfc1812
- Huston G. Autonomous System (AS) Number Reservation for Documentation Use. — RFC 5398, IETF, 2008. https://www.rfc-editor.org/rfc/rfc5398