
Протокол IP в работе: заголовок, ARP, ICMP, фрагментация
В теме 6 адрес IPv4 рассматривался статически: как число из 32 битов, разделённое маской на номер сети и номер узла, и как элемент адресного плана. Адресный план отвечает на вопрос «кто где находится», но не на вопрос «как пакет туда попадает». Между моментом, когда приложение передало данные в сокет, и моментом, когда они появились на другом конце, происходит множество действий: формируется заголовок IP, хост решает, отправлять ли пакет адресату напрямую или маршрутизатору, выясняет MAC-адрес следующего узла, маршрутизаторы уменьшают время жизни пакета и, если пакет не помещается в канал, дробят его на части или сообщают отправителю об ошибке. Именно эти механизмы составляют «протокол IP в работе», и без них невозможно понять ни вывод ping и traceroute, ни типичные неисправности вроде «маленькие страницы открываются, а большие нет».
Тема построена по пути одного пакета. Сначала рассматривается модель сервиса IP и заголовок IPv4, поле за полем, с разбором реального пакета байт за байтом. Затем — действия хоста-отправителя: решение «свой сегмент или шлюз» и протокол разрешения адресов ARP, связывающий сетевой уровень с канальным, рассмотренным в теме 4. Третий раздел посвящён протоколу управляющих сообщений ICMP, через который сеть сообщает об ошибках и на котором построены утилиты ping и traceroute. Последний раздел описывает фрагментацию, MTU пути и механизм его обнаружения вместе с самой известной его неисправностью — «чёрной дырой» PMTUD.
Все примеры выводов в теме получены на учебной топологии лабораторной работы 7: два сегмента 10.7.1.0/24 и 10.7.2.0/24, соединённые маршрутизаторами r1 и r2 через транзитное звено 10.7.12.0/30. Как маршрутизатор выбирает, куда отправить пакет, здесь затрагивается лишь в той мере, в какой это нужно хосту; таблицы маршрутизации и выбор маршрута подробно рассматриваются в теме 8.
Модель сервиса IP и заголовок IPv4
Датаграммы и доставка по возможности
Протокол IP (англ. Internet Protocol), определённый в RFC 791, предоставляет вышележащим протоколам очень скромный сервис: он принимает блок данных и адрес назначения и пытается доставить этот блок, не давая никаких гарантий 1. Единица передачи называется датаграммой (англ. datagram) — самостоятельным пакетом, который несёт полный адрес назначения и обрабатывается каждым маршрутизатором независимо от других. Предварительного установления соединения нет, состояние о потоке пакетов в маршрутизаторах не хранится, два последовательных пакета одного отправителя могут пройти разными путями.
Такой сервис называют доставкой по возможности (англ. best effort). Пакет может быть потерян (например, при переполнении очереди маршрутизатора), доставлен в двух экземплярах, доставлен не в том порядке, в каком был отправлен, или задержан на непредсказуемое время. IP не обнаруживает и не исправляет эти ситуации: подтверждений, повторных передач и нумерации пакетов в нём нет. Единственная проверка целостности — контрольная сумма заголовка, причём только заголовка: искажение данных IP не замечает.
Скромность сервиса — сознательное проектное решение. Как обсуждалось в теме 2, принцип «из конца в конец» предписывает реализовывать надёжность там, где она действительно нужна, — в конечных узлах, в протоколе TCP (тема 12); сеть же, не храня состояния о соединениях, проще, дешевле и устойчивее к отказам: при выходе из строя маршрутизатора пакеты просто пойдут другим путём, и ни одно соединение не «повиснет» в его памяти. Цена этого решения — необходимость в служебных механизмах, о которых пойдёт речь далее: время жизни пакета защищает сеть от вечно циркулирующих пакетов, протокол ICMP позволяет хотя бы сообщить отправителю о проблеме, а фрагментация согласует размер пакета с возможностями каналов.
Поля заголовка IPv4
Каждая датаграмма начинается с заголовка длиной от 20 до 60 байт. Его формат показан на рисунке ниже в традиционной для RFC форме: каждая строка — 32-битное слово, биты нумеруются слева направо от 0 до 31, а байты передаются в сеть в порядке «старший байт первым» (англ. network byte order, big-endian) 1.
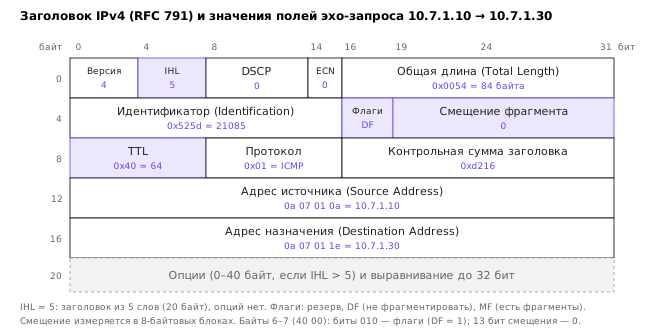
Назначение полей:
- Версия (англ. Version, 4 бита) — номер версии протокола, для IPv4 равен 4. Именно по этому полю узел отличает IPv4 от IPv6 (тема 11), хотя на практике канальный уровень уже указывает это значением EtherType (0x0800 для IPv4).
- Длина заголовка (англ. Internet Header Length, IHL, 4 бита) — длина заголовка в 32-битных словах. Минимальное значение 5 (20 байт, заголовок без опций), максимальное 15 (60 байт). Поле нужно потому, что заголовок имеет переменную длину из-за опций.
- Тип обслуживания (англ. Type of Service, 8 бит) — в исходном RFC 791 содержал приоритет и признаки «малая задержка», «высокая пропускная способность», «высокая надёжность». Позднее байт переопределён: старшие 6 бит — код дифференцированного обслуживания (англ. Differentiated Services Code Point, DSCP) 10, младшие 2 бита — явное уведомление о перегрузке (англ. Explicit Congestion Notification, ECN) 11. DSCP позволяет маршрутизаторам по-разному обслуживать классы трафика (например, голос раньше файлов), ECN — сигнализировать о перегрузке без отбрасывания пакетов (подробно — в теме 13).
- Общая длина (англ. Total Length, 16 бит) — длина всей датаграммы (заголовок плюс данные) в байтах. Максимум — 65 535 байт; любой хост обязан уметь принять датаграмму длиной не менее 576 байт 14.
- Идентификатор (англ. Identification, 16 бит), флаги (3 бита) и смещение фрагмента (англ. Fragment Offset, 13 бит) — служат фрагментации и сборке; подробно рассматриваются в последнем разделе темы. Из трёх битов флагов первый зарезервирован и должен быть равен нулю, второй — DF (англ. Don't Fragment, «не фрагментировать»), третий — MF (англ. More Fragments, «есть ещё фрагменты»).
- Время жизни (англ. Time to Live, TTL, 8 бит) — счётчик, который каждый маршрутизатор уменьшает хотя бы на единицу; когда он достигает нуля, пакет уничтожается 15. Несмотря на название, на практике это счётчик переходов, а не секунд.
- Протокол (англ. Protocol, 8 бит) — номер протокола, которому передаются данные датаграммы на узле назначения: 1 — ICMP, 2 — IGMP, 6 — TCP, 17 — UDP, 47 — GRE, 50 — ESP, 89 — OSPF. Номера ведёт реестр IANA. Это поле — аналог EtherType, но на сетевом уровне: оно реализует демультиплексирование, о котором говорилось в теме 2.
- Контрольная сумма заголовка (англ. Header Checksum, 16 бит) — защищает только заголовок; правило вычисления разобрано ниже.
- Адрес источника и адрес назначения (по 32 бита).
- Опции (англ. Options, переменной длины, дополняются до границы 32-битного слова) — необязательные расширения.
Опции заслуживают короткого комментария. RFC 791 определяет, в частности, запись маршрута (англ. Record Route), отметки времени и маршрутизацию от источника (англ. source routing), при которой отправитель сам указывает промежуточные узлы 1. Маршрутизация от источника позволяет обойти фильтрацию и подменить путь, поэтому маршрутизаторы и межсетевые экраны обычно отбрасывают такие пакеты, а пакеты с опциями вообще обрабатываются многими аппаратными маршрутизаторами на медленном программном пути. В современной сети опции почти не встречаются. Одно из немногих исключений — опция «предупреждение маршрутизатору» (англ. Router Alert), которой помечены, например, сообщения протокола управления группами IGMP: в захвате трафика они видны как options (RA), а поле IHL у них равно 6.
Разбор реального пакета байт за байтом
Рассмотрим конкретный пакет. На хосте h1 (10.7.1.10) выполнена команда ping -c 1 10.7.1.30, и кадр с эхо-запросом захвачен на интерфейсе h1:
# в пространстве имён h1
tcpdump -i eth0 -nn -XX -c 1 icmp
IP 10.7.1.10 > 10.7.1.30: ICMP echo request, id 53644, seq 1, length 64
	0x0000:  0200 0007 0130 0200 0007 0110 0800 4500  .....0........E.
	0x0010:  0054 525d 4000 4001 d216 0a07 010a 0a07  .TR]@.@.........
	0x0020:  011e 0800 42ce d18c 0001 53ac cc6a 0000  ....B.....S..j..
	0x0030:  0000 f6b9 0e00 0000 0000 1011 1213 1415  ................
	...
Первые 14 байт — заголовок Ethernet (тема 4): MAC-адрес назначения 02:00:00:07:01:30, MAC-адрес источника 02:00:00:07:01:10 и EtherType 0800, сообщающий, что дальше лежит пакет IPv4. Заголовок IP начинается с байта со смещением 14 (0x0e) и занимает 20 байт. Разберём их по порядку.
| Байты (hex) | Поле | Значение и смысл |
|---|---|---|
45 | Версия, IHL | 4 — IPv4; 5 слов = 20 байт, опций нет |
00 | DSCP, ECN | 0 — обычное обслуживание, ECN не используется |
00 54 | Общая длина | 0x54 = 84 байта: 20 (IP) + 8 (заголовок ICMP) + 56 (данные ping) |
52 5d | Идентификатор | 0x525d = 21 085 |
40 00 | Флаги, смещение | 0100 0000 0000 0000: DF = 1, MF = 0, смещение 0 |
40 | TTL | 64 — начальное значение по умолчанию в Linux |
01 | Протокол | 1 — ICMP |
d2 16 | Контрольная сумма | 0xd216 |
0a 07 01 0a | Адрес источника | 10.7.1.10 |
0a 07 01 1e | Адрес назначения | 10.7.1.30 |
Сразу за заголовком IP начинается сообщение ICMP: тип 08 (эхо-запрос), код 00, контрольная сумма ICMP 42ce, идентификатор d18c (53 644 — тот самый id в выводе tcpdump) и номер последовательности 0001. Далее идут 56 байт данных, первые 16 из которых ping в Linux заполняет отметкой времени отправки, — так утилита вычисляет время кругового обхода, не храня состояния о каждом запросе.
Длина кадра, которую сообщает tcpdump, равна 98 байтам: 14 байт Ethernet плюс 84 байта IP. Контрольная последовательность кадра FCS (4 байта) в захват не попадает — её проверяет и удаляет сетевая карта, — а на виртуальном интерфейсе veth её нет вовсе.
Вычислим контрольную сумму, чтобы убедиться, что значение d216 не случайно. Алгоритм определён в RFC 791 и подробно объяснён в RFC 1071: заголовок рассматривается как последовательность 16-битных слов, поле контрольной суммы на время вычисления полагается равным нулю, слова складываются в арифметике с обратным кодом (англ. ones' complement) — то есть перенос из старшего разряда прибавляется к младшему, — и результат инвертируется 1:
  4500 + 0054 + 525d + 4000 + 4001 + 0000 + 0a07 + 010a + 0a07 + 011e
= 0x12de8                       (сумма десяти слов, контрольная сумма = 0)
  0x2de8 + 0x1                = 0x2de9   (перенос прибавлен к младшим разрядам)
  ~0x2de9                     = 0xd216   (инверсия всех 16 бит)
Получатель складывает все десять слов вместе с полученной контрольной суммой; при отсутствии ошибок результат после свёртки переносов равен 0xffff. Поскольку маршрутизатор на каждом переходе уменьшает TTL, контрольная сумма меняется на каждом переходе, и маршрутизатор обязан её пересчитать; на практике это делается не полным пересчётом, а инкрементально, по разности старого и нового значений слова 5. Для сравнения: в эхо-ответе от h3 в том же захвате поле флагов равно 00 00 (DF не установлен), идентификатор другой (99f3), а контрольная сумма — ca80. Флаг DF в запросе выставлен потому, что Linux по умолчанию применяет механизм обнаружения MTU пути, рассмотренный в конце темы.
Время жизни пакета
Поле TTL решает задачу, у которой в Ethernet нет решения: защиту от бесконечной циркуляции пакетов. Как показано в теме 5, кадр в петле коммутаторов живёт сколь угодно долго и порождает широковещательный шторм. Пакет IP в петле маршрутизации — ситуации, когда маршрутизаторы из-за ошибки конфигурации пересылают пакет друг другу по кругу, — погибнет самое большее через 255 переходов. Маршрутизатор, получивший пакет с TTL, равным 1 (или 0), не пересылает его, а уничтожает и отправляет источнику сообщение ICMP «время истекло» 5. Петли маршрутизации и наблюдение за ними подробно рассматриваются в теме 8.
Начальное значение TTL выбирает отправитель. В Linux оно задаётся параметром net.ipv4.ip_default_ttl и по умолчанию равно 64 14, в Windows — 128, в ряде сетевых ОС — 255. Отсюда полезное следствие для диагностики: по TTL полученного пакета можно оценить число пройденных маршрутизаторов. Если эхо-ответ пришёл с TTL 62, а отвечающий узел — Linux, то по пути было два маршрутизатора: 64 − 62 = 2.
Отправка пакета хостом: свой сегмент или шлюз
Решение о следующем переходе
Пусть приложение на h1 отправляет пакет по адресу назначения D. Прежде чем передать пакет канальному уровню, хост должен решить, кому именно отдать кадр. Возможны два случая. Если D принадлежит той же IP-подсети, что и один из интерфейсов хоста, адресат находится в том же широковещательном домене, и кадр отправляется ему напрямую (англ. direct delivery). Иначе кадр отправляется маршрутизатору — следующему переходу (англ. next hop), чаще всего шлюзу по умолчанию (англ. default gateway), который продолжит доставку 4.
Проверка «свой сегмент» сводится к операции, разобранной в теме 6: побитовое «И» адреса назначения с маской интерфейса сравнивается с номером сети интерфейса. Для h1 с адресом 10.7.1.10/24 адрес 10.7.1.30 даёт после наложения маски 10.7.1.0 — та же сеть, доставка прямая; адрес 10.7.2.20 даёт 10.7.2.0 — сеть чужая, нужен шлюз 10.7.1.1. В Linux это решение — частный случай поиска в таблице маршрутизации (тема 8): маршрут к собственной подсети создаётся автоматически при назначении адреса, а шлюз задаётся маршрутом по умолчанию. Результат решения для конкретного адреса показывает команда ip route get:
# в пространстве имён h1
ip route get 10.7.1.30
ip route get 10.7.2.20
10.7.1.30 dev eth0 src 10.7.1.10 uid 0
    cache
10.7.2.20 via 10.7.1.1 dev eth0 src 10.7.1.10 uid 0
    cache
Слово via во второй строке и означает «через следующий переход». Принципиально важно, что адрес шлюза в заголовок IP не попадает: адресом назначения пакета остаётся 10.7.2.20. Шлюз определяет лишь, на чей MAC-адрес будет отправлен кадр. Схема на рисунке ниже показывает это для обоих случаев: при прямой доставке MAC-адрес назначения кадра принадлежит самому адресату, при доставке через шлюз — маршрутизатору r1, хотя IP-адрес назначения в обоих кадрах указывает на конечный узел.
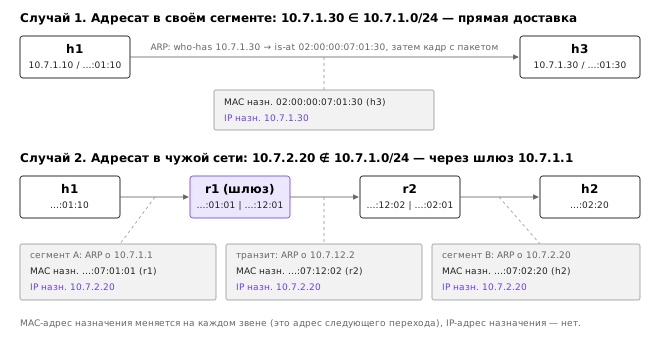
Типичная ошибка понимания — считать, что хост «отправляет пакет на IP-адрес шлюза». Если бы это было так, шлюз не знал бы, куда пересылать пакет дальше. На каждом переходе меняется кадр (MAC-адреса источника и назначения), а заголовок IP остаётся прежним, за исключением TTL и контрольной суммы — а при трансляции адресов, о которой пойдёт речь в теме 14, ещё и адресов.
Протокол ARP: формат и обмен
Решив, что следующий переход — узел с IP-адресом N, хост должен узнать MAC-адрес этого узла: коммутатор Ethernet доставляет кадры только по MAC-адресам. Эту задачу решает протокол разрешения адресов (англ. Address Resolution Protocol, ARP), описанный в RFC 826 в 1982 году 3. Идея проста: хост рассылает широковещательный запрос «у кого адрес N? сообщите отправителю», а владелец адреса отвечает индивидуальным кадром «N находится по MAC-адресу M».
Сообщение ARP переносится непосредственно в кадре Ethernet с EtherType 0x0806, без заголовка IP. Протокол задуман универсальным — для любых пар «сетевой адрес — аппаратный адрес», поэтому в нём явно указаны типы и длины адресов. Для пары Ethernet/IPv4 сообщение занимает 28 байт:
| Поле | Длина | Значение для Ethernet и IPv4 |
|---|---|---|
| Тип аппаратного адреса (HTYPE) | 2 байта | 1 — Ethernet |
| Тип протокольного адреса (PTYPE) | 2 байта | 0x0800 — IPv4 |
| Длина аппаратного адреса (HLEN) | 1 байт | 6 |
| Длина протокольного адреса (PLEN) | 1 байт | 4 |
| Код операции (OPER) | 2 байта | 1 — запрос, 2 — ответ |
| Аппаратный адрес отправителя (SHA) | 6 байт | MAC-адрес отправителя |
| Протокольный адрес отправителя (SPA) | 4 байта | IPv4-адрес отправителя |
| Аппаратный адрес цели (THA) | 6 байт | в запросе — нули, в ответе — MAC запросившего |
| Протокольный адрес цели (TPA) | 4 байта | искомый IPv4-адрес |
Обмен, предшествующий первому эхо-запросу h1 к h3, выглядит в захвате так (ключ -e выводит заголовок Ethernet):
02:00:00:07:01:10 > ff:ff:ff:ff:ff:ff, ethertype ARP (0x0806), length 42: Request who-has 10.7.1.30 tell 10.7.1.10, length 28
02:00:00:07:01:30 > 02:00:00:07:01:10, ethertype ARP (0x0806), length 42: Reply 10.7.1.30 is-at 02:00:00:07:01:30, length 28
02:00:00:07:01:10 > 02:00:00:07:01:30, ethertype IPv4 (0x0800), length 98: ... 10.7.1.10 > 10.7.1.30: ICMP echo request ...
02:00:00:07:01:30 > 02:00:00:07:01:10, ethertype IPv4 (0x0800), length 98: ... 10.7.1.30 > 10.7.1.10: ICMP echo reply ...
Запрос в шестнадцатеричном виде:
0x0000:  ffff ffff ffff 0200 0007 0110 0806 0001  ................
0x0010:  0800 0604 0001 0200 0007 0110 0a07 010a  ................
0x0020:  0000 0000 0000 0a07 011e                 ..........
После 14 байт заголовка Ethernet (широковещательный адрес назначения, MAC h1, EtherType 0806) читаются поля ARP: 0001 — Ethernet, 0800 — IPv4, 06 и 04 — длины адресов, 0001 — запрос, затем MAC h1 и его IP 0a07010a (10.7.1.10), шесть нулевых байт на месте неизвестного MAC цели и искомый адрес 0a07011e (10.7.1.30). Кадр занимает 42 байта; на настоящей линии Ethernet сетевая карта дополнит его до минимальных 60 байт (без FCS), как объяснялось в теме 4.
В RFC 826 есть деталь, которую легко упустить: получатель запроса, прежде чем ответить, заносит в свою таблицу пару «IP — MAC» отправителя 3. Логика такова: раз h1 спрашивает h3, то h3, скорее всего, вскоре придётся отвечать h1, и второй широковещательный запрос не понадобится. Поэтому в захвате видны ровно один запрос и один ответ, хотя адреса друг друга узнали оба узла. Тот же принцип обновления существующих записей по любому полученному ARP-пакету лежит в основе gratuitous ARP и, увы, ARP-спуфинга.
Таблица соседей Linux и её состояния
Результаты разрешения кешируются: рассылать широковещательный запрос перед каждым пакетом было бы расточительно. Классический ARP-кеш (англ. ARP cache) в Linux реализован как общая подсистема соседей (англ. neighbour subsystem), обслуживающая и ARP, и обнаружение соседей IPv6 (тема 11). Её содержимое показывает команда ip neigh:
# в пространстве имён h1: ping соседа, затем несуществующего адреса
ping -c 1 10.7.1.30
ping -c 1 -W 1 10.7.1.99
ip neigh
10.7.1.99 dev eth0  INCOMPLETE
10.7.1.30 dev eth0 lladdr 02:00:00:07:01:30 REACHABLE
Каждая запись находится в одном из состояний конечного автомата, основанного на алгоритме проверки недостижимости соседа (англ. Neighbor Unreachability Detection, NUD), заимствованном из IPv6:
| Состояние | Смысл |
|---|---|
INCOMPLETE | запрос отправлен, ответа ещё нет |
REACHABLE | достижимость недавно подтверждена ответом ARP или подтверждением от верхнего уровня (например, приходом ACK TCP) |
STALE | запись устарела: MAC-адрес известен, но давно не подтверждался; использовать её можно |
DELAY | по устаревшей записи отправлен пакет; ядро ждёт несколько секунд подтверждения от верхнего уровня, прежде чем проверять самостоятельно |
PROBE | ядро отправляет индивидуальные ARP-запросы, проверяя соседа |
FAILED | сосед не ответил на все попытки |
PERMANENT | статическая запись, добавленная администратором (ip neigh add ... nud permanent) |
NOARP | разрешение адресов не требуется (например, на петлевом интерфейсе) |
Время пребывания записи в состоянии REACHABLE выбирается случайно в пределах от половины до полуторного значения параметра base_reachable_time_ms, по умолчанию равного 30 000 мс 14; случайность нужна, чтобы узлы сегмента не обновляли записи синхронно. Через 15–45 секунд неактивности запись переходит в STALE, но не удаляется: в учебной топологии через 40 секунд после ping обе записи h1 оказываются в состоянии STALE. При следующей отправке пакета запись проходит через DELAY (5 секунд по умолчанию, параметр delay_first_probe_time) и при отсутствии подтверждения — через PROBE. Такой автомат позволяет не задерживать пакеты из-за проверки: устаревший адрес используется сразу, а проверка идёт параллельно. Удаляются записи сборщиком мусора, причём неиспользуемые записи в STALE хранятся не меньше gc_stale_time (60 с по умолчанию).
Запись INCOMPLETE и последующий FAILED — первый признак того, что в сегменте нет узла с нужным адресом. Если такая запись возникает для адреса шлюза, хост не может отправить ни одного пакета за пределы сегмента; ping при этом сообщает Destination Host Unreachable от собственного адреса хоста, а не от маршрутизатора, — характерный симптом проблемы на канальном уровне, а не в маршрутизации.
Gratuitous ARP, proxy ARP и безопасность ARP
Несколько разновидностей ARP-сообщений используют тот же формат для иных целей.
Безвозмездный ARP (англ. gratuitous ARP) — запрос или ответ, в котором узел сообщает о собственном адресе, хотя никто его не спрашивал: адрес отправителя и искомый адрес совпадают. RFC 5227 называет такое сообщение объявлением (англ. ARP Announcement) 9. Его рассылают, чтобы обновить кеши соседей после смены MAC-адреса (замена сетевой карты, переход виртуального IP-адреса на резервный сервер в кластере, миграция виртуальной машины). Поскольку получатели обновляют существующие записи по любому ARP-пакету, после объявления трафик сегмента сразу направляется на новый MAC-адрес. В Linux объявление не создаёт новых записей (за это отвечает параметр arp_accept, по умолчанию 0), но обновляет уже имеющиеся 14.
Проверка адреса (англ. ARP Probe), также описанная в RFC 5227, — запрос с адресом отправителя 0.0.0.0, который узел рассылает перед тем, как начать пользоваться адресом 9. Если кто-то ответил, адрес занят, и узел обязан от него отказаться. Нулевой адрес отправителя нужен, чтобы сама проверка не «отравила» кеши соседей. Такую проверку выполняют, например, DHCP-клиенты (тема 14) и механизм link-local адресов 169.254.0.0/16. При ручном назначении адреса командой ip addr add Linux никакой проверки не делает, поэтому конфликт адресов — две машины с одним IP — проявляется не сообщением об ошибке, а «мерцанием» связности: кеши соседей указывают то на один MAC-адрес, то на другой, в зависимости от того, кто последним отправил ARP-пакет.
Proxy ARP — режим, в котором маршрутизатор отвечает на ARP-запросы о чужих адресах своим MAC-адресом и затем пересылает полученные кадры по назначению. Так можно соединить узлы, ошибочно считающие, что находятся в одной подсети, или «растянуть» подсеть через маршрутизатор. В Linux режим включается параметром net.ipv4.conf.<интерфейс>.proxy_arp 14. Proxy ARP маскирует ошибки адресного плана, поэтому в современных сетях его включают только намеренно и в ограниченных сценариях.
Безопасность в ARP не предусмотрена: ответ не аутентифицирован, а получатель доверяет любому ответу и любому объявлению. Узел злоумышленника может разослать объявления «IP-адрес шлюза находится по моему MAC-адресу» и тем самым перенаправить через себя трафик всего сегмента — атака подмены ARP (англ. ARP spoofing) лежит в основе классической атаки «человек посередине». Методы защиты (динамическая проверка ARP на коммутаторах, статические записи, обнаружение аномалий) рассматриваются в теме 18.
ICMP: сообщения об ошибках и диагностика
Назначение и формат сообщений ICMP
Поскольку IP не даёт гарантий доставки, отправитель без дополнительных средств никогда бы не узнал, почему пакет не дошёл: потерян в очереди, некуда пересылать или адресат не существует. Протокол управляющих сообщений Интернета (англ. Internet Control Message Protocol, ICMP), определённый в RFC 792 одновременно с IP, предоставляет маршрутизаторам и хостам способ сообщить источнику о проблеме 2. ICMP считается неотъемлемой частью IP и обязан быть реализован в каждом узле, хотя его сообщения переносятся внутри датаграмм IP с номером протокола 1, как если бы ICMP был протоколом более высокого уровня.
Сообщение ICMP начинается с заголовка из четырёх байт — тип (англ. Type, 1 байт), код (англ. Code, 1 байт), контрольная сумма всего сообщения (2 байта) — за которым следуют четыре байта, смысл которых зависит от типа, и данные. Тип задаёт класс сообщения, код уточняет причину. Наиболее важные сочетания приведены в таблице.
| Тип | Код | Название | Кто и когда отправляет |
|---|---|---|---|
| 0 | 0 | Echo Reply — эхо-ответ | адресат эхо-запроса |
| 3 | 0 | Net Unreachable — сеть недостижима | маршрутизатор, не имеющий маршрута к сети назначения |
| 3 | 1 | Host Unreachable — узел недостижим | маршрутизатор, не получивший ответа ARP от узла в подключённой сети |
| 3 | 3 | Port Unreachable — порт недостижим | узел назначения, на котором никто не слушает порт UDP |
| 3 | 4 | Fragmentation Needed and DF Set | маршрутизатор, которому нужно фрагментировать пакет с флагом DF |
| 3 | 13 | Communication Administratively Prohibited | маршрутизатор или межсетевой экран, отбросивший пакет по политике |
| 5 | 0–3 | Redirect — перенаправление | маршрутизатор, знающий для хоста лучший следующий переход в том же сегменте |
| 8 | 0 | Echo Request — эхо-запрос | ping |
| 11 | 0 | Time Exceeded in Transit — TTL истёк в пути | маршрутизатор, получивший пакет с TTL 1 |
| 11 | 1 | Fragment Reassembly Time Exceeded | узел назначения, не дождавшийся всех фрагментов |
| 12 | 0 | Parameter Problem — ошибка в заголовке | узел, обнаруживший некорректное поле |
Сообщения делятся на два класса: информационные (запросы и ответы — эхо, а исторически ещё отметки времени и маски) и сообщения об ошибках (типы 3, 5, 11, 12). Код 13 и некоторые другие коды типа 3 добавлены позднее, в требованиях к маршрутизаторам RFC 1812 5. Тип 4, «подавление источника» (англ. Source Quench), задумывался как сигнал перегрузки, но оказался неэффективным и признан устаревшим; управление перегрузкой реализуется в TCP (тема 13).
Сообщение об ошибке обязательно содержит начало того пакета, который её вызвал: заголовок IP и по меньшей мере первые 8 байт данных 2. Восемь байт выбраны не случайно — в них помещаются номера портов UDP и TCP, а значит, получатель ошибки может определить, какому сокету она адресована, и передать её приложению. RFC 1812 разрешает маршрутизаторам вкладывать больше — столько, сколько возможно без превышения 576 байт итогового пакета 5. Linux так и поступает: ниже в разборе ping -t 1 сообщение «время истекло» имеет длину 112 байт — 20 байт собственного заголовка IP, 8 байт заголовка ICMP и все 84 байта исходного пакета.
Когда сообщения об ошибках не отправляются
Если бы ошибки порождали ошибки, одна неисправность могла бы вызвать лавину служебного трафика. Поэтому RFC 1122 запрещает отправлять сообщение об ошибке ICMP в ответ на: другое сообщение об ошибке ICMP; датаграмму, адресованную на широковещательный или групповой адрес; кадр, отправленный на широковещательный канальный адрес; датаграмму, адрес источника которой не идентифицирует единственный узел (нулевой, широковещательный, групповой адрес); любой фрагмент, кроме первого 4. Последнее правило связано с тем, что только первый фрагмент содержит заголовок транспортного протокола, а значит, только по нему ошибку можно сопоставить с сокетом.
Кроме того, узлы ограничивают частоту отправки сообщений об ошибках. В Linux это делают параметры net.ipv4.icmp_ratelimit (минимальный интервал между сообщениями к одному адресату, по умолчанию 1000 мс в терминах корзины маркеров) и net.ipv4.icmp_ratemask, задающая, к каким типам применяется ограничение; по умолчанию это типы 3, 4, 11 и 12 14. Ограничение частоты объясняет, почему traceroute иногда показывает звёздочки на промежуточном маршрутизаторе, который при этом исправно пересылает трафик: маршрутизатор просто не успевает или не желает отвечать на все пробы.
Наконец, многие администраторы фильтруют ICMP на межсетевых экранах целиком — «на всякий случай». Последствия такого решения для эхо-запросов безобидны, а для сообщений «требуется фрагментация» — разрушительны, что будет показано в последнем разделе.
Как работает ping
Утилита ping отправляет эхо-запросы (тип 8) и ждёт эхо-ответов (тип 0). Узел, получивший эхо-запрос, обязан вернуть данные запроса без изменений 24. Идентификатор позволяет отличить ответы, адресованные разным экземплярам ping, номер последовательности — обнаружить потери и переупорядочение, а отметка времени в данных — вычислить время кругового обхода (англ. round-trip time, RTT).
Вывод ping содержит не только RTT. Значение ttl= в строке ответа — это TTL эхо-ответа в момент получения, по которому, как показано выше, оценивается длина обратного пути. Если ответа нет, а вместо него пришло сообщение об ошибке, ping печатает его с адресом отправителя ошибки. В учебной топологии удаление на r1 маршрута к сети 10.7.2.0/24 приводит к такому результату:
PING 10.7.2.20 (10.7.2.20) 56(84) bytes of data.
From 10.7.1.1 icmp_seq=1 Destination Net Unreachable

--- 10.7.2.20 ping statistics ---
1 packets transmitted, 0 received, +1 errors, 100% packet loss, time 0ms
Адрес From 10.7.1.1 указывает, кто именно не смог переслать пакет, — это первая и самая ценная подсказка при поиске неисправности. Отличие отсутствия ответа от получения ошибки также существенно: ошибка означает, что пакет дошёл до узла, который о нём что-то знает, тишина — что пакет или ответ потерялся где-то по пути, в том числе был молча отброшен фильтром.
Похожим образом сообщает о себе закрытый порт UDP. Если отправить датаграмму на порт, который никто не слушает, узел назначения ответит сообщением «порт недостижим», вложив в него начало исходной датаграммы:
IP (tos 0x0, ttl 64, id 53719, offset 0, flags [DF], proto UDP (17), length 31)
    10.7.1.10.52199 > 10.7.2.20.5555: UDP, length 3
IP (tos 0xc0, ttl 62, id 33441, offset 0, flags [none], proto ICMP (1), length 59)
    10.7.2.20 > 10.7.1.10: ICMP 10.7.2.20 udp port 5555 unreachable, length 39
	IP (tos 0x0, ttl 62, id 53719, offset 0, flags [DF], proto UDP (17), length 31)
    10.7.1.10.52199 > 10.7.2.20.5555: UDP, length 3
Обратим внимание на tos 0xc0 сообщения об ошибке: Linux помечает служебные сообщения ICMP значением DSCP 48 (класс CS6, «управление сетью»). Вложенный заголовок показывает исходный пакет таким, каким он пришёл к адресату, — с TTL 62 после двух маршрутизаторов.
Как работают traceroute и tracepath
Утилита traceroute, написанная Ван Джекобсоном в 1988 году, превращает механизм TTL в инструмент измерения пути. Она отправляет к адресату пробные пакеты с TTL, равным 1, затем 2, 3 и так далее. Пакет с TTL 1 уничтожается первым маршрутизатором, который возвращает сообщение «время истекло» и тем самым раскрывает свой адрес; пакет с TTL 2 — вторым, и так далее, пока проба не достигнет адресата 13. Временная диаграмма на рисунке ниже показывает этот процесс для учебной топологии.
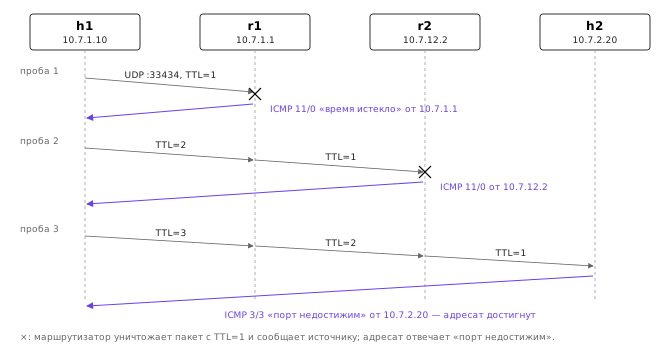
Классический traceroute в Linux отправляет на каждый переход по три пробы UDP на порты, начиная с 33434, увеличивая номер порта для каждой пробы, и прекращает работу, получив от адресата «порт недостижим» — расчёт делается на то, что столь высокие порты никто не слушает. Ключ -I заменяет пробы на эхо-запросы ICMP (так по умолчанию работает tracert в Windows), ключ -T — на сегменты TCP SYN, обычно к порту 80 или 443. Варианты существуют потому, что межсетевые экраны по-разному относятся к разным протоколам: проба TCP к открытому порту веб-сервера проходит туда, где UDP и ICMP отфильтрованы.
Простой опыт показывает основу метода без всякого traceroute: эхо-запрос с TTL 1 к узлу за маршрутизатором.
# в пространстве имён h1
ping -c 1 -t 1 10.7.2.20
PING 10.7.2.20 (10.7.2.20) 56(84) bytes of data.
From 10.7.1.1 icmp_seq=1 Time to live exceeded
В захвате видны сам запрос с ttl 1 и ответ r1, внутри которого вложен исходный пакет:
02:00:00:07:01:10 > 02:00:00:07:01:01, ... (tos 0x0, ttl 1, id 56956, offset 0, flags [DF], proto ICMP (1), length 84)
    10.7.1.10 > 10.7.2.20: ICMP echo request, id 8848, seq 1, length 64
02:00:00:07:01:01 > 02:00:00:07:01:10, ... (tos 0xc0, ttl 64, id 40921, offset 0, flags [none], proto ICMP (1), length 112)
    10.7.1.1 > 10.7.1.10: ICMP time exceeded in-transit, length 92
	(tos 0x0, ttl 1, id 56956, offset 0, flags [DF], proto ICMP (1), length 84)
    10.7.1.10 > 10.7.2.20: ICMP echo request, id 8848, seq 1, length 64
Утилита tracepath из пакета iputils работает по тому же принципу, но не требует прав суперпользователя и попутно определяет MTU пути, о котором пойдёт речь далее. Для учебной топологии:
 1?: [LOCALHOST]                      pmtu 1500
 1:  10.7.1.1                                              0.073ms
 1:  10.7.1.1                                              0.018ms
 2:  10.7.12.2                                             0.029ms
 3:  10.7.2.20                                             0.033ms reached
     Resume: pmtu 1500 hops 3 back 3
Интерпретируя вывод трассировки, нужно помнить о трёх ограничениях. Во-первых, маршрутизатор отвечает с адреса того интерфейса, через который отправляет ответ (обычно — обращённого к источнику), поэтому r2 виден как 10.7.12.2, а не как 10.7.2.1. Во-вторых, трассировка показывает только прямой путь; обратный путь в Интернете часто иной, а время, выводимое для каждого перехода, включает именно обратный путь ответа. В-третьих, маршрутизаторы обрабатывают адресованные им пакеты и генерируют ICMP на медленном программном пути с ограничением частоты, поэтому большая задержка на промежуточном переходе при нормальной задержке до конечных узлов говорит о загруженности процессора маршрутизатора, а не канала.
Фрагментация и MTU пути
MTU и фрагментация на маршрутизаторе
Каждая канальная технология ограничивает размер полезной нагрузки кадра. Это ограничение называется максимальным размером передаваемого блока (англ. Maximum Transmission Unit, MTU): для Ethernet — 1500 байт (тема 4), для туннелей — меньше на размер дополнительных заголовков (тема 19), для звеньев с jumbo-кадрами — до 9000 байт. Датаграмма IP может достигать 65 535 байт, а путь через Интернет проходит через каналы с разным MTU. MTU пути (англ. Path MTU, PMTU) — наименьшее из значений MTU всех каналов на пути от источника к адресату.
IPv4 решает проблему несовпадения размеров фрагментацией (англ. fragmentation): узел, который должен отправить датаграмму в канал с меньшим MTU, разрезает её на фрагменты, каждый из которых — самостоятельная датаграмма с собственным заголовком IP 1. Фрагментировать может как источник, так и любой маршрутизатор на пути; собирает фрагменты только узел назначения. Для сборки используются три поля заголовка:
- идентификатор — одинаков у всех фрагментов одной исходной датаграммы; вместе с адресами источника и назначения и номером протокола он однозначно определяет, к какой датаграмме относится фрагмент 12;
- смещение фрагмента — позиция данных фрагмента в данных исходной датаграммы, измеряемая в единицах по 8 байт: 13 битов поля дают максимум 8191 × 8 = 65 528 байт;
- флаг MF — равен 1 у всех фрагментов, кроме последнего.
Из-за единицы измерения смещения длина данных каждого фрагмента, кроме последнего, должна быть кратна 8. Заголовок IP копируется в каждый фрагмент; опции копируются выборочно, по признаку в коде опции 1.
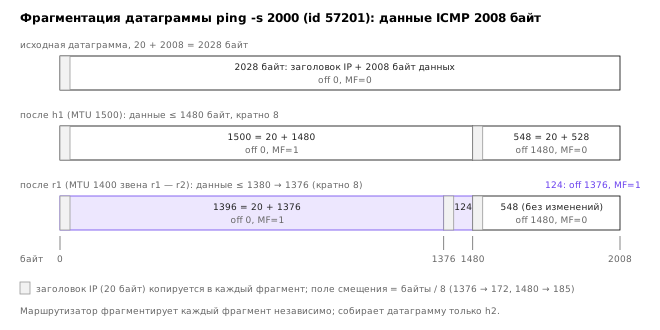
Разберём числовой пример, полученный в учебной топологии. MTU транзитного звена r1 — r2 уменьшено до 1400 байт, на остальных звеньях оно равно 1500. Хост h1 отправляет команду ping -s 2000 -M dont 10.7.2.20: 2000 байт данных, 8 байт заголовка ICMP, 20 байт заголовка IP, итого датаграмма длиной 2028 байт; ключ -M dont запрещает устанавливать флаг DF.
Первым фрагментирует сам источник, поскольку датаграмма не помещается в свой же интерфейс с MTU 1500. В фрагмент помещается не больше 1500 − 20 = 1480 байт данных; 1480 кратно 8 (185 × 8), поэтому первый фрагмент несёт 1480 байт со смещением 0 и MF = 1, второй — оставшиеся 2008 − 1480 = 528 байт со смещением 1480 (значение поля 185) и MF = 0. Его общая длина — 548 байт. Захват на h1 (tcpdump выводит смещение уже в байтах, а flags [+] означает MF = 1):
(tos 0x0, ttl 64, id 57201, offset 0, flags [+], proto ICMP (1), length 1500)
    10.7.1.10 > 10.7.2.20: ICMP echo request, id 43364, seq 1, length 1480
(tos 0x0, ttl 64, id 57201, offset 1480, flags [none], proto ICMP (1), length 548)
    10.7.1.10 > 10.7.2.20: ip-proto-1
Затем фрагментирует маршрутизатор r1: первый фрагмент длиной 1500 байт не помещается в звено с MTU 1400. Данных в новом фрагменте может быть не больше 1400 − 20 = 1380 байт, но 1380 не кратно 8, поэтому берётся ближайшее меньшее кратное — 1376 (172 × 8). Фрагмент длиной 1500 распадается на два: 20 + 1376 = 1396 байт со смещением 0 и 20 + 104 = 124 байта со смещением 1376. У второго из них флаг MF остаётся равным 1, потому что за ним в исходной датаграмме следуют ещё данные — фрагмент со смещением 1480, который проходит звено без изменений. Захват на транзитном звене:
(tos 0x0, ttl 63, id 57201, offset 0, flags [+], proto ICMP (1), length 1396)
    10.7.1.10 > 10.7.2.20: ICMP echo request, id 43364, seq 1, length 1376
(tos 0x0, ttl 63, id 57201, offset 1376, flags [+], proto ICMP (1), length 124)
    10.7.1.10 > 10.7.2.20: ip-proto-1
(tos 0x0, ttl 63, id 57201, offset 1480, flags [none], proto ICMP (1), length 548)
    10.7.1.10 > 10.7.2.20: ip-proto-1
Схема на рисунке ниже сводит обе стадии в одну картину. Заметим, что повторная фрагментация не «склеивает» фрагменты: маршрутизатор работает с каждым фрагментом как с обычной датаграммой, и итоговое разбиение получается неоптимальным — три фрагмента там, где хватило бы двух. Только заголовок первого фрагмента содержит заголовок ICMP, поэтому tcpdump распознаёт эхо-запрос лишь в нём, а остальные показывает как ip-proto-1.
Сборка фрагментов и её проблемы
Узел назначения складывает фрагменты в буфер сборки, упорядочивая их по смещению, и считает датаграмму собранной, когда получен фрагмент с MF = 0 и заполнены все промежутки. Если за отведённое время собрать датаграмму не удалось, уже полученные фрагменты отбрасываются, а источнику, если был получен первый фрагмент, отправляется сообщение ICMP типа 11 код 1. В Linux это время задаётся параметром net.ipv4.ipfrag_time и равно 30 с, а объём памяти под буферы сборки ограничен параметром ipfrag_high_thresh 14. Счётчики фрагментации и сборки видны в статистике ядра:
nstat -az 'IpReasm*' 'IpFrag*'
IpReasmReqds                    3                  0.0
IpReasmOKs                      1                  0.0
IpFragOKs                       1                  0.0
IpFragCreates                   2                  0.0
Этот вывод получен на h1 после описанного выше опыта: хост создал два фрагмента из одной датаграммы (IpFragCreates, IpFragOKs) и собрал один эхо-ответ из трёх полученных фрагментов (IpReasmReqds, IpReasmOKs).
Фрагментация решает задачу совместимости, но с самого начала считалась нежелательной. Ещё в 1987 году Кент и Могул показали её основные недостатки 15, а RFC 8900 в 2020 году подытожил накопленный опыт под заголовком «Фрагментация IP считается хрупкой» 8. Основные проблемы таковы. Потеря одного фрагмента означает потерю всей датаграммы, причём повторно передаётся (если передаётся) датаграмма целиком; при доле потерь p и n фрагментах вероятность доставки падает до (1 − p) в степени n. Фрагментация нагружает маршрутизаторы и вынуждает узел назначения хранить состояние, что открывает путь атакам на исчерпание буферов сборки и атакам с перекрывающимися фрагментами. Межсетевые экраны и балансировщики, принимающие решение по номерам портов, видят порты только в первом фрагменте. Наконец, 16-битный идентификатор при высоких скоростях быстро повторяется, и фрагменты разных датаграмм могут быть ошибочно собраны вместе 12.
Поэтому современная практика — избегать фрагментации: подбирать размер пакетов под MTU пути на стороне источника. IPv6 доводит эту идею до конца, запрещая фрагментацию на маршрутизаторах (тема 11).
Обнаружение MTU пути
Механизм обнаружения MTU пути (англ. Path MTU Discovery, PMTUD), описанный в RFC 1191, использует флаг DF 6. Источник отправляет пакеты с установленным DF, поначалу размером, равным MTU своего интерфейса. Маршрутизатор, который не может переслать такой пакет без фрагментации, отбрасывает его и отправляет источнику сообщение ICMP типа 3 код 4 «требуется фрагментация, а флаг DF установлен». RFC 1191 добавил к этому сообщению важное поле: в ранее не используемых младших 16 битах второго слова заголовка ICMP маршрутизатор указывает MTU следующего перехода (англ. Next-Hop MTU). Источник запоминает это значение как MTU пути к данному адресату и уменьшает размер последующих пакетов; транспортный протокол TCP соответственно уменьшает размер сегмента.
Опыт в учебной топологии с тем же звеном MTU 1400 выглядит так:
# в пространстве имён h1: 1472 байта данных + 8 + 20 = 1500 байт, флаг DF установлен
ping -c 2 -s 1472 -M do 10.7.2.20
PING 10.7.2.20 (10.7.2.20) 1472(1500) bytes of data.
From 10.7.1.1 icmp_seq=1 Frag needed and DF set (mtu = 1400)
ping: local error: message too long, mtu=1400
Первый пакет дошёл до r1 и вызвал сообщение ICMP; захват на h1 показывает его вместе с вложенным пакетом и полем MTU следующего перехода:
(tos 0x0, ttl 64, id 0, offset 0, flags [DF], proto ICMP (1), length 1500)
    10.7.1.10 > 10.7.2.20: ICMP echo request, id 4911, seq 1, length 1480
(tos 0xc0, ttl 64, id 41411, offset 0, flags [none], proto ICMP (1), length 576)
    10.7.1.1 > 10.7.1.10: ICMP 10.7.2.20 unreachable - need to frag (mtu 1400), length 556
Второй пакет уже не покинул h1: ядро, запомнив MTU пути 1400, отказало приложению локально (local error). Запомненное значение хранится в виде исключения маршрута (англ. route exception) и видно в выводе ip route get:
10.7.2.20 via 10.7.1.1 dev eth0 src 10.7.1.10 uid 0
    cache expires 597sec mtu 1400
Значение устаревает через 600 с (параметр net.ipv4.route.mtu_expires), после чего источник снова пробует полный размер — так обнаруживается увеличение MTU пути, если путь изменился 614. Обратим внимание на длину сообщения ICMP — ровно 576 байт: r1 вложил в него столько исходного пакета, сколько допускает ограничение RFC 1812.
Выбор, использовать ли PMTUD, в Linux задаётся для сокета параметром IP_MTU_DISCOVER; утилита ping управляет им через ключ -M (do — всегда DF, dont — никогда, want — DF с локальной фрагментацией при необходимости). Протокол TCP в Linux использует PMTUD всегда, поэтому все его сегменты несут флаг DF.
Чёрные дыры PMTUD и способы борьбы с ними
PMTUD работает, только если сообщения «требуется фрагментация» доходят до источника. Межсетевой экран, отбрасывающий весь ICMP, или маршрутизатор, которому запрещено генерировать ICMP, ломают механизм, причём особенно коварным образом. Источник отправляет большие пакеты с DF, они молча исчезают, а уведомление не приходит. Маленькие пакеты при этом проходят. Возникает чёрная дыра PMTUD (англ. PMTUD black hole) — проблема, описанная ещё в RFC 2923 16 и подробно разобранная в RFC 4821 7.
Симптом чёрной дыры узнаваем: соединение TCP устанавливается (сегменты SYN малы), короткий запрос и первые небольшие порции ответа проходят, но передача большого объёма данных «зависает». В лабораторной работе 7 этот случай моделируется: MTU транзитного звена уменьшается до 1400, а на r2 выходящие сообщения ICMP «требуется фрагментация» отбрасываются фильтром. При загрузке файла с веб-сервера на h2 захват на r2 показывает следующее:
IP 10.7.1.10.58010 > 10.7.2.20.8080: Flags [S], ... options [mss 1460,...]
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [S.], ... options [mss 1460,...]
...
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [P.], seq 1:206, ...
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [P.], seq 206:7446, ...
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [P.], seq 7446:14686, ...
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [.], seq 206:1654, ...    (через 0,21 с)
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [.], seq 206:1654, ...    (через 0,64 с)
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [.], seq 206:1654, ...    (через 1,47 с)
IP 10.7.2.20.8080 > 10.7.1.10.58010: Flags [.], seq 206:1654, ...    (через 3,13 с)
Стороны договорились о максимальном размере сегмента 1460 байт, рассчитанном по MTU их собственных интерфейсов. Заголовок HTTP-ответа длиной 205 байт дошёл до h1, а сегменты данных — по 1448 байт полезной нагрузки плюс 32 байта заголовка TCP с опцией отметок времени и 20 байт заголовка IP, ровно 1500 байт — не проходят звено с MTU 1400. Сервер повторяет передачу с удваивающимся тайм-аутом (механизм повторных передач — тема 13), а клиент curl через 5 секунд прекращает ожидание, получив 0 байт файла. Статистика фильтра на r2 подтверждает, что сообщения ICMP генерировались, но уничтожались.
Методов борьбы с чёрными дырами три. Первый, правильный, — не фильтровать ICMP типа 3 код 4; RFC 8900 и документы по эксплуатации межсетевых экранов прямо рекомендуют пропускать эти сообщения 8. Второй — коррекция размера сегмента TCP (англ. MSS clamping): маршрутизатор на границе звена с уменьшенным MTU исправляет опцию MSS в проходящих сегментах SYN, и стороны изначально договариваются о меньшем сегменте. Приём широко применяется на домашних маршрутизаторах с PPPoE и в туннелях; его реализация в nftables рассматривается в теме 14. Третий — обнаружение MTU пути на уровне пакетизации (англ. Packetization Layer Path MTU Discovery, PLPMTUD, RFC 4821, для датаграммных протоколов — RFC 8899): транспортный протокол сам пробует пакеты разного размера и делает выводы по тому, подтверждены ли они, не полагаясь на ICMP 7. В Linux для TCP он включается параметром net.ipv4.tcp_mtu_probing: значение 0 (по умолчанию) — выключено, 1 — включается после обнаружения чёрной дыры, 2 — всегда 14. В лабораторной топологии при tcp_mtu_probing=1 на сервере та же загрузка файла завершается, хотя и с задержкой около 6,5 с, затраченной на распознавание чёрной дыры. Механизм PLPMTUD используют также QUIC (тема 16) и современные реализации DNS поверх UDP.
Итоги темы
Протокол IP предоставляет минимальный сервис — доставку отдельных датаграмм по возможности, без гарантий и без хранения состояния в сети. Заголовок IPv4 отражает эту философию: в нём есть только то, что нужно для пересылки (адреса, TTL, номер протокола), для согласования с каналами (поля фрагментации) и для минимальной самозащиты (контрольная сумма заголовка). Разбор реального пакета показывает, что каждое из этих полей имеет конкретное значение, которое можно прочитать в шестнадцатеричном дампе и проверить вручную.
Отправка пакета хостом включает два шага, которые часто смешивают. Сначала по таблице маршрутизации определяется следующий переход — сам адресат или шлюз; затем протокол ARP выясняет MAC-адрес этого следующего перехода. IP-адрес назначения в пакете при этом остаётся адресом конечного узла. Кеш ARP в Linux — часть подсистемы соседей с конечным автоматом состояний, позволяющим использовать устаревшие записи без задержки и проверять их в фоне. Отсутствие аутентификации в ARP делает возможными как полезные приёмы (gratuitous ARP при переключении на резерв), так и атаки подмены.
Протокол ICMP — обратная связь сети с отправителем. Его сообщения об ошибках содержат начало исходного пакета, что позволяет сопоставить ошибку с сокетом, а строгие правила (не отвечать на ошибки, широковещательные пакеты и не первые фрагменты, ограничивать частоту) защищают сеть от лавины служебного трафика. На ICMP построены основные диагностические утилиты: ping проверяет достижимость и измеряет RTT, traceroute и tracepath, управляя TTL проб, раскрывают путь пакета.
Несовпадение MTU каналов IPv4 разрешает фрагментацией, которая работает, но дорога и хрупка. Поэтому источники предпочитают обнаруживать MTU пути с помощью флага DF и сообщений ICMP «требуется фрагментация», а фильтрация этих сообщений порождает чёрные дыры — одну из самых трудных для диагностики неисправностей. Знание механизма превращает загадочный симптом «маленькое проходит, большое нет» в проверяемую гипотезу.
Во всей теме вопрос о том, как маршрутизатор решает, куда переслать пакет, оставался за кадром: в учебной топологии маршруты были заданы заранее. Устройству таблицы маршрутизации, правилу наибольшего совпадения префикса, статической маршрутизации и Linux как маршрутизатору посвящена тема 8.
Литература
- Postel J. Internet Protocol. — RFC 791, IETF, 1981. https://www.rfc-editor.org/rfc/rfc791
- Postel J. Internet Control Message Protocol. — RFC 792, IETF, 1981. https://www.rfc-editor.org/rfc/rfc792
- Plummer D. C. An Ethernet Address Resolution Protocol. — RFC 826, IETF, 1982. https://www.rfc-editor.org/rfc/rfc826
- Braden R. (ed.) Requirements for Internet Hosts — Communication Layers. — RFC 1122, IETF, 1989. https://www.rfc-editor.org/rfc/rfc1122
- Baker F. (ed.) Requirements for IP Version 4 Routers. — RFC 1812, IETF, 1995. https://www.rfc-editor.org/rfc/rfc1812
- Mogul J., Deering S. Path MTU Discovery. — RFC 1191, IETF, 1990. https://www.rfc-editor.org/rfc/rfc1191
- Mathis M., Heffner J. Packetization Layer Path MTU Discovery. — RFC 4821, IETF, 2007. https://www.rfc-editor.org/rfc/rfc4821
- Bonica R., Baker F., Huston G., Hinden R., Troan O., Gont F. IP Fragmentation Considered Fragile. — RFC 8900 (BCP 230), IETF, 2020. https://www.rfc-editor.org/rfc/rfc8900
- Cheshire S. IPv4 Address Conflict Detection. — RFC 5227, IETF, 2008. https://www.rfc-editor.org/rfc/rfc5227
- Nichols K., Blake S., Baker F., Black D. Definition of the Differentiated Services Field (DS Field) in the IPv4 and IPv6 Headers. — RFC 2474, IETF, 1998. https://www.rfc-editor.org/rfc/rfc2474
- Ramakrishnan K., Floyd S., Black D. The Addition of Explicit Congestion Notification (ECN) to IP. — RFC 3168, IETF, 2001. https://www.rfc-editor.org/rfc/rfc3168
- Touch J. Updated Specification of the IPv4 ID Field. — RFC 6864, IETF, 2013. https://www.rfc-editor.org/rfc/rfc6864
- Fall K. R., Stevens W. R. TCP/IP Illustrated, Volume 1: The Protocols. 2nd ed. — Addison-Wesley, 2011.
- The Linux Kernel Documentation. IP Sysctl. — 2025. https://docs.kernel.org/networking/ip-sysctl.html
- Kent C. A., Mogul J. C. Fragmentation Considered Harmful. — Proceedings of ACM SIGCOMM '87, 1987, P. 390–401.
- Lahey K. TCP Problems with Path MTU Discovery. — RFC 2923, IETF, 2000. https://www.rfc-editor.org/rfc/rfc2923