
Маршрутизация: принципы и статическая маршрутизация
В теме 7 пакет был прослежен от хоста-отправителя до адресата, но одно звено цепочки оставалось за кадром: маршрутизатор, получив пакет, каким-то образом знал, в какой интерфейс и какому следующему узлу его отправить. В учебной топологии маршруты были заданы заранее, и вопрос «откуда маршрутизатор это знает» не возникал. Между тем именно он составляет суть сетевого уровня. Коммутатор Ethernet (тема 4) может позволить себе лавинную рассылку кадров с неизвестным адресом, потому что работает в пределах одного широковещательного домена; маршрутизатор Интернета такой роскоши лишён — ему приходится выбирать один путь из многих для пакетов к любому из сотен тысяч префиксов.
Тема отвечает на три вопроса. Как маршрутизатор принимает решение о пересылке одного пакета — то есть что хранится в таблице маршрутизации и по какому правилу из неё выбирается запись. Как маршрутизатор устроен физически, чтобы принимать такие решения миллионы раз в секунду. И как заполнить таблицы маршрутизации вручную — статической маршрутизацией, — какие ошибки при этом возникают и как они проявляются.
Изложение построено так. Первый раздел разделяет две задачи маршрутизатора — пересылку и маршрутизацию — и соответствующие им плоскости данных и управления. Второй посвящён таблице маршрутизации и правилу наибольшего совпадения префикса с числовыми примерами. Третий обзорно описывает архитектуру маршрутизатора: порты, коммутационную матрицу, очереди, разделение RIB и FIB, аппаратный поиск. Четвёртый рассматривает статическую маршрутизацию: проектирование, суммаризацию, резервные маршруты, асимметрию и петли. Пятый показывает Linux как маршрутизатор: пересылку, таблицы и правила политик, многопутевую маршрутизацию и фильтр обратного пути. Все выводы команд получены на топологии лабораторной работы 8: три маршрутизатора r1, r2, r3, соединённых треугольником, и три сети хостов. Протоколы, автоматически заполняющие таблицы маршрутизации, рассматриваются в темах 9 и 10.
Пересылка и маршрутизация
Две задачи маршрутизатора
Слово «маршрутизация» в обиходе обозначает всё, что делает маршрутизатор, но в сетевой инженерии различают две функции 3. Пересылка (англ. forwarding) — локальное действие над одним пакетом: определить по адресу назначения выходной интерфейс и следующий переход и передать пакет туда. Маршрутизация (англ. routing) — сетевой процесс построения путей: определить, по каким маршрутам вообще должны идти пакеты к каждой сети назначения, и записать результат в таблицы пересылки всех маршрутизаторов.
Удачная аналогия — поездка на автомобиле. Пересылка соответствует действию водителя на перекрёстке: посмотреть на указатель и свернуть. Маршрутизация соответствует прокладке маршрута по карте до поездки. Различие не только смысловое, но и количественное. Пересылка выполняется для каждого пакета: на интерфейсе 100 Гбит/с пакеты минимального размера приходят с частотой около 150 миллионов в секунду, то есть на решение отводится несколько наносекунд. Маршрутизация выполняется при изменении топологии или политики — раз в секунды, минуты или дни — и может позволить себе сложные вычисления длительностью в миллисекунды и секунды.
Принципиально важно, что пересылка в IP выполняется по адресу назначения, причём каждым маршрутизатором независимо (англ. hop-by-hop). Маршрутизатор не знает и не выбирает весь путь пакета; он знает лишь следующий переход. Корректный сквозной путь получается, только если решения всех маршрутизаторов согласованы. Если они не согласованы — например, r1 считает, что к сети X нужно идти через r2, а r2 — что через r1, — возникает петля маршрутизации, с которой справляется лишь TTL (тема 7). Поэтому основная забота маршрутизации — согласованность таблиц во всей сети.
Плоскость данных и плоскость управления
Различие двух функций закреплено в архитектуре маршрутизатора разделением на плоскости (англ. planes). Плоскость данных (англ. data plane, также forwarding plane) пересылает пакеты, плоскость управления (англ. control plane) вычисляет маршруты: исполняет протоколы маршрутизации, обменивается сообщениями с соседями, принимает статическую конфигурацию и в итоге заполняет таблицу пересылки плоскости данных 311. Иногда выделяют ещё плоскость администрирования (англ. management plane) — интерфейсы конфигурирования и мониторинга (командная строка, SSH, SNMP, NETCONF; подробно — в теме 22).
Схема на рисунке ниже показывает это разделение. В аппаратном маршрутизаторе плоскость данных реализована специализированными микросхемами на линейных платах, а плоскость управления — программами на процессоре общего назначения. Пакеты, адресованные самому маршрутизатору (сообщения протоколов маршрутизации, SSH-сессии администратора, эхо-запросы к его адресу), плоскость данных передаёт «наверх», процессору; именно поэтому маршрутизатор отвечает на ping и генерирует сообщения ICMP медленнее, чем пересылает транзитный трафик (тема 7).
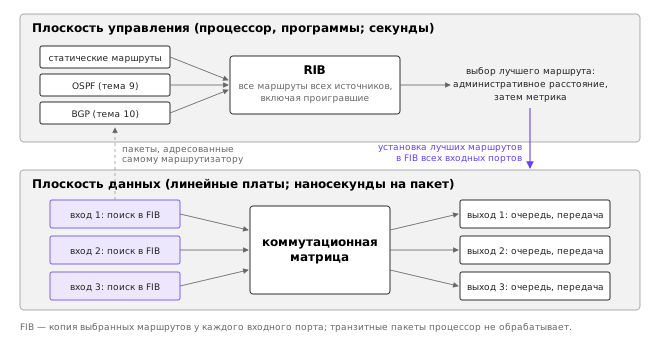
В Linux граница проходит между пространством пользователя и ядром: ядро выполняет пересылку по своей таблице, а заполняют её администратор командой ip route или демоны маршрутизации вроде FRRouting, работающие как обычные процессы (темы 9 и 10). Идея программно-конфигурируемых сетей (англ. Software-Defined Networking, SDN) доводит разделение до предела, вынося плоскость управления из маршрутизаторов на отдельный контроллер; об этом пойдёт речь в теме 21.
Таблица маршрутизации и правило наибольшего совпадения
Состав записи маршрута
Таблица маршрутизации (англ. routing table) состоит из записей-маршрутов. Каждая запись утверждает: «пакеты, адрес назначения которых принадлежит префиксу P, следует отправлять через интерфейс I следующему переходу N». Помимо этих трёх элементов запись содержит атрибуты, нужные для выбора между несколькими маршрутами к одному префиксу: метрику и источник маршрута. Вот таблица маршрутизатора r1 из лабораторной работы 8 после базовой настройки:
# в пространстве имён r1
ip route
10.8.1.0/24 dev lan proto kernel scope link src 10.8.1.1
10.8.2.0/24 via 10.8.12.2 dev to-r2
10.8.12.0/30 dev to-r2 proto kernel scope link src 10.8.12.1
10.8.13.0/30 dev to-r3 proto kernel scope link src 10.8.13.1
10.8.32.0/23 via 10.8.13.2 dev to-r3
Расшифруем поля вывода ip route 9:
- префикс (
10.8.2.0/24) — множество адресов назначения, к которым относится запись; via— IP-адрес следующего перехода. Он должен быть достижим напрямую, через подключённую сеть; попытка добавить маршрут через адрес из неподключённой сети завершается ошибкойNexthop has invalid gateway;dev— выходной интерфейс;proto— источник маршрута:kernel— создан ядром автоматически при назначении адреса,static— статический,ospf,bgp— установлен демоном маршрутизации; маршруты, добавленные командойip route addбез явного указания, получают значениеboot, котороеip routeне печатает;scope link— маршрут к подключённой сети: адресаты доступны напрямую, без следующего перехода;src— адрес источника, который ядро подставит в локально созданные пакеты, отправляемые по этому маршруту;metric— метрика; при нескольких маршрутах к одному и тому же префиксу выбирается маршрут с наименьшей метрикой (без указания метрика равна 0 и не печатается).
Маршруты делятся на три группы по происхождению. Подключённые (англ. connected, directly connected) маршруты появляются автоматически при назначении интерфейсу адреса с маской: адрес 10.8.12.1/30 на интерфейсе to-r2 порождает маршрут к 10.8.12.0/30. Статические (англ. static) маршруты вводит администратор. Динамические (англ. dynamic) маршруты устанавливают протоколы маршрутизации. Пересылка с точки зрения плоскости данных одинакова для всех трёх групп; происхождение важно лишь при выборе между конкурирующими маршрутами.
Правило наибольшего совпадения префикса
Если бы префиксы в таблице не пересекались, поиск был бы простым: найти единственный префикс, содержащий адрес назначения. Но префиксы пересекаются — и намеренно. Как показано в теме 6, бесклассовая адресация CIDR позволяет объединять сети в агрегаты и описывать исключения из агрегатов более длинными префиксами 2. Поэтому адрес назначения, как правило, принадлежит нескольким префиксам таблицы одновременно, и нужно правило выбора. Таким правилом служит наибольшее совпадение префикса (англ. longest prefix match, LPM): из всех записей, префикс которых содержит адрес назначения, выбирается запись с наибольшей длиной префикса, то есть самая специфичная 12.
Рассмотрим числовой пример. Пусть таблица маршрутизатора содержит пять записей:
| № | Префикс | Следующий переход | Третий октет префикса в двоичном виде |
|---|---|---|---|
| 1 | 0.0.0.0/0 | 10.8.12.2 (провайдер) | — |
| 2 | 10.8.0.0/16 | 10.8.12.2 | — |
| 3 | 10.8.32.0/23 | 10.8.13.2 | 0010000x |
| 4 | 10.8.33.0/24 | 10.8.12.2 | 00100001 |
| 5 | 10.8.40.0/21 | отбросить | 00101xxx |
Знак x обозначает биты, не входящие в префикс. Определим следующий переход для нескольких адресов.
Адрес 10.8.33.7: третий октет 33 = 00100001. Он совпадает с записью 1 (длина 0), записью 2 (первые 16 бит — 10.8), записью 3 (первые 7 бит третьего октета 0010000 совпадают, итого 23 бита) и записью 4 (все 8 бит третьего октета, итого 24). Наибольшая длина — 24, выбирается запись 4, следующий переход 10.8.12.2. Адрес 10.8.32.5: третий октет 00100000 совпадает с записью 3 (23 бита), но не с записью 4 (последний бит отличается), поэтому выбирается запись 3 и r3. Адрес 10.8.41.1: третий октет 41 = 00101001, первые 5 бит 00101 совпадают с записью 5 — пакет будет отброшен. Адрес 10.8.50.1: третий октет 50 = 00110010 не совпадает ни с записью 3, ни с 4, ни с 5; выбирается запись 2 (длина 16). Адрес 192.0.2.1 совпадает только с маршрутом по умолчанию.
Тот же результат даёт Linux, если поместить эти записи в таблицу r1:
# в пространстве имён r1
ip route add default via 10.8.12.2
ip route add 10.8.0.0/16 via 10.8.12.2
ip route add 10.8.33.0/24 via 10.8.12.2
ip route add blackhole 10.8.40.0/21
for d in 10.8.33.7 10.8.32.5 10.8.50.1 192.0.2.1; do ip route get $d | head -1; done
10.8.33.7 via 10.8.12.2 dev to-r2 src 10.8.12.1 uid 0
10.8.32.5 via 10.8.13.2 dev to-r3 src 10.8.13.1 uid 0
10.8.50.1 via 10.8.12.2 dev to-r2 src 10.8.12.1 uid 0
192.0.2.1 via 10.8.12.2 dev to-r2 src 10.8.12.1 uid 0
Для адреса 10.8.41.1 команда ip route get возвращает ошибку RTNETLINK answers: Invalid argument: маршрут типа blackhole найден, но пересылки по нему нет, и пакеты молча уничтожаются.
Правило наибольшего совпадения делает порядок записей в таблице несущественным, а смысл таблицы — декларативным: агрегат задаёт «общее правило», специфичный префикс — «исключение». Обратная сторона — неожиданные эффекты при ошибках: один ошибочно добавленный длинный префикс перехватывает часть трафика, предназначенного агрегату, и этот эффект не виден при беглом взгляде на таблицу. В Интернете на этом основаны перехваты префиксов, рассматриваемые в теме 10: анонс более специфичного префикса побеждает анонс законного владельца.
Маршрут по умолчанию и специальные маршруты
Маршрут по умолчанию (англ. default route) — запись с префиксом 0.0.0.0/0, совпадающая с любым адресом и, по правилу наибольшего совпадения, выбираемая только тогда, когда никакая другая запись не подходит. В выводе ip route он обозначается словом default. Маршрут по умолчанию — основа иерархии Интернета: хост отправляет всё «чужое» шлюзу, сеть организации — провайдеру. Лишь маршрутизаторы ядра Интернета обходятся без него, храня полную таблицу из примерно миллиона префиксов IPv4 (англ. default-free zone; тема 10). Если в таблице нет ни подходящей записи, ни маршрута по умолчанию, маршрутизатор отбрасывает пакет и отправляет источнику сообщение ICMP «сеть недостижима» 1.
Кроме обычных (unicast) маршрутов Linux поддерживает специальные типы 9. Маршрут blackhole молча уничтожает пакеты. Маршрут unreachable уничтожает пакеты и отвечает сообщением ICMP «узел недостижим», prohibit — сообщением «запрещено администратором» (тип 3, код 13). В лабораторной топологии ping из h1 к адресам с такими маршрутами на r1 выводит соответственно молчание, Destination Host Unreachable и Packet filtered. Маршрут blackhole к собственному агрегату — стандартный приём защиты от петель при суммаризации, о котором пойдёт речь в разделе о статической маршрутизации. Наконец, маршруты типа local и broadcast к собственным адресам маршрутизатора Linux хранит в отдельной таблице local; именно по ним ядро определяет, что пакет адресован самому узлу и должен быть доставлен приложению, а не переслан.
Выбор между источниками маршрутов
К одному и тому же префиксу маршрут может быть известен из нескольких источников: статический маршрут, введённый администратором, и маршруты от OSPF и BGP. Метрики разных протоколов несравнимы (стоимость OSPF и длина пути BGP измеряют разное), поэтому маршрутизаторы сначала выбирают источник, а затем — лучший маршрут внутри источника по его метрике. Приоритет источника называют административным расстоянием (англ. administrative distance, AD): меньшее значение означает большее доверие. Термин и типовые значения происходят из маршрутизаторов Cisco и приняты также в FRRouting:
| Источник маршрута | Административное расстояние |
|---|---|
| Подключённая сеть | 0 |
| Статический маршрут | 1 |
| eBGP (внешний BGP) | 20 |
| OSPF | 110 |
| IS-IS | 115 |
| RIP | 120 |
| iBGP (внутренний BGP) | 200 |
Значения не стандартизованы IETF и могут различаться у разных производителей; их можно изменить в конфигурации. Ядро Linux понятия административного расстояния не имеет: в его таблице маршруты к одному префиксу различаются только метрикой, и выбирается маршрут с наименьшей. Выбор между протоколами выполняет демон маршрутизации (в FRRouting — процесс zebra) и устанавливает в ядро только победителя 3.
Устройство маршрутизатора
Порты, коммутационная матрица и очереди
Обобщённая архитектура маршрутизатора включает четыре компонента: входные порты, коммутационную матрицу, выходные порты и процессор маршрутизации 3. Входной порт принимает сигнал (физический уровень, тема 3), выделяет кадр (канальный уровень, тема 4), проверяет заголовок IP и выполняет поиск в таблице пересылки, определяя выходной порт. Важно, что поиск выполняется на входе и децентрализованно: у каждого входного порта есть своя копия таблицы пересылки, и центральный процессор в пересылке транзитных пакетов не участвует.
Коммутационная матрица (англ. switching fabric) переносит пакеты от входных портов к выходным. Исторически применялись три способа: коммутация через память (процессор копирует пакет в память и из неё — так работали первые маршрутизаторы и так работает обычный компьютер с Linux), через общую шину (один пакет за раз) и через матричный коммутатор (англ. crossbar), позволяющий одновременно передавать пакеты между несколькими непересекающимися парами портов. Современные высокопроизводительные маршрутизаторы используют многокаскадные матрицы.
Выходной порт хранит пакеты в очереди, пока канал занят, и передаёт их по одному. Очереди возникают и на входе, и на выходе. Выходная очередь растёт, когда к одному выходному порту одновременно направляются пакеты с нескольких входов: если N входов по 10 Гбит/с отправляют трафик в один выход 10 Гбит/с, избыток накапливается в буфере, а при его переполнении пакеты отбрасываются — это основной механизм потерь в Интернете (тема 13). Входная очередь возникает, когда матрица не успевает перенести пакеты; здесь появляется явление блокировки головой очереди (англ. head-of-line blocking, HOL): пакет в голове входной очереди ждёт занятого выхода и задерживает следующие за ним пакеты, хотя их выходы свободны. Классический анализ показал, что при равномерной случайной нагрузке блокировка ограничивает пропускную способность матрицы с входными FIFO-очередями примерно 58,6 % 12. Поэтому в современных маршрутизаторах на входе держат отдельную виртуальную очередь для каждого выхода (англ. virtual output queueing).
Наконец, выходной порт решает, какой пакет передать следующим и какой отбросить при переполнении, — это планирование (FIFO, приоритеты, взвешенное справедливое обслуживание) и управление очередями (англ. active queue management), рассматриваемые в теме 13.
RIB и FIB
Таблиц маршрутизации у маршрутизатора на самом деле две. Информационная база маршрутизации (англ. Routing Information Base, RIB) — структура плоскости управления, содержащая все известные маршруты из всех источников, включая проигравшие альтернативы: статический маршрут с большой метрикой, маршрут OSPF, проигравший статическому, несколько маршрутов BGP к одному префиксу. База пересылки (англ. Forwarding Information Base, FIB) — структура плоскости данных, содержащая для каждого префикса только выбранный маршрут, причём в форме, удобной для быстрого поиска: с уже определёнными выходным интерфейсом и MAC-адресом следующего перехода 311.
Разделение позволяет протоколам маршрутизации работать с полной информацией, не замедляя пересылку. Когда основной маршрут пропадает, плоскость управления находит в RIB альтернативу и устанавливает её в FIB; на этом основана работа резервных маршрутов. В FRRouting RIB видна командой show ip route (с пометкой выбранных маршрутов), а FIB — это таблица ядра Linux, видимая через ip route. В ядре Linux таблицы main и local хранятся в виде сжатого префиксного дерева, о котором сказано ниже; его внутреннее устройство можно увидеть в файле /proc/net/fib_trie.
Аппаратный поиск: префиксные деревья и TCAM
Поиск по правилу наибольшего совпадения сложнее точного поиска по ключу: хеш-таблица, которой пользуется коммутатор для MAC-адресов, здесь неприменима, потому что заранее неизвестно, сколько битов адреса участвует в сравнении. Классическая программная структура — префиксное дерево (англ. trie) 10: двоичное дерево, в котором путь от корня соответствует битам адреса, а узлы, отвечающие префиксам таблицы, помечены маршрутами. Поиск спускается по битам адреса назначения и запоминает последний встреченный помеченный узел — он и есть наибольшее совпадение. Простое двоичное дерево требует до 32 обращений к памяти на поиск, поэтому применяют сжатые варианты, обрабатывающие несколько битов за шаг. Таблица пересылки ядра Linux основана на дереве с сжатием уровней и путей (англ. level-compressed trie, LC-trie), предложенном Нильссоном и Карлссоном 13; обзор других алгоритмов поиска дан в работе 14.
Аппаратные маршрутизаторы используют также троичную ассоциативную память (англ. Ternary Content-Addressable Memory, TCAM). В обычной памяти по адресу ячейки получают её содержимое; в ассоциативной — по содержимому получают адрес совпавшей ячейки, причём сравнение со всеми ячейками выполняется параллельно за один такт. «Троичная» означает, что каждый бит хранимого шаблона может быть 0, 1 или «безразлично» — это и есть префикс с маской. Если записать префиксы в TCAM в порядке убывания длины, то первая совпавшая ячейка окажется наибольшим совпадением. TCAM очень быстра, но дорога и энергоёмка, поэтому её объём ограничен; рост глобальной таблицы маршрутизации регулярно упирается в эти ограничения (тема 10).
Маршрутизация между VLAN и L3-коммутаторы
Как показано в теме 5, разные VLAN — это разные широковещательные домены и, как правило, разные IP-подсети, поэтому трафик между ними обязан пройти через маршрутизатор. Существует два типовых решения. В схеме «маршрутизатор на палочке» (англ. router-on-a-stick) маршрутизатор подключается к коммутатору одним транковым портом, а на этом порту создаются подынтерфейсы — по одному на VLAN, каждый со своим IP-адресом, служащим шлюзом по умолчанию для своей VLAN. Пакет из VLAN 10 в VLAN 20 приходит на маршрутизатор с тегом 10, проходит обычную пересылку и уходит обратно в тот же физический порт с тегом 20. В Linux подынтерфейс создаётся командой вида ip link add link eth0 name eth0.10 type vlan id 10. Недостаток схемы — весь межсетевой трафик дважды проходит один канал.
Второе решение — коммутатор третьего уровня (англ. Layer 3 switch), который сочетает коммутацию кадров внутри VLAN с аппаратной маршрутизацией между ними. Для каждой VLAN в нём создаётся виртуальный интерфейс (англ. Switched Virtual Interface, SVI) с IP-адресом шлюза; пересылка между SVI выполняется той же микросхемой, что и коммутация, с поиском в TCAM, на скорости портов. С точки зрения IP L3-коммутатор — обычный маршрутизатор с таблицей маршрутизации и всеми рассмотренными в этой теме правилами; отличается он лишь тем, что набор поддерживаемых функций уже, а интерфейсы — порты коммутатора.
Статическая маршрутизация
Проектирование статических маршрутов
Статическая маршрутизация (англ. static routing) — заполнение таблиц маршрутизации вручную. Её достоинства — простота, предсказуемость, отсутствие служебного трафика и отсутствие поверхности атаки протокола маршрутизации. Недостатки — трудоёмкость, которая растёт примерно пропорционально произведению числа маршрутизаторов на число сетей, высокая вероятность ошибки и, главное, отсутствие реакции на отказы: статический маршрут не знает, работает ли путь, на который он указывает. Поэтому статическая маршрутизация уместна в небольших сетях, на тупиковых участках (англ. stub network) с единственным выходом — например, маршрут по умолчанию от офиса к провайдеру и обратный маршрут провайдера к сети офиса — и как дополнение к динамической маршрутизации.
Проектирование статических маршрутов следует нескольким правилам. Первое: для каждой пары взаимодействующих сетей маршрут нужен в обоих направлениях. Пакет, дошедший до адресата, бесполезен, если ответ не может вернуться; «ping в одну сторону» — самая частая ошибка начинающих. Второе: на каждом маршрутизаторе пути маршрут к каждой удалённой сети должен вести в сторону этой сети, причём выбор следующих переходов всех маршрутизаторов должен быть согласован, иначе возникнет петля. Третье: подключённые сети в статических маршрутах не нуждаются. Для топологии лабораторной работы 8 (рисунок ниже) каждому маршрутизатору нужно два-три маршрута:
# r1: к сети h2 — через r2, к сетям за r3 — через r3 (одной суммарной записью)
ip -n r1 route add 10.8.2.0/24  via 10.8.12.2
ip -n r1 route add 10.8.32.0/23 via 10.8.13.2
# r2: к сети h1 — через r1, к сетям за r3 — через r3
ip -n r2 route add 10.8.1.0/24  via 10.8.12.1
ip -n r2 route add 10.8.32.0/23 via 10.8.23.2
# r3: к сети h1 — через r1, к сети h2 — через r2
ip -n r3 route add 10.8.1.0/24  via 10.8.13.1
ip -n r3 route add 10.8.2.0/24  via 10.8.23.1
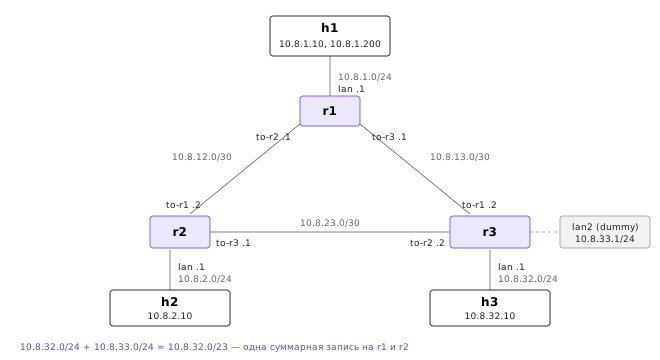
Транзитные сети /30 между маршрутизаторами в этой конфигурации друг другу не анонсированы: r1 не знает маршрута к 10.8.23.0/30. Для пересылки транзитного трафика это не важно, но проявляется в диагностике: если r2 отправляет сообщение ICMP с адреса 10.8.23.1 (например, отвечая на пробу traceroute из сети за r3), ответ дойдёт до хоста, а вот ping 10.8.23.1 с r1 не пройдёт. Решение — добавить маршруты и к транзитным сетям либо выбирать для таких сетей агрегируемые адреса.
Суммаризация и её подвохи
Суммаризация (англ. route summarization, aggregation) — замена нескольких маршрутов одним маршрутом к охватывающему их префиксу (тема 6). В лабораторной топологии за r3 расположены сети 10.8.32.0/24 и 10.8.33.0/24, отличающиеся только последним битом третьего октета; они объединяются в 10.8.32.0/23, и r1 и r2 обходятся одной записью вместо двух 2. В больших сетях суммаризация многократно сокращает таблицы, ускоряет поиск и, что не менее важно, изолирует изменения: если одна из сетей внутри агрегата пропадает, маршрут к агрегату остаётся, и соседи не замечают изменения.
У суммаризации два подвоха. Первый — агрегат может охватывать адреса, которых на самом деле нет. Если бы за r3 была только сеть 10.8.32.0/24, а суммаризация была выполнена по /23, то пакеты к несуществующей сети 10.8.33.0/24 всё равно шли бы к r3. Второй подвох — петли при наличии маршрута по умолчанию. Пусть r3, получив пакет к 10.8.33.0/24, не находит подходящего маршрута (сеть отключена) и отправляет пакет по своему маршруту по умолчанию — например, обратно к r1. А r1 по агрегату снова отправит его к r3. Пакет будет ходить по кругу до исчерпания TTL. Стандартная защита — на маршрутизаторе, выполняющем суммаризацию, добавить маршрут blackhole к самому агрегату: его длина больше, чем у маршрута по умолчанию, но меньше, чем у реальных подсетей, поэтому существующие подсети пересылаются как обычно, а пакеты к несуществующим частям агрегата уничтожаются на месте. Протоколы маршрутизации, выполняющие суммаризацию, обычно добавляют такой маршрут автоматически (в терминологии Cisco — Null0 route).
Плавающие статические маршруты
Хотя статический маршрут не знает о работоспособности пути, некоторая защита от отказов возможна. Плавающий статический маршрут (англ. floating static route) — резервный статический маршрут к тому же префиксу, что и основной, но с худшим приоритетом: большей метрикой в Linux или большим административным расстоянием в маршрутизаторах Cisco и FRRouting. Пока основной маршрут присутствует в таблице, резервный не используется; если основной исчезает, резервный «всплывает» и начинает действовать. В лабораторной топологии r1 может достигать сетей за r3 и напрямую, и через r2:
ip -n r1 route add 10.8.32.0/23 via 10.8.13.2 metric 10    # основной
ip -n r1 route add 10.8.32.0/23 via 10.8.12.2 metric 100   # резервный
ip -n r1 route show 10.8.32.0/23
10.8.32.0/23 via 10.8.13.2 dev to-r3 metric 10
10.8.32.0/23 via 10.8.12.2 dev to-r2 metric 100
Ключевой вопрос — при каком событии основной маршрут исчезнет. В Linux статический маршрут удаляется из таблицы, когда его выходной интерфейс административно выключается (ip link set to-r3 down). При потере несущей (англ. carrier) — например, при выключении интерфейса на другом конце кабеля — маршрут не удаляется, а лишь помечается признаком linkdown и по умолчанию продолжает использоваться; чтобы ядро игнорировало такие маршруты, нужно включить параметр net.ipv4.conf.<интерфейс>.ignore_routes_with_linkdown 8. Наконец, если канал физически исправен, но пакеты по нему не проходят (отказ промежуточного оборудования, ошибка фильтрации, однонаправленный отказ), никакого события не происходит вовсе, и трафик продолжает уходить в нерабочий путь. В лабораторной топологии это моделируется 100-процентными потерями на интерфейсе to-r3 (tc qdisc add dev to-r3 root netem loss 100%): ip route get продолжает указывать на r3, а связность пропадает.
Отсюда следует вывод, существенный для проектирования: плавающие статические маршруты защищают лишь от отказов, которые маршрутизатор видит как изменение состояния интерфейса. Для обнаружения остальных отказов нужен протокол, проверяющий путь, — протокол маршрутизации с обменом приветствиями или быстрый детектор BFD (тема 9). Есть и вторая особенность Linux: удалённые при выключении интерфейса статические маршруты при его повторном включении не восстанавливаются автоматически. После восстановления канала в опыте лабораторной работы в таблице r1 остаётся только резервный маршрут через r2, и трафик продолжает идти в обход, пока администратор не добавит основной маршрут заново. Демоны маршрутизации, такие как FRRouting, хранят статические маршруты в своей конфигурации и переустанавливают их в ядро сами, поэтому на маршрутизаторах под Linux статику обычно задают через них.
Резерв должен быть настроен в обоих направлениях. Если r1 перешёл на путь через r2, а r3 по-прежнему отправляет ответы в выключенный интерфейс к r1, связности не будет; в лабораторной топологии резервный маршрут к 10.8.1.0/24 через r2 нужен и на r3.
Асимметрия маршрутов и петли маршрутизации
Поскольку каждый маршрутизатор решает независимо, путь «туда» и путь «обратно» не обязаны совпадать. Асимметричная маршрутизация (англ. asymmetric routing) сама по себе не является ошибкой и в Интернете встречается постоянно: провайдеры выбирают выход из своей сети по собственной политике, и пакеты от A к B и от B к A проходят через разные автономные системы (тема 10). Но асимметрия усложняет диагностику (traceroute показывает только прямой путь) и ломает устройства, которые должны видеть оба направления соединения: межсетевые экраны с отслеживанием состояния (тема 18), трансляторы адресов (тема 14) и фильтры обратного пути, рассматриваемые в следующем разделе.
Петля маршрутизации (англ. routing loop) — ситуация, в которой таблицы нескольких маршрутизаторов для некоторого адреса образуют цикл. Причины — ошибка конфигурации статических маршрутов, неудачная суммаризация с маршрутом по умолчанию, временная несогласованность таблиц во время сходимости протокола маршрутизации (тема 9). Петли в IP, в отличие от петель Ethernet (тема 5), не размножают пакеты, а лишь гоняют их по кругу, и каждый пакет погибает, исчерпав TTL. Тем не менее петля вредна: каждый пакет многократно занимает каналы петли, и при значительном трафике они перегружаются.
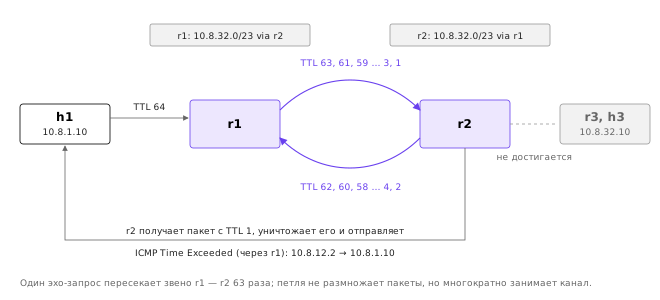
Пронаблюдаем петлю в лабораторной топологии. Пусть на r1 маршрут к 10.8.32.0/23 указывает на r2, а на r2 — обратно на r1. Хост h1 отправляет эхо-запрос к h3 с начальным TTL 64. Захват на интерфейсе r2, обращённом к r1, показывает один и тот же пакет (идентификатор 17028) многократно:
IP (tos 0x0, ttl 63, id 17028, offset 0, flags [DF], proto ICMP (1), length 84)
    10.8.1.10 > 10.8.32.10: ICMP echo request, id 13677, seq 1, length 64
IP (tos 0x0, ttl 62, id 17028, offset 0, flags [DF], proto ICMP (1), length 84)
    10.8.1.10 > 10.8.32.10: ICMP echo request, id 13677, seq 1, length 64
IP (tos 0x0, ttl 61, id 17028, offset 0, flags [DF], proto ICMP (1), length 84)
    10.8.1.10 > 10.8.32.10: ICMP echo request, id 13677, seq 1, length 64
...
IP (tos 0x0, ttl 1, id 17028, offset 0, flags [DF], proto ICMP (1), length 84)
    10.8.1.10 > 10.8.32.10: ICMP echo request, id 13677, seq 1, length 64
IP (tos 0xc0, ttl 64, id 37386, offset 0, flags [none], proto ICMP (1), length 112)
    10.8.12.2 > 10.8.1.10: ICMP time exceeded in-transit, length 92
Пакет пересекает звено r1 — r2 63 раза: TTL 63 после r1, 62 после r2 и так далее. Нечётные значения TTL соответствуют направлению r1 → r2, чётные — обратному. Пакет с TTL 1 приходит на r2, тот уничтожает его и сообщает h1 об истечении времени. Пользователь видит:
PING 10.8.32.10 (10.8.32.10) 56(84) bytes of data.
From 10.8.12.2 icmp_seq=1 Time to live exceeded
Сообщение «время истекло» в ответ на обычный ping с TTL 64 — характерный признак петли: в исправной сети пакет не проходит 64 маршрутизатора. Рисунок ниже иллюстрирует этот процесс. Трассировка traceroute к адресу за петлёй показывает чередующиеся адреса двух маршрутизаторов, повторяющиеся до максимального числа переходов. Обратим также внимание, что ответ «время истекло» возвращается к h1 корректно: маршрут к 10.8.1.0/24 у r2 исправен, и петля касается только одного направления и одного префикса.
Linux как маршрутизатор
Включение пересылки и путь пакета через ядро
Любой компьютер с Linux и двумя сетевыми интерфейсами может работать маршрутизатором, но по умолчанию пересылка выключена: узел, получивший пакет, адресованный не ему, молча его отбрасывает. Это правильное умолчание для хоста — оно предписано требованиями к хостам, чтобы случайный компьютер с двумя интерфейсами не стал непреднамеренным мостом между сетями. Пересылка IPv4 включается параметром ядра 8:
sysctl -w net.ipv4.ip_forward=1 # то же, что net.ipv4.conf.all.forwarding=1
Изменение, сделанное командой sysctl -w, действует до перезагрузки; для постоянной настройки параметр записывают в файл в каталоге /etc/sysctl.d/. Параметр действует в пределах сетевого пространства имён, поэтому в лабораторной работе пересылка включается в каждом пространстве-маршрутизаторе отдельно.
Обработка входящего пакета в ядре проходит следующие шаги. Сначала проверяется корректность заголовка (версия, длина, контрольная сумма). Затем выполняется поиск маршрута — по правилам политик и таблицам, описанным ниже. Если найден маршрут типа local, пакет адресован самому узлу и передаётся протоколу верхнего уровня. Если найден обычный маршрут, а пересылка включена, ядро проверяет TTL: при значении 1 или 0 пакет уничтожается с отправкой ICMP «время истекло». Иначе TTL уменьшается, контрольная сумма корректируется, при необходимости выполняется фрагментация (тема 7), и пакет передаётся подсистеме соседей, которая определяет MAC-адрес следующего перехода и отправляет кадр. Если входной и выходной интерфейсы совпадают, а источник находится в той же подсети, ядро может отправить источнику перенаправление ICMP 1. На нескольких из этих шагов действуют хуки межсетевого экрана netfilter (тема 18).
Инструмент, позволяющий заглянуть в это решение, — ip route get. С ключами from и iif он моделирует поиск для транзитного пакета, пришедшего на заданный интерфейс от заданного источника, что важно при использовании правил политик и фильтра обратного пути:
ip -n r1 route get 10.8.32.10 from 10.8.1.10 iif lan
10.8.32.10 from 10.8.1.10 via 10.8.13.2 dev to-r3
    cache iif lan
Счётчики пересылки и ошибок видны в nstat: IpForwDatagrams — число пересланных пакетов, IpInHdrErrors — уничтоженных из-за ошибок заголовка, в том числе из-за истёкшего TTL, IpOutNoRoutes — отброшенных из-за отсутствия маршрута, IcmpOutTimeExcds — отправленных сообщений «время истекло».
Таблицы маршрутизации и правила политик
Классическая пересылка по адресу назначения иногда недостаточна. Организации с двумя провайдерами нужно отправлять ответы через того провайдера, чей адрес указан в пакете как адрес источника; гостевая сеть должна выходить в Интернет через отдельный канал; трафик определённого приложения нужно направить в VPN. Все эти задачи требуют учитывать при выборе маршрута не только адрес назначения. Такой подход называют маршрутизацией по политикам (англ. policy-based routing, PBR).
В Linux он реализован двумя механизмами: множеством таблиц маршрутизации и базой правил политик (англ. routing policy database, RPDB) 9. Таблиц может быть до 2^32, каждая — самостоятельная таблица со своим правилом наибольшего совпадения. По умолчанию существуют три: local (номер 255, адреса самого узла), main (номер 254, обычная таблица, с которой работает ip route без указания таблицы) и default (номер 253, обычно пустая). Правила, перечисленные командой ip rule, определяют, в какой таблице искать маршрут для пакета:
0:	from all lookup local
32766:	from all lookup main
32767:	from all lookup default
Правила просматриваются в порядке возрастания приоритета (числа слева). Каждое правило содержит условие (адрес источника from, адрес назначения to, входной интерфейс iif, метку fwmark, установленную межсетевым экраном, и другие) и действие — чаще всего lookup в заданной таблице. Если в таблице найден подходящий маршрут, поиск заканчивается; если нет — продолжается со следующего правила.
Пример из лабораторной работы 8: в сети h1 адреса 10.8.1.128/25 отведены гостям, и их трафик к сетям за r3 должен идти через r2, а не напрямую:
ip -n r1 route add 10.8.32.0/23 via 10.8.12.2 table 100
ip -n r1 rule add from 10.8.1.128/25 lookup 100 pref 1000
ip -n r1 route get 10.8.32.10 from 10.8.1.200 iif lan
ip -n r1 route get 10.8.32.10 from 10.8.1.10 iif lan
10.8.32.10 from 10.8.1.200 via 10.8.12.2 dev to-r2 table 100
    cache iif lan
10.8.32.10 from 10.8.1.10 via 10.8.13.2 dev to-r3
    cache iif lan
Проверить, что разные источники действительно идут разными путями, можно эхо-запросом с TTL 2: второй маршрутизатор на пути отвечает «время истекло» и раскрывает себя. С адреса 10.8.1.200 отвечает r2 (From 10.8.12.2 ... Time to live exceeded), с адреса 10.8.1.10 — r3 (From 10.8.13.2). В таблице 100 есть маршрут только к одному префиксу; для остальных адресов назначения поиск в ней неудачен, и обработка продолжается правилом таблицы main.
Многопутевая маршрутизация ECMP
Если к одному префиксу ведут несколько путей одинаковой стоимости, их можно использовать одновременно, распределяя трафик. Такой режим называют многопутевой маршрутизацией с равной стоимостью (англ. Equal-Cost Multi-Path, ECMP). В Linux маршрут с несколькими следующими переходами задаётся ключевым словом nexthop:
ip -n r1 route replace 10.8.32.0/23 nexthop via 10.8.13.2 nexthop via 10.8.12.2
ip -n r1 route show 10.8.32.0/23
10.8.32.0/23
	nexthop via 10.8.13.2 dev to-r3 weight 1
	nexthop via 10.8.12.2 dev to-r2 weight 1
Распределять пакеты поочерёдно, «по кругу», нельзя: пакеты одного соединения пошли бы разными путями с разной задержкой и приходили бы не по порядку, что TCP воспринимает как потери (тема 13). Поэтому маршрутизаторы распределяют не пакеты, а потоки: от полей заголовка, одинаковых для всех пакетов потока, вычисляется хеш, и по нему выбирается следующий переход. Все пакеты одного потока идут одним путём, а разные потоки распределяются по путям статистически 67. RFC 2992 анализирует, как выбор функции отображения хеша на пути влияет на перераспределение потоков при добавлении или удалении пути 6.
Какие поля участвуют в хеше, в Linux задаёт параметр net.ipv4.fib_multipath_hash_policy 8: 0 (по умолчанию) — только адреса источника и назначения (уровень 3), 1 — пятёрка «адреса, протокол, порты» (уровень 4), 2 — адреса уровня 3, а для инкапсулированных пакетов — адреса внутреннего заголовка, 3 — произвольный набор полей, заданный параметром net.ipv4.fib_multipath_hash_fields. Разница видна, если смоделировать поиск для нескольких потоков UDP с разными портами источника между одной и той же парой хостов:
for p in 1 2 3 4 5 6; do
  ip -n r1 route get 10.8.32.10 from 10.8.1.10 iif lan ipproto udp sport 4000$p dport 53 | head -1
done
При политике 0 все шесть потоков получают один и тот же следующий переход (10.8.13.2), поскольку адреса у них одинаковы. При политике 1 в лабораторной топологии получено распределение 3 к 3: потоки с портами 40001, 40002 и 40004 направлены через r2, остальные — через r3. Конкретное разбиение зависит от версии ядра и от случайного начального значения хеш-функции, которое выбирается при загрузке системы, поэтому у каждого оно будет своим; устойчив лишь сам факт распределения по путям. Отсюда практический вывод: при хешировании по адресам один «тяжёлый» обмен между двумя узлами никогда не займёт больше одного пути, а при хешировании по портам — может распределиться, если состоит из многих соединений. ECMP — основа топологий центров обработки данных (тема 21).
Фильтр обратного пути rp_filter
Адрес источника в пакете IP ничем не защищён: отправитель может указать любой. Подделка адреса источника (англ. IP spoofing) используется в атаках отражения и усиления (тема 18). Эффективная защита — фильтровать пакеты как можно ближе к источнику: маршрутизатор на входе сети клиента должен принимать от клиента только пакеты с адресами источника из его префиксов. Это требование сформулировано в документе BCP 38 (RFC 2827) 5.
Автоматизированная форма такой фильтрации — проверка обратного пути одноадресной рассылки (англ. Unicast Reverse Path Forwarding, uRPF), описанная в RFC 3704 4. В строгом режиме (англ. strict mode) маршрутизатор принимает пакет, только если маршрут к адресу источника пакета указывает на тот самый интерфейс, через который пакет пришёл: «я бы сам отправил ответ этому источнику через этот интерфейс». В свободном режиме (англ. loose mode) достаточно, чтобы маршрут к адресу источника вообще существовал (через любой интерфейс).
В Linux uRPF реализован параметром rp_filter: 0 — проверка выключена, 1 — строгий режим, 2 — свободный 8. Действующим для интерфейса считается наибольшее из значений net.ipv4.conf.all.rp_filter и net.ipv4.conf.<интерфейс>.rp_filter. Многие дистрибутивы, включая Ubuntu, по умолчанию устанавливают значение 2, а некоторые — 1. Пакеты, не прошедшие проверку, отбрасываются молча; их число видно в счётчике TcpExtIPReversePathFilter, а при включённом параметре log_martians они записываются в журнал ядра.
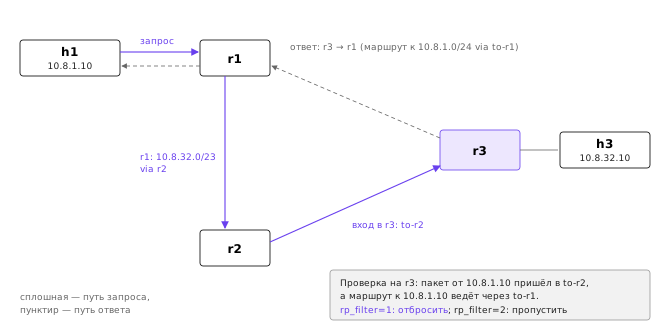
Строгий режим несовместим с асимметричной маршрутизацией, и это хорошо видно в лабораторной топологии. Пусть r1 отправляет трафик от h1 к h3 через r2 (r1 → r2 → r3), а r3 по своей таблице отвечает в сеть h1 напрямую через r1. Включим на r3 строгий режим:
ip netns exec r3 sysctl -w net.ipv4.conf.all.rp_filter=1
ip netns exec h1 ping -c 2 -W 1 10.8.32.10        # 100% packet loss
ip netns exec r3 nstat -az TcpExtIPReversePathFilter
ip -n r3 route get 10.8.32.10 from 10.8.1.10 iif to-r2
TcpExtIPReversePathFilter       2                  0.0
RTNETLINK answers: Invalid cross-device link
Эхо-запросы приходят на r3 через интерфейс to-r2, но маршрут r3 к источнику 10.8.1.10 ведёт через to-r1. Проверка не пройдена, оба запроса отброшены, что подтверждает счётчик. Команда ip route get с ключом iif воспроизводит ту же проверку и возвращает ошибку «Invalid cross-device link». При переключении r3 в свободный режим (rp_filter=2) связность восстанавливается: маршрут к источнику существует, и этого достаточно. Схема на рисунке ниже показывает этот сценарий. В реальных сетях строгий режим уместен на интерфейсах к тупиковым сетям клиентов, где асимметрия невозможна, а на интерфейсах между маршрутизаторами ядра применяют свободный режим или не применяют фильтр вовсе 4.
Итоги темы
Работа маршрутизатора распадается на две задачи разного масштаба. Пересылка — решение о каждом отдельном пакете, принимаемое плоскостью данных за наносекунды по таблице пересылки; маршрутизация — построение этой таблицы плоскостью управления по конфигурации и протоколам. В IP каждый маршрутизатор решает независимо и знает лишь следующий переход, поэтому корректность сквозного пути зависит от согласованности таблиц всех маршрутизаторов.
Таблица маршрутизации — набор префиксов с указанием следующего перехода и выходного интерфейса. Префиксы пересекаются, и выбор делается по правилу наибольшего совпадения: самый специфичный маршрут побеждает, маршрут по умолчанию срабатывает последним. Между маршрутами к одному префиксу из разных источников выбирают по административному расстоянию, внутри источника — по метрике. Все маршруты хранятся в RIB плоскости управления, а лучшие из них устанавливаются в FIB плоскости данных, где поиск ускоряется сжатыми префиксными деревьями или аппаратной памятью TCAM.
Статическая маршрутизация проста и предсказуема, но требует дисциплины: маршруты нужны в обоих направлениях, решения маршрутизаторов должны быть согласованы, суммаризация требует защиты маршрутом blackhole, а резервные плавающие маршруты срабатывают только при отказах, видимых как изменение состояния интерфейса, — и в Linux основной маршрут после восстановления интерфейса нужно вернуть вручную. Ошибки проявляются характерными симптомами: «время истекло» в ответ на обычный ping указывает на петлю, односторонняя связность — на отсутствие обратного маршрута.
Linux предоставляет полноценный маршрутизатор: пересылку, включаемую одним параметром, множество таблиц и правила политик для маршрутизации по источнику, ECMP с выбором полей хеширования и фильтр обратного пути, конфликтующий с асимметричной маршрутизацией. Инструмент ip route get позволяет проверить решение ядра для любого пакета, не отправляя его.
Главный недостаток статической маршрутизации — отсутствие реакции на изменения сети — устраняется протоколами динамической маршрутизации, которые сами обнаруживают соседей и отказы и согласованно перестраивают таблицы. Протоколам маршрутизации внутри автономной системы — RIP и OSPF — посвящена тема 9.
Литература
- Baker F. (ed.) Requirements for IP Version 4 Routers. — RFC 1812, IETF, 1995. https://www.rfc-editor.org/rfc/rfc1812
- Fuller V., Li T. Classless Inter-domain Routing (CIDR): The Internet Address Assignment and Aggregation Plan. — RFC 4632, IETF, 2006. https://www.rfc-editor.org/rfc/rfc4632
- Kurose J. F., Ross K. W. Computer Networking: A Top-Down Approach. 8th ed. — Pearson, 2021.
- Baker F., Savola P. Ingress Filtering for Multihomed Networks. — RFC 3704 (BCP 84), IETF, 2004. https://www.rfc-editor.org/rfc/rfc3704
- Ferguson P., Senie D. Network Ingress Filtering: Defeating Denial of Service Attacks which employ IP Source Address Spoofing. — RFC 2827 (BCP 38), IETF, 2000. https://www.rfc-editor.org/rfc/rfc2827
- Hopps C. Analysis of an Equal-Cost Multi-Path Algorithm. — RFC 2992, IETF, 2000. https://www.rfc-editor.org/rfc/rfc2992
- Thaler D., Hopps C. Multipath Issues in Unicast and Multicast Next-Hop Selection. — RFC 2991, IETF, 2000. https://www.rfc-editor.org/rfc/rfc2991
- The Linux Kernel Documentation. IP Sysctl. — 2025. https://docs.kernel.org/networking/ip-sysctl.html
- ip-route(8), ip-rule(8) — Linux manual pages. — man7.org. https://man7.org/linux/man-pages/man8/ip-route.8.html
- Peterson L. L., Davie B. S. Computer Networks: A Systems Approach. 5th ed. — Morgan Kaufmann, 2011.
- Yang L., Dantu R., Anderson T., Gopal R. Forwarding and Control Element Separation (ForCES) Framework. — RFC 3746, IETF, 2004. https://www.rfc-editor.org/rfc/rfc3746
- Karol M. J., Hluchyj M. G., Morgan S. P. Input Versus Output Queueing on a Space-Division Packet Switch. — IEEE Transactions on Communications, 1987, vol. 35, no. 12, P. 1347–1356.
- Nilsson S., Karlsson G. IP-Address Lookup Using LC-Tries. — IEEE Journal on Selected Areas in Communications, 1999, vol. 17, no. 6, P. 1083–1092.
- Ruiz-Sanchez M. A., Biersack E. W., Dabbous W. Survey and Taxonomy of IP Address Lookup Algorithms. — IEEE Network, 2001, vol. 15, no. 2, P. 8–23.