
Динамическая маршрутизация внутри автономной системы: RIP и OSPF
В теме 8 маршрутизатор рассматривался как устройство, которое для каждого пакета находит в таблице маршрутизации запись с наибольшим совпадением префикса и пересылает пакет следующему переходу. Откуда берутся сами записи, там решалось просто: администратор вписывал их вручную командами ip route add. Для трёх маршрутизаторов в треугольнике это работает, но уже в той же лабораторной работе обнаружились слабые места статической маршрутизации: резервный путь приходилось заранее описывать «плавающим» маршрутом, а ошибка в одной записи порождала петлю, которую обрывал только счётчик TTL. Сеть из сотни маршрутизаторов, где каналы время от времени отказывают, вручную поддерживать невозможно.
Динамическая маршрутизация передаёт эту работу самим маршрутизаторам. Они обмениваются сообщениями протокола маршрутизации (англ. routing protocol), по этим сообщениям вычисляют пути и сами записывают результат в таблицу. Задача формулируется как классическая задача теории графов — поиск кратчайших путей, — но решается в необычных условиях: граф распределён по многим устройствам, никто не видит его целиком в момент изменения, а сообщения задерживаются и теряются. Именно эти условия, а не математика кратчайших путей, определяют устройство протоколов и их типичные проблемы.
Тема посвящена маршрутизации внутри одной организации, или автономной системы. Сначала задача формулируется на языке графов. Затем рассматриваются два семейства алгоритмов: дистанционно-векторные на основе уравнения Беллмана — Форда с протоколом RIP в качестве примера и алгоритмы состояния каналов на основе алгоритма Дейкстры с протоколом OSPF. Оба алгоритма разбираются по шагам на одной и той же учебной топологии, которая затем используется в лабораторной работе. Последний раздел посвящён тому, что превращает алгоритм в работающую сеть: областям, сходимости, обнаружению отказов и обмену маршрутами между протоколами. Маршрутизация между автономными системами — предмет темы 10.
Задача динамической маршрутизации
Плоскость управления и протокол маршрутизации
Как было показано в теме 8, в маршрутизаторе различают две плоскости. Плоскость данных (англ. data plane) пересылает пакеты по готовой таблице и должна работать со скоростью канала. Плоскость управления (англ. control plane) строит эту таблицу и может работать гораздо медленнее — за миллисекунды и секунды. Протокол маршрутизации целиком принадлежит плоскости управления: его сообщения не переносят пользовательский трафик, а описывают сеть. Результат его работы попадает сначала в таблицу маршрутов протокола, затем в общую базу маршрутов RIB (англ. Routing Information Base) и оттуда в таблицу пересылки FIB (англ. Forwarding Information Base) ядра.
В программном маршрутизаторе FRRouting, который используется в лабораторных работах курса, это разделение видно буквально: протоколы работают отдельными процессами (ripd, ospfd, bgpd), каждый передаёт свои лучшие маршруты процессу zebra, а тот выбирает среди маршрутов разных протоколов и устанавливает победителей в таблицу маршрутизации ядра Linux через интерфейс netlink 9. Когда к одному префиксу ведут маршруты от разных источников, выбор делается по административному расстоянию, знакомому по теме 8: в FRR у статического маршрута оно равно 1, у OSPF — 110, у RIP — 120. Внутри одного протокола сравниваются уже метрики.
От протокола маршрутизации требуется несколько свойств. Он должен находить пути, оптимальные по выбранному критерию; быстро перестраивать их после отказа или восстановления канала, то есть обладать малым временем сходимости (англ. convergence); не создавать петель даже в переходных состояниях или хотя бы ограничивать их время; масштабироваться на сотни и тысячи маршрутизаторов, не перегружая каналы и процессоры служебным трафиком. Эти требования противоречат друг другу, и каждый протокол представляет собой компромисс между ними.
Сеть как взвешенный граф
Для протокола маршрутизации сеть — это граф. Вершины (англ. nodes) — маршрутизаторы, рёбра — каналы между ними, а каждому ребру приписан вес, или стоимость (англ. cost). Стоимость пути равна сумме стоимостей его рёбер, и задача маршрутизации — для каждой пары вершин найти путь наименьшей стоимости. Сети назначения, к которым подключены хосты, изображаются либо отдельными вершинами, либо «листьями» маршрутизаторов; для алгоритма это не важно.
Что именно выражает стоимость, решает протокол или администратор. Простейшая метрика — число переходов (англ. hop count): каждое ребро весит 1, и лучшим считается путь через наименьшее число маршрутизаторов. Так устроен RIP. Метрика, учитывающая пропускную способность, назначает медленным каналам больший вес: в OSPF стоимость интерфейса по умолчанию вычисляется как отношение опорной скорости к скорости канала, и путь из двух каналов по 1 Гбит/с оказывается лучше одного канала 100 Мбит/с. Встречаются и метрики, учитывающие задержку, — их использовал, например, алгоритм маршрутизации ARPANET 1980 года, где вес канала пересчитывался по измеренной задержке пакетов 13. Опыт ARPANET показал и опасность такого подхода: если вес зависит от нагрузки, трафик уходит с загруженного канала на свободный, загружает его, и маршруты начинают колебаться. Поэтому в современных внутренних протоколах стоимость — статическая величина, которую задаёт администратор.
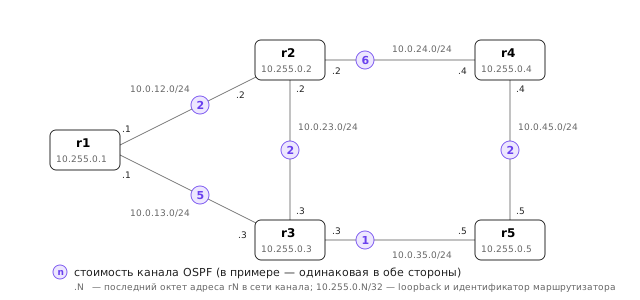
Учебная топология, используемая в разделах ниже и в лабораторной работе, показана на рисунке. Пять маршрутизаторов r1–r5 соединены шестью каналами; у каждого канала своя подсеть /24, а у каждого маршрутизатора — адрес на интерфейсе обратной связи (англ. loopback) 10.255.0.N/32, который служит ему именем.
Автономная система и внутренние протоколы
Интернет состоит из десятков тысяч сетей, принадлежащих разным организациям, и единый протокол маршрутизации для него невозможен ни технически, ни организационно. Поэтому маршрутизация разделена на два уровня. Автономная система (англ. autonomous system, AS) — совокупность сетей под единым административным управлением с единой политикой маршрутизации: сеть провайдера, университета, крупной компании. Внутри AS работает внутренний протокол маршрутизации (англ. Interior Gateway Protocol, IGP), задача которого — найти кратчайшие пути быстро и надёжно; владелец сети доверяет всем своим маршрутизаторам и сам назначает стоимости. Между автономными системами работает внешний протокол (англ. Exterior Gateway Protocol, EGP), в современном Интернете это BGP, и его главная задача — не кратчайший путь, а соблюдение договорных и экономических отношений между организациями. Внешней маршрутизации посвящена тема 10.
К внутренним протоколам относятся RIP, OSPF, IS-IS и фирменный EIGRP компании Cisco. Их можно разделить по алгоритму на два семейства, и это разделение — главная идея темы.
Два семейства алгоритмов
Алгоритмы маршрутизации различаются прежде всего тем, какой информацией о графе располагает каждый маршрутизатор 4. В децентрализованном, или дистанционно-векторном (англ. distance vector), алгоритме маршрутизатор знает лишь стоимости своих каналов к соседям и то, что соседи сообщают о своих расстояниях до всех сетей. Ни один маршрутизатор не видит граф целиком; кратчайшие пути возникают в результате итеративного обмена, как решение уравнения, которое все участники решают сообща. В алгоритме состояния каналов (англ. link state) каждый маршрутизатор рассылает всем остальным описание своих каналов, в результате у всех оказывается одна и та же полная карта сети, и каждый вычисляет кратчайшие пути самостоятельно, централизованным алгоритмом.
Из этого различия вытекают все остальные. Дистанционно-векторный протокол прост, требует мало памяти и вычислений, но сходится медленно и в переходных состояниях может создавать петли. Протокол состояния каналов сложнее, требует памяти под карту и процессорного времени на её обработку, зато сходится быстро и предсказуемо. Обе идеи появились в ARPANET: исходный алгоритм маршрутизации 1969 года был дистанционно-векторным, а в 1980 году его заменили алгоритмом состояния каналов именно из-за проблем со сходимостью и петлями 13.
Дистанционно-векторная маршрутизация
Уравнение Беллмана — Форда
Обозначим через D_x(y) стоимость кратчайшего пути от узла x до узла y, через c(x,v) — стоимость канала от x к соседу v. Кратчайший путь от x к y обязательно начинается с какого-то соседа v, а продолжается кратчайшим путём от v до y, иначе его можно было бы укоротить. Отсюда уравнение Беллмана — Форда 5:
D_x(y) = \min_{v} \big( c(x, v) + D_v(y) \big)
где минимум берётся по всем непосредственным соседям v узла x.
Уравнение замечательно тем, что для вычисления своего расстояния узлу x нужны лишь стоимости собственных каналов и расстояния, известные соседям. Сосед, на котором достигается минимум, и есть следующий переход (англ. next hop) — ровно то, что требуется записать в таблицу маршрутизации. Р. Беллман опубликовал этот подход в 1958 году как метод решения задачи о маршруте в графе 5; независимо к тому же алгоритму пришли Л. Форд и Э. Мур, отсюда двойное имя.
Вектор расстояний (англ. distance vector) узла x — это его текущие оценки D_x(y) до всех известных назначений. В распределённом алгоритме каждый узел хранит свой вектор и последние полученные векторы соседей, периодически или при изменении сообщает свой вектор соседям, а получив вектор соседа, пересчитывает собственный по уравнению. Если вектор изменился, узел рассылает его дальше. Доказано, что при неизменной топологии и положительных стоимостях такой асинхронный процесс сходится к истинным кратчайшим расстояниям при любом порядке обменов 411.
Распределённый алгоритм на учебной топологии
Проследим работу алгоритма на учебной топологии, начиная с момента, когда все маршрутизаторы одновременно включились. Будем считать обмен синхронным: в каждом раунде все узлы рассылают векторы соседям, затем все пересчитывают свои векторы. Перед первым раундом каждый узел знает только себя. Вектор узла r1 по раундам приведён в таблице; запись 4 (r2) означает «расстояние 4, следующий переход r2».
| Раунд | до r2 | до r3 | до r4 | до r5 | Что произошло |
|---|---|---|---|---|---|
| 1 | 2 (r2) | 5 (r3) | ∞ | ∞ | r1 узнал о соседях из их векторов |
| 2 | 2 (r2) | 4 (r2) | 8 (r2) | 6 (r3) | r2 сообщил: до r3 — 2, до r4 — 6; r3 сообщил: до r5 — 1 |
| 3 | 2 (r2) | 4 (r2) | 8 (r2) | 5 (r2) | r2 сообщил: до r5 — 3 (через r3) |
| 4 | 2 (r2) | 4 (r2) | 7 (r2) | 5 (r2) | r2 сообщил: до r4 — 5 (через r3 и r5) |
| 5 | 2 (r2) | 4 (r2) | 7 (r2) | 5 (r2) | изменений нет, алгоритм сошёлся |
Таблица иллюстрирует две особенности. Во-первых, хорошие новости распространяются по сети со скоростью один переход за раунд: о пути до r4 стоимостью 7, проходящем через четыре канала, r1 узнаёт только в четвёртом раунде. Во-вторых, промежуточные результаты неоптимальны: в раунде 2 маршрутизатор использует путь до r4 стоимостью 8 через прямой канал r2—r4, хотя существует более дешёвый. Пакеты при этом доставляются, но не лучшим путём. Итоговые маршруты совпадают с результатом алгоритма Дейкстры, который будет получен в разделе о состоянии каналов. Таблицу можно воспроизвести учебным скриптом spf.py из окружения лабораторной работы:
python3 spf.py dv topology.txt --node r1
Сходимость с нуля (режим simple), узлы r1
раунд  1 | r1: r2=2(r2) r3=5(r3) r4=∞ r5=∞
раунд  2 | r1: r2=2(r2) r3=4(r2) r4=8(r2) r5=6(r3)
раунд  3 | r1: r2=2(r2) r3=4(r2) r4=8(r2) r5=5(r2)
раунд  4 | r1: r2=2(r2) r3=4(r2) r4=7(r2) r5=5(r2)
раунд  5 | r1: r2=2(r2) r3=4(r2) r4=7(r2) r5=5(r2)
сошлось: раунд 5 ничего не изменил
Счёт до бесконечности
Хорошие новости распространяются быстро, плохие — медленно, и в этом главный недостаток дистанционно-векторного подхода. Рассмотрим цепочку из трёх маршрутизаторов a—b—c с единичными стоимостями. После сходимости b достигает c за 1, а a — за 2 через b. Пусть канал b—c отказал. Маршрутизатор b обнаруживает это и помечает c недостижимым. Но если прежде, чем b успеет сообщить об этом, он получит очередной вектор от a, где по-прежнему записано «до c — 2», то по уравнению Беллмана — Форда b получит новый маршрут: до c — 1 + 2 = 3 через a. Маршрутизатор b не может знать, что путь a к c проходил через него самого: вектор расстояний сообщает только числа, но не пути.
Дальше процесс повторяется. Узел a получает от b расстояние 3 и обновляет свой маршрут: 4 через b. Узел b получает 4 и записывает 5 через a, и так далее. Метрики растут на 2 за каждый обмен, а пакеты для c всё это время бегают по петле a—b—a, пока не истечёт их TTL. Явление называется счётом до бесконечности (англ. count to infinity). Если бы в сети существовал другой, длинный путь до c, счёт остановился бы, когда метрика петли превысила его стоимость; если пути нет вовсе, счёт продолжается неограниченно. Единственная защита в самом алгоритме — объявить некоторое конечное число «бесконечностью». В RIP бесконечность равна 16 1, и рисунок ниже показывает, как два маршрутизатора доходят до неё: у a метрика достигает 16 на седьмом обмене, у b — на восьмом.
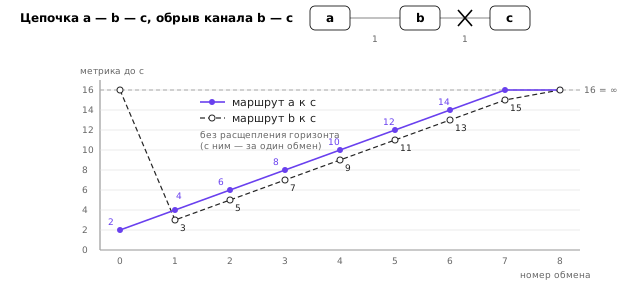
Время счёта зависит от периода обмена. В RIP векторы рассылаются раз в 30 секунд, и до восьми обменов без дополнительных механизмов заняли бы минуты, в течение которых сеть до c не просто недоступна, а образует петлю, нагружающую каналы. Небольшое значение бесконечности в RIP — прямое следствие этой проблемы: чем больше бесконечность, тем дольше счёт. Плата за малое значение — ограничение диаметра сети: путь длиннее 15 переходов в RIP непредставим.
Расщепление горизонта, отравленный обратный маршрут и триггерные обновления
Петлю из двух узлов устраняет правило расщеплённого горизонта (англ. split horizon): маршрутизатор не сообщает соседу о маршрутах, которые сам проложил через этого соседа 1. В примере a достигает c через b, поэтому в векторе, отправляемом b, назначения c нет вовсе, и после отказа канала b не может «подхватить» устаревший путь. Усиленный вариант — расщеплённый горизонт с отравленным обратным маршрутом (англ. split horizon with poisoned reverse): такой маршрут не умалчивается, а сообщается соседу с метрикой 16, «недостижимо». Отравление надёжнее простого умолчания, потому что явно разрушает возможную петлю, а не ждёт, пока устаревшая запись истечёт по таймеру; цена — более длинные сообщения 2.
python3 spf.py dv chain.txt --fail b-c --split-horizon none --sequential --node a,b
python3 spf.py dv chain.txt --fail b-c --split-horizon simple --sequential --node a,b
Обрыв канала b-c
раунд  0 | a: b=1(b) c=2(b) | b: a=1(a) c=∞
раунд  1 | a: b=1(b) c=4(b) | b: a=1(a) c=3(a)
раунд  2 | a: b=1(b) c=6(b) | b: a=1(a) c=5(a)
...
раунд  7 | a: b=1(b) c=∞ | b: a=1(a) c=15(a)
раунд  8 | a: b=1(b) c=∞ | b: a=1(a) c=∞
...
Обрыв канала b-c
раунд  0 | a: b=1(b) c=2(b) | b: a=1(a) c=∞
раунд  1 | a: b=1(b) c=∞ | b: a=1(a) c=∞
Расщеплённый горизонт не решает проблему полностью. Если три маршрутизатора образуют кольцо, а сеть назначения подключена к одному из них, после отказа возможна петля из трёх узлов: x узнаёт о маршруте от y, который проложил его через z, а z — через x; правило запрещает сообщать маршрут только тому соседу, через которого он проложен, а здесь каждый сообщает маршрут «третьему». В такой ситуации снова спасает только конечная бесконечность 11.
Два других механизма ускоряют распространение плохих новостей. Триггерное обновление (англ. triggered update) — немедленная рассылка изменившейся записи, не дожидаясь очередного 30-секундного периода; RIPv2 требует отправлять такие обновления с небольшой случайной задержкой от 1 до 5 секунд, чтобы волна обновлений не захлестнула сеть 2. Удержание (англ. hold-down) — период, в течение которого маршрутизатор после пометки маршрута недостижимым не принимает о нём сведений с худшей метрикой; механизм реализован у ряда производителей и упоминается в RFC 1058 (разд. 2.2.2), но не стандартизован и в FRR не используется.
Протокол RIP
Сообщения и формат записи
Протокол маршрутной информации (англ. Routing Information Protocol, RIP) — прямое воплощение распределённого алгоритма Беллмана — Форда. Он происходит из протокола GWINFO системы Xerox XNS и программы routed в BSD UNIX и был описан как стандарт в RFC 1058 в 1988 году, задним числом относительно уже широко распространённых реализаций 1. Вторая версия, RIPv2, описанная в RFC 2453, добавила маску подсети в каждую запись (первая версия была классовой и масок не передавала), адрес следующего перехода, метку маршрута и аутентификацию; для IPv6 существует RIPng 2.
Сообщения RIP передаются в датаграммах UDP на порт 520 от порта 520. Первая версия рассылала их широковещательно, RIPv2 — на групповой адрес 224.0.0.9, который слушают только маршрутизаторы RIP. Сообщение состоит из заголовка длиной 4 байта и до 25 записей о маршрутах по 20 байт; большая таблица передаётся несколькими сообщениями. Поля записи RIPv2 перечислены в таблице.
| Поле | Длина, байт | Назначение |
|---|---|---|
| Command | 1 | 1 — запрос (Request), 2 — ответ (Response); в заголовке |
| Version | 1 | номер версии, 2 для RIPv2; в заголовке |
| Must be zero | 2 | не используется; в заголовке |
| Address Family Identifier | 2 | семейство адресов, 2 для IPv4; 0xFFFF — запись аутентификации |
| Route Tag | 2 | метка маршрута, полученного из другого протокола |
| IP Address | 4 | адрес сети назначения |
| Subnet Mask | 4 | маска сети |
| Next Hop | 4 | следующий переход, если он отличается от отправителя; 0.0.0.0 — сам отправитель |
| Metric | 4 | метрика от 1 до 15; 16 — недостижимо |
Метрика RIP — число переходов: маршрутизатор, получив запись с метрикой m от соседа, увеличивает её на стоимость входного интерфейса, по умолчанию на 1. Так выглядит ответ RIPv2 в выводе tcpdump с подробным разбором (адреса — из учебной топологии):
IP 10.0.12.2.520 > 224.0.0.9.520: RIPv2, Response, length: 64, routes: 3 or less
  AFI IPv4,      10.0.23.0/24, tag 0x0000, metric: 1, next-hop: self
  AFI IPv4,      10.0.24.0/24, tag 0x0000, metric: 1, next-hop: self
  AFI IPv4,     10.255.0.2/32, tag 0x0000, metric: 1, next-hop: self
Длина 64 байта — это 4 байта заголовка и три записи по 20 байт. Заметим, что r2 не сообщает r1 о сети 10.0.12.0/24, общей для них, и о маршрутах, проложенных через r1: действует расщеплённый горизонт.
Таймеры и жизненный цикл маршрута
Поведение RIP во времени задают три таймера 2. Каждые 30 секунд маршрутизатор рассылает соседям полную таблицу (англ. update timer); чтобы обновления разных маршрутизаторов не синхронизировались, период слегка случайно варьируется. Если о маршруте 180 секунд не поступало сведений (англ. timeout), он считается устаревшим: метрика устанавливается в 16, маршрут удаляется из таблицы пересылки, но ещё 120 секунд (англ. garbage-collection timer) продолжает объявляться соседям как недостижимый, чтобы плохая новость наверняка до них дошла. Только после этого запись удаляется окончательно. Получается, что при молчаливом отказе соседа (канал физически «поднят», но маршрутизатор завис) RIP обнаруживает проблему только через три минуты.
В FRR протокол RIP настраивается командами, похожими на OSPF; таймеры по умолчанию задаются командой timers basic 30 180 120, а текущее состояние показывает show ip rip:
r1# show ip rip
Codes: R - RIP, C - connected, S - Static, O - OSPF, B - BGP
Sub-codes:
      (n) - normal, (s) - static, (d) - default, (r) - redistribute,
      (i) - interface

     Network            Next Hop         Metric From            Tag Time
C(i) 10.0.12.0/24       0.0.0.0               1 self              0
C(i) 10.0.13.0/24       0.0.0.0               1 self              0
R(n) 10.0.23.0/24       10.0.12.2             2 10.0.12.2         0 02:51
R(n) 10.0.24.0/24       10.0.12.2             2 10.0.12.2         0 02:51
R(n) 10.0.35.0/24       10.0.13.3             2 10.0.13.3         0 02:47
...
Столбец Time — оставшееся время до истечения 180-секундного таймера: при каждом обновлении от соседа он сбрасывается к 3:00. Метрика непосредственно подключённой сети равна 1, а не 0: в RIP стоимость входного интерфейса прибавляется уже при включении сети в таблицу.
Ограничения и область применения RIP
Ограничения RIP следуют из алгоритма. Диаметр сети не превышает 15 переходов. Метрика не учитывает скорости каналов: путь через два канала по 10 Гбит/с проигрывает одному каналу 10 Мбит/с. Периодическая рассылка полной таблицы расходует полосу пропорционально размеру таблицы, даже когда ничего не меняется. Сходимость после отказа измеряется десятками секунд при триггерных обновлениях и минутами при молчаливом отказе соседа, а в переходный период возможны петли.
Тем не менее RIP не исчез. Он прост в настройке, поддерживается практически любым оборудованием, включая бытовые маршрутизаторы, и вполне пригоден для маленьких сетей без резервных путей. Кроме того, он остаётся лучшим учебным примером: на нём видны все проблемы распределённого алгоритма в чистом виде. В производственных сетях организаций его место заняли OSPF и IS-IS, к которым мы переходим.
Маршрутизация по состоянию каналов
Идея: у каждого маршрутизатора полная карта
Протокол состояния каналов решает задачу в два независимых этапа. Сначала каждый маршрутизатор описывает своё непосредственное окружение: с какими соседями он соединён, какой стоимостью обладает каждый канал, какие сети к нему подключены. Это описание называется объявлением о состоянии каналов (англ. link-state advertisement, LSA). Маршрутизатор рассылает свои объявления всем маршрутизаторам сети — не только соседям, — и каждый собирает полученные объявления в базу данных состояния каналов (англ. link-state database, LSDB). Если рассылка работает правильно, базы всех маршрутизаторов одинаковы и представляют собой полный граф сети. На втором этапе каждый маршрутизатор независимо запускает над своей копией графа алгоритм поиска кратчайших путей и строит дерево кратчайших путей с собой в корне.
Важное отличие от дистанционно-векторного подхода: маршрутизатор распространяет не результаты своих вычислений («до сети X мне 5»), а исходные данные («у меня есть канал к Y стоимостью 2»). Ошибка или устаревшие сведения одного маршрутизатора не складываются с ошибками другого, как в цепочке a—b выше, потому что никто не строит свои выводы на чужих выводах. Расплата — объём: база содержит описание каждого маршрутизатора и каждого канала сети.
Алгоритм Дейкстры: пошаговый пример
Кратчайшие пути от одной вершины в графе с неотрицательными весами вычисляет алгоритм Э. Дейкстры, опубликованный в 1959 году 6. В маршрутизаторах его называют SPF (англ. Shortest Path First). Алгоритм поддерживает множество вершин, расстояние до которых уже известно окончательно, и для остальных вершин — текущие оценки расстояния. На каждом шаге:
- среди вершин, не вошедших в окончательное множество, выбирается вершина
uс наименьшей оценкой, и её оценка объявляется окончательной; - для каждого соседа
vвершиныu, ещё не закреплённого, проверяется, не короче ли путь черезu: еслиD(u) + c(u,v) < D(v), оценкаD(v)уменьшается, а первым переходом кvстановится первый переход кu; эта операция называется релаксацией (англ. relaxation); - шаги повторяются, пока не будут закреплены все достижимые вершины.
Правильность алгоритма опирается на неотрицательность весов: если u имеет наименьшую оценку среди незакреплённых вершин, никакой путь через ещё не закреплённые вершины не может оказаться короче, потому что он уже в своей первой незакреплённой вершине стоит не меньше D(u), а дальше только дорожает. Для маршрутизатора важен не столько сам путь, сколько первый переход на нём, поэтому вместе с оценкой хранится сосед корня, через которого путь начинается.
Выполним алгоритм для маршрутизатора r1 на учебной топологии. В таблице на каждом шаге указаны оценки расстояний и первые переходы; звёздочкой отмечены закреплённые вершины.
| Шаг | Закрепляется | r2 | r3 | r4 | r5 |
|---|---|---|---|---|---|
| 0 | r1 (0) | 2 / r2 | 5 / r3 | ∞ | ∞ |
| 1 | r2 (2) | 2 / r2 * | 4 / r2 | 8 / r2 | ∞ |
| 2 | r3 (4) | 2 / r2 * | 4 / r2 * | 8 / r2 | 5 / r2 |
| 3 | r5 (5) | 2 / r2 * | 4 / r2 * | 7 / r2 | 5 / r2 * |
| 4 | r4 (7) | 2 / r2 * | 4 / r2 * | 7 / r2 * | 5 / r2 * |
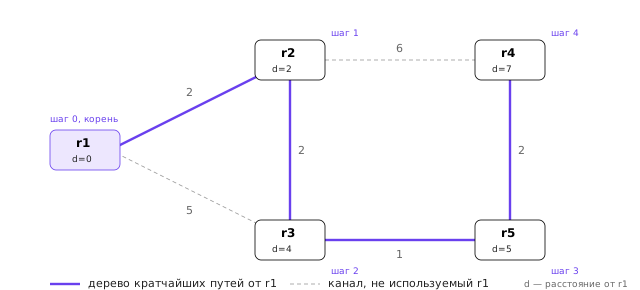
На шаге 0 закрепляется корень, а его соседи получают оценки по стоимостям прямых каналов: r2 — 2, r3 — 5. На шаге 1 наименьшую оценку имеет r2; релаксация его каналов улучшает оценку r3 с 5 до 2 + 2 = 4 (теперь первый переход — r2, а не прямой канал) и даёт первую оценку r4: 2 + 6 = 8. На шаге 2 закрепляется r3 с расстоянием 4, его канал к r5 даёт оценку 4 + 1 = 5. На шаге 3 закрепляется r5, и через него путь к r4 стоит 5 + 2 = 7 < 8 — оценка снова улучшается. На шаге 4 закрепляется последняя вершина. Все маршруты r1 идут через r2; прямой канал к r3 стоимостью 5 не используется вовсе, потому что обход через r2 стоит 4. Получившееся дерево кратчайших путей изображено на рисунке.
Результаты совпадают с полученными распределённым алгоритмом Беллмана — Форда: оба алгоритма решают одну задачу и при неизменной топологии приходят к одному ответу. Различается путь к нему: Дейкстра выполняет пять шагов локально за микросекунды, а распределённому алгоритму понадобились четыре раунда обмена по сети. Если две вершины имеют равные оценки через разных соседей, маршрутизатор сохраняет оба первых перехода и делит трафик между ними — так возникают равноценные многопутевые маршруты (англ. Equal-Cost Multi-Path, ECMP), о которых шла речь в теме 8. Таблицу шагов печатает учебный скрипт:
python3 spf.py dijkstra topology.txt r1
шаг  закреплён           r2          r3          r4          r5
---------------------------------------------------------------
  0  r1                2/r2        5/r3           ∞           ∞
  1  r2               2/r2*        4/r2        8/r2           ∞
  2  r3               2/r2*       4/r2*        8/r2        5/r2
  3  r5               2/r2*       4/r2*        7/r2       5/r2*
  4  r4               2/r2*       4/r2*       7/r2*       5/r2*
Вычислительная сложность алгоритма Дейкстры с двоичной кучей — O((V + E) log V) для графа из V вершин и E рёбер. Для области OSPF из нескольких сотен маршрутизаторов расчёт занимает доли миллисекунды на современном процессоре, поэтому вычисление давно перестало быть узким местом; время сходимости определяется обнаружением отказа и рассылкой объявлений.
Надёжная лавинная рассылка
Чтобы базы всех маршрутизаторов совпадали, объявления должны доходить до каждого маршрутизатора, причём доходить надёжно и в правильном порядке. Для этого служит лавинная рассылка (англ. flooding): получив объявление, маршрутизатор проверяет, новее ли оно имеющейся копии; если новее — записывает в базу, подтверждает получение и пересылает во все интерфейсы, кроме того, откуда оно пришло; если не новее — только подтверждает, а если полученная копия старее имеющейся — отправляет соседу свою, более новую. Каждая отправка подтверждается отдельно, и неподтверждённое объявление повторяется, поэтому рассылка надёжна даже поверх ненадёжного IP 3.
Новизну определяют поля самого объявления. Порядковый номер (англ. sequence number) увеличивается при каждом изменении: из двух копий новее та, у которой номер больше. Контрольная сумма защищает содержимое. Возраст (англ. age) растёт с момента создания; объявление, не обновлявшееся слишком долго, удаляется из базы, а его автор обязан периодически переиздавать свои объявления, даже если ничего не изменилось. В OSPF период переиздания — 30 минут, а максимальный возраст — 1 час 3. Необходимость всех трёх механизмов показал инцидент в ARPANET 27 октября 1980 года: из-за аппаратного сбоя в сети одновременно оказались три копии объявления одного узла с номерами, сравнение которых давало циклический результат («каждая новее предыдущей»), и маршрутизаторы бесконечно пересылали их друг другу, пока сеть не была остановлена целиком. Разбор этого случая лёг в основу правил сравнения номеров и обязательного старения записей в последующих протоколах 11.
Сравнение двух подходов
| Свойство | Дистанционно-векторный (RIP) | Состояния каналов (OSPF) |
|---|---|---|
| Что знает маршрутизатор | векторы соседей | полный граф области |
| Что рассылается | свои расстояния, только соседям | описание своих каналов, всем |
| Алгоритм | распределённый Беллман — Форд | Дейкстра на локальной копии |
| Когда рассылается | периодически (30 с) и при изменениях | при изменениях и раз в 30 минут |
| Метрика | число переходов, не более 15 | стоимость интерфейса, 1–65535 |
| Сходимость | десятки секунд — минуты, возможен счёт до бесконечности | обычно секунды и быстрее, без счёта до бесконечности |
| Требования к ресурсам | минимальные | память под базу, процессор под SPF |
| Масштабирование | десятки маршрутизаторов | сотни в области, больше — с иерархией областей |
Ни один подход не свободен от петель в переходный период. В протоколе состояния каналов петля возникает, когда маршрутизаторы уже получили разные версии базы: один пересчитал маршруты, а другой ещё нет. Такие микропетли (англ. microloops) живут доли секунды — пока обновление не дойдёт до всех, — и не нарастают, как счёт до бесконечности.
OSPF: протокол состояния каналов в работе
Пакеты OSPF и протокол приветствия
Протокол OSPF (англ. Open Shortest Path First) разработан в IETF в конце 1980-х годов как открытая замена RIP; его вторая версия для IPv4 описана в RFC 2328 Дж. Моем 3, версия для IPv6 — OSPFv3 — в RFC 5340. Слово Open означает открытость спецификации, а не что-либо в алгоритме 12. OSPF работает непосредственно поверх IP, без TCP и UDP: номер протокола в заголовке IP равен 89. Сообщения рассылаются на групповые адреса 224.0.0.5 (все маршрутизаторы OSPF, AllSPFRouters) и 224.0.0.6 (выделенные маршрутизаторы, AllDRouters) с TTL, равным 1, — пакеты OSPF никогда не покидают канал. Надёжность доставки обеспечивает сам протокол подтверждениями.
Всего в OSPFv2 пять типов пакетов: приветствие Hello (тип 1), описание базы данных Database Description, DBD (тип 2), запрос состояния каналов Link State Request, LSR (тип 3), обновление Link State Update, LSU (тип 4), содержащее сами объявления, и подтверждение Link State Acknowledgment, LSAck (тип 5). Все они начинаются с общего 24-байтного заголовка.
| Поле | Длина, байт | Назначение |
|---|---|---|
| Version | 1 | 2 для OSPFv2 |
| Type | 1 | тип пакета, 1–5 |
| Packet length | 2 | длина пакета OSPF вместе с заголовком |
| Router ID | 4 | идентификатор маршрутизатора-отправителя |
| Area ID | 4 | идентификатор области, 0.0.0.0 — магистральная |
| Checksum | 2 | контрольная сумма пакета |
| AuType | 2 | тип аутентификации: 0 — нет, 1 — пароль, 2 — криптографическая |
| Authentication | 8 | данные аутентификации |
Идентификатор маршрутизатора (англ. Router ID) — 32-битное число, записываемое как адрес IPv4 и уникальное в пределах AS. Обычно его задают явно, равным адресу loopback, как в учебной топологии; без явного задания реализация выбирает один из адресов маршрутизатора, и смена этого адреса неожиданно меняет «имя» маршрутизатора для всей сети.
Пакет Hello выполняет три задачи: обнаруживает соседей, проверяет совместимость их параметров и служит сигналом жизни. Маршрутизатор отправляет его в каждый интерфейс, где включён OSPF, с интервалом HelloInterval, по умолчанию 10 секунд на широковещательных и точка-точка каналах. Если от соседа нет Hello в течение RouterDeadInterval, по умолчанию 40 секунд, то есть четырёх интервалов, сосед считается отказавшим 3. Так выглядит Hello от r2 в канале с r1, захваченный tcpdump -v:
IP (tos 0xc0, ttl 1, id 41210, offset 0, flags [none], proto OSPF (89), length 68)
    10.0.12.2 > 224.0.0.5: OSPFv2, Hello, length 48
	Router-ID 10.255.0.2, Backbone Area, Authentication Type: none (0)
	Options [External]
	  Hello Timer 10s, Dead Timer 40s, Mask 255.255.255.0, Priority 1
	  Designated Router 10.0.12.2, Backup Designated Router 10.0.12.1
	  Neighbor List:
	    10.255.0.1
Разберём размеры. Тело Hello состоит из маски сети (4 байта), HelloInterval (2), поля опций (1), приоритета (1), RouterDeadInterval (4), адресов выделенного и резервного выделенного маршрутизаторов (по 4) и списка соседей по 4 байта на каждого. Вместе с заголовком без соседей получается 24 + 20 = 44 байта, с одним соседом — 48, что и показывает tcpdump; добавив 20 байт заголовка IP, получим 68. Поле tos 0xc0 означает класс обслуживания CS6, которым по традиции помечается служебный трафик маршрутизации.
Соседство устанавливается, только если у двух маршрутизаторов совпадают: идентификатор области, маска сети на широковещательном канале, HelloInterval и RouterDeadInterval, флаг E в опциях (признак того, что область не является тупиковой) и параметры аутентификации. Несовпадение не вызывает никакого сообщения у соседа — его Hello просто отбрасываются, и в выводе show ip ospf neighbor сосед не появляется. Такие ошибки — одна из самых частых причин «OSPF не поднимается»; в лабораторной работе их предстоит найти по журналу и захвату трафика.
Состояния соседства и синхронизация баз
Установление соседства — это последовательность состояний конечного автомата, показанная на временной диаграмме. Маршрутизатор r1, получив Hello от r2, переводит соседа из состояния Down в Init: «я тебя слышу». Когда в списке соседей очередного Hello от r2 появляется идентификатор самого r1, связь подтверждена в обе стороны, и сосед переходит в состояние 2-Way. На этом этапе маршрутизаторы решают, нужна ли им полная синхронизация баз — смежность (англ. adjacency). На канале точка-точка она нужна всегда, на широковещательном — только с выделенным маршрутизатором, о чём речь ниже.
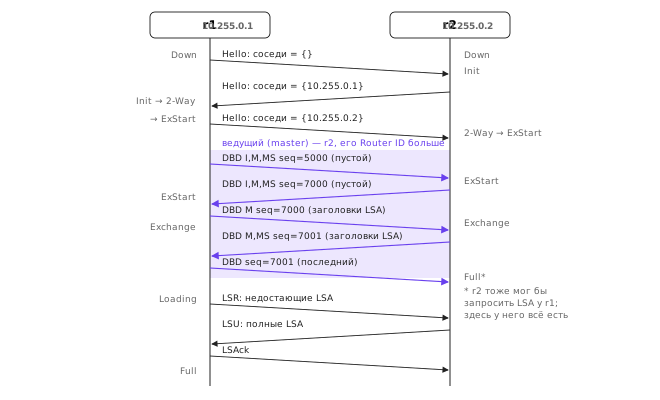
Синхронизация начинается в состоянии ExStart. Маршрутизаторы обмениваются пустыми пакетами DBD с установленными флагами I (Init), M (More) и MS (Master) и выясняют, кто будет ведущим (англ. master): им становится маршрутизатор с большим Router ID, в примере r2. Ведущий задаёт порядковые номера пакетов DBD, ведомый (англ. slave) повторяет номер в ответе — так обмен превращается в надёжный протокол «запрос — подтверждение». В состоянии Exchange стороны пересылают друг другу заголовки всех LSA своих баз; заголовок LSA занимает 20 байт и содержит тип, идентификатор, автора, порядковый номер, возраст и контрольную сумму — достаточно, чтобы понять, новее ли объявление имеющегося, не передавая его целиком. Каждый маршрутизатор составляет список объявлений, которых у него нет или которые у него устарели. При получении каждого DBD в состояниях ExStart и Exchange проверяется MTU: поле Interface MTU в пакете DBD сравнивается с собственным MTU интерфейса, и если сосед сообщает больший MTU, его DBD отвергаются — пакет LSU с большой базой мог бы не пройти через интерфейс. Соседство при этом «застревает» в состоянии ExStart или Exchange, что является классическим симптомом несовпадения MTU 3.
В состоянии Loading маршрутизатор запрашивает недостающие объявления пакетами LSR, получает их в пакетах LSU и подтверждает пакетами LSAck. Когда список запросов опустеет, соседство переходит в состояние Full: базы синхронизированы. Только после этого маршрутизатор включает канал к соседу в своё объявление, и сосед участвует в вычислении маршрутов.
Выделенный маршрутизатор на широковещательных сегментах
Если к одному сегменту Ethernet подключены n маршрутизаторов, полная смежность каждого с каждым дала бы n(n − 1)/2 пар, каждая из которых синхронизирует базы и пересылает объявления; при 10 маршрутизаторах это 45 смежностей и многократное дублирование лавинной рассылки. Кроме того, описывать сегмент как полный граф каналов между всеми маршрутизаторами было бы расточительно. OSPF решает обе проблемы, выбирая на каждом широковещательном сегменте выделенный маршрутизатор (англ. Designated Router, DR) и резервный (англ. Backup Designated Router, BDR) 3.
Все маршрутизаторы сегмента устанавливают полную смежность только с DR и BDR, а между собой остаются в состоянии 2-Way. Маршрутизатор, у которого изменилось состояние, отправляет LSU на адрес 224.0.0.6, который слушают DR и BDR; DR пересылает объявление всем на 224.0.0.5. Кроме того, DR создаёт объявление о сети (LSA типа 2), описывающее сегмент как отдельную вершину графа, соединённую со всеми подключёнными маршрутизаторами. Выборы проходят по полю приоритета в Hello: побеждает наибольший приоритет (по умолчанию 1; приоритет 0 означает «никогда не быть DR»), при равенстве — наибольший Router ID. Выборы не вытесняющие (англ. non-preemptive): маршрутизатор с большим приоритетом, включённый позже, не отнимает роль у действующего DR; BDR становится DR только при отказе последнего.
Механизм рассчитан на сегменты с многими маршрутизаторами. На канале между двумя маршрутизаторами DR не нужен, но если канал имеет тип broadcast — а именно такой тип OSPF присваивает интерфейсам Ethernet, в том числе виртуальным в Docker, — выборы всё равно проводятся, и в базе появляются лишние объявления типа 2. Поэтому на двухточечных каналах Ethernet принято задавать тип сети явно: ip ospf network point-to-point. Это убирает выборы, ускоряет установление смежности (не требуется ждать окончания выборов, длящихся до RouterDeadInterval) и упрощает граф.
Типы LSA и база данных состояния каналов
LSDB OSPF состоит из объявлений нескольких типов. В объёме курса нужны четыре 3:
- LSA типа 1, объявление маршрутизатора (англ. Router LSA), — его создаёт каждый маршрутизатор для каждой своей области; перечисляет каналы маршрутизатора: к соседям точка-точка, к транзитным сегментам (через их DR), к тупиковым сетям (англ. stub networks, например loopback или сегменты без соседей OSPF) — каждый со своей стоимостью;
- LSA типа 2, объявление сети (англ. Network LSA), — создаёт DR широковещательного сегмента; перечисляет все маршрутизаторы сегмента и маску сети;
- LSA типа 3, сводное объявление (англ. Summary LSA), — создаёт пограничный маршрутизатор области; сообщает в одну область префиксы другой со стоимостью до них, без топологии;
- LSA типа 5, внешнее объявление (англ. AS-External LSA), — создаёт пограничный маршрутизатор AS; описывает маршрут, полученный извне OSPF, например статический или из BGP; распространяется по всей AS.
Существуют и другие типы: 4 (сводка о пограничном маршрутизаторе AS, нужна, чтобы маршрутизаторы другой области знали, как до него добраться) и 7 (внешние маршруты в областях NSSA, RFC 3101); их достаточно знать по названию. Объявления типов 1 и 2 вместе образуют граф области, по которому работает алгоритм Дейкстры. Базу можно увидеть командой show ip ospf database; в учебной топологии с одной областью и широковещательными каналами она выглядит так:
r1# show ip ospf database

       OSPF Router with ID (10.255.0.1)

                Router Link States (Area 0.0.0.0)

Link ID         ADV Router      Age  Seq#       CkSum  Link count
10.255.0.1     10.255.0.1       312 0x80000006 0x4b1e 3
10.255.0.2     10.255.0.2       305 0x80000008 0x9a07 4
10.255.0.3     10.255.0.3       306 0x80000008 0x1d5c 4
10.255.0.4     10.255.0.4       298 0x80000005 0xe2a3 3
10.255.0.5     10.255.0.5       297 0x80000006 0x37f1 3

                Net Link States (Area 0.0.0.0)

Link ID         ADV Router      Age  Seq#       CkSum
10.0.12.2      10.255.0.2       316 0x80000001 0x6c35
10.0.13.3      10.255.0.3       316 0x80000001 0x5a43
10.0.23.3      10.255.0.3       309 0x80000001 0x0e86
10.0.24.4      10.255.0.4       301 0x80000001 0xb2d8
10.0.35.5      10.255.0.5       300 0x80000001 0x96ee
10.0.45.5      10.255.0.5       299 0x80000001 0x7c09
Пять объявлений типа 1 — по одному на маршрутизатор; число каналов Link count у r1 равно 3: два транзитных сегмента и loopback как тупиковая сеть. Шесть объявлений типа 2 соответствуют шести сегментам; Link ID объявления сети — адрес интерфейса DR на этом сегменте, поэтому по нему сразу видно, кто стал DR: на сегменте 10.0.12.0/24 это r2 с большим Router ID. Порядковые номера начинаются с 0x80000001 — наименьшего допустимого значения, ведь номер трактуется как знаковое 32-битное число, — и увеличиваются при каждом переиздании. Возраст в секундах растёт до 1800, после чего объявление переиздаётся. Подробное содержимое одного объявления выводит команда show ip ospf database router 10.255.0.1:
  LS age: 312
  Options: 0x2  : *|-|-|-|-|-|E|-
  LS Flags: 0x3
  Flags: 0x0
  LS Type: router-LSA
  Link State ID: 10.255.0.1
  Advertising Router: 10.255.0.1
  LS Seq Number: 80000006
  Checksum: 0x4b1e
  Length: 60

   Number of Links: 3

    Link connected to: a Transit Network
     (Link ID) Designated Router address: 10.0.12.2
     (Link Data) Router Interface address: 10.0.12.1
      Number of TOS metrics: 0
       TOS 0 Metric: 2

    Link connected to: a Transit Network
     (Link ID) Designated Router address: 10.0.13.3
     (Link Data) Router Interface address: 10.0.13.1
      Number of TOS metrics: 0
       TOS 0 Metric: 5

    Link connected to: Stub Network
     (Link ID) Net: 10.255.0.1
     (Link Data) Network Mask: 255.255.255.255
      Number of TOS metrics: 0
       TOS 0 Metric: 0
Длина объявления — 60 байт: 20 байт заголовка LSA, 4 байта флагов и числа каналов и три описания каналов по 12 байт. Стоимости 2 и 5 — те самые веса рёбер учебного графа. Стоимость задаётся на исходящем интерфейсе каждого маршрутизатора отдельно, поэтому в OSPF возможны несимметричные стоимости: из r1 в r2 — 2, а из r2 в r1 — 10. Тогда и пути в двух направлениях могут различаться — это нормальное, хотя и затрудняющее диагностику, свойство протокола.
Масштабирование, сходимость и обмен маршрутами
Области OSPF и межобластная маршрутизация
Полная карта сети — достоинство протокола состояния каналов, но в большой сети она становится обузой. Каждое изменение любого канала рассылается всем маршрутизаторам и заставляет каждого пересчитывать дерево; база растёт пропорционально размеру сети. OSPF вводит двухуровневую иерархию: AS делится на области (англ. areas), и топология каждой области видна только её маршрутизаторам 3. Одна область, с номером 0, называется магистральной (англ. backbone area), и все остальные области обязаны с ней соединяться.
Маршрутизатор, интерфейсы которого принадлежат нескольким областям, называется пограничным маршрутизатором области (англ. Area Border Router, ABR). Он хранит отдельную базу для каждой своей области и в каждую область сообщает сводными объявлениями типа 3 префиксы других областей вместе со стоимостью от себя до них. Маршрутизатор внутри области видит, таким образом, свою область как граф, а остальную AS — как набор префиксов «за ABR со стоимостью X». Это уже не состояние каналов, а вектор расстояний: межобластная маршрутизация OSPF устроена по дистанционно-векторному принципу, и от петель её защищает правило, что сводки передаются между немагистральными областями только через магистраль. Схема показана на рисунке на примере учебной топологии, разделённой на две области.
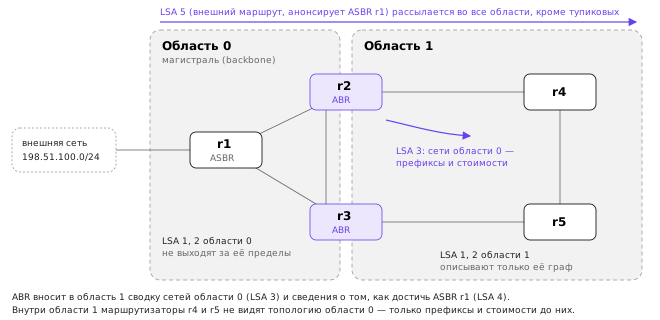
Маршрутизатор, вносящий в OSPF внешние маршруты, называется пограничным маршрутизатором AS (англ. AS Boundary Router, ASBR); на рисунке это r1, которому известен статический маршрут во внешнюю сеть. ABR дополнительно сообщает в другие области, как добраться до ASBR (LSA типа 4), а само внешнее объявление типа 5 рассылается по всем областям без изменений. Области, куда внешние объявления не допускаются, называются тупиковыми (англ. stub area); их маршрутизаторы получают вместо внешних маршрутов маршрут по умолчанию от ABR. Разновидности тупиковых областей и виртуальные каналы, которыми восстанавливают связность магистрали, выходят за рамки курса.
Области дают ещё одно преимущество — суммаризацию на границе. ABR может объявлять в магистраль вместо десятков префиксов области один суммарный (команда area 1 range 10.0.0.0/16), и тогда изменения внутри области вовсе не выходят за её пределы. Расплата за иерархию — потеря оптимальности: маршрутизатор другой области не видит внутренней топологии и выбирает ABR по сумме стоимостей, известной лишь приближённо.
Стоимость интерфейса и выбор маршрута
Стоимость интерфейса OSPF — целое число от 1 до 65535. Если она не задана явно, реализация вычисляет её по скорости интерфейса: стоимость равна опорной скорости, делённой на скорость канала, с округлением вниз и не менее 1. RFC 2328 не фиксирует опорную скорость, но традиционное значение — 100 Мбит/с, и в FRR это значение по умолчанию 9. Отсюда известная проблема: каналы 100 Мбит/с, 1 Гбит/с и 10 Гбит/с получают одинаковую стоимость 1, и протокол перестаёт их различать. Поэтому опорную скорость повышают на всех маршрутизаторах одинаково, например командой auto-cost reference-bandwidth 100000 (в Мбит/с, то есть 100 Гбит/с), либо назначают стоимости вручную командой ip ospf cost на интерфейсе. Виртуальные интерфейсы veth, через которые соединены контейнеры в лабораторной работе, сообщают скорость 10 Гбит/с, и при опорной скорости по умолчанию их стоимость равна 1.
Когда к одному префиксу ведут несколько маршрутов OSPF, сначала сравнивается их тип, а затем стоимость. Внутриобластной маршрут (англ. intra-area) предпочитается межобластному (англ. inter-area) независимо от стоимостей, а оба — внешним. Внешние маршруты бывают двух типов: у типа 1 (E1) стоимость складывается из внешней метрики и внутренней стоимости до ASBR, у типа 2 (E2) учитывается только внешняя метрика, а внутренняя стоимость используется лишь для выбора между равными. В FRR перераспределённые маршруты по умолчанию получают тип E2 и метрику 20. Маршруты с равной итоговой стоимостью устанавливаются как ECMP, по умолчанию FRR допускает до 64 следующих переходов на префикс (зависит от параметров сборки). Итог виден в таблице маршрутизации; число в квадратных скобках — административное расстояние и метрика:
r1# show ip route ospf
Codes: K - kernel route, C - connected, L - local, S - static,
       R - RIP, O - OSPF, I - IS-IS, B - BGP, E - EIGRP, N - NHRP,
       T - Table, v - VNC, V - VNC-Direct, A - Babel, F - PBR,
       f - OpenFabric, t - Table-Direct,
       > - selected route, * - FIB route, q - queued, r - rejected, b - backup
       t - trapped, o - offload failure

O   10.0.12.0/24 [110/2] is directly connected, eth0, weight 1, 00:05:12
O   10.0.13.0/24 [110/5] is directly connected, eth1, weight 1, 00:05:12
O>* 10.0.23.0/24 [110/4] via 10.0.12.2, eth0, weight 1, 00:05:02
O>* 10.0.24.0/24 [110/8] via 10.0.12.2, eth0, weight 1, 00:05:02
O>* 10.0.35.0/24 [110/5] via 10.0.12.2, eth0, weight 1, 00:04:55
O>* 10.0.45.0/24 [110/7] via 10.0.12.2, eth0, weight 1, 00:04:55
O>* 10.255.0.2/32 [110/2] via 10.0.12.2, eth0, weight 1, 00:05:02
O>* 10.255.0.3/32 [110/4] via 10.0.12.2, eth0, weight 1, 00:05:02
O>* 10.255.0.4/32 [110/7] via 10.0.12.2, eth0, weight 1, 00:04:55
O>* 10.255.0.5/32 [110/5] via 10.0.12.2, eth0, weight 1, 00:04:55
Стоимости совпадают с расчётом по алгоритму Дейкстры: до r4 — 7, до r5 — 5, до r3 — 4, всё через r2. Интересны две первые строки. Маршруты к 10.0.12.0/24 и 10.0.13.0/24 не отмечены символом >: эти сети подключены к r1 непосредственно, и маршрут типа C с административным расстоянием 0 побеждает маршрут OSPF. Стоимость маршрута OSPF к 10.0.13.0/24 равна 5, а не 4 через r2: стоимость пути до сети — это стоимость до маршрутизатора, к которому сеть подключена, плюс стоимость его интерфейса в эту сеть, и для собственной сети r1 она равна стоимости собственного интерфейса. Номера интерфейсов eth0 и eth1 в контейнере могут отличаться от приведённых: Docker не гарантирует их порядок.
Сходимость, таймеры и BFD
Время сходимости OSPF после отказа складывается из четырёх слагаемых: обнаружения отказа, создания и рассылки новых LSA, ожидания и выполнения SPF, обновления таблицы пересылки. Первое слагаемое обычно наибольшее. Если отказ виден на физическом уровне — пропала несущая, интерфейс перешёл в состояние down, — маршрутизатор узнаёт о нём за миллисекунды. Но часто отказ невидим: канал проходит через коммутатор, который продолжает поддерживать линк, или сосед завис, не выключив интерфейс. Тогда остаётся ждать RouterDeadInterval — 40 секунд по умолчанию. Уменьшить интервалы Hello можно, но пакеты обрабатываются плоскостью управления, и интервалы меньше секунды становятся источником ложных срабатываний при загрузке процессора.
Остальные слагаемые FRR контролирует таймерами. Новое объявление рассылается немедленно, но повторное изменение того же LSA принимается не чаще раза в секунду (MinLSArrival). Перед запуском SPF маршрутизатор ждёт, чтобы обработать сразу пачку объявлений от одного события; в FRR по умолчанию действует адаптивная задержка timers throttle spf 0 50 5000: первый расчёт без задержки, повторные — с удвоением паузы от 50 мс до 5 с при частых изменениях 9. В сумме при видимом отказе OSPF сходится примерно за секунду, при невидимом — за время RouterDeadInterval.
Для быстрого обнаружения невидимых отказов служит протокол двунаправленного обнаружения пересылки (англ. Bidirectional Forwarding Detection, BFD), описанный в RFC 5880 7. Два соседа обмениваются короткими контрольными пакетами UDP (порт 3784 для BFD в пределах одного перехода) с интервалом в сотни или десятки миллисекунд; если подряд пропущено заданное число пакетов (множитель обнаружения, англ. detect multiplier), сессия объявляется упавшей, и BFD немедленно сообщает об этом протоколу маршрутизации. BFD прост, поэтому его можно реализовать в аппаратуре или в быстром пути ядра, независимо от загрузки процессора. В FRR BFD работает отдельным процессом bfdd, по умолчанию с интервалами 300 мс и множителем 3, то есть обнаруживает отказ за 0,9 с; для OSPF он включается командой ip ospf bfd на интерфейсе.
r1# show bfd peers brief
Session count: 2
SessionId  LocalAddress                             PeerAddress                             Status
=========  ============                             ===========                             ======
3418829173 10.0.12.1                                10.0.12.2                               up
1739420557 10.0.13.1                                10.0.13.3                               up
Перераспределение маршрутов и IS-IS
На практике в одной сети работают несколько источников маршрутов: статические маршруты, OSPF, BGP на границе с провайдером. Передача маршрутов из одного протокола в другой называется перераспределением (англ. redistribution). В FRR она задаётся в конфигурации принимающего протокола: redistribute static или redistribute connected в разделе router ospf превращает маршрутизатор в ASBR, и перераспределённые маршруты появляются в OSPF как LSA типа 5. Метрику и тип можно задать явно: redistribute static metric 100 metric-type 1. Частный случай — анонс маршрута по умолчанию командой default-information originate: пограничный маршрутизатор с выходом в Интернет сообщает остальным, что всё неизвестное следует отправлять ему.
Перераспределение — частый источник ошибок. Метрики разных протоколов несопоставимы: число переходов RIP ничего не говорит о стоимости OSPF, и при передаче метрика назначается заново, а информация о пути теряется. Особенно опасно взаимное перераспределение в двух точках: маршрут, переданный из RIP в OSPF на одном маршрутизаторе, возвращается из OSPF в RIP на другом, и при неудачном сочетании административных расстояний возникает устойчивая петля маршрутизации. Поэтому перераспределение ограничивают фильтрами (route-map) и помечают перенесённые маршруты метками (поле Route Tag в RIP, метка внешнего LSA в OSPF), чтобы не принимать их обратно.
Наконец, о третьем распространённом внутреннем протоколе. IS-IS (англ. Intermediate System to Intermediate System) разработан для стека протоколов OSI и стандартизован как ISO/IEC 10589; его применение для маршрутизации IP описано в RFC 1195 8. Это тоже протокол состояния каналов с алгоритмом Дейкстры, но с иными решениями: он работает непосредственно поверх канального уровня, а не IP, его объявления (LSP) расширяются полями «тип — длина — значение», что упростило добавление IPv6 и новых возможностей без смены версии, а иерархия строится из уровней 1 и 2 вместо областей вокруг магистрали. IS-IS популярен в сетях крупных провайдеров и в центрах обработки данных; OSPF — в корпоративных сетях. Принципиальных различий в качестве маршрутизации между ними нет 10.
Итоги темы
Динамическая маршрутизация сводит задачу построения таблиц к поиску кратчайших путей во взвешенном графе, но решает её в распределённой системе, где граф меняется, а сведения о нём запаздывают. Два семейства протоколов по-разному распределяют работу. В дистанционно-векторном подходе маршрутизаторы сообща решают уравнение Беллмана — Форда, обмениваясь только расстояниями; это просто и экономно, но хорошие новости распространяются на один переход за обмен, а плохие порождают счёт до бесконечности, который смягчают расщеплённый горизонт, отравленный обратный маршрут, триггерные обновления и малая «бесконечность» 16 в RIP.
В подходе состояния каналов маршрутизаторы обмениваются не выводами, а исходными фактами — описаниями своих каналов, — и надёжная лавинная рассылка с порядковыми номерами и старением записей обеспечивает всем одинаковую карту. Кратчайшие пути каждый вычисляет сам алгоритмом Дейкстры, что исключает счёт до бесконечности и даёт быструю предсказуемую сходимость. На учебной топологии оба алгоритма дали одинаковые маршруты: все пути r1 проходят через r2, а самый дорогой — до r4 стоимостью 7.
OSPF превращает алгоритм в инженерный протокол: Hello обнаруживает соседей и проверяет совместимость параметров, обмен DBD, LSR и LSU синхронизирует базы, выделенный маршрутизатор сокращает число смежностей на общих сегментах, типы LSA разделяют описание маршрутизаторов, сегментов, межобластных и внешних маршрутов. Области ограничивают размер базы и распространение изменений ценой оптимальности, а время сходимости определяется в первую очередь обнаружением отказа, для ускорения которого служит BFD.
Внутренний протокол исходит из того, что все маршрутизаторы принадлежат одному владельцу и цель одна — кратчайший путь. Между автономными системами это допущение неверно: у каждой системы свои интересы, договоры и политика, и кратчайший путь не обязательно желателен. Как устроена маршрутизация в таких условиях — предмет темы 10, посвящённой BGP.
Литература
- Hedrick C. Routing Information Protocol. — RFC 1058, IETF, 1988. https://www.rfc-editor.org/rfc/rfc1058
- Malkin G. RIP Version 2. — RFC 2453, IETF, 1998. https://www.rfc-editor.org/rfc/rfc2453
- Moy J. OSPF Version 2. — RFC 2328, IETF, 1998. https://www.rfc-editor.org/rfc/rfc2328
- Kurose J. F., Ross K. W. Computer Networking: A Top-Down Approach. 8th ed. — Pearson, 2021.
- Bellman R. On a Routing Problem. — Quarterly of Applied Mathematics, 1958, Vol. 16, No. 1, P. 87–90, DOI: 10.1090/qam/102435.
- Dijkstra E. W. A Note on Two Problems in Connexion with Graphs. — Numerische Mathematik, 1959, Vol. 1, P. 269–271, DOI: 10.1007/BF01386390.
- Katz D., Ward D. Bidirectional Forwarding Detection (BFD). — RFC 5880, IETF, 2010. https://www.rfc-editor.org/rfc/rfc5880
- Callon R. Use of OSI IS-IS for Routing in TCP/IP and Dual Environments. — RFC 1195, IETF, 1990. https://www.rfc-editor.org/rfc/rfc1195
- FRRouting Project. FRRouting User Guide: OSPFv2. — 2025. https://docs.frrouting.org/en/latest/ospfd.html
- Doyle J., Carroll J. Routing TCP/IP, Volume 1. 2nd ed. — Cisco Press, 2005.
- Perlman R. Interconnections: Bridges, Routers, Switches, and Internetworking Protocols. 2nd ed. — Addison-Wesley, 1999.
- Moy J. T. OSPF: Anatomy of an Internet Routing Protocol. — Addison-Wesley, 1998.
- McQuillan J. M., Richer I., Rosen E. C. The New Routing Algorithm for the ARPANET. — IEEE Transactions on Communications, 1980, Vol. 28, No. 5, P. 711–719, DOI: 10.1109/TCOM.1980.1094721.