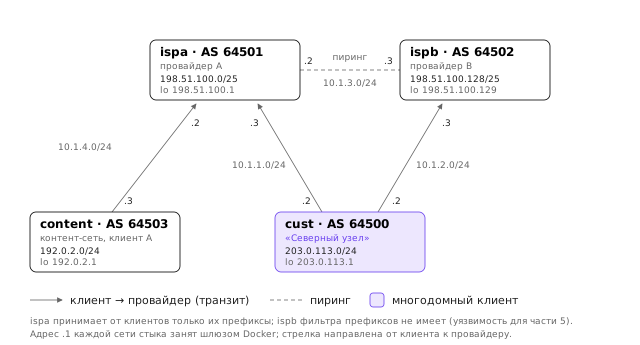
Междоменная маршрутизация и BGP
В теме 9 рассматривалась маршрутизация внутри одной организационной единицы: все маршрутизаторы сети подчиняются одному администратору, знают общую карту или общие метрики и стремятся к единой цели — доставить пакет по кратчайшему пути. Протоколы RIP и OSPF решают эту задачу хорошо, но лишь до тех пор, пока сеть остаётся под единым управлением. Интернет устроен иначе. Он состоит из десятков тысяч независимых сетей — провайдеров, университетов, облачных платформ, контент-компаний, — каждая из которых самостоятельно решает, через кого передавать свой трафик, чей трафик принимать и кому сообщать о своих адресах. Эти решения определяются договорами и деньгами, а не метрикой каналов, и ни одна организация не видит и не контролирует Интернет целиком.
Отсюда вопрос, на который отвечает тема: как независимые сети договариваются о достижимости адресов так, чтобы каждая из них сохраняла контроль над своей политикой, а глобальная система при этом оставалась связной и не зацикливалась. Ответом служит протокол пограничного шлюза (англ. Border Gateway Protocol, BGP) четвёртой версии — единственный протокол междоменной маршрутизации, используемый в Интернете с середины 1990-х годов 1.
Изложение построено так. Сначала вводится понятие автономной системы и рассматриваются экономические отношения между сетями, которые определяют, какие пути в Интернете вообще допустимы. Затем разбирается сам протокол BGP: сессия поверх TCP, конечный автомат, формат сообщений OPEN и UPDATE байт за байтом. Третий раздел посвящён атрибутам пути и процессу выбора лучшего маршрута с пошаговым примером. Далее рассматриваются политики маршрутизации, управление трафиком и BGP внутри автономной системы. Пятый раздел посвящён уязвимостям глобальной маршрутизации — перехватам и утечкам маршрутов — и механизмам защиты: реестрам IRR, RPKI и ролям BGP. Завершает тему обзор anycast и инструментов наблюдения за маршрутизацией в реальном Интернете.
Интернет как сеть автономных систем
Автономная система и её номер
Автономная система (англ. Autonomous System, AS) — совокупность маршрутизаторов и сетей под единым техническим управлением, которая для внешнего мира выглядит как целое с единой согласованной политикой маршрутизации 1. Внутри автономной системы могут работать любые протоколы внутренней маршрутизации — OSPF, IS-IS, статические маршруты (тема 9), — но наружу она предъявляет один набор правил: какие префиксы принадлежат ей, какие она готова передавать транзитом и на каких условиях. Протоколы внутри AS называют протоколами внутреннего шлюза (англ. Interior Gateway Protocol, IGP), протокол между автономными системами — протоколом внешнего шлюза (англ. Exterior Gateway Protocol, EGP); BGP — единственный используемый сегодня протокол второго класса.
Каждой автономной системе, участвующей в глобальной маршрутизации, присваивается уникальный номер (англ. Autonomous System Number, ASN). Номера распределяет IANA между пятью региональными интернет-регистратурами (англ. Regional Internet Registry, RIR): AFRINIC, APNIC, ARIN, LACNIC и RIPE NCC, — а те выдают их организациям. Изначально номер занимал 16 бит, что давало 65 536 значений; к середине 2000-х годов стало ясно, что их не хватит, и номер расширили до 32 бит 3. Четырёхбайтовые номера записываются обычным десятичным числом, например 4200000000; встречается и устаревшая запись через точку (65536 записывается как 1.0).
Некоторые диапазоны номеров зарезервированы. Номера 64496–64511 и 65536–65551 предназначены для документации и учебных примеров (RFC 5398) — ими пользуется и настоящий курс. Номера 64512–65534 и 4200000000–4294967294 — частные (RFC 6996): их применяют внутри организаций и в центрах обработки данных, но не анонсируют в Интернет. Номер 23456 (AS_TRANS) служит заглушкой для совместимости старых двухбайтовых реализаций с четырёхбайтовыми номерами 3. По данным проекта CIDR Report, в октябре 2026 года в глобальной таблице маршрутизации видны около 80 тысяч автономных систем и около 1,08 млн префиксов IPv4.
Важно различать два понятия: префикс принадлежит организации, а автономная система его анонсирует, то есть сообщает соседям, что пакеты для этих адресов можно отправлять ей. Автономная система, которая первой анонсирует префикс, называется источником (англ. origin AS) этого префикса. Связь между префиксом и законной AS-источником — центральный вопрос безопасности маршрутизации, к которому мы вернёмся в пятом разделе.
Отношения между автономными системами: транзит и пиринг
Соединение двух автономных систем — не только техническое, но и договорное. В Интернете преобладают два типа отношений 713.
Отношение «клиент — провайдер» (англ. customer — provider), или транзит (англ. transit): клиент платит провайдеру за доступ ко всему Интернету. Провайдер обязуется анонсировать префиксы клиента всем своим соседям и передавать клиенту маршруты ко всем известным ему сетям. Деньги текут от клиента к провайдеру, обычно пропорционально объёму трафика (например, по 95-му процентилю загрузки канала).
Отношение «равноправный обмен» (англ. peer — peer), или пиринг (англ. peering): две сети договариваются обмениваться трафиком между своими клиентами, как правило без взаимных платежей. Принципиальная особенность пиринга — его ограниченность: каждая сторона сообщает другой только свои префиксы и префиксы своих клиентов, но не маршруты, полученные от провайдеров или других пиров. Пир не продаёт пиру транзит в остальной Интернет.
Мотивация пиринга экономическая. Если провайдеры А и Б обмениваются большим объёмом трафика между своими клиентами, им выгоднее соединиться напрямую, чем платить общему вышестоящему провайдеру за доставку этого трафика.
Точки обмена трафиком и иерархия провайдеров
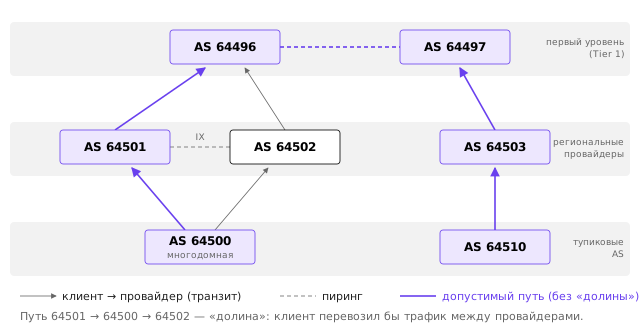
На вершине иерархии находятся провайдеры первого уровня (англ. Tier 1) — сети, которые достигают любого адреса Интернета без покупки транзита: со всеми остальными сетями первого уровня у них пиринг, а все прочие сети являются их прямыми или косвенными клиентами. К ним относят, например, Lumen (AS3356), Arelion (AS1299), NTT (AS2914), Cogent (AS174). Ниже располагаются региональные провайдеры, которые покупают транзит у первого уровня и одновременно продают его своим клиентам, а в самом низу — тупиковые (англ. stub) автономные системы: предприятия и университеты, которые ничего не передают транзитом. Тупиковая AS, подключённая к двум и более провайдерам ради надёжности, называется многодомной (англ. multihomed).
Иерархия на практике давно размыта. Крупные контент-провайдеры и облачные платформы (Google, Amazon, Cloudflare, Meta) построили собственные глобальные сети и обмениваются трафиком напрямую с тысячами провайдеров, минуя верхние уровни. Этому способствуют точки обмена трафиком (англ. Internet Exchange Point, IX или IXP) — площадки, где десятки и сотни сетей подключаются к общему коммутатору Ethernet и устанавливают пиринговые сессии друг с другом. Крупнейшие IX — DE-CIX во Франкфурте, AMS-IX в Амстердаме, LINX в Лондоне, MSK-IX в Москве. Чтобы не устанавливать сессию с каждым участником, на IX работают серверы маршрутов (англ. route server), собирающие маршруты всех участников и раздающие их обратно. Сама IX не участвует в пересылке на сетевом уровне: это общий сегмент второго уровня, а BGP-сессии идут между маршрутизаторами участников.
Рисунок ниже показывает типичную картину: провайдеры первого уровня связаны пирингом, региональные провайдеры покупают у них транзит и пирингуются между собой на IX, тупиковые AS подключены к одному или двум провайдерам.
Правило «долины» и экспорт маршрутов
Из договорных отношений следуют правила экспорта маршрутов, которые первыми формализовали Л. Гао и Дж. Рексфорд 7. Обозначим маршруты по тому, от кого они получены: от клиента, от пира или от провайдера. Тогда:
- маршруты, полученные от клиентов, а также собственные префиксы экспортируются всем соседям — клиентам, пирам и провайдерам: за доставку трафика к клиенту платит клиент, и чем больше сетей о нём знает, тем лучше;
- маршруты, полученные от пиров и провайдеров, экспортируются только клиентам: передавать трафик пира через своего провайдера или другого пира — значит бесплатно оказывать транзит, оплачиваемый собственными деньгами.
Последствие этих правил для путей в Интернете называют правилом «долины» (англ. valley-free). Представим путь как последовательность шагов: «вверх» — от клиента к провайдеру, «вниз» — от провайдера к клиенту, «вбок» — между пирами. Допустимый путь сначала идёт только вверх (ноль или более шагов), затем делает не более одного шага вбок и далее идёт только вниз. Путь, спускающийся к клиенту и снова поднимающийся к другому провайдеру, образует «долину»: клиент при этом бесплатно, а точнее за собственный счёт, перевозит трафик между двумя своими провайдерами. Также недопустимы два шага вбок подряд.
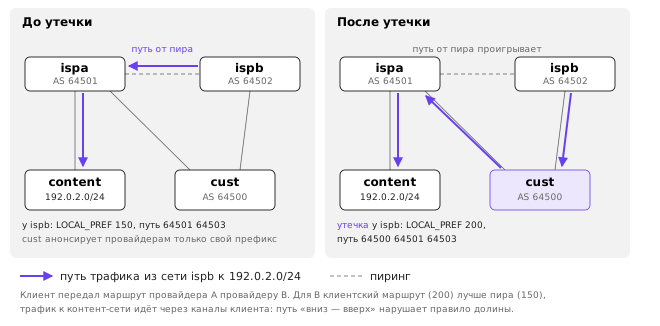
Рассмотрим пример по рисунку выше. Тупиковая AS 64500 подключена к провайдерам 64501 и 64502. Путь «64500 → 64501 → 64496 → 64497 → 64503 → 64510» поднимается от клиента к провайдеру первого уровня, делает шаг вбок между двумя сетями первого уровня и спускается к получателю — он допустим. Путь «64501 → 64500 → 64502» опускается к клиенту и вновь поднимается — это долина. Если бы AS 64500 анонсировала провайдеру 64502 маршруты, полученные от 64501, весь трафик между двумя провайдерами мог бы пойти через её каналы. Такая ошибка называется утечкой маршрутов и разбирается в пятом разделе.
Гао и Рексфорд показали и более сильный результат: если каждая AS предпочитает маршруты через клиентов маршрутам через пиров, а те — маршрутам через провайдеров, и соблюдает правила экспорта, а граф отношений «клиент — провайдер» не содержит циклов, то BGP гарантированно сходится к устойчивому состоянию без какой-либо глобальной координации 7. Именно поэтому практическая политика большинства провайдеров выглядит одинаково: клиентским маршрутам назначается наибольший приоритет, пиринговым — средний, провайдерским — наименьший. Как это делается средствами BGP, показано в третьем и четвёртом разделах.
Протокол BGP-4: сессии и сообщения
Вектор путей вместо вектора расстояний
Прежде чем разбирать формат сообщений, выясним, почему для междоменной маршрутизации не подходят протоколы из темы 9. Протокол состояния каналов (OSPF) требует, чтобы каждый маршрутизатор знал полный граф сети с метриками каналов. Для Интернета это неприемлемо по трём причинам: граф огромен, сети не желают раскрывать внутреннее устройство конкурентам, а главное — единой метрики не существует, поскольку каждая AS выбирает путь по собственным коммерческим критериям. Дистанционно-векторный протокол (RIP) раскрывает меньше, но страдает от счёта до бесконечности и тоже опирается на общую метрику.
BGP — протокол вектора путей (англ. path vector). Как и в дистанционно-векторном подходе, маршрутизатор сообщает соседям только свои лучшие маршруты, но вместо числового расстояния каждый маршрут несёт полный список автономных систем, через которые прошло объявление, — атрибут AS_PATH. Это решает две задачи сразу. Во-первых, петли обнаруживаются тривиально: AS, увидевшая собственный номер в пути, отбрасывает маршрут, поэтому счёт до бесконечности невозможен. Во-вторых, путь даёт материал для политики: AS может отвергать маршруты через нежелательные сети или предпочитать одних соседей другим, а длина пути служит лишь одним из критериев выбора.
История протокола начинается в 1989 году, когда первая версия BGP (RFC 1105) пришла на смену протоколу EGP, рассчитанному на древовидную топологию ранней NSFNET. Версия 4 опубликована в 1994–1995 годах (RFC 1771) и с поддержкой бесклассовой адресации (CIDR) стала основой коммерческого Интернета; действующая спецификация — RFC 4271 1. Многопротокольные расширения позволяют переносить в BGP префиксы IPv6, VPN и другие семейства адресов 6; их устройство кратко рассмотрено ниже.
Сессия поверх TCP и конечный автомат
Два маршрутизатора, обменивающиеся маршрутами по BGP, называются соседями (англ. neighbors) или пирами. Слово «пир» здесь имеет технический смысл — участник сессии — и не совпадает с договорным «пирингом» из предыдущего раздела; путаница этих значений — частая ошибка. Сессия между маршрутизаторами разных AS называется внешней (англ. external BGP, eBGP), между маршрутизаторами одной AS — внутренней (англ. internal BGP, iBGP).
В отличие от OSPF, который сам обнаруживает соседей рассылкой hello-пакетов, BGP соседей не ищет: администратор явно указывает адрес и номер AS каждого соседа. Сообщения передаются по TCP на порт 179 1. TCP обеспечивает надёжность, упорядоченность и управление потоком (подробно — в темах 12 и 13), поэтому в BGP нет ни подтверждений, ни повторной передачи, ни периодического повторения всей таблицы: однажды переданный маршрут считается известным соседу до тех пор, пока не будет явно отозван или пока не разорвётся сессия. Это ключевое отличие от RIP с его рассылкой всей таблицы каждые 30 секунд — и причина того, что BGP справляется с таблицей из миллиона префиксов.
Состояние сессии описывается конечным автоматом из шести состояний 1:
Idle— исходное состояние: ресурсы не выделены, соединение не устанавливается (например, после ошибки или административного отключения);Connect— маршрутизатор пытается установить TCP-соединение с соседом;Active— попытка не удалась, маршрутизатор ожидает входящего соединения от соседа и повторит попытку по истечении таймераConnectRetry(рекомендуемое значение — 120 с);OpenSent— TCP-соединение установлено, отправлено сообщение OPEN, ожидается OPEN соседа;OpenConfirm— OPEN соседа получен и проверен, отправлен KEEPALIVE, ожидается KEEPALIVE в ответ;Established— сессия установлена, идёт обмен UPDATE.
Название состояния Active вводит в заблуждение: оно означает не «сессия активна», а «соединения нет, жду». Сосед, надолго застрявший в Active или колеблющийся между Active и Connect, указывает на проблему связности или настройки: неверный адрес соседа, отсутствие маршрута до него, фильтр на TCP-порт 179.
Временна́я диаграмма на рисунке ниже показывает установление сессии. После трёхэтапного рукопожатия TCP обе стороны отправляют OPEN, подтверждают параметры друг друга сообщением KEEPALIVE и переходят в Established, после чего передают свои маршруты в сообщениях UPDATE.
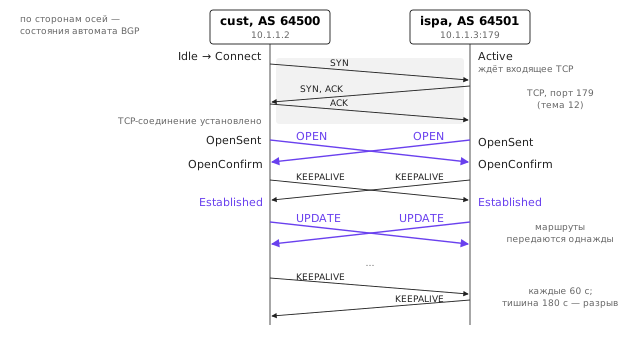
Живость сессии контролируют два таймера. Каждая сторона предлагает в OPEN время удержания (англ. hold time); действует меньшее из двух предложенных значений. Если в течение времени удержания от соседа не пришло ни одного сообщения, сессия разрывается, а все полученные от него маршруты удаляются. Чтобы при отсутствии изменений сессия не разорвалась, стороны периодически посылают KEEPALIVE; RFC 4271 рекомендует время удержания 90 с и интервал KEEPALIVE в треть от него 1. FRRouting по умолчанию использует 180 и 60 с 12. Таким образом, отказ соседа, не сопровождающийся разрывом канала, обнаруживается только через три минуты — для ускорения применяют уменьшенные таймеры или протокол BFD (тема 9). При падении непосредственно подключённого интерфейса FRR разрывает eBGP-сессию сразу, не дожидаясь таймера.
Формат сообщений: заголовок и OPEN
Каждое сообщение BGP начинается с заголовка длиной 19 байт 1:
| Поле | Длина | Назначение |
|---|---|---|
| Marker | 16 байт | все биты равны 1; служит для синхронизации и совместимости |
| Length | 2 байта | полная длина сообщения с заголовком: от 19 до 4096 байт |
| Type | 1 байт | 1 — OPEN, 2 — UPDATE, 3 — NOTIFICATION, 4 — KEEPALIVE, 5 — ROUTE-REFRESH |
Тип 5 введён отдельным документом (RFC 2918) и позволяет запросить у соседа повторную передачу маршрутов без разрыва сессии — именно его использует команда «мягкого» сброса clear bgp ... soft in. Предельная длина 4096 байт позднее расширена до 65 535 байт для соседей, договорившихся об этом (RFC 8654).
Сообщение OPEN после заголовка содержит:
| Поле | Длина | Назначение |
|---|---|---|
| Version | 1 байт | версия протокола, всегда 4 |
| My Autonomous System | 2 байта | номер AS отправителя; при четырёхбайтовом номере — 23456 |
| Hold Time | 2 байта | предлагаемое время удержания, с; 0 или не менее 3 |
| BGP Identifier | 4 байта | идентификатор маршрутизатора (англ. router ID), записывается как адрес IPv4 |
| Opt Parm Len | 1 байт | длина необязательных параметров |
| Optional Parameters | переменная | параметры, на практике — объявления возможностей |
Наиболее важный необязательный параметр — объявление возможностей (англ. capabilities, тип параметра 2): каждая сторона перечисляет поддерживаемые расширения, и действует их пересечение. Среди них многопротокольные расширения (код 1) с указанием семейства адресов 6, поддержка ROUTE-REFRESH (код 2), четырёхбайтовые номера AS (код 65) 3, добавление нескольких путей ADD-PATH (код 69), плавный перезапуск (код 64), роль BGP (код 9) 10.
Разберём OPEN, который маршрутизатор AS 64500 с идентификатором 203.0.113.1 отправляет соседу. Сообщение предельно сокращено: в нём три возможности (реальный OPEN FRR содержит их около десятка и потому длиннее).
0000  ff ff ff ff ff ff ff ff ff ff ff ff ff ff ff ff   Marker
0010  00 31 01                                          Length = 49, Type = 1 (OPEN)
0013  04                                                Version = 4
0014  fb f4                                             My AS = 0xFBF4 = 64500
0016  00 b4                                             Hold Time = 180 с
0018  cb 00 71 01                                       BGP Identifier = 203.0.113.1
001c  14                                                Opt Parm Len = 20
001d  02 06 01 04 00 01 00 01                           Capability 1: AFI 1 (IPv4), SAFI 1 (unicast)
0025  02 02 02 00                                       Capability 2: Route Refresh
0029  02 06 41 04 00 00 fb f4                           Capability 65: 4-octet AS = 64500
Каждая возможность упакована в параметр типа 2: байт 02 — тип параметра, следующий байт — его длина, затем код возможности, её длина и значение. Проверим длину: 19 байт заголовка, 10 байт фиксированной части OPEN (1 + 2 + 2 + 4 + 1) и 20 байт параметров дают 49 = 0x31. Номер 64500 помещается в два байта, поэтому поле My AS содержит его самого; маршрутизатор с номером 4200000001 записал бы туда 23456, а настоящий номер передал бы только в возможности 65 3.
Получатель проверяет OPEN: совпадает ли номер AS с настроенным для этого соседа, допустимо ли время удержания, не совпадает ли идентификатор с собственным. При ошибке он отправляет NOTIFICATION и закрывает соединение. Типичная ошибка настройки — неверный remote-as — проявляется именно здесь: сессия циклически проходит Connect → OpenSent → Idle, а в журнале появляется NOTIFICATION с кодом 2 (ошибка в OPEN) и подкодом 2 (неверный номер AS соседа).
Сообщения UPDATE, KEEPALIVE и NOTIFICATION
Маршрутная информация передаётся в сообщениях UPDATE. Одно сообщение может одновременно отзывать ранее анонсированные префиксы и анонсировать новые, причём все новые префиксы в одном сообщении разделяют общий набор атрибутов пути. Структура UPDATE показана на рисунке ниже.
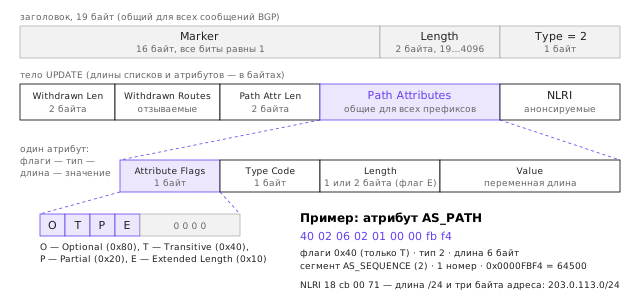
После заголовка следуют: длина списка отзываемых маршрутов (2 байта) и сам список (англ. Withdrawn Routes); суммарная длина атрибутов пути (2 байта) и сами атрибуты (англ. Path Attributes); затем, до конца сообщения, — список анонсируемых префиксов (англ. Network Layer Reachability Information, NLRI) 1. Префикс кодируется компактно: байт длины префикса в битах и минимальное число байт адреса, вмещающее эти биты. Префикс /24 занимает 1 + 3 = 4 байта, /25 — 1 + 4 = 5 байт, маршрут по умолчанию 0.0.0.0/0 — один байт.
Каждый атрибут закодирован по схеме «флаги — тип — длина — значение». Четыре старших бита байта флагов означают: Optional (0x80) — атрибут необязательный; Transitive (0x40) — атрибут следует передавать дальше, даже если он непонятен; Partial (0x20) — необязательный транзитивный атрибут прошёл через маршрутизатор, который его не понимал; Extended Length (0x10) — поле длины занимает два байта вместо одного.
Рассмотрим UPDATE, которым маршрутизатор AS 64500 анонсирует провайдеру свой префикс 203.0.113.0/24 через eBGP-сессию с адреса 10.1.1.2:
0000  ff ff ff ff ff ff ff ff ff ff ff ff ff ff ff ff   Marker
0010  00 2f 02                                          Length = 47, Type = 2 (UPDATE)
0013  00 00                                             Withdrawn Routes Length = 0
0015  00 14                                             Total Path Attribute Length = 20
0017  40 01 01 00                                       ORIGIN: flags 0x40, type 1, len 1, IGP (0)
001b  40 02 06 02 01 00 00 fb f4                        AS_PATH: type 2, len 6, AS_SEQUENCE из 1 номера: 64500
0024  40 03 04 0a 01 01 02                              NEXT_HOP: type 3, len 4, 10.1.1.2
002b  18 cb 00 71                                       NLRI: /24, 203.0.113
Атрибуты ORIGIN, AS_PATH и NEXT_HOP имеют флаг 0x40: они общеизвестные (не Optional) и транзитивные. Атрибут AS_PATH состоит из сегментов; сегмент типа 2 (AS_SEQUENCE) — упорядоченная последовательность номеров, здесь из одного четырёхбайтового номера, поскольку обе стороны объявили возможность 65. Длина сообщения: 19 + 2 + 2 + 20 + 4 = 47 байт. Реальный UPDATE от FRR обычно содержит ещё атрибут MULTI_EXIT_DISC со значением 0 для локально созданных маршрутов; в примере он опущен.
Отзыв маршрута — UPDATE с непустым списком Withdrawn Routes и без атрибутов. Отзыв того же префикса займёт 19 + 2 + 4 + 2 = 27 байт. Многопротокольные расширения переносят префиксы других семейств (IPv6, VPN) не в полях NLRI и Withdrawn Routes, а в атрибутах MP_REACH_NLRI (тип 14) и MP_UNREACH_NLRI (тип 15), которые содержат идентификаторы семейства AFI/SAFI и собственный следующий переход 6. Поэтому BGP для IPv6 — тот же протокол, а нередко и та же сессия поверх IPv4 (тема 11).
Сообщение KEEPALIVE состоит из одного заголовка и имеет длину 19 байт. Сообщение NOTIFICATION сообщает об ошибке и всегда сопровождается закрытием соединения; оно содержит код ошибки (1 — ошибка заголовка, 2 — ошибка в OPEN, 3 — ошибка в UPDATE, 4 — истечение времени удержания, 5 — ошибка конечного автомата, 6 — прекращение сессии, англ. Cease), подкод и диагностические данные 1. Код 6 используется и при штатном административном отключении соседа, и при превышении допустимого числа префиксов.
Атрибуты пути и выбор лучшего маршрута
Категории атрибутов
Атрибуты пути — это свойства маршрута, на которых строятся и выбор лучшего пути, и политика. RFC 4271 делит их на четыре категории 1:
| Категория | Атрибуты | Свойство |
|---|---|---|
| Общеизвестные обязательные | ORIGIN (1), AS_PATH (2), NEXT_HOP (3) | должны присутствовать в каждом UPDATE с NLRI |
| Общеизвестные необязательные | LOCAL_PREF (5), ATOMIC_AGGREGATE (6) | понимаются всеми реализациями, но могут отсутствовать |
| Необязательные транзитивные | AGGREGATOR (7), COMMUNITIES (8), LARGE_COMMUNITY (32), OTC (35) | передаются дальше даже непонимающими маршрутизаторами |
| Необязательные нетранзитивные | MULTI_EXIT_DISC (4), ORIGINATOR_ID (9), CLUSTER_LIST (10) | непонимающий маршрутизатор их отбрасывает |
В скобках указаны коды типов. Атрибуты сообществ определены в RFC 1997 и RFC 8092 45, атрибуты отражения маршрутов — в RFC 4456 9, атрибут OTC — в RFC 9234 10.
AS_PATH, NEXT_HOP и ORIGIN
Атрибут AS_PATH — список автономных систем, через которые прошло объявление, в обратном порядке: последней записана AS-источник, первой — сосед. Каждый маршрутизатор, передающий маршрут по eBGP, дописывает свой номер в начало. Если провайдер 64501 получил от клиента маршрут с путём 64500 и передал его пиру 64502, тот увидит путь 64501 64500. Помимо обнаружения петель путь используется в выборе маршрута — короче значит лучше — и в фильтрах. При агрегации маршрутов из разных путей возникает сегмент типа AS_SET — неупорядоченное множество номеров, которое при подсчёте длины учитывается как один номер.
Атрибут NEXT_HOP — адрес маршрутизатора, которому следует передать пакеты для данного префикса. При передаче по eBGP маршрутизатор обычно подставляет собственный адрес на этой сессии. При передаче по iBGP атрибут по умолчанию не меняется: маршрутизатор внутри AS получает в качестве следующего перехода адрес внешнего соседа на другой границе AS. Чтобы маршрут был пригоден, этот адрес должен быть достижим по таблице маршрутизации — через IGP или подключённую сеть. Если сеть между AS не известна внутреннему протоколу, маршрут остаётся в таблице BGP, но не используется; лекарство — команда next-hop-self на граничном маршрутизаторе либо анонс сетей стыков в IGP.
Атрибут ORIGIN указывает, как префикс попал в BGP: IGP (0) — по явной команде network, EGP (1) — из исторического протокола EGP, на практике не встречается, INCOMPLETE (2) — перераспределением из другого источника, например командой redistribute static. В выводе команд значения обозначаются символами i, e и ?.
LOCAL_PREF, MED и сообщества
Атрибут LOCAL_PREF (локальный приоритет) — главный инструмент политики выбора исходящего пути. Это число, чем больше, тем предпочтительнее маршрут; значение по умолчанию — 100. Атрибут действует только внутри одной AS: он передаётся по iBGP, чтобы все маршрутизаторы AS принимали согласованное решение, и никогда не передаётся по eBGP. Именно через LOCAL_PREF реализуется иерархия предпочтений Гао — Рексфорд: на входящих сессиях от клиентов устанавливается, например, 200, от пиров — 150, от провайдеров — 100. Поскольку сравнение LOCAL_PREF предшествует сравнению длины пути, клиентский маршрут будет выбран даже тогда, когда путь через пира короче.
Атрибут MULTI_EXIT_DISC (MED, межсистемный дискриминатор) — подсказка соседней AS о том, через какую из нескольких точек стыка лучше входить: меньшее значение предпочтительнее. Атрибут нетранзитивен — он передаётся только в соседнюю AS и дальше не распространяется — и по умолчанию сравнивается лишь между маршрутами, полученными из одной и той же соседней AS. Сосед вправе подсказку проигнорировать: LOCAL_PREF и длина пути проверяются раньше.
Атрибут COMMUNITIES (сообщества) — это набор 32-битных меток, которые маршрутизатор прикрепляет к маршруту 4. Метка записывается как ASN:значение, где старшие 16 бит — номер AS, определяющей смысл метки. Сообщества не влияют на выбор маршрута сами по себе: они служат для передачи намерений между сетями и между маршрутизаторами одной сети. Провайдер помечает маршруты по происхождению («получен от клиента», «получен на IX во Франкфурте») и затем фильтрует экспорт по меткам, а клиентам публикует сообщества действий: например, метка 64501:70 от клиента означает «установите этому маршруту LOCAL_PREF 70», что позволяет клиенту управлять входящим трафиком. Определены общеизвестные сообщества: NO_EXPORT (65535:65281) — не передавать маршрут за пределы AS, NO_ADVERTISE (65535:65282) — не передавать никому 4, а также BLACKHOLE (65535:666, RFC 7999) — просьба отбрасывать трафик к префиксу, применяемая при отражении DDoS-атак.
Шестнадцати бит для номера AS в обычном сообществе недостаточно для четырёхбайтовых номеров, поэтому введены большие сообщества (англ. large communities) — тройки 32-битных чисел вида 4200000001:1:70 5.
Наконец, вес (англ. weight) — не атрибут протокола, а локальное свойство маршрута в реализациях Cisco и FRR: число, действующее на одном маршрутизаторе и проверяемое раньше всех атрибутов. Локально созданные маршруты получают вес 32768, полученные от соседей — 0.
Процесс выбора лучшего маршрута: пошаговый разбор
Маршрутизатор может получить один и тот же префикс от нескольких соседей. Все полученные варианты хранятся в таблице BGP (англ. Adj-RIB-In, затем Loc-RIB), но в таблицу маршрутизации устанавливается и соседям анонсируется только один — лучший. Сначала отбрасываются непригодные маршруты: отвергнутые входной политикой, содержащие собственный номер AS в пути, с недостижимым следующим переходом. Затем оставшиеся сравниваются по шагам; на каждом шаге отбрасываются все кандидаты, кроме лучших по данному критерию, и процесс останавливается, как только остаётся один. В FRR 10 порядок шагов следующий 12:
- Больший вес (
weight). - Больший
LOCAL_PREF. - Локально созданный маршрут (
network, агрегат, перераспределение) предпочтительнее полученного от соседа. - Более короткий
AS_PATH. - Меньший
ORIGIN: IGP лучше EGP, EGP лучше INCOMPLETE. - Меньший
MED— только среди маршрутов из одной соседней AS. - Маршрут от eBGP-соседа предпочтительнее маршрута от iBGP-соседа.
- Меньшая стоимость IGP до следующего перехода.
- Проверка многопутевой маршрутизации: если она включена, оставшиеся равные маршруты используются одновременно.
- Если оба маршрута получены по eBGP — предпочтительнее уже выбранный ранее (защита от колебаний).
- Меньший идентификатор маршрутизатора соседа (или
ORIGINATOR_IDдля отражённого маршрута). - Более короткий
CLUSTER_LIST. - Адрес соседа как последний критерий.
Шаги 4–8 и 11 соответствуют правилам разрешения неопределённости RFC 4271 1; шаги 1, 3, 9 и 10 — расширения реализаций, и их набор у разных производителей немного различается. На последнем шаге RFC 4271 предписывает предпочесть соседа с меньшим адресом; так же поступает и FRR (функция bgp_path_info_cmp), хотя его документация говорит о большем адресе. На практике до этого шага сравнение доходит крайне редко.
Разберём пример. Маршрутизатор R3 в AS 64502 получил пять маршрутов к префиксу 192.0.2.0/24. Маршруты от iBGP-соседей R1, R2 и R4 пришли с других граничных маршрутизаторов той же AS, где им уже был назначен LOCAL_PREF по типу отношения.
| № | Получен от | Тип | LOCAL_PREF | AS_PATH | ORIGIN | MED | IGP до NEXT_HOP | ID соседа |
|---|---|---|---|---|---|---|---|---|
| 1 | провайдер AS 64496 | eBGP | 100 | 64496 64503 | IGP | — | 0 | 198.51.100.200 |
| 2 | пир AS 64501, стык в Москве | eBGP | 150 | 64501 64503 | IGP | 20 | 0 | 198.51.100.1 |
| 3 | R1, пир AS 64501, стык в Петербурге | iBGP | 150 | 64501 64503 | IGP | 10 | 20 | 10.255.0.1 |
| 4 | R2, пир AS 64505 | iBGP | 150 | 64505 64504 64503 | IGP | — | 10 | 10.255.0.2 |
| 5 | R4, пир AS 64507 | iBGP | 150 | 64507 64503 | INCOMPLETE | — | 30 | 10.255.0.4 |
Шаг 1. Вес всех маршрутов равен 0 — без изменений.
Шаг 2. Наибольший LOCAL_PREF — 150. Маршрут 1 (100) отбрасывается, хотя по длине пути он не хуже остальных: политика «пир дешевле провайдера» срабатывает прежде любых технических критериев. Остаются 2, 3, 4, 5.
Шаг 3. Локальных маршрутов нет.
Шаг 4. Длина AS_PATH: у маршрутов 2, 3, 5 — 2, у маршрута 4 — 3. Маршрут 4 отбрасывается. Остаются 2, 3, 5.
Шаг 5. ORIGIN: у маршрута 5 значение INCOMPLETE — источник перераспределил префикс из другого протокола. Маршрут 5 отбрасывается. Остаются 2 и 3.
Шаг 6. Оба оставшихся маршрута получены из одной соседней AS 64501, поэтому их MED сравнимы: 10 меньше 20. AS 64501 сообщила, что предпочитает принимать трафик через петербургский стык, и выбран маршрут 3.
Итог: лучшим стал маршрут 3, полученный по iBGP, хотя рядом был маршрут 2 непосредственно от eBGP-соседа. Пример показывает важную особенность порядка: шаг «eBGP лучше iBGP» (7) проверяется после MED. Если бы MED совпадали или отсутствовали, решение принял бы шаг 7, и победил бы маршрут 2. Если бы маршрут 3 пришёл из другой AS, например 64508, сравнение MED было бы пропущено вовсе. Такой поатрибутный разбор — основной приём при объяснении любого неожиданного выбора BGP, и в лабораторной работе он выполняется как вручную, так и вспомогательным сценарием на Python.
В FRR результат выбора виден в подробном выводе для префикса: рядом с лучшим маршрутом указаны слово best и в скобках причина — шаг, на котором отсеян ближайший конкурент.
# в vtysh маршрутизатора AS 64500 из лабораторной работы
show bgp ipv4 unicast 192.0.2.0/24
BGP routing table entry for 192.0.2.0/24, version 7
Paths: (2 available, best #1, table default)
  Not advertised to any peer
  64501 64503
    10.1.1.3 from 10.1.1.3 (198.51.100.1)
      Origin IGP, valid, external, best (AS Path)
      Last update: ...
  64502 64501 64503
    10.1.2.3 from 10.1.2.3 (198.51.100.129)
      Origin IGP, valid, external
      Last update: ...
Лучший путь выбран на шаге сравнения длины AS_PATH, о чём говорит пометка best (AS Path). Строка Not advertised to any peer показывает действие выходной политики: маршрут, полученный от одного провайдера, клиент не передаёт ни одному соседу, в том числе другому провайдеру.
Политики маршрутизации, eBGP и iBGP
Политики импорта и экспорта
Политика BGP — это набор правил, применяемых к маршрутам на входе от соседа (импорт) и на выходе к соседу (экспорт). Входная политика решает, принять ли маршрут и с какими атрибутами (LOCAL_PREF, сообщества); выходная — передавать ли маршрут соседу и как его изменить (удлинить путь, добавить метки). В FRR, как и в большинстве реализаций, политики строятся из трёх элементов 12:
- список префиксов (
ip prefix-list) — упорядоченный набор правилpermit/denyпо префиксу и диапазону длин, напримерpermit 203.0.113.0/24 le 25; - список сообществ (
bgp community-list) и список путей (bgp as-path access-list, регулярные выражения надAS_PATH); - карта маршрутов (
route-map) — последовательность пронумерованных записей вида «если совпало (match ...), то разрешить или запретить и изменить атрибуты (set ...)». Маршрут, не совпавший ни с одной записью, отвергается: в конце карты подразумевается запрет.
Политика типичного провайдера по отношению к клиенту выглядит так: принимать только префиксы, которые клиент вправе анонсировать (список префиксов, составленный по реестру), назначать им высокий LOCAL_PREF и метку «клиентский», а отдавать клиенту все маршруты. По отношению к пиру: принимать его маршруты с меньшим LOCAL_PREF, отдавать только собственные и клиентские маршруты. Фрагмент такой политики в синтаксисе FRR:
ip prefix-list FROM-CUST-64500 seq 10 permit 203.0.113.0/24
bgp community-list standard C-CUSTOMER seq 10 permit 64501:100
!
route-map CUST64500-IN permit 20
 match ip address prefix-list FROM-CUST-64500
 set local-preference 200
 set community 64501:100 additive
exit
!
route-map PEER-OUT permit 10
 match community C-CUSTOMER
exit
!
router bgp 64501
 neighbor 10.1.1.2 remote-as 64500
 neighbor 10.1.3.3 remote-as 64502
 address-family ipv4 unicast
  neighbor 10.1.1.2 route-map CUST64500-IN in
  neighbor 10.1.3.3 route-map PEER-OUT out
 exit-address-family
Исторически многие реализации BGP по умолчанию принимали и анонсировали по eBGP всё подряд, и забытый фильтр приводил к утечкам. RFC 8212 потребовал противоположного поведения: без явно настроенной политики eBGP-сессия не должна ни принимать, ни передавать маршруты. В FRR это правило включено по умолчанию в профиле traditional и управляется командой bgp ebgp-requires-policy 12. Сессия при этом устанавливается, но в выводе show bgp summary в столбцах принятых или отправленных префиксов вместо числа стоит (Policy). Отключать проверку командой no bgp ebgp-requires-policy допустимо лишь в лабораторных стендах; в рабочей сети правильный ответ — написать политику, пусть даже route-map ALL permit 10, явно выражающую намерение.
Изменение политики не применяется к уже полученным маршрутам автоматически: маршрутизатор должен повторно пропустить их через фильтры. Для этого служит «мягкий» сброс clear bgp ipv4 unicast <сосед> soft in (запрос ROUTE-REFRESH) или soft out (повторная отправка своих маршрутов), не разрывающий сессию.
Управление исходящим и входящим трафиком
Управление трафиком в BGP асимметрично. Исходящим трафиком, то есть выбором, через какого соседа отправлять пакеты, автономная система управляет полностью: решение принимают её собственные маршрутизаторы, и основной инструмент — LOCAL_PREF на входящих маршрутах. Например, многодомная AS, у которой канал к провайдеру 64501 шире, назначает его маршрутам LOCAL_PREF 200 и весь исходящий трафик направляет туда, а второй канал оставляет резервным.
Входящим трафиком AS управляет только косвенно — она может лишь повлиять на решения чужих маршрутизаторов, изменяя то, что анонсирует. Инструменты, в порядке возрастания силы:
- удлинение пути (англ. AS path prepending): AS повторяет свой номер в анонсе резервному провайдеру несколько раз (
64500 64500 64500), делая путь через него длиннее. Это работает только для тех удалённых сетей, у которых выбор доходит до шага сравнения длины пути. Провайдер, для которого маршрут клиентский и имеетLOCAL_PREF200, выберет его при любой длине — удлинение пути не может перебить локальный приоритет; - сообщества действий: если провайдер их поддерживает, клиент меткой просит понизить
LOCAL_PREFсвоего маршрута в сети провайдера, и тот начинает предпочитать путь через пира или другого клиента. Это действует уже на решение провайдера, а не только удалённых сетей; - более специфичные префиксы: анонс 203.0.113.0/25 и 203.0.113.128/25 через разные каналы вместе с общим /24 гарантированно распределяет трафик, поскольку правило наибольшего совпадения префикса (тема 8) сильнее любого атрибута BGP. Цена — рост глобальной таблицы; многие провайдеры не принимают префиксы IPv4 длиннее /24.
MED также влияет на входящий трафик, но лишь между несколькими стыками с одним и тем же соседом.
iBGP, полносвязность и отражатели маршрутов
Если у автономной системы несколько граничных маршрутизаторов, маршруты, полученные одним из них по eBGP, нужно донести до остальных. Для этого служат сессии iBGP. Внутри AS путь не удлиняется — номер AS дописывается только на eBGP-границе, — поэтому AS_PATH не может защитить от петель внутри AS. RFC 4271 решает это жёстким правилом: маршрут, полученный от iBGP-соседа, не передаётся другим iBGP-соседям 1. Следствие — каждый маршрутизатор BGP в AS должен иметь сессию с каждым: полносвязная схема (англ. full mesh) из n маршрутизаторов требует n(n − 1)/2 сессий. Для 10 маршрутизаторов это 45 сессий, для 100 — 4950, и при добавлении нового маршрутизатора приходится перенастраивать все остальные.
Отражатели маршрутов (англ. route reflectors) снимают это ограничение 9. Отражатель — маршрутизатор, которому разрешено передавать iBGP-маршруты дальше: маршруты от своих клиентов он отражает всем, маршруты от обычных iBGP-соседей — только клиентам. Клиенту достаточно одной-двух сессий с отражателями. Для защиты от петель вводятся атрибуты ORIGINATOR_ID (идентификатор маршрутизатора, впервые внёсшего маршрут в AS; получив маршрут со своим идентификатором, маршрутизатор его отбрасывает) и CLUSTER_LIST (список кластеров, через которые маршрут уже отражался). iBGP обычно устанавливается между адресами петлевых интерфейсов, достижимыми через IGP, чтобы сессия переживала отказ отдельного канала; сам IGP переносит только внутренние адреса, а не сотни тысяч внешних префиксов — их несёт iBGP. Применение BGP внутри центров обработки данных вместо IGP рассматривается в теме 21.
Безопасность междоменной маршрутизации
Перехваты и утечки маршрутов: разбор инцидентов
BGP создавался в среде взаимного доверия и в базовой спецификации не проверяет, вправе ли AS анонсировать префикс и вправе ли она передавать полученный маршрут дальше. Любая AS может объявить чужой префикс, и соседи, не фильтрующие анонсы, распространят его. Различают два класса инцидентов.
Перехват префикса (англ. prefix hijack) — анонс чужого префикса от имени не той AS-источника, по ошибке или умышленно. Если перехватчик анонсирует тот же префикс, часть Интернета, для которой его путь короче, направит трафик ему. Если он анонсирует более специфичный префикс, трафик пойдёт к нему отовсюду, куда дошёл анонс, — правило наибольшего совпадения префикса сильнее любых атрибутов.
Классический пример — инцидент 24 февраля 2008 года, подробно восстановленный по данным коллекторов RIPE NCC 11. YouTube (AS36561) анонсировал префикс 208.65.152.0/22. Получив предписание властей заблокировать YouTube внутри страны, Pakistan Telecom (AS17557) в 18:47 UTC начал анонсировать более специфичный 208.65.153.0/24 — предполагалось, что только внутри своей сети, направляя трафик в никуда. Анонс ушёл к вышестоящему провайдеру PCCW Global (AS3491), который не фильтровал префиксы клиента и распространил его по всему миру; трафик YouTube со всего Интернета пошёл в Пакистан. В 20:07 YouTube начал анонсировать тот же /24, частично вернув трафик, в 20:18 — два ещё более специфичных /25, выигрывающих по правилу наибольшего совпадения везде, куда они дошли. В 21:01 PCCW отозвал маршруты Pakistan Telecom. Инцидент длился более двух часов и показал, что одна ошибка фильтрации у провайдера транзита превращает локальную ошибку в глобальную.
Утечка маршрутов (англ. route leak) — распространение маршрута за пределы, предусмотренные политикой, при правильной AS-источнике 8. Типичный случай — нарушение правила долины: многодомный клиент передаёт маршруты одного провайдера другому, и второй провайдер, назначающий клиентским маршрутам высокий LOCAL_PREF, начинает отправлять через клиента трафик к огромной части Интернета. Каналы клиента перегружаются, пакеты теряются. Так произошло 24 июня 2019 года: небольшая компания (AS396531) передала своему провайдеру Verizon (AS701) тысячи маршрутов, полученных от другого провайдера (DQE, AS33154), причём более специфичных — их сгенерировал так называемый оптимизатор BGP внутри DQE. Verizon не фильтровал префиксы клиента, и на несколько часов значительная часть трафика к Cloudflare, Amazon и другим сервисам пошла через малую сеть. Схема утечки показана на рисунке ниже; тот же сценарий воспроизводится в лабораторной работе.
Среди других известных инцидентов — анонс AS7007 в апреле 1997 года, «разрезавший» таблицу на префиксы /24 и на время сделавший небольшую AS точкой притяжения для значительной части Интернета; анонс около 37 тысяч чужих префиксов China Telecom 8 апреля 2010 года; перехват адресов DNS-сервиса Amazon Route 53 в апреле 2018 года с целью кражи криптовалюты. Отдельный случай — отказ Facebook 4 октября 2021 года: ошибочное изменение конфигурации привело к отзыву маршрутов к собственным DNS-серверам компании, и её сервисы стали недоступны примерно на шесть часов. Это не атака, но наглядная демонстрация того, что в BGP исчезнуть из Интернета можно несколькими сообщениями UPDATE.
Реестры маршрутизации IRR и фильтрация
Первая линия защиты — фильтрация анонсов клиентов на стороне провайдера: принимать от клиента только те префиксы, которые ему принадлежат. Источником сведений служат реестры маршрутизации (англ. Internet Routing Registry, IRR) — базы данных, где владельцы адресов публикуют объекты route («префикс P анонсируется AS N») и as-set («AS N передаёт маршруты таких-то клиентских AS»). Крупнейшие реестры ведут RIR (RIPE DB, ARIN IRR) и независимые операторы (RADB). Провайдер автоматически строит списки префиксов по as-set клиента инструментами вроде bgpq4. Ограничение IRR — слабая достоверность: в реестрах, не связанных с RIR, объект может зарегистрировать кто угодно, и они полны устаревших записей.
Вторая мера — ограничение числа префиксов (англ. maximum prefix): если клиент, обычно анонсирующий два префикса, внезапно прислал тысячу, сессия разрывается с NOTIFICATION «Cease». Третья — отбрасывание заведомо недопустимых анонсов: частных и документационных адресов (англ. bogons), префиксов IPv4 длиннее /24, путей с частными номерами AS. Эти практики продвигает инициатива MANRS.
RPKI и проверка источника маршрута
Инфраструктура открытых ключей для ресурсов (англ. Resource Public Key Infrastructure, RPKI) даёт криптографически проверяемую связь между префиксом и правом его анонсировать 2. Её иерархия повторяет иерархию распределения адресов: корневые сертификаты (якоря доверия) принадлежат пяти RIR, которые выдают сертификаты на адресные блоки своим членам 14. Владелец блока подписывает разрешение на анонс (англ. Route Origin Authorization, ROA): «префикс 203.0.113.0/24 с длиной до /24 может анонсировать AS 64500». Параметр maxLength задаёт наибольшую длину допустимых более специфичных префиксов; щедрый maxLength облегчает перехват более специфичным префиксом с подделанным путём, поэтому рекомендуется указывать точно анонсируемые длины.
ROA публикуются в репозиториях RIR. Специальные программы-валидаторы (Routinator, rpki-client, FORT) загружают их, проверяют подписи и передают маршрутизаторам готовый список пар «префикс, длина, AS» по протоколу RPKI-to-Router. Маршрутизатор относит каждый полученный маршрут к одному из трёх состояний проверки источника (англ. Route Origin Validation, ROV) 2:
Valid— существует ROA, покрывающий префикс, с той же AS-источником (последней вAS_PATH) и допустимой длиной;Invalid— префикс покрыт хотя бы одним ROA, но ни один не совпал по AS-источнику или по длине;NotFound— ни один ROA префикс не покрывает.
Политика большинства сетей, внедривших ROV: отбрасывать Invalid, остальные принимать. Применительно к инциденту 2008 года: если бы у YouTube был ROA на 208.65.152.0/22 с maxLength 22, анонс 208.65.153.0/24 от AS17557 получил бы статус Invalid и был бы отброшен везде, где работает ROV. В FRR проверка подключается модулем rpki и командой match rpki invalid в карте маршрутов 12. К середине 2020-х годов ROV внедрили крупнейшие провайдеры транзита и облачные платформы, а ROA покрывают более половины префиксов IPv4 глобальной таблицы.
Важно понимать границы ROV: он проверяет только AS-источник. Перехватчик, который подделает путь, дописав законную AS-источник в конец своего AS_PATH, проверку пройдёт. Защиту всего пути даёт протокол BGPsec (RFC 8205), где каждая AS подписывает путь, но из-за вычислительной стоимости и требования поддержки на всём пути он практически не развёрнут. Промежуточную защиту от подделки пути и утечек дают проекты ASPA (англ. Autonomous System Provider Authorization), находящийся в стадии стандартизации, и роли BGP.
Защита от утечек: роли BGP и атрибут OTC
Утечка маршрутов не нарушает ни один ROA: AS-источник законна. Защититься от неё можно только зная отношения между AS. RFC 9234 вводит роли BGP: каждая сторона сессии объявляет в OPEN возможность «роль» — provider, customer, peer, rs (сервер маршрутов IX) или rs-client, — и роли сторон должны быть согласованы (провайдер с клиентом, пир с пиром) 10. Кроме того, вводится атрибут «только клиентам» (англ. Only to Customer, OTC): маршрут, полученный от провайдера или пира, помечается номером AS, после чего его нельзя передать провайдеру или пиру. А маршрут с меткой OTC, пришедший от клиента, — признак утечки, и он отбрасывается. Тем самым правило долины, прежде существовавшее лишь в головах администраторов и в их картах маршрутов, становится частью протокола. В FRR роль задаётся командой neighbor <адрес> local-role customer и т. п. 12.
Anycast и наблюдение за глобальной маршрутизацией
Anycast
BGP позволяет нескольким географически разнесённым узлам анонсировать один и тот же префикс от одной AS. Каждая сеть Интернета выбирает ближайший по критериям BGP вариант, и пакеты к одному и тому же адресу попадают на разные серверы в зависимости от того, откуда они отправлены. Такая схема называется anycast («к любому из»). Так устроены корневые серверы DNS — 13 имён, за которыми стоят более 1900 экземпляров по всему миру, — публичные резолверы 1.1.1.1 и 8.8.8.8, сети доставки контента. Его ограничение следует из природы BGP: «ближайший» означает ближайший по политике и длине пути, а не по километрам или миллисекундам, и при изменении маршрутов TCP-соединение может переключиться на другой экземпляр, не знающий о нём. Поэтому anycast лучше всего подходит для коротких транзакций, например DNS поверх UDP. Подробнее anycast в контексте DNS рассматривается в теме 15.
Коллекторы маршрутов и инструменты наблюдения
Поскольку ни одна сеть не видит Интернет целиком, для наблюдения за глобальной маршрутизацией созданы коллекторы маршрутов (англ. route collectors) — маршрутизаторы, устанавливающие BGP-сессии с сотнями сетей по всему миру и записывающие все полученные UPDATE в архивы формата MRT. Крупнейшие проекты — RIPE RIS (RIPE NCC) и RouteViews (Университет Орегона). Архивы RIS позволили восстановить хронологию инцидента с YouTube по минутам 11. Поверх этих данных построены удобные инструменты:
- RIPEstat — веб-интерфейс и открытый программный интерфейс RIPE NCC: кто анонсирует префикс, история анонсов, видимость, состояние RPKI, сведения о AS;
- bgp.tools — обзор AS, префиксов, соседей вверх и вниз по иерархии, RPKI, а также whois-интерфейс для быстрых запросов из командной строки;
- looking glass («зеркало») — веб-интерфейс к маршрутизатору провайдера, позволяющий выполнить
show bgpилиtracerouteиз его сети и увидеть Интернет с чужой стороны; - PeeringDB — общая база сведений о сетях, точках обмена трафиком и ЦОД: какая сеть на каких IX присутствует, её политика пиринга, контакты.
Запрос к RIPEstat возвращает JSON; например, срез таблиц коллекторов для префикса публичного резолвера Cloudflare показывает, какие пути к нему видят пиры коллектора RRC01 в Лондоне:
curl -s "https://stat.ripe.net/data/looking-glass/data.json?resource=1.1.1.0/24" \
  | python3 -m json.tool | grep -E '"(as_path|peer|origin)"' | head -6
                        "as_path": "15692 13335",
                        "peer": "5.57.80.113",
                        "origin": "IGP",
                        "as_path": "8218 13335",
                        "peer": "5.57.80.210",
                        "origin": "IGP",
Пути из двух номеров — следствие того, что Cloudflare пирингуется на IX в Лондоне практически со всеми участниками. Проверка ROA для того же префикса показывает статус valid:
curl -s "https://stat.ripe.net/data/rpki-validation/data.json?resource=AS13335&prefix=1.1.1.0/24" \
  | python3 -c "import json,sys; d=json.load(sys.stdin)['data']; print(d['status'], d['validating_roas'])"
valid [{'origin': '13335', 'prefix': '1.1.1.0/24', 'validity': 'valid', 'max_length': 24}]
По этим данным видно, кто провайдер у вашего провайдера, какие пути ведут к крупным сервисам и подписаны ли префиксы ROA; в лабораторной работе они используются в заключительной части.
Итоги темы
Интернет — это сеть десятков тысяч автономных систем, каждая из которых самостоятельно определяет политику маршрутизации. Политика вытекает из экономики: клиент платит провайдеру за транзит, пиры бесплатно обмениваются трафиком своих клиентов. Из этих отношений следуют правила экспорта маршрутов и правило долины, а предпочтение клиентских маршрутов пиринговым и пиринговых провайдерским при соблюдении правил экспорта гарантирует устойчивость глобальной маршрутизации без центральной координации.
BGP-4 — протокол вектора путей, работающий поверх TCP на порту 179. Соседи задаются явно, сессия проходит состояния конечного автомата до Established, после чего маршруты передаются однократно в сообщениях UPDATE и далее лишь изменяются или отзываются; живость сессии поддерживают KEEPALIVE и время удержания. Список автономных систем в AS_PATH одновременно предотвращает петли и служит материалом для политики.
Выбор лучшего маршрута — последовательное сравнение атрибутов, где политика (weight, LOCAL_PREF) стоит раньше технических критериев (длина пути, ORIGIN, MED, тип сессии, стоимость IGP). Понимание этого порядка объясняет, почему удлинение пути не перебивает локальный приоритет провайдера, почему маршрут по iBGP может выиграть у eBGP-маршрута и почему исходящим трафиком AS управляет полностью, а входящим — лишь косвенно. Внутри AS маршруты распространяются по iBGP — полносвязно или через отражатели.
BGP изначально доверяет соседям, и ошибки фильтрации порождают перехваты и утечки, затрагивающие весь Интернет. Защита многоуровневая: фильтры префиксов по реестрам, ограничение числа префиксов, проверка источника по RPKI, роли BGP и атрибут OTC против утечек. Наблюдать результат можно публичными инструментами — RIPEstat, bgp.tools, PeeringDB и looking glass.
Темы 8–10 завершают рассмотрение маршрутизации IPv4. Следующая тема посвящена IPv6, где те же протоколы — OSPFv3 и многопротокольный BGP — переносят префиксы нового семейства адресов, а BGP в центрах обработки данных рассматривается в теме 21.
Литература
- Rekhter Y., Li T., Hares S. A Border Gateway Protocol 4 (BGP-4). — RFC 4271, IETF, 2006. https://www.rfc-editor.org/rfc/rfc4271
- Mohapatra P., Scudder J., Ward D., Bush R., Austein R. BGP Prefix Origin Validation. — RFC 6811, IETF, 2013. https://www.rfc-editor.org/rfc/rfc6811
- Vohra Q., Chen E. BGP Support for Four-Octet Autonomous System (AS) Number Space. — RFC 6793, IETF, 2012. https://www.rfc-editor.org/rfc/rfc6793
- Chandra R., Traina P., Li T. BGP Communities Attribute. — RFC 1997, IETF, 1996. https://www.rfc-editor.org/rfc/rfc1997
- Heitz J., Snijders J., Patel K., Bagdonas I., Hilliard N. BGP Large Communities Attribute. — RFC 8092, IETF, 2017. https://www.rfc-editor.org/rfc/rfc8092
- Bates T., Chandra R., Katz D., Rekhter Y. Multiprotocol Extensions for BGP-4. — RFC 4760, IETF, 2007. https://www.rfc-editor.org/rfc/rfc4760
- Gao L., Rexford J. Stable Internet Routing Without Global Coordination. — IEEE/ACM Transactions on Networking, 2001, Vol. 9, No. 6, P. 681–692, DOI: 10.1109/90.974523.
- Sriram K., Montgomery D., McPherson D., Osterweil E., Dickson B. Problem Definition and Classification of BGP Route Leaks. — RFC 7908, IETF, 2016. https://www.rfc-editor.org/rfc/rfc7908
- Bates T., Chen E., Chandra R. BGP Route Reflection: An Alternative to Full Mesh Internal BGP (IBGP). — RFC 4456, IETF, 2006. https://www.rfc-editor.org/rfc/rfc4456
- Azimov A., Bogomazov E., Bush R., Patel K., Sriram K. Route Leak Prevention and Detection Using Roles in UPDATE and OPEN Messages. — RFC 9234, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9234
- RIPE NCC. YouTube Hijacking: A RIPE NCC RIS case study. — 2008. https://www.ripe.net/about-us/news/youtube-hijacking-a-ripe-ncc-ris-case-study/
- FRRouting Project. FRR User Manual: BGP. — 2025. https://docs.frrouting.org/en/latest/bgp.html
- Kurose J. F., Ross K. W. Computer Networking: A Top-Down Approach. 8th ed. — Pearson, 2021.
- Lepinski M., Kent S. An Infrastructure to Support Secure Internet Routing. — RFC 6480, IETF, 2012. https://www.rfc-editor.org/rfc/rfc6480