
IPv6
В темах 6–8 сетевой уровень рассматривался на примере IPv4: адрес из 32 бит, разбиение на подсети, заголовок, ARP для поиска соседа, ICMP для сообщений об ошибках, фрагментация на маршрутизаторах, таблица маршрутизации. Все эти механизмы работают и сегодня, однако одно их свойство оказалось непреодолимым ограничением: 32-битное адресное пространство содержит чуть более 4,29 млрд адресов, и к началу 2010-х годов свободные адреса в мировом реестре закончились. Протокол IP версии 6 (англ. Internet Protocol version 6, IPv6) был разработан в 1990-е годы как ответ на эту угрозу и стал стандартом Интернета в 2017 году 1.
Было бы ошибкой считать IPv6 «тем же IPv4 с длинными адресами». Разработчики воспользовались сменой версии, чтобы пересмотреть решения, которые за двадцать лет эксплуатации IPv4 показали себя неудачными: заголовок стал фиксированной длины и лишился контрольной суммы, фрагментация переместилась с маршрутизаторов на отправителя, широковещательная рассылка исчезла и уступила место групповой, а протоколы ARP, ICMP-перенаправления и частично DHCP объединились в протокол обнаружения соседей поверх ICMPv6. Узел IPv6 способен сам построить себе глобальный адрес по объявлению маршрутизатора, без сервера адресов. Следствие для инженера: опыт IPv4 переносится на IPv6 лишь частично, и многие ошибки эксплуатации IPv6 — например, блокировка «ненужного» ICMP — возникают именно из-за механического переноса привычек.
Изложение построено так. Сначала обсуждается, почему понадобилась новая версия и что в ней изменилось принципиально. Затем рассматриваются адреса: запись, типы, адресный план и способы выбора идентификатора интерфейса. Третий раздел посвящён заголовку IPv6, цепочке расширяющих заголовков и обработке слишком больших пакетов. Четвёртый — ICMPv6 и протоколу обнаружения соседей, который заменяет ARP. Пятый — автонастройке узла: объявлениям маршрутизатора, SLAAC и DHCPv6. Завершает тему обзор маршрутизации IPv6, механизмов сосуществования с IPv4 и специфических вопросов безопасности. Примеры выводов команд получены в учебной топологии лабораторной работы 11: два хоста офиса h1 и h2, маршрутизатор r1 и сервер srv, адреса из документационного блока 2001:db8::/32 2.
Зачем понадобилась новая версия IP
Исчерпание адресов IPv4 и пределы обходных решений
Как было показано в теме 6, адреса IPv4 распределяются иерархически: организация IANA выделяет крупные блоки пяти региональным интернет-регистратурам (RIR), а те — провайдерам и организациям. Центральный пул IANA был исчерпан 3 февраля 2011 года, когда последние пять блоков /8 были разданы регистратурам. Региональные пулы закончились вслед за ним: в Азиатско-Тихоокеанском регионе (APNIC) — в апреле 2011 года, в Европе (RIPE NCC) последний блок /8 начали распределять в 2012 году, а в ноябре 2019 года регистратура объявила о полном исчерпании, в Северной Америке (ARIN) — в 2015 году.
Задолго до исчерпания стало ясно, что рост Интернета не остановится, и были предложены два направления. Первое — продлить жизнь IPv4: бесклассовая адресация CIDR (тема 6) позволила экономнее раздавать блоки, частные адреса RFC 1918 и трансляция адресов NAT (тема 14) — скрыть за одним публичным адресом целую сеть, а затем и трансляция на стороне провайдера (англ. Carrier-Grade NAT, CGNAT) — скрыть за одним адресом тысячи абонентов. Второе направление — новая версия протокола с бо́льшим адресным пространством. В 1994 году IETF выбрала проект, ставший IPv6; первая спецификация опубликована в 1995 году (RFC 1883), вторая — в 1998 году (RFC 2460), действующая — RFC 8200 (2017), имеющая статус стандарта Интернета STD 86 1.
Обходные решения IPv4 работают, но имеют цену. NAT разрушает сквозную адресуемость: узел за трансляцией не принимает входящие соединения без ухищрений, а протоколы, передающие адреса внутри данных, требуют специальных шлюзов. CGNAT вдобавок делит один адрес между многими абонентами, что затрудняет расследование инцидентов и работу сервисов, ограничивающих число запросов с адреса. Адреса IPv4 стали товаром со вторичным рынком. На этом фоне IPv6 предлагает адресное пространство из 2¹²⁸ ≈ 3,4·10³⁸ адресов, в котором вопрос дефицита снимается окончательно.
Что изменилось в IPv6 помимо длины адреса
Длина адреса выросла с 32 до 128 бит, но это лишь самое заметное изменение. Принципиальные отличия IPv6 от IPv4 можно сгруппировать так 114:
- Упрощённый заголовок фиксированной длины. Основной заголовок занимает ровно 40 байт и содержит 8 полей. Из него удалены длина заголовка, контрольная сумма и поля фрагментации; редко используемые функции вынесены в необязательные расширяющие заголовки, которые маршрутизатор, как правило, не просматривает.
- Фрагментация только у отправителя. Маршрутизатор IPv6 никогда не дробит пакет: слишком большой пакет отбрасывается, а отправителю возвращается сообщение ICMPv6 «Packet Too Big». Минимальный MTU любого канала, по которому передаётся IPv6, — 1280 байт.
- Нет широковещательной рассылки. Функции широковещания выполняют групповые (multicast) адреса, причём разрешение адресов соседей использует специальные группы, в которые входит лишь один-два узла сегмента.
- Обнаружение соседей вместо ARP. Поиск канального адреса соседа, проверка его достижимости, обнаружение маршрутизаторов, перенаправления и проверка уникальности адреса выполняются единым протоколом поверх ICMPv6.
- Автонастройка без сервера. Узел строит себе link-local адрес сам, а глобальный — по префиксу, объявленному маршрутизатором; сервер DHCPv6 нужен лишь там, где администратор хочет централизованно управлять адресами.
- Иерархия и агрегирование. Огромное пространство позволяет выдавать организациям блоки с запасом на десятилетия и строить адресный план по структуре сети, а не по нехватке адресов.
Важное следствие: IPv6 и IPv4 несовместимы на уровне пакетов. Узел, умеющий только IPv4, не может обратиться к узлу, имеющему только IPv6, без транслятора. Поэтому переход растянулся на десятилетия и опирается на механизмы сосуществования, которые рассматриваются в последнем разделе темы.
Состояние внедрения
Внедрение IPv6 шло медленно: выгоду получает сеть в целом, а затраты несёт каждый участник, которому, пока доступен IPv4 через NAT, переход не нужен. Тем не менее к середине 2020-х годов доля пользователей, обращающихся к сервисам Google по IPv6, по публичной статистике компании приблизилась к половине, а в ряде стран превышает её; мобильные операторы строят сети только на IPv6, а крупные поставщики контента поддерживают IPv6 повсеместно. Поэтому инженер обязан понимать IPv6 наравне с IPv4: в типичной сети оба протокола работают одновременно, и неисправность одного из них проявляется как «у части пользователей сайт открывается медленно».
Куда исчезли другие версии IP: от IPv5 до IPv9 и конкурс IPng
Естественный вопрос при знакомстве с IPv6: почему после четвёртой версии сразу последовала шестая, куда делись версии 5, 7, 8 и 9, и что означают упоминания «IPv8» или «IPv9» в литературе и новостях?
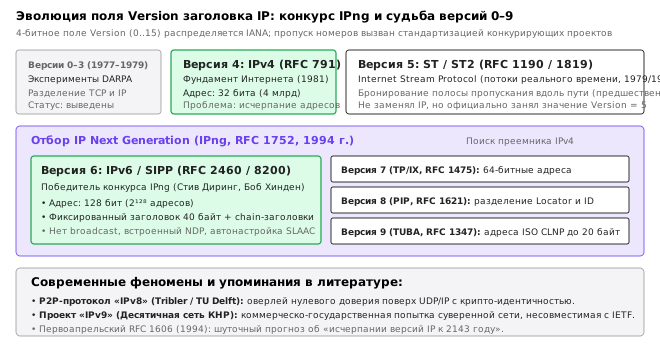
Номер версии протокола IP задаётся 4-битным полем Version в самом начале IP-заголовка, что допускает шестнадцать значений — от 0 до 15. Значения распределяются организацией IANA 15:
- Версии 0–3: экспериментальные протоколы межсетевого взаимодействия DARPA, разрабатывавшиеся в 1977–1979 годах в процессе разделения исходного протокола TCP на транспортный (TCP) и сетевой (IP) уровни. После завершения экспериментов эти номера были выведены из употребления, а стандартом стал IPv4 (RFC 791, версия 4).
- Версия 5 (ST / ST2 — Internet Stream Protocol): экспериментальный потоковый протокол реального времени, созданный в 1979 году (RFC 1190, обновлён как ST2 в RFC 1819 16). В отличие от датаграммного IP, ST устанавливал ориентированные на соединение мультимедийные потоки с гарантированной полосой пропускания и бронированием ресурсов вдоль маршрута (предшественник RSVP и протоколов ATM). Пакеты ST имели в поле версии значение
5. Протокол не предназначался для замены IPv4, но номер версии 5 оказался официально занят в реестре IANA.
В начале 1990-х годов угроза исчерпания адресного пространства IPv4 и лавинообразный рост таблиц маршрутизации BGP заставили IETF инициировать конкурс IPng (IP Next Generation), зафиксированный в RFC 1752 17. В конкурсе участвовало несколько альтернативных архитектур, каждой из которых присваивался свой номер версии:
- Версия 7 (TP/IX — The Next Internet, RFC 1475 18): проект Роберта Ульмана (Robert Ullmann), предлагавший расширение адресов до 64 бит, замену заголовков TCP и UDP новыми версиями с 32-битными номерами портов и улучшенную обработку потоков. Позже проект эволюционировал в CATNIP.
- Версия 8 (PIP — P Internet Protocol, RFC 1621 19): разработка Пола Фрэнсиса (Paul Francis, известного также как изобретатель концепции NAT). PIP разделял идентификацию узла и его маршрутный локатор и использовал цепочки директив пересылки для гибкой иерархической маршрутизации.
- Версия 9 (TUBA — TCP and UDP with Bigger Addresses, RFC 1347 20): предложение группы инженеров использовать уже готовый и стандартизованный Международной организацией по стандартизации (ISO) сетевой протокол CLNP (Connectionless Network Protocol, спецификация ISO 8473), поддерживающий адреса переменной длины NSAP (до 20 байт), и перенести поверх него транспортные протоколы TCP и UDP. Для TUBA был зарезервирован номер версии 9.
- Объединённый проект CATNIP (Common Architecture for the Next Internet Protocol, RFC 1707): попытка объединить лучшие черты TP/IX (версия 7), PIP (версия 8) и TUBA (версия 9) в универсальный конвергентный протокол.
Победителем отбора IPng в 1994 году стал проект SIPP (Simple Internet Protocol Plus) Стива Диринга и Боба Хиндена, объединивший концепции простого заголовка SIP с адресацией протокола IPAE. Для SIPP комитет IESG выделил свободный номер 6, ставший официальным названием нового стандарта — IPv6 1.
В истории сетевых технологий закрепились ещё два специфических феномена, связанных с номерами версий:
- Первоапрельский RFC 1606 (1994 г.) «A Historical Perspective On The Usage Of IP Version Numbers» 21: сатирический документ, пародирующий споры вокруг версий протоколов и прогнозирующий «неизбежное исчерпание версий IP к 2143 году» из-за слишком быстрой смены стандартов от IPv4 до IPv9.
- Китайский проект «IPv9» («Десятичная сеть» / Decimal Network): в конце 1990-х и начале 2000-х годов коммерческо-государственная группа в КНР анонсировала так называемый «китайский суверенный стандарт IPv9» с переменной длиной адреса (до 256 бит, записываемых десятичными цифрами) и собственной изолированной системой корневых серверов доменных имён. Проект не имел отношения к IETF (где номер 9 принадлежал TUBA), позиционировался как средство изоляции национального сегмента сети и был отвергнут международным инженерным сообществом как технически несовместимый с глобальным Интернетом.
- P2P-протокол «IPv8» (проект Tribler / TU Delft): в современных академических кругах название «IPv8» иногда используется как имя собственное для децентрализованного оверлейного протокола аутентифицированных датаграмм нулевого доверия (англ. Zero-Trust authenticated datagrams). Он работает поверх транспортных протоколов UDP/IPv4/IPv6, идентифицирует узлы криптографическими ключами и строит пиринговые оверлеи с блокчейн-репутацией TrustChain, не претендуя на изменение пакетных заголовков маршрутизаторов Интернета.
Адресация IPv6
Запись адреса и правила сокращения
Адрес IPv6 записывается как восемь групп по 16 бит, каждая — четырьмя шестнадцатеричными цифрами, через двоеточие 2:
2001:0db8:000a:0001:0000:0000:0000:0100
Такая запись громоздка, поэтому допускаются два сокращения. Во-первых, ведущие нули в каждой группе можно опустить: 000a превращается в a, 0000 — в 0. Во-вторых, одну последовательность из нескольких подряд идущих нулевых групп можно заменить двумя двоеточиями ::. Применив оба правила, получаем 2001:db8:a:1::100. Сокращение :: допустимо только один раз: адрес 2001:db8::1::1 неоднозначен, поскольку нельзя определить, сколько нулевых групп скрыто в каждом из двух мест.
Свобода записи порождает проблему: один адрес может быть записан многими способами (2001:db8:0:0:1::1, 2001:db8::1:0:0:1, 2001:0DB8::1:0:0:1), что затрудняет поиск по журналам и сравнение конфигураций. RFC 5952 устанавливает каноническую форму, которой обязаны придерживаться программы при выводе адресов 3:
- ведущие нули в группе опускаются всегда;
::заменяет самую длинную последовательность нулевых групп; при равной длине — первую слева;::не используется для одной нулевой группы: пишется2001:db8:0:1:1:1:1:1, а не2001:db8::1:1:1:1:1;- шестнадцатеричные цифры записываются строчными буквами.
Рассмотрим пример. Адрес 2001:0db8:0000:0000:0001:0000:0000:0001 содержит две серии нулей по две группы. По правилу «самая длинная, при равенстве — первая» каноническая запись — 2001:db8::1:0:0:1. Проверить себя можно модулем ipaddress языка Python, который выводит адреса в форме RFC 5952:
import ipaddress
print(ipaddress.ip_address("2001:0db8:0000:0000:0001:0000:0000:0001"))
print(ipaddress.ip_address("2001:0DB8:0:0:0:0:0:0100").exploded)
2001:db8::1:0:0:1
2001:0db8:0000:0000:0000:0000:0000:0100
Префикс сети записывается так же, как в IPv4, через косую черту: 2001:db8:a:1::/64 означает, что первые 64 бита — номер сети. Отдельная сложность возникает в URL: двоеточие в нём отделяет номер порта, поэтому адрес IPv6 заключается в квадратные скобки:
http://[2001:db8:a:2::10]:8080/index.html
Типы адресов и их префиксы
Архитектура адресации IPv6 различает три вида адресов по способу доставки 2. Индивидуальный (англ. unicast) адрес идентифицирует один интерфейс. Групповой (англ. multicast) — множество интерфейсов, и пакет доставляется всем членам группы. Адрес любой рассылки (англ. anycast) назначается нескольким интерфейсам, обычно разных узлов, но пакет доставляется одному из них — ближайшему с точки зрения маршрутизации. Синтаксически anycast-адрес не отличается от индивидуального: его «люборассылочность» определяется тем, что один и тот же адрес настроен в нескольких местах. Широковещательных адресов в IPv6 нет.
Тип индивидуального адреса определяется его префиксом. Основные блоки сведены в таблицу.
| Префикс | Назначение | Пример |
|---|---|---|
::/128 | неопределённый адрес: «адреса ещё нет» (источник в DAD) | :: |
::1/128 | петлевой интерфейс (аналог 127.0.0.1) | ::1 |
::ffff:0:0/96 | адреса IPv4, отображённые в IPv6 (внутри API сокетов) | ::ffff:192.0.2.1 |
fe80::/10 | локальные для канала (link-local) | fe80::5054:ff:fe11:110 |
fc00::/7 | уникальные локальные (ULA), на практике fd00::/8 | fd3c:9a1e:52b4:1::10 |
2000::/3 | глобальные индивидуальные (выделяются IANA сегодня) | 2a00:1450:4010::8a |
2001:db8::/32 | для документации и учебников (RFC 3849) | 2001:db8:a:1::1 |
64:ff9b::/96 | общеизвестный префикс трансляции NAT64 (RFC 6052) | 64:ff9b::c000:221 |
ff00::/8 | групповые адреса | ff02::1 |
Локальный для канала (англ. link-local) адрес действует только в пределах одного сегмента: маршрутизатор никогда не пересылает пакеты с таким адресом получателя или отправителя в другой сегмент. Link-local адрес есть у каждого интерфейса с включённым IPv6, даже если глобального адреса нет, и именно с него узел ведёт служебный обмен: обнаружение соседей, объявления маршрутизаторов, сообщения протоколов маршрутизации. Поскольку префикс fe80::/64 одинаков на всех интерфейсах, адрес fe80::1 сам по себе не указывает, через какой интерфейс отправлять пакет. Поэтому при обращении к link-local адресу указывается идентификатор зоны (англ. zone index) — имя интерфейса после знака %:
ip netns exec h1 ping -6 -c 2 fe80::1%eth0
PING fe80::1%eth0(fe80::1%eth0) 56 data bytes
64 bytes from fe80::1%eth0: icmp_seq=1 ttl=64 time=0.098 ms
64 bytes from fe80::1%eth0: icmp_seq=2 ttl=64 time=0.057 ms
Уникальные локальные адреса (англ. Unique Local Addresses, ULA, RFC 4193) — аналог частных адресов IPv4 из RFC 1918, но с важным отличием. Организация не берёт общий для всех блок вроде 10.0.0.0/8, а генерирует случайный 40-битный глобальный идентификатор, получая префикс /48 вида fdXX:XXXX:XXXX::/48. Вероятность совпадения префиксов двух организаций ничтожна, поэтому при слиянии компаний или соединении сетей через VPN перенумерация, как правило, не требуется. ULA не маршрутизируются в Интернете и применяются для внутренних служб, которым не нужен выход наружу.
Глобальные индивидуальные адреса (англ. Global Unicast Addresses, GUA) маршрутизируются в Интернете. Сегодня IANA распределяет их из блока 2000::/3, то есть адреса начинаются с цифры 2 или 3. Блок 2001:db8::/32 зарезервирован для документации — им пользуется и настоящий курс.
Групповые адреса начинаются с ff. Следующие 4 бита — флаги, ещё 4 бита — область действия (англ. scope): 1 — интерфейс, 2 — канал, 5 — площадка, e — глобальная. Поэтому ff02::1 означает «все узлы данного канала», ff02::2 — «все маршрутизаторы канала», ff05::1:3 — «все серверы DHCPv6 площадки». Особая разновидность — групповые адреса запрашиваемого узла (англ. solicited-node), которые заменяют широковещание в протоколе обнаружения соседей; они рассматриваются в четвёртом разделе.
Наконец, каждый интерфейс IPv6 имеет одновременно несколько адресов: link-local, один или несколько глобальных (постоянный и временные), возможно ULA, а также состоит в нескольких группах. Это одно из главных отличий от IPv4, где интерфейс обычно имеет один адрес. Выбор адреса отправителя для каждого исходящего пакета выполняется по правилам RFC 6724: предпочитается адрес той же области действия, что и у получателя, не устаревший, с наибольшим общим префиксом.
Структура глобального адреса и адресный план
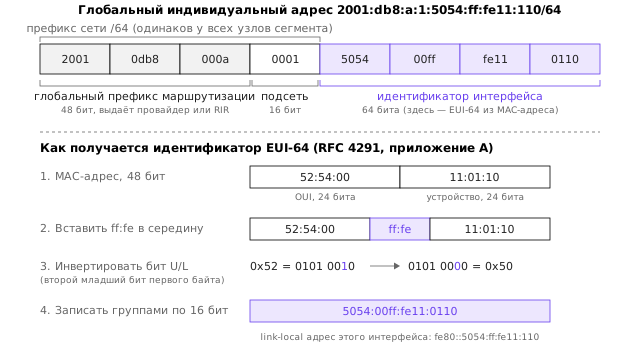
Глобальный индивидуальный адрес делится на три части 2: глобальный префикс маршрутизации, который выдаёт провайдер или регистратура; идентификатор подсети, которым распоряжается сама организация; идентификатор интерфейса (англ. Interface Identifier, IID), выбираемый узлом. Для всех глобальных адресов, кроме начинающихся с двоичных 000, идентификатор интерфейса имеет длину 64 бита, поэтому длина префикса сегмента локальной сети в IPv6 практически всегда равна /64. Это не рекомендация, а условие работы автонастройки: SLAAC строит адрес из 64-битного префикса и 64-битного идентификатора. Подсети длиннее /64 применяются лишь на звеньях «точка — точка» между маршрутизаторами (/127, RFC 6164) и для петлевых адресов (/128).
Структура адреса показана на рисунке ниже на примере адреса хоста h1 из лабораторной работы.
Типовые размеры выделений определяются политиками регистратур и рекомендациями IETF (RFC 6177): организация получает префикс /48, домашний абонент — от /56 до /48, отдельный сегмент — /64. Рекомендация RIPE NCC (документ RIPE-690) прямо советует выдавать бизнес-клиентам /48, а частным абонентам — /56. Посчитаем, что это означает для «Северного узла», получившего от провайдера блок 2001:db8:a::/48. На идентификатор подсети остаётся 64 − 48 = 16 бит, то есть 2¹⁶ = 65 536 подсетей /64. В каждой подсети 2⁶⁴ ≈ 1,8·10¹⁹ адресов. Задача адресного плана в IPv6, таким образом, противоположна задаче IPv4: экономить адреса не нужно, нужно сделать план читаемым и агрегируемым.
Удобный приём — кодировать структуру сети в 16 битах подсети по полубайтам, так чтобы границы совпадали с шестнадцатеричными цифрами. Например, первая цифра — площадка, вторая — назначение, две последние — номер сегмента:
| Подсеть | Площадка | Назначение | Сегмент |
|---|---|---|---|
2001:db8:a:1001::/64 | 1 — главный офис | 0 — пользователи | 01 — бухгалтерия |
2001:db8:a:1002::/64 | 1 — главный офис | 0 — пользователи | 02 — разработка |
2001:db8:a:1101::/64 | 1 — главный офис | 1 — серверы | 01 — серверная |
2001:db8:a:2001::/64 | 2 — филиал | 0 — пользователи | 01 — общий |
Тогда все сети главного офиса агрегируются в один маршрут 2001:db8:a:1000::/52, все сети филиала — в 2001:db8:a:2000::/52, а правило межсетевого экрана «серверы главного офиса» записывается как 2001:db8:a:1100::/56. В учебной топологии лабораторной работы для краткости используются подсети 2001:db8:a:1::/64 (офис) и 2001:db8:a:2::/64 (серверная).
Идентификатор интерфейса: EUI-64, стабильные и временные адреса
Остаётся вопрос, откуда берутся младшие 64 бита адреса. Исторически первый способ — модифицированный формат EUI-64 (RFC 4291, приложение A) 2. Из 48-битного MAC-адреса интерфейса строится 64-битный идентификатор: между третьим и четвёртым байтами вставляются байты ff:fe, а второй младший бит первого байта (бит U/L, «универсальный/локальный») инвертируется. Возьмём MAC-адрес хоста h1 52:54:00:11:01:10. Первый байт 0x52 = 0101 0010; после инверсии второго младшего бита получаем 0101 0000 = 0x50. Вставка ff:fe даёт 50:54:00:ff:fe:11:01:10, или в группах по 16 бит 5054:00ff:fe11:0110. Отсюда link-local адрес fe80::5054:ff:fe11:110, который действительно видим в выводе команды:
ip netns exec h1 ip -6 addr show dev eth0
2: eth0@if3: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP group default qlen 1000 link-netns sw
    inet6 fe80::5054:ff:fe11:110/64 scope link
       valid_lft forever preferred_lft forever
Инверсия бита U/L объясняется удобством ручной настройки: у глобально уникального MAC-адреса производителя этот бит равен нулю, после инверсии в IID он становится единицей, а вручную назначенные короткие идентификаторы вроде ::1 получают нулевой бит, что означает «локально назначен» — и администратору не приходится писать ::200:0:0:1.
EUI-64 прост, но у него серьёзный недостаток: идентификатор интерфейса не меняется при смене сети. Ноутбук с одним и тем же MAC-адресом в офисе, кафе и дома получает адреса с одинаковыми младшими 64 битами, и любой сервер, видящий эти адреса, может отслеживать перемещения устройства. Кроме того, MAC-адрес раскрывает производителя сетевой карты, а знание OUI сужает пространство перебора при сканировании. Поэтому IETF рекомендует по умолчанию не использовать EUI-64 (RFC 8064) и предлагает два альтернативных механизма.
Стабильные семантически непрозрачные идентификаторы (RFC 7217) вычисляются как криптографическая хеш-функция от префикса сети, имени интерфейса, секретного ключа узла и счётчика попыток DAD 8. В одной и той же сети узел всегда получает один и тот же адрес — это удобно для журналов и правил доступа, — а при переходе в другую сеть адрес меняется непредсказуемо, и отследить устройство по нему нельзя. Временные адреса (RFC 8981) решают иную задачу: они случайны, имеют короткое время жизни (по рекомендации стандарта предпочтительное — сутки, действительное — двое суток) и периодически заменяются новыми 9. Узел использует их как адрес отправителя для исходящих соединений, а стабильный адрес — для входящих. В Linux выбор задаётся параметрами ядра addr_gen_mode (0 — EUI-64, 2 — стабильный по RFC 7217, 3 — случайный) и use_tempaddr (0 — временные адреса не создаются, 2 — создаются и предпочитаются для исходящих соединений) 13. Настольные дистрибутивы, как правило, включают временные адреса, а серверы и маршрутизаторы — нет. Вот как выглядит интерфейс хоста h2 после включения временных адресов и получения префикса от маршрутизатора:
inet6 2001:db8:a:1:ecdc:5c19:cf9c:c6a9/64 scope global temporary dynamic
   valid_lft 3596sec preferred_lft 3596sec
inet6 2001:db8:a:1:5054:ff:fe11:120/64 scope global dynamic mngtmpaddr
   valid_lft 3596sec preferred_lft 3596sec
inet6 fe80::5054:ff:fe11:120/64 scope link
   valid_lft forever preferred_lft forever
Временный адрес помечен словом temporary, а адрес, служащий шаблоном для порождения временных, — mngtmpaddr. Время жизни временного адреса здесь ограничено сверху временем жизни объявленного префикса (1 ч).
Заголовок IPv6 и обработка пакета
Основной заголовок
Основной заголовок IPv6 имеет фиксированную длину 40 байт: 8 байт служебных полей и два адреса по 16 байт 1. Формат показан на рисунке ниже.
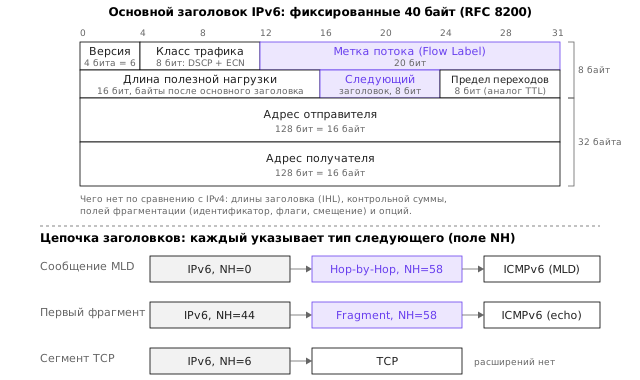
Назначение полей:
- Версия (англ. Version), 4 бита: число 6.
- Класс трафика (англ. Traffic Class), 8 бит: те же 6 бит DSCP и 2 бита ECN, что и в байте DSCP/ECN заголовка IPv4 (тема 7); используется для приоритизации и явного уведомления о перегрузке (тема 13).
- Метка потока (англ. Flow Label), 20 бит: отправитель помечает пакеты одного потока одинаковым значением, чтобы маршрутизаторы могли распределять потоки по равноценным путям (ECMP) без разбора заголовков транспортного уровня. Linux заполняет метку псевдослучайным значением, вычисленным из адресов и портов соединения (в захвате это видно как
flowlabel 0x810f7). - Длина полезной нагрузки (англ. Payload Length), 16 бит: число байтов после основного заголовка, включая расширяющие заголовки. В отличие от поля «Общая длина» IPv4, сам основной заголовок не учитывается.
- Следующий заголовок (англ. Next Header), 8 бит: тип заголовка, непосредственно следующего за основным. Значения те же, что в поле «Протокол» IPv4: 6 — TCP, 17 — UDP, 58 — ICMPv6, плюс номера расширяющих заголовков.
- Предел переходов (англ. Hop Limit), 8 бит: уменьшается на единицу каждым маршрутизатором; при достижении нуля пакет отбрасывается с сообщением ICMPv6 «Time Exceeded». Это прямой аналог TTL, переименованный в соответствии с реальным смыслом: счёт идёт по переходам, а не по секундам.
- Адрес отправителя и адрес получателя, по 128 бит.
Сравнение с заголовком IPv4 показывает, что изменилось по существу.
| Поле IPv4 | Судьба в IPv6 | Причина |
|---|---|---|
| Длина заголовка (IHL) | удалено | основной заголовок всегда 40 байт |
| Контрольная сумма заголовка | удалено | ошибки ловят CRC канального уровня и контрольные суммы TCP/UDP; маршрутизатору не нужно пересчитывать сумму после уменьшения Hop Limit |
| Идентификатор, флаги, смещение | перенесены в расширяющий заголовок Fragment | маршрутизаторы не фрагментируют |
| Опции | заменены расширяющими заголовками | обрабатываются только там, где нужны |
| TTL | переименовано в Hop Limit | смысл не изменился |
| Протокол | переименовано в Next Header | указывает и на расширения |
| — | добавлена метка потока | классификация потоков без разбора транспорта |
Удаление контрольной суммы делает обязательной контрольную сумму UDP: в IPv4 она могла быть нулевой, в IPv6 нулевое значение недопустимо, потому что иначе ни один уровень не защищал бы адреса от искажения (подробно о контрольной сумме и псевдозаголовке UDP — в теме 12).
Расширяющие заголовки
Функции, которые в IPv4 реализовывались опциями, в IPv6 вынесены в расширяющие заголовки (англ. extension headers), образующие цепочку: поле Next Header основного заголовка указывает тип первого расширения, поле Next Header первого расширения — тип второго, и так до заголовка транспортного уровня 1. Стандарт определяет следующие расширяющие заголовки и рекомендуемый порядок их следования:
| Номер | Заголовок | Назначение |
|---|---|---|
| 0 | Hop-by-Hop Options | опции, которые обязан просматривать каждый узел на пути (например, Router Alert в MLD) |
| 60 | Destination Options | опции для получателя |
| 43 | Routing | список промежуточных узлов (сегментная маршрутизация SRv6 — RFC 8754) |
| 44 | Fragment | сведения о фрагменте |
| 51 | Authentication Header (AH) | аутентификация IPsec (тема 19) |
| 50 | Encapsulating Security Payload (ESP) | шифрование IPsec (тема 19) |
| 59 | No Next Header | за заголовком ничего нет |
Принципиально, что все расширения, кроме Hop-by-Hop, обрабатывает только получатель, указанный в поле адреса назначения. Это позволило сделать пересылку на маршрутизаторе быстрой: ему достаточно просмотреть 40 байт фиксированного формата. Цепочку заголовков можно наблюдать на сообщении протокола обнаружения групп MLD, которое Linux рассылает при поднятии интерфейса:
:: > ff02::16: HBH (rtalert: 0x0000) (padn) [icmp6 sum ok] ICMP6, multicast listener report v2,
   1 group record(s) [gaddr ff02::1:ff11:110 to_ex { }]
Здесь основной заголовок содержит Next Header = 0 (Hop-by-Hop), заголовок Hop-by-Hop несёт опцию Router Alert и указывает Next Header = 58 (ICMPv6). Практическое следствие для анализа трафика: фильтр icmp6 программы tcpdump проверяет лишь поле Next Header основного заголовка и такие сообщения не покажет — надо использовать более общий фильтр ip6.
Гибкость расширяющих заголовков обернулась и проблемами. Заголовок Routing типа 0 позволял отправителю указать произвольный список промежуточных узлов, что использовалось для усиления атак, и был запрещён в 2007 году (RFC 5095). Длинные цепочки расширений затрудняют работу межсетевых экранов и балансировщиков, которым нужно добраться до номеров портов, поэтому пакеты с расширяющими заголовками в Интернете нередко отбрасываются. Измерения показали, что заметная доля путей теряет пакеты с заголовками Fragment, Hop-by-Hop или Destination Options (RFC 7872). Поэтому на практике расширения используют внутри управляемых сетей (SRv6 у провайдеров, IPsec), а в Интернете их стараются избегать.
Фрагментация у отправителя и минимальный MTU
В IPv4 маршрутизатор, получивший пакет больше MTU исходящего канала, мог раздробить его (если не установлен флаг DF), и сборка выполнялась получателем (тема 7). IPv6 отказался от этой возможности: фрагментация на маршрутизаторе требует ресурсов, усложняет аппаратную пересылку, а потеря одного фрагмента губит весь пакет. Маршрутизатор IPv6 отбрасывает слишком большой пакет и посылает отправителю сообщение ICMPv6 «Packet Too Big» (тип 2) с MTU следующего канала 6. Отправитель запоминает уменьшенный MTU пути до данного получателя и далее либо уменьшает размер сегментов (TCP), либо фрагментирует пакеты сам, добавляя расширяющий заголовок Fragment. Этот механизм — обнаружение MTU пути (англ. Path MTU Discovery, PMTUD) — для IPv6 описан в RFC 8201 12 и, в отличие от IPv4, является единственным способом пропустить большой пакет через узкое звено.
Чтобы отправителю не приходилось начинать совсем вслепую, стандарт требует, чтобы каждый канал передавал пакеты IPv6 размером не менее 1280 байт; если канальный уровень не способен на это, он обязан сам фрагментировать и собирать кадры ниже уровня IP 1. Узел, не желающий выполнять PMTUD, может просто не отправлять пакетов больше 1280 байт.
Рассмотрим числовой пример из лабораторной работы. На звене r1 — srv установлен MTU 1280 байт, на сегменте офиса — 1500. Хост h1 отправляет эхо-запрос с 1400 байтами данных. Размер пакета: 40 байт основного заголовка + 8 байт заголовка ICMPv6 + 1400 байт данных = 1448 байт, что больше 1280. Маршрутизатор r1 отбрасывает пакет и отвечает «Packet Too Big, mtu 1280». В сообщение об ошибке вкладывается начало исходного пакета — столько, чтобы сообщение не превысило минимальный MTU: 1280 − 40 − 8 = 1232 байта, поэтому длина полезной нагрузки сообщения равна 8 + 1232 = 1240 байт. Повторный запрос h1 фрагментирует сам. В первый фрагмент помещается 1280 − 40 − 8 = 1232 байта фрагментируемой части (смещение должно быть кратно 8 байтам, и 1232 = 154 · 8 подходит), во второй — оставшиеся 1408 − 1232 = 176 байт. Захват подтверждает расчёт:
2001:db8:a:1::10 > 2001:db8:a:2::10: ICMP6, echo request, id 39288, seq 1   (payload length: 1408)
2001:db8:a:1::1 > 2001:db8:a:1::10: ICMP6, packet too big, mtu 1280         (payload length: 1240)
2001:db8:a:1::10 > 2001:db8:a:2::10: frag (0x4e81cf1e:0|1232) ICMP6, echo request, id 35657, seq 1
2001:db8:a:1::10 > 2001:db8:a:2::10: frag (0x4e81cf1e:1232|176)
Запись frag (0x4e81cf1e:0|1232) означает: идентификатор фрагментированного пакета 0x4e81cf1e (32 бита против 16 в IPv4), смещение 0, длина данных 1232 байта. Сведения о сниженном MTU пути ядро хранит в кеше маршрутов и показывает командой ip -6 route get; в Linux такая запись по умолчанию устаревает через 600 с 13:
2001:db8:a:2::10 from :: via fe80::1 dev eth0 src 2001:db8:a:1::10 metric 1024 expires 596sec mtu 1280 pref medium
Отсюда главная эксплуатационная опасность IPv6: если сообщения Packet Too Big отфильтрованы где-то на пути, отправитель так и не узнаёт о малом MTU, и большие пакеты бесследно исчезают — возникает «чёрная дыра» PMTUD, знакомая по теме 7, но в IPv6 обойти её фрагментацией на маршрутизаторе уже нельзя. Типичный симптом — ping и установка TCP-соединения работают, а передача больших объёмов (загрузка страницы, копирование файла) зависает.
ICMPv6 и протокол обнаружения соседей
ICMPv6: сообщения об ошибках и информационные сообщения
Протокол управляющих сообщений ICMPv6 (RFC 4443) выполняет в IPv6 гораздо больше функций, чем ICMP в IPv4 6. Номер протокола в поле Next Header — 58. Сообщения делятся на два класса: сообщения об ошибках (типы 0–127) и информационные (128–255). Кроме диагностики, на ICMPv6 построены протокол обнаружения соседей и протокол обнаружения групповых слушателей (англ. Multicast Listener Discovery, MLD), заменивший IGMP.
| Тип | Сообщение | Назначение |
|---|---|---|
| 1 | Destination Unreachable | нет маршрута, запрещено политикой, порт недостижим и т. п. |
| 2 | Packet Too Big | пакет больше MTU канала; основа PMTUD |
| 3 | Time Exceeded | Hop Limit исчерпан или истекло время сборки фрагментов |
| 4 | Parameter Problem | ошибка в заголовке, неизвестный расширяющий заголовок |
| 128, 129 | Echo Request, Echo Reply | ping -6 |
| 133 | Router Solicitation (RS) | запрос объявления маршрутизатора |
| 134 | Router Advertisement (RA) | объявление маршрутизатора |
| 135 | Neighbor Solicitation (NS) | запрос канального адреса соседа, проверка дубликата |
| 136 | Neighbor Advertisement (NA) | ответ на NS, оповещение об изменении адреса |
| 137 | Redirect | перенаправление на лучший следующий переход |
| 143 | MLDv2 Report | сообщение о членстве в группах |
Таблица объясняет, почему перенос в IPv6 правила «ICMP не нужен, разрешим только ping» приводит к неработоспособной сети. Без NS и NA узлы не находят друг друга даже в одном сегменте, без RA не получают адреса и маршрут по умолчанию, без Packet Too Big теряют большие пакеты. Рекомендации по фильтрации ICMPv6 (RFC 4890) перечисляют сообщения, которые межсетевой экран обязан пропускать, — в лабораторной работе последствия ошибочного фильтра исследуются экспериментально.
Групповые адреса запрашиваемого узла
В IPv4 протокол ARP рассылает запрос «у кого адрес X?» широковещательно, и каждый узел сегмента обязан принять кадр, передать его операционной системе и разобрать, хотя ответить должен лишь один. В IPv6 широковещания нет, а запрос адресуется группе запрашиваемого узла (англ. solicited-node multicast address) — особому групповому адресу, построенному из искомого адреса 2. Правило таково: к префиксу ff02::1:ff00:0/104 присоединяются младшие 24 бита индивидуального адреса. Узел обязан вступить в группу запрашиваемого узла для каждого своего индивидуального адреса.
Пример. У хоста h1 link-local адрес fe80::5054:ff:fe11:110; младшие 24 бита — 11:01:10, поэтому его группа — ff02::1:ff11:110. Глобальный адрес 2001:db8:a:1:5054:ff:fe11:110 порождает ту же группу, так как младшие 24 бита совпадают. Групповому адресу IPv6 соответствует групповой MAC-адрес Ethernet: к префиксу 33:33 присоединяются младшие 32 бита группы (RFC 2464). Для ff02::1:ff11:110 получается 33:33:ff:11:01:10.
Выигрыш объясняется тем, что сетевая карта фильтрует групповые кадры аппаратно: она принимает только кадры на те групповые MAC-адреса, в которые подписана операционная система. Поскольку 24 бита совпадают у разных узлов крайне редко, запрос получает и обрабатывает, как правило, ровно один узел — тот, кого ищут. Коммутаторы с поддержкой отслеживания MLD (англ. MLD snooping) идут дальше и вообще не передают такие кадры в порты, за которыми нет членов группы. Чтобы коммутаторы знали о членстве, узел при поднятии интерфейса рассылает отчёт MLDv2 на адрес ff02::16 — именно его мы видели в предыдущем разделе.
Разрешение адресов и проверка достижимости соседа
Протокол обнаружения соседей (англ. Neighbor Discovery Protocol, NDP, RFC 4861) объединяет несколько задач, решавшихся в IPv4 разными средствами 4: разрешение адреса IPv6 в канальный адрес (вместо ARP), проверку достижимости соседа, обнаружение маршрутизаторов и префиксов, перенаправления, обнаружение дубликатов адресов. Все сообщения NDP передаются в ICMPv6 и отправляются с Hop Limit = 255. Получатель обязан отбросить сообщение NDP, у которого Hop Limit меньше 255: такое значение доказывает, что пакет не прошёл ни через один маршрутизатор, а значит, отправлен из того же сегмента. Это простая, но эффективная защита от подделки сообщений NDP из удалённых сетей.
Разрешение адреса устроено так. Узел, которому нужно отправить пакет соседу с адресом X, но неизвестен его MAC-адрес, отправляет NS на групповой адрес запрашиваемого узла для X, вкладывая в опцию Source Link-Layer Address собственный MAC. Сосед отвечает индивидуальным NA с флагом S (англ. Solicited, «в ответ на запрос») и опцией Target Link-Layer Address. Схема обмена показана на рисунке.
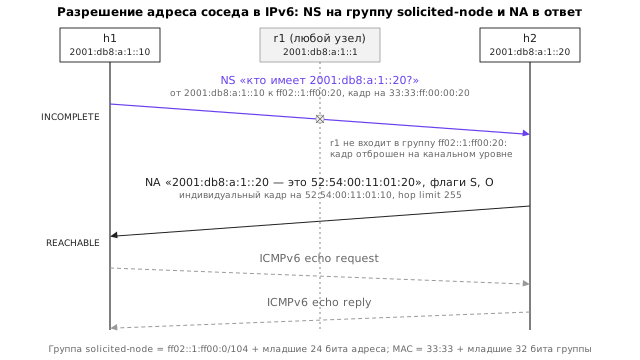
Реальный обмен при первом ping хоста h1 к адресу шлюза fe80::1, захваченный на коммутаторе:
52:54:00:11:01:10 > 33:33:ff:00:00:01, ... (hlim 255, ...) fe80::5054:ff:fe11:110 > ff02::1:ff00:1:
    ICMP6, neighbor solicitation, length 32, who has fe80::1
      source link-address option (1), length 8 (1): 52:54:00:11:01:10
52:54:00:11:01:01 > 52:54:00:11:01:10, ... (hlim 255, ...) fe80::1 > fe80::5054:ff:fe11:110:
    ICMP6, neighbor advertisement, length 32, tgt is fe80::1, Flags [router, solicited, override]
      destination link-address option (2), length 8 (1): 52:54:00:11:01:01
52:54:00:11:01:10 > 52:54:00:11:01:01, ... fe80::5054:ff:fe11:110 > fe80::1: ICMP6, echo request, id 16412, seq 1
52:54:00:11:01:01 > 52:54:00:11:01:10, ... fe80::1 > fe80::5054:ff:fe11:110: ICMP6, echo reply, id 16412, seq 1
Флаги NA имеют следующий смысл: R (англ. Router) — отправитель является маршрутизатором; S — ответ на запрос; O (англ. Override) — получатель должен заменить имеющуюся у него запись о соседе. Заметим, что запрос ушёл на MAC-адрес 33:33:ff:00:00:01, построенный из младших бит fe80::1, а ответ — индивидуальный.
Результат разрешения хранится в кеше соседей (англ. neighbor cache), который в Linux просматривается той же командой ip neigh, что и таблица ARP (тема 7):
ip netns exec h1 ip -6 neigh
fe80::1 dev eth0 lladdr 52:54:00:11:01:01 router REACHABLE
Состояния записи определяет алгоритм проверки недостижимости соседа (англ. Neighbor Unreachability Detection, NUD) 4. Запись создаётся в состоянии INCOMPLETE, пока ответ на NS не получен. После NA она переходит в REACHABLE и остаётся в нём примерно 30 с (базовое значение ReachableTime, умноженное на случайный коэффициент от 0,5 до 1,5). Затем запись становится STALE: адрес известен, но его актуальность не подтверждена. Когда узлу понадобится отправить пакет по записи STALE, он отправляет его и переводит запись в DELAY, ожидая 5 с подтверждения «сверху» — например, ответного TCP-сегмента. Если подтверждения нет, запись переходит в PROBE, и узел посылает до трёх индивидуальных NS с интервалом 1 с; при отсутствии ответа запись удаляется (FAILED). Если же три групповых NS в состоянии INCOMPLETE остались без ответа, отправителю пакета возвращается ошибка «адрес недостижим». В отличие от ARP, NUD проверяет достижимость соседа, а не только знание его адреса, и позволяет узлу быстро обнаружить отказ маршрутизатора по умолчанию и переключиться на другой.
Сообщение Redirect (тип 137) маршрутизатор посылает узлу, когда пакет можно было отправить напрямую соседу или через другой маршрутизатор того же сегмента.
Обнаружение дубликатов адресов
Прежде чем начать пользоваться новым индивидуальным адресом — link-local, полученным через SLAAC или назначенным вручную, — узел проверяет, что адрес не занят. Эта процедура называется обнаружением дубликатов адресов (англ. Duplicate Address Detection, DAD) и описана в RFC 4862 5. На время проверки адрес находится в состоянии «предварительный» (англ. tentative): узел не использует его как адрес отправителя и не отвечает на NS для него. Узел вступает в группу запрашиваемого узла и отправляет NS, в котором искомым адресом служит проверяемый, а адресом отправителя — неопределённый адрес :: (своего адреса у узла ещё нет). По умолчанию отправляется один такой NS (dad_transmits = 1), после чего узел ждёт 1 с. Если за это время пришёл NA для проверяемого адреса или чужой NS для того же адреса (другой узел проверяет тот же адрес одновременно), адрес признаётся дубликатом и не используется.
Конфликт адресов легко воспроизвести: назначим адрес 2001:db8:a:1::100 хосту h1, а через две секунды — тот же адрес хосту h2. Захват показывает DAD-запрос h2 и защиту адреса со стороны h1:
:: > ff02::1:ff00:100: ICMP6, neighbor solicitation, length 32, who has 2001:db8:a:1::100
      unknown option (14), length 8 (1):
        0x0000:  0705 1772 949f
2001:db8:a:1::100 > ff02::1: ICMP6, neighbor advertisement, length 32, tgt is 2001:db8:a:1::100, Flags [override]
      destination link-address option (2), length 8 (1): 52:54:00:11:01:10
Поскольку запрос пришёл с неопределённого адреса, h1 отвечает не индивидуально, а на группу всех узлов ff02::1, и без флага S. Опция с номером 14, которую tcpdump не умеет назвать, — случайное число (англ. nonce) из механизма улучшенного DAD (RFC 7527): по нему узел отличает собственный NS, вернувшийся к нему через петлю в сети, от чужого. В Linux он включён по умолчанию. Результат проверки на h2:
inet6 2001:db8:a:1::100/64 scope global dadfailed tentative
Адрес остался в состоянии tentative с отметкой dadfailed и не используется; ядро также пишет сообщение в системный журнал. Важно понимать ограничения DAD: проверка выполняется только при назначении адреса, поэтому узел, подключённый к сегменту позже (или вынутый кабелем на время проверки), конфликт не обнаружит. Кроме того, DAD задерживает готовность адреса примерно на секунду; в контейнерах и тестовых средах её иногда отключают параметром nodad, как сделано в лабораторной работе 12.
Автонастройка узла
Объявления маршрутизатора
В IPv4 узел получает адрес, маску, шлюз и DNS-серверы от сервера DHCP (тема 14) или из ручной настройки. В IPv6 основным источником сведений о сети служит сам маршрутизатор. Он периодически рассылает на адрес всех узлов ff02::1 объявление маршрутизатора (англ. Router Advertisement, RA, тип 134), а узел, только что поднявший интерфейс, может не ждать очередной рассылки и запросить объявление сообщением Router Solicitation (RS, тип 133) на адрес всех маршрутизаторов ff02::2 4. По умолчанию узел отправляет до трёх RS с интервалом 4 с, а маршрутизатор рассылает незапрошенные RA с интервалом от 200 до 600 с.
Объявление маршрутизатора несёт сведения, которые в IPv4 приходили бы из DHCP. Ниже — RA, разосланное маршрутизатором r1 (программой dnsmasq) в лабораторной работе:
fe80::5054:ff:fe11:101 > ff02::1: ICMP6, router advertisement, length 88
   hop limit 64, Flags [none], pref medium, router lifetime 1800s, reachable time 0ms, retrans timer 0ms
     prefix info option (3), length 32 (4): 2001:db8:a:1::/64, Flags [onlink, auto], valid time 3600s, pref. time 3600s
     mtu option (5), length 8 (1):  1500
     source link-address option (1), length 8 (1): 52:54:00:11:01:01
     rdnss option (25), length 24 (3):  lifetime 3600s, addr: 2001:db8:a:2::53
Разберём содержимое по частям:
- Hop limit 64 — значение предела переходов, которое узлам рекомендуется ставить в исходящих пакетах.
- Флаги M и O (здесь оба сброшены,
Flags [none]). Флаг M (англ. Managed address configuration) сообщает, что адреса выдаёт сервер DHCPv6; флаг O (англ. Other configuration) — что по DHCPv6 можно получить прочие параметры, например DNS-серверы. - Router lifetime 1800 s — сколько секунд узел может считать отправителя маршрутизатором по умолчанию. Нулевое значение означает «я маршрутизатор, но не используйте меня по умолчанию». Предпочтение
pref medium(RFC 4191) позволяет нескольким маршрутизаторам сегмента указать приоритет. - Опция Prefix Information — префикс
2001:db8:a:1::/64с флагами L (англ. on-link: адреса этого префикса достижимы напрямую, без маршрутизатора) и A (англ. autonomous: из префикса можно строить адрес через SLAAC), а также двумя временами жизни: действительным (англ. valid lifetime) и предпочтительным (англ. preferred lifetime). - Опция MTU — рекомендуемый MTU канала.
- Опция Source Link-Layer Address — MAC-адрес маршрутизатора, избавляющий узлы от отдельного разрешения адреса.
- Опция RDNSS (англ. Recursive DNS Server, RFC 8106) — адреса DNS-серверов. Долгое время узлы, получившие адрес через SLAAC, не имели стандартного способа узнать DNS-сервер без DHCPv6; опция RDNSS закрыла этот пробел.
Обратим внимание на адрес отправителя: RA всегда отправляется с link-local адреса маршрутизатора, и именно этот адрес узел запишет как следующий переход маршрута по умолчанию. Маршрутизаторы IPv6 и их соседи общаются link-local адресами, и это обеспечивает устойчивость: при перенумерации сети (смене глобального префикса провайдером) маршруты по умолчанию на хостах остаются верными.
SLAAC: автонастройка адреса без сохранения состояния
Получив RA с префиксом, у которого установлен флаг A, узел строит адрес самостоятельно. Этот механизм — автонастройка адреса без сохранения состояния (англ. Stateless Address Autoconfiguration, SLAAC, RFC 4862) 5 — называется так потому, что маршрутизатор не хранит сведений о том, какие адреса заняты: он лишь объявляет префикс, а уникальность адреса каждый узел проверяет сам через DAD. Последовательность шагов показана на рисунке.
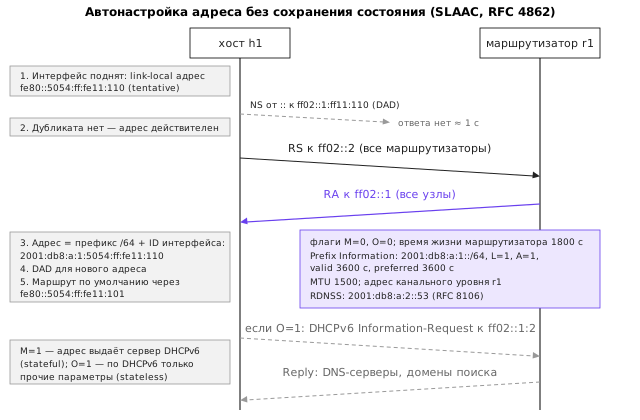
Пошагово:
- При поднятии интерфейса узел строит link-local адрес
fe80::/64+ идентификатор интерфейса и выполняет для него DAD. - Узел отправляет RS на
ff02::2с link-local адреса. - Маршрутизатор отвечает RA. Узел добавляет маршрут по умолчанию через link-local адрес маршрутизатора и маршрут к префиксу (флаг L).
- Для каждого префикса с флагом A длиной 64 бита узел строит адрес «префикс + идентификатор интерфейса» и выполняет DAD.
- Если включены временные адреса, узел дополнительно строит временный адрес со случайным идентификатором.
Результат автонастройки хоста h1 в лабораторной работе:
ip netns exec h1 ip -6 addr show dev eth0
ip netns exec h1 ip -6 route
inet6 2001:db8:a:1:5054:ff:fe11:110/64 scope global dynamic
   valid_lft 3597sec preferred_lft 3597sec
inet6 fe80::5054:ff:fe11:110/64 scope link
   valid_lft forever preferred_lft forever

2001:db8:a:1::/64 dev eth0 proto kernel metric 256 expires 3596sec pref medium
fe80::/64 dev eth0 proto kernel metric 256 pref medium
default via fe80::5054:ff:fe11:101 dev eth0 proto ra metric 1024 expires 1796sec hoplimit 64 pref medium
Слово dynamic и отсчитываемые времена жизни показывают, что адрес получен автоматически и будет жить, пока маршрутизатор продолжает объявлять префикс. Маршрут по умолчанию помечен proto ra и истекает через router lifetime. Два времени жизни адреса определяют его состояния. Пока не истекло предпочтительное время, адрес «предпочтительный» и используется для новых соединений. После него, но до истечения действительного времени, адрес становится «устаревшим» (англ. deprecated): уже установленные соединения продолжают им пользоваться, но новые выбирают другой адрес. По истечении действительного времени адрес удаляется. Этот механизм позволяет плавно перенумеровать сеть: маршрутизатор начинает объявлять новый префикс, а у старого объявляет нулевое предпочтительное время, и узлы постепенно переходят на новые адреса без разрыва существующих соединений.
Маршрутизатор сам не должен строить себе адреса по чужим RA и не должен принимать маршрут по умолчанию от соседних маршрутизаторов. В Linux это обеспечивается автоматически: при включённой пересылке (forwarding = 1) параметр accept_ra = 1 игнорируется, и объявления обрабатываются, только если явно задано accept_ra = 2 13 — этот режим нужен, например, домашнему маршрутизатору, получающему адрес от провайдера.
DHCPv6 с сохранением состояния и без него
Протокол динамической настройки узла для IPv6 (англ. Dynamic Host Configuration Protocol for IPv6, DHCPv6, RFC 8415) работает поверх UDP: клиент использует порт 546, сервер — 547 7. Клиент обращается к серверам по групповому адресу ff02::1:2 со своего link-local адреса, поэтому, в отличие от DHCP для IPv4, широковещание не требуется. Клиент и сервер идентифицируют себя уникальным идентификатором DUID (англ. DHCP Unique Identifier), а не MAC-адресом.
Возможны два режима. В режиме с сохранением состояния (англ. stateful), который включается флагом M в RA, сервер выдаёт клиенту адреса и учитывает их аренду — так же, как DHCP в IPv4. Обмен состоит из четырёх сообщений Solicit, Advertise, Request и Reply (или двух при быстром режиме Rapid Commit). В режиме без сохранения состояния (англ. stateless), который включается флагом O, адрес клиент строит через SLAAC, а у сервера запрашивает только прочие параметры двумя сообщениями Information-Request и Reply. В лабораторной работе такой сервер DHCPv6 сообщает клиенту адрес DNS-сервера; в его журнале видно содержимое ответа:
dnsmasq-dhcp: 6099700 sent size: 10 option:  1 client-id  00:03:00:01:52:54:00:11:01:10
dnsmasq-dhcp: 6099700 sent size: 14 option:  2 server-id  00:01:00:01:32:5f:69:31:00:00:00:00:00:00
dnsmasq-dhcp: 6099700 sent size: 16 option: 23 dns-server  2001:db8:a:2::53
dnsmasq-dhcp: 6099700 sent size:  4 option: 32 information-refresh-time  1h
Важная особенность: DHCPv6 не сообщает клиенту маршрут по умолчанию и длину префикса. Маршрутизатор по умолчанию узел всегда узнаёт из RA, поэтому сеть с DHCPv6 без объявлений маршрутизатора работать не будет. Это частая ошибка при переносе опыта IPv4.
Третья функция DHCPv6 — делегирование префиксов (англ. Prefix Delegation, PD): маршрутизатор провайдера выдаёт абонентскому маршрутизатору не адрес, а целый префикс (например, /56), который тот делит на подсети /64 для своих сегментов. Именно так домашний маршрутизатор получает адресное пространство для домашней сети.
Выбор между SLAAC и DHCPv6 — вопрос политики. SLAAC проще и поддерживается всеми операционными системами. Stateful DHCPv6 даёт централизованный учёт адресов, но поддерживается не всеми клиентами: в частности, Android не реализует получение адресов по DHCPv6, опираясь на SLAAC. Поэтому распространённая конфигурация офисной сети — SLAAC с опцией RDNSS и, при необходимости, stateless DHCPv6.
Маршрутизация, сосуществование с IPv4 и безопасность
Маршрутизация IPv6
Принципы маршрутизации IPv6 те же, что изложены в темах 8–10: таблица с правилом наибольшего совпадения префикса, маршрут по умолчанию ::/0, статические маршруты и протоколы динамической маршрутизации. В Linux маршрутизатор IPv6 включается параметром net.ipv6.conf.all.forwarding = 1, а таблица просматривается командой ip -6 route. Отличие, бросающееся в глаза, — следующий переход обычно указывается link-local адресом с обязательным указанием интерфейса:
ip -n srv -6 route add default via fe80::1 dev eth0
ip netns exec h1 ip -6 route get 2001:db8:a:2::10
2001:db8:a:2::10 from :: via fe80::5054:ff:fe11:101 dev eth0 proto ra src 2001:db8:a:1:5054:ff:fe11:110 metric 1024 hoplimit 64 pref medium
Утилиты ping -6 и tracepath -6 работают так же, как их аналоги для IPv4; последняя дополнительно сообщает MTU пути:
 1?: [LOCALHOST]                        0.019ms pmtu 1500
 1:  2001:db8:a:1::1                                       0.064ms
 2:  2001:db8:a:2::10                                      0.032ms reached
     Resume: pmtu 1500 hops 2 back 2
Протоколы динамической маршрутизации получили версии для IPv6. OSPFv3 (RFC 5340) сохраняет алгоритм и типы областей OSPFv2 (тема 9), но работает поверх IPv6, использует для соседства link-local адреса и отделяет топологию от адресации: адресные префиксы вынесены в отдельные типы LSA. BGP (тема 10) переносит маршруты IPv6 благодаря многопротокольным расширениям MP-BGP (RFC 4760), в которых атрибуты MP_REACH_NLRI и MP_UNREACH_NLRI несут префиксы любого семейства адресов; одна BGP-сессия поверх IPv4 может передавать и маршруты IPv6.
Двойной стек и Happy Eyeballs
Основная стратегия перехода — двойной стек (англ. dual stack): узлы и маршрутизаторы одновременно поддерживают IPv4 и IPv6, имеют адреса обеих версий, а приложение выбирает протокол для каждого соединения. Выбор начинается с DNS: для имени сервера запрашиваются записи A (IPv4) и AAAA (IPv6) (тема 15), и стандартный алгоритм выбора адреса (RFC 6724) по умолчанию предпочитает IPv6.
Строгое предпочтение IPv6 создало проблему: если у клиента есть адрес IPv6, но путь IPv6 к серверу неисправен (неверный маршрут, чёрная дыра PMTUD), приложение ждёт таймаута соединения — десятки секунд — и лишь затем пробует IPv4. Пользователь видит «очень медленный Интернет». Решением стал алгоритм Happy Eyeballs (RFC 8305) 10. Клиент начинает соединение по IPv6 и, если за короткое время (рекомендуемое значение — 250 мс) оно не установлено, параллельно начинает соединение по IPv4; используется то, которое установится первым, а второе закрывается. Тем самым неисправность одного из протоколов стоит пользователю не более четверти секунды, а не десятков секунд. Алгоритм реализован в браузерах, в curl и в системных библиотеках macOS и iOS. Обратная сторона медали — Happy Eyeballs маскирует неисправности IPv6: сеть годами может работать с неисправным IPv6, и никто этого не замечает, пока не придётся отказаться от IPv4.
Трансляция и туннели
Когда у части узлов есть только один протокол, двойного стека недостаточно, и применяются трансляция или туннелирование.
Трансляция NAT64 (RFC 6146) позволяет клиентам, имеющим только IPv6, обращаться к серверам, имеющим только IPv4 11. Шлюз NAT64 владеет префиксом /96, обычно общеизвестным 64:ff9b::/96 (RFC 6052), и каждому адресу IPv4 сопоставляет адрес IPv6 вида «префикс + 32 бита адреса IPv4». Например, адресу 192.0.2.33 (в шестнадцатеричной записи c0.00.02.21) соответствует 64:ff9b::c000:221. Клиент отправляет пакет на этот адрес, шлюз переписывает заголовок IPv6 в заголовок IPv4, подставляя в качестве отправителя свой адрес IPv4 и запоминая соответствие портов — так же, как NAPT в теме 14. Чтобы клиент узнал синтетический адрес, используется DNS64 (RFC 6147): DNS-сервер, не найдя для имени записи AAAA, синтезирует её из записи A. Связка NAT64/DNS64 широко применяется мобильными операторами.
Сочетание NAT64/DNS64 не помогает приложениям, которые обращаются к литеральным адресам IPv4 или используют API сокетов только для IPv4. Для них предназначен механизм 464XLAT (RFC 6877): на самом клиентском устройстве работает транслятор без состояния CLAT, переводящий пакеты IPv4 приложения в IPv6, а в сети оператора — шлюз NAT64 (PLAT), переводящий их обратно в IPv4. Приложение видит обычный IPv4-адрес, а сеть оператора остаётся чистой IPv6-сетью. Именно так работает доступ к IPv4 у абонентов многих мобильных операторов.
Туннелирование решает обратную задачу: соединить островки IPv6 через сеть, работающую только по IPv4. В туннеле 6in4 (RFC 4213) пакет IPv6 целиком помещается в пакет IPv4 с номером протокола 41; концы туннеля настраиваются вручную. Автоматические механизмы 6to4 и Teredo оказались ненадёжными и выведены из употребления (6to4 — RFC 7526). Общие вопросы туннелей — накладные расходы, MTU, инкапсуляция — рассматриваются в теме 19.
Безопасность IPv6
IPv6 не делает сеть ни более, ни менее защищённой сам по себе, но меняет набор угроз. Распространённое заблуждение — «IPv6 безопаснее, потому что в нём обязательный IPsec»: в ранних спецификациях поддержка IPsec действительно требовалась, но использовать его никто не обязывал, а сейчас требование ослаблено до рекомендации.
Наиболее характерная угроза локального сегмента — подложные объявления маршрутизатора (англ. rogue RA). Любой узел сегмента может разослать RA и объявить себя маршрутизатором по умолчанию, перехватывая трафик соседей, — нередко без злого умысла, по ошибке конфигурации. Аналогично ARP-спуфингу в IPv4 (тема 18), возможна подделка NA. Защита строится на коммутаторе: функция RA Guard (RFC 6105) пропускает RA только с портов, к которым подключены настоящие маршрутизаторы, а отслеживание NDP сверяет адреса в NA с привязками. Криптографическая защита NDP SEND (RFC 3971) существует, но почти не реализована. Злоумышленники пытались обходить RA Guard, пряча RA за цепочкой расширяющих заголовков, поэтому реализации должны просматривать всю цепочку (RFC 7113).
Огромное адресное пространство меняет разведку. Перебрать подсеть /64 невозможно: при скорости миллион проб в секунду на это ушло бы 2⁶⁴ / 10⁶ ≈ 1,8·10¹³ с, то есть около 585 тысяч лет. Однако сканирование не исчезло, а изменилось (RFC 7707): атакующий ищет адреса с предсказуемыми идентификаторами (::1, ::2, адреса EUI-64 с известным OUI производителя, встроенные адреса IPv4), извлекает адреса из DNS, журналов и заголовков почты. Поэтому стабильные непрозрачные идентификаторы RFC 7217 полезны не только для приватности, но и для защиты от разведки.
Наконец, межсетевой экран обязан учитывать особенности протокола. Политика должна пропускать ICMPv6-сообщения NDP внутри сегмента и сообщения Packet Too Big из Интернета (RFC 4890), иначе сеть перестанет работать. А там, где IPv6 якобы «не используется», он почти наверняка работает: современные операционные системы включают его по умолчанию и строят link-local адреса, поэтому сегмент без контроля IPv6 открыт для подложных RA. Типичная ошибка — настроить фильтрацию для IPv4 (iptables) и забыть про IPv6 (ip6tables); в nftables семейство inet позволяет описать политику для обеих версий одной таблицей (тема 18).
Итоги темы
IPv6 появился как ответ на исчерпание адресов IPv4, но стал не просто расширением адреса, а переработкой сетевого уровня с учётом двадцатилетнего опыта. Адрес длиной 128 бит записывается восемью шестнадцатеричными группами с канонической сокращённой формой и делится на префикс маршрутизации, идентификатор подсети и 64-битный идентификатор интерфейса. Каждый интерфейс имеет несколько адресов разных областей действия — link-local, глобальные, временные, — а адресный план организации строится не из экономии, а из удобства агрегирования: блок /48 содержит 65 536 подсетей /64.
Основной заголовок упрощён до 40 байт фиксированного формата; редкие функции вынесены в цепочку расширяющих заголовков, которые обрабатывает только получатель. Маршрутизаторы больше не фрагментируют пакеты: отправитель узнаёт MTU пути из сообщений Packet Too Big и при необходимости фрагментирует сам, а каждый канал обязан передавать пакеты размером не менее 1280 байт. Отсюда следует первое практическое правило IPv6: ICMPv6 нельзя фильтровать по образцу ICMP для IPv4.
Протокол обнаружения соседей поверх ICMPv6 объединил функции ARP, обнаружения маршрутизаторов, перенаправлений и проверки уникальности адресов. Широковещание заменено групповыми адресами запрашиваемого узла, а проверка Hop Limit = 255 гарантирует, что сообщения NDP пришли из своего сегмента. Объявления маршрутизатора сообщают узлам префиксы, маршрут по умолчанию, MTU и DNS-серверы; узел строит себе глобальный адрес через SLAAC и проверяет его уникальность процедурой DAD, а DHCPv6 применяется там, где нужен централизованный учёт или делегирование префиксов.
Переход с IPv4 на IPv6 опирается на двойной стек с алгоритмом Happy Eyeballs, трансляцию NAT64/DNS64 и 464XLAT для сетей, где остался только IPv6, и туннели для островков IPv6 в IPv4-сети. Безопасность IPv6 требует внимания к локальному сегменту (подложные RA, RA Guard) и к фильтрации ICMPv6.
Тема завершает рассмотрение сетевого уровня. Сетевой уровень доставляет пакет до узла, но не до конкретной программы на нём и не гарантирует доставку. Как несколько приложений одного узла делят сетевой интерфейс, как поверх ненадёжных датаграмм строится надёжный поток байтов и как программа обращается к сети через сокеты — предмет темы 12, открывающей транспортный уровень.
Литература
- Deering S., Hinden R. Internet Protocol, Version 6 (IPv6) Specification. — RFC 8200, IETF, 2017. https://www.rfc-editor.org/rfc/rfc8200
- Hinden R., Deering S. IP Version 6 Addressing Architecture. — RFC 4291, IETF, 2006. https://www.rfc-editor.org/rfc/rfc4291
- Kawamura S., Kawashima M. A Recommendation for IPv6 Address Text Representation. — RFC 5952, IETF, 2010. https://www.rfc-editor.org/rfc/rfc5952
- Narten T., Nordmark E., Simpson W., Soliman H. Neighbor Discovery for IP version 6 (IPv6). — RFC 4861, IETF, 2007. https://www.rfc-editor.org/rfc/rfc4861
- Thomson S., Narten T., Jinmei T. IPv6 Stateless Address Autoconfiguration. — RFC 4862, IETF, 2007. https://www.rfc-editor.org/rfc/rfc4862
- Conta A., Deering S., Gupta M. Internet Control Message Protocol (ICMPv6) for the Internet Protocol Version 6 (IPv6) Specification. — RFC 4443, IETF, 2006. https://www.rfc-editor.org/rfc/rfc4443
- Mrugalski T., Siodelski M., Volz B., Yourtchenko A., Richardson M., Jiang S., Lemon T., Winters T. Dynamic Host Configuration Protocol for IPv6 (DHCPv6). — RFC 8415, IETF, 2018. https://www.rfc-editor.org/rfc/rfc8415
- Gont F. A Method for Generating Semantically Opaque Interface Identifiers with IPv6 Stateless Address Autoconfiguration (SLAAC). — RFC 7217, IETF, 2014. https://www.rfc-editor.org/rfc/rfc7217
- Gont F., Krishnan S., Narten T., Draves R. Temporary Address Extensions for Stateless Address Autoconfiguration in IPv6. — RFC 8981, IETF, 2021. https://www.rfc-editor.org/rfc/rfc8981
- Schinazi D., Pauly T. Happy Eyeballs Version 2: Better Connectivity Using Concurrency. — RFC 8305, IETF, 2017. https://www.rfc-editor.org/rfc/rfc8305
- Bagnulo M., Matthews P., van Beijnum I. Stateful NAT64: Network Address and Protocol Translation from IPv6 Clients to IPv4 Servers. — RFC 6146, IETF, 2011. https://www.rfc-editor.org/rfc/rfc6146
- McCann J., Deering S., Mogul J., Hinden R. Path MTU Discovery for IP version 6. — RFC 8201, IETF, 2017. https://www.rfc-editor.org/rfc/rfc8201
- The Linux Kernel Documentation. IP Sysctl. — 2025. https://docs.kernel.org/networking/ip-sysctl.html
- Kurose J. F., Ross K. W. Computer Networking: A Top-Down Approach. 8th ed. — Pearson, 2021.
- IANA. Internet Protocol Version Numbers. Registry. — 2025. https://www.iana.org/assignments/version-numbers/version-numbers.xhtml
- Delgrossi L., Berger L. Internet Stream Protocol Version 2 (ST2) Protocol Specification - Version ST2+. — RFC 1819, IETF, 1995. https://www.rfc-editor.org/rfc/rfc1819
- Bradner S., Mankin A. The Recommendation for the IP Next Generation Protocol. — RFC 1752, IETF, 1995. https://www.rfc-editor.org/rfc/rfc1752
- Ullmann R. TP/IX: The Next Internet. — RFC 1475, IETF, 1993. https://www.rfc-editor.org/rfc/rfc1475
- Francis P. A Territorial Addressing and Routing Architecture. — RFC 1621, IETF, 1994. https://www.rfc-editor.org/rfc/rfc1621
- Callon R. TCP and UDP with Bigger Addresses (TUBA), A Simple Proposal for Internet Protocol Next Generation. — RFC 1347, IETF, 1992. https://www.rfc-editor.org/rfc/rfc1347
- Onions J. A Historical Perspective On The Usage Of IP Version Numbers. — RFC 1606, IETF, 1994. https://www.rfc-editor.org/rfc/rfc1606