
Транспортный уровень: UDP, TCP и сокеты
Темы 6–11 были посвящены сетевому уровню, и итог их можно сформулировать одной фразой: протокол IP доставляет датаграмму от одного узла к другому, но делает это «по возможности» (англ. best effort). Пакет может потеряться в переполненной очереди маршрутизатора, прийти дважды, обогнать отправленный раньше или прийти с искажёнными данными, и сетевой уровень об этом никому не сообщит. Кроме того, адрес IP указывает на узел, а не на программу: на сервере одновременно работают веб-сервер, почтовый сервер и сервер SSH, и пакету, пришедшему на адрес сервера, нужно ещё указать, какой из них его ждёт.
Обе задачи решает транспортный уровень. Он работает только на конечных узлах — маршрутизаторы его заголовков, как правило, не разбирают — и превращает доставку «узел — узел» в доставку «процесс — процесс». В стеке TCP/IP два основных транспортных протокола. Протокол пользовательских датаграмм UDP добавляет к IP лишь номера портов и контрольную сумму и оставляет датаграммы такими же ненадёжными. Протокол управления передачей TCP строит поверх ненадёжных датаграмм надёжный упорядоченный поток байтов между двумя процессами — и для этого вводит понятие соединения со своим жизненным циклом. Принцип «из конца в конец» (тема 2) здесь проявляется в чистом виде: надёжность реализуется не в сети, а на её краях.
Изложение построено так. Сначала рассматриваются общие задачи транспортного уровня: порты и мультиплексирование. Затем — UDP, его заголовок и контрольная сумма. Третий раздел излагает принципы надёжной передачи от простейшего протокола «отправил — жди подтверждения» до скользящего окна, без привязки к конкретному протоколу. Четвёртый и пятый разделы посвящены TCP: заголовку, установлению соединения, завершению, конечному автомату состояний и характерным состояниям TIME_WAIT и CLOSE_WAIT. Последний раздел описывает программный интерфейс сокетов, через который приложения пользуются транспортом, и средства наблюдения за соединениями в Linux. Механизмы надёжности TCP во всех подробностях — оценка времени кругового обхода, повторная передача, управление потоком и перегрузкой — составляют предмет темы 13. Примеры выводов получены в учебной топологии лабораторной работы 12: клиент cli с адресом 10.12.0.1 и сервер srv с адресом 10.12.0.2, на звене между ними задержка 5 мс в каждую сторону.
Задачи транспортного уровня
Доставка между процессами и номера портов
Чтобы отличать друг от друга программы на одном узле, транспортный уровень вводит номер порта (англ. port number) — 16-битное число от 0 до 65 535. Порт — не физический объект и не процесс, а точка обмена: программа просит операционную систему закрепить за ней порт, и после этого ОС передаёт ей все данные, пришедшие на этот порт. Заголовки и UDP, и TCP начинаются с двух номеров портов — отправителя и получателя.
Номера портов делятся на три диапазона, которые ведёт IANA (RFC 6335) 7:
| Диапазон | Название | Назначение |
|---|---|---|
| 0–1023 | системные, общеизвестные (англ. well-known) | стандартные службы: 22 — SSH, 25 — SMTP, 53 — DNS, 80 — HTTP, 443 — HTTPS; в Unix привязка к ним требует прав администратора |
| 1024–49151 | регистрируемые (англ. registered) | службы, зарегистрированные по заявке: 3306 — MySQL, 5432 — PostgreSQL, 8080 — альтернативный HTTP |
| 49152–65535 | динамические, эфемерные (англ. dynamic, ephemeral) | временные порты клиентов |
Сервер слушает заранее известный порт, иначе клиент не знал бы, куда обращаться. Клиенту же известный порт не нужен: операционная система выдаёт ему свободный временный (эфемерный) порт в момент соединения, и сервер отвечает на него. Linux, вопреки рекомендации IANA, по умолчанию берёт эфемерные порты из диапазона 32768–60999 (параметр net.ipv4.ip_local_port_range) 14. Соответствие имён служб номерам портов хранится в файле /etc/services; именно по нему утилиты вроде ss без ключа -n печатают https вместо 443.
Заметим, что номер порта сам по себе не говорит, какой протокол прикладного уровня передаётся: соглашение «HTTP — на 80» — именно соглашение. Веб-сервер можно запустить на любом порту, а межсетевой экран, разрешающий «порт 443», пропустит любой трафик на этот порт.
Мультиплексирование и пятёрка соединения
Сбор данных от многих сокетов отправителя в один поток пакетов называется мультиплексированием (англ. multiplexing), а распределение пришедших пакетов по сокетам получателя — демультиплексированием (англ. demultiplexing). Правила демультиплексирования у UDP и TCP различаются принципиально 9.
Сокет UDP определяется парой «локальный адрес, локальный порт». Все датаграммы, пришедшие на порт 53 сервера DNS, попадают в один и тот же сокет независимо от того, от кого они пришли; адрес отправителя программа узнаёт из каждой датаграммы и отвечает по нему.
Соединение TCP определяется пятёркой (англ. 5-tuple): протокол, адрес и порт отправителя, адрес и порт получателя. Рассмотрим веб-сервер 203.0.113.10:443, к которому одновременно подключились два клиента, причём два — с одного и того же узла:
| Соединение | Адрес и порт клиента | Адрес и порт сервера |
|---|---|---|
| 1 | 198.51.100.7:51234 | 203.0.113.10:443 |
| 2 | 198.51.100.7:51240 | 203.0.113.10:443 |
| 3 | 192.0.2.55:51234 | 203.0.113.10:443 |
У всех трёх соединений одинаковые адрес и порт сервера, а у первого и третьего совпадают даже номера портов клиентов. Тем не менее все пятёрки различны, и ядро сервера безошибочно направляет каждый сегмент в свой сокет. Поэтому один серверный порт обслуживает десятки тысяч соединений одновременно: ограничение «65 535 портов» касается числа соединений с одной парой адресов, а не числа соединений сервера. Кроме сокетов отдельных соединений, у сервера есть слушающий сокет с пятёркой «TCP, 203.0.113.10:443, *:*», который принимает новые соединения; в выводе ss он отображается состоянием LISTEN и звёздочками на месте адреса собеседника.
Какой сервис предоставляет транспорт
Сетевой уровень предлагает ненадёжную доставку датаграмм между узлами. Транспортный протокол может добавить к этому разные гарантии. UDP и TCP занимают два полюса.
| Свойство | UDP | TCP |
|---|---|---|
| Единица обмена | датаграмма, границы сохраняются | поток байтов, границ сообщений нет |
| Соединение | нет | устанавливается и завершается явно |
| Надёжность | нет: потери и дубликаты не обнаруживаются | подтверждения и повторная передача |
| Порядок | не гарантирован | гарантирован |
| Управление потоком и перегрузкой | нет | есть (тема 13) |
| Размер заголовка | 8 байт | 20–60 байт |
| Задержка начала обмена | нет | один RTT на рукопожатие |
| Рассылка многим получателям | возможна (multicast, broadcast) | только «один к одному» |
Ни один из двух протоколов не гарантирует ни задержки, ни пропускной способности, ни конфиденциальности: этого не может обещать протокол, работающий поверх best effort. Защиту данных добавляет TLS поверх TCP (тема 17), а новые транспортные свойства — протоколы, построенные поверх UDP, например QUIC (тема 16).
Протокол UDP
Заголовок UDP
Протокол пользовательских датаграмм (англ. User Datagram Protocol, UDP) описан в RFC 768 1980 года — документе длиной в три страницы 1. Заголовок UDP занимает ровно 8 байт и содержит четыре 16-битных поля:
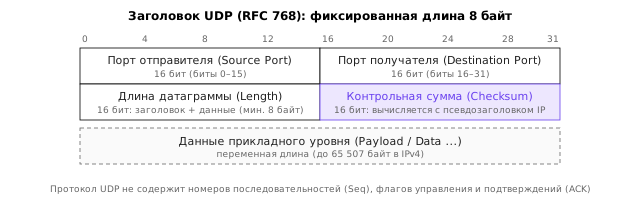
Поле «длина» содержит размер датаграммы вместе с заголовком, поэтому минимальное значение — 8. Поскольку поле 16-битное, датаграмма не может превышать 65 535 байт; с учётом заголовка IPv4 (20 байт) и UDP (8 байт) наибольший объём данных в одной датаграмме — 65 507 байт. Датаграмма больше MTU канала будет фрагментирована на уровне IP (тема 7), и потеря любого фрагмента означает потерю всей датаграммы; поэтому протоколы поверх UDP стараются укладываться в MTU пути.
UDP не делает почти ничего сверх IP: добавляет порты для демультиплексирования и контрольную сумму для обнаружения искажений. Он не устанавливает соединения, не нумерует датаграммы, не подтверждает их и не повторяет потерянные. Обмен в лабораторной работе выглядит так:
IP 10.12.0.1.36481 > 10.12.0.2.5005: UDP, length 22
IP 10.12.0.2.5005 > 10.12.0.1.36481: UDP, length 22
Клиент отправил датаграмму со своего эфемерного порта 36481 на порт 5005 эхо-сервера, сервер вернул её на тот же порт. Поле length 22 в выводе tcpdump — длина данных, без заголовка. Если на целевом порту никто не слушает, узел-получатель отвечает сообщением ICMP «порт недостижим» (тема 7):
IP 10.12.0.1.43747 > 10.12.0.2.5999: UDP, length 22
IP 10.12.0.2 > 10.12.0.1: ICMP 10.12.0.2 udp port 5999 unreachable, length 58
Получит ли программа-отправитель это сообщение, зависит от того, как она пользуется сокетом. В Linux сообщения ICMP об ошибках доставляются только «соединённому» UDP-сокету — такому, для которого вызван connect(); соединения при этом не устанавливается, ядро лишь запоминает адрес собеседника 13. Несоединённый сокет ошибку не увидит и будет ждать ответа до своего таймаута.
Псевдозаголовок и контрольная сумма
Контрольная сумма UDP защищает не только заголовок и данные, но и часть заголовка IP. Перед вычислением к датаграмме мысленно присоединяется псевдозаголовок (англ. pseudo-header): адреса отправителя и получателя, нулевой байт, номер протокола (17) и длина UDP. Псевдозаголовок не передаётся по сети — получатель восстанавливает его из заголовка IP пришедшего пакета. Смысл в том, чтобы обнаружить датаграмму, доставленную не тому узлу или не тому протоколу из-за искажения заголовка IP. Такая перекрёстная проверка нарушает чистоту разделения уровней, и это сознательный компромисс: транспортный уровень доверяет сетевому ровно настолько, насколько может проверить 112.
Алгоритм — 16-битная сумма в обратном коде (англ. one's complement), общая для IP, UDP и TCP: все данные разбиваются на 16-битные слова (нечётный хвост дополняется нулевым байтом), слова складываются, переносы из старшего разряда прибавляются к младшему, результат инвертируется. Рассмотрим пример: клиент 10.12.0.1, порт 40000, отправляет серверу 10.12.0.2, порт 5005, датаграмму с двумя байтами данных Hi (0x48 0x69). Длина UDP: 8 + 2 = 10 байт. Слова для суммирования:
| Часть | Слова |
|---|---|
псевдозаголовок: адрес отправителя 10.12.0.1 | 0a0c, 0001 |
псевдозаголовок: адрес получателя 10.12.0.2 | 0a0c, 0002 |
| псевдозаголовок: ноль и протокол 17, длина 10 | 0011, 000a |
| заголовок: порты 40000 и 5005 | 9c40, 138d |
| заголовок: длина 10, контрольная сумма (пока 0) | 000a, 0000 |
данные Hi | 4869 |
Сумма слов равна 0x10c76. Перенос 1 из 17-го разряда прибавляется к младшим 16 битам: 0x0c76 + 0x1 = 0x0c77. Инверсия даёт контрольную сумму 0xf388. Получатель складывает те же слова вместе с пришедшей контрольной суммой: 0x0c77 + 0xf388 = 0xffff — все единицы означают, что ошибок не обнаружено.
Эта контрольная сумма слаба: она не замечает перестановки 16-битных слов и некоторых парных ошибок. Основную защиту от искажений дают циклические коды канального уровня (CRC Ethernet, тема 3), а контрольная сумма транспорта ловит ошибки, возникшие внутри узлов — в памяти маршрутизатора, в драйвере. В IPv4 контрольная сумма UDP необязательна: нулевое значение означает «не вычислялась». В IPv6, где у заголовка IP собственной контрольной суммы нет, она обязательна (тема 11). Современные сетевые карты вычисляют контрольные суммы аппаратно (англ. checksum offload), поэтому tcpdump на передающей стороне нередко показывает в этом поле неверное значение: в момент захвата ядро ещё не заполнило его.
Когда выбирают UDP
Отсутствие гарантий у UDP — не недостаток, а свойство, нужное многим приложениям 89:
- Короткие обмены «запрос — ответ». Запрос DNS и ответ на него помещаются в одну датаграмму каждый; установление соединения TCP удвоило бы время ответа. Если ответ не пришёл, клиент DNS просто повторяет запрос.
- Данные реального времени. Для голоса и видео (RTP), онлайн-игр опоздавший пакет так же бесполезен, как потерянный: повторная передача только увеличит задержку. Приложению лучше пропустить потерянный кадр.
- Служебные протоколы, работающие до появления адреса или поверх широковещания. DHCP (порты 67 и 68), обнаружение служб в локальной сети, протоколы маршрутизации вроде RIP.
- Собственный транспорт поверх UDP. Если надёжность нужна, но поведение TCP не устраивает, протокол реализует её сам поверх UDP. Так устроены QUIC (тема 16), WireGuard (тема 19) и многие протоколы передачи файлов. UDP здесь служит «тонкой обёрткой», которую пропускают межсетевые экраны и NAT и которую можно реализовать в приложении, не меняя ядро ОС.
Свобода UDP накладывает на приложение обязанности. Руководство по использованию UDP (RFC 8085) требует от протоколов поверх UDP самостоятельно ограничивать скорость при перегрузке, укладываться в MTU пути, обрабатывать потери, дубликаты и перестановки и защищаться от подделки адреса отправителя 8. Последнее важно потому, что UDP без рукопожатия позволяет атакующему отправить запрос от имени жертвы, а ответ, во много раз больший запроса, уйдёт жертве; на этом основаны атаки отражения с усилением через DNS, NTP и memcached (тема 18).
Принципы надёжной передачи данных
Подтверждения, таймауты и номера последовательности
Прежде чем разбирать TCP, полезно понять, из каких элементов вообще складывается надёжная передача поверх ненадёжного канала. Классическое изложение строит протокол постепенно, добавляя по одному механизму на каждую новую неприятность канала 9.
Если канал искажает биты, но ничего не теряет, достаточно контрольной суммы и обратной связи: получатель отвечает положительным подтверждением (англ. acknowledgement, ACK), если данные целы, и отрицательным (NAK), если нет; отправитель в ответ на NAK повторяет пакет. Такие протоколы называют протоколами с автоматическим запросом повторной передачи (англ. Automatic Repeat reQuest, ARQ). Но и само подтверждение может быть искажено. Если отправитель на всякий случай повторит пакет, получатель не сможет отличить повтор от новых данных. Отсюда второй элемент — номер последовательности (англ. sequence number): каждый пакет нумеруется, и получатель отбрасывает дубликат, но подтверждает его снова. Отрицательное подтверждение при этом становится лишним: подтверждение предыдущего пакета вместо ожидаемого означает то же самое.
Если канал может терять пакеты целиком, ни ACK, ни NAK может не прийти никогда. Третий элемент — таймер повторной передачи: отправитель, не получивший подтверждения за определённое время (англ. timeout), повторяет пакет. Время ожидания должно быть больше времени кругового обхода (англ. Round-Trip Time, RTT), иначе протокол будет повторять пакеты, которые просто ещё не успели подтвердить. Но если таймаут слишком велик, потеря обходится долгим простоем. Как TCP выбирает таймаут по измеренному RTT, рассматривается в теме 13.
Итог — четыре элемента, из которых состоит любой надёжный протокол: контрольная сумма для обнаружения искажений, подтверждения для обратной связи, номера последовательности для распознавания дубликатов и таймер для обнаружения потерь.
Протокол с остановкой и ожиданием и его эффективность
Простейший протокол, собранный из этих элементов, отправляет пакет и ждёт подтверждения, прежде чем отправить следующий. Он называется протоколом с остановкой и ожиданием (англ. stop-and-wait). Номеров последовательности ему достаточно двух — 0 и 1, поэтому его называют также протоколом с чередующимся битом.
Протокол корректен, но крайне неэффективен на длинных каналах. Пусть канал имеет скорость R = 1 Гбит/с, RTT = 30 мс (примерно путь Москва — Новосибирск по оптике), а пакет — L = 1500 байт = 12 000 бит. Время передачи пакета в канал (тема 1) составляет L / R = 12 000 / 10⁹ = 12 мкс. После этого отправитель ждёт подтверждения ещё 30 мс. Коэффициент использования канала:
U = \frac{L / R}{\text{RTT} + L / R} = \frac{0{,}012 \text{ мс}}{30{,}012 \text{ мс}} \approx 0{,}0004
Канал занят передачей лишь 0,04 % времени, и полезная скорость составляет 12 000 бит / 30,012 мс ≈ 400 Кбит/с на гигабитном канале. Проблема не в скорости канала, а в том, что в каждый момент «в пути» находится только один пакет.
Скользящее окно: возврат на N и выборочный повтор
Решение — конвейерная передача (англ. pipelining): разрешить отправителю иметь в пути до N неподтверждённых пакетов. Чтобы загрузить канал из предыдущего примера полностью, в пути должно находиться количество данных, равное произведению пропускной способности на задержку (BDP, тема 1): 10⁹ бит/с · 0,03 с = 3·10⁷ бит = 3,75 МБ, или 2500 пакетов по 1500 байт. Конвейеризация требует большего диапазона номеров последовательности и буферов у отправителя (для неподтверждённых пакетов) и, возможно, у получателя. Множество номеров, которые отправитель имеет право использовать в данный момент, называют окном (англ. window); по мере прихода подтверждений окно сдвигается вперёд, отсюда название «скользящее окно» (англ. sliding window).
Существуют два классических способа восстанавливаться после потерь при конвейерной передаче; они сопоставлены на рисунке ниже.
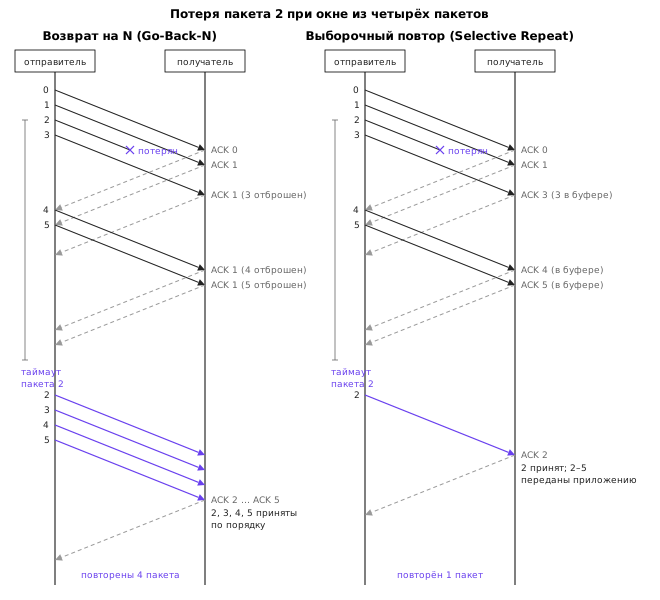
В протоколе с возвратом на N (англ. Go-Back-N, GBN) получатель принимает пакеты только по порядку, а подтверждение кумулятивно (англ. cumulative acknowledgement): «ACK n» означает «получены все пакеты по n включительно». Пакет, пришедший после пропуска, отбрасывается, а получатель повторяет подтверждение последнего пакета, пришедшего по порядку. Отправитель держит один таймер для самого старого неподтверждённого пакета и по его срабатыванию повторяет все неподтверждённые пакеты. Получатель устроен просто — ему не нужен буфер, — но одна потеря при большом окне вызывает повторную передачу многих уже доставленных пакетов.
В протоколе с выборочным повтором (англ. Selective Repeat, SR) получатель буферизует пакеты, пришедшие не по порядку, и подтверждает каждый пакет отдельно. Отправитель держит таймер для каждого пакета и повторяет только тот, для которого таймер сработал. Потери обходятся дешевле, но получатель сложнее, а размер окна ограничен строже. Номер последовательности занимает в заголовке k бит, и номера идут по кругу от 0 до 2ᵏ − 1. Для GBN окно не может превышать 2ᵏ − 1, для SR — 2ᵏ⁻¹. Пример показывает, почему. Пусть k = 2 (номера 0–3), а окно SR равно 3. Отправитель передаёт пакеты 0, 1, 2; получатель принимает их, сдвигает своё окно на номера 3, 0, 1 и отправляет подтверждения, которые все теряются. Отправитель по таймеру повторяет старый пакет 0, а получатель принимает его за новый пакет 0 из следующего круга — данные искажены, и никто этого не заметил. При окне 2 = 2ᵏ⁻¹ окна отправителя и получателя никогда не перекрываются, и неоднозначности не возникает.
TCP сочетает черты обоих подходов. Его подтверждения кумулятивны, как в GBN, но получатель буферизует сегменты, пришедшие не по порядку, а отправитель по таймауту повторяет, как правило, только первый неподтверждённый сегмент. Расширение выборочных подтверждений SACK позволяет сообщать о полученных «островах» данных и приближает TCP к выборочному повтору. Номер последовательности TCP занимает 32 бита и отсчитывает байты, а не пакеты, поэтому ограничение на размер окна там касается байтов. Подробности — в теме 13.
TCP: поток байтов и установление соединения
Поток байтов и нумерация
Протокол управления передачей (англ. Transmission Control Protocol, TCP) восходит к работе В. Серфа и Р. Кана 1974 года, где была предложена единая программа передачи между разнородными сетями 4. В 1978 году её разделили на IP и TCP, в 1981 году TCP был стандартизован в RFC 793 3, а в 2022 году спецификация, сорок лет обраставшая уточнениями, была сведена в единый документ RFC 9293 2.
TCP предоставляет приложению надёжный, упорядоченный, дуплексный поток байтов (англ. byte stream) между двумя сокетами. Ключевое слово — поток. TCP не знает о сообщениях приложения: байты, переданные несколькими вызовами отправки, могут прийти одним блоком, а байты одного вызова — несколькими. Отправитель накапливает данные в буфере отправки и нарезает их на сегменты (англ. segments) по своему усмотрению — с учётом размера сегмента, окна получателя и перегрузки, а получатель складывает их в буфер приёма, откуда приложение читает сколько захочет. В лабораторной работе клиент делает пять отдельных вызовов send() с короткими строками и один вызов с 100 000 байт, а сервер, начав чтение с опозданием на полсекунды, получает:
recv №1: 65536 байт: b'msg0;msg1;msg2;msg3;msg4;BBBBBBBBBBBBBBB...BBBBBBBBBB'
recv №2: 34489 байт: b'BBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBBB...BBBBBBBBBB'
Пять «сообщений» склеились друг с другом и с началом шестого, а шестое оказалось разрезано на два вызова чтения (25 + 100 000 = 65 536 + 34 489 байт). Ничего неправильного здесь нет: так работает поток. Если приложению нужны сообщения, оно обязано само размечать их границы — кадрированием (англ. framing): передавать перед каждым сообщением его длину, ставить разделитель (как HTTP/1.1 ставит пустую строку после заголовков) или использовать сообщения фиксированной длины. Ошибка «одно recv() — одно сообщение» — самая распространённая ошибка начинающих сетевых программистов; в локальной сети она может годами не проявляться, а в реальной сети с другим MTU и потерями приводит к редким и плохо воспроизводимым сбоям.
Чтобы поток был надёжным и упорядоченным, TCP нумерует не сегменты, а байты. Номер последовательности сегмента — это номер первого байта данных в нём, а номер подтверждения — номер следующего байта, который получатель ожидает (то есть «все байты до этого номера получены»). Нумерация начинается не с нуля, а со случайного начального номера, выбираемого при установлении соединения (об этом ниже). Каждое направление потока нумеруется независимо.
Заголовок TCP
Заголовок TCP занимает не менее 20 байт; к ним могут добавляться опции общим объёмом до 40 байт 2. Формат показан на рисунке.
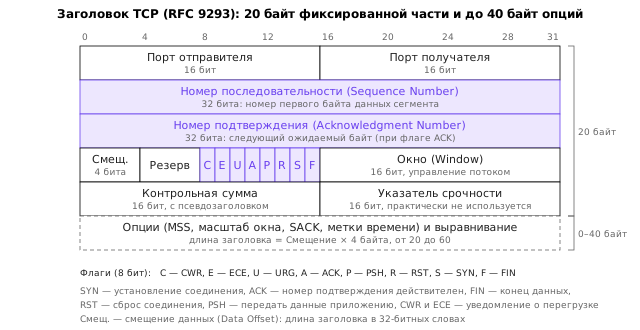
Назначение полей:
- Порт отправителя и порт получателя, по 16 бит.
- Номер последовательности (англ. Sequence Number), 32 бита: номер первого байта данных сегмента. Для сегмента с флагом SYN — начальный номер ISN.
- Номер подтверждения (англ. Acknowledgment Number), 32 бита: следующий ожидаемый байт от собеседника; действителен при установленном флаге ACK.
- Смещение данных (англ. Data Offset), 4 бита: длина заголовка в 32-битных словах, от 5 (20 байт) до 15 (60 байт).
- Флаги, 8 бит (плюс 4 зарезервированных бита).
- Окно (англ. Window), 16 бит: сколько байтов, начиная с номера подтверждения, получатель готов принять — основа управления потоком (тема 13).
- Контрольная сумма, 16 бит: вычисляется так же, как в UDP, с псевдозаголовком; в TCP она обязательна.
- Указатель срочности (англ. Urgent Pointer), 16 бит: устаревший механизм «срочных данных», на практике не используется.
- Опции: размер сегмента MSS, масштаб окна, метки времени, разрешение SACK и другие.
Флаги определяют назначение сегмента:
| Флаг | Название | Смысл |
|---|---|---|
SYN | synchronize | установление соединения, передача начального номера |
ACK | acknowledgment | поле номера подтверждения действительно (во всех сегментах после первого) |
FIN | finish | отправитель закончил передачу данных в своём направлении |
RST | reset | немедленный сброс соединения |
PSH | push | передать данные приложению без задержки |
URG | urgent | указатель срочности действителен |
ECE, CWR | ECN echo, congestion window reduced | явное уведомление о перегрузке (тема 13) |
В выводе tcpdump флаги обозначаются буквами в квадратных скобках: S — SYN, . — ACK, P — PSH, F — FIN, R — RST; запись S. означает SYN и ACK вместе.
Трёхкратное рукопожатие
Прежде чем передавать данные, две стороны TCP должны договориться о начальных номерах последовательности в обоих направлениях и о параметрах соединения. Для этого служит трёхкратное рукопожатие (англ. three-way handshake) 2:
- Клиент отправляет сегмент SYN со своим начальным номером последовательности x и переходит в состояние SYN_SENT.
- Сервер, слушающий порт, отвечает сегментом SYN+ACK: свой начальный номер y и подтверждение x + 1. Флаг SYN «занимает» один номер последовательности, поэтому ожидаемым становится x + 1.
- Клиент отвечает ACK с подтверждением y + 1. С этого момента соединение установлено у обеих сторон.
Захват рукопожатия в лабораторной работе (ключ -S выводит абсолютные номера, -ttt — интервалы между пакетами):
 00:00:00.000000 IP 10.12.0.1.55736 > 10.12.0.2.5006: Flags [S], seq 1959813724, win 64240,
                 options [mss 1460,sackOK,TS val 156460196 ecr 0,nop,wscale 7], length 0
 00:00:00.005126 IP 10.12.0.2.5006 > 10.12.0.1.55736: Flags [S.], seq 2326266259, ack 1959813725, win 65160,
                 options [mss 1460,sackOK,TS val 2781685360 ecr 156460196,nop,wscale 7], length 0
 00:00:00.005124 IP 10.12.0.1.55736 > 10.12.0.2.5006: Flags [.], ack 2326266260, win 502, ...
 00:00:00.000051 IP 10.12.0.1.55736 > 10.12.0.2.5006: Flags [P.], seq 1959813725:1959813743, ack 2326266260, ... length 18
 00:00:00.005045 IP 10.12.0.2.5006 > 10.12.0.1.55736: Flags [.], ack 1959813743, win 509, ... length 0
 00:00:00.000106 IP 10.12.0.2.5006 > 10.12.0.1.55736: Flags [P.], seq 2326266260:2326266278, ack 1959813743, ... length 18
 00:00:00.005072 IP 10.12.0.1.55736 > 10.12.0.2.5006: Flags [.], ack 2326266278, win 502, ...
Здесь x = 1959813724, y = 2326266259. Клиент отправил 18 байт (строку «Привет, TCP!» в UTF-8) с номерами 1959813725–1959813742; запись seq 1959813725:1959813743 у tcpdump означает «с первого байта включительно по последний исключительно». Сервер подтвердил ack 1959813743 — следующий ожидаемый байт — и вернул те же 18 байт. Интервалы около 5 мс соответствуют задержке звена в одну сторону: клиент может отправлять данные уже через один RTT (10 мс) после начала соединения, сразу за последним сегментом рукопожатия. Именно поэтому программа-клиент сообщила «соединение установлено за 10,3 мс».
В сегментах SYN стороны обмениваются опциями, которые действуют на всё соединение: mss 1460 — наибольший размер данных в сегменте, который сторона готова принять (1500 − 20 − 20 = 1460 для Ethernet и IPv4); sackOK — поддержка выборочных подтверждений; TS — метки времени для измерения RTT; wscale 7 — масштаб окна: значение поля «окно» умножается на 2⁷ = 128, поэтому win 502 в третьем сегменте означает 502 · 128 = 64 256 байт. Опции, не объявленные в SYN, в соединении не используются; подробно их смысл разбирается в теме 13.
Почему рукопожатие трёхкратное, а не двукратное? Каждая сторона должна передать свой начальный номер и получить подтверждение, что собеседник его принял. Это требует четырёх действий (SYN клиента, ACK сервера, SYN сервера, ACK клиента), и два средних объединяются в один сегмент. При двукратном рукопожатии сервер не знал бы, получил ли клиент его номер, и, что важнее, не смог бы отличить настоящий запрос от старого дубликата SYN, задержавшегося в сети: на старый SYN клиент ответит RST, и полуготовое соединение будет отменено 2.
Начальный номер последовательности
Почему начальный номер (англ. Initial Sequence Number, ISN) не равен нулю? Первая причина — защита от старых дубликатов. Если соединение с той же пятёркой закрылось и тут же открылось снова, задержавшиеся сегменты прежнего соединения могли бы попасть в окно нового и быть приняты как данные. RFC 793 предлагал выбирать ISN по часам, увеличивающимся каждые 4 мкс, так чтобы номера нового соединения были далеки от номеров старого 3.
Вторая причина — безопасность. Если ISN предсказуем, атакующий, подделав адрес отправителя, может отправить серверу SYN, а затем ACK с правильно угаданным номером подтверждения, и сервер поверит, что соединение установлено с доверенным узлом, хотя ответов атакующий не видит. Такая атака была описана Р. Моррисом в 1985 году и использована на практике в 1994 году. Современная рекомендация RFC 6528 — вычислять ISN как сумму показаний таймера и криптографической хеш-функции от пятёрки соединения и секретного ключа 5. Номера для одной и той же пятёрки по-прежнему растут со временем, а угадать ISN чужого соединения нельзя. В захвате выше начальные номера клиента и сервера — два ничем не связанных случайных на вид 32-битных числа; Wireshark по умолчанию показывает относительные номера (от ISN), чтобы их было удобно читать.
Отказ в соединении, отфильтрованный порт и SYN flood
Если на порту никто не слушает, ядро получателя отвечает на SYN сегментом с флагом RST. Клиент получает ошибку «соединение отвергнуто» (англ. connection refused) через один RTT:
IP 10.12.0.1.35942 > 10.12.0.2.5555: Flags [S], seq 2739611341, win 64240, ... length 0
IP 10.12.0.2.5555 > 10.12.0.1.35942: Flags [R.], seq 0, ack 2739611342, win 0, length 0
Совсем иначе выглядит порт, закрытый межсетевым экраном с действием «отбросить» (тема 18). Ответа нет вовсе, и клиент повторяет SYN по таймеру. Число повторов задаётся параметром net.ipv4.tcp_syn_retries (по умолчанию 6), а интервалы зависят от версии ядра 14. Классически первый повтор происходит через 1 с, далее интервал удваивается: повторы уходят через 1, 3, 7, 15, 31 и 63 с после первой попытки, и ошибку таймаута приложение получает лишь через 127 с — это значение до сих пор приводится в справочной странице tcp(7) 13. Начиная с версии 6.5 ядро Linux (а значит, и Ubuntu 24.04; есть ли параметр в вашем ядре, покажет sysctl net.ipv4.tcp_syn_linear_timeouts) первые четыре повтора выполняет с постоянным интервалом 1 с (параметр net.ipv4.tcp_syn_linear_timeouts = 4) и лишь затем удваивает интервал: повторы уходят через 1, 2, 3, 4, 5 и 7 с, а попытка прекращается примерно через 11 с. В лабораторной работе это легко проверить захватом. Различие между быстрым RST и долгим молчанием — главный признак, по которому сканер портов (nmap, тема 18) отличает «закрытый» порт от «отфильтрованного». Клиент в лабораторной работе ограничивает ожидание 10 секундами и сообщает: «нет ответа за 10,0 с (SYN без ответа)».
Состояние между получением SYN и завершением рукопожатия делает сервер уязвимым. Для каждого полученного SYN сервер создаёт запись о полуоткрытом соединении и ждёт последнего ACK. Атака SYN flood — поток SYN с поддельных адресов — заполняет очередь таких записей, и настоящие клиенты получают отказ 6. Основная защита — SYN cookies: при переполнении очереди сервер не хранит состояние вовсе, а кодирует сведения о соединении (время, MSS, хеш пятёрки с секретом) прямо в свой начальный номер y. Если клиент настоящий, он вернёт y + 1 в последнем ACK, и сервер восстановит по нему соединение. В Linux SYN cookies включаются автоматически при переполнении очереди (параметр net.ipv4.tcp_syncookies = 1 по умолчанию) 14. Платой служит то, что опции, не поместившиеся в номер, теряются.
С очередями связан и аргумент вызова listen(backlog): в Linux он ограничивает число полностью установленных соединений, которые ещё не забрало приложение вызовом accept(); полуоткрытые соединения учитываются отдельно. Значение backlog ограничено сверху параметром net.core.somaxconn 13.
Завершение соединения и конечный автомат TCP
Завершение соединения и полузакрытие
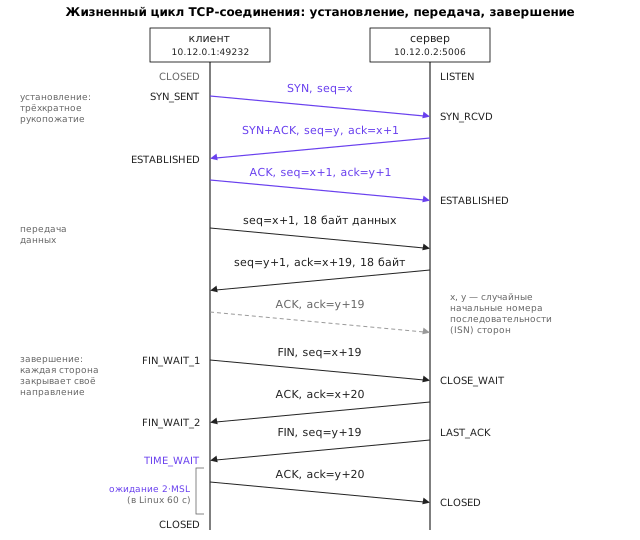
TCP-соединение дуплексно, и каждое из двух направлений закрывается независимо. Сторона, закончившая передачу, отправляет сегмент с флагом FIN, который, как и SYN, занимает один номер последовательности; собеседник подтверждает его. После этого данные в этом направлении больше не идут, но в обратном направлении передача может продолжаться — соединение находится в состоянии полузакрытия (англ. half-close). Затем вторая сторона отправляет свой FIN и получает подтверждение. Полный обмен показан на временной диаграмме ниже вместе с рукопожатием и передачей данных.
Захват завершения соединения из лабораторной работы (клиент закрывает первым):
IP 10.12.0.1.55736 > 10.12.0.2.5006: Flags [F.], seq 1959813743, ack 2326266278, ...
IP 10.12.0.2.5006 > 10.12.0.1.55736: Flags [F.], seq 2326266278, ack 1959813744, ...
IP 10.12.0.1.55736 > 10.12.0.2.5006: Flags [.], ack 2326266279, ...
Сегментов три, а не четыре: сервер-эхо, получив FIN, сразу закрыл свой сокет, и его ядро объединило подтверждение FIN клиента с собственным FIN. Если приложение сервера закрывает сокет с задержкой, обмен будет четырёхсегментным, как на диаграмме.
Полузакрытие доступно приложению через вызов shutdown(SHUT_WR): он отправляет FIN, но оставляет сокет открытым для чтения. Получатель обнаруживает FIN как «конец файла»: вызов recv() возвращает пустой результат. Так клиент может сказать серверу «запрос полностью передан» и затем дочитать ответ до конца — классический приём протоколов, в которых конец запроса не размечен иначе. Вызов close(), напротив, закрывает сокет для приложения целиком.
Наряду с упорядоченным завершением существует аварийное: сегмент RST. Его отправляют в ответ на сегмент, не относящийся ни к какому соединению (например, на SYN к закрытому порту или на данные после перезагрузки узла), а также при закрытии сокета, в буфере приёма которого остались непрочитанные данные — так приложение сигнализирует, что данные потеряны. Получив RST, сторона немедленно уничтожает соединение без подтверждения, а приложение получает ошибку «соединение сброшено» (англ. connection reset by peer).
Конечный автомат состояний
Поведение каждой стороны TCP описывается конечным автоматом из 11 состояний (англ. finite state machine) 2. Переход происходит по событию — вызову приложения или приходу сегмента — и, как правило, сопровождается отправкой сегмента. Автомат показан на рисунке; переходы подписаны в форме «событие / действие».
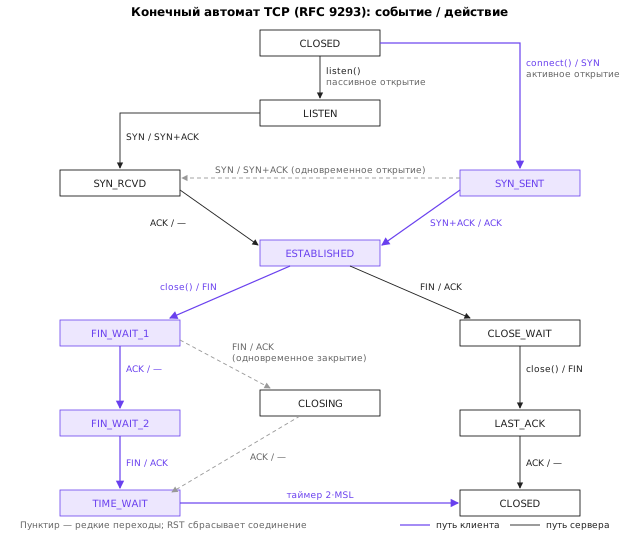
| Состояние | Смысл |
|---|---|
| CLOSED | соединения нет (условное начальное и конечное состояние) |
| LISTEN | слушающий сокет ждёт SYN |
| SYN_SENT | клиент отправил SYN и ждёт SYN+ACK |
| SYN_RECEIVED | сервер получил SYN, отправил SYN+ACK и ждёт ACK |
| ESTABLISHED | соединение установлено, идёт обмен данными |
| FIN_WAIT_1 | приложение закрыло сокет, отправлен FIN, подтверждения нет |
| FIN_WAIT_2 | FIN подтверждён, ждём FIN собеседника |
| CLOSE_WAIT | получен FIN собеседника, ждём, когда своё приложение закроет сокет |
| LAST_ACK | свой FIN отправлен после CLOSE_WAIT, ждём его подтверждения |
| CLOSING | обе стороны отправили FIN одновременно, ждём подтверждения |
| TIME_WAIT | своё направление закрыто последним ACK, выжидаем 2·MSL |
Сторона, которая закрывает соединение первой, выполняет активное закрытие (англ. active close) и проходит путь FIN_WAIT_1 → FIN_WAIT_2 → TIME_WAIT. Вторая выполняет пассивное закрытие и проходит путь CLOSE_WAIT → LAST_ACK → CLOSED. Какая из сторон закроет первой — клиент или сервер, — определяет протокол приложения; например, веб-сервер нередко сам закрывает простаивающие соединения и потому накапливает сокеты в TIME_WAIT. Редкие переходы — одновременное открытие (обе стороны отправили SYN друг другу) и одновременное закрытие через CLOSING — на практике встречаются нечасто, но автомат должен их обрабатывать.
В Linux названия состояний немного отличаются: ss выводит ESTAB, SYN-RECV, TIME-WAIT и т. п. Кроме того, полуоткрытые соединения на стороне сервера хранятся не как полноценные сокеты, а как облегчённые записи запросов в состоянии NEW_SYN_RECV — это одна из защит от SYN flood.
Состояние TIME_WAIT и зачем оно нужно
Сторона, выполнившая активное закрытие, после отправки последнего ACK не уничтожает соединение сразу, а остаётся в состоянии TIME_WAIT в течение удвоенного максимального времени жизни сегмента (англ. Maximum Segment Lifetime, MSL). RFC 793 предлагал считать MSL равным двум минутам, то есть TIME_WAIT длился бы 4 минуты 3; реализации выбирают меньшие значения 11, а Linux использует фиксированную длительность 60 с (константа TCP_TIMEWAIT_LEN в исходном коде ядра). В лабораторной работе это видно непосредственно:
ip netns exec cli ss -tano
State     Recv-Q Send-Q Local Address:Port  Peer Address:Port Process
TIME-WAIT 0      0          10.12.0.1:55736    10.12.0.2:5006 timer:(timewait,58sec,0)
Состояние решает две задачи 211. Первая — надёжное завершение. Последний ACK может потеряться. Тогда собеседник, находящийся в LAST_ACK, по таймеру повторит свой FIN. Если бы активная сторона уже забыла соединение, она ответила бы на повторный FIN сегментом RST, и собеседник получил бы ошибку вместо нормального завершения. Пока соединение в TIME_WAIT, повторный FIN будет снова подтверждён. Вторая задача — защита нового соединения от старых сегментов. Сегмент прежнего соединения мог задержаться в сети; если бы та же пятёрка немедленно использовалась для нового соединения, запоздавший сегмент мог бы попасть в его окно. Ожидание 2·MSL гарантирует, что все сегменты прежнего соединения (в обоих направлениях) за это время либо дошли, либо были уничтожены по Hop Limit/TTL.
TIME_WAIT часто воспринимают как проблему: на нагруженном сервере или клиенте, открывающем тысячи коротких соединений, накапливаются десятки тысяч таких записей. Сами по себе они дёшевы — ядро хранит для них облегчённую структуру, — но клиент, открывающий много соединений к одному и тому же адресу и порту сервера, может исчерпать эфемерные порты: пятёрка с портом в TIME_WAIT не может быть использована повторно. Правильные средства — постоянные соединения в протоколе приложения (тема 16), параметр net.ipv4.tcp_tw_reuse, позволяющий клиенту повторно использовать пятёрку из TIME_WAIT при включённых метках времени, или изменение того, кто закрывает соединение первым. Сокращать TIME_WAIT «вручную» опасно; параметр tcp_tw_recycle, делавший это, был удалён из Linux в 2017 году, потому что ломал соединения клиентов за NAT.
С TIME_WAIT связана и знакомая ошибка «адрес уже используется» (англ. Address already in use) при перезапуске сервера: если сервер закрыл соединения первым, на его порту остались записи TIME_WAIT, и bind() к этому порту по умолчанию запрещён. Опция сокета SO_REUSEADDR разрешает привязку в такой ситуации, и её устанавливает практически каждый TCP-сервер 10.
CLOSE_WAIT, полуоткрытые соединения и проверка живости
Если TIME_WAIT — нормальное и временное состояние, то большое число соединений в CLOSE_WAIT почти всегда указывает на ошибку в приложении. Соединение переходит в CLOSE_WAIT, когда ядро получило FIN собеседника и подтвердило его, а дальнейшее зависит от приложения: оно должно заметить конец потока (recv() вернул пустой результат) и вызвать close(). Если программа этого не делает — забыла закрыть сокет в ветке обработки ошибки, зависла, держит ссылку на объект соединения, — соединение остаётся в CLOSE_WAIT бессрочно: у этого состояния нет таймера. Каждое такое соединение занимает файловый дескриптор, и сервер со временем упирается в лимит открытых файлов. В лабораторной работе «забывчивый» сервер воспроизводит эту ошибку:
State      Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN     0      8            0.0.0.0:5007      0.0.0.0:*     users:(("python3",pid=13958,fd=3))
CLOSE-WAIT 0      0          10.12.0.2:5007    10.12.0.1:54086 users:(("python3",pid=13958,fd=4))
Ключ -p команды ss показывает процесс и номер файлового дескриптора, по которому виновника легко найти. Клиент при этом находится в состоянии FIN_WAIT_2 — он ждёт FIN, который никогда не придёт. Чтобы такие «осиротевшие» соединения не жили вечно, Linux ограничивает время ожидания в FIN_WAIT_2 для сокета, уже закрытого приложением, параметром net.ipv4.tcp_fin_timeout (60 с по умолчанию) 14.
Полуоткрытым (англ. half-open) называют соединение, одна сторона которого перестала существовать без уведомления: узел перезагрузился, пропало питание, NAT-шлюз забыл трансляцию. Вторая сторона продолжает считать соединение установленным. Если она отправит данные, получит в ответ RST и узнает о разрыве. Но если она только ждёт данных, ожидание может длиться бесконечно — TCP не обменивается сегментами в отсутствие данных. Для обнаружения таких соединений служит механизм проверки живости (англ. keepalive): после заданного времени простоя TCP отправляет пустой сегмент с уже подтверждённым номером, на который живой собеседник обязан ответить ACK. Keepalive включается приложением опцией SO_KEEPALIVE, а время простоя по умолчанию в Linux — 7200 с, то есть два часа 1214; поэтому многие протоколы приложений реализуют собственные проверки живости с куда меньшими интервалами.
Сокеты Беркли и наблюдение за соединениями
Интерфейс сокетов и последовательность вызовов
Приложение обращается к транспортному уровню через программный интерфейс операционной системы. Де-факто стандартом стал интерфейс сокетов Беркли (англ. Berkeley sockets), появившийся в 4.2BSD в 1983 году и вошедший затем в стандарт POSIX; его варианты есть во всех современных ОС, включая Windows (Winsock) 10. Сокет (англ. socket) — объект ядра, представляющий конечную точку обмена; приложение работает с ним через файловый дескриптор.
Основные вызовы и их связь с протоколом:
| Вызов | Кто вызывает | Что происходит |
|---|---|---|
socket(семейство, тип) | обе стороны | создаётся сокет: AF_INET/AF_INET6, SOCK_STREAM (TCP) или SOCK_DGRAM (UDP) |
bind(адрес, порт) | сервер | сокету назначается локальный адрес и порт |
listen(backlog) | сервер | сокет переходит в LISTEN |
connect(адрес, порт) | клиент | ядро выбирает эфемерный порт и выполняет рукопожатие; вызов завершается в ESTABLISHED |
accept() | сервер | из очереди установленных соединений извлекается одно; возвращается новый сокет |
send(), recv() | обе стороны | данные копируются в буфер отправки ядра или из буфера приёма |
shutdown(SHUT_WR) | любая | отправляется FIN, чтение остаётся возможным |
close() | любая | сокет закрывается; для TCP — FIN (или RST при непрочитанных данных) |
Последовательность вызовов клиента и сервера и её соответствие сегментам TCP показаны на рисунке.
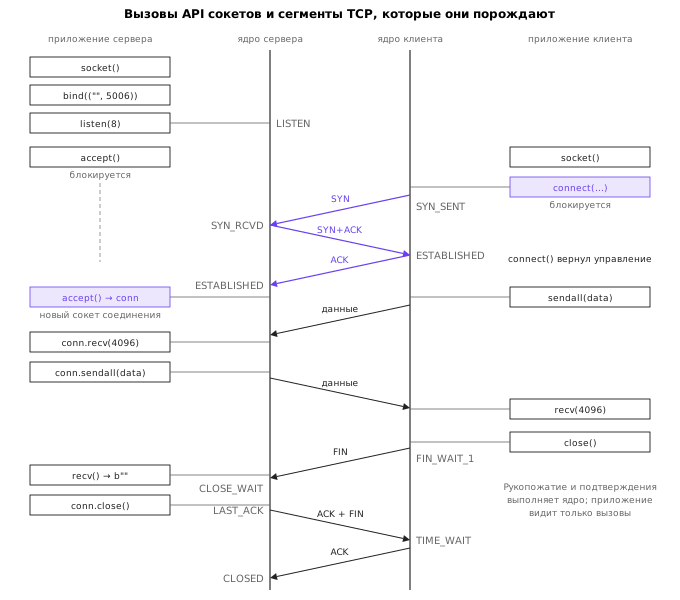
Важно понимать, что рукопожатие выполняет ядро, а не приложение. Сервер, вызвавший listen(), принимает соединения, даже если приложение ещё не дошло до accept(): ядро само отвечает SYN+ACK и складывает установленные соединения в очередь. Вызов accept() лишь забирает готовое соединение. Аналогично send() завершается, как только данные скопированы в буфер ядра, а вовсе не когда они доставлены получателю.
На Python минимальный TCP-сервер, возвращающий клиенту полученные данные, выглядит так (полная версия с комментариями — в окружении лабораторной работы):
import socket

lsock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
lsock.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
lsock.bind(("", 5006))          # "" — любой адрес узла
lsock.listen(8)                 # LISTEN
while True:
    conn, addr = lsock.accept() # новый сокет для каждого клиента
    with conn:
        while data := conn.recv(4096):   # b"" — собеседник прислал FIN
            conn.sendall(data)
Клиент вызывает socket.create_connection(("10.12.0.2", 5006)), который выполняет socket() и connect(), затем sendall() и recv(). Для UDP всё проще: сервер вызывает bind() и затем в цикле recvfrom(), возвращающий датаграмму вместе с адресом отправителя, и sendto(); listen() и accept() не нужны, потому что соединений нет.
Частичная отправка и приём
Из потоковой природы TCP следуют два правила программирования. Первое: recv(n) возвращает от одного до n байтов — сколько есть в буфере приёма на момент вызова, — и пустой результат только при закрытии потока собеседником. Второе: send() может принять в буфер ядра не все переданные данные и возвращает число принятых байтов; остаток приложение обязано отправить повторно. В Python для этого есть sendall(), повторяющий send() до полной отправки, а для чтения нужно писать цикл самостоятельно.
Поэтому протокол приложения поверх TCP почти всегда содержит кадрирование. Простейший и надёжный способ — префикс длины: перед каждым сообщением передаётся его длина фиксированным числом байтов в сетевом порядке (англ. network byte order, big-endian). Получатель читает ровно 4 байта заголовка, затем ровно столько байтов, сколько указано в нём, — оба чтения в цикле до получения нужного количества. Такой протокол чата реализуется в лабораторной работе.
Блокирующий и неблокирующий ввод-вывод, мультиплексирование
По умолчанию вызовы сокетов блокирующие (англ. blocking): accept() ждёт входящего соединения, recv() — данных, send() — места в буфере. Сервер из примера выше обслуживает клиентов строго по очереди: пока он в цикле обмена с одним клиентом, остальные ждут в очереди listen. Существуют три основных способа обслуживать многих клиентов одновременно 10.
Первый — отдельный поток или процесс на каждое соединение. Код остаётся простым и блокирующим, но каждый поток расходует память под стек и время на переключение, и при десятках тысяч соединений это становится узким местом (так называемая проблема C10K, сформулированная в 1999 году).
Второй — неблокирующие сокеты и мультиплексирование ввода-вывода (англ. I/O multiplexing). Сокет переводится в неблокирующий режим, при котором вызов, который пришлось бы ждать, немедленно возвращает ошибку «попробуйте позже» (EAGAIN). Программа в одном потоке спрашивает у ядра: «какие из этих сокетов готовы к чтению или записи?» — и обрабатывает только готовые. Классический вызов select() из 4.2BSD принимает множество дескрипторов при каждом обращении и просматривает его целиком, поэтому его стоимость растёт с числом соединений. Механизмы epoll в Linux и kqueue в BSD-системах регистрируют интерес к сокетам один раз и возвращают только готовые, поэтому масштабируются до сотен тысяч соединений. На этой модели — цикле событий (англ. event loop) — построены nginx, Node.js, модуль asyncio Python. В Python модуль selectors выбирает лучший доступный механизм автоматически; чат-сервер лабораторной работы сообщает при запуске селектор: EpollSelector.
Третий способ — асинхронный ввод-вывод, при котором приложение ставит операцию в очередь и получает уведомление о её завершении (Windows IOCP, io_uring в Linux). Для понимания транспортного уровня достаточно запомнить главное: независимо от модели, соединения и буферы находятся в ядре, а модель ввода-вывода определяет лишь то, как приложение узнаёт о готовности данных.
Наблюдение за сокетами: ss и /proc/net/tcp
Основной инструмент наблюдения за сокетами в Linux — утилита ss из пакета iproute2, пришедшая на смену netstat 13. Полезные ключи: -t — TCP, -u — UDP, -a — все сокеты, включая слушающие, -l — только слушающие, -n — числовые адреса и порты, -p — процесс, -o — таймеры, -i — внутренние параметры TCP, -e — расширенные сведения. Фильтры позволяют выбрать состояние и адреса: ss -tn state time-wait, ss -tn dport = :443. Пример с внутренними параметрами соединения, установленного в лабораторной работе:
ip netns exec cli ss -tanoi
State Recv-Q Send-Q Local Address:Port  Peer Address:Port Process
ESTAB 0      0          10.12.0.1:55736    10.12.0.2:5006
	 ts sack cubic wscale:7,7 rto:212 rtt:10.172/3.842 ato:40 mss:1448 pmtu:1500 rcvmss:536 advmss:1448
	 cwnd:10 bytes_sent:18 bytes_acked:19 bytes_received:18 segs_out:4 segs_in:3 ...
Из вывода видно согласованное в SYN: метки времени (ts), SACK, масштаб окна 7 в обе стороны. Измеренный RTT — 10,2 мс, что соответствует задержке звена; таймаут повторной передачи rto:212 мс; размер сегмента 1448 байт — 1460 минус 12 байт опции меток времени; алгоритм управления перегрузкой cubic и окно перегрузки cwnd:10 сегментов. Смысл этих величин — предмет темы 13. Столбцы Recv-Q и Send-Q у установленного соединения показывают число байтов в буферах приёма (не прочитанных приложением) и отправки (не подтверждённых собеседником); у слушающего сокета — текущую и максимальную длину очереди принятых соединений.
Сама ss получает сведения через специальный интерфейс ядра (netlink), а старый netstat читает текстовые файлы /proc/net/tcp, /proc/net/tcp6, /proc/net/udp. Их полезно разобрать хотя бы однажды:
  sl  local_address rem_address   st tx_queue rx_queue ...
   0: 01000C0A:D9B8 02000C0A:138E 06 00000000:00000000 ...
Адрес записан как 32-битное число в порядке байтов процессора (на x86 — от младшего к старшему): 01000C0A читается справа налево по байтам 0A.0C.00.01, то есть 10.12.0.1. Порт D9B8 = 55736, 138E = 5006. Поле st — номер состояния из перечисления ядра: 01 — ESTABLISHED, 06 — TIME_WAIT, 08 — CLOSE_WAIT, 0A — LISTEN. Сценарий proc_tcp.py из окружения лабораторной работы выполняет эту расшифровку.
Итоги темы
Транспортный уровень превращает доставку между узлами в доставку между процессами. Для этого служат 16-битные номера портов: сервер слушает известный порт, клиент получает временный, а соединение TCP однозначно определяется пятёркой «протокол, адреса и порты обеих сторон», поэтому один серверный порт обслуживает любое число клиентов.
UDP добавляет к IP только порты и контрольную сумму с псевдозаголовком и сохраняет границы датаграмм. Его выбирают для коротких обменов «запрос — ответ», данных реального времени и как основу собственных транспортных протоколов, подобных QUIC; ответственность за потери, перегрузку и защиту от подделки адресов при этом переходит к приложению.
Надёжная передача поверх ненадёжного канала собирается из четырёх элементов: контрольной суммы, подтверждений, номеров последовательности и таймера. Протокол с остановкой и ожиданием корректен, но на канале с большим произведением пропускной способности на задержку загружает его ничтожно; конвейерная передача со скользящим окном решает эту проблему, а протоколы с возвратом на N и выборочным повтором представляют два способа восстановления после потерь. TCP сочетает их черты и нумерует байты, а не пакеты.
TCP предоставляет надёжный упорядоченный поток байтов без границ сообщений, поэтому приложение обязано само кадрировать свои сообщения. Соединение устанавливается трёхкратным рукопожатием со случайными начальными номерами, завершается независимо в каждом направлении сегментами FIN и описывается конечным автоматом из 11 состояний. Состояние TIME_WAIT у стороны, закрывшей первой, защищает завершение и будущие соединения; большое число соединений в CLOSE_WAIT указывает на ошибку приложения; закрытый порт отвечает RST, отфильтрованный — молчанием. Приложения пользуются транспортом через сокеты Беркли, а наблюдать соединения позволяют ss и /proc/net/tcp.
Открытыми остались вопросы, как именно TCP выбирает таймаут повторной передачи, как он не переполняет буфер получателя и, главное, как множество независимых соединений делит пропускную способность сети, не вызывая её перегрузки. Эти механизмы — управление потоком и управление перегрузкой — составляют предмет темы 13.
Литература
- Postel J. User Datagram Protocol. — RFC 768, IETF, 1980. https://www.rfc-editor.org/rfc/rfc768
- Eddy W. (Ed.) Transmission Control Protocol (TCP). — RFC 9293, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9293
- Postel J. Transmission Control Protocol. — RFC 793, IETF, 1981. https://www.rfc-editor.org/rfc/rfc793
- Cerf V., Kahn R. A Protocol for Packet Network Intercommunication. — IEEE Transactions on Communications, 1974, Vol. 22, No. 5, P. 637–648, DOI: 10.1109/TCOM.1974.1092259.
- Gont F., Bellovin S. Defending against Sequence Number Attacks. — RFC 6528, IETF, 2012. https://www.rfc-editor.org/rfc/rfc6528
- Eddy W. TCP SYN Flooding Attacks and Common Mitigations. — RFC 4987, IETF, 2007. https://www.rfc-editor.org/rfc/rfc4987
- Cotton M., Eggert L., Touch J., Westerlund M., Cheshire S. Internet Assigned Numbers Authority (IANA) Procedures for the Management of the Service Name and Transport Protocol Port Number Registry. — RFC 6335, IETF, 2011. https://www.rfc-editor.org/rfc/rfc6335
- Eggert L., Fairhurst G., Shepherd G. UDP Usage Guidelines. — RFC 8085, IETF, 2017. https://www.rfc-editor.org/rfc/rfc8085
- Kurose J. F., Ross K. W. Computer Networking: A Top-Down Approach. 8th ed. — Pearson, 2021.
- Stevens W. R., Fenner B., Rudoff A. M. UNIX Network Programming. Volume 1: The Sockets Networking API. 3rd ed. — Addison-Wesley, 2003.
- Fall K. R., Stevens W. R. TCP/IP Illustrated. Volume 1: The Protocols. 2nd ed. — Addison-Wesley, 2011.
- Braden R. (Ed.) Requirements for Internet Hosts — Communication Layers. — RFC 1122, IETF, 1989. https://www.rfc-editor.org/rfc/rfc1122
- The Linux man-pages project. tcp(7), udp(7), ss(8). — 2025. https://man7.org/linux/man-pages/man7/tcp.7.html
- The Linux Kernel Documentation. IP Sysctl. — 2025. https://docs.kernel.org/networking/ip-sysctl.html