TCP: надёжность, управление потоком и перегрузкой
В теме 12 протокол TCP был рассмотрен как служба, предоставляемая приложению: соединение устанавливается трёхкратным рукопожатием, данные передаются упорядоченным потоком байтов, каждый байт имеет номер последовательности, а получатель подтверждает принятое. Там же на абстрактных протоколах надёжной передачи были введены подтверждения, таймауты, скользящее окно, схемы Go-Back-N и выборочного повтора. Остался открытым главный вопрос: как именно TCP пользуется этими идеями в реальной сети, где время доставки меняется в десятки раз, получатель может не успевать обрабатывать данные, а канал разделяется с тысячами чужих соединений.
Тема отвечает на три связанных вопроса. Первый — надёжность: когда отправитель решает, что сегмент потерян, и что он повторяет. Ошибка в любую сторону дорого обходится: слишком ранний повтор засоряет сеть дубликатами, слишком поздний останавливает передачу. Второй — управление потоком (англ. flow control): как не переполнить буфер приёма получателя. Третий — управление перегрузкой (англ. congestion control): как не переполнить саму сеть. Последняя задача принципиально сложнее двух первых, потому что отправитель ничего не знает ни о пропускной способности пути, ни о других потоках, и вынужден выводить состояние сети из косвенных признаков — потерь, задержек, меток в заголовках.
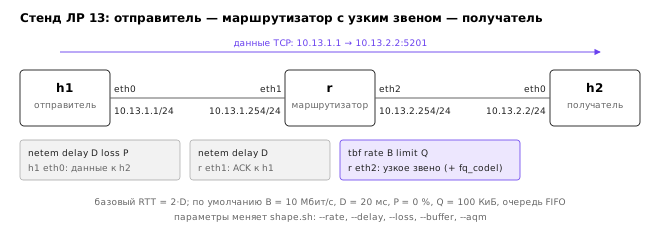
Изложение идёт от механизмов отдельного соединения к поведению сети в целом. Сначала рассматриваются подтверждения и повторная передача, затем вычисление таймера повторной передачи, затем окно получателя. После этого изложена история коллапса перегрузки 1986 года и классические алгоритмы Джекобсона, их современные преемники CUBIC и BBR, явное уведомление о перегрузке и проблема переполненных буферов. Завершает тему количественная модель: сколько данных в секунду способен передать один поток TCP при заданных задержке и доле потерь. Все числовые примеры воспроизводятся в лабораторной работе 13 на учебном стенде из пространств имён Linux.
Надёжная доставка: подтверждения и повторная передача
Номера последовательности и кумулятивные подтверждения
TCP нумерует не сегменты, а байты потока. Поле номера последовательности (англ. sequence number) в заголовке содержит номер первого байта данных сегмента, а поле номера подтверждения (англ. acknowledgment number) — номер следующего байта, который получатель ожидает 1. Если получены байты с 1 по 14480, получатель отвечает ack 14481: «всё до 14480 включительно принято, жду 14481». Такое подтверждение называется кумулятивным (англ. cumulative acknowledgment): одно число подтверждает весь непрерывный префикс потока.
Кумулятивность даёт устойчивость к потере самих подтверждений. Если подтверждение ack 2897 потеряно, а следующее ack 5793 дошло, отправитель узнаёт из него и то, что сообщало потерянное. Цена кумулятивности проявляется при потере данных: если из десяти сегментов потерян третий, получатель, приняв четвёртый — десятый, не может сообщить об этом в поле подтверждения. Номер подтверждения остаётся на начале потерянного сегмента, и каждый следующий сегмент вызывает повтор того же номера. Подтверждение с номером, который уже присылался, называют дублирующим (англ. duplicate ACK, dupACK).
Сегменты, пришедшие после пропуска, TCP-получатель обычно не выбрасывает, а хранит в буфере вне порядка (англ. out-of-order queue) до прихода недостающего сегмента. В этом TCP ближе к схеме выборочного повтора, чем к Go-Back-N из темы 12: после устранения пропуска весь накопленный хвост подтверждается одним скачком номера. Однако без дополнительных средств отправитель не знает, какие именно сегменты лежат у получателя, и при нескольких потерях в одном окне вынужден действовать вслепую.
Отложенные подтверждения
Подтверждать каждый сегмент отдельно расточительно: при передаче больших объёмов половина пакетов в обратном направлении оказалась бы «пустыми» подтверждениями длиной 40–52 байта. Поэтому получатель задерживает подтверждение в надежде, что за это время придёт ещё один сегмент или у приложения появятся данные для ответа, к которым подтверждение «прицепится» (англ. piggybacking). Механизм называется отложенным подтверждением (англ. delayed ACK). Стандарт ограничивает его двумя правилами: подтверждение должно отправляться по крайней мере на каждый второй полноразмерный сегмент и не позднее чем через 500 мс после прихода неподтверждённых данных 1.
Конкретные задержки определяет реализация. В Linux таймер отложенного подтверждения адаптивен и лежит в пределах примерно от 40 до 200 мс; кроме того, в начале соединения и после обнаружения пропуска ядро временно переходит в режим быстрых подтверждений (англ. quick ACK) и подтверждает каждый сегмент. Это поведение видно в выводе ss -ti, где поле ato (англ. ACK timeout) показывает текущее значение таймера. Отложенные подтверждения важны не только как экономия: ниже будет показано, что их взаимодействие с алгоритмом Нейгла даёт характерные задержки в 40–200 мс в интерактивных протоколах.
Быстрая повторная передача
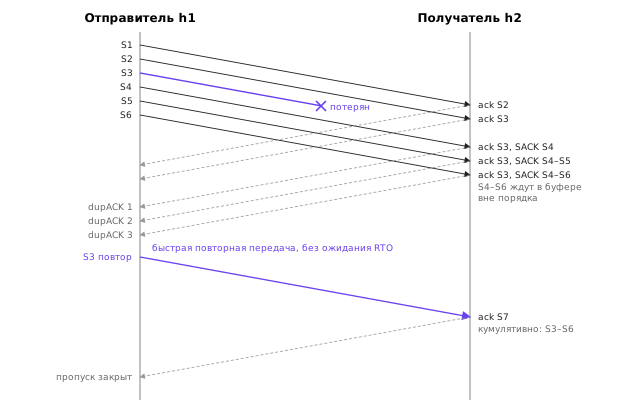
Первый способ обнаружить потерю — таймер: если подтверждение не пришло за время RTO (англ. retransmission timeout), сегмент передаётся повторно. Как вычисляется RTO, рассмотрено в следующем разделе; здесь важно, что он заведомо больше времени кругового обхода (RTT), и ожидание таймера означает простой в одну-две сотни миллисекунд и более. Второй, более быстрый способ использует дублирующие подтверждения. Один dupACK ещё не доказывает потерю: сегменты могут прийти к получателю в другом порядке, например при распределении трафика по параллельным путям. Но если подряд пришли три дублирующих подтверждения одного номера, перестановка маловероятна, и отправитель, не дожидаясь таймера, повторяет сегмент, начинающийся с этого номера. Механизм называется быстрой повторной передачей (англ. fast retransmit), порог в три dupACK закреплён в RFC 5681 3.
Ниже приведён фрагмент реального захвата на учебном стенде лабораторной работы: отправитель 10.13.1.1 передаёт поток получателю 10.13.2.2 через канал 10 Мбит/с с RTT 40 мс и 1 % случайных потерь. Опции временных меток удалены для краткости.
39.865081 10.13.2.2.5201 > 10.13.1.1.33868: Flags [.], ack 57921, win 1074, length 0
39.865209 10.13.2.2.5201 > 10.13.1.1.33868: Flags [.], ack 57921, win 1096, options [sack 1 {59369:60817}], length 0
39.866416 10.13.2.2.5201 > 10.13.1.1.33868: Flags [.], ack 57921, win 1119, options [sack 1 {59369:62265}], length 0
39.867628 10.13.2.2.5201 > 10.13.1.1.33868: Flags [.], ack 57921, win 1142, options [sack 1 {59369:63713}], length 0
...
39.887675 10.13.1.1.33868 > 10.13.2.2.5201: Flags [.], seq 57921:59369, ack 1, win 502, length 1448
Сегмент с байтами 57921–59368 был потерян. Получатель продолжает подтверждать номер 57921, каждый раз сообщая в опции SACK (о ней — ниже), какой непрерывный блок за пропуском у него уже есть: сначала 59369–60816, затем блок растёт по мере прихода новых сегментов. После третьего дублирующего подтверждения отправитель повторяет ровно один потерянный сегмент seq 57921:59369. Интервал около 20 мс между третьим dupACK и повтором в захвате объясняется устройством стенда: на выходе отправителя стоит эмулятор задержки, и захват видит сегмент уже после неё. Схема на рисунке ниже показывает тот же обмен в виде временной диаграммы.
Обратим внимание на поле win: оно растёт от 1074 до 1142, хотя приложение получателя ничего не прочитало из сокета специально для этого. Значения указаны в единицах масштабированного окна, о масштабировании речь пойдёт в разделе об управлении потоком.
Выборочные подтверждения SACK
Кумулятивное подтверждение сообщает только левую границу пропуска. Если в одном окне потеряно несколько сегментов, отправитель узнаёт о каждом следующем пропуске лишь после того, как исправлен предыдущий, — по одному пропуску на RTT. Выборочное подтверждение (англ. Selective Acknowledgment, SACK) решает эту задачу: получатель перечисляет в опции заголовка блоки байтов, принятые вне порядка, в виде пар «левая граница — правая граница» 6. Поддержка SACK согласуется при установлении соединения опцией SACK-permitted; в захвате рукопожатия она видна как sackOK.
Длина поля опций TCP ограничена 40 байтами, а один блок SACK занимает 8 байтов. Поэтому в сегменте помещается не более четырёх блоков, а при одновременном использовании временных меток (10 байтов) — не более трёх 6. Получатель всегда ставит первым блок, содержащий самый свежий принятый сегмент, так что даже при потере части подтверждений отправитель постепенно собирает полную картину. На основе этой картины отправитель ведёт табло (англ. scoreboard) — перечень того, что получено, что считается потерянным и что ещё находится в пути, — и повторяет только действительно отсутствующие сегменты.
Современные реализации идут дальше. Linux по умолчанию использует алгоритм RACK-TLP, который объявляет сегмент потерянным не по числу дублирующих подтверждений, а по времени: если подтверждён сегмент, отправленный заметно позже данного, данный считается потерянным. Это лучше работает при переупорядочении пакетов и при потерях в хвосте передачи, когда трёх dupACK просто не набирается. Концептуально, однако, все эти алгоритмы решают одну и ту же задачу — как можно раньше и как можно точнее отличить потерю от задержки.
Таймер повторной передачи
Почему таймаут нельзя задать константой
Таймер повторной передачи остаётся последним рубежом надёжности: если потеряны и сегмент, и все последующие, никаких дублирующих подтверждений не будет, и только истечение таймера заставит отправителя повторить данные. Значение таймаута должно быть немного больше времени, за которое подтверждение обычно приходит. Но RTT различается на порядки: внутри стойки центра обработки данных — десятки микросекунд, по городу — единицы миллисекунд, между континентами — 100–300 мс, через геостационарный спутник — более 500 мс. Кроме того, RTT одного соединения меняется во времени: при заполнении очереди на узком звене он может вырасти в несколько раз, что будет показано в разделе о буферах.
Поэтому RTO вычисляется адаптивно по измерениям. Отправитель отмечает время отправки сегмента и время прихода подтверждающего его ACK, разность даёт выборку RTT. Одна выборка ненадёжна, поэтому TCP ведёт две сглаженные величины: среднее и разброс. Идея оценивать разброс, а не только среднее, принадлежит Джекобсону 4: в ранних реализациях RTO вычислялся как удвоенное среднее, и при высокой изменчивости задержки, типичной для перегруженной сети, этого оказывалось мало. Таймер срабатывал преждевременно, сеть засорялась ненужными повторами, что только усиливало перегрузку.
Алгоритм RFC 6298 на числах
Стандартный алгоритм описан в RFC 6298 2. Отправитель хранит сглаженное время кругового обхода SRTT (англ. smoothed RTT) и его вариацию RTTVAR (англ. RTT variation). По первой выборке R:
- SRTT = R;
- RTTVAR = R/2;
- RTO = SRTT + max(G, K·RTTVAR), где K = 4, а G — гранулярность часов.
По каждой следующей выборке R′ сначала обновляется вариация, затем среднее, причём в формуле вариации используется ещё старое значение SRTT:
- RTTVAR = (1 − β)·RTTVAR + β·|SRTT − R′|, где β = 1/4;
- SRTT = (1 − α)·SRTT + α·R′, где α = 1/8;
- RTO = SRTT + max(G, K·RTTVAR).
Формулы реализуют экспоненциально взвешенное скользящее среднее (англ. exponentially weighted moving average, EWMA): каждая новая выборка входит в среднее с весом 1/8, вклад старых выборок затухает геометрически. Коэффициенты 1/8 и 1/4 выбраны так, чтобы вычисления сводились к сдвигам целых чисел. До получения первой выборки RTO принимается равным 1 с; вычисленное значение, меньшее 1 с, следует округлять до 1 с; верхняя граница допускается, но должна быть не меньше 60 с 2.
Рассмотрим соединение, в котором последовательно получены выборки 100, 120, 300 и 110 мс (гранулярность часов пренебрежимо мала). Результаты сведены в таблицу.
| Шаг | Выборка R, мс | RTTVAR, мс | SRTT, мс | SRTT + 4·RTTVAR, мс |
|---|---|---|---|---|
| 1 | 100 | 100/2 = 50 | 100 | 300 |
| 2 | 120 | 0,75·50 + 0,25·20 = 42,5 | 0,875·100 + 0,125·120 = 102,5 | 272,5 |
| 3 | 300 | 0,75·42,5 + 0,25·197,5 = 81,25 | 0,875·102,5 + 0,125·300 = 127,19 | 452,2 |
| 4 | 110 | 0,75·81,25 + 0,25·17,19 = 65,23 | 0,875·127,19 + 0,125·110 = 125,04 | 386,0 |
На третьем шаге одиночная выборка 300 мс, втрое превышающая среднее, сдвинула SRTT всего на 25 мс, но почти удвоила вариацию, и RTO вырос до 452 мс. Таймер реагирует на рост изменчивости быстрее, чем на рост среднего, — именно это и требовалось. По строгому правилу RFC 6298 все четыре значения пришлось бы поднять до 1 с, поскольку они меньше минимума 2. Минимум в 1 с введён осторожно, с оглядкой на ложные срабатывания, и в реальных системах часто смягчается.
Linux использует нижнюю границу 200 мс (параметр tcp_rto_min, может задаваться и для отдельного маршрута опцией rto_min команды ip route), а слагаемое, отвечающее за вариацию, не опускается ниже этой границы. Поэтому на коротких путях RTO в Linux приблизительно равен SRTT + 200 мс. Вывод ss -ti на учебном стенде с RTT 40 мс это подтверждает:
ESTAB 0      360952     10.13.1.1:57482    10.13.2.2:5201
	 reno wscale:7,7 rto:248 rtt:46.459/8.617 mss:1448 ... cwnd:12 ssthresh:11 ... retrans:0/13 ... minrtt:40
Поле rtt:46.459/8.617 содержит SRTT и RTTVAR в миллисекундах, rto:248 — текущий таймаут, округлённый до тиков системного таймера. Формула RFC 6298 дала бы 46,5 + 4·8,6 ≈ 81 мс, но нижняя граница поднимает значение до 46 + 200 ≈ 248 мс.
Алгоритм Карна и экспоненциальная отсрочка
Измерение RTT по повторно переданному сегменту неоднозначно. Если сегмент отправлен, затем повторён по таймеру и пришло подтверждение, неизвестно, на какую из двух копий оно ответ. Отнести его к первой отправке — значит получить завышенную выборку; ко второй — возможно, заниженную, если на самом деле запоздало подтверждение первой копии. Алгоритм Карна (Karn's algorithm, по имени Ф. Карна и К. Партриджа, описавших его в 1987 году) запрещает брать выборки RTT по повторно переданным сегментам 2.
Само по себе это правило создаёт ловушку: если задержка в сети резко выросла и таймер начал срабатывать, новых достоверных выборок не будет, и RTO останется старым, слишком маленьким. Поэтому правило Карна дополняется экспоненциальной отсрочкой (англ. exponential backoff): при каждом срабатывании таймера RTO удваивается, и удвоенное значение сохраняется до получения подтверждения на новые, не повторённые данные 2. При начальном RTO 1 с последовательные попытки повтора происходят через 1, 2, 4, 8, 16 с и так далее. Linux ограничивает RTO сверху 120 с и после заданного числа неудач (параметр tcp_retries2, по умолчанию 15) разрывает соединение, что при коротком RTT соответствует примерно 15 минутам безуспешных попыток, а при длинном — ещё больше.
Неоднозначность измерений устраняет опция временных меток (англ. timestamps, TSopt) из RFC 7323 5. Отправитель кладёт в каждый сегмент значение своих часов TS val, получатель возвращает его в поле TS ecr подтверждения. Разность текущего времени и TS ecr даёт выборку RTT по любому подтверждению, в том числе на повторённые данные. В захвате выше опция присутствует в каждом сегменте: TS val 3012562458 ecr 2182740891. Та же опция служит защитой от «оборачивания» номеров последовательности (англ. Protection Against Wrapped Sequences, PAWS): 32-битное пространство номеров на скорости 10 Гбит/с исчерпывается примерно за 3,4 с, и старый сегмент, задержавшийся в сети, мог бы оказаться принят за новый 5.
Управление потоком
Окно получателя
Получатель TCP хранит принятые данные в буфере сокета до тех пор, пока приложение не прочитает их вызовом recv(). Если приложение читает медленнее, чем приходят данные, буфер заполняется. Чтобы отправитель не переполнил его, каждый сегмент, идущий от получателя, несёт в поле окна (англ. window) объём свободного места в буфере — окно получателя rwnd (англ. receive window) 1. Отправитель обязан следить, чтобы количество отправленных, но не подтверждённых байтов не превышало последнего объявленного окна. Таким образом, окно получателя ограничивает число байтов «в полёте» (англ. bytes in flight), а скорость передачи оказывается не больше rwnd/RTT.
Если приложение-получатель не читает данные совсем, окно уменьшается до нуля, и отправитель останавливается. Возникает опасность взаимной блокировки: когда приложение наконец прочитает данные и окно откроется, получатель отправит подтверждение с ненулевым окном, но это подтверждение не содержит данных, никем не подтверждается и может быть потеряно. Отправитель будет ждать открытия окна вечно, а получатель — данных. Поэтому при нулевом окне отправитель запускает таймер настойчивости (англ. persist timer) и периодически посылает пробы нулевого окна (англ. zero window probe), вынуждающие получателя ответить текущим окном 1. В Wireshark такие сегменты помечаются как TCP ZeroWindow и TCP ZeroWindowProbe.
Важно не путать управление потоком с управлением перегрузкой. Первое защищает получателя и опирается на точную информацию, которую получатель сам сообщает. Второе защищает сеть, и точной информации у отправителя нет. Оба механизма действуют одновременно: отправитель ограничивает объём данных в полёте меньшим из двух окон, окна получателя rwnd и окна перегрузки cwnd.
Масштабирование окна
Поле окна в заголовке TCP занимает 16 бит, поэтому без расширений окно не может превышать 65 535 байтов. Для локальной сети этого достаточно, но рассмотрим путь с пропускной способностью 100 Мбит/с и RTT 80 мс. Чтобы загрузить его полностью, в полёте должно находиться столько данных, сколько канал передаёт за время кругового обхода, — произведение пропускной способности на задержку (англ. bandwidth-delay product, BDP), введённое в теме 1:
BDP = 100·10⁶ бит/с · 0,08 с = 8·10⁶ бит = 1 000 000 байтов.
С окном 65 535 байтов скорость ограничена величиной 65 535·8 / 0,08 ≈ 6,55 Мбит/с — пятнадцатая часть канала, сколько бы ни было свободной ёмкости. Каналы, у которых BDP значительно превышает 64 КиБ, в RFC 7323 названы «длинными толстыми трубами» (англ. long fat networks, LFN) 5.
Опция масштабирования окна (англ. Window Scale, WSopt) из того же RFC вводит множитель: стороны при установлении соединения сообщают сдвиг S от 0 до 14, и значение поля окна в последующих сегментах умножается на 2^S 5. Максимальное окно становится равным 65 535·2^14 ≈ 1 ГиБ. Опция передаётся только в сегментах SYN и действует до конца соединения. В захвате выше рукопожатие содержит wscale 7, поэтому значение win 1096 в подтверждении означает 1096·128 = 140 288 байтов свободного места. Отсюда типичная ошибка при чтении захватов: если начало соединения не попало в захват, анализатор не знает множителя и показывает окно, заниженное в 128 раз; Wireshark в таком случае пишет «window size scaling factor: -1 (unknown)».
Размеры буферов сокета в Linux по умолчанию настраиваются автоматически (англ. autotuning) в пределах, заданных параметрами net.ipv4.tcp_rmem и net.ipv4.tcp_wmem: три числа — минимум, начальное значение и максимум в байтах.
sysctl net.ipv4.tcp_rmem net.ipv4.tcp_wmem net.ipv4.tcp_window_scaling
net.ipv4.tcp_rmem = 4096	131072	6291456
net.ipv4.tcp_wmem = 4096	16384	4194304
net.ipv4.tcp_window_scaling = 1
Максимальный буфер приёма 6 МиБ при RTT 100 мс позволяет одному потоку достичь не более 6 291 456·8/0,1 ≈ 500 Мбит/с (фактически меньше, поскольку часть буфера уходит на служебные структуры ядра); на более быстрых межконтинентальных путях это ограничение становится заметным. Явная установка размера буфера в приложении вызовом setsockopt(SO_RCVBUF) отключает автонастройку для этого сокета, и нередко именно она, а не сеть, оказывается причиной низкой скорости.
Синдром глупого окна и алгоритм Нейгла
Механизм окна допускает патологический режим, который назвали синдромом глупого окна (англ. silly window syndrome). Пусть приложение-получатель читает данные по одному байту. Каждый раз освобождается один байт, получатель объявляет окно в один байт, отправитель тут же посылает сегмент с одним байтом данных и 40 байтами заголовков IP и TCP. Эффективность канала падает до 1/41. Симметричная проблема возникает на стороне отправителя, когда приложение пишет в сокет мелкими порциями. RFC 9293 закрепляет оба лекарства 1. Получатель не объявляет увеличение окна, пока свободное место не достигнет одного полного сегмента MSS или половины буфера. Отправитель не посылает маленький сегмент, если может вскоре собрать полный.
Правило для отправителя называется алгоритмом Нейгла (англ. Nagle's algorithm), по имени Дж. Нейгла, предложившего его в 1984 году 1. Формулировка проста: если в полёте есть неподтверждённые данные, новые мелкие порции не отправляются, а накапливаются в буфере до прихода подтверждения или до набора полного сегмента. Для терминального сеанса это означает, что при быстром наборе символы уходят пачками раз в RTT, а не по одному в отдельном пакете.
Алгоритм Нейгла плохо сочетается с отложенными подтверждениями. Рассмотрим приложение, которое отправляет запрос двумя вызовами send(): сначала заголовок из 100 байтов, затем тело из 50 байтов, после чего ждёт ответа. Первая порция уходит сразу, вторая задерживается алгоритмом Нейгла до прихода подтверждения на первую. Получатель же, получив неполный запрос, не может ответить и откладывает подтверждение, ожидая второго сегмента. Обе стороны ждут друг друга, пока не сработает таймер отложенного подтверждения — 40 мс в Linux или до 200 мс в других системах. Каждый запрос получает лишнюю задержку, хотя сеть свободна. Лечится это двумя способами: собирать сообщение целиком перед вызовом send() (один системный вызов или sendmsg() с несколькими буферами) либо отключать алгоритм Нейгла опцией сокета TCP_NODELAY, что и делают большинство интерактивных протоколов и HTTP-клиентов. Второй способ без первого порождает поток мелких пакетов, поэтому правильным решением остаётся кадрирование сообщений на уровне приложения, рассмотренное в теме 12.
Перегрузка сети и классические алгоритмы управления
Коллапс перегрузки 1986 года
В октябре 1986 года на пути между Национальной лабораторией Лоуренса в Беркли и Калифорнийским университетом в Беркли, разделённом тремя транзитными участками, пропускная способность упала с 32 Кбит/с до 40 бит/с, почти в тысячу раз 4. Каналы работали исправно, маршрутизаторы тоже. Происходил коллапс перегрузки (англ. congestion collapse): очереди маршрутизаторов переполнялись, пакеты отбрасывались, отправители по таймерам повторяли их, повторы снова занимали очереди и отбрасывались. Почти вся ёмкость сети тратилась на доставку копий, которые затем выбрасывались, а полезная пропускная способность стремилась к нулю.
Причина была в том, что TCP той поры управлял только потоком: отправитель сразу посылал всё окно получателя, не учитывая, сколько может пропустить сеть. Механизма, который замедлял бы источники при перегрузке, не существовало. Возможность такого коллапса Дж. Нейгл предсказал ещё в 1984 году, но решение предложил В. Джекобсон в статье «Congestion Avoidance and Control» 1988 года 4. Ключевая идея — принцип сохранения пакетов (англ. conservation of packets): в равновесии новый пакет должен входить в сеть только тогда, когда старый её покинул. Подтверждения служат «тактовым сигналом» (англ. ACK clocking): получатель подтверждает сегменты с той скоростью, с какой они проходят узкое звено, и отправитель, посылая новый сегмент в ответ на каждое подтверждение, автоматически подстраивается под эту скорость.
Решение Джекобсона не требовало изменений в маршрутизаторах и в протоколе: только иной алгоритм на отправителе. Именно поэтому оно было быстро внедрено и стало основой всех последующих алгоритмов. За ним стоит важный архитектурный принцип Интернета: сеть остаётся простой, а сложное поведение реализуется на конечных узлах.
Окно перегрузки и AIMD
Отправитель вводит вторую переменную — окно перегрузки cwnd (англ. congestion window), оценку того, сколько данных сеть способна принять в полёте без перегрузки. Фактическое ограничение равно меньшему из двух окон, cwnd и rwnd 3. Сеть не сообщает значение cwnd явно, поэтому отправитель ищет его подбором: постепенно увеличивает окно, пока не произойдёт потеря, считая её признаком переполнения очереди, затем уменьшает.
Каким должен быть закон изменения? Анализ Д. Чиу и Р. Джейна (1989) показал, что из простейших линейных законов к справедливому и эффективному распределению канала между потоками сходится только аддитивное увеличение и мультипликативное уменьшение (англ. additive increase, multiplicative decrease, AIMD). В режиме предотвращения перегрузки окно растёт на один сегмент за RTT, а при потере уменьшается вдвое 3. Интуиция такова. Когда два потока делят канал, при аддитивном росте оба прибавляют одинаковую величину, и разность их окон не меняется. При мультипликативном уменьшении больший поток теряет больше, и разность сокращается вдвое. Цикл за циклом окна сближаются, а сумма колеблется около ёмкости канала.
В терминах RFC 5681 прирост задаётся так: на каждое подтверждение новых данных cwnd увеличивается на SMSS·SMSS/cwnd, где SMSS — максимальный размер сегмента отправителя 3. За один RTT приходит около cwnd/SMSS подтверждений, и в сумме окно вырастает примерно на один сегмент. При потере, обнаруженной по дублирующим подтверждениям, порог медленного старта ssthresh (англ. slow start threshold) устанавливается равным max(FlightSize/2, 2·SMSS), где FlightSize — объём данных в полёте, и окно уменьшается до этого порога.
Медленный старт
Аддитивный рост пригоден вблизи равновесия, но не для начала соединения. Если путь пропускает 1000 сегментов за RTT, а начать с одного сегмента и добавлять по одному за RTT, до полной загрузки пройдёт 1000 RTT, то есть 40 секунд при RTT 40 мс. Поэтому в начале соединения работает медленный старт (англ. slow start): на каждое подтверждение cwnd увеличивается на один сегмент, и окно удваивается каждый RTT 34. Название историческое: «медленным» старт был в сравнении с прежней практикой отправлять сразу всё окно получателя; на деле рост экспоненциальный. Медленный старт продолжается, пока cwnd меньше ssthresh, или до первой потери.
Начальное окно IW (англ. initial window) по RFC 5681 не превышает min(4·SMSS, max(2·SMSS, 4380 байтов)), то есть от двух до четырёх сегментов 3. Экспериментальный RFC 6928 предложил увеличить его до десяти сегментов, примерно 14 600 байтов, поскольку большинство веб-ответов невелико и при маленьком начальном окне их доставка занимает лишние RTT 7. Linux использует IW = 10 с 2011 года. В журнале ss, собранном в лабораторной работе, начальное окно видно непосредственно:
t,lport,cc,cwnd,ssthresh,rtt_ms,rttvar_ms,rto_ms,retrans_total,bytes_acked,unacked,delivery_mbps,inflight_kb
0.000,43676,reno,10,,0,0,1000,0,0,1,0.00,0.5
0.053,43676,reno,10,,40.128,20.064,244,0,1,10,0.00,14.1
0.107,43676,reno,20,,40.205,1.18,244,0,14481,20,2.88,28.3
0.161,43676,reno,52,,42.673,3.31,244,0,60817,52,7.24,73.5
В первой строке соединение только устанавливается, RTT ещё не измерен и RTO равен начальному значению 1000 мс, как требует RFC 6298. Через RTT окно составляет 10 сегментов, ещё через RTT — 20, затем 52: подтверждения приходят по мере прохождения сегментов через узкое звено, и окно на каждом шаге увеличивается на число подтверждённых сегментов. Поле ssthresh пусто: до первой потери порог не определён, и Linux его не печатает.
После срабатывания таймера повторной передачи отправитель считает, что тактовый сигнал подтверждений потерян полностью. Порог ssthresh снижается до max(FlightSize/2, 2·SMSS), а окно сбрасывается до одного сегмента (англ. loss window, LW), после чего снова работает медленный старт 3. Окно быстро, за несколько RTT, возвращается к половине прежнего значения и далее растёт линейно.
Tahoe, Reno, NewReno
Исторически алгоритмы управления перегрузкой называют по версиям BSD Unix, в которых они впервые появились. Вариант Tahoe (4.3BSD-Tahoe, 1988) реализовал медленный старт, предотвращение перегрузки и быструю повторную передачу, но после любой потери сбрасывал cwnd до одного сегмента. Вариант Reno (4.3BSD-Reno, 1990) добавил быстрое восстановление (англ. fast recovery): потеря, обнаруженная по трём дублирующим подтверждениям, означает, что последующие сегменты доходят и сеть не парализована, поэтому медленный старт не нужен. Окно уменьшается вдвое и далее растёт линейно 3. В RFC 5681 быстрое восстановление записано так:
- по третьему dupACK ssthresh = max(FlightSize/2, 2·SMSS), потерянный сегмент повторяется, cwnd = ssthresh + 3·SMSS (три сегмента, вызвавшие dupACK, уже покинули сеть);
- на каждый следующий dupACK cwnd увеличивается на SMSS: ещё один сегмент покинул сеть, и можно отправить новый, сохраняя тактовый сигнал;
- когда приходит подтверждение новых данных, cwnd устанавливается равным ssthresh («сдувание» окна), и отправитель переходит к предотвращению перегрузки.
Reno плохо справляется с несколькими потерями в одном окне. Первое подтверждение новых данных после повтора оказывается частичным (англ. partial ACK): оно подтверждает повторённый сегмент, но не всё окно, потому что следующий потерянный сегмент всё ещё отсутствует. Reno выходит из быстрого восстановления и снова ждёт трёх dupACK, которых при маленьком окне может не набраться, и тогда остаётся только таймер. Модификация NewReno (RFC 6582) остаётся в быстром восстановлении до подтверждения всех данных, бывших в полёте на момент потери, и по каждому частичному подтверждению сразу повторяет следующий отсутствующий сегмент 8. При наличии SACK отправитель знает о всех пропусках сразу и может повторить их за один RTT. Различия трёх вариантов показаны на диаграмме ниже.
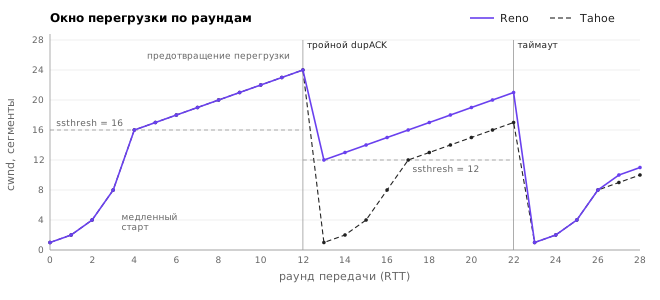
Прочитаем диаграмму по раундам (раунд — один RTT). С начала соединения окно растёт экспоненциально: 1, 2, 4, 8, 16 сегментов. На 16 сегментах начальный порог ssthresh = 16 достигнут, дальше рост линейный: 17, 18, …, 24. В раунде 12, при cwnd = 24, происходит потеря, обнаруженная по тройному dupACK. Оба варианта ставят ssthresh = 12. Tahoe сбрасывает окно до 1 и за четыре раунда медленного старта (1, 2, 4, 8, затем 12 — рост ограничен порогом) возвращается к 12; Reno сразу продолжает с 12 и растёт линейно. За десять раундов между потерей и таймаутом Reno передаёт 165 сегментов, Tahoe — 102. При таймауте в раунде 22, показанном справа, оба варианта начинают с одного сегмента, а порог устанавливается равным половине окна: 10 у Reno и 8 у Tahoe.
Справедливость и её пределы
AIMD обеспечивает справедливое деление канала только между потоками с одинаковым RTT. Линейный рост измеряется в сегментах за RTT, поэтому поток с RTT 10 мс наращивает окно в десять раз чаще, чем поток с RTT 100 мс. Средние окна потоков, проходящих через общее узкое звено, оказываются примерно одинаковыми, а скорости, равные окну, делённому на RTT, обратно пропорциональны RTT. Ближний сервер получает большую долю канала, чем дальний. Это свойство называют несправедливостью по RTT (англ. RTT unfairness).
Второе ограничение — справедливость определяется на уровне соединений, а не приложений или пользователей. Приложение, открывшее шесть параллельных соединений (так поступали браузеры с HTTP/1.1), получает на узком звене примерно в шесть раз больше, чем приложение с одним соединением. Наконец, справедливость держится на добровольном соблюдении правил: отправитель, не снижающий скорость при потерях, вытесняет «вежливых» соседей. Защиту от этого может дать только сеть, например планировщик очередей, делящий канал по потокам; к нему изложение вернётся в разделе о буферах.
Современные алгоритмы, ECN и буферы
CUBIC
Линейный рост на один сегмент за RTT непригоден для быстрых длинных путей. Рассмотрим путь 10 Гбит/с с RTT 100 мс. BDP составляет 125 МБ, или около 86 000 сегментов по 1448 байтов. После одной потери Reno уменьшает окно до 43 000 сегментов и возвращается к полному окну за 43 000 RTT, то есть больше чем за час. При этом в следующем разделе будет показано, что для поддержания такой скорости доля потерь должна быть не выше одной на пять миллиардов пакетов. В реальных сетях это недостижимо.
Алгоритм CUBIC (RFC 9438) решает проблему, делая рост окна функцией времени, прошедшего с последней потери, а не числа RTT 9. Окно задаётся кубической функцией:
W(t) = C·(t − K)³ + W_max,
где W_max — окно в момент последней потери, t — время с момента уменьшения окна в секундах, C = 0,4, а K = ∛(W_max·(1 − β)/C) — время, за которое окно вернётся к W_max. При потере окно уменьшается не вдвое, а умножением на β = 0,7 9. Форма кривой отражает разумную стратегию. Вдали от W_max окно растёт быстро. При приближении к значению, на котором в прошлый раз произошла потеря, рост замедляется почти до нуля (плато). Если потери нет, рост снова ускоряется, и алгоритм пробует найти новую, большую ёмкость.
Численный пример. Пусть W_max = 100 сегментов. После потери окно становится 0,7·100 = 70 сегментов, K = ∛(100·0,3/0,4) = ∛75 ≈ 4,2 с. Через 4,2 с окно вернётся к 100 сегментам независимо от RTT. Через 2 с после потери W(2) = 0,4·(2 − 4,2)³ + 100 ≈ 0,4·(−10,65) + 100 ≈ 95,7 сегмента. Окно, таким образом, восстанавливается в основном в первые две секунды, затем следует плато. Независимость от RTT делает CUBIC справедливее Reno по отношению к потокам с разными задержками. Чтобы на коротких путях с маленьким BDP CUBIC не оказывался медленнее Reno, в нём предусмотрена «Reno-совместимая» область: окно не опускается ниже оценки того, каким оно было бы у Reno 9. CUBIC используется по умолчанию в Linux с 2006 года, позднее стал алгоритмом по умолчанию и в Windows, и в macOS.
sysctl net.ipv4.tcp_available_congestion_control net.ipv4.tcp_congestion_control
net.ipv4.tcp_available_congestion_control = reno cubic
net.ipv4.tcp_congestion_control = cubic
Список доступных алгоритмов зависит от загруженных модулей ядра: например, модуль tcp_bbr добавляет алгоритм bbr. Алгоритм можно выбрать для всей системы этим параметром или для отдельного сокета опцией TCP_CONGESTION, что и делает генератор трафика лабораторной работы.
BBR: управление по модели пути
Все рассмотренные алгоритмы считают потерю сигналом перегрузки. Но потеря происходит, только когда очередь на узком звене уже переполнена; до этого момента отправитель, увеличивая окно, лишь заполняет очередь и наращивает задержку, не получая прибавки скорости. С другой стороны, на беспроводных каналах и длинных линиях бывают случайные потери, не связанные с перегрузкой, и алгоритм, реагирующий на каждую потерю, недогружает канал.
Алгоритм BBR (англ. Bottleneck Bandwidth and Round-trip propagation time), опубликованный исследователями Google в 2016 году, строит явную модель пути из двух величин 10. Первая — пропускная способность узкого звена BtlBw, оцениваемая как максимум измеренной скорости доставки за последние несколько RTT. Вторая — минимальное время кругового обхода RTprop, оцениваемое как минимум RTT за последние 10 с. Их произведение — BDP пути. BBR стремится держать в полёте около одного BDP, то есть работать в точке, где канал загружен, а очередь пуста; эту точку Л. Клейнрок ещё в 1979 году назвал оптимальной. Скорость отправки задаётся не окном, а темпом (англ. pacing): сегменты выпускаются равномерно со скоростью, близкой к BtlBw. Периодически BBR на короткое время повышает темп на 25 %, проверяя, не появилась ли дополнительная ёмкость, а затем снижает его, чтобы опустошить созданную очередь.
Вывод ss -ti показывает поля, на которые опирается такой подход и которые Linux вычисляет для любого алгоритма: delivery_rate — измеренная скорость доставки, pacing_rate — темп отправки, minrtt — минимальный RTT. BBR версии 1 входит в ядро Linux с версии 4.9. Он не реагирует на потери непосредственно, поэтому при совместной работе с CUBIC в неглубоких буферах может вытеснять его, а в глубоких — сам уступать. Следующие версии, BBRv2 и BBRv3, учитывают потери и метки ECN, но в основное ядро Linux на момент написания не включены.
Явное уведомление о перегрузке
Потеря — дорогой сигнал: данные приходится повторять, а соединение узнаёт о перегрузке с опозданием. Явное уведомление о перегрузке (англ. Explicit Congestion Notification, ECN, RFC 3168) позволяет маршрутизатору сообщить о перегрузке, не отбрасывая пакет 11. Для этого используются два младших бита бывшего поля ToS в заголовке IP:
| Биты ECN | Название | Смысл |
|---|---|---|
| 00 | Not-ECT | транспорт не поддерживает ECN |
| 10 | ECT(0) | транспорт поддерживает ECN |
| 01 | ECT(1) | транспорт поддерживает ECN (в L4S — особый режим) |
| 11 | CE | перегрузка испытана (англ. Congestion Experienced) |
Отправитель помечает пакеты кодом ECT. Маршрутизатор с активным управлением очередью, вместо того чтобы отбросить такой пакет, меняет код на CE. Получатель TCP, увидев CE, устанавливает флаг ECE (англ. ECN-Echo) во всех своих подтверждениях. Отправитель реагирует так же, как на потерю, то есть уменьшает окно, но без повторной передачи, и подтверждает реакцию флагом CWR (англ. Congestion Window Reduced) 11. Использование ECN согласуется в рукопожатии флагами ECE и CWR в сегменте SYN.
В Linux параметр net.ipv4.tcp_ecn по умолчанию равен 2: входящие соединения с ECN принимаются, исходящие его не запрашивают. Причина в осторожности: часть устаревшего сетевого оборудования отбрасывала пакеты с ненулевыми битами ECN. Новое направление — архитектура L4S (англ. Low Latency, Low Loss, and Scalable throughput), в которой коду ECT(1) придан особый смысл: такие потоки получают метки CE очень рано и часто, реагируют на них пропорционально и удерживают очередь в пределах единиц миллисекунд.
Буферы, bufferbloat и активное управление очередью
Буфер на узком звене нужен, чтобы поглощать кратковременные всплески трафика. Классическое правило, сформулированное К. Вильямизаром и Ч. Сонгом в 1994 году, предписывает размер буфера порядка одного BDP: тогда поток Reno после уменьшения окна вдвое не опустошает канал. Но память дешевела, и производители домашних маршрутизаторов, модемов и операционных систем стали устанавливать буферы в десятки BDP. Алгоритм, основанный на потерях, увеличивает окно, пока буфер не переполнится. В результате очередь на узком звене постоянно заполнена, и каждый пакет, в том числе пакет интерактивного приложения, проводит в ней сотни миллисекунд. Это явление Дж. Геттис назвал bufferbloat («раздувание буферов»).
Учебный стенд лабораторной работы позволяет измерить эффект. Узкое звено — 10 Мбит/с, базовый RTT — 40 мс, буфер — 1000 КиБ, то есть около 0,82 с передачи на скорости звена. Пока по пути идёт поток CUBIC, команда ping измеряет RTT:
rtt min/avg/max/mdev = 684.272/777.657/857.972/66.120 ms, pipe 3
qdisc tbf 1: root refcnt 13 rate 10Mbit burst 16Kb lat 806ms
 Sent 16804424 bytes 11118 pkt (dropped 116, overlimits 33877 requeues 0)
 backlog 788864b 522p requeues 0
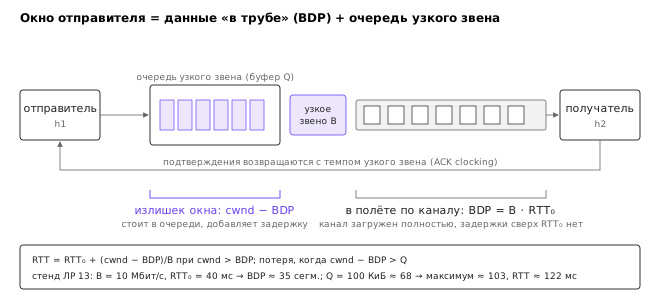
Задержка выросла с 40 до 778 мс, почти в двадцать раз. В очереди стоят 522 пакета, 788 864 байта, что при 10 Мбит/с соответствует 631 мс ожидания. Пропускная способность потока при этом не выше, чем с маленьким буфером: 9,55 Мбит/с. Вся «лишняя» часть окна сверх BDP превратилась в задержку, а не в скорость. Соотношение между BDP, очередью и задержкой показано на рисунке ниже.
Решение — активное управление очередью (англ. Active Queue Management, AQM): маршрутизатор отбрасывает или помечает пакеты до того, как буфер переполнится, сигнализируя отправителям о необходимости замедлиться. Алгоритм CoDel (англ. Controlled Delay, RFC 8289) измеряет не длину очереди, а время пребывания пакета в ней (англ. sojourn time) 12. Если в течение интервала 100 мс минимальное время ожидания пакетов не опускается ниже целевого значения 5 мс, очередь считается «стоячей», то есть не поглощающей всплески, а постоянно заполненной. Тогда CoDel начинает отбрасывать пакеты, сокращая интервал между отбрасываниями пропорционально 1/√n, где n — число отбрасываний подряд, пока задержка не вернётся к цели. Кратковременные всплески CoDel пропускает без потерь.
Дисциплина fq_codel (RFC 8290) сочетает CoDel со справедливыми очередями (англ. flow queuing): пакеты распределяются по хешу пятёрки соединения в 1024 отдельные очереди, которые обслуживаются по кругу, а CoDel работает в каждой из них 13. Новые и «тонкие» потоки, например DNS-запросы, пакеты игр и голосовой связи, обслуживаются в первую очередь, и объёмная загрузка не задерживает их. На том же стенде замена простой очереди на fq_codel дала:
rtt min/avg/max/mdev = 40.068/40.518/41.221/0.444 ms
qdisc fq_codel 10: parent 1:1 limit 10240p flows 1024 quantum 1514 target 5ms interval 100ms memory_limit 32Mb ecn drop_batch 64
 Sent 15514142 bytes 10261 pkt (dropped 14, overlimits 0 requeues 0)
Задержка ping вернулась к базовым 40,5 мс, а потоку понадобилось всего 14 отброшенных пакетов вместо 116, чтобы удерживать окно вблизи BDP. Скорость передачи — 9,36 Мбит/с — практически не изменилась. Вывод tc показывает параметры по умолчанию, совпадающие с RFC: target 5ms, interval 100ms, flows 1024; флаг ecn означает, что пакеты с ECT дисциплина будет помечать, а не отбрасывать. Важно, где работает AQM: он полезен только на самом узком звене пути, где реально образуется очередь, обычно на выходе домашнего маршрутизатора к провайдеру. Если узкое звено находится в модеме провайдера, локальная дисциплина очереди бессильна, пока скорость на маршрутизаторе не ограничена немного ниже скорости модема, и очередь не перенесена к себе.
Пропускная способность одного потока TCP
Ограничение окном и BDP
Подведём итог предыдущих разделов в виде одного неравенства. За один RTT отправитель может передать не больше, чем позволяет меньшее из окон, поэтому скорость одного потока TCP ограничена сверху:
скорость ≤ min(cwnd, rwnd) / RTT.
Из него следуют практические выводы. Чтобы загрузить канал с пропускной способностью B при RTT, равном T, окно должно быть не меньше BDP = B·T. В таблице приведены значения BDP для типичных путей при MSS 1448 байтов.
| Путь | Скорость | RTT | BDP, байтов | BDP, сегментов |
|---|---|---|---|---|
| учебный стенд ЛР 13 | 10 Мбит/с | 40 мс | 50 000 | 35 |
| домашний доступ, город | 100 Мбит/с | 10 мс | 125 000 | 86 |
| Москва — Новосибирск | 100 Мбит/с | 50 мс | 625 000 | 432 |
| межконтинентальный путь | 1 Гбит/с | 150 мс | 18 750 000 | 12 950 |
| ЦОД, внутри стойки | 25 Гбит/с | 0,05 мс | 156 250 | 108 |
Связь окна, BDP и очереди удобно рассмотреть на стенде лабораторной работы: 10 Мбит/с, базовый RTT 40 мс, буфер узкого звена 100 КиБ. BDP равен 10⁷·0,04/8 = 50 000 байтов, или около 35 сегментов. Буфер вмещает 102 400 байтов, то есть около 68 кадров по 1514 байтов. Поток Reno увеличивает окно, пока в полёте не окажется BDP плюс полный буфер, около 35 + 68 ≈ 103 сегментов, после чего очередь переполняется и происходит потеря. RTT при полной очереди равен 40 мс плюс время передачи буфера, 102 400·8/10⁷ ≈ 82 мс, итого около 122 мс. Измеренный график на рисунке ниже показывает именно это. После начального этапа окно колеблется между 50 и 101 сегментом с периодом около пяти секунд, RTT синхронно растёт от 62 до 122 мс, а пропускная способность всё время остаётся на уровне 9,55 Мбит/с, потому что окно ни разу не опускается ниже BDP. Обратим внимание и на начало графика. Медленный старт удваивает окно за RTT и «проскакивает» ёмкость пути: окно успевает вырасти до 185 сегментов, прежде чем отправитель узнаёт о первой потере, и из переполненного буфера выпадает сразу около сотни сегментов. Восстановление после такой массовой потери и есть главный недостаток медленного старта, который пытаются смягчить алгоритмы вроде HyStart в CUBIC, завершающие медленный старт по росту RTT.
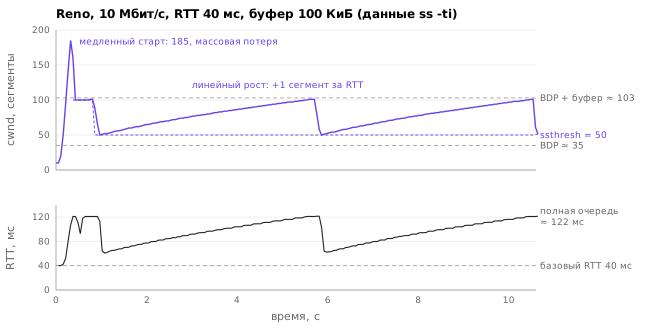
Минимум окна после уменьшения, 50 сегментов, выше BDP в 35 сегментов, поэтому канал не простаивает: буфер подобран с запасом. Если бы буфер был меньше BDP, окно после уменьшения вдвое опускалось бы ниже BDP, и скорость в течение части цикла падала бы ниже ёмкости канала. Это и есть обоснование правила «буфер не меньше BDP» для одного потока Reno. При большом числе потоков, чьи циклы не синхронизированы, достаточен буфер порядка BDP/√n, где n — число потоков (результат Г. Аппенцеллера, И. Кесласси и Н. Маккьюна, 2004), что существенно для магистральных маршрутизаторов.
Формула Мэтиса
Когда потери вызваны не переполнением собственного буфера, а внешними причинами — чужим трафиком, помехами, ошибками на линии, — скорость потока определяется долей потерь. В 1997 году М. Мэтис, Дж. Семке, Дж. Махдави и Т. Отт вывели простую оценку 14. Пусть в режиме предотвращения перегрузки каждый 1/p-й пакет теряется, где p — доля потерь, и каждая потеря обнаруживается по тройному dupACK. Тогда окно описывает правильную «пилу»: растёт линейно от W/2 до W за W/2 раундов, затем падает вдвое. За один цикл передаётся
(W/2 + W)/2 · W/2 = 3W²/8 сегментов.
На цикл приходится одна потеря, поэтому 3W²/8 = 1/p, откуда W = √(8/(3p)). Среднее окно за цикл равно 3W/4, и средняя скорость
скорость = (MSS/RTT) · (3/4)·√(8/(3p)) = (MSS/RTT) · √(3/2) / √p ≈ (MSS/RTT) · 1,22/√p.
Формула Мэтиса утверждает, что скорость потока обратно пропорциональна RTT и корню из доли потерь. Константа C = √(3/2) ≈ 1,22 соответствует подтверждению каждого сегмента; при отложенных подтверждениях на каждый второй сегмент она уменьшается до √(3/4) ≈ 0,87 14. Linux увеличивает окно по числу подтверждённых байтов, а не по числу ACK, поэтому для него ближе значение 1,22. Формула не учитывает таймауты, ограничение окном получателя и медленный старт, поэтому применима при умеренных потерях, примерно от 0,01 до 2 %. Уточнённая модель Падхье и соавторов учитывает таймауты и при больших потерях даёт заметно меньшие значения.
Сравним формулу с экспериментом. На стенде лабораторной работы установлены узкое звено 100 Мбит/с, RTT 40 мс и случайные потери в направлении данных. MSS равен 1448 байтов, то есть 11 584 бита, и MSS/RTT = 11 584/0,04 = 289 600 бит/с.
| Доля потерь p | Оценка Мэтиса, Мбит/с | Reno, измерено, Мбит/с | CUBIC, измерено, Мбит/с |
|---|---|---|---|
| 0,1 % | 289 600·1,22/0,0316 ≈ 11,2 | 11,2 | 15,2 |
| 1 % | 289 600·1,22/0,1 ≈ 3,55 | 3,67 | 3,39 |
Для Reno совпадение почти точное, хотя канал способен передавать 100 Мбит/с: скорость определяется не ёмкостью, а потерями и задержкой. CUBIC при потерях 0,1 % оказывается на треть быстрее, поскольку его окно растёт не линейно и уменьшается не вдвое, а в 0,7 раза. При потерях 1 % окно мало, и CUBIC работает в Reno-совместимой области с близким результатом.
Формула объясняет, почему потери недопустимы на быстрых длинных путях. Обратим её: чтобы поток Reno передавал 10 Гбит/с при RTT 100 мс, требуется p ≤ (1,22·MSS/(RTT·B))² = (1,22·11 584/(0,1·10¹⁰))² ≈ 2·10⁻¹⁰. Это одна потеря на пять миллиардов пакетов, или примерно одна потеря за 1,6 часа непрерывной передачи. Именно эта оценка мотивировала создание CUBIC и других алгоритмов для быстрых сетей 9. Формула объясняет и практическую рекомендацию: перенос сервера ближе к пользователю, то есть уменьшение RTT, ускоряет передачу при тех же потерях пропорционально. На этом в том числе основана эффективность сетей доставки контента.
Почему появился QUIC
Механизмы, изложенные в теме, развивались почти сорок лет, но многие улучшения доходят до пользователей медленно. TCP реализован в ядре операционной системы, и новый алгоритм восстановления или новая опция работают только после обновления ядер на обеих сторонах. Промежуточные устройства — межсетевые экраны, трансляторы адресов, балансировщики — нередко разбирают заголовок TCP и отбрасывают сегменты с незнакомыми опциями, поэтому протокол фактически «окостенел» (англ. ossification). Кроме того, TCP доставляет единый упорядоченный поток байтов. Если несколько независимых объектов, например ресурсы веб-страницы, мультиплексированы в одном соединении, потеря одного сегмента задерживает их все, пока пропуск не будет восполнен. Это блокировка «голова очереди» (англ. head-of-line blocking) на транспортном уровне.
Протокол QUIC переносит транспортную логику — надёжность, управление потоком и перегрузкой — в пространство пользователя поверх UDP и шифрует почти весь заголовок, лишая промежуточные устройства возможности вмешиваться. Он использует те же принципы, что изложены в этой теме: подтверждения с диапазонами, похожие на SACK, оценку RTT и таймеры, NewReno, CUBIC или BBR для управления перегрузкой. Но каждый поток данных внутри соединения восстанавливается независимо, а номер пакета никогда не повторяется, поэтому неоднозначность измерения RTT, решаемая в TCP алгоритмом Карна, исчезает. Подробно QUIC и HTTP/3 рассмотрены в теме 16.
Итоги темы
TCP обеспечивает надёжность сочетанием кумулятивных подтверждений, выборочных подтверждений SACK и двух способов обнаружения потерь: быстрой повторной передачи по трём дублирующим подтверждениям и таймера повторной передачи. Таймер вычисляется адаптивно, по сглаженному среднему RTT и его вариации (RFC 6298), что позволяет одному и тому же протоколу работать и в локальной сети, и через спутник. Алгоритм Карна исключает неоднозначные измерения по повторённым сегментам, экспоненциальная отсрочка защищает сеть при длительной недоступности получателя, а временные метки дают точные измерения и защиту от оборачивания номеров.
Управление потоком защищает получателя: окно rwnd сообщает свободное место в буфере, масштабирование окна снимает ограничение 64 КиБ на длинных быстрых путях, а правила против синдрома глупого окна и алгоритм Нейгла предотвращают поток крошечных сегментов. Взаимодействие алгоритма Нейгла с отложенными подтверждениями — классический источник необъяснимых задержек в 40–200 мс, который устраняется кадрированием сообщений в приложении и опцией TCP_NODELAY.
Управление перегрузкой защищает сеть и появилось как ответ на коллапс 1986 года. Окно перегрузки cwnd ищется подбором: медленный старт удваивает его каждый RTT, предотвращение перегрузки увеличивает на сегмент за RTT, потеря уменьшает вдвое. Закон AIMD сводит потоки к справедливому делению канала, хотя и с несправедливостью по RTT. Варианты Tahoe, Reno и NewReno различаются реакцией на потери. CUBIC делает рост окна функцией времени и подходит для быстрых длинных путей. BBR отказывается от потерь как основного сигнала и строит модель пропускной способности и минимального RTT. ECN и активное управление очередью, в первую очередь fq_codel, позволяют сообщать о перегрузке до переполнения буферов и устраняют bufferbloat: на учебном стенде задержка под нагрузкой сократилась с 778 до 40 мс без потери скорости.
Количественно скорость одного потока ограничена окном, делённым на RTT, и при случайных потерях описывается формулой Мэтиса: скорость пропорциональна MSS/RTT и обратно пропорциональна корню из доли потерь. Эта зависимость объясняет, почему потери губительны на длинных быстрых путях и почему сокращение RTT ускоряет передачу. Следующая тема переходит к сервисам, без которых узел не может даже начать соединение, — автоматической настройке адресов по DHCP и трансляции адресов NAT, которая, отслеживая каждое соединение TCP, опирается на изученный здесь конечный автомат протокола.
Литература
- Eddy W. (ed.) Transmission Control Protocol (TCP). — RFC 9293, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9293
- Paxson V., Allman M., Chu J., Sargent M. Computing TCP's Retransmission Timer. — RFC 6298, IETF, 2011. https://www.rfc-editor.org/rfc/rfc6298
- Allman M., Paxson V., Blanton E. TCP Congestion Control. — RFC 5681, IETF, 2009. https://www.rfc-editor.org/rfc/rfc5681
- Jacobson V. Congestion Avoidance and Control. — Proceedings of ACM SIGCOMM '88, 1988, С. 314–329, DOI: 10.1145/52324.52356.
- Borman D., Braden B., Jacobson V., Scheffenegger R. (ed.) TCP Extensions for High Performance. — RFC 7323, IETF, 2014. https://www.rfc-editor.org/rfc/rfc7323
- Mathis M., Mahdavi J., Floyd S., Romanow A. TCP Selective Acknowledgment Options. — RFC 2018, IETF, 1996. https://www.rfc-editor.org/rfc/rfc2018
- Chu J., Dukkipati N., Cheng Y., Mathis M. Increasing TCP's Initial Window. — RFC 6928, IETF, 2013. https://www.rfc-editor.org/rfc/rfc6928
- Henderson T., Floyd S., Gurtov A., Nishida Y. The NewReno Modification to TCP's Fast Recovery Algorithm. — RFC 6582, IETF, 2012. https://www.rfc-editor.org/rfc/rfc6582
- Xu L., Ha S., Rhee I., Goel V., Eggert L. (ed.) CUBIC for Fast and Long-Distance Networks. — RFC 9438, IETF, 2023. https://www.rfc-editor.org/rfc/rfc9438
- Cardwell N., Cheng Y., Gunn C. S., Yeganeh S. H., Jacobson V. BBR: Congestion-Based Congestion Control. — Communications of the ACM, 2017, Vol. 60, No. 2, С. 58–66, DOI: 10.1145/3009824.
- Ramakrishnan K., Floyd S., Black D. The Addition of Explicit Congestion Notification (ECN) to IP. — RFC 3168, IETF, 2001. https://www.rfc-editor.org/rfc/rfc3168
- Nichols K., Jacobson V., McGregor A., Iyengar J. (ed.) Controlled Delay Active Queue Management. — RFC 8289, IETF, 2018. https://www.rfc-editor.org/rfc/rfc8289
- Hoeiland-Joergensen T., McKenney P., Taht D., Gettys J., Dumazet E. The Flow Queue CoDel Packet Scheduler and Active Queue Management Algorithm. — RFC 8290, IETF, 2018. https://www.rfc-editor.org/rfc/rfc8290
- Mathis M., Semke J., Mahdavi J., Ott T. The Macroscopic Behavior of the TCP Congestion Avoidance Algorithm. — ACM SIGCOMM Computer Communication Review, 1997, Vol. 27, No. 3, С. 67–82, DOI: 10.1145/263932.264023.