DHCP и трансляция сетевых адресов (NAT)
К теме 14 курс прошёл стек от физического уровня до транспортного. Узел, у которого есть IP-адрес, маска, шлюз по умолчанию и адрес сервера имён, умеет доставить пакет в любую точку Интернета и открыть соединение TCP. Но откуда эти параметры берутся? В темах 6–8 они назначались вручную командами ip addr и ip route. В офисе с сотней рабочих мест, в гостиничной сети Wi-Fi или в сети провайдера с миллионом абонентов ручная настройка немыслима: ошибки, повторяющиеся адреса, невозможность перенести ноутбук из одной сети в другую. Первая половина темы посвящена протоколу динамической настройки узла DHCP, который решает эту задачу.
Вторая половина отвечает на вопрос, возникший ещё в теме 6: как 4,3 миллиарда адресов IPv4 обслуживают десятки миллиардов устройств. Частные адреса RFC 1918 можно использовать в любом числе организаций, но они не маршрутизируются в Интернете. Мост между частной сетью и публичным Интернетом строит трансляция сетевых адресов (англ. Network Address Translation, NAT). Устройство NAT переписывает адреса и порты в заголовках проходящих пакетов так, что сотни внутренних узлов выходят в Интернет под одним публичным адресом. NAT стал повсеместным, но нарушил одно из исходных свойств архитектуры Интернета — возможность любого узла обратиться к любому другому. Поэтому значительная часть темы посвящена последствиям: проблемам протоколов, передающих адреса внутри данных, способам обхода NAT и трансляции на стороне провайдера (CGNAT).
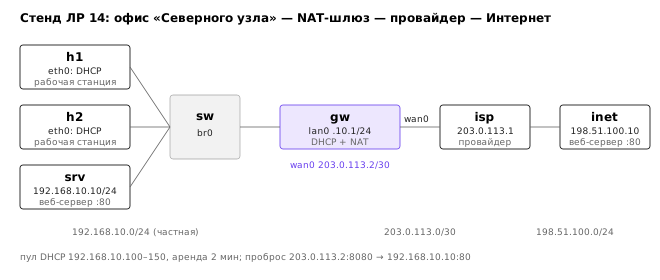
Изложение заканчивается реализацией NAT в Linux. Подсистема netfilter отслеживает соединения (conntrack) и применяет правила трансляции из таблицы nat в nftables. Эти механизмы используются в лабораторной работе 14, где поднимается DHCP-сервер и NAT-шлюз офиса компании «Северный узел». Функции межсетевого экрана, которые выполняет та же подсистема, рассматриваются в теме 18, а сервер имён, адрес которого сообщает DHCP, — в теме 15.
Автоматическая настройка узла: протокол DHCP
Что нужно узлу и почему DHCP — протокол поверх UDP
Чтобы работать в IP-сети, узлу необходимы как минимум четыре параметра: собственный адрес, длина префикса подсети, адрес шлюза по умолчанию и адрес рекурсивного сервера DNS. Часто нужны и другие: имя домена для поиска, адрес сервера времени, MTU, статические маршруты, адрес сервера загрузки для бездисковых станций. Задача автоматической настройки осложнена тем, что узел, которому нужен адрес, ещё не имеет адреса. Он не может отправить пакет конкретному серверу, поскольку не знает ни его адреса, ни своего, и не может получить ответ по адресу, которого у него нет.
Протокол динамической настройки узла (англ. Dynamic Host Configuration Protocol, DHCP) решает эту задачу широковещательными сообщениями UDP 1. Клиент отправляет запрос с адресом отправителя 0.0.0.0 на ограниченный широковещательный адрес 255.255.255.255. Такой пакет не покидает пределы канального сегмента, но его получают все узлы сегмента, в том числе сервер DHCP. Клиент использует порт UDP 68, сервер — порт 67. Выбор UDP естественен: соединение TCP невозможно без адресов обеих сторон, а надёжность обеспечивается простыми повторами по таймеру на стороне клиента.
DHCP вырос из протокола начальной загрузки BOOTP (англ. Bootstrap Protocol, RFC 951, 1985), созданного для бездисковых станций: станция получала адрес и имя файла для загрузки по сети. BOOTP выдавал адреса статически по таблице MAC-адресов, которую администратор заполнял вручную. DHCP, стандартизированный в 1993 году и в действующей редакции описанный в RFC 2131 (1997), сохранил формат сообщения BOOTP и порты, а к нему добавил главное новшество — аренду (англ. lease), то есть выдачу адреса из пула на ограниченный срок 1. Совместимость форматов позволяет одним и тем же ретрансляторам обслуживать оба протокола.
Формат сообщения
Сообщение DHCP состоит из фиксированной части длиной 236 байтов, унаследованной от BOOTP, четырёхбайтового «магического числа» 99.130.83.99 (в шестнадцатеричной записи 63 82 53 63), отмечающего начало опций, и поля опций переменной длины 1. Поля фиксированной части перечислены в таблице.
| Поле | Байтов | Назначение |
|---|---|---|
op | 1 | 1 — запрос от клиента (BOOTREQUEST), 2 — ответ сервера (BOOTREPLY) |
htype, hlen | 1 + 1 | тип и длина аппаратного адреса: для Ethernet 1 и 6 |
hops | 1 | число ретрансляторов, через которые прошло сообщение |
xid | 4 | идентификатор транзакции: случайное число, связывающее ответ с запросом |
secs | 2 | секунд с начала попыток клиента получить адрес |
flags | 2 | старший бит — флаг BROADCAST: «отвечайте широковещательно» |
ciaddr | 4 | текущий адрес клиента, если он уже есть (при продлении) |
yiaddr | 4 | «ваш адрес» — адрес, который сервер выдаёт клиенту |
siaddr | 4 | адрес следующего сервера в процессе загрузки (например, TFTP) |
giaddr | 4 | адрес ретранслятора (англ. gateway IP address), если сообщение прошло через него |
chaddr | 16 | аппаратный адрес клиента (MAC), дополненный нулями |
sname, file | 64 + 128 | имя сервера загрузки и имя загрузочного файла |
Тип сообщения DHCP определяется не полем op, а обязательной опцией 53. Это ещё одно следствие совместимости с BOOTP: в BOOTP были только запрос и ответ. Опции кодируются в формате «тип — длина — значение» (англ. type-length-value, TLV): один байт кода, один байт длины и значение 2. Исключения — опция 0 (заполнитель) и опция 255 (конец), состоящие из одного байта. Наиболее важные опции приведены в таблице.
| Код | Название | Содержание |
|---|---|---|
| 1 | Subnet Mask | маска подсети |
| 3 | Router | список шлюзов по умолчанию |
| 6 | Domain Name Server | список серверов DNS |
| 12 | Host Name | имя узла клиента |
| 15 | Domain Name | имя домена для поиска |
| 50 | Requested IP Address | адрес, который клиент хочет получить |
| 51 | IP Address Lease Time | срок аренды в секундах |
| 53 | DHCP Message Type | тип сообщения: 1 DISCOVER, 2 OFFER, 3 REQUEST, 4 DECLINE, 5 ACK, 6 NAK, 7 RELEASE, 8 INFORM |
| 54 | Server Identifier | адрес сервера, выдавшего предложение |
| 55 | Parameter Request List | коды опций, которые клиент просит прислать |
| 58, 59 | Renewal (T1), Rebinding (T2) Time | моменты начала продления, в секундах от выдачи |
| 61 | Client Identifier | идентификатор клиента; если указан, сервер различает клиентов по нему, а не по MAC |
| 82 | Relay Agent Information | сведения, которые добавляет ретранслятор: порт коммутатора, идентификатор устройства |
Все опции, кроме 82, определены в RFC 2132 2; опция 82 — в RFC 3046 3. Клиент не обязан понимать все опции, а сервер присылает только те, которые клиент запросил в опции 55, и обязательные.
Получение, продление и ретрансляция аренды
Обмен DORA
Получение адреса с нуля состоит из четырёх сообщений. По их первым буквам — DISCOVER, OFFER, REQUEST, ACK — процесс называют DORA. Схема на рисунке ниже показывает обмен на временной диаграмме.
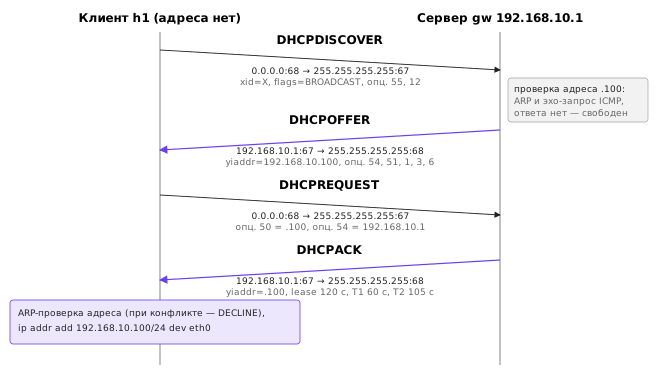
- DHCPDISCOVER. Клиент без адреса отправляет широковещательный запрос с 0.0.0.0:68 на 255.255.255.255:67. В запросе — новый случайный
xid, MAC-адрес вchaddr, список нужных опций (55), по желанию — имя узла (12) и ранее использованный адрес (50). - DHCPOFFER. Каждый сервер, получивший запрос, выбирает свободный адрес из пула, резервирует его на короткое время и отвечает предложением, где адрес указан в
yiaddr, а свой идентификатор — в опции 54. До отправки предложения сервер должен убедиться, что адрес не занят, например отправив на него эхо-запрос ICMP 1. - DHCPREQUEST. Клиент выбирает одно из предложений и снова широковещательно сообщает о выборе: в опции 50 указан выбранный адрес, в опции 54 — идентификатор выбранного сервера. Широковещательная рассылка нужна для того, чтобы остальные серверы, чьи предложения отвергнуты, увидели это и вернули зарезервированные адреса в пул.
- DHCPACK. Выбранный сервер подтверждает аренду, повторяя адрес и полный набор параметров. Если адрес за это время стал недоступен, сервер отвечает DHCPNAK, и клиент начинает заново.
Получив подтверждение, клиент должен проверить, что адрес действительно свободен, например запросом ARP. Если на адрес кто-то откликнулся, клиент отправляет DHCPDECLINE и начинает процесс заново 1. Освободить адрес досрочно позволяет сообщение DHCPRELEASE. Сообщение DHCPINFORM используется узлом с вручную заданным адресом, которому нужны только остальные параметры.
Почему сервер отвечает клиенту, у которого нет адреса? Обычный IP-пакет на адрес 192.168.10.100 требует, чтобы получатель отозвался на запрос ARP, а клиент ещё не знает, что это его адрес. Сервер может обойти это, отправив кадр прямо на MAC-адрес из chaddr. Но не все стеки протоколов принимают одноадресный IP-пакет до настройки адреса, поэтому клиент может установить флаг BROADCAST, и тогда сервер отвечает на 255.255.255.255 1.
Ниже приведён захват обмена на стенде лабораторной работы. В роли сервера выступает dnsmasq на шлюзе 192.168.10.1, клиент — учебный клиент на Python с флагом BROADCAST:
13:02:37.710827 IP 0.0.0.0.68 > 255.255.255.255.67: BOOTP/DHCP, Request from 96:0c:09:9f:30:1e, length 266
13:02:37.711080 ARP, Request who-has 192.168.10.100 tell 192.168.10.1, length 28
13:02:38.718035 ARP, Request who-has 192.168.10.100 tell 192.168.10.1, length 28
13:02:39.737996 ARP, Request who-has 192.168.10.100 tell 192.168.10.1, length 28
13:02:40.714148 IP 0.0.0.0.68 > 255.255.255.255.67: BOOTP/DHCP, Request from 96:0c:09:9f:30:1e, length 266
13:02:40.714970 IP 192.168.10.1.67 > 255.255.255.255.68: BOOTP/DHCP, Reply, length 305
13:02:40.715271 IP 192.168.10.1.67 > 255.255.255.255.68: BOOTP/DHCP, Reply, length 305
13:02:40.715281 IP 0.0.0.0.68 > 255.255.255.255.67: BOOTP/DHCP, Request from 96:0c:09:9f:30:1e, length 278
13:02:40.774916 IP 192.168.10.1.67 > 255.255.255.255.68: BOOTP/DHCP, Reply, length 305
Захват показывает подробность, о которой схемы обычно умалчивают. На первый DISCOVER сервер ответил не сразу. Сначала он проверил кандидата 192.168.10.100 эхо-запросом ICMP. Для этого понадобилось разрешить адрес через ARP, и три запроса ARP за три секунды остались без ответа: адрес свободен. Тем временем клиент, не дождавшись предложения, повторил DISCOVER, и сервер ответил двумя предложениями — по одному на каждый запрос с тем же xid. Клиент выбрал первое, отправил REQUEST и получил ACK. Тот же обмен глазами сервера записан в журнале dnsmasq (фрагмент):
dnsmasq-dhcp: DHCPDISCOVER(lan0) 96:0c:09:9f:30:1e
dnsmasq-dhcp: DHCPOFFER(lan0) 192.168.10.100 96:0c:09:9f:30:1e
dnsmasq-dhcp: requested options: 1:netmask, 3:router, 6:dns-server, 15:domain-name,
dnsmasq-dhcp: requested options: 51:lease-time, 58:T1, 59:T2
dnsmasq-dhcp: DHCPREQUEST(lan0) 192.168.10.100 96:0c:09:9f:30:1e
dnsmasq-dhcp: DHCPACK(lan0) 192.168.10.100 96:0c:09:9f:30:1e h1
dnsmasq-dhcp: sent size:  4 option: 51 lease-time  2m
dnsmasq-dhcp: sent size:  4 option: 58 T1  1m
dnsmasq-dhcp: sent size:  4 option: 59 T2  1m45s
dnsmasq-dhcp: sent size:  4 option:  3 router  192.168.10.1
Аренда: продление и повторная привязка
Адрес выдаётся на срок, указанный в опции 51. Срок позволяет серверу вернуть в пул адреса узлов, которые исчезли без предупреждения, например ноутбуков, унесённых из офиса. Типичные сроки — от часа в гостевых сетях Wi-Fi до суток и более в офисах. Чем короче срок, тем быстрее освобождаются адреса, но тем больше служебного трафика и тем чувствительнее сеть к недоступности сервера.
Клиент не дожидается окончания срока. RFC 2131 вводит два момента времени: T1, по умолчанию половина срока, и T2, по умолчанию 7/8 срока 1. Сервер может задать их явно опциями 58 и 59. В момент T1 клиент переходит в состояние RENEWING и отправляет DHCPREQUEST напрямую, одноадресно, тому серверу, который выдал адрес. В этом запросе поле ciaddr содержит текущий адрес, а опции 50 и 54 отсутствуют. Если сервер отвечает DHCPACK, срок отсчитывается заново. Если сервер не отвечает до момента T2, клиент переходит в состояние REBINDING и рассылает тот же запрос широковещательно: возможно, исходный сервер вышел из строя, но другой сервер располагает сведениями об этой аренде и может её продлить. Если срок истёк без ответа, клиент обязан прекратить использование адреса и вернуться к DISCOVER. Временная шкала аренды показана на рисунке ниже.
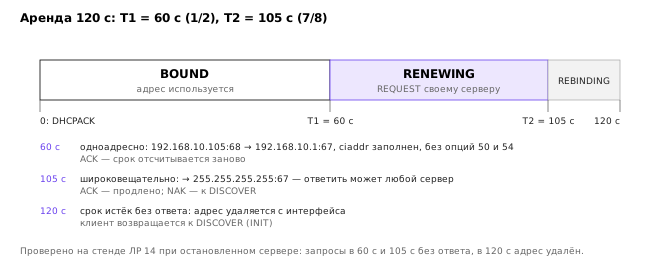
Числовой пример со стенда лабораторной работы. dnsmasq настроен на срок аренды 2 минуты, поэтому клиент получил опции lease-time 120 с, T1 60 с, T2 105 с. Значение 105 с — это 7/8 от 120. Через 60 с после получения адреса клиент отправит одноадресный REQUEST серверу 192.168.10.1. Если сервер остановлен, через 105 с клиент перейдёт к широковещательным запросам, а через 120 с удалит адрес с интерфейса. Ядро Linux поддерживает время жизни адреса непосредственно: клиент назначает адрес с параметрами valid_lft 120 preferred_lft 120, и ip addr показывает обратный отсчёт.
inet 192.168.10.100/24 scope global dynamic eth0
   valid_lft 116sec preferred_lft 116sec
При перезагрузке или повторном подключении к сети клиент, помнящий прежний адрес, начинает не с DISCOVER, а из состояния INIT-REBOOT. Он сразу отправляет широковещательный REQUEST с опцией 50, но без опции 54. Если он оказался в другой сети, сервер ответит DHCPNAK, и клиент получит новый адрес обычным порядком 1. Именно поэтому ноутбук, принесённый из дома в офис, получает новый адрес быстро. Многие серверы, в том числе dnsmasq, стараются выдавать одному и тому же клиенту один и тот же адрес, запоминая аренды в файле. Постоянную привязку адреса к MAC-адресу или идентификатору клиента называют резервированием (англ. reservation, или static lease); принтеры и серверы обычно получают адреса именно так.
Ретранслятор DHCP и опция 82
Широковещательные сообщения не проходят через маршрутизатор. Если бы в каждой подсети организации требовался свой сервер DHCP, централизованное управление адресами было бы невозможным. Поэтому на маршрутизаторе каждой подсети включают ретранслятор (англ. relay agent, в оборудовании Cisco — команда ip helper-address). Ретранслятор принимает широковещательный запрос клиента, записывает в поле giaddr адрес своего интерфейса в подсети клиента, увеличивает hops и пересылает запрос одноадресно на сервер 1. По giaddr сервер узнаёт, из какой подсети пришёл запрос и из какого пула выдавать адрес, и отправляет ответ ретранслятору на порт 67, а тот доставляет его клиенту в локальном сегменте.
Ретранслятор может добавить в запрос опцию 82 (англ. Relay Agent Information) с подопциями Circuit ID — например, номером порта коммутатора и VLAN, к которым подключён клиент, — и Remote ID, идентификатором самого устройства доступа 3. Сервер может использовать эти сведения при выборе адреса, а ретранслятор удаляет опцию из ответа перед доставкой клиенту. Провайдеры широкополосного доступа применяют опцию 82, чтобы привязать адрес к абонентской линии, а не к MAC-адресу устройства, которое абонент может заменить.
Безопасность DHCP
DHCP не предусматривает аутентификации: клиент принимает ответ любого сервера, и в этом его главная уязвимость. Если в сеть подключён посторонний сервер DHCP (англ. rogue DHCP server) — по ошибке, как домашний маршрутизатор, принесённый в офис, или умышленно, — часть клиентов получит от него неверные параметры. Самое опасное здесь — подменённый шлюз по умолчанию или сервер DNS: весь трафик жертвы пойдёт через узел злоумышленника, что даёт классическую атаку «человек посередине». Вторая атака — истощение пула (англ. DHCP starvation): злоумышленник рассылает DISCOVER с тысячами поддельных MAC-адресов и занимает все свободные адреса, после чего законные клиенты не могут получить адрес, а посторонний сервер становится единственным отвечающим.
Защита строится на коммутаторах доступа. Функция отслеживания DHCP (англ. DHCP snooping) делит порты на доверенные (англ. trusted), к которым подключены серверы и вышестоящие коммутаторы, и недоверенные. Ответы сервера (OFFER, ACK, NAK), пришедшие на недоверенный порт, отбрасываются. Попутно коммутатор строит таблицу привязок «MAC-адрес — IP-адрес — порт — VLAN» по наблюдаемым подтверждениям. На этой таблице основаны две другие функции: динамическая проверка ARP (англ. Dynamic ARP Inspection) отбрасывает ответы ARP, противоречащие привязкам, а защита источника IP (англ. IP Source Guard) — пакеты с чужим адресом отправителя. Ограничение числа MAC-адресов на порту защищает от истощения пула. В IPv6 аналогичную роль для объявлений маршрутизатора играет RA Guard (тема 11). Общие принципы сетевой безопасности и межсетевые экраны рассмотрены в теме 18.
Трансляция сетевых адресов
Зачем понадобилась трансляция
К началу 1990-х годов стало ясно, что 32-битного адресного пространства IPv4 не хватит, а внедрение протокола нового поколения займёт годы. Были приняты две меры. Первая — частные адреса: RFC 1918 зарезервировал блоки 10.0.0.0/8, 172.16.0.0/12 и 192.168.0.0/16 для сетей, не нуждающихся в прямой связи с Интернетом. Эти блоки могут повторно использоваться в любом числе организаций и не должны появляться в глобальной таблице маршрутизации 5. Вторая — трансляция адресов, впервые описанная в RFC 1631 в 1994 году и уточнённая в RFC 3022 под названием «традиционный NAT» 4. Устройство на границе частной сети подменяет частные адреса публичными в исходящих пакетах и выполняет обратную подмену во входящих.
Сочетание этих мер оказалось настолько эффективным, что фактически отсрочило дефицит адресов на два десятилетия. Центральный пул IANA был исчерпан в феврале 2011 года, региональные регистраторы исчерпали свои пулы в 2011–2019 годах. К этому моменту NAT стоял почти в каждом домашнем маршрутизаторе, а за адресами IPv4 сложился вторичный рынок. Решение проблемы по существу даёт IPv6, рассмотренный в теме 11, но NAT остаётся частью инфраструктуры Интернета.
Статический, динамический NAT и NAPT
Различают несколько видов трансляции 4:
- статический NAT — постоянное взаимно однозначное соответствие «частный адрес — публичный адрес», например 192.168.10.10 ↔ 203.0.113.10. Применяется для серверов, доступных извне, и требует столько публичных адресов, сколько внутренних узлов;
- динамический NAT (базовый, англ. Basic NAT) — публичный адрес выделяется из пула на время сеанса узла. Он экономит адреса, только если одновременно активна лишь часть узлов;
- трансляция адресов и портов (англ. Network Address Port Translation, NAPT), в документации оборудования Cisco — PAT (англ. Port Address Translation), в Linux — маскарадинг (англ. masquerading). Все внутренние узлы используют один публичный адрес, а различаются соединения по номерам портов транспортного уровня, которые устройство NAT при необходимости тоже подменяет.
NAPT — самый распространённый вид, именно его подразумевают, говоря «NAT» о домашнем маршрутизаторе. Работа NAPT показана на рисунке ниже и разобрана на примере стенда лабораторной работы.
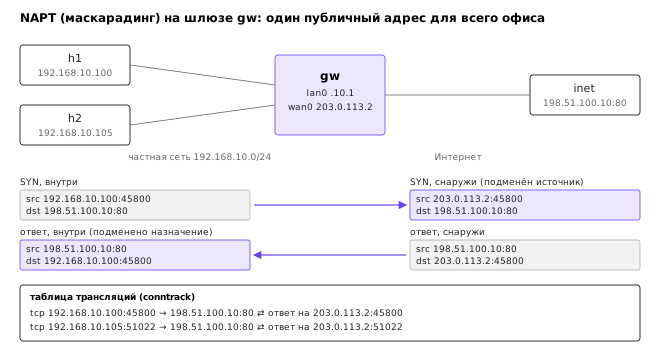
Узел h1 с адресом 192.168.10.100 открывает соединение с веб-сервером 198.51.100.10:80 из порта 45800. Пакет SYN приходит на шлюз с внутренней стороны. Шлюз создаёт запись в таблице трансляций (англ. translation table), заменяет адрес отправителя на свой публичный 203.0.113.2 и отправляет пакет провайдеру. Порт 45800 на шлюзе свободен, поэтому он сохраняется. Ответ сервера адресован 203.0.113.2:45800. Шлюз находит запись по этой паре и заменяет адрес получателя на 192.168.10.100. Захват на двух интерфейсах шлюза одновременно показывает обе формы одного и того же пакета SYN:
# lan0 (офис)
IP 192.168.10.100.45800 > 198.51.100.10.80: Flags [S], seq 961500100, win 64240, ...
# wan0 (провайдер)
IP 203.0.113.2.45800 > 198.51.100.10.80: Flags [S], seq 961500100, win 64240, ...
Номер последовательности, окно и опции не изменились: NAT переписывает только адрес и, при необходимости, порт. Поскольку адреса входят в псевдозаголовок контрольной суммы TCP и UDP (тема 12), шлюз пересчитывает и её, а также контрольную сумму заголовка IP. Журнал веб-сервера подтверждает, что он видит не внутренний адрес клиента, а адрес шлюза: 203.0.113.2 - - "GET / HTTP/1.1" 200. Если два внутренних узла случайно выберут один и тот же исходный порт для соединения с одним и тем же сервером, шлюз заменит порт одного из них на свободный. Одному публичному адресу соответствует около 64 тысяч портов на каждый транспортный протокол, а при учёте адреса назначения соединений может быть и больше: записи различаются всей пятёркой.
Проброс портов и hairpin NAT
NAPT пропускает внутрь только ответы на соединения, открытые изнутри. Входящий пакет SYN на 203.0.113.2:8080 не соответствует ни одной записи, и шлюз не знает, какому внутреннему узлу его отдать. Чтобы сделать внутренний сервер доступным извне, настраивают проброс порта (англ. port forwarding), то есть трансляцию адреса назначения (англ. Destination NAT, DNAT). Правило гласит: пакеты, пришедшие на публичный адрес и порт 8080, отправлять на 192.168.10.10:80. Ответы сервера проходят обратную трансляцию по той же записи. На стенде лабораторной работы после включения правила запрос с «интернет-сервера» curl http://203.0.113.2:8080/ возвращает страницу внутреннего сервера srv, а в журнале srv виден настоящий адрес внешнего клиента 198.51.100.10: при DNAT адрес отправителя не меняется.
Особый случай возникает, когда к пробросу обращается узел из той же внутренней сети по публичному адресу: например, сотрудник открывает корпоративный сайт по его внешнему имени. Пакет h1 → 203.0.113.2:8080 приходит на шлюз с внутренней стороны, и правило DNAT, ограниченное внешним интерфейсом, не срабатывает. Пакет адресован самому шлюзу, а на шлюзе порт 8080 никто не слушает, и клиент получает отказ в соединении. Если же сделать правило DNAT независимым от интерфейса, возникает вторая проблема. Пакет уходит к srv с адресом отправителя h1, сервер отвечает напрямую h1, минуя шлюз, а h1 отбрасывает ответ от 192.168.10.10, поскольку ждал его от 203.0.113.2. Решение называется hairpin NAT, или NAT loopback («петля NAT»): такие пакеты получают дополнительно трансляцию адреса отправителя в адрес шлюза, и ответ сервера возвращается через шлюз. RFC 4787 требует, чтобы устройства NAT поддерживали такую петлю, называя её hairpinning 6. Обратная сторона решения — внутренний сервер видит в журнале не адрес клиента, а адрес шлюза. Альтернатива — «расщеплённый» DNS (англ. split-horizon DNS), который внутренним клиентам возвращает внутренний адрес сервера.
Поведение NAT: отображение, фильтрация, таймауты
Для приложений важно не только то, что NAT подменяет адреса, но и как именно он это делает. RFC 4787 вводит две независимые характеристики 6. Поведение отображения (англ. mapping behavior) отвечает на вопрос, получат ли два исходящих потока с одного внутреннего адреса и порта к разным адресатам один и тот же внешний адрес и порт. Варианты: независимое от адресата отображение (англ. Endpoint-Independent Mapping), зависимое от адреса назначения и зависимое от адреса и порта назначения. Поведение фильтрации (англ. filtering behavior) отвечает на вопрос, от кого NAT примет входящие пакеты на уже созданное отображение: от любого узла, только от тех адресов, к которым внутренний узел обращался, или только от тех адресов и портов. В старой терминологии RFC 3489 эти сочетания назывались «полный конус», «ограниченный конус», «конус с ограничением порта» и «симметричный NAT». Для успешной работы одноранговых приложений RFC 4787 требует независимого от адресата отображения 6.
Запись трансляции живёт, пока по ней идёт трафик, и удаляется по таймауту бездействия. Для UDP, где нет признаков начала и конца сеанса, RFC 4787 требует таймаут не меньше 2 минут и рекомендует 5 минут 6. Для установленных соединений TCP RFC 5382 требует не меньше 2 часов 4 минут 7. На практике домашние маршрутизаторы и операторские NAT часто используют гораздо меньшие значения, и долгоживущее, но молчащее соединение, например SSH-сеанс или соединение push-уведомлений, обрывается без какого-либо сигнала. Поэтому приложения отправляют периодические проверочные сообщения (англ. keepalive) раз в десятки секунд. В Linux таймауты задаются параметрами nf_conntrack_*_timeout: для установленного TCP-соединения по умолчанию 5 суток, для UDP — 30 с для одиночного обмена и 120 с для потока, в котором были пакеты в обоих направлениях 12.
Последствия NAT и способы его обхода
Нарушение сквозной связности
Архитектура Интернета исходила из принципа «из конца в конец» (англ. end-to-end principle): сеть только доставляет пакеты, а вся прикладная логика сосредоточена на конечных узлах, и каждый узел адресуем любым другим 14. NAT нарушает этот принцип в двух отношениях. Во-первых, узел за NAT недоступен извне без явной настройки проброса, поэтому равноправная связь двух узлов, каждый из которых находится за своим NAT, — видеозвонок, обмен файлами, сетевая игра — не может быть установлена напрямую. Во-вторых, промежуточное устройство хранит состояние каждого соединения. Его перезагрузка разрывает все соединения, его таблица ограничена по размеру, а маршрут ответа обязан пройти через то же устройство, что затрудняет резервирование.
Часто говорят, что NAT обеспечивает безопасность, поскольку закрывает внутренние узлы от входящих соединений. Это верно лишь отчасти и скорее побочный эффект: та же фильтрация обеспечивается межсетевым экраном с отслеживанием состояния (тема 18) без подмены адресов. Кроме того, NAT не защищает от соединений, инициированных изнутри, например вредоносной программой, а сокрытие внутренней структуры сети неполно: по полям IP ID, временным меткам TCP и поведению стеков число узлов за NAT нередко удаётся оценить.
Протоколы с адресами внутри данных и ALG
NAT переписывает адреса в заголовках IP и TCP/UDP, но не в данных. Протоколы, которые передают адреса и порты в полезной нагрузке, перестают работать. Классический пример — FTP в активном режиме. Клиент сообщает серверу командой PORT адрес и порт, на которые сервер должен открыть соединение для передачи данных: PORT 192,168,10,100,195,80. Четыре первых числа — адрес, последние два — порт: 195·256 + 80 = 50000. Сервер в Интернете попытается соединиться с частным адресом 192.168.10.100 и не сможет 13. Аналогичная проблема у протокола установления сеансов SIP, используемого в IP-телефонии. Описание медиапотока в теле сообщения (протокол SDP) содержит адрес и порт, на которые следует отправлять голосовой трафик RTP, и это внутренний адрес абонента.
Решение для таких протоколов — шлюз прикладного уровня (англ. Application Level Gateway, ALG). Это модуль NAT, который понимает конкретный протокол, разбирает его сообщения и переписывает адреса в данных, а заодно заранее создаёт записи трансляции для ожидаемых вторичных соединений 13. ALG имеют существенные недостатки. Замена текстового адреса 192,168,10,100 на 203,0,113,2 меняет длину сообщения, и шлюзу приходится корректировать номера последовательности TCP во всех последующих сегментах соединения. Шифрованный трафик ALG прочитать не может. Наконец, ошибки в реализации ALG — частая причина неработающей IP-телефонии, поэтому SIP ALG на маршрутизаторах нередко рекомендуют отключать. В Linux ALG называются помощниками отслеживания соединений (англ. conntrack helpers), например nf_conntrack_ftp и nf_nat_ftp. Начиная с ядра 4.7 они не назначаются соединениям автоматически, их нужно явно привязывать правилом ct helper в nftables. Современные протоколы проектируют так, чтобы адреса в данных не требовались. Пассивный режим FTP, в котором соединение для данных открывает клиент, проходит через NAT без помощников.
Обход NAT: STUN, TURN, ICE
Для равноправной связи двух узлов за разными NAT разработан набор методов обхода NAT (англ. NAT traversal). Протокол STUN (англ. Session Traversal Utilities for NAT, RFC 8489) позволяет узлу узнать свой внешний адрес и порт: узел отправляет запрос Binding на публичный сервер STUN (обычно порт UDP 3478), и сервер возвращает в атрибуте XOR-MAPPED-ADDRESS адрес и порт, с которых пришёл запрос, то есть адрес после трансляции 8. Адрес передаётся в «замаскированном» виде, сложенным по модулю 2 с константой. Так сделано именно для того, чтобы неосторожный ALG не переписал его, приняв за внутренний.
Узнав внешние адреса друг друга через сервер сигнализации, два узла одновременно отправляют пакеты навстречу. Исходящий пакет каждого создаёт на своём NAT отображение и правило фильтрации, разрешающее ответ от партнёра, и встречный пакет проходит. Приём называют «пробиванием дыр» (англ. hole punching). Он работает, если оба NAT используют независимое от адресата отображение. Если хотя бы один NAT симметричный, внешний порт для партнёра отличается от порта, сообщённого сервером STUN, и пробивание не удаётся. Тогда используется ретрансляция через сервер TURN (англ. Traversal Using Relays around NAT): оба узла устанавливают связь с публичным ретранслятором, который пересылает данные между ними. Это надёжно, но дорого для оператора сервиса.
Процедура ICE (англ. Interactive Connectivity Establishment, RFC 8445) объединяет эти методы 9. Каждый узел собирает кандидатов: адреса своих интерфейсов (англ. host candidates), внешние адреса, полученные через STUN (англ. server-reflexive), и адреса на ретрансляторе TURN (англ. relayed). Затем узлы обмениваются списками кандидатов через сервер сигнализации, проверяют связность всех пар кандидатов запросами STUN и выбирают лучшую работающую пару: прямую, если возможно, ретранслированную, если нет. ICE лежит в основе WebRTC — видеосвязи в браузерах.
NAT на стороне провайдера: CGNAT
С исчерпанием пулов IPv4 провайдеры перестали выдавать каждому абоненту публичный адрес. Трансляция переместилась в сеть провайдера, и появился NAT операторского класса (англ. Carrier-Grade NAT, CGNAT, или Large-Scale NAT). Абонентский маршрутизатор получает от провайдера частный адрес, а публичный адрес провайдерского NAT делят сотни абонентов. Получается двойная трансляция, NAT444: частная сеть абонента, адресное пространство провайдера и Интернет. Чтобы адреса между абонентским и операторским NAT не совпали с частными адресами в домашних сетях, для этого сегмента выделен отдельный блок 100.64.0.0/10, разделяемое адресное пространство (англ. Shared Address Space) 10. Если маршрутизатор показывает внешний адрес из 100.64.0.0/10, а сайты определения адреса — другой, абонент находится за CGNAT.
CGNAT усиливает все проблемы NAT. Абонент не может настроить проброс порта, и разместить дома сервер невозможно. Число портов на абонента ограничено, обычно выделяется блок из нескольких сотен или тысяч портов, и приложения со множеством соединений его исчерпывают. Один публичный адрес разделяют многие абоненты, поэтому блокировка адреса за злоупотребление одного из них задевает всех. Наконец, по закону провайдер обязан установить, кто из абонентов пользовался адресом и портом в заданный момент, и вынужден хранить журналы трансляций огромного объёма. Выделение абоненту фиксированного блока портов (англ. port block allocation) сокращает журналы: регистрируется выделение блока, а не каждое соединение. Устойчивое решение, как и в случае домашнего NAT, — переход на IPv6, где NAT не требуется.
NAT в Linux: netfilter, conntrack и nftables
Хуки netfilter и место трансляции
В ядре Linux обработкой пакетов на пути через стек управляет подсистема netfilter. Она предоставляет пять точек перехвата, или хуков (англ. hooks), в которых зарегистрированные модули и правила могут просматривать, изменять и отбрасывать пакеты 11. Схема на рисунке ниже показывает хуки на пути пакета.
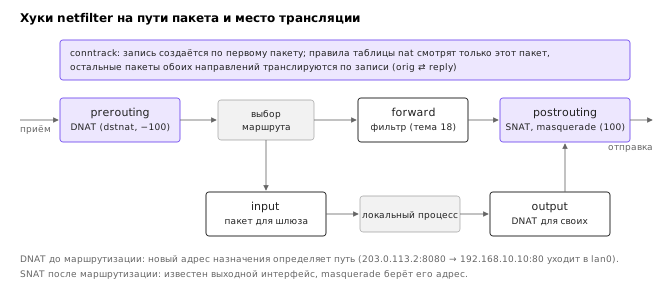
prerouting— сразу после приёма пакета, до решения о маршруте;input— для пакетов, адресованных самому узлу;forward— для пакетов, пересылаемых узлом в другую сеть;output— для пакетов, созданных локальными процессами;postrouting— непосредственно перед отправкой в интерфейс, после выбора маршрута.
Место каждого вида трансляции определяется логикой маршрутизации. Подмена адреса назначения (DNAT) должна произойти в prerouting, до выбора маршрута: от нового адреса назначения зависит, куда пакет пойдёт дальше. Пакет на 203.0.113.2:8080 без DNAT был бы доставлен самому шлюзу, а после DNAT на 192.168.10.10:80 маршрутизируется во внутреннюю сеть. Подмена адреса отправителя (SNAT, маскарадинг) выполняется в postrouting, когда уже известен выходной интерфейс: маскарадинг берёт адрес именно этого интерфейса. Кроме того, в postrouting фильтрующие правила цепочки forward уже видели исходные внутренние адреса, что удобно для политики межсетевого экрана.
Отслеживание соединений conntrack
Трансляция требует памяти о соединениях: ответный пакет должен получить обратную подмену. Эту память обеспечивает подсистема отслеживания соединений (англ. connection tracking, conntrack). Для каждого потока она хранит запись из двух кортежей: исходного направления (англ. original) и ответного (англ. reply), состояние и таймаут 12. Ключевая особенность NAT в netfilter: правила таблицы nat применяются только к первому пакету соединения, для которого conntrack создаёт новую запись. Принятое решение о трансляции сохраняется в записи, и все последующие пакеты обоих направлений транслируются по ней без просмотра правил. Поэтому изменение правил NAT не влияет на уже установленные соединения. Это частая причина недоумения при отладке, которое устраняется удалением записей командой conntrack -D или повторным подключением.
Содержимое таблицы можно увидеть командой conntrack -L из одноимённого пакета или в файле /proc/net/nf_conntrack. Для соединения h1 с веб-сервером через шлюз запись имеет вид:
tcp 6 117 TIME_WAIT src=192.168.10.100 dst=198.51.100.10 sport=45800 dport=80 src=198.51.100.10 dst=203.0.113.2 sport=80 dport=45800 [ASSURED] mark=0 use=1
Первый кортеж описывает пакеты, как их отправил клиент. Второй — какими ожидаются ответы: от 198.51.100.10:80 на 203.0.113.2:45800. Несовпадение адреса назначения ответа с адресом отправителя оригинала, 203.0.113.2 вместо 192.168.10.100, и есть признак трансляции источника. Число 117 — оставшееся время жизни записи в секундах, TIME_WAIT — состояние, которое conntrack отслеживает по флагам TCP так же, как конечный автомат из темы 12. Флаг ASSURED означает, что трафик был в обоих направлениях и запись не будет вытеснена при переполнении таблицы. Размер таблицы ограничен параметром net.netfilter.nf_conntrack_max. На загруженном шлюзе переполнение таблицы приводит к отбрасыванию новых соединений и к сообщению nf_conntrack: table full, dropping packet в журнале ядра.
Таблица nat в nftables
Правила трансляции в nftables, современной замене iptables, размещаются в цепочках с типом nat, привязанных к хукам 11. Минимальная конфигурация маскарадинга для шлюза «Северного узла»:
table ip nat {
	chain postrouting {
		type nat hook postrouting priority srcnat; policy accept;
		oifname "wan0" ip saddr 192.168.10.0/24 counter masquerade
	}
}
Правило читается так: пакеты, уходящие через интерфейс wan0 с адресом отправителя из офисной сети, маскировать адресом wan0. Приоритет srcnat (числовое значение 100) — стандартный для подмены источника; для подмены назначения используется dstnat (−100). Цепочки с меньшим приоритетом выполняются в хуке раньше. Действие masquerade отличается от snat to 203.0.113.2 тем, что адрес не указывается, а берётся с выходного интерфейса в момент создания соединения. Кроме того, при отключении интерфейса записи conntrack маскарадинга удаляются. Поэтому masquerade применяют на интерфейсах с динамическим адресом, полученным по DHCP или PPPoE, а snat — при постоянном адресе, где он немного эффективнее.
Проброс порта и hairpin NAT добавляют цепочку prerouting и ещё одно правило в postrouting:
table ip nat {
	chain prerouting {
		type nat hook prerouting priority dstnat; policy accept;
		ip daddr 203.0.113.2 tcp dport 8080 counter dnat to 192.168.10.10:80
	}
	chain postrouting {
		type nat hook postrouting priority srcnat; policy accept;
		oifname "wan0" ip saddr 192.168.10.0/24 counter masquerade
		oifname "lan0" ip saddr 192.168.10.0/24 ip daddr 192.168.10.10 tcp dport 80 ct status dnat counter masquerade
	}
}
Выражение ct status dnat обращается к записи conntrack и выделяет соединения, к которым уже применён DNAT. Благодаря этому маскируются только «петлевые» обращения к пробросу, а прямые обращения внутренних узлов к 192.168.10.10 сохраняют свои адреса. Счётчики counter в выводе nft list ruleset показывают, сколько пакетов совпало с правилом. Поскольку в таблице nat правила видят только первые пакеты соединений, значения счётчиков равны числу соединений, а не числу пакетов. На стенде после одного запроса через проброс счётчик показывает packets 1 bytes 60: один пакет SYN длиной 60 байтов.
Для работы шлюза недостаточно правил NAT. Ядро должно пересылать пакеты между интерфейсами, а это по умолчанию отключено: net.ipv4.ip_forward = 0. Забытая пересылка — самая частая ошибка при настройке шлюза: правила NAT загружены, счётчики стоят на нуле, клиенты не получают ответов. Если на шлюзе действует политика межсетевого экрана, цепочка forward таблицы filter должна пропускать нужные пакеты, включая проброшенные внутрь (тема 18).
MSS clamping
С NAT-шлюзами связана ещё одна типичная проблема. Если внешний канал шлюза имеет MTU меньше 1500, например 1492 байта при PPPoE или меньше в туннеле, а ICMP-сообщения «необходима фрагментация» где-то по пути фильтруются, механизм определения MTU пути (тема 7) не работает. Рукопожатие TCP проходит, а большие сегменты пропадают: веб-страницы начинают загружаться и «зависают». Распространённое лекарство — коррекция MSS (англ. MSS clamping). Шлюз переписывает опцию MSS в проходящих сегментах SYN, уменьшая её до значения, соответствующего MTU выходного маршрута, и обе стороны соединения с самого начала используют сегменты подходящего размера. В nftables это правило цепочки forward:
tcp flags syn tcp option maxseg size set rt mtu
Выражение rt mtu подставляет MSS, вычисленный по MTU маршрута к адресату. Коррекция MSS работает только для TCP и не помогает протоколам поверх UDP, но для домашних и офисных шлюзов это наиболее надёжное средство. Подробнее туннели и связанные с ними ограничения MTU рассматриваются в теме 19.
Итоги темы
DHCP решает задачу автоматической настройки узла, у которого ещё нет адреса. Широковещательный обмен из четырёх сообщений DORA выдаёт клиенту адрес из пула, маску, шлюз, серверы DNS и другие параметры, передаваемые опциями в формате «тип — длина — значение». Ключевое понятие DHCP — аренда: адрес выдаётся на срок, клиент продлевает его у своего сервера в момент T1 и у любого сервера в момент T2, а по истечении срока обязан прекратить его использование. Ретранслятор с полем giaddr и опцией 82 позволяет одному серверу обслуживать множество подсетей. Отсутствие аутентификации делает DHCP уязвимым для посторонних серверов и истощения пула, и защита строится на коммутаторах функциями DHCP snooping, Dynamic ARP Inspection и IP Source Guard.
NAT позволил частным сетям с адресами RFC 1918 выходить в Интернет и на два десятилетия отсрочил дефицит адресов IPv4. NAPT различает соединения множества внутренних узлов по портам и хранит таблицу трансляций. Проброс порта открывает доступ к внутренним серверам, hairpin NAT позволяет внутренним клиентам обращаться к ним по публичному адресу. Поведение отображения и фильтрации, описанное в RFC 4787, и таймауты записей определяют, какие приложения работают через данный NAT.
Цена NAT — потеря сквозной связности. Узлы за NAT недоступны извне, протоколы с адресами в данных требуют шлюзов прикладного уровня, а равноправная связь возможна только с помощью STUN, TURN и ICE. CGNAT провайдеров с адресным пространством 100.64.0.0/10 усиливает эти проблемы и делает IPv6 не просто желательным, но необходимым.
В Linux трансляцию выполняет netfilter. DNAT происходит в хуке prerouting до выбора маршрута, SNAT и маскарадинг — в postrouting. Правила таблицы nat применяются только к первому пакету соединения, а дальнейшую работу ведёт conntrack по записи с исходным и ответным кортежами. Те же механизмы отслеживания состояния лежат в основе межсетевых экранов, рассматриваемых в теме 18. Следующая тема, 15, посвящена системе доменных имён — сервису, адрес которого узел получает по DHCP и без которого пользователь не смог бы обратиться ни к одному сайту по имени.
Литература
- Droms R. Dynamic Host Configuration Protocol. — RFC 2131, IETF, 1997. https://www.rfc-editor.org/rfc/rfc2131
- Alexander S., Droms R. DHCP Options and BOOTP Vendor Extensions. — RFC 2132, IETF, 1997. https://www.rfc-editor.org/rfc/rfc2132
- Patrick M. DHCP Relay Agent Information Option. — RFC 3046, IETF, 2001. https://www.rfc-editor.org/rfc/rfc3046
- Srisuresh P., Egevang K. Traditional IP Network Address Translator (Traditional NAT). — RFC 3022, IETF, 2001. https://www.rfc-editor.org/rfc/rfc3022
- Rekhter Y., Moskowitz B., Karrenberg D., de Groot G. J., Lear E. Address Allocation for Private Internets. — RFC 1918, IETF, 1996. https://www.rfc-editor.org/rfc/rfc1918
- Audet F., Jennings C. Network Address Translation (NAT) Behavioral Requirements for Unicast UDP. — RFC 4787, IETF, 2007. https://www.rfc-editor.org/rfc/rfc4787
- Guha S., Biswas K., Ford B., Sivakumar S., Srisuresh P. NAT Behavioral Requirements for TCP. — RFC 5382, IETF, 2008. https://www.rfc-editor.org/rfc/rfc5382
- Petit-Huguenin M., Salgueiro G., Rosenberg J., Wing D., Mahy R., Matthews P. Session Traversal Utilities for NAT (STUN). — RFC 8489, IETF, 2020. https://www.rfc-editor.org/rfc/rfc8489
- Keranen A., Holmberg C., Rosenberg J. Interactive Connectivity Establishment (ICE): A Protocol for Network Address Translator (NAT) Traversal. — RFC 8445, IETF, 2018. https://www.rfc-editor.org/rfc/rfc8445
- Weil J., Kuarsingh V., Donley C., Liljenstolpe C., Azinger M. IANA-Reserved IPv4 Prefix for Shared Address Space. — RFC 6598, IETF, 2012. https://www.rfc-editor.org/rfc/rfc6598
- The nftables wiki. Performing Network Address Translation (NAT). — 2024. https://wiki.nftables.org/wiki-nftables/index.php/Performing_Network_Address_Translation_(NAT)
- The Linux Kernel Documentation. Netfilter Conntrack Sysfs variables. — 2025. https://docs.kernel.org/networking/nf_conntrack-sysctl.html
- Holdrege M., Srisuresh P. Protocol Complications with the IP Network Address Translator. — RFC 3027, IETF, 2001. https://www.rfc-editor.org/rfc/rfc3027
- Saltzer J. H., Reed D. P., Clark D. D. End-to-End Arguments in System Design. — ACM Transactions on Computer Systems, 1984, Vol. 2, No. 4, С. 277–288, DOI: 10.1145/357401.357402.