
HTTP и прикладные протоколы Веба
Предыдущая тема закончилась на том, что браузер получил от DNS адрес сервера. Дальше начинается работа протокола передачи гипертекста (англ. Hypertext Transfer Protocol, HTTP) — основного прикладного протокола Интернета. Через HTTP загружаются веб-страницы, работают мобильные приложения и программные интерфейсы облачных сервисов, распространяются обновления программ и видео; по различным оценкам, на HTTP и его зашифрованный вариант HTTPS приходится основная доля трафика Интернета. Из предыдущих тем известны транспортные механизмы, на которые HTTP опирается: надёжный поток байтов TCP с рукопожатием, управлением перегрузкой и блокировкой начала очереди (темы 12–13).
HTTP интересен для изучения тем, что в нём хорошо видны два уровня проектирования протокола. Первый — семантика: что означает запрос GET или код ответа 404, можно ли повторить запрос, можно ли сохранить ответ в кеше. Эта часть за тридцать лет почти не изменилась. Второй — способ передачи сообщений по сети: текстовые сообщения поверх TCP в HTTP/1.1, двоичные кадры с мультиплексированием в HTTP/2, независимые потоки поверх нового транспорта QUIC в HTTP/3. Эта часть менялась трижды, и каждый раз — из-за ограничений производительности, о которых пойдёт речь. Такое разделение закреплено и в стандартах: в 2022 году спецификация HTTP была переиздана комплектом документов, где семантика (RFC 9110) и кеширование (RFC 9111) описаны отдельно от версий протокола (RFC 9112, 9113, 9114) 123.
Изложение построено следующим образом. Сначала рассматриваются модель Веба, идентификаторы ресурсов и устройство сообщения HTTP/1.1, затем — семантика методов, кодов и заголовков, включая способы передачи тела и механизм cookies. Третий раздел посвящён соединениям HTTP/1.1 и их влиянию на производительность, четвёртый — кешированию и промежуточным узлам: прокси, балансировщикам, сетям доставки контента. Пятый раздел описывает HTTP/2, транспорт QUIC и HTTP/3, шестой — прикладные протоколы поверх HTTP и рядом с ним: REST, WebSocket, электронную почту и SSH. Шифрование TLS упоминается там, где без него нельзя обойтись, а подробно рассматривается в теме 17.
Модель Веба и сообщение HTTP/1.1
Клиент, сервер и ресурс
Веб построен по модели «клиент — сервер»: клиент (браузер, мобильное приложение, утилита curl) отправляет запрос, сервер возвращает ответ. Предмет обмена — ресурс (англ. resource): всё, что можно идентифицировать, от HTML-документа до записи в базе данных или результата поиска. Сервер передаёт не сам ресурс, а его представление (англ. representation) — последовательность байтов в некотором формате, например HTML, JSON или PNG, с метаданными о нём: типом содержимого, языком, датой изменения 1. Один ресурс может иметь несколько представлений, и клиент указывает в запросе предпочтительные (заголовки Accept, Accept-Language, Accept-Encoding); этот механизм называется согласованием содержимого (англ. content negotiation).
HTTP — протокол без сохранения состояния (англ. stateless): каждый запрос самодостаточен, и сервер не обязан помнить предыдущие запросы того же клиента. Это свойство упрощает масштабирование — любой запрос может обработать любой из множества одинаковых серверов, — но требует отдельного механизма там, где состояние всё же нужно, например для входа пользователя в систему; его роль выполняют cookies, рассмотренные ниже.
Между клиентом и сервером-источником (англ. origin server) могут находиться посредники (англ. intermediaries): прокси, шлюзы, кеши, балансировщики нагрузки. Протокол учитывает их явно: часть заголовков адресована только ближайшему узлу, часть — получателю на другом конце цепочки, а правила кеширования определяют, что посредник вправе сохранить и повторно выдать.
Идентификаторы ресурсов: URI и URL
Ресурс идентифицируется унифицированным идентификатором ресурса (англ. Uniform Resource Identifier, URI), синтаксис которого определён в RFC 3986 9. URI, указывающий не только имя, но и способ доступа к ресурсу, исторически называется URL (англ. Uniform Resource Locator); в Вебе практически все URI являются URL. Разберём его составные части на примере:
https://www.nsu.example:8443/catalog/search?q=dns&page=2#results
\___/   \__________________/\_____________/\___________/\______/
схема       авторитет           путь         запрос     фрагмент
Схема (англ. scheme) определяет протокол: http (порт по умолчанию 80) или https (порт 443, HTTP поверх TLS). Авторитет (англ. authority) — имя или адрес сервера и необязательный порт; имя разрешается через DNS (тема 15). Путь (англ. path) и запрос (англ. query) передаются серверу и определяют ресурс. Фрагмент после # серверу не передаётся вовсе: он обрабатывается клиентом, например указывает место на странице. Символы, недопустимые в URI, кодируются процентной записью: пробел — %20, кириллическая буква «д» в UTF-8 — два байта %D0%B4.
Важное следствие: в URI имя сервера и путь разделены, а в запросе HTTP/1.1 они передаются в разных местах. Путь с запросом попадает в строку запроса, а имя сервера — в заголовок Host. Благодаря заголовку Host на одном IP-адресе и порту могут работать тысячи сайтов (англ. virtual hosting): сервер выбирает сайт по значению этого заголовка.
Устройство сообщения HTTP/1.1
Сообщение HTTP/1.1 — текст в кодировке ASCII, передаваемый по соединению TCP 3. Запрос состоит из строки запроса (англ. request line): метода, цели запроса и версии протокола; затем следуют поля заголовка (англ. header fields) вида Имя: значение, по одному в строке; затем пустая строка и необязательное тело (англ. body, content). Строки разделяются парой символов CRLF (байты 0d 0a). Ответ устроен так же, но начинается строкой состояния (англ. status line): версия, трёхзначный код состояния и поясняющая фраза. Ниже — реальный обмен из лабораторной работы, показанный curl -v: строки, начинающиеся с >, отправлены клиентом, с < — получены от сервера, со * — комментарии curl.
curl -v http://10.16.0.1/hello
*   Trying 10.16.0.1:80...
* Connected to 10.16.0.1 (10.16.0.1) port 80 (#0)
> GET /hello HTTP/1.1
> Host: 10.16.0.1
> User-Agent: curl/7.81.0
> Accept: */*
>
< HTTP/1.1 200 OK
< Content-Type: text/plain; charset=utf-8
< Content-Length: 24
< X-Backend: web1
< Date: Mon, 12 Oct 2026 09:46:00 GMT
< Server: LabProxy/1.0
< Via: 1.1 px
<
* Connection #0 to host 10.16.0.1 left intact
Привет от web1!
Запрос занимает 78 байт: строка GET /hello HTTP/1.1 (19 символов и CRLF — 21 байт), три заголовка и завершающая пустая строка из двух байтов. Конец заголовков сервер определяет по последовательности 0d 0a 0d 0a. Тела у запроса нет. Ответ сообщает длину тела — 24 байта — заголовком Content-Length, и по этому числу клиент узнаёт, где кончается ответ и где в том же соединении начнётся следующий. Строка «Привет от web1!» вместе с переводом строки содержит 16 символов, но 24 байта: 8 кириллических букв занимают в UTF-8 по два байта, а остальные 8 символов (пробелы, латиница, цифра, восклицательный знак и перевод строки) — по одному. Имена полей нечувствительны к регистру, и в HTTP/2 и HTTP/3 они передаются строчными буквами.
Текстовый формат делает HTTP/1.1 удобным для наблюдения и отладки: запрос можно набрать вручную через nc или telnet, что и делается в лабораторной работе. У этого удобства есть цена: текст нужно разбирать посимвольно, заголовки повторяются в каждом запросе, а неоднозначности разбора (лишние пробелы, дублирующиеся заголовки длины) становятся уязвимостями, о чём пойдёт речь в следующем разделе.
Семантика HTTP: методы, коды состояния, заголовки
Методы и их свойства
Метод (англ. method) указывает, что клиент просит сделать с ресурсом. RFC 9110 определяет восемь методов и два важных свойства, которые позволяют посредникам и клиентам принимать решения, не понимая смысла конкретного приложения 1. Метод безопасен (англ. safe), если по замыслу он только читает и не изменяет состояние сервера. Метод идемпотентен (англ. idempotent), если результат нескольких одинаковых запросов такой же, как одного. Безопасные методы по определению идемпотентны.
| Метод | Назначение | Безопасный | Идемпотентный | Тело запроса |
|---|---|---|---|---|
GET | получить представление ресурса | да | да | не определено |
HEAD | как GET, но только заголовки | да | да | не определено |
OPTIONS | какие возможности поддерживает ресурс | да | да | возможно |
TRACE | вернуть полученный запрос (диагностика) | да | да | нет |
POST | обработать данные: создать, отправить форму | нет | нет | да |
PUT | создать или заменить ресурс целиком | нет | да | да |
DELETE | удалить ресурс | нет | да | возможно |
CONNECT | установить туннель через прокси | нет | нет | нет |
PATCH (RFC 5789) | частично изменить ресурс | нет | нет | да |
Различие имеет практические последствия. Если соединение оборвалось до получения ответа, клиент или прокси может автоматически повторить идемпотентный запрос, но не POST: повтор оформления заказа может создать второй заказ. Именно поэтому браузер спрашивает пользователя перед повторной отправкой формы. Поисковые роботы и функции предварительной загрузки браузера следуют по ссылкам методом GET, исходя из его безопасности; приложение, удаляющее данные по ссылке вида GET /delete?id=5, нарушает семантику и рискует потерять данные из-за робота. Заметим, что PUT идемпотентен, а POST нет: два одинаковых PUT /users/7 оставляют одно и то же состояние, а два POST /users создают двух пользователей.
Коды состояния
Код состояния (англ. status code) — трёхзначное число, первая цифра которого задаёт класс ответа 1. Клиент, не знающий конкретного кода, обязан обрабатывать его как код x00 того же класса; поэтому новые коды можно добавлять без поломки старых клиентов.
| Класс | Смысл | Частые коды |
|---|---|---|
| 1xx | промежуточный ответ, окончательный последует | 100 Continue, 101 Switching Protocols, 103 Early Hints |
| 2xx | успех | 200 OK, 201 Created, 204 No Content, 206 Partial Content |
| 3xx | перенаправление: нужны дальнейшие действия клиента | 301 Moved Permanently, 302 Found, 304 Not Modified, 307 и 308 |
| 4xx | ошибка клиента | 400 Bad Request, 401 Unauthorized, 403 Forbidden, 404 Not Found, 405 Method Not Allowed, 429 Too Many Requests |
| 5xx | ошибка сервера | 500 Internal Server Error, 502 Bad Gateway, 503 Service Unavailable, 504 Gateway Timeout |
Несколько кодов заслуживают пояснения. Перенаправления 301 и 302 исторически позволяли клиенту сменить метод POST на GET, поэтому позднее введены 307 и 308, которые требуют сохранить метод и тело. Код 304 Not Modified не является ошибкой: это ответ на условный запрос, означающий «ваша копия актуальна», — он рассматривается в разделе о кешировании. Код 401 означает «не аутентифицирован» (не предъявлены или неверны учётные данные), а 403 — «аутентифицирован, но доступ запрещён». Коды 502 и 504 выдаёт не сам сервер-источник, а шлюз или обратный прокси: 502 — бэкенд вернул некорректный ответ или недоступен, 504 — бэкенд не ответил вовремя. Различение этих кодов — первый шаг диагностики: при 502 искать проблему следует за прокси, а не в браузере пользователя. Промежуточный код 103 Early Hints позволяет серверу ещё до готовности основного ответа сообщить браузеру, какие ресурсы стоит начать загружать; его можно увидеть у крупных сайтов, например curl -I https://www.cloudflare.com/ возвращает сначала HTTP/2 103, затем HTTP/2 200.
Длина тела: Content-Length и кодирование chunked
Поскольку соединение TCP — непрерывный поток байтов (тема 12), получатель должен знать, где кончается тело одного сообщения. HTTP/1.1 предусматривает три способа 3. Первый — заголовок Content-Length с длиной тела в байтах, как в примере выше. Второй — закрытие соединения сервером после тела; так работал HTTP/1.0, и этот способ не позволяет переиспользовать соединение и не отличает полный ответ от оборванного. Третий — кодирование передачи частями (англ. chunked transfer coding), объявляемое заголовком Transfer-Encoding: chunked. Оно нужно, когда длина тела заранее неизвестна: сервер генерирует страницу постепенно, передаёт результат долгого вычисления или поток журнала.
При кодировании chunked тело разбито на части (англ. chunks). Каждой части предшествует строка с её длиной в шестнадцатеричной записи и CRLF, за данными части следует ещё один CRLF; конец тела обозначается частью нулевой длины, после которой могут идти завершающие поля (англ. trailer fields) и пустая строка. Реальный ответ учебного сервера, полученный curl --raw (ключ отключает декодирование и показывает тело как есть):
22
часть 1, время 12:46:01

22
часть 2, время 12:46:01

22
часть 3, время 12:46:01

0
Число 22 — шестнадцатеричное, то есть 34 байта: строка «часть 1, время 12:46:01» и символ перевода строки. Слово «часть» и «время» содержат 10 кириллических букв по два байта (20 байт), остальные 13 символов и перевод строки — по одному (14 байт). Пустая строка после каждой части — это CRLF, завершающий данные части, и перевод строки внутри самих данных. Кодирование chunked существует только в HTTP/1.1: в HTTP/2 и HTTP/3 тело и так передаётся кадрами с собственной длиной, и заголовок Transfer-Encoding там запрещён.
Правила определения длины кажутся техническими, но их нарушение приводит к серьёзной уязвимости — контрабанде запросов (англ. HTTP request smuggling). Если сообщение содержит и Content-Length, и Transfer-Encoding: chunked, а прокси и бэкенд по-разному решают, какому заголовку верить, они разойдутся во мнении, где кончается запрос. Остаток, который бэкенд считает началом следующего запроса, злоумышленник формирует сам, и этот «контрабандный» запрос выполняется от имени другого пользователя того же соединения. RFC 9112 требует, чтобы Transfer-Encoding имел приоритет, а сервер, получивший оба заголовка, считал такое сообщение подозрительным и закрывал соединение после ответа 3.
Состояние поверх протокола без состояния: cookies и сессии
Чтобы интернет-магазин «помнил» корзину покупателя, а почтовый сервис — что пользователь вошёл в систему, сервер должен связывать последовательные запросы одного клиента. Механизм cookies, описанный в RFC 6265, решает эту задачу без изменения самого протокола 10. Сервер включает в ответ заголовок Set-Cookie с парой «имя=значение» и атрибутами; клиент сохраняет её и в последующих запросах к тому же сайту отправляет заголовок Cookie. Ответ учебного сервера на первое посещение:
HTTP/1.1 200 OK
Set-Cookie: sid=4f0c2a9e1b7d3e65; Path=/; HttpOnly; SameSite=Lax
...
сессия 4f0c2a9e1b7d3e65 на web1, посещение 1
Чаще всего в cookie хранится не само состояние, а случайный идентификатор сессии (англ. session ID), по которому сервер находит данные сессии в своём хранилище. Атрибуты ограничивают использование cookie: Domain и Path — область сайта, Expires или Max-Age — срок хранения (без них cookie удаляется при закрытии браузера), Secure — передавать только по HTTPS, HttpOnly — недоступно сценариям JavaScript на странице, что снижает ущерб от внедрения сценария, SameSite — не отправлять cookie в запросах, инициированных чужими сайтами, что защищает от подделки межсайтовых запросов (англ. Cross-Site Request Forgery, CSRF).
Хранение сессии на сервере создаёт проблему при балансировке нагрузки: если сессия лежит в памяти сервера web1, а следующий запрос пользователя попадёт на web2, пользователь «выйдет из системы». Решения три: общее хранилище сессий для всех серверов, «липкие» сессии (англ. sticky sessions), когда балансировщик направляет клиента всегда на один сервер, или хранение подписанных данных сессии в самом cookie. В лабораторной работе эта проблема воспроизводится намеренно. Отметим также, что cookies, установленные сторонними сайтами (англ. third-party cookies), долгое время служили основой отслеживания пользователей между сайтами, и браузеры последовательно ограничивают их.
Соединения HTTP/1.1 и производительность
Стоимость соединения и постоянные соединения
В HTTP/1.0 каждый запрос открывал новое соединение TCP, и сервер закрывал его после ответа. Рассмотрим, сколько стоит одно соединение. Установление TCP занимает один круговой обход (англ. Round-Trip Time, RTT): SYN, SYN-ACK, после чего клиент может отправлять данные вместе с ACK. Для HTTPS добавляется рукопожатие TLS: один RTT в TLS 1.3 и два в TLS 1.2 (тема 17). Затем ещё один RTT уходит на сам запрос и ответ. Кроме того, новое соединение начинает с малого окна перегрузки и медленного старта (тема 13), поэтому большой ответ по свежему соединению передаётся медленнее, чем по «разогретому».
Числовой пример. При RTT 50 мс получение одного небольшого ресурса по HTTPS с TLS 1.3 по новому соединению займёт не менее 3 × 50 = 150 мс, из которых 100 мс — подготовка; по TLS 1.2 — 200 мс. Страница из 30 ресурсов при последовательной загрузке по отдельным соединениям потребовала бы не менее 30 × 150 = 4,5 с только на круговые задержки. Реальные измерения подтверждают порядок величин. Ниже — разбивка времени загрузки документа RFC 9110 с сервера, RTT до которого, по данным ping, около 40 мс:
curl -so /dev/null -w 'dns=%{time_namelookup} connect=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} total=%{time_total} http=%{http_version}\n' https://www.rfc-editor.org/rfc/rfc9110.html
dns=0.035299 connect=0.083492 tls=0.179763 ttfb=0.408104 total=0.643659 http=2
Все значения отсчитываются от начала: DNS-запрос занял 35 мс, установление TCP — ещё 48 мс (около одного RTT), рукопожатие TLS — ещё 96 мс, первый байт ответа пришёл через 408 мс (здесь существенна обработка на сервере), а весь документ размером около 1,2 МБ (curl без ключа --compressed не запрашивает сжатие) — через 644 мс. Более четверти времени ушло на подготовку соединения.
Постоянные соединения (англ. persistent connections, keep-alive) устраняют повторную подготовку: в HTTP/1.1 соединение по умолчанию остаётся открытым после ответа, и следующий запрос отправляется по нему 3. Закрыть соединение после ответа любая сторона может, указав заголовок Connection: close; сервер также закрывает соединение, простоявшее без запросов некоторое время. В лабораторной работе сервер, написанный на сокетах, нумерует запросы в пределах соединения, и два запроса, отправленные подряд через один nc, получают ответы «запрос 1» и «запрос 2 в этом TCP-соединении».
Конвейеризация и блокировка начала очереди
Постоянное соединение устраняет подготовку, но не ожидание: по одному соединению HTTP/1.1 запросы обслуживаются строго последовательно, и следующий запрос отправляется только после получения полного ответа на предыдущий. На каждый ресурс по-прежнему уходит не меньше одного RTT. Стандарт HTTP/1.1 предусматривает конвейеризацию (англ. pipelining): клиент может отправить несколько запросов подряд, не дожидаясь ответов, и сервер обязан ответить на них в том же порядке 3.
Требование порядка и стало причиной неудачи конвейеризации. Если первый запрос обращается к медленно генерируемой странице, а за ним стоят десять маленьких картинок, готовые ответы на картинки не могут быть отправлены, пока не завершится первый ответ: в HTTP/1.1 нет способа указать, к какому запросу относится фрагмент данных, — ответы различаются только порядком. Это явление называется блокировкой начала очереди (англ. head-of-line blocking, HOL blocking). Вдобавок многие прокси и серверы реализовывали конвейеризацию с ошибками, и браузеры в итоге отключили её. Конвейеризация осталась в стандарте, но на практике не используется.
Параллельные соединения и приёмы оптимизации
Вместо конвейеризации браузеры открывают к одному серверу несколько параллельных соединений — обычно до шести на пару «схема, хост, порт». Это сокращает время загрузки примерно во столько раз, сколько соединений открыто, пока не упирается в пропускную способность. Лабораторная работа воспроизводит эффект: страница ссылается на 30 картинок, задержка канала клиента искусственно увеличена на 50 мс утилитой tc netem, и загрузчик loadpage.py измеряет общее время в трёх режимах (реальный вывод):
соединений: 1 (параллельно до 1), keep-alive: да
запросов: 31, общее время: 1669 мс
соединений: 6 (параллельно до 6), keep-alive: да
запросов: 31, общее время: 433 мс
соединений: 31 (параллельно до 1), keep-alive: нет
запросов: 31, общее время: 3187 мс
Результаты совпадают с простой моделью. По одному постоянному соединению 31 запрос требует примерно 31 RTT по 52–54 мс (с учётом обработки), то есть около 1,65 с. Шесть соединений делят 30 картинок на группы по 5, и время составляет около (1 + 1 + 5) × RTT ≈ 0,4 с: одно рукопожатие, HTML, пять волн запросов. Без постоянных соединений каждый запрос стоит двух RTT — рукопожатие и запрос, — и 31 × 2 × 52 ≈ 3,2 с.
Ограничение в шесть соединений и стоимость каждого из них породили целый набор приёмов эпохи HTTP/1.1: объединение мелких файлов в один (склейка сценариев и стилей, «спрайты» из картинок), встраивание мелких ресурсов прямо в HTML, распределение ресурсов по нескольким доменам (англ. domain sharding), чтобы обойти ограничение числа соединений на домен. Все они — обходные пути вокруг отсутствия мультиплексирования в протоколе, и с переходом на HTTP/2 часть из них стала вредной: например, распределение по доменам мешает использовать одно соединение.
Кеширование и промежуточные узлы
Кеширование HTTP: свежесть и проверка актуальности
Кеш HTTP (англ. HTTP cache) хранит ответы, чтобы обслуживать повторные запросы без обращения к серверу-источнику. Кеши бывают частными (англ. private cache), принадлежащими одному пользователю, — кеш браузера, — и общими (англ. shared cache), обслуживающими многих пользователей: прокси организации, сеть доставки контента. Правила кеширования вынесены в отдельный стандарт RFC 9111 2.
Центральное понятие — свежесть (англ. freshness). Сервер указывает, сколько секунд ответ можно использовать без проверки, директивой Cache-Control: max-age=N; пока возраст сохранённого ответа меньше max-age, кеш отдаёт его, не обращаясь к серверу. Общий кеш сообщает возраст выдаваемого ответа заголовком Age. Другие часто используемые директивы: no-store — не сохранять ответ вовсе (для конфиденциальных данных); no-cache — сохранять можно, но перед каждым использованием проверять актуальность у сервера (распространённая ошибка — считать, что no-cache запрещает кеширование); private — только для частного кеша; s-maxage — срок свежести для общих кешей; immutable — ресурс никогда не изменится. Если сервер не указал срок явно, кеш может вычислить его эвристически; RFC 9111 предлагает в качестве разумного значения 10 % от времени, прошедшего с последнего изменения ресурса 2.
Когда срок свежести истёк, ответ не обязательно устарел. Чтобы проверить это, не загружая ресурс заново, используются валидаторы (англ. validators) — метаданные, по которым сервер может сравнить версии. Валидатор Last-Modified содержит дату последнего изменения, валидатор ETag (англ. entity tag) — непрозрачную для клиента метку версии, обычно хеш содержимого. Сильный ETag ("11b93fcbe2ba5571") меняется при изменении любого байта представления; слабый (W/"...") — только при смысловом изменении. Клиент, имеющий устаревшую копию, отправляет условный запрос (англ. conditional request) с заголовками If-None-Match: <ETag> или If-Modified-Since: <дата>. Если версия не изменилась, сервер отвечает кодом 304 Not Modified без тела, и клиент продлевает срок жизни своей копии; если изменилась — обычным ответом 200 с новым телом. Временная диаграмма на рисунке ниже показывает обе ситуации.
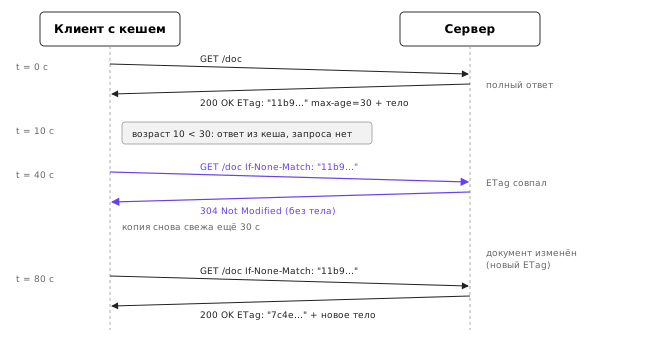
Реальный обмен с учебным сервером. Первый ответ на GET /doc содержит валидаторы и срок свежести:
HTTP/1.1 200 OK
Content-Type: text/plain; charset=utf-8
Content-Length: 35
ETag: "11b93fcbe2ba5571"
Last-Modified: Mon, 12 Oct 2026 09:46:00 GMT
Cache-Control: max-age=30
Повторный запрос с заголовком If-None-Match: "11b93fcbe2ba5571" получает ответ без тела:
HTTP/1.1 304 Not Modified
ETag: "11b93fcbe2ba5571"
Last-Modified: Mon, 12 Oct 2026 09:46:00 GMT
Cache-Control: max-age=30
Экономия зависит от размера ресурса: для 35-байтового документа она ничтожна, а для изображения в 2 МБ ответ 304 сокращает передачу до нескольких сотен байтов заголовков. Однако круговой обход остаётся: условный запрос экономит пропускную способность, но не задержку. Поэтому для неизменяемых ресурсов применяется другой приём — версионирование имён (app.3f9a1c.js) с очень большим max-age и директивой immutable: при изменении файла меняется его имя, и проверять старое имя никогда не нужно.
Заголовок Vary сообщает кешу, от каких заголовков запроса зависит ответ: при Vary: Accept-Encoding сжатый и несжатый варианты хранятся раздельно. Ошибка в Vary или кеширование ответа, зависящего от cookie, приводит к тому, что общий кеш выдаёт одному пользователю страницу другого, — такие инциденты регулярно случаются у неаккуратно настроенных CDN.
Прямой и обратный прокси
Прокси-сервер (англ. proxy) — посредник, принимающий запросы клиентов и пересылающий их дальше от своего имени. Различают два вида по тому, чьим интересам он служит. Прямой прокси (англ. forward proxy) действует от имени клиентов: его настраивает организация, и браузеры сотрудников направляют запросы к любым сайтам через него ради фильтрации, журналирования или общего кеша. Для HTTPS прямой прокси получает запрос CONNECT host:443 и после ответа 200 просто передаёт байты в обе стороны, не видя содержимого. Обратный прокси (англ. reverse proxy) действует от имени серверов: клиент считает, что обращается к самому сайту, а прокси распределяет запросы между внутренними серверами (бэкендами), завершает TLS, сжимает ответы и кеширует их. Типичные программы — nginx, HAProxy, Envoy.
Обратный прокси устанавливает с бэкендом собственное соединение TCP, поэтому бэкенд видит в качестве адреса клиента адрес прокси. Чтобы сохранить сведения о клиенте, прокси добавляет заголовки: X-Forwarded-For (адрес клиента; каждый следующий прокси дописывает через запятую адрес своего соседа), X-Forwarded-Proto (исходная схема — http или https), X-Forwarded-Host. Эти заголовки — фактический стандарт, стандартизованный аналог — заголовок Forwarded из RFC 7239. Кроме того, каждый посредник может добавлять заголовок Via 1. Схема на рисунке ниже показывает учебную площадку лабораторной работы и путь заголовков.
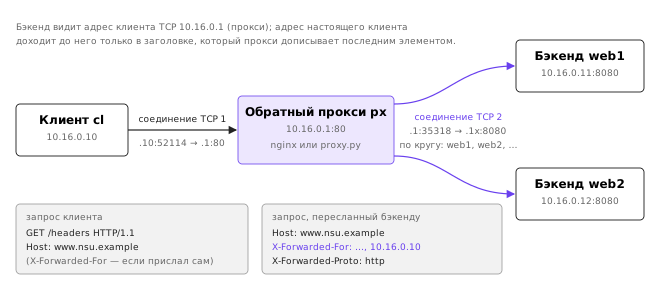
Ответ бэкенда, который возвращает полученные заголовки, показывает, что прокси дописал адрес клиента к значению, уже присланному клиентом:
GET /headers HTTP/1.1
клиент TCP: 10.16.0.1:35318

Host: 10.16.0.1
X-Forwarded-For: 203.0.113.7, 10.16.0.10
X-Forwarded-Proto: http
Via: 1.1 px
Заголовок Via в этом примере добавил учебный прокси proxy.py; nginx в роли обратного прокси его по умолчанию не добавляет.
Пример раскрывает типичную ошибку безопасности. Клиент 10.16.0.10 сам добавил в запрос заголовок X-Forwarded-For: 203.0.113.7, и бэкенд, наивно берущий первый адрес списка, «увидит» клиента 203.0.113.7. Доверять можно только адресам, дописанным собственными прокси, то есть следует брать адрес, добавленный последним доверенным посредником, — в данном случае последний элемент списка. В nginx для этого служит модуль realip с директивой set_real_ip_from, перечисляющей доверенные прокси.
Прокси также удаляет заголовки, относящиеся только к одному переходу (англ. hop-by-hop): Connection, Keep-Alive, Transfer-Encoding, Upgrade и перечисленные в заголовке Connection 1. Например, бэкенд может прислать ответ кодированием chunked, а прокси — переслать его клиенту с Content-Length или наоборот: способ передачи тела выбирается на каждом участке отдельно.
Балансировщики нагрузки уровней L4 и L7 и сети доставки контента
Балансировщик нагрузки (англ. load balancer) распределяет запросы между несколькими серверами. Различают два класса по уровню, на котором принимается решение. Балансировщик уровня L4 (транспортного) работает с соединениями: он видит адреса и порты, выбирает бэкенд для нового соединения TCP или потока UDP (по кругу, по наименьшей загрузке, по хешу адресов) и далее пересылает пакеты, не разбирая их содержимое. Он быстр, может работать в ядре ОС или на сетевом оборудовании, не требует ключей TLS, но не может направлять запросы по URL или cookie, а все запросы одного постоянного соединения попадают на один бэкенд. Балансировщик уровня L7 (прикладного) — это обратный прокси: он завершает соединение клиента, разбирает каждый запрос HTTP и может направлять /api/ на одни серверы, а /static/ — на другие, повторять неудачный идемпотентный запрос на другом бэкенде, учитывать cookie сессии, добавлять заголовки. Плата — больший расход ресурсов, необходимость расшифровывать TLS и два соединения вместо одного.
Балансировщик проверяет состояние бэкендов (англ. health check): периодически запрашивает служебный адрес, например /healthz, и исключает не ответившие серверы. Учебный прокси в лабораторной работе делает упрощённый вариант: при отказе соединения с бэкендом пробует следующий, а если не ответил никто, возвращает 502.
Сеть доставки контента (англ. Content Delivery Network, CDN) — географически распределённая система обратных прокси с кешами. Пользователь направляется на ближайший узел CDN с помощью DNS (GeoDNS) или anycast (тема 15), узел отдаёт ресурс из кеша, а при промахе обращается к серверу-источнику. CDN сокращает RTT до пользователя, разгружает источник и поглощает атаки отказа в обслуживании. Все директивы кеширования, рассмотренные выше, касаются CDN напрямую: именно они определяют, что и как долго узел CDN вправе хранить.
HTTP/2 и HTTP/3
HTTP/2: двоичное кадрирование и мультиплексирование
HTTP/2 вырос из экспериментального протокола SPDY компании Google и был стандартизован в 2015 году (RFC 7540), а в 2022 году переиздан как RFC 9113 4. Его цель — устранить блокировку начала очереди на уровне HTTP и накладные расходы текстовых заголовков, не меняя семантики: методы, коды состояния и заголовки остались прежними, и приложению безразлично, по какой версии пришёл запрос.
Главное изменение — двоичное кадрирование (англ. binary framing). Всё соединение разбито на кадры (англ. frames) с 9-байтовым заголовком: длина данных кадра (24 бита), тип (8 бит), флаги (8 бит), зарезервированный бит и идентификатор потока (31 бит) 4. Поток (англ. stream) — логический двунаправленный канал внутри соединения, по которому передаётся одна пара «запрос — ответ»; клиент открывает потоки с нечётными номерами 1, 3, 5 и так далее. Запрос — это кадр HEADERS (при необходимости с продолжениями CONTINUATION) и кадры DATA с телом; ответ передаётся так же в том же потоке. Служебные кадры относятся к потоку 0: SETTINGS (параметры соединения), PING, GOAWAY (корректное завершение), WINDOW_UPDATE (управление потоком данных). Кадр RST_STREAM отменяет один поток, не закрывая соединение.
Поскольку каждый кадр помечен номером потока, кадры разных ответов могут чередоваться в одном соединении TCP: сервер отправляет готовые фрагменты любого ответа, не дожидаясь завершения других. Это мультиплексирование (англ. multiplexing) устраняет блокировку начала очереди уровня HTTP, и браузеру достаточно одного соединения с сервером вместо шести. Схема на рисунке ниже сравнивает передачу трёх ответов в HTTP/1.1 и HTTP/2.
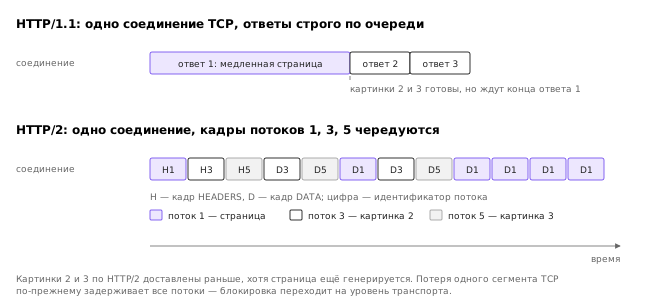
Эффект виден на реальном сервере. Ниже шесть параллельных загрузок одного документа утилитой curl -Z (параллельный режим) с принудительным HTTP/1.1 и с HTTP/2; подсчитаны строки отладочного вывода (номер соединения (#N) в конце строки Connected перед подсчётом отброшен):
== --http1.1
      6 * ALPN, server accepted to use http/1.1
      6 * Connected to www.rfc-editor.org (8.47.69.5) port 443
      6 < HTTP/1.1 200 OK
== --http2
      1 * ALPN, server accepted to use h2
      1 * Connected to www.rfc-editor.org (8.47.69.5) port 443
      5 * Multiplexed connection found!
      6 < HTTP/2 200
В первом случае curl открыл шесть соединений TCP и провёл шесть рукопожатий TLS, во втором — одно соединение, по которому все шесть запросов прошли как разные потоки. Версия протокола согласуется во время рукопожатия TLS расширением ALPN (англ. Application-Layer Protocol Negotiation): клиент предлагает h2 и http/1.1, сервер выбирает. На практике HTTP/2 используется только поверх TLS; вариант без шифрования (h2c) стандарт допускает, но браузеры его не поддерживают.
Мультиплексирование требует новых механизмов. Управление потоком данных (англ. flow control) действует и на уровне отдельного потока, и на уровне соединения: получатель объявляет окно (по умолчанию 65 535 байт) и расширяет его кадрами WINDOW_UPDATE, чтобы быстрый поток не занял весь буфер. Приоритизация позволяет клиенту сообщить, какие ответы важнее; исходная древовидная схема RFC 7540 оказалась слишком сложной, в RFC 9113 она объявлена устаревшей, а ей на смену пришла простая схема с заголовком Priority (RFC 9218). Функция серверного выталкивания (англ. server push), позволявшая серверу отправить ресурс до запроса, на практике почти не дала выигрыша и отключена в основных браузерах.
Сжатие заголовков HPACK
Заголовки HTTP/1.1 повторяются почти без изменений в каждом запросе: User-Agent, Accept, Cookie вместе легко занимают 500–800 байт, и при сотне запросов страницы это десятки килобайт только в направлении к серверу, где канал часто медленнее. Для HTTP/2 разработано специальное сжатие HPACK (RFC 7541) 5. Обычные алгоритмы сжатия вроде DEFLATE не подошли: атака CRIME 2012 года показала, что при сжатии секретов (cookie) вместе с данными, подконтрольными злоумышленнику, по размеру зашифрованного сообщения можно подобрать секрет.
HPACK использует три приёма. Статическая таблица содержит 61 частую пару «имя — значение» или только имя: например, индекс 2 — :method: GET, индекс 7 — :scheme: https. Динамическая таблица (по умолчанию до 4096 байт) заполняется в ходе соединения: заголовок, отправленный один раз, в следующих запросах передаётся номером записи, то есть одним-двумя байтами. Строки, которые всё же передаются, могут кодироваться статическим кодом Хаффмана, оптимизированным для типичных заголовков. В HTTP/2 строка запроса заменена псевдозаголовками :method, :scheme, :authority (замена Host) и :path, а строка состояния — псевдозаголовком :status; имена полей пишутся строчными буквами. Типичный второй запрос к тому же сайту сжимается HPACK до нескольких десятков байтов.
Динамическая таблица — общее состояние кодировщика и декодировщика, поэтому кадры с заголовками должны обрабатываться строго в порядке отправки. Для HTTP/2 поверх упорядоченного потока TCP это естественно, но для HTTP/3, где порядок между потоками не гарантирован, потребовалась другая схема — QPACK.
Блокировка начала очереди в TCP и транспорт QUIC
HTTP/2 устранил блокировку начала очереди на уровне HTTP, но перенёс её на уровень ниже. Все потоки идут по одному соединению TCP, а TCP доставляет байты строго по порядку (тема 13). Если потерян один сегмент, содержащий кадр потока 5, ядро получателя не передаст приложению уже пришедшие следующие сегменты с кадрами потоков 1 и 3, пока потерянный сегмент не будет передан повторно. При потерях в 1–2 % (мобильные сети, перегруженный Wi-Fi) одно соединение HTTP/2 может работать хуже шести соединений HTTP/1.1, у каждого из которых свой порядок. Исправить это внутри TCP нельзя: порядок доставки — часть его контракта, а сам TCP реализован в ядрах операционных систем и в промежуточном оборудовании, которое плохо переносит изменения протокола (явление окостенения, англ. ossification).
Ответом стал новый транспортный протокол QUIC, стандартизованный в 2021 году в RFC 9000 6. QUIC работает поверх UDP, что позволяет реализовать его в пространстве пользователя, в составе браузера или серверного приложения, и проходить через существующие сети. Его основные свойства:
- потоки встроены в транспорт: QUIC сам знает, какие байты к какому потоку относятся, и потеря пакета задерживает только те потоки, данные которых в нём были; остальные потоки доставляются приложению без ожидания;
- шифрование обязательно и встроено: рукопожатие QUIC объединено с рукопожатием TLS 1.3 (RFC 9001), зашифрованы не только данные, но и большая часть заголовка пакета, включая номер пакета, что защищает протокол от вмешательства промежуточных устройств 14;
- установление соединения вместе с согласованием ключей занимает один RTT, а при повторном подключении к знакомому серверу возможна отправка данных уже в первом пакете (0-RTT);
- соединение идентифицируется не четвёркой «адреса и порты», а идентификатором соединения (англ. connection ID), поэтому при смене адреса клиента — переходе телефона с Wi-Fi на мобильную сеть, смене порта после перезапуска трансляции NAT — соединение продолжается без нового рукопожатия; это называется миграцией соединения (англ. connection migration);
- обнаружение потерь и управление перегрузкой (RFC 9002) наследуют идеи TCP, но номера пакетов никогда не повторяются, даже для повторной передачи, что устраняет неоднозначность измерения RTT, известную в TCP.
Схема на рисунке ниже сравнивает число круговых обходов до получения первого ответа для TCP с TLS 1.3 и для QUIC.
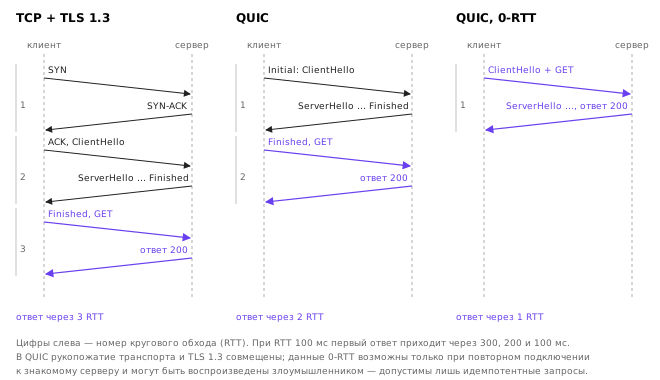
Числовой пример. При RTT 100 мс (пользователь в другой части континента) первый ответ по HTTPS поверх TCP и TLS 1.3 приходит не раньше чем через 300 мс, по TLS 1.2 — через 400 мс, по QUIC — через 200 мс, по QUIC с 0-RTT — через 100 мс. Данные 0-RTT имеют ограничение: злоумышленник может перехватить и повторно отправить такой пакет, поэтому в 0-RTT допустимы только запросы, повтор которых безопасен, — в первую очередь идемпотентные GET (подробнее о повторах — в теме 17).
Перенос транспорта в UDP имеет и обратную сторону. Часть корпоративных сетей блокирует UDP-порт 443, и клиенты должны уметь возвращаться к TCP. Обработка UDP в ядрах ОС исторически оптимизирована хуже, чем TCP, и реализация QUIC в пространстве пользователя расходует больше процессорного времени на байт. Для защиты от использования в атаках с усилением сервер QUIC до подтверждения адреса клиента может отправить не более чем втрое больше данных, чем получил, а первый пакет клиента дополняется до 1200 байт 6.
HTTP/3 и QPACK
HTTP/3 (RFC 9114, 2022) — отображение семантики HTTP на транспорт QUIC 7. Каждый запрос и ответ передаются в отдельном двунаправленном потоке QUIC кадрами HEADERS и DATA, похожими на кадры HTTP/2, но без номера потока: его роль играет поток QUIC. Управление потоком данных, мультиплексирование и надёжная доставка перешли в транспорт, и HTTP/3 устроен проще HTTP/2. Однонаправленные потоки используются для служебных целей: управляющий поток с кадром SETTINGS и потоки кодировщика и декодировщика заголовков.
Сжатие заголовков в HTTP/3 выполняет QPACK (RFC 9204) 8. Он сохраняет идеи HPACK — статическую таблицу (в QPACK она расширена до 99 записей), динамическую таблицу и код Хаффмана, — но решает проблему порядка: обновления динамической таблицы передаются по отдельному однонаправленному потоку, а каждый блок заголовков указывает, какое состояние таблицы ему нужно. Кодировщик сам выбирает компромисс: ссылаться на ещё не подтверждённые записи (лучше сжатие, но возможно ожидание) или нет (поток никогда не блокируется).
Как клиент узнаёт, что сервер поддерживает HTTP/3, если первое соединение идёт по TCP? Существуют два способа. Первый — заголовок Alt-Svc (англ. alternative services, RFC 7838) в ответе HTTP/2 или HTTP/1.1: alt-svc: h3=":443"; ma=86400 означает, что тот же сервис доступен по HTTP/3 на UDP-порту 443, и эти сведения действительны сутки. Браузер запоминает это и следующее соединение пробует устанавливать по QUIC. Второй — запись HTTPS в DNS с параметром alpn="h3,h2" (тема 15), позволяющая использовать HTTP/3 уже при первом подключении. Реальные ответы крупных сайтов содержат такие заголовки:
HTTP/2 200
server: cloudflare
alt-svc: h3=":443"; ma=86400
Сводная таблица сравнивает три версии протокола.
| Свойство | HTTP/1.1 | HTTP/2 | HTTP/3 |
|---|---|---|---|
| Стандарт | RFC 9112 | RFC 9113 | RFC 9114 |
| Транспорт | TCP | TCP (на практике с TLS) | QUIC поверх UDP |
| Формат | текст | двоичные кадры | двоичные кадры |
| Запросов одновременно на соединение | 1 (конвейеризация не используется) | много (потоки) | много (потоки QUIC) |
| Блокировка начала очереди | на уровне HTTP и TCP | на уровне TCP | нет (только внутри потока) |
| Сжатие заголовков | нет | HPACK | QPACK |
| Шифрование | необязательно | фактически обязательно | всегда TLS 1.3 |
| Рукопожатие до первого запроса (с TLS 1.3) | 2 RTT | 2 RTT | 1 RTT (0 при 0-RTT) |
| Смена адреса клиента | разрыв соединения | разрыв соединения | миграция |
Прикладные протоколы поверх HTTP и рядом с ним
REST и программные интерфейсы
Термин REST (англ. Representational State Transfer) ввёл Рой Филдинг, один из авторов спецификации HTTP/1.1, в диссертации 2000 года для описания архитектурного стиля Веба 12. Его ограничения — модель «клиент — сервер», отсутствие состояния на сервере между запросами, кешируемость ответов, единообразный интерфейс (ресурсы, идентифицируемые URI, и манипуляция ими через представления), многоуровневая система с посредниками. На практике «REST API» обычно означает программный интерфейс поверх HTTP, в котором ресурсы адресуются путями, действия выражаются методами, а результаты — кодами состояния:
GET    /api/v1/hosts          — список узлов                 200
POST   /api/v1/hosts          — создать узел (тело — JSON)   201, Location: /api/v1/hosts/17
GET    /api/v1/hosts/17       — получить узел                200 или 404
PUT    /api/v1/hosts/17       — заменить узел целиком        200 или 204
DELETE /api/v1/hosts/17       — удалить узел                 204
Такой интерфейс автоматически получает всё, что даёт инфраструктура HTTP: кеширование ответов GET, повтор идемпотентных запросов, балансировку на уровне L7, стандартную аутентификацию через заголовок Authorization. Неудачные интерфейсы, передающие всё методом POST на один адрес и всегда отвечающие кодом 200 с описанием ошибки в теле, теряют эти преимущества. Наряду с REST широко используются GraphQL (язык запросов, передаваемых обычно методом POST) и gRPC — система удалённого вызова процедур поверх HTTP/2 с двоичной сериализацией Protocol Buffers, популярная для взаимодействия внутренних сервисов. Интерфейсы управления сетевым оборудованием RESTCONF и gNMI, рассматриваемые в теме 22, построены на тех же принципах.
WebSocket
HTTP устроен по схеме «запрос — ответ»: сервер не может отправить клиенту данные по своей инициативе. Для чатов, биржевых котировок, совместного редактирования документов нужен двунаправленный канал. До 2011 года эту задачу решали искусственно — периодическим опросом (англ. polling) или «долгим опросом» (англ. long polling), когда сервер задерживает ответ до появления данных. Протокол WebSocket (RFC 6455) предоставляет полноценный двунаправленный канал сообщений поверх одного соединения TCP 11.
Соединение WebSocket начинается как обычный запрос HTTP/1.1, просящий сменить протокол:
GET /chat HTTP/1.1
Host: server.example.com
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Key: dGhlIHNhbXBsZSBub25jZQ==
Sec-WebSocket-Version: 13

HTTP/1.1 101 Switching Protocols
Upgrade: websocket
Connection: Upgrade
Sec-WebSocket-Accept: s3pPLMBiTxaQ9kYGzzhZRbK+xOo=
Сервер подтверждает, что понял именно протокол WebSocket, а не просто вернул закешированный ответ: значение Sec-WebSocket-Accept — хеш SHA-1 от присланного ключа, сцепленного с фиксированной строкой 258EAFA5-E914-47DA-95CA-C5AB0DC85B11, в кодировке base64 (пример взят из RFC 6455) 11. После ответа 101 соединение перестаёт быть HTTP: по нему в обе стороны передаются кадры WebSocket с коротким заголовком (2–14 байт), содержащим тип (текст, двоичные данные, закрытие, ping, pong) и длину. Кадры от клиента маскируются случайным 32-битным ключом — это защита от отравления кешей промежуточных прокси, которые могли бы принять данные внутри соединения за запрос HTTP. Заголовок Upgrade относится к одному переходу, поэтому обратный прокси должен быть явно настроен на пересылку WebSocket — частая причина того, что WebSocket «не работает за nginx».
Электронная почта: SMTP, IMAP и защита отправителя
Электронная почта старше Веба и устроена иначе: письмо проходит через несколько серверов, каждый из которых хранит его и пересылает дальше (англ. store-and-forward). Протокол SMTP (англ. Simple Mail Transfer Protocol, RFC 5321) передаёт письма между серверами и от почтового клиента к серверу отправки 13. Как и HTTP/1.1, он текстовый и работает поверх TCP: сервер-отправитель находит по записи MX (тема 15) сервер получателя, подключается к нему на порт 25 и ведёт диалог командами EHLO, MAIL FROM, RCPT TO, DATA, завершая текст письма строкой из одной точки; каждая команда получает трёхзначный код ответа, похожий по смыслу на коды HTTP (2xx — успех, 4xx — временная ошибка, повторить позже, 5xx — постоянная ошибка). Клиенты отправляют почту на порт 587 с аутентификацией, а читают её с сервера по протоколу IMAP (порт 993 с TLS), при котором письма хранятся на сервере и синхронизируются между устройствами.
Важно различать конверт и заголовки письма. Адреса в командах MAIL FROM и RCPT TO — конверт, по которому письмо доставляется; заголовок From: внутри текста письма — то, что видит пользователь, и в исходном SMTP он ничем не проверяется. Это открыло путь массовой подделке отправителя, и три механизма, публикуемые владельцем домена в DNS в записях TXT, сейчас обязательны для надёжной доставки почты. SPF (RFC 7208) перечисляет адреса, с которых разрешено отправлять почту домена, — например, v=spf1 mx -all означает «только серверы из MX, остальные отвергать». DKIM (RFC 6376) добавляет к письму цифровую подпись заголовков и тела, открытый ключ для которой публикуется в DNS. DMARC (RFC 7489) связывает обе проверки с видимым адресом From: и сообщает получателю политику: что делать с письмом, не прошедшим проверку (ничего, поместить в спам, отвергнуть), и куда присылать отчёты.
SSH
Протокол защищённой оболочки (англ. Secure Shell, SSH; RFC 4251–4254) обеспечивает удалённый вход в систему и выполнение команд по зашифрованному каналу TCP на порту 22. Он состоит из трёх уровней: транспортного (согласование алгоритмов, обмен ключами по Диффи — Хеллману, аутентификация сервера по его ключу), аутентификации пользователя (по паролю или, предпочтительнее, по ключу) и уровня соединения, мультиплексирующего в одном соединении несколько каналов — сеанс оболочки, передачу файлов SFTP, перенаправление портов. В отличие от TLS, SSH обычно не использует сертификаты удостоверяющих центров: при первом подключении клиент показывает отпечаток ключа сервера и запоминает его в файле ~/.ssh/known_hosts (модель «доверие при первом использовании», англ. Trust On First Use, TOFU), а при изменении ключа выдаёт предупреждение о возможной атаке «человек посередине». Перенаправление портов SSH (ssh -L, ssh -D) превращает его в простой туннель; туннели и VPN рассматриваются в теме 19.
Синхронизация сетевого времени: протокол NTP
Наряду с именами (DNS) и адресами (DHCP), распределённым системам требуется общее представление о времени. Без точной синхронизации часов невозможны сопоставление событий в распределённых журналах, проверка срока действия сертификатов TLS, работа протокола аутентификации Kerberos и алгоритмы репликации баз данных. Эту задачу решает сетевой протокол времени (англ. Network Time Protocol, NTP; RFC 5905) 15, работающий поверх UDP на порту 123.
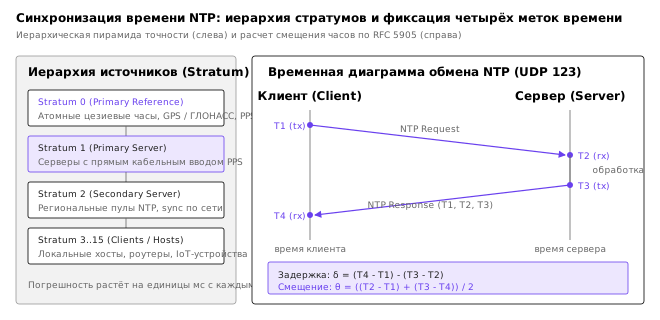
NTP организован как иерархическая сеть стратумов (англ. stratum):
- Stratum 0: первичные физические эталоны времени (атомные цезиевые часы, сигналы GPS/ГЛОНАСС), подключённые к серверу напрямую через последовательный порт или интерфейс импульса в секунду (PPS);
- Stratum 1: серверы точного времени, непосредственно подключённые к источникам Stratum 0;
- Stratum 2: серверы и рабочие станции, синхронизирующиеся по сети с серверами Stratum 1;
- Stratum N (до 15): каждый последующий уровень синхронизируется с уровнем N-1, накапливая небольшую систематическую погрешность (обычно единицы миллисекунд в глобальном Интернете и доли миллисекунды в локальной сети).
Для вычисления смещения часов клиент и сервер обмениваются 48-байтными пакетами, фиксируя четыре временные метки с 64-битной точностью (32 бита — секунды с 1 января 1900 года, 32 бита — доли секунды):
- T_1 — время отправки запроса клиентом (по часам клиента);
- T_2 — время приёма запроса сервером (по часам сервера);
- T_3 — время отправки ответа сервером (по часам сервера);
- T_4 — время приёма ответа клиентом (по часам клиента).
Круговая сетевая задержка (Round-Trip Delay) \delta и смещение часов клиента относительно сервера (Clock Offset) \theta рассчитываются по формулам:
\delta = (T_4 - T_1) - (T_3 - T_2), \qquad \theta = \frac{(T_2 - T_1) + (T_3 - T_4)}{2}
Временная диаграмма и иерархия стратумов приведены на схеме ниже.
Формула предполагает симметричность сетевого пути. Чтобы отсеять асимметрию и дрожание задержки (джиттер), клиент опрашивает несколько серверов и применяет алгоритм пересечения интервалов Марзулло, отбрасывая источники с аномальными показаниями. Для плавной корректировки времени операционная система использует дисциплину фазовой автоподстройки: вместо резких скачков назад, способных нарушить монотонность временных меток в базах данных, ход системных часов плавно замедляется или ускоряется с помощью системного вызова adjtimex (режим slewing). Для простых встраиваемых устройств и IoT-датчиков применяется облегчённая версия SNTP (Simple NTP, RFC 4330).
Одноранговые сети и распределённые оверлеи (Peer-to-Peer)
Все рассмотренные ранее протоколы (HTTP, DNS, SMTP) следуют парадигме «клиент — сервер»: централизованный сервер несёт на себе всю нагрузку по хранению и раздаче контента. При лавинообразном росте числа пользователей серверная инфраструктура становится узким местом.
Альтернативой является парадигма одноранговых сетей (Peer-to-Peer, P2P). В P2P-сети каждый узел (пир, англ. peer или servent от server + client) одновременно выступает и клиентом, потребляющим данные, и сервером, раздающим их другим участникам 16. При росте числа скачивающих совокупная пропускная способность сети не падает, а масштабируется вместе с числом участников.
Логическая топология P2P-сети строится поверх физического Интернета в виде оверлейной сети (Overlay Network). Эволюция оверлеев привела к созданию структурированных сетей на основе распределённых хеш-таблиц (DHT — Distributed Hash Table), обеспечивающих децентрализованный поиск ключей с логарифмической сложностью O(\log N).
Де-факто стандартом современных DHT стал алгоритм Kademlia 16, используемый в протоколе BitTorrent (Mainline DHT), сетях IPFS и Ethereum. В Kademlia узлам и файлам присваиваются 160-битные идентификаторы. Расстоянием между двумя узлами x и y считается побитовое исключающее ИЛИ:
d(x, y) = x \oplus y
Метрика XOR обладает свойствами строгого математического расстояния. Узел хранит контакты соседей в списках (k-бакетах), сгруппированных по расстояниям степеней двойки, что позволяет найти узел, ответственный за любой ключ, за \log_2 N шагов маршрутизации.
Примером высокоэффективного прикладного P2P-протокола является BitTorrent 17. Файл делится на равные куски (pieces) по 256 КиБ — 2 МБ, контрольные суммы которых заверяются в файле метаданных или magnet-ссылке (BTIH — BitTorrent Info Hash). Ключевые механизмы BitTorrent:
- Стратегия «самый редкий первым» (Rarest-First): пиры в первую очередь скачивают и раздают те куски, которые реже всего встречаются в рое (swarm), предотвращая деградацию распределения при уходе источников;
- Игровой механизм «око за око» (Tit-for-Tat): пир отдаёт данные с максимальной скоростью тем узлам, которые быстрее всего отдают данные ему самому, поощряя раздающих участников;
- Преодоление NAT (NAT Traversal): установление прямых P2P-соединений между узлами за трансляторами адресов через технику согласования портов (UDP Hole Punching).
Итоги темы
HTTP разделяет семантику и способ передачи. Семантика — ресурсы, идентифицируемые URI, методы с определёнными свойствами безопасности и идемпотентности, коды состояния, заголовки, правила кеширования — едина для всех версий и позволяет клиентам, серверам и посредникам взаимодействовать, не зная устройства друг друга. На этой основе построены программные интерфейсы REST, а механизм cookies добавляет состояние поверх протокола без состояния.
HTTP/1.1 передаёт сообщения текстом поверх TCP и определяет длину тела через Content-Length или кодирование chunked. Постоянные соединения устраняют повторную подготовку соединения, но по каждому соединению запросы идут строго по очереди, а неудачная конвейеризация показала, что упорядоченные ответы порождают блокировку начала очереди. Браузеры компенсируют это параллельными соединениями, и время загрузки страницы со многими ресурсами определяется прежде всего числом круговых обходов, а не пропускной способностью.
Кеширование уменьшает и задержку, и нагрузку: свежий ответ выдаётся без обращения к серверу, а устаревший проверяется условным запросом с ETag и подтверждается кодом 304 без тела. Посредники — прямые и обратные прокси, балансировщики уровней L4 и L7, сети доставки контента — составляют неотъемлемую часть Веба, и протокол учитывает их явно: заголовками hop-by-hop, Via, X-Forwarded-For, директивами для общих кешей. Неаккуратное доверие этим заголовкам и расхождения в определении длины сообщения — источник реальных уязвимостей.
HTTP/2 ввёл двоичные кадры и мультиплексирование потоков в одном соединении, а сжатие HPACK сократило накладные расходы заголовков; но блокировка начала очереди осталась на уровне TCP. HTTP/3 переносит HTTP на новый транспорт QUIC поверх UDP со встроенным TLS 1.3, независимыми потоками, рукопожатием в один RTT и миграцией соединения. Шифрование, на котором держатся HTTPS, QUIC, DoH и SSH, — предмет следующей темы, посвящённой криптографическим примитивам, инфраструктуре открытых ключей и протоколу TLS.
Литература
- Fielding R., Nottingham M., Reschke J. HTTP Semantics. — RFC 9110, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9110
- Fielding R., Nottingham M., Reschke J. HTTP Caching. — RFC 9111, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9111
- Fielding R., Nottingham M., Reschke J. HTTP/1.1. — RFC 9112, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9112
- Thomson M., Benfield C. HTTP/2. — RFC 9113, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9113
- Peon R., Ruellan H. HPACK: Header Compression for HTTP/2. — RFC 7541, IETF, 2015. https://www.rfc-editor.org/rfc/rfc7541
- Iyengar J., Thomson M. QUIC: A UDP-Based Multiplexed and Secure Transport. — RFC 9000, IETF, 2021. https://www.rfc-editor.org/rfc/rfc9000
- Bishop M. HTTP/3. — RFC 9114, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9114
- Krasic C., Bishop M., Frindell A. QPACK: Field Compression for HTTP/3. — RFC 9204, IETF, 2022. https://www.rfc-editor.org/rfc/rfc9204
- Berners-Lee T., Fielding R., Masinter L. Uniform Resource Identifier (URI): Generic Syntax. — RFC 3986, IETF, 2005. https://www.rfc-editor.org/rfc/rfc3986
- Barth A. HTTP State Management Mechanism. — RFC 6265, IETF, 2011. https://www.rfc-editor.org/rfc/rfc6265
- Fette I., Melnikov A. The WebSocket Protocol. — RFC 6455, IETF, 2011. https://www.rfc-editor.org/rfc/rfc6455
- Fielding R. T. Architectural Styles and the Design of Network-based Software Architectures. — Doctoral dissertation, University of California, Irvine, 2000. https://ics.uci.edu/~fielding/pubs/dissertation/top.htm
- Klensin J. Simple Mail Transfer Protocol. — RFC 5321, IETF, 2008. https://www.rfc-editor.org/rfc/rfc5321
- Thomson M., Turner S. Using TLS to Secure QUIC. — RFC 9001, IETF, 2021. https://www.rfc-editor.org/rfc/rfc9001
- Mills D., Martin J., Burbank J., Kasch W. Network Time Protocol Version 4: Protocol and Algorithms Specification. — RFC 5905, IETF, 2010. https://www.rfc-editor.org/rfc/rfc5905
- Maymounkov P., Mazières D. Kademlia: A Peer-to-Peer Information System Based on the XOR Metric. — First International Workshop on Peer-to-Peer Systems (IPTPS '02), Lecture Notes in Computer Science, 2002, Vol. 2429, С. 53–65.
- Cohen B. Incentives Build Robustness in BitTorrent. — Workshop on Economics of Peer-to-Peer Systems, 2003.