
Межсетевые экраны и сетевая безопасность
В предыдущих темах сеть рассматривалась как механизм доставки: коммутатор пересылает кадр, маршрутизатор — пакет, TCP гарантирует доставку потока байтов, DNS превращает имя в адрес. Каждый из этих механизмов проектировался в расчёте на добросовестных участников. Адрес источника в заголовке IP никем не проверяется, ответ ARP принимается без доказательства его подлинности, а TCP-сервер выделяет ресурсы любому, кто прислал сегмент SYN. В теме 17 было показано, как криптография защищает содержимое соединения: TLS обеспечивает конфиденциальность, целостность и подлинность сервера. Однако TLS ничего не говорит о том, кому вообще разрешено устанавливать соединение с сервером базы данных, и не мешает чужому узлу заполнить очередь входящих соединений веб-сервера.
Тема посвящена второй половине сетевой безопасности — управлению доступом и потоками. Центральное средство здесь — межсетевой экран (англ. firewall): узел или функция ядра, который пропускает или отбрасывает пакеты в соответствии с явно записанной политикой. Вокруг него строятся сегментация сети на зоны доверия, демилитаризованная зона для публичных сервисов, ограничение частоты запросов и журналирование. Экран реализует политику, а политика выводится из модели угроз, поэтому изложение идёт от принципов к устройству экранов и их реализации в Linux (netfilter и nftables), затем к зонам и DMZ, типовым угрозам и обнаружению вторжений.
Угрозы рассматриваются с позиции защищающейся стороны: каков механизм, по каким признакам его можно заметить и какие меры ему противостоят. Трансляция адресов (NAT), которая в Linux реализуется тем же netfilter, разобрана в теме 14 и здесь лишь упоминается; защищённые туннели и VPN — предмет темы 19.
Модель угроз и принципы защиты сети
Активы, нарушители и поверхность атаки
Безопасность всегда определяется относительно чего-то: защищать «сеть вообще» невозможно, потому что непонятно, от кого и ценой каких ограничений. Модель угроз (англ. threat model) отвечает на три вопроса. Первый — какие активы защищаются: данные клиентов в базе, доступность интернет-магазина, учётные записи администраторов. Второй — каковы свойства, которые нужно сохранить; классическая триада — конфиденциальность (англ. confidentiality), целостность (англ. integrity) и доступность (англ. availability), сокращённо CIA. Третий — кто нарушитель и каковы его возможности: внешний узел в Интернете, который может отправить любой пакет на публичный адрес; узел внутри локальной сети, который может отправить любой кадр в свой сегмент; администратор, ошибившийся в конфигурации.
Для «Северного узла» из сквозного примера курса модель угроз выглядит так. Порты 80 и 443 публичного веб-сайта открыты для всех, и нарушитель может отправлять на них что угодно. База данных и служба удалённого управления по SSH должны быть недоступны снаружи: их компрометация означает утечку данных или полный захват сервера. Рабочие места сотрудников обращаются в Интернет, но никто извне не должен устанавливать с ними соединения. Наконец, сотрудник или заражённый ноутбук внутри офиса — тоже возможный нарушитель, хотя и с другими возможностями.
Поверхность атаки (англ. attack surface) — совокупность точек, через которые нарушитель может взаимодействовать с системой. На сетевом уровне это множество пар «адрес — порт», до которых доходят пакеты нарушителя, плюс сами сетевые протоколы, обрабатываемые ядром (ARP, ICMP, разбор заголовков). Каждый открытый порт — это программа, разбирающая данные чужого узла. Отсюда основная инженерная цель сетевой защиты: сделать поверхность атаки минимальной и известной. Межсетевой экран решает именно эту задачу — он определяет, какие пары «источник — назначение — сервис» вообще достижимы.
Минимальные привилегии и политика «запрещено всё, что не разрешено»
Принцип минимальных привилегий (англ. principle of least privilege) сформулирован Зальцером и Шрёдером в 1975 году: каждая программа и каждый пользователь должны обладать лишь теми правами, которые необходимы для выполнения их задачи 12. В той же работе сформулирован родственный принцип умолчаний, безопасных при отказе (англ. fail-safe defaults): решение о доступе должно основываться на явном разрешении, а не на явном запрете, поскольку ошибка в списке разрешений проявляется как отказ в доступе и быстро замечается, а ошибка в списке запретов проявляется как незамеченная брешь 12.
В применении к межсетевым экранам эти принципы дают политику «запрещено всё, что не разрешено явно» (англ. default deny). Чесвик и Белловин, авторы одной из первых книг о межсетевых экранах, называют её единственной разумной отправной точкой: список того, что нужно, конечен и известен администратору, а список того, что опасно, бесконечен и пополняется каждый день 1. Рекомендации NIST по межсетевым экранам предписывают то же самое: входящий трафик, не разрешённый политикой явно, должен блокироваться, а политика должна описывать как входящие, так и исходящие потоки 2.
Противоположная политика «разрешено всё, что не запрещено» (англ. default allow) кажется удобнее, но страдает от асимметрии ошибок. Забытый отладочный сервис на порту 8080 при такой политике оказывается доступен из Интернета незаметно, а при default deny он просто не работает снаружи, и ошибка обнаруживается сразу.
Минимальные привилегии касаются и исходящего трафика. Веб-серверу, который только отвечает на запросы, незачем самому устанавливать соединения в Интернет. Если такой сервер скомпрометирован, запрет исходящих соединений мешает нарушителю загрузить инструменты и передать данные наружу. Фильтрацию исходящего трафика называют egress-фильтрацией; NIST рекомендует применять её наряду с фильтрацией входящего 2.
Эшелонированная защита и границы её возможностей
Ни одна мера защиты не безупречна: в правилах межсетевого экрана бывают ошибки, в программах — уязвимости, у пользователей — слабые пароли. Эшелонированная защита (англ. defense in depth) предполагает несколько независимых рубежей, так что прорыв одного не означает полной компрометации. Для веб-сервера «Северного узла» рубежи выглядят так: пограничный межсетевой экран пропускает к серверу только HTTP и HTTPS; локальный межсетевой экран на самом сервере дублирует это правило; веб-приложение работает от непривилегированного пользователя; база данных принимает соединения только с адреса веб-сервера и требует пароль; все действия журналируются, а журналы уходят на отдельный сервер, недоступный из DMZ.
Важно понимать, чего межсетевой экран не делает. Он решает, какие пакеты доходят до сервиса, но не проверяет, безопасно ли содержимое разрешённых пакетов: SQL-инъекция приходит в обычном HTTPS-запросе на разрешённый порт 443. Он не защищает от нарушителя, находящегося по ту же сторону экрана, что и цель, и от вредоносной программы, устанавливающей разрешённое исходящее соединение. Экран уменьшает число мест, где нужна тщательная защита, но не заменяет её 1.
Межсетевые экраны: от пакетного фильтра к NGFW
Пакетный фильтр без состояния
Простейший межсетевой экран — пакетный фильтр без состояния (англ. stateless packet filter). Он рассматривает каждый пакет независимо от остальных и принимает решение по полям заголовков: адресам источника и назначения, протоколу, портам, флагам TCP, входному и выходному интерфейсу. Политика записывается упорядоченным списком правил вида «условие — действие», и для пакета применяется первое совпавшее правило; если не совпало ни одно, применяется политика по умолчанию. Так работали списки доступа (ACL) маршрутизаторов конца 1980-х годов, и так до сих пор работают ACL на коммутаторах и маршрутизаторах.
Рассмотрим, как разрешить сотрудникам открывать внешние сайты. Запрос идёт от адреса 192.168.18.10 с эфемерного порта, например 45678, на адрес 203.0.113.10, порт 80. Правило для запроса очевидно: «из LAN на любой адрес, TCP, порт назначения 80 — пропустить». Но ответ сервера идёт в обратную сторону — с порта 80 на порт 45678, и для него нужно второе правило. Фильтр без состояния не знает, что этот пакет — ответ на разрешённый запрос, поэтому правило придётся записать как «из Интернета в LAN, TCP, порт источника 80, порт назначения выше 1023 — пропустить». Такое правило пропускает любой пакет нарушителя, отправленный с порта 80 на любой высокий порт внутренней сети, то есть открывает внутреннюю сеть шире, чем требуется.
Приём смягчения — проверять флаг ACK: первый сегмент TCP-соединения (SYN) его не имеет, а все последующие имеют. Правило «из Интернета пропускать только сегменты с ACK» не даёт извне начать соединение, но не мешает отправлять сегменты с ACK, не относящиеся ни к какому соединению; для UDP и ICMP подобного признака нет вовсе 1. Ещё одна трудность — фрагментация (тема 7): номера портов есть только в первом фрагменте, и фильтру приходится либо пропускать последующие фрагменты вслепую, либо собирать пакет.
Достоинства фильтра без состояния — скорость и отсутствие памяти, которую можно исчерпать, поэтому ACL без состояния применяются на магистральных маршрутизаторах, в частности для фильтрации адресов источника по BCP 38.
Фильтр с отслеживанием состояния
Межсетевой экран с отслеживанием состояния (англ. stateful firewall) хранит таблицу соединений. Когда первый пакет нового потока разрешён политикой, экран создаёт запись, в которой записан набор из пяти полей (англ. 5-tuple): протокол, адреса и порты источника и назначения, — и вычисляет, как будет выглядеть ответный пакет (адреса и порты меняются местами). Все последующие пакеты сначала сверяются с таблицей. Пакет, принадлежащий известному соединению в любом направлении, пропускается одним общим правилом, а политика пишется только для новых соединений.
Тот же пример с веб-сайтом записывается теперь двумя строками: «пакеты известных соединений — пропустить» и «новое соединение из LAN на TCP-порт 80 — пропустить». Ответ сервера проходит потому, что он принадлежит соединению, которое начал внутренний узел; пакет нарушителя с порта 80 на высокий порт отбрасывается, потому что такого соединения в таблице нет. Политика описывает намерение, а не его следствия для отдельных пакетов.
Отслеживание состояния распространяется и на протоколы без соединений. Для UDP запись создаётся по первой датаграмме, а ответные датаграммы с переставленными адресами и портами считаются частью того же «соединения», пока не истечёт тайм-аут неактивности. Для ICMP эхо-запрос и эхо-ответ сопоставляются по идентификатору. Особую роль играют сообщения об ошибках ICMP — «адресат недостижим», «время жизни истекло», «требуется фрагментация»: они несут внутри себя заголовок исходного пакета, и экран по нему находит соединение, к которому относится ошибка. Такие пакеты называют связанными (англ. related). Их пропуск критически важен: если экран отбрасывает сообщения «требуется фрагментация», ломается определение MTU пути (тема 7), и соединения зависают на больших пакетах.
Цена состояния — память и уязвимость к её исчерпанию. Каждая запись занимает сотни байтов, таблица имеет предельный размер, и если нарушитель создаёт новые записи быстрее, чем истекают старые, таблица переполняется и экран перестаёт принимать новые соединения легитимных пользователей. Эта угроза рассматривается ниже вместе с атакой SYN flood.
Прикладные шлюзы, прокси и межсетевые экраны нового поколения
Фильтр видит заголовки до транспортного уровня, но не понимает протокол приложения. Прикладной шлюз (англ. application-level gateway), или прокси (англ. proxy), работает иначе: клиент устанавливает соединение с прокси, прокси разбирает запрос на уровне протокола (HTTP, SMTP, DNS), проверяет его по политике и сам устанавливает второе соединение с сервером. Между внутренней и внешней сетью нет сквозного TCP-соединения, и любой пакет, дошедший до сервера, сформирован программой прокси, а не нарушителем. Чесвик и Белловин описывают такие шлюзы как наиболее надёжный, но и наиболее трудоёмкий тип экрана: для каждого протокола нужна своя программа, и каждая сама становится поверхностью атаки 1. В современной сети прикладные шлюзы — это прямые прокси для выхода сотрудников в Интернет и обратные прокси перед веб-серверами (тема 16), к которым часто добавляется фильтр веб-приложений (англ. web application firewall, WAF).
Межсетевой экран нового поколения (англ. next-generation firewall, NGFW) — маркетинговый, но устоявшийся термин для устройства, совмещающего фильтр с отслеживанием состояния, распознавание приложений по содержимому потока независимо от номера порта, систему предотвращения вторжений и привязку правил к пользователям, а не к адресам. Для анализа зашифрованного трафика такие устройства вынуждены либо ограничиваться метаданными (именем сервера SNI), либо расшифровывать трафик, выступая доверенным посредником 2.
Сравнение типов межсетевых экранов приведено в таблице.
| Тип | Что анализирует | Состояние | Сильные стороны | Ограничения |
|---|---|---|---|---|
| Пакетный фильтр без состояния | заголовки IP, TCP/UDP, интерфейсы | нет | скорость, нет таблицы для исчерпания | правила для ответов слишком широки |
| Фильтр с отслеживанием состояния | то же плюс принадлежность соединению | таблица соединений | точная политика для новых соединений | таблица ограничена, не видит приложения |
| Прикладной шлюз, прокси | сообщения протокола приложения | сессии приложения | контроль содержимого, нет сквозного соединения | своя программа на каждый протокол, задержка |
| NGFW | приложение по содержимому, пользователь, сигнатуры | всё перечисленное | одна точка контроля и наблюдения | сложность, стоимость, шифрование ограничивает анализ |
Отбросить или отклонить
У межсетевого экрана два способа не пропустить пакет. Действие drop молча уничтожает пакет: отправитель не получает ничего и через тайм-аут повторяет попытку. Действие reject уничтожает пакет и отправляет отправителю уведомление — сегмент TCP RST или сообщение ICMP «адресат недостижим» с кодом «запрещено администратором».
Выбор влияет и на удобство, и на то, что видит внешний наблюдатель. Для легитимного клиента reject лучше: программа сразу получает ошибку Connection refused или No route to host вместо зависания на десятки секунд. Для внешней границы чаще выбирают drop: нарушитель, проверяющий порты, не получает ответа и вынужден ждать тайм-аута на каждой попытке, а сам экран не тратит ресурсы на генерацию ответов — что существенно, если адрес источника подделан и ответы ушли бы третьему лицу. Разница хорошо видна при проверке политики: порт за reject с ответом TCP RST или ICMP «порт недостижим» выглядит «закрытым», порт за reject с кодом «запрещено администратором» и порт за drop — «фильтруемыми», и по этому различию можно понять, где именно и каким правилом остановлен пакет.
netfilter и nftables в Linux
Хуки netfilter и путь пакета через ядро
В ядре Linux фильтрация пакетов, трансляция адресов и отслеживание соединений построены на подсистеме netfilter. Её идея — набор хуков (англ. hooks), точек на пути пакета через сетевой стек, в которых зарегистрированные модули могут осмотреть пакет и вынести вердикт: пропустить, отбросить, поставить в очередь для программы пользователя 7. Для IPv4 и IPv6 определено пять хуков, а их расположение определяется тем, куда направляется пакет.
prerouting— сразу после приёма пакета, до решения о маршрутизации. Здесь выполняется трансляция адреса назначения (DNAT, тема 14) и создаётся запись conntrack для нового потока.input— пакет адресован самому узлу и будет передан локальному сокету.forward— пакет транзитный: узел работает маршрутизатором и пересылает пакет на другой интерфейс.output— пакет порождён локальным процессом.postrouting— последняя точка перед отправкой в интерфейс; здесь выполняется трансляция адреса источника (SNAT, маскарадинг).
В семействе netdev есть ещё хук ingress, срабатывающий сразу после драйвера. Схема на рисунке ниже показывает три возможных пути пакета: входящий к локальному процессу, транзитный и исходящий от локального процесса.
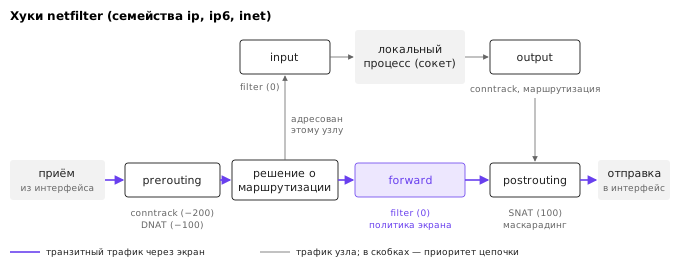
Отсюда первое практическое следствие: межсетевой экран, стоящий между сетями, фильтрует в цепочке forward, а защита самого экрана (например, его службы SSH) — в цепочке input. Частая ошибка начинающих — написать правила для веб-сервера DMZ в input и удивляться, что они не действуют: пакеты к серверу через экран транзитные и в input не попадают.
В одном хуке может быть зарегистрировано несколько цепочек; порядок их вызова задаётся числовым приоритетом, меньшее значение срабатывает раньше. Отслеживание соединений регистрируется с приоритетом −200, трансляция адреса назначения — −100, фильтрация (ключевое слово filter) — 0, трансляция адреса источника — 100 7. Поэтому к моменту фильтрации пакет уже сопоставлен с записью conntrack, а после DNAT фильтр видит уже новый адрес назначения.
Отслеживание соединений: conntrack и его состояния
Подсистема отслеживания соединений (англ. connection tracking, conntrack) хранит таблицу потоков, проходящих через узел, и каждому пакету присваивает состояние относительно этой таблицы 8. В правилах доступны следующие состояния.
new— пакет начинает поток, которого ещё нет в таблице (для TCP — обычно сегмент SYN).established— пакет принадлежит потоку, в котором уже наблюдались пакеты в обоих направлениях; к этому же состоянию относятся и последующие пакеты исходного направления.related— пакет начинает новый поток или является сообщением об ошибке ICMP, но связан с уже существующим соединением: ICMP-ошибка, несущая заголовок пакета известного соединения, или канал данных FTP, ожидаемый по командам канала управления.invalid— пакет не удаётся отнести ни к одному потоку или он противоречит состоянию соединения: например, сегмент TCP с недопустимым сочетанием флагов (SYN вместе с FIN или RST) или сегмент с номером последовательности далеко за пределами окна.untracked— пакет явно исключён из отслеживания правиломnotrack.
Важно не путать состояния conntrack с состояниями конечного автомата TCP из темы 12. Состояние established в conntrack наступает, как только экран увидел ответ, — для TCP это сегмент SYN+ACK, то есть ещё до завершения тройного рукопожатия. Внутри записи для TCP conntrack ведёт и собственный автомат (SYN_SENT, SYN_RECV, ESTABLISHED, FIN_WAIT, TIME_WAIT и т. д.), от которого зависят тайм-ауты записи. Временная диаграмма на рисунке ниже показывает, как меняется состояние при установлении соединения через экран.
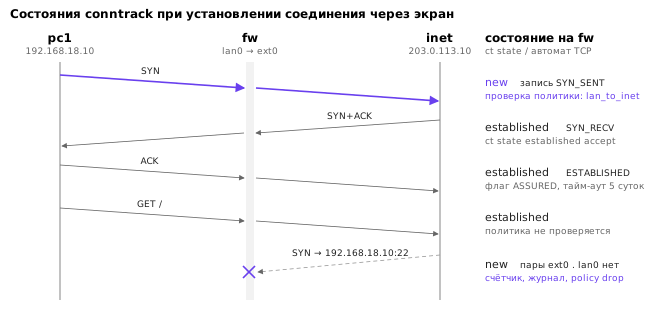
Содержимое таблицы можно увидеть утилитой conntrack из пакета conntrack-tools.
# на межсетевом экране: показать отслеживаемые соединения TCP
conntrack -L -p tcp
tcp      6 431995 ESTABLISHED src=192.168.18.10 dst=203.0.113.10 sport=45678 dport=80 src=203.0.113.10 dst=192.168.18.10 sport=80 dport=45678 [ASSURED] mark=0 use=1
tcp      6 118 SYN_SENT src=203.0.113.10 dst=198.51.100.10 sport=51022 dport=22 [UNREPLIED] src=198.51.100.10 dst=203.0.113.10 sport=22 dport=51022 mark=0 use=1
Разберём первую строку. tcp 6 — протокол и его номер в заголовке IP. Число 431995 — оставшееся время жизни записи в секундах; для установленного TCP-соединения в Linux по умолчанию задано 432000 секунд, то есть пять суток, и отсчёт сбрасывается каждым пакетом 14. Далее — внутреннее состояние автомата TCP. Первая группа адресов и портов описывает исходное направление (англ. original), вторая — ожидаемое обратное (англ. reply). Если бы на экране работал маскарадинг, вторая группа содержала бы публичный адрес экрана вместо 192.168.18.10 — именно так NAT из темы 14 «вспоминает», кому вернуть ответ. Флаг ASSURED означает, что трафик наблюдался в обоих направлениях и запись не будет вытеснена первой при переполнении таблицы. Вторая строка — попытка соединения, на которую ответа не было (UNREPLIED): запись проживёт 120 секунд и исчезнет.
Основные параметры таблицы задаются переменными sysctl в net.netfilter 14. Некоторые значения по умолчанию сведены в таблицу; конкретные числа зависят от версии ядра, поэтому их стоит сверять с sysctl -a | grep conntrack на своей системе.
| Параметр | Значение по умолчанию | Смысл |
|---|---|---|
nf_conntrack_max | вычисляется из объёма памяти | наибольшее число записей в таблице |
nf_conntrack_tcp_timeout_established | 432000 с (5 суток) | неактивное установленное TCP-соединение |
nf_conntrack_tcp_timeout_syn_sent | 120 с | SYN отправлен, ответа нет |
nf_conntrack_udp_timeout | 30 с | UDP-поток с ответом в одну сторону |
nf_conntrack_udp_timeout_stream | 120 с | UDP-поток с обменом в обе стороны |
Когда таблица заполнена, ядро пытается вытеснить запись без флага ASSURED, а если это не удаётся, отбрасывает новый пакет и пишет в журнал ядра сообщение nf_conntrack: table full, dropping packet. Оно говорит о потоке новых соединений или о слишком малой таблице.
Язык nftables: таблицы, цепочки, правила, наборы
Исторически правила netfilter задавались утилитой iptables (и отдельными ip6tables, arptables, ebtables), в которой каждая таблица и цепочка были зашиты в ядро. С 2014 года в ядре есть nftables — новый каркас, в котором ядро предоставляет небольшую виртуальную машину для классификации пакетов, а вся структура политики определяется пользователем 7. Утилита nft пишет политику на едином языке для IPv4, IPv6, ARP и мостов. В современных дистрибутивах команда iptables — это обычно iptables-nft, транслирующая старый синтаксис в правила nftables; утилита iptables-translate показывает, как старое правило записывается на новом языке.
Объекты nftables образуют иерархию. Таблица (англ. table) — контейнер, принадлежащий семейству: ip, ip6, inet (IPv4 и IPv6 вместе), arp, bridge, netdev. Цепочка (англ. chain) — упорядоченный список правил; базовая цепочка привязана к хуку и имеет тип, приоритет и политику по умолчанию, а обычная цепочка вызывается из других правил переходом jump или goto и служит для структурирования. Правило (англ. rule) состоит из выражений-условий и операторов (англ. statements): accept, drop, reject, jump, counter, log, limit и т. д. Правило, у которого все условия истинны, выполняет операторы слева направо; вердикт accept или drop завершает обработку пакета в данной базовой цепочке.
Минимальная политика узла, принимающего только SSH и ICMP-эхо, выглядит так.
table inet host {
    chain input {
        type filter hook input priority filter; policy drop;
        iif "lo" accept
        ct state established,related accept
        ct state invalid drop
        tcp dport 22 ct state new counter accept
        icmp type echo-request limit rate 5/second accept
        icmpv6 type { nd-neighbor-solicit, nd-neighbor-advert, echo-request } accept
    }
}
Порядок правил здесь существенен. Первым разрешается интерфейс lo: многие программы общаются с собой через 127.0.0.1, и его блокировка ломает их непредсказуемым образом. Вторым — пакеты известных соединений; это правило срабатывает для подавляющего большинства пакетов, и его раннее положение экономит процессорное время. Строка для ICMPv6 нужна потому, что обнаружение соседей в IPv6 (тема 11) идёт через ICMPv6.
Сильная сторона nftables — наборы (англ. sets) и словари (англ. maps). Набор — это множество значений одного типа, проверка принадлежности к которому выполняется за время, почти не зависящее от размера набора (используется хеш-таблица или дерево интервалов). Вместо сотни правил «запретить адрес X» пишется одно правило ip saddr @blocklist drop, а адреса добавляются и удаляются командами nft add element без перезагрузки политики. Наборы бывают анонимными (tcp dport { 80, 443 }) и именованными, могут содержать интервалы и префиксы (флаг interval), элементы с тайм-аутом (флаг timeout) и составные ключи, записываемые через точку: ip saddr . tcp dport. Словарь вердиктов (англ. verdict map, vmap) сопоставляет ключу действие, что позволяет одним правилом выбрать цепочку по паре интерфейсов:
iifname . oifname vmap {
    "lan0" . "ext0" : jump lan_to_inet,
    "lan0" . "dmz0" : jump lan_to_dmz,
    "ext0" . "dmz0" : jump inet_to_dmz
}
Такая запись прямо отражает матрицу «из какой зоны — в какую зону» (о ней — в следующем разделе), и каждой ячейке матрицы соответствует своя короткая цепочка. Пакет, для которого в словаре нет ключа, продолжает обработку следующим правилом и в итоге попадает под политику drop.
Политика загружается из файла командой nft -f, и загрузка атомарна: ядро либо принимает весь файл, либо, при ошибке в любой строке, оставляет старую политику нетронутой. Файл обычно начинается строкой flush ruleset, удаляющей прежние правила, — благодаря атомарности между удалением старых и добавлением новых правил нет момента, когда экран открыт.
Счётчики, журналирование и ограничение частоты
Оператор counter подсчитывает пакеты и байты, прошедшие через правило. Счётчики — главный инструмент отладки политики: если после обращения клиента счётчик разрешающего правила не изменился, а счётчик правила перед политикой drop вырос, причина отказа найдена. Просмотр — nft list ruleset или nft list chain inet filter forward; обнуление — nft reset counters.
Оператор log записывает сведения о пакете в журнал ядра (dmesg, journalctl -k) с заданным префиксом:
fw-fwd-drop: IN=ext0 OUT=lan0 MAC=... SRC=203.0.113.10 DST=192.168.18.10 LEN=60 TOS=0x00 PREC=0x00 TTL=63 ID=8812 DF PROTO=TCP SPT=51034 DPT=22 WINDOW=64240 RES=0x00 SYN URGP=0
Из такой строки видно, через какие интерфейсы шёл пакет, кто и куда пытался подключиться, и какие флаги TCP были установлены (здесь SYN — попытка нового соединения). Журналирование каждого отброшенного пакета само может стать проблемой: поток мусорного трафика превращается в поток записей на диск. Поэтому перед log обычно ставят ограничение частоты, а в нагруженных системах журналируют через log group N в программу пользователя (например, ulogd2), которая агрегирует записи. Для отладки отдельного пакета удобнее трассировка: правило meta nftrace set 1 помечает пакеты, а команда nft monitor trace показывает, через какие цепочки и правила прошёл каждый помеченный пакет и каким вердиктом всё закончилось 7.
Оператор limit реализует ограничение частоты алгоритмом маркерного ведра (англ. token bucket). В ведро ёмкостью burst маркеров маркеры поступают с постоянной скоростью rate; каждый пакет забирает один маркер, а если ведро пусто, условие limit ложно (или, в форме limit rate over, истинно). Разберём численный пример для правила limit rate over 10/second burst 20 packets drop, применённого к новым соединениям с одного адреса. В начальный момент ведро полно: 20 маркеров. Пусть клиент открывает соединения со скоростью 50 в секунду, то есть каждые 20 мс. За первую секунду придёт 50 попыток, а маркеров будет 20 исходных плюс 10 пополненных — 30; первые примерно 30 попыток пройдут, остальные 20 будут отброшены. Во вторую и последующие секунды ведро пусто, и проходит ровно столько, сколько поступает маркеров, — 10 соединений в секунду, а 40 из 50 отбрасываются. Обычный пользователь, открывающий страницу с десятком ресурсов, укладывается в запас 20 и ограничения не замечает; источник, непрерывно создающий соединения, получает не больше 10 в секунду.
Если такое правило написать без привязки к источнику, ограничение будет общим для всех клиентов, и один шумный источник исчерпает лимит для всех остальных. Поэтому ограничение привязывают к адресу источника с помощью динамического набора: оператор update @meter { ip saddr limit rate over 10/second burst 20 packets } заводит отдельное ведро для каждого адреса, а флаг timeout набора удаляет вёдра неактивных адресов. Лабораторная работа 18 проверяет такое правило на практике.
Сегментация сети и зоны доверия
Зоны и матрица потоков
Плоская сеть, в которой любой узел может связаться с любым, удобна, но означает, что компрометация одного узла даёт нарушителю доступ ко всем остальным. Сегментация (англ. network segmentation) делит сеть на зоны — группы узлов со сходными требованиями к безопасности и сходным уровнем доверия — и пропускает трафик между зонами только через точки контроля, где действует политика. Внутри зоны трафик обычно не фильтруется, между зонами — фильтруется по принципу минимальных привилегий 2.
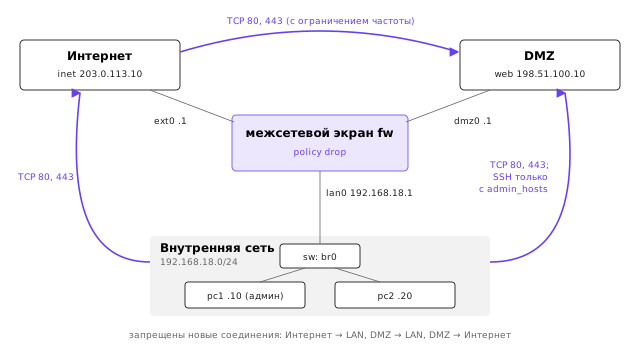
Технически зоны создаются средствами, изученными ранее: отдельными подсетями IP (тема 6), виртуальными локальными сетями (тема 5), отдельными физическими сегментами. Граница зон проходит через маршрутизатор или межсетевой экран, и в его правилах зона удобно выражается интерфейсом, через который она подключена. Политика между зонами записывается матрицей потоков: строки — зона-источник, столбцы — зона назначения, в ячейке — какие новые соединения разрешены. Для «Северного узла» матрица выглядит так.
| Откуда / куда | Интернет | DMZ | Внутренняя сеть | Сам экран |
|---|---|---|---|---|
| Интернет | — | TCP 80, 443 к веб-серверу | запрещено | запрещено |
| DMZ | запрещено (кроме обновлений через прокси, если нужно) | — | запрещено | запрещено |
| Внутренняя сеть | TCP 80, 443 | TCP 80, 443; SSH только с рабочих мест администраторов | — | SSH только с рабочих мест администраторов |
Матрица — это одновременно документ, понятный руководителю, и спецификация, по которой проверяются правила экрана: каждой непустой ячейке соответствует цепочка nftables, а пустые ячейки закрыты политикой drop. При аудите сравнивают не правила с правилами, а правила с матрицей. Ответные пакеты в матрице не указываются: они пропускаются отслеживанием состояния. В лабораторной работе матрица реализуется политикой из трёх частей: правило ct state established,related accept в цепочке forward, словарь iifname . oifname vmap, направляющий новые соединения в цепочку своей ячейки (lan_to_inet, lan_to_dmz, inet_to_dmz), и завершающие счётчик и журнал перед политикой drop.
Проследим несколько пакетов через такую политику. Сотрудник с адреса 192.168.18.20 открывает внешний сайт: сегмент SYN имеет состояние new, словарь направляет его в lan_to_inet, где порт 443 разрешён, а ответ сайта проходит как established. Тот же сотрудник пробует подключиться по SSH к веб-серверу: в цепочке lan_to_dmz SSH разрешён только адресам из набора admin_hosts, цепочка заканчивается без вердикта, обработка возвращается в forward, где срабатывают счётчик, журнал и политика drop. Пар ext0 . lan0 и dmz0 . ext0 в словаре нет, и во втором случае это особенно важно: если веб-сервер скомпрометирован и пытается открыть соединение наружу, оно не устанавливается, а запись в журнале с входным интерфейсом dmz0 становится серьёзным поводом для расследования.
Две ошибки в такой политике встречаются чаще прочих. Без правила ct state established,related accept SYN разрешённого соединения уходит, но ответный SYN+ACK отбрасывается политикой, и клиент видит тайм-аут, хотя «разрешающее правило есть». Правило чёрного списка, поставленное после разрешающего, для разрешённого трафика не срабатывает никогда: первое совпавшее правило с вердиктом accept завершает обработку.
Демилитаризованная зона
Публичный сервис — веб-сайт, почтовый шлюз, внешний DNS-сервер — по определению принимает соединения от любого узла Интернета и потому имеет наибольшую вероятность быть скомпрометированным. Размещать его во внутренней сети опасно: взломав веб-сервер, нарушитель окажется рядом с рабочими станциями и базами данных. Решение, описанное ещё в первых работах о межсетевых экранах, — демилитаризованная зона (англ. demilitarized zone, DMZ), или экранированная подсеть (англ. screened subnet): отдельный сегмент для публичных серверов, отделённый экраном и от Интернета, и от внутренней сети 1.
Ключевое свойство DMZ отражено в матрице: из DMZ во внутреннюю сеть новые соединения запрещены. Внутренние узлы могут обращаться к серверам DMZ, но не наоборот. Если веб-сервер нужно связать с внутренней базой данных, разрешается ровно одно направление и один порт («с адреса веб-сервера на адрес СУБД, TCP 5432»), а сама СУБД доступна только из этой точки. Тогда компрометация веб-сервера даёт нарушителю доступ к базе через уязвимость приложения, но не ко всей внутренней сети.
DMZ строится по одной из двух схем. В схеме с одним экраном и тремя интерфейсами (англ. three-legged firewall) все потоки проходят через одно устройство — так устроена учебная топология лабораторной работы, показанная на рисунке ниже. В схеме с двумя экранами внешний экран отделяет DMZ от Интернета, а внутренний — внутреннюю сеть от DMZ; для проникновения во внутреннюю сеть нарушителю нужно преодолеть оба, и если они разных производителей, одна уязвимость не открывает обоих. Первая схема дешевле и проще в сопровождении, вторая лучше соответствует идее эшелонированной защиты.
Микросегментация и модель нулевого доверия
Классическая модель «периметра» считает доверенным всё внутреннее. Она плохо выдерживает современные условия: сотрудники работают удалённо, сервисы живут в облаке, а нарушитель, получивший доступ к одному ноутбуку через фишинговое письмо, оказывается «внутри» и может свободно перемещаться по плоской внутренней сети (англ. lateral movement).
Микросегментация (англ. microsegmentation) доводит сегментацию до предела: политика задаётся не для подсетей, а для отдельных рабочих нагрузок — виртуальных машин, контейнеров, процессов. Правило вида «сервис заказов может обращаться к сервису оплаты на порт 8443» исполняется распределённо — локальным экраном на каждом узле или виртуальным коммутатором гипервизора (тема 21), — а не одним устройством на границе.
Модель нулевого доверия (англ. zero trust), описанная в стандарте NIST SP 800-207, обобщает эту идею: местоположение в сети само по себе не даёт никакого доверия 3. Каждый запрос к ресурсу проходит через точку применения политики (англ. policy enforcement point), которая спрашивает у механизма принятия решений (англ. policy decision point), допустим ли доступ данного субъекта с данного устройства к данному ресурсу именно сейчас. Решение учитывает пользователя, состояние устройства и чувствительность ресурса и принимается для каждой сессии 3. Межсетевой экран в такой архитектуре не исчезает, но перестаёт быть единственным рубежом: он ограничивает, какие точки применения политики вообще достижимы, а решение о доступе к данным принимается выше, с учётом идентичности.
Архитектура межсетевого экрана на основе зон (Zone-Based Policy Firewall)
В классической модели межсетевого экрана правила привязывались к конкретным интерфейсам («входящий трафик на eth0», «исходящий на eth1»). При росте числа интерфейсов и виртуальных сетей (VLAN) такая конфигурация экспоненциально усложняется: добавление нового интерфейса требует пересмотра сотен правил на всех остальных интерфейсах.
Архитектура Zone-Based Policy Firewall (ZBF) отвязывает правила фильтрации от интерфейсов и вводит абстракцию зон безопасности (англ. security zones) 15:
- Каждый сетевой интерфейс маршрутизатора или экрана назначается ровно в одну зону безопасности (например,
ZONE_INSIDE,ZONE_OUTSIDE,ZONE_DMZ). - Для интерфейсов, находящихся в одной зоне, трафик по умолчанию пересылается свободно без фильтрации.
- Между разными зонами трафик по умолчанию полностью запрещён (
default drop). - Для разрешения передачи трафика администратор явно определяет пару зон (англ. zone-pair) с указанием источника и назначения: например,
ZONE_INSIDE -> ZONE_OUTSIDEиZONE_INSIDE -> ZONE_DMZ. - К конкретной паре зон применяется карта политик (англ. policy-map), задающая действие:
drop(отбросить),pass(пропустить без отслеживания состояния) илиinspect(активировать stateful-инспекцию с автоматическим пропуском обратных сессий).
Модель ZBF кардинально упрощает масштабирование: при подключении нового физического канала или подсети интерфейс просто добавляется в уже существующую зону, мгновенно наследуя все её политики безопасности.
Централизованное управление доступом AAA: RADIUS и TACACS+
В корпоративной сети контроль доступа распределён по сотням устройств: коммутаторам, беспроводным точкам, VPN-шлюзам и маршрутизаторам. Хранение локальных учётных записей на каждом узле невозможно поддерживать централизованно. Эту задачу решает архитектурный фреймворк AAA (Authentication, Authorization, Accounting):
- Аутентификация (Authentication): проверка подлинности субъекта (кто запрашивает доступ — логин/пароль, сертификат, одноразовый OTP-токен);
- Авторизация (Authorization): определение прав и привилегий (какие ресурсы разрешено открывать или какие команды в CLI разрешено выполнять);
- Учёт (Accounting): регистрация факта использования ресурсов (время начала и конца сессии, объём переданных байт, введённые команды конфигурации).
В сетевой индустрии закрепились два основных протокола AAA: RADIUS и TACACS+, спроектированные под принципиально разные сценарии 1617.
| Критерий | RADIUS (RFC 2865) | TACACS+ (RFC 8907) |
|---|---|---|
| Основное назначение | Доступ клиентов в сеть (802.1X, Wi-Fi Enterprise, VPN) | Администрирование сетевого оборудования (CLI роутеров, коммутаторов) |
| Транспортный протокол | UDP (порты 1812/1813 или устаревшие 1645/1646) | TCP (порт 49), надёжная доставка и подтверждение сессий |
| Разделение фаз AAA | Аутентификация и авторизация объединены в одном пакете Access-Accept | Полное разделение: аутентификация, авторизация и учёт — независимые процессы |
| Шифрование | Шифрует только поле пароля (хеш MD5 с солью); тело пакета открыто | Шифрует всё тело пакета целиком, открыт только заголовок TACACS+ |
| Авторизация команд | Ограничена (возврат фиксированного уровня привилегий) | Гранулярная: проверка каждой введённой инженером команды на сервере |
Точки съёма трафика и видимость: Network TAP vs SPAN
Системы обнаружения вторжений (IDS), анализаторы протоколов и средства поведенческого анализа (NDR/NTA) пассивны: они не стоят в разрыве канала, а анализируют копию сетевого трафика. Качество их работы критически зависит от метода съёма данных:
- Зеркалирование портов (SPAN / Port Mirroring): коммутатор программно дублирует кадры с одного или нескольких портов на выделенный порт мониторинга (а при RSPAN/ERSPAN — инкапсулирует их в GRE через транзитную сеть). Недостаток SPAN — перегрузка буферов: при суммарном трафике двух дуплексных гигабитных направлений в 2 Гбит/с на исходящий порт SPAN в 1 Гбит/с коммутатор вынужден сбрасывать кадры. При этом сбрасываются именно кадры аномалий или всплесков DDoS, искажая результаты анализа. Кроме того, коммутатор отбрасывает повреждённые кадры с ошибками CRC, делая их невидимыми для криминалистического анализа.
- Аппаратные ответвители (Network TAP — Test Access Point): пассивные оптоволоконные призменные сплиттеры или специализированные электронные устройства, физически врезаемые в кабель. TAP передаёт точную физическую копию каждого бита (включая повреждённые кадры и ошибки преамбулы) на раздельные приёмные порты без задержки и риска переполнения буферов коммутатора.
Серьёзным вызовом для всех средств сетевого мониторинга стало внедрение шифрования TLS 1.3 и расширения Encrypted Client Hello (ECH): имя запрашиваемого домена (SNI), сертификат сервера и прикладные заголовки больше не передаются в открытом виде. Для сохранения видимости современные центры обработки данных либо применяют дешифрующие прокси (TLS Inbound/Outbound Inspection) на выделенных шлюзах, либо переходят от сигнатурного анализа полезной нагрузки к поведенческому анализу метаданных сетевых потоков (длительности, распределению размеров пакетов, энтропии и профилям задержек).
Типовые угрозы сетевого уровня и защита от них
Сканирование портов: что видит защищающаяся сторона
Прежде чем атаковать сервис, нарушитель выясняет, какие сервисы существуют. Сканирование портов (англ. port scanning) — систематическая отправка пакетов на диапазон адресов и портов с классификацией ответов. Тем же приёмом (например, утилитой Nmap) администраторы проверяют собственные сети; проверять чужие сети без разрешения владельца нельзя.
Механизм классификации вытекает из уже изученного поведения TCP (тема 12). Если на порт приходит SYN и порт слушается, узел отвечает SYN+ACK — порт открыт (англ. open). Если порт не слушается, ядро отвечает сегментом RST — порт закрыт (англ. closed), но узел явно существует. Если ответа нет вовсе, пакет был отброшен по пути — порт фильтруется (англ. filtered). Сообщение ICMP «адресат недостижим, запрещено администратором» говорит о правиле reject на экране. Для UDP отсутствие ответа неоднозначно: многие UDP-сервисы молчат на неожиданный запрос.
Для защищающейся стороны из этого следуют три вывода. Во-первых, политика drop на внешней границе делает сканирование медленным и малоинформативным: каждый закрытый экраном порт отвечает тайм-аутом, а не мгновенным RST, и нарушитель не может отличить отсутствующий узел от защищённого. Во-вторых, сканирование оставляет хорошо заметный след: от одного источника за короткое время поступает много новых соединений к разным портам или разным адресам, большая доля их не получает ответа или получает RST. Такой рисунок легко выявляется по журналу экрана и правилами систем обнаружения вторжений. В-третьих, регулярное сканирование собственных адресов — обязательная часть эксплуатации: оно показывает фактическую поверхность атаки, которая часто отличается от задуманной. В лабораторной работе этот приём применяется именно так: из каждой зоны проверяется доступность портов, а результат сравнивается с матрицей потоков.
Подмена ARP и перехват в локальном сегменте
Протокол ARP (тема 7) сопоставляет IP-адрес с MAC-адресом и не содержит никакой аутентификации: узел, получивший ответ ARP, записывает сопоставление в таблицу соседей, не проверяя, кто его прислал. Подмена ARP (англ. ARP spoofing, ARP cache poisoning) использует это: узел нарушителя в том же широковещательном сегменте рассылает ответы ARP, в которых IP-адресу шлюза сопоставлен его собственный MAC-адрес. Жертвы начинают отправлять кадры, предназначенные шлюзу, нарушителю, а тот пересылает их дальше и оказывается посредником (англ. man-in-the-middle, MITM) — может читать незашифрованный трафик, изменять его или просто отбрасывать.
Атака возможна только изнутри сегмента второго уровня; межсетевой экран на границе от неё не защищает, потому что кадры между узлами одной VLAN через него не проходят. Признаки подмены, доступные для наблюдения:
- в таблице соседей (
ip neigh) у двух разных IP-адресов — шлюза и какого-то узла — оказывается один и тот же MAC-адрес; - MAC-адрес, соответствующий адресу шлюза, меняется без видимой причины, и в захвате трафика видны ответы ARP, о которых никто не спрашивал, причём повторяющиеся каждые несколько секунд;
- на коммутаторе один MAC-адрес попеременно появляется на разных портах (в таблице коммутации моста Linux —
bridge fdb show), если нарушитель подставил чужой MAC.
Те же признаки — дублирующийся MAC-адрес, конфликт IP-адресов — возникают и при безобидных ошибках конфигурации, например при клонировании виртуальной машины вместе с её MAC-адресом, поэтому наблюдение за таблицей соседей полезно и вне контекста атак. Изменения пар «IP — MAC» отслеживает, например, утилита arpwatch.
Меры защиты действуют на разных уровнях. На управляемых коммутаторах применяются функции DHCP snooping и динамической проверки ARP (англ. Dynamic ARP Inspection): коммутатор знает по журналу выдачи DHCP, какой IP-адрес выдан какому порту, и отбрасывает ответы ARP, противоречащие этому знанию. Аутентификация портов по стандарту IEEE 802.1X не пускает в сегмент неизвестные устройства. Для критичных узлов можно задать постоянную запись ARP для шлюза. И, наконец, самая надёжная мера — сквозное шифрование и аутентификация (TLS, SSH, тема 17): посредник, не имеющий ключей, может отбросить трафик, но не может незаметно прочитать или изменить его.
SYN flood и защита сервера
Атака SYN flood направлена на доступность. При получении SYN сервер создаёт запись о полуоткрытом соединении (англ. half-open connection), отправляет SYN+ACK и ждёт завершающего ACK. Нарушитель отправляет поток сегментов SYN, обычно с подделанными адресами источника, и никогда не завершает рукопожатие. Очередь полуоткрытых соединений заполняется, и сервер перестаёт принимать SYN от легитимных клиентов 6.
Числовой пример показывает, почему атака дешева. Пусть очередь полуоткрытых соединений вмещает 1024 записи, а сервер повторяет SYN+ACK пять раз с удвоением интервала, начиная с одной секунды. Тогда запись живёт около 1 + 2 + 4 + 8 + 16 + 32 = 63 секунд. Чтобы держать очередь полной, достаточно присылать 1024 / 63 ≈ 16 сегментов SYN в секунду — это около 1 Кбайт/с, что доступно любому подключению.
RFC 4987 рассматривает несколько мер противодействия 6. Увеличение очереди и сокращение числа повторов SYN+ACK лишь повышают порог. Главная мера на конечных узлах — SYN cookies: при переполнении очереди сервер не хранит состояние полуоткрытого соединения, а кодирует необходимые сведения (время, MSS, криптографическую свёртку адресов и портов с секретом) в начальном номере последовательности своего SYN+ACK. Когда клиент присылает ACK, сервер восстанавливает из номера подтверждения всё необходимое и создаёт соединение; если ACK не приходит, сервер ничего не потерял. В Linux механизм включён по умолчанию параметром net.ipv4.tcp_syncookies = 1 и срабатывает только при переполнении очереди.
Межсетевой экран со своей стороны может ограничивать частоту новых соединений с одного источника, как было показано выше, и тем защищать сервер от одного слишком активного клиента. Против распределённого потока с подделанных адресов такое ограничение помогает мало: каждый «источник» присылает всего один SYN. Более того, отслеживание состояния делает сам экран мишенью — поток SYN порождает записи в таблице conntrack. Для таких случаев в Linux есть механизм SYNPROXY: экран сам отвечает на SYN с использованием SYN cookies и передаёт соединение серверу только после завершения рукопожатия, не создавая записей для незавершённых попыток.
Отражение, усиление и подмена адреса источника
Атаки на отказ в обслуживании (англ. denial of service, DoS) становятся распределёнными (англ. distributed DoS, DDoS), когда трафик поступает от множества источников, и тогда суммарный поток может превышать пропускную способность канала жертвы. Особый класс — атаки с отражением и усилением (англ. reflection and amplification). Их механизм показан на рисунке ниже. Нарушитель отправляет небольшие запросы по UDP к общедоступным серверам — отражателям (англ. reflectors), — подставив в поле адреса источника адрес жертвы. Отражатели добросовестно отвечают на запрос, но ответ уходит жертве. Если ответ больше запроса, трафик ещё и умножается.
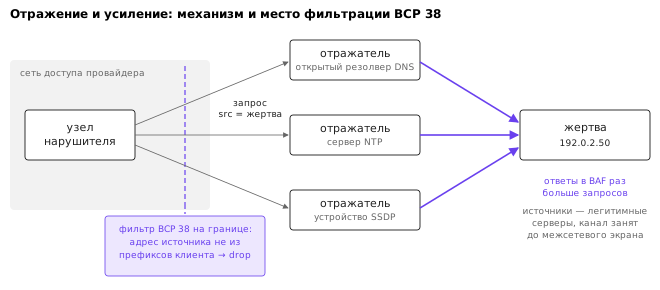
Эффективность протокола для такой атаки характеризуется коэффициентом усиления по полезной нагрузке (англ. bandwidth amplification factor, BAF) — отношением размера ответа к размеру запроса. Россов в систематическом исследовании 2014 года измерил его для ряда протоколов 9; некоторые значения приведены в таблице.
| Протокол | Механизм усиления | BAF (по данным Россова) |
|---|---|---|
| SNMP v2 | ответ GetBulk на короткий запрос | 6,3 |
| SSDP | ответ на поисковый запрос устройства | 30,8 |
| DNS (открытый резолвер) | большой ответ на короткий запрос | 28,7–54,6 |
| CharGen | поток символов в ответ на любую датаграмму | 358,8 |
| NTP | ответ monlist со списком последних клиентов | 556,9 |
Числовой пример: при BAF порядка 50 нарушитель, располагающий исходящим каналом 100 Мбит/с, направляет на жертву около 5 Гбит/с ответов, причём источниками этого трафика выглядят тысячи легитимных серверов, которые нельзя просто занести в чёрный список. Общие черты уязвимых протоколов очевидны: UDP (нет рукопожатия, подтверждающего адрес клиента), ответ значительно больше запроса, множество общедоступных серверов. Отсюда меры со стороны владельцев серверов: не держать открытыми резолверы и служебные UDP-сервисы, отключать отладочные команды вроде NTP monlist, ограничивать частоту ответов (для DNS — механизм Response Rate Limiting). Протоколы, проектируемые сегодня, избегают усиления на этапе установления связи: QUIC, например, требует, чтобы сервер до проверки адреса клиента отправлял не более чем втрое больше данных, чем получил.
Корень проблемы — возможность отправить пакет с чужим адресом источника. Маршрутизация в Интернете смотрит только на адрес назначения, и пакет с подделанным источником доставляется так же, как настоящий. Решение известно с 2000 года и опубликовано как лучшая текущая практика BCP 38 (RFC 2827): входная фильтрация (англ. ingress filtering) на границе сети, к которой подключён источник 4. Провайдер знает, какие префиксы выданы клиенту, и отбрасывает приходящие от клиента пакеты, у которых адрес источника не принадлежит этим префиксам. Если так поступает каждый провайдер доступа, подделка адреса становится невозможной у самого источника. RFC 3704 (BCP 84) развивает идею для сетей с несколькими подключениями и описывает автоматическую проверку обратного пути (англ. unicast Reverse Path Forwarding, uRPF): пакет принимается, только если маршрут к его адресу источника ведёт через тот же интерфейс, на который он пришёл (строгий режим), или хотя бы существует (свободный режим) 5. В Linux аналогичная проверка включается параметром net.ipv4.conf.*.rp_filter, а в nftables записывается выражением fib saddr . iif oif missing drop.
Слабость BCP 38 — экономическая: фильтрация защищает не применяющую её сеть, а других участников Интернета, и потому внедрена не повсеместно. Межсетевой экран жертвы против атаки, заполняющей канал, бессилен — пакеты отбрасываются уже после того, как заняли канал; такие атаки отражают провайдеры и службы очистки трафика, принимающие его на множестве площадок через anycast (тема 10). На собственном пограничном экране BCP 38 сводится к egress-правилу: пакеты из внутренней сети с адресом источника вне 192.168.18.0/24 отбрасываются и журналируются.
Обнаружение вторжений и журналирование
Системы обнаружения и предотвращения вторжений
Межсетевой экран отвечает на вопрос «разрешён ли поток»; система обнаружения вторжений (англ. intrusion detection system, IDS) отвечает на другой вопрос — «не выглядит ли разрешённый поток как атака». Сетевая IDS получает копию трафика (с зеркального порта коммутатора или отвода) и анализирует её: собирает IP-фрагменты и TCP-потоки, разбирает прикладные протоколы и сравнивает результат с правилами. Если система стоит в разрыве линии и может отбрасывать пакеты, её называют системой предотвращения вторжений (англ. intrusion prevention system, IPS).
Различают два подхода к обнаружению. Сигнатурный (англ. signature-based, misuse detection) ищет известные образцы: строку эксплойта в запросе HTTP, характерную последовательность байтов, известный командный сервер вредоносной программы. Он точен для известных угроз и бесполезен против новых. Поведенческий, или поиск аномалий (англ. anomaly detection), строит модель нормального трафика и сообщает об отклонениях: внезапный рост числа соединений, необычный объём передачи данных наружу, обращения к портам, к которым узел никогда не обращался. Он способен заметить неизвестную атаку, но дорого платит за это ложными срабатываниями.
Классические открытые системы — Snort, созданный Мартином Рёшем в 1998 году как «лёгкая» сетевая IDS с простым языком правил 10, и Suricata, многопоточная система с совместимым языком правил, разбором прикладных протоколов и журналом событий в формате JSON 13. Правило Suricata или Snort читается как правило экрана, дополненное условием на содержимое:
alert http $EXTERNAL_NET any -> $HOME_NET any (msg:"Попытка обхода каталога в URI"; flow:established,to_server; http.uri; content:"../"; sid:1000001; rev:1;)
Правило срабатывает на установленный поток к защищаемой сети, в URI которого встречается последовательность ../, и записывает предупреждение с номером sid. Как и межсетевой экран, IDS видит содержимое только открытого трафика: в соединении TLS ей доступны адреса, порты, имя сервера из SNI и статистика потока, но не запрос.
Журналирование и наблюдаемость
Журналы — это память системы защиты. Без них невозможно ни заметить медленную атаку, ни восстановить ход инцидента, ни проверить, что политика действует так, как задумано. Источники журналов — межсетевой экран, IDS, веб-серверы и прокси, системы аутентификации, DNS-резолвер, сводки потоков NetFlow или IPFIX (тема 22). Рекомендации NIST требуют, чтобы межсетевые экраны журналировали как минимум изменения политики и отброшенный трафик, а журналы регулярно анализировались 2.
На практике журналирование подчиняется нескольким правилам. Журналы отправляются с узла сразу (по протоколу syslog или агентом) на отдельный сервер сбора, недоступный из зон, где они порождаются: нарушитель, захвативший веб-сервер в DMZ, первым делом попытается стереть следы. Часы всех узлов синхронизированы по NTP, иначе события из разных источников невозможно сопоставить. Наконец, журналы собираются для того, чтобы их читать: в организациях этим занимаются системы управления событиями безопасности (англ. security information and event management, SIEM), которые сводят журналы вместе и строят по ним оповещения.
Пределы обнаружения: проблема базовой частоты
Даже очень точный детектор порождает много ложных тревог, если настоящие атаки редки. Аксельссон показал это в 2000 году, применив к обнаружению вторжений рассуждение о базовой частоте из теории вероятностей 11. Разберём числовой пример. Пусть за сутки IDS анализирует миллион событий (сессий), из которых 10 связаны с настоящей атакой. Детектор обнаруживает 99 % атак и ошибочно срабатывает на 0,1 % нормальных событий. Тогда за сутки он выдаст 0,99 · 10 ≈ 10 верных тревог и 0,001 · 999 990 ≈ 1000 ложных. Доля верных среди всех тревог — 10 / 1010 ≈ 1 %.
Вывод Аксельссона состоит в том, что для практической пригодности доля ложных срабатываний должна быть на порядки меньше, чем кажется достаточным интуитивно, — порядка базовой частоты самих атак 11. Практические следствия — настройка правил под конкретную сеть (отключение сигнатур, не относящихся к используемому ПО), корреляция нескольких слабых признаков вместо реакции на каждый, и прежде всего уменьшение объёма того, что нужно анализировать. Именно здесь межсетевой экран и IDS дополняют друг друга: строгая политика default deny отсекает огромную долю мусорного трафика ещё до анализа, и каждая запись об отброшенном пакете из DMZ наружу становится редким и потому значимым событием.
Модели анализа атак: Cyber Kill Chain, Diamond Model и MITRE ATT&CK
Для обнаружения и нейтрализации сложных целевых атак (англ. Advanced Persistent Threats, APT) защитникам необходимы формальные модели описания действий противника.
-
Цепочка поражения (Lockheed Martin Cyber Kill Chain): военная концепция последовательных фаз нападения, адаптированная для киберпространства Хатчинсом с соавторами 18:
- Reconnaissance (Разведка): сбор информации о цели (сканирование сети, DNS, OSINT, фишинг);
- Weaponization (Вооружение): объединение эксплойта под уязвимость с полезной нагрузкой (пейлоадом);
- Delivery (Доставка): передача вредоносного объекта жертве (email-фишинг, вредоносный сайт, USB);
- Exploitation (Эксплуатация): исполнение кода через уязвимость в ПО или ошибку конфигурации;
- Installation (Закрепление): установка бэкдора, сервиса persistence, скрытие в системе;
- Command & Control (Управление, C2): открытие канала связи с сервером управления атакующего;
- Actions on Objectives (Действия по достижению цели): эксфильтрация данных, шифрование вымогателем, деструктивные действия.
Главная практическая ценность модели Kill Chain — асимметрия защиты: нападающий обязан успешно пройти все фазы подряд, тогда как защитнику для срыва всей атаки достаточно обнаружить и заблокировать противника хотя бы на одном из звеньев цепочки 18.
-
Алмазная модель анализа вторжений (Diamond Model): разработана Серджио Кальтаджироне для аналитиков центров мониторинга (SOC) 19. Каждое событие безопасности формализуется в виде четырёх вершин ромба: Противник (Adversary) применяет Возможность (Capability) против Жертвы (Victim) через коммуникационную Инфраструктуру (Infrastructure). Две вспомогательные оси — Технологическая (какие протоколы и платформы задействованы) и Социально-политическая (мотивация и контекст) — позволяют сопоставлять разрозненные сетевые аномалии в единую кампанию вторжения.
-
База знаний MITRE ATT&CK: таксономия реального поведения атакующих, структурированная в виде матрицы «Тактики (зачем действует?) — Техники и Подтехники (как именно делает?) — Процедуры (TTPs)». В отличие от линейной Kill Chain, ATT&CK отражает нелинейное поведение нарушителя внутри скомпрометированного периметра.
Оценка и скоринг уязвимостей: система CVSS
Для приоритизации обновлений сетевого оборудования и серверов используется открытый стандарт CVSS (Common Vulnerability Scoring System) консорциума FIRST 20. Оценка выражается числом от 0.0 до 10.0 и складывается из метрик:
- Базовая группа (Base Metrics): внутренние качества уязвимости, неизменные во времени:
- Вектор атаки (Attack Vector, AV): Network (сетевой, наивысший риск), Adjacent (соседняя сеть/L2), Local (локальный доступ), Physical (физический);
- Сложность атаки (Attack Complexity, AC): Low (нет условий) / High (требуются гонки, редкие конфигурации);
- Требуемые привилегии (Privileges Required, PR): None / Low / High;
- Взаимодействие с пользователем (User Interaction, UI): None (автономно) / Required (жертва должна нажать ссылку);
- Область действия (Scope, S): Unchanged / Changed (эксплойт пробивает песочницу или гипервизор наружу);
- Влияние (Impact): Конфиденциальность (C), Целостность (I), Доступность (A) — None / Low / High.
- Временная группа (Temporal Metrics): наличие публичного эксплойта (Exploit Code Maturity) и официального патча (Remediation Level).
- Контекстная группа (Environmental Metrics): важность конкретного хоста внутри организации.
Каждая уязвимость получает векторный код вида CVSS:3.1/AV:N/AC:L/PR:N/UI:N/S:U/C:H/I:H/A:H (критический рейтинг 9.8), что позволяет автоматизировать обработку результатов сканеров уязвимостей (Vulnerability Scanners) в SIEM.
Жизненный цикл реагирования на инциденты и порядок волатильности улик
Реагирование на инциденты информационной безопасности организуется дежурными командами CSIRT / CERT / SOC по международному стандарту NIST SP 800-61 Rev. 2 в рамках четырёх фаз 21:
- Подготовка (Preparation): составление регламентов, настройка резервных копий, установка датчиков мониторинга, обучение персонала;
- Обнаружение и анализ (Detection & Analysis): фиксация аномалии, первичная триаж-классификация, валидация ложных срабатываний, определение масштаба компрометации;
- Локализация, ликвидация и восстановление (Containment, Eradication & Recovery): изоляция скомпрометированных узлов сети (отключение портов коммутатора, блокировка на межсетевом экране), удаление вредоносного ПО, закрытие уязвимостей, восстановление из доверенных бэкапов;
- Постинцидентная деятельность (Post-Incident Activity / Lessons Learned): анализ извлечённых уроков, модернизация правил фильтрации, подготовка юридических отчётов.
При сборе цифровых доказательств критически важно соблюдать Порядок волатильности данных (Order of Volatility по RFC 3227) 22 — сбор начинается с наиболее быстро исчезающих артефактов до отключения питания узла:
- Регистры процессора и кэш-память;
- Таблицы маршрутизации, ARP-кэш, таблица состояний conntrack ядра и содержимое оперативной памяти (RAM);
- Временная сетевая статистика и активные сетевые подключения;
- Содержимое дисковых накопителей и локальных файловых систем;
- Удалённые журналы регистрации и архивные резервные копии.
Для каждого снятого артефакта (образа памяти или диска) немедленно вычисляется криптографический хеш (SHA-256), гарантирующий неизменность улики при передаче в суд в рамках цепочки обеспечения сохранности доказательств (англ. Chain of Custody).
Итоги темы
Сетевые протоколы, изученные в курсе, проектировались в расчёте на добросовестных участников: в них нет проверки адреса источника, подлинности ответа ARP, намерения клиента завершить рукопожатие. Защита сети поэтому строится вокруг явной политики, выведенной из модели угроз: какие активы защищаются, от кого и какие потоки для работы действительно необходимы. Принципы минимальных привилегий и безопасных умолчаний приводят к политике «запрещено всё, что не разрешено», а принцип эшелонированной защиты — к тому, что межсетевой экран остаётся одним из нескольких рубежей и не заменяет защиту самих сервисов.
Межсетевые экраны прошли путь от пакетного фильтра без состояния, которому для пропуска ответов приходилось открывать широкие диапазоны портов, к экрану с отслеживанием соединений, где политика описывает только новые соединения, а ответы и связанные сообщения ICMP пропускаются по таблице состояний. В Linux эта модель реализована подсистемой netfilter: хуки определяют, где пакет может быть рассмотрен, conntrack сопоставляет пакет с потоком, а nftables даёт язык с наборами, словарями, счётчиками, журналированием и ограничением частоты. Порядок правил, правильный выбор цепочки (forward для транзита, input для самого экрана) и правило для состояний established,related — три вещи, ошибки в которых встречаются чаще всего.
Сегментация переводит политику с уровня отдельных правил на уровень архитектуры: зоны доверия, матрица потоков между ними и демилитаризованная зона для публичных сервисов, из которой нельзя инициировать соединения во внутреннюю сеть. Модель нулевого доверия продолжает эту линию, отказываясь считать доверенным любой узел только по его расположению. Защита от типовых угроз сетевого уровня распределена по уровням: политика drop и журналирование на экране, проверки на коммутаторах доступа, SYN cookies на серверах, фильтрация адресов источника по BCP 38 у провайдеров. Обнаружение вторжений и журналирование замыкают цикл, делая видимым то, что политика пропустила или отвергла, но их эффективность ограничена проблемой базовой частоты.
Межсетевой экран управляет тем, какие потоки возможны, но не защищает их содержимое при прохождении через недоверенную сеть. Следующая тема посвящена туннелям и виртуальным частным сетям, которые объединяют криптографию из темы 17 с маршрутизацией и позволяют безопасно связать удалённые площадки и пользователей через Интернет.
Литература
- Cheswick W. R., Bellovin S. M., Rubin A. D. Firewalls and Internet Security: Repelling the Wily Hacker. 2nd ed. — Addison-Wesley, 2003.
- Scarfone K., Hoffman P. Guidelines on Firewalls and Firewall Policy. — NIST Special Publication 800-41 Rev. 1, 2009. https://doi.org/10.6028/NIST.SP.800-41r1
- Rose S., Borchert O., Mitchell S., Connelly S. Zero Trust Architecture. — NIST Special Publication 800-207, 2020. https://doi.org/10.6028/NIST.SP.800-207
- Ferguson P., Senie D. Network Ingress Filtering: Defeating Denial of Service Attacks which employ IP Source Address Spoofing. — RFC 2827 (BCP 38), IETF, 2000. https://www.rfc-editor.org/rfc/rfc2827
- Baker F., Savola P. Ingress Filtering for Multihomed Networks. — RFC 3704 (BCP 84), IETF, 2004. https://www.rfc-editor.org/rfc/rfc3704
- Eddy W. TCP SYN Flooding Attacks and Common Mitigations. — RFC 4987, IETF, 2007. https://www.rfc-editor.org/rfc/rfc4987
- The netfilter.org project. nftables wiki. — 2025. https://wiki.nftables.org/
- Neira Ayuso P. Netfilter's connection tracking system. — ;login: The USENIX Magazine, 2006, Vol. 31, No. 3.
- Rossow C. Amplification Hell: Revisiting Network Protocols for DDoS Abuse. — Proceedings of the Network and Distributed System Security Symposium (NDSS), 2014.
- Roesch M. Snort — Lightweight Intrusion Detection for Networks. — Proceedings of the 13th USENIX Conference on System Administration (LISA '99), 1999, С. 229–238.
- Axelsson S. The Base-Rate Fallacy and the Difficulty of Intrusion Detection. — ACM Transactions on Information and System Security, 2000, Vol. 3, No. 3, С. 186–205, DOI: 10.1145/357830.357849.
- Saltzer J. H., Schroeder M. D. The Protection of Information in Computer Systems. — Proceedings of the IEEE, 1975, Vol. 63, No. 9, С. 1278–1308, DOI: 10.1109/PROC.1975.9939.
- Open Information Security Foundation. Suricata User Guide. — 2025. https://docs.suricata.io/
- The Linux Kernel Documentation. Netfilter Conntrack Sysfs variables. — 2025. https://docs.kernel.org/networking/nf_conntrack-sysctl.html
- Cisco Systems. Zone-Based Policy Firewall Design Guide. — 2024.
- Rigney C., Willens S., Rubens A., Simpson W. Remote Authentication Dial In User Service (RADIUS). — RFC 2865, IETF, 2000. https://www.rfc-editor.org/rfc/rfc2865
- Dahm T., et al. The TACACS+ Protocol. — RFC 8907, IETF, 2020. https://www.rfc-editor.org/rfc/rfc8907
- Hutchins E. M., Cloppert M. J., Amin R. M. Intelligence-Driven Computer Network Defense Informed by Analysis of Adversary Campaigns and Intrusion Kill Chains. — 6th International Conference on Information Warfare and Security, 2011, С. 113–125.
- Caltagirone S., Pendergast A., Betz C. The Diamond Model of Intrusion Analysis. — Center for Cyber Intelligence Analysis and Threat Research, 2013.
- FIRST. Common Vulnerability Scoring System v3.1: Specification Document. — Forum of Incident Response and Security Teams, 2019. https://www.first.org/cvss/v3.1/specification-document
- Cichonski P., Millar T., Grance T., Scarfone K. Computer Security Incident Handling Guide. — NIST Special Publication 800-61 Rev. 2, 2012. https://doi.org/10.6028/NIST.SP.800-61r2
- Brezinski D., Killalea T. Guidelines for Evidence Collection and Archiving. — RFC 3227 (BCP 55), IETF, 2002. https://www.rfc-editor.org/rfc/rfc3227