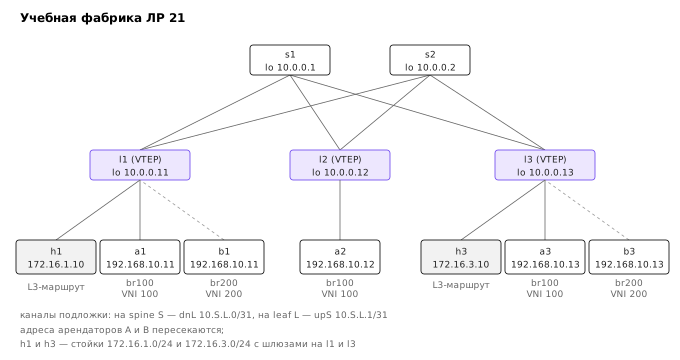
Сети центров обработки данных и виртуализация сети
В предыдущих темах сеть рассматривалась с точки зрения организации, подключённой к Интернету: офисные сегменты и VLAN (тема 5), маршрутизация внутри автономной системы и между ними (темы 9 и 10), туннели между площадками (тема 19). Центр обработки данных (ЦОД, англ. data center) ставит перед сетью иные требования. В одном здании работают десятки тысяч серверов, на каждом из них — десятки виртуальных машин или сотни контейнеров, а основной объём трафика передаётся не между пользователем и сервером, а между серверами внутри здания. Сеть ЦОД должна давать любой паре серверов почти одинаковую пропускную способность, переживать отказ любого коммутатора незаметно для приложений и позволять создавать и удалять изолированные сети арендаторов за секунды, без участия человека.
Ответом на эти требования стали три идеи, каждой из которых посвящён отдельный раздел темы. Первая — топологическая: вместо дерева из нескольких мощных коммутаторов строится многоступенчатая сеть Клоза из множества одинаковых недорогих коммутаторов, а нагрузка распределяется по многим равноценным путям (ECMP). Вторая — разделение физической сети и логических сетей арендаторов: физическая сеть становится простой маршрутизируемой IP-фабрикой, а сети арендаторов строятся поверх неё как оверлеи, прежде всего VXLAN с плоскостью управления EVPN. Третья — программная реализация сетевых функций: коммутатор, маршрутизатор и балансировщик нагрузки становятся программами, работающими в ядре Linux или в пользовательском пространстве на обычных серверах, а сетью управляет централизованный контроллер.
Изложение следует от физической фабрики к логическим сетям. Сначала рассматриваются требования и топологии ЦОД, затем многопутевая маршрутизация и применение BGP внутри ЦОД, после этого — оверлеи VXLAN и EVPN. Четвёртый раздел показывает, из каких «кирпичей» построена виртуальная сеть в Linux и как на них устроены сети Docker и Kubernetes. Завершают тему программно-определяемые сети, балансировка нагрузки и средства ускорения обработки пакетов.
Требования к сети ЦОД и топология Клоза
Трафик «восток — запад» и требования к сети ЦОД
Трафик ЦОД принято делить по направлению на схеме, где Интернет нарисован сверху, а серверы — снизу. Трафик «север — юг» (англ. north–south) входит в ЦОД извне и выходит наружу: запрос пользователя к веб-сайту и ответ на него. Трафик «восток — запад» (англ. east–west) остаётся внутри ЦОД: обращения веб-сервера к базе данных, репликация хранилища, обмен между микросервисами, распределённые вычисления. В современных ЦОД второй вид преобладает: один запрос пользователя к поисковой системе или социальной сети порождает сотни внутренних запросов к сервисам и хранилищам, а задачи анализа данных и обучения моделей перемещают между серверами терабайты без участия пользователя. В работе о пяти поколениях сетей ЦОД Google отмечается, что пропускная способность, требуемая внутри ЦОД, удваивалась каждые 12–15 месяцев и росла быстрее, чем трафик, выходящий в Интернет 3.
Из преобладания трафика «восток — запад» следуют требования к сети. Первое — высокая пропускная способность сечения (англ. bisection bandwidth): если мысленно разделить все серверы на две равные половины, суммарная скорость, с которой одна половина может обмениваться с другой, должна быть сопоставима с суммарной скоростью подключения серверов. Второе — однородность: планировщик кластера размещает задачи на любых свободных серверах, и приложение не должно зависеть от того, оказались ли два его экземпляра в одной стойке или в разных концах зала. Третье — отказоустойчивость: в сети из тысяч коммутаторов и десятков тысяч кабелей что-то неисправно постоянно, и отказ одного элемента должен лишь немного уменьшать пропускную способность, а не разрывать связность. Четвёртое — масштабируемость: сеть наращивается постепенно, стойка за стойкой, без замены уже установленного оборудования. Пятое — управляемость: при таком числе устройств конфигурация может создаваться только автоматически, из описания намерения, о чём пойдёт речь в теме 22.
Трёхуровневая архитектура и её пределы
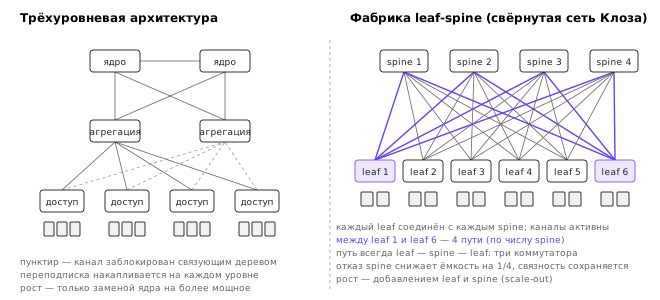
Классическая сеть предприятия и ЦОД первого поколения строится по трёхуровневой иерархии (англ. three-tier architecture). Серверы подключаются к коммутаторам доступа (англ. access), обычно установленным наверху стойки — отсюда название ToR (англ. top of rack). Коммутаторы доступа подключаются к паре коммутаторов агрегации (англ. aggregation, или distribution), а те — к паре коммутаторов ядра (англ. core). Уровень доступа и агрегации, как правило, работает на канальном уровне с VLAN, а маршрутизация выполняется на агрегации или в ядре. Такая иерархия хорошо подходит для трафика «север — юг»: почти весь он поднимается по дереву к ядру и выходит наружу.
Для трафика «восток — запад» у трёхуровневой архитектуры три недостатка. Первый — переподписка (англ. oversubscription), то есть отношение суммарной скорости портов, обращённых вниз, к суммарной скорости портов, обращённых вверх. Каждый уровень дерева её накапливает: если коммутатор доступа имеет переподписку 4:1, а агрегация — ещё 5:1, то два сервера в разных ветвях дерева при одновременной нагрузке получают лишь двадцатую долю скорости своих сетевых карт. Второй — избыточные каналы на канальном уровне блокируются протоколом связующего дерева (тема 5): из двух каналов от доступа к агрегации один находится в резерве и не передаёт трафик, так что половина купленной пропускной способности простаивает. Третий — масштаб ограничен мощностью коммутаторов ядра: увеличить ёмкость сети можно лишь заменой их на более мощные и дорогие (англ. scale-up), а коммутатор с тысячами портов 100 Гбит/с либо очень дорог, либо не существует.
Сеть Клоза и архитектура leaf-spine
Решение пришло из телефонии. В 1953 году Ч. Клоз (C. Clos) показал, как построить большой неблокирующий коммутатор из многих малых: трёхступенчатая сеть, в которой каждый коммутатор входной ступени соединён с каждым коммутатором средней ступени, а каждый коммутатор средней ступени — с каждым коммутатором выходной 1. Если у входного коммутатора n входов, а средних коммутаторов m, то при m ≥ 2n − 1 новое соединение между свободными входом и выходом можно установить всегда, не перестраивая существующие (строго неблокирующая сеть). Для пакетной сети строгое условие не требуется: потоки распределяются по путям статистически, и достаточно, чтобы суммарная ёмкость средней ступени была не меньше суммарной ёмкости входов.
В ЦОД эта идея воплощена в архитектуре leaf-spine (англ. «лист — хребет»), которую называют также свёрнутой сетью Клоза (англ. folded Clos): входная и выходная ступени совмещены в одном коммутаторе, поскольку каждый порт сервера одновременно и передаёт, и принимает. Коммутаторы уровня leaf стоят в стойках и подключают серверы. Коммутаторы уровня spine подключают только leaf. Каждый leaf соединён с каждым spine, а между собой коммутаторы одного уровня не соединены. Путь между серверами разных стоек всегда содержит ровно три коммутатора — leaf, spine, leaf, — и таких путей столько, сколько spine в фабрике. Отказ одного spine уменьшает пропускную способность между стойками на долю 1/S, где S — число spine, но не нарушает связность. Схема на рисунке ниже сопоставляет две архитектуры.
Аль-Фарес, Лукиссас и Вахдат показали, что из одинаковых коммутаторов с k портами можно построить фабрику по схеме «толстого дерева» (англ. fat-tree) — трёхуровневой сети Клоза с полной пропускной способностью сечения 2. Фабрика состоит из k модулей (англ. pod), в каждом по k/2 коммутаторов доступа и k/2 коммутаторов агрегации, и из (k/2)² коммутаторов ядра. Она подключает k³/4 серверов, а между серверами разных модулей существует (k/2)² равноценных путей. Для коммутаторов с 48 портами получается 27 648 серверов, 2880 коммутаторов и 576 путей между любыми двумя серверами из разных модулей. Главный вывод работы был экономическим: сеть из массовых коммутаторов одинаковой конструкции (англ. commodity) обходится дешевле дерева из специализированных и при этом наращивается горизонтально (англ. scale-out) — добавлением однотипных элементов. Google пришла к той же архитектуре независимо: фабрика Jupiter, описанная в 2015 году, построена из коммутаторов на массовых микросхемах (англ. merchant silicon) и обеспечивает пропускную способность сечения 1,3 Пбит/с 3.
Переподписка и масштаб фабрики: числовой пример
Рассмотрим фабрику для зала ЦОД. Коммутатор leaf имеет 48 портов 25 Гбит/с для серверов и 8 портов 100 Гбит/с вверх; коммутатор spine — 32 порта 100 Гбит/с. Каждый leaf подключается одним каналом к каждому spine, поэтому число spine равно числу восходящих портов leaf, то есть 8. Каждый spine подключает по одному каналу от каждого leaf, поэтому число leaf ограничено числом портов spine — 32.
| Величина | Расчёт | Значение |
|---|---|---|
| Скорость портов leaf вниз | 48 × 25 Гбит/с | 1200 Гбит/с |
| Скорость портов leaf вверх | 8 × 100 Гбит/с | 800 Гбит/с |
| Переподписка на leaf | 1200 : 800 | 1,5 : 1 |
| Число серверов | 32 leaf × 48 | 1536 |
| Число равноценных путей между стойками | число spine | 8 |
| Ёмкость между стойками после отказа одного spine | 7/8 от исходной | 700 Гбит/с на leaf |
| Пропускная способность сечения фабрики | 32 × 800 Гбит/с / 2 | 12,8 Тбит/с |
Переподписка 1,5:1 означает, что если все серверы стойки одновременно передают трафик в другие стойки на полной скорости, каждый получит две трети скорости своей карты. На практике серверы редко нагружают сеть одновременно, и переподписка от 1:1 до 3:1 считается для ЦОД нормальной; полное отсутствие переподписки (1:1) применяют в кластерах для обучения нейросетей и высокопроизводительных вычислений, где обмен между всеми узлами действительно одновременный. Важно понимать, что переподписка — не недостаток, а инженерный выбор: восходящие порты и spine — самая дорогая часть фабрики, и отношение 3:1 при типичной нагрузке экономит две трети этих затрат.
Если 1536 серверов недостаточно, фабрику расширяют. Можно взять spine с большим числом портов: spine на 64 порта позволит подключить 64 leaf. Если и этого мало, добавляется третий уровень: несколько фабрик leaf-spine (их называют модулями, англ. pod, или кластерами) соединяются через уровень суперспайнов (англ. super-spine), и получается пятиступенчатая сеть Клоза. Именно такую топологию рассматривает RFC 7938, о котором пойдёт речь в следующем разделе 5.
Многопутевая маршрутизация и маршрутизация до стойки
ECMP и хеширование потоков
Фабрика leaf-spine полезна, только если трафик действительно распределяется по всем путям. На сетевом уровне это делает маршрутизация по нескольким путям равной стоимости (англ. Equal-Cost Multi-Path, ECMP): если протокол маршрутизации нашёл к префиксу несколько маршрутов с одинаковой метрикой, маршрутизатор устанавливает в таблицу их все, и маршрут получает несколько следующих переходов (англ. next hop). Возникает вопрос, по какому из них отправить конкретный пакет.
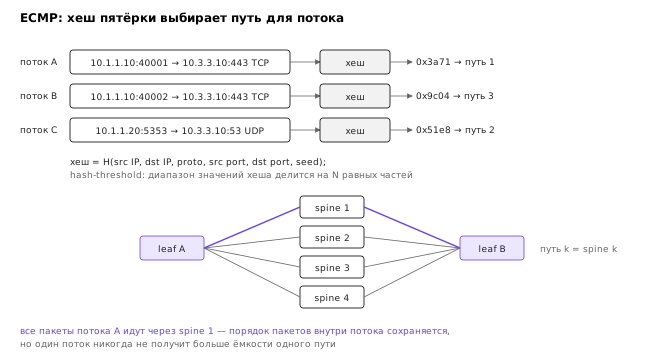
Распределять пакеты по очереди, «по кругу», нельзя. Пути имеют разную задержку и разную загрузку очередей, пакеты одного TCP-соединения приходили бы не по порядку, а TCP, как было показано в теме 13, воспринимает три повторных подтверждения как признак потери и уменьшает окно перегрузки. Поэтому маршрутизатор распределяет не пакеты, а потоки (англ. flow). Потоком называется последовательность пакетов с одинаковой пятёркой (англ. 5-tuple): адрес и порт источника, адрес и порт назначения, протокол. Маршрутизатор вычисляет хеш-функцию от полей пятёрки и по значению хеша выбирает следующий переход. Все пакеты потока имеют одинаковый хеш и идут одним путём, а разные потоки распределяются по путям случайно и в среднем равномерно. Анализ алгоритмов выбора дан в RFC 2992: простейший способ — остаток от деления хеша на число переходов (англ. modulo-N), более удачный — разбиение пространства значений хеша на равные интервалы (англ. hash-threshold), при котором изменение числа переходов затрагивает меньшую долю потоков 4.
В Linux маршрут с несколькими следующими переходами задаётся командой ip route с несколькими ключевыми словами nexthop. В лабораторной работе такой маршрут установлен на коммутаторе leaf l1 к адресам всех стоек фабрики:
ip route replace 172.16.0.0/16 \
    nexthop via 10.1.1.0 weight 1 \
    nexthop via 10.2.1.0 weight 1
ip route show 172.16.0.0/16
172.16.0.0/16
	nexthop via 10.1.1.0 dev up1 weight 1
	nexthop via 10.2.1.0 dev up2 weight 1
Какие поля входят в хеш, определяет параметр ядра net.ipv4.fib_multipath_hash_policy 12. Значение 0 (по умолчанию) — только адреса источника и назначения, значение 1 — пятёрка, значение 2 — адреса, а для туннелированных пакетов — адреса внутреннего заголовка, значение 3 — набор полей, заданный параметром fib_multipath_hash_fields. Разница принципиальна. Опыт из лабораторной работы: сервер h1 за l1 отправляет серверу h3 за l3 64 потока UDP по 10 датаграмм, различающиеся только портом источника, и подсчитывается, сколько пакетов прошло через каждый spine.
политика 1 (пятёрка), 64 потока:       через s1: 330 пакетов   через s2: 311 пакетов
политика 1 (пятёрка), один поток:      через s1: 640 пакетов   через s2: 0 пакетов
политика 0 (адреса), 64 потока:        через s1: 640 пакетов   через s2: 0 пакетов
При хешировании пятёрки 64 потока разошлись по двум путям почти поровну: 33 потока через s1 и 31 через s2 (лишний пакет в сумме — посторонний служебный). Один поток, как и следовало ожидать, целиком прошёл одним путём. При хешировании только адресов все 64 потока имеют одну пару адресов, а значит, один хеш и один путь: второй spine простаивает. Отсюда практическое правило: ECMP распределяет нагрузку хорошо, когда потоков много и они различаются полями, входящими в хеш. Пара серверов, обменивающаяся одним большим потоком, никогда не получит больше скорости одного пути, сколько бы путей ни было в фабрике. Иллюстрация ниже показывает, как поля пятёрки превращаются в выбор пути.
Ограничения ECMP
Хеширование потоков создаёт несколько эффектов, о которых нужно помнить при эксплуатации фабрики. Первый — коллизии крупных потоков. Распределение трафика ЦОД по размеру потоков сильно неравномерно: большинство потоков — короткие «мыши» (англ. mice) в несколько килобайт, а основной объём байтов переносят немногочисленные «слоны» (англ. elephant flows) — копирование образов, репликация, резервное копирование. Если два «слона» случайно получили один путь, этот путь перегружен, а соседний свободен, и хеш об этом не знает. Аль-Фарес и соавторы показали, что статическое хеширование на толстом дереве может терять заметную долю пропускной способности сечения из-за таких коллизий 2. Против этого применяют разбиение потока на пачки (англ. flowlet) по паузам между пакетами, динамическое перераспределение по загрузке и распыление пакетов с переупорядочиванием на приёмнике — это предмет исследований и специализированного оборудования.
Второй эффект — поляризация (англ. hash polarization). Если все коммутаторы фабрики используют одинаковую хеш-функцию с одинаковыми входными данными, то на втором уровне пути выбираются коррелированно: на spine приходят только потоки, у которых хеш на leaf дал определённое значение, и spine, применяя ту же функцию, отправит их все в один и тот же из своих каналов. Поэтому в хеш добавляют уникальное для каждого устройства начальное значение (англ. seed). Третий эффект — перестройка при отказе. Когда один из N переходов пропадает, при наивном вычислении остатка от деления на N почти все потоки меняют путь, а на новых путях установленные соединения могут потерять пакеты и состояние промежуточных устройств, например балансировщиков. Устойчивое хеширование (англ. resilient hashing) хранит таблицу корзин (англ. buckets) и при отказе переназначает только корзины отказавшего перехода. В Linux такие группы создаются объектами ip nexthop с параметром type resilient.
Четвёртое обстоятельство касается туннелей. Внешние заголовки туннельного трафика между двумя узлами одинаковы для всех внутренних потоков: у GRE (тема 19) это пара адресов концов туннеля и номер протокола 47. Хеш внешнего заголовка направит весь туннель одним путём. Протоколы, рассчитанные на ЦОД, решают эту задачу, помещая энтропию внутреннего потока во внешний заголовок: VXLAN, как будет показано ниже, вычисляет порт источника UDP по хешу внутреннего кадра.
Маршрутизация до стойки и BGP в ЦОД
В фабрике leaf-spine граница между канальным и сетевым уровнем проходит по коммутатору leaf: каналы между leaf и spine — маршрутизируемые соединения точка — точка, а широковещательный домен не выходит за пределы стойки или вовсе ограничен одним сервером. Такой подход называют маршрутизацией до стойки (англ. layer 3 to the ToR, routed access). Он убирает из фабрики связующее дерево и широковещательные штормы: все каналы активны, а избыточность обеспечивает ECMP. Платой становится то, что подсеть привязана к стойке, и виртуальная машина не может переехать в другую стойку с тем же IP-адресом; эту задачу решают оверлеи следующего раздела.
Какой протокол маршрутизации выбрать для фабрики? Естественным кажется протокол внутреннего шлюза — OSPF или IS-IS (тема 9). RFC 7938, обобщивший опыт крупных операторов ЦОД, рекомендует другое решение: использовать на всех уровнях фабрики только внешний BGP (eBGP) 5. Аргументы такие. BGP проще по устройству состояния: он не рассылает по всей области базу состояния каналов и не пересчитывает дерево кратчайших путей, а передаёт соседям только лучшие маршруты, поэтому отказ канала затрагивает меньшую часть фабрики. Одним протоколом обслуживаются и фабрика, и подключение к внешним сетям. У BGP богатые средства политик и зрелые реализации, а eBGP-сессия по каналу точка — точка не нуждается в отдельном протоколе обнаружения соседей и в протоколе внутреннего шлюза для достижимости адресов следующего перехода.
Схема назначения номеров автономных систем в RFC 7938 построена так, чтобы механизм предотвращения петель BGP — отбрасывание маршрута, в AS_PATH которого уже есть собственный номер (тема 10), — сам исключал неправильные пути 5. Всем spine одного уровня назначается один общий номер AS, каждому leaf — собственный, номера берутся из частного диапазона (64512–65534 для двухбайтовых номеров, а при нехватке — из частного диапазона четырёхбайтовых). Маршрут от leaf A к leaf B проходит через любой spine и имеет AS_PATH из двух номеров: номер spine и номер leaf B. Все такие пути имеют одинаковую длину, и BGP со включённой многопутевой маршрутизацией (maximum-paths) установит их в таблицу как ECMP. Путь «leaf — spine — другой leaf — другой spine», который мог бы появиться при сбое, будет отброшен, поскольку содержит номер spine дважды. Для сходимости при отказе канала используется быстрое обнаружение отказа: отключение физического канала замечается сразу, а для отказов без потери несущей применяется BFD.
! фрагмент конфигурации FRRouting на leaf с AS 65011 (тема 9 — синтаксис FRR)
router bgp 65011
 bgp router-id 10.0.0.11
 neighbor 10.1.1.0 remote-as 65000
 neighbor 10.2.1.0 remote-as 65000
 address-family ipv4 unicast
  network 172.16.1.0/24
  maximum-paths 8
 exit-address-family
На практике конфигурацию упрощают ещё больше. Реализации вроде FRRouting позволяют устанавливать сессию по имени интерфейса без IPv4-адреса на канале (так называемый BGP unnumbered): соседи находят друг друга по локальным адресам IPv6 канала, а маршруты IPv4 передаются со следующим переходом IPv6. Тогда конфигурация всех leaf отличается лишь номером AS и анонсируемыми префиксами и генерируется автоматически.
Оверлейные сети: VXLAN и EVPN
Зачем нужен оверлей
Маршрутизация до стойки делает физическую фабрику простой и масштабируемой, но сталкивается с требованиями виртуализации. Во-первых, виртуальная машина при живой миграции (англ. live migration) переезжает на другой сервер, возможно в другую стойку, и должна сохранить IP- и MAC-адреса, иначе прервутся её соединения. Во-вторых, облачный ЦОД обслуживает многих арендаторов (англ. multi-tenancy), каждый из которых хочет собственных сетей с собственными, возможно пересекающимися, адресами. В-третьих, число изолированных сетей велико: идентификатор VLAN занимает 12 бит, что даёт не более 4094 сетей на всю фабрику, тогда как у облачного провайдера арендаторов и их сетей — сотни тысяч.
Решение состоит в разделении сети на два слоя. Подложка (англ. underlay) — физическая IP-фабрика с маршрутизацией до стойки, которая умеет только одно: доставить IP-пакет от одного коммутатора или сервера к другому. Оверлей (англ. overlay) — логические сети арендаторов, кадры которых упаковываются в IP-пакеты подложки на входе и распаковываются на выходе. Подложка ничего не знает об арендаторах, их адресах и VLAN, а оверлей не знает о топологии подложки. Создание новой сети арендатора требует изменений только на краях фабрики — там, где выполняется упаковка, — и не затрагивает ни один spine. Общая идея туннелирования изложена в теме 19; здесь рассматривается её вариант, специально созданный для ЦОД.
Формат VXLAN и накладные расходы
Виртуальная расширяемая локальная сеть (англ. Virtual eXtensible Local Area Network, VXLAN) описана в RFC 7348 6. Она переносит кадр Ethernet целиком, включая его MAC-адреса, внутри UDP-датаграммы. Узел, выполняющий упаковку и распаковку, называется оконечной точкой туннеля VXLAN (англ. VXLAN Tunnel End Point, VTEP). Роль VTEP выполняет коммутатор leaf или сам сервер виртуализации, если виртуальный коммутатор работает в его ядре. Пакет VXLAN состоит из следующих частей:
- внешний заголовок Ethernet (14 байт) — MAC-адреса VTEP и следующего перехода подложки;
- внешний заголовок IPv4 (20 байт) — адрес источника и адрес назначения являются адресами VTEP, обычно адресами loopback коммутаторов leaf;
- заголовок UDP (8 байт) — порт назначения 4789, назначенный IANA для VXLAN; порт источника вычисляется по хешу заголовков внутреннего кадра;
- заголовок VXLAN (8 байт) — флаги (8 бит, из которых используется только флаг I, означающий наличие действительного идентификатора), 24 зарезервированных бита, идентификатор сети VXLAN (англ. VXLAN Network Identifier, VNI) длиной 24 бита и ещё 8 зарезервированных бит;
- исходный кадр Ethernet арендатора без контрольной последовательности FCS.
Длина VNI в 24 бита даёт 16 777 216 возможных сегментов вместо 4094 VLAN. Порт источника UDP выбран как носитель энтропии сознательно: RFC 7348 рекомендует вычислять его по хешу полей внутреннего кадра и брать из диапазона динамических портов 49152–65535 6. Тогда ECMP подложки, хеширующий пятёрку внешнего заголовка, распределит разные внутренние потоки между двумя VTEP по разным путям, хотя адреса VTEP у них одинаковы. Linux по умолчанию берёт порт источника из диапазона эфемерных портов ядра; диапазон можно задать параметром srcport при создании интерфейса. Рисунок ниже показывает структуру пакета и его длины.
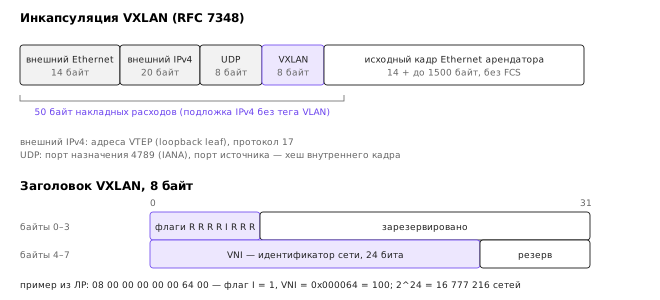
Накладные расходы инкапсуляции — 14 + 20 + 8 + 8 = 50 байт при подложке IPv4 без тега VLAN (с подложкой IPv6 — 70 байт). Отсюда задача о MTU. Пусть арендатор использует обычный Ethernet с MTU 1500 байт. Внутренний кадр без FCS занимает 1500 + 14 = 1514 байт, к нему добавляются заголовки VXLAN (8), UDP (8) и внешний IP (20), и внешний IP-пакет имеет длину 1550 байт. Значит, MTU подложки должно быть не меньше 1550 байт, а внешний кадр в канале занимает 1564 байта плюс FCS. RFC 7348 запрещает VTEP фрагментировать пакеты VXLAN 6, поэтому подложку настраивают с запасом — обычно на MTU 9000 или 9216 байт («джамбо-кадры»). Если же подложка имеет MTU 1500, MTU сетей арендаторов приходится уменьшить до 1450 байт; именно такое значение Linux по умолчанию присваивает интерфейсу VXLAN, созданному с указанием нижележащего интерфейса.
Заголовок VXLAN, снятый в лабораторной работе программным анализатором с канала между leaf и spine, выглядит так (кадр 148 байт: внутренний кадр эхо-запроса 98 байт плюс 50 байт инкапсуляции):
внешний IP: 10.0.0.11 -> 10.0.0.13   UDP: 48128 -> 4789
заголовок VXLAN: 08 00 00 00 00 00 64 00
внутренний кадр: 02:aa:00:00:00:13 <- 02:aa:00:00:00:11, тип 0x0800
Первый байт 08 — флаги с установленным битом I, следующие три байта зарезервированы, затем три байта 00 00 64 — VNI, равный 100, и последний зарезервированный байт. Внутри — исходный кадр арендатора с его собственными MAC-адресами, о которых подложка ничего не знает.
VTEP, рассылка BUM-трафика и обучение адресов
VTEP ведёт себя как порт виртуального коммутатора, растянутого на всю фабрику. Чтобы отправить кадр, ему нужно знать, за каким удалённым VTEP находится MAC-адрес назначения. В простейшей реализации, описанной в RFC 7348, VTEP обучается так же, как обычный коммутатор (тема 4): получив из туннеля кадр с MAC-адресом источника X от VTEP с адресом Y, он запоминает соответствие «X находится за Y». Кадры, для которых соответствие неизвестно, а также широковещательные и групповые кадры — их вместе называют BUM-трафиком (англ. broadcast, unknown unicast, multicast) — нужно доставить всем VTEP данного VNI. RFC 7348 предлагает для этого групповую рассылку IP в подложке: каждому VNI сопоставляется групповой адрес, и VTEP отправляет BUM-кадры на этот адрес 6. Групповая маршрутизация в подложке ЦОД, однако, сложна в эксплуатации, и на практике чаще применяется репликация на головном узле (англ. head-end replication, или ingress replication): VTEP хранит список всех остальных VTEP данного VNI и отправляет каждому отдельную копию.
В Linux интерфейс VXLAN подключается к программному мосту, и мост вместе с таблицей пересылки интерфейса VXLAN реализует обе части механизма. Список удалённых VTEP для репликации задаётся записями с нулевым MAC-адресом, а адреса, изученные из туннеля, появляются в таблице с указанием VTEP:
ip link add vxlan100 type vxlan id 100 local 10.0.0.11 dstport 4789
ip link set vxlan100 master br100 up
bridge fdb append 00:00:00:00:00:00 dev vxlan100 dst 10.0.0.12
bridge fdb append 00:00:00:00:00:00 dev vxlan100 dst 10.0.0.13
bridge fdb show dev vxlan100
00:00:00:00:00:00 dst 10.0.0.12 self permanent
00:00:00:00:00:00 dst 10.0.0.13 self permanent
02:aa:00:00:00:13 dst 10.0.0.13 self
02:aa:00:00:00:12 dst 10.0.0.12 self
Первые две строки заданы вручную, последние две изучены после обмена эхо-запросами. Обучение по данным (англ. flood and learn) работает, но имеет те же недостатки, что и в обычном Ethernet, умноженные на размер фабрики: каждый неизвестный адрес и каждый запрос ARP копируется на все VTEP сегмента, изученные записи устаревают и требуют повторной рассылки, а список VTEP на каждом узле нужно поддерживать вручную или внешней системой.
EVPN как плоскость управления
Ethernet VPN (EVPN) заменяет обучение по данным обучением через плоскость управления (англ. control plane learning). EVPN определён в RFC 7432 как расширение BGP — новое семейство адресов, в котором маршрутами являются не IP-префиксы, а MAC-адреса и связанные с ними сведения 7. Изначально стандарт описывал работу поверх MPLS; RFC 8365 переносит его на оверлеи ЦОД, прежде всего VXLAN, причём VNI передаётся в поле, предназначенном для метки MPLS 8.
Идея такова. Когда VTEP узнаёт о локальном хосте — по первому кадру из порта сервера или от системы виртуализации, — он анонсирует по BGP маршрут типа 2 (англ. MAC/IP Advertisement): «MAC-адрес X с IP-адресом x в VNI 100 доступен через VTEP 10.0.0.11». Все остальные VTEP этого VNI получают маршрут и заранее заполняют таблицы пересылки; неизвестных адресов почти не остаётся. Маршрут типа 3 (англ. Inclusive Multicast Ethernet Tag) объявляет, что VTEP участвует в данном VNI, — из этих маршрутов автоматически строится список репликации BUM-трафика. Маршруты типов 1 и 4 обслуживают многоадресное подключение (англ. multihoming): сервер подключается к двум leaf одновременно, и оба leaf объявляют общий идентификатор сегмента Ethernet (англ. Ethernet Segment Identifier, ESI), что позволяет использовать оба канала активно без связующего дерева 7. Поскольку VTEP заранее знает соответствие IP- и MAC-адресов удалённых хостов, он может сам отвечать на локальные запросы ARP (англ. ARP suppression), и широковещательные запросы не уходят в фабрику.
Таким образом, в современном ЦОД работают два экземпляра BGP с разными задачами: eBGP подложки по схеме RFC 7938 распространяет адреса loopback VTEP, а BGP EVPN (как правило, через spine, выступающие отражателями маршрутов или просто передающие маршруты по eBGP) распространяет MAC- и IP-адреса арендаторов. Для учебных целей достаточно понимать разделение ролей; конфигурация EVPN выходит за рамки курса.
Виртуальная сеть в Linux и сети контейнеров
Пара veth, мост, macvlan и ipvlan
Сервер виртуализации и узел с контейнерами содержат внутри себя целую сеть. В Linux она строится из нескольких типов виртуальных интерфейсов, которые уже использовались в лабораторных работах курса и теперь рассматриваются систематически.
Сетевое пространство имён (англ. network namespace) — изолированный экземпляр сетевого стека ядра со своими интерфейсами, таблицами маршрутизации, правилами netfilter и сокетами. Контейнер в сетевом отношении — это процесс в отдельном пространстве имён. Пара veth (англ. virtual Ethernet) — два интерфейса, соединённых «виртуальным кабелем»: кадр, переданный в один, принимается другим. Концы пары можно поместить в разные пространства имён, связав, например, контейнер с хостом. Мост (англ. bridge) — программный коммутатор Ethernet в ядре с обучением MAC-адресов, поддержкой VLAN и, при необходимости, связующего дерева (тема 5). Пара veth, один конец которой находится в контейнере, а другой подключён к мосту хоста, — основной способ подключения контейнеров.
Интерфейс macvlan создаёт поверх физического интерфейса дочерние интерфейсы с собственными MAC-адресами. Контейнер с интерфейсом macvlan выглядит в физической сети как отдельный хост в той же подсети, без моста и NAT. Особенность режима bridge, которая часто становится неожиданностью: дочерние интерфейсы видят друг друга, но не видят сам хост через родительский интерфейс. Интерфейс ipvlan похож на macvlan, но все дочерние интерфейсы используют MAC-адрес родителя, а различаются только IP-адресами; это нужно там, где коммутатор доступа ограничивает число MAC-адресов на порту или облачная сеть пропускает только известный MAC. В режиме L3 ipvlan маршрутизирует пакеты между дочерними интерфейсами, а не коммутирует кадры.
| Механизм | Уровень | Как контейнер выглядит снаружи | Типичное применение |
|---|---|---|---|
| veth + мост + NAT | 2 и 3 | адрес хоста (через NAT) | Docker по умолчанию |
| veth + маршрутизация | 3 | отдельный маршрутизируемый адрес | Kubernetes с маршрутизирующими CNI |
| macvlan | 2 | отдельный хост со своим MAC | контейнер в подсети офиса |
| ipvlan | 2 или 3 | отдельный IP с MAC хоста | ограничение числа MAC на порту |
| VXLAN + мост | 2 поверх 3 | хост в сети арендатора | оверлей между узлами |
VRF: несколько таблиц маршрутизации на одном узле
Изоляция арендаторов на сетевом уровне требует, чтобы один маршрутизатор держал несколько независимых таблиц маршрутизации. Виртуальный экземпляр маршрутизации и пересылки (англ. Virtual Routing and Forwarding, VRF) — именно такая таблица вместе с набором интерфейсов, к ней привязанных. Пакет, пришедший на интерфейс VRF, ищется только в таблице этой VRF; поэтому у двух арендаторов могут быть одинаковые подсети, и они не конфликтуют. В сетях провайдеров VRF — основа L3VPN (тема 19), в ЦОД — основа маршрутизации между сетями одного арендатора и изоляции разных арендаторов на leaf.
В Linux VRF реализована как специальное сетевое устройство, связанное с отдельной таблицей маршрутизации 13. Интерфейс включается в VRF так же, как порт в мост, — командой ip link set ... master, и его подключённые маршруты переезжают в таблицу VRF:
ip link add vrf-a type vrf table 10
ip link set vrf-a up
ip link set br100 master vrf-a
ip addr add 192.168.10.1/24 dev br100
ip route show vrf vrf-a
192.168.10.0/24 dev br100 proto kernel scope link src 192.168.10.1
192.168.110.0/24 dev p-ad proto kernel scope link src 192.168.110.1
В лабораторной работе на одном leaf созданы две VRF с одинаковым адресом шлюза 192.168.10.1/24 и одинаковой подсетью серверов 192.168.110.0/24. Хост арендатора A с адресом 192.168.10.11 достигает своего сервера 192.168.110.10, а хост арендатора B с тем же адресом — своего сервера с тем же адресом, и ни один не видит чужую сеть. В отличие от отдельного пространства имён на каждого арендатора, VRF оставляет один сетевой стек: один процесс маршрутизации (например, FRRouting) обслуживает все VRF, а сокет можно привязать к конкретной VRF. Следует помнить, что VRF изолирует таблицы маршрутизации, но не заменяет межсетевой экран: пакет можно намеренно направить из одной VRF в другую маршрутом с указанием чужой VRF, и такая утечка маршрутов (англ. route leaking) иногда используется для общих сервисов.
Сеть контейнеров Docker
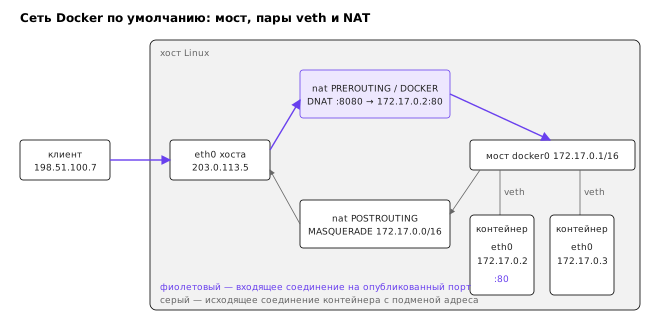
Сеть Docker по умолчанию — прямое применение рассмотренных механизмов вместе с NAT из темы 14. Демон создаёт мост docker0 с адресом 172.17.0.1/16. Для каждого контейнера создаётся пространство имён и пара veth: один конец становится интерфейсом eth0 контейнера с адресом из 172.17.0.0/16, другой подключается к мосту. Шлюз по умолчанию контейнера — адрес моста. Исходящие соединения контейнеров транслируются правилом маскарадинга в цепочке POSTROUTING, поэтому снаружи они выглядят как соединения хоста. Публикация порта (docker run -p 8080:80) создаёт правило DNAT: соединения на порт 8080 хоста перенаправляются на порт 80 контейнера; дополнительно для соединений с самого хоста может работать вспомогательный процесс docker-proxy. Схема на рисунке ниже показывает путь пакета от клиента к опубликованному порту.
# фрагмент таблицы nat на хосте с контейнером, опубликовавшим порт 8080 -> 80
-A POSTROUTING -s 172.17.0.0/16 ! -o docker0 -j MASQUERADE
-A DOCKER ! -i docker0 -p tcp -m tcp --dport 8080 -j DNAT --to-destination 172.17.0.2:80
Из устройства следует несколько практических выводов. Контейнеры одного хоста общаются через мост напрямую, без NAT. Контейнеры разных хостов в такой схеме друг друга по внутренним адресам не видят: каждому хосту выдана одна и та же сеть 172.17.0.0/16. Опубликованный порт обходит правила межсетевого экрана, добавленные пользователем в цепочку INPUT, поскольку трафик после DNAT идёт через цепочку FORWARD, — частая причина неожиданно открытых наружу служб. Для многоузловых сетей Docker использует оверлей на основе VXLAN (драйвер overlay), а для подключения контейнера напрямую к физической сети — драйверы macvlan и ipvlan. Подробнее контейнеры рассматриваются в курсе «Облачные технологии».
Сеть Kubernetes
Kubernetes — система оркестрации контейнеров, распределяющая группы контейнеров (под, англ. pod) по узлам кластера. Её сетевая модель сформулирована как набор требований 14: каждый под получает собственный IP-адрес, уникальный в кластере; поды на любых узлах общаются друг с другом по этим адресам без NAT; агенты на узле могут обращаться ко всем подам этого узла. Модель снимает главный недостаток схемы Docker по умолчанию: приложение не должно знать, на каком узле работает собеседник, и не должно иметь дело с трансляцией портов.
Сама система Kubernetes модель не реализует, а поручает это подключаемому модулю по стандартному интерфейсу CNI (англ. Container Network Interface): при создании пода среда исполнения вызывает модуль, и тот создаёт интерфейс, назначает адрес и прокладывает маршруты. Разные модули реализуют модель по-разному: оверлеем VXLAN между узлами, маршрутизацией без оверлея с анонсом сетей подов по BGP в фабрику ЦОД (то есть та же схема, что и в разделе о BGP, только листом становится сервер) или программами eBPF в ядре.
Поды эфемерны: при перезапуске они получают новые адреса. Поэтому клиенты обращаются не к подам, а к службе (англ. Service) — объекту с постоянным виртуальным адресом (англ. ClusterIP) и именем в DNS кластера. Виртуальный адрес не принадлежит ни одному интерфейсу. Компонент kube-proxy на каждом узле превращает его в правила DNAT (на основе iptables, IPVS или nftables): соединение к адресу службы перенаправляется на адрес одного из подов, выбранного случайно. Это та же балансировка на транспортном уровне, что и в теме 16, только распределённая по всем узлам кластера. Для входящего HTTP-трафика извне используется объект Ingress (или более новый Gateway API) с контроллером — обратным прокси, который маршрутизирует запросы по имени узла и пути URL. Подробности Kubernetes выходят за рамки курса; существенно, что каждая его сетевая абстракция сводится к уже знакомым механизмам: пространствам имён, парам veth, маршрутизации, туннелям, NAT и прокси.
Программно-определяемые сети и балансировка нагрузки
Разделение плоскостей и OpenFlow
В маршрутизаторе с самого начала курса различались две функции. Плоскость управления (англ. control plane) решает, куда должны идти пакеты: обменивается сообщениями протоколов маршрутизации, вычисляет пути и заполняет таблицы. Плоскость данных (англ. data plane, forwarding plane) пересылает каждый пакет по готовым таблицам, и в аппаратном коммутаторе выполняется специализированной микросхемой. Иногда выделяют и третью — плоскость администрирования (англ. management plane): настройку и мониторинг устройства. В традиционной сети плоскости управления и данных находятся в одном корпусе, и каждое устройство принимает решения самостоятельно, договариваясь с соседями по распределённым протоколам.
Программно-определяемая сеть (англ. Software-Defined Networking, SDN) отделяет плоскость управления от устройств и переносит её в логически централизованный контроллер. Коммутатор оставляет за собой лишь пересылку по таблицам, которые контроллер записывает через открытый протокол. Первым таким протоколом стал OpenFlow, предложенный в 2008 году группой исследователей во главе с Н. Маккеоном как способ ставить эксперименты с новыми протоколами в кампусной сети, не дожидаясь, пока производители реализуют их в оборудовании 9. Коммутатор OpenFlow содержит таблицу потоков (англ. flow table). Каждая запись таблицы состоит из условия соответствия на поля заголовков (порт входа, MAC-адреса, тип Ethernet, VLAN, IP-адреса, протокол, порты транспортного уровня), действия (переслать в порт, отправить контроллеру, отбросить, изменить поле) и счётчиков. Пакет, не нашедший соответствия, передаётся контроллеру, который решает, что с ним делать, и при необходимости устанавливает новую запись.
условие соответствия                                   действие            счётчик
in_port=1, eth_type=0x0800, ip_dst=10.0.2.0/24         output:3            1520 пакетов
eth_type=0x0806                                        output:CONTROLLER    12 пакетов
ip_dst=10.0.9.9, tcp_dst=22                            drop                 3 пакета
Централизация даёт контроллеру полную картину сети и позволяет реализовать политики, неудобные для распределённых протоколов: маршрутизацию с учётом загрузки всех каналов, изоляцию арендаторов, мгновенное изменение правил по событию. Ценой становятся задержка обращения к контроллеру и необходимость сделать сам контроллер отказоустойчивым и масштабируемым. Поэтому в чистом виде, с реакцией контроллера на каждый новый поток, SDN почти не используется; на практике контроллер работает проактивно, заранее вычисляя таблицы. Идеи SDN нашли широкое применение в ЦОД крупных операторов (фабрика Jupiter управляется централизованно 3), в виртуальных коммутаторах серверов виртуализации и в глобальных сетях между ЦОД.
Программируемые коммутаторы и P4
OpenFlow задаёт фиксированный набор полей, которые коммутатор умеет разбирать. Каждый новый заголовок, например VXLAN, требовал новой версии протокола и новой микросхемы. Следующий шаг — сделать программируемой саму плоскость данных. Язык P4 (англ. Programming Protocol-independent Packet Processors), предложенный в 2014 году, описывает, какие заголовки коммутатор разбирает, какие таблицы «условие — действие» применяет и в каком порядке, а компилятор отображает программу на конвейер программируемой микросхемы или на программный коммутатор 10. Программа P4 может разбирать собственный формат заголовка, собирать телеметрию прямо в пакеты, проходящие через коммутатор (тема 22), или выполнять функции, прежде доступные лишь серверам, — например, балансировку нагрузки на скорости линии. Важна сама идея: граница между «аппаратной» сетью и «программной» в ЦОД размыта, и поведение коммутатора всё чаще определяет программа, написанная оператором, а не производителем.
Балансировка нагрузки в ЦОД: anycast, ECMP и Maglev
Сервис крупного масштаба обслуживается тысячами серверов, а клиенты обращаются к нему по одному виртуальному адресу (англ. Virtual IP, VIP). Распределение соединений по серверам — задача балансировщика нагрузки (тема 16). Аппаратный балансировщик в виде пары устройств «активный — резервный» плохо масштабируется: его ёмкость ограничена, а резервное устройство простаивает. В ЦОД балансировку строят из уже рассмотренных механизмов, и работа о балансировщике Maglev, применяемом в Google с 2008 года, показывает, как они складываются 11.
Первый уровень — anycast и ECMP. Несколько машин-балансировщиков анонсируют по BGP один и тот же VIP. Маршрутизатор перед ними получает несколько равноценных маршрутов к VIP и распределяет пакеты по машинам хешированием пятёрки, то есть ECMP. Добавление балансировщика сводится к ещё одному анонсу, а отказ — к отзыву маршрута. Второй уровень — сами машины Maglev, обычные серверы Linux, обрабатывающие пакеты в обход сетевого стека ядра. Каждая машина выбирает для соединения сервер (англ. backend) и пересылает ему пакет, упакованный в GRE; сервер отвечает клиенту напрямую, минуя балансировщик (англ. direct server return), поэтому через Maglev проходит только входящий трафик, который обычно в разы меньше исходящего. По данным авторов, одна машина Maglev способна загрузить канал 10 Гбит/с пакетами малого размера 11.
Главная трудность в том, что пакеты одного соединения могут приходить на разные машины Maglev: при изменении набора балансировщиков ECMP маршрутизатора перераспределяет потоки. Если каждая машина выбирает сервер независимо, соединение разорвётся. Maglev решает задачу двумя средствами: таблицей отслеживания соединений на каждой машине и согласованным хешированием (англ. consistent hashing). Каждая машина строит из списка серверов таблицу поиска (англ. lookup table) размером M — простое число, например 65 537, — по одному и тому же детерминированному алгоритму: каждый сервер заполняет свободные ячейки в порядке своей псевдослучайной перестановки по очереди с остальными. Таблица у всех машин получается одинаковой, поэтому соединение, попавшее на другую машину, будет направлено на тот же сервер. Каждый сервер получает почти равную долю ячеек, а при удалении одного сервера меняется лишь небольшая часть ячеек помимо принадлежавших ему 11. Этот приём — общий для распределённых систем: вместо разделяемого состояния все узлы независимо вычисляют одинаковый результат из одинаковых входных данных.
Ускорение обработки пакетов: offload, SR-IOV, DPDK и XDP
Программная сеть на серверах упирается в производительность. При скорости 100 Гбит/с и минимальных кадрах Ethernet (64 байта плюс 20 байт преамбулы и межкадрового интервала) поступает около 148,8 миллиона кадров в секунду, то есть на обработку одного кадра остаётся менее 7 наносекунд, — заметно меньше времени одного промаха кеша процессора. Обычный путь пакета через сетевой стек ядра со всеми прерываниями, выделениями памяти и копированиями для этого слишком длинен. Существует несколько способов его сократить, и они дополняют друг друга.
Перенос работы в сетевую карту (англ. offload) — самый старый способ. Карта сама вычисляет контрольные суммы, режет большой буфер TCP на сегменты размером MSS (англ. TCP Segmentation Offload, TSO) и склеивает принятые сегменты одного потока обратно (англ. Generic/Large Receive Offload, GRO/LRO); современные карты умеют то же для пакетов VXLAN. Следствие, знакомое по лабораторным работам: захват на передающем хосте показывает «пакеты» длиной 64 КиБ и неверные контрольные суммы, потому что программа захвата видит данные до того, как с ними поработала карта. Отключить эти функции для наблюдения можно командой ethtool -K.
Виртуализация ввода-вывода с одним корнем (англ. Single Root I/O Virtualization, SR-IOV) позволяет одной физической карте представиться системе несколькими виртуальными функциями PCI Express (англ. virtual function, VF), каждую из которых можно напрямую передать виртуальной машине. Пакеты виртуальной машины минуют гипервизор и программный мост, но и все сетевые функции гипервизора — фильтрация, оверлей, учёт — для них перестают работать, если карта не берёт их на себя. Набор библиотек DPDK (англ. Data Plane Development Kit) идёт другим путём: драйвер карты работает в пользовательском пространстве, процессорные ядра непрерывно опрашивают очереди карты (англ. poll mode) без прерываний, а пакеты обрабатываются пачками. DPDK даёт максимальную производительность, но забирает карту у ядра целиком, и приложение должно само реализовать всё, что обычно делает стек.
Быстрый путь данных XDP (англ. eXpress Data Path) — компромисс, встроенный в ядро Linux. Программа на ограниченном подмножестве языка C компилируется в байт-код eBPF, проверяется верификатором ядра на безопасность и вызывается драйвером для каждого пакета ещё до выделения структур сетевого стека. Программа может отбросить пакет (XDP_DROP), передать его стеку (XDP_PASS), отправить обратно в тот же интерфейс (XDP_TX) или перенаправить в другой интерфейс либо сокет (XDP_REDIRECT). На XDP строят фильтры против DDoS-атак, балансировщики нагрузки и быстрые пути для оверлеев, а более широкие возможности eBPF в других точках ядра используют модули CNI для Kubernetes. Отличие от DPDK принципиально: всё, что программа не обработала, продолжает путь через обычный стек ядра со всеми его инструментами.
Итоги темы
Сеть ЦОД оптимизирована под трафик «восток — запад» и требование однородности: любая пара серверов должна получать сопоставимую пропускную способность независимо от расположения. Трёхуровневое дерево с этим не справляется из-за накапливающейся переподписки, заблокированных связующим деревом каналов и предела мощности ядра. Сеть Клоза в форме фабрики leaf-spine заменяет немногие мощные коммутаторы множеством одинаковых, даёт между любыми стойками столько равноценных путей, сколько в фабрике spine, и растёт горизонтально. Степень переподписки становится явным инженерным параметром, который вычисляется из числа и скорости портов.
Многочисленные пути используются благодаря ECMP, распределяющему по путям потоки, а не пакеты: хеш пятёрки сохраняет порядок пакетов внутри соединения, но не спасает от коллизий крупных потоков и требует внимания к полям хеша, поляризации и устойчивости при отказах. Маршрутизация до стойки исключает связующее дерево из фабрики, а eBGP с продуманной схемой номеров AS по RFC 7938 оказывается простым и масштабируемым протоколом для неё.
Физическая фабрика при этом ничего не знает об арендаторах: их сети строятся поверх неё как оверлеи. VXLAN упаковывает кадр Ethernet в UDP с 24-битным идентификатором сети, добавляя 50 байт заголовков, что требует увеличенного MTU подложки, и переносит энтропию внутреннего потока в порт источника UDP для ECMP. EVPN заменяет рассылку и обучение по данным анонсами MAC- и IP-адресов по BGP. Внутри сервера та же логика реализуется пространствами имён, парами veth, мостами, VRF и NAT — из них состоят сети Docker и Kubernetes.
Наконец, сеть ЦОД всё больше становится программой. Контроллер SDN вычисляет таблицы централизованно, P4 делает программируемой плоскость данных, балансировщик Maglev строится из anycast, ECMP и согласованного хеширования на обычных серверах, а XDP и DPDK позволяют обрабатывать на них миллионы пакетов в секунду. Сеть такого масштаба невозможно ни настроить, ни отладить вручную. Как наблюдать за её состоянием, искать неисправности и описывать конфигурацию кодом — предмет заключительной темы 22.
Литература
- Clos C. A Study of Non-Blocking Switching Networks. — Bell System Technical Journal, 1953, Vol. 32, No. 2, С. 406–424, DOI: 10.1002/j.1538-7305.1953.tb01433.x.
- Al-Fares M., Loukissas A., Vahdat A. A Scalable, Commodity Data Center Network Architecture. — Proceedings of ACM SIGCOMM 2008, 2008, С. 63–74, DOI: 10.1145/1402958.1402967.
- Singh A., Ong J., Agarwal A. et al. Jupiter Rising: A Decade of Clos Topologies and Centralized Control in Google's Datacenter Network. — Proceedings of ACM SIGCOMM 2015, 2015, С. 183–197, DOI: 10.1145/2785956.2787508.
- Hopps C. Analysis of an Equal-Cost Multi-Path Algorithm. — RFC 2992, IETF, 2000. https://www.rfc-editor.org/rfc/rfc2992
- Lapukhov P., Premji A., Mitchell J. Use of BGP for Routing in Large-Scale Data Centers. — RFC 7938, IETF, 2016. https://www.rfc-editor.org/rfc/rfc7938
- Mahalingam M., Dutt D., Duda K. et al. Virtual eXtensible Local Area Network (VXLAN): A Framework for Overlaying Virtualized Layer 2 Networks over Layer 3 Networks. — RFC 7348, IETF, 2014. https://www.rfc-editor.org/rfc/rfc7348
- Sajassi A., Aggarwal R., Bitar N. et al. BGP MPLS-Based Ethernet VPN. — RFC 7432, IETF, 2015. https://www.rfc-editor.org/rfc/rfc7432
- Sajassi A., Drake J., Bitar N. et al. A Network Virtualization Overlay Solution Using Ethernet VPN (EVPN). — RFC 8365, IETF, 2018. https://www.rfc-editor.org/rfc/rfc8365
- McKeown N., Anderson T., Balakrishnan H. et al. OpenFlow: Enabling Innovation in Campus Networks. — ACM SIGCOMM Computer Communication Review, 2008, Vol. 38, No. 2, С. 69–74, DOI: 10.1145/1355734.1355746.
- Bosshart P., Daly D., Gibb G. et al. P4: Programming Protocol-Independent Packet Processors. — ACM SIGCOMM Computer Communication Review, 2014, Vol. 44, No. 3, С. 87–95, DOI: 10.1145/2656877.2656890.
- Eisenbud D. E., Yi C., Contavalli C. et al. Maglev: A Fast and Reliable Software Network Load Balancer. — Proceedings of the 13th USENIX Symposium on Networked Systems Design and Implementation (NSDI '16), 2016. https://www.usenix.org/conference/nsdi16/technical-sessions/presentation/eisenbud
- The Linux Kernel Documentation. IP Sysctl. — 2025. https://docs.kernel.org/networking/ip-sysctl.html
- The Linux Kernel Documentation. Virtual Routing and Forwarding (VRF). — 2025. https://docs.kernel.org/networking/vrf.html
- Kubernetes Documentation. Cluster Networking. — 2025. https://kubernetes.io/docs/concepts/cluster-administration/networking/