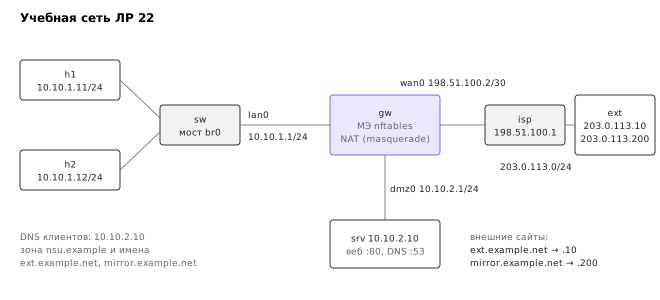
Мониторинг, диагностика и автоматизация сети
Предыдущие двадцать одна тема описывали, как сеть устроена: как кадр проходит коммутатор, как маршрутизатор выбирает путь, как TCP управляет окном, как DNS превращает имя в адрес, как межсетевой экран решает судьбу пакета. Заключительная тема посвящена тому, как с сетью работают в эксплуатации, когда она уже построена. Здесь возникают три вопроса. Как найти причину, если «сайт не открывается», а в цепочке между пользователем и сервером десяток устройств и протоколов? Как узнать о проблеме раньше пользователя и количественно оценить, хорошо ли работает сеть? Как изменять конфигурацию сотен устройств так, чтобы изменения были воспроизводимы, проверяемы и не порождали новых неисправностей?
Тема интегрирующая: новых протоколов в ней почти нет, а инструменты и механизмы предыдущих тем собираются в систему. Первый раздел излагает методологию поиска неисправностей — способ рассуждения, который превращает перебор команд в последовательную проверку гипотез. Второй систематизирует инструменты диагностики и показывает на подробном примере, как они дополняют друг друга. Третий раздел посвящён мониторингу: какие показатели измерять, как определять уровень обслуживания и какими средствами собирать данные — от SNMP и NetFlow до Prometheus и потоковой телеметрии. Четвёртый описывает автоматизацию: инфраструктуру как код, модели данных YANG и протоколы NETCONF, RESTCONF и gNMI. Завершает тему краткий раздел о планировании ёмкости и соглашениях об уровне обслуживания.
Методология поиска неисправностей
Неисправность как гипотеза
Поиск неисправности в сети — частный случай экспериментального метода. Наблюдается симптом: пользователь сообщает, что «не открывается портал». Симптом не совпадает с причиной, и одному симптому соответствует множество возможных причин: неверный адрес шлюза, ошибка в записи DNS, правило межсетевого экрана, остановленный сервер, переполненный диск сервера. Задача инженера — сузить множество причин до одной, выполняя проверки, каждая из которых исключает как можно больше вариантов, и затем подтвердить найденную причину тем, что её устранение устраняет симптом.
Отсюда несколько правил, которые кажутся очевидными, но систематически нарушаются. Первое — сначала уточнить симптом. Жалоба «не работает Интернет» может означать, что не открывается один сайт, что не открывается ничего, что всё открывается медленно или что не работает только у одного пользователя. Каждая из этих формулировок указывает на разные части сети, и минута, потраченная на вопросы «у кого», «что именно», «с какого момента» и «что изменилось», экономит час проверок. Второе — формулировать гипотезу до проверки и записывать результат. Проверка без гипотезы даёт данные, которые не с чем сравнить, а незаписанные проверки повторяются по кругу. Третье — изменять одну вещь за раз. Если одновременно перезапустить службу, поправить маршрут и очистить кеш, то при исчезновении симптома останется неизвестным, что именно помогло, и неисправность вернётся. Четвёртое — отличать отсутствие доказательства от доказательства отсутствия: если ping до сервера не проходит, это не значит, что сервер недоступен, — эхо-запросы могут фильтроваться, тогда как TCP-соединения проходят.
Полезно сравнивать неисправный случай с исправным. Если у пользователя h1 всё работает, а у h2 нет, причина почти наверняка в том, чем они различаются, — в настройках узла h2 или в его участке сети, — а общие для них элементы (шлюз, DNS-сервер, канал к провайдеру) можно на время исключить. Этот приём сравнения с эталоном (англ. known good) столь же полезен для конфигураций: разность конфигурации неисправного устройства с конфигурацией исправного или с сохранённой копией часто прямо указывает на причину.
Стратегии поиска
Сетевая модель из темы 2 подсказывает несколько упорядоченных стратегий, каждая из которых задаёт порядок проверок. Рисунок ниже сопоставляет их.
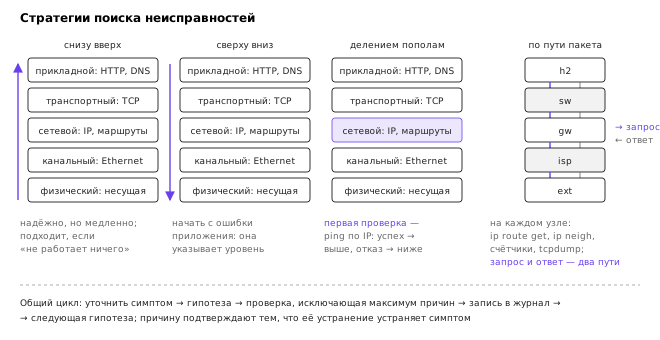
Стратегия «снизу вверх» (англ. bottom-up) начинает с физического уровня: есть ли несущая на интерфейсе, нет ли ошибок приёма, затем — настроен ли адрес, известен ли MAC-адрес шлюза, есть ли маршрут, устанавливается ли TCP-соединение, отвечает ли приложение. Она надёжна и подходит, когда симптом общий («ничего не работает») или когда есть подозрение на оборудование, но медленна: при исправных нижних уровнях много времени тратится на подтверждение очевидного. Стратегия «сверху вниз» (англ. top-down) начинает с приложения: что именно сообщает браузер или curl, какая ошибка — отказ в соединении, тайм-аут, ошибка разрешения имени, код HTTP 502. Ошибка приложения часто сразу указывает уровень, на котором искать: «Could not resolve host» — DNS, «Connection refused» — служба не слушает порт или соединение отвергнуто правилом с отправкой RST, тайм-аут — пакеты теряются по пути.
Стратегия «разделяй и властвуй» (англ. divide and conquer) начинает с середины: проверяется уровень, который делит пространство причин пополам, обычно сетевой, командой ping по IP-адресу. Если эхо-запрос по адресу проходит, нижние уровни и маршрутизация исправны, и поиск продолжается выше; если нет — ниже. По тому же принципу делится и путь: если до шлюза пакеты доходят, а до сервера нет, неисправность находится между шлюзом и сервером. Этот принцип двоичного поиска даёт наименьшее число проверок, когда о причине ничего не известно.
Стратегия «по пути пакета» (англ. follow the path) отслеживает пакет от источника к назначению и обратно, проверяя на каждом узле, пришёл ли пакет, куда он отправлен и почему. На каждом узле задаются одни и те же вопросы: какой маршрут выбран (ip route get), известен ли адрес следующего перехода (ip neigh), что делает с пакетом межсетевой экран (счётчики правил), видит ли пакет захват на входном и выходном интерфейсах. Стратегия трудоёмка, но незаменима для неисправностей, затрагивающих одно направление: асимметричной маршрутизации, неверного обратного маршрута, фильтрации ответов. Важно помнить, что путь — это два пути: запрос и ответ могут идти разными маршрутами, и ответ, потерянный на обратном пути, выглядит для отправителя точно так же, как потерянный запрос.
На практике стратегии комбинируют. Симптом уточняется сверху (ошибка приложения), затем делением пополам определяется участок и уровень, и уже на этом участке пакет прослеживается по пути с захватом трафика.
Документация сети и базовая линия
Методология работает лишь тогда, когда известно, как сеть должна работать. Документация сети включает схему физических и логических связей, адресный план, описание VLAN и подсетей, таблицы маршрутизации ключевых узлов, политики межсетевых экранов и перечень служб с их зависимостями. Последнее часто упускают: чтобы найти причину недоступности сайта, нужно знать, что он зависит от DNS-сервера, базы данных и внешнего платёжного шлюза. Документация, которая не соответствует действительности, вреднее её отсутствия, поэтому в современных сетях её стремятся получать автоматически — из той же системы, которая формирует конфигурации (раздел об автоматизации).
Вторая опора — базовая линия (англ. baseline): измеренные значения показателей в нормальном состоянии. Утверждение «задержка до сервера 40 мс» само по себе ничего не говорит; оно становится симптомом, если обычно задержка 2 мс. То же относится к загрузке каналов, числу ошибок на интерфейсах, числу записей в таблице отслеживания соединений, времени ответа DNS. Базовую линию дают системы мониторинга, о которых пойдёт речь в третьем разделе: без истории показателей невозможно ответить на вопрос «с какого момента» и «что изменилось».
Инструменты диагностики
Связность и путь: ping, tracepath и mtr
Основные инструменты курса были введены в соответствующих темах; здесь они рассматриваются с точки зрения вопроса, на который каждый отвечает. Сводка приведена в таблице.
| Вопрос | Инструмент | Тема |
|---|---|---|
| Есть ли несущая, ошибки, скорость интерфейса | ip -s link, ethtool, ethtool -S | 3, 4 |
| Какие адреса и маршруты, какой путь выбран | ip addr, ip route, ip route get | 6, 8 |
| Известен ли MAC-адрес соседа | ip neigh | 7 |
| Доходят ли пакеты, какова задержка | ping, mtr | 1, 7 |
| Через какие узлы идёт путь, каков PMTU | tracepath, traceroute, mtr | 7, 8 |
| Какие сокеты открыты, состояние TCP | ss -tanp, ss -ti | 12, 13 |
| Счётчики протоколов ядра | nstat, netstat -s | 7, 12, 13 |
| Что происходит в проводе | tcpdump, Wireshark | все |
| Разрешается ли имя и каким сервером | dig, getent hosts | 15 |
| Отвечает ли приложение и за сколько | curl -v, curl -w | 16 |
| Какие порты открыты и что фильтруется | nmap, nc -zv | 18 |
| Что делает межсетевой экран и NAT | nft list ruleset со счётчиками, conntrack -L | 14, 18 |
| Где ядро отбросило пакет | dropwatch, perf trace, nstat | 22 |
Утилита ping отправляет эхо-запросы ICMP и показывает потери и время кругового обхода. Её достоинство — простота и универсальность, недостаток — она проверяет только ICMP: межсетевой экран может пропускать эхо-запросы и отбрасывать TCP или наоборот. Утилиты traceroute и tracepath определяют путь, отправляя пакеты с последовательно увеличивающимся TTL и собирая сообщения ICMP «Time exceeded» от маршрутизаторов (тема 7); tracepath попутно определяет MTU пути. Утилита mtr объединяет оба подхода: непрерывно трассирует путь и накапливает для каждого перехода статистику потерь и задержек.
mtr -n -r -c 5 203.0.113.10 # в пространстве имён h1 исправной сети ЛР 22
HOST: lab                         Loss%   Snt   Last   Avg  Best  Wrst StDev
  1.|-- 10.10.1.1                  0.0%     5    0.1   0.1   0.1   0.1   0.0
  2.|-- 198.51.100.1               0.0%     5    0.1   0.1   0.1   0.1   0.0
  3.|-- 203.0.113.10               0.0%     5    0.1   0.1   0.1   0.1   0.0
Чтение вывода mtr требует осторожности. Потери на промежуточном переходе при их отсутствии на последнем означают лишь то, что этот маршрутизатор ограничивает частоту генерации ICMP-сообщений: пересылка пакетов на быстром пути и ответ на пакет с истёкшим TTL — разные операции, и вторая часто имеет низкий приоритет. О реальной потере говорят потери, начинающиеся на некотором переходе и сохраняющиеся до конца пути. Точно так же рост задержки на промежуточном переходе без роста на последующих — задержка генерации ответа, а не очереди на пути. Если же трассировка обрывается — после некоторого перехода только ??? или no reply, — пакеты дальше этого узла не уходят или ответы не возвращаются; именно так выглядит забытый маршрут в чёрную дыру, разбираемый в лабораторной работе.
Состояние узла: ip, ss, nstat, ethtool и conntrack
Команды iproute2 отвечают на вопросы о конфигурации узла. Особенно полезна ip route get: она показывает не таблицу целиком, а решение, которое ядро примет для конкретного адреса назначения, с учётом правил политики маршрутизации, VRF и кеша PMTU.
ip route get 203.0.113.10 # на шлюзе gw с «забытым» маршрутом
203.0.113.10 via 10.10.2.10 dev dmz0 src 10.10.2.1 uid 0
    cache
Утилита ss выводит сокеты, а с ключом -i — внутреннее состояние TCP: окно перегрузки, оценку RTT, MSS, PMTU, число повторных передач. Это прямое окно в механизмы темы 13. Утилита nstat выводит счётчики протоколов ядра (те же, что netstat -s, но в машиночитаемом виде и с разностью от предыдущего вызова): число отправленных сообщений ICMP «Destination unreachable», отказов фрагментации, пакетов UDP на закрытые порты, повторных передач TCP. Сравнение счётчиков до и после воспроизведения проблемы часто сразу указывает механизм. Утилита ethtool показывает параметры физического канала — скорость, дуплекс, состояние автосогласования — и расширенную статистику драйвера (ethtool -S): ошибки CRC, переполнения очередей приёма, отбросы из-за нехватки буферов. Ошибки CRC указывают на кабель или трансивер, отбросы rx_missed — на нехватку производительности.
На узлах с NAT и межсетевым экраном отдельный источник неисправностей — таблица отслеживания соединений (тема 18). Утилита conntrack -L выводит записи таблицы, conntrack -S — статистику, в том числе счётчики drop и insert_failed. Если таблица заполнена до предела net.netfilter.nf_conntrack_max, ядро отбрасывает новые соединения, а в журнал ядра записывается сообщение «nf_conntrack: table full, dropping packet». Симптом — случайные отказы новых соединений при исправных старых — легко принять за перегрузку сервера.
Наблюдение трафика и проверка служб
Захват трафика — окончательный аргумент в споре о том, что происходит в сети: он показывает не то, что должно было произойти по конфигурации, а то, что произошло. Основной приём — захват в двух точках пути. Если пакет виден на входном интерфейсе маршрутизатора и не виден на выходном, причина на маршрутизаторе; если запрос виден на сервере, а ответа нет, причина на сервере или в его обратном маршруте. Фильтры захвата следует делать узкими, чтобы видеть только исследуемый обмен: tcpdump -ni eth0 host 10.10.2.10 and tcp port 80. В захвате ищут не только наличие пакетов, но и их признаки: флаги TCP (повторные SYN — нет ответа, RST — отказ), сообщения ICMP (недостижимость, необходимость фрагментации), повторные передачи данных и их размер.
Утилита curl с ключом -w раскладывает время запроса по этапам — разрешение имени, установление TCP-соединения, рукопожатие TLS, получение первого байта ответа, загрузка полностью — и тем самым показывает, на каком этапе возникает задержка:
curl -s -o /dev/null -w 'dns=%{time_namelookup} connect=%{time_connect} ttfb=%{time_starttransfer} total=%{time_total} code=%{http_code} size=%{size_download}\n' http://ext.example.net/
dns=0.000851 connect=0.001026 ttfb=0.005106 total=0.005407 code=200 size=59489
Большое время dns при малом connect указывает на DNS (например, на недоступный первый сервер в списке и ожидание тайм-аута перед обращением ко второму). Большое connect — на сеть или перегруженный сервер. Большое ttfb при быстром соединении — на приложение. Утилита dig проверяет DNS независимо от приложения: какой сервер ответил, с каким кодом, какой адрес и какой TTL вернулся. Полезно сравнивать её результат с getent hosts, который разрешает имя тем же путём, что и приложения, с учётом /etc/hosts и порядка источников в /etc/nsswitch.conf. Наконец, nmap и простая проверка nc -zv адрес порт отвечают на вопрос, открыт ли порт: отказ в соединении означает, что пакет дошёл до узла, но порт закрыт, а тайм-аут — что пакет или ответ где-то отброшен, вероятнее всего межсетевым экраном.
Где ядро отбросило пакет
Если захват показывает, что пакет пришёл на узел и не ушёл с него, остаётся выяснить, где именно в ядре он исчез. Первое средство — счётчики: в правилах nftables с выражением counter видно, сколько пакетов совпало с каждым правилом, а nstat показывает протокольные отбросы. Второе — трассировка. Каждый отбрасываемый пакет в ядре Linux освобождается функцией kfree_skb, и на ней есть точка трассировки skb:kfree_skb. Утилита dropwatch подписывается на эти события и выводит, в какой функции ядра произошёл отброс; perf record -e skb:kfree_skb делает то же средствами профилировщика. Современные ядра сообщают в этой точке ещё и причину отброса (англ. drop reason) — например, NETFILTER_DROP, IP_NOROUTE, NO_SOCKET, — что превращает вопрос «где пропал пакет» в чтение одной строки. Для правил nftables существует и собственная трассировка: правило meta nftrace set 1 помечает пакеты, а nft monitor trace показывает, какие правила каждый из них прошёл.
Разбор примера: чёрная дыра PMTUD
Рассмотрим неисправность, которая хорошо показывает, почему инструменты нужно применять систематически. Жалоба: внешний сайт открывается «бесконечно» и в итоге не загружается, а внутренний портал работает. Проверки «по адресу» дают противоречивую картину: ping до сервера проходит, mtr не показывает потерь, TCP-соединение устанавливается. Утилита curl с ключом -w уточняет симптом:
connect=0.001163 ttfb=0.006340 total=4.000770 code=200 size=0
Соединение установлено за миллисекунду, заголовки ответа с кодом 200 получены, но за четыре секунды не пришло ни одного байта тела, и curl завершился по тайм-ауту. Заметим, что код 200 в выводе обманчив: проверка, которая смотрит только на код ответа, сочла бы сайт исправным. Малый файл с того же сервера загружается. Значит, проходят малые пакеты и не проходят большие — классический признак проблемы с MTU. Эхо-запрос с запретом фрагментации подтверждает гипотезу и даёт значение MTU:
ping -c 1 -M do -s 1472 203.0.113.10
ping -c 1 -M do -s 1372 203.0.113.10
tracepath -n 203.0.113.10
From 10.10.1.1 icmp_seq=1 Frag needed and DF set (mtu = 1400)
1380 bytes from 203.0.113.10: icmp_seq=1 ttl=62 time=0.073 ms
 1?: [LOCALHOST]                      pmtu 1400
 ...
     Resume: pmtu 1400 hops 3 back 3
Канал между шлюзом и провайдером имеет MTU 1400 байт. В исправной сети это не мешало бы: механизм определения MTU пути (англ. Path MTU Discovery, PMTUD) работает так, что маршрутизатор, не способный переслать пакет с флагом DF, отбрасывает его и отправляет источнику сообщение ICMP «Fragmentation needed» с допустимым MTU, а источник уменьшает размер сегментов 11. В направлении от клиента так и происходит: сообщение от шлюза 10.10.1.1 пришло. Но большие пакеты идут от сервера к клиенту, и сообщение должен получить сервер — а его генерирует маршрутизатор провайдера. На сервере ss -ti показывает соединение с pmtu:1500, многократными повторными передачами и экспоненциально растущим тайм-аутом, а счётчики nstat на маршрутизаторе провайдера — что сообщения «Destination unreachable» отправлялись, хотя сервер их не получил. Сообщения отбрасываются фильтром на маршрутизаторе провайдера. Сервер, не получая ни подтверждений, ни сообщений ICMP, раз за разом повторяет передачу сегментов того же размера. Это и есть чёрная дыра PMTUD (англ. PMTUD black hole), описанная ещё в RFC 2923 как одна из типичных проблем TCP 10. Механизм показан на рисунке ниже.
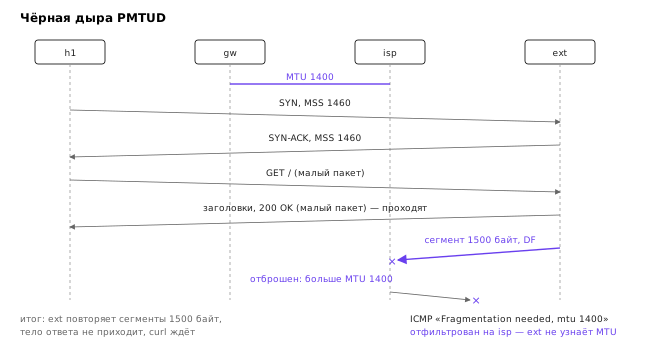
Пример показателен в трёх отношениях. Во-первых, ни одна проверка связности «по умолчанию» (ping, mtr, установление соединения) неисправности не показала, потому что все они используют малые пакеты. Во-вторых, ключом стало уточнение симптома: «заголовки пришли, тело нет» и «малый файл загружается». В-третьих, исправить причину — фильтр у провайдера — организация не может. Обходное решение на своей стороне — ограничение MSS в SYN-сегментах на шлюзе (англ. MSS clamping, тема 19), при котором стороны с самого начала договариваются о сегментах, проходящих через узкий канал; более общее — определение MTU на транспортном уровне без опоры на ICMP (англ. Packetization Layer PMTUD), включаемое в Linux параметром net.ipv4.tcp_mtu_probing 13.
# на gw: ограничить MSS проходящих SYN-сегментов по MTU маршрута
nft add table inet clamp
nft add chain inet clamp fwd '{ type filter hook forward priority mangle; }'
nft add rule inet clamp fwd tcp flags syn tcp option maxseg size set rt mtu
Мониторинг: метрики, SLI и сбор данных
Что измерять: SLI, SLO и золотые сигналы
Мониторинг (англ. monitoring) — непрерывный сбор и анализ показателей работы системы, цель которого — обнаружить проблему раньше пользователя, понять её масштаб и иметь данные для поиска причины и планирования. Показателей сетевого оборудования тысячи, и главный вопрос мониторинга — что из них важно. Практика эксплуатации крупных сервисов, обобщённая в книге Google о Site Reliability Engineering, предлагает начинать с четырёх «золотых сигналов» (англ. golden signals): задержки, объёма трафика, доли ошибок и насыщения, то есть близости ресурса к пределу 1. Для сети они конкретизируются так: задержка — RTT и время ответа служб; трафик — скорость в битах и пакетах в секунду на каналах; ошибки — потери пакетов, ошибки CRC, отбросы в очередях, неудачные запросы DNS и HTTP; насыщение — загрузка каналов, заполнение очередей, таблиц отслеживания соединений, таблиц маршрутизации и MAC-адресов.
Та же книга вводит понятия, позволяющие говорить о качестве количественно 1. Показатель уровня обслуживания (англ. Service Level Indicator, SLI) — измеряемая величина, отражающая то, что важно пользователю: доля успешных HTTP-запросов, доля запросов, обслуженных быстрее 200 мс, доля успешных проверок доступности. Цель уровня обслуживания (англ. Service Level Objective, SLO) — требуемое значение SLI за период: «99,9 % проверок за 30 дней успешны». Соглашение об уровне обслуживания (англ. Service Level Agreement, SLA) — договор с клиентом, фиксирующий цели и последствия их нарушения; о нём речь в последнем разделе.
Задержку не следует описывать средним значением. Распределение задержек асимметрично: большинство запросов быстрые, а небольшая доля — очень медленные, и среднее значение скрывает именно то, что ощущают пользователи. Вместо среднего используют перцентили (англ. percentile): 95-й перцентиль задержки — значение, которое не превышают 95 % измерений. Пусть из 100 проверок 94 заняли 2 мс, а 6 — по 1000 мс из-за повторной передачи потерянного SYN. Среднее равно (94 · 2 + 6 · 1000) / 100 ≈ 62 мс — число, не соответствующее ни одной проверке. Медиана равна 2 мс, а 95-й перцентиль — 1000 мс: он сразу показывает, что каждый двадцатый пользователь ждёт секунду. Сервис, к которому один запрос пользователя порождает сотни внутренних, особенно чувствителен к «хвосту» распределения: вероятность того, что хотя бы один из ста внутренних запросов попадёт в медленный 1 %, равна 1 − 0,99¹⁰⁰ ≈ 63 %.
Активные и пассивные измерения
Активные измерения (англ. active measurements) создают собственный тестовый трафик: эхо-запросы, запросы DNS, HTTP-запросы, синтетические транзакции. Их достоинство — контролируемость: известно, что и когда отправлено, и измерение доступно даже тогда, когда пользователей нет. Их недостаток — они измеряют путь пробного трафика, а не реальный: эхо-запрос ICMP может обрабатываться иначе, чем TCP, и проверка из серверной не покажет проблему, существующую только в филиале. Поэтому проверки запускают из нескольких точек и тем же протоколом, что используют пользователи. Пример инфраструктуры активных измерений масштаба Интернета — RIPE Atlas: тысячи небольших зондов, размещённых добровольцами в сетях по всему миру, выполняют по заданию пользователей ping, traceroute, запросы DNS и HTTP к выбранным целям, позволяя увидеть сеть «снаружи».
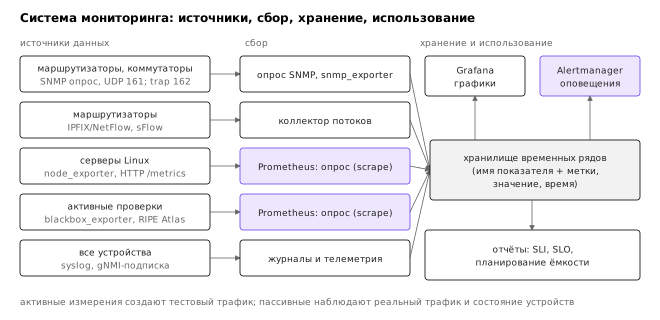
Пассивные измерения (англ. passive measurements) наблюдают реальный трафик и состояние устройств: счётчики интерфейсов, записи о потоках, журналы, время ответа реальных запросов. Они показывают то, что действительно происходит с пользователями, не создают нагрузки, но ничего не говорят о направлениях, по которым трафика нет, и сложнее в интерпретации. Полноценный мониторинг сочетает оба вида: активные проверки отвечают на вопрос «работает ли сервис сейчас», пассивные — «как он работает для реальных пользователей и где узкое место». Схема типичной системы мониторинга приведена на рисунке ниже.
SNMP и базы управляющей информации
Простой протокол управления сетью (англ. Simple Network Management Protocol, SNMP) — исторически основной способ опроса сетевого оборудования. Его архитектура описана в RFC 3411 2. Управляемое устройство содержит агента (англ. agent), который отвечает на запросы менеджера (англ. manager) — системы мониторинга — по UDP на порт 161 и сам отправляет менеджеру уведомления (англ. trap, inform) на порт 162. Данные агента организованы в базы управляющей информации (англ. Management Information Base, MIB) — иерархические описания переменных, каждая из которых имеет числовой идентификатор объекта (англ. Object Identifier, OID). Например, MIB интерфейсов (IF-MIB) определяет для каждого интерфейса его имя, состояние, скорость и счётчики байтов и пакетов 3.
IF-MIB::ifName.2         = STRING: eth0
IF-MIB::ifOperStatus.2   = INTEGER: up(1)
IF-MIB::ifHCInOctets.2   = Counter64: 9183746512     # OID 1.3.6.1.2.1.31.1.1.1.6.2
IF-MIB::ifInErrors.2     = Counter32: 0
Менеджер опрашивает счётчики периодически (типично раз в 1–5 минут) и вычисляет скорость как разность значений, делённую на интервал. Здесь скрыт важный числовой подвох. Счётчик байтов ifInOctets в исходной MIB имеет тип Counter32 и после значения 2³² − 1 возвращается к нулю. При скорости 1 Гбит/с счётчик переполняется за 2³² · 8 / 10⁹ ≈ 34,4 с, при 10 Гбит/с — за 3,4 с. Если опрашивать его раз в 5 минут, между двумя опросами пройдёт несколько неизвестных переполнений, и вычисленная скорость окажется бессмысленной. Поэтому для каналов быстрее 20 Мбит/с IF-MIB предписывает использовать 64-битные счётчики ifHCInOctets и ifHCOutOctets 3; их переполнение при 100 Гбит/с наступит через десятки лет.
SNMP существует в трёх версиях. В SNMPv1 и SNMPv2c доступ защищён лишь «строкой сообщества» (англ. community string), передаваемой открытым текстом, — по сути паролем, видимым в любом захвате; SNMPv3 добавляет аутентификацию и шифрование пользователей. Ограничения протокола — опрос по инициативе менеджера, неэффективная передача больших таблиц, разнородные MIB производителей и не всегда удобные операции записи — привели к тому, что для настройки устройств SNMP почти не используется, а для сбора показателей его постепенно вытесняет потоковая телеметрия. Тем не менее SNMP поддерживает практически любое сетевое устройство, и в большинстве сетей он остаётся основным средством опроса.
Учёт потоков: NetFlow, IPFIX и sFlow
Счётчики интерфейсов показывают, сколько трафика прошло, но не какой. На вопрос «кто загружает канал» отвечает учёт потоков. Маршрутизатор группирует пакеты в записи о потоках по ключу — обычно пятёрке вместе с входным интерфейсом и полем ToS — и для каждой записи считает пакеты и байты, запоминает время начала и конца и флаги TCP. Завершённые или устаревшие записи экспортируются коллектору. Формат, предложенный Cisco под названием NetFlow, был стандартизован IETF как протокол экспорта информации о потоках IP (англ. IP Flow Information Export, IPFIX), описанный в RFC 7011 4. Экспортёр IPFIX сначала передаёт шаблон (англ. template) — список полей и их длин, — а затем записи данных в соответствии с шаблоном; благодаря этому набор полей можно расширять без изменения протокола. Стандартный порт коллектора — 4739.
Альтернативный подход — sFlow (RFC 3176) — не ведёт записи о потоках на устройстве, а отправляет коллектору заголовки каждого N-го пакета вместе с периодическими значениями счётчиков интерфейсов 5. Выборка с частотой 1 из 1000 или 1 из 10 000 почти не нагружает устройство, а статистика больших потоков восстанавливается по выборке с хорошей точностью; малые потоки при этом могут не попасть в выборку вовсе. Выборку применяют и в NetFlow/IPFIX на высокоскоростных каналах. Записи о потоках используют для определения источников нагрузки, обнаружения DDoS-атак и сканирования (тема 18), планирования ёмкости и расчётов с клиентами; их хранение порождает и вопросы конфиденциальности, поскольку записи фиксируют, кто с кем общался.
Prometheus, потоковая телеметрия и журналы
В инфраструктуре серверов и всё чаще в сети стандартом мониторинга стала система Prometheus 12. Её модель отличается от SNMP. Каждая цель — сервер, коммутатор, приложение — или промежуточный экспортёр (англ. exporter) публикует по HTTP страницу /metrics с текущими значениями показателей в простом текстовом формате. Сервер Prometheus периодически опрашивает (англ. scrape) все цели и сохраняет значения как временные ряды (англ. time series), каждый из которых определяется именем показателя и набором меток (англ. labels).
# фрагмент /metrics экспортёра node_exporter
node_network_receive_bytes_total{device="eth0"} 9.183746512e+09
node_network_receive_drop_total{device="eth0"} 12
node_nf_conntrack_entries 18234
node_nf_conntrack_entries_limit 262144
Показатели обрабатываются языком запросов PromQL. Например, скорость приёма в битах в секунду за последние 5 минут вычисляется выражением rate(node_network_receive_bytes_total{device="eth0"}[5m]) * 8 — функция rate сама учитывает сброс счётчиков, — а доля заполнения таблицы отслеживания соединений — отношением двух последних показателей. Экспортёр node_exporter публикует показатели узла Linux, включая сетевые; экспортёр blackbox_exporter выполняет по запросу Prometheus активные проверки — ICMP, TCP, DNS, HTTP — и публикует их результат и длительность по этапам; для оборудования, поддерживающего только SNMP, существует snmp_exporter. Визуализацию обычно выполняет Grafana, а оповещения по правилам, записанным на PromQL (например, «доля успешных проверок за 5 минут ниже 99 %»), рассылает компонент Alertmanager.
Опрос, будь то SNMP или Prometheus, видит состояние только в моменты опроса: всплеск загрузки длительностью 2 с при опросе раз в минуту будет сглажен до незаметности. Потоковая телеметрия (англ. streaming telemetry) переворачивает модель: устройство само отправляет подписчику значения показателей с заданным периодом, вплоть до секунд и долей секунды, или при каждом изменении. Наиболее распространённый протокол — gNMI (англ. gRPC Network Management Interface) на основе gRPC с моделями данных OpenConfig 14; к нему мы вернёмся в разделе об автоматизации. Программируемые коммутаторы (тема 21) позволяют пойти ещё дальше и записывать сведения о задержке в очереди каждого коммутатора прямо в проходящие пакеты (англ. in-band network telemetry).
Третий источник данных — журналы событий. Протокол syslog, описанный в RFC 5424, определяет формат сообщения с источником (англ. facility), уровнем серьёзности от 0 (emerg) до 7 (debug), отметкой времени, именем узла и текстом 6; сообщения традиционно передаются по UDP на порт 514. Журналы сетевых устройств фиксируют то, чего нет в показателях: падения и подъёмы интерфейсов, смену состояния сессий BGP и OSPF, срабатывания правил межсетевого экрана, входы администраторов. Для корреляции событий журналов разных устройств необходима синхронизация времени (NTP): без неё восстановить последовательность событий при аварии невозможно.
Автоматизация и управление конфигурациями
Инфраструктура как код
Сеть из десятков устройств ещё можно настраивать вручную через командную строку каждого устройства. При сотнях и тысячах устройств ручная настройка становится главным источником аварий: по разным оценкам операторов, значительная доля крупных сбоев вызвана ошибками при изменении конфигурации, а не отказами оборудования. Инфраструктура как код (англ. Infrastructure as Code, IaC) переносит в эксплуатацию сети практики разработки программ. Желаемое состояние сети описывается в текстовых файлах — данных (адресный план, список VLAN, соседи BGP) и шаблонах конфигураций; файлы хранятся в системе контроля версий; конфигурации устройств генерируются из них автоматически и применяются программно. Изменение сети становится изменением файлов, которое можно просмотреть, обсудить, проверить автоматическими тестами и при необходимости откатить.
Распространённый инструмент — Ansible: программа, которая по описанию в формате YAML (сценарию, англ. playbook) подключается к устройствам по SSH или через API и приводит их в описанное состояние. Ключевое свойство таких инструментов — идемпотентность: повторное применение того же описания к устройству, уже находящемуся в нужном состоянии, ничего не меняет. Это позволяет применять описание регулярно и тем самым устранять дрейф конфигурации (англ. configuration drift) — постепенное расхождение реальных настроек с документированными из-за ручных правок.
# фрагмент сценария Ansible: VLAN на коммутаторах доступа
- name: VLAN офиса
  hosts: access_switches
  tasks:
    - name: создать VLAN из файла данных
      cisco.ios.ios_vlans:
        config: "{{ office_vlans }}"
        state: merged
Для программ на Python существуют библиотеки Netmiko — подключение к устройствам разных производителей по SSH с учётом особенностей их командной строки — и NAPALM, предоставляющая единый интерфейс поверх разных производителей: получить сведения об интерфейсах или соседях BGP в одинаковом формате, загрузить кандидатную конфигурацию, посмотреть разность с текущей и применить или откатить её. Работа через командную строку, однако, остаётся хрупкой: вывод команд предназначен для человека, меняется между версиями программного обеспечения и требует разбора текста. Надёжная автоматизация требует программного интерфейса со структурированными данными.
Модели данных YANG и протокол NETCONF
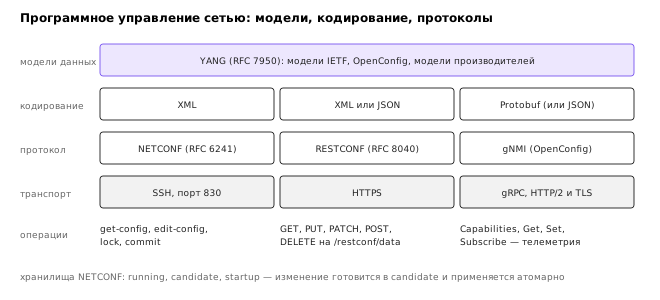
Таким интерфейсом стал протокол настройки сети NETCONF (англ. Network Configuration Protocol), описанный в RFC 6241 7. NETCONF работает поверх SSH (порт 830) и обменивается сообщениями XML в стиле удалённого вызова процедур. Протокол различает хранилища конфигурации (англ. datastore): текущее (running), кандидатное (candidate), в котором изменения готовятся, не влияя на работу, и стартовое (startup). Операции get-config и get читают конфигурацию и состояние, edit-config изменяет хранилище, lock и unlock блокируют его от параллельных изменений, commit атомарно переносит кандидатную конфигурацию в текущую. Последнее — ключевое преимущество перед командной строкой: изменение либо применяется целиком, либо не применяется вовсе, а при подтверждаемой фиксации (англ. confirmed commit) устройство само откатит изменение, если в течение заданного времени не получит подтверждения, — защита от изменения, лишившего администратора доступа к устройству.
Содержимое хранилищ описывается моделями на языке YANG (RFC 7950) 8. Модуль YANG определяет иерархию данных: контейнеры (container), списки с ключом (list), листья с типами (leaf), ограничения и зависимости между значениями. Модель играет для конфигурации ту же роль, что схема для базы данных: по ней устройство проверяет корректность изменения до применения, а программа автоматизации знает структуру данных без разбора текста.
module nsu-interfaces {
  namespace "urn:example:nsu-interfaces";
  prefix nsui;
  container interfaces {
    list interface {
      key "name";
      leaf name    { type string; }
      leaf enabled { type boolean; default true; }
      leaf mtu     { type uint16 { range "68..9216"; } }
    }
  }
}
Модели бывают стандартными (IETF), межпроизводительскими (OpenConfig) и собственными моделями производителей. Рисунок ниже показывает, как модели, кодирование и протоколы складываются в стек программного управления.
RESTCONF и gNMI
Протокол RESTCONF (RFC 8040) предоставляет доступ к тем же данным, описанным моделями YANG, через HTTPS в стиле REST (тема 16) 9. Узлы модели отображаются в пути URL под корнем /restconf/data, данные передаются в XML или JSON, а операции выражаются методами HTTP: GET читает, PUT и PATCH изменяют, POST создаёт, DELETE удаляет. RESTCONF удобен для программ и веб-интерфейсов, привычных к HTTP-интерфейсам, но не имеет понятий кандидатного хранилища и блокировок.
curl -s -u admin:secret -H 'Accept: application/yang-data+json' \
  https://r1.nsu.example/restconf/data/ietf-interfaces:interfaces/interface=eth0
Протокол gNMI, развиваемый сообществом OpenConfig, работает поверх gRPC с кодированием Protobuf и предоставляет четыре операции: Capabilities (какие модели поддерживает устройство), Get, Set и Subscribe 14. Последняя и сделала gNMI основным протоколом потоковой телеметрии: подписка может быть периодической, по изменению или однократной, и устройство отправляет обновления по уже открытому соединению. Таким образом, один протокол и одни модели данных обслуживают и настройку, и мониторинг.
GitOps и проверка изменений
Подход GitOps соединяет описанные средства в процесс. Источником истины о желаемом состоянии сети служит репозиторий Git. Изменение начинается с запроса на слияние (англ. pull/merge request), в котором видна разность файлов. Автоматическая проверка (непрерывная интеграция, англ. CI) генерирует конфигурации, проверяет их на синтаксическую и смысловую корректность — нет ли пересекающихся подсетей, все ли интерфейсы имеют описание, совпадают ли номера AS у соседей BGP, — а в развитых организациях применяет изменение к эмулированной копии сети и прогоняет тесты связности. После рецензии и слияния система развёртывания применяет изменение к устройствам, начиная с малой группы, и откатывает его при ухудшении показателей мониторинга.
Учебная среда курса — пространства имён и FRRouting в контейнерах — является упрощённой моделью такой эмулированной сети: те же скрипты, которые поднимают топологию лабораторной работы, можно рассматривать как код инфраструктуры, а проверки связности — как тесты. Существенно, что автоматизация не отменяет понимания: она лишь быстрее и единообразнее применяет решения, и ошибочное решение, применённое автоматически, ломает сеть быстрее и шире ручного. Поэтому проверки, мониторинг после изменения и возможность быстрого отката — обязательная часть любого процесса изменений.
Планирование ёмкости и соглашения об уровне обслуживания
Планирование ёмкости
Планирование ёмкости (англ. capacity planning) отвечает на вопрос, когда и какие ресурсы нужно добавить, чтобы сеть продолжала выполнять цели уровня обслуживания при росте нагрузки. Исходные данные дают системы мониторинга: история загрузки каналов, таблиц, процессоров устройств. Ключевая трудность — выбрать правильную статистику. Средняя загрузка канала за сутки бесполезна: канал, загруженный в среднем на 30 %, может быть перегружен каждый вечер. Используют загрузку в часы наибольшей нагрузки и высокие перцентили коротких интервалов.
Распространённый пример — расчёт по 95-му перцентилю, применяемый и для оплаты транзита у провайдеров. Загрузка измеряется 5-минутными интервалами; за 30 дней это 30 · 24 · 12 = 8640 значений. Значения сортируются, верхние 5 % — 432 интервала, то есть 36 часов наибольшей загрузки за месяц, — отбрасываются, и наибольшее из оставшихся считается расчётной загрузкой. Такая метрика игнорирует кратковременные всплески, но отражает регулярную вечернюю нагрузку. Если 95-й перцентиль загрузки канала 1 Гбит/с составил 620 Мбит/с, а за год трафик растёт на 40 %, через год он достигнет 868 Мбит/с, то есть 87 % ёмкости.
Сколько запаса нужно? Как было показано в теме 1, задержка ожидания в очереди растёт нелинейно с загрузкой и становится большой при приближении к 100 %, а трафик с высокой изменчивостью (англ. bursty) переполняет буферы задолго до того, как средняя загрузка достигнет предела. Поэтому на практике модернизацию канала планируют, когда загрузка в часы наибольшей нагрузки устойчиво превышает 60–80 %, и с учётом срока поставки оборудования или заказа канала у провайдера. В примере выше модернизацию нужно начинать уже сейчас. Отдельно учитываются сценарии отказов: если трафик двух каналов при отказе одного переходит на другой, каждый из них в нормальном режиме не должен быть загружен больше чем наполовину. Тот же принцип «N + 1» применяется к spine фабрики ЦОД (тема 21).
SLA и бюджет ошибок
Соглашение об уровне обслуживания фиксирует показатели, которые поставщик услуги обязуется выдерживать, способ их измерения и последствия нарушения — обычно скидку на стоимость услуги. Типичные показатели SLA провайдера связи — доступность, задержка между точками его сети, потери пакетов и время восстановления после аварии. Доступность удобно пересчитывать во время простоя.
| Доступность | Простой за 30 дней | Простой за год |
|---|---|---|
| 99 % | 7,2 ч | 3,65 сут |
| 99,9 % | 43,2 мин | 8,76 ч |
| 99,99 % | 4,3 мин | 52,6 мин |
| 99,999 % | 26 с | 5,3 мин |
Таблица показывает, почему каждая следующая «девятка» стоит дорого: 99,99 % означает, что на обнаружение, диагностику и устранение всех аварий за месяц остаётся четыре минуты, что невозможно без автоматического переключения на резерв. Важно и то, как измеряется доступность: проверки из одной точки раз в минуту не заметят 30-секундного сбоя, а сбой, затронувший 10 % пользователей, может быть по-разному учтён в зависимости от определения SLI.
Подход SRE переворачивает отношение к цели уровня обслуживания 1. Если SLO составляет 99,9 %, то 0,1 % — 43 минуты простоя в месяц — является бюджетом ошибок (англ. error budget), который команда вправе израсходовать. Пока бюджет не исчерпан, можно выполнять рискованные изменения и выпускать новые функции; когда он исчерпан, изменения приостанавливаются до восстановления надёжности. Такой подход делает надёжность не абстрактным пожеланием, а измеряемой величиной, о которой можно договариваться, и связывает воедино все разделы темы: SLI измеряются мониторингом, нарушения находятся методологией диагностики, а изменения, расходующие бюджет, проходят через автоматизированный и проверяемый процесс.
Итоги темы
Поиск неисправностей в сети — экспериментальный метод: уточнить симптом, сформулировать гипотезу, проверить её так, чтобы исключить максимум причин, изменять одно за раз и подтвердить причину её устранением. Стратегии «снизу вверх», «сверху вниз», «разделяй и властвуй» и «по пути пакета» задают порядок проверок, а сравнение с исправным случаем, документация и базовая линия показателей дают точку отсчёта. Инструменты курса — от ip и ping до tcpdump, curl -w, счётчиков nftables и трассировки отбросов в ядре — отвечают каждый на свой вопрос, и разбор чёрной дыры PMTUD показал, что неисправность, невидимая для простых проверок связности, обнаруживается уточнением симптома и проверкой с пакетами нужного размера.
Мониторинг превращает сеть из «чёрного ящика» в измеряемую систему. Золотые сигналы — задержка, трафик, ошибки и насыщение — подсказывают, что измерять; SLI и SLO позволяют выразить качество числами, а перцентили — описать задержку честнее среднего. Активные проверки показывают, работает ли сервис, пассивные данные — как он работает для пользователей. SNMP с 64-битными счётчиками, учёт потоков IPFIX и sFlow, экспортёры Prometheus, потоковая телеметрия gNMI и журналы syslog дополняют друг друга.
Автоматизация переносит в сеть практики разработки программ: желаемое состояние описывается кодом и данными, хранится в системе контроля версий, проверяется и применяется программно и идемпотентно. Модели YANG и протоколы NETCONF, RESTCONF и gNMI дают для этого структурированный программный интерфейс с атомарными изменениями и откатом, а процесс GitOps — рецензию, тесты и постепенное развёртывание. Планирование ёмкости по высоким перцентилям загрузки и с учётом сценариев отказа, а также бюджет ошибок связывают техническую эксплуатацию с обязательствами перед пользователями.
Этой темой курс завершается. Пройдя путь от сигнала в кабеле до фабрик ЦОД и автоматизированной эксплуатации, читатель располагает не набором команд, а моделью: каждый пакет проходит через известные механизмы, у каждого механизма есть наблюдаемые признаки, и неисправность — это расхождение между ожидаемым по модели и наблюдаемым. Применение этой модели к сети целой организации — предмет курсового проекта.
Литература
- Beyer B., Jones C., Petoff J., Murphy N. R. Site Reliability Engineering: How Google Runs Production Systems. — O'Reilly Media, 2016. https://sre.google/sre-book/table-of-contents/
- Harrington D., Presuhn R., Wijnen B. An Architecture for Describing Simple Network Management Protocol (SNMP) Management Frameworks. — RFC 3411, IETF, 2002. https://www.rfc-editor.org/rfc/rfc3411
- McCloghrie K., Kastenholz F. The Interfaces Group MIB. — RFC 2863, IETF, 2000. https://www.rfc-editor.org/rfc/rfc2863
- Claise B., Trammell B., Aitken P. Specification of the IP Flow Information Export (IPFIX) Protocol for the Exchange of Flow Information. — RFC 7011, IETF, 2013. https://www.rfc-editor.org/rfc/rfc7011
- Phaal P., Panchen S., McKee N. InMon Corporation's sFlow: A Method for Monitoring Traffic in Switched and Routed Networks. — RFC 3176, IETF, 2001. https://www.rfc-editor.org/rfc/rfc3176
- Gerhards R. The Syslog Protocol. — RFC 5424, IETF, 2009. https://www.rfc-editor.org/rfc/rfc5424
- Enns R., Bjorklund M., Schoenwaelder J., Bierman A. Network Configuration Protocol (NETCONF). — RFC 6241, IETF, 2011. https://www.rfc-editor.org/rfc/rfc6241
- Bjorklund M. The YANG 1.1 Data Modeling Language. — RFC 7950, IETF, 2016. https://www.rfc-editor.org/rfc/rfc7950
- Bierman A., Bjorklund M., Watsen K. RESTCONF Protocol. — RFC 8040, IETF, 2017. https://www.rfc-editor.org/rfc/rfc8040
- Lahey K. TCP Problems with Path MTU Discovery. — RFC 2923, IETF, 2000. https://www.rfc-editor.org/rfc/rfc2923
- Mogul J., Deering S. Path MTU Discovery. — RFC 1191, IETF, 1990. https://www.rfc-editor.org/rfc/rfc1191
- Prometheus Documentation. Overview. — 2025. https://prometheus.io/docs/introduction/overview/
- The Linux Kernel Documentation. IP Sysctl. — 2025. https://docs.kernel.org/networking/ip-sysctl.html
- OpenConfig. gRPC Network Management Interface (gNMI) Specification. — 2025. https://github.com/openconfig/reference/blob/master/rpc/gnmi/gnmi-specification.md