
Аналитический SQL
Аналитический вопрос, как было показано в теме 1, читает сотни тысяч строк и возвращает несколько. Задаётся он на SQL — том же языке, на котором прикладная система читает и изменяет отдельные записи. Язык один, но пользуются им по-разному. Прикладной запрос обращается к строке по ключу, и его ошибка обычно обнаруживается сразу: заявка не найдена, статус не сохранён. Аналитический запрос обращается ко всей таблице и возвращает агрегат, а ошибка в нём, как правило, не сопровождается никаким сообщением: запрос выполняется и возвращает правдоподобное число, которое неверно.
Причина таких ошибок почти всегда одна: автор вкладывает в запрос иной смысл, чем определяет семантика языка. Поэтому тема построена не как справочник по конструкциям, а вокруг семантики SQL — того, в каком порядке вычисляется запрос, как язык обращается с типами и отсутствующими значениями, что происходит со строками при группировке и соединении. Завершают тему средства, позволяющие записать многошаговый вопрос так, чтобы каждый шаг проверялся отдельно. Примеры относятся к предметной области курса — объектам городской инфраструктуры, приборам учёта, инцидентам — и записаны в диалекте DuckDB; расхождения с другими СУБД оговариваются там, где они существенны. Читателю, не встречавшему SQL прежде, до чтения темы следует обратиться к экспресс-введению в базовые запросы в дополнительных материалах к теме 2.
Запрос к большой таблице
Порядок вычисления запроса
SQL — декларативный язык: запрос описывает не последовательность действий, а свойства результата. Результат определяется как композиция операций — отбора строк, группировки, вычисления выражений, — каждая из которых получает таблицу и возвращает таблицу; лишь завершающее упорядочение превращает результат в последовательность строк. От реляционной модели в строгом смысле SQL отличается тем, что таблица в нём — не множество, а мультимножество (англ. multiset) строк: одинаковые строки допускаются и учитываются столько раз, сколько встречаются 1. К этому обстоятельству мы вернёмся при разборе соединений.
Запрос на выборку записывается в фиксированном порядке предложений: SELECT, FROM, WHERE, GROUP BY, HAVING, ORDER BY, LIMIT. Язык создавался как попытка приблизить запрос к фразе на английском языке 2, и порядок записи следует порядку фразы: сначала называется, что требуется получить, затем — откуда. Вычисляется запрос в ином порядке. Логически сначала определяется источник строк (FROM вместе с соединениями), затем отбрасываются строки, не удовлетворяющие условию WHERE, оставшиеся делятся на группы, для групп вычисляются агрегаты и проверяется условие HAVING, и только после этого вычисляются выражения списка SELECT, результат упорядочивается и усекается.
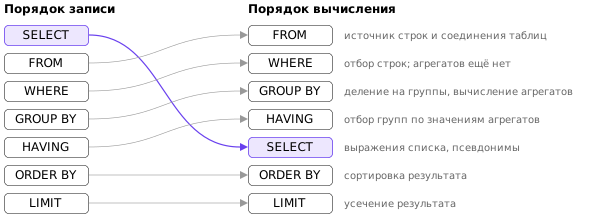
Логический порядок объясняет ограничения, которые в порядке записи выглядят произвольными. Условие WHERE не может содержать агрегат: в момент его проверки групп ещё нет. Псевдоним, объявленный в SELECT, по стандарту недоступен в WHERE и GROUP BY по той же причине — выражение, которое он называет, ещё не вычислено. Некоторые системы, в том числе DuckDB, это ограничение ослабляют 3, однако запрос, опирающийся на такое расширение, при переносе в другую СУБД перестаёт выполняться.
Логический порядок — модель смысла запроса, а не план выполнения. Планировщик вправе проверять условия раньше, чем того требует модель, менять порядок соединений и читать данные в удобном ему порядке; обязательно лишь одно — результат должен совпасть с тем, который дала бы модель. Благодаря такому разделению автор запроса рассуждает о смысле, а способ вычисления выбирает система.
Типы данных при загрузке из файлов
Тип определяет не только множество допустимых значений, но и операции над ними: как значения сравниваются, как упорядочиваются, какая арифметика к ним применима. Одна и та же последовательность символов ведёт себя по-разному в зависимости от типа. Строки сравниваются посимвольно слева направо, поэтому текст '10' меньше текста '9', тогда как число 10 больше числа 9. Дата в формате ISO 8601 (2025-01-31) упорядочивается как текст так же, как дата, но это свойство формата записи, а не типа: для записи 31.01.2025 текстовое сравнение даст неверный порядок без какого-либо сообщения. Арифметика над датами и выделение месяца к тексту неприменимы вовсе.
Файл CSV, как отмечалось в теме 1, типов не хранит, и при чтении их приходится выводить. Аналитические движки определяют тип каждого столбца по выборке строк: столбец, все значения которого в выборке — целые числа, становится целочисленным, похожий на дату — датой. Такой вывод — частный случай схемы на чтении, которой посвящена тема 5, и он ненадёжен в двух отношениях. Значение, не попавшее в выборку и не отвечающее выведенному типу, останавливает чтение ошибкой, причём, возможно, далеко за пределами выборки. Опаснее вывод формально успешный, но ошибочный по смыслу: серийный номер или почтовый индекс, прочитанные как число, теряют ведущие нули, и соединение по ним перестаёт находить пары. Формат со схемой, например Parquet, снимает проблему вывода, но не проблему выбора: тип в нём фиксирует тот, кто записал файл, и дата, записанная строкой, остаётся строкой.
Отсюда правило: тип фиксируется явно и однократно — при загрузке файла в таблицу хранилища, выражением CAST(столбец AS DATE) или краткой записью столбец::DATE, принятой в DuckDB и PostgreSQL. Последующие запросы опираются на объявленный тип и не повторяют преобразование.
С типом связана и запись периодов. Условие на месяц записывается полуинтервалом — начало включено, конец исключён: date >= DATE '2025-01-01' AND date < DATE '2025-02-01'. Такая запись верна для столбца любого временного типа, тогда как BETWEEN '2025-01-01' AND '2025-01-31' для отметки времени с часами и минутами отбросит всё, что произошло 31 января позже полуночи.
NULL и трёхзначная логика
NULL — не значение, а отметка об отсутствии значения. Кодд ввёл её в реляционную модель для значения, неизвестного в данный момент 4, и позднее предложил отличать неизвестное значение от неприменимого 5. SQL обозначает оба случая одним NULL, хотя смысл у них разный. Суточное потребление, не вычисленное из-за сбоя прибора, неизвестно: оно было, но в данных его нет. Потребление у датчика температуры неприменимо: его нет по определению. Язык эти случаи не различает, и различать их приходится автору запроса.
Сравнение с NULL даёт не «ложь», а третье логическое значение — «неизвестно» (англ. unknown); логику с тремя значениями истинности называют трёхзначной (англ. three-valued logic). Логические связки определены так, чтобы результат не зависел от того, каким окажется неизвестное значение, если это возможно. «Ложь» И «неизвестно» — ложь, каким бы ни был второй операнд; «истина» ИЛИ «неизвестно» — истина; «истина» И «неизвестно» остаётся неизвестным, как и отрицание неизвестного. Сравнение двух отсутствующих значений NULL = NULL тоже даёт «неизвестно», а не «истину».
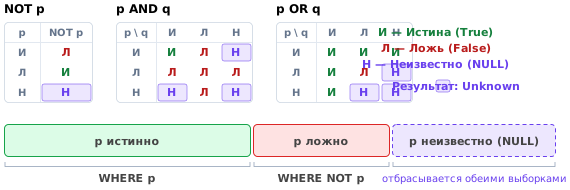
Предложение WHERE пропускает только строки, для которых условие истинно; строки с неизвестным результатом отбрасываются вместе с ложными. Отсюда следствие, противоречащее интуиции: закон исключённого третьего в SQL не выполняется, и условие вместе с его отрицанием не покрывает таблицу. Запросы WHERE p и WHERE NOT p в сумме возвращают меньше строк, чем содержит таблица, — ровно на число строк, где p неизвестно. Если в столбце пропущена треть значений, треть таблицы не попадёт ни в одну из двух выборок.
Проверка на отсутствие значения записывается отдельным оператором IS NULL; сравнение = NULL синтаксически допустимо, но не бывает истинным. Функция coalesce подставляет значение вместо пропуска, однако подстановка нуля меняет смысл: неизвестное потребление — не то же самое, что нулевое. Дейт считает NULL источником логически неверных ответов и предлагает обходиться без него 1. В хранилище, куда данные поступают из внешних систем, пропуски неизбежны, поэтому для каждого столбца требуется знать, что в нём означает NULL, и оценивать долю пропусков до вычисления агрегатов.
Положение пропусков при сортировке стандарт оставляет на усмотрение реализации, и системы расходятся. DuckDB помещает NULL в конец при любом направлении сортировки. PostgreSQL считает NULL больше любого значения, и при сортировке по убыванию пропуски оказываются первыми. Запрос «пять наибольших значений» вернёт в двух системах разные строки; переносимая запись задаёт порядок явно: ORDER BY consumption DESC NULLS LAST.
Стоимость запроса
Стоимость запроса определяется прежде всего объёмом данных, который необходимо прочитать. Для условия отбора существенна его селективность (англ. selectivity) — доля строк, которые ему удовлетворяют. Условие, выбирающее одну заявку из миллиона, выгодно проверять через индекс: система находит нужную строку, прочитав несколько страниц диска. Условие, отбирающее значительную долю строк, например месяц из шести, через индекс проверять невыгодно: обращение к таблице вразброс за каждой строкой обходится дороже, чем последовательное чтение всей таблицы. Поэтому основной способ выполнения аналитического запроса — полное сканирование (англ. full table scan), при котором условие проверяется по ходу чтения.
Выбор между способами делает планировщик, сравнивая оценки стоимости альтернативных планов; этот подход сложился ещё в первых реляционных системах 6. Выбранный план показывает команда EXPLAIN, а EXPLAIN ANALYZE дополняет его фактическим числом строк и временем каждого шага. В колоночной СУБД полное сканирование читает лишь нужные столбцы и пропускает блоки, заведомо не содержащие подходящих значений; как это устроено, показано в теме 3.
Предложение LIMIT часто применяют при отладке, но оно ограничивает объём результата, а не объём работы. Причина — в устройстве операторов выполнения. Конвейерные операторы (англ. pipelined), например отбор строк, передают строку дальше сразу после её обработки, и запрос с LIMIT 10 без сортировки может остановиться после первых прочитанных строк. Блокирующие операторы (англ. blocking) — сортировка и группировка — не могут выдать первую строку результата, не получив всех входных 7. Запрос с ORDER BY … LIMIT 10 должен просмотреть все строки, чтобы найти десять наибольших, агрегирующий запрос с LIMIT сначала вычисляет все группы.
Без ORDER BY набор строк, которые вернёт LIMIT, не определён: у мультимножества нет порядка, и СУБД с параллельным выполнением может возвращать при каждом запуске разные строки. Для отладки на подмножестве надёжнее ограничить сам источник — один месяц, один объект — или взять случайную выборку строк.
Значение этих различий зависит от объёма данных. Учебные таблицы сканируются за доли секунды. Телеметрия города с пятьюдесятью тысячами приборов при почасовом опросе даёт 438 миллионов строк в год. Полное сканирование такой таблицы занимает секунды или минуты, а в облачных платформах с оплатой по объёму прочитанных данных каждое лишнее сканирование оплачивается. Отсюда три правила, которые следует соблюдать уже на малых данных: перечислять нужные столбцы вместо SELECT *, ограничивать период и проверять запрос на подмножестве прежде, чем запускать его на всей таблице.
Агрегация и группировка
Агрегатные функции
Агрегатная функция (англ. aggregate function) отображает мультимножество значений в одно значение. Базовых функций, общих для всех СУБД, пять: count, sum, avg, min и max. Все они, кроме count(*), пропускают NULL, а на пустом входе ведут себя по-разному: count возвращает ноль, остальные — NULL. Поэтому сумма по группе, где все значения пропущены, равна не нулю, а NULL.
От правила пропуска зависит ответ даже в простом подсчёте. Рассмотрим прибор, который за трое суток дал значения потребления 4 и 5 и один пропуск. Функция count(*) вернёт три, count(consumption) — два. Функция avg(consumption) делит сумму на число известных значений и даёт 4,5; выражение sum(consumption) / count(*) делит ту же сумму на число строк и даёт 3. Какой ответ верен, язык не определяет. Первый — если пропуск означает «неизвестно», второй — если пропуск означает отсутствие события и по существу равен нулю. Различить эти случаи можно, только зная, откуда в столбце берутся пропуски.
Среднее неустойчиво к выбросам: одно ошибочное значение, на два порядка превосходящее типичные, сдвигает среднее сотен строк. Поэтому аналитические СУБД, включая DuckDB, предоставляют медиану (median) и квантили, а сопоставление среднего с медианой служит простой проверкой данных.
Группировка (GROUP BY) разбивает строки на группы с одинаковым значением ключа и вычисляет агрегаты для каждой группы отдельно; результат содержит ровно одну строку на группу. Отсюда правило соответствия столбцов: в списке SELECT запроса с группировкой допустимы ключи группировки, агрегаты и столбцы, однозначно определяемые ключом. Последнее допущение введено стандартом SQL:1999 через понятие функциональной зависимости; PostgreSQL применяет его, когда ключ группировки включает первичный ключ таблицы, большинство других систем требуют перечислить такие столбцы в GROUP BY. Столбец, не определяемый ключом, не имеет в группе единственного значения, и строгая система отвечает на такой запрос ошибкой. Не все системы строги: SQLite выполняет такой запрос и возвращает значение одной из строк группы, как до версии 5.7.5 по умолчанию поступал и MySQL, — ответ без ошибки и без смысла.
С пропусками группировка обращается иначе, чем сравнение: все строки с NULL в ключе попадают в одну группу. Для группировки два отсутствующих значения неразличимы (англ. not distinct), хотя их сравнение на равенство истинным не является.
Условная агрегация считает в группе только строки, удовлетворяющие условию. Предложение FILTER введено стандартом SQL:2003; в СУБД, которые его не поддерживают, например в MySQL, то же записывается через CASE:
SELECT type,
       count(*)                                      AS incidents,
       count(*) FILTER (WHERE severity = 3)          AS severe,
       sum(CASE WHEN severity = 3 THEN 1 ELSE 0 END) AS severe_portable
FROM incidents
GROUP BY type
Несколько условных агрегатов в одном запросе дают за один проход по таблице сводную таблицу: строка — группа, столбец — значение признака.
Фильтрация до и после агрегации
Условие на строки и условие на группы относятся к разным объектам и записываются в разных предложениях. WHERE — предикат на строку: он проверяется до группировки и определяет, какие строки войдут в группы. HAVING — предикат на группу: он проверяется после вычисления агрегатов и определяет, какие группы останутся в результате. Запрос «объекты, на которых произошло не менее четырёх инцидентов тяжести 2 и выше» использует оба:
SELECT object_id, count(*) AS incidents
FROM incidents
WHERE severity >= 2
GROUP BY object_id
HAVING count(*) >= 4
Условие на тяжесть относится к отдельному инциденту, условие на число — к совокупности инцидентов объекта. Перенести второе в WHERE невозможно: агрегата на этом этапе ещё нет.
Опаснее обратная ошибка, которая сообщения не вызывает: условие на группу, записанное как условие на строки. Её природу проясняет различие кванторов. Вопрос «на каких объектах хотя бы один инцидент устранён быстрее чем за 12 часов» содержит квантор существования: достаточно одной подходящей строки, и условие записывается в WHERE с последующим подсчётом различных объектов. Вопрос «на каких объектах все инциденты устранены быстрее чем за 12 часов» содержит квантор всеобщности: условие должно выполняться для каждой строки группы. В SQL такое условие выражается агрегатом и записывается в HAVING: максимальная длительность в группе меньше 12 часов или, прямее, логический агрегат bool_and от условия на строку (в стандарте SQL — every). Если же условие второго вопроса записать в WHERE, запрос ответит на первый вопрос: оба синтаксически верны, различаются одним словом в формулировке и дают разные ответы. Агрегатная запись наследует и правило пропуска: инцидент, ещё не устранённый, имеет пустую длительность, max его не учтёт, и объект с открытым инцидентом попадёт в число устранивших всё быстро. Прежде чем записывать условие, требуется определить, к чему оно относится, какой квантор содержит формулировка и как с ним обойдутся пропуски.
Соответствие pandas
Группировка с агрегацией — одна и та же операция в SQL и в pandas; различается запись. Соответствие основных конструкций приведено в дополнительных материалах к теме 2; здесь существенны расхождения в семантике.
Правила обращения с пропусками совпадают не полностью. Методы mean и count в pandas пропускают NaN, как avg и count(столбец) в SQL. Но groupby по умолчанию отбрасывает строки с пустым ключом (параметр dropna=True), тогда как SQL собирает их в отдельную группу, и один и тот же вопрос даёт разное число групп. Сумма одних только пропусков в pandas равна нулю, в SQL — NULL. При сверке ответов, полученных двумя способами, эти расхождения исключаются прежде, чем искать ошибку в логике.
Запрос короче кода, когда вопрос представляет собой цепочку «отобрать — соединить — сгруппировать — отобрать группы»: SQL записывает её одним декларативным выражением, а порядок выполнения выбирает планировщик. Код на pandas короче, когда обработка пошаговая и исследовательская: изменение формы таблицы, применение собственной функции на Python, построение графика по промежуточному результату. Выбирать один инструмент не обязательно: DuckDB обращается к DataFrame по имени переменной как к таблице и возвращает результат запроса в pandas. Существенное различие лежит не в записи, а в том, где находятся данные: pandas требует, чтобы таблица помещалась в оперативную память, СУБД этого не требует, как показано в теме 1.
Соединение таблиц
Виды соединений
Внутреннее соединение (англ. inner join) по определению — подмножество декартова произведения двух таблиц: из всех пар строк остаются те, для которых выполнено условие соединения. Внешние соединения добавляют к нему строки, не нашедшие пары: левое внешнее соединение (англ. left outer join) — строки левой таблицы, правое — строки правой, полное внешнее (англ. full outer join) — строки обеих; недостающие столбцы заполняются NULL. Перекрёстное соединение (англ. cross join) — само декартово произведение; с его помощью получают, например, полную сетку «объект — сутки», на которую затем накладываются факты.
Типовой аналитический запрос соединяет таблицу событий со справочниками. События — сутки потребления, инциденты, обращения — многочисленны и содержат ссылки: идентификатор объекта, дату. Справочники — объекты, районы, приборы — немногочисленны и содержат описания, по которым события группируют. Это разделение лежит в основе схемы «звезда», которой посвящена тема 4 8; здесь нас будет интересовать техника соединения.
Выбор между внутренним и левым соединением определяется вопросом. Если вопрос касается и тех, у кого событий не было, — например, «число инцидентов по каждому объекту», — внутреннее соединение объектов с журналом инцидентов исключит из ответа объекты без инцидентов. Левое соединение их сохранит, но меняет правило подсчёта.
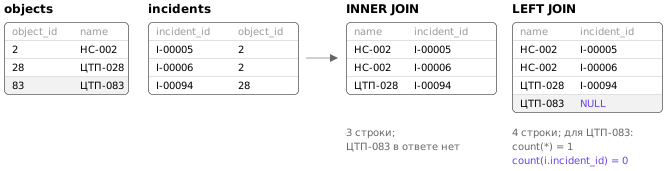
Строка объекта без пары в результате левого соединения одна, и count(*) засчитает её как один инцидент. Считать следует непустые значения столбца правой таблицы — count(i.incident_id), — который у такой строки пуст. Тот же приём даёт антисоединение (англ. anti-join), то есть отбор строк, у которых пары нет: левое соединение и условие i.incident_id IS NULL. Полусоединение (англ. semi-join), напротив, отбирает строки, у которых пара есть, причём каждую — один раз, сколько бы пар она ни нашла.
Ошибки соединений
Число строк результата соединения определяется кратностью ключей: для каждого значения ключа в результат попадает столько строк, каково произведение числа строк с этим значением в левой и в правой таблицах. Если в правой таблице ключ уникален, как у справочника, соединяемого по первичному ключу, каждая строка событий находит не более одной пары, и число строк событий не возрастает: при левом соединении оно сохраняется, при внутреннем может лишь уменьшиться. Такую связь называют «многие к одному». Если ключ в правой таблице неуникален, строка левой таблицы повторяется столько раз, сколько пар нашла. Поскольку таблица в SQL — мультимножество, повторённые строки не схлопываются, а участвуют в агрегатах наравне с исходными. Отсюда первая ошибка соединений — размножение строк (англ. fan-out).
Рассмотрим вопрос: сколько электроэнергии потребили объекты, на которых был хотя бы один тяжёлый инцидент. Прямолинейный запрос соединяет суточное потребление с журналом инцидентов:
SELECT sum(c.consumption)
FROM consumption_daily c
JOIN incidents i ON i.object_id = c.object_id AND i.severity = 3
WHERE c.resource = 'электроэнергия'
У объекта много суточных строк и может быть несколько инцидентов, то есть связь двух таблиц по object_id — «многие ко многим». Объект с двумя тяжёлыми инцидентами находит в журнале две пары, и каждая его суточная строка входит в сумму дважды. Число правдоподобно, и ничто в результате на ошибку не указывает; на учебных данных единственный такой объект завышает итог на 15 %.
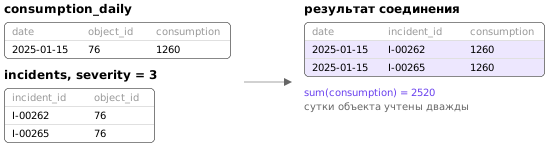
Исправлений два, и оба следуют из природы ошибки. Если от второй таблицы требуется лишь факт наличия пары, соединение заменяется полусоединением — проверкой object_id IN (SELECT object_id FROM incidents WHERE severity = 3), которая строк не размножает. Если от второй таблицы требуются значения, её предварительно агрегируют до уникальности ключа — по одной строке на объект — и соединяют уже результат агрегации; этот приём показан в следующем разделе.
Вторая ошибка — потеря строк. Внутреннее соединение с неполным справочником без какого-либо сообщения отбрасывает события, для которых в справочнике нет пары: объект ещё не внесён, прибор заменён, код района введён с ошибкой. Неполнота бывает и не дефектом данных, а свойством предметной области: приборы учёта установлены не на всех объектах, и внутреннее соединение сведений об объектах с таблицей приборов отбрасывает неоснащённые объекты.
Разновидность той же ошибки — условие на правую таблицу левого соединения, записанное в WHERE. Если к объектам присоединить журнал инцидентов левым соединением, а условие «тяжесть равна 3» записать в WHERE, из ответа исчезнут все объекты без тяжёлых инцидентов: у дополненных строк тяжесть пуста, сравнение даёт «неизвестно», и WHERE строку не пропускает. Условие, которое не бывает истинным, когда все столбцы присоединённой таблицы пусты, называют отвергающим NULL (англ. null-rejecting); при нём левое соединение по смыслу совпадает с внутренним, и планировщики, как правило, так его и выполняют. Условие IS NULL пустые значения не отвергает, поэтому антисоединение работает. Условие, относящееся к присоединяемой таблице, записывается в ON: там оно определяет, какие строки считаются парой, но не отбрасывает строки левой таблицы.
Обе ошибки обнаруживаются одной проверкой — сравнением числа строк до и после соединения. Соединение событий со справочником по столбцу, который считается ключом справочника, должно сохранить число строк событий: для левого соединения — всегда, для внутреннего — при соблюдённой ссылочной целостности. Если строк стало больше, столбец в справочнике неуникален; убедиться в этом позволяет группировка по нему с условием HAVING count(*) > 1, которая для настоящего ключа возвращает пустой результат. Если строк стало меньше, в справочнике недостаёт ключей. Такая проверка предшествует интерпретации любого ответа, полученного через соединение.
Составные запросы
Общие табличные выражения
Вопрос, требующий нескольких агрегаций и соединений, в одном выражении SQL читается плохо: подзапросы вкладываются друг в друга, и порядок вычисления приходится восстанавливать изнутри наружу. Общее табличное выражение (англ. common table expression, CTE) даёт промежуточному результату имя: конструкция WITH имя AS (запрос) объявляет шаг, к которому последующие шаги обращаются как к таблице. Запрос превращается в последовательность именованных шагов, читаемую сверху вниз, — композицию функций, каждая из которых получает таблицы и возвращает таблицу.
Главное достоинство такой записи — проверяемость. Результат каждого шага можно получить отдельно и сопоставить с ожиданием: число строк, крайние значения, долю пропусков. Рассмотрим вопрос о связи потребления тепла с погодой: каково суточное потребление тепла одним объектом при разной температуре наружного воздуха. Он раскладывается на четыре шага: отобрать сутки с известным потреблением тепла, присоединить к ним температуру воздуха по дате, отнести каждые сутки к интервалу температуры, вычислить агрегаты по интервалам.
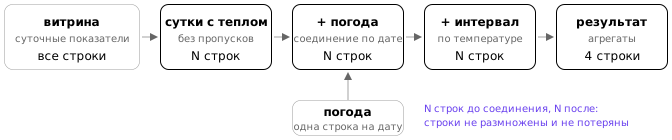
Проверка числа строк на втором шаге подтверждает, что соединение со сводкой погоды не размножило и не потеряло строк: в сводке одна строка на дату. Проверка крайних значений на последнем шаге выявляет другое. Одни сутки с потреблением, на два порядка превышающим типичное, заметно сдвигают среднее своего интервала, тогда как медиана от них почти не меняется. Обработка подобных дефектов — предмет тем 6 и 8. Здесь существенно, что без промежуточных проверок искажение осталось бы незамеченным.
Второе применение общих табличных выражений — предварительная агрегация, устраняющая размножение строк, когда от второй таблицы требуются значения. Пусть требуется сравнить среднесуточное потребление объектов в зависимости от того, сколько тяжёлых инцидентов на них произошло. Инциденты сначала сводятся к одной строке на объект, и только затем результат соединяется с потреблением:
WITH severe AS (
    SELECT object_id, count(*) AS severe_incidents
    FROM incidents
    WHERE severity = 3
    GROUP BY object_id
)
SELECT s.severe_incidents, avg(c.consumption) AS avg_daily
FROM consumption_daily c
JOIN severe s ON s.object_id = c.object_id
WHERE c.resource = 'электроэнергия'
GROUP BY s.severe_incidents
Ключ object_id в шаге severe уникален по построению, связь становится «многие к одному», и соединение сохраняет число строк потребления. Общее правило: таблицу, из которой берутся значения, приводят к гранулярности ключа соединения — так, чтобы одна её строка соответствовала одному значению ключа. Гранулярностью называют то, чему соответствует одна строка таблицы; подробно это понятие разбирается в теме 4.
Общее табличное выражение — средство записи, а не указание порядка вычислений. Планировщик вправе встроить шаг в основной запрос или вычислить его однократно и сохранить результат; на ответ это не влияет. Конструкция введена стандартом SQL:1999 и поддерживается всеми распространёнными СУБД.
Подзапросы
Подзапрос (англ. subquery) — запрос, вложенный в другой. По роли во внешнем запросе различают три вида подзапросов. Скалярный подзапрос возвращает одно значение и участвует в выражении как значение: условие capacity > (SELECT avg(capacity) FROM objects) отбирает объекты с мощностью выше средней. Подзапрос в IN или EXISTS проверяет, есть ли для строки внешнего запроса подходящая строка в другой таблице, то есть записывает полусоединение, определённое в разделе о видах соединений. Наконец, подзапрос в FROM служит источником строк наравне с таблицей и по смыслу равнозначен общему табличному выражению.
С отрицанием NOT IN связана ошибка, вытекающая из трёхзначной логики. Условие x NOT IN (1, 2, NULL) раскрывается в x <> 1 AND x <> 2 AND x <> NULL; последнее сравнение даёт «неизвестно», и конъюнкция не бывает истинной ни для одной строки. Если подзапрос в NOT IN вернёт хотя бы один NULL, результат окажется пустым: запрос «объекты без инцидентов» перестанет что-либо находить после появления в журнале единственной записи с неизвестным объектом. Надёжная форма — NOT EXISTS, прямая запись антисоединения: она проверяет существование строки, а не результат сравнения, и пропуски на неё не влияют.
Коррелированный подзапрос (англ. correlated subquery) ссылается на столбцы внешнего запроса и логически вычисляется заново для каждой его строки:
SELECT o.name,
       (SELECT count(*) FROM incidents i WHERE i.object_id = o.object_id) AS incidents
FROM objects o
Буквальное выполнение означает отдельный проход по журналу инцидентов для каждого объекта, то есть время, растущее как произведение размеров двух таблиц. Современные планировщики умеют преобразовывать коррелированные подзапросы в соединения 9, и DuckDB делает это для подзапросов любого вида. Не все СУБД поступают так же, поэтому время выполнения одного и того же текста запроса в разных системах может различаться на порядки. В аналитических запросах предпочтительна явная форма — соединение с предварительно агрегированным общим табличным выражением: её стоимость предсказуема в любой СУБД, а промежуточный результат проверяем. Раскрывая подзапрос вручную, важно сохранить его смысл: приведённый запрос возвращает ноль для объектов без инцидентов, и равнозначная ему явная форма — левое соединение с агрегатом и подстановка coalesce(incidents, 0). Внутреннее соединение потеряло бы такие объекты; эта ошибка при раскрытии подзапросов известна давно и получила название ошибки подсчёта (англ. COUNT bug) 10. Коррелированный подзапрос оправдан там, где он естествен по смыслу, — в проверках EXISTS и NOT EXISTS.
Итоги темы
Аналитический запрос описывает результат, а не способ его получения, и вычисляется в логическом порядке, отличном от порядка записи: источник строк, отбор строк, группировка, отбор групп, вычисление списка, сортировка. Из этого порядка следуют ограничения языка и различие между WHERE и HAVING — предикатом на строку и предикатом на группу.
Ошибки аналитического запроса, как правило, не сопровождаются сообщениями, и их источники лежат в семантике языка. Тип определяет порядок и допустимые операции, и тип, выведенный по выборке или оставшийся текстовым, меняет ответ. NULL порождает трёхзначную логику, в которой условие и его отрицание не покрывают таблицу, а агрегаты пропускают значения. Соединение по неуникальному ключу размножает строки, и, поскольку таблица в SQL — мультимножество, копии входят в агрегаты наравне с исходными; внутреннее соединение с неполным справочником строки теряет. Каждой ошибке соответствует проверка: явное приведение типов при загрузке, оценка доли пропусков до агрегации, сравнение числа строк до и после соединения.
Многошаговый вопрос записывается последовательностью общих табличных выражений, каждый шаг которой проверяется отдельно, а предварительная агрегация до гранулярности ключа устраняет размножение строк. Полусоединение через IN и EXISTS проверяет наличие пары, не размножая строк; стоимость коррелированного подзапроса, в отличие от явного соединения, зависит от того, умеет ли СУБД его раскрывать.
Стоимость аналитического запроса определяется объёмом прочитанных данных, и LIMIT в общем случае её не снижает. От того, как таблица лежит на диске, зависит, сколько данных придётся прочитать при сканировании; этому посвящена тема 3.
Литература
- Date C. J. SQL and Relational Theory: How to Write Accurate SQL Code. — O'Reilly Media, 2015.
- Chamberlin D. D., Boyce R. F. SEQUEL: A Structured English Query Language. — Proceedings of the 1974 ACM SIGFIDET (now SIGMOD) Workshop on Data Description, Access and Control, 1974, С. 249–264, DOI: 10.1145/800296.811515.
- Foundation} {. Friendly SQL. — 2026, https://duckdb.org/docs/current/sql/dialect/friendly_sql.
- Codd E. F. Extending the Database Relational Model to Capture More Meaning. — ACM Transactions on Database Systems, 1979, С. 397–434, DOI: 10.1145/320107.320109.
- Codd E. F. Missing Information (Applicable and Inapplicable) in Relational Databases. — ACM SIGMOD Record, 1986, DOI: 10.1145/16301.16303.
- Selinger P. G., Astrahan M. M., Chamberlin D. D., Lorie R. A., Price T. G. Access Path Selection in a Relational Database Management System. — Proceedings of the 1979 ACM SIGMOD International Conference on Management of Data, 1979, С. 23–34, DOI: 10.1145/582095.582099.
- Graefe G. Query Evaluation Techniques for Large Databases. — ACM Computing Surveys, 1993, С. 73–169, DOI: 10.1145/152610.152611.
- Kimball R., Ross M. The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling. — Wiley, 2013.
- Neumann T., Kemper A. Unnesting Arbitrary Queries. — Datenbanksysteme für Business, Technologie und Web (BTW 2015), 2015, С. 383–402, https://dl.gi.de/handle/20.500.12116/2418.
- Ganski R. A., Wong H. K. T. Optimization of Nested SQL Queries Revisited. — Proceedings of the 1987 ACM SIGMOD International Conference on Management of Data, 1987, С. 23–33, DOI: 10.1145/38713.38723.