
Форматы колоночного хранения: Apache Parquet и Apache Arrow
В темах 1 и 2 мы убедились, что текстовые табличные форматы (CSV, TSV) и классические реляционные СУБД со строковым хранением (Row-Oriented DBMS) быстро достигают предела производительности при аналитической обработке сотен тысяч и миллионов записей. Для расчёта среднего расхода воды или поиска пикового давления в городской сети за полгода аналитический запрос обращается лишь к двум-трём числовым столбцам из десятка атрибутов, содержащихся в записи. Однако построчное хранилище вынуждено поднимать с диска каждую строку целиком, забивая шину памяти бесполезным вводом-выводом 1.
Решением этой проблемы стал переход к колоночному представлению данных (Columnar Storage). В этой теме мы детально разберём два взаимодополняющих открытых стандарта индустрии:
- Apache Parquet — бинарный колоночный формат хранения данных на диске и в объектных хранилищах;
- Apache Arrow — стандарт непрерывного колоночного представления данных в оперативной памяти для высокоскоростной аналитики без сериализации.
Строковое против колоночного хранения
В строковом формате (Row-Oriented, традиционные СУБД вроде OLTP PostgreSQL или SQLite) байты кортежей следуют друг за другом:
\text{Строка 1: } [id_1, time_1, sensor_1, val_1, status_1], \quad \text{Строка 2: } [id_2, time_2, sensor_2, val_2, status_2] \dots
Такая схема идеальна для транзакционных систем: добавление новой строки требует простой дозаписи в конец файла, а поиск конкретного инцидента по первичному ключу читает одну страницу диска.
В колоночном формате (Column-Oriented) массив группируется по столбцам:
\text{Столбец } val: [val_1, val_2, val_3, val_4, \dots], \quad \text{Столбец } time: [time_1, time_2, time_3, time_4, \dots]
Ключевые преимущества колоночного подхода
- Проекция без накладных расходов (Column Pruning):
Если аналитический запрос агрегирует только столбец val (
SELECT avg(val) FROM telemetry), с диска читаются страницы только этого столбца. Все остальные данные (текстовые комментарии, идентификаторы датчиков, координаты) физически не считываются с накопителя. - Экстремальное сжатие данных: Значения одного столбца имеют одинаковый тип данных и схожее распределение. Последовательные временные метки идут с шагом в одну секунду, а показания температуры колеблются около одного значения. Это позволяет применять специализированные алгоритмы кодирования (RLE, Delta-encoding, Dictionary), сжимая данные в 5–10 раз лучше универсальных архиваторов 2.
- Векторизованные вычисления (SIMD): Однородный массив чисел в памяти идеально ложится в векторные регистры процессора, позволяя выполнять инструкции AVX-512 над десятками значений за один такт процессора.
Внутреннее устройство формата Apache Parquet
Apache Parquet — открытый формат колоночного хранения, созданный совместными усилиями инженеров Twitter и Cloudera на основе идей исследовательской статьи Google Dremel 3.
Файл Parquet имеет иерархическую структуру:
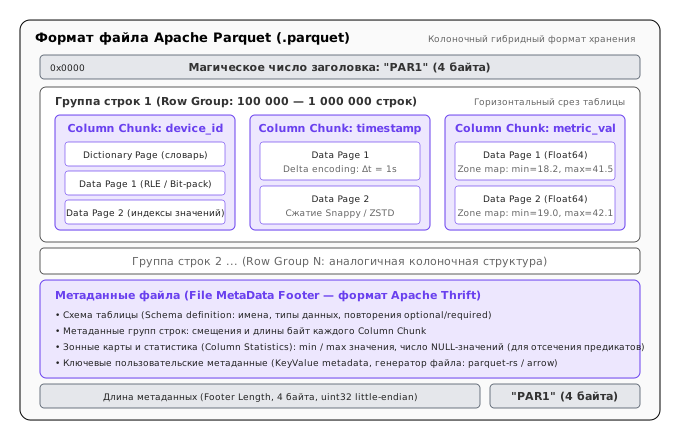
Основные компоненты файла
- Группа строк (Row Group): Логическое разбиение набора данных по горизонтали. Каждая группа строк содержит данные для фиксированного числа строк (обычно от 100 000 до 1 000 000 строк или 128–512 МБ несжатых данных). Наличие нескольких групп строк позволяет обрабатывать файл параллельно несколькими потоками.
- Фрагмент столбца (Column Chunk): Данные одного конкретного столбца в рамках одной группы строк. Фрагмент сохраняется на диске непрерывным блоком.
- Страницы (Pages): Минимальная единица сжатия и чтения внутри фрагмента столбца (обычно около 1 МБ). Бывают страницами данных (Data Page) и страницами словарей (Dictionary Page).
- Подвал файла (File Footer / File MetaData): Ключевая особенность Parquet — метаданные хранятся в конце файла. Движок чтения сначала обращается к последним байтам файла, считывает длину метаданных, читает подвал через Apache Thrift, узнаёт точную схему таблицы, типы данных, смещения всех колонок и их статистику, и лишь затем точечно запрашивает нужные диапазоны байт.
Алгоритмы кодирования и сжатия
Перед тем как сжать страницу универсальным алгоритмом (Snappy, ZSTD, Gzip), Parquet применяет предварительное кодирование значений:
- Словарное кодирование (Dictionary Encoding):
Строковые значения заменяются компактными целочисленными индексами. Например, названия районов города заменяются байтами
0, 1, 2, а словарь уникальных строк сохраняется отдельно в Dictionary Page. - Кодирование длин серий (Run-Length Encoding, RLE) и упаковка бит (Bit-Packing):
Последовательность повторяющихся значений
[5, 5, 5, 5, 5]сохраняется как пара(5 раз, значение 5). - Дельта-кодирование (Delta Encoding): Для монотонно возрастающих значений (например, временных меток с шагом в 1 секунду) сохраняется только базовое значение и разности между соседними элементами.
После кодирования блок сжимается:
- Snappy: промышленный стандарт по умолчанию — умеренное сжатие при колоссальной скорости распаковки (до 1 ГБ/с на ядро CPU).
- Zstandard (ZSTD): современный алгоритм от Meta, обеспечивающий превосходный баланс между высоким коэффициентом сжатия и высокой скоростью декомпрессии.
Статистика и предикатный пушдаун (Predicate Pushdown)
В подвале Parquet-файла для каждого фрагмента столбца в каждой группе строк сохраняются так называемые зонные карты (Zone Maps / Column Statistics):
- минимальное значение (
min_value); - максимальное значение (
max_value); - число значений
NULL(null_count).
Рассмотрим аналитический запрос к телеметрии:
SELECT avg(temperature)
FROM telemetry
WHERE timestamp >= '2024-06-01' AND timestamp < '2024-07-01';
Движок выполнения запросов (например, DuckDB) читает метаданные подвала файла Parquet. Если для группы строк 1 зонная карта показывает min_value = '2024-01-01' и max_value = '2024-03-31', движок полностью пропускает чтение этой группы строк (Row Group Skipping). Ни один байт данных этой группы строк не считывается с диска.
Этот механизм называется предикатным пушдауном (Predicate Pushdown): фильтрация переносится с уровня вычислительного ядра на уровень подсистемы чтения формата данных 4.
Apache Arrow: колоночный стандарт в оперативной памяти
Если Apache Parquet оптимизирован для долгосрочного хранения на диске и эффективного сжатия, то Apache Arrow — это стандарт представления колоночных данных в оперативной памяти (In-Memory Columnar Format) 5.
До появления Arrow каждый фреймворк (Pandas, DuckDB, Spark, ClickHouse) использовал собственный внутренний формат памяти. При передаче данных между ними до 80 % времени уходило на сериализацию и десериализацию объектов.
Apache Arrow определяет стандартизированную структуру непрерывных буферов памяти:
- Bitmap валидности (Validity Bitmap): один бит на значение, где
1означает присутствие данных, а0—NULL. - Массив смещений (Offsets Buffer): для строк переменной длины.
- Буфер данных (Data Buffer): непрерывный массив байт.
Благодаря Arrow различные аналитические библиотеки могут обращаться к одной и той же области памяти с нулевым копированием (Zero-Copy Sharing): например, DuckDB может напрямую выполнять SQL-запрос по DataFrame библиотеки Polars или Pandas без копирования байт данных.
Итоги темы
Колоночные форматы произвели революцию в аналитике больших данных. Разделение данных по колонкам позволяет читать только запрошенные поля (Column Pruning), а зонные карты метаданных отсекают чтение ненужных диапазонов строк (Row Group Skipping). Формат Parquet гарантирует компактное и безопасное хранение на диске с алгоритмами кодирования RLE и словарями, а стандарт Apache Arrow обеспечивает молниеносный анализ в памяти без накладных расходов на сериализацию.
Литература
- Kleppmann M. Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. — O'Reilly Media, 2017. — Chapter 3: Storage and Retrieval 1.
- Abadi D., Boncz P., Harizopoulos S. The Design and Implementation of Modern Column-Oriented Database Systems. — Foundations and Trends in Databases, 2013, Vol. 5, No. 3, С. 197–280 2.
- Melnik S., Gubarev A., Long J. J., Romer G., Shivakumar S., Tolton M., Vassilakis T. Dremel: Interactive Analysis of Web-Scale Datasets. — Proceedings of the VLDB Endowment, 2010, Vol. 3, No. 1–2, С. 330–339 3.
- Apache Parquet Documentation. Parquet Format Specification. — The Apache Software Foundation, 2024. https://parquet.apache.org/docs/file-format/ 4.
- Apache Arrow Documentation. Arrow Columnar Format. — The Apache Software Foundation, 2024. https://arrow.apache.org/docs/format/Columnar.html 5.