
Распределённые платформы потоковых данных: Apache Kafka
В системах интернета вещей, мониторинга энергосетей и управления транспортом данные не возникают однократными пакетами раз в сутки. Они рождаются как непрерывный поток событий (Event Stream): сотни тысяч датчиков, расходомеров и умных контроллеров ежесекундно отправляют сообщения о текущем состоянии объектов.
Традиционная интеграция через прямую запись каждого сообщения в реляционную или документоориентированную СУБД быстро приводит к отказу: база данных захлебывается от миллионов мелких транзакций вставки, а одновременные запросы аналитиков блокируют входящий поток телеметрии. Попытки использовать классические брокеры сообщений (RabbitMQ, ActiveMQ) также наталкиваются на ограничения: они созданы для очередей задач, где сообщение удаляется сразу после подтверждения его обработки одним получателем, и не способны хранить терабайты истории для повторного чтения 1.
Стандартом индустрии для построения потоковых магистралей данных стала распределенная платформа Apache Kafka, созданная инженерами LinkedIn 2.
Архитектура: распределённый журнал фиксации (Commit Log)
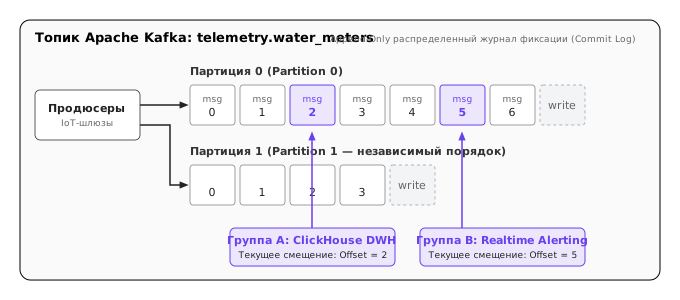
В основе Apache Kafka лежит предельно простая, но фундаментальная абстракция: неизменяемый распределённый журнал с последовательной дозаписью (Distributed Append-Only Commit Log) 3.
В отличие от традиционных очередей, в Kafka:
- Сообщения не удаляются после того, как их прочитал потребитель. Они сохраняются на диске в течение заданного времени хранения (Retention Period, например, 7 дней или бессрочно).
- Чтение сообщения не меняет состояние брокера. Разные независимые системы (хранилище телеметрии ClickHouse, аналитический конвейер DuckDB, система мгновенных аварийных оповещений) могут читать один и тот же поток событий независимо, с разной скоростью и в разное время.
Ключевые концепции
- Топик (Topic): Логическая категория или поток сообщений (например,
telemetry.water_metersилиalerts.critical). - Партиция (Partition): Единица параллелизма и масштабирования топика. Каждый топик разбивается на N партиций, распределенных по разным серверам (брокерам) кластера. Внутри одной партиции гарантируется строгий порядок сообщений.
- Смещение (Offset): Уникальный монотонно возрастающий 64-битный целочисленный номер, присваиваемый каждому сообщению внутри партиции.
- Производитель (Producer): Приложение, отправляющее события в Kafka. Производитель может указать ключ сообщения (
key): сообщения с одинаковым ключом (например,device_id = "MTR-4021") всегда гарантированно попадают в одну и ту же партицию за счет хешированияhash(key) % num_partitions. - Потребитель (Consumer) и группа потребителей (Consumer Group): Группа независимых экземпляров сервиса, совместно вычитывающих топик. Каждая партиция назначается ровно одному потребителю внутри группы, обеспечивая горизонтальное масштабирование чтения.
Механизмы экстремальной производительности
Kafka способна передавать миллионы сообщений в секунду на одном сервере благодаря трем архитектурным решениям:
- Последовательный ввод-вывод (Sequential I/O): Запись и чтение на диск происходят строго последовательно. На современных дисках (даже HDD) скорость линейной последовательной записи достигает сотен мегабайт в секунду, сопоставимо со скоростью случайного доступа в RAM.
- Использование системного дискового кэша (Page Cache): Kafka исполняется на виртуальной машине Java (JVM), но не кэширует сообщения в куче JVM (Heap), избегая накладных расходов сборщика мусора (Garbage Collection). Вместо этого брокер полностью полагается на кэш страниц ядра Linux (Page Cache).
- Нулевое копирование через системный вызов
sendfile(Zero-Copy): При передаче данных из журнала в сеть брокер использует системный вызов ядраsendfile(): данные передаются из кэша страниц напрямую в буфер сетевого адаптера, минуя пространство пользователя. Это полностью исключает копирование байт в память приложения и снижает нагрузку на CPU 4.
Семантики доставки сообщений
В распределенных системах передача сообщений по ненадежной сети сталкивается с сетевыми сбоями и отказами узлов. Kafka поддерживает три уровня гарантий доставки:
- At-most-once (не более одного раза): Сообщения могут теряться, но никогда не дублируются. Смещение фиксируется до фактической обработки сообщения.
- At-least-once (как минимум один раз):
Стандартный и наиболее надежный промышленный режим: производитель ждет подтверждения от реплик (
acks=all), а потребитель фиксирует смещение (commit) только после успешной обработки и сохранения данных. При сбое сообщение может быть прочитано повторно, что требует идемпотентности приемника. - Exactly-once (ровно один раз, EOS):
Сочетание идемпотентного продюсера (
enable.idempotence=true) и двухфазных распределенных транзакций между топиками Kafka, гарантирующее, что каждое событие отразится в итоговом состоянии ровно один раз даже при сбоях брокеров и перезапусках сервисов.
Архитектурные шаблоны: Lambda и Kappa
Интеграция потоковой обработки в корпоративное хранилище строится по двум классическим паттернам 5:
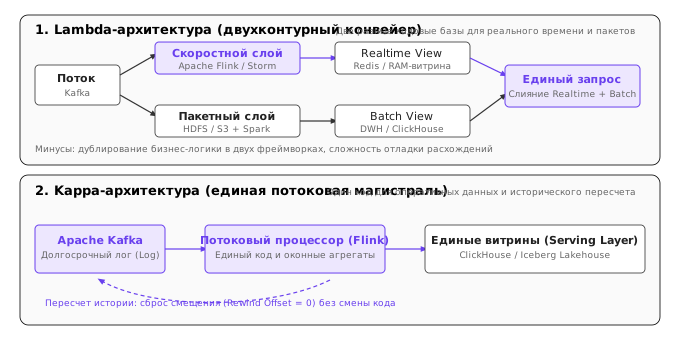
- Lambda-архитектура: Исторический шаблон с разделением на два независимых тракта: быстрый (Speed Layer) для мгновенного приближенного анализа последних часов и пакетный (Batch Layer) для медленной, но точной ночной переобработки исторической базы. Недостаток — необходимость поддерживать две разные кодовые базы.
- Kappa-архитектура (предложенная Джеем Крепсом): Отказ от пакетного слоя в пользу единой потоковой магистрали. Все данные непрерывно поступают через журнал Apache Kafka с длительным хранением. Пересчет истории и аналитика выполняются единым потоковым кодом путем простого сброса смещения потребителя (
rewind offset) к началу журнала.
Итоги темы
Apache Kafka стала центральной нервной системой современных архитектур обработки данных. Модель распределенного журнала фиксации с последовательной записью, нулевым копированием через Page Cache и концепцией групп потребителей обеспечивает колоссальную пропускную способность и отказоустойчивость, связывая датчики IoT, оперативные сервисы оповещения и аналитические хранилища данных в единую масштабируемую экосистему.
Литература
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017. — Chapter 11: Stream Processing 1.
- Kreps J., Narkhede N., Rao J. Kafka: A Distributed Messaging System for Log Processing. — Proceedings of the NetDB Workshop, 2011, С. 1–7 2.
- Kreps J. I Love Logs: Event Data, Stream Processing, and Data Integration. — O'Reilly Media, 2014 3.
- Apache Kafka Documentation. Kafka Design and Architecture Fundamentals. — The Apache Software Foundation, 2024. https://kafka.apache.org/documentation/#design 4.
- Marz N., Warren J. Big Data: Principles and best practices of scalable realtime data systems. — Manning Publications, 2015 5.