
Архитектура современных озёр данных: Data Lakehouse
На протяжении последних десятилетий архитектура корпоративного хранения данных прошла через три фундаментальных этапа:
- Классические хранилища данных (Data Warehouses, 1990–2000-е): Реляционные системы высокой надежности с транзакциями ACID и строгой схемой. Прекрасно подходили для структурированной отчетности, но плохо масштабировались на петабайты сырых данных и не поддерживали неструктурированные форматы.
- Озера данных (Data Lakes, 2010-е): Построенные на базе Hadoop HDFS, а затем облачных объектных хранилищ (Amazon S3, MinIO, Ceph). Позволили дешево сохранять любые объемы сырых файлов (CSV, JSON, Parquet). Однако «озера» быстро превратились в неуправляемые «болота данных» (Data Swamps): отсутствие транзакций приводило к чтению полузаписанных файлов при сбоях, отсутствовала версионность, а изменение одной строки требовало перезаписи терабайтных разделов 1.
- Data Lakehouse (современный этап): Новая открытая парадигма, предложенная создателями Apache Spark и Databricks 2. Она объединяет низкую стоимость и масштабируемость объектных хранилищ с надежностью, схемами и транзакциями ACID классических СУБД.
В этой заключительной теме мы разберем устройство открытых форматов таблиц (Open Table Formats: Apache Iceberg, Delta Lake), концепцию разделения хранения и вычислений, управление метаданными и возможность путешествия во времени (Time Travel).
Архитектура Data Lakehouse
Главный принцип архитектуры Lakehouse — полное разделение подсистемы хранения и вычислительных движков (Separation of Storage and Compute):
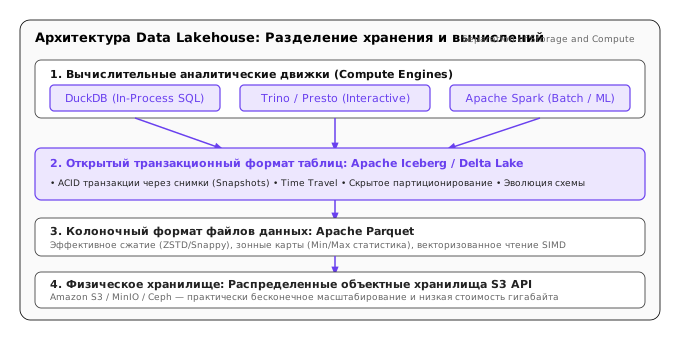
Вместо привязки к единственной монолитной СУБД, данные сохраняются в открытом объектном хранилище в стандартном формате Apache Parquet. Поверх них накладывается транзакционный уровень управления метаданными (Apache Iceberg или Delta Lake), к которому могут одновременно обращаться десятки разнородных вычислительных ядер: DuckDB для быстрой локальной аналитики, Trino для распределенных интерактивных SQL-запросов и Spark для пакетного машинного обучения.
Устройство открытого формата таблиц на примере Apache Iceberg
Созданный в Netflix и переданный в Apache Software Foundation, формат Apache Iceberg решил главную проблему озер данных: как выполнять атомарные транзакции над неизменяемыми файлами в объектном хранилище 3.
Таблица Iceberg представляет собой не просто каталог с файлами, а трехуровневое дерево метаданных:
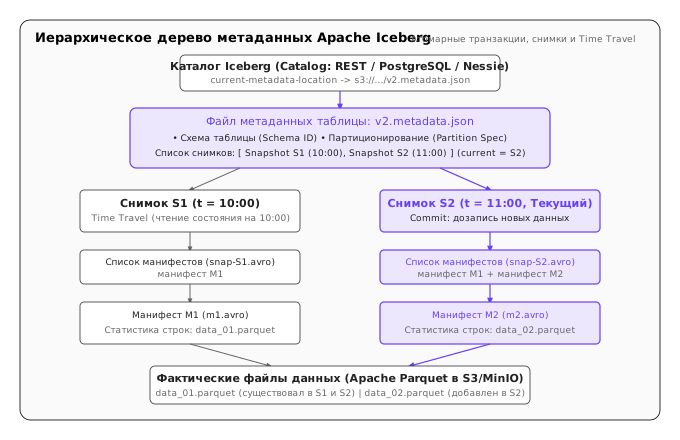
Компоненты дерева Iceberg
- Каталог (Catalog): Центральный реестр (REST-каталог, Hive Metastore или PostgreSQL), хранящий атомарную ссылку на текущий актуальный файл метаданных таблицы.
- Файл метаданных таблицы (Table Metadata): Содержит эволюцию схемы таблицы, историю партиционирования и список всех моментальных снимков (Snapshots).
- Список манифестов (Manifest List): Фиксирует снимок состояния таблицы на определенный момент времени и перечисляет файлы манифестов с их диапазонами разделов.
- Файлы манифестов (Manifest Files): Содержат списки реальных файлов данных Parquet, а также подробные зонные карты (минимумы, максимумы и число
null) для каждого столбца каждого файла. - Файлы данных (Data Files): Непосредственно файлы Parquet или ORC, расположенные в бакетах S3/MinIO.
Ключевые возможности Lakehouse
1. Гарантии ACID и изоляция снимков (Snapshot Isolation)
Операции записи в Iceberg никогда не перезаписывают существующие файлы данных. Вместо этого они записывают новые файлы Parquet, создают новые файлы манифестов и формируют новый моментальный снимок (Snapshot). Фиксация транзакции заключается в атомарной замене указателя на снимок в каталоге с помощью механизма оптимистического контроля параллелизма (OCC: Compare-And-Swap) 4. Читатели видят согласованное состояние данных и никогда не блокируют писателей.
2. Путешествие во времени (Time Travel) и откат изменений
Поскольку исторические снимки и связанные с ними манифесты сохраняются, аналитик может запросить состояние хранилища на любую дату и время в прошлом или к конкретному идентификатору снимка:
-- Запрос к состоянию телеметрии на 10 утра вчерашнего дня в DuckDB:
SELECT district, avg(val)
FROM iceberg_scan('s3://lake/telemetry', as_of = '2024-03-01 10:00:00')
GROUP BY district;
Это позволяет воспроизводить отчеты полугодичной давности, отлаживать ошибки в ETL-конвейерах и мгновенно откатывать ошибочные пакетные загрузки.
3. Эволюция схемы и скрытое партиционирование (Hidden Partitioning)
В традиционных СУБД удаление или переименование столбца требует переписывания терабайтов данных. В Iceberg схема отвязана от файлов: столбцам присваиваются уникальные неизменяемые целочисленные ID, что позволяет добавлять, переименовывать и удалять столбцы за миллисекунды простой правкой метаданных.
Скрытое партиционирование (Hidden Partitioning): Пользователю больше не нужно вручную формировать искусственные столбцы вроде year и month для фильтрации подкаталогов. Iceberg сам вычисляет функции партиционирования (days(timestamp)) и автоматически отсекает ненужные файлы при обычном запросе с фильтром по дате.
4. Обслуживание данных: компактизация мелких файлов
Потоковая запись телеметрии в реальном времени приводит к появлению множества мелких файлов Parquet (small files problem). В Lakehouse фоновые служебные процессы периодически выполняют операцию компактизации (Compaction): переписывают десятки мелких файлов в крупные блоки по 512 МБ с обновлением манифестов в новой атомарной транзакции без остановки читающих аналитиков.
Итоги темы и курса
Парадигма Data Lakehouse стерла грань между транзакционными базами данных и масштабируемыми файловыми озерами. Объединив открытые колоночные форматы хранения (Parquet), векторные стандарты памяти (Arrow), высокоскоростные встраиваемые движки (DuckDB) и транзакционные форматы открытых таблиц (Apache Iceberg), современная инженерия данных сформировала гибкий, экономичный и невероятно мощный технологический стек для обработки любых объемов структурированных и телеметрических данных.
Литература
- Armbrust M. et al. Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics. — Proceedings of CIDR 2021 1.
- Zaharia M. et al. Delta Lake: High-Performance ACID Table Storage over Cloud Object Stores. — Proceedings of the VLDB Endowment, 2020, Vol. 13, No. 12, С. 3411–3424 2.
- Apache Iceberg Project. Apache Iceberg Table Spec: Format Version 2. — Apache Software Foundation, 2024. https://iceberg.apache.org/spec/ 3.
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017 4.