
Основы облачных технологий
На протяжении нескольких десятилетий вычислительная инфраструктура организаций строилась преимущественно на локальных ресурсах. Серверы размещались в собственных или арендованных помещениях, закупались с запасом на пиковые нагрузки, требовали физического обслуживания и планирования замены оборудования. Такая модель обеспечивала полный контроль над средой, но порождала целый ряд устойчивых проблем: длительные сроки ввода мощностей в эксплуатацию, низкий средний коэффициент использования оборудования и необходимость содержать штат специалистов для обслуживания физической инфраструктуры.
Облачные вычисления представляют собой принципиально иной подход к организации доступа к вычислительным ресурсам. Вместо приобретения и сопровождения оборудования потребитель получает ресурсы по запросу через сеть, оплачивая фактическое потребление. Эта модель изменяет не только экономику владения инфраструктурой, но и способ проектирования, развертывания и сопровождения программных систем. Поэтому понимание основ облачной модели является обязательной предпосылкой для дальнейшего изучения виртуализации, контейнеризации и оркестрации, составляющих технологическое ядро данного курса.
Настоящая тема раскрывает фундаментальные понятия облачных вычислений: сущность облачной модели и её ключевые признаки, модели предоставления сервисов, модели развертывания инфраструктуры, а также экономические и эксплуатационные эффекты, определяющие практический смысл перехода к облаку. Каждый из этих вопросов рассматривается не только в описательном ключе, но и с позиции ограничений, допущений и типичных ошибок интерпретации, которые возникают при первом знакомстве с облачной тематикой.
Сущность облачной модели вычислений
Переход от локальной инфраструктуры к модели предоставления ресурсов по запросу
Традиционная модель организации вычислительной инфраструктуры предполагает, что организация самостоятельно приобретает, размещает и обслуживает аппаратные ресурсы. Сервер, закупленный для конкретного проекта, физически устанавливается в серверном помещении или центре обработки данных (ЦОД), подключается к сети, настраивается, а затем эксплуатируется на протяжении нескольких лет до момента замены. Этот подход принято обозначать термином «on-premises» (локальное размещение). Его ключевая особенность состоит в том, что ответственность за все уровни инфраструктуры — от электропитания до прикладного программного обеспечения — лежит на самой организации.
Облачная модель вычислений меняет этот принцип. Вычислительные, сетевые и дисковые ресурсы предоставляются сторонним поставщиком через программный интерфейс или веб-консоль. Потребитель не владеет оборудованием, не отвечает за его физическое размещение и не планирует его жизненный цикл. Вместо этого он формулирует требования к ресурсам, получает их в необходимом объёме и освобождает по мере завершения потребности. Такая модель делает вычислительные ресурсы аналогичными коммунальным услугам: они доступны по требованию, потребляются в необходимом количестве и оплачиваются по факту использования.
Важно подчеркнуть, что переход к облаку не сводится к замене физического оборудования виртуальным. Облачная модель меняет саму логику взаимодействия с инфраструктурой. Если при локальном размещении решение о приобретении ресурсов принимается заблаговременно, с учётом прогнозируемой нагрузки, то в облачной среде ресурсы могут быть получены в момент возникновения потребности и возвращены сразу после её удовлетворения. Это различие имеет не только экономические, но и архитектурные следствия: приложения могут проектироваться с расчётом на динамическое изменение объёма доступных ресурсов, а не на фиксированную аппаратную конфигурацию.
Ключевые признаки облачной среды
Для формального определения облачных вычислений в мировой практике принято опираться на характеристики, сформулированные Национальным институтом стандартов и технологий США (National Institute of Standards and Technology, NIST) в специальной публикации NIST SP 800-145 «The NIST Definition of Cloud Computing» (2011) 1. Документ занимает всего несколько страниц и определяет облачные вычисления как модель, обеспечивающую повсеместный и удобный сетевой доступ по требованию к общему пулу конфигурируемых вычислительных ресурсов (сетей, серверов, хранилищ, приложений, сервисов), которые могут быть быстро выделены и освобождены с минимальными усилиями по управлению и минимальным взаимодействием с поставщиком. Модель NIST состоит из трёх частей: пяти существенных признаков, трёх сервисных моделей и четырёх моделей развертывания. Согласно этому определению, облачная среда обладает пятью существенными признаками.
Первый признак — самообслуживание по требованию (on-demand self-service). Потребитель может самостоятельно выделять вычислительные ресурсы — серверные мощности, хранилища, сетевые компоненты — без необходимости обращения к представителю поставщика. Это означает, что процесс предоставления ресурсов автоматизирован и доступен через программный интерфейс или панель управления.
Второй признак — широкая сетевая доступность (broad network access). Облачные ресурсы доступны через сеть с использованием стандартных протоколов и механизмов доступа. Это позволяет потребителям работать с инфраструктурой из различных сред: рабочих станций, мобильных устройств, удалённых терминалов.
Третий признак — объединение ресурсов (resource pooling). Поставщик объединяет физические ресурсы в общий пул и динамически распределяет их между несколькими потребителями. Конкретный потребитель, как правило, не контролирует и не знает точного физического расположения предоставленных ему ресурсов, хотя может задать ограничения на уровне региона или зоны доступности (эти понятия разобраны ниже, в разделе о распределённости облака).
Четвёртый признак — быстрая эластичность (rapid elasticity). Ресурсы могут масштабироваться — увеличиваться или уменьшаться — в соответствии с текущими потребностями потребителя. С точки зрения пользователя доступные ресурсы кажутся практически неограниченными и могут быть получены в любом объёме в любой момент. Именно эту «иллюзию бесконечных ресурсов» вместе с отсутствием предварительных обязательств и оплатой за краткосрочное использование авторы известного обзора облачных вычислений из Беркли называют главной новизной облака по сравнению с прежними формами аренды 2.
Пятый признак — измеряемость потребления (measured service). Облачная система автоматически контролирует и оптимизирует использование ресурсов, предоставляя механизмы мониторинга, отчётности и прозрачного учёта потребления. Это обеспечивает возможность оплаты строго за использованные ресурсы и позволяет обеим сторонам — поставщику и потребителю — контролировать объём предоставленных услуг.
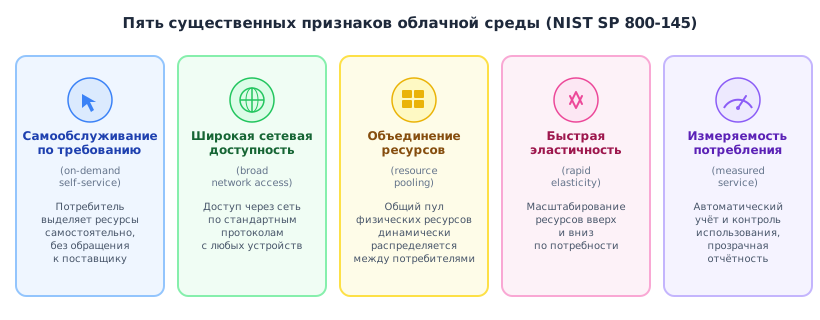
Следует оговориться, что перечисленные признаки описывают идеальную модель. На практике конкретные облачные платформы могут реализовывать эти свойства в различной степени. Например, эластичность может быть ограничена квотами, время выделения ресурсов может составлять не секунды, а минуты, а механизмы учёта потребления могут существенно различаться по прозрачности и детализации. Тем не менее именно совокупность этих пяти признаков позволяет отличить облачную среду от традиционного хостинга или обычной аренды виртуальных серверов, где степень автоматизации и эластичности существенно ниже.
Отличие облачных вычислений от традиционного хостинга и классической серверной инфраструктуры
Разграничение облачных вычислений и традиционного хостинга важно не только терминологически, но и практически. Услуги традиционного хостинга — аренда выделенного сервера, виртуального сервера с фиксированной конфигурацией, размещение оборудования в ЦОД — существуют на рынке давно и продолжают использоваться. Однако они, как правило, не обладают свойствами эластичности и автоматического самообслуживания. Арендованный сервер предоставляется в заранее согласованной конфигурации, его масштабирование требует ручного вмешательства или нового договора, а управление осуществляется через ограниченный набор инструментов.
Облачная модель отличается тем, что инфраструктура программно определяема (software-defined). Это означает, что создание, конфигурирование, масштабирование и уничтожение ресурсов осуществляется через программный интерфейс (API), а не посредством физических операций или переговоров с поставщиком. Программная определяемость делает инфраструктуру пригодной для автоматизации: ресурсы могут создаваться и удаляться скриптами, описываться в конфигурационных файлах и управляться как часть программного проекта.
Рассмотрим, как это выглядит на практике. Создание виртуальной машины в AWS сводится к одному вызову программного интерфейса; утилита командной строки AWS CLI формирует HTTPS-запрос RunInstances к конечной точке ec2.eu-central-1.amazonaws.com, подписывает его ключом учётной записи и печатает ответ сервиса 7:
aws ec2 run-instances \
  --region eu-central-1 \
  --image-id ami-0abcdef1234567890 \
  --instance-type t3.micro \
  --count 1 \
  --tag-specifications 'ResourceType=instance,Tags=[{Key=Name,Value=demo-web}]'
{
    "ReservationId": "r-0123456789abcdef0",
    "OwnerId": "123456789012",
    "Instances": [
        {
            "InstanceId": "i-0a1b2c3d4e5f67890",
            "InstanceType": "t3.micro",
            "ImageId": "ami-0abcdef1234567890",
            "LaunchTime": "2026-10-22T09:14:03+00:00",
            "Placement": {
                "AvailabilityZone": "eu-central-1b",
                "Tenancy": "default"
            },
            "State": {
                "Code": 0,
                "Name": "pending"
            },
            ...
        }
    ]
}
В этом ответе заметны сразу несколько свойств облачной модели. Ресурс получил идентификатор i-… за доли секунды, без участия человека со стороны поставщика — это самообслуживание по требованию. Состояние pending означает, что вызов асинхронный: API принял заявку и вернул управление, а сама машина будет запущена на одном из физических узлов позже, обычно в пределах минуты; её готовность нужно проверять отдельным запросом (aws ec2 describe-instances). Зону доступности eu-central-1b выбрал поставщик, поскольку запрос её не задавал, — это объединение ресурсов. Освобождение ресурса — такой же вызов:
aws ec2 terminate-instances --region eu-central-1 --instance-ids i-0a1b2c3d4e5f67890
{
    "TerminatingInstances": [
        {
            "InstanceId": "i-0a1b2c3d4e5f67890",
            "CurrentState": { "Code": 32, "Name": "shutting-down" },
            "PreviousState": { "Code": 16, "Name": "running" }
        }
    ]
}
Идентификаторы в примере условные, но структура ответа соответствует документации. Посекундная тарификация начинается с перехода в состояние running и заканчивается после завершения машины, поэтому машина, прожившая десять минут, оплачивается как десять минут (у AWS для Linux-машин — с минимумом в одну минуту). Именно такие вызовы вместо заявок и договоров делают возможной инфраструктуру как код (тема 9), а подпись запроса и права учётной записи, от имени которой он выполнен, подробно рассматриваются в темах 10 и 11.
Ещё одно существенное отличие касается модели тарификации. Традиционный хостинг чаще всего предполагает фиксированную абонентскую плату за заранее определённый объём ресурсов, независимо от фактической загрузки. Облачная модель в типичном случае предполагает оплату по факту потребления (pay-as-you-go): потребитель платит за количество использованных процессорных часов, объём хранимых данных, объём переданного сетевого трафика. Это различие создаёт как преимущества, так и риски, которые подробнее рассматриваются в разделе об экономике облака.
Таким образом, облачные вычисления не следует воспринимать как простое продолжение услуг хостинга. Это качественно иная модель, в основе которой лежат программная определяемость, эластичность, автоматизированное управление и учёт потребления. Понимание этих различий необходимо для корректной оценки возможностей и ограничений облачной инфраструктуры.
Модели предоставления сервисов
Облачная модель вычислений не является однородной. В зависимости от того, какой именно уровень инфраструктуры предоставляется потребителю в виде управляемого сервиса, принято различать несколько моделей обслуживания. Каждая из них определяет границу ответственности между поставщиком облачных услуг и потребителем (эталонная архитектура NIST описывает эти роли подробно и добавляет к ним посредника, оператора связи и аудитора 9): чем выше уровень абстракции сервиса, тем меньше задач ложится на потребителя и тем больше контроля он передаёт поставщику.
Инфраструктура как услуга (Infrastructure as a Service, IaaS)
Модель IaaS предоставляет потребителю базовые вычислительные ресурсы: виртуальные машины, дисковые хранилища, сетевые компоненты. Потребитель получает доступ к виртуализированной инфраструктуре, на которой он самостоятельно устанавливает операционную систему, настраивает среду выполнения, развёртывает приложения и отвечает за их сопровождение. Поставщик при этом обеспечивает работоспособность физического оборудования, гипервизора, сетевой инфраструктуры и базовых служб платформы.
Граница ответственности в IaaS проходит на уровне операционной системы. Всё, что находится выше — системное администрирование, установка обновлений, настройка безопасности, развертывание приложений — является задачей потребителя. Это создаёт максимальную гибкость: потребитель может использовать любые операционные системы, любые программные стеки и любые конфигурации. Однако эта же гибкость порождает значительную эксплуатационную нагрузку, поскольку требует квалификации в области системного администрирования, сетевой безопасности и сопровождения инфраструктуры.
IaaS является наиболее близкой к традиционной серверной модели формой облачного сервиса. Потребитель работает с виртуальными машинами примерно так же, как с физическими серверами, но получает преимущества облачной модели: эластичность, автоматизируемость и оплату по факту потребления. Примерами IaaS-сервисов являются Amazon EC2, Google Compute Engine, Azure Virtual Machines, Yandex Compute Cloud.
Платформа как услуга (Platform as a Service, PaaS)
Модель PaaS поднимает уровень абстракции выше. Потребитель получает не виртуальную машину, а готовую платформу для развертывания приложений. Поставщик берёт на себя управление операционной системой, средой выполнения, базовыми службами и инфраструктурными компонентами. Потребитель сосредоточен на разработке, развертывании и сопровождении прикладного кода, не занимаясь вопросами конфигурации серверов и системного программного обеспечения.
Практический смысл PaaS состоит в сокращении эксплуатационной нагрузки. Разработчик загружает код приложения, а платформа обеспечивает его исполнение, масштабирование, балансировку нагрузки и базовый мониторинг. Это позволяет существенно ускорить цикл разработки и развертывания, особенно для типовых веб-приложений и сервисов. Однако у этой модели есть и ограничения. PaaS накладывает требования на архитектуру приложения: поддерживаемые языки программирования, среды выполнения, способы хранения данных и механизмы масштабирования определяются поставщиком платформы. Если приложение не вписывается в предложенные рамки, его адаптация может оказаться трудоёмкой или невозможной.
Ещё одним следствием модели PaaS является более выраженная зависимость от поставщика (vendor lock-in). Приложение, спроектированное под конкретную платформу, может использовать специфические интерфейсы, механизмы хранения и способы конфигурации, которые не переносятся напрямую на другие платформы. Поэтому выбор PaaS требует осознанной оценки баланса между удобством и степенью привязки. Примерами PaaS-сервисов являются Google App Engine, Heroku, Azure App Service.
Программное обеспечение как услуга (Software as a Service, SaaS)
Модель SaaS представляет собой наивысший уровень абстракции в классификации облачных сервисов. Потребитель получает доступ к готовому приложению, работающему в облачной инфраструктуре поставщика. Вся ответственность за инфраструктуру, платформу, среду выполнения и само приложение лежит на поставщике. Потребитель использует приложение через веб-интерфейс или API, не занимаясь ни его установкой, ни обновлением, ни обеспечением доступности.
SaaS является наиболее распространённой формой облачного потребления для конечных пользователей. Примеры SaaS-решений хорошо знакомы: почтовые сервисы, системы управления проектами, офисные пакеты, платформы для совместной работы. С точки зрения курса облачных технологий модель SaaS интересна прежде всего как граничный случай, демонстрирующий предельную степень передачи контроля поставщику. Потребитель SaaS не имеет доступа ни к инфраструктуре, ни к платформе, ни к исходному коду приложения. Его возможности ограничены конфигурацией, предусмотренной поставщиком.
Ограничения SaaS проявляются в невозможности глубокой настройки, в зависимости от политик поставщика в отношении хранения данных, доступности и функциональных обновлений, а также в риске потери доступа к данным при прекращении оказания услуги. Для инженерных задач, связанных с проектированием и эксплуатацией инфраструктуры, SaaS является объектом изучения, но не основным инструментом работы.
Производные модели: контейнеры и функции как услуга
Определение NIST 1 знает только три сервисные модели, однако за прошедшие годы между IaaS и PaaS появились две модели, которые поставщики выделяют как самостоятельные. Обе они отличаются от трёх базовых не уровнем абстракции «вообще», а единицей, которую потребитель передаёт платформе, и единицей, за которую он платит.
Контейнеры как услуга (Containers as a Service, CaaS) — модель, в которой потребитель передаёт платформе образ контейнера и описание желаемого числа экземпляров, а платформа размещает контейнеры на своих узлах, перезапускает их при сбоях и балансирует трафик. Потребитель не администрирует операционную систему узлов, но сохраняет контроль над содержимым образа: языком, библиотеками, версией среды выполнения. Примеры — Amazon ECS с Fargate, Google Cloud Run, управляемые кластеры Kubernetes (Amazon EKS, Google GKE, Yandex Managed Service for Kubernetes). Устройство контейнера рассматривается в теме 3, оркестрация — в теме 7.
Функции как услуга (Function as a Service, FaaS), или бессерверные вычисления (serverless computing), — модель, в которой единицей развертывания является отдельная функция, вызываемая событием: HTTP-запросом, появлением объекта в хранилище, сообщением в очереди. Платформа запускает экземпляр функции при поступлении события и останавливает его после периода бездействия, поэтому при отсутствии запросов потребитель не платит за вычисления совсем 10. Цена этой модели — холодный старт (первый вызов после простоя ждёт создания экземпляра, от десятков миллисекунд до нескольких секунд), ограничение времени исполнения одного вызова (у AWS Lambda — 15 минут) и отсутствие локального состояния между вызовами: всё, что должно сохраниться, записывается во внешнее хранилище. Примеры — AWS Lambda, Google Cloud Functions, Yandex Cloud Functions.
| Модель | Что передаёт потребитель | Чем управляет потребитель | Единица тарификации | Пример |
|---|---|---|---|---|
| IaaS | образ ВМ, конфигурацию | ОС, среда выполнения, приложение | секунда работы ВМ | Amazon EC2 |
| CaaS | образ контейнера | содержимое образа, число экземпляров | секунда работы контейнера или узла | Google Cloud Run, Amazon EKS |
| PaaS | исходный код или архив приложения | код и конфигурация приложения | экземпляр платформы в час | Heroku, Azure App Service |
| FaaS | код функции и триггер | код функции | вызов и время исполнения (ГБ·с) | AWS Lambda |
| SaaS | — | данные и настройки | пользователь в месяц | почтовый сервис |
Таблица показывает, что модели упорядочены по тому, насколько мелкой становится единица, которой оперирует потребитель: машина, контейнер, приложение, функция. Чем мельче единица, тем точнее оплата следует за нагрузкой, но тем больше ограничений платформа накладывает на код.
Сравнение моделей
Три базовые модели образуют спектр, на одном конце которого находится максимальный контроль при высокой эксплуатационной нагрузке (IaaS), а на другом — минимальный контроль при минимальной нагрузке (SaaS). PaaS занимает промежуточную позицию.
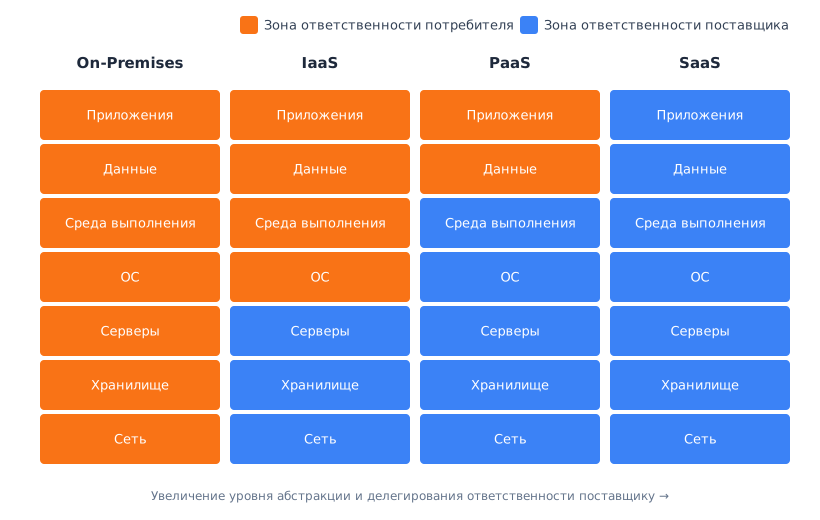
Выбор модели определяется не абстрактными предпочтениями, а конкретными требованиями. Если организации необходимо полное управление операционной системой и сетевой конфигурацией, IaaS является единственным подходящим вариантом. Если задача сводится к быстрому развертыванию типового приложения, PaaS может оказаться более рациональным выбором. Если потребность состоит в использовании готового продукта без необходимости его сопровождения, SaaS удовлетворяет её наиболее полно.
Важно понимать, что границы между моделями не являются абсолютно жёсткими. Современные облачные платформы предлагают сервисы, которые сочетают признаки нескольких моделей. Например, управляемые базы данных предоставляют инфраструктурный ресурс (хранилище, вычисления), но освобождают потребителя от задач системного администрирования, что сближает их с PaaS. Управляемые сервисы оркестрации контейнеров (такие как Amazon EKS или Google GKE) располагаются на границе IaaS и PaaS. Поэтому классификация моделей полезна как концептуальная рамка, но не должна восприниматься как строгая таксономия с непроницаемыми границами.
Модели развертывания облачной инфраструктуры
Помимо модели предоставления сервисов, облачная инфраструктура различается по способу развертывания. Эта классификация отвечает на вопрос о том, кому принадлежит и кем эксплуатируется облачная среда, а также кто имеет к ней доступ. Выбор модели развертывания определяется требованиями к безопасности, нормативному соответствию, стоимости и масштабируемости.
Публичное облако (public cloud)
Публичное облако представляет собой инфраструктуру, которая принадлежит и управляется сторонним поставщиком облачных услуг и предоставляется широкому кругу потребителей. Физические ресурсы являются общими для множества арендаторов (multi-tenancy), хотя каждый потребитель работает в логически изолированной среде. Публичное облако обеспечивает наибольшую эластичность и наименьшие начальные затраты, поскольку потребителю не требуется приобретать оборудование и содержать инфраструктуру.
К основным преимуществам публичного облака относятся практически неограниченная масштабируемость, глобальная географическая доступность, широкий спектр предоставляемых сервисов и модель оплаты по факту потребления. Крупнейшими поставщиками публичных облачных услуг являются Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform (GCP), а также региональные провайдеры, такие как Yandex Cloud.
Вместе с тем публичное облако имеет ограничения. Потребитель не контролирует физическое расположение данных с точностью до конкретного сервера, не может влиять на политику обновления платформы и вынужден полагаться на гарантии поставщика в отношении доступности и безопасности. Для отдельных отраслей — финансового сектора, здравоохранения, государственного управления — нормативные требования могут ограничивать или полностью исключать размещение определённых категорий данных в публичном облаке.
Частное облако (private cloud)
Частное облако представляет собой облачную инфраструктуру, выделенную для использования одной организацией. Оно может размещаться как на собственных площадках организации, так и на площадках стороннего поставщика, но в обоих случаях ресурсы не разделяются с другими потребителями. Частное облако позволяет реализовать те же принципы — самообслуживание, эластичность, измеряемость, — но в контролируемой среде с более жёстким управлением доступом и политиками безопасности.
Мотивация к построению частного облака обычно связана с требованиями безопасности и нормативного соответствия. Организация сохраняет полный контроль над физическим расположением данных, сетевой инфраструктурой и политиками доступа. Это особенно важно в тех случаях, когда обрабатываемые данные подпадают под регуляторные ограничения, требующие их локализации или исключения доступа третьих лиц.
Однако частное облако имеет существенные ограничения. Построение и сопровождение такой инфраструктуры требует значительных капитальных вложений, квалифицированного персонала и непрерывных затрат на эксплуатацию. Масштабируемость частного облака ограничена объёмом имеющихся физических ресурсов: при исчерпании ёмкости необходимо закупать новое оборудование, что занимает время и требует дополнительных инвестиций. Поэтому частное облако, как правило, экономически оправдано для крупных организаций с устойчивыми и предсказуемыми нагрузками.
Гибридное облако (hybrid cloud)
Гибридное облако объединяет элементы публичного и частного облака, обеспечивая возможность переноса нагрузок между ними. Типичный сценарий состоит в том, что базовая нагрузка обрабатывается в частном облаке, а пиковые запросы перенаправляются в публичное. Другой распространённый вариант предполагает размещение критически важных данных в частном облаке с использованием публичного облака для менее чувствительных задач.
Привлекательность гибридной модели состоит в возможности сочетать контроль частного облака с эластичностью публичного. Однако на практике реализация гибридного облака порождает значительные инженерные сложности. Необходимо обеспечить надёжную сетевую связность между средами, единообразные политики безопасности и управления доступом, совместимость форматов данных и механизмов развертывания. Переносимость нагрузок между частным и публичным сегментами требует продуманной архитектуры приложений и инфраструктуры, а не является свойством, возникающим автоматически.
Типичная ошибка при обсуждении гибридного облака состоит в предположении, что простое одновременное использование частной и публичной инфраструктуры уже образует гибридное облако. На самом деле гибридная модель предполагает интеграцию сред: оркестрацию нагрузок, единый контур управления, согласованные политики. Без этих элементов речь идёт о параллельном использовании двух разрозненных инфраструктур, а не о гибридном облаке в строгом смысле.
Общественное облако (community cloud)
Четвёртая модель развертывания в определении NIST — общественное облако (community cloud): инфраструктура, предназначенная для исключительного использования определённым сообществом организаций с общими задачами, требованиями безопасности или нормативными ограничениями 1. Владеть и управлять ею может одна или несколько организаций сообщества, третья сторона или их сочетание, а размещаться она может как на площадке участников, так и вне её.
Общественное облако занимает промежуточное положение между частным и публичным. От частного его отличает то, что ресурсы разделяются между несколькими независимыми организациями, а от публичного — то, что круг арендаторов закрыт и все они подчиняются общему набору требований. Типичные примеры — государственные облака, доступные только ведомствам и проходящие единую сертификацию (AWS GovCloud, Azure Government), отраслевые облака для медицинских или финансовых организаций, научные вычислительные инфраструктуры, разделяемые университетами. Экономический смысл модели состоит в распределении стоимости соответствия требованиям: аттестацию, аудит и выделенный персонал оплачивает сообщество целиком, а не каждый участник отдельно.
Ограничения общественного облака следуют из его закрытости: масштаб пула меньше, чем у публичного облака, поэтому эластичность ниже, а управление требует согласованных правил между участниками — кто расширяет мощности, как делятся расходы, что происходит при выходе организации из сообщества.
Выбор модели развертывания
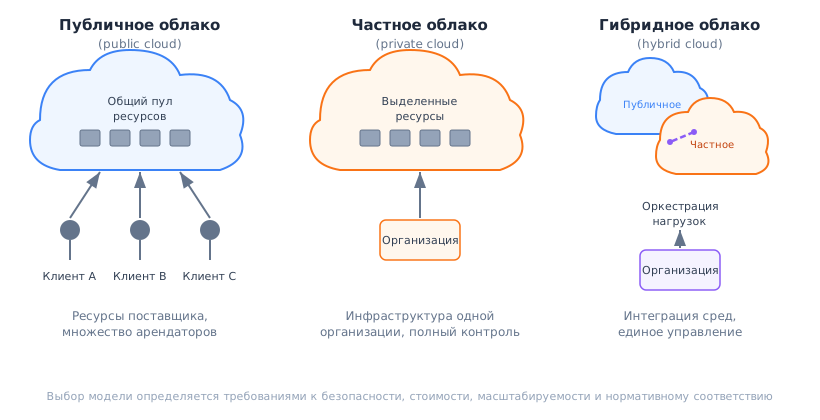
Выбор между публичным, частным и гибридным облаком определяется совокупностью факторов: требованиями к безопасности и нормативному соответствию, характером нагрузок, бюджетными ограничениями, наличием квалифицированных кадров и стратегическими приоритетами организации. Универсального решения не существует. Публичное облако оптимально для стартапов, исследовательских проектов и нагрузок с высокой вариативностью. Частное облако подходит для организаций с жёсткими регуляторными требованиями и стабильной нагрузкой. Гибридное облако позволяет совместить достоинства обоих подходов, но требует зрелой инженерной практики и дополнительных затрат на интеграцию. Общественное облако рационально тогда, когда несколько организаций подчиняются одинаковым требованиям и готовы разделить стоимость их выполнения; на рисунке выше оно не показано, поскольку встречается значительно реже трёх остальных моделей.
Распределённость облака: регионы, зоны доступности, SLA и теорема CAP
Публичное облако физически представляет собой десятки центров обработки данных на разных континентах. Потребителю эта распределённость видна в двух формах: как выбор места размещения ресурса (регион и зона доступности) и как обещание поставщика о доле времени, в течение которой сервис работает (соглашение об уровне обслуживания). У распределённости есть и фундаментальное следствие, которое нельзя отменить никакой инженерией: при разрыве связи между площадками система должна выбирать между согласованностью данных и доступностью. Этому выбору посвящена теорема CAP.
Регионы и зоны доступности
Регион (region) — географическая область, в которой поставщик размещает группу независимых площадок и в пределах которой ресурсы потребителя связаны между собой быстрой сетью: например, eu-central-1 (Франкфурт) у AWS или ru-central1 у Yandex Cloud. Регионы изолированы друг от друга: отказ одного региона не должен затрагивать другие, и по умолчанию данные из региона не выходят. Поэтому выбор региона определяется расстоянием до пользователей (задержкой), требованиями закона о месте хранения данных и ценой, которая у одного и того же ресурса в разных регионах различается.
Зона доступности (availability zone, AZ) — одна или несколько площадок внутри региона с независимым электропитанием, охлаждением и сетевыми подключениями. Зоны разнесены на километры, чтобы пожар, затопление или отключение подстанции не затронули две зоны сразу, но находятся достаточно близко (у AWS — в пределах 100 км) для того, чтобы задержка между ними составляла единицы миллисекунд 5. Такая задержка позволяет синхронно реплицировать данные между зонами, тогда как между регионами, удалёнными на сотни и тысячи километров, синхронная репликация уже заметно замедляет каждую запись.
Список зон региона можно получить тем же программным интерфейсом:
aws ec2 describe-availability-zones --region eu-central-1 \
  --query 'AvailabilityZones[].[ZoneName,ZoneId,State]' --output table
----------------------------------------------------
|             DescribeAvailabilityZones            |
+----------------+-------------+-------------------+
|  eu-central-1a |  euc1-az2   |  available        |
|  eu-central-1b |  euc1-az3   |  available        |
|  eu-central-1c |  euc1-az1   |  available        |
+----------------+-------------+-------------------+
Обратим внимание на два столбца с именами. ZoneName — имя зоны в пространстве учётной записи, ZoneId — идентификатор физической зоны; соответствие между ними может различаться у разных учётных записей 5. Это сделано для равномерного распределения нагрузки: если бы все клиенты по умолчанию выбирали физически одну и ту же «зону a», она переполнялась бы первой. Практическое следствие — при согласовании размещения между двумя учётными записями сравнивать нужно ZoneId, а не имена.
Единица отказа определяет архитектуру. Приложение из одной виртуальной машины переживает отказ сервера (поставщик перезапустит машину на другом узле, если это предусмотрено), но не переживает отказ зоны. Приложение, экземпляры которого распределены по двум или трём зонам за балансировщиком, переживает отказ целой зоны ценой межзонального трафика, который у большинства поставщиков тарифицируется. Приложение, развёрнутое в двух регионах, переживает отказ региона, но сталкивается с проблемой согласованности данных между ними, о которой речь пойдёт ниже.
Соглашение об уровне обслуживания и расчёт допустимого простоя
Соглашение об уровне обслуживания (Service Level Agreement, SLA) — договорное обязательство поставщика обеспечить доступность сервиса не ниже заданной доли времени за расчётный период (обычно календарный месяц) и порядок компенсации при нарушении. Доступность задаётся «девятками», и интуиция плохо работает с ними: разница между 99,9 % и 99,99 % выглядит как десятая доля процента, но в минутах простоя это различие в десять раз.
Допустимое время простоя за период T при доступности A равно (1 - A) \cdot T. Для SLA 99,95 % и месяца из 30 дней (T = 30 \cdot 24 \cdot 60 = 43\,200 минут) допустимый простой в минутах составляет:
(1 - 0{,}9995) \cdot 43\,200 = 0{,}0005 \cdot 43\,200 = 21{,}6
Таким образом, сервис с SLA 99,95 % может быть недоступен около 22 минут в месяц или около 4,4 часа в год, и это не будет нарушением соглашения. Значения для распространённых уровней сведены в таблицу.
| Доступность | Простой за месяц (30 дней) | Простой за год (365 дней) |
|---|---|---|
| 99 % | 432 мин (7 ч 12 мин) | 87,6 ч |
| 99,5 % | 216 мин (3 ч 36 мин) | 43,8 ч |
| 99,9 % | 43,2 мин | 8,76 ч |
| 99,95 % | 21,6 мин | 4,38 ч |
| 99,99 % | 4,32 мин | 52,6 мин |
Приложение, как правило, зависит от нескольких сервисов сразу, и его доступность меньше доступности каждого из них. Если для обработки запроса необходимы и виртуальная машина с SLA 99,5 %, и управляемая база данных с SLA 99,95 %, а их отказы независимы, то доступность цепочки равна произведению, а простой в минутах за месяц — почти четырём часам:
0{,}995 \cdot 0{,}9995 \approx 0{,}99450, \qquad (1 - 0{,}99450) \cdot 43\,200 \approx 237{,}5
Если же запросы обслуживают две машины в разных зонах и для работы достаточно любой из них, вероятность одновременного отказа обеих равна (1 - 0{,}995)^2 = 0{,}000025, и доступность пары составляет 99,9975 %. Вместе с базой данных получается 0{,}999975 \cdot 0{,}9995 \approx 0{,}99948, то есть около 22,7 минуты простоя в месяц: теперь узким местом стала база данных, а не вычислительный уровень. На практике отказы зон не вполне независимы (общие ошибки обновления, сбои уровня региона), поэтому поставщики дают для размещения в нескольких зонах более скромные обязательства: у AWS для виртуальных машин на момент написания это 99,99 % на уровне региона и 99,5 % для отдельной машины 6.
Важно понимать, что именно обещает SLA. Во-первых, поставщик сам определяет, что считается недоступностью: например, отсутствие внешнего сетевого подключения у всех экземпляров в двух и более зонах, а не медленные ответы. Во-вторых, из расчёта исключаются плановые работы и сбои по вине клиента. В-третьих, компенсация выражается в кредитах на оплату — доле месячного счёта за пострадавший сервис, — а не в возмещении убытков потребителя. Поэтому SLA следует рассматривать как нижнюю границу ответственности поставщика, а не как гарантию доступности приложения. Собственные цели по доступности приложения (SLO) и бюджет ошибок рассматриваются в теме 12.
Теорема CAP как следствие распределённости
Чтобы пережить отказ зоны, данные хранятся в нескольких копиях (репликах) на разных площадках. Как только копий больше одной, возникает вопрос: что должна делать система, если связь между площадками пропала, а клиенты продолжают присылать запросы? Теорема CAP, сформулированная Э. Брюером в 2000 году как гипотеза и доказанная С. Гилбертом и Н. Линч в 2002 году 3, утверждает, что распределённая система хранения данных не может одновременно обеспечить три свойства:
- согласованность (consistency, C) — каждое чтение возвращает результат последней завершённой записи, как если бы копия данных была одна;
- доступность (availability, A) — каждый запрос к работающему узлу получает ответ (не ошибку и не бесконечное ожидание);
- устойчивость к разделению (partition tolerance, P) — система продолжает работу, когда сеть теряет сообщения между группами узлов.
Рассмотрим две реплики в зонах a и b и разрыв связи между ними, как показано на рисунке ниже. Клиент в зоне a записывает новое значение, клиент в зоне b его читает. Реплика a не может передать запись реплике b. У системы остаётся ровно два варианта поведения. Первый — отказать в записи или в чтении, пока связь не восстановится: данные остаются согласованными, но часть запросов получает ошибку (выбор CP). Второй — принять запись в a и ответить на чтение в b старым значением: все запросы получают ответ, но клиенты видят разные данные (выбор AP). Третьего варианта нет, поскольку реплика b физически не может узнать о записи, которую до неё не доставила сеть.
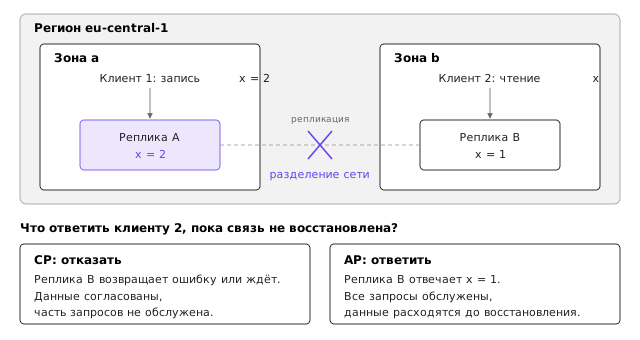
Отсюда следует правильное прочтение теоремы. Популярная формулировка «выберите любые два свойства из трёх» вводит в заблуждение: от разделения сети нельзя отказаться, оно происходит независимо от желания проектировщика, поэтому реальный выбор делается только между C и A и только на время разделения 4. Пока сеть исправна, система может быть и согласованной, и доступной. Зато и без разделений остаётся компромисс между согласованностью и задержкой: синхронная запись в реплику в другой зоне добавляет к каждой операции время обмена между зонами, а в другом регионе — десятки миллисекунд 8.
Облачные сервисы делают этот выбор по-разному, и знание выбора объясняет их поведение. Хранилище etcd, на котором держится состояние Kubernetes, выбирает согласованность: при потере большинства узлов оно перестаёт принимать записи (тема 7). Система DNS выбирает доступность: после изменения записи разные клиенты ещё некоторое время получают старый адрес из кэшей. Объектное хранилище Amazon S3 с 2020 года обеспечивает строгую согласованность чтения после записи внутри региона, а межрегиональная репликация объектов асинхронна (тема 10). Поэтому вопрос «согласована ли эта база» без уточнения «при каком отказе и в каком масштабе — зона, регион» не имеет смысла.
Типичные ошибки интерпретации распределённости
Первая ошибка — считать, что облако само по себе отказоустойчиво. Поставщик обеспечивает независимость зон, но приложение из одной машины в одной зоне так же уязвимо к отказу этой зоны, как сервер в собственной серверной. Отказоустойчивость возникает только тогда, когда сама архитектура использует несколько зон.
Вторая ошибка — отождествлять SLA поставщика с доступностью приложения. Как показал расчёт выше, доступность цепочки зависимостей ниже доступности каждого звена, а компенсация по SLA не покрывает убытков от простоя.
Третья ошибка — понимать теорему CAP как классификацию продуктов («эта база CP, та AP»). Многие системы позволяют выбирать уровень согласованности для каждого запроса, а одна и та же система ведёт себя по-разному внутри зоны, между зонами и между регионами. Теорема описывает не продукт, а неизбежный выбор в момент разделения сети.
Экономика и эксплуатационные эффекты облака
Переход к облачной модели затрагивает не только техническую архитектуру, но и экономику владения инфраструктурой. Понимание экономических эффектов облака важно не менее, чем знание его технических характеристик, поскольку именно экономические соображения часто определяют решение о миграции в облако или отказе от неё.
Капитальные и операционные затраты
В традиционной модели организация несёт капитальные затраты (Capital Expenditure, CapEx) на приобретение оборудования. Сервер приобретается единовременно, ставится на баланс и амортизируется в течение нескольких лет. Помимо стоимости самого оборудования, капитальные затраты включают расходы на проектирование серверного помещения, системы охлаждения, электроснабжения и физической безопасности. Эти расходы возникают до момента начала эксплуатации и не зависят от фактического уровня использования ресурсов.
Облачная модель трансформирует капитальные затраты в операционные (Operational Expenditure, OpEx). Потребитель не приобретает оборудование, а оплачивает использование ресурсов на регулярной основе. Это изменение имеет два важных следствия. Во-первых, снижается барьер входа: для запуска проекта не требуется крупных первоначальных инвестиций. Во-вторых, затраты становятся более пропорциональными реальному потреблению, что в теории позволяет избежать оплаты простаивающих ресурсов.
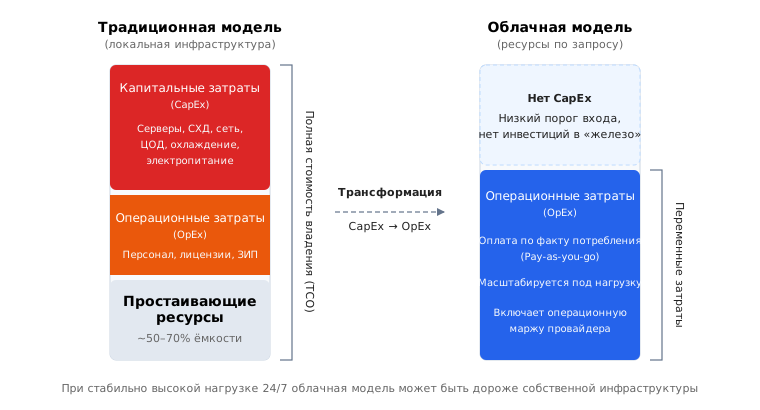
Однако замена CapEx на OpEx не является безусловным преимуществом. При устойчивых и предсказуемых нагрузках облачное размещение может оказаться дороже, чем эксплуатация собственного оборудования. Это связано с тем, что в стоимость облачных ресурсов включена маржа поставщика, затраты на обеспечение избыточности и расходы на программную инфраструктуру платформы. Поэтому экономическая оценка облачной модели должна учитывать не только прямые затраты на ресурсы, но и полную стоимость владения (Total Cost of Ownership, TCO), включающую расходы на персонал, лицензии, сетевой трафик, хранение данных и обеспечение безопасности.
Эластичное выделение ресурсов как инструмент оптимизации затрат
Одним из центральных экономических преимуществ облака является эластичность — возможность динамически изменять объём потребляемых ресурсов в зависимости от текущей нагрузки. В традиционной модели оборудование закупается с расчётом на пиковые нагрузки. Если пиковая нагрузка составляет условные 100 единиц, а средняя — 30, то 70% ёмкости большую часть времени простаивает. Организация платит за полный объём оборудования вне зависимости от того, сколько из него используется.
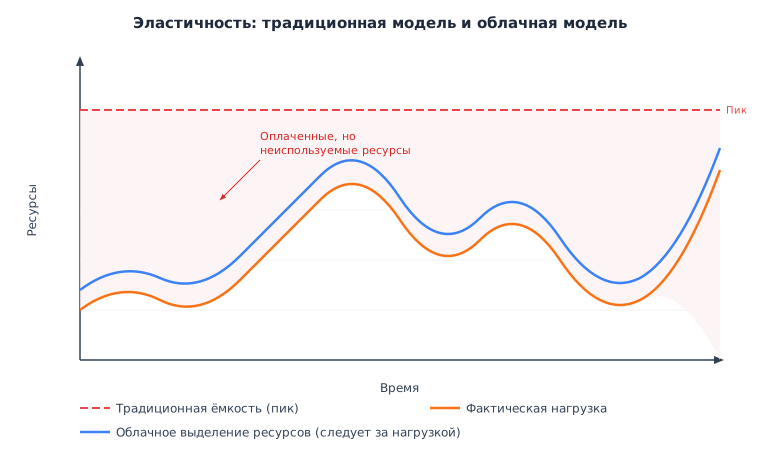
Эластичность облака позволяет приблизить фактическое потребление ресурсов к текущей потребности. В идеальном сценарии при нагрузке в 30 единиц потребитель оплачивает только 30 единиц, а при кратковременном росте до 100 единиц ресурсы масштабируются автоматически и возвращаются к прежнему уровню после снижения нагрузки. Это снижает избыточное резервирование и позволяет более рационально использовать бюджет.
На практике реализация эластичности требует инженерной подготовки. Приложение должно быть спроектировано таким образом, чтобы поддерживать горизонтальное масштабирование — добавление новых экземпляров обработки. Если архитектура приложения предполагает единственный сервер с фиксированным состоянием, эластичность облака не может быть использована в полной мере. Следовательно, эластичность является не только инфраструктурным свойством, но и архитектурным требованием к приложению.
Числовой пример: полная стоимость владения и эффект эластичности
Разберём, при каких условиях облако дешевле собственного оборудования, на условном примере. Веб-сервису в обычное время достаточно трёх экземпляров виртуальной машины, а в течение четырёх пиковых часов в сутки требуется десять. Цены условные (у. е.), но их соотношение типично: экземпляр в облаке стоит 0,20 у. е. в час; собственный сервер, вмещающий четыре таких экземпляра, стоит 6000 у. е. и амортизируется за 36 месяцев, а электропитание, место в стойке и доля работы администратора обходятся в 150 у. е. в месяц на сервер. Чтобы выдержать пик в десять экземпляров, своих серверов нужно три. Расчёт удобно записать короткой программой:
# Сравнение месячной стоимости трёх вариантов размещения (условные единицы, у. е.)
HOURS = 730                      # часов в среднем месяце
PRICE = 0.20                     # цена экземпляра ВМ в облаке, у. е./час
BASE, PEAK, PEAK_H = 3, 10, 4    # экземпляров в обычное время и в пик, пиковых часов в сутки

# Собственное оборудование: 3 сервера по 4 экземпляра (запас под пик 10)
servers, capex, months, opex = 3, 6000, 36, 150
onprem = servers * (capex / months + opex)

static = PEAK * HOURS * PRICE                                  # облако, 10 ВМ круглосуточно
peak_hours = (PEAK - BASE) * PEAK_H * HOURS / 24               # экземпляро-часы пика
elastic = (BASE * HOURS + peak_hours) * PRICE                  # облако с автомасштабированием

avg = (BASE * (24 - PEAK_H) + PEAK * PEAK_H) / 24
print(f"средняя нагрузка: {avg:.2f} экз., загрузка своего оборудования: {avg / (servers * 4):.0%}")
for name, cost in [("собственные серверы", onprem), ("облако, 10 ВМ постоянно", static),
                   ("облако, эластично", elastic)]:
    print(f"{name:26} {cost:8.0f} у. е./мес")
средняя нагрузка: 4.17 экз., загрузка своего оборудования: 35%
собственные серверы             950 у. е./мес
облако, 10 ВМ постоянно        1460 у. е./мес
облако, эластично               608 у. е./мес
Результат содержит главный вывод раздела. Облако, в котором ресурсы выделены «как в своей серверной» — под пик и круглосуточно, — оказалось в полтора раза дороже собственного оборудования, потому что цена облачного часа включает маржу поставщика и его резервы. Облако с автоматическим масштабированием оказалось дешевле обоих вариантов, потому что 65 % ёмкости собственных серверов простаивает, а в облаке простаивающая ёмкость не оплачивается. Если бы нагрузка была постоянной и равнялась десяти экземплярам, эластичности нечего было бы экономить, и выгоднее оказалось бы собственное оборудование. Таким образом, экономию даёт не облако как таковое, а отношение пиковой нагрузки к средней. Реальная оценка полной стоимости владения добавляет к этой модели исходящий трафик, хранение, лицензии, скидки за резервирование ёмкости на год или три и стоимость персонала с обеих сторон.
Риски облачной модели
При всех преимуществах облачная модель несёт ряд рисков, которые должны учитываться при принятии решения о миграции.
Первый риск — неконтролируемый рост потребления. Простота выделения ресурсов в облаке может приводить к тому, что отдельные команды или проекты потребляют значительно больше, чем планировалось. Если в организации отсутствуют механизмы мониторинга и контроля расходов, общий счёт за облачные услуги может оказаться существенно выше ожидаемого. Эта проблема обозначается термином «cloud sprawl» (неконтролируемое разрастание облачных ресурсов).
Второй риск — зависимость от поставщика (vendor lock-in). Чем глубже организация интегрируется с конкретной облачной платформой, тем труднее перенести нагрузки на другую платформу или вернуть их в собственную инфраструктуру. Зависимость может проявляться на уровне специфических API, форматов данных, механизмов управления и ценовых моделей. Снижение зависимости возможно за счёт использования открытых стандартов, контейнеризации приложений и абстрагирования от платформенно-специфических сервисов, однако полное её устранение на практике достигается редко.
Третий риск — сложность прогнозирования полной стоимости владения. Облачные тарифы формируются из множества компонентов: стоимость вычислений, хранения, сетевого трафика, операций ввода-вывода, использования дополнительных сервисов. Прозрачное прогнозирование итоговой стоимости требует понимания модели тарификации каждого используемого компонента. Неверный прогноз может привести к тому, что реальные затраты значительно превысят бюджет, а обратная миграция окажется сложной и дорогостоящей.
Перечисленные риски не обесценивают преимуществ облачной модели, но требуют осознанного подхода. Решение о переходе в облако должно основываться на анализе конкретных условий, а не на предположении о безусловной экономической выгоде.
Итоги темы
Облачные вычисления представляют собой модель предоставления вычислительных ресурсов по запросу, основанную на принципах самообслуживания, эластичности, широкой сетевой доступности, объединения ресурсов и измеряемости потребления. Эта модель принципиально отличается от традиционного хостинга и локальной серверной инфраструктуры прежде всего программной определяемостью ресурсов и динамическим характером их выделения.
Модели предоставления сервисов — IaaS, PaaS и SaaS, а также производные от них CaaS и FaaS — образуют спектр от максимального контроля при высокой эксплуатационной нагрузке до минимального контроля при минимальной нагрузке. Выбор модели определяется конкретными требованиями к гибкости, управляемости и степени делегирования ответственности поставщику. Границы между моделями подвижны, а современные облачные платформы предлагают сервисы, сочетающие признаки нескольких уровней.
Модели развертывания — публичное, частное, гибридное и общественное облако — различаются по критериям принадлежности инфраструктуры, уровня контроля и нормативного соответствия. Каждая из них имеет свою область применимости, и выбор должен основываться на анализе требований к безопасности, стоимости, масштабируемости и зрелости инженерных практик организации.
Распределённость облака видна потребителю через регионы и зоны доступности. Отказоустойчивость приложения возникает только тогда, когда его архитектура использует несколько зон, а доступность цепочки сервисов, рассчитанная по их SLA, всегда ниже доступности каждого звена. Хранение копий данных на разных площадках неизбежно приводит к выбору, который описывает теорема CAP: при разделении сети система либо отказывает части запросов, либо отвечает устаревшими данными.
Экономические эффекты облака связаны с трансформацией капитальных затрат в операционные, с возможностью эластичного выделения ресурсов и со снижением избыточного резервирования. Однако эти преимущества сопровождаются рисками неконтролируемого роста потребления, зависимости от поставщика и сложности прогнозирования полной стоимости владения. Осознанный переход к облачной модели требует не только технической компетенции, но и понимания экономических и организационных последствий принимаемых решений.
Рассмотренные в данной теме основы создают концептуальную базу для дальнейшего изучения технологий, составляющих ядро облачной инфраструктуры. Следующая тема посвящена виртуализации — фундаментальному механизму, обеспечивающему абстрагирование физических ресурсов и формирование управляемых вычислительных сред, на которых строится большинство облачных платформ.
Литература
- Mell P., Grance T. The NIST Definition of Cloud Computing. — NIST SP 800-145, 2011. https://doi.org/10.6028/NIST.SP.800-145
- Armbrust M., Fox A., Griffith R., Joseph A. D., Katz R., Konwinski A., Lee G., Patterson D., Rabkin A., Stoica I., Zaharia M. A View of Cloud Computing. — Communications of the ACM, 2010, Vol. 53, No. 4, С. 50–58, DOI: 10.1145/1721654.1721672.
- Gilbert S., Lynch N. Brewer's Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services. — ACM SIGACT News, 2002, Vol. 33, No. 2, С. 51–59, DOI: 10.1145/564585.564601.
- Brewer E. CAP Twelve Years Later: How the "Rules" Have Changed. — IEEE Computer, 2012, Vol. 45, No. 2, С. 23–29.
- AWS Documentation. Regions and Zones (Amazon EC2 User Guide). — https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/using-regions-availability-zones.html (дата обращения: 22.10.2026).
- Amazon Web Services. Amazon Compute Service Level Agreement. — https://aws.amazon.com/compute/sla/ (дата обращения: 22.10.2026).
- AWS CLI Command Reference. ec2 run-instances. — https://docs.aws.amazon.com/cli/latest/reference/ec2/run-instances.html (дата обращения: 22.10.2026).
- Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017.
- Liu F., Tong J., Mao J., Bohn R., Messina J., Badger L., Leaf D. NIST Cloud Computing Reference Architecture. — NIST SP 500-292, 2011. https://doi.org/10.6028/NIST.SP.500-292
- Jonas E., Schleier-Smith J., Sreekanti V., Tsai C.-C., Khandelwal A., Pu Q., Shankar V., Carreira J., Krauth K., Yadwadkar N., Gonzalez J. E., Popa R. A., Stoica I., Patterson D. A. Cloud Programming Simplified: A Berkeley View on Serverless Computing. — arXiv:1902.03383, 2019. https://arxiv.org/abs/1902.03383