Курс объясняет, как устроена современная облачная инфраструктура, и учит с ней работать. Путь идёт снизу вверх: облачная модель и виртуализация, контейнеры на одном хосте, оркестрация кластера, а затем инфраструктура как код, хранилища, безопасность и наблюдаемость.
Главное в курсе — механизмы, а не перечень инструментов. Почему Kubernetes описывает желаемое состояние, а не последовательность команд. Зачем OpenTofu хранит файл состояния и что случится, если два инженера применят план одновременно. Почему объектное хранилище не годится для базы данных. Почему квантиль из гистограммы Prometheus — оценка, а не точное значение. Каждое утверждение проверяется руками: все лабораторные выполняются на одном компьютере, без облачного аккаунта и без затрат.
Через темы 7–12 и курсовой проект проходит одно приложение — «Заметки» (веб-интерфейс на nginx, API на Node.js, PostgreSQL). Его упаковывают в контейнеры, разворачивают в Kubernetes, описывают кодом, подключают к объектному хранилищу, защищают и снабжают метриками.
Что даёт курс
объяснять облачные модели (IaaS, PaaS, SaaS, CaaS, FaaS) через разделение ответственности и экономику;
понимать аппаратную виртуализацию и изоляцию контейнеров на уровне ядра Linux (namespaces, cgroups, overlay2);
собирать компактные воспроизводимые образы, управлять жизненным циклом контейнеров, их сетями и томами, описывать приложение в Docker Compose;
разворачивать и диагностировать приложения в Kubernetes: Deployment, Service, Ingress, пробы, HPA, ConfigMap, Secret, PVC, StatefulSet;
описывать инфраструктуру в OpenTofu: модули, состояние в удалённом бэкенде с блокировкой, обнаружение дрейфа;
работать с S3-совместимым объектным хранилищем: версионирование, жизненный цикл, presigned URL, политики доступа;
строить защиту по уровням: RBAC, Pod Security Standards, securityContext, NetworkPolicy, сканирование и проверка цепочки поставок;
инструментировать сервис метриками, писать PromQL, формулировать SLO и алерты по бюджету ошибок, собирать логи и трассы.
Метрики и PromQL, гистограммы, кардинальность, SLO и бюджет ошибок, алерты, Loki, OpenTelemetry
ЛР 12: инструментирование сервиса, Prometheus, Grafana, алерт по SLO
Учебная среда
Всё выполняется локально. Целевая платформа — Ubuntu 24.04: на физической машине, в виртуальной машине или в WSL2. На macOS и Windows подходит Docker Desktop, особенности оговорены в работах. Нужно 4 ядра, 8 ГБ оперативной памяти и 30 ГБ диска.
Инструмент
Версия
Темы
VirtualBox
7.x
2
Docker Engine и Docker Compose v2
27+ / 2.29+
3–6, 9, 10, 12, курсовой проект
minikube с драйвером docker, kubectl
1.35+
7, 8, 11, курсовой проект
OpenTofu
1.10+
9, курсовой проект
AWS CLI v2, Python 3.12 с boto3
—
9, 10
Trivy
0.6x
4, 11
Prometheus, Grafana, Loki
закреплены в окружении ЛР 12
12
S3-совместимый сервер для тем 9 и 10 запускается в контейнере, его образ и версия указаны в ЛР 10. MinIO в курсе не используется: в 2025–2026 годах проект прекратил публикацию образов и клиента mc, а его репозиторий переведён в архив.
Как работать с материалами
Каждая тема состоит из трёх частей:
Теория — механизмы, примеры команд с выводом, расчёты, ограничения и типичные ошибки понимания. В конце — список литературы, ссылки на неё стоят прямо в тексте.
Лабораторная работа — эксперимент на своём компьютере. Сначала предсказание, затем наблюдение, затем объяснение расхождений. В каждой части сказано, что должно получиться. Окружение (манифесты, скрипты, исходники) скачивается архивом над текстом работы. Записи полезно вести в журнале работы: предсказание — команда — фактический вывод — объяснение.
Дополнительно — вопросы для самопроверки, глоссарий, шпаргалка команд, аннотированные ссылки и очерки для углубления.
Темы лучше проходить по порядку: каждая следующая опирается на предыдущие. Курсовой проект можно начинать после темы 6 и наращивать по мере прохождения тем 7–12.
Итоговые вопросы для самопроверки
Чем облачная модель отличается от аренды серверов в дата-центре? Какие из пяти характеристик NIST при этом теряются?
Почему контейнер не является «лёгкой виртуальной машиной»? Какие механизмы ядра создают изоляцию и чего они не изолируют?
Почему приложение, запущенное в контейнере shell-формой CMD, может не завершаться по docker stop за разумное время?
Почему опубликованный порт контейнера может оказаться доступен из интернета при включённом ufw?
Что происходит в кластере между командой kubectl apply и запуском процесса на узле? Какие компоненты участвуют?
Почему кластер etcd из четырёх узлов переживает не больше отказов, чем кластер из трёх?
Чем liveness-проба отличается от readiness-пробы? Что случится, если liveness проверяет доступность базы данных?
Почему Secret в Kubernetes сам по себе не является безопасным хранилищем секретов?
Зачем OpenTofu нужен файл состояния? Какие опасности несут его хранение в Git и одновременный apply?
Во сколько раз коды стирания 8+3 экономнее тройной репликации по объёму? Сколько отказов дисков переживает каждая схема?
Как presigned URL даёт доступ к объекту, не раскрывая секретный ключ?
Почему NetworkPolicy default-deny на исходящий трафик часто ломает приложение, и как это исправить?
Почему квантиль histogram_quantile — оценка? От чего зависит её точность?
Сколько минут простоя в месяц допускает SLO 99,9 %? Почему алерт по скорости расходования бюджета лучше алерта по порогу ошибок?
Рекомендуемая литература
Mell P., Grance T. The NIST Definition of Cloud Computing. — NIST SP 800-145, 2011.
Popek G. J., Goldberg R. P. Formal Requirements for Virtualizable Third Generation Architectures. — Communications of the ACM, 1974, Vol. 17, No. 7.
Rice L. Container Security: Fundamental Technology Concepts that Protect Containerized Applications. — O'Reilly Media, 2020.
Burns B., Grant B., Oppenheimer D., Brewer E., Wilkes J. Borg, Omega, and Kubernetes. — Communications of the ACM, 2016, Vol. 59, No. 5.
Lukša M. Kubernetes in Action. — Manning Publications, 2017.
Burns B., Beda J., Hightower K., Evenson L. Kubernetes: Up and Running. — 3rd ed. — O'Reilly Media, 2022.
Morris K. Infrastructure as Code: Dynamic Systems for the Cloud Age. — 2nd ed. — O'Reilly Media, 2020.
Brikman Y. Terraform: Up & Running. — 3rd ed. — O'Reilly Media, 2022.
Kleppmann M. Designing Data-Intensive Applications. — O'Reilly Media, 2017.
Beyer B., Jones C., Petoff J., Murphy N. R. Site Reliability Engineering: How Google Runs Production Systems. — O'Reilly Media, 2016. https://sre.google/books/
Majors C., Fong-Jones L., Miranda G. Observability Engineering. — O'Reilly Media, 2022.
Turnbull J. Monitoring with Prometheus. — Turnbull Press, 2018.
Лабораторные работы курса рассматривают механизмы по отдельности: образ собирается в теме 4, сеть контейнеров настраивается в теме 6, Deployment разбирается в теме 7, PersistentVolume — в теме 8, бакет S3 — в теме 10. В эксплуатации эти механизмы работают одновременно и влияют друг на друга: проба liveness, зависящая от базы данных, превращает отказ PostgreSQL в перезапуск всех подов; политика default-deny без исключения для DNS ломает разрешение имён; presigned URL, подписанный от внутреннего имени сервиса, не открывается из браузера. Курсовой проект собирает изученные механизмы на одном небольшом приложении и проводит его от исходного кода до кластера с инфраструктурой как кодом, объектным хранилищем и наблюдаемостью.
Приложение «Заметки» дано готовым: frontend (статическая страница на nginx, проксирующем /api на backend), backend (REST API на Node.js и Express) и база данных PostgreSQL. Писать приложение не требуется. Требуется упаковать его в образы, описать локальный запуск, развернуть в Kubernetes, обновлять без простоя, ограничить права и сетевые пути, перенести платформенную часть стенда в OpenTofu, подключить S3 для вложений и резервных копий и построить метрики с целевым уровнем обслуживания и алертом.
Проект выполняется самостоятельно и для себя. Результат — работающий стенд, репозиторий, из которого его можно воспроизвести с нуля, и журнал, в котором записано, что предсказывалось, что наблюдалось и почему. Каждый этап заканчивается разделом «Что должно получиться» с проверочными командами и ожидаемым результатом; в конце — сводный чек-лист самопроверки.
Этапы и связь с темами курса
Этап
Содержание
Темы
1. Контейнеризация
Dockerfile для frontend и backend, многоэтапная сборка, непривилегированный пользователь, HEALTHCHECK
3, 4, 5
2. Docker Compose
три сервиса, сеть, том, healthcheck и depends_on, ограничения ресурсов
обновление без простоя, откат, HPA, самовосстановление, отказ БД
7
5. Безопасность
securityContext, Pod Security Admission, RBAC, NetworkPolicy, Trivy
4, 11
6. Инфраструктура как код
OpenTofu: пространство имён, секреты, квоты, Ingress-контроллер через Helm, state в S3
9
7. Объектное хранилище
presigned URL для вложений, CronJob резервного копирования в бакет с версионированием
10
8. Наблюдаемость
/metrics, Prometheus, дашборд RED в Grafana, SLO и алерт по скорости сжигания бюджета ошибок
12
Этапы выполняются по порядку: каждый следующий опирается на стенд предыдущего. Этапы 1–5 можно начинать после тем 4–7 и дополнять по мере прохождения тем 8 и 11; этапы 6–8 — после тем 9, 10 и 12 соответственно.
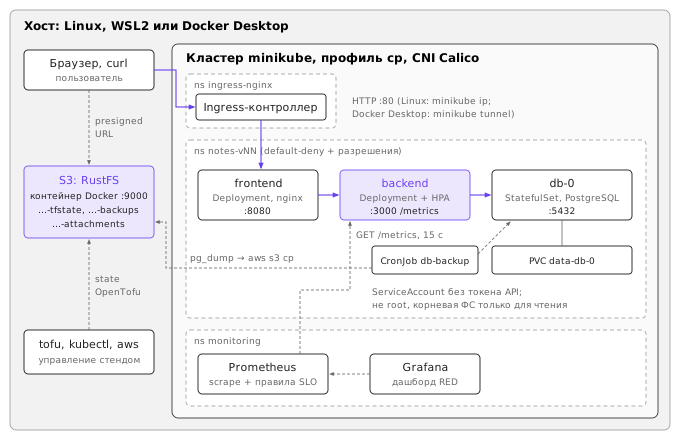
Стенд после всех этапов: кластер minikube с тремя пространствами имён и S3-сервер RustFS в контейнере Docker на хосте. Сплошные стрелки — путь пользовательского запроса, пунктирные — служебные потоки. На этапе 6 контроллер ingress-nginx заменяется на Traefik
Схема на рисунке выше показывает стенд в конечном виде. Пользовательский запрос идёт по сплошным стрелкам: браузер → Ingress-контроллер → frontend → backend → PostgreSQL. Файлы вложений идут мимо приложения: backend лишь подписывает URL, а браузер обращается к S3 напрямую. S3-сервер вынесен из кластера намеренно: в нём хранится state OpenTofu, которым описывается сам кластер, и размещать state внутри управляемой им же системы нельзя — при её поломке пропадёт и описание того, как её восстановить.
Приложение «Заметки»
Исходный код
Код приложения — в архиве cp-env.zip. После распаковки:
cp-env/
├── README.md              # справка по эндпоинтам и переменным окружения
├── backend/
│   ├── app.js             # REST API: Express + PostgreSQL, метрики, presigned URL
│   ├── package.json
│   └── package-lock.json  # точные версии зависимостей, нужен для npm ci
├── frontend/
│   ├── index.html         # веб-интерфейс
│   └── nginx.conf         # конфигурация nginx: порт 8080, прокси /api → backend:3000
└── scripts/
    └── load.sh            # генератор нагрузки и счётчик кодов ответа
Код можно менять, если это нужно для эксплуатации (например, добавить поле в ответ при отработке обновления), но ни один этап этого не требует. Всё, что связано с упаковкой и развёртыванием, — Dockerfile, compose.yaml, манифесты, конфигурация OpenTofu и Prometheus — пишется самостоятельно и составляет содержание проекта.
Эндпоинты и их назначение
Метод и путь
Назначение
Коды ответа
GET /api/live
liveness: процесс способен обрабатывать запросы; БД не проверяется
200
GET /api/health
readiness: процесс жив и БД отвечает на SELECT 1
200 или 503
GET /api/notes
список заметок
200; 503, пока БД не готова
POST /api/notes
создать заметку из JSON {"title": "…", "content": "…"}
201; 400 без title или при неверном JSON
DELETE /api/notes/:id
удалить заметку
200; 400 при нечисловом id; 404
POST /api/notes/:id/attachment-url
выдать presigned URL для загрузки вложения
201; 404; 503 без S3
GET /api/notes/:id/attachment-url
выдать presigned URL для скачивания вложения
200; 404; 503 без S3
GET /metrics
метрики в формате экспозиции Prometheus
200
Разделение /api/live и /api/health — ключевое для этапов 3 и 4. Проба liveness отвечает на вопрос «нужно ли перезапустить контейнер», проба readiness — «можно ли направлять на него трафик». Если liveness проверяет базу данных, то при отказе PostgreSQL kubelet перезапустит все поды backend, хотя перезапуск ничего не исправит, а после восстановления базы все реплики будут одновременно стартовать. Поэтому /api/live от базы не зависит, а /api/health — зависит.
/metrics доступен только внутри кластера: nginx проксирует наружу лишь /api/.
Поведение backend при старте и отказах
Backend открывает HTTP-порт сразу, а схему базы создаёт в фоне с повторными попытками: паузы растут как 1, 2, 4, 8 с и далее остаются по 10 с, число попыток не ограничено. Пока база недоступна, /api/live отвечает 200, а /api/health и /api/notes — 503. Ошибка отдельного запроса к базе превращается в ответ 500 и не завершает процесс. По сигналу SIGTERM процесс перестаёт принимать новые соединения, дожидается текущих запросов (не дольше 10 с) и закрывает пул соединений.
Такое поведение — проектное решение, а не единственно возможное. Альтернатива «упасть, если базы нет» тоже встречается: тогда перезапуском занимается оркестратор, а под показывает CrashLoopBackOff. В проекте выбран вариант, при котором состояние зависимости видно через readiness, а журнал остаётся читаемым.
Все параметры задаются переменными окружения. Основные:
Переменная
По умолчанию
Смысл
PORT
3000
порт HTTP
APP_VERSION
версия из package.json
попадает в ответы /api/live и /api/health
DB_HOST, DB_PORT, DB_NAME, DB_USER, DB_PASSWORD
localhost, 5432, notes, notes, notes
подключение к PostgreSQL
S3_BUCKET
пусто — вложения выключены
бакет для вложений
S3_PUBLIC_ENDPOINT
пусто
адрес S3, подставляемый в presigned URL; должен быть доступен клиенту
AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY
—
ключи доступа к S3
FAULT_RATE, FAULT_DELAY_MS
0, 0
доля искусственных ответов 500 и задержка для запросов к /api/notes (этап 8)
Полная таблица — в README.md архива.
Учебная среда
Минимальные требования
Ubuntu 24.04 (физическая или виртуальная машина либо WSL2) или macOS/Windows с Docker Desktop.
4 ядра CPU, 8 ГБ RAM, 30 ГБ свободного диска. Кластер minikube получает 5 ГБ памяти; ещё около 1 ГБ нужно Docker, S3-серверу и браузеру. На машине с 8 ГБ на время работы стенда стоит закрыть тяжёлые программы.
Docker Desktop: в настройках ресурсов выделить виртуальной машине Docker не меньше 6 ГБ памяти и 4 CPU, иначе minikube не стартует с указанными ниже параметрами.
Доступ в интернет для скачивания образов и провайдеров OpenTofu.
Версии инструментов и образов
Проект рассчитан на версии из таблицы. Отклонение на минорную версию обычно безопасно; более старые мажорные версии — нет (например, use_lockfile в S3-бэкенде появился только в OpenTofu 1.10). Тег latest нигде не используется: он не фиксирует содержимое образа, и стенд, собранный через месяц, окажется другим.
Node.js (только для запуска backend без контейнера)
24 LTS
1
Образ
Тег
Назначение
node
24.22.1-alpine3.24
база образа backend
nginxinc/nginx-unprivileged
1.30.6-alpine3.24
база образа frontend
postgres
17.11-alpine3.24
база данных и pg_dump в CronJob
busybox
1.37.0
отладочные и нагрузочные поды
rustfs/rustfs
1.0.3
S3-сервер
amazon/aws-cli
2.38.4
выгрузка резервной копии в S3
prom/prometheus
v3.15.1
сбор метрик и правила алертов
grafana/grafana
13.2.4
дашборды
Helm-чарт traefik из https://traefik.github.io/charts
41.6.1
Ingress-контроллер на этапе 6
Версии образов в таблице были актуальны в октябре 2026 г. Перед началом работы проверьте, что теги существуют (docker pull <образ>:<тег>). Если тег удалён, возьмите ближайший более новый из той же ветки и запишите замену в README проекта.
О двух компонентах стоит сказать отдельно. MinIO в курсе не используется: в 2025 г. проект прекратил публикацию готовых образов и клиента mc для свободной редакции. Его место занимает RustFS — S3-совместимый сервер с открытым кодом; клиентом служат AWS CLI v2 и AWS SDK, поэтому навыки переносятся на любой S3-совместимый сервис (подробно — в теме 10). Второй компонент — контроллер ingress-nginx: в марте 2026 г. проект переведён в архив и больше не получает исправлений. Аддон ingress в minikube 1.39 по-прежнему его разворачивает, и для этапов 3–5 этого достаточно; на этапе 6 контроллер заменяется на Traefik, а для новых установок в эксплуатации рекомендуется Gateway API (кратко — в теме 7).
Кластер и пространства имён
Кластер создаётся один раз в начале этапа 3 отдельным профилем cp и живёт до конца проекта. Calico указывается при создании сразу: сетевой плагин (CNI) существующего кластера не меняется, а без плагина с поддержкой NetworkPolicy политики этапа 5 будут приняты API-сервером, но не будут действовать.
Приложение размещается в пространстве имён из варианта (notes-v01 … notes-v10), Prometheus и Grafana — в monitoring. Чтобы не писать -n в каждой команде:
kubectl config use-context cp
kubectl config set-context --current --namespace=notes-v01   # своё имя из варианта
Перерывы в работе: minikube stop -p cp сохраняет кластер с данными, minikube start -p cp поднимает его снова. Полный сброс — minikube delete -p cp, после него этапы 3–8 повторяются из репозитория, и это хорошая проверка воспроизводимости.
Индивидуальный вариант
Номер варианта выбирается самостоятельно. Вариант меняет параметры, а не суть этапов: с ним ответы проверочных команд у каждого свои, и решение нельзя переписать из чужого репозитория, не разобравшись.
Вариант
Пространство имён
Реплики backend
Реплики frontend
Том БД
HPA: цель CPU / максимум реплик
SLO доступности
SLO задержки
Префикс бакетов
Расписание бэкапа
1
notes-v01
2
2
1Gi
50 % / 5
99,0 %
95 % запросов ≤ 250 мс
aurora
*/30 * * * *
2
notes-v02
3
2
2Gi
60 % / 6
99,5 %
90 % ≤ 100 мс
boreas
0 * * * *
3
notes-v03
2
3
1500Mi
40 % / 4
99,9 %
99 % ≤ 500 мс
cirrus
*/15 * * * *
4
notes-v04
3
3
1Gi
70 % / 8
99,0 %
95 % ≤ 100 мс
delta
15 * * * *
5
notes-v05
2
2
3Gi
55 % / 5
99,5 %
99 % ≤ 250 мс
ember
*/20 * * * *
6
notes-v06
4
2
2Gi
50 % / 8
99,9 %
95 % ≤ 500 мс
fjord
30 * * * *
7
notes-v07
2
2
512Mi
65 % / 6
99,0 %
90 % ≤ 250 мс
gale
*/10 * * * *
8
notes-v08
3
2
1Gi
45 % / 5
99,5 %
95 % ≤ 250 мс
helix
0 */2 * * *
9
notes-v09
2
3
2500Mi
75 % / 7
99,9 %
99 % ≤ 100 мс
iris
5,35 * * * *
10
notes-v10
3
3
1Gi
50 % / 6
99,0 %
99 % ≤ 500 мс
jade
45 * * * *
Префикс бакетов даёт три имени: <префикс>-tfstate (state OpenTofu), <префикс>-attachments (вложения), <префикс>-backups (резервные копии). Порог задержки в SLO совпадает с одной из границ корзин гистограммы в app.js (0,1; 0,25; 0,5 с) — почему это важно, объясняется на этапе 8.
В тексте ниже в примерах используется вариант 1. Свои значения подставляются везде, где встречаются notes-v01, aurora, 1Gi и т. д.
Порядок работы
Репозиторий проекта
Проект ведётся в git-репозитории. Рекомендуемая структура:
В репозиторий не попадают: .env, файлы с паролями и ключами, terraform.tfstate*, каталог .terraform/, выгрузки резервных копий. Это стоит закрепить в .gitignore до первого коммита: удалить секрет из истории git значительно труднее, чем не добавить его.
Журнал работы
Ведите JOURNAL.md по схеме «предсказание — команда — фактический вывод — объяснение». Перед каждым экспериментом (удаление пода, отказ базы, обновление на несуществующий образ, применение default-deny) запишите, что, по вашему мнению, произойдёт, затем выполните команду, вставьте сокращённый вывод и объясните расхождение, если оно есть. Через месяц такой журнал полезнее любого итогового документа: в нём видно, где модель системы в голове была неверной.
Разборка стенда
docker compose down -v                     # этап 2: контейнеры и тома Compose
minikube delete -p cp                      # этапы 3–8: кластер целиком
docker rm -f cp-rustfs && docker volume rm cp-rustfs-data   # S3-сервер этапов 6–7
Этап 1. Контейнеризация
Задачи этапа
Написать Dockerfile для backend и frontend, собрать образы notes-backend:1.0.0 и notes-frontend:1.0.0, убедиться, что контейнеры запускаются от непривилегированного пользователя с числовым UID, а backend стартует и без базы данных. Механизмы, на которые опирается этап, — слои и кэш сборки, многоэтапная сборка, инструкция USER, форма exec у CMD и обработка сигналов процессом с PID 1 — разобраны в темах 4 и 5.
Базовый образ node:24.22.1-alpine3.24 на обоих этапах сборки.
Первый этап устанавливает зависимости: копирует package.json и package-lock.json и выполняет npm ci --omit=dev. Копировать сначала только эти два файла, а затем исходный код, нужно ради кэша: слой с node_modules пересобирается лишь при изменении зависимостей, а не при каждой правке app.js. npm ci ставит пакеты строго по lock-файлу и завершается ошибкой, если lock-файл расходится с package.json; поэтому две сборки с разницей в месяц дают одинаковые зависимости.
Второй этап копирует из первого node_modules, затем package.json и app.js. Рабочий каталог — /app. Файлы принадлежат root и доступны процессу только на чтение: приложению не нужно писать в свой каталог, и запрет записи сужает последствия компрометации.
Пользователь задаётся числом: USER 1000 (в образах node:*-alpine UID 1000 принадлежит встроенному пользователю node). Имя USER node для Docker работает, но на этапе 5 kubelet с runAsNonRoot: true не сможет проверить, что имя node не означает UID 0, и откажется запускать контейнер с ошибкой CreateContainerConfigError.
ENV NODE_ENV=production и EXPOSE 3000 (EXPOSE ничего не публикует, это документация порта).
CMD в форме exec, то есть JSON-массивом из node и app.js: тогда процессом с PID 1 будет сам node, и SIGTERM от docker stop или kubelet дойдёт до обработчика в app.js. В shell-форме PID 1 — /bin/sh, который сигнал не передаёт, и контейнер будет убит по SIGKILL через 10 с (Docker) или 30 с (Kubernetes).
HEALTHCHECK обращается к /api/health утилитой wget из BusyBox (в alpine нет curl):
Docker не перезапускает контейнер со статусом unhealthy: статус используется Compose в условии depends_on: condition: service_healthy и виден в docker ps. Поэтому здесь проверяется готовность (/api/health), а не живучесть. Kubernetes инструкцию HEALTHCHECK игнорирует и полагается на собственные пробы этапа 3.
Файл исключений контекста сборки — docker/backend/Dockerfile.dockerignore рядом с Dockerfile (BuildKit ищет его там в первую очередь) или app/backend/.dockerignore. В нём как минимум node_modules и npm-debug.log: локальный node_modules, собранный под другую ОС, не должен попасть в образ поверх установленного npm ci.
Базовый образ nginxinc/nginx-unprivileged:1.30.6-alpine3.24. В отличие от официального nginx, в нём master-процесс работает от UID 101, порт по умолчанию 8080, а PID-файл и временные каталоги перенесены в /tmp. Официальный образ стартует от root, слушает порт 80 и пишет в /var/cache/nginx и /var/run; запустить его от непривилегированного пользователя можно, но потребуется переписать основной nginx.conf.
index.html копируется в /usr/share/nginx/html/, nginx.conf — в /etc/nginx/conf.d/default.conf, заменяя конфигурацию по умолчанию (иначе в образе останутся два server на порту 8080).
USER 101 явно, хотя он уже задан в базовом образе: Dockerfile документирует намерение, а смена базового образа не изменит пользователя незаметно.
EXPOSE 8080 и HEALTHCHECK на http://127.0.0.1:8080/healthz — этот путь в nginx.conf отвечает самим nginx, без обращения к backend.
Перед запуском запишите в журнал предсказание: какие коды вернут /api/live и /api/health, что будет в docker ps в колонке STATUS через минуту, сколько секунд займёт docker stop.
Что должно получиться
Оба образа собираются; повторная сборка без изменений занимает секунды (все шаги CACHED), а правка app.js не вызывает повторного npm ci.
Сжатый размер базового node:24.22.1-alpine3.24 около 59 МиБ против примерно 420 МиБ у варианта на Debian trixie; зависимости приложения добавляют около 32 МБ. Запишите фактические размеры своих образов из docker images.
docker run --rm notes-backend:1.0.0 id выводит uid=1000(node) gid=1000(node), docker run --rm notes-frontend:1.0.0 id — uid=101(nginx) gid=101(nginx).
В журнале контейнера — строки вида database not ready (attempt 3): ...; retry in 4000 ms, а в docker ps через минуту — (unhealthy). docker stop завершается почти сразу, последняя строка журнала — SIGTERM received, shutting down. Если stop длится 10 с, сигнал не доходит до node: проверьте форму CMD.
Вопросы для самопроверки
Почему порядок COPY package*.json → RUN npm ci → COPY app.js ускоряет сборку, а COPY . . перед npm ci — нет?
Что именно проверяет kubelet при runAsNonRoot: true и почему ему недостаточно имени пользователя?
Что изменится, если записать CMD node app.js в shell-форме? Как это увидеть по времени docker stop?
Почему HEALTHCHECK в Docker проверяет /api/health, а liveness в Kubernetes (этап 3) — /api/live?
Этап 2. Docker Compose
Задачи этапа
Описать три сервиса в compose.yaml и поднимать приложение одной командой так, чтобы данные переживали пересоздание контейнеров. Модель проекта Compose, встроенный DNS пользовательских сетей, тома и порядок запуска с depends_on разобраны в теме 6.
Требования к compose.yaml
Сервис db:
образ postgres:17.11-alpine3.24, переменные POSTGRES_DB, POSTGRES_USER, POSTGRES_PASSWORD из файла .env через подстановку ${DB_PASSWORD:?задайте DB_PASSWORD в .env} (форма :? останавливает запуск с понятным сообщением, если переменная не задана);
именованный том, смонтированный в /var/lib/postgresql/data. Это путь данных для PostgreSQL 17 и ниже. В образах PostgreSQL 18 путь по умолчанию изменён на /var/lib/postgresql/18/docker, а том объявлен на /var/lib/postgresql; при переходе на 18 монтировать нужно /var/lib/postgresql, иначе данные окажутся вне тома. Именно поэтому версия закреплена до минорной: postgres:17 или тем более postgres без тега однажды молча станут другой мажорной версией с другим форматом каталога данных;
healthcheck командой pg_isready -U "$POSTGRES_USER" -d "$POSTGRES_DB";
порт наружу не публикуется: базе достаточно сети Compose.
Сервис backend:
build с context: app/backend и dockerfile: ../../docker/backend/Dockerfile (путь к Dockerfile задаётся относительно контекста), image: notes-backend:1.0.0;
переменные DB_HOST=db и остальные DB_*; пароль — та же переменная из .env;
depends_on: db: condition: service_healthy. Backend и без этого дождётся базы благодаря повторным попыткам, но с условием в журнале нет десятка ошибок подключения при каждом старте;
depends_on: backend: condition: service_started. nginx разрешает имя backend из proxy_pass один раз при старте, а встроенный DNS Docker знает имя, только пока контейнер существует. Если frontend стартует раньше, nginx завершится с ошибкой host not found in upstream "backend".
Общее: пользовательская сеть notes (на сети default DNS тоже работает, но явная сеть понадобится на этапе 6), том db-data. Файл .env с DB_NAME, DB_USER, DB_PASSWORD — в .gitignore, в репозиторий кладётся .env.example с теми же ключами и пустыми значениями.
Эксперименты (с предсказанием в журнале перед каждым):
docker compose down и снова up -d — заметки на месте. docker compose down -v — заметок нет: том удалён.
docker compose stop db, затем curl к /api/health и /api/notes, затем docker compose start db и повторить. Backend не перезапускается: docker compose ps показывает тот же CREATED.
docker compose exec backend wget -qO- http://db:5432 и docker compose exec frontend wget -qO- -T 3 http://backend:3000/api/health: какой из запросов и почему завершится ошибкой протокола, а не сети?
Что должно получиться
docker compose ps показывает три сервиса в состоянии running, у db и backend — (healthy).
http://localhost:8080 в браузере показывает «API: подключено, версия 1.0.0»; заметки создаются и удаляются.
При остановленной базе /api/health отвечает 503 с "db":"not ready" или текстом ошибки подключения, страница показывает «API: ошибка — база данных: …»; после start db в пределах 10 с всё возвращается без перезапуска backend.
docker stats --no-stream показывает у backend предел памяти 256MiB.
Вопросы для самопроверки
Чем отличаются условия service_started и service_healthy, и почему для frontend достаточно первого?
Почему внутри сети Compose backend обращается к db:5432, а не к localhost:5432?
Где физически лежат данные именованного тома и что произойдёт с ними при docker compose down без -v?
Какие задачи Compose не решает и для чего на следующем этапе нужен оркестратор?
Этап 3. Развёртывание в Kubernetes
Задачи этапа
Создать кластер, загрузить в него образы и описать приложение манифестами: PostgreSQL в StatefulSet с томом, backend и frontend в Deployment, Service для каждого компонента, ConfigMap и Secret, пробы, Ingress. Начиная с этого этапа даются требования к объектам и проверки, а не готовые манифесты: синтаксис полей разобран в ЛР 7 и 8 и в документации, а навык этапа — перевести требования в манифест и доказать проверкой, что он делает то, что нужно.
Кластер, аддоны и образы
Создайте кластер командой из раздела «Учебная среда», затем включите аддоны и загрузите образы:
Узел minikube — отдельный контейнер со своим containerd, и образов из локального Docker он не видит; image load копирует образ в хранилище узла. Каждая пересборка получает новый тег (1.0.1, 1.1.0): загрузка образа с прежним тегом не обязательно заменит уже загруженный, а под с imagePullPolicy: IfNotPresent и подавно не заметит подмены. Тег, идентифицирующий содержимое, — то же требование воспроизводимости, что и запрет latest.
Манифесты базы данных
Общее для всех объектов этапа: метки app: <компонент> и app.kubernetes.io/part-of: notes; селекторы Service и Deployment совпадают с метками шаблона пода; у каждого контейнера заданы resources.requests и resources.limits.
Secret db-credentials с ключами POSTGRES_USER и POSTGRES_PASSWORD. Base64 в поле data — кодирование, а не шифрование: kubectl get secret db-credentials -o jsonpath='{.data.POSTGRES_PASSWORD}' | base64 -d возвращает пароль любому, у кого есть право get на секреты. Значение по умолчанию хранится в etcd без шифрования (шифрование на диске включается отдельно), а защиту секрета обеспечивают RBAC (этап 5) и то, что манифест с паролем не попадает в git. Создавайте Secret командой без пароля в истории оболочки:
Если Secret описывается файлом, используйте поле stringData с открытым текстом — API-сервер сам закодирует его в data; такой файл держите вне репозитория. Остальные объекты базы:
headless Service db (clusterIP: None) на порт 5432. Для StatefulSet он обязателен: через него под получает стабильное DNS-имя db-0.db.notes-v01.svc.cluster.local, а имя db разрешается в адреса готовых подов.
StatefulSet db: serviceName: db, одна реплика, контейнер db из postgres:17.11-alpine3.24, переменные POSTGRES_DB=notes и PGDATA=/var/lib/postgresql/data/pgdata, учётные данные — из Secret через envFrom или secretKeyRef. volumeClaimTemplates с именем data, ReadWriteOnce, размер из варианта, монтирование в /var/lib/postgresql/data. Подкаталог pgdata нужен потому, что корень многих томов (ext4 облачных дисков) содержит lost+found, а initdb отказывается инициализировать непустой каталог. Пробы: readiness — exec с pg_isready -U notes -d notes.
Почему StatefulSet, а не Deployment. Deployment с одной репликой и томом ReadWriteOnce формально работает, но при обновлении по стратегии RollingUpdate контроллер сначала создаёт новый под и лишь потом удаляет старый. На многоузловом кластере новый под зависнет в ContainerCreating, потому что том ещё подключён к другому узлу; на одном узле оба пода получат один каталог данных, и второй PostgreSQL откажется стартовать из-за postmaster.pid. Deployment для базы требует strategy: Recreate и всё равно не даёт гарантии «не больше одного пода с этой идентичностью». StatefulSet даёт её по построению: под db-0 пересоздаётся только после полного удаления прежнего db-0, PVC data-db-0 привязан к порядковому номеру и не удаляется вместе с подом или даже со StatefulSet. Подробно — в теме 8.
Deployment backend: число реплик из варианта; контейнер с именем backend (на это имя ссылается kubectl set image на этапе 4); образ notes-backend:1.0.0, imagePullPolicy: IfNotPresent; containerPort: 3000 с именем http; переменные из ConfigMap через envFrom, DB_USER и DB_PASSWORD — из Secret через secretKeyRef; requests 100m CPU и 128Mi, limits 500m CPU и 256Mi.
Пробы backend:
Проба
Путь
Параметры
Что происходит при провале
startup
/api/live
periodSeconds: 2, failureThreshold: 15
пока не пройдёт, остальные пробы не выполняются; 30 с без ответа — перезапуск
liveness
/api/live
periodSeconds: 10, failureThreshold: 3
перезапуск контейнера
readiness
/api/health
periodSeconds: 5, failureThreshold: 2
под исключается из EndpointSlice сервиса, но не перезапускается
Service backend, ClusterIP, порт 3000 → targetPort: http. Имя backend обязательно: его ищет proxy_pass в nginx.conf.
Манифесты frontend и Ingress
Deployment frontend: число реплик из варианта, контейнер frontend, образ notes-frontend:1.0.0, порт 8080, readiness и liveness на /healthz, requests 50m и 32Mi, limits 200m и 64Mi.
Service frontend, ClusterIP, порт 80 → 8080. Порт сервиса и порт контейнера независимы: снаружи остаётся привычный 80, а процессу не нужны привилегии для порта ниже 1024.
Ingress notes с ingressClassName: nginx, одно правило без host: путь / типа Prefix → Service frontend, порт 80. Минимальный фрагмент, остальное по документации:
Порядок создания объектов неважен: Deployment frontend, созданный раньше Service backend, несколько раз перезапустится (host not found in upstream) и поднимется, как только Service появится, — это цикл согласования в действии.
Доступ к Ingress зависит от платформы:
Linux и WSL2 с Docker Engine: curl http://$(minikube -p cp ip)/api/health. Адрес узла (обычно 192.168.49.2) доступен с хоста напрямую.
macOS и Windows с Docker Desktop: узел живёт внутри виртуальной машины Docker, и его адрес с хоста недоступен. Запустите в отдельном терминале minikube -p cp tunnel (запросит пароль администратора для портов 80 и 443) и обращайтесь к http://127.0.0.1.
Везде, включая браузер Windows при minikube внутри WSL2: kubectl -n ingress-nginx port-forward svc/ingress-nginx-controller 8081:80 и http://localhost:8081.
Что должно получиться
kubectl get pods — все поды Running, READY 1/1; у db-0 — стабильное имя.
kubectl get pvc — data-db-0 в состоянии Bound, ёмкость из варианта.
kubectl get endpointslices -l kubernetes.io/service-name=backend перечисляет столько адресов, сколько реплик backend.
Через Ingress открывается страница, заметки создаются.
Проверка сохранности данных: создайте заметку, выполните kubectl delete pod db-0, дождитесь Running — заметка на месте. Затем kubectl delete statefulset db и kubectl get pvc: PVC остался; повторный kubectl apply возвращает базу с данными.
kubectl exec deploy/backend -- env | grep DB_ показывает значения из ConfigMap и Secret (пароль тоже — права на exec равносильны праву прочитать секрет, вернитесь к этому на этапе 5).
Вопросы для самопроверки
Почему frontend обращается к backend:3000, а не к адресу конкретного пода, и что произойдёт с запросами при удалении одного пода backend?
Чем readiness отличается от liveness по последствиям провала? Что случится со всеми подами backend при остановке базы, если liveness направить на /api/health?
Почему PVC data-db-0 не удаляется вместе со StatefulSet и какую ошибку эксплуатации это предотвращает?
Что делает Ingress-контроллер с объектом Ingress и почему без контроллера объект ничего не делает?
Этап 4. Обновление, масштабирование и самовосстановление
Задачи этапа
Показать четыре механизма жизненного цикла: обновление без простоя, откат неудачного обновления, автомасштабирование по CPU и восстановление после отказов разного рода. Каждый эксперимент сопровождается предсказанием в журнале и проверкой, а не только наблюдением. Теория — в теме 7 (RollingUpdate, HPA и metrics-server, отказ узла и пода).
Обновление без простоя
Требования к Deployment backend:
strategy.rollingUpdate с maxUnavailable: 0 и maxSurge: 1: во время обновления число готовых реплик не опускается ниже заданного;
minReadySeconds: 5 — новый под считается доступным, только если продержался готовым 5 с;
корректное завершение пода: lifecycle.preStop с действием sleep на 5 с (поле sleep.seconds, доступно по умолчанию с Kubernetes 1.30). Удаление пода из EndpointSlice и доставка SIGTERM происходят параллельно; пауза перед SIGTERM даёт kube-proxy и Ingress-контроллеру время перестать слать на под новые запросы.
Запустите в отдельном терминале счётчик ответов через Ingress, затем обновите образ и версию:
app/scripts/load.sh http://$(minikube -p cp ip)/api/health 120 0.1
kubectl set image deployment/backend backend=notes-backend:1.1.0
kubectl set env deployment/backend APP_VERSION=1.1.0
kubectl rollout status deployment/backend
kubectl rollout history deployment/backend
Две команды подряд создают две ревизии. Объясните в журнале, почему, и как получить одну ревизию (правка манифеста и один kubectl apply, или аннотация kubernetes.io/change-cause).
Неудачное обновление и откат
Обновите образ на несуществующий тег notes-backend:9.9.9 и наблюдайте kubectl get pods -w. Предскажите: сколько подов окажется в ErrImagePull и затем ImagePullBackOff, сколько старых продолжат обслуживать запросы, чем закончится kubectl rollout status --timeout=60s. Затем откатитесь:
kubectl rollout undo deployment/backend
kubectl rollout status deployment/backend
kubectl get deploy backend -o jsonpath='{.spec.template.spec.containers[0].image}{"\n"}'
Автомасштабирование
Требования к HorizontalPodAutoscaler backend (autoscaling/v2): цель — Deployment backend, minReplicas равно числу реплик из варианта, maxReplicas и целевая утилизация CPU — из варианта. После создания HPA уберите поле replicas из манифеста Deployment: иначе каждый kubectl apply -R -f k8s/ будет возвращать число реплик к значению из файла, споря с HPA.
Утилизация считается от requests, а не от limits: при requests 100m под, потребляющий 75m, загружен на 75 %. Желаемое число реплик HPA вычисляет как
Например, при двух репликах, средней утилизации 130 % и цели 50 % получается \lceil 2 \cdot 130 / 50 \rceil = \lceil 5{,}2 \rceil = 6, и при максимуме 5 из варианта 1 HPA остановится на пяти. Уменьшение числа реплик выполняется с окном стабилизации 300 с по умолчанию: после снятия нагрузки реплики уходят не раньше чем через пять минут.
Нагрузка — несколько подов, опрашивающих backend внутри кластера в обход Ingress:
kubectl create deployment load --image=busybox:1.37.0 --replicas=3 -- \
  sh -c 'while true; do wget -q -O /dev/null http://backend:3000/api/notes; done'
kubectl get hpa backend -w
kubectl top pods -l app=backend
kubectl delete deployment load
На этапе 5 после default-deny этот генератор перестанет работать, пока ему не разрешат доступ; это ожидаемо.
Самовосстановление и отказ зависимости
Три эксперимента, у каждого — своё предсказание:
kubectl delete pod <под-backend>: ReplicaSet создаёт новый под с другим именем. Время до готовности замены запишите по kubectl get pods -w.
kubectl exec <под-backend> -- kill 1: процесс получает SIGTERM и завершается, kubelet перезапускает тот же контейнер в том же поде, растёт RESTARTS. Сравните с первым случаем: какой контроллер отреагировал в каждом из них.
Отказ базы: kubectl scale statefulset db --replicas=0. Через 10–15 с поды backend переходят в READY 0/1, но RESTARTS не растёт; kubectl get endpointslices -l kubernetes.io/service-name=backend показывает адреса с ready: false; страница через Ingress отвечает ошибкой 502 или 503. Возврат: kubectl scale statefulset db --replicas=1, и в пределах 10–20 с всё восстанавливается само.
Что должно получиться
Во время обновления на 1.1.0 счётчик load.sh не показывает ни одного кода, отличного от 200 (допустимы единичные 000 или 502, если не настроены preStop и maxUnavailable: 0; найдите причину, исправьте и повторите). Ответ /api/health после обновления содержит "version":"1.1.0".
Обновление на 9.9.9 останавливается на одном новом поде с ошибкой загрузки образа; старые реплики остаются READY, пользователь простоя не замечает; rollout status завершается по тайм-ауту с ненулевым кодом; после undo образ снова notes-backend:1.1.0.
Под нагрузкой kubectl get hpa показывает рост TARGETS выше цели и рост REPLICAS до максимума варианта или ниже; после снятия нагрузки через 5–6 мин число реплик возвращается к минимуму.
В эксперименте с отказом базы RESTARTS у backend не меняется — это прямое следствие того, что liveness смотрит на /api/live.
Вопросы для самопроверки
Почему maxUnavailable: 0 без корректной readiness-пробы не обеспечивает обновление без простоя?
Что произошло бы при обновлении на несуществующий образ с maxUnavailable: 1 и двумя репликами?
Почему HPA показывает <unknown> в первые минуты и что изменится, если удалить requests.cpu из Deployment?
Чем перезапуск контейнера отличается от пересоздания пода с точки зрения IP-адреса, журналов (kubectl logs --previous) и содержимого emptyDir?
Этап 5. Безопасность
Задачи этапа
Сузить то, что может сделать скомпрометированный компонент: процесс без привилегий и без записи в корневую ФС, Pod Security Admission как страховка, ServiceAccount без лишних прав, сетевые пути только между теми компонентами, которым они нужны, и проверка образов на известные уязвимости. Модель угроз, конвейер API-сервера (аутентификация → авторизация → admission), RBAC, Pod Security Standards и NetworkPolicy разобраны в теме 11.
securityContext и Pod Security Admission
Требования к подам frontend и backend:
на уровне пода: runAsNonRoot: true, runAsUser (1000 для backend, 101 для frontend), seccompProfile.type: RuntimeDefault;
на уровне контейнера: allowPrivilegeEscalation: false, readOnlyRootFilesystem: true, сброс всех capabilities (capabilities.drop со значением ALL);
emptyDir в /tmp у обоих: nginx-unprivileged пишет туда PID-файл и временные файлы прокси, а Node.js и библиотеки могут писать временные файлы. Без тома nginx при readOnlyRootFilesystem завершается при старте с ошибкой mkdir() "/tmp/client_temp" failed (30: Read-only file system).
Пространство имён помечается метками Pod Security Admission: enforce на уровне baseline и warn, audit на уровне restricted.
При apply API-сервер выведет предупреждения Warning: would violate PodSecurity "restricted:latest" для тех подов, которые не соответствуют restricted. Если frontend и backend настроены правильно, предупреждения останутся только у StatefulSet db: официальный образ PostgreSQL стартует от root, чтобы поменять владельца каталога данных, и только потом переключается на пользователя postgres (UID 70 в alpine-образах). Продвинутая часть: добиться прохождения restricted и для базы (runAsUser: 70, fsGroup: 70, сброс всех capabilities) и объяснить, почему это работает только при пустом или уже принадлежащем UID 70 томе.
Проверка «сломать и починить»: временно уберите emptyDir у frontend, примените, найдите причину по kubectl logs и kubectl describe pod, верните том.
ServiceAccount и RBAC
Ни backend, ни frontend не обращаются к API Kubernetes, поэтому минимальная роль для них — отсутствие роли:
ServiceAccount backend и frontend, у каждого automountServiceAccountToken: false; Deployment ссылаются на них через serviceAccountName. В ServiceAccount default по умолчанию монтируется токен, и процесс, захваченный через уязвимость в приложении, получает учётные данные для API-сервера.
ServiceAccount notes-reader для наблюдения за приложением (например, для скрипта мониторинга или человека с правами «только смотреть»). Role notes-reader: get, list, watch на pods, services, endpointslices (группа discovery.k8s.io) и get на подресурс pods/log. RoleBinding связывает их в пределах пространства имён. Права на secrets и pods/exec в роль не входят: exec в под, где переменные содержат пароль, равносилен чтению секрета.
Проверка прав без входа под этой учётной записью — через имперсонацию:
И с настоящим токеном: kubectl create token notes-reader --duration=10m выдаёт короткоживущий токен (TokenRequest API), который можно передать kubectl --token=… get pods и kubectl --token=… delete pod ….
Проверка отсутствия токена в контейнере:
kubectl exec deploy/backend -- ls /var/run/secrets/kubernetes.io/serviceaccount
NetworkPolicy
По умолчанию любой под кластера может открыть соединение с любым другим. Требуемая модель — «всё запрещено, кроме перечисленного»:
Политика
Кому (podSelector)
Что разрешено
default-deny
все поды пространства имён
ничего: policyTypes: Ingress, Egress без правил
allow-dns
все поды
egress на поды k8s-app: kube-dns в пространстве имён kube-system, порты 53/UDP и 53/TCP
frontend
app: frontend
ingress на 8080 из пространства имён ingress-nginx; egress на app: backend, порт 3000
backend
app: backend
ingress на 3000 от app: frontend; egress на app: db, порт 5432
db
app: db
ingress на 5432 от app: backend
Пространство имён выбирается по метке kubernetes.io/metadata.name, которую API-сервер ставит на каждое пространство имён автоматически. Политики аддитивны: под, выбранный несколькими политиками, получает объединение их разрешений, а запрет нельзя выразить явно — только отсутствием разрешения. Для соединения нужны оба разрешения: egress у источника и ingress у получателя. Минимальный фрагмент — политика DNS, без которой после default-deny перестанут разрешаться все имена, включая db и backend:
Обратите внимание на отступы в to: namespaceSelector и podSelector в одном элементе списка означают «поды kube-dns в kube-system» (логическое И). Если поставить перед podSelector дефис, получатся два элемента — «любой под kube-system или под kube-dns в своём пространстве имён» (логическое ИЛИ).
Пробы kubelet политиками не блокируются: трафик с узла, на котором работает под, NetworkPolicy не ограничивает.
Перед применением убедитесь, что Calico работает (kubectl -n kube-system get pods -l k8s-app=calico-node — Running). Затем примените политики по одной и после каждой проверяйте матрицу доступности. Временный под с нужной меткой имитирует компонент:
# от имени frontend к backend — должно работать
kubectl run t1 --rm -it --restart=Never --image=busybox:1.37.0 --labels=app=frontend -- \
  wget -q -O- -T 3 http://backend:3000/api/health
# от имени frontend к базе — соединение не должно установиться
kubectl run t2 --rm -it --restart=Never --image=busybox:1.37.0 --labels=app=frontend -- \
  wget -q -O- -T 3 http://db:5432
# под без меток — не должен достучаться ни до чего, кроме DNS
kubectl run t3 --rm -it --restart=Never --image=busybox:1.37.0 -- \
  sh -c 'nslookup backend; wget -q -O- -T 3 http://backend:3000/api/health'
Генератор нагрузки этапа 4 после default-deny получит отказ; чтобы снова пользоваться им, дайте ему отдельную метку и отдельное правило, а не ослабляйте политику backend.
trivy image сопоставляет пакеты ОС и зависимости из package-lock.json с базой известных уязвимостей. Число найденных CVE зависит от даты базы, поэтому в журнал записывается вывод trivy --version (версия и дата базы) вместе с результатом. --exit-code 1 превращает сканирование в «ворота»: команда завершается с ошибкой, если найдено хотя бы одно совпадение, и в конвейере CI сборка остановится. trivy config проверяет Dockerfile и манифесты на ошибки конфигурации: отсутствие USER, readOnlyRootFilesystem, ограничений ресурсов.
Для каждой найденной уязвимости уровня HIGH и CRITICAL запишите: в каком пакете, устраняется ли обновлением базового образа или зависимости (колонка Fixed Version), достижим ли уязвимый код из приложения.
Что должно получиться
kubectl get pods после применения securityContext — все поды Running; kubectl exec deploy/backend -- touch /app/x завершается ошибкой Read-only file system, а touch /tmp/x — успешно.
kubectl apply выводит предупреждения PodSecurity только для db (или ни для чего, если выполнена продвинутая часть).
Ответы kubectl auth can-i: yes, yes, no, no, no. Запрос delete pod с токеном notes-reader возвращает Forbidden с текстом User "system:serviceaccount:notes-v01:notes-reader" cannot delete resource "pods".
В контейнере backend каталога /var/run/secrets/kubernetes.io/serviceaccount нет.
Матрица доступности: t1 получает {"status":"ok",...}, t2 завершается через 3 с с download timed out (если вместо этого wget сообщает об ошибке протокола или обрыве соединения, TCP-соединение с PostgreSQL установилось, и политика не действует), t3 разрешает имя backend (DNS разрешён), но не получает ответа HTTP. Приложение через Ingress работает как прежде.
Если сразу после default-deny всё сломалось с ошибками getaddrinfo EAI_AGAIN db в журнале backend — это и есть забытая политика DNS.
Если t2 и t3 получают доступ, политики не действуют: проверьте, что кластер создан с --cni=calico (раздел «Типичные проблемы»).
Вопросы для самопроверки
Почему runAsNonRoot в манифесте не заменяет USER в Dockerfile, а дополняет его?
Зачем отключать монтирование токена ServiceAccount у приложения, которое не обращается к API? Что мог бы сделать атакующий с токеном default?
Почему для соединения frontend → backend нужны две политики (egress у одного и ingress у другого)?
Почему после default-deny сначала ломается DNS, и почему ошибка выглядит как недоступность базы?
Почему число CVE в выводе Trivy для одного и того же образа меняется со временем?
Этап 6. Инфраструктура как код
Задачи этапа
Перенести в OpenTofu ту часть стенда, которая до сих пор создавалась командами вручную: пространство имён с метками Pod Security, секреты и ConfigMap, квоты ресурсов, Ingress-контроллер. State хранится в S3-бакете с версионированием и блокировкой. Декларативная модель, план и его символы + ~ - -/+, импорт существующих объектов, дрейф и удалённый бэкенд разобраны в теме 9, устройство S3 — в теме 10.
Граница ответственности. Deployment, StatefulSet и прочие объекты приложения остаются YAML-манифестами в k8s/ и применяются kubectl: они меняются с каждой версией приложения, и в эксплуатации их обычно доставляет конвейер CI/CD или GitOps-контроллер. OpenTofu описывает платформу, на которую приложение ставится: то, что меняется редко и создаётся раньше приложения. Описать в OpenTofu и Deployment технически возможно (kubernetes_deployment_v1 или kubernetes_manifest), но тогда каждый выпуск приложения становится изменением инфраструктуры.
S3-сервер для state
S3-сервер RustFS запускается контейнером Docker на хосте, вне кластера: в нём будет лежать описание кластера, и он не должен зависеть от того, жив ли кластер.
Процесс в образе работает от UID 10001. Именованный том Docker при первом подключении заполняется содержимым /data из образа вместе с владельцем, поэтому права совпадают; при монтировании каталога хоста (-v $(pwd)/data:/data) его владельца нужно сменить на 10001:10001 вручную. Порт 9000 — S3 API, 9001 — веб-консоль. Ключи, переданные через -e, видны в docker inspect cp-rustfs: для учебного стенда это допустимо, в эксплуатации ключи передаются через файл секрета.
Профиль AWS CLI и бакет для state:
aws configure set aws_access_key_id cpadmin --profile cp
aws configure set aws_secret_access_key "$RUSTFS_SECRET_KEY" --profile cp
aws configure set region us-east-1 --profile cp
aws configure set endpoint_url http://localhost:9000 --profile cp
aws configure set s3.addressing_style path --profile cp
export AWS_PROFILE=cp
aws s3api create-bucket --bucket aurora-tfstate
aws s3api put-bucket-versioning --bucket aurora-tfstate \
  --versioning-configuration Status=Enabled
aws s3api get-bucket-versioning --bucket aurora-tfstate
Если AWS CLI сообщает об ошибке контрольной суммы или о неподдерживаемом заголовке, задайте export AWS_REQUEST_CHECKSUM_CALCULATION=when_required AWS_RESPONSE_CHECKSUM_VALIDATION=when_required: новые версии CLI по умолчанию добавляют к запросам контрольные суммы CRC, которые поддерживают не все S3-совместимые серверы.
Конфигурация OpenTofu
Каталог iac/. Провайдеры и бэкенд — единственная часть, которая даётся целиком, потому что она не содержит решений, только адреса:
Блок backend не может ссылаться на переменные: бэкенд инициализируется раньше, чем вычисляются переменные. Поэтому параметры вынесены в файл частичной конфигурации backend.hcl (в репозиторий — как backend.hcl.example):
Флаги skip_* отключают обращения к сервисам AWS, которых у S3-совместимого сервера нет (STS для проверки ключей, служба метаданных EC2, проверка имени региона). use_lockfile = true включает блокировку state объектом terraform.tfstate.tflock рядом с самим state; она основана на условной записи S3 (If-None-Match), и сервер должен её поддерживать. Ключи доступа OpenTofu берёт из профиля AWS_PROFILE=cp.
Требования к ресурсам (по одному ресурсу на пункт):
kubernetes_namespace_v1 — пространство имён из варианта с метками Pod Security этапа 5. Пространство имён уже существует, поэтому оно не создаётся заново, а импортируется блоком import с id — именем пространства имён. Первый tofu plan должен показать 1 to import и ни одного to destroy.
kubernetes_secret_v1 — Secret db-credentials, тоже через импорт (id вида notes-v01/db-credentials). Пароль — из переменной db_password с sensitive = true, значение задаётся переменной окружения TF_VAR_db_password, а не в файле. Пароль должен совпадать с действующим: PostgreSQL читает POSTGRES_PASSWORD только при инициализации пустого каталога данных, и смена значения в Secret не меняет пароль в базе — backend перестанет подключаться.
kubernetes_limit_range_v1 — значения по умолчанию для контейнеров без resources (default_request 50m и 64Mi, default 200m и 128Mi). Без него после введения квоты API-сервер отклонит любой под без requests и limits, например генератор нагрузки этапа 4.
helm_release — Ingress-контроллер Traefik вместо аддона ingress-nginx, фрагмент ниже.
Переменные варианта (namespace, bucket_prefix) — в terraform.tfvars; выходные значения namespace и ingress_class.
resource "helm_release" "traefik" {
  name             = "traefik"
  repository       = "https://traefik.github.io/charts"
  chart            = "traefik"
  version          = "41.6.1"
  namespace        = "traefik"
  create_namespace = true

  set = [
    { name = "ports.web.hostPort", value = "80" },
    { name = "service.type", value = "ClusterIP" },
    { name = "ingressClass.isDefaultClass", value = "true" },
  ]
}
hostPort 80 привязывает точку входа Traefik к порту 80 узла, так же как это делает аддон ingress-nginx, поэтому доступ снаружи (minikube ip, minikube tunnel) не меняется. Перед apply отключите аддон, иначе оба контроллера займут порт 80: minikube -p cp addons disable ingress. После apply поменяйте в Ingress ingressClassName на traefik, а в NetworkPolicy frontend — пространство имён источника с ingress-nginx на traefik.
Порядок работы и эксперименты
cd iac
export AWS_PROFILE=cp TF_VAR_db_password="$(kubectl get secret db-credentials \
  -o jsonpath='{.data.POSTGRES_PASSWORD}' | base64 -d)"
tofu init -backend-config=backend.hcl
tofu fmt -check && tofu validate
tofu plan -out=plan.bin
tofu apply plan.bin
tofu plan            # повторный план: изменений быть не должно
Эксперименты, с предсказанием в журнале:
Дрейф, то есть расхождение фактического состояния с описанным: kubectl label namespace notes-v01 owner=manual и kubectl edit configmap backend-config (поменять APP_VERSION). Предскажите, что покажет tofu plan для каждого из двух изменений, затем проверьте. Провайдер сравнивает с state только атрибуты, описанные в конфигурации; объясните по факту, попала ли посторонняя метка в план и почему, и что сделает tofu apply.
Блокировка: запустите tofu apply и, не отвечая на запрос подтверждения, во втором терминале выполните tofu plan и aws s3 ls s3://aurora-tfstate/course-project/.
Секреты в state: план показывает пароль как (sensitive value), но aws s3 cp s3://aurora-tfstate/course-project/terraform.tfstate - | grep -c POSTGRES_PASSWORD найдёт его в state открытым текстом. Отсюда требования к бакету state: доступ только у тех, кто применяет инфраструктуру, шифрование, версионирование. В OpenTofu есть и собственное шифрование state (блок encryption, начиная с версии 1.7) — продвинутая часть этапа.
История state: aws s3api list-object-versions --bucket aurora-tfstate --prefix course-project/ после нескольких apply. Как восстановить state, испорченный неудачной операцией?
Квота: после apply выполните kubectl describe resourcequota и создайте под с requests.cpu: 3. Каким будет ответ API-сервера?
Что должно получиться
tofu plan после apply выводит No changes. Your infrastructure matches the configuration.
Первый план с импортом не содержит destroy и -/+ для пространства имён и секрета; приложение во время apply не прерывается.
kubectl -n traefik get pods — контроллер Running; kubectl get ingressclass показывает traefik с пометкой класса по умолчанию; приложение снова открывается по тому же адресу, что и на этапе 3.
Во время ожидающего apply второй tofu plan завершается ошибкой Error acquiring the state lock с идентификатором блокировки, а в бакете виден объект terraform.tfstate.tflock; после завершения apply он исчезает.
kubectl describe resourcequota показывает занятые и предельные значения, а под с requests.cpu: 3 отклоняется с сообщением exceeded quota.
В репозитории нет terraform.tfstate, .terraform/, backend.hcl с реальными ключами и пароля в terraform.tfvars; файл .terraform.lock.hcl — есть (он фиксирует версии и контрольные суммы провайдеров).
Вопросы для самопроверки
Почему state нельзя хранить в той системе, которую он описывает?
Что произошло бы, если бы пространство имён было описано в OpenTofu без импорта, а затем выполнен apply?
Чем блокировка state отличается от версионирования бакета, и от каких ошибок защищает каждое?
Почему .terraform.lock.hcl коммитится, а terraform.tfstate — нет?
Какие объекты стенда стоит описывать в OpenTofu, а какие оставить манифестам приложения? Сформулируйте критерий.
Этап 7. Объектное хранилище
Задачи этапа
Подключить S3 двумя способами, которые встречаются в любом облачном приложении. Первый — вложения заметок через presigned URL: backend не пропускает файлы через себя, а выдаёт клиенту подписанную ссылку с ограниченным сроком действия. Второй — резервное копирование PostgreSQL по расписанию в бакет с версионированием и правилом жизненного цикла, с проверкой восстановления. Модель S3, подпись SigV4, presigned URL, версионирование и lifecycle разобраны в теме 10.
Бакеты и учётные данные
S3-сервер — тот же контейнер cp-rustfs из этапа 6. Создайте два бакета:
aurora-attachments — вложения;
aurora-backups — резервные копии, с версионированием и правилом lifecycle: неактуальные (noncurrent) версии удаляются через 7 дней.
Правило за время работы над проектом не сработает: проверка сводится к тому, что сервер принял конфигурацию и возвращает её. Если сервер отвечает NotImplemented, запишите это в README: поддержка lifecycle у S3-совместимых серверов неполная, и это одно из отличий от AWS S3.
Ключи доступа для кластера — Secret s3-credentials с AWS_ACCESS_KEY_ID и AWS_SECRET_ACCESS_KEY, описанный в OpenTofu рядом с db-credentials (значение — из переменной с sensitive = true). Для простоты используются ключи администратора cpadmin. Это нарушение принципа минимальных привилегий, и продвинутая часть этапа — завести в консоли RustFS отдельного пользователя с политикой, разрешающей только s3:PutObject и s3:GetObject на arn:aws:s3:::aurora-attachments/* и s3:PutObject на arn:aws:s3:::aurora-backups/notes/*, и убедиться через AWS CLI, что aws s3 rb и чтение чужого бакета с этими ключами отклоняются.
Сетевой путь от кластера к S3
Внутри кластера хост доступен по имени host.minikube.internal: minikube прописывает его в /etc/hosts узла и в конфигурацию CoreDNS. Проверьте оба пути и запишите адрес — он понадобится для NetworkPolicy:
Под запускается в default, где нет default-deny. Ответ S3 без подписи — XML с кодом AccessDenied: сеть до сервера есть, а доступа без ключей нет, что и ожидается.
Вложения через presigned URL
Требования к конфигурации backend (через OpenTofu, а не kubectl edit: ConfigMap теперь описан в state, и ручная правка будет откатана следующим apply):
в backend-config: S3_BUCKET=aurora-attachments, S3_ENDPOINT=http://host.minikube.internal:9000, S3_PUBLIC_ENDPOINT=http://localhost:9000, S3_PRESIGN_TTL=300;
в Deployment backend: переменные из s3-credentials;
после изменения ConfigMap — kubectl rollout restart deployment/backend: переменные окружения читаются только при старте контейнера (семантика обновления ConfigMap — в теме 8).
Зачем два адреса. Presigned URL содержит имя хоста, и оно входит в подписанные данные. Подписать URL можно любым именем — подпись вычисляется локально из ключа, без обращения к серверу, — но использовать его сможет только тот, кто доступен по этому имени. Браузер на хосте видит RustFS как localhost:9000, под в кластере — как host.minikube.internal:9000. Если подписать от внутреннего имени, ссылка не откроется в браузере; если заменить в готовой ссылке хост, сервер вернёт SignatureDoesNotMatch.
Предскажите до проверки: нужна ли backend политика egress к S3, чтобы выдавать presigned URL? Проверьте, не добавляя такой политики.
Повторить PUT по тому же URL с -H 'Content-Type: application/pdf'. Backend подписывает заголовок Content-Type (signableHeaders в app.js), поэтому клиент не может загрузить под этим ключом файл другого типа.
Заменить в URL localhost на 127.0.0.1 и повторить GET.
Задать S3_PRESIGN_TTL=30, получить ссылку, подождать минуту и повторить GET.
Резервное копирование CronJob
Требования к CronJob db-backup:
расписание из варианта; concurrencyPolicy: Forbid (следующий запуск не стартует, пока не завершён предыдущий), startingDeadlineSeconds: 300, successfulJobsHistoryLimit: 3, failedJobsHistoryLimit: 3; в Job — backoffLimit: 2, activeDeadlineSeconds: 600; в поде — restartPolicy: Never, метка app: db-backup, ServiceAccount db-backup без токена;
init-контейнер dump из postgres:17.11-alpine3.24 выполняет pg_dump -h db -U "$PGUSER" -d notes -Fc -f /backup/notes.dump; PGUSER и PGPASSWORD — из db-credentials. Версия pg_dump не должна быть младше версии сервера, поэтому образ тот же, что у базы;
основной контейнер upload из amazon/aws-cli:2.38.4 (точка входа образа — aws) с аргументами s3 cp /backup/notes.dump s3://aurora-backups/notes/notes.dump; переменные AWS_ENDPOINT_URL=http://host.minikube.internal:9000, AWS_REGION=us-east-1, ключи из s3-credentials;
emptyDir/backup общий для двух контейнеров: init-контейнер завершается до старта основного, и файл переходит от одного к другому через том;
securityContext как у приложения: не root (runAsUser: 70 для dump, 1000 для upload), readOnlyRootFilesystem: true; AWS CLI нужен домашний каталог для записи — HOME=/tmp и emptyDir в /tmp;
NetworkPolicy: egress db-backup → app: db порт 5432 и → ipBlock с адресом host.minikube.internal/32, порт 9000; ingress у db дополняется источником app: db-backup.
Ключ объекта при каждом запуске одинаковый: при включённом версионировании каждая выгрузка становится новой версией того же объекта, а старые копии хранятся как неактуальные версии до срабатывания lifecycle-правила.
Запишите в журнал время восстановления (RTO) и объём потерянных данных (RPO) для своего расписания: сколько заметок в худшем случае пропадёт при отказе диска прямо перед очередным бэкапом.
Что должно получиться
Ответ POST /api/notes/:id/attachment-url — JSON с method: "PUT", url на http://localhost:9000/aurora-attachments/attachments/<id>/<uuid>-report.txt?X-Amz-Algorithm=AWS4-HMAC-SHA256&...&X-Amz-Expires=300&X-Amz-SignedHeaders=content-type%3Bhost&... и headers с тем же Content-Type.
PUT возвращает 200, объект виден в aws s3 ls, GET по второй ссылке выдаёт привет из S3; на странице у заметки появляется кнопка «Вложение», открывающая файл.
Presigned URL выдаётся и без egress-политики к S3: подпись не требует сетевого обращения.
Эксперименты 1–3 дают 403: SignatureDoesNotMatch в первых двух случаях, отказ по истечении срока (AccessDenied, «Request has expired» или аналогичное сообщение сервера) в третьем.
Ручной Job завершается Complete, в журнале upload — строка вида upload: ../backup/notes.dump to s3://aurora-backups/notes/notes.dump; после двух запусков list-object-versions показывает две версии, одна с IsLatest = True.
После pg_restore из выбранной версии GET /api/notes возвращает заметку «до сбоя» и не возвращает «после бэкапа».
Вопросы для самопроверки
Почему backend выдаёт ссылку, а не принимает файл сам? Какие ресурсы backend и сети это экономит и какой контроль теряется?
Почему presigned URL нельзя «исправить», заменив в нём имя хоста?
От каких сценариев отказа защищает версионирование бакета бэкапов, а от каких нет (подсказка: удаление бакета, компрометация ключей с правом удаления версий, отказ хоста с RustFS)?
Почему pg_dump в CronJob запускается из образа той же версии, что и сервер?
Как изменится RPO, если перейти от ежечасного pg_dump к непрерывному архивированию WAL?
Этап 8. Наблюдаемость
Задачи этапа
Собрать метрики backend в Prometheus, построить дашборд по методу RED (Rate — интенсивность запросов, Errors — доля ошибок, Duration — длительность), сформулировать целевой уровень обслуживания (SLO) из варианта и написать правило алерта по скорости сжигания бюджета ошибок, а затем вызвать срабатывание алерта искусственным отказом. Формат экспозиции, типы метрик, rate, гистограммы и оценка квантилей, RED, SLI/SLO и burn rate разобраны в теме 12.
Метрики backend
В app.js уже есть инструментирование библиотекой prom-client:
Метрика
Тип
Метки
Что измеряет
http_requests_total
counter
method, route, status
число обработанных запросов
http_request_duration_seconds
histogram
method, route, status
длительность обработки; корзины 5 мс … 5 с, включая 0,1; 0,25; 0,5 с
notes_db_ready
gauge
—
1, если последняя проверка /api/health прошла
process_*, nodejs_*
разные
—
CPU, память, задержка цикла событий, сборка мусора
Метка route — шаблон маршрута (/api/notes/:id), а не фактический путь. Если бы в метку попадал путь, каждый идентификатор заметки порождал бы новый временной ряд в каждой из 10 корзин гистограммы, и число рядов росло бы без ограничения — это проблема кардинальности. Посмотрите на сырой вывод:
Требования (пространство имён monitoring добавляется в конфигурацию OpenTofu):
ServiceAccount prometheus в monitoring (токен нужен: Prometheus обращается к API за списком подов). Role prometheus-discovery в notes-v01 с get, list, watch на pods и RoleBinding на этот ServiceAccount. Роль namespaced, а не ClusterRole: Prometheus видит поды только того пространства имён, которое ему разрешено.
ConfigMap prometheus-config с prometheus.yml и файлом правил; Deployment prometheus из prom/prometheus:v3.15.1 с аргументами --config.file=/etc/prometheus/prometheus.yml, --storage.tsdb.path=/prometheus, --storage.tsdb.retention.time=2d, --web.enable-lifecycle; emptyDir в /prometheus (данные теряются при пересоздании пода — для учебного стенда допустимо, в эксплуатации нужен PVC); requests 200m и 256Mi, limits 512Mi; Service prometheus на 9090.
Обнаружение целей через API Kubernetes, роль pod, а не статический адрес Service: через Service каждый опрос попадал бы на случайный под, и счётчики разных подов смешивались бы в один скачущий ряд. Минимальный фрагмент:
NetworkPolicy backend дополняется правилом ingress на 3000 из пространства имён monitoring от подов app: prometheus.
Deployment grafana из grafana/grafana:13.2.4: пароль администратора из Secret (GF_SECURITY_ADMIN_PASSWORD), источник данных подключается через provisioning — ConfigMap с файлом в /etc/grafana/provisioning/datasources/, где type: prometheus и url: http://prometheus.monitoring.svc:9090; emptyDir в /var/lib/grafana.
Проверка конфигурации до применения — promtool из того же образа:
Доступ к интерфейсам: kubectl -n monitoring port-forward svc/prometheus 9090:9090 и kubectl -n monitoring port-forward svc/grafana 3001:3000. После изменения ConfigMap Prometheus перечитывает конфигурацию по curl -X POST localhost:9090/-/reload, но сам файл в томе обновляется не сразу, а с задержкой до минуты (период синхронизации kubelet).
Дашборд RED
Дашборд Notes RED в Grafana, переменная route со значениями label_values(http_requests_total{job="notes-backend"}, route), три панели. Запросы — основа, их можно уточнять:
# Rate: запросов в секунду по маршрутам
sum by (route) (rate(http_requests_total{job="notes-backend", route=~"$route"}[5m]))

# Errors: доля ответов 5xx
sum(rate(http_requests_total{job="notes-backend", route=~"$route", status=~"5.."}[5m]))
  / sum(rate(http_requests_total{job="notes-backend", route=~"$route"}[5m]))

# Duration: 95-й процентиль по маршрутам
histogram_quantile(0.95,
  sum by (le, route) (rate(http_request_duration_seconds_bucket{job="notes-backend", route=~"$route"}[5m])))
Почему именно так. rate применяется к счётчику до суммирования: при перезапуске пода счётчик обнуляется, и rate обрабатывает сброс, а сумма сырых счётчиков — нет. histogram_quantile получает корзины, просуммированные по подам, но с сохранением le: квантиль считается по объединённому распределению, а усреднять квантили отдельных подов нельзя. Дашборд экспортируется в JSON и сохраняется в monitoring/dashboards/notes-red.json.
SLO и бюджет ошибок
SLI доступности — доля ответов без кода 5xx среди пользовательских запросов к /api/notes…. Пробы /api/live и /api/health в SLI не входят: kubelet опрашивает их каждые несколько секунд, они почти всегда успешны и быстры, и их доля размыла бы реальные ошибки.
Бюджет ошибок — допустимая доля неуспешных запросов, 1 - \text{SLO}. Для варианта 1 (SLO 99,0 % за 30 дней) это 1 % запросов; при равномерной нагрузке — эквивалент полного простоя длительностью
Для SLO 99,5 % получается 216 мин, для 99,9 % — 43,2 мин. Скорость сжигания (burn rate) — отношение текущей доли ошибок к бюджету: при скорости 1 бюджет расходуется ровно за 30 дней, при скорости 14,4 за один час расходуется 14{,}4 \cdot 1 / 720 = 2\,\% месячного бюджета. Правило быстрого сжигания срабатывает, когда доля ошибок превышает 14{,}4 \cdot (1 - \text{SLO}) и в окне 1 ч, и в окне 5 мин: длинное окно отсекает короткие всплески, короткое — позволяет алерту погаснуть вскоре после устранения причины. Для варианта 1 порог — 14{,}4 \cdot 0{,}01 = 0{,}144, то есть 14,4 % ошибок.
Минимальный фрагмент правил (константа 1 - \text{SLO} — из своего варианта; правило записи для окна 1 ч пишется аналогично):
Этот запрос точен только потому, что порог совпадает с границей корзины: число запросов не дольше 0,25 с гистограмма хранит прямо. Для порога 0,3 с такой корзины нет, и пришлось бы либо менять корзины в коде, либо полагаться на линейную интерполяцию histogram_quantile внутри корзины 0,25–0,5 с, ошибка которой может быть порядка ширины корзины.
Эксперимент с алертом
Предскажите, через сколько минут алерт перейдёт в Firing, затем проверьте. Внесите отказ и запустите нагрузку на API:
kubectl set env deployment/backend FAULT_RATE=0.3     # выберите долю больше порога своего варианта
app/scripts/load.sh http://$IP/api/notes 2400 0.2
Оценка времени. Если до эксперимента запросов к API не было, доля ошибок в окне 1 ч сразу равна доле внесённых отказов (0,3 > 0,144), и алерт перейдёт в Pending через несколько минут, когда заполнится окно 5 мин, а в Firing — ещё через 2 мин (for: 2m). Если же нагрузка той же интенсивности шла весь предыдущий час без ошибок, доля ошибок в часовом окне растёт линейно: через t минут она равна 0{,}3 \cdot t / 60 и превысит 0,144 только при t > 28{,}8 мин. Это свойство правила, а не недостаток: алерт быстрого сжигания срабатывает, когда расход бюджета действительно велик, а не на первом всплеске. Сравните оценку с наблюдением на странице Alerts в Prometheus.
Затем kubectl set env deployment/backend FAULT_RATE- (дефис в конце удаляет переменную) и наблюдайте, как алерт гаснет: короткое окно 5 мин опускается ниже порога быстрее часового. Отдельно проверьте SLI задержки с FAULT_DELAY_MS=300.
Что должно получиться
На странице Status → Targets в Prometheus в задании notes-backend столько целей в состоянии UP, сколько подов backend; при kubectl scale deployment backend --replicas=<N+1> (или росте HPA) новая цель появляется без правки конфигурации.
Запрос up{job="notes-backend"} возвращает по ряду на под с меткой pod.
Дашборд показывает рост Rate под нагрузкой load.sh, рост Errors после FAULT_RATE и рост Duration после FAULT_DELAY_MS.
Алерт NotesErrorBudgetFastBurn проходит Inactive → Pending → Firing и после снятия отказа возвращается в Inactive; фактическое время совпадает с оценкой с точностью до интервалов опроса (15 с) и вычисления правил.
Если цели в состоянии DOWN с context deadline exceeded — их блокирует NetworkPolicy; если целей нет вовсе, а в журнале Prometheus pods is forbidden — не хватает Role или RoleBinding.
Вопросы для самопроверки
Почему Prometheus опрашивает каждый под, а не Service, и что будет с графиком rate при опросе через Service?
Почему нельзя сначала просуммировать счётчики по подам, а потом взять rate?
Почему проба readiness и SLI доступности измеряют разное, хотя оба «про доступность»?
Чем окно 1 ч в правиле алерта отличается по назначению от окна 5 мин? Что произойдёт, если оставить только одно из них?
Как изменится бюджет ошибок в минутах, если SLO поднять с 99,9 % до 99,99 %, и что это значит для частоты выпусков?
Типичные проблемы
Диагностика почти всегда начинается с трёх команд: kubectl get pods (состояние и RESTARTS), kubectl describe pod <под> (раздел Events и Last State с кодом выхода) и kubectl logs <под> --previous (журнал предыдущего, упавшего экземпляра контейнера). Подробная классификация состояний — в теме 7.
CrashLoopBackOff
Контейнер стартует и завершается, kubelet перезапускает его с растущей паузой (10 с, 20 с, 40 с … до 5 мин). Причина — в журнале предыдущего экземпляра и в коде выхода.
Признак
Причина
Исправление
frontend: host not found in upstream "backend"
Service backend не создан или называется иначе; в Compose — контейнер backend ещё не запущен
создать Service с именем backend; depends_on в Compose
frontend: bind() to 0.0.0.0:80 failed (13: Permission denied)
официальный образ nginx или конфигурация с listen 80 при непривилегированном пользователе
образ nginx-unprivileged и listen 8080
backend: Cannot find module 'express'
node_modules не скопирован во второй этап сборки или затёрт локальным каталогом
проверить COPY --from и .dockerignore
Last State: Terminated, Reason: OOMKilled, Exit Code: 137
превышен limits.memory
увеличить предел или найти утечку; код 137 = 128 + 9 (SIGKILL)
Liveness probe failed в Events, растёт RESTARTS
неверный порт или путь пробы; liveness направлена на /api/health при недоступной базе
liveness на /api/live, проверить port
db: initdb: error: directory "/var/lib/postgresql/data" exists but is not empty
в корне тома lost+found
PGDATA=/var/lib/postgresql/data/pgdata
ImagePullBackOff после minikube image load
Образ загружен, но под пытается скачать его из реестра и не находит.
Не та версия: minikube -p cp image ls | grep notes и сравнить с image в манифесте. Частая ошибка — образ загружен в другой профиль (minikube image load без -p cp грузит в профиль minikube).
imagePullPolicy: Always или его отсутствие при теге latest: для latest политика по умолчанию — Always, и kubelet всегда обращается к реестру, игнорируя загруженный образ. Отсюда ещё одна причина не использовать latest.
Образ пересобран с прежним тегом: на узле остался старый образ, а IfNotPresent не повод его обновлять. Новый тег на каждую сборку.
Архитектура: образ, собранный под amd64 на одной машине и перенесённый на arm64 (Apple Silicon), на узле не запустится (exec format error). Собирайте на той же машине, где работает minikube.
CreateContainerConfigError
container has runAsNonRoot and image has non-numeric user (node), cannot verify user is non-root — в Dockerfile USER node; нужно USER 1000 или runAsUser: 1000 в securityContext.
secret "db-credentials" not found или couldn't find key DB_PASSWORD in Secret — опечатка в имени Secret или ключа, Secret в другом пространстве имён.
Под в состоянии Pending
0/1 nodes are available: insufficient cpu — сумма requests превышает ёмкость узла (на этапе 4 при большом maxReplicas); уменьшить requests или максимум HPA.
PVC в Pending — нет StorageClass по умолчанию (kubectl get storageclass), в minikube это standard. Состояние WaitForFirstConsumer до появления пода нормально.
После этапа 6: exceeded quota в событиях ReplicaSet (kubectl describe rs) — квота исчерпана, под даже не создан.
Ingress недоступен
Аддон не включён или контроллер не готов: kubectl -n ingress-nginx get pods (после этапа 6 — -n traefik).
У Ingress пустой ADDRESS в kubectl get ingress в первые минуту-две — нормально; если дольше, не совпадает ingressClassName с классом установленного контроллера (kubectl get ingressclass).
macOS и Windows с Docker Desktop: адрес minikube ip с хоста недоступен, запросы висят до тайм-аута. Нужен minikube -p cp tunnel в отдельном терминале и http://127.0.0.1, либо kubectl port-forward к Service контроллера.
Ответ 404 Not Found от контроллера — запрос дошёл, но не совпал ни с одним правилом (путь, host).
502 или 503 — правило совпало, но у Service frontend нет готовых подов или frontend не достучался до backend. Проверить kubectl get endpointslices.
504 после этапа 5 — NetworkPolicy не пускает контроллер к frontend: источник должен совпадать с пространством имён контроллера (ingress-nginx или traefik).
HPA показывает unknown
kubectl get hpa выводит cpu: <unknown>/50%:
metrics-server не включён или ещё не собрал данные: minikube -p cp addons list | grep metrics-server, kubectl top pods (ошибка Metrics API not available означает то же). Первые значения появляются через 1–2 мин после включения.
У контейнеров нет resources.requests.cpu: утилизацию не от чего считать, в kubectl describe hpa — missing request for cpu.
scaleTargetRef указывает не на тот Deployment.
NetworkPolicy «не работает»
Политики применены, kubectl get networkpolicy их показывает, а трафик проходит. Почти всегда причина в CNI: политику исполняет сетевой плагин, а API-сервер лишь хранит объект. Стандартный CNI minikube политики не поддерживает и молча их игнорирует.
kubectl -n kube-system get pods -l k8s-app=calico-node
Если подов Calico нет, кластер создан без --cni=calico, и CNI существующего кластера не поменять: minikube delete -p cp и создание заново (манифесты из репозитория применяются за минуту — ещё одна причина держать всё в git). Если Calico работает, а политика не действует, проверьте селекторы: kubectl get pods --show-labels и сравните с podSelector; опечатка в метке делает политику пустой, а не ошибочной.
Обратная ситуация — после default-deny не работает ничего, в журнале backend getaddrinfo EAI_AGAIN db: нет политики egress на DNS.
readOnlyRootFilesystem и nginx
Официальный образ nginx при старте пишет PID-файл в /var/run/nginx.pid и создаёт временные каталоги в /var/cache/nginx, а скрипты входа в /docker-entrypoint.d/ пытаются править /etc/nginx/conf.d/default.conf. С корневой ФС только для чтения ему нужны emptyDir в /var/cache/nginx и /var/run, а для запуска не от root ещё и смена порта и владельцев. В nginx-unprivileged всё перенесено в /tmp, поэтому достаточно одного emptyDir в /tmp. Сообщение can not modify /etc/nginx/conf.d/default.conf (read-only file system?) в журнале при старте — информационное: скрипт пропускает шаг, nginx запускается.
PostgreSQL и учётные данные
Пароль в Secret изменён, backend перестал подключаться (password authentication failed for user "notes"): POSTGRES_PASSWORD применяется только при первой инициализации пустого каталога данных. Сменить пароль в самой базе: kubectl exec -it db-0 -- psql -U notes -d notes -c "ALTER USER notes PASSWORD '…'", либо вернуть прежнее значение в Secret.
Переход на образ postgres:18: путь данных по умолчанию изменён (/var/lib/postgresql/18/docker), и том, смонтированный в /var/lib/postgresql/data, окажется вне каталога данных. Мажорная версия меняется только через pg_dump/pg_restore или pg_upgrade, а не заменой тега.
S3 и OpenTofu
SignatureDoesNotMatch при использовании presigned URL — заголовок Content-Type отличается от подписанного, хост в URL изменён, или часы хоста и сервера расходятся больше чем на 15 мин.
В presigned URL адрес host.minikube.internal — не задан S3_PUBLIC_ENDPOINT.
Ошибки контрольных сумм AWS CLI или SDK с S3-совместимым сервером — AWS_REQUEST_CHECKSUM_CALCULATION=when_required и AWS_RESPONSE_CHECKSUM_VALIDATION=when_required (в app.js то же самое сделано параметрами клиента).
tofu init: NoSuchBucket — бакет state не создан; ошибки STS или IMDS — не заданы флаги skip_* в backend.hcl.
Error acquiring the state lock после прерванного apply (Ctrl+C, закрытый терминал) — блокировка осталась в бакете. Убедитесь, что другой операции действительно нет, и снимите её: tofu force-unlock <ID>.
Что должно получиться
В конце проекта есть стенд, который поднимается из репозитория на чистой машине по README, и понимание, почему каждая его часть устроена именно так.
Образы frontend и backend собираются многоэтапно, работают от числовых непривилегированных UID, корректно завершаются по SIGTERM; размеры записаны.
docker compose up -d поднимает приложение локально; данные переживают down/up.
В кластере cp: PostgreSQL в StatefulSet с PVC, backend и frontend в Deployment с пробами liveness, readiness и startup, Ingress снаружи; данные переживают удаление пода базы.
Обновление backend проходит без единого ответа, отличного от 200; неудачное обновление откатывается; HPA масштабирует backend под нагрузкой; отказ базы выводит поды backend из балансировки без перезапусков.
Поды без root и без записи в корневую ФС, ServiceAccount без токенов, Role «только чтение» проверена через auth can-i, сетевые пути ограничены матрицей этапа 5 и проверены тестовыми подами; результат сканирования Trivy с датой базы и разбором HIGH/CRITICAL.
Платформенная часть описана в OpenTofu, state в версионируемом бакете с блокировкой, повторный plan пуст, дрейф обнаруживается и устраняется.
Вложения загружаются и скачиваются по presigned URL; резервная копия создаётся по расписанию, хранит версии и из неё выполнено восстановление с записанными RTO и RPO.
Prometheus находит поды backend через API, дашборд RED отражает нагрузку и отказы, алерт по скорости сжигания бюджета ошибок срабатывает при внесённом отказе за предсказанное время и гаснет после его снятия.
Чек-лист самопроверки
Пункты сформулированы так, чтобы на каждый можно было ответить «да» или «нет» по выводу команды. Пункт с ответом «нет» — повод вернуться к этапу или к разделу «Типичные проблемы».
Контейнеры и Compose:
docker run --rm notes-backend:<тег> id и то же для frontend выводят UID 1000 и 101.
docker stop контейнера backend занимает меньше 2 с, последняя строка журнала — SIGTERM received, shutting down.
docker compose config --quiet проходит без ошибок, а в выводе docker compose config нет пароля, записанного в compose.yaml открытым текстом.
В git нет .env, а .env.example есть.
Kubernetes:
kubectl get pods в пространстве имён варианта: все поды Running и READY, RESTARTS не растёт в покое.
Число адресов в EndpointSlice backend равно числу реплик.
Заметка, созданная до kubectl delete pod db-0, видна после.
Во время kubectl rollout счётчик load.sh показывает только 200.
При kubectl scale statefulset db --replicas=0 у подов backend READY 0/1 и неизменный RESTARTS.
kubectl get hpa backend под нагрузкой показывает больше реплик, чем минимум.
В контейнере backend нет каталога /var/run/secrets/kubernetes.io/serviceaccount.
Под с меткой app: frontend не открывает соединение с db:5432, а с backend:3000 — открывает.
kubectl apply -R -f k8s/ не выводит предупреждений PodSecurity ни для чего, кроме db (или вообще).
Записаны дата базы Trivy и решение по каждой уязвимости HIGH/CRITICAL.
Инфраструктура как код и S3:
tofu plan выводит No changes.
aws s3api list-object-versions --bucket <префикс>-tfstate показывает несколько версий state.
В git нет terraform.tfstate, .terraform/ и ключей S3; .terraform.lock.hcl есть.
Presigned URL с изменённым Content-Type получает 403.
В бакете бэкапов больше одной версии notes/notes.dump, и восстановление из неактуальной версии выполнено.
Наблюдаемость:
up{job="notes-backend"} возвращает столько рядов, сколько подов backend.
Ни в одной метке http_requests_total нет числовых идентификаторов заметок.
Алерт NotesErrorBudgetFastBurn побывал в состоянии Firing и вернулся в Inactive.
promtool check rules проходит для файла правил из репозитория.
Воспроизводимость:
После minikube delete -p cp стенд поднимается заново по README, и все пункты выше снова выполняются.
Материалы проекта
Материалы ведутся для себя: чтобы через полгода поднять стенд, вспомнить решения и показать работу, если понадобится.
Репозиторий со структурой из раздела «Порядок работы». История коммитов по этапам (этап 3: StatefulSet для БД) полезнее одного итогового коммита: по ней видно, как стенд менялся и что ломалось.
README — инструкция, по которой стенд поднимается на чистой машине: требования и версии инструментов, вариант и его параметры, порядок команд по этапам, как получить доступ к приложению, Prometheus и Grafana, как разобрать стенд. Проверка README — выполнить его самому после minikube delete, ничего не вспоминая.
Схема архитектуры своего стенда (docs/architecture.svg или PNG): компоненты и их типы объектов (Deployment, StatefulSet, CronJob), Service и порты, Ingress, PVC, пространства имён, разрешённые NetworkPolicy потоки, внешний S3 и путь presigned URL. Нотация произвольная, важно, чтобы по схеме можно было ответить на вопрос «кто с кем и по какому порту соединяется». Схема в начале этого документа — образец уровня детализации.
Журнал JOURNAL.md с экспериментами всех этапов по схеме «предсказание — команда — вывод — объяснение», включая результат сканирования Trivy с датой базы, RTO и RPO восстановления и сравнение оценки времени срабатывания алерта с фактом.