
Виртуализация как основа облачной инфраструктуры
Облачные вычисления, рассмотренные в предыдущей теме, опираются на способность предоставлять вычислительные ресурсы по запросу, динамически распределять их между потребителями и обеспечивать логическую изоляцию нагрузок. Все эти свойства предполагают наличие промежуточного программного уровня, который отделяет прикладные задачи от физического оборудования. Таким уровнем является виртуализация.
Виртуализация не является изобретением облачной эпохи. Первые практические реализации виртуальных машин появились ещё в 1960-х годах в контексте мэйнфреймов IBM, где требовалось одновременно исполнять несколько независимых операционных сред на одном дорогостоящем вычислительном узле. Однако именно в сочетании с облачной моделью виртуализация приобрела массовое промышленное значение: она стала технологической основой, на которой строятся центры обработки данных, платформы IaaS и большинство управляемых облачных сервисов.
Настоящая тема раскрывает назначение виртуализации, типы гипервизоров и подходов к виртуализации, ресурсную модель виртуальной машины, а также механизмы изоляции и управления ресурсами, реализуемые на уровне ядра операционной системы. Каждый из этих вопросов важен не только теоретически, но и практически: без понимания механизмов виртуализации невозможно корректно оценить ни возможности облачных платформ, ни ограничения различных подходов к изоляции вычислительных сред.
Назначение виртуализации
Абстрагирование физических ресурсов и формирование управляемых вычислительных сред
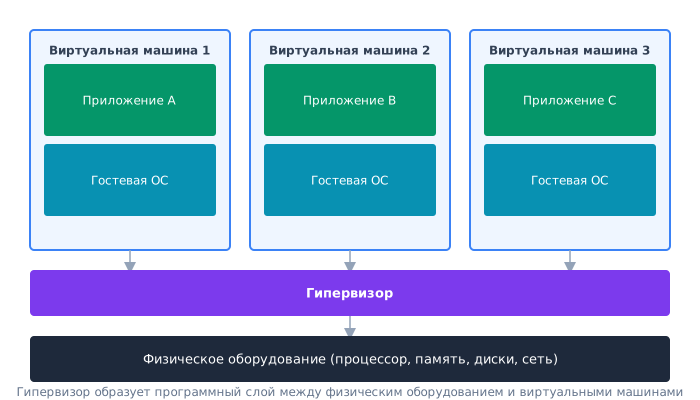
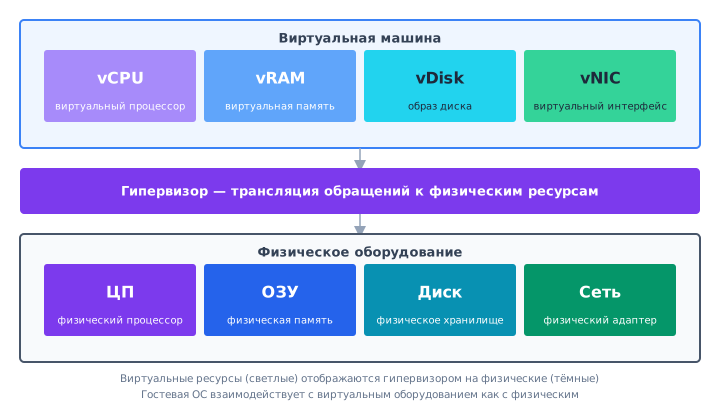
Основная идея виртуализации состоит в создании программной абстракции над физическим оборудованием. Вместо того чтобы предоставлять приложению прямой доступ к процессору, оперативной памяти, дисковому хранилищу и сетевому интерфейсу конкретного сервера, виртуализация формирует промежуточный уровень, который представляет эти ресурсы в виде логических сущностей. Приложение и операционная система, работающие внутри виртуальной машины, взаимодействуют с виртуальным оборудованием так, как если бы оно было физическим, но в действительности все обращения транслируются программным слоем виртуализации.
Такое абстрагирование решает несколько фундаментальных задач. Во-первых, оно позволяет разместить на одном физическом сервере несколько независимых вычислительных сред, каждая из которых содержит собственную операционную систему, собственный набор приложений и собственную конфигурацию. Во-вторых, оно обеспечивает логическую изоляцию между этими средами: сбой или компрометация одной виртуальной машины не затрагивает другие, размещённые на том же оборудовании. В-третьих, абстрагирование делает вычислительные ресурсы управляемыми программно: виртуальную машину можно создать, остановить, клонировать, перенести на другой физический узел или уничтожить через программный интерфейс, без физического доступа к оборудованию.
Именно программная управляемость превращает виртуализацию из механизма разделения ресурсов в инструмент построения масштабируемой инфраструктуры. Без неё облачная модель — с её требованиями к самообслуживанию, эластичности и измеряемости — была бы практически нереализуема. Каждый раз, когда потребитель облачного сервиса создаёт виртуальный сервер через веб-консоль или API, он фактически инициирует процесс создания виртуальной машины на одном из физических узлов центра обработки данных.
Консолидация нагрузок и повышение коэффициента использования оборудования
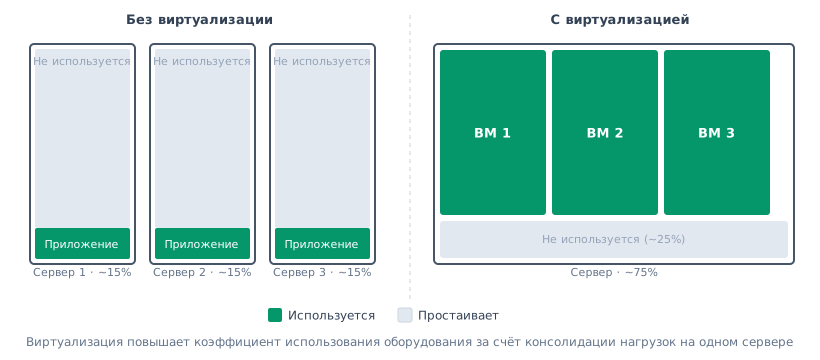
Одним из наиболее осязаемых практических эффектов виртуализации является консолидация нагрузок (workload consolidation). В традиционной модели каждому приложению или сервису нередко выделяется отдельный физический сервер. Такой подход мотивирован соображениями изоляции и совместимости: различные приложения могут требовать разных версий операционной системы, конфликтующих библиотек или несовместимых настроек среды. Однако следствием этого является крайне низкий коэффициент использования оборудования. Исследования показывают, что средняя загрузка физических серверов в традиционных центрах обработки данных составляет от 5 до 15 процентов вычислительной мощности. Остальные ресурсы простаивают, но продолжают потреблять электроэнергию и занимать место.
Виртуализация позволяет разместить на одном физическом сервере десятки виртуальных машин, каждая из которых функционирует как изолированная вычислительная среда. Это повышает коэффициент использования оборудования до 60–80 процентов и более, что даёт значительный экономический эффект: сокращается количество физических серверов, снижаются затраты на электроэнергию, охлаждение, размещение и обслуживание.
Вместе с тем консолидация нагрузок не является безусловно позитивным явлением. Размещение слишком большого числа виртуальных машин на одном физическом узле приводит к конкуренции за ресурсы: процессорное время, пропускную способность памяти и дисковую подсистему. Если совокупная потребность виртуальных машин систематически превышает возможности оборудования, возникает деградация производительности, которая может затронуть все размещённые нагрузки. Поэтому планирование ёмкости (capacity planning) является обязательной дисциплиной при эксплуатации виртуализированной инфраструктуры.
Роль виртуализации в построении центров обработки данных и облачных платформ
Современный центр обработки данных (ЦОД), обслуживающий облачную платформу, представляет собой не просто совокупность серверов, а управляемую среду, в которой физические ресурсы объединены в единый пул и предоставляются потребителям через программные интерфейсы. Виртуализация является ключевым компонентом этой архитектуры. Она обеспечивает абстрагирование оборудования, изоляцию потребителей друг от друга (multi-tenancy), управление жизненным циклом виртуальных сред и динамическое перераспределение ресурсов.
На уровне облачной платформы виртуализация реализует несколько критически важных функций. Миграция виртуальных машин между физическими узлами (live migration) позволяет проводить обслуживание оборудования без остановки пользовательских нагрузок. Моментальные снимки состояния (snapshots) обеспечивают возможность отката к предыдущему состоянию в случае сбоя. Шаблонизация ускоряет массовое развертывание однотипных сред. Автоматизированное управление ресурсами позволяет платформе перераспределять нагрузки в зависимости от текущего потребления.
Следует, однако, учитывать, что виртуализация не является единственной технологией, используемой в облачных платформах. Современные платформы дополняют её программно-определяемыми сетями (Software-Defined Networking, SDN), программно-определяемым хранилищем (Software-Defined Storage, SDS) и системами оркестрации, которые координируют работу всех компонентов. Тем не менее именно виртуализация вычислительных ресурсов остаётся фундаментальным слоем, без которого остальные надстройки не имеют основания.
Гипервизоры и типы виртуализации
Понятие гипервизора
Гипервизор (hypervisor), или монитор виртуальных машин (Virtual Machine Monitor, VMM), представляет собой программный компонент, обеспечивающий создание и управление виртуальными машинами. Гипервизор располагается между физическим оборудованием и гостевыми операционными системами, выполняя функции распределения ресурсов, изоляции и трансляции обращений гостевых систем к аппаратуре. Именно гипервизор определяет, какие ресурсы доступны каждой виртуальной машине, каким образом обращения к оборудованию транслируются и как обеспечивается взаимная независимость виртуальных сред.
С точки зрения архитектуры гипервизоры принято разделять на два типа, различающихся способом взаимодействия с аппаратным обеспечением.
Гипервизор первого типа (type 1 hypervisor)
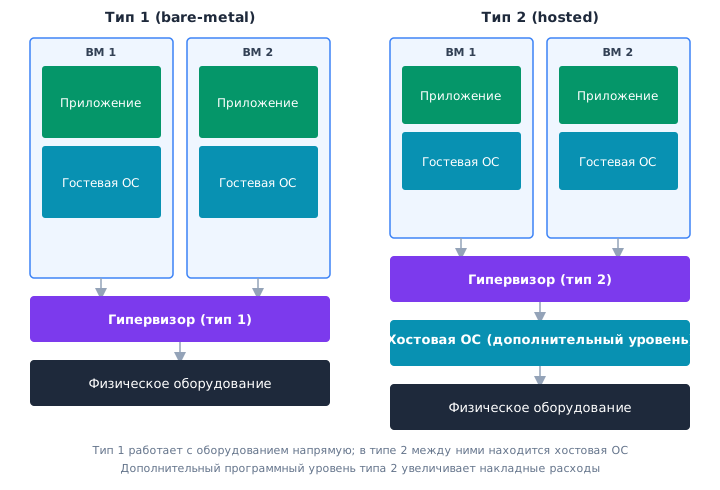
Гипервизор первого типа, называемый также «bare-metal hypervisor», устанавливается непосредственно на физическое оборудование, без промежуточной операционной системы общего назначения. Он берёт на себя функции управления аппаратными ресурсами и предоставляет их гостевым операционным системам. Фактически гипервизор первого типа сам является минимальной операционной средой, специализированной на задачах виртуализации.
Примерами гипервизоров первого типа являются VMware ESXi, Microsoft Hyper-V (в режиме серверной роли), Xen и KVM. Последний заслуживает отдельного пояснения. KVM (Kernel-based Virtual Machine) встроен в ядро Linux и превращает операционную систему Linux в гипервизор первого типа. Хотя Linux при этом продолжает функционировать как операционная система общего назначения, KVM обычно классифицируют как гипервизор первого типа, поскольку модуль виртуализации работает на уровне ядра и взаимодействует с аппаратными средствами виртуализации процессора напрямую 4. Эта классификация в литературе не единодушна: часть авторов относит KVM ко второму типу, поскольку рядом с ним работает полноценная ОС с обычными приложениями, а эмуляцию устройств выполняет пользовательский процесс QEMU — каждая виртуальная машина на хосте с KVM видна как процесс qemu-system-x86_64. Деление на два типа удобно как первое приближение, но реальные системы занимают промежуточные положения, и полезнее спрашивать, какая часть гипервизора работает в ядре, а какая — в пользовательском пространстве.
Гипервизоры первого типа применяются в центрах обработки данных и облачных платформах, где требуется высокая производительность, надёжная изоляция и возможность управления большим количеством виртуальных машин. Отсутствие промежуточной операционной системы общего назначения снижает накладные расходы и уменьшает поверхность атаки.
Гипервизор второго типа (type 2 hypervisor)
Гипервизор второго типа устанавливается как обычное приложение поверх существующей операционной системы. Хостовая операционная система управляет аппаратными ресурсами, а гипервизор работает как её приложение, создавая виртуальные машины как процессы хостовой среды. Слово «приложение» здесь не следует понимать буквально как «только пользовательское пространство»: для использования VT-x/AMD-V и управления памятью гостя гипервизору второго типа всё равно нужен собственный модуль ядра (у VirtualBox это драйвер vboxdrv, без которого машина не запустится). Отличие от первого типа в другом — аппаратурой управляет хостовая ОС общего назначения, и гипервизор получает процессорное время и память у её планировщика наравне с остальными программами. Обращения гостевых систем к аппаратуре проходят через два программных уровня: сначала через гипервизор, затем через хостовую операционную систему.
Примерами гипервизоров второго типа являются Oracle VirtualBox и VMware Workstation. Такие решения широко используются для разработки, тестирования и обучения, поскольку не требуют выделенного оборудования и позволяют запускать виртуальные машины на обычном рабочем компьютере наряду с другими приложениями.
Основным недостатком гипервизоров второго типа являются более высокие накладные расходы. Дополнительный программный уровень в виде хостовой операционной системы вносит задержки при обработке обращений к аппаратуре. Кроме того, гостевые операционные системы конкурируют за ресурсы не только друг с другом, но и с приложениями хостовой системы. Поэтому для задач промышленной эксплуатации гипервизоры второго типа, как правило, не используются.
Условие Попека — Голдберга и проблема архитектуры x86
Прежде чем рассматривать способы виртуализации, нужно понять, почему одни процессоры виртуализируются легко, а другие — нет. В 1974 году Дж. Попек и Р. Голдберг сформулировали формальное условие 1. Назовём чувствительной (sensitive) инструкцию, которая читает или меняет состояние, важное для изоляции: режим процессора, таблицы страниц, флаг разрешения прерываний. Назовём привилегированной (privileged) инструкцию, которая в пользовательском режиме вызывает исключение (trap) и тем самым передаёт управление ядру. Теорема Попека — Голдберга утверждает: эффективный монитор виртуальных машин можно построить, если множество чувствительных инструкций является подмножеством множества привилегированных. Тогда гостевое ядро можно исполнять напрямую в непривилегированном режиме: обычные инструкции выполняются процессором с полной скоростью, а каждая чувствительная вызывает исключение, которое перехватывает гипервизор и эмулирует её эффект. Этот подход называют «trap-and-emulate».
Архитектура x86 до середины 2000-х годов этому условию не удовлетворяла: в ней было около семнадцати чувствительных, но непривилегированных инструкций. Классический пример — POPF: в пользовательском режиме она молча игнорирует попытку изменить флаг разрешения прерываний, вместо того чтобы вызвать исключение. Гостевое ядро, запущенное в непривилегированном режиме, думает, что запретило прерывания, гипервизор об этом не узнаёт, и поведение гостя становится неверным. Аналогично инструкция SMSW позволяет непривилегированному коду прочитать часть управляющего регистра и обнаружить, что он работает не в нулевом кольце защиты.
Обойти это ограничение можно двумя способами, которые соответствуют двум подходам, рассмотренным ниже: либо переписывать проблемные инструкции гостя на лету (бинарная трансляция), либо изменить само гостевое ядро так, чтобы оно не использовало их (паравиртуализация). Третий способ — изменить процессор — появился позже и сделал x86 виртуализируемой в смысле Попека — Голдберга.
Полная виртуализация, паравиртуализация и аппаратная поддержка
Помимо архитектурной классификации гипервизоров по типу размещения, существует классификация по способу обработки привилегированных инструкций гостевых операционных систем. Этот вопрос связан с тем, что операционная система, исполняющаяся внутри виртуальной машины, полагает себя единственным владельцем аппаратных ресурсов и пытается выполнять привилегированные операции — управление таблицами страниц памяти, обращения к устройствам ввода-вывода, управление прерываниями, — которые в действительности должны быть перехвачены гипервизором.
При полной виртуализации (full virtualization) гостевая операционная система не модифицируется. Она исполняется в неизменённом виде, а гипервизор перехватывает и эмулирует привилегированные инструкции. На x86 без аппаратной поддержки перехвата исключений недостаточно, поэтому VMware с 1999 года применяла бинарную трансляцию (binary translation): код гостевого ядра перед исполнением просматривается блоками, чувствительные инструкции заменяются вызовами гипервизора, а оттранслированные блоки кэшируются и повторно используются; пользовательский код гостя при этом исполняется напрямую 2. Это обеспечивает максимальную совместимость: внутри виртуальной машины можно запустить практически любую операционную систему без её адаптации. Однако эмуляция привилегированных операций создаёт вычислительные накладные расходы, которые могут быть заметны при интенсивных операциях ввода-вывода или при работе с памятью.
Паравиртуализация (paravirtualization) предполагает модификацию гостевой операционной системы. Вместо выполнения привилегированных инструкций напрямую гостевая система использует специальные программные интерфейсы (hypercalls) для обращения к гипервизору. Это позволяет избежать затратного перехвата и эмуляции, повышая производительность. Однако паравиртуализация требует изменений в ядре гостевой операционной системы, что ограничивает набор совместимых систем и усложняет сопровождение. Наиболее известной реализацией паравиртуализации является гипервизор Xen в его раннем варианте 3. Сегодня паравиртуализацию ядра целиком применяют редко, но её идея сохранилась в паравиртуализированных драйверах устройств, которые рассматриваются в следующем разделе.
Аппаратная поддержка виртуализации (hardware-assisted virtualization) появилась в процессорах Intel (технология VT-x) и AMD (технология AMD-V) в середине 2000-х годов. Она вводит специальный режим работы процессора, в котором гостевые операционные системы могут безопасно исполнять привилегированные инструкции, а процессор аппаратно обеспечивает перехват тех операций, которые должны обрабатываться гипервизором. Аппаратная поддержка существенно сократила накладные расходы полной виртуализации, сделав её производительность сопоставимой с паравиртуализацией. Интересно, что первые реализации VT-x уступали по скорости зрелой бинарной трансляции: каждый выход из гостя в гипервизор (VM exit) стоил тысячи тактов, а таблицы страниц по-прежнему приходилось обслуживать программно 2. Разрыв закрыло второе поколение аппаратной поддержки — двухуровневая трансляция адресов, о которой пойдёт речь ниже. В результате аппаратная виртуализация стала доминирующим подходом в современных системах. KVM, VMware ESXi и Microsoft Hyper-V опираются на аппаратную поддержку процессора как на обязательное условие работы.
Проверить наличие аппаратной поддержки в Linux можно без специальных средств: процессор с VT-x сообщает флаг vmx, с AMD-V — флаг svm, а утилита lscpu выводит итог в строке Virtualization. Ниже приведён вывод, полученный в среде WSL2 на процессоре AMD Ryzen:
lscpu | grep -i -E 'virtualization|hypervisor'
Virtualization:                       AMD-V
Hypervisor vendor:                    Microsoft
Virtualization type:                  full
Строка Hypervisor vendor показывает, что сама эта система Linux уже работает внутри виртуальной машины под гипервизором Hyper-V, а строка Virtualization: AMD-V — что гипервизор передал гостю возможность запускать собственные виртуальные машины. Эта ситуация называется вложенной виртуализацией и рассматривается в разделе о виртуализации памяти и ввода-вывода. Если строки Virtualization нет, а в /proc/cpuinfo отсутствуют флаги vmx и svm, то либо процессор не поддерживает аппаратную виртуализацию, либо она отключена в настройках BIOS/UEFI, либо (внутри ВМ) гипервизор её не пробрасывает.
Влияние выбранного подхода на практику
Выбор типа гипервизора и подхода к виртуализации определяется конкретными требованиями. Для промышленной облачной инфраструктуры стандартом де-факто являются гипервизоры первого типа с аппаратной поддержкой виртуализации, обеспечивающие оптимальное соотношение производительности, совместимости и изоляции. Для учебных и исследовательских задач гипервизоры второго типа остаются удобным и доступным инструментом.
Важно осознавать, что производительность виртуальной машины всегда несколько ниже, чем производительность приложения, исполняющегося непосредственно на физическом оборудовании. Даже при наличии аппаратной поддержки виртуализации существуют накладные расходы на трансляцию обращений к памяти, эмуляцию устройств ввода-вывода и управление переключениями контекста между гостевыми системами. В большинстве прикладных сценариев эти расходы составляют единицы процентов и несущественны, однако для задач с высокими требованиями к производительности — высоконагруженные базы данных, системы реального времени, ресурсоёмкие вычисления — они могут стать значимым фактором.
Виртуализация памяти и ввода-вывода
Аппаратная поддержка VT-x и AMD-V решила проблему чувствительных инструкций, но не две другие причины накладных расходов: трансляцию адресов памяти и эмуляцию устройств. Именно в них сегодня сосредоточена основная разница между «медленной» и «быстрой» виртуальной машиной, и именно их механизмы определяют, сколько стоит каждая операция гостя.
Двухуровневая трансляция адресов: EPT и NPT
В обычной системе процессор переводит виртуальный адрес процесса в физический по таблицам страниц, которые ведёт ядро. В виртуальной машине уровней адресов три: гостевой виртуальный адрес (guest virtual address, GVA), гостевой физический адрес (guest physical address, GPA), то есть адрес в «оперативной памяти», которую гость считает своей, и физический адрес хоста (host physical address, HPA). Гостевое ядро ведёт таблицы GVA → GPA и ничего не знает о том, где в действительности лежат его страницы.
До появления аппаратной помощи гипервизор строил для каждого гостевого процесса теневые таблицы страниц (shadow page tables), сразу отображающие GVA → HPA, и загружал в процессор их, а не гостевые. Чтобы теневые таблицы оставались верными, гипервизор защищал гостевые таблицы от записи и перехватывал каждое их изменение. Для нагрузок, которые часто создают процессы и отображают память (компиляция, веб-серверы с порождением процессов), такие перехваты становились главной статьёй накладных расходов.
Второе поколение аппаратной поддержки ввело двухуровневую трансляцию адресов (Second Level Address Translation, SLAT): у Intel она называется EPT (Extended Page Tables), у AMD — NPT (Nested Page Tables) или RVI. Процессор сам выполняет обе трансляции: по гостевым таблицам переводит GVA → GPA, а по второй таблице, которую ведёт гипервизор, — GPA → HPA, как показано на рисунке ниже. Гость свободно меняет свои таблицы без единого перехвата, а гипервизор правит только вторую таблицу, когда выделяет гостю или отбирает у него память.
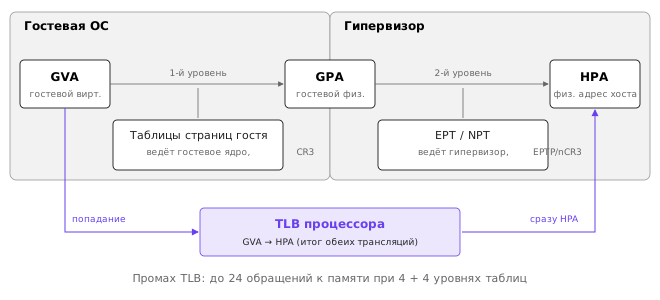
Цена этого решения проявляется при промахе буфера ассоциативной трансляции (Translation Lookaside Buffer, TLB). Каждое обращение к гостевой таблице страниц само является гостевым физическим адресом, который нужно перевести через вторую таблицу. При четырёхуровневых таблицах с обеих сторон полный обход в худшем случае требует (4 + 1) \cdot (4 + 1) - 1 = 24 обращения к памяти вместо 4 без виртуализации 6. Поэтому для виртуальных машин особенно полезны большие страницы (2 МиБ и 1 ГиБ): они сокращают число уровней обхода и число записей в TLB. Наличие SLAT в Linux видно по флагам процессора ept (Intel) и npt (AMD) в /proc/cpuinfo; гипервизоры используют её автоматически, если процессор её поддерживает.
Паравиртуализированные устройства virtio
Эмуляция реального сетевого адаптера (например, Intel e1000) означает, что гостевой драйвер пишет в регистры несуществующего устройства, каждая такая запись вызывает выход в гипервизор, и гипервизор программно воспроизводит поведение микросхемы. На передачу одного сетевого пакета приходится несколько выходов из гостя, каждый из которых стоит микросекунды.
Паравиртуализированное устройство устроено иначе: гость знает, что работает в виртуальной машине, и обменивается с гипервизором через очереди в разделяемой памяти. Стандартом таких устройств стал virtio, предложенный Р. Расселом для Linux в 2008 году 5 и с тех пор стандартизованный организацией OASIS. Драйвер гостя кладёт в кольцевую очередь (virtqueue) описатели буферов — например, десятки пакетов сразу — и одним уведомлением сообщает об этом гипервизору; гипервизор обрабатывает пакеты пачкой и так же пачкой возвращает ответы. Семейство virtio включает сетевую карту (virtio-net), блочное устройство (virtio-blk), SCSI-контроллер (virtio-scsi), консоль, генератор случайных чисел и устройство «балуна» памяти (virtio-balloon), с помощью которого гипервизор просит гостя вернуть неиспользуемые страницы.
Таким образом, паравиртуализация, которая в варианте раннего Xen требовала переписать гостевое ядро, сегодня живёт на уровне драйверов: ядро гостя остаётся неизменным, а быстрыми становятся только устройства. Драйверы virtio входят в ядро Linux, а для Windows устанавливаются отдельно. В VirtualBox паравиртуализированный сетевой адаптер выбирается как тип «Paravirtualized Network (virtio-net)», а в облаках, построенных на KVM, virtio используется по умолчанию: внутри типичной облачной ВМ диск виден как /dev/vda, а не как /dev/sda.
Прямой доступ к устройствам: IOMMU и SR-IOV
Для сетей 100 Гбит/с и ускорителей вычислений даже virtio оказывается узким местом, и гостю передают физическое устройство напрямую (PCI passthrough). Препятствие здесь в прямом доступе к памяти (Direct Memory Access, DMA): устройство пишет в память по физическим адресам, и драйвер гостя указал бы ему гостевые физические адреса, которые не совпадают с адресами хоста. Хуже того, злонамеренный гость мог бы приказать устройству записать данные в чужую память. Эту задачу решает блок управления памятью для ввода-вывода (Input–Output Memory Management Unit, IOMMU; у Intel — VT-d, у AMD — AMD-Vi): он транслирует адреса DMA устройства так же, как MMU транслирует адреса процессора, и ограничивает устройство памятью своего гостя.
Отдавать каждой ВМ отдельную физическую карту дорого, поэтому применяется виртуализация ввода-вывода с единым корнем (Single Root I/O Virtualization, SR-IOV): одна физическая сетевая карта представляет себя на шине PCIe как одна физическая функция (physical function) и десятки виртуальных функций (virtual functions), каждая из которых передаётся отдельной ВМ. Гость работает с виртуальной функцией напрямую, минуя гипервизор на пути данных. Платой за скорость является потеря гибкости: такую машину сложнее перенести на другой узел без остановки (live migration), поскольку состояние находится в аппаратуре. Крупные облака идут дальше и выносят обработку сети и дисков на отдельные платы с собственным процессором (у AWS — система Nitro), оставляя основному процессору хоста только исполнение гостей.
Вложенная виртуализация
Вложенная виртуализация (nested virtualization) — запуск гипервизора внутри виртуальной машины. Она нужна, например, для тестирования самих гипервизоров, для учебных стендов и для сред вроде WSL2 и Docker Desktop, которые сами работают в виртуальной машине и при этом могут запускать свои ВМ. Аппаратура x86 поддерживает только один уровень VT-x, поэтому гипервизор нижнего уровня (L0) эмулирует для гостевого гипервизора (L1) инструкции VT-x: когда L1 пытается запустить свою машину (L2), инструкция перехватывается L0, который сам запускает L2 на реальном процессоре, сливая таблицы L1 со своими 7. Вывод lscpu, приведённый выше, получен именно в такой среде: Hyper-V (L0) пробросил флаг AMD-V в Linux-машину WSL2 (L1).
Каждый уровень добавляет выходы в гипервизор: одно событие в L2, которое должен обработать L1, превращается в несколько переходов через L0. Поэтому вложенная виртуализация пригодна для разработки, обучения и непрерывной интеграции, но для промышленных нагрузок её избегают. Облачные поставщики включают её только для отдельных типов машин или по запросу.
Ресурсная модель виртуальной машины
Виртуальные процессоры, оперативная память, дисковые образы и виртуальные сетевые интерфейсы
Виртуальная машина представляется гостевой операционной системе как полноценный компьютер с определённым набором аппаратных ресурсов. Эти ресурсы являются виртуальными, то есть предоставляются гипервизором на основе физических ресурсов хоста, но с точки зрения гостевой системы они неотличимы от реального оборудования.
Виртуальные процессоры (virtual CPU, vCPU) соответствуют логическим ядрам физического процессора, выделяемым виртуальной машине. Количество виртуальных процессоров определяет, сколько потоков вычислений гостевая система может выполнять параллельно. Гипервизор планирует исполнение виртуальных процессоров на физических ядрах, обеспечивая разделение процессорного времени между виртуальными машинами. При этом суммарное количество виртуальных процессоров всех виртуальных машин на одном хосте может превышать количество физических ядер — это называется переподпиской (overcommitment) процессорных ресурсов. Умеренная переподписка допустима, если нагрузки не являются одновременно интенсивными, но при чрезмерной переподписке неизбежна деградация производительности.
Оперативная память виртуальной машины выделяется из общего объёма физической памяти хоста. Гипервизор обеспечивает изоляцию адресного пространства: каждая гостевая система видит собственный непрерывный диапазон адресов, хотя в действительности эти адреса могут быть размещены в различных физических областях. Некоторые гипервизоры поддерживают механизмы оптимизации памяти, такие как дедупликация одинаковых страниц (memory deduplication) и динамическое перераспределение памяти (memory ballooning), однако эти технологии имеют свои ограничения и не всегда применимы.
Дисковые ресурсы виртуальной машины представлены в виде образов дисков (disk images) — файлов или блочных устройств, которые гипервизор предоставляет гостевой системе как виртуальные жёсткие диски. Распространёнными форматами образов являются VMDK (VMware), VHD и VHDX (Microsoft), QCOW2 (QEMU/KVM) и RAW. Выбор формата влияет на производительность, возможность создания снимков состояния и эффективность использования дискового пространства. Формат RAW обеспечивает наименьшие накладные расходы, но занимает полный объём выделенного пространства. Формат QCOW2 поддерживает динамическое выделение (thin provisioning), при котором файл образа увеличивается по мере фактической записи данных, а также позволяет создавать снимки состояния. Основные свойства форматов сведены в таблицу.
| Формат | Родной гипервизор | Динамическое выделение | Снимки | Особенности |
|---|---|---|---|---|
| RAW | любой (QEMU/KVM, Xen) | только как разреженный файл файловой системы хоста | нет | побайтная копия диска, минимальные накладные расходы |
| QCOW2 | QEMU/KVM | да | внутренние снимки и цепочки наложений (backing file) | сжатие, шифрование, основной формат облачных образов Linux |
| VDI | VirtualBox | да (dynamically allocated) | разностные VDI-файлы | родной формат VirtualBox |
| VMDK | VMware (читается VirtualBox и QEMU) | да | разностные (delta) диски | может быть разбит на файлы по 2 ГБ |
| VHD / VHDX | Hyper-V | да (dynamic) | разностные диски (AVHDX) | VHD — до 2 ТБ, VHDX — до 64 ТБ |
Форматы взаимно преобразуются утилитой qemu-img из комплекта QEMU, а её подкоманда info показывает разницу между заявленным размером диска и фактически занятым местом — то есть результат динамического выделения:
qemu-img convert -p -f vdi -O qcow2 lab-vm-01.vdi lab-vm-01.qcow2
qemu-img info lab-vm-01.qcow2
image: lab-vm-01.qcow2
file format: qcow2
virtual size: 20 GiB (21474836480 bytes)
disk size: 3.92 GiB
cluster_size: 65536
Format specific information:
    compat: 1.1
    compression type: zlib
    lazy refcounts: false
    refcount bits: 16
    corrupt: false
    extended l2: false
Строка virtual size — объём диска, который видит гость, disk size — место, фактически занятое файлом на хосте. Приведённый вывод соответствует документации QEMU; конкретные числа зависят от установленной системы.
Виртуальные сетевые интерфейсы обеспечивают подключение виртуальной машины к сети. Гипервизор эмулирует сетевой адаптер, который гостевая система использует для передачи и приёма данных. Виртуальные интерфейсы могут быть подключены к различным типам виртуальных сетей: трансляции адресов (NAT), при которой гипервизор выступает для гостя маршрутизатором с трансляцией адресов в сеть хоста, мостовым (bridged), обеспечивающим доступ к физической сети хоста, внутренним (internal), связывающим только виртуальные машины на одном хосте, или изолированным (host-only), ограничивающим связность виртуальной машиной и хостом. Режим NAT используется по умолчанию в большинстве настольных гипервизоров: гость получает выход в интернет, но снаружи, в том числе с самого хоста, к нему нельзя обратиться без явного проброса портов. Поведение режимов на примере VirtualBox сведено в таблицу 9. Для повышения производительности сетевого ввода-вывода используются паравиртуализированные сетевые драйверы (например, virtio в среде KVM), которые снижают накладные расходы на эмуляцию полноценного аппаратного адаптера.
| Режим VirtualBox | Гость → интернет | Хост → гость | ВМ ↔ ВМ | Другие узлы ЛВС → гость | Адрес гостя по умолчанию |
|---|---|---|---|---|---|
| NAT | да | только проброс портов | нет, у каждой ВМ свой NAT | нет | 10.0.2.15, шлюз 10.0.2.2 |
| NAT Network | да | только проброс портов | да, внутри сети | нет | из 10.0.2.0/24 |
| Bridged | да, через физическую сеть | да | да | да | от DHCP физической сети |
| Internal | нет | нет | да, внутри именованной сети | нет | задаётся вручную |
| Host-only | нет | да | да | нет | DHCP в 192.168.56.0/24, хост — 192.168.56.1 |
Сочетание двух адаптеров — NAT для выхода в интернет и host-only для доступа с хоста — даёт учебную ВМ, которая обновляется из интернета, доступна по SSH с хоста и при этом не видна из локальной сети. Именно такая конфигурация используется в лабораторной работе 2.
Шаблоны, снимки состояния и клонирование
Помимо основных вычислительных ресурсов, виртуализация предоставляет ряд инструментов, существенно упрощающих управление вычислительными средами.
Шаблон (template) виртуальной машины представляет собой предварительно настроенный образ, содержащий операционную систему, базовое программное обеспечение и конфигурацию. Шаблоны используются для быстрого развертывания новых виртуальных машин: вместо установки операционной системы с нуля администратор создаёт экземпляр на основе шаблона, что сокращает время подготовки среды с десятков минут, которые занимает установка, до времени копирования образа и загрузки гостевой системы — обычно меньше минуты. Связанные клоны (linked clones), у которых диск — разностный файл поверх общего образа, копируются за секунды, но загрузку ОС это не ускоряет. В контексте облачных платформ шаблоны лежат в основе каталогов готовых образов (например, Amazon Machine Images в AWS или образов в Yandex Cloud).
Снимок состояния (snapshot) фиксирует состояние виртуальной машины в определённый момент времени: содержимое дисков и конфигурацию виртуального оборудования, а если снимок делается с работающей машины и гипервизор это поддерживает, — также содержимое оперативной памяти и состояние процессора. В VirtualBox снимок работающей машины сохраняет память в отдельный файл, и после восстановления машина продолжает работу с того же места; снимок выключенной машины памяти не содержит, и после восстановления система загружается заново. Дисковая часть снимка не копирует диск: исходный образ становится доступным только для чтения, а все последующие записи попадают в новый разностный файл (в VirtualBox — разностный VDI, в QCOW2 — внутренний снимок или наложение с указанием backing file). Поэтому снимок создаётся за секунды, а его размер растёт по мере изменений после него. Снимки позволяют оперативно вернуться к зафиксированному состоянию, что особенно полезно при тестировании обновлений, экспериментах с конфигурацией и в учебных сценариях. Однако снимки не являются полноценной заменой резервного копирования. Длительное накопление снимков увеличивает объём занимаемого дискового пространства, усложняет управление и может негативно сказаться на производительности дисковой подсистемы, поскольку каждая операция записи должна учитывать цепочку зависимых снимков.
Клонирование (cloning) создаёт полную копию существующей виртуальной машины, включая её дисковые образы и конфигурацию. Клон представляет собой независимый экземпляр, который после создания существует и развивается отдельно от оригинала. Клонирование используется для масштабирования однотипных сред, создания тестовых копий и подготовки учебных лабораторий.
Ограничения виртуальной машины
При всех достоинствах виртуализации виртуальная машина обладает рядом ограничений, которые необходимо учитывать при проектировании инфраструктуры.
Первое ограничение — накладные расходы на гостевую операционную систему. Каждая виртуальная машина содержит полноценный экземпляр операционной системы со всеми её компонентами: ядром, системными службами, библиотеками и конфигурационными файлами. Это означает, что значительная доля ресурсов — оперативной памяти и дискового пространства — расходуется не на прикладную задачу, а на поддержание операционной среды. Если на одном физическом сервере размещено двадцать виртуальных машин с одной и той же операционной системой, ядро этой системы загружено в память двадцать раз, и двадцать экземпляров системных служб потребляют процессорное время.
Второе ограничение — длительность запуска. Создание и загрузка виртуальной машины включает инициализацию виртуального оборудования, загрузку ядра операционной системы и запуск системных служб. Этот процесс занимает от десятков секунд до нескольких минут в зависимости от конфигурации. Для задач, требующих быстрого масштабирования и мгновенного развертывания экземпляров, такая задержка может быть неприемлемой.
Третье ограничение — объём артефакта. Образ виртуальной машины, включающий операционную систему и прикладное программное обеспечение, может занимать гигабайты дискового пространства. Передача таких образов по сети, их хранение и версионирование требуют значительных ресурсов.
Перечисленные ограничения не делают виртуализацию непригодной — напротив, для широкого спектра задач она остаётся оптимальным решением. Однако именно эти ограничения стали одной из предпосылок появления контейнеризации как альтернативного, более легковесного подхода к изоляции приложений.
Механизмы изоляции на уровне ядра операционной системы
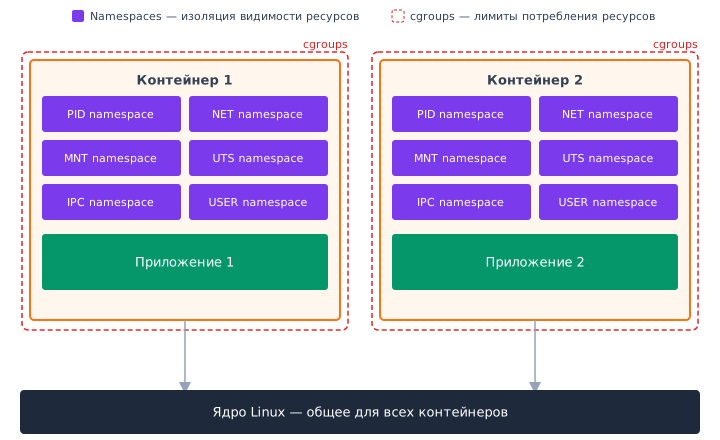
Помимо аппаратной виртуализации, реализуемой гипервизорами, современные ядра операционных систем предоставляют собственные механизмы изоляции и управления ресурсами. Эти механизмы позволяют разделять процессы и группы процессов на уровне операционной системы, обеспечивая логическое разграничение без создания полноценных виртуальных машин. Понимание этих механизмов важно в контексте виртуализации, поскольку они составляют основу легковесных форм изоляции, широко применяемых в современных облачных платформах.
Пространства имён (namespaces)
Пространства имён (namespaces) обеспечивают логическое разделение глобальных ресурсов ядра между процессами. Каждое пространство имён создаёт для входящих в него процессов изолированное представление определённого ресурса, скрывая существование одноимённых ресурсов в других пространствах. Linux реализует несколько типов пространств имён, каждый из которых изолирует отдельную категорию ресурсов 10. Новое пространство имён создаётся системным вызовом clone() (при порождении процесса) или unshare() (для текущего процесса) с соответствующим флагом; одноимённая утилита unshare из пакета util-linux принимает эти флаги как ключи командной строки.
| Пространство имён | Флаг clone/unshare | Ключ утилиты unshare | Что изолирует | Ядро |
|---|---|---|---|---|
| Mount | CLONE_NEWNS | --mount | точки монтирования | 2.4.19 |
| UTS | CLONE_NEWUTS | --uts | имя хоста и доменное имя NIS | 2.6.19 |
| IPC | CLONE_NEWIPC | --ipc | System V IPC, очереди сообщений POSIX | 2.6.19 |
| PID | CLONE_NEWPID | --pid | идентификаторы процессов | 2.6.24 |
| Network | CLONE_NEWNET | --net | сетевые устройства, адреса, маршруты, порты, правила сетевого экрана | 2.6.29 |
| User | CLONE_NEWUSER | --user | идентификаторы пользователей и групп, привилегии | 3.8 |
| Cgroup | CLONE_NEWCGROUP | --cgroup | видимый корень иерархии cgroups | 4.6 |
| Time | CLONE_NEWTIME | --time | смещение часов CLOCK_MONOTONIC и CLOCK_BOOTTIME | 5.6 |
Принадлежность процесса пространствам имён видна в каталоге /proc/<pid>/ns: каждая запись — символическая ссылка, номер в квадратных скобках которой является номером индексного дескриптора пространства. Два процесса находятся в одном пространстве имён тогда и только тогда, когда номера совпадают.
ls -l /proc/self/ns
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 cgroup -> cgroup:[4026531835]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 ipc -> ipc:[4026532206]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 mnt -> mnt:[4026532217]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 net -> net:[4026531840]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 pid -> pid:[4026532219]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 pid_for_children -> pid:[4026532219]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 time -> time:[4026531834]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 time_for_children -> time:[4026531834]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 user -> user:[4026531837]
lrwxrwxrwx 1 noum noum 0 Oct 22 00:01 uts -> uts:[4026532218]
Пространство имён процессов (PID namespace) скрывает от группы процессов все остальные процессы системы. Внутри пространства имён нумерация процессов начинается заново с единицы. Первый процесс, запущенный в изолированной среде, получает идентификатор PID 1 в пределах своего пространства имён, хотя хостовая система видит его под иным глобальным идентификатором. Это легко наблюдать без контейнерных инструментов. Ключ --fork нужен потому, что новое пространство PID применяется к потомкам вызвавшего процесса, а --mount-proc монтирует новый экземпляр /proc, иначе ps читал бы список процессов хоста. Ключ -r (--map-root-user) дополнительно создаёт пространство имён пользователей, что позволяет выполнить пример без sudo:
unshare -r --pid --fork --mount-proc ps -o pid,user,cmd
  PID USER     CMD
    1 root     ps -o pid,user,cmd
Внутри нового пространства существует единственный процесс — сама команда ps с PID 1, — хотя на хосте в тот же момент работают сотни процессов.
Сетевое пространство имён (network namespace) предоставляет изолированный сетевой стек: собственные сетевые интерфейсы, таблицы маршрутизации, правила сетевого экрана и диапазон портов. Благодаря этому несколько групп процессов на одном хосте могут одновременно использовать одни и те же номера портов, не конфликтуя друг с другом.
Пространство имён точек монтирования (mount namespace) изолирует файловую систему: каждая группа процессов видит собственное дерево каталогов, независимое от основной файловой системы хоста и от файловых систем других изолированных сред.
Пространство имён узла (UTS namespace) позволяет группе процессов иметь собственное имя хоста (hostname) и доменное имя, независимое от хостовой системы. Это важно для приложений, которые используют имя хоста для идентификации узла в распределённой системе.
Пространство имён межпроцессного взаимодействия (IPC namespace) изолирует объекты System V IPC (сегменты разделяемой памяти, очереди сообщений и наборы семафоров System V) и очереди сообщений POSIX. Именованные семафоры и разделяемая память POSIX им не изолируются: они реализованы как файлы в /dev/shm и разделяются через mount namespace. Процессы внутри изолированной среды могут взаимодействовать через эти механизмы, не затрагивая процессы за её пределами.
Пространство имён пользователей (user namespace) позволяет отображать идентификаторы пользователей и групп внутри изолированной среды на иные идентификаторы снаружи. Практически значимым следствием этого является возможность предоставить процессу привилегии суперпользователя (UID 0) в пределах пространства имён, тогда как на уровне хостовой системы он будет работать с ограниченными правами непривилегированного пользователя. Данный механизм снижает риски эскалации привилегий при нарушении изоляции. Отображение задаётся файлом /proc/<pid>/uid_map, и его действие видно на простом опыте: файл, созданный «суперпользователем» внутри пространства имён, снаружи принадлежит обычному пользователю с UID 1000.
unshare -r sh -c 'cat /proc/self/uid_map; touch /tmp/ux_test; ls -ln /tmp/ux_test'
ls -ln /tmp/ux_test
         0       1000          1
-rw-r--r-- 1 0 0 0 Oct 22 00:02 /tmp/ux_test
-rw-r--r-- 1 1000 1000 0 Oct 22 00:02 /tmp/ux_test
Строка 0 1000 1 читается так: идентификатор 0 внутри пространства соответствует идентификатору 1000 снаружи, длина диапазона — один идентификатор. Привилегии «root» внутри распространяются только на объекты, принадлежащие этому пространству имён пользователей.
Группы управления ресурсами (control groups, cgroups)
Группы управления ресурсами (control groups, cgroups) решают задачу, принципиально отличную от пространств имён. Если пространства имён определяют, какие ресурсы видит процесс, то cgroups определяют, сколько ресурсов он может потребить. С их помощью можно задать верхние пределы потребления процессорного времени, оперативной памяти, пропускной способности дисковой подсистемы и числа процессов. Пропускную способность сети cgroups не ограничивают: в версии 2 сетевого контроллера нет, а контроллеры net_cls и net_prio версии 1 лишь помечали пакеты для подсистемы управления трафиком tc, которая и выполняла ограничение. При достижении лимита памяти, например, ядро может завершить наиболее ресурсоёмкий процесс группы или ограничить его выполнение — в зависимости от настроенной политики. Без количественных ограничений одна неконтролируемая группа процессов способна исчерпать все ресурсы хоста, нарушая работу остальных.
Механизм существует в двух версиях 11. В cgroups v1 (ядро 2.6.24, 2008 год) у каждого контроллера — cpu, memory, blkio, pids и других — была своя иерархия, и один процесс мог находиться в разных местах разных деревьев, что делало согласованное управление трудным. В cgroups v2 (стабильна с ядра 4.5) иерархия единая: группа — это каталог в файловой системе cgroup2, все контроллеры действуют на одно и то же дерево, процессы находятся только в листовых группах, а включение контроллеров для дочерних групп задаётся файлом cgroup.subtree_control 12. Ubuntu начиная с 21.10, Debian 11, Fedora 31 и RHEL 9 используют v2 по умолчанию. Определить версию можно по типу файловой системы, смонтированной в /sys/fs/cgroup:
stat -fc %T /sys/fs/cgroup
cat /sys/fs/cgroup/cgroup.controllers
ls /sys/fs/cgroup
cgroup2fs
cpuset cpu io memory hugetlb pids rdma
cgroup.controllers      cgroup.stat             cpu.stat.local          memory.numa_stat
cgroup.max.depth        cgroup.subtree_control  cpuset.cpus.effective   memory.pressure
cgroup.max.descendants  cgroup.threads          cpuset.mems.effective   memory.reclaim
cgroup.pressure         cpu.pressure            io.pressure             memory.stat
cgroup.procs            cpu.stat                io.stat
Этот вывод получен в WSL2: файловая система cgroup2fs означает v2, а в корне видны только файлы интерфейса корневой группы. На обычном хосте с systemd рядом с ними находятся ещё и каталоги дочерних групп — init.scope, system.slice (системные службы, в том числе docker.service и группы контейнеров), user.slice (сеансы пользователей). Файлы с префиксом контроллера задают лимиты (memory.max, cpu.max, pids.max, io.max) или отдают статистику (memory.stat, cpu.stat, *.pressure — время, в течение которого задачи простаивали из-за нехватки ресурса). Членство процесса в группе показывает файл /proc/<pid>/cgroup: в v2 в нём одна строка вида 0::/user.slice/user-1000.slice/session-3.scope, в v1 — по строке на каждую иерархию.
Отдельно стоит упомянуть контроллер pids, который ограничивает число процессов и потоков в группе. Он защищает от «форк-бомбы» — процесса, бесконечно порождающего свои копии: без него такой процесс исчерпывает общесистемный предел числа процессов (/proc/sys/kernel/pid_max), после чего на хосте не может запуститься даже оболочка администратора. Ограничение задаётся одной записью (команды требуют прав root и показаны для иллюстрации):
sudo mkdir /sys/fs/cgroup/demo
echo 20 | sudo tee /sys/fs/cgroup/demo/pids.max
echo $$ | sudo tee /sys/fs/cgroup/demo/cgroup.procs   # перенести текущую оболочку в группу
for i in $(seq 30); do sleep 600 & done
...
bash: fork: retry: Resource temporarily unavailable
bash: fork: Resource temporarily unavailable
После двадцатого процесса в группе системный вызов fork() возвращает ошибку EAGAIN, а счётчик max в файле pids.events группы увеличивается при каждом отказе. Именно этот механизм используют Docker (--pids-limit) и Kubernetes (podPidsLimit).
Соотношение аппаратной и программной изоляции
Механизмы изоляции ядра и гипервизорная виртуализация решают схожую задачу — разграничение вычислительных сред — но на разных уровнях абстракции и с различными гарантиями. Гипервизор создаёт аппаратную границу между гостевой и хостовой системой, опираясь на поддержку процессора. Пространства имён и cgroups — это программные средства одного и того же ядра операционной системы, а не аппаратные барьеры. Уязвимость в ядре хостовой системы потенциально затрагивает все изолированные среды, работающие на этом ядре. Поэтому изоляция средствами ядра считается менее строгой по сравнению с изоляцией, обеспечиваемой гипервизором.
В сценариях с высокими требованиями к безопасности дополнительно используются специализированные механизмы: seccomp-профили, ограничивающие набор доступных системных вызовов; политики AppArmor и SELinux, реализующие мандатный контроль доступа; а также изолирующие среды исполнения, добавляющие промежуточный уровень между процессами и ядром.
Промежуточные решения: microVM, gVisor и Kata Containers
Противопоставление «тяжёлая, но надёжно изолированная ВМ» и «лёгкий, но разделяющий ядро процесс» за последние годы размылось: появились решения, которые берут от каждого подхода его сильную сторону.
Микровиртуальная машина (microVM) — виртуальная машина с предельно урезанным набором виртуального оборудования. Монитор Firecracker, созданный AWS для сервисов Lambda и Fargate, работает поверх KVM, но вместо QEMU с его сотнями эмулируемых устройств предоставляет гостю только несколько устройств virtio (сеть, блочное устройство, сокет vsock), последовательный порт и контроллер клавиатуры для перезагрузки 8. Отсутствие BIOS, шины PCI и эмуляции старого оборудования позволяет запускать гостевое ядро Linux примерно за 125 мс и тратить на служебные структуры монитора около 5 МиБ памяти на машину, благодаря чему на одном сервере размещаются тысячи microVM. Каждая функция или контейнер клиента получает собственное ядро и аппаратную границу изоляции при затратах, сопоставимых с контейнером.
Kata Containers применяет ту же идею к контейнерам: среда исполнения, совместимая со спецификацией OCI (тема 3), запускает каждый контейнер или каждый под Kubernetes внутри отдельной лёгкой ВМ на базе QEMU, Cloud Hypervisor или Firecracker. Для Docker и Kubernetes такой контейнер выглядит обычным, но разделяет с хостом не ядро, а только гипервизор.
gVisor, разработанный Google, решает задачу иначе: он не создаёт ВМ, а перехватывает системные вызовы контейнера и обслуживает их собственным ядром Sentry, написанным на Go и работающим в пользовательском пространстве. К ядру хоста обращается только Sentry, причём через узкий набор системных вызовов. Поверхность атаки на ядро хоста уменьшается, но системные вызовы становятся дороже, и часть интерфейсов Linux не поддерживается. Все три подхода показывают, что граница изоляции — это не бинарный выбор между ВМ и контейнером, а шкала, на которой каждое решение платит производительностью за строгость.
Типичные ошибки интерпретации
Первая ошибка — полагать, что процессы гостевой системы видны на хосте. Хост видит процесс гипервизора (VirtualBoxVM, qemu-system-x86_64) и, возможно, его потоки, по одному на виртуальный процессор, но не процессы внутри гостя: у гостя собственное ядро и собственная таблица процессов. Нагрузка гостя проявляется на хосте как загрузка процессора потоками гипервизора. С контейнером ситуация обратная: его процессы — обычные процессы ядра хоста и видны в ps на хосте под своими глобальными PID.
Вторая ошибка — считать снимок резервной копией. Снимок хранится рядом с исходным диском и зависит от него: повреждение или потеря базового образа делает бесполезной всю цепочку снимков.
Третья ошибка — считать, что «аппаратная виртуализация делает ВМ такой же быстрой, как физический сервер». Вычисления действительно выполняются почти без потерь, но промахи TLB, выходы в гипервизор при вводе-выводе и эмулируемые устройства по-прежнему стоят дорого; именно поэтому так важны SLAT, virtio и SR-IOV.
Четвёртая ошибка — считать, что cgroups ограничивают «всё». Они не ограничивают сетевую полосу, а лимит памяти без запрета подкачки может перевести группу в swap вместо завершения процесса; эти детали рассматриваются в темах 3 и 5.
Итоги темы
Виртуализация является фундаментальной технологией, обеспечивающей абстрагирование физических ресурсов и формирование управляемых вычислительных сред. Она позволяет размещать на одном физическом сервере множество независимых виртуальных машин, каждая из которых содержит полноценную операционную систему и работает в изолированном окружении. Консолидация нагрузок повышает коэффициент использования оборудования, а программная управляемость виртуальных сред делает возможным построение облачных платформ с их требованиями к эластичности, самообслуживанию и автоматизации.
Гипервизоры первого типа, работающие непосредственно на оборудовании, обеспечивают производительность и изоляцию, необходимые для промышленной эксплуатации. Гипервизоры второго типа остаются удобным инструментом для разработки и обучения. Аппаратная поддержка виртуализации в современных процессорах существенно сократила накладные расходы и стала обязательным компонентом всех актуальных решений.
Ресурсная модель виртуальной машины включает виртуальные процессоры, оперативную память, дисковые образы и сетевые интерфейсы, а инструменты шаблонизации, создания снимков и клонирования ускоряют управление вычислительными средами. Вместе с тем виртуальные машины обладают ограничениями: значительные накладные расходы на гостевую операционную систему, длительное время запуска и большой объём артефактов.
Помимо аппаратной виртуализации, ядро операционной системы предоставляет собственные механизмы изоляции — пространства имён и группы управления ресурсами, — которые позволяют разграничивать процессы и ограничивать их потребление ресурсов на программном уровне. Эти механизмы обеспечивают менее строгую, но значительно более легковесную изоляцию по сравнению с гипервизором и составляют технологическую основу для подходов, рассматриваемых в последующих темах курса.
Между этими полюсами находятся промежуточные решения. Двухуровневая трансляция адресов, паравиртуализированные устройства virtio и прямой доступ к устройствам через IOMMU и SR-IOV сократили накладные расходы ВМ до уровня, при котором микровиртуальные машины вроде Firecracker запускаются за доли секунды и изолируют отдельные функции и контейнеры собственным ядром. Следующая тема рассматривает противоположный полюс — контейнер, — и показывает, как Docker собирает пространства имён и cgroups в единый объект.
Литература
- Popek G. J., Goldberg R. P. Formal Requirements for Virtualizable Third Generation Architectures. — Communications of the ACM, 1974, Vol. 17, No. 7, С. 412–421, DOI: 10.1145/361011.361073.
- Adams K., Agesen O. A Comparison of Software and Hardware Techniques for x86 Virtualization. — Proceedings of ASPLOS XII, 2006, С. 2–13, DOI: 10.1145/1168857.1168860.
- Barham P., Dragovic B., Fraser K., Hand S., Harris T., Ho A., Neugebauer R., Pratt I., Warfield A. Xen and the Art of Virtualization. — Proceedings of the 19th ACM Symposium on Operating Systems Principles (SOSP '03), 2003, С. 164–177, DOI: 10.1145/945445.945462.
- Kivity A., Kamay Y., Laor D., Lublin U., Liguori A. kvm: the Linux Virtual Machine Monitor. — Proceedings of the Linux Symposium, Ottawa, 2007, Vol. 1, С. 225–230.
- Russell R. virtio: Towards a De-Facto Standard for Virtual I/O Devices. — ACM SIGOPS Operating Systems Review, 2008, Vol. 42, No. 5, С. 95–103, DOI: 10.1145/1400097.1400108.
- Bhargava R., Serebrin B., Spadini F., Manne S. Accelerating Two-Dimensional Page Walks for Virtualized Systems. — Proceedings of ASPLOS XIII, 2008.
- Ben-Yehuda M., Day M. D., Dubitzky Z., Factor M., Har'El N., Gordon A., Liguori A., Wasserman O., Yassour B.-A. The Turtles Project: Design and Implementation of Nested Virtualization. — Proceedings of the 9th USENIX Symposium on Operating Systems Design and Implementation (OSDI '10), 2010.
- Agache A., Brooker M., Florescu A., Iordache A., Liguori A., Neugebauer R., Piwonka P., Popa D.-M. Firecracker: Lightweight Virtualization for Serverless Applications. — Proceedings of the 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI '20), 2020, С. 419–434.
- Oracle VM VirtualBox User Guide. Virtual Networking. — https://www.virtualbox.org/manual/ (дата обращения: 22.10.2026).
- Linux man-pages. namespaces(7) — overview of Linux namespaces. — https://man7.org/linux/man-pages/man7/namespaces.7.html (дата обращения: 22.10.2026).
- Linux man-pages. cgroups(7) — Linux control groups. — https://man7.org/linux/man-pages/man7/cgroups.7.html (дата обращения: 22.10.2026).
- The Linux Kernel Documentation. Control Group v2. — https://docs.kernel.org/admin-guide/cgroup-v2.html (дата обращения: 22.10.2026).